

Qwen 3.8 Flash Next ist die Open-Weight-Vorschau des Qwen-Teams auf seine Qwen4-Architektur der nächsten Generation, veröffentlicht am 26. August 2026. Der Name verwirrt viele, deshalb gleich zu Beginn: Flash Next ist die Open-Weight-Forschungsvorschau, die Sie selbst hosten; Qwen3.8-Flash ist die kommende gehostete API mit 1M Kontextfenster und integrierten Tools. Beides sind zwei Gesichter desselben Modells.
Die Spezifikationen sind die eigentliche Geschichte. Es ist ein 125B-Mixture-of-Experts-Modell, das pro Token nur 6B Parameter aktiviert und mit einer 51B-N-Gram-Lookup-Tabelle gekoppelt ist, die Sie in normalen Arbeitsspeicher auslagern können. Dieses Design erklärt, warum es auf Hardware schnell läuft, die ein dichtes Modell dieser Größe nie fassen könnte, und warum die gehostete Version nur $0.15 Input / $0.47 Output pro Million Tokens kostet.
Unabhängige Tests stützen den Hype bis zu einem gewissen Punkt: Artificial Analysis sieht es bei der Intelligenz im Verhältnis zum Preis unter den besten Modellen. Der Haken, der in allen Community-Threads wiederkehrt: Es ist eine bewusst untertrainierte F&E-Vorschau, kein fertiges Produktionsmodell. GLM 5.3 Flash ist der ausgereiftere Konkurrent, wenn Sie heute etwas Stabiles brauchen.
Wenn Sie hier sind, weil Sie günstige KI für den Kundensupport suchen: Die Modellwahl ist der leichte Teil. Ein reines Modell liest keine Tickets, schreibt keine Antworten und eskaliert nicht. Das ist Aufgabe einer Plattform, und genau das leistet eesel auf Modellen wie diesem.
Was Qwen 3.8 Flash Next eigentlich ist
Ich baue bei eesel KI-Agenten, das heißt, ich sehe die Modellebene alle paar Wochen durcheinanderwirbeln und habe gelernt, über Launch-Grafiken hinwegzulesen. Als das Qwen-Team also am 26. August 2026 Qwen 3.8 Flash Next veröffentlichte, habe ich zuerst den Namen entwirrt, denn er ist wirklich verwirrend.
Hier die klare Version. "Flash" ist Qwens günstige und schnelle Stufe. "Next" ist kein größeres oder neueres Flash. Es ist das Label, das Qwen einer Architekturvorschau gibt, dieselbe Rolle, die Qwen3-Next vor Qwen3.5 hatte. Flash Next existiert, damit die Community die neue Technik ausprobieren kann, bevor die komplette Qwen4-Familie darauf aufgebaut wird.
Die praktische Aufteilung ist wichtig, weil sie verändert, was Sie damit tun können:
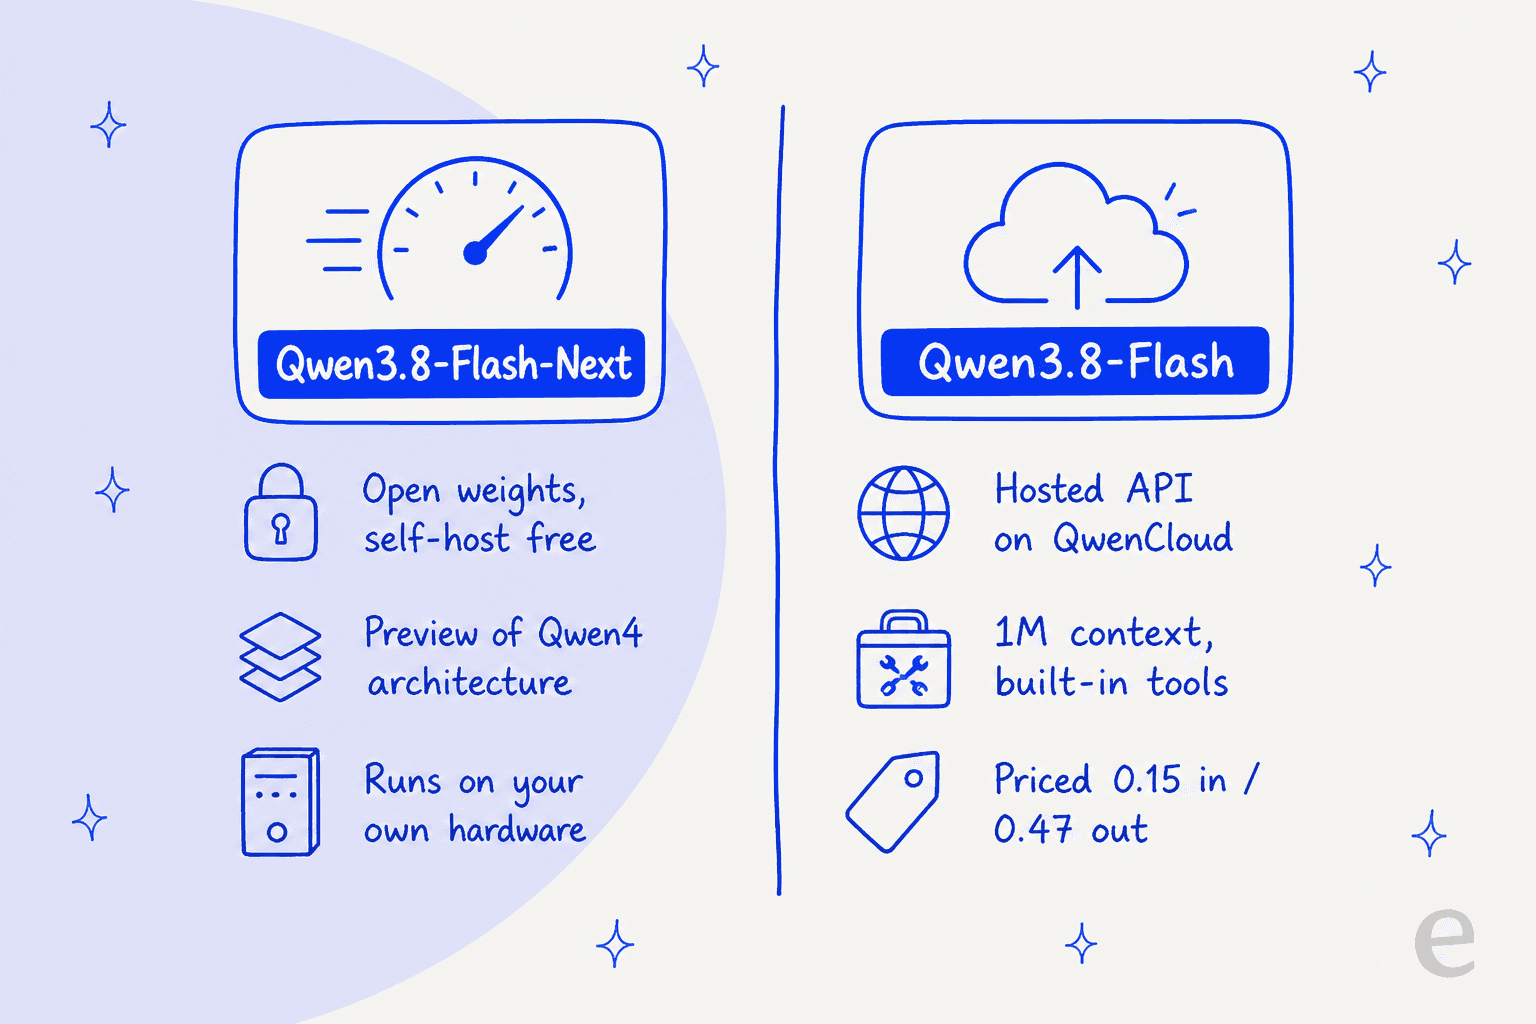
- Qwen3.8-Flash-Next ist die Open-Weight-Version auf Hugging Face und ModelScope unter der Qwen Community License 1.0. Sie laden es herunter und betreiben es selbst.
- Qwen3.8-Flash ist die Produktionsversion auf QwenCloud mit standardmäßig 1M Kontext und offiziellen integrierten Tools. Diese Version sprechen Sie über eine API an.
Das ist bereits eine echte Veränderung gegenüber Qwen 3.7 Flash, das geschlossen erschien, ohne Gewichte und ganz ohne Benchmarks. Diesmal bekommen Sie offene Gewichte und eine detaillierte Benchmark-Tabelle von Tag eins. Es ist ein multimodales Reasoning-Modell: Es nimmt Text, Bilder und Video entgegen, gibt Text aus, und der Denkmodus ist standardmäßig aktiv.
Die Architektur, die das "Next" verdient
Dieser Teil interessiert mich wirklich, denn die Architektur ist der Grund, warum der Preis so niedrig sein kann. Flash Next erweitert das Hybrid-Design von Qwen3-Next entlang von vier Achsen, und jede ist eine Wette darauf, Speicher gegen Rechenleistung zu tauschen.
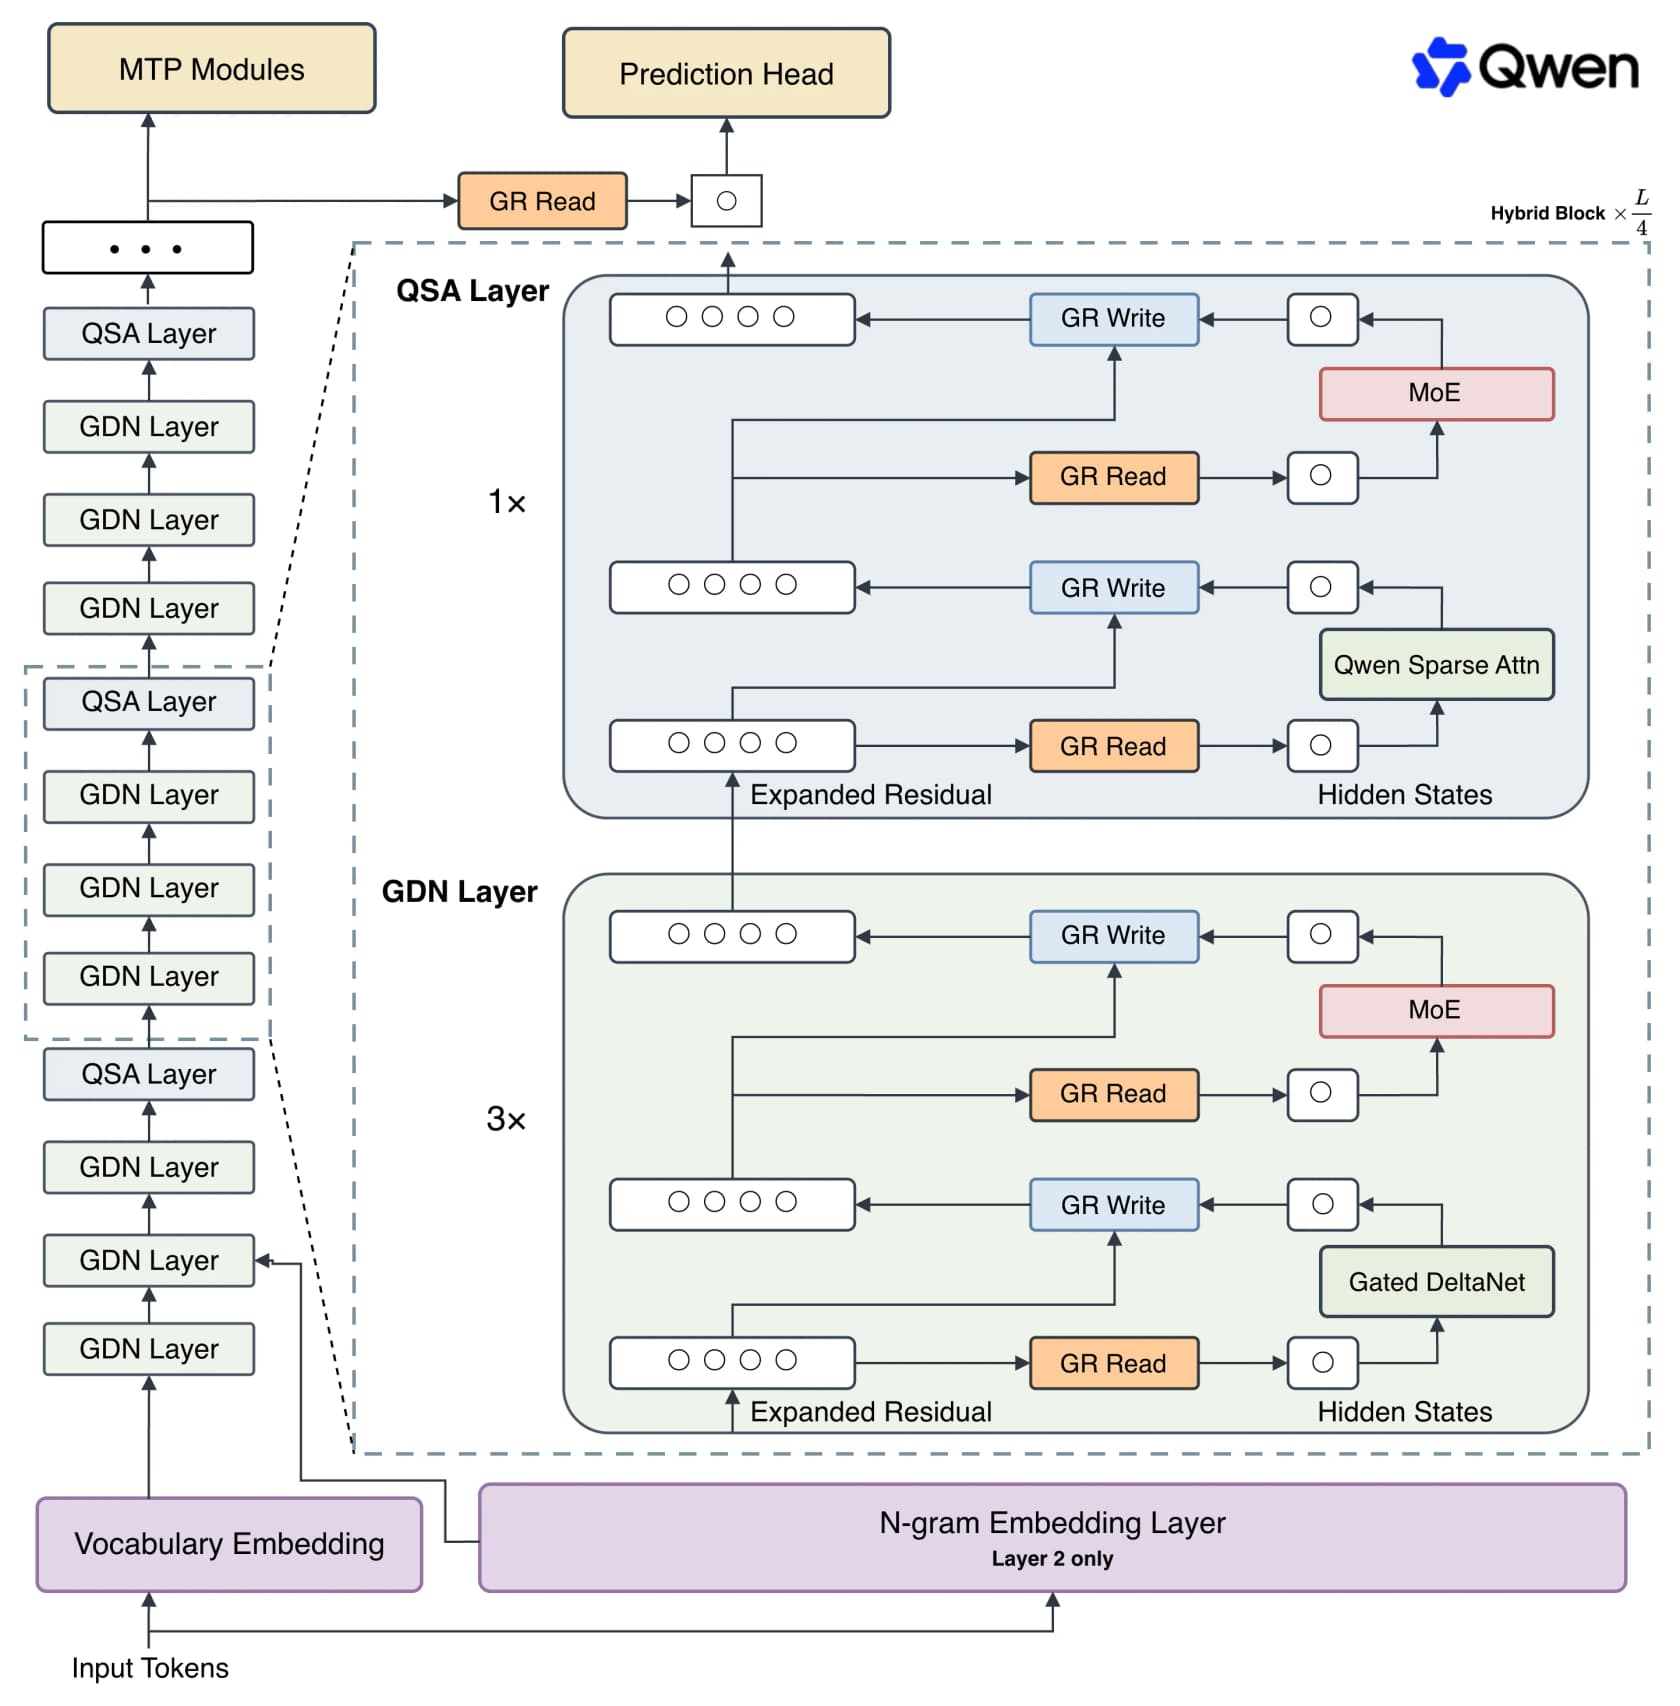
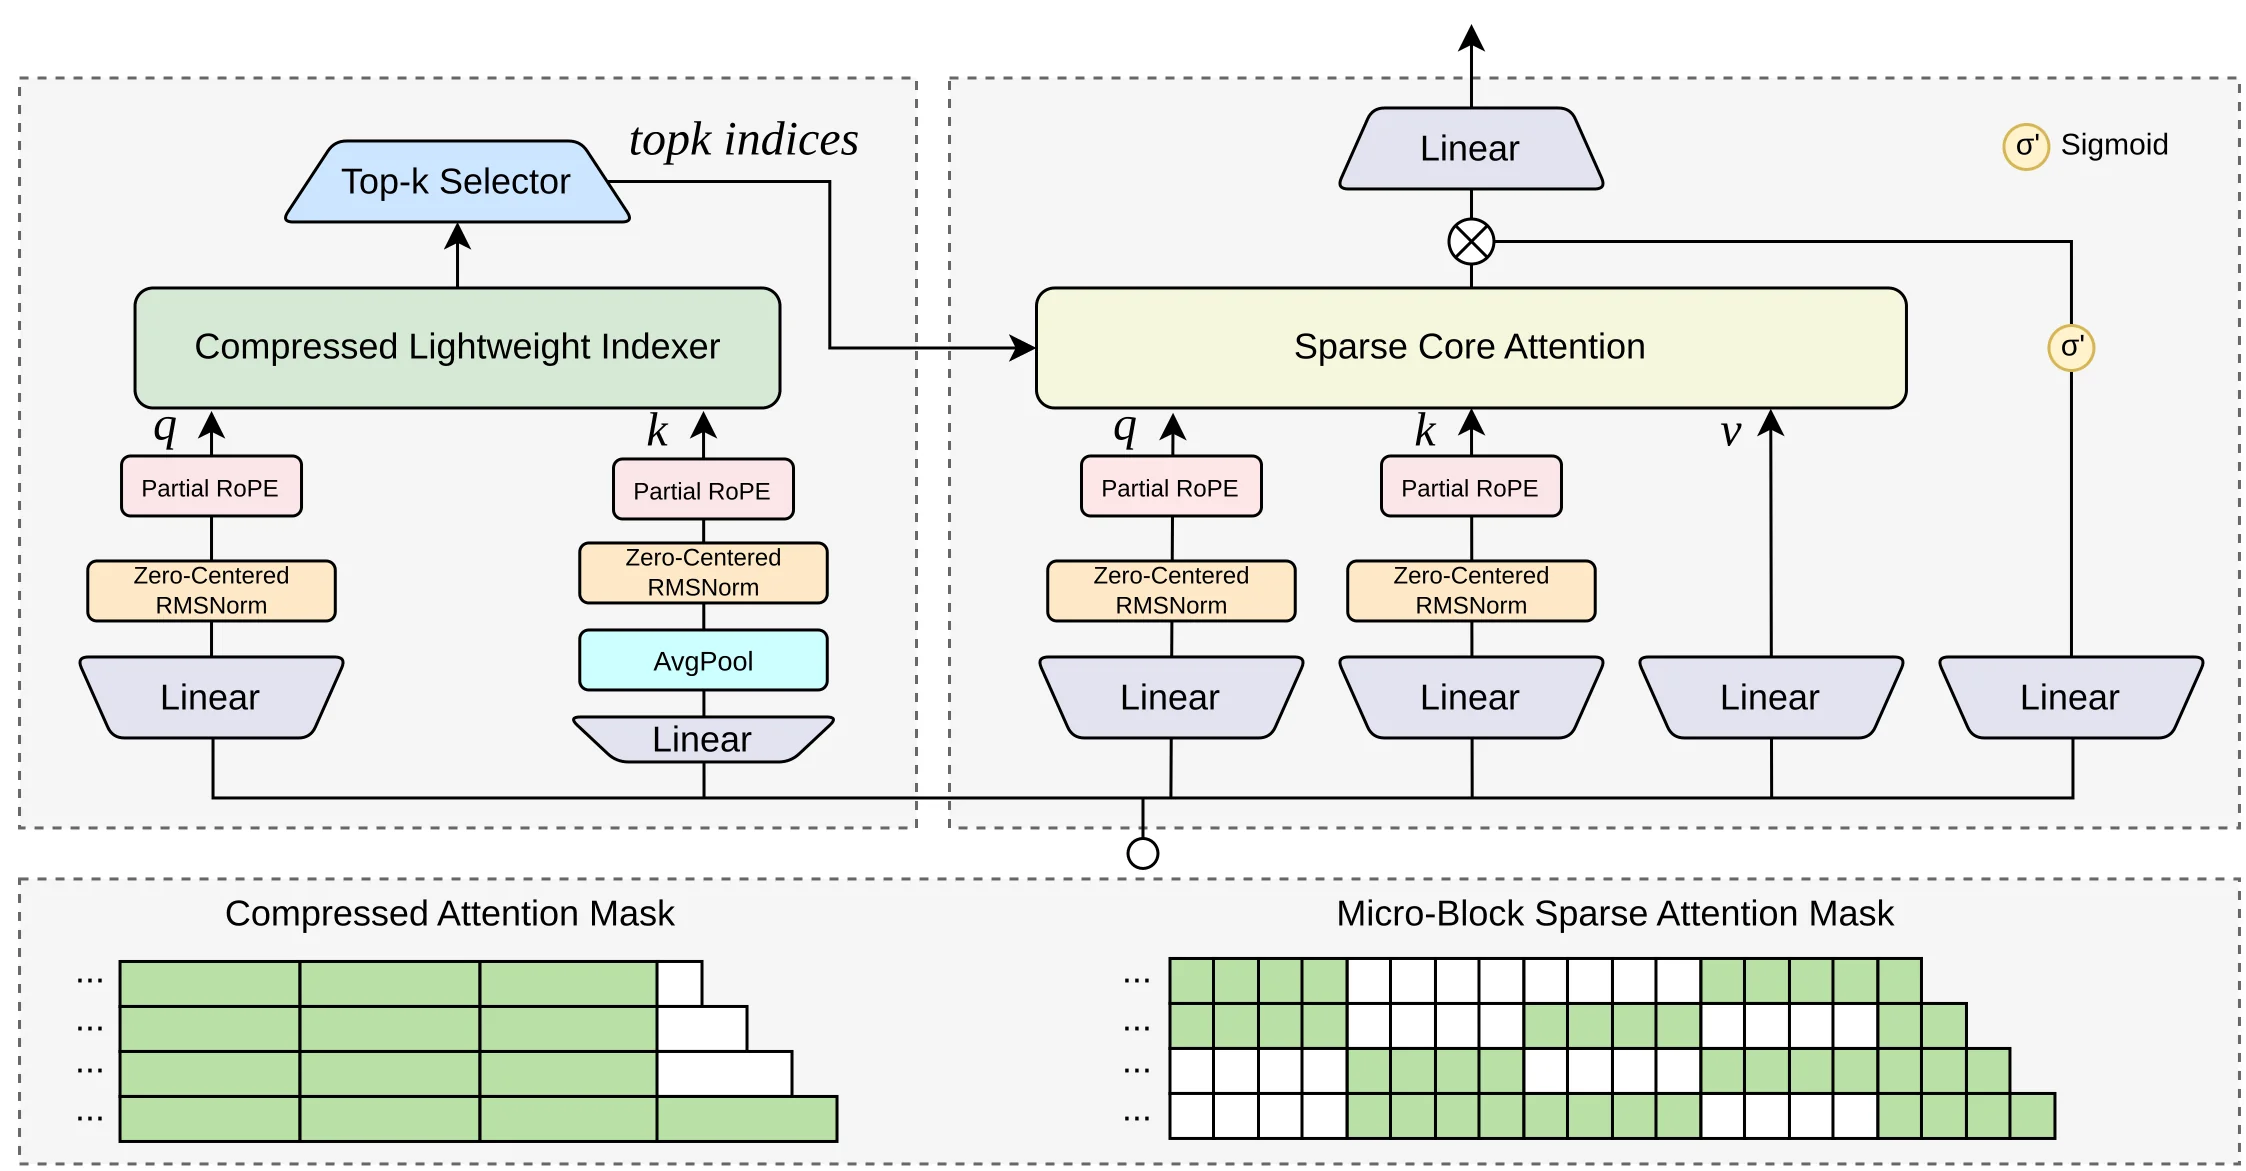
Attention: ein GDN-und-QSA-Hybrid. Drei von vier Schichten nutzen Gated DeltaNet, um den Verlauf in einen Zustand fester Größe zu komprimieren, was weit günstiger ist als einen vollständigen Key-Value-Cache zu speichern. Die vierte Schicht nutzt globale Attention, die aber durch Qwen Sparse Attention ersetzt wird, das wichtigen Kontext in Mikroblock-Granularität auswählt statt Token für Token.
Embedding: eine 51B-N-Gram-Tabelle. Das ist der clevere Teil. Qwen fügt 51 Milliarden Parameter kontextbasierter Bigram- und Trigram-Lookups hinzu, die in den Host-Speicher ausgelagert und asynchron vorab geladen werden können. Sie erhalten einen enormen Kapazitätsschub mit kaum zusätzlicher Rechenleistung pro Token, weshalb Leute ein "180B-ähnliches" Modell auf Rechnern mit bescheidenen GPUs betreiben.
Die anderen beiden Achsen sind ein Gated-Residual-Stream, der das Residual in vier parallele Zweige mit FP8-Speicherung aufweitet, und der Wechsel zum Muon-Optimizer für die 2D-Linearabbildungen. Laut Qwen senkte die Kombination die Trainingskosten auf etwa ein Neuntel von Qwen3.7-Plus und schlug es bei Coding- und Büroaufgaben.
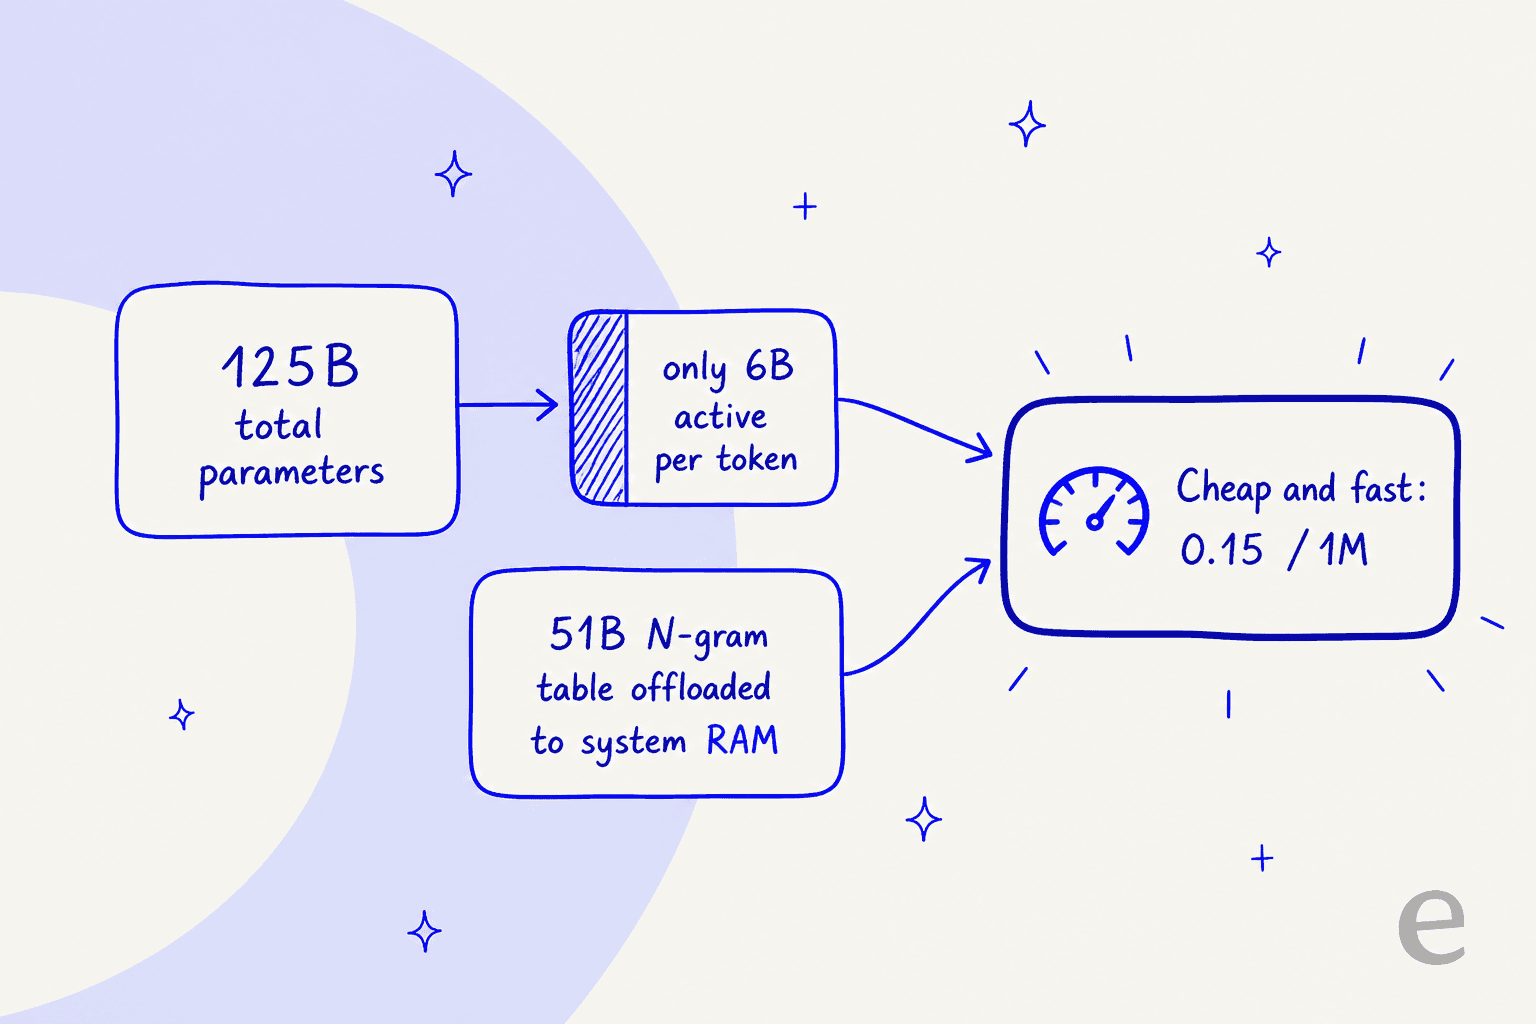
Zusammengenommen ergeben die Spezifikationen ein klares Bild: 125B Hauptparameter, 6B aktiviert pro Token, dazu das 51B-N-Gram-Embedding und ein 4B-Multi-Token-Prediction-Kopf (Artificial Analysis rundet die Gesamtzahl auf 180B). Es nutzt 512 Experten mit 10 gerouteten plus 1 geteilten aktiven, einen nativen Kontext von 262.144 Tokens, per YaRN auf 1M erweiterbar. Ein ehrlicher Vorbehalt: Die Kontextangabe ist je nach Quelle uneinheitlich. Die Modellkarte nennt 262K nativ, QwenCloud läuft standardmäßig mit 1M, und Artificial Analysis listet 256K. Lesen Sie es als "sehr lang, die genaue Obergrenze hängt davon ab, wo Sie es betreiben."
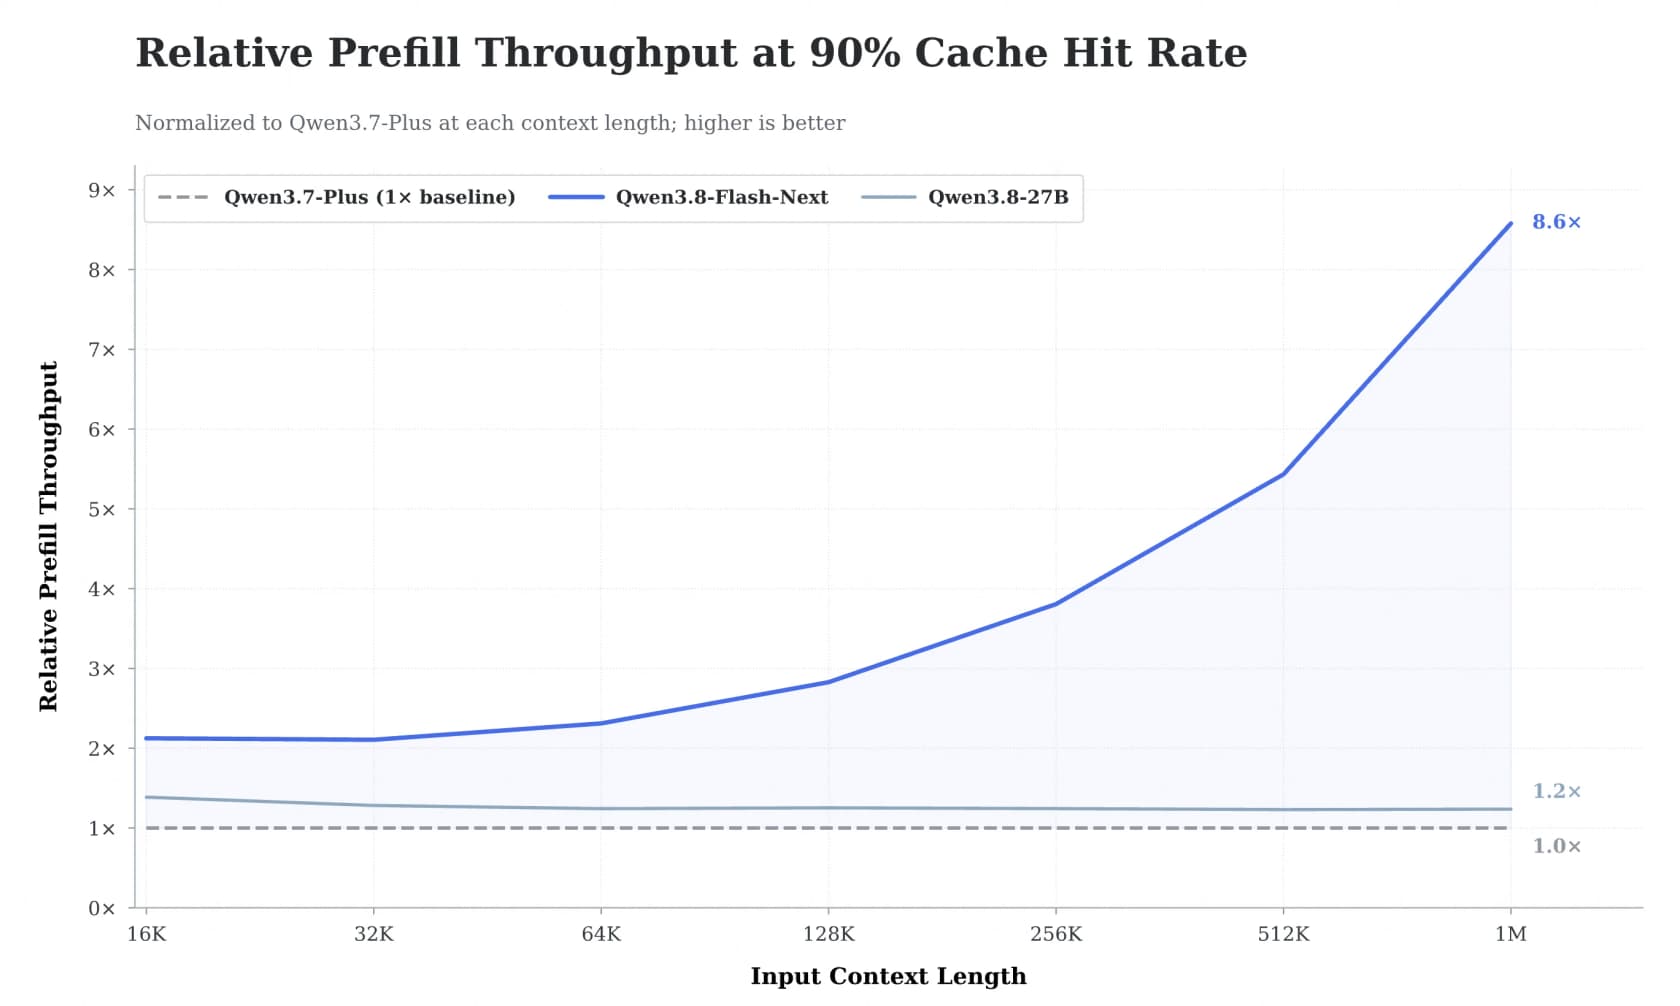
Der Effizienzgewinn zeigt sich am stärksten bei langem Kontext. Qwen berichtet, dass der QSA-Kernel bei 1M Tokens bis zu 7,6x Prefill- und 4,9x Decode-Beschleunigung erreicht und bei 1M mit 90 % Cache-Trefferquote den 8,6-fachen Prefill-Durchsatz von Qwen3.7-Plus.
Was Qwen 3.8 Flash Next tatsächlich kann
Benchmarks gibt es hier in zwei Varianten, und der Unterschied ist wichtig. Da ist Qwens eigene Tabelle, die beeindruckend, aber vom Hersteller berichtet ist, und es gibt einen wirklich unabhängigen Anker.
Beginnen wir mit dem unabhängigen. Artificial Analysis bewertet Flash Next mit 56 auf dem Intelligence Index und Platz 5 von 111 in seiner Klasse, bei einem Median von 29. Es schafft 77 Output-Tokens pro Sekunde und kostet etwa $0.10 pro Index-Aufgabe. Ihr Fazit in einem Satz: Es gehört "zu den führenden Modellen bei der Intelligenz und ist angemessen bepreist", ist aber "sehr wortreich" und verbraucht 200M Output-Tokens, um den Index abzuschließen, gegenüber einem Median von 110M. Merken Sie sich den Punkt mit der Wortreichheit, denn er bläht still die echten Rechnungen auf.
Qwens eigene Zahlen, die Sie als "Qwen berichtet" und nicht als neutrale Tatsache lesen sollten, setzen es in den meisten Zeilen vor seine Geschwistermodelle:
| Benchmark | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | - | 77.5 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| IFBench (Befolgen von Anweisungen) | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (lange Büroaufgaben) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
Quelle: Qwens Benchmark-Tabellen. Zwei Dinge fallen auf. Es ist bei Coding und agentischen Aufgaben wirklich stark und übertrifft auf SWE-bench Pro deutlich größere Modelle. Und es ist kein Klassensieg auf ganzer Linie: Claude Opus 4.6 gewinnt weiterhin Humanity's Last Exam, und DeepSeek V4 Flash schlägt es bei der Generierung auf Repository-Ebene. Im Bildbereich berichtet Qwen 84,5 bei AndroidWorld und 88,5 bei RealWorldQA, beides führend im Vergleichsfeld.
Preise von Qwen 3.8 Flash Next
Die offenen Gewichte sind kostenlos. Wenn Sie die Hardware haben, zahlen Sie nur für Rechenleistung, und genau das ist der ganze Reiz für die Self-Hosting-Szene.
Für die gehostete Qwen3.8-Flash-API ist der Preis pauschal, ohne Kontextlängenstufen, wie sie Qwen 3.7 Flash hatte:
| Position | Preis (USD / 1M Tokens) |
|---|---|
| Input | $0.15 |
| Output | $0.47 |
| Input, gecachter Lesezugriff | $0.016 |
| Explizite Cache-Erstellung | $0.20 |
| Expliziter Cache-Lesezugriff | $0.016 |
Dieser Cache-Lesezugriff ist rund 89 % günstiger als frischer Input, und das ist nicht theoretisch: OpenRouter beobachtete im Live-Traffic eine Cache-Trefferquote von 91,1 %, was den effektiven Input-Preis auf etwa $0.028 pro Million drückt. Was Sie bei repetitiven, cachefreundlichen Workloads tatsächlich zahlen, liegt also deutlich unter dem Listenpreis.
Ein Sternchen zur Schlagzeile "günstig". Weil das Modell sehr wortreich ist, zahlen output-lastige Workloads mehr, als der niedrige Preis pro Token vermuten lässt, da all diese Denk-Tokens berechnet werden. Bei einer gesprächigen Support-Antwort ist das eine Randnotiz, bei langen agentischen Läufen summiert es sich. Wenn Sie es preislich mit DeepSeek V4 Flash oder Kimi K3 vergleichen, rechnen Sie die Output-Tokens durch, nicht nur den Input-Preis.
Außerdem gibt es vorerst nur einen API-Anbieter: Alibaba Cloud International. OpenRouter leitet direkt dorthin weiter, es gibt also noch kein Multi-Provider-Routing und kein Failover.
Was die Leute tatsächlich sagen
Die Reaktion der Community ist laut, und sie ist fast ausschließlich eine Geschichte über lokale Inferenz, nicht über API oder Unternehmen. Der Launch-Thread auf Hacker News erreichte 698 Punkte, und r/LocalLLaMA führte einen Release-Megathread mit über 650 Kommentaren. Die Leute sind besessen davon, es auf eigenen Rechnern laufen zu lassen.
Die Tooling-Szene gab den Ton an. Unsloth brachte es schnell zum Laufen und machte eine große Behauptung:
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
Die Aussage "übertrifft Opus 4.6" stammt von ihnen und ist nicht unabhängig gebenchmarkt, nehmen Sie sie also als Begeisterung, nicht als Fakt. Die geerdeteren Stimmen ergänzten den Vorbehalt, der immer wieder auftaucht. Hier die klarste Erklärung, was "Next" wirklich bedeutet, aus dem HN-Thread:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Und der praktische Haken von Simon Willison, der es auf einem DGX Spark mit mehreren Reasoning-Stufen ausprobierte und am Ende das kleinere dichte Modell bevorzugte, was er auf die Low-Bit-Quantisierung zurückführte, die nötig ist, damit es passt. Das ist das wiederkehrende Thema: Die Architektur ist spannend, aber dieser konkrete Checkpoint ist eine Vorschau, und das Zwängen auf Consumer-Hardware kostet Qualität. Wenn Sie in dieser Gewichtsklasse heute die Option wollen, die sich fertig anfühlt, verweisen viele Threads stattdessen auf GLM 5.3 Flash.
Also, sollten Sie es nutzen?
So sehe ich es nach einer Woche, in der ich das Ganze beobachtet habe.
Greifen Sie zu, wenn Sie Tüftler für lokale Inferenz sind, mit einem Unified-Memory-Rechner oder einer freien GPU, einen frühen Blick auf die Qwen4-Architektur wollen oder einen cachefreundlichen, coding-lastigen Workload haben, bei dem sich der niedrige gehostete Preis und die starken SWE-bench-Werte auszahlen. Das Sparse-Activation-Design lässt es wirklich über seinen Hardware-Fußabdruck hinauswachsen.
Warten Sie ab, wenn Sie jetzt ein stabiles, produktionsreifes Modell brauchen. Es ist nach Qwens eigener Aussage eine untertrainierte Vorschau, Quantisierung schadet, und die gehostete Qwen3.8-Flash-API hat nur einen einzigen Anbieter. Für geschäftskritische Aufgaben ist ein ausgereifteres Modell, sei es GLM 5.3 Flash, eine Claude Opus 5-Stufe oder Qwen 3.8 Max, die sicherere Wahl, bis die komplette Qwen4-Reihe erscheint.
So oder so, der wichtigere Punkt ist, was ein Modell eigentlich ist: eine Komponente. Das führt mich zu dem, was ich Teams, die nach "günstiger KI" suchen, immer wieder erklären muss.
Wo ein solches Modell in die echte Support-Arbeit passt
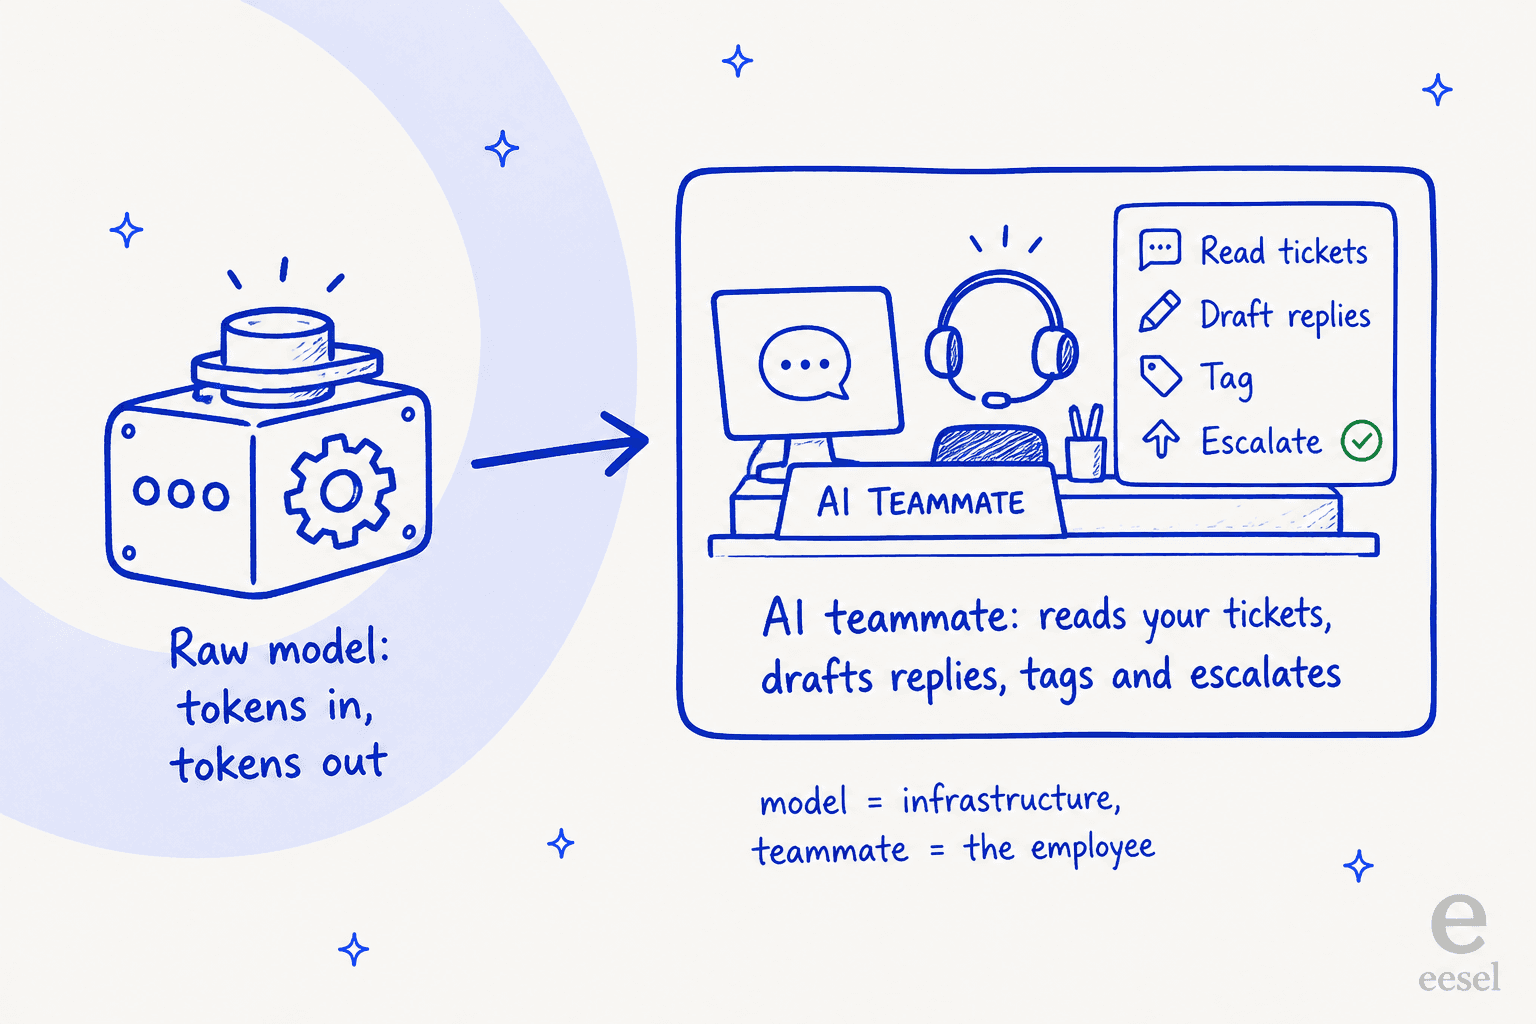
Viele lesen eine Ankündigung wie diese und denken: "Super, ich richte meinen Support-Posteingang auf Qwen 3.8 Flash Next aus und senke meine KI-Rechnung." Das ist ein Kategorienfehler. Ein reines Modell nimmt Tokens entgegen und gibt Tokens aus. Es kennt Ihre Erstattungsrichtlinie nicht, kann die Bestellhistorie eines Kunden nicht lesen, entwirft keine Antwort in Ihrem Helpdesk und weiß nicht, ob seine selbstsichere Antwort tatsächlich stimmt. Das Modell ist Infrastruktur; was die Arbeit erledigt, ist der Mitarbeiter.
Diese Mitarbeiter-Schicht bauen wir bei eesel. Unser Leitbild ist einfach: eesel ist eine Plattform für KI-Teammitglieder, und Sie stellen einsatzbereite Teammitglieder für bestimmte Aufgaben ein, derzeit ein KI-Helpdesk-Teammitglied und einen KI-Blog-Autor. Jedes kommt mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für seine Rolle, sodass die Frage, welches Modell darunter läuft, zum Implementierungsdetail wird und nicht Ihr Problem ist.

Den Teil, den ich am nachdrücklichsten hervorheben würde, weil ich gesehen habe, wie er Leute verbrannt hat, ist das Testen. Wir alle haben schon einen selbstsicher klingenden Bot gesehen, der still eine falsche Antwort gibt. Deshalb simuliert das eesel-Helpdesk-Teammitglied jeden Rollout anhand Ihrer historischen Tickets, bevor es je einen Live-Kunden berührt. Sie sehen die Lösungsquote und die genauen Antworten, die es in echten vergangenen Gesprächen gesendet hätte, und entscheiden dann, was Sie automatisieren. Ein brandneues, untertrainiertes Modell ist genau das, was Sie durch dieses Tor schicken wollen, statt einer Benchmark-Tabelle zu vertrauen. Und weil eesel sich in Ihren bestehenden Helpdesk einklinkt und aus Ihrer Wissensdatenbank und vergangenen Tickets liest, ist das Kontextproblem gelöst, das ein reines Modell allein nie lösen kann.
Die Kurzfassung: Modelle wie Qwen 3.8 Flash Next werden schnell günstig und leistungsfähig, was großartig ist, aber eines auszuwählen sind die leichten 10 % der Arbeit. Die anderen 90 % bestehen darin, daraus ein Teammitglied zu machen, das Tickets wirklich löst, und diese Schicht ist es wert, Ihre Zeit zu investieren.