

Kurzfassung
Qwen 3.8 Flash Next ist die Open-Weight-Vorabversion des Qwen-Teams für seine nächste Generation, die Qwen4-Architektur. Nach einer Woche im Einsatz lautet mein Fazit: Es ist eines der besten Modelle für Intelligenz pro Dollar, die man derzeit bekommen kann, und es ist zugleich eine Forschungsvorschau, die Qwen absichtlich untertrainiert hat. Beides stimmt gleichzeitig.
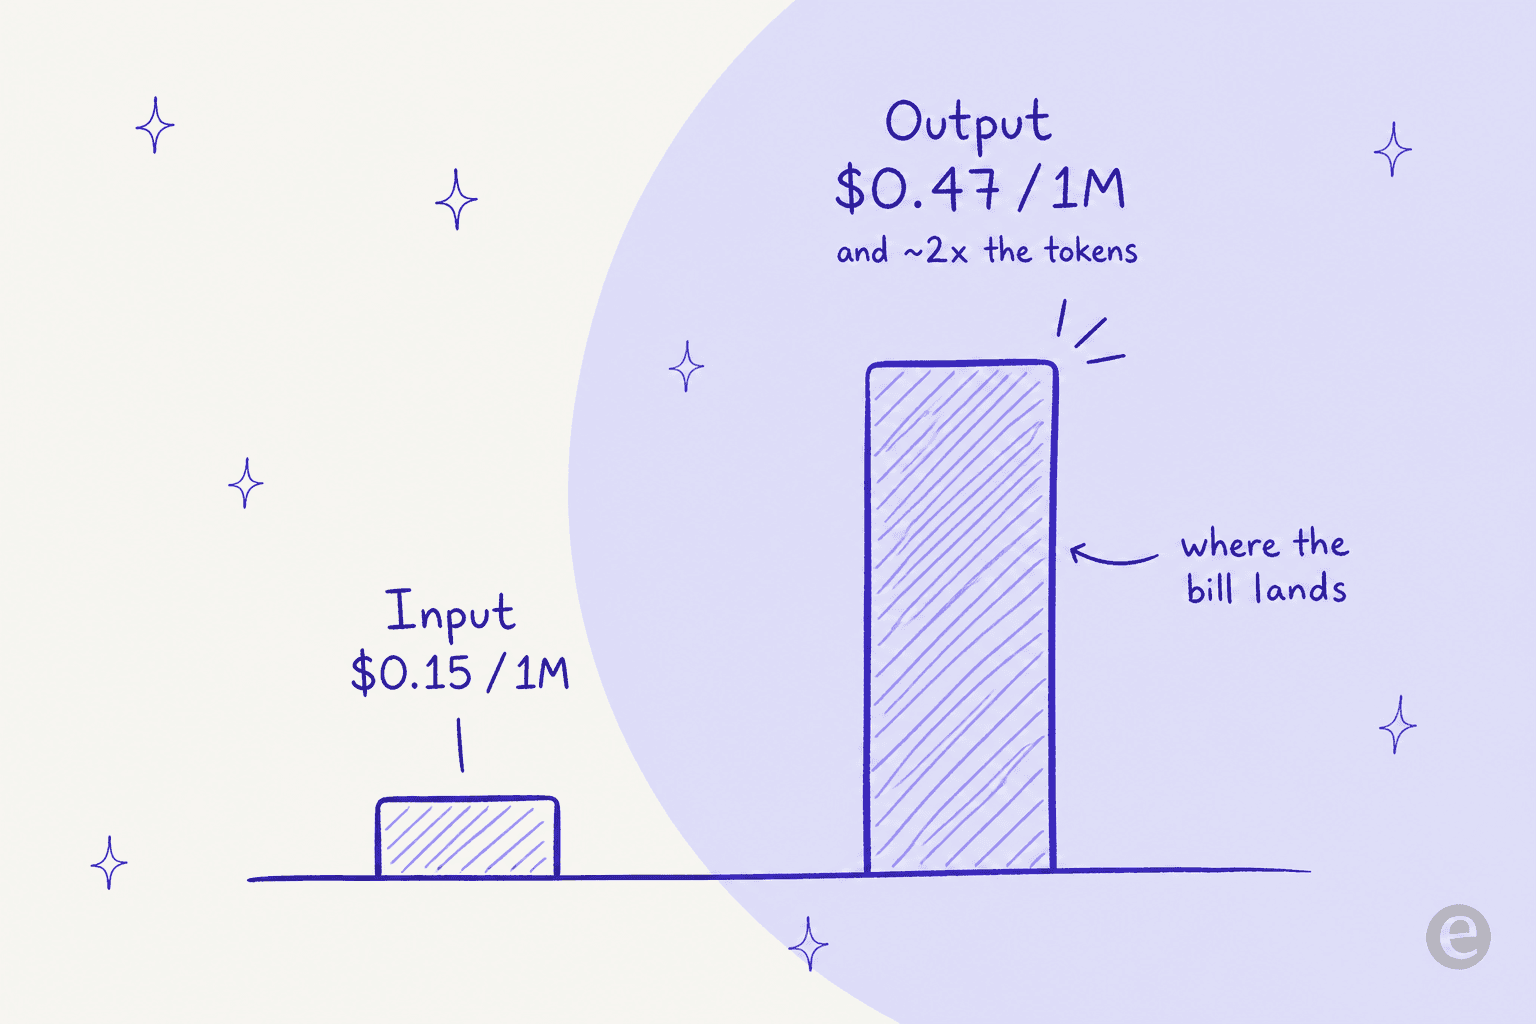
Was es gut kann, ist real. Es ist ein 125B-Mixture-of-Experts-Modell, das pro Token nur 6B Parameter aktiviert. Dadurch läuft es schnell auf Hardware, die ein dichtes Modell dieser Größe nie fassen könnte, und die gehostete Version kostet nur $0.15 Input / $0.47 Output pro Million Tokens. Artificial Analysis sieht es in seiner Klasse bei der Intelligenz auf Platz 5 von 111.
Die Haken sind genauso real. Qwen sagt selbst, es sei absichtlich untertrainiert, die niedrige Bit-Quantisierung für den lokalen Betrieb kostet sichtbar Qualität, und das Modell ist sehr ausführlich, was die Output-Token-Rechnung still aufbläht. Wenn Sie heute ein fertiges Modell dieser Gewichtsklasse wollen, ist GLM 5.3 Flash die sicherere Wahl.
Und wenn Sie hier sind, weil Sie günstige KI für den Kundensupport suchen: Das Modell ist der leichte Teil. Ein rohes Modell liest Ihre Tickets nicht und verfasst keine Antworten. Das ist die Aufgabe einer Plattform, und genau die übernimmt eesel auf Basis von Modellen wie diesem.
Was ich eigentlich getestet habe
Ich baue bei eesel KI-Agenten, daher ist ein Modellstart für mich ein Arbeitsproblem und kein Zuschauersport: Die Frage lautet immer, ob ich es vor eine echte Arbeitslast stellen würde. Als das Qwen-Team Qwen 3.8 Flash Next am 26. August 2026 veröffentlichte, ging die erste Stunde dafür drauf, den Namen zu entwirren, denn er sorgt für Verwirrung.
Hier die saubere Version. Qwen3.8-Flash-Next ist die Open-Weight-Vorabversion zum Selbsthosten; Qwen3.8-Flash ist die kommende gehostete API mit 1M Kontext und integrierten Tools. „Next" ist kein größeres Flash. Es ist das Label, das Qwen auf eine Architektur-Vorschau setzt, die veröffentlicht wurde, damit die Community die neue Technik ausprobieren kann, bevor die komplette Qwen4-Familie darauf aufgebaut wird. Jedes Urteil unten hängt an diesem einen Wort.
Diese Einordnung ist wichtig, denn „untertrainierte Vorabversion" ist keine Kritik, die ich erfunden habe. Es ist Qwens eigene Beschreibung, die überall in der Community wiederholt wurde. Die klarste Erklärung kam aus dem Hacker-News-Launch-Thread:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Fair bewertet man es also nicht mit „Ist das das beste Modell?", sondern mit „Zahlt sich die Architekturwette aus, und lohnt sich dieser konkrete Checkpoint?". Andere Fragen, andere Antworten.
Was wirklich gut ist
Die Schlagzeilenzahl hält einer unabhängigen Prüfung stand, was seltener ist, als es sein sollte. Artificial Analysis bewertet Flash Next mit 56 im Intelligence Index und Platz 5 von 111 in seiner Klasse, bei einem Median von 29. Ihr Urteil: „amongst the leading models in intelligence and reasonably priced". Bei etwa $0.10 pro Index-Aufgabe ist das Preis-Leistungs-Versprechen kein Hype.
In Qwens eigener Benchmark-Tabelle, die Sie als Herstellerangabe lesen sollten, ist es besonders stark bei Coding und agentischen Aufgaben:
| Benchmark | Qwen3.8-Flash-Next | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 55.8 | 56.0 | 53.4 |
| LiveCodeBench v6 | 91.9 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 90.3 | 90.8 | 91.3 |
| IFBench (Befolgen von Anweisungen) | 81.3 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (lange Büroaufgaben) | 73.9 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 34.7 | 33.8 | 40.0 |
Quelle: Qwens Benchmark-Tabellen. Zwei ehrliche Lesarten. Bei SWE-bench Pro schlägt es deutlich größere Modelle, ein echtes Ergebnis für diese Größe. Und es ist kein Klarsieg: Claude Opus 4.6 holt Humanity's Last Exam, und DeepSeek V4 Flash schlägt es bei der Generierung auf Repository-Ebene.
Die zweite echte Stärke ist die Hardware-Effizienz, und genau die interessiert die Community am meisten. Weil pro Token nur 6B Parameter aktiv sind und die 51B große N-Gram-Nachschlagetabelle in den normalen Arbeitsspeicher ausgelagert werden kann, laufen Modelle der ~180B-Klasse auf bescheidenen Rechnern. Die Tooling-Szene gab schnell den Ton an:
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
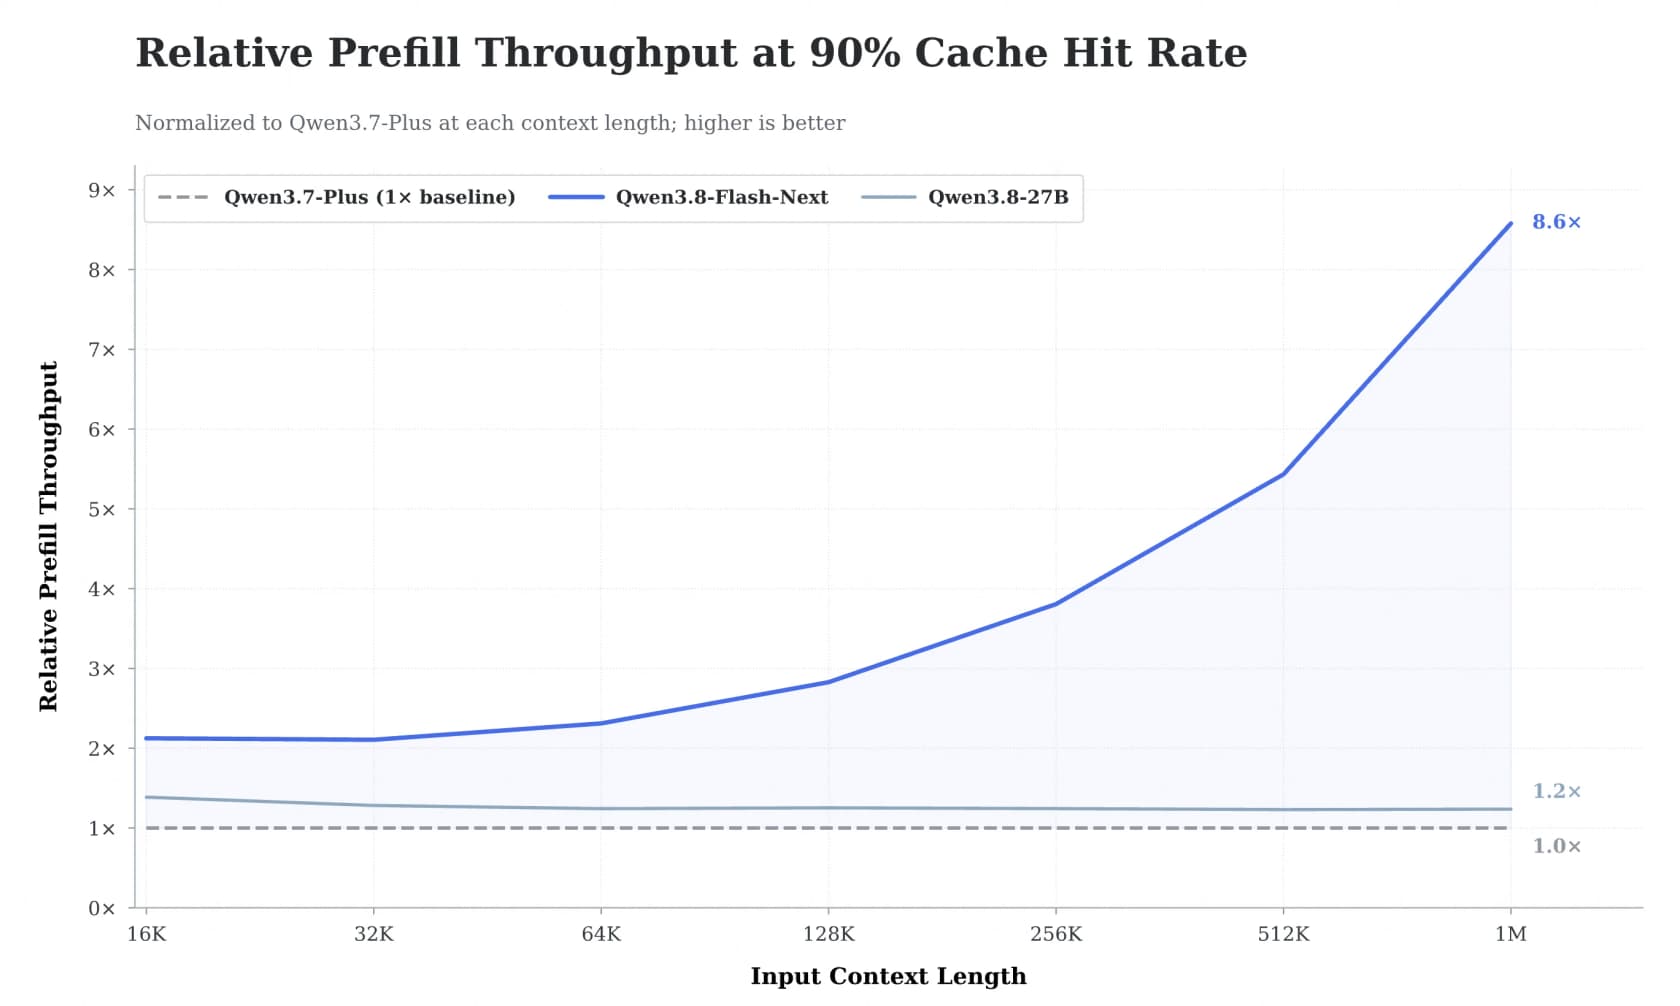
Die Aussage „übertrifft Opus 4.6" ist Begeisterung und kein belegter Fakt, denn sie stammt von ihnen und ist ungeprüft. Aber die Aussage zu hohen Geschwindigkeiten auf günstiger Hardware ist real und wird vielfach wiederholt. Bei langem Kontext ist der Gewinn am größten: Qwen berichtet, dass sein Sparse-Attention-Kernel bei 1M Tokens bis zu 7.6x schnelleres Prefill und 4.9x schnelleres Decode erreicht.
Wo die Vorabversion Schwächen zeigt
Jetzt die Punkte, die es aus einem Produktionseinsatz heraushalten.
Quantisierung schadet, sichtbar. Um ein Modell der ~180B-Klasse auf Consumer-Hardware unterzubringen, muss man stark quantisieren, und der Qualitätsverlust ist nicht subtil. Simon Willison ließ es auf einem DGX Spark mit mehreren Reasoning-Stufen laufen und blieb am Ende lieber beim kleineren dichten Modell:
"I ran some pelicans at the four different reasoning levels... Surprised I didn't get one I liked as much as the Qwen 3.8 27B one, maybe because of quantization."
Das ist das wiederkehrende Thema in jedem lokalen Thread, den ich gelesen habe. Die Architektur erlaubt es, das Modell günstig auszuführen; sie verspricht nicht, dass der auf Ihren Rechner gequetschte Checkpoint der Benchmark-Tabelle entspricht.
Es denkt zu viel. Wie die meisten Qwen-Reasoning-Modelle ist Flash Next ein intensiver Denker, und das sieht man in den Traces.
"It's definitely a heavy thinker, like most Qwens. I see strings like 'write, now.' in the thinking traces then it goes on to think for a lot longer, so it's kind of weird."
Das führt zur schärfsten praktischen Warnung des ganzen Tests.
Die Kostenfalle durch ausführliche Ausgaben. Artificial Analysis hat es als „very verbose" markiert: 200M Output-Tokens, um den Index abzuschließen, gegenüber einem Median von 110M. Das ist fast das Doppelte. Bei der gehosteten API wird die Ausgabe mit $0.47 pro Million berechnet, daher versteckt die günstige Input-Schlagzeile eine echte Output-Rechnung bei langen agentischen Läufen. Bei einer kurzen Support-Antwort ist das ein Rundungsfehler; bei einer mehrstufigen Agentenschleife entscheidet genau diese Zahl über Ihre Kosten. Rechnen Sie die Output-Tokens durch, bevor Sie dem Listenpreis trauen.
Was es tatsächlich kostet
Die offenen Gewichte sind kostenlos. Wenn Sie die Hardware haben, zahlen Sie nur Rechenleistung und sonst nichts, und das ist der ganze Reiz für die Selbsthosting-Fraktion.
Für die gehostete Qwen3.8-Flash-API ist der Preis pauschal, ohne Kontextlängen-Stufen wie bei Qwen 3.7 Flash:
| Posten | Preis (USD / 1M Tokens) |
|---|---|
| Input | $0.15 |
| Output | $0.47 |
| Input, gecachter Lesezugriff | $0.016 |
| Explizite Cache-Erstellung | $0.20 |
Der gecachte Lesezugriff ist etwa 89 % günstiger als frischer Input, und das ist nicht theoretisch: OpenRouter beobachtete im Live-Traffic eine Cache-Trefferquote von 91.1 %, was den effektiven Input-Preis auf etwa $0.028 pro Million drückt. Ein weiteres Sternchen neben der Ausführlichkeit: Derzeit gibt es nur einen API-Anbieter, Alibaba Cloud International, also noch keinen Failover über mehrere Anbieter. Wägen Sie das gegen Kimi K3 oder Qwen 3.8 Max ab, wenn Ausfallsicherheit wichtiger ist als der letzte Cent.
Sollten Sie es einsetzen?
So sehe ich es nach einer Woche. Gehen Sie die beiden Fragen unten durch, dann sortiert sich alles von selbst.
Ich möchte Modelle auf meiner eigenen Hardware betreiben
Klares Ja. Ein Mac mit Unified Memory, ein DGX Spark oder ein Rechner mit viel Arbeitsspeicher ist genau das Setup, das dieses Design belohnt. Rechnen Sie mit Geschwindigkeiten nahe an VRAM und mit etwas Qualitätsverlust durch Quantisierung. Wählen Sie Ihre Flags für das Reasoning-Budget, um das Übernachdenken zu zähmen.
Ich möchte eine günstige, codelastige gehostete API
Ja, mit offenen Augen. Die SWE-bench-Zahlen sind real und der Preis für gecachten Input ist hervorragend. Rechnen Sie zuerst die Output-Tokens durch, denn dort landet die Rechnung, und denken Sie daran, dass es heute nur einen Anbieter gibt.
Ich brauche jetzt ein stabiles Modell für die Produktion
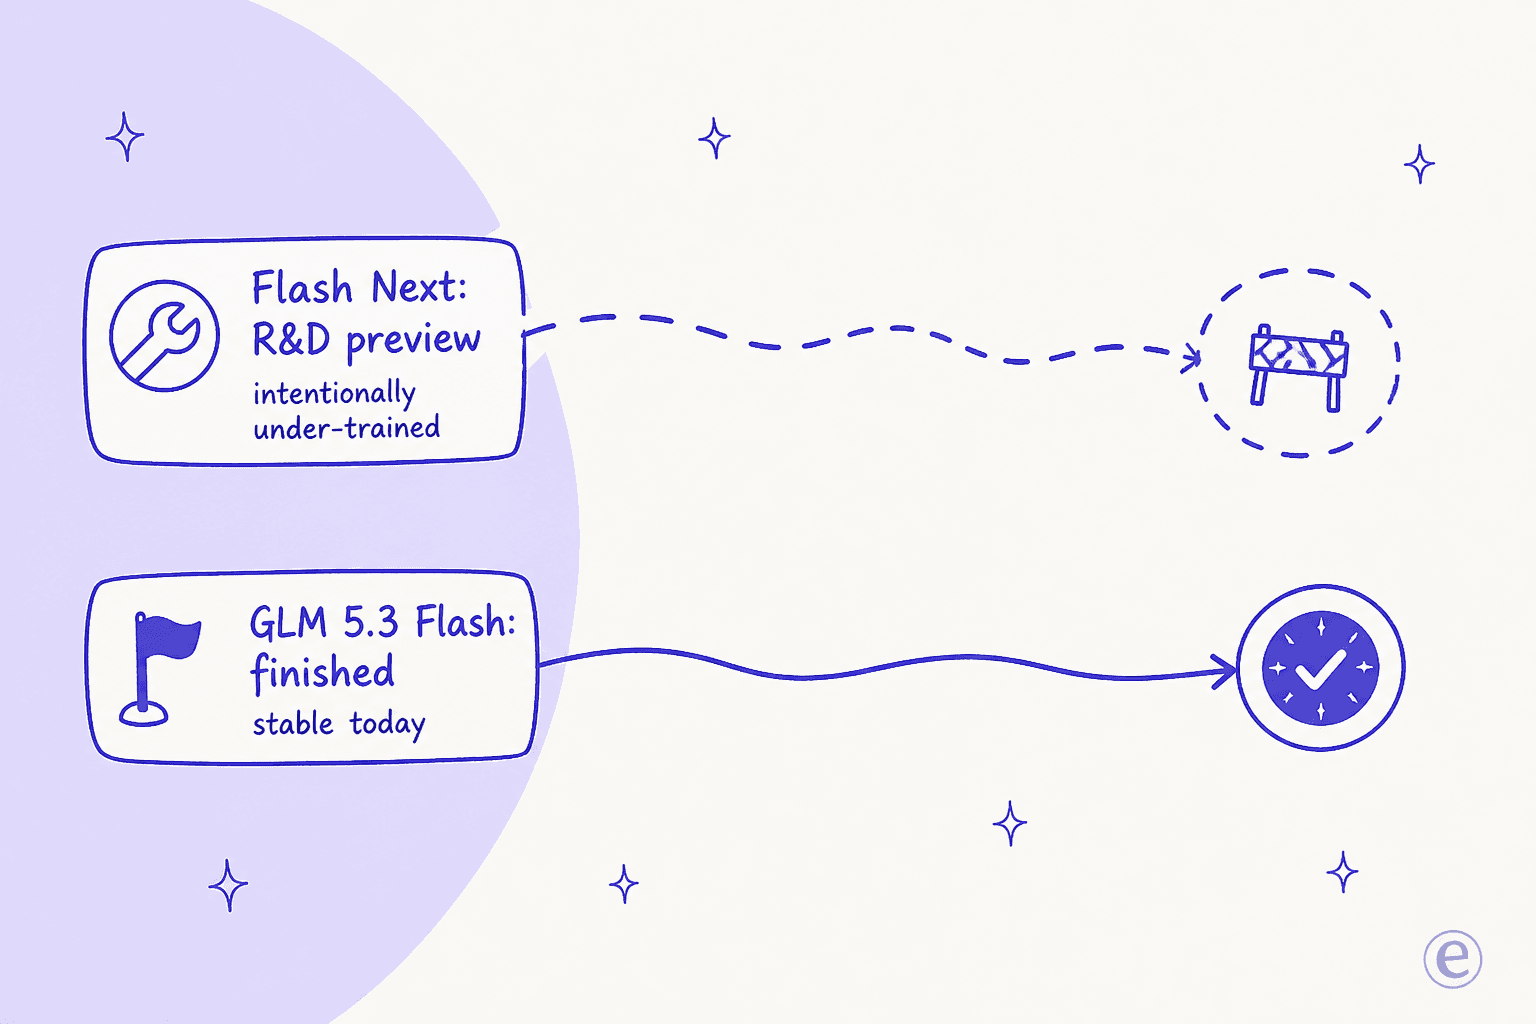
Warten Sie ab. Qwen nennt es eine untertrainierte Vorabversion, und es verhält sich auch so. Greifen Sie zu GLM 5.3 Flash, einem Claude Opus 5-Modell oder Qwen 3.8 Max, bis die vollständige Qwen4-Reihe erscheint.
Greifen Sie zu, wenn Sie ein Tüftler für lokale Inferenz sind, einen frühen Blick auf die Qwen4-Architektur wollen oder einen cachefreundlichen Coding-Workload haben, bei dem sich der niedrige Preis und die starken SWE-bench-Zahlen auszahlen. Warten Sie ab, wenn Sie heute ein produktionsreifes Modell brauchen, denn es ist nach Qwens eigener Aussage eine untertrainierte Vorabversion, Quantisierung schadet, und die gehostete API hat nur einen Anbieter.
So oder so ist der nützlichere Punkt, was ein Modell eigentlich ist: eine Komponente. Das muss ich Teams, die nach „günstiger KI" suchen, immer wieder erklären.
Wo ein Modell wie dieses in der echten Support-Arbeit hineinpasst
Viele lesen einen solchen Launch und denken: „Super, ich richte mein Support-Postfach auf Qwen 3.8 Flash Next aus und senke meine KI-Rechnung." Das ist ein Kategorienfehler. Ein rohes Modell nimmt Tokens entgegen und gibt Tokens aus. Es kennt Ihre Erstattungsrichtlinie nicht, kann die Bestellhistorie eines Kunden nicht lesen und weiß nicht, ob seine selbstsichere Antwort tatsächlich stimmt. Das Modell ist Infrastruktur; was die Arbeit erledigt, ist der Mitarbeiter.
Ich habe erlebt, wie diese Lücke auf die schlimmste Weise zuschlägt. Zu Beginn bei einem Kunden sagte der Bot Käufern fröhlich „ja, wir unterstützen Ihr Automodell" für Marken, die in der Datenbank gar nicht vorkamen, weil die Wissensdatenbank „wir unterstützen alle Modelle" sagte. Die Lösung war nicht ein besseres Basismodell. Es waren besseres Retrieval, engere Verankerung und Tests an echten früheren Daten vor dem Livegang. Die eigene Zusammenfassung des Teams für diese Phase lautete „Versuch und Irrtum am Anfang", und genau in diese Phase würde Sie ein brandneues, untertrainiertes Modell zurückwerfen, wenn Sie ihm roh vertrauen.
Diese Mitarbeiter-Ebene bauen wir bei eesel. Der Gedanke ist einfach: eesel ist eine Plattform für KI-Teammates, und Sie stellen einsatzbereite Teammates für bestimmte Aufgaben ein, derzeit einen KI-Helpdesk-Teammate und einen KI-Blog-Autor. Jeder bringt die Fähigkeiten, Integrationen und den Unternehmenskontext für seine Rolle mit, sodass das darunter laufende Modell ein Implementierungsdetail wird und nicht Ihr Problem.

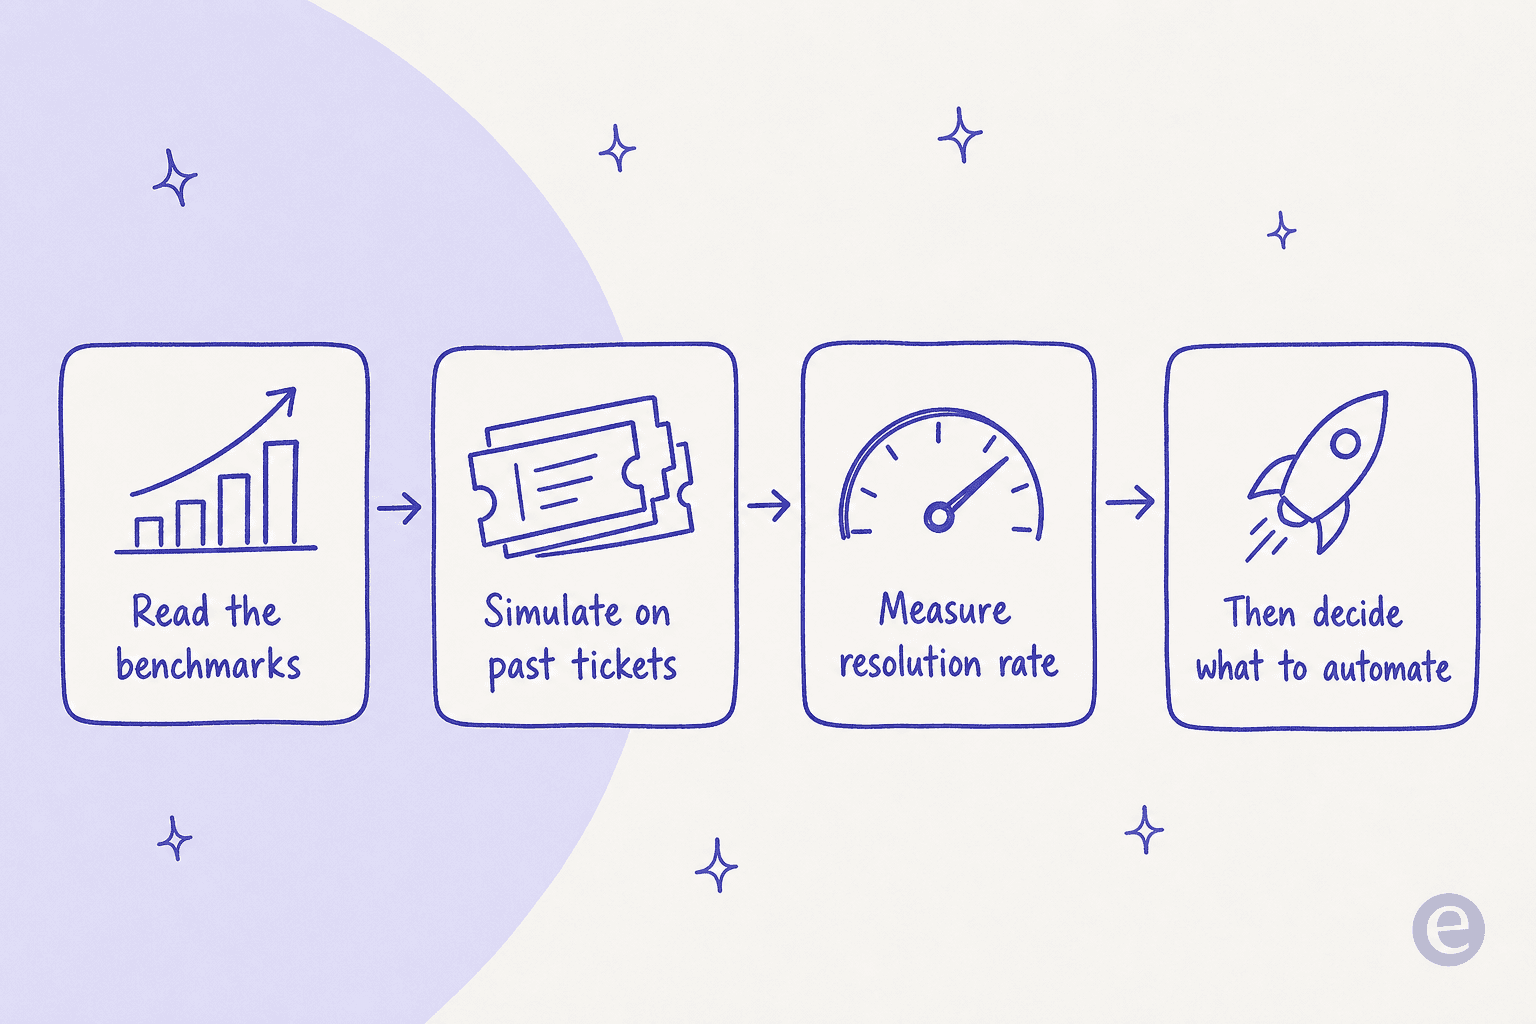
Den Teil, den ich am dringlichsten hervorheben würde, ist das Testen, denn ich habe erlebt, wie es Leute gerettet hat. Der eesel-Helpdesk-Teammate simuliert jeden Rollout an Ihren historischen Tickets, bevor er je einen Live-Kunden berührt. Sie sehen die Lösungsquote und die genauen Antworten, die er in echten früheren Gesprächen gesendet hätte, und entscheiden dann, was automatisiert wird. Ein untertrainiertes Vorabmodell ist genau das, was Sie durch diese Schleuse schicken wollen, statt einer Benchmark-Tabelle zu vertrauen. Und weil eesel aus Ihrer bestehenden Wissensdatenbank und früheren Tickets liest, ist das Kontextproblem gelöst, das ein rohes Modell nie allein lösen kann.
Kurz gesagt: Modelle wie Qwen 3.8 Flash Next werden schnell günstig und leistungsfähig, was großartig ist, aber die Auswahl eines Modells sind die einfachen 10 % der Aufgabe. Die anderen 90 % bestehen darin, daraus einen Teammate zu machen, der Tickets löst, und diese Ebene ist Ihre Zeit wert.
eesel ausprobieren
Wenn Sie hier sind, weil Sie Qwen 3.8 Flash Next für den Support abwägen, lautet der ehrliche Rat: Hören Sie auf, nach einem Modell zu suchen, und fangen Sie an, an Ihren eigenen Tickets zu testen. eesel verbindet sich mit Ihrem bestehenden Helpdesk, lernt aus Ihrer Wissensdatenbank und früheren Gesprächen und simuliert jeden Rollout an historischen Tickets, sodass Sie die echte Lösungsquote sehen, bevor etwas live geht. Es ist kostenlos zu testen, und das Modell darunter bleibt unser Problem, nicht Ihres.