

Gimlet Labs betreibt nach eigener Aussage die erste „Multi-Silicon-Inferenz-Cloud“. Vereinfacht gesagt: Software, die einen KI-Workload auf verschiedene Chiparten aufteilt, sodass jede Phase eines Modells auf der Hardware läuft, die sie am besten bewältigt. Am 4. September 2026 hat das Unternehmen eine Series B über 300 Millionen $ unter Führung von Andreessen Horowitz abgeschlossen, bei einer Bewertung von 3 Milliarden $. Arm und der Venture-Arm von Microsoft sind eingestiegen.
Der Grund für diesen Preis von 3 Mrd. $ ist derselbe, aus dem ich mich als jemand, der beruflich KI-Agenten baut, dafür interessiere: Agentische Workloads sprengen die Annahme „ein Modell, eine GPU“. Ein Agent verkettet ein Dutzend aufeinanderfolgender Modellaufrufe, und jeder Aufruf beansprucht einen anderen Teil der Hardware. Gimlets Wette ist, dass man jeden Teil auf den Chip lenkt, der dafür am schnellsten ist.
Versprochen wird eine 3- bis 10-mal schnellere Inferenz bei gleichem Energiebedarf. Das sind Herstellerangaben, die eine gesunde Portion Skepsis verdienen, auf die ich noch eingehe. Das zugrunde liegende Problem ist aber real, und ich spüre es bei jedem Release.
Was ist Gimlet Labs?
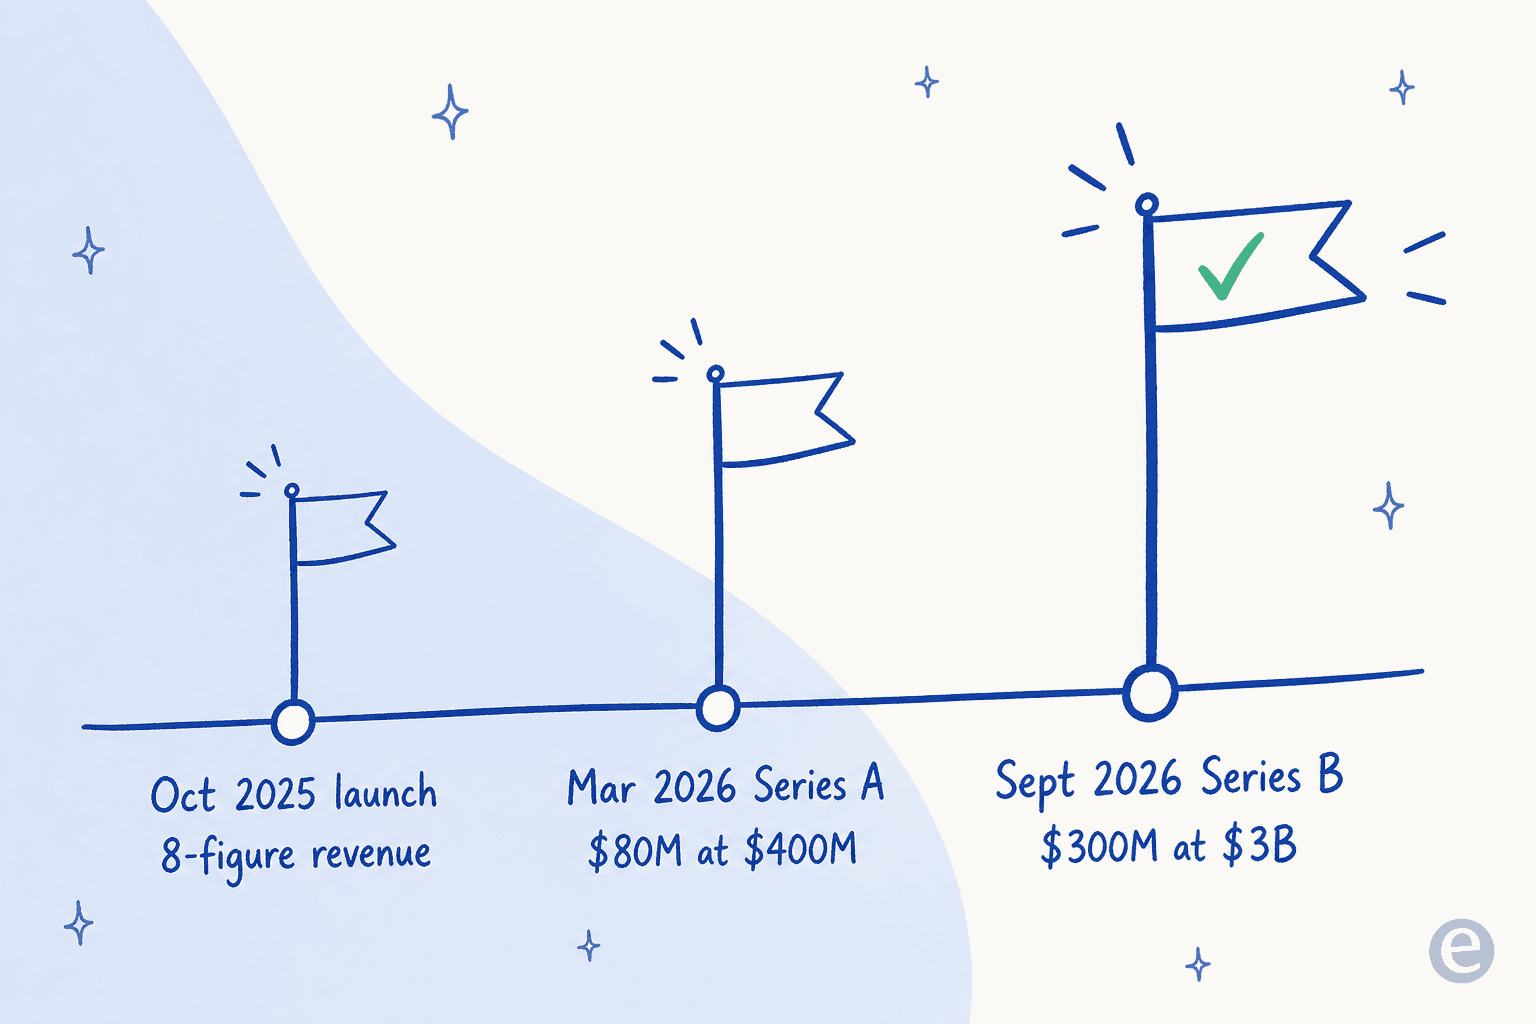
Gimlet Labs ist ein Unternehmen für angewandte KI-Forschung und Produktentwicklung. Es ist im Oktober 2025 öffentlich gestartet und hatte nach eigener Aussage von Beginn an einen Umsatz im achtstelligen Bereich, was für ein so junges Unternehmen ungewöhnlich ist.
Die Startseite fasst die Weltsicht in einem Satz zusammen: „Today's computing systems will undergo a massive transformation to efficiently and scalably serve AI workloads.“ Alles Weitere folgt daraus. Statt hinzunehmen, dass ein Modell auf der GPU läuft, die man gerade mietet, baut Gimlet die Schicht, die das Modell gleichzeitig über viele Chiptypen verteilt.
Hinter dem Versprechen stehen zwei Produkte:
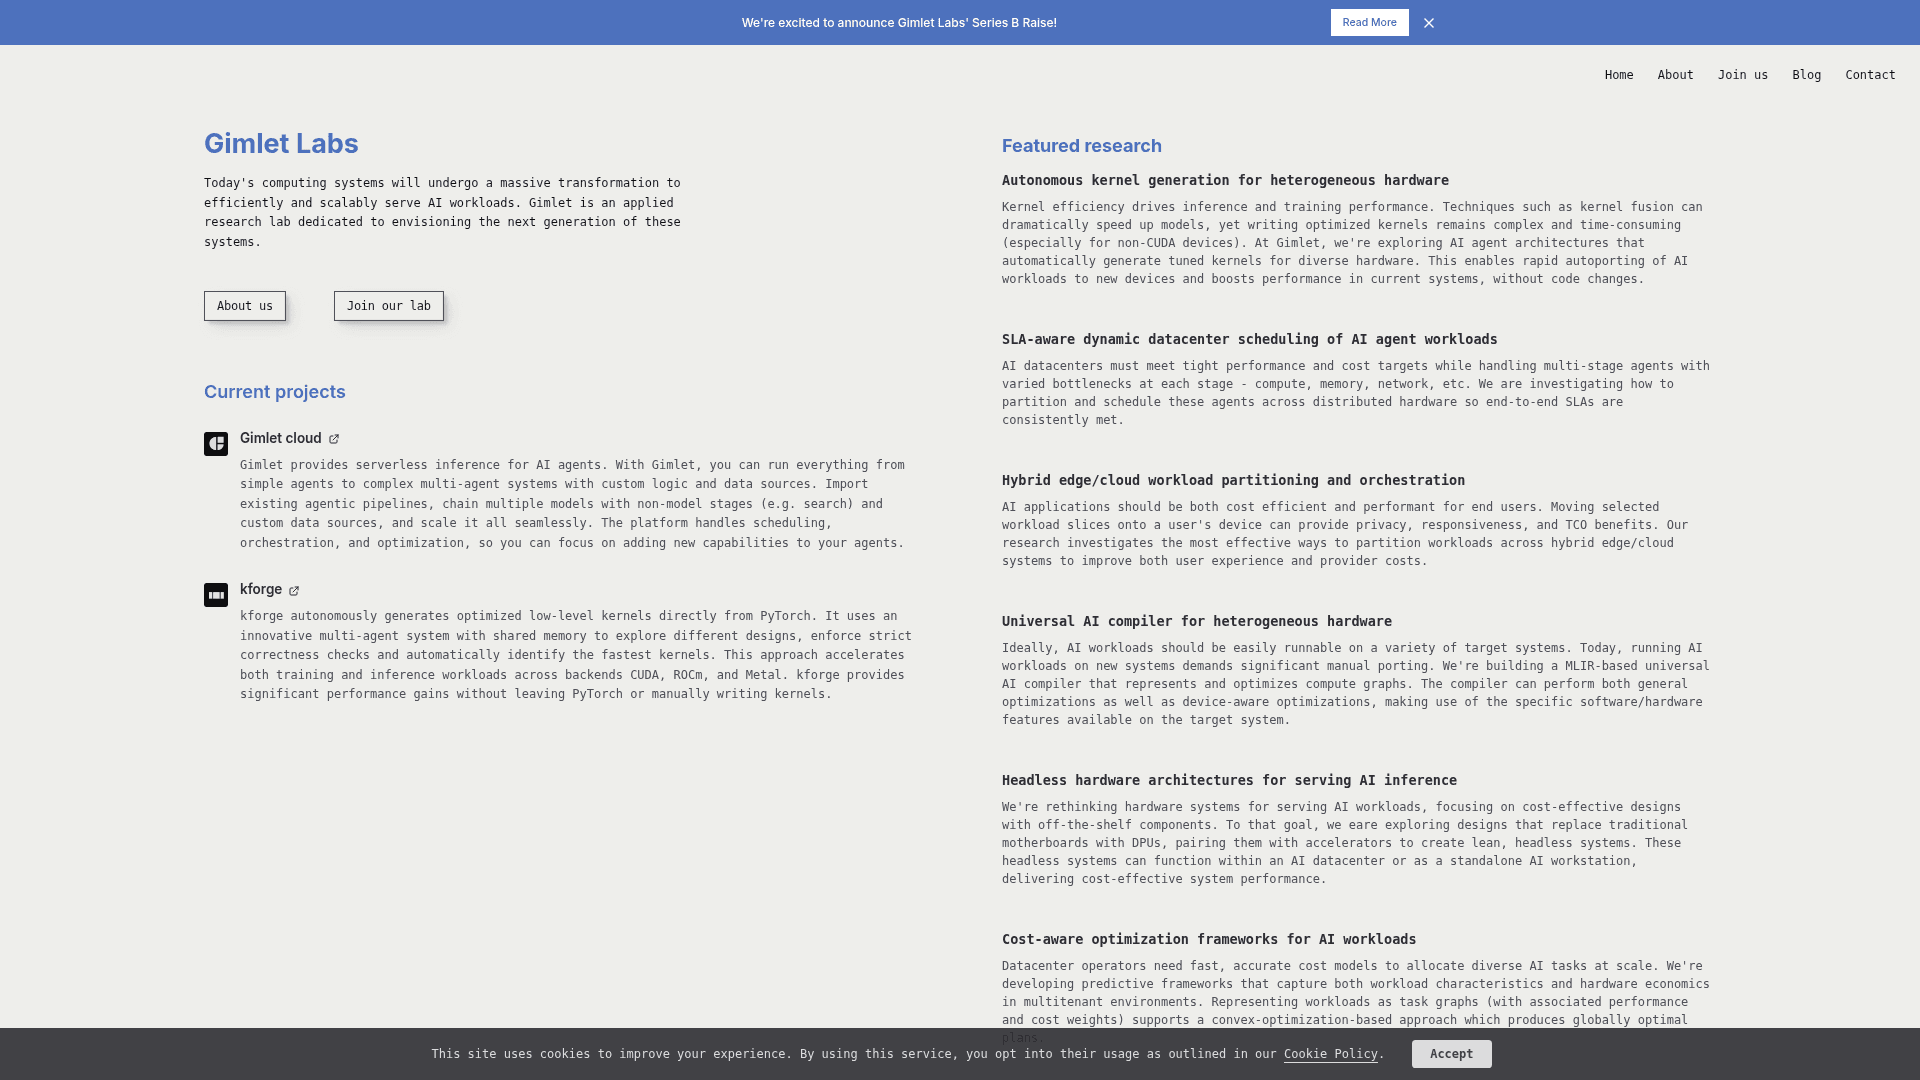
- Gimlet Cloud ist eine serverlose Inferenzplattform für KI-Agenten. Sie importieren eine bestehende agentische Pipeline, verketten mehrere Modelle mit Nicht-Modell-Schritten wie der Suche, und die Plattform übernimmt Scheduling und Orchestrierung.
- kforge ist der Baustein auf niedrigerer Ebene. Es generiert direkt aus PyTorch automatisch optimierte Kernel für die Backends CUDA, ROCm und Metal. Dabei nutzt es ein Multi-Agenten-System, das Kernel-Designs erkundet und auf Korrektheit prüft, sodass Ingenieure Beschleunigungen erhalten, ohne Kernel von Hand zu schreiben.
Das Problem: Agenten haben die Inferenz auf einem Chip gesprengt
Hier macht alles klick, und deshalb halte ich das für mehr als eine reine Finanzierungsmeldung.
Ein großes Sprachmodell leistet nicht eine einheitliche Art von Arbeit. Wenn es antwortet, liest es zuerst Ihren Prompt (die Prefill-Phase), die rechengebunden ist und rohen Rechendurchsatz verlangt. Dann erzeugt es Token nacheinander (die Decode-Phase), die speicherbandbreitengebunden ist und die Zeit damit verbringt, Daten in den Speicher hinein- und wieder herauszuschaufeln. Und ein moderner KI-Agent hört dort nicht auf: Er ruft Tools auf, spricht APIs an und holt Dokumente, was netzwerkgebunden ist.
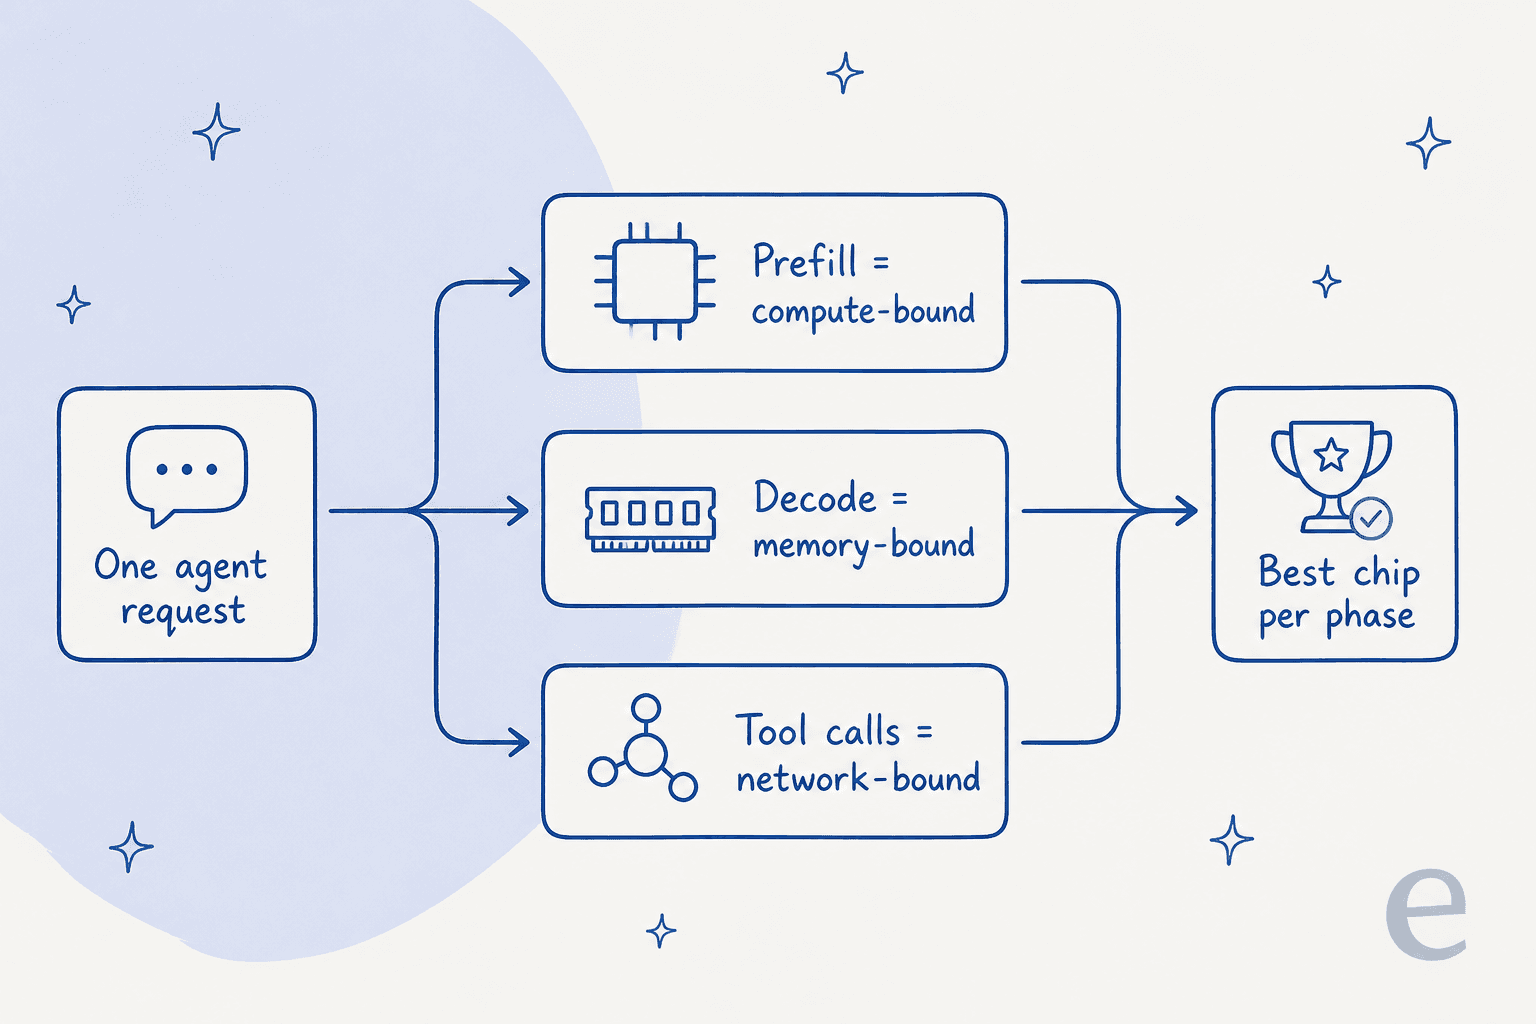
Läuft das alles auf einem homogenen GPU-Cluster, bleibt immer etwas ungenutzt. Beim Decode ist Ihre teure Rechenleistung nur halb ausgelastet. Bei Tool-Aufrufen wartet der gesamte Beschleuniger auf das Netzwerk. Gimlets Argument, direkt aus dem Series-B-Beitrag, lautet: Homogene Hardware allein kann die Anforderungen agentischer Workloads an Geschwindigkeit und Effizienz nicht erfüllen. Je mehr Schritte ein Agent verkettet, desto stärker summiert sich diese Verschwendung.
Für mich ist das kein abstraktes Thema. Bei eesel baue ich KI-Agenten, die Support-Tickets lösen, und eine einzige Lösung ist eine Kette: Ticket lesen, die Wissensdatenbank durchsuchen, über die Fundstellen nachdenken, manchmal eine Bestellabfrage-API aufrufen und dann eine Antwort schreiben. Jeder dieser Schritte hat einen anderen Engpass. Wenn Leute fragen, warum sich agentische Produkte langsam anfühlen können, ist das ein großer Teil der Antwort.
Wie die Multi-Silicon-Cloud funktioniert
Gimlets Lösung ist die Disaggregation. Das System trennt die Phasen und führt jede auf dem Silizium aus, das dafür am besten geeignet ist: Prefill auf einer Gerätegruppe, die auf Rechenleistung getrimmt ist, Decode auf einer anderen, die auf Speicherbandbreite ausgelegt ist, und so weiter. Hinzu kommen spekulatives Decoding und die Aufteilung in Attention und Feed-Forward, und es balanciert dynamisch um, sobald Hardware frei wird.
Damit das möglich ist, arbeitet Gimlet mit der gesamten Chipbranche zusammen, statt sich für eine Seite zu entscheiden. Das Unternehmen arbeitet mit NVIDIA-Chips ebenso wie mit AMD, Intel, Arm, Cerebras und d-Matrix. Die Software ist das Produkt, das Silizium ist austauschbar. Das ist das Gegenteil der üblichen Geschichte „kaufen Sie unseren Beschleuniger“, und deshalb hat Arm in die Runde investiert, statt Gimlet als Bedrohung zu betrachten.
Der beworbene Nutzen sind 5- bis 10-fache Beschleunigungen im gleichen Leistungsrahmen oder derselbe Durchsatz bei geringerer Latenz. Gerade bei agentischer KI, bei der eine Anfrage Dutzende aufeinanderfolgender Modellaufrufe benötigen kann, wirkt der Zinseszinseffekt zu Ihren Gunsten statt gegen Sie, wenn bei jedem Aufruf Latenz eingespart wird.
Die Finanzierung und wer darauf wettet
Das Geld verrät, wer daran glaubt. Die Series B wurde von Andreessen Horowitz angeführt, mit einer langen Liste von Teilnehmern, darunter Menlo Ventures (Lead der Series A), Arm, M12, Samsung Ventures, Tiger Global und XTX Markets. Gimlet sagt, seit März seien Milliarden an vertraglich gesichertem Umsatz hinzugekommen, und die Pipeline an Rechenzentren werde in Gigawatt gemessen.
Die Entwicklung ist steil: eine Series A über 80 Millionen $ im März 2026 bei einer Bewertung von rund 400 Millionen $, danach ein Sprung auf 3 Milliarden $ sechs Monate später. In einem Markt, in dem jedes Labor günstigere LLM-Inferenz anstrebt, kommt die These bei Investoren offenbar gut an, dass Effizienz und nicht nur größere Modelle das nächste Schlachtfeld ist.
Die ehrlichen Einschränkungen
Ich möchte hier fair bleiben, denn eine Bewertung von 3 Mrd. $ und ein 10-faches Versprechen laden genau zu der Art von Hype ein, die ich vermeiden will.
Erstens stammen die Leistungszahlen von Gimlet selbst. Als das Unternehmen einen Beitrag über KI-generierte Metal-Kernel veröffentlichte, äußerte ein PyTorch-Entwickler auf Hacker News einen berechtigten, pointierten Einwand:
„I work on PyTorch and there are many things that make me suspicious about these results. My TL;DR is unless we get a zip file of all the kernels with how they're benchmarked results like this are almost impossible to verify.“

Das ist kein Verriss, und das Gimlet-Team hat sich im Thread damit auseinandergesetzt. Aber es ist der richtige Rahmen: Benchmark-Beschleunigungen sind eine Behauptung, die Sie mit Ihrem eigenen Workload überprüfen sollten, kein gesichertes Ergebnis. Zweitens hat Gimlet seine Kunden nicht öffentlich genannt, sondern beschreibt sie nur als „a major model maker“ und „an extremely large cloud computing company“. Und drittens ist dies Infrastruktur für Labore und Rechenzentren. Wenn Sie ein Produkt entwickeln, werden Sie Gimlet vermutlich nie direkt anfassen, sondern es nur als schnellere, günstigere Inferenz unter den Tools spüren, die Sie tatsächlich nutzen.
Was das bedeutet, wenn Sie mit KI bauen
Wo stehen Sie also, wenn Sie kein Frontier-Labor betreiben?
Gimlet ist eine gute Erinnerung an das Schichtenmodell. Unten liegt das Silizium, in der Mitte die Inferenzschicht, um die Gimlet kämpft, darüber die Modelle und ganz oben die tatsächlichen Mitarbeiter, die Sie einstellen. Gimlet ist Infrastruktur. Es sorgt dafür, dass der Motor besser läuft, erledigt aber nicht Ihre Arbeit.
Genau so denke ich über eesel. eesel ist eine Plattform für KI-Teammitglieder: Sie stellen einsatzbereite Teammitglieder für bestimmte Aufgaben ein, und heute besteht das Team aus einem KI-Helpdesk-Teammitglied und einem KI-Blog-Autor. Das Helpdesk-Teammitglied steigt in Ihre bestehende Support-Warteschlange ein, lernt aus Ihren früheren Tickets und Ihrem Help Center und löst Konversationen in Zendesk, Freshdesk oder Gorgias. Der Blog-Autor tut dasselbe für Inhalte. Welche Inferenz-Cloud auch immer darunter liegt, das Teammitglied bringt die Aufgabe zum Abschluss.

Und weil Gimlets ganze Welt agentisch und programmierbar ist, holt eesel diese Leser ebenfalls dort ab, wo sie stehen. Die eesel CLI steuert dasselbe Helpdesk-Teammitglied vom Terminal aus: Ein Mensch kann sie von Hand ausführen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code oder Cursor können sie über die CLI und den MCP-Server bedienen. So wird das Simulieren eines Rollouts anhand historischer Tickets oder das Auslösen eines Laufs zu einem einzigen Befehl statt zu einem Klick im Dashboard. Wenn Sie lieber sehen möchten, wie eesel echte Tickets löst, als noch ein Datenblatt zu lesen, können Sie eesel kostenlos testen und es in wenigen Minuten auf Ihr eigenes Help Center richten.
Wenn Sie noch am Anfang stehen und nur Optionen vergleichen, sind die Übersichten zu den besten KI-Agenten und zur KI-Ticket-Klassifizierung ein besserer Einstieg als eine 3-Mrd.-$-Inferenz-Cloud.
Fazit
Gimlet Labs ist ein interessantes Unternehmen, das ein reales, unglamouröses Problem löst: Die Hardware unter der KI passt schlecht dazu, wie Agenten tatsächlich laufen, und jemand musste die Software bauen, um das zu beheben. Die Bewertung von 3 Mrd. $ ist eine Wette darauf, dass die Inferenz-Effizienz der nächste große Kampf wird, und angesichts des rasanten Wachstums von agentischer KI ist das keine verrückte Wette.
Nehmen Sie die Geschwindigkeitsversprechen nur mit Vorbehalt, bis sie unabhängig getestet sind, und denken Sie daran, welche Schicht Sie eigentlich kaufen. Gimlet macht den Motor schneller. Das Teammitglied obendrauf ist weiterhin derjenige, der die Arbeit erledigt.