

Was Z.ai am 12. Oktober tatsächlich veröffentlicht hat
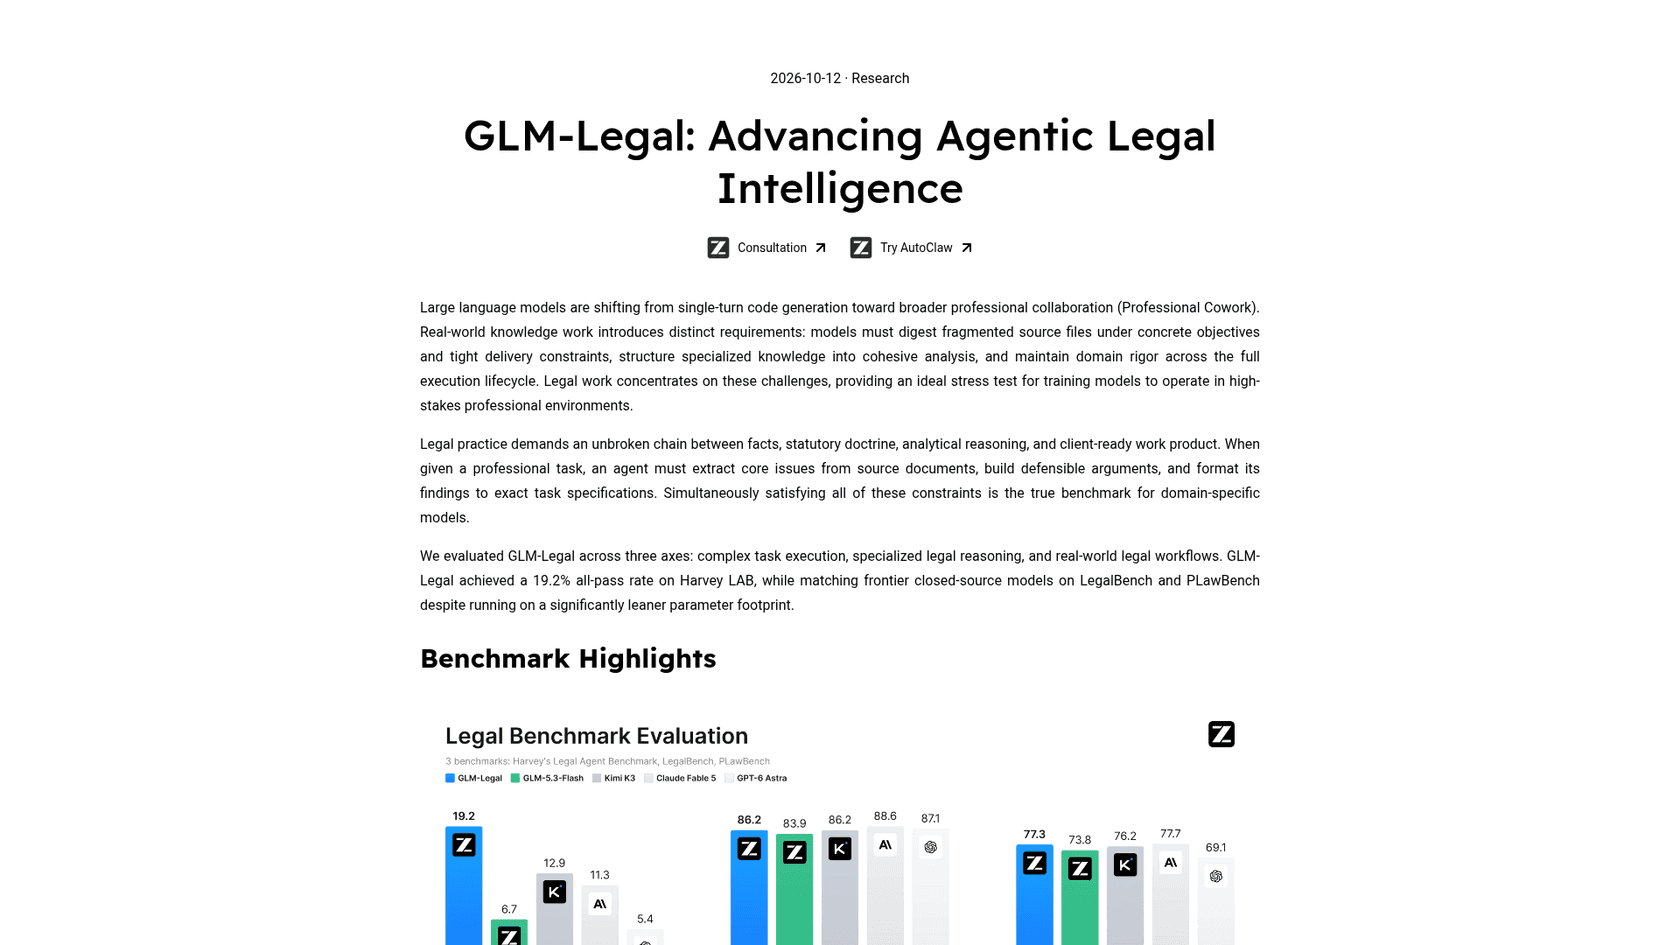
Z.ai hat GLM-Legal als Forschungsbeitrag mit dem Titel "Advancing Agentic Legal Intelligence" veröffentlicht, mit zwei Buttons oben: einer für ein Beratungsformular, einer für AutoClaw, die Desktop-Agent-App. Der Launch-Beitrag auf X hat über 7.000 Likes, und der Hacker-News-Thread kam auf 594 Punkte und 332 Kommentare.
Das ist drin, und das nicht:
| Was Z.ai sagt oder zeigt | |
|---|---|
| Basismodell | GLM-5.3-Flash, ein Mixture-of-Experts-Modell mit 320 Mrd. Parametern, davon 18 Mrd. aktiv |
| Kontextfenster | 1 Mio. Tokens; 128k maximale Ausgabe (Vals-Modellkarte) |
| Eingabe | Nur Text im Vals-Test, obwohl das Basismodell Bilder verarbeitet |
| Zielaufgaben | Vertragsprüfung, Beweisauswertung, Compliance-Recherche |
| Zielgruppen | Kanzleien, Legal-Tech-Unternehmen, Rechtsabteilungen, Einzelanwälte |
| Zugang | API-Test auf Antrag; AutoClaw-Unterstützung "bald" |
| Preis | Nicht veröffentlicht |
| Gewichte | Kein Download auf Z.ais Hugging-Face-Seite (Stand 14. Oktober) |
Wenn Sie den GLM-5.2-Launch oder die Flash-Veröffentlichung im August verfolgt haben, kommt Ihnen das Muster bekannt vor: Z.ai nimmt ein starkes allgemeines Modell und richtet es auf eine bestimmte Aufgabe aus. Neu ist, dass die Aufgabe ein regulierter Beruf ist und die Veröffentlichung beschränkt wird.
Wie GLM-Legal unter der Haube funktioniert
Z.ai beschreibt drei Trainingsstufen, und die dritte ist die interessante.
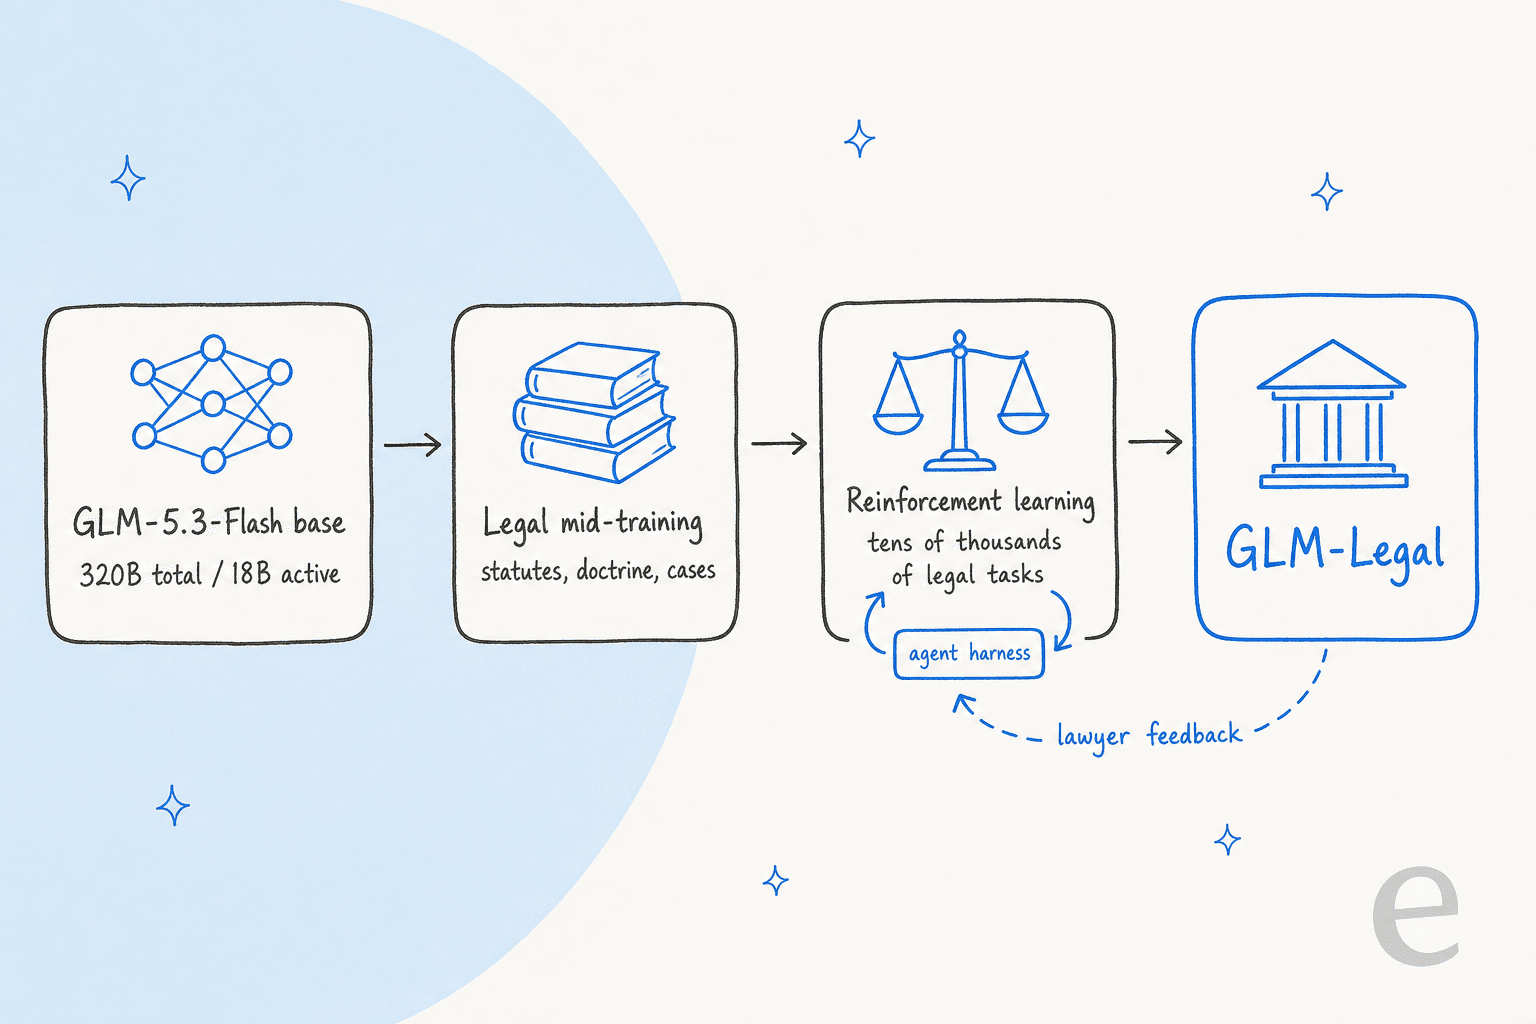
1. Mid-Training auf juristischen Texten. Z.ai hat "expanded the volume of high-quality legal corpora", damit das Modell Gesetze, Rechtsdogmatik und die Auslegung durch Juristen lernt. Das ist der übliche Zug bei domänenspezifischen LLMs und hilft für sich genommen vor allem beim Abruf von Wissen.
2. Reinforcement Learning in einem Agent-Harness. Auf diesen Teil würde ich achten. Das Modell wurde "across tens of thousands of realistic legal environments" trainiert, in denen es eine Analyse plant, Dateien öffnet, ein Ergebnis entwirft und bewertet wird. Der Harness (der Code, der dem Modell seine Dateien und Werkzeuge übergibt) wurde gemeinsam mit trainiert. Scheiterte das Modell, korrigierte Z.ai auch den Harness, und umgekehrt.
Ich baue seit Jahren Agenten auf allgemeinen Modellen, und die meisten Fehler, denen ich nachjage, lauten nicht "das Modell ist dumm". Sie lauten "das Modell hat nicht die richtige Datei gelesen" oder "es hat die Antwort für den nächsten Schritt falsch formatiert". Modell und Harness gemeinsam zu trainieren greift genau diese Fehlerklasse an. Es heißt auch, dass GLM-Legal sich wahrscheinlich in Z.ais eigenem Harness, AutoClaw, am besten verhält und in Ihrem weniger vorhersehbar.
3. Eine Schleife mit praktizierenden Anwälten. Z.ai sagt, Anwälte bewerten Ausgaben anhand von Fragen wie "Are all critical issues and edge cases addressed?" und "Are arguments well-substantiated and citations legally sound?" Diese Bewertungen fließen in die nächste Trainingsrunde.
Nichts davon ist als Paper mit Datenquellen veröffentlicht. Ein HN-Kommentator wies darauf hin, dass man ohne Kenntnis des Trainingssatzes Aufgaben nicht ausschließen kann, die dem Test stark ähneln. Behalten Sie das für den nächsten Abschnitt im Kopf.
Die drei Demos von Z.ai
Der Launch-Beitrag vergleicht GLM-5.3-Flash und GLM-Legal an denselben drei Aufgaben. Der Unterschied ist vor allem die Genauigkeit. Bei einem Softwaredienstleistungsvertrag schlägt das Basismodell vor, "consider shortening the notice period". GLM-Legal sagt, die Frist "from 60 to 30 days" zu kürzen, die Heilungsfrist bei Verstößen gegen IP, Vertraulichkeit und Datensicherheit zu streichen und "up to 90 days of transition assistance" aufzunehmen.
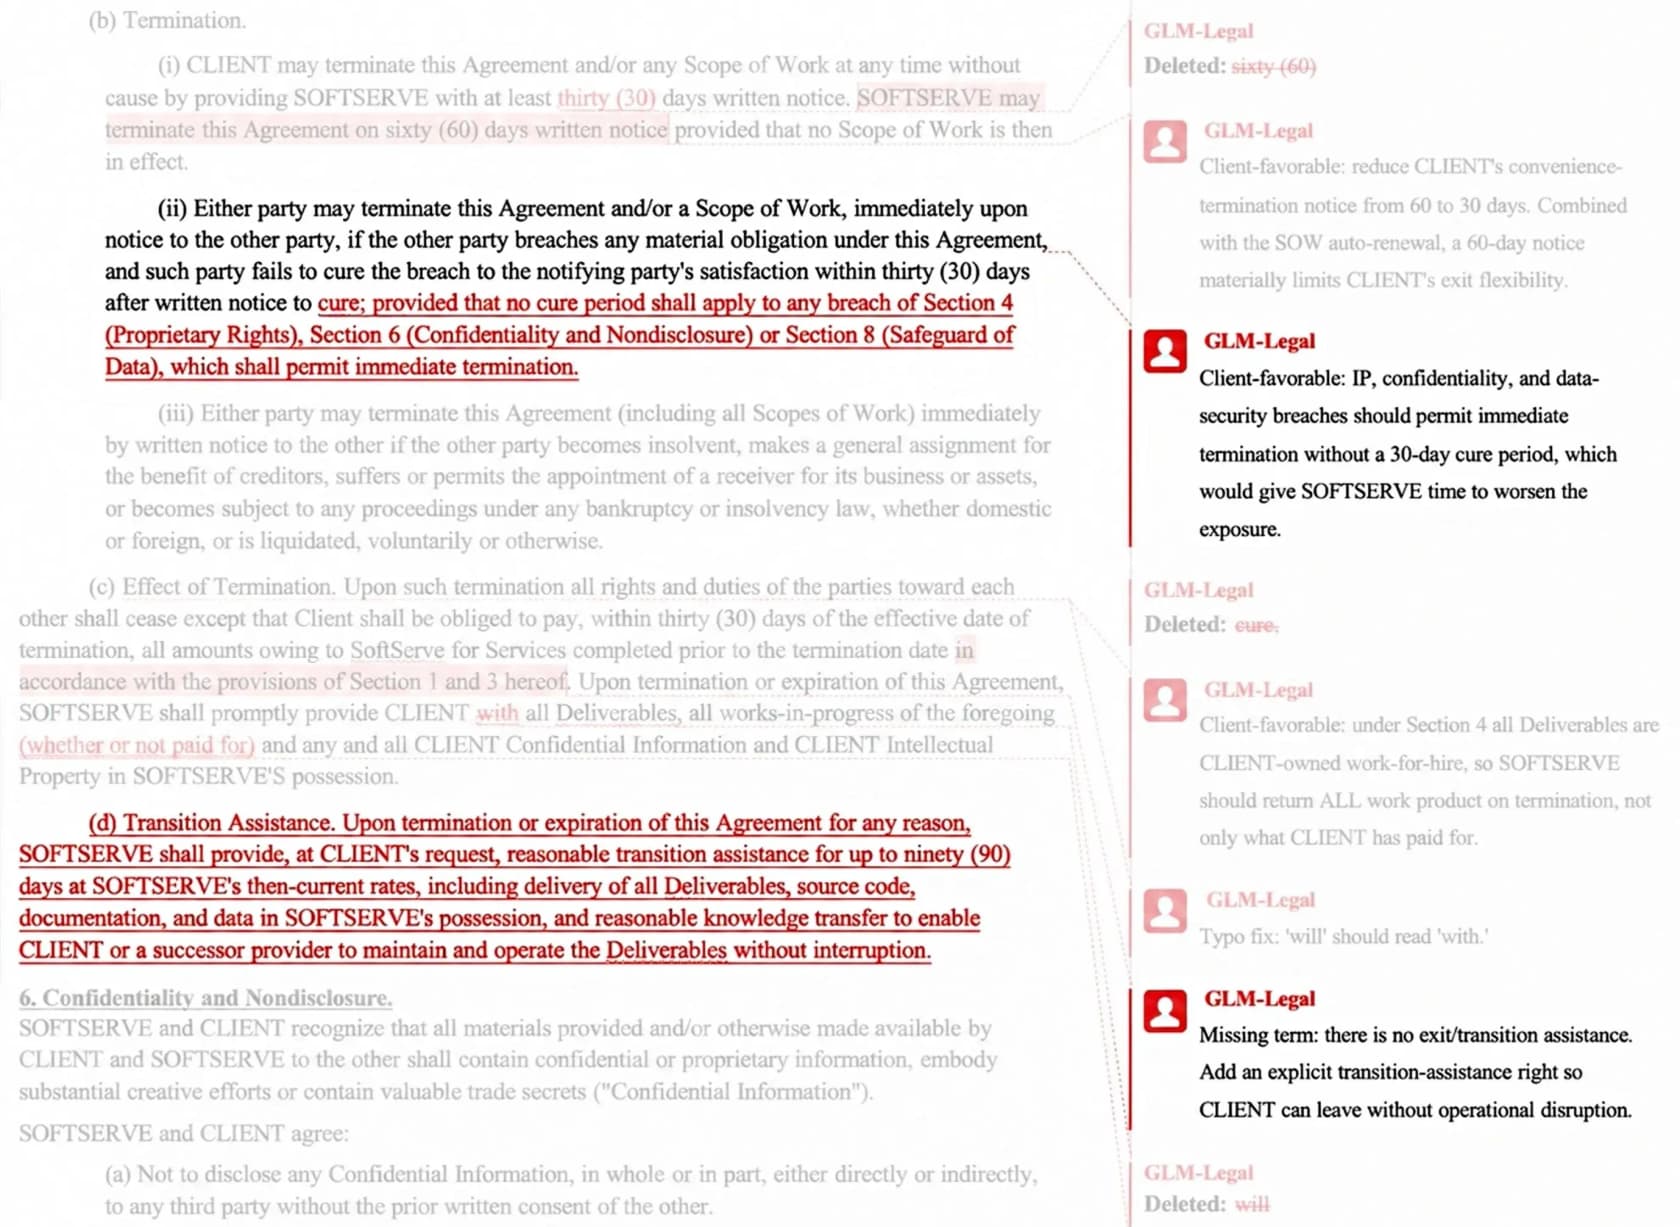
Das Ergebnis landet als nachverfolgte Änderungen und Kommentare in einer Word-Datei, und das ist die richtige Form: Ein Anwalt nimmt jede Änderung an oder lehnt sie ab, statt einer Zusammenfassung zu vertrauen.
Die zweite Demo liest 40 Dokumente aus einem Streit um ein Softwareprojekt und baut eine Chronologie, in der jeder Eintrag mit einer Dokumentnummer belegt ist. GLM-Legal verknüpft einen Kundenbericht über "60 % complete" mit einem internen Snapshot von etwa 41 % und einer E-Mail, die Mitarbeiter anweist, weiter zu fakturieren. Die dritte plant die Datenschutz-Compliance für einen Start in Singapur, Malaysia und Indonesien, mit Paragrafenangaben zum Datenschutzgesetz jedes Landes.
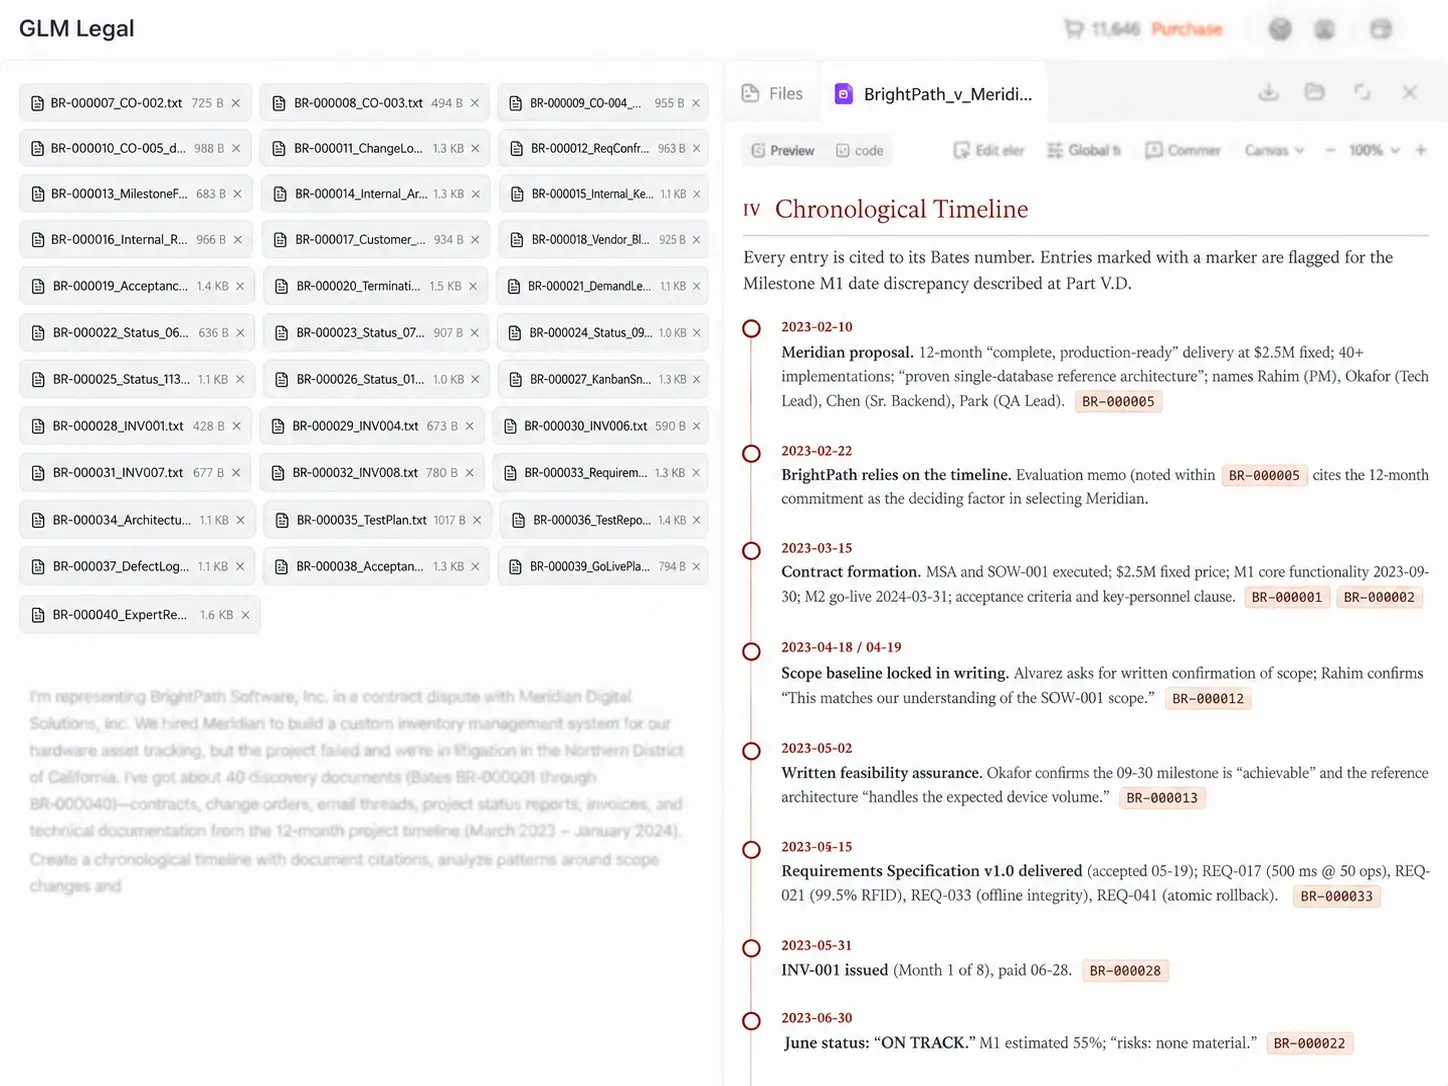
Diese Beispiele sind per Definition handverlesen. Dennoch ist die gezeigte Gewohnheit (für jede Aussage das Quelldokument zu nennen) genau die, die KI-Ausgaben überprüfbar macht, und überprüfbar zählt in der Rechtsarbeit mehr als clever.
GLM-Legal-Benchmarks: Was die 19,2 % wirklich bedeuten
Z.ais Grafik vergleicht GLM-Legal mit dem eigenen Basismodell, Kimi K3, Claude Fable 5 und GPT-6 Astra in drei Tests.
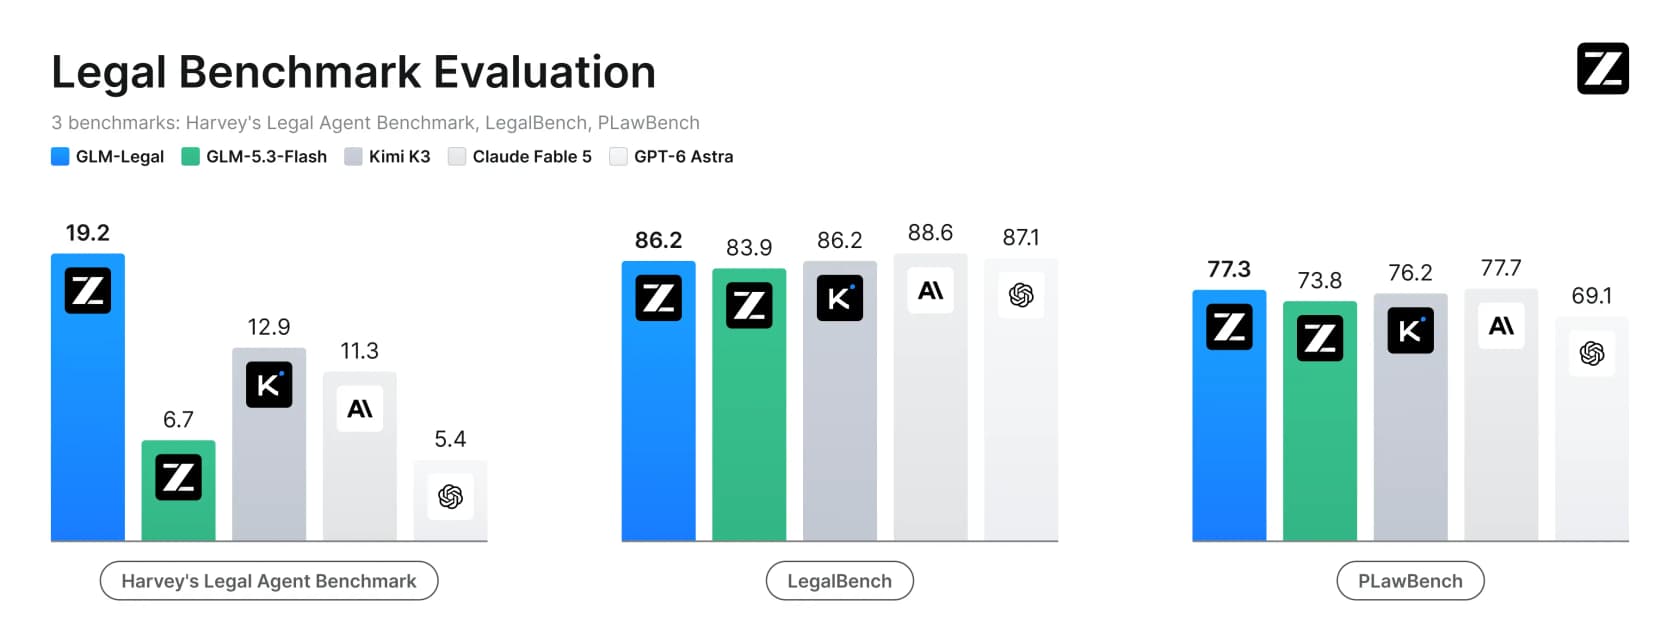
| Benchmark (Z.ais Grafik) | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench (chinesisches Recht) | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
Bei genauem Hinsehen bedeutet "matches frontier models" etwas Engeres, als es klingt. GLM-Legal gewinnt eine Spalte klar. In LegalBench und PLawBench gleicht es Claude Fable 5 aus oder liegt ein bis zwei Punkte dahinter. Das ist für ein Modell mit 18 Mrd. aktiven Parametern immer noch ein starkes Ergebnis, aber es ist Gleichstand bei den älteren Tests und ein Vorsprung bei einem neuen.
Warum die Werte so niedrig aussehen
Der Legal Agent Benchmark von Harvey gibt einem Agenten einen Ordner mit Dateien, sechs Werkzeuge (Dateien lesen, bearbeiten und schreiben, dazu Suche und eine Shell) sowie Word-, Excel- und PowerPoint-Skills. Jede Aufgabe hat einen Katalog von Kriterien, und die Kennzahl ist eine All-Pass-Quote: Die Aufgabe zählt nur, wenn jedes Kriterium bestanden ist.
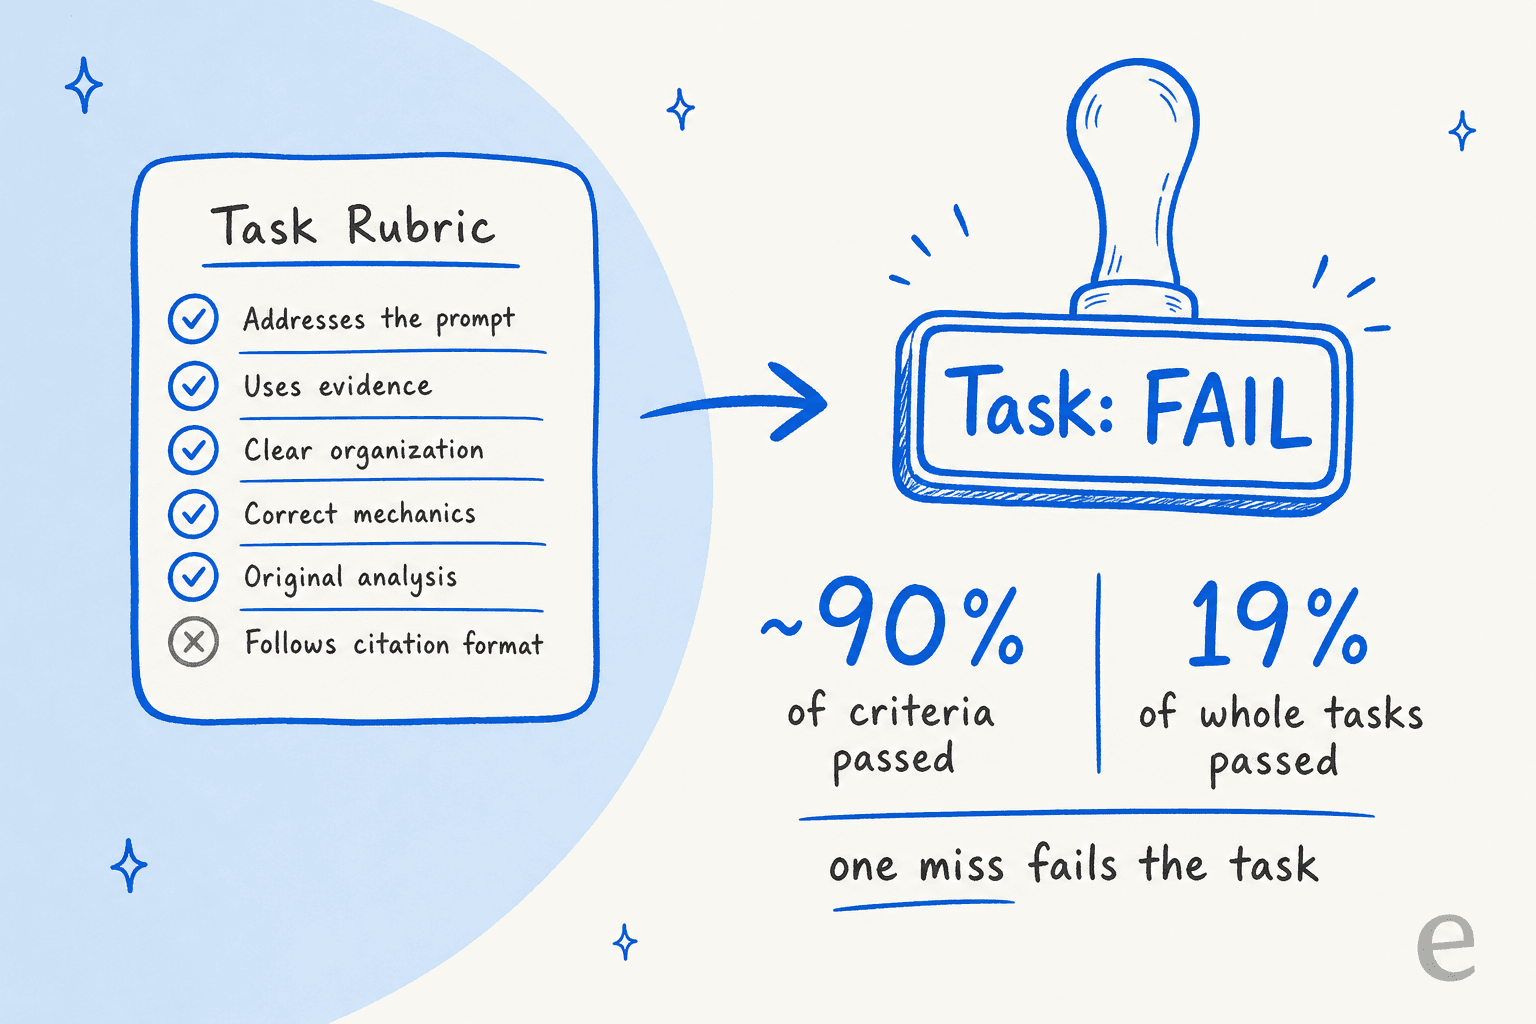
Vals merkt an, dass Spitzenmodelle rund 90 % der einzelnen Kriterien bestehen, während der beste Wert für ganze Aufgaben bei 25,42 % liegt. Ein Modell mit 19 % liegt also nicht in vier von fünf Fällen falsch. Meist erledigt es den Großteil der Arbeit richtig und verfehlt eine Anforderung. In der Rechtsarbeit kann dieser eine Fehler das ganze Problem sein, weshalb die strenge Bewertung vertretbar ist.
"This is why I severely dislike using all pass rate. A model could be at like 93%, meeting practically every requirement except the broken ones and all pass would give it like 20%."

Was die unabhängige Rangliste ergänzt
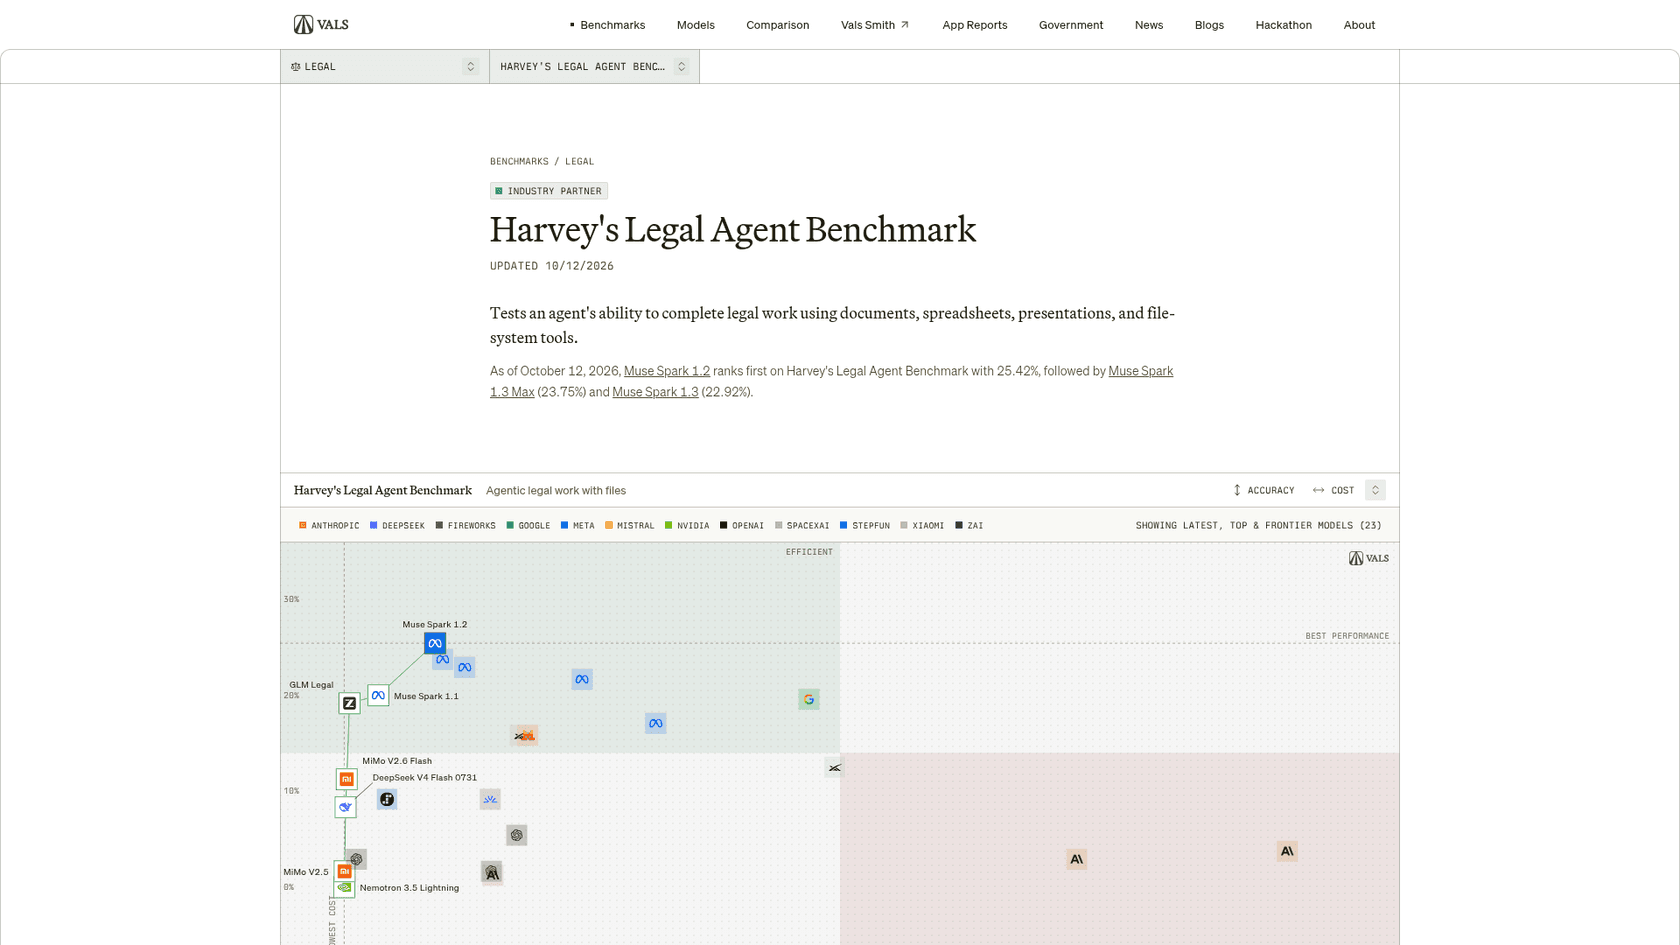
Z.ai hat GLM-Legal zur unabhängigen Prüfung an Vals AI geschickt, und die Vals-HLAB-Rangliste ist die nützlichere Sicht, weil sie alle einbezieht:
| Rang | Modell | Aufgaben-Erfolgsquote | Kosten pro Aufgabe | Zeit pro Aufgabe |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25.42% | $2.09 | 24m16s |
| 2 | Muse Spark 1.3 Max | 23.75% | $2.26 | 14m43s |
| 3 | Muse Spark 1.3 | 22.92% | $2.76 | 17m04s |
| 4 | Muse Wonder Full | 21.67% | $5.41 | 53m21s |
| 6 | Gemini 4 Argon | 19.58% | $10.55 | 43m55s |
| 7 | GLM-Legal | 19.17% | $0.15 | 1h12m |
| 9 | Mistral Large 4 | 15.83% | $4.18 | 39m25s |
| 12 | Kimi K3 | 12.92% | $3.83 | 13m58s |
| 31 | GLM-5.3-Flash (Basis) | 6.67% | $0.57 | 52m17s |
| 41 | Claude Opus 5.5 | 3.75% | $21.38 | 52m55s |
Zwei Dinge fallen auf. Erstens entspricht der Sprung von 6,67 % auf 19,17 % genau den 12,5 Punkten, die Z.ai angibt, die Herstellerzahl hält also stand. Zweitens schlagen vier Meta-Modelle GLM-Legal, und keines taucht in Z.ais Grafik auf. Ein HN-Kommentator hat das am Launch-Tag bemerkt. Auf Vals' Modellseite erreicht GLM-Legal außerdem 86,23 % im LegalBench (Platz 14 von 150, das beste GLM-Ergebnis dort) und 41,83 % im Legal Research Bench (Platz 24 von 78).
Auch Harveys Test selbst hat Kritiker. Ein HN-Kommentator, der Agent-Traces durchgesehen hat, sagte, er habe "found multiple problematic tasks and rubrics", und verlinkte ein offenes Issue im Repo von Harvey. Eine Marge von ±3,25 Punkten bei einem Wert von 19 % ist groß. Ich würde GLM-Legal und Gemini 4 Argon als gleichauf behandeln, nicht als gereiht.
Die eigentliche Geschichte: Kosten pro Aufgabe und die Wartezeit
Wäre GLM-Legal bei 19 % für 10 $ pro Aufgabe gelandet, würde niemand darüber schreiben. Wichtig ist es wegen der Rechnung.
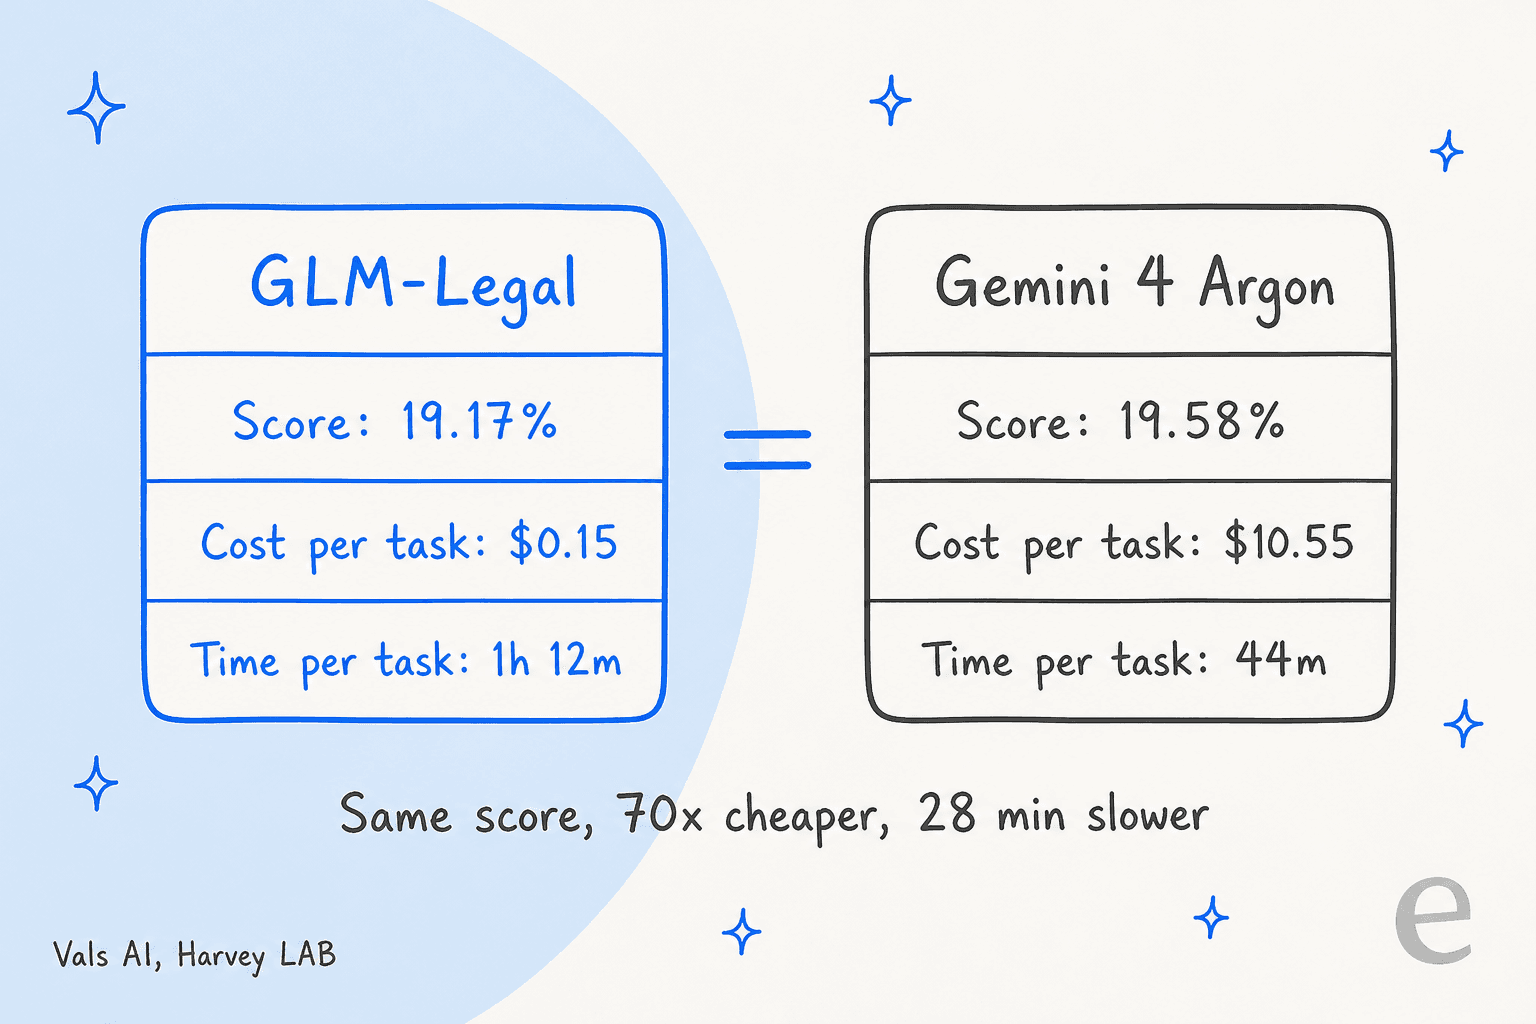
Nach den Zahlen von Vals erreicht GLM-Legal den Wert von Gemini 4 Argon für etwa 1/70 der Kosten, und Vals nennt es das günstigste Modell der Top 10. Der Haken ist die Zeit: 72 Minuten pro Aufgabe gegenüber 44 bei Argon und 24 beim Spitzenreiter. Für einen nächtlichen Stapel von Due-Diligence-Prüfungen spielt das keine Rolle. Für einen Anwalt, der vor einem Termin auf einen Redline wartet, schon.
Setzen Sie Ihr eigenes monatliches Aufgabenvolumen ein, um zu sehen, wie der Tausch ausfällt:
Bei 500 Aufgaben im Monat ergeben die Vals-Zahlen etwa 75 $ für GLM-Legal gegenüber 5.275 $ für Gemini 4 Argon, mit rund 600 Agent-Stunden gegenüber 366. Muse Spark 1.2 liegt mit etwa 1.045 $ dazwischen und besteht mehr Aufgaben als beide. Wer nur auf Punkte pro Dollar schaut, für den gewinnt GLM-Legal mühelos. Wer auf bestandene Aufgaben pro Stunde schaut, für den gewinnt das Meta-Modell.
GLM-Legal: Preise und Zugang
Dieser Teil des Launchs ist weitgehend noch leer. Das ist alles, was heute öffentlich ist:
| Frage | Antwort Stand 14. Oktober 2026 |
|---|---|
| Kann ich mich anmelden und es nutzen? | Nein. Sie füllen das Beratungsformular (Unternehmen, Größe, Rolle, Anwendungsfall) aus, um API-Zugang zu beantragen |
| Gibt es einen GLM-Legal-Preis? | Nicht auf Z.ais Preisseite |
| Was kostet das Basismodell? | GLM-5.3-Flash: 0,15 $ pro 1 Mio. Input-Tokens, 0,03 $ gecacht, 0,50 $ Output |
| Mit welchem Preis hat Vals getestet? | 0,075 $ Input und 0,25 $ Output, die Flash-Einführungsaktion, die am 9. September endete |
| Kann ich es in AutoClaw nutzen? | "Soon" laut Launch-Beitrag |
| Kann ich die Gewichte herunterladen? | Heute nicht; kein GLM-Legal-Repo auf Z.ais Hugging-Face-Seite |
Die Frage nach den Gewichten ist ungeklärt. Vals' Modellkarte sagt "Weights: Open", während Z.ais Launch-Beitrag nie eine Lizenz erwähnt und mehrere HN-Leser auf ein geschlossenes Modell schlossen. Das Basismodell ist offen, wie mein GLM-5.3-Flash-Test beschreibt. Bis Z.ai Gewichte oder eine Lizenz veröffentlicht, würde ich davon ausgehen, dass GLM-Legal nur per API verfügbar ist. Eine vollständige Aufschlüsselung der Preisliste des Basismodells finden Sie unter GLM-5.3-Flash-Preise.
Das zählt aus einem Grund besonders: wohin Mandantendokumente gehen. Kanzleien, die keinen Vertrag an die API eines US-Labors schicken, schicken ihn kaum an die eines chinesischen, und eine reine API-Veröffentlichung schließt den Selbsthosting-Weg, der frühere GLM-Modelle bei datenschutzsensiblen Teams beliebt gemacht hat.
"Wait, so this not an open weight model, correct? Only available via z.ai?"
Was Anwälte und Entwickler sagen
Der HN-Thread teilte sich grob in drei Lager. Praktizierende Anwälte zeigten sich vom absoluten Wert unbeeindruckt:
"As an attorney, I am not particularly impressed about a 20% pass rate on a benchmark. The name of the game for litigation practice is about being prepared for novel situations, not relitigating past ones."
Wer den Benchmark kennt, verwies stattdessen auf die relative Position:
"To be fair to them, on this particular benchmark (Harvey's Legal Agent) 20% puts it almost top of the pack of any model, and certainly top for any remotely in its price class."
Und eine dritte Gruppe sorgte sich um das älteste Problem der Rechts-KI: erfundene Rechtsprechung. Ein Kommentator merkte an, der Launch stütze sich auf "tracked changes and human review", sage aber nichts dazu, wie man "LLMs outright hallucinating cases or holdings" abfängt. Ein anderer, ein Anwalt, brachte einen feineren Punkt zum Redlining: "I don't just see what's there but also what is missing." Eine fehlende Klausel zu erkennen ist für ein Modell schwerer, als eine vorhandene zu bearbeiten.
Auf X lautete die Top-Antwort auf Z.ais Ankündigung schlicht "We need glm illegal", mit über 1.200 Likes. Das Internet bleibt das Internet.
GLM-Legal im Vergleich zu Frontier-Modellen und Rechtsprodukten
Drei Vergleiche sollte man auseinanderhalten.
Gegenüber allgemeinen Frontier-Modellen gewinnt GLM-Legal im Agent-Test von Harvey und liegt im LegalBench ungefähr gleichauf. Claude Opus 5.5 kostet im Vals-Lauf etwa 140-mal mehr pro Aufgabe und erreicht 3,75 %. Ein allgemeines Modell ist weiterhin die bessere Wahl, wenn Ihre Rechtsarbeit mit allem anderen vermischt ist oder Sie Bildeingabe brauchen, die GLM-Legal in Vals' Tests nicht annahm.
Gegenüber Metas Muse-Spark-Reihe verliert GLM-Legal bei Wert und Tempo. Muse Spark 1.2 besteht ein Drittel mehr Aufgaben in einem Drittel der Zeit für etwa 2 $ pro Aufgabe. Wenn 2 $ pro Aufgabe in Ordnung sind, ist das Meta-Modell heute die stärkere Wahl.
Gegenüber Rechtsprodukten wie Harvey AI ist es nicht dieselbe Kategorie. Harvey verkauft die Workflows, Berechtigungen, Audit-Trails und den Kanzlei-Rollout rund um Modelle, und das spiegelt sich im Preis wider. GLM-Legal ist eine Komponente, auf der ein Legal-Tech-Unternehmen aufbauen könnte. Der HN-Kommentator, der fragte, ob das mit Harveys Margen zu tun hat, meinte genau das: Günstige Spezialmodelle machen die Produktschicht zum einzigen Teil, für den man noch Geld verlangen kann. Mein Harvey-AI-Test beschreibt, was diese Schicht tatsächlich leistet.
Wer sollte sich also für die Beta bewerben? Legal-Tech-Teams mit hohem Volumen und nächtlicher Erstprüfung (Due Diligence, Vertragsvorsortierung, Discovery-Chronologien), bei denen ohnehin ein Mensch jede Ausgabe prüft. Dort sind 0,15 $ und 72 Minuten ein hervorragender Tausch. Alle anderen können auf Preise, Gewichte und eine unabhängige Bewertung von jemandem warten, der es an echten Mandaten laufen ließ. Wenn Sie ein fertiges Werkzeug statt eines Modells suchen, ist meine Liste von KI-Schreibwerkzeugen für Kanzleien der bessere Einstieg.
Was GLM-Legal für ein Support-Team bedeutet
Die meisten, die über ein Rechtsmodell lesen, arbeiten nicht in einer Kanzlei. Sie leiten ein Support- oder Ops-Team, das Fragen mit rechtlichem Einschlag beantwortet: Erstattungsbedingungen, Gewährleistungsfälle, Löschanfragen, "can you send me a copy of my data under GDPR."
Ein Rechtsmodell ist dafür das falsche Werkzeug. Diese Fragen betreffen nicht Rechtsprechung. Sie betreffen Ihre Richtlinie, festgehalten in Ihrem Help Center und Ihren internen Dokumenten, und die richtige Antwort ist, was Ihre Richtlinie sagt, auch wenn ein klügeres Modell anders argumentieren könnte. Das ist ein Retrieval-Problem mit Übergabe an einen Menschen, kein Denkproblem.
Ich baue seit Jahren bei eesel die Agenten, die in echten Support-Warteschlangen sitzen, und die Lehre aus dem Benchmark von GLM-Legal ist die, die wir immer wieder neu lernen: Die gefährliche Ausgabe ist die, die 90 % der Prüfungen besteht. Ein Support-Leiter einer DTC-Nahrungsergänzungsmarke formulierte die Anforderung in einem Gespräch mit uns klar:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Deshalb testen wir jeden eesel-Rollout an den historischen Tickets eines Teams, bevor er einem Live-Kunden antwortet, und deshalb kann alles, was Erstattungen, rechtliche Drohungen oder Datenschutz-Compliance betrifft, direkt an eine Person geleitet werden. Unser Halluzinations-Leitfaden beschreibt die Einrichtung. Wenn Sie selbst Rechtsmandanten betreuen, geht KI-Kundenservice für Juristen tiefer auf diesen Fall ein.
eesel ausprobieren
GLM-Legal ist Infrastruktur: ein Modell, das Sie beantragen, in einen Harness einbinden, mit Prompts versehen, überwachen und pro Token bezahlen. eesel ist der Mitarbeiter. Der KI-Helpdesk-Teammate steigt in Ihre bestehende Warteschlange in Zendesk, Freshdesk, Gorgias und den übrigen ein, lernt Ihre Erstattungs-, Gewährleistungs- und Datenrichtlinien aus Ihrem Help Center und vergangenen Tickets und übergibt alles, bei dem er unsicher ist, mit einer Zusammenfassung an einen Menschen. Bevor er irgendjemandem antwortet, können Sie ansehen, wie er hunderte Ihrer historischen Tickets beantwortet hätte.

Wenn Ihr Team ihn lieber vom Terminal aus steuert, können Sie mit der eesel CLI die Standardregeln des Teammates lesen und bearbeiten, auf Freigabe wartende Aktionen prüfen und sehen, was er getan hat und warum, sodass ein Coding-Agent Ihren Support-Teammate so verwalten kann wie Ihr Repo. Wenn Sie stattdessen Inhalte schreiben, gehört zum selben Team auch ein KI-Blog-Autor.
Sie wollen eine KI, die Richtlinienfragen aus Ihren eigenen Richtlinien beantwortet und weiß, wann sie aufhören muss? Testen Sie eesel an den Tickets des letzten Monats und sehen Sie, welche er bearbeitet hätte.