

IBM hat Granite 4.2 am 25. August 2026 veröffentlicht: eine Familie von Reasoning-Modellen mit offenen Gewichten in drei Größen, 3B, 8B und 30B, alle unter einer Apache-2.0-Lizenz. Die wichtigste Änderung ist natives „Denken": Schritt-für-Schritt-Reasoning ist jetzt im Modell eingebaut und lässt sich zwischen vollständig, geringem Aufwand und aus umschalten.
Die Modelle sind klein, günstig und ehrlich darin, wofür sie gedacht sind: agentische Unternehmensaufgaben, Tool-Calling und strukturierte Aufgaben, die du auf eigener Hardware laufen lassen kannst. Die Untergrenze ist kostenlos, weil die Gewichte offen sind, und der günstigste gehostete Tarif, den ich bestätigen konnte, ist Replicates 8B mit 0,06 $/0,25 $ pro Million Tokens. Bei den Benchmarks ist das 30B-Modell wirklich stark (57,0 auf SWE-Bench Verified), auch wenn die Local-LLM-Szene weiter zu Qwen greift, wenn es nur um rohe Coding-Leistung geht.
Eines vorab, weil ich beruflich Support-KI baue: Ein Modell ist kein Produkt. Granite 4.2 ist ein hervorragender Motor. Wenn du eigentlich einen KI-Agenten willst, der Tickets löst, ist das Modell die leichten 10 %, Wissen, Integrationen und Leitplanken sind die anderen 90 %. Mehr dazu am Ende.
Was ist IBM Granite 4.2?
Granite ist IBMs Familie offener Modelle für Unternehmen, und 4.2 ist die Release mit Reasoning-Fokus. Sie kam als drei Checkpoints heraus, granite-4.2-3b, granite-4.2-8b und granite-4.2-30b, jeweils nachtrainiert aus dem passenden Granite-4.1-Basismodell. Daneben hat IBM auch zwei winzige Granite-Speech-5.0-Transkriptionsmodelle veröffentlicht, aber der Name „4.2" bezieht sich eigentlich auf diese drei Sprachmodelle.
Ich habe die letzten Jahre damit verbracht, KI in live betriebene Support-Warteschlangen zu bringen, und bei jedem neuen offenen Modell schaue ich zuerst nicht auf den Top-Benchmark, sondern auf Lizenz und Deployment. Hier schneidet Granite gut ab: Die Gewichte stehen unter Apache 2.0, die Modelle sind kryptografisch signiert und ISO-zertifiziert, und die Familie erhielt Spitzenbewertungen im Foundation Model Transparency Index der Stanford University. Für ein reguliertes Team, das das Modell in den eigenen vier Wänden betreiben muss, zählt diese Kombination mehr als ein paar Benchmark-Punkte.
IBMs Versprechen lautet „konkurrenzfähig mit größeren Denkmodellen, zu einem Bruchteil der Kosten". Das ist die interessante Wette, und sie sollte man prüfen, statt sie zu wiederholen, also schauen wir uns die tatsächliche Aufstellung an.
Die Modellpalette: 3B, 8B und 30B
So unterscheiden sich die drei Größen bei den Specs, die entscheiden, wo jede laufen kann. Alle drei sind dichte Decoder-only-Transformer, die Parameterzahl ist also das ganze Modell, hier versteckt sich kein Mixture-of-Experts-Trick mit kleinerer aktiver Größe.
| Modell | Parameter | Schichten | Kontext | Basismodell | Am besten für |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B (dicht) | 40 | 128K | granite-4.1-3b-base | Laptops und Edge, schnelle einfache Aufgaben |
| granite-4.2-8b | 8B (dicht) | 40 | 128K | granite-4.1-8b-base | Allzweck-Unternehmensaufgaben |
| granite-4.2-30b | 30B (dicht) | 64 | 128K (512K erweitert) | granite-4.1-30b-base | Komplexes Reasoning und Agenten |
Jede Größe verarbeitet nativ ein Kontextfenster von 128K Tokens, und das 30B lässt sich auf 512K dehnen. IBM liefert außerdem offizielle quantisierte Builds jeder Größe (fp8, mxfp4, nvfp4), die den Speicherbedarf senken, sowie GGUF-Konvertierungen aus der Community für llama.cpp und LM Studio. Wenn du eine Sicherheitsschicht willst, verweisen die Model Cards auf das separate Granite Guardian 4.1 8B zur Risikoerkennung.
Das Schwierigste ist für die meisten schlicht die Wahl der Größe. Hier ein kurzer Leitfaden, je nachdem, wofür du optimierst.
Was wirklich neu ist: natives Reasoning zum Umschalten
Die eigentliche Geschichte von 4.2 ist, dass Reasoning jetzt fest eingebaut ist. Frühere Granite-Modelle antworteten direkt, 4.2 kann ein Problem zuerst in <think>...</think>-Tags durchdenken, bevor es sich auf eine Antwort festlegt, was bei Mathe, Coding und jeder mehrstufigen Logik hilft. Praktisch macht es, dass IBM das Reasoning in einem einzigen Modell umschaltbar gemacht hat, du pflegst also keine getrennten „Reasoning"- und „Chat"-Checkpoints.
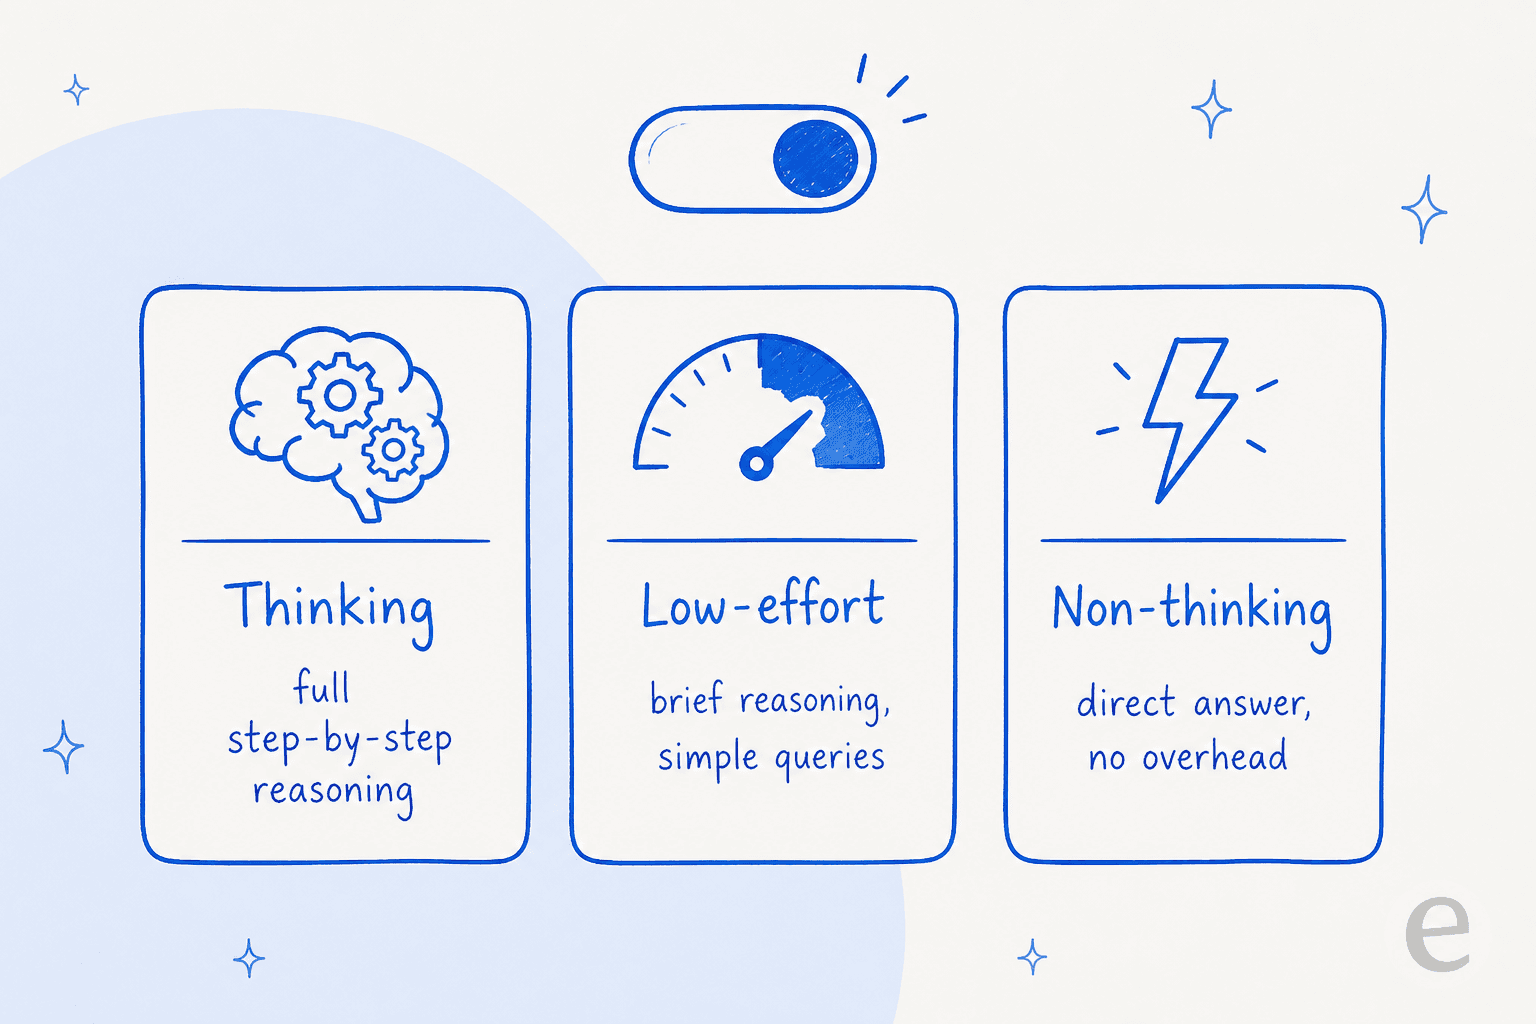
Es gibt drei Modi, und die Wahl des richtigen ist meist eine Kostenentscheidung:
- Thinking (der Standard): volle Chain-of-Thought. Am besten für schwieriges Reasoning, am schlechtesten für Latenz und Token-Verbrauch.
- Low-effort: ein kurzer Reasoning-Durchgang für einfachere Anfragen, ein Mittelweg, der einen Teil der Genauigkeit ohne den vollen Aufwand behält.
- Non-thinking: eine direkte Antwort ganz ohne Reasoning-Tokens, wenn du nur Tempo brauchst.
In Ollama wechselst du mit /set think und /set nothink zwischen ihnen. Das ist in der Produktion wirklich nützlich, denn „immer nachdenken" ist teuer und „nie nachdenken" ist dumm, und die meisten realen Workloads wollen je nach Anfrage beides mischen. Wenn du schon einmal einen Support-Bot abgestimmt hast, ist das derselbe Zielkonflikt wie die Entscheidung zwischen Eskalieren und automatisch Beantworten.
Tool-Calling mit Reasoning
Das andere Upgrade, und das, das IBM erkennbar am wichtigsten ist, ist das Tool-Calling. Granite 4.2 wurde darauf trainiert, zu überlegen, welches Tool es aufruft und warum, bevor es den Aufruf macht, statt nur einen Funktionsnamen per Mustervergleich zu treffen. In der Praxis plant das Modell, ruft ein Tool auf, prüft das Ergebnis und kann sich selbst korrigieren.
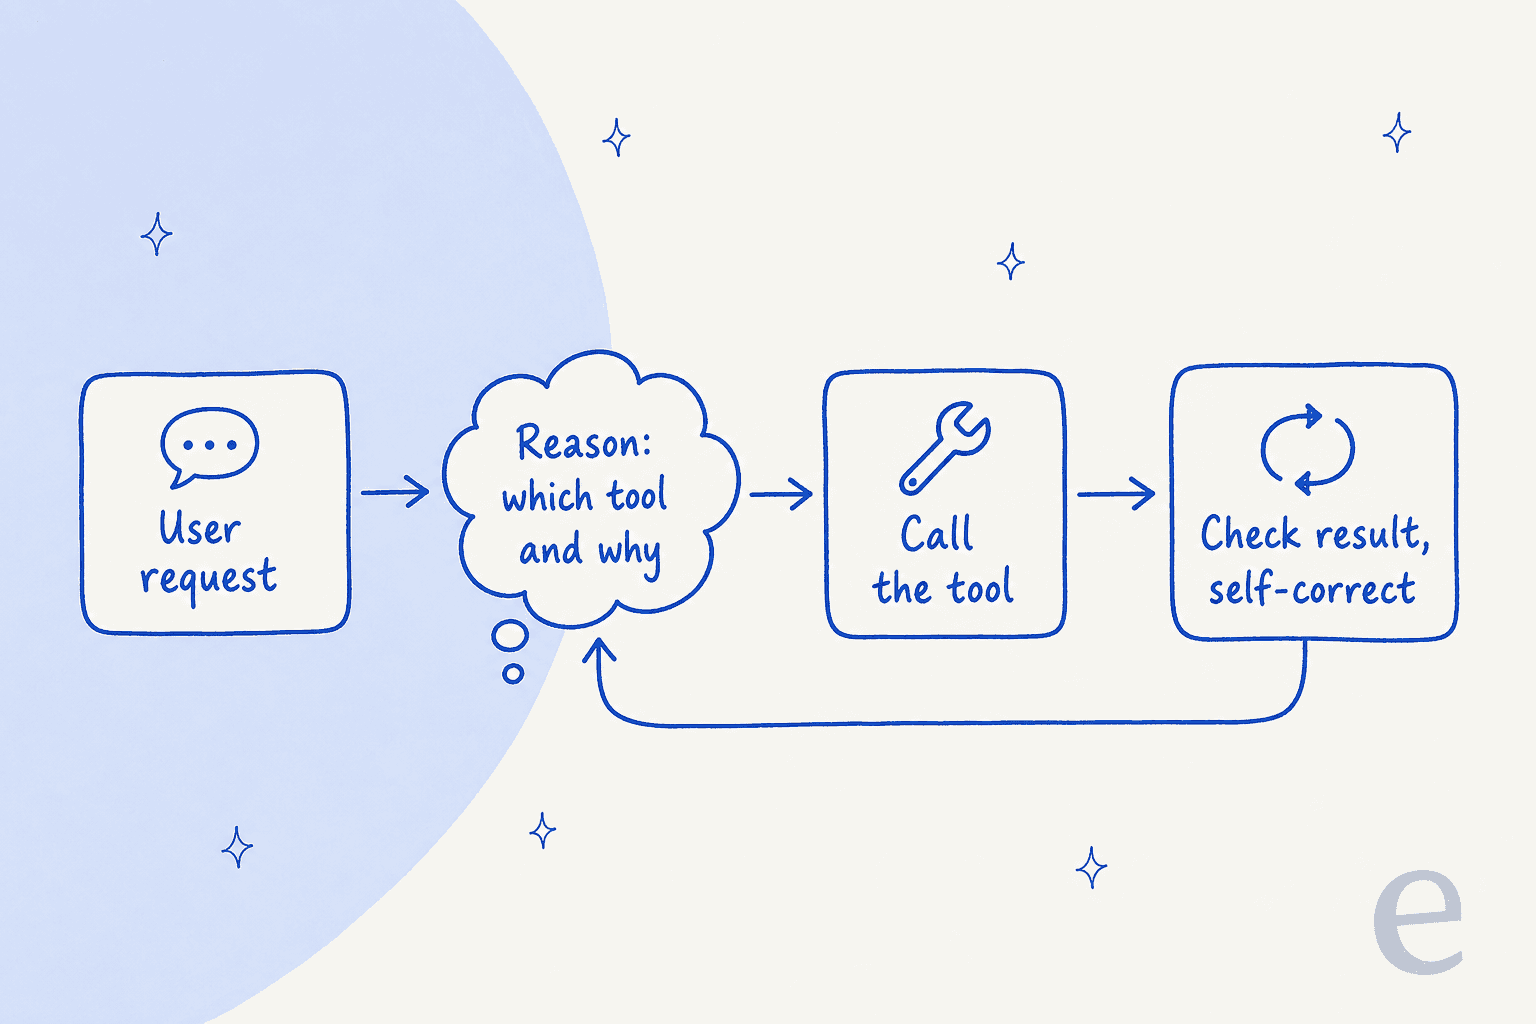
Es bietet eine OpenAI-kompatible API und funktioniert sofort mit agentischen Coding-Harnesses wie OpenCode, Pi und OpenHands, und es ist für das Serving auf vLLM optimiert (v0.20+) sowie SGLang. Dieser Teil lässt 4.2 eindeutig auf die KI-Agenten-Szene zielen statt auf Chatbots. Man sollte auch nüchtern bleiben: Zuverlässiges Tool-Calling in einer Demo ist nicht dasselbe wie zuverlässiges Tool-Calling gegen deine unaufgeräumten Produktivsysteme, und genau deshalb simulieren wir jeden Rollout mit echten historischen Daten, bevor er einen Live-Kunden berührt.
Dicht statt hybrid: die Änderung gegenüber Granite 4.0
Das ist eine Nuance, über die viele stolpern, also einen Absatz wert. Granite 4.0 nutzte eine hybride Mamba-2/Transformer-Architektur mit einer Mixture-of-Experts-Schicht (MoE), die IBM mit geringerem Speicherbedarf und schnellerer Inferenz bewarb. Granite 4.2 geht den anderen Weg: Es ist ein schlichter dichter Decoder-only-Transformer, nachtrainiert aus der dichten Granite-4.1-Basis.
Warum ist das für dich wichtig? Bei einem dichten Modell gibt es keine Aufteilung in „aktive versus gesamte" Parameter, ein dichtes 30B-Modell braucht also bei jedem Token etwa die Rechenleistung von 30B Parametern. Das ist pro Token schwerer als ein vergleichbares MoE, aber einfacher nachzuvollziehen, breit kompatibel mit Standard-Tooling und vorhersagbar im Deployment. IBMs eigene Formulierung lautet, „its dense architecture supports broad compatibility", eine faire Art zu sagen, dass es etwas Effizienz gegen deutlich weniger Reibung beim Deployment tauscht.
Wie Granite 4.2 bei Benchmarks abschneidet
Hier sind die Zahlen, die IBM auf den Model Cards veröffentlicht hat, und zwar die Werte, in denen beide offiziellen Tabellen von IBM übereinstimmen. Ich habe mich auf die Benchmarks beschränkt, die einen Käufer wirklich interessieren.
| Benchmark | 3B | 8B | 30B |
|---|---|---|---|
| SWE-Bench Verified (Coding) | NA | 47.67 | 57.00 |
| Terminal-Bench 2.1 | NA | 20.56 | 29.24 |
| AIME25 (mathematisches Reasoning) | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU-Pro | 67.84 | 74.04 | 77.60 |
| Arena-Hard-V2 | 34.96 | 65.19 | 67.93 |
| RULER 128K (langer Kontext) | 55.30 | 71.41 | 81.38 |
Für diese Größen sind das starke Ergebnisse, besonders das 30B bei Coding und Mathe. Aber hier will ich ehrlich mit dir sein, denn es ist das Nützlichste in diesem Abschnitt: IBM vergleicht Granite hauptsächlich mit früheren Granite-Versionen und stellt die neuen Modelle gegen Nemotron 3 Super und Gemma 4, statt gegen die Modelle, die die meisten Leute tatsächlich lokal betreiben. Das schränkt ein, wie viel diese Tabellen aussagen.
Die Einschätzung der Community ist skeptischer, und zwar zu Recht. Wie ein Hacker-News-Kommentator nach der 4.1-Release schrieb:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."

Betrachte die Benchmarks also als „Granite ist deutlich besser geworden als das letzte Granite", was stimmt und nützlich ist, und nicht als „Granite schlägt alles in seiner Größe", was die Tabellen gar nicht zeigen.
Was die Leute sagen
Unabhängige Praxistests speziell zu 4.2 sind noch dünn gesät, da es erst wenige Tage alt ist, aber die Stimmung zu Granite 4.x ist gut etabliert und einheitlich. Das Lob ist echt: Die kleinen Modelle laufen schnell auf Standardhardware und sind still hervorragend bei fundierten, strukturierten Aufgaben.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
Die Kritik ist genauso einheitlich und kommt in zwei Varianten. Erstens: Bei der rohen Leistung bewertet die Local-LLM-Szene für Coding und agentisches Reasoning weiterhin Qwen höher:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Zweitens gibt es einen praktischen Haken, den du kennen solltest, bevor du das 8B ziehst: Mehrere Leute haben erlebt, dass sich der Speicherbedarf nach dem Laden weit über die Downloadgröße aufbläht, wegen des KV-Caches des langen Kontextfensters.
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"

Die Lösung ist meist, die Kontextlänge beim Laden zu begrenzen, aber es ist eine echte Falle, wenn man annimmt, die Downloadgröße sei die Speichergröße.
Was es kostet und wie du es betreibst
Weil die Gewichte offen sind, ist der günstigste Weg, Granite 4.2 zu betreiben, kostenlos: Zieh es mit Ollama oder Hugging Face und zahle nur für deine eigene Rechenleistung. Das kostet jede Variante tatsächlich.
| Weg | Was du zahlst | Hinweise |
|---|---|---|
| Self-Hosting (Ollama / Hugging Face / vLLM) | 0 $ an Lizenz | Apache 2.0; die Hardware trägst du. Das 3B ist ein laptopgroßer Download von 2,2 GB |
| Replicate (granite-4.2-8b) | 0,06 $ / 1 Mio. Input, 0,25 $ / 1 Mio. Output | Günstigster bestätigter gehosteter Preis pro Token; ca. 0,0014 $ pro typischem Aufruf |
| IBM watsonx.ai | Pay-as-you-go pro 1 Mio. Tokens + stündliches Hosting | Standard-Tarif ca. 1.050 $/Monat; Abrechnung in Resource Units (1 RU = 1.000 Tokens) |
Ein Hinweis zu watsonx: Die aktuelle Preistabelle für die Granite-4.2-Position lieferte bei meiner Prüfung einen Fehler, daher konnte ich keinen genauen 4.2-Preis pro Token direkt bestätigen. Der nächste bestätigte Tarif der Granite-4-Familie in IBMs Dokumentation liegt bei etwa 0,06 $ pro 1 Mio. Input und 0,27 $ pro 1 Mio. Output, und das Preismodell (Pay-as-you-go pro Million Tokens plus stündliches Hosting) ist bestätigt. Zum Zeitpunkt des Schreibens listete OpenRouter weiterhin nur Granite 4.0 und 4.1, nicht 4.2.
Für einen echten Kostenvergleich ist das Self-Hosting des 3B auf Hardware, die du schon besitzt, so nah an kostenloser Inferenz, wie es nur geht, und das ist ein großer Grund, warum Teams, denen Datenschutz wichtig ist, die Granite-Familie mögen. Wenn du sie mit einem gehosteten Produkt vergleichst, ist unsere Aufschlüsselung der KI-Lösungsrate ein besserer Maßstab als der reine Token-Preis.
Wer sollte Granite 4.2 tatsächlich nutzen?
Nach allem, was ich durchgesehen habe, hier meine ehrliche Einschätzung.
Greif zu Granite 4.2, wenn du ein offenes, lizenzierbares Modell brauchst, das du on-prem betreiben kannst, wenn dir strukturierte und fundierte Aufgaben wichtig sind (Tool-Calling, Zusammenfassung, Extraktion, Tagging) und du umschaltbares Reasoning willst, ohne zwei Checkpoints zu jonglieren. Das 8B ist ein fantastischer Standard für Unternehmensautomatisierung, und das 3B ist ein wirklich gutes „läuft auf dem Laptop"-Modell. Es passt außerdem natürlich zu einer Retrieval-Schicht, denn diese Modelle glänzen, wenn sie auf deinen eigenen Dokumenten fußen, statt aus dem Gedächtnis zu antworten.
Schau dich anderweitig um, wenn deine einzige Priorität erstklassiges Coding oder agentisches Reasoning um jeden Preis ist, wo der Konsens der Community weiterhin auf Qwen zeigt, oder wenn du ein verwaltetes Komplettprodukt statt eines Modells zum Daraufbauen willst. Granite ist ein hervorragendes Modell, keine fertige Anwendung, und die Lücke zwischen beidem ist der Ort, an dem die meisten Support-KI-Projekte tatsächlich gelingen oder scheitern.
Vom Modell zum Teammitglied: wo eesel ins Spiel kommt
Das ist der Teil, der mir am wichtigsten ist, weil es der Fehler ist, den ich Teams immer wieder machen sehe. Ein rohes Modell wie Granite 4.2 ist ein Motor. Ein sehr guter Motor. Aber ein Motor ist keine Neueinstellung.
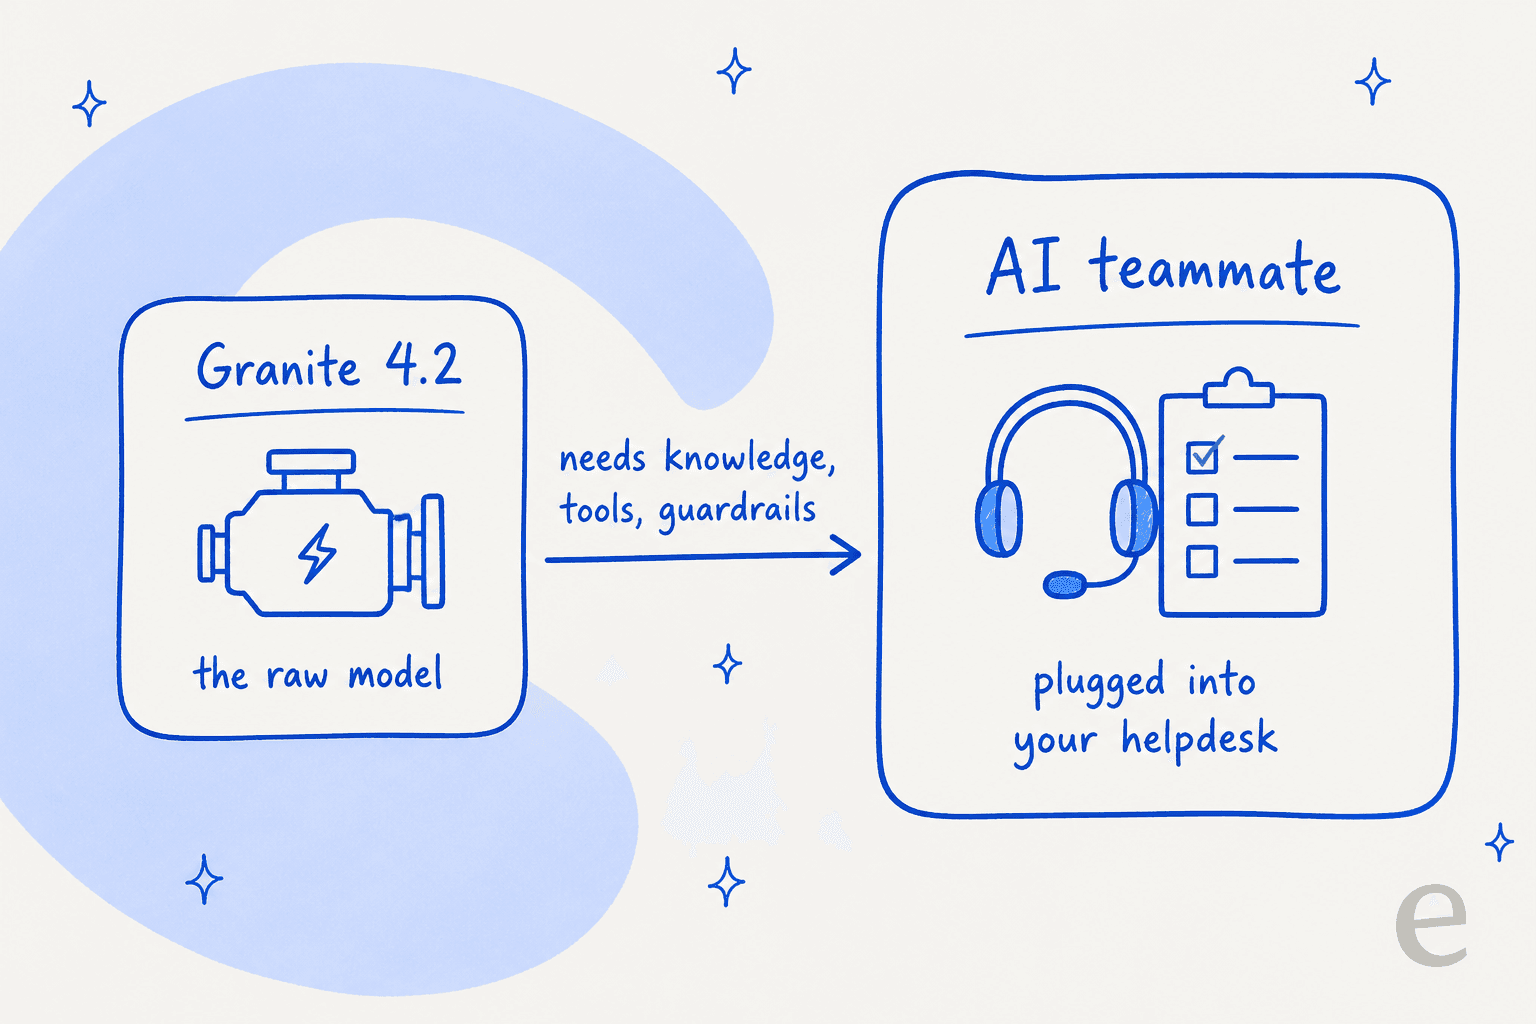
eesel verkauft das fertige Teammitglied, nicht den Motor. Das KI-Helpdesk-Teammitglied wird in das Helpdesk eingebunden, das du schon nutzt, sei es Zendesk, Freshdesk, Gorgias oder ein gemeinsames Postfach, lernt aus deinen vergangenen Tickets und deiner Wissensdatenbank und entwirft oder sendet Antworten direkt in deinen bestehenden Tools. Was Granite 4.2 dir bietet, natives Reasoning und Tool-Calling, ist hier Grundvoraussetzung, die harten 90 % sind der Unternehmenskontext, die Integrationen und das Sicherheitsnetz drumherum.

Und der Teil, ohne den ich keinen Support-Bot ausliefern würde: Mit eesel kannst du das Teammitglied an Tausenden deiner echten historischen Tickets simulieren, bevor es je mit einem Kunden spricht. So siehst du Lösungsrate und genaue Antworten schon vor dem Go-live, statt einen Schalter umzulegen und zu hoffen. Wir haben das gebaut, weil wir gesehen haben, wie selbstsicher klingende Bots stillschweigend falsche Antworten geben, und der Test an deinen eigenen Tickets ist das Einzige, was das auffängt.
Wenn du Granite 4.2 prüfst, weil du den Support automatisieren willst, ist das die Abkürzung, die man kennen sollte: Du kannst eesel kostenlos ausprobieren, dein Helpdesk in wenigen Minuten verbinden und sehen, wie ein einsatzbereites Teammitglied deine echten Tickets bearbeitet, ohne selbst ein Modell aufsetzen und betreuen zu müssen. Und wenn das Schreiben die Aufgabe ist, treibt dieselbe Idee auch das Teammitglied KI-Blog-Writer an.
Häufig gestellte Fragen
Was ist IBM Granite 4.2?
IBM Granite 4.2 ist eine Familie von Reasoning-Sprachmodellen mit offenen Gewichten, die am 25. August 2026 in drei Größen erschienen ist: 3B, 8B und 30B Parameter. Alle drei stehen unter der Apache-2.0-Lizenz, unterstützen ein Kontextfenster von 128K und bringen natives Chain-of-Thought-Reasoning mit, das sich ein- und ausschalten lässt. Sie sind gebaut für KI im Kundenservice, Coding und agentische Tool-Nutzung.
Was kostet der Betrieb von Granite 4.2?
Die Untergrenze ist kostenlos: Die Gewichte stehen unter Apache 2.0, also kannst du selbst über Ollama oder Hugging Face hosten und zahlst nur für deine eigene Hardware. Der günstigste bestätigte gehostete Tarif ist Replicates granite-4.2-8b mit 0,06 $ pro 1 Mio. Input-Tokens und 0,25 $ pro 1 Mio. Output-Tokens. IBMs eigenes watsonx.ai rechnet pro Million Tokens plus stündliches Hosting ab, mit einem Standard-Tarif von rund 1.050 $/Monat.
Ist Granite 4.2 gut für Coding und Agenten?
Das 30B-Modell erreicht 57,0 auf SWE-Bench Verified und bringt Tool-Calling mit Reasoning, daher ist es für agentische und Coding-Aufgaben glaubwürdig. Bei der reinen Coding-Leistung bewertet die Local-LLM-Community Qwen weiterhin tendenziell höher. Wenn dein Ziel ein KI-Agent ist, der Support-Tickets löst, ist das Modell nur der Motor: Wissen, Tools und Leitplanken brauchst du trotzdem drumherum.
Wie unterscheidet sich Granite 4.2 von Granite 4.0?
Granite 4.0 nutzte ein hybrides Mamba-2/Transformer-Design mit einer Mixture-of-Experts-Schicht. Granite 4.2 ist ein dichter Decoder-only-Transformer, der auf Basis von Granite 4.1 nachtrainiert wurde, und seine wichtigste Neuerung ist das umschaltbare native Reasoning. Dicht bedeutet, dass es keine Aufteilung in aktive und gesamte Parameter gibt: Die Größe, die du herunterlädst, ist die Größe, die läuft.
Kann ich Granite 4.2 kostenlos kommerziell nutzen?
Ja. Die Apache-2.0-Lizenz erlaubt uneingeschränkte kommerzielle und Forschungsnutzung, Fine-Tuning und Self-Hosting ohne Lizenzgebühr pro Token. Für die Rechenleistung bist du selbst verantwortlich. Für einen Support-Einsatz macht erst die Kombination mit einer KI-Helpdesk-Agent-Schicht wie eesel aus dem rohen Modell etwas, das deine Warteschlange tatsächlich abarbeitet.