

Sakana AI hat Fugu Max am 11. September 2026 veröffentlicht, und es ist kein gewöhnliches Modell. Fugu Max ist die Preis-Leistungs-Stufe der Fugu-Familie und im Kern ein gelerntes Orchestrierungssystem: Ein schlanker Koordinator liest deine Anfrage und leitet sie an das sparsamste geeignete Modell in einem Pool aus Open-Weight- und spezialisierten Modellen weiter, darunter NVIDIA Nemotron, alles hinter einer OpenAI-kompatiblen API.
Das Verkaufsargument ist Geld. Bei 2 $ pro Million Input-Tokens und 6 $ pro Million Output-Tokens, pauschal unabhängig von der Kontextlänge, ist der Output laut Sakana in seinem Release-Beitrag 40-60 % günstiger als bei Sonnet 5, GPT 5.6 Terra und Kimi K3, und liegt dabei "within striking distance of elite models." Der Haken: Die Benchmarks stammen vom Hersteller, die Weiterleitung ist bewusst intransparent, es ist in der EU nicht verfügbar, und die besten proprietären Modelle sind absichtlich nicht im Pool.
Wenn du eine App baust, ist Fugu Max ein wirklich interessanter Weg, Output auf Frontier-Niveau (fast) zu einer niedrigeren Rechnung zu bekommen. Wenn deine eigentliche Aufgabe darin besteht, Support-Tickets zu lösen, ist ein Modell nur der Motor. Du musst immer noch den Mitarbeiter darum herum bauen, und genau diesen Teil bekommst du bei einem KI-Teammate wie eesel schon fertig zusammengebaut.
Was Sakana Fugu Max eigentlich ist
Die meisten Modell-Launches liefern dir ein größeres Modell. Sakana hat etwas Merkwürdigeres gemacht: Fugu Max ist ein Modell, das andere Modelle aufruft.
Das klingt nach Marketing, bis man sich den Mechanismus ansieht. Sakana AI ist ein Forschungslabor in Tokio, 2023 von drei ehemaligen Google-Leuten gegründet, darunter CTO Llion Jones, einer der acht Autoren des ursprünglichen Transformer-Papers "Attention Is All You Need". Die ganze Wette des Labors: Die Zukunft der KI ist "a vast collection of small AI systems", die wie ein Fischschwarm zusammenarbeiten, statt eines riesigen Monolithen. Fugu ist dieser Gedanke als Produkt.
Fugu Max ist das vierte Modell der Familie, und der Wechsel zwischen ihnen ist eine Parameteränderung in einer Zeile über dieselbe API:
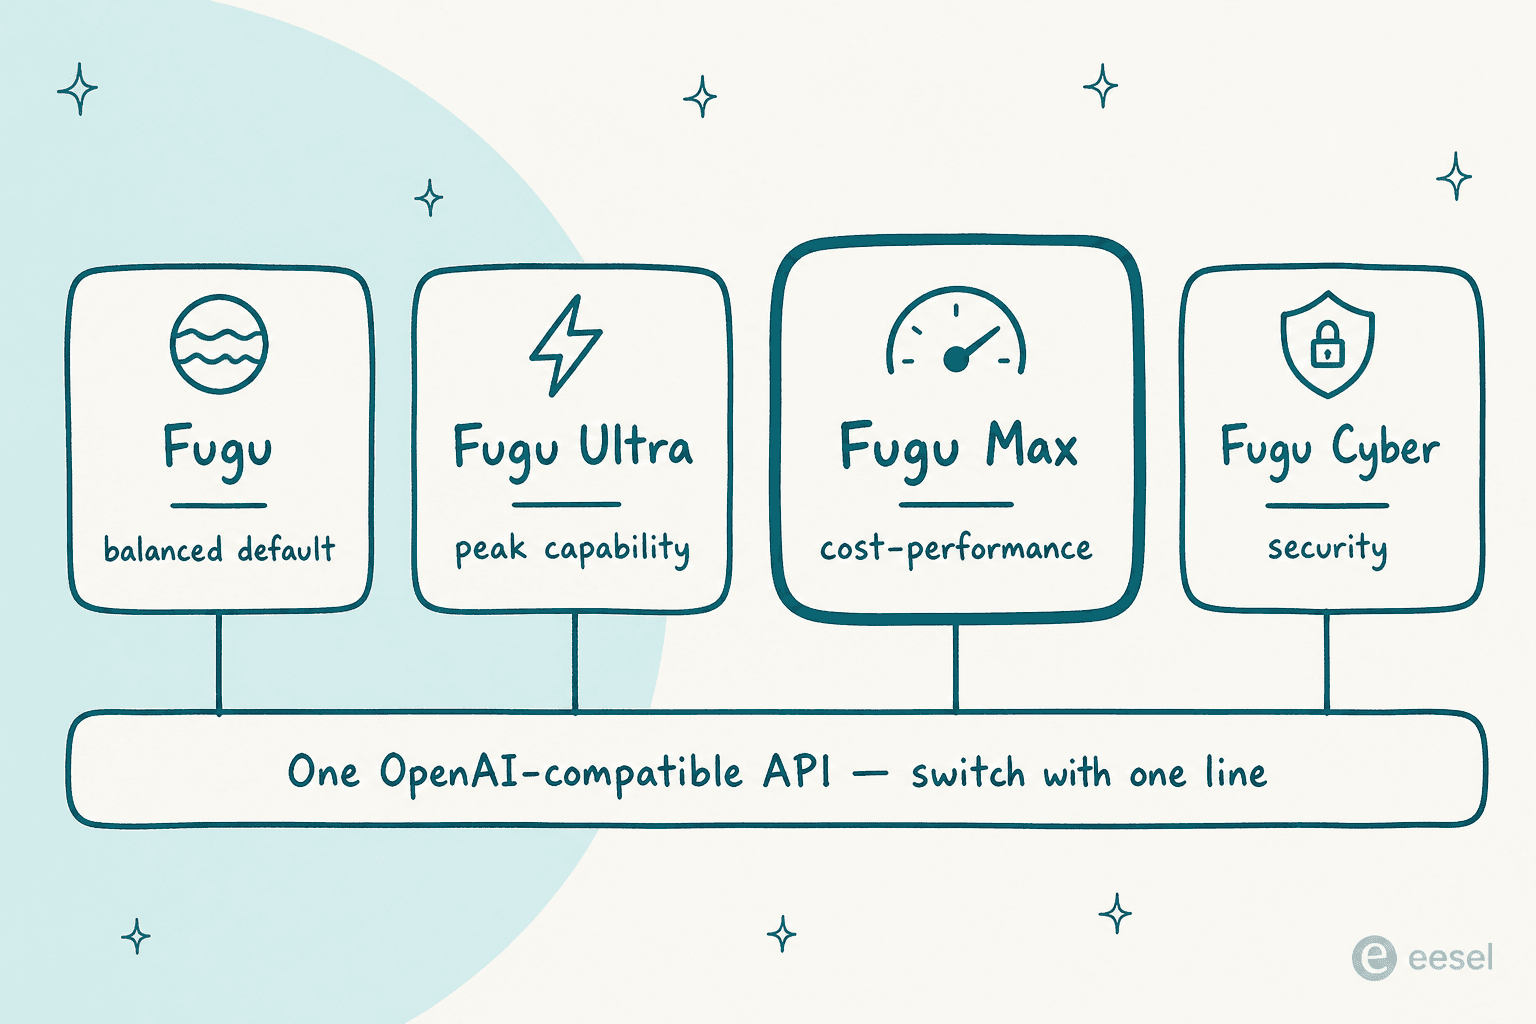
- Fugu balanciert Leistung und Latenz, der Standard für den Alltag.
- Fugu Ultra (jetzt v2) ist auf maximale Antwortqualität bei schwierigen Problemen mit hohem Einsatz getrimmt.
- Fugu Max ist auf Preis-Leistung getrimmt und orchestriert den größten Pool der Familie.
- Fugu Cyber ist auf Sicherheitsarbeit wie Schwachstellenforschung spezialisiert.
Der Release-Beitrag rahmt Fugu Max mit einer Frage: "What is the best possible output we can deliver at the lowest possible cost?" Die Antwort: den Pool der ansteuerbaren Modelle erweitern, "an unprecedented number of open-weights and specialized models" einbinden und dann jede Teilaufgabe an das günstigste Modell schicken, das sie tatsächlich bewältigt. Sakana nennt Max und Ultra v2 "not separate products", sondern "the same core orchestration architecture optimized for two distinct missions": Max drückt die Rechnung, Ultra hebt die Obergrenze.
Wie die Orchestrierung tatsächlich funktioniert
Das ist der Teil, den ich wirklich clever finde. Wenn du Fugu Max aufrufst, sprichst du nicht mit einem einzelnen Netz aus Gewichten. Du sprichst mit einem Koordinator, der pro Anfrage entscheidet, wer die Arbeit macht.
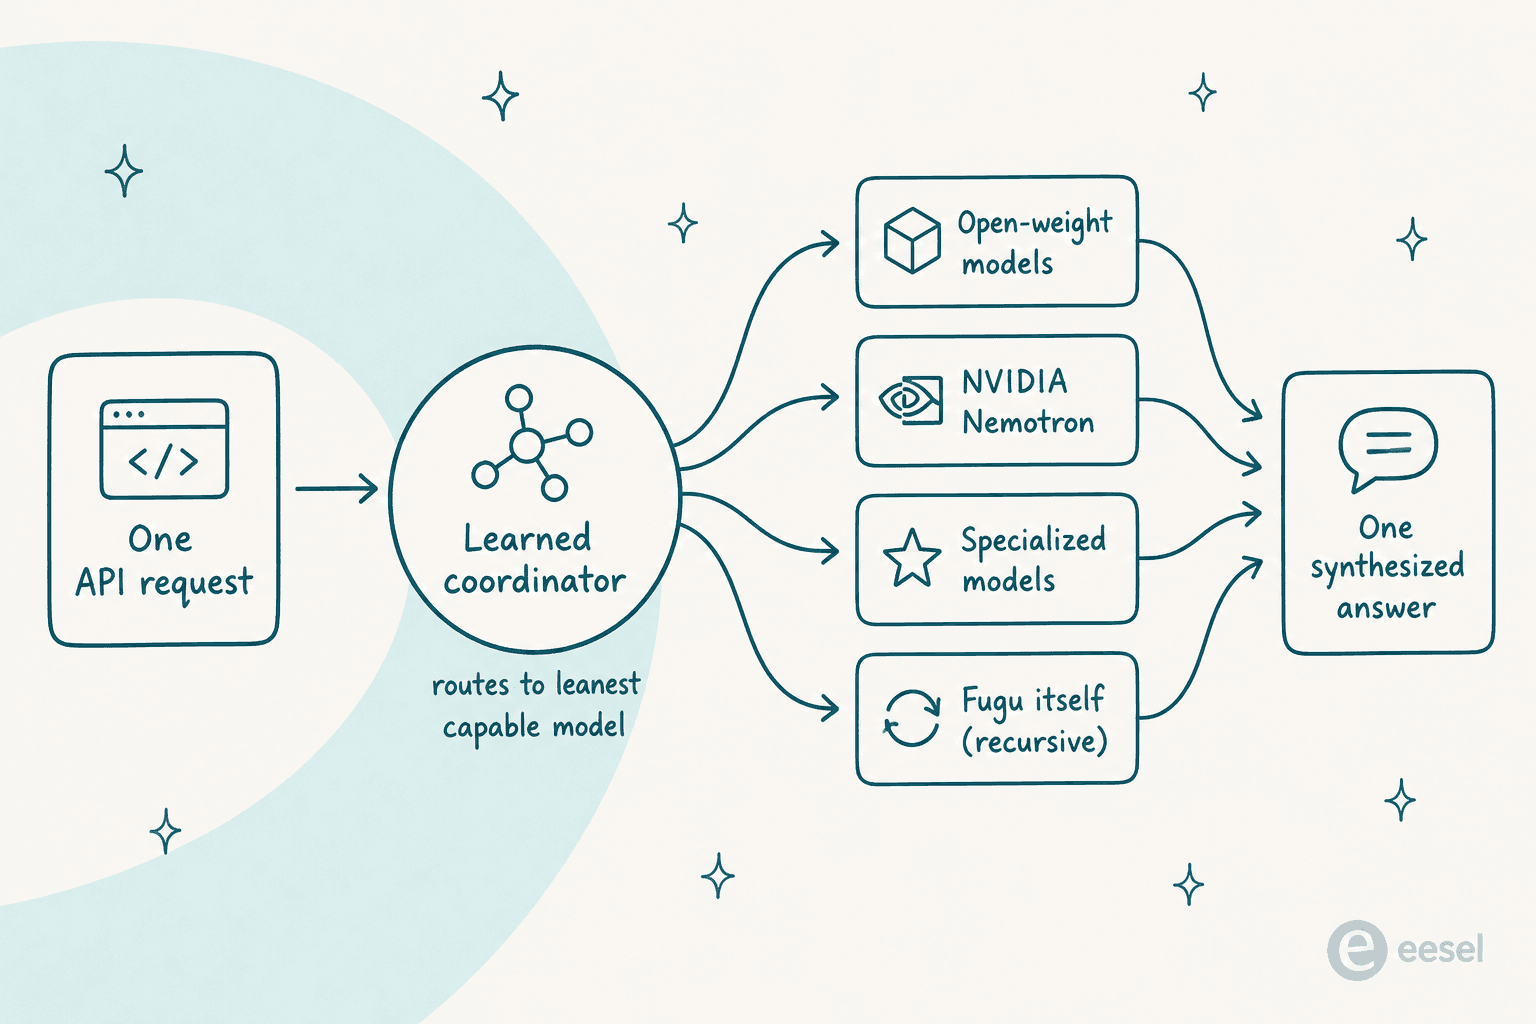
Der Koordinator selbst ist ein kleines, zur Orchestrierung trainiertes Modell, das auf zwei ICLR-2026-Papers beruht. TRINITY ist ein evolvierter Koordinator, der über mehrere Runden die Rollen Thinker, Worker und Verifier auf eine Reihe von LLMs verteilt. The Conductor wird mit Reinforcement Learning trainiert, um Koordinationsstrategien in natürlicher Sprache zu entdecken, sodass ein vielfältiger Pool jeden einzelnen Worker schlägt. Einfach gesagt: Das System hat das Delegieren gelernt, statt einer handgeschriebenen Pipeline zu folgen, und es kann sogar Instanzen von sich selbst rekursiv aufrufen.
Das Architekturdiagramm von Sakana zeigt dieselbe Idee, von der Anfrage über die Weiterleitung bis zur zusammengeführten Antwort:
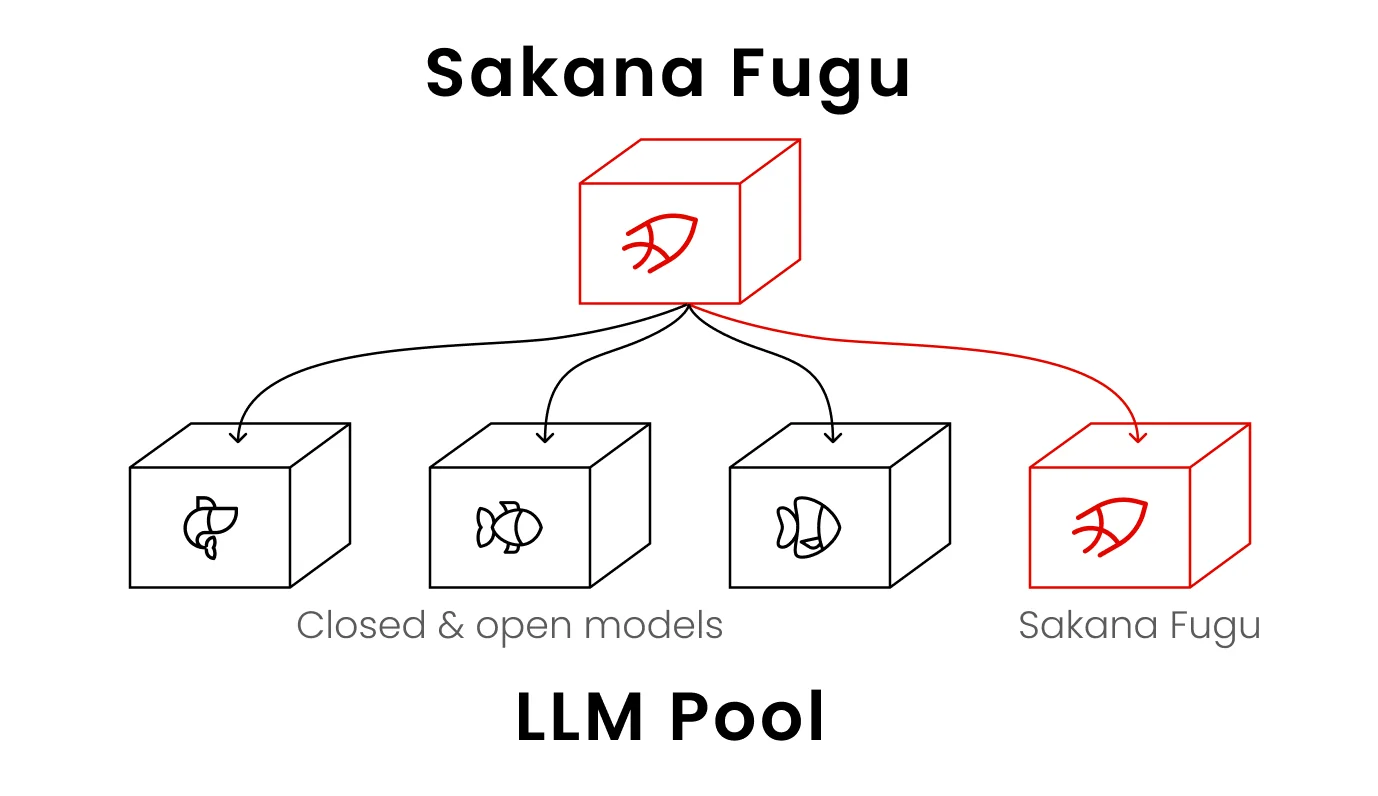
Für Entwickler liegt der Reiz darin, dass sich all das hinter einem Endpunkt versteckt. Du bekommst den Vorteil eines Multi-Agent-Systems, Expertenmodelle je nach Aufgabe, ohne dieses System selbst bauen und pflegen zu müssen. Das ist ein echtes Echo darauf, wie gute KI-Agenten funktionieren sollen: für jeden Schritt das richtige Werkzeug wählen, statt ein Modell alles machen zu lassen.
Ein paar Details zur Max-Variante, von der OpenRouter-Modellseite:
- 1 Million Tokens Kontext, mit Text-, Bild- und PDF-Eingaben und Text-Ausgabe.
- Konfigurierbarer Reasoning-Aufwand auf high, xhigh und max.
- Function Calling, strukturierte Ausgaben und integrierte Websuche und Fetch.
- Der Agent-Pool ist fest. Anders als beim Basismodell Fugu kannst du bei Fugu Max einzelne Modelle nicht über die Konsole ein- oder ausschließen.
- Orchestrierungs-Tokens werden wie normale Tokens abgerechnet. Der interne Datenverkehr zwischen den Agenten landet auf deinem Zähler, was für die Kostenrechnung unten wichtig ist.
Die Benchmarks und wie man sie liest
Sakanas Kernaussagen zu Fugu Max sind stark, und sie sind alle vom Hersteller berichtet. Ich würde sie deshalb als die beste Seite des Herstellers sehen, nicht als unabhängigen Beweis.
Laut Release-Beitrag erreicht Fugu Max das beste Gesamtergebnis bei sechs Benchmarks (Terminal Bench 2.1, GPQAD, AA-LCR, GDP.pdf, AutomationBench und SWEFish) und "expands the cost-performance Pareto frontier on seven out of ten benchmarks." Die Effizienz ist die eigentliche Geschichte: Leistung nahe an Elite-Modellen zu "two to six times lower cost."
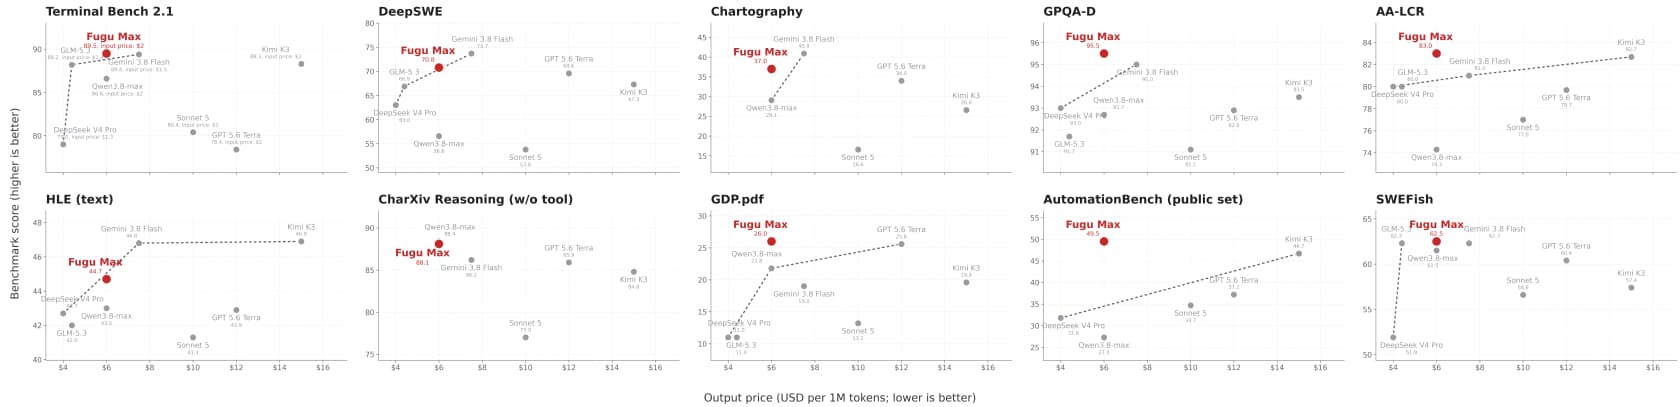
Das Schwestermodell Fugu Ultra v2 kam am selben Tag mit härteren Zahlen. Auf Chartography, einem Benchmark für visuelles Schlussfolgern, erreicht Ultra v2 48,3 gegenüber Opus 5 mit 27,3 und Fable 5 mit 29,5. Auf DeepSWE, einem Benchmark für Software Engineering unter realen Bedingungen, kommt es auf 74,3, womit es laut Sakana Modelle schlägt, die pro Token drei- bis fünfmal mehr kosten.
Drei Vorbehalte halten das Bild ehrlich, und Sakana nennt sie alle selbst:
- SWEFish ist Sakanas eigener interner Benchmark, der die eigenen Coding-Aufgaben abbildet, kein Test von Dritten.
- Die stärksten proprietären Modelle sind nicht im Pool. Sakana sagt ausdrücklich, dass Fable 5, Fable 5.1 und GPT-6-Astra nicht zu den Modellen gehören, die Fugu orchestriert. Frontier-Modelle ohne sie zu schlagen ist genau die Aussage, die sie treffen wollen, aber es bedeutet auch, dass der Pool aus offenen und mittelklassigen Modellen besteht.
- Die Weiterleitung ist bewusst intransparent. Sakana sagt dir nicht, welche zugrunde liegenden Modelle eine bestimmte Anfrage beantwortet haben, du kannst die Mischung also nicht pro Anfrage prüfen.
Das letzte ist ein echter Kompromiss für alle in regulierten oder sicherheitskritischen Umgebungen, und es ist derselbe Grund, warum Tests mit echten Daten besser sind, als einer Benchmark-Tabelle zu vertrauen.
Preise: die tatsächlichen Zahlen
Die Preise von Fugu Max sind öffentlich und erfreulich pauschal. Hier das ganze Bild, mit Fugu Ultra v2 zum Vergleich.
| Posten | Fugu Max (v1.0) | Fugu Ultra v2 (Standard) | Fugu Ultra v2 (>272K) |
|---|---|---|---|
| Input / 1 Mio. Tokens | $2.00 | $5.00 | $10.00 |
| Output / 1 Mio. Tokens | $6.00 | $30.00 | $45.00 |
| Gecachter Input / 1 Mio. | $0.25 | $0.50 | $1.00 |
| Kontextaufschlag | Keiner (pauschal) | Ab 272K Tokens | Angewendet |
| Websuche / Fetch | $0.007 pro Aufruf | $0.007 pro Aufruf | $0.007 pro Aufruf |
Das pauschale Preismodell ist das stärkste Verkaufsargument von Fugu Max: laut Sakana gilt der Satz von 2 $/6 $ "regardless of context length", ein Prompt mit 900K Tokens kostet pro Token also dasselbe wie ein kurzer. Das ist ungewöhnlich und nützlich, wenn du große Dokumente hineinwirfst.
Wenn Abos besser passen, gibt es drei, und jede Stufe enthält den Zugang zu allen Fugu-Modellen:
| Tarif | Preis | Kontingent |
|---|---|---|
| Standard | $20/Monat | Basis |
| Pro | $100/Monat | 10x Standard |
| Max | $200/Monat | 20x Standard |
Eine Namensfalle: Das "Max Plan"-Abo ist nicht dasselbe wie das Modell "Fugu Max". Der 200-$-Tarif ist ein Nutzungskontingent, das alle Modelle einschließt; Fugu Max ist eines der Modelle darin.
Zwei Fußnoten verändern die realen Kosten. Erstens: Weil Orchestrierungs-Tokens gemessen werden, verbraucht eine Anfrage, die sich auf mehrere Agenten verzweigt, mehr Tokens als ein Aufruf an ein einzelnes Modell, der niedrige Preis pro Token bedeutet also nicht immer eine niedrige Rechnung pro Antwort. Sakana mildert das mit dem Versprechen, "never stacks fees" und berechnet "a single rate based on the top-tier model involved." Zweitens: Caching leistet in der Praxis viel: Im Live-Panel von OpenRouter lag in den ersten Tagen von Fugu Max der gewichtete durchschnittliche effektive Input-Preis bei etwa 0,61 $ pro Million gegenüber dem Listenpreis von 2 $, getragen von einer Cache-Trefferquote von 79,4 %, bei etwa 29 Tokens pro Sekunde.
Was die Leute tatsächlich sagen
Der Launch von Fugu Max selbst blieb online ruhig, aber die Debatte über den Orchestrierungsansatz von Fugu insgesamt ist seit dem Start der allgemeinen Verfügbarkeit im Juni laut. Es lohnt sich, sie zu lesen, denn die Kritik gilt genauso für Max. (Das sind Reaktionen auf das Orchestrierungsmodell von Fugu allgemein, nicht speziell auf die Max-Variante.)
Die dominierende Kritik lautet "warum für einen Router zahlen". Einer der Top-Kommentare im Hacker-News-Thread zur allgemeinen Verfügbarkeit fing die Stimmung ein:
"You pay $200/month to Anthropic, $200/month to OpenAI, $200/month to Cursor, $200/month to Google, and seeing that it didn't come to a nice round $1024/month, you pay $200/month to Sakana to coordinate it all, because why not."

Das ist die eigentliche Frage für alle Technikaffinen: Wenn ich günstige offene Modelle und einen Orchestrator selbst verdrahten kann, was kaufe ich dann? Für einen großen Teil des Threads lautete die Antwort "nicht genug". Es gab aber auch einen fairen Gegenpunkt, und ich halte ihn für die ehrliche Lesart:
"Kind of shocking - a model comes out that beats mythos and offers a reasonable price and it ... gets downvoted? ... it's a genuine accomplishment to hit those benchmarks and offer a reasonable plan?"
Und mindestens ein Nutzer berichtete von einem echten, funktionierenden Setup, bei dem Fugu Ultra als Berater mit einem schnelleren Driver-Modell kombiniert wird:
"Happy user here, pairing it with Composer 2.5, with Fugu Ultra as advisor and Fugu as planner... Worth it if your harness can split advisor from worker."
Meine Einschätzung: Fugu Max ist ein wirklich kluges Stück Engineering, und das Angebot "verwaltete Orchestrierung kaufen, statt sie zu bauen" ist für Teams real, die keine Routing-Schicht pflegen wollen. Ob es eine eigene Rechnung zusätzlich zu deinen bestehenden Modellkosten wert ist, hängt ganz davon ab, wie viel Orchestrierung du sonst selbst bauen würdest.
Wo das Modell endet und die Arbeit beginnt
Das ist die Unterscheidung, auf die ich immer wieder zurückkomme, weil sie leicht verschwimmt. Fugu Max ist Infrastruktur. Es ist ein Motor, kein Mitarbeiter.
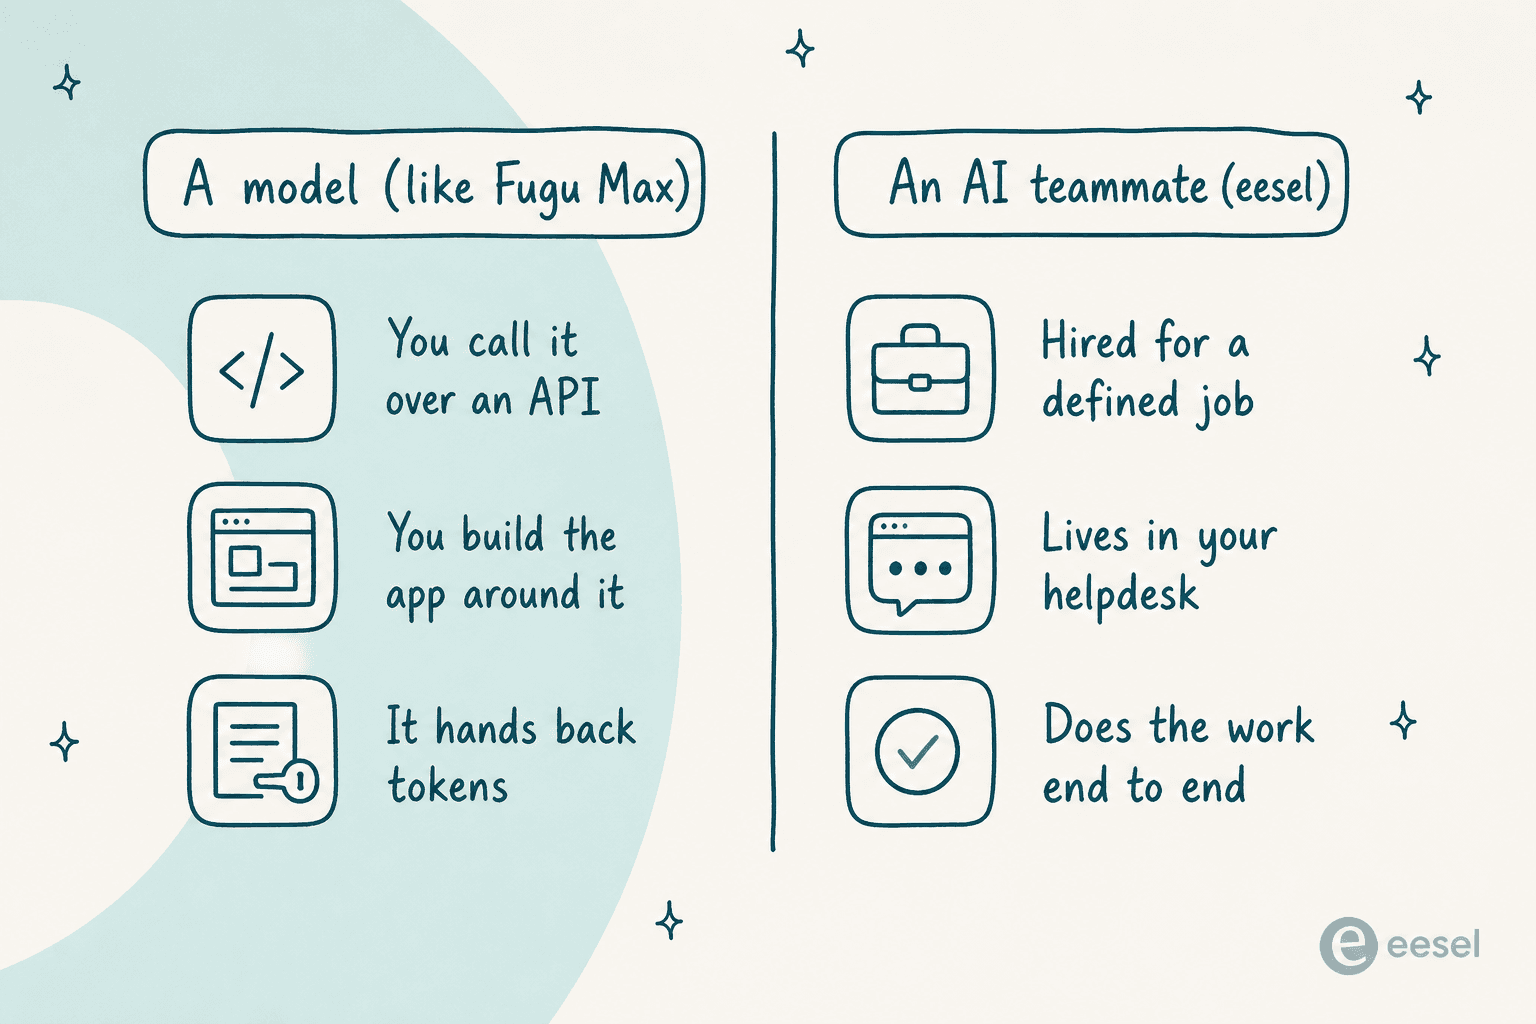
Ein Modell, so klug seine Weiterleitung auch ist, gibt dir Tokens zurück. Um daraus gelöste Support-Tickets zu machen, musst du es weiterhin an dein Helpdesk anbinden, ihm dein Produkt und deine Richtlinien beibringen, ihm die Erlaubnis geben, eine Bestellung nachzuschlagen oder ein Ticket zu taggen, entscheiden, wann es an einen Menschen eskaliert, und nachweisen, dass es sicher ist, bevor es einen echten Kunden berührt. Diese Lücke zwischen "einem fähigen Modell" und "einem Teammate, der die Arbeit macht" ist der größte Teil des eigentlichen Projekts, und es ist der Teil, den Benchmarks nie messen.
Genau das ist der Kompromiss hinter Fugus eigenem Erfolg: Die meisten Teams wollen die Multi-Agent-Infrastruktur nicht selbst bauen. Dieselbe Logik gilt eine Ebene höher. Für den Kundensupport willst du wahrscheinlich auch nicht den ganzen Mitarbeiter um ein Modell herum bauen.
eesel ausprobieren: der Teammate, nicht der Motor
Diese Lücke schließt eesel. eesel ist eine Plattform für KI-Teammates: Du stellst einsatzbereite Teammates für bestimmte Aufgaben ein, und jeder kommt mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für seine Rolle. Der KI-Helpdesk-Teammate steigt in deine bestehende Warteschlange ein, schlägt Bestellungen und Datensätze nach, taggt Tickets und entwirft oder sendet Antworten, alles in dem Helpdesk, das du bereits betreibst.

Der relevante Punkt für einen Modell-Beitrag: Du musst nie das Modell wählen. eesel läuft im Hintergrund auf Frontier-Modellen und nimmt dir diese Wahl ab, die Entscheidung lautet also nicht "Fugu Max oder Sonnet 5", sondern "will ich, dass Tickets gelöst werden". Es lernt aus deinen vergangenen Tickets und deinem Help Center, bindet sich in über 1000 Tools wie Zendesk, Freshdesk und Gorgias ein und lässt dich, entscheidend, auf historischen Tickets simulieren, bevor es je einem Kunden antwortet, der Probelauf, den Fugus intransparente Weiterleitung nicht bieten kann.
Wenn du im Terminal lebst, bietet eesel auch eine echte programmierbare Oberfläche. Das eesel CLI (@eesel/cli) und sein MCP-Server lassen eine Person, ein Skript oder einen Coding-Agenten wie Claude Code denselben Teammate und Workspace steuern wie das Dashboard. Du kannst Integrationen verbinden, die Standardanweisungen des Teammates bearbeiten, mit eesel activity jeden Lauf einsehen und Aktionen mit einem Menschen im Loop genehmigen oder ablehnen, alles als JSON, mit einem --dry-run-Flag, das den genauen Aufruf ausgibt, den ein Schreibvorgang machen würde, bevor er gesendet wird.

Fugu Max ist eine großartige Antwort auf "welches Modell soll meine App antreiben". Wenn deine Frage lautet "wie löse ich tatsächlich mehr Tickets", kannst du eesel kostenlos testen, ohne Kreditkarte und ohne Verkaufsgespräch, und in Minuten einen Teammate live haben.
Häufig gestellte Fragen
Was ist Sakana Fugu Max?
Sakana Fugu Max ist ein KI-Modell für ein gutes Preis-Leistungs-Verhältnis, das am 11. September 2026 veröffentlicht wurde. Statt selbst zu antworten, verteilt es mit einem gelernten Koordinator jede Anfrage auf einen Pool aus Open-Weight- und spezialisierten Modellen, alles hinter einer OpenAI-kompatiblen API. Es steht neben Fugu, Fugu Ultra und Fugu Cyber in der Sakana-Fugu-Familie.
Was kostet Sakana Fugu Max?
Fugu Max kostet laut Sakanas FAQ 2 $ pro Million Input-Tokens, 6 $ pro Million Output-Tokens und 0,25 $ pro Million gecachte Input-Tokens, pauschal und unabhängig von der Kontextlänge. Web-Search- und Web-Fetch-Aufrufe kosten jeweils 0,007 $. Die Abos kosten 20 $ (Standard), 100 $ (Pro) und 200 $ (Max) pro Monat.
Ist Fugu Max besser als ein einzelnes Frontier-Modell?
Sakana gibt an, dass Fugu Max bei sechs Benchmarks insgesamt am besten abschneidet und beim Output 40-60 % günstiger ist als Sonnet 5, GPT 5.6 Terra und Kimi K3. Das sind Herstellerangaben, und Spitzenmodelle aus dem proprietären Lager wie Fable 5 sind nicht im Pool. Sieh die Zahlen also als Ausgangspunkt und teste mit deinen eigenen Aufgaben. Wenn dein Ziel darin besteht, Support-Tickets zu lösen, zählt ein KI-Teammate, der die gesamte Aufgabe übernimmt, meist mehr als das reine Modell.
Wo kann ich auf Sakana Fugu Max zugreifen?
Es gibt es nur als gehostete API, verfügbar über console.sakana.ai, OpenRouter, das Vercel AI Gateway und opencode. In der EU und im EWR ist es nicht verfügbar, solange Sakana an der Compliance arbeitet.
Brauche ich ein Modell wie Fugu Max, um den Kundensupport zu automatisieren?
Nein. Ein Modell ist rohe Infrastruktur, auf der du aufbaust. Für den Support übernimmt ein KI-Teammate wie eesel bereits Modellwahl, Wissen und Aktionen, bindet sich in dein bestehendes Helpdesk ein und lässt dich auf vergangenen Tickets simulieren, bevor du live gehst. Sieh dir den Vergleich mit einem regelbasierten Chatbot an.