

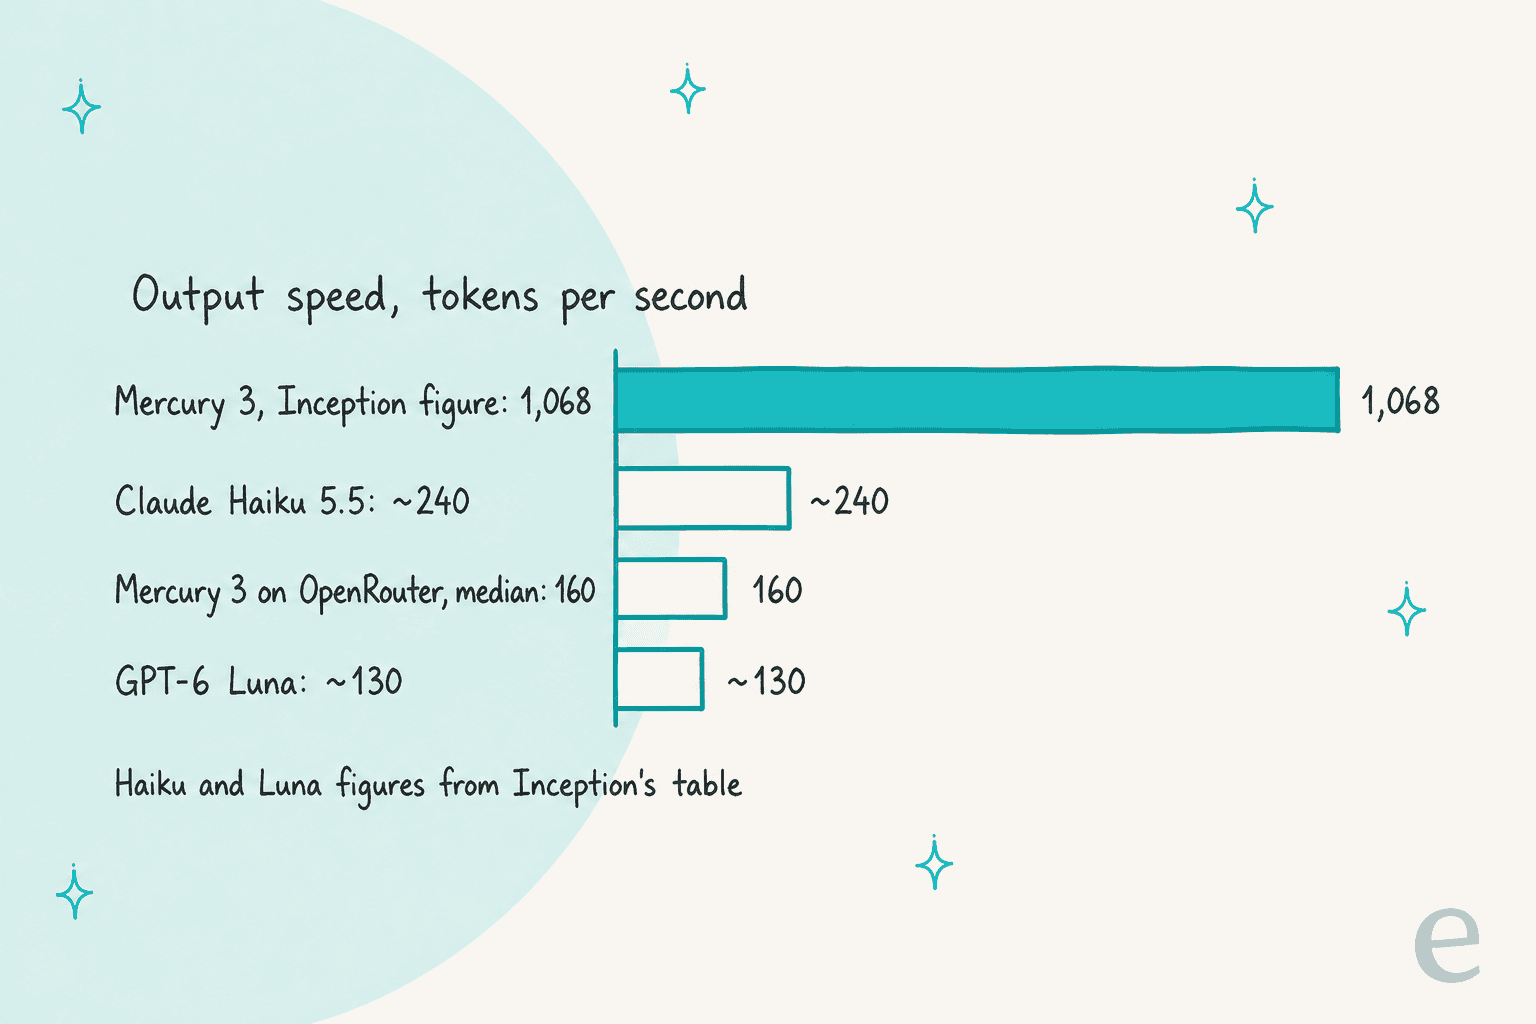
Mercury 3 ist das neueste Modell von Inception und wurde am 19. Oktober 2026 veröffentlicht. Es ist ein Diffusions-Sprachmodell: Statt Token für Token zu tippen, entwirft es die ganze Antwort und schärft sie in wenigen Durchgängen nach. Inception misst 1,068 Tokens pro Sekunde, bei einem Kontextfenster von 1 Mio. Tokens, mit Tool Calling und strukturierten Ausgaben.
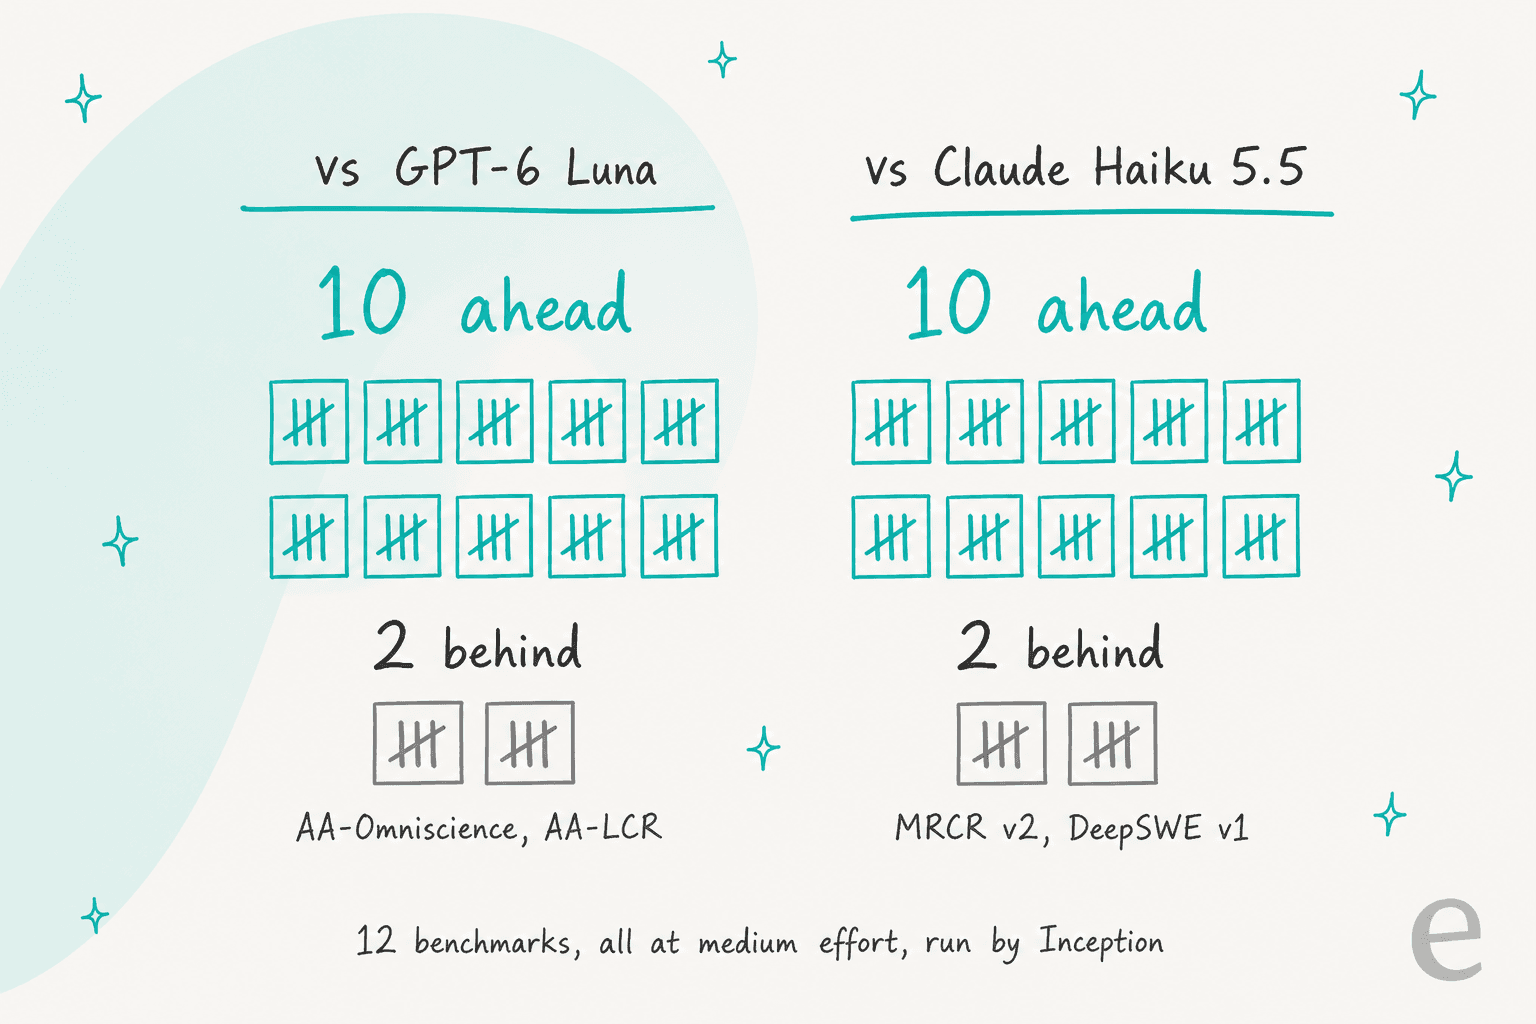
In Inceptions eigener Benchmark-Tabelle schlägt es GPT-6 Luna und Claude Haiku 5.5 bei 10 von 12 Tests, alle bei mittlerem Aufwand. Es kostet $0.20 für Eingabe und $0.70 für Ausgabe pro Million Tokens, zum Start die Hälfte ($0.10 / $0.35), und neue Schlüssel bekommen 100 Millionen kostenlose Tokens.
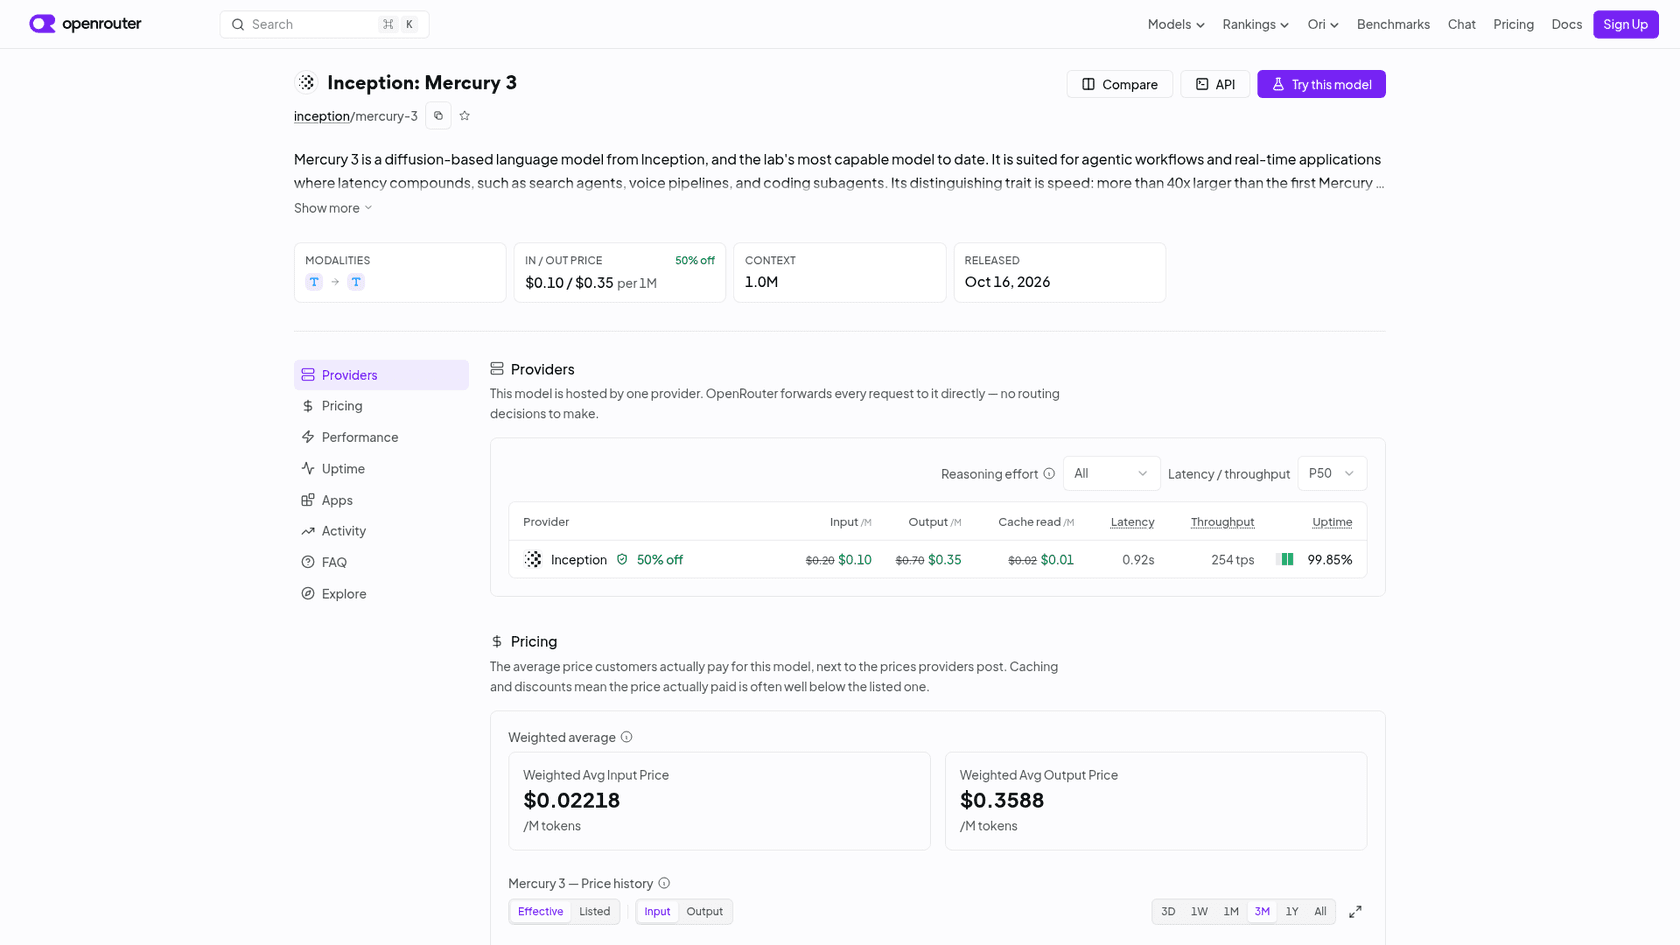
Der Haken ist das Tempo, das du tatsächlich siehst. OpenRouter, das jede Mercury-3-Anfrage an Inception weiterleitet, maß in der Startwoche einen Median von 160 bis 254 Tokens pro Sekunde, schnell, aber weit von 1,068 entfernt, und Tester auf Hacker News meldeten einen langsamen ersten Token. Nutze es für Agent-Schleifen und Subagenten, bei denen sich Wartezeit aufaddiert. Für Support-Teams ist es eine starke Engine, aber eben Infrastruktur: eesel ist der Mitarbeiter, und der KI-Helpdesk-Teammate macht aus einem solchen Modell beantwortete Tickets.
Warum ich mir diesen Launch genau angesehen habe
Ich verbringe einen Großteil meiner Woche damit, zu lesen, wonach Leute suchen und was sie damit wirklich meinen. „Mercury 3“ ist eine Tempo-Suche: Die Leute wollen wissen, ob die Zahl von 1.000 Tokens pro Sekunde den Kontakt mit einer echten API übersteht. So habe ich den Launch gelesen, mit Inceptions eigenen Seiten neben OpenRouters Live-Zahlen und dem Hacker-News-Launch-Thread.
Es gibt einen zweiten Grund. eesel setzt seit Jahren KI-Modelle auf echte Support-Warteschlangen, und die Lehre, die sich ständig wiederholt: Die Laborwerte eines Modells entscheiden nie, ob es bei deinen Tickets funktioniert. Deshalb simuliert eesel jeden Rollout an den historischen Tickets eines Kunden, bevor die KI jemandem antwortet. Dieselbe Gewohnheit habe ich hier angewendet: Prüfe die Behauptung an einer externen Messung, bevor du darauf aufbaust.
Was ist Inception Mercury 3?
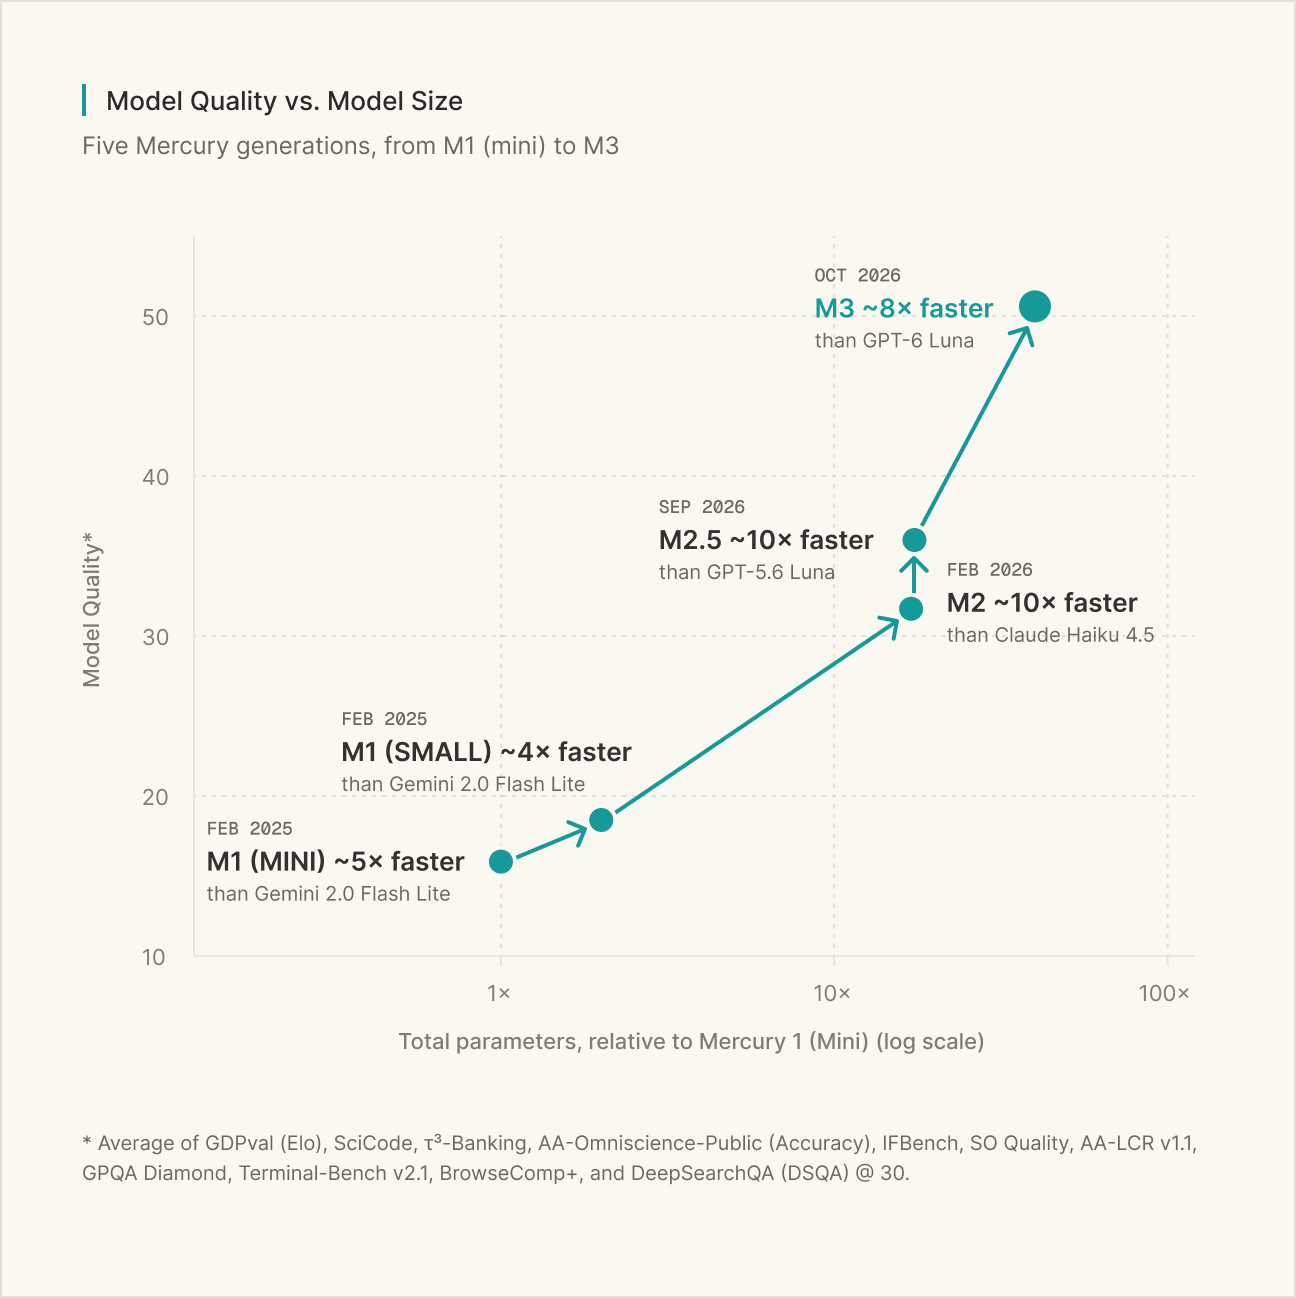
Mercury 3 ist das Flaggschiff-Modell von Inception, einem Labor, das sogenannte Diffusions-LLMs (dLLMs) baut. Inceptions Launch-Beitrag nennt es "the most capable diffusion-based LLM released to date" und sagt, es sei mehr als 40-mal größer als Mercury 1 und laufe dabei gleich schnell. Es ersetzt Mercury 2.5, das erst letzten Monat erschienen ist.
Das bekommst du, direkt aus Inceptions Modell-Doku:
| Eigenschaft | Mercury 3 |
|---|---|
| Startdatum | 19. Oktober 2026 |
| Typ | Diffusions-LLM, geschlossene Gewichte |
| Ausgabetempo (Angabe von Inception) | 1,068 Tokens pro Sekunde auf NVIDIA-GPUs |
| Kontextfenster | 1M Tokens (vorher 260K bei Mercury 2.5) |
| Maximale Ausgabe | 131,072 Tokens |
| Reasoning-Aufwand | instant, low, medium, high |
| Funktionen | Tool Calling, strukturierte Ausgaben |
| Ein- und Ausgabe | Nur Text |
| API | OpenAI-kompatibel, Modell-ID mercury-3 |
| Preis (Liste) | $0.20 Eingabe / $0.70 Ausgabe pro 1M Tokens |
| Preis (Start, 50 % Rabatt) | $0.10 Eingabe / $0.35 Ausgabe pro 1M Tokens |
| Gratis-Kontingent | 100 Millionen Tokens bei neuen API-Schlüsseln |
Zwei Dinge, die die Tabelle nicht sagt. Inception hat die Parameterzahl nicht veröffentlicht; der Mitgründer schrieb auf Hacker News, man gebe die Modellgröße „not publicly announcing the model size right now“ nicht bekannt. Und es gibt keine Gewichte zum Herunterladen. Wenn dir das wichtig ist, ist Googles DiffusionGemma das offene Diffusionsmodell zum Vergleich.
Wie unterscheidet sich ein Diffusions-LLM?
Fast jedes Modell, das du heute nutzt, von GPT-6.1 Sol bis DeepSeek V4.1 Flash, ist autoregressiv. Es sagt den nächsten Token voraus, hängt ihn an und wiederholt das, von links nach rechts. Deshalb dauern lange Antworten lange: Eine Antwort mit 2,000 Tokens sind 2,000 Schritte hintereinander, egal wie schnell jeder Schritt ist.
Ein Diffusionsmodell arbeitet andersherum. Es startet mit einem groben, verrauschten Entwurf der gesamten Antwort und verfeinert alles parallel in wenigen Durchgängen. Inceptions Mercury-2-Launch-Beitrag hat es gut formuliert: "Less typewriter, more editor revising a full draft at once." Wenn du gesehen hast, wie Bildgeneratoren ein Bild aus dem Rauschen schärfen, ist es dieselbe Idee, angewandt auf Text. Mein Erklärartikel zu Diffusions-basierten KI-Modellen geht tiefer auf die Bildseite ein.
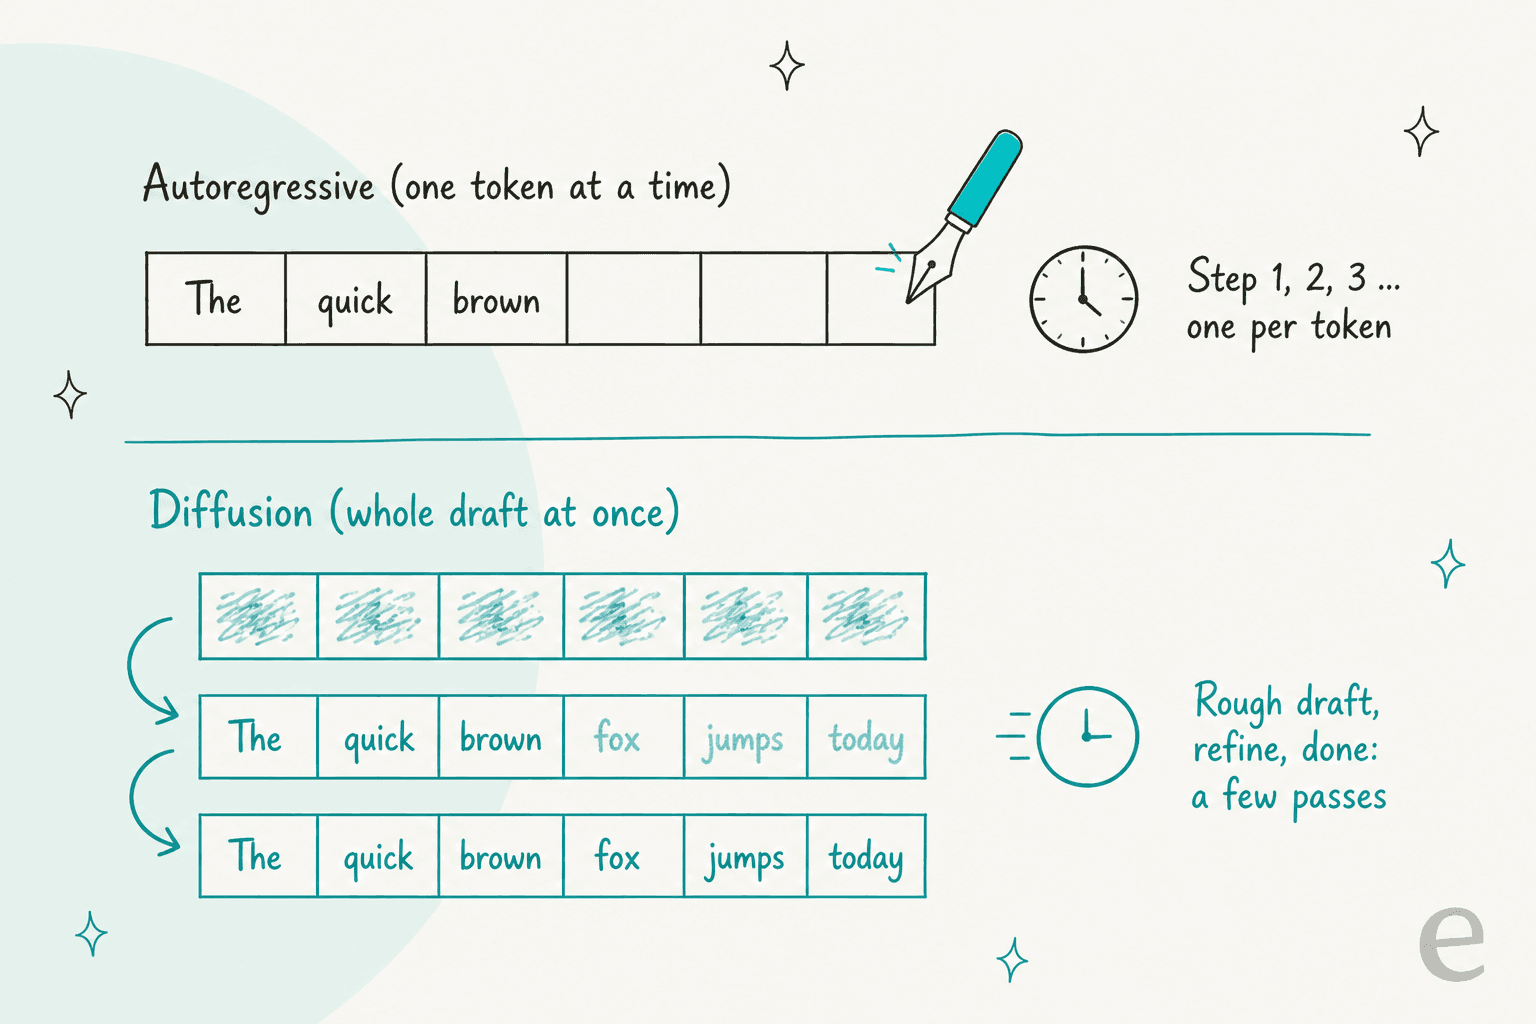
Warum das jetzt wichtiger ist: Reasoning-Modelle denken, bevor sie antworten, und Denken sind Ausgabe-Tokens. Inceptions Mitgründer und Chief Scientist Volodymyr Kuleshov machte im Launch-Thread den Punkt, dass Diffusion Tokens parallel schreibt und die Tempolücke deshalb wächst, je länger Modelle denken.
"Diffusion generates tokens in parallel through iterative denoising rather than one at a time, so as reasoning models think longer per answer, the speed advantage over autoregressive models of the same size grows."

Die offene Frage der letzten Jahre war, ob Diffusions-LLMs auch schlau werden können, nicht nur schnell. Inceptions Antwort ist ein Skalierungsdiagramm: fünf Mercury-Generationen von Anfang 2025 bis heute, mit steigender Qualität bei wachsender Modellgröße.
Mercury-3-Benchmarks: was Inceptions Tabelle zeigt
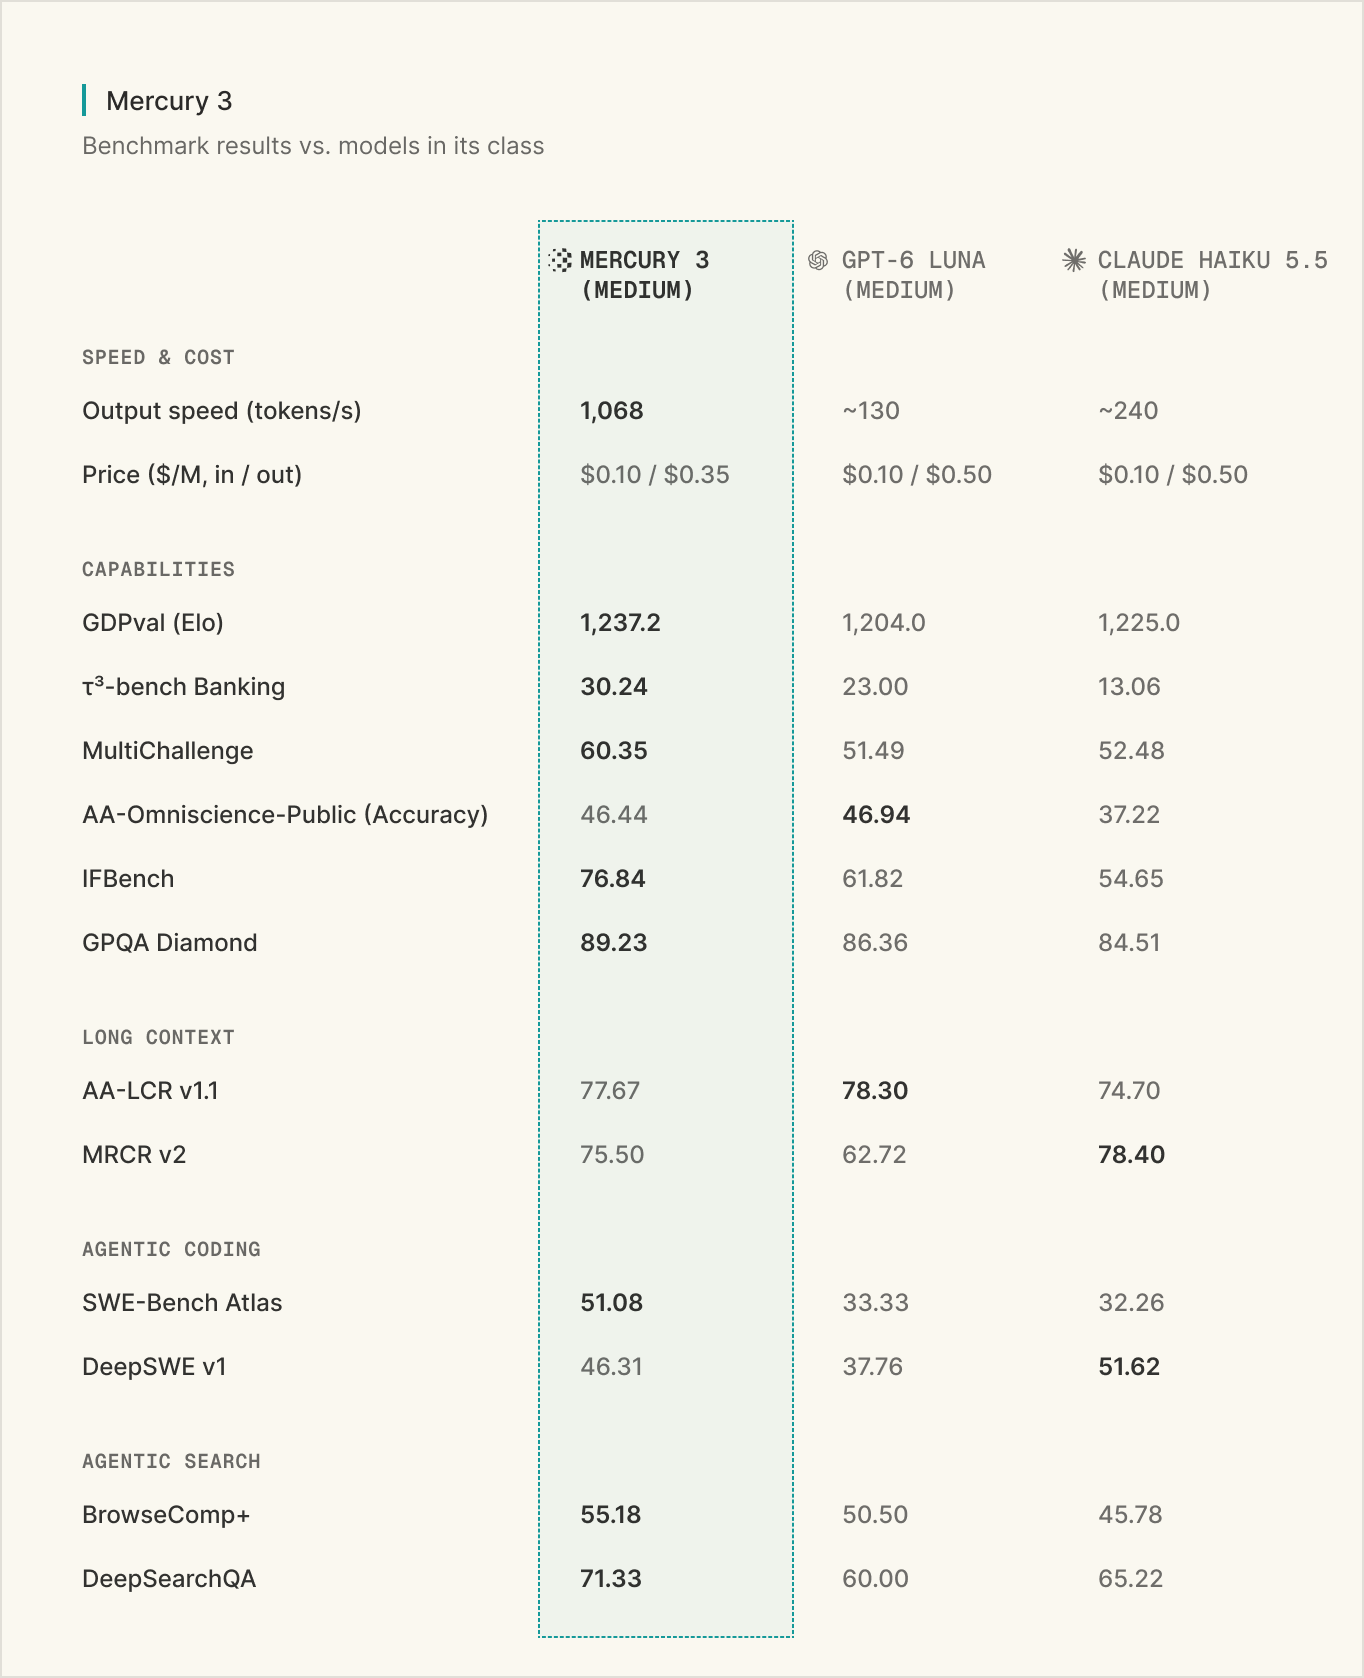
Inception vergleicht Mercury 3 mit den beiden Modellen, die es ersetzen soll: OpenAIs GPT-6 Luna und Anthropics Claude Haiku 5.5, beide bei mittlerem Aufwand. Hier die vollständige Tabelle aus dem Launch-Beitrag:
| Benchmark | Was er testet | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|---|
| GDPval (Elo) | Reale Arbeitsaufgaben | 1,237.2 | 1,204.0 | 1,225.0 |
| τ³-bench Banking | Agent im Kundenservice | 30.24 | 23.00 | 13.06 |
| MultiChallenge | Mehrstufiger Chat | 60.35 | 51.49 | 52.48 |
| AA-Omniscience (Accuracy) | Faktenwissen | 46.44 | 46.94 | 37.22 |
| IFBench | Anweisungen befolgen | 76.84 | 61.82 | 54.65 |
| GPQA Diamond | Naturwissenschaft auf Hochschulniveau | 89.23 | 86.36 | 84.51 |
| AA-LCR v1.1 | Reasoning über lange Kontexte | 77.67 | 78.30 | 74.70 |
| MRCR v2 | Erinnerung bei langem Kontext | 75.50 | 62.72 | 78.40 |
| SWE-Bench Atlas | Agentisches Coding | 51.08 | 33.33 | 32.26 |
| DeepSWE v1 | Agentisches Coding | 46.31 | 37.76 | 51.62 |
| BrowseComp+ | Agentische Suche | 55.18 | 50.50 | 45.78 |
| DeepSearchQA | Agentische Suche | 71.33 | 60.00 | 65.22 |
Insgesamt hat Mercury 3 in 8 von 12 Zeilen den Höchstwert. Im direkten Vergleich schlägt es jeden Konkurrenten in 10 von 12.
Drei Dinge würde ich im Kopf behalten, bevor du das zitierst:
- Jede Zahl stammt aus Inceptions eigenem Lauf. Es gibt noch keine Artificial-Analysis-Seite für Mercury 3, und Kuleshov sagte auf Hacker News, die Benchmarks durch Dritte liefen noch.
- Alles läuft bei mittlerem Aufwand. Ein Kommentator fragte, warum, da viele günstige Modelle auf high oder max betreiben. Es gibt keine Kurve von low bis high, also lässt sich nicht erkennen, wie stark Luna oder Haiku mit mehr Denkaufwand aufholen.
- Die größten Siege liegen bei Agent-Tests. SWE-Bench Atlas (51 vs. 33) und τ³-bench Banking (30 vs. 23 und 13) zeigen große Abstände. Die Niederlagen betreffen die Erinnerung bei langem Kontext und einen Coding-Test, bei denen Haiku 5.5 vorn liegt.
Die ehrliche Zusammenfassung kommt von Inception selbst. Gefragt, warum Haiku DeepSWE gewann, übertrieb Kuleshov nicht:
"overall we have found the model to be Haiku- or Luna-level in our own daily usage. That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Das ist der Rahmen, den ich nutzen würde: Intelligenz auf Luna-Niveau, deutlich schnellere Ausgabe. Partnerergebnisse im Launch-Beitrag deuten in dieselbe Richtung. TinyFish sagt, Mercury 3 habe die Hälfte von 50 Live-Web-Navigationsaufgaben aus Mind2Web gelöst, "significantly more than GPT-6.1-Sol", und Octen maß in seinen Smart-Glasses-Suchtests eine mediane Generierungszeit von 0.9 Sekunden.
Wie schnell ist Mercury 3 in der Praxis?
Das ist der Teil, den die meiste Launch-Berichterstattung auslässt. Die Zahl 1,068 ist Inceptions Messung auf der eigenen NVIDIA-Hardware. Die einzige unabhängige Zahl, die ich finden konnte, stammt von OpenRouter, das für Mercury 3 nur einen Anbieter hat (Inception selbst) und Live-Durchsatz veröffentlicht.
Als ich am 20. Oktober 2026 nachsah, zeigte OpenRouter einen Median von 160 Tokens pro Sekunde, und eine zweite Messung später am selben Tag zeigte 254. Der Wochendurchschnitt des Medians liegt bei 203, bei einer mittleren Latenz von etwa einer Sekunde. Das ist immer noch schneller als die ~130, die Inception für Luna angibt, aber nur etwa ein Fünftel der Schlagzeile.
Woher die Lücke? OpenRouters Durchsatz wird über echten Traffic gemessen, bei jedem Reasoning-Aufwand, den Aufrufer wählen, und unter der jeweiligen Serverlast. Diffusions Tempovorteil ist bei geringer Parallelität am stärksten, der Kompromiss, den ein Kommentator für Googles experimentelles Diffusionsmodell beschrieb:
"It doesn't benefit from batching to reduce memory bandwidth in the same way that a "standard" autoregressive model does, which ends up meaning that it's great at reducing latency for individual/low-concurrency users and delivers better outcomes on certain tasks but much more expensive per token at scale."
Kuleshov sagt, Mercury skaliere gut mit der Batch-Größe, und Inceptions Preise legen nahe, dass es sich im großen Maßstab betreiben lässt. Aber Simon Willison, der seinen üblichen Pelikan-Test lief, fand das Tempo "a bit disappointing", und der direkte Aufruf von Inceptions API statt über OpenRouter "didn't seem to speed it up."
Spielt das reale Tempo dann noch eine Rolle? Das hängt davon ab, wie viele Modellaufrufe hintereinander stehen. Ein Chatbot mit einem Aufruf pro Nachricht merkt den Unterschied zwischen 1,068 und 160 kaum. Ein Agent, der 12 Aufrufe nacheinander macht, spürt jeden einzelnen. Gib im Rechner unten deine eigene Aufgabe ein und sieh, ab wann die Tempolücke keine Rolle mehr spielt.
Ändere die Zahl der Schritte und Tokens pro Schritt, um zu sehen, wie viel Modell-Wartezeit Mercury 3 pro Aufgabe spart, bei Inceptions Tempo und beim von OpenRouter gemessenen Median.
Mit den Standardwerten (12 Aufrufe à 600 Tokens) ist Mercury 3 bei Inceptions Tempo nach 6.7 Sekunden mit der Generierung fertig und beim OpenRouter-Median nach 45 Sekunden, gegenüber 55 Sekunden bei Luna. Selbst die langsamere Zahl spart bei langen Ketten Zeit. Bei einem einzigen Aufruf schrumpft der ganze Unterschied unter eine Sekunde, weshalb Mercury 3 eine Wahl für Schleifen ist, nicht für einzelne Antworten.
Mercury-3-Preise auf einen Blick
Inception veröffentlicht eine einzige Preisliste, identisch bei der eigenen API und bei OpenRouter. Die Modellseite listet die ganze Familie:
| Modell | Eingabe (Liste → Start) | Gecachte Eingabe | Ausgabe (Liste → Start) | Kontext | Am besten für |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | Allgemeines Reasoning, Agenten |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | Sprach-Agenten, TTFT unter 170 ms |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (nicht berechnet) | k. A. | Klassifizierung, Scoring |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | Code-Autovervollständigung, nächste Änderung |
Alle Preise gelten pro Million Tokens. Der Zugang gibt es in drei Tarifen: Free (100 Millionen Tokens, alle Modelle), Developer (nutzungsbasiert) und Enterprise (individuelle Rate Limits, SLA, Mengenpreise). Inception hat nicht gesagt, wann der Startrabatt endet.
So steht es im Vergleich zu den Modellen, die es angreift, jeweils nach der Preisliste des Anbieters:
| Modell | Eingabe pro 1M | Ausgabe pro 1M | Hinweis |
|---|---|---|---|
| Mercury 3 (Start) | $0.10 | $0.35 | Vorerst 50 % Rabatt |
| Mercury 3 (Liste) | $0.20 | $0.70 | Nach dem Rabatt |
| GPT-6 Luna | $0.10 | $0.50 | Standard-API von OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.50 | Prompts bis 100K Tokens; darüber das 5-Fache |
| DeepSeek V4.1 Flash | $0.15 | $0.60 | Außerhalb der Stoßzeiten, Cache-Miss; zu Stoßzeiten doppelt |
Zum Start ist Mercury 3 also der günstigste Ausgabe-Token in dieser Gruppe. Zum Listenpreis ist es bei der Ausgabe der teuerste. Ein Hacker-News-Kommentator sprach die Sorge deutlich aus: "I'm wondering if it'll still be useful once the discount is lifted?" Meine Einschätzung: Wenn du es wegen des Tempos kaufst, sind $0.70 immer noch günstig. Wenn du es kaufst, weil es billig ist, plane mit dem Listenpreis. Mein Leitfaden zu den Preisen von GPT-6 Luna deckt OpenAIs Seite vollständig ab, und DeepSeeks Stoßzeiten-Regeln erkläre ich in meinem Beitrag zu den V4.1-Flash-Preisen.
Ein weiteres Preisdetail, das du kennen solltest: Mercury 2 und Mercury 2.5 sind für neue Nutzer geschlossen. Bestehende Kunden behalten den Zugang bis zum 15. November 2026, wenn du also eines von beiden betreibst, plane den Wechsel jetzt.
So bekommst du Zugang zu Mercury 3
Laut Launch-Beitrag hast du vier Wege:
- Inception API Platform. Registriere dich auf platform.inceptionlabs.ai, erstelle einen Schlüssel und erhalte 100 Millionen kostenlose Tokens.
- OpenRouter. Gleicher Preis, an Inception weitergeleitet, praktisch, wenn du ohnehin über OpenRouter abrechnest.
- Baseten. In Basetens Modellbibliothek gelistet, aber für den Zugang musst du Baseten kontaktieren. Mein Baseten-Review behandelt die Plattform.
- Vercel. Inception nennt Vercel ebenfalls als Launch-Partner.
Die API ist OpenAI-kompatibel, der Wechsel besteht also meist aus Base-URL und Modellname. Hier der Aufruf aus Inceptions Doku:
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $INCEPTION_API_KEY" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "What is a diffusion model?"}],
    "reasoning_effort": "medium",
    "max_completion_tokens": 8192
  }'
Inceptions Integrations-Doku deckt Coding-Tools (Cursor, Kilo Code, OpenCode), Frameworks wie LangChain und Sprachplattformen wie ElevenLabs und Vapi ab.
Fürs Coding rät Kuleshov selbst, es als Helfer zu nutzen, nicht als Anführer. Ein schnelles Modell passt zu Claude-Code-Subagenten und Nebenaufgaben, während ein größeres Modell die Hauptarbeit steuert.
Was frühe Nutzer sagen
Der Hacker-News-Launch-Thread zog am ersten Tag 85 Kommentare an. Die Stimmung war beeindruckt, aber skeptisch gegenüber der Tempo-Behauptung.
Die positiven Stimmen kamen von Leuten, die es bei echter Arbeit ausprobiert haben:
"If their benchmarks are to be believed they've made some real progress. [...] EDIT: just trying this out on a repo and it's actually pretty good so far. Pleasantly surprised."
Die häufigste Beschwerde war die Wartezeit vor dem ersten Token, die eine Tokens-pro-Sekunde-Zahl nicht erfasst:
"Hmm at least in Openrouter, deepseek v4.1 flash via together/baseten/fireworks still beat mercury 3 on latency and intelligence Ttft is quite slow with mercury"
Ein anderer Tester sah dasselbe, mochte aber trotzdem den Preis: "the issue with speed seems to be that ttft is still high," schrieb er und fügte hinzu, es "was as cheap as deepseek for a few tasks I tried." Und ein Kommentator stellte die Wirtschaftlichkeit infrage: "Pricing can always be set at a loss, however, particularly for a private company." Das ist eine berechtigte Frage, auf die es noch keine öffentliche Antwort gibt.
Wo Mercury 3 schwächelt
- Noch keine unabhängigen Benchmarks. Jeder Wert stammt von Inception, nur bei mittlerem Aufwand.
- Das reale Tempo liegt unter der Schlagzeile. OpenRouters Median lag in der Startwoche bei 160 bis 254 Tokens pro Sekunde, und Tester berichten von einem langsamen ersten Token.
- Nur Text. Keine Bild- oder Audioeingabe. Inception sagt, es gebe interne multimodale Prototypen, offen für frühe Tester per E-Mail.
- Geschlossene Gewichte, unbekannte Größe. Du kannst es weder selbst hosten noch inspizieren.
- Bei zwei Tests hinter Haiku 5.5. Erinnerung bei langem Kontext (MRCR v2) und DeepSWE-Coding, teste es also an langen Dokumenten, bevor du ihm dort vertraust.
- Der Preis ist eine Aktion. Der Listenpreis für die Ausgabe liegt bei $0.70, das Doppelte des Startpreises, ohne angekündigtes Enddatum.
- Strukturierte Ausgabe ist nicht fehlerfrei. OpenRouter zeigt bei seinem Traffic eine Fehlerrate von 2.78 % bei strukturierter Ausgabe, behalte also eine Schema-Prüfung in deiner Pipeline.
Ist Mercury 3 gut für den Kundensupport?
Support ist einer der vier Produktionseinsätze, die Inception zum Start nennt, und die größte Benchmark-Lücke für Support-Arbeit ist τ³-bench Banking, das einen Agenten im Umgang mit Bankkunden simuliert: 30.24 für Mercury 3 gegenüber 23.00 für Luna und 13.06 für Haiku 5.5. Lorikeet, ein Anbieter von Support-KI, sagte Inception, in frühen Tests habe "Mercury 3 beat other models on latency while also performing higher on evals and in production." Wenn du Support-Anbieter vergleichst, deckt mein Beitrag zu Lorikeet-Alternativen diesen Markt ab.
Tempo zählt am meisten in Live-Kanälen. Bei Website-Chat und Sprach-Agenten sieht ein Kunde den Punkten zu oder hört Stille. Bei E-Mail-Tickets ändern ein paar Sekunden nichts. Dort setzt Mercury Voice mit einer Zeit bis zum ersten Token unter 170 Millisekunden an, und es lohnt sich ein Blick darauf neben den Tools in meiner Übersicht der besten KI-Sprach-Agenten.
Aber eine schnelle falsche Antwort bleibt eine falsche Antwort. Was eesel beim Betrieb von KI an echten Warteschlangen gelernt hat: Du kannst keinem Modell an einer Live-Warteschlange vertrauen, bevor du gesehen hast, wie es mit deinen eigenen früheren Tickets umgeht. Ein Banking-Benchmark-Wert von 30 heißt außerdem, dass es die meisten dieser Aufgaben nicht geschafft hat, das Modell braucht also Leitplanken, Eskalation und Tests um sich herum. Mein Leitfaden zur Vermeidung von KI-Halluzinationen behandelt diese Leitplanken, und KI-Ticket-Klassifizierung ist ein risikoarmer erster Job für ein günstiges, schnelles Modell wie dieses.
Wer sollte Mercury 3 nutzen?
So würde ich entscheiden:
- Agent-Entwickler mit langen Aufrufketten. Browser-Agenten, Such-Agenten, Coding-Subagenten. Hier summiert sich das Tempo, und hier sind Inceptions Partnerergebnisse am stärksten. Probiere es zuerst aus.
- Sprach- und Echtzeit-Chat-Teams. Sieh dir Mercury Voice wegen der Latenz bis zum ersten Token an und teste Mercury 3 für die Reasoning-Schritte dahinter. Vergleiche mit Retell AI, wenn du einen kompletten Sprach-Stack willst.
- Teams, die für Luna oder Haiku bei hohem Volumen und geringem Risiko zahlen. Zum Startpreis ist es bei der Ausgabe günstiger und schneller. Rechne zum Listenpreis neu, bevor du dich festlegst.
- Alle, die Vision, Gewichte oder Erinnerung bei langen Dokumenten brauchen. Warte oder wähle ein anderes Modell. Gemini 3.8 Flash verarbeitet Bilder, und DeepSeek V4.1 Flash hat offene Gewichte.
- Teams, deren Engpass nicht das Modell ist. Wenn eine einzelne Antwort so oder so eine Sekunde dauert, bewegt Tempo deine Zahlen nicht. Sieh dir zuerst dein KI-Agent-API-Setup oder das Retrieval an.
Wenn du das Feld noch sondierst, sind meine Übersicht der besten KI-Agenten und der Leitfaden zum besten Modell für Support-Tickets gute nächste Lektüre.
eesel ausprobieren
Mercury 3 ist Infrastruktur: ein schnelles Modell, eine API und eine Rechnung pro Token. Um es auf deine Support-Warteschlange zu bringen, müsstest du weiterhin die Helpdesk-Anbindung, Retrieval über dein Help Center, Eskalationsregeln und die Test-Umgebung bauen. eesel ist der Mitarbeiter. Der KI-Helpdesk-Teammate steigt in die Warteschlange ein, die du schon betreibst, lernt aus deinen früheren Tickets und Dokumenten, und du kannst ihn an deinen historischen Gesprächen abspielen, bevor er auch nur einem Kunden antwortet.
SamCart ist ein gutes Beispiel dafür, wo Tempo und Kanäle zusammenkommen. Das Unternehmen betreibt einen eesel-Agenten an Freshdesk-Tickets und einen separaten in der Chat-Blase auf seiner Website, jeweils mit eigener Begrüßung und eigenem Ton, beide antworten aus rund 280 Help-Center-Artikeln. Der Ticket-Agent antwortet nur, bis ein Teammitglied das Ticket übernimmt, und ein Verkäufer, der nach einem Menschen fragt, beendet seinen Teil.
Wenn du neue Modelle gern im Terminal testest, steuert die eesel CLI denselben Teammate. eesel init chat-bubble --site https://your-site.com richtet einen Website-Chat-Agenten ein, der deine Seiten liest, eesel instructions bearbeitet seine Dauerregeln, und eesel approvals listet Aktionen auf, die auf einen Menschen warten. Jeder Befehl gibt JSON aus, ein Coding-Agent wie Claude Code kann die Einrichtung also für dich übernehmen. Mehr dazu in meinem Leitfaden zur KI-Agent-CLI.
Tarife beginnen bei $299 im Monat für 500 Credits, wobei ein Ticket oder ein Chat einen Credit kostet, und die kostenlose Testphase bietet 100 Credits ohne Karte. Probiere eesel an den Tickets des letzten Monats aus oder sieh dir zuerst die Preisseite an. Wenn du Inhalte schreibst statt Tickets zu beantworten, gehört auch ein KI-Blog-Autor zum Team.