

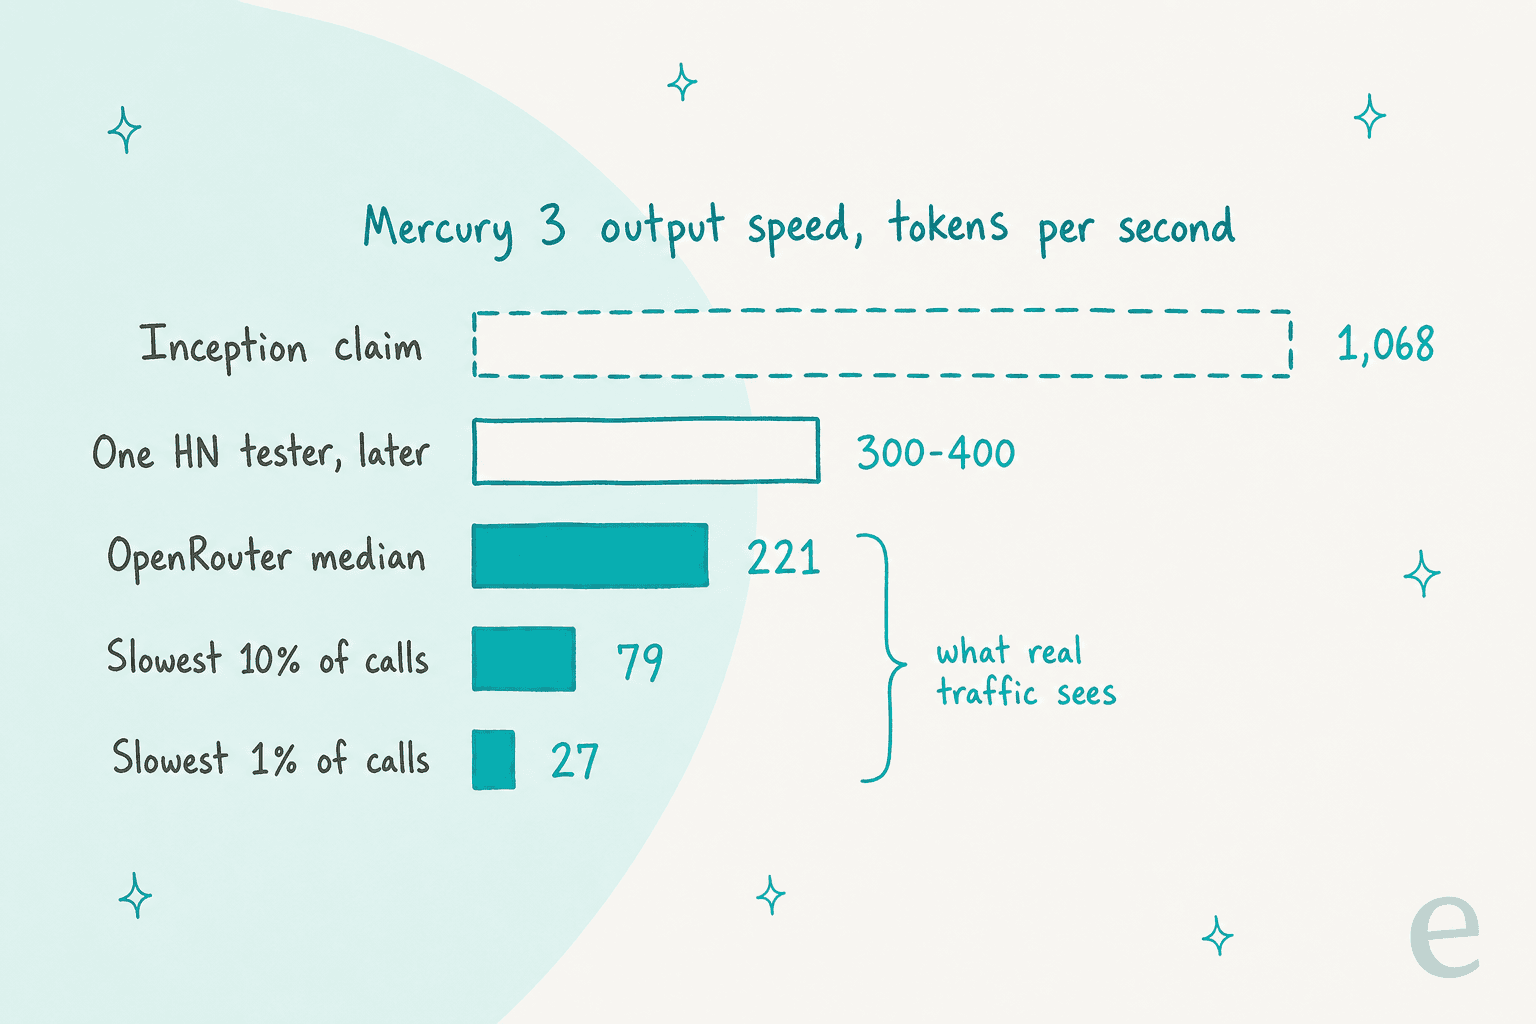
Mein Urteil: 3,7 von 5. Mercury 3 ist der bisher beste Beleg dafür, dass ein Diffusions-Sprachmodell sowohl schlau als auch schnell sein kann. In Inceptions eigener Tabelle schlägt es GPT-6 Luna und Claude Haiku 5.5 bei 10 von 12 Benchmarks, und im Live-Traffic von OpenRouter läuft es mit einem Median von 221 Tokens pro Sekunde, schneller als beide Konkurrenten, aber nur ein Fünftel der 1.068, die Inception angibt.
Was die Note bremst: Die langsamsten 10 % der echten Anfragen schleichen mit 79 Tokens pro Sekunde oder weniger, jeder Benchmark lief auf mittlerer Stufe, während die API standardmäßig auf low steht, es gibt noch kein unabhängiges Leaderboard, und es nimmt nur Text mit einer Temperaturuntergrenze von 0,5. Zum Launch kostet es 0,10 $ Input und 0,35 $ Output pro Million Tokens; kalkuliere mit dem Listenpreis von 0,20 $ / 0,70 $.
Für wen es passt: Agenten-Entwickler mit langen Ketten von Modellaufrufen, Such- und Browser-Agenten sowie Coding-Subagenten. Wer warten sollte: alle, die Bilder, offene Gewichte, deterministische Ausgaben oder nachgewiesenen Recall bei langen Dokumenten brauchen. Für Support-Teams ist es ein starker Motor, aber eben nur ein Motor. Der KI-Helpdesk-Teammate von eesel ist der Mitarbeiter, der aus einem Modell beantwortete Tickets macht, so wie Lesson Pro ihn rund 1.900 Zendesk-Tickets pro Monat mit Notizen und Entwürfen bearbeiten lässt.
Wie ich Mercury 3 getestet habe
Ich baue bei eesel Funktionen und KI-Agenten und lese einen Modell-Launch deshalb anders als eine Benchmark-Tabelle. Mich interessieren die Nahtstellen: was die API standardmäßig tut, wie die Ausgabe gestreamt wird, was bei den langsamen Anfragen passiert und wo ein Agent bricht, wenn das Modell das schwache Glied ist. eesel betreibt KI seit Jahren in Live-Support-Warteschlangen, und die eine Gewohnheit, die geblieben ist: Kein Modell kommt in die Nähe eines Kunden, bevor es echte vergangene Tickets durchgespielt hat. Labor-Zahlen haben uns nie gesagt, ob etwas funktioniert.
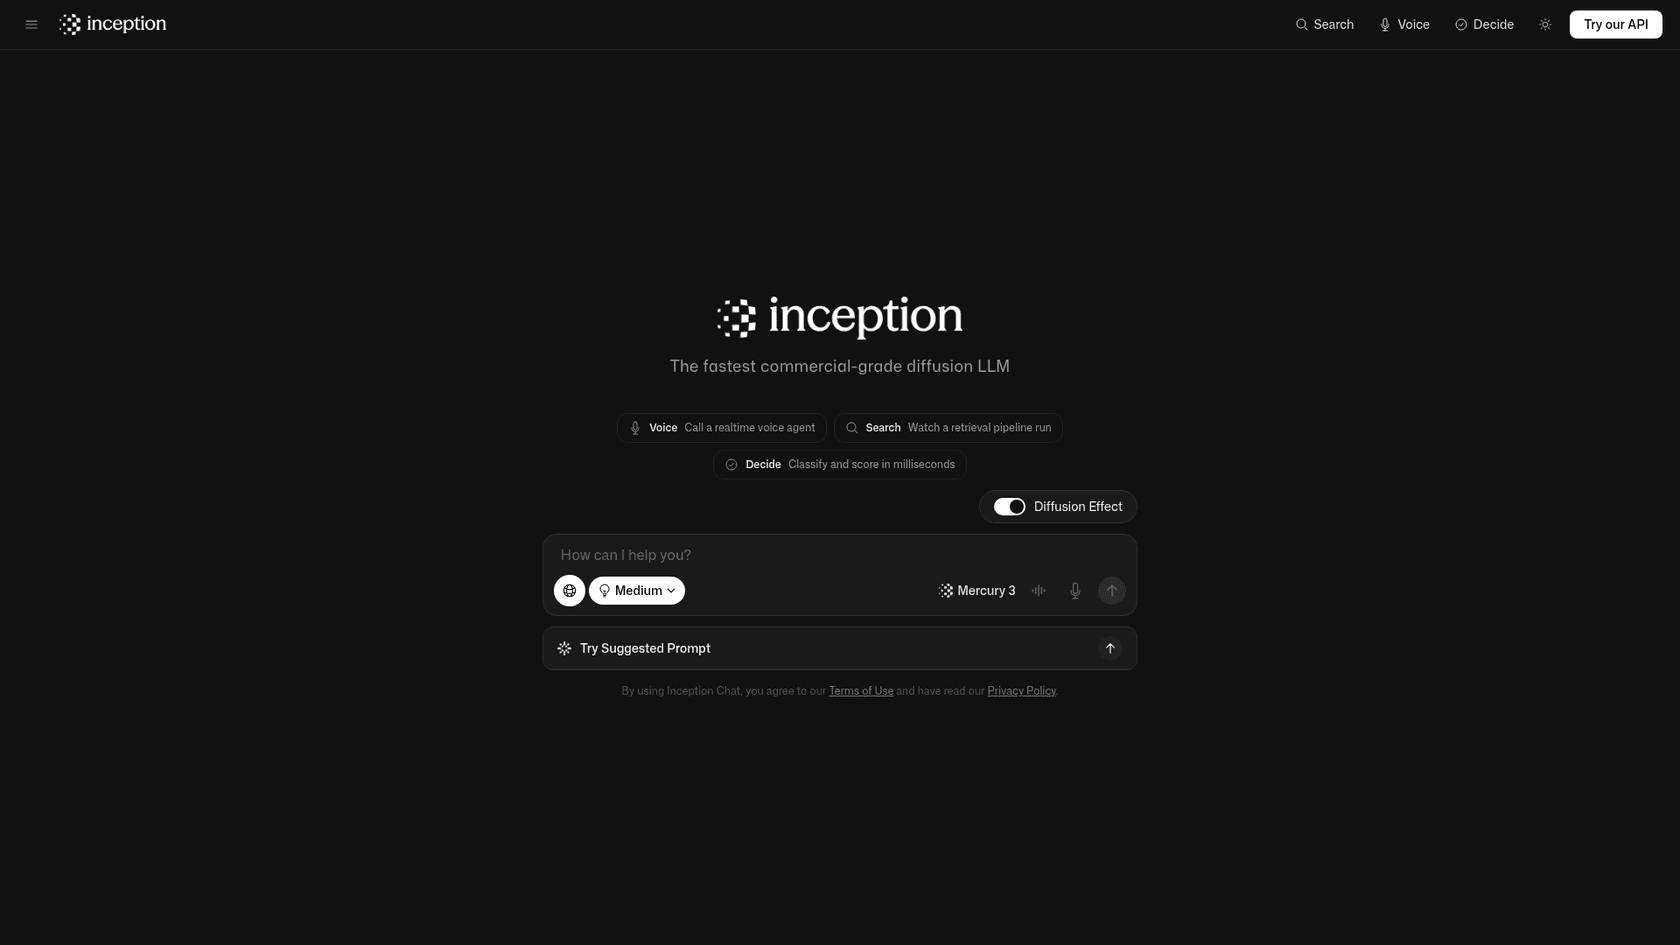
Dieser Test beruht deshalb auf vier Quellen. Inceptions eigener Launch-Beitrag und die API-Doku. Die Performance-Seite von OpenRouter, die Perzentile für echten Traffic veröffentlicht. Der Hacker-News-Launch-Thread, in dem Leute es innerhalb von Stunden an ihrer eigenen Arbeit getestet haben. Und Inceptions eigene Chat-App, die den Diffusionsprozess auf dem Bildschirm zeigt.
Wenn du erst die Launch-Grundlagen willst (Specs, die vollständige Benchmark-Tabelle, Zugangswege), beginne mit meinem Mercury-3-Überblick. Wenn dich nur der Preis interessiert, rechnet Ramas Mercury-3-Preisaufschlüsselung ihn pro Aufgabe durch. Dieser Beitrag ist das Urteil.
Mercury-3-Scorecard
So habe ich bewertet, und warum.
| Kategorie | Punkte | Begründung |
|---|---|---|
| Echtes Tempo | 4,0 / 5 | 221 Tok/s Median auf OpenRouter schlägt Luna und Haiku, aber der Ausreißer-Bereich ist langsam |
| Qualität für die Klasse | 4,0 / 5 | Vorn bei 10 von 12 Herstellerbenchmarks, im Alltag auf Luna- oder Haiku-Niveau |
| Preis | 3,5 / 5 | Zum Launch der günstigste Output der Klasse, zum Listenpreis der teuerste |
| Zuverlässigkeit | 3,5 / 5 | 0,58 % Tool-Call-Fehler, 2,51 % Fehler bei strukturierter Ausgabe auf OpenRouter |
| Reife und Offenheit | 3,5 / 5 | Keine unabhängigen Benchmarks, nur Text, geschlossene Gewichte, Größe nicht genannt |
| Gesamt | 3,7 / 5 | Ein echter Schritt für Diffusions-LLMs, am besten als schnelles Hilfsmodell |
Die Note würde schnell steigen, wenn zwei Dinge passieren: Ein unabhängiges Leaderboard wie Artificial Analysis bestätigt die Benchmark-Tabelle, und der langsame Ausreißer-Bereich bei OpenRouter schrumpft, sobald Inception Kapazität ausbaut. Am Launch-Tag trifft keines von beiden zu.
Was Diffusion in der Praxis verändert
Fast jedes Modell, das du benutzt hast, von GPT-6.1 Sol bis DeepSeek V4.1 Flash, schreibt ein Token nach dem anderen, von links nach rechts. Mercury 3 entwirft die ganze Antwort als verrauschten Text und verfeinert ihn in einigen Durchgängen. Meine Erklärung zu Diffusionsmodellen behandelt die Theorie. Für einen Test zählt, was das mit deinem Code und deinen Nutzern macht.
Text kommt in Blöcken, nicht in Tokens
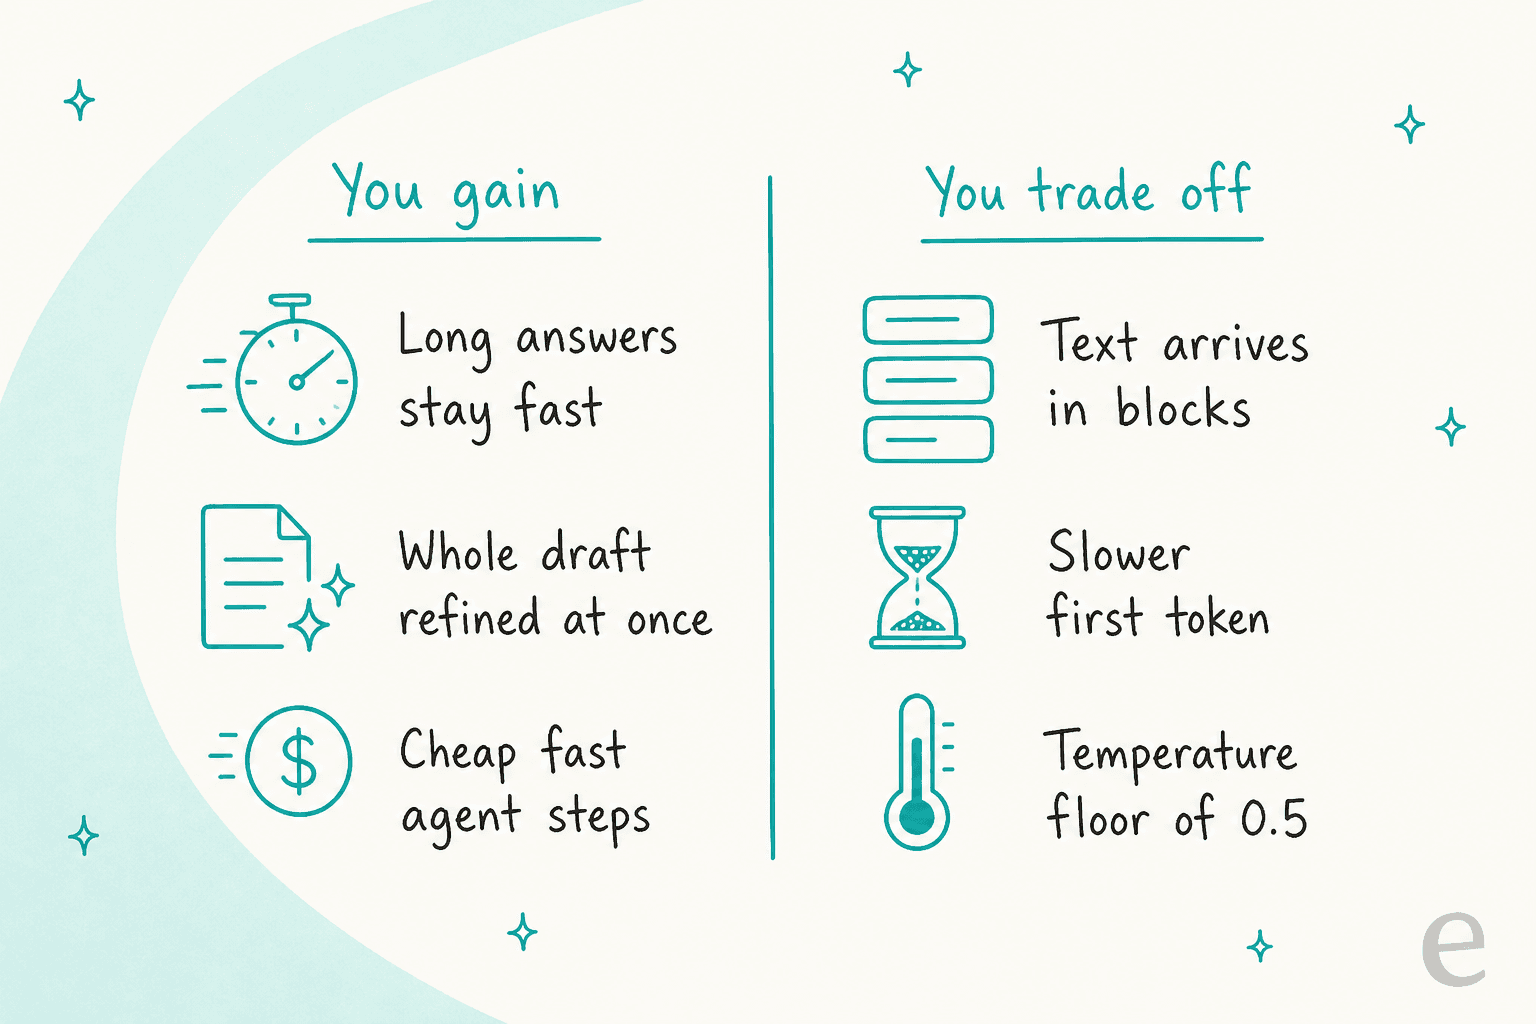
Inceptions Streaming-Doku sagt, Antworten werden "block-by-block" gestreamt, wobei ein Block ein Stück verfeinerten Textes ist, nicht ein einzelnes Token. In einem Chat-Fenster sieht das anders aus als das gewohnte Wort-für-Wort-Tröpfeln: erst nichts, dann ein Satz, dann der nächste. Es gibt außerdem einen optionalen diffusing-Modus, bei dem jeder Block die ganze Antwort bis zu diesem Punkt ist, sodass deine Oberfläche bei jedem Schritt den Text überschreiben muss, statt anzuhängen. Das ist eine nette Demo und ein leichter Bug, wenn dein Frontend vom Anhängen ausgeht.
Das ist auch meine beste Vermutung, warum Tester auf Hacker News immer wieder die Zeit bis zum ersten Token erwähnten. Einer schrieb "Ttft is quite slow with mercury" im Launch-Thread, und ein anderer Tester sagte "the issue with speed seems to be that ttft is still high." Tokens pro Sekunde sagt dir, wie schnell die Antwort fertig wird, nicht, wie bald der Nutzer etwas sieht.
Lange Antworten kosten kaum mehr Zeit
Der Vorteil ist die Kehrseite. Ein Token-für-Token-Modell braucht doppelt so lange, um doppelt so viel zu schreiben. Ein Diffusionsmodell verfeinert den ganzen Block parallel, sodass der Abstand wächst, je länger Antworten und Reasoning werden. Inceptions Mitgründer Volodymyr Kuleshov hat genau das am Launch-Tag gesagt: Je länger Reasoning-Modelle pro Antwort nachdenken, desto größer wird der Geschwindigkeitsvorteil. Deshalb passt das Modell besser zu mehrstufigen Agenten als zu Einzeilern.
Die Standardeinstellungen sind nicht das gebenchmarkte Modell
Dieses Detail würde ich jedem Team nennen, das es ausprobiert. Jeder Wert in Inceptions Launch-Tabelle lief mit mittlerer Reasoning-Stufe. Aber die Doku zur Reasoning-Stufe sagt, dass mercury-3 auf low steht, wenn du reasoning_effort weglässt. Mercury 2 und 2.5 standen standardmäßig auf medium.
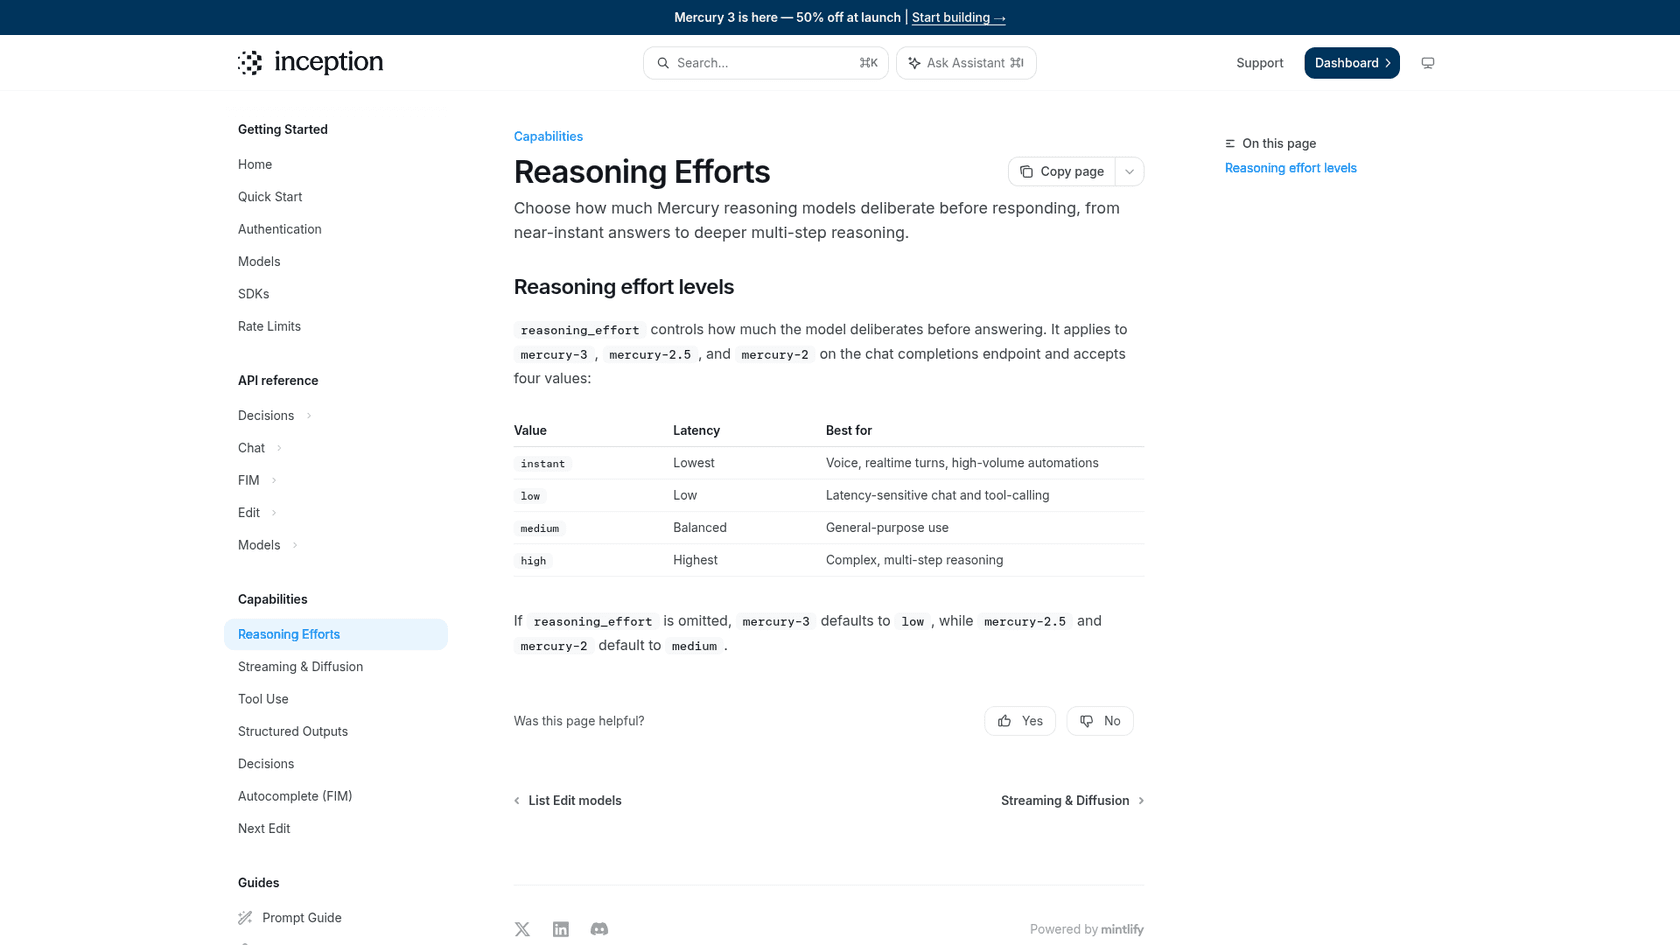
Ein schneller Test ohne gesetzte Stufe testet also eine schnellere, leichtere Einstellung als die in der Tabelle. Das ist ein vernünftiger Standard für Tempo, aber setze medium ausdrücklich, bevor du Qualität vergleichst. Und nimm nicht an, dass high besser ist: Ein Tester bemerkte bei Simon Willisons Pelikan-Zeichnungen, dass "the medium pelican is better than the high". Das ist eine Kritzelei, kein Benchmark, aber ein guter Grund, jede Stufe an der eigenen Aufgabe zu testen.
Die Temperatur beginnt bei 0,5
Inceptions Modell-Doku nennt für Mercury 3 eine einstellbare Temperatur von 0,5 bis 1,0. Wenn deine Pipeline die Temperatur für reproduzierbare Ausgaben auf 0 setzt (Klassifikation, Extraktion, Test-Fixtures), geht das hier nicht. Kombiniere es stattdessen mit strukturierten Ausgaben und einer Schema-Prüfung. Für reine Labeling-Aufgaben ist Inceptions separates Modell Mercury Decide für Klassifikation gebaut.
Angegebenes Tempo gegen gemessenes Tempo
Inceptions Zahl sind 1.068 Output-Tokens pro Sekunde auf NVIDIA-GPUs. Mein Überblick hat die Lücke beim Median behandelt. Für diesen Test wollte ich die Streuung, denn die Gesamtwartezeit eines Agenten bestimmen seine langsamen Aufrufe, nicht die durchschnittlichen.
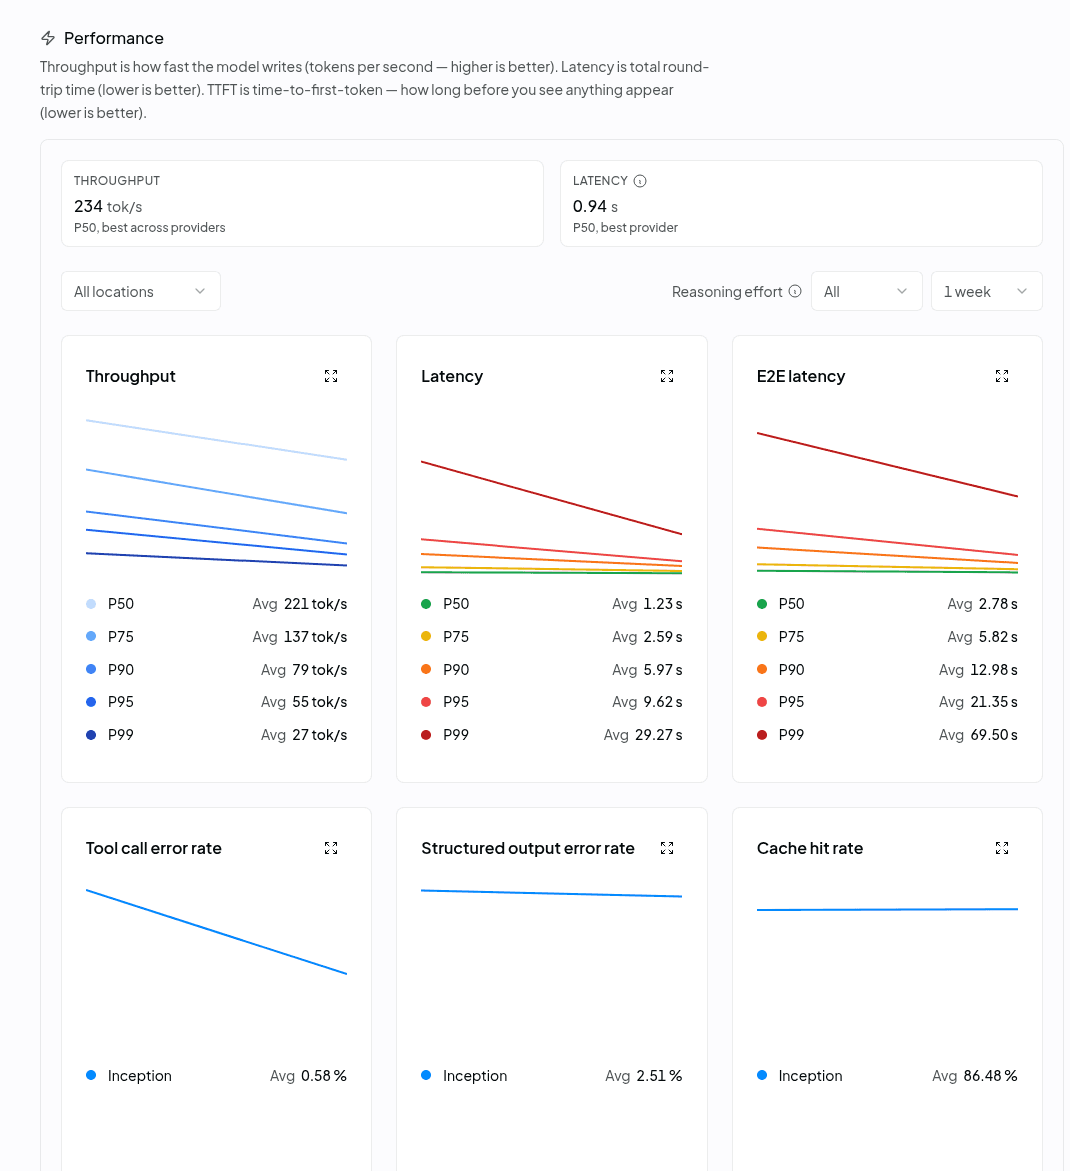
OpenRouter leitet jede Mercury-3-Anfrage an Inception weiter und veröffentlicht Perzentile. Das zeigte die Performance-Seite am 20. Oktober 2026, gemittelt über eine Woche:
| Perzentil | Durchsatz | Latenz | Gesamt |
|---|---|---|---|
| P50 | 221 tok/s | 1,23 s | 2,78 s |
| P75 | 137 tok/s | 2,59 s | 5,82 s |
| P90 | 79 tok/s | 5,97 s | 12,98 s |
| P95 | 55 tok/s | 9,62 s | 21,35 s |
| P99 | 27 tok/s | 29,27 s | 69,50 s |
Der Median ist gut. Inceptions eigene Tabelle setzt GPT-6 Luna bei etwa 130 Tokens pro Sekunde und Haiku 5.5 bei etwa 240 an, Mercury 3 liegt im echten Traffic also ungefähr gleichauf mit Haiku und deutlich vor Luna. Das Problem ist der Ausreißer-Bereich: Jede zehnte Anfrage läuft mit 79 Tokens pro Sekunde oder langsamer, und jede hundertste braucht Ende zu Ende über eine Minute.
Zwei Vorbehalte halten das fair. OpenRouter mischt jede Reasoning-Stufe, die seine Nutzer wählen, und der Traffic der Launch-Woche ist sprunghaft. Bei manchen Nutzern wurde es schon bis zum Ende des ersten Tages schneller:
"I've been trialing this for the last few hours. It was quite slow at first, but now I'm getting around 300-400tps. Still nowhere near 1000tps, but it's still incredibly fast compared to what I'm used to with other models."

Simon Willison dagegen fand das Tempo "a bit disappointing" und sah keinen Gewinn, wenn er Inceptions API direkt statt über OpenRouter aufrief. Mein Fazit: Der Median ist echt und heute nützlich, die 1.068 sind ein Bestwert auf Inceptions eigener Hardware, und der Ausreißer-Bereich ist die Zahl, die man im nächsten Monat beobachten sollte. Wenn du reine Tempo-Optionen vergleichst, behandelt mein Beitrag zu Groq 3 LPX den Hardware- statt den Modellweg.
Benchmark-Realitätscheck
Die Launch-Tabelle ist stark. Mercury 3 schlägt Luna und Haiku 5.5 jeweils bei 10 von 12 Tests, und die größten Abstände liegen bei Agentenarbeit: SWE-Bench Atlas mit 51,08 gegenüber 33,33 für Luna und τ³-bench Banking mit 30,24 gegenüber 23,00 und 13,06. Die ganze Tabelle steht in meinem Mercury-3-Überblick, deshalb konzentriere ich mich hier darauf, wie viel Gewicht sie tragen kann.
- Es ist Inceptions eigener Lauf. Es gibt noch keine Artificial-Analysis-Seite für Mercury 3, und Kuleshov sagte auf Hacker News, dass Benchmarks durch Dritte und Zeiten bis zur Aufgabenerledigung noch folgen.
- Nur eine Reasoning-Stufe. Alle 12 Zeilen laufen auf medium. Ein Kommentator fragte, warum, und merkte an, dass es keine Kurve von low bis max gibt. Wir wissen nicht, ob Luna oder Haiku bei höherer Stufe aufholen.
- Die Niederlagen sind knapp, manche Siege deutlich. Es liegt bei AA-Omniscience (46,44 vs 46,94) und AA-LCR (77,67 vs 78,30) knapp hinter Luna und bei MRCR v2 (75,50 vs 78,40) und DeepSWE (46,31 vs 51,62) hinter Haiku 5.5. Recall bei langen Dokumenten würde ich am härtesten testen.
- Die Einschätzung des Herstellers ist bescheiden. Kuleshov beschrieb es als Haiku- oder Luna-Niveau im Alltag, und ich halte das für die ehrliche Einordnung.
"That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Die Praxisberichte passen dazu. Ein Entwickler hat damit eine kleine macOS-App von Anfang bis Ende gebaut:
"I made it come up with a plan for this tool and had it implement the thing end to end in about 8 or 9 steps. It originally messed up the coordinate calculation but quickly corrected that when I pointed it out and other than that it one-shotted all the other steps."
Derselbe Tester sagte, die Aufgabe habe 26 Millionen Tokens verbraucht, davon 1,3 Millionen ohne Cache, bei etwa 160 Tokens pro Sekunde. Das ist ein nützliches Bild aus der Praxis: Ein Coding-Harness sendet viel Kontext erneut, weshalb der Cache-Preis genauso zählt wie der Hauptpreis. Ein anderer Tester baute einen UML-Renderer nach, in drei Runden, und sagte, es habe das HTML korrekt aktualisiert.
Stärken und Grenzen
Hier die ausgewogene Version, in der Reihenfolge, in der ich sie gewichten würde.
Wo es stark ist:
- Agenten-Schleifen. Tempo summiert sich, wenn eine Aufgabe ein Dutzend Modellaufrufe hintereinander macht. Inceptions Launch-Partner TinyFish sagt, es habe die Hälfte von 50 Live-Web-Aufgaben aus Mind2Web gelöst, "significantly more than GPT-6.1-Sol."
- Hilfs- und Subagenten-Arbeit. Kontext-Verdichtung, Routing, Zusammenfassen von Tool-Ausgaben. Beim älteren Mercury 2 berichtete Augment Code von 82 % weniger Latenz bei der Verdichtung und 90 % weniger Kosten gegenüber dem vorherigen Modell. Das ist Mercury 2, aber Mercury 3 ist dasselbe Versprechen mit einem größeren Modell.
- Lange Kontexte zum Einheitspreis. Ein 1M-Token-Fenster zu einem Satz, während Haiku 5.5 ab 100K Tokens das Fünffache berechnet. Mein Leitfaden zu den Haiku-5.5-Preisen hat die Details.
- Leicht auszuprobieren. Es ist OpenAI-kompatibel, mit 100 Millionen kostenlosen Tokens für neue Keys und Setup-Anleitungen für Cursor, LangChain und Vapi.
Wo es begrenzt ist:
- Der langsame Ausreißer-Bereich. P90-Durchsatz von 79 tok/s und P99-Gesamtzeit von 69,5 Sekunden in OpenRouters Wochenansicht.
- Strukturierte Ausgabe ist nicht fehlerfrei. OpenRouter zeigt eine Fehlerrate von 2,51 % bei strukturierter Ausgabe, halte also einen Validator im Ablauf.
- Nur Text, geschlossene Gewichte, unbekannte Größe. Inception sagt, Multimodalität sei in internen Prototypen. Für offene Diffusionsgewichte ist DiffusionGemma die Alternative.
- Preis nach der Aktion. Mit 0,70 $ pro Million Output-Tokens liegt der Listenpreis über den 0,50 $ von Luna und Haiku, und Inception hat kein Enddatum für den Rabatt von 50 % genannt.
- Die Verfügbarkeit pendelt sich noch ein. OpenRouters Verfügbarkeit über drei Tage lag bei 99,26 %, mit sichtbaren Einbrüchen am Launch-Tag.
Passt Mercury 3 zu deiner Arbeitslast?
Die Entscheidung "wechseln oder nicht" hängt meist an drei Fragen: wie viele Aufrufe hintereinander laufen, ob ein Mensch wartet und ob du etwas brauchst, das Mercury 3 nicht bietet. Der Auswahlhelfer unten führt dich durch sie.
Beantworte drei Fragen, um zu sehen, ob Mercury 3 zu einer Arbeitslast passt und was du vor einem Wechsel testen solltest.
Das Muster ist einfach: je mehr Aufrufe hintereinander und je mehr ein Mensch wartet, desto mehr verdient Mercury 3 seinen Platz. Bei einem einzelnen Hintergrundaufruf ändert Tempo nichts, und zum Listenpreis sind Luna oder Haiku die günstigere Wahl. Meine Aufschlüsselung der GPT-6-Luna-Preise hat deren Seite dieser Rechnung.
Wie Mercury 3 in eine Support-Arbeitslast passt
Support ist einer der vier Produktionseinsätze, die Inception nennt, und der Launch zitiert Lorikeet, einen Support-KI-Anbieter, mit der Aussage, Mercury 3 "beat other models on latency while also performing higher on evals and in production." Der Benchmark, der Support am nächsten kommt, τ³-bench Banking, ist zugleich der, bei dem Mercury 3 am weitesten vorn liegt.
Lies diesen Wert aber genau. Eine 30,24 bedeutet, dass das Modell die meisten dieser simulierten Banking-Aufgaben nicht geschafft hat, nur seltener als die Konkurrenz. Das ist bei kleinen, schnellen Modellen normal, und es ist der Grund, warum ein Modell nie der ganze Support-Agent ist. Tempo hilft am meisten in Live-Kanälen wie KI-Live-Chat und Sprachagenten, wo ein Kunde auf den Bildschirm schaut. Bei E-Mail-Tickets ändert eine Lücke von zwei Sekunden nichts.
Ein schnelles Hilfsmodell passt im Support am besten zu den vielen kleinen Aufgaben rund um jede Antwort. Denk an Ticket-Triage, Tagging, das Zusammenfassen langer Threads und das Heraussuchen von Bestelldetails. Das ist dasselbe Subagenten-Muster, das Inception fürs Coding beschreibt. Und so sieht ein echter Support-Einsatz aus, wenn man ihn aufmacht.
Lesson Pro, das private Unterrichtsmarken wie GOSKATE betreibt, ist ein gutes Beispiel. Seine eesel-Agenten arbeiten über zwei Zendesk-Konten. Bei jedem Ticket klärt der Agent zuerst, zu welcher Marke der Kunde gehört, hinterlässt dann eine interne Notiz und entwirft eine Antwort, signiert als diese Marke. Bewerbungen, Voicemails und Bestellformulare werden absichtlich übersprungen. Zwischen dem 8. August und dem 8. September 2026 bearbeitete er etwa 1.900 Tickets, hinterließ etwa 1.700 Notizen und entwarf etwa 560 Antworten, die das Team versenden konnte. Wenn ein Teammitglied "@eesel find instructors near this lesson" schreibt, durchsucht er vergangene Tickets in den umliegenden Orten nach Lehrern, die dort unterrichtet haben.
Nichts davon hängt davon ab, ob das Modell dahinter mit 221 oder 1.068 Tokens pro Sekunde schreibt. Es hängt an der Markenregel, der Überspringliste, den Entwürfen, die zuerst an einen Menschen gehen, und am Testen. Das ist der Unterschied, auf den ich immer wieder komme: Mercury 3 ist Infrastruktur; eesel ist der Mitarbeiter. Wenn du die Modellschicht selbst wählst, behandeln meine Leitfäden zum besten Support-Ticket-Modell und zur Vermeidung von KI-Halluzinationen die Leitplanken, und KI-Agenten testen behandelt den Schritt, den die meisten Teams überspringen.
Wer Mercury 3 nutzen sollte und wer warten sollte
Nutze es jetzt, wenn du:
- Agenten mit langen Aufrufketten baust: Browser-Agenten, Such-Agenten, Recherche-Schleifen. Hier summiert sich sein Tempo.
- Coding-Harnesses betreibst und einen schnellen Helfer willst. Kuleshovs eigener Rat lautet Subagenten, nicht Leitmodell, was zu Setups mit Claude Code oder Cursor passt, in denen ein größeres Modell plant.
- Für Luna oder Haiku bei hohem Volumen und geringem Risiko zahlst und später mit dem Listenpreis leben kannst. Teste auf medium, bevor du tauschst.
Warte oder nimm etwas anderes, wenn du:
- Bild-Eingabe, offene Gewichte oder Temperatur 0 brauchst. Gemini 3.8 Flash verarbeitet Bilder, und kleine Sprachmodelle decken Self-Hosting ab.
- Dich auf exakten Recall über lange Dokumente verlässt. Mach zuerst deine eigene Auswertung.
- Pro Anfrage einen Modellaufruf machst und niemand wartet. Tempo ändert deine Zahlen nicht, wähle also nach Qualität und Preis.
- Garantierte Latenz brauchst. Bis P90 und P99 enger werden, halte ein Ausweichmodell oder ein Timeout drumherum.
Wenn du die Optionen noch sortierst, sind mein Überblick über die besten KI-Agenten und der Claude-Haiku-5.5-Test die naheliegenden nächsten Lektüren.
eesel ausprobieren
Ein schnelles Modell liefert dir ein schnelles Token. Es liefert dir keine Zendesk-Anbindung, keine Markenregel, keine Liste von Tickets zum Überspringen und keine Möglichkeit, die Gespräche des letzten Monats durchzuspielen, bevor etwas live geht. eesels KI-Helpdesk-Teammate bringt das mit. Er schließt sich deinem bestehenden Zendesk oder anderen Helpdesk an, liest dein Help Center, deine Makros und vergangene Tickets und läuft auf den Triggern, die du einschaltest, etwa einer @eesel-Erwähnung in einer internen Notiz.
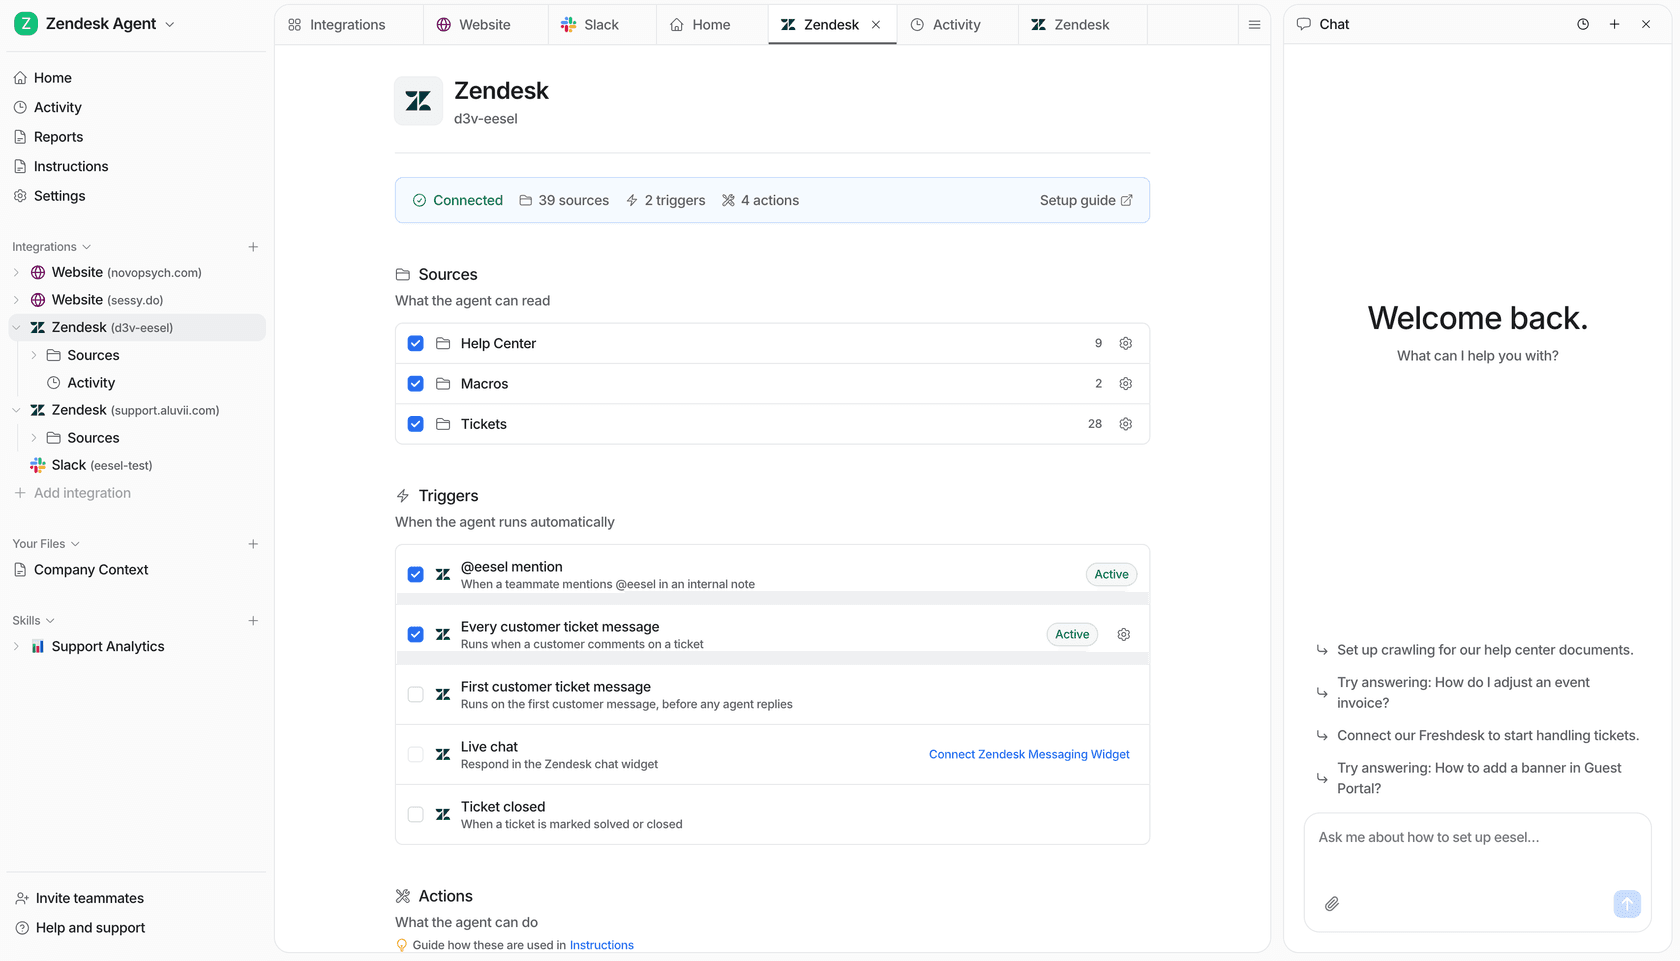
Wenn du Modelle vom Terminal aus testest, wird dir die eesel CLI gefallen. Sie steuert denselben Teammate wie das Dashboard: eesel integrations connect zendesk startet die Helpdesk-Verbindung, eesel automations listet auf und schaltet ein, was der Agent von selbst tut, und eesel chat "how do I reset a password?" stellt ihm eine Frage und streamt die Antwort. Jeder Befehl gibt JSON aus, sodass ein Coding-Agent das Setup für dich ausführen kann. Mein Leitfaden zur KI-Agenten-CLI geht weiter.
Die Pläne beginnen bei 299 $ im Monat für 500 Credits, und die kostenlose Testversion enthält 100 Credits ohne Karte. Teste eesel an deinen eigenen vergangenen Tickets oder sieh dir zuerst die Preisseite an. Wenn es bei dir um Inhalte statt Tickets geht, gibt es bei eesel auch einen KI-Blog-Autor.