

Was ist ein Entscheidungsmodell?
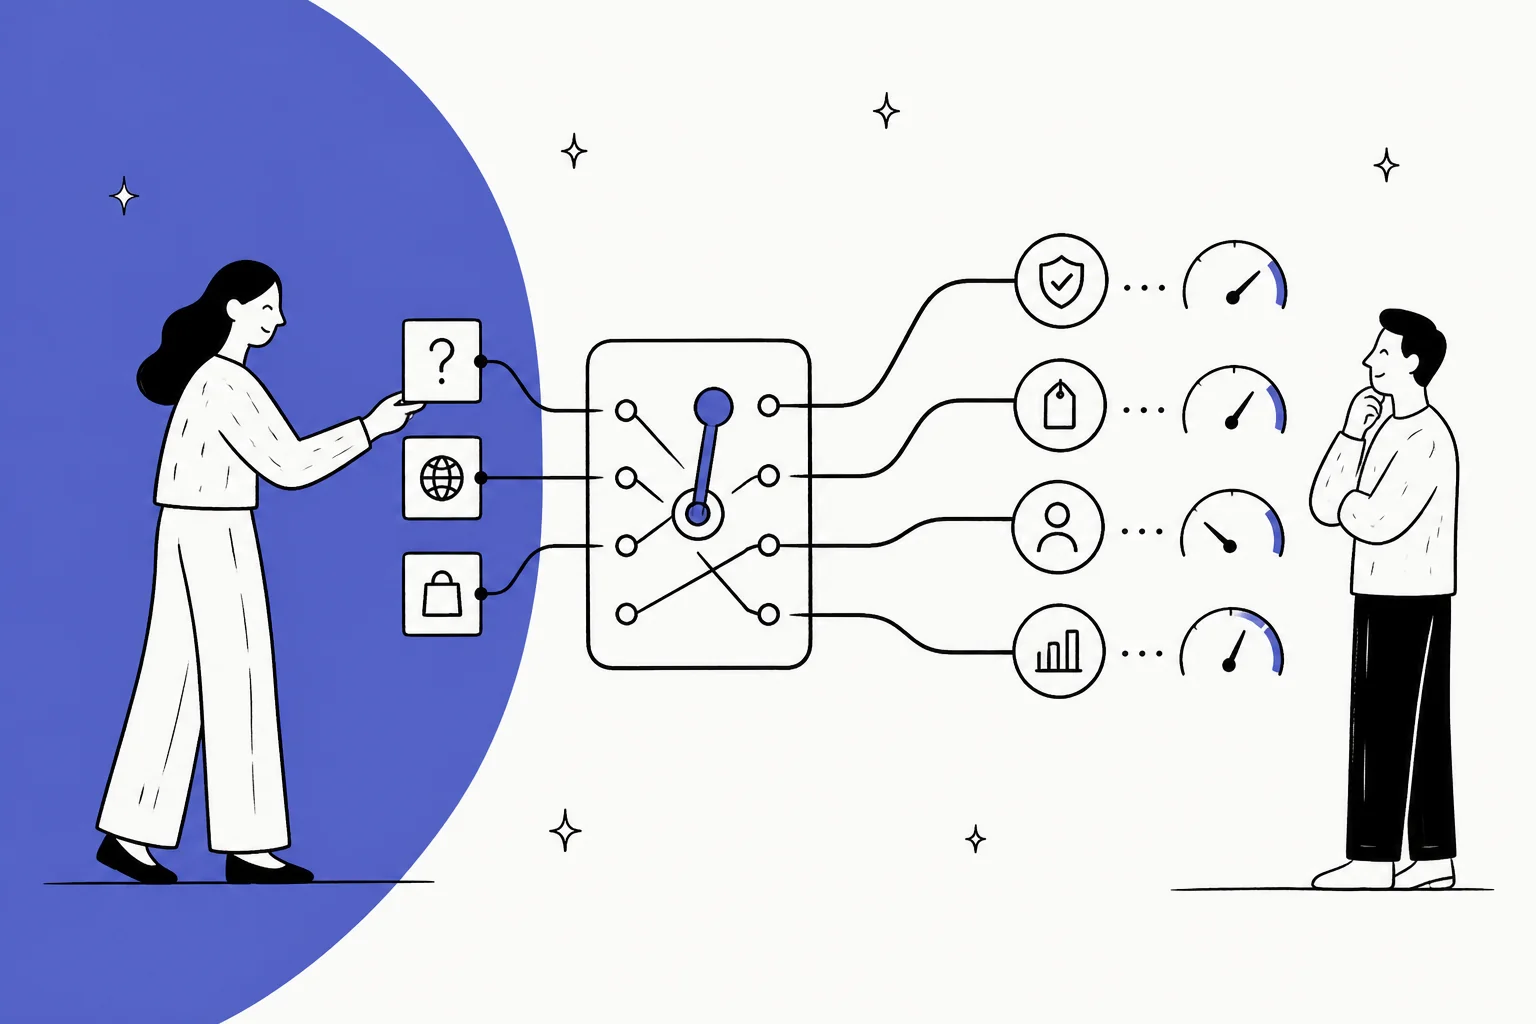
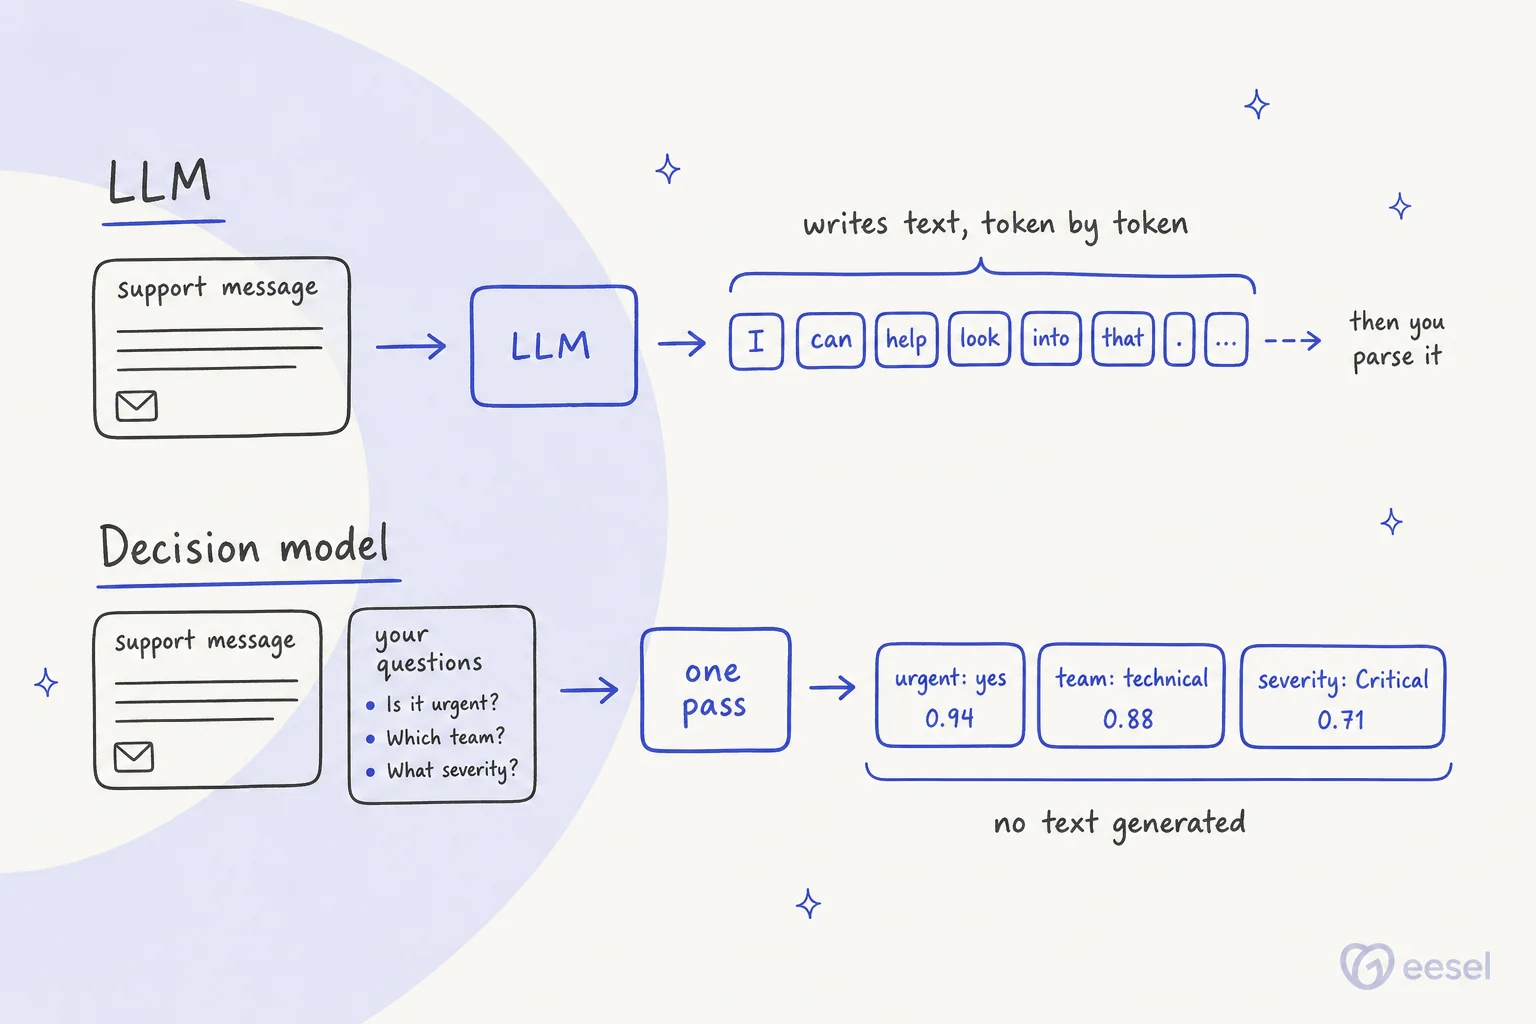
Ein Entscheidungsmodell nimmt zwei Dinge entgegen: einen State (die Roheingabe, etwa eine Support-E-Mail, einen JSON-Block oder einen Screenshot) und eine Reihe typisierter Fragen dazu. Es sendet pro Frage eine typisierte Antwort zurück, jeweils mit einer Wahrscheinlichkeit. Kein Absatz, kein JSON, das Sie erst parsen müssen, kein „Gerne! Hier ist meine Analyse.“
TypeSafes Dokumentation beschreibt das gelöste Problem treffend: Wenn Sie ein LLM um ein Urteil bitten, das Ihr Code weiterverarbeitet, „zwingen Sie ein Textgenerierungssystem, strukturierte Entscheidungen auszugeben, und parsen die Ergebnisse dann zurück“. Ein Entscheidungsmodell verzichtet komplett auf Text.
Fast jedes Modell der Kategorie hat sich auf dieselben drei Fragetypen geeinigt, die TypeSafe Primitive nennt:
| Fragetyp | Was er fragt | Was zurückkommt | Support-Beispiel |
|---|---|---|---|
| Noul | Stimmt diese Aussage? | Eine Wahrscheinlichkeit, 0 bis 1 | „Ist diese Anfrage dringend?“ |
| Choice | Welche Option passt? | Die Wahl, eine Wahrscheinlichkeit pro Option, eine Konfidenz | „Abrechnung, Technik oder Vertrieb?“ |
| Score | Wo auf dieser Skala? | Eine Stufe, eine Wahrscheinlichkeit pro Stufe, eine Konfidenz | „Keine Auswirkung, gering, hoch oder kritisch?“ |
Sie können alle drei in einer Anfrage mischen, und jede Frage wird parallel gegen denselben State ausgewertet. TypeSafe sagt, „zusätzliche Fragen verändern die Antwortzeit kaum“, und die Strands-Decider-README betont dasselbe: Der Text wird einmal gelesen, und „jede Frage kostet nur ihre eigenen Tokens“.
So sieht das in der Praxis aus, aus Cloudflares eigenem Launch-Beispiel. Ein Aufruf stellt drei Fragen zu einer einzigen Supportnachricht:
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
Wenn Sie schon einmal Ticket-Triage von Hand gemacht haben, kommt Ihnen diese Anfrage bekannt vor. Es sind Dringlichkeit, Team und Schweregrad, dieselben drei Felder, die auch ein menschlicher Triagierer ausfüllt, und dieselbe Aufteilung, die hinter Dringlichkeit und Auswirkung in den meisten Helpdesks steckt.
Wie funktioniert ein Entscheidungsmodell im Inneren?
Das ist der Teil, den ich am spannendsten finde, denn der Trick ist einfacher, als das Marketing vermuten lässt.
Die meisten offenen Entscheidungsmodelle starten von einem gewöhnlichen offenen LLM (meist eine Qwen- oder Gemma-Basis) und ändern, wie es antwortet. Cloudflares Launch-Beitrag beschreibt, dass Clef „einen Prefill-only-Durchlauf macht und dann die gültigen Schema-Optionen parallel bewertet“. Strands hat den Sprachmodell-Kopf komplett entfernt, sodass Strands Decider 2B physisch keinen Text erzeugen kann. Laut seinem Launch-Blog hat der ergänzte Bewertungskopf „nur gut eine Million Parameter insgesamt“.
Einfach gesagt passieren drei Dinge:
- Das Modell liest State und Fragen einmal. Das ist der „Prefill“-Schritt, den jedes LLM vor dem Schreiben ausführt. Entscheidungsmodelle hören dort auf.
- Ein kleiner Kopf bewertet jede erlaubte Antwort. Statt „technical“ Buchstabe für Buchstabe zu erzeugen, bewertet er Abrechnung, Technik und Vertrieb gleichzeitig anhand dessen, was er gerade gelesen hat.
- Die Werte werden auf Ehrlichkeit trainiert. TypeSafe nennt seine Trainingsmethode Reinforcement Learning for Calibrated Decisions (RLCD). Cloudflare hat für Clef eine eigene Version von RLCD gebaut und koppelt sie mit einem Brier-Loss, einer Standardstrafe für übermütige Wahrscheinlichkeiten (Cloudflare).
Dieser dritte Schritt ist das eigentliche Produkt. Eine Konfidenz von 0.9 ist nur nützlich, wenn Antworten bei 0.9 in etwa 90% der Fälle stimmen. Strands berichtet, dass bei ungesehenen kurzen Klassifizierungsaufgaben „Antworten mit einer Konfidenz von 0.9 oder mehr in etwa 95% der Fälle richtig sind“. Deshalb werden Entscheidungsmodelle für die Ticket-Priorisierung und andere Entscheidungen empfohlen, bei denen Sie einen sicheren Grenzwert wollen. Genau diese Eigenschaft erlaubt if confidence > 0.9: auto-route, else: send to a human.
Weil nichts generiert wird, sinken die Ausgabekosten auf null oder nahe null. Vergleichen Sie das mit Function Calling bei einem LLM, wo jede Klammer und jedes Anführungszeichen ein abgerechnetes Ausgabe-Token ist. Dasselbe gilt für den JSON-Modus. Jev berechnet nichts für die Ausgabe, und Clef führt gar keinen Ausgabepreis. Deshalb setzt Jevs Startseite so stark auf den Ansatz „mehr wie Code“: eine Anfrage, eine typisierte Antwort, jedes Mal.
Entscheidungsmodelle vs. LLMs vs. klassische Klassifikatoren
Der lauteste Einwand auf Hacker News lautet, das sei bloß ein Klassifikator mit neuem Etikett. Ein Kommentator fasste es als „Entscheidungsmodell = Klassifikator“ zusammen. Bei der Mathematik haben sie nicht unrecht. Falsch liegen sie bei dem, was sich für die Person ändert, die es ausliefert.
"LLM as judges - generalized, but too slow. ... traditional classifiers, very specific 1 trick pony, super fast and cheap once built. ... decision models/jev - are generic, you can throw them at most generic classification problems, and they are good enough."

Das ist die ehrliche Version. So vergleichen sich die drei Optionen für eine typische Aufgabe des KI-Ticket-Routings:
| LLM mit striktem Schema | Entscheidungsmodell | Klassischer trainierter Klassifikator | |
|---|---|---|---|
| Neue Labels | Prompt ändern | Anfrage ändern | Daten sammeln, neu trainieren |
| Ausgabe | Text, den Sie parsen | Typisierte Antwort + Wahrscheinlichkeit | Label + Wahrscheinlichkeit |
| Typische Latenz | 1 bis 3 Sekunden (mein Luna-Test: 1.3 bis 2.6 s) | 39 bis 524 ms Median | Unter 10 ms |
| Kosten für Ausgabe-Tokens | Abgerechnet (Luna: $0.50/M) | Kostenlos oder nicht abgerechnet | Keine (selbst gehostet) |
| Kalibrierte Konfidenz | Schwach nach dem Post-Training | Das Kernfeature | Möglich, schwer richtig hinzubekommen |
| Kann eine Antwort schreiben | Ja | Nein | Nein |
| Am besten für | Offene Aufgaben, Antworten, Reasoning | Viele kleine Zero-Shot-Aufrufe | Eine feste, hochvolumige Aufgabe |
Die Luna-Latenzwerte stammen aus einem Test mit GPT-6 Luna bei ausgeschaltetem Reasoning, den ich für meinen Beitrag zu den Decisions-API-Preisen gemacht habe. Der Bereich für Entscheidungsmodelle stammt aus dem Cloudflare-Benchmark weiter unten, ohne Laya. Die Zeile des Klassifikators spiegelt Laya, einen 421M-Encoder, der sich weitgehend wie ein klassischer Klassifikator verhält und den Cloudflare mit 5.8 ms gemessen hat.
Auf die Spalte „Neue Labels“ würde ich mich konzentrieren. Ein anderer Kommentator hat das praktische Argument besser formuliert als jeder Anbieter: „Dass man ein beliebiges Klassifizierungsproblem in Minuten statt in einer Woche erledigt, ist eine große Sache.“ Wenn Ihr Support-Team jedes Quartal eine neue Produktlinie und eine neue Routing-Kategorie bekommt, ist das vierteljährliche Neutrainieren eines Klassifikators der versteckte Kostenpunkt, den ein Entscheidungsmodell beseitigt.
Welche Entscheidungsmodelle können Sie heute nutzen?
Die Kategorie hat sich absurd schnell entwickelt. Der von der Community betriebene Jev Decision Index startete am 22. September mit 31 offenen Teilnehmern und führte beim Update vom 28. September 70 offene Modelle. Die meisten sind Hobby-Nachbauten. Hier die Modelle mit echtem Anbieter oder bemerkenswertem Wert dahinter:
| Modell | Hersteller | Größe | Offene Gewichte | Gehostet | Preis | Eingaben | Decision Index |
|---|---|---|---|---|---|---|---|
| Jev | TypeSafe | Nicht offengelegt | Nein | TypeSafe API, Workers AI | $0.042/M Input, Output kostenlos | Text | 57.9 |
| Clef | Cloudflare | 27B | Ja, Apache 2.0 | Workers AI | $0.24/M Input | Text, JSON, Bilder, Video | 61.2 (selbst berichtet) |
| Clef-flash | Cloudflare | 9B | Ja, Apache 2.0 | Workers AI | $0.09/M Input | Text, JSON, Bilder, Video | 57.1 (selbst berichtet) |
| pplx-decider-v1-27b | Perplexity | 26B | Ja | Nicht verifiziert | Selbst hosten | Text, Bilder | 56.4 |
| Strands Decider 2B | AWS Strands Labs | 1.9B | Ja, Apache 2.0 | Nein | Kostenlos (selbst hosten) | Text (Bilder experimentell) | Nicht auf dem Board |
| Bespoke-Nimble-9B-v2 | Bespoke Labs | 9B-Adapter | Ja | Nein | Selbst hosten | Text | 39.6 |
| Kev 9B | Jared Palmer | 9B-Adapter | Ja, Apache 2.0 | Nein | Selbst hosten | Text | 38.5 |
| Tev1-4B | Together AI | 4B | Ja, Lizenz nicht final | Together serverless | Nicht erfasst | Text | 29.0 |
| Laya | Convai Innovations | 421M | Ja, Apache 2.0 | Nein | Selbst hosten | Text, 100+ Sprachen | 6.0 |
| Decisions API | OpenAI | Basiert auf GPT-6 Luna | Nein | Limited Preview | Nicht veröffentlicht | Text, Bilder | Nicht auf dem Board |
Quellen: der Decision Index, Cloudflares selbst berichtetes Board und die jeweils eigene Seite jedes Modells, die in den Abschnitten unten verlinkt ist. Der Index ist über 38 Benchmarks zufallskorrigiert, 0 bedeutet also reines Raten.
Die vier, die ich mir zuerst ansehen würde, folgen unten.
TypeSafe Jev
Jev ist das Original und weiterhin die Referenz, an der sich alle messen. Es ist ein geschlossenes Modell von TypeSafe AI, einem Team aus San Francisco unter der Leitung von Diogo Almeida, der die RLHF- und InstructGPT-Methoden hinter ChatGPT mitentwickelt hat. Am 27. September hat TypeSafe die Warteliste abgeschaltet, sodass jetzt jeder ein Konto anlegen kann.
Der Einstiegspreis im Launch-Beitrag beträgt $0.042 pro Million Input-Tokens bei kostenloser Ausgabe, und TypeSafe nennt Ende-zu-Ende-Antwortzeiten von 70 bis 500 ms. Es verarbeitet nur Text mit 32K Kontext. Zwei Dinge sollten Sie vor der Entscheidung wissen: Jevs Architektur und Gewichte sind nicht öffentlich, und TypeSafe selbst sagt, es „kann nicht beweisen, dass es nicht subventioniert ist“.
Für die Kostenrechnung bei Ihrem Volumen sehen Sie sich meine Aufschlüsselung der Jev-Preise an. Eine praktische Einschätzung finden Sie in meinem Jev-Test. Außerdem gibt es eine separate Stufe mit geringerer Latenz, die ich als Jev Ultrafast beschrieben habe.
Cloudflare Clef und Clef-flash
Clef ist das offene Modell, das Jev angeblich schlägt. Cloudflare hat es auf Qwen3.8-27B gebaut (Clef-flash auf Qwen3.5-9B), beide unter Apache 2.0 veröffentlicht und vollständig Jev-API-kompatibel gemacht, sodass der Wechsel meist nur eine geänderte URL bedeutet.
Clefs zwei echte Vorteile gegenüber Jev sind Vision (es liest Bilder und Video) und ein 64K-Kontext. Nach Cloudflares Zahlen gewinnt es außerdem 3 von 4 der eigenen Workflow-Evals von TypeSafe, darunter den Kundenservice, wo alle drei Modelle innerhalb eines Punktes liegen (Clef 76.3, Clef-flash 77, Jev 76.0). Der Haken: Beide Clef-Werte sind Cloudflare, das seine eigenen Hausaufgaben benotet. Sie sind auf dem Upstream-Board nicht reproduziert, und Cloudflare hat zwei Benchmarks ausgelassen. Außerdem kostet es etwa das 5.7-Fache von Jevs Preis pro Token. Die Rechnung pro Entscheidung habe ich in meinem Beitrag zu den Cloudflare-Clef-Preisen gemacht.
Strands Decider 2B
Strands Decider 2B ist der Beitrag von AWS Strands Labs, verfasst von Marc Brooker, Mike Chambers und Fabio Nonato de Paula. Es ist die kleine Option, die auf Ihrem Laptop läuft: 1.9B Parameter auf einer Qwen3.5-2B-Basis, mit veröffentlichten Gewichten, Trainingsdaten und Trainingsskripten.
Es läuft auf CPU, NVIDIA-GPUs oder Apple Silicon, mit einem Median von 115 ms auf einer RTX 3090 und 153 ms auf einem M3 Pro bei kurzen Prompts, laut GitHub-Repo. Auf JevBench erreicht die neueste Version 0.762. Ich mag, wie offen der Launch-Beitrag ist: Er sagt, das Single-Pass-Design mache es „deutlich schlechter bei komplexen Problemen als Reasoning-Modelle“ und ungeeignet für Chatbots oder Zusammenfassungen. Zwei praktische Hinweise: Es gibt keine gehostete Version (Hugging Face zeigt keinen Inference-Provider), und sein lokaler Server hat keine Authentifizierung, taugt also für Experimente, nicht für Produktionsverkehr. Wenn Sie bereits auf dem Strands-Harness aufbauen, lässt es sich als Proceed/Deny-Gate in einen Tool-Call-Hook einklinken.
OpenAI Decisions API
OpenAI hat die Decisions API am 29. September auf der DevDay angekündigt, und der DevDay-Rückblick beschreibt sie als „Lunas Intelligenz auf eine bestimmte Menge nutzerdefinierter Fragen mit endlichen, vordefinierten Antworten zu fokussieren“. Sieben Tage später finde ich weiterhin keine Dokumentationsseite, kein Referenzschema, keine Preiszeile und keinen Changelog-Eintrag. Der Endpunkt /v1/decisions existiert, aber ein Standardschlüssel erhält ein HTTP 403 mit dem Hinweis, die API sei für diesen Nutzer nicht aktiviert.
Die einzige überprüfbare OpenAI-Zahl ist daher vorerst Lunas Token-Preis: $0.10 pro Million Input und $0.50 pro Million Output. Wenn Sie heute bei OpenAI sind, erledigt ein Luna-Aufruf mit striktem Enum-Schema dieselbe Aufgabe. Mein Beitrag zur OpenAI Decisions API zeigt diesen Workaround.
Wie schnell sind Entscheidungsmodelle?
Beim Tempo verdient die Kategorie ihren Namen. Cloudflare hat die Median-Latenz über 43 Benchmarks für sechs Entscheidungsmodelle auf seinem eigenen Stack gemessen:
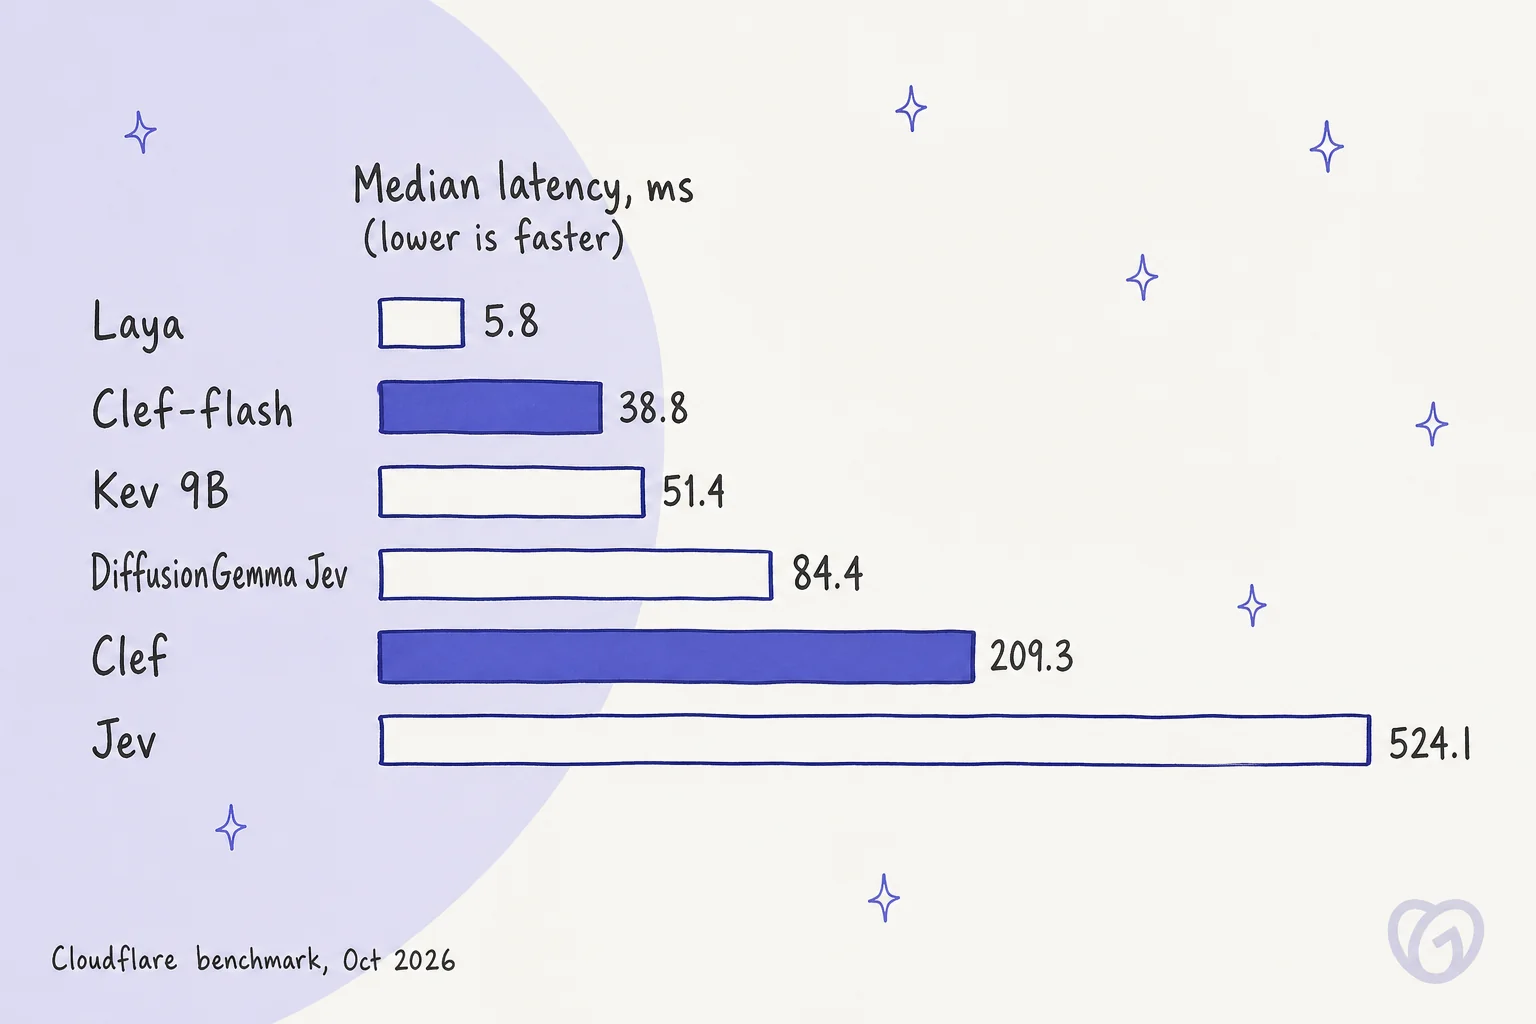
Zwei ehrliche Einschränkungen zu diesem Diagramm. Erstens ist Jevs 524 ms ein gehosteter Round Trip über das Internet, während die offenen Modelle auf Cloudflares eigenen GPUs gemessen wurden, es ist also kein fairer Vergleich. Zweitens ist Laya blitzschnell, erreicht aber nur 6.0 im Decision Index. Tempo ohne Genauigkeit ist nur eine schnelle falsche Antwort.
Zum Vergleich: Ein LLM für dieselbe Aufgabe wird in Sekunden gemessen. Ein Entwickler, der bei einem Mock-Support-Agenten die Guardrail-Schicht von einem LLM auf Jev umgestellt hat, berichtete bei einem kleinen Test mit 51 Fällen „194ms vs 5,825ms. $125 vs $5,894 pro Million Prüfungen“. Dieser Abstand ist das ganze Argument dafür, ein Entscheidungsmodell als Guardrail vor einen KI-Helpdesk-Agenten zu setzen.
Sind Entscheidungsmodelle genau?
Hier würde ich dem Hype widersprechen. Entscheidungsmodelle sind für viele Aufgaben gut genug, aber nicht die genaueste Option auf dem Tisch.
Auf JevBench beschreiben die Strands-Evaluationsnotizen die Spitze des Boards als „Reasoning-Modelle (GPT-6 Luna 0.996), dann Jev-Nachbauten auf größeren Torsos, meist 12B und mehr (0.83-0.93)“. Ein Reasoning-LLM wie Luna oder Claude Sonnet 5.5 gewinnt bei der Genauigkeit weiterhin. Entscheidungsmodelle gewinnen bei Kosten, Tempo und Kalibrierung, und Sie tauschen dafür ein paar Punkte Genauigkeit ein.
Die Genauigkeit sinkt auch, wenn die Zahl der Labels wächst. Layas eigene Karte zeigt 0.425 auf BANKING77 (77 Labels) gegenüber Jevs 0.870 (Laya). Wenn Ihr Helpdesk 60 Routing-Kategorien hat, testen Sie alle 60, nicht eine aufgeräumte Demo mit vier.
Und die Konfidenzwerte, das zentrale Verkaufsargument, sind noch keine gesicherte Wissenschaft:
"for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones."
Ein Tester fragte Jev nach dem Ergebnis eines fairen Würfelwurfs und bekam rund 80% Konfidenz für „1“ zurück (wat10000). Ein anderer zeigte, wie eine offene Jev-Kopie auf „100% legitim“ umschlug, als die E-Mail selbst behauptete, legitim zu sein (FooBarWidget). Entscheidungsmodelle können keinen Absatz halluzinieren, aber sie können sehr wohl selbstsicher falsch liegen oder sich zu einer Antwort überreden lassen.
Die Strands-Modellkarte nennt die richtige Voreinstellung: „Messen Sie mit Ihrem eigenen Traffic, bevor Sie einem Schwellenwert vertrauen.“ Es ist dieselbe Lehre wie beim Verhindern von KI-Halluzinationen im Support: mit echten Tickets testen, nicht mit Demos.
Welches Entscheidungsmodell passt zu Ihrer Aufgabe?
Wählen Sie die Situation, die Ihrer am nächsten kommt.
Dieser letzte Tab ist kein Witz. Ein Reddit-Kommentator hat es perfekt formuliert: „Die Hälfte des Routings, das ich geschrieben habe, war am Ende ein verkleidetes if-Statement.“ Einfache Zendesk-Routing-Regeln decken noch viel ab.
Wo passen Entscheidungsmodelle in den Kundensupport?
Der Support ist der Anwendungsfall, nach dem jeder Anbieter zuerst greift, und das aus gutem Grund. Auto-Triage besteht großteils aus einem Stapel kleiner, begrenzter Entscheidungen. Cloudflares Launch-Beispiel ist ein Support-Ticket. TypeSafes eigene Workflow-Evals enthalten einen Kundenservice-Satz mit 5,330 Zeilen.
Intent-Klassifizierung ist eine Choice-Frage. Genauso die Spam-Erkennung. Dringlichkeit ist ein Score, und „Soll das an einen Menschen gehen?“ ist ein Ja/Nein, das Herzstück der KI-Eskalation. Sogar die Stimmungsanalyse ist ein Score auf einer festen Skala. Alles sind begrenzte Fragen mit einer festen Menge von Antworten. Genau dafür ist ein Entscheidungsmodell gebaut.
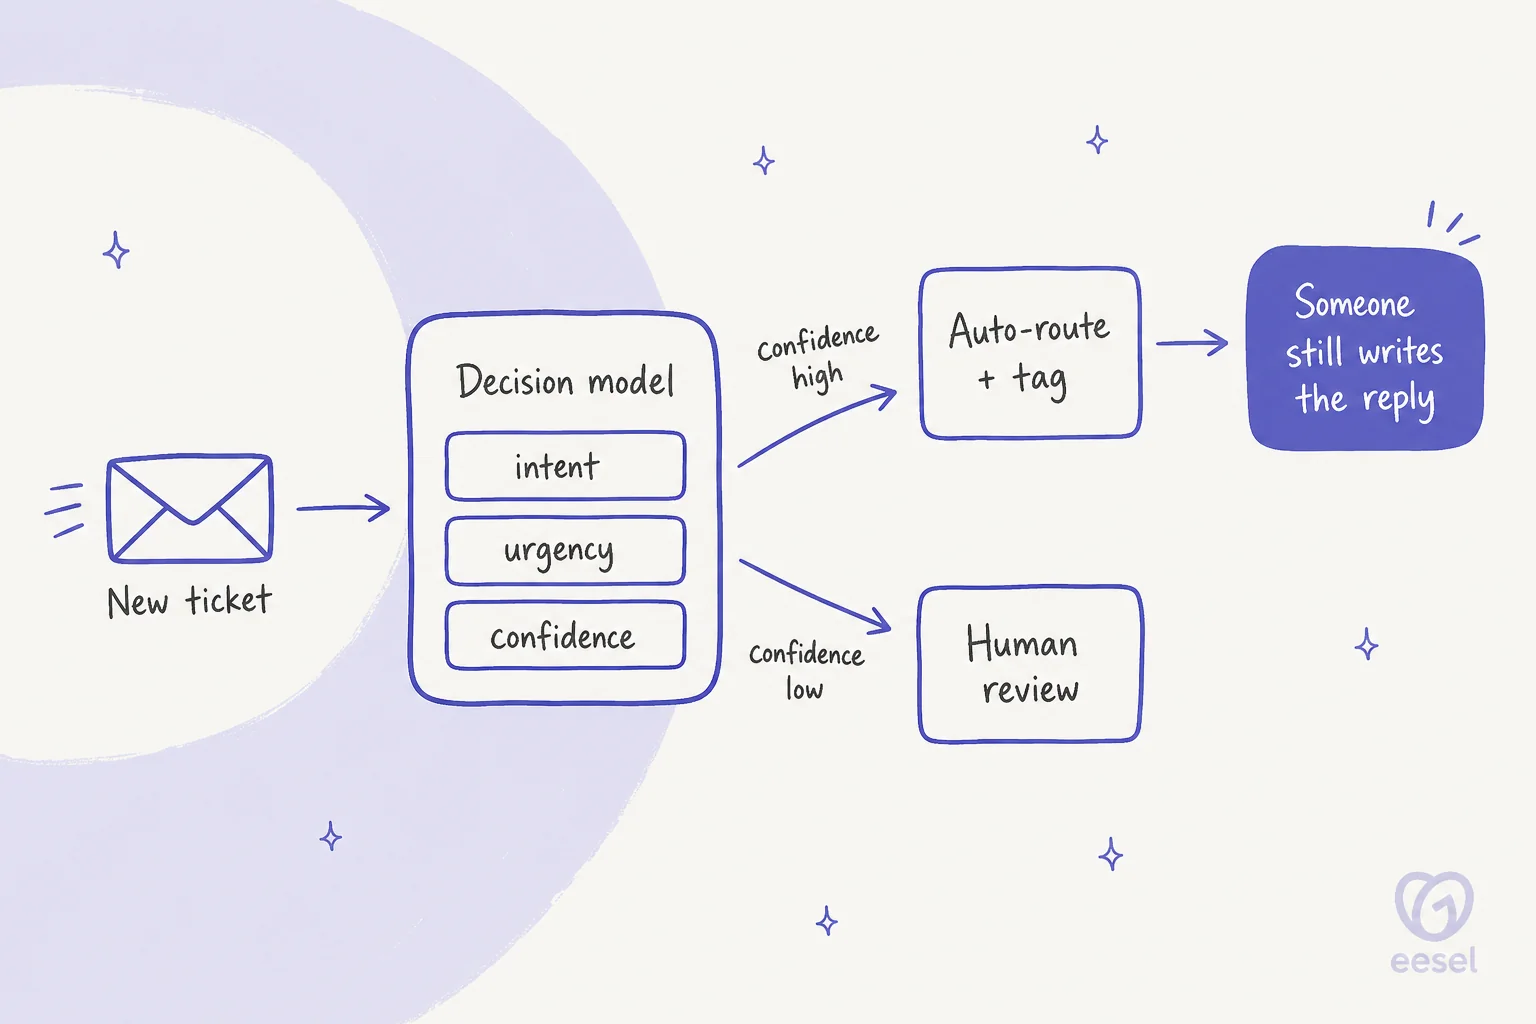
Das habe ich in Jahren gelernt, in denen ich bei eesel KI auf Live-Support-Queues gesetzt habe: das Sortieren ist die leichte Hälfte. In einem kreuzvalidierten Test im echten Zendesk-Posteingang eines E-Commerce-Unternehmens erreichte die KI-Triage 93% Genauigkeit und erkannte 100% des Spams, der 22% des Posteingangs ausmachte. Im selben Test wurden nur 12% der KI-Antwortentwürfe unverändert gesendet, und 7% enthielten einen sachlichen Fehler. Die Ticket-Klassifizierung war fast gelöst. Die Arbeit steckte in der Antwort.
Der Konfidenzwert ist das, wonach Käufer schon immer gefragt haben. Ein CX-Leiter mit 7,000 Tickets im Monat sagte eesels Team in einem Verkaufsgespräch:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist die Kernidee eines Entscheidungsmodells in einem Satz. Es ist auch der Grund, warum eesel jeden Rollout an den historischen Tickets eines Teams simuliert, bevor etwas live geht: Eine selbstsicher falsche Antwort ist schlimmer als keine Antwort, und nur mit echtem Traffic erfahren Sie, wo Ihr Schwellenwert liegt.
Ein praktischer Hinweis eines MSP-Inhabers ist es wert, gehört zu werden, bevor Sie Ihren Stack um Geschwindigkeit herum neu bauen. In einem r/SmallMSP-Thread sagte er, das Modell sei nicht der Engpass: „Ich vermute, dass Autotask bei der Geschwindigkeit mein schwaches Glied ist.“ Zwei Sekunden bei einem Routing-Aufruf einzusparen, bringt wenig, wenn das Ticket danach 40 Minuten in einer Queue liegt.
Wo gehört ein Entscheidungsmodell also hin? In einen Workflow, den Sie selbst bauen, als günstiger erster Durchlauf. Wenn Sie Code schreiben und Millionen von Ereignissen verarbeiten, ist ein Entscheidungsmodell ein toller Baustein für Routing, Moderation oder Guardrails, und meine Übersicht der Jev-Alternativen deckt die Selbstbau-Optionen ab. Wenn Sie ein Support-Team sind, das Tickets in seinem bestehenden Helpdesk getaggt, geroutet, eskaliert und beantwortet haben möchte, ist ein rohes Modell der Beginn eines Projekts, nicht dessen Ende. Sie müssten weiterhin das Tagging, den Eskalationsprozess, die Wissenssuche und die Antwort bauen.
Für den vollständigen DIY-Weg starten Sie mit meinem Leitfaden zur Automatisierung der Ticket-Triage. Wenn Sie lieber kaufen als bauen, vergleicht meine Übersicht der KI-Triage-Tools die fertigen Optionen.
eesel für Triage und Antworten testen
eesels KI-Helpdesk-Teammate erledigt beide Hälften der Aufgabe, von denen Entscheidungsmodelle nur eine leisten. Es steigt in Ihre bestehende Queue ein (es gibt eine Zendesk-Integration, außerdem Freshdesk und Gorgias), vergibt Tags und leitet Tickets weiter, eskaliert, was es nicht anfassen sollte, und schreibt die Antwort aus Ihrem Help Center und vergangenen Tickets. Jede Automatisierung hat sogar eine Einstellung „Model strength“, mit einem leichteren Modell „für einfache Aufgaben wie Tagging oder Routing“ (Automatisierungs-Doku) und dem stärkeren für das Verfassen, sodass die günstige Entscheidung und die schwere Antwort bereits auf verschiedenen Modellen laufen.

Die Konfidenz-Idee zieht sich auch hier durch. Jede Aktion (ein Tag, eine Antwort, eine Erstattung) ist auf automatisch, genehmigungspflichtig oder deaktiviert gesetzt, und Ereignisse, die Ihre Anweisungen nicht abdecken, werden übersprungen und mit Begründung protokolliert. Vor dem Livegang können Sie eine Simulation an Ihren eigenen vergangenen Tickets laufen lassen.
Wenn Sie als Entwickler hierher gekommen sind, ist die eesel CLI die Brücke. Führen Sie npx @eesel/cli aus, und Sie können einen Helpdesk verbinden, per eesel automations eine Automatisierung mit Routing-Anweisungen in Alltagssprache einrichten und mit eesel approvals zurückgehaltene Aktionen freigeben oder ablehnen, alles aus einem Terminal. Jeder Befehl gibt JSON zurück, sodass Claude Code, Cursor oder Codex das gesamte Setup steuern können, und --dry-run prüft eine Schreiboperation, bevor sie passiert. Sie bekommen die Routing-Logik, die Sie um ein Entscheidungsmodell herum gebaut hätten, plus den Teil, der dem Kunden antwortet, ohne den Klebstoff-Code zu schreiben.
Pläne starten bei $299 im Monat für 500 Credits auf der eesel-Preisseite, wobei ein Credit einem Ticket entspricht, ohne Gebühren pro Nutzerplatz, und es gibt einen kostenlosen Tarif mit 100 Credits. Testen Sie eesel an Ihren eigenen Tickets und sehen Sie, wo Ihre Konfidenzgrenze tatsächlich liegt.
Häufig gestellte Fragen
Was ist ein Entscheidungsmodell in der KI?
Ein Entscheidungsmodell ist ein kleines KI-Modell, das typisierte Fragen (Ja/Nein, eine Auswahl oder eine Bewertung auf einer Skala) zu einer Eingabe beantwortet und jede Antwort mit einer Wahrscheinlichkeit zurückgibt, statt Text zu schreiben. TypeSafe Jev hat die Kategorie im September 2026 gestartet, und Entscheidungsmodelle werden inzwischen für Aufgaben wie Ticket-Triage eingesetzt. Ein Ticket nach Thema zu sortieren, auch Intent-Klassifizierung genannt, ist eine typische Aufgabe.
Worin unterscheiden sich Entscheidungsmodelle von LLMs?
Ein LLM erzeugt Text Token für Token, sodass Sie seine Antwort erst parsen müssen. Ein Entscheidungsmodell liest die Eingabe einmal und bewertet die erlaubten Antworten in einem einzigen Durchlauf. Es gibt also keinen Text zu erzeugen, und die Ausgabe ist praktisch kostenlos. Der Preis dafür: Entscheidungsmodelle können keine Antworten, keinen Code und keine Zusammenfassungen schreiben. Deshalb braucht ein Support-Team für die Antwort weiterhin einen KI-Helpdesk-Agenten oder einen Menschen.
Sind Entscheidungsmodelle nicht einfach Klassifikatoren?
Mathematisch sind sie sich nah: Sie wählen aus Labels und geben Wahrscheinlichkeiten zurück. Neu ist, dass sie Zero-Shot mit Labels arbeiten, die Sie erst zur Anfragezeit definieren. Sie müssen also keine Daten sammeln und kein Modell trainieren, wenn ein neues Problem der Ticket-Klassifizierung auftaucht.
Was kosten Entscheidungsmodelle?
Jev kostet $0.042 pro Million Input-Tokens bei kostenloser Ausgabe, Cloudflare Clef kostet $0.24 und Clef-flash $0.09 pro Million Input-Tokens, und Strands Decider 2B ist kostenlos, wenn Sie es selbst betreiben. OpenAI hat keinen Preis für seine Decisions API veröffentlicht. Meinen Beitrag zu den Jev-Preisen finden Sie mit der vollständigen Rechnung. Zu Clef siehe die Aufschlüsselung der Clef-Preise.
Welches Entscheidungsmodell ist das beste?
Im Community-Decision-Index erreicht Jev 57.9, und kein unabhängig getestetes offenes Modell schlägt es bisher. Cloudflare meldet für Clef 61.2 auf seiner eigenen Kopie des Boards, aber dieser Wert ist selbst berichtet. Für Bilder: Clef; für Offline- oder CPU-Betrieb: Strands Decider 2B; für die günstigsten gehosteten Textentscheidungen: Jev.
Kann ich ein Entscheidungsmodell für das Ticket-Routing nutzen?
Ja. Routing, Dringlichkeit und Eskalationsentscheidungen bei Tickets sind der Paradefall, und Cloudflares eigenes Launch-Beispiel leitet eine Supportnachricht nach Team und Schweregrad weiter. Sie brauchen weiterhin Code oder ein Helpdesk-Tool, das auf das Label reagiert, und genau das übernimmt ein KI-Helpdesk-Teammate von Anfang bis Ende.
Ist die OpenAI Decisions API verfügbar?
OpenAI hat die Decisions API auf der DevDay 2026 als Limited Preview angekündigt. Stand 6. Oktober 2026 gibt es weder öffentliche Dokumentation noch ein Schema oder einen Preis, und der Endpunkt gibt für Standard-API-Schlüssel einen Fehler „nicht aktiviert“ zurück. Mein Beitrag zur OpenAI Decisions API hält den Wissensstand fest.
Ersetzen Entscheidungsmodelle einen KI-Support-Agenten?
Nein. Ein Entscheidungsmodell trifft eine eng begrenzte Entscheidung, etwa welches Team zuständig ist oder wie dringend es ist. Es schlägt keine Bestellung nach, wendet keine Erstattungsrichtlinie an und schreibt keine Antwort. Entscheidungsmodelle sind ein Baustein für die Automatisierung der Ticket-Triage, kein Ersatz für das Teammate, das das Ticket löst.