

Kurzfassung
Strands Decider 2B ist ein kostenloses, offenes 1,9B-Entscheidungsmodell aus AWS Strands Labs, veröffentlicht am 1. Oktober 2026. Sie geben ihm Text plus typisierte Fragen ("Welches Team?", "Ist das dringend?"), und es liefert in einem Durchgang ein Label mit Konfidenzwert. Es erreicht 0,762 auf JevBench, nahe an der Spitze seiner Größenklasse, und läuft auf einer Gaming-GPU in etwa 115 ms.
Was die meiste Berichterstattung zum Launch auslässt: Die Gewichte sind das Uninteressanteste in der Box. Es gibt keine gehostete API, der lokale Server hat keine Authentifizierung, und auf einem normalen CPU-Server braucht eine Frage etwa 1,6 Sekunden, nicht 115 ms. Was AWS tatsächlich ausgeliefert hat, ist ein offenes Kit mit Trainingsdaten, Rezept und Forschungsprotokoll, sodass Sie das Modell in rund 11 Stunden auf einer einzelnen RTX 3090 auf Ihre eigenen Fragen nachtrainieren können.
Für Support-Teams ist das Sortieren des Tickets die leichte Hälfte. In einem eesel-Test mit echtem Ticketaufkommen erreichte die KI-Triage 93% Genauigkeit, während nur 12% der entworfenen Antworten unverändert rausgingen. Wenn Sie Triage, Routing und Antwort gemeinsam in Zendesk oder Freshdesk erledigt haben wollen, übernimmt das eesels KI-Helpdesk-Teammate, ohne dass Sie ein Modell hosten müssen.
Was ist Strands Decider?
Strands Decider 2B ist ein kleines Entscheidungsmodell von Strands Labs, dem experimentellen Zweig des Open-Source-Projekts Strands Agents von AWS. Der Launch-Beitrag nennt Marc Brooker, Mike Chambers und Fabio Nonato de Paula als Autoren, und alles steht unter Apache-2.0.
Ein Entscheidungsmodell schreibt keinen Text. Stellen Sie es sich als kleines Sprachmodell ohne das Reden vor. Es beantwortet Fragen, die Sie definieren, aus Optionen, die Sie definieren, und nennt für jede eine Wahrscheinlichkeit. Die Kategorie wurde populär, nachdem TypeSafe Jev im September gestartet war, und das Strands-Team sagt das offen: Es sei "a type of model that has been gaining a lot of attention since TypeSafe AI's launch of Jev."
Ich baue eesels Integrationen und die Helpdesk-API, und der Triage-Aufruf (welches Team, wie dringend, ist es Spam) ist der Schritt, den ich in mehr Helpdesks eingebaut habe als jeden anderen. Deshalb habe ich diesen Release so gelesen, wie ich ein Bauteil für eine Pipeline lesen würde: Was liefert es zurück, wie schnell, wo bricht es, und was bleibt für mich zu bauen?
Hier das kurze Datenblatt:
| Eigenschaft | Strands Decider 2B |
|---|---|
| Veröffentlicht | 1. Oktober 2026 |
| Parameter | 1,9 Milliarden |
| Basismodell | Qwen3.5-2B-Base, LoRA Rang 16 + Pointer Head |
| Aktuelles Referenzmodell | strands-decider-2B-hobson-v21 (v19 bleibt veröffentlicht) |
| Fragetypen | noul (Ja/Nein), choice (eine von N), score (geordnete Skala) |
| Ausgabe | Eine Antwort pro Frage, mit kalibrierter Wahrscheinlichkeit |
| Kontext | standardmäßig 4.096 Token |
| Lizenz | Apache-2.0 (Gewichte, Code, Daten, Rezept) |
| Gehostete Option | Keine |
| Hardware | CUDA, Apple MPS oder MLX, CPU |
Jede Zeile stammt aus dem GitHub-README des Projekts und seiner Hugging-Face-Modellkarte.
Wie funktioniert Strands Decider?
Der Trick ist Subtraktion. Strands nimmt ein normales Sprachmodell, behält dessen "Torso" (die Schichten, die Text verstehen) und wirft den Kopf weg, der normalerweise Wörter erzeugt. An seiner Stelle sitzt ein winziger Pointer Head mit knapp über einer Million Parametern, der jede Antwortoption bewertet. Das README fasst es so zusammen: "One forward pass, no generation, no decoding loop."
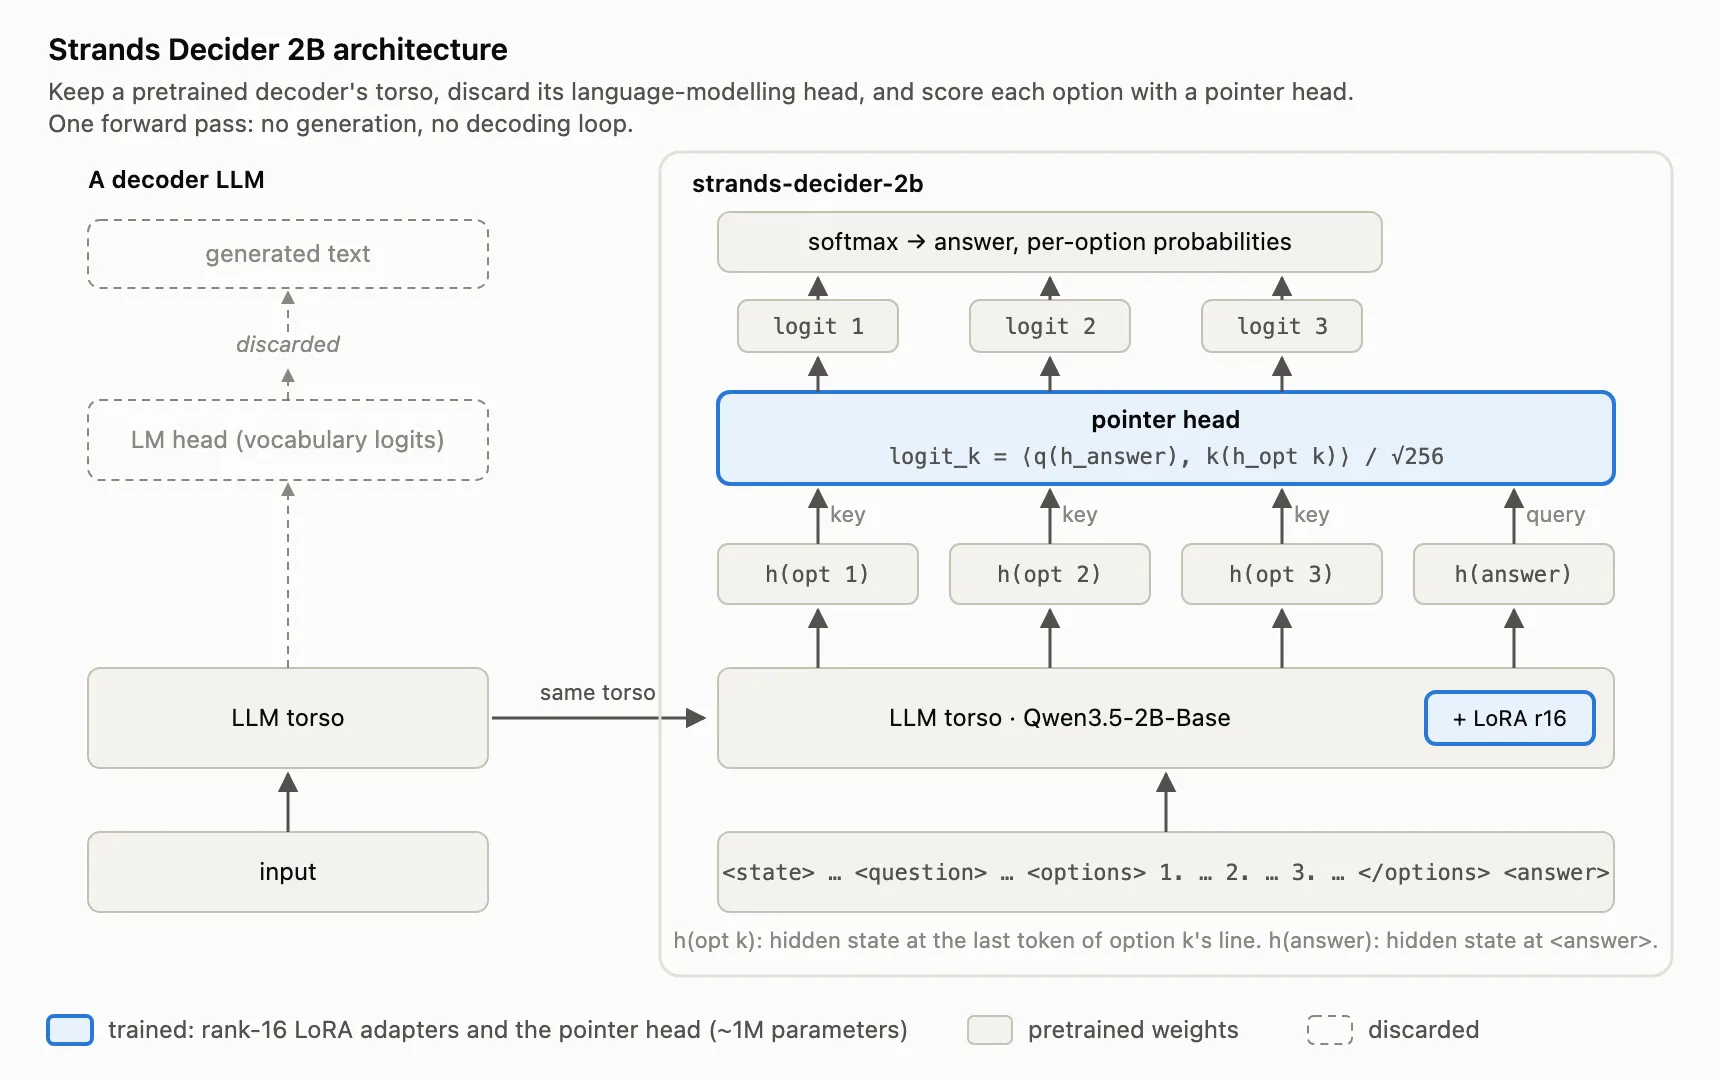
Weil es nie generiert, kann es nicht aus dem Format ausbrechen. Wenn Sie eines von billing, sales oder retail verlangen, bekommen Sie jedes Mal eines dieser drei. Das ist dasselbe Versprechen wie Function Calling bei einem großen LLM (oder dem lockereren JSON-Modus), aber günstiger, weil es keine Token-für-Token-Schleife und kein JSON zu parsen gibt.
Es heißt auch, dass zusätzliche Fragen sehr wenig kosten. Das Modell liest Ihren Text einmal, und "each question adds only its own tokens." Wenn Sie also in einem Aufruf "Welches Team?", "Ist es dringend?" und "Wie frustriert ist der Verfasser?" stellen, kostet das fast so viel wie eine einzige Frage.
Die Demo auf der Hugging-Face-Karte ist ein Support-Ticket, was genau verrät, wen AWS als Käufer sieht:
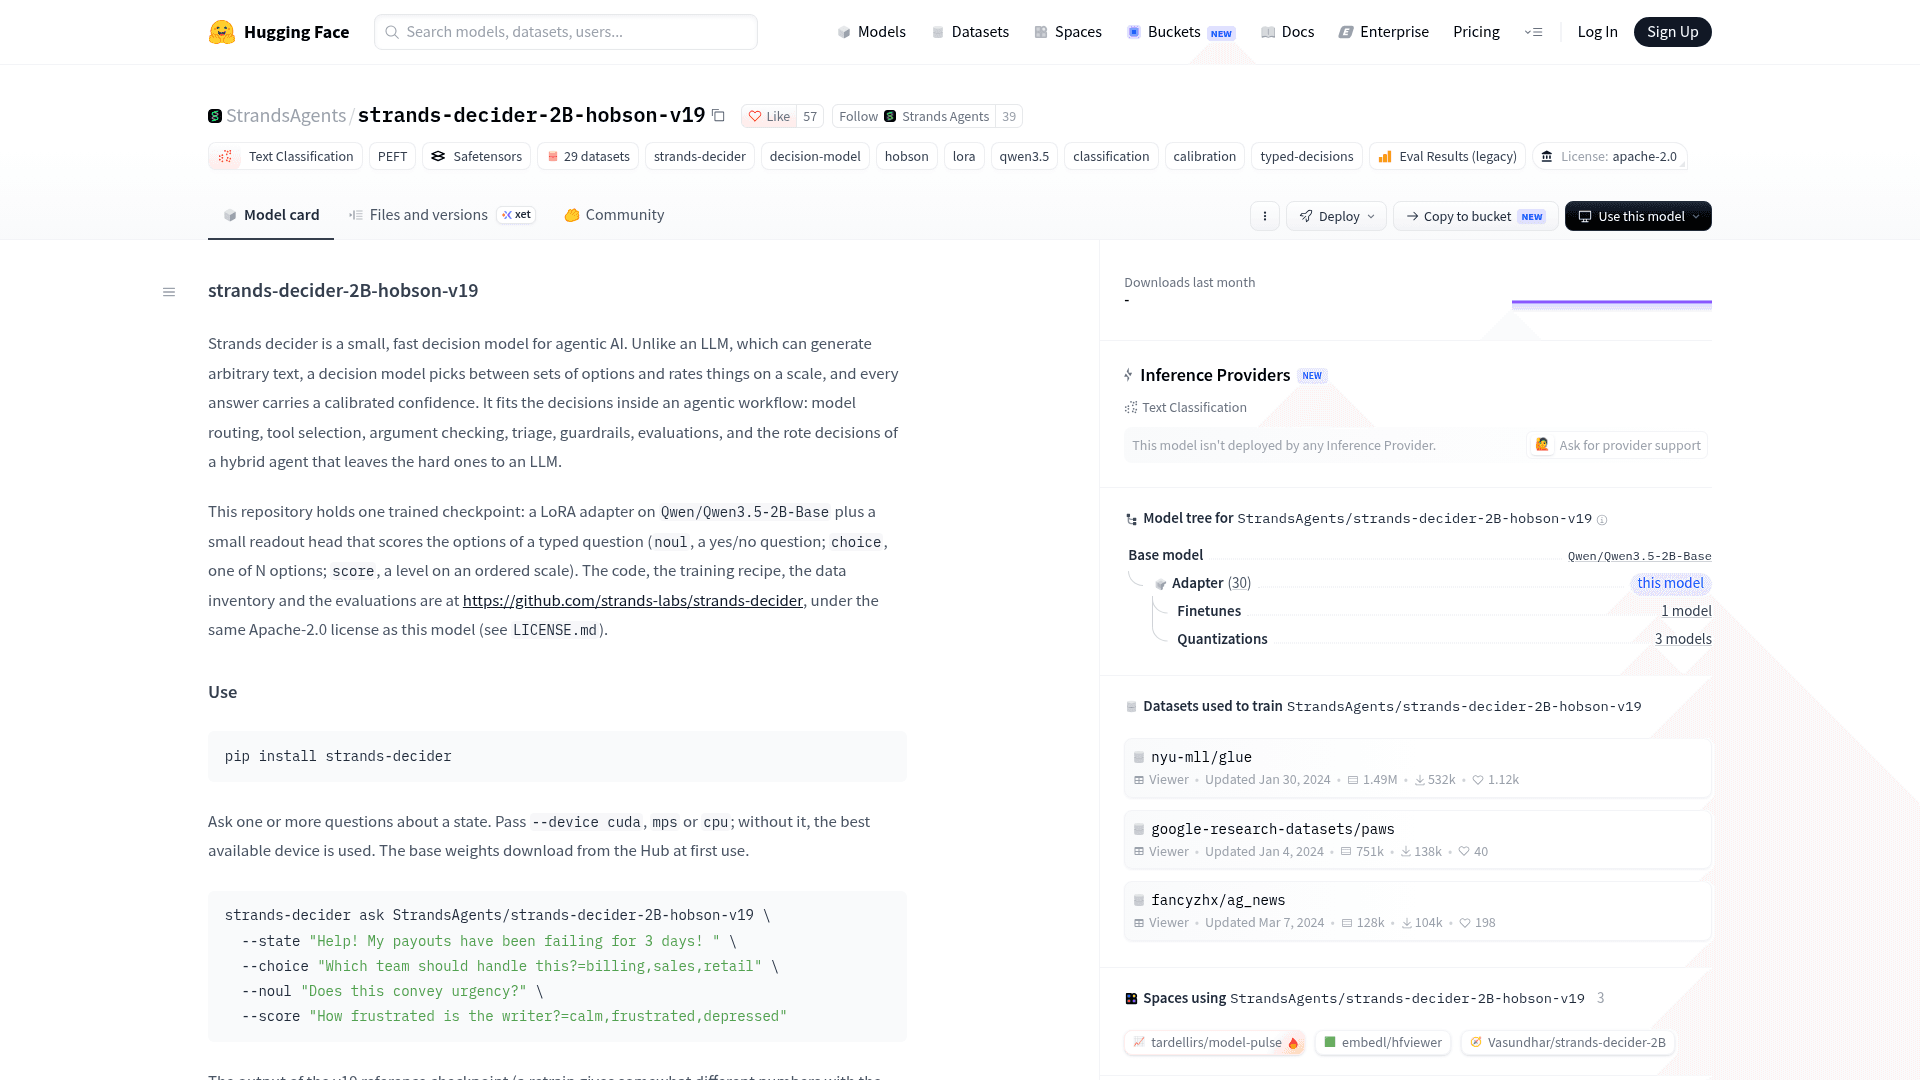
Um es als Dienst zu betreiben, starten Sie den mitgelieferten Server und senden Anfragen an ihn:
pip install strands-decider
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
Die Gewichte werden bei der ersten Nutzung von Hugging Face geladen. Dann senden Sie POST /v1/systemone mit einem state- und einem questions-Objekt und erhalten Antworten pro Frage, Token-Verbrauch (output_tokens: 1) und latency_ms zurück. Eines sollten Sie wissen, bevor Sie sich auf den Austausch gegen Jev freuen: Die Doku sagt, der Adapter von JevBench laufe unverändert gegen diesen Endpunkt, und fügt dann hinzu: "Compatibility with the Jev API itself is not verified" (docs/inference.md).
Auch der Anbieter nennt die Grenzen offen. Der Launch-Beitrag sagt, das One-Pass-Design mache es "significantly worse at solving complex problems than reasoning models" und es sei "unsuited for coding, chatbots, document summarization." Die Modellkarte ergänzt, dass lange, mehrstufige Dokumente seine Schwäche sind.
Wie genau ist Strands Decider?
Auf dem öffentlichen JevBench-Set (231 Aufgaben) sehen die Zahlen aus dem Repo so aus:
| Messwert | v21 (Referenz) | v19 (Launch) |
|---|---|---|
| Genauigkeit | 0.762 (176/231) | 0.723 (167/231) |
| Brier-Score (niedriger ist besser) | 0.323 | 0.342 |
| Kalibrierungsfehler (ECE) | 0.064 | 0.052 |
| Stufen leicht / Standard / schwer | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
Der Satz, den ich im ganzen Release am meisten respektiere, ist der, in dem das Team sein eigenes Upgrade kleinredet. Über je sechs Trainingsläufe erreichen die Rezepte von v19 und v21 im Schnitt "172.8 and 172.3 JevBench tasks: the same accuracy." Die höhere Schlagzeilenzahl von v21 ist größtenteils Zufall durch den Seed, und das sagen sie auch. Diese Ehrlichkeit ist mehr wert als die vier zusätzlichen Punkte.
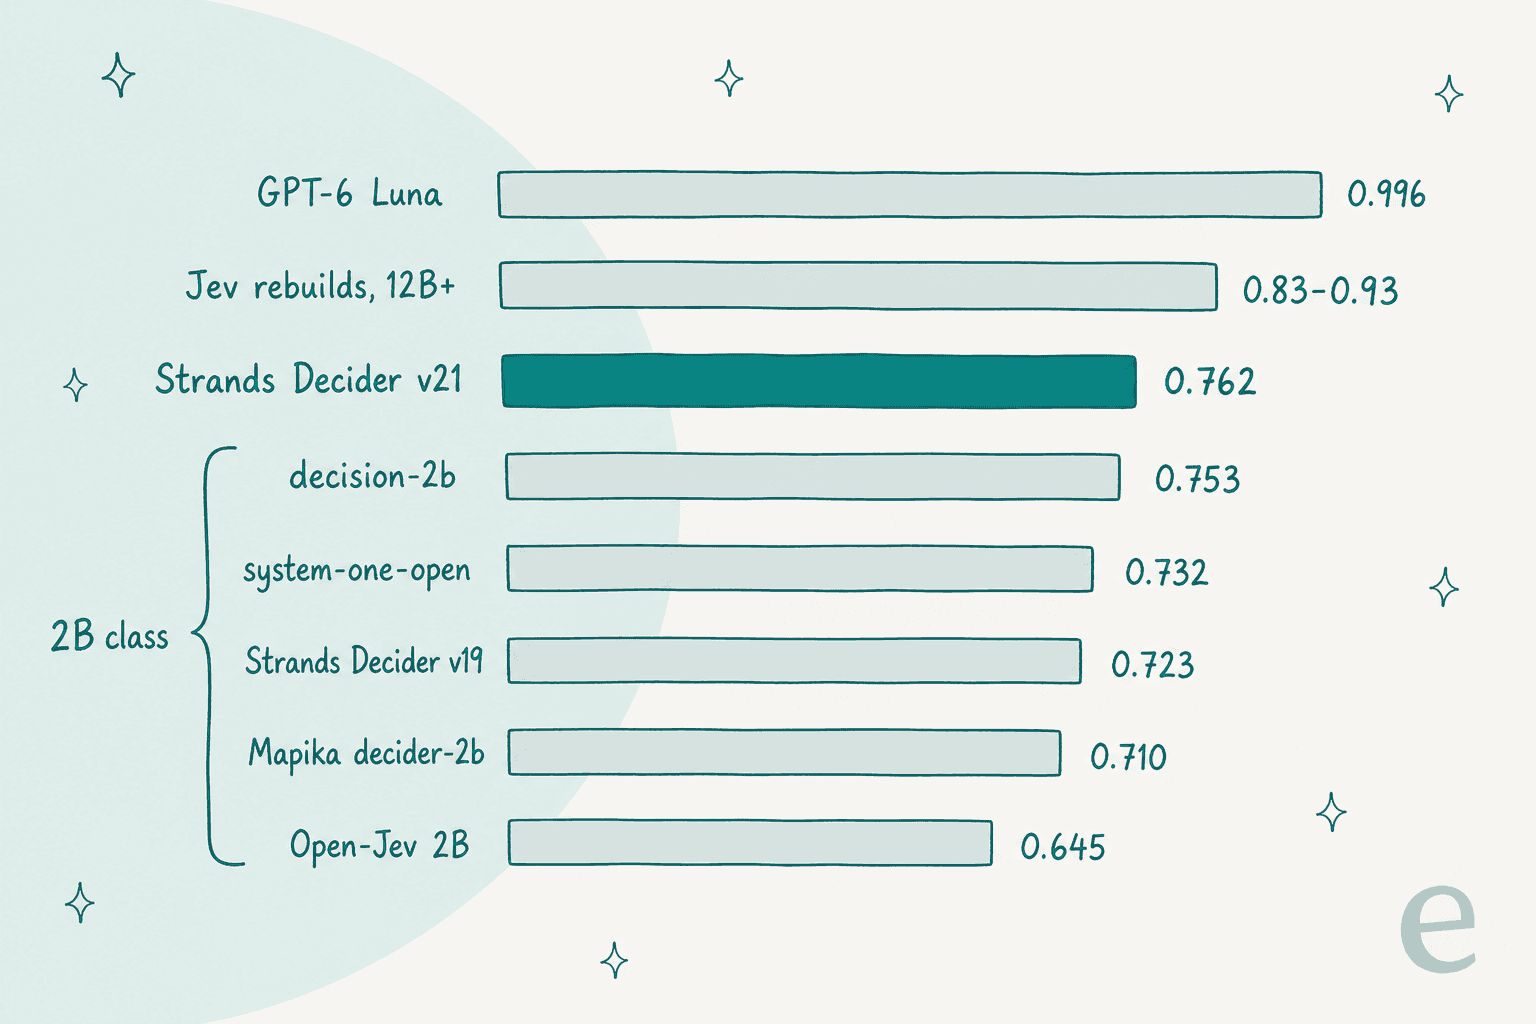
Wo steht es also in der Rangliste? Im JevBench-Leaderboard v1.4.2 (89 Systeme, 25. September) lag v19 auf Platz 50 insgesamt und Platz 3 von 33 in der 2B-Klasse, hinter decision-2b von FlyMy.AI (0,753) und dem Gemma-basierten system-one-open (0,732), laut den Evaluationsnotizen. Die Spitze der Tabelle gehört Reasoning-Modellen, mit GPT-6 Luna bei 0,996, danach folgen Jev-Nachbauten auf 12B-plus-Torsos mit 0,83 bis 0,93. Wenn Sie das ganze Feld nebeneinander sehen wollen, reiht der Überblick zu Jev-Alternativen sie auf.
Ehrlich gesagt ist Strands Decider also ein starkes kleines Modell, kein starkes Modell. Es tauscht etwa 23 Punkte Genauigkeit gegenüber einem Frontier-LLM gegen Tempo, Preis und die Möglichkeit, auf der eigenen Maschine zu laufen.
Ein Hinweis, falls Sie sich die Trainingsverlaufs-Grafik im Launch-Beitrag ansehen: Sie beschriftet zwei Vergleichspunkte mit "strands-decider-2b v10/v11". Marc Brooker hat das auf Hacker News korrigiert: Das sei ein anderes Modell namens "decider-2B", "which isn't ours."
Bedeuten die Konfidenzwerte etwas?
Kalibrierung ist das ganze Verkaufsargument. Ein Konfidenzwert taugt nur, wenn er ehrlich ist: Ein Label nützt für Automatisierung nur, wenn Sie sagen können "ab 0,9 handeln, darunter an einen Menschen geben." Das Repo behauptet, bei unbekannten kurzen Klassifikationsaufgaben seien "answers at a confidence of 0.9 or more are right about 95% of the time."
Das ist ermutigend, mit zwei Einschränkungen, die die Modellkarte selbst nennt: Die Konfidenzbänder wurden nur an kurzen Klassifikationen festgelegt, daher "measure on your own traffic before you trust a threshold", und das Modell liest Fragen weniger genau als Dokumente, sodass eine umformulierte Frage oft dieselbe Antwort bekommt. Frühe Nutzer haben eine dritte gefunden:
"From what i can tell from my (limited) experiments, there is a lot of variation caused by simply reordering options, plus a heavy bias toward the first option listed"

Die Lösung ist unspektakulär und funktioniert: Mischen Sie in Ihren Tests die Reihenfolge der Optionen und bewerten Sie das Modell an ein paar hundert eigenen gelabelten Tickets, bevor Sie irgendeiner Zahl trauen. Brooker selbst schlug auf HN vor, dass man bei 2B auf die eigenen Fragen feinjustieren oder auch ohne Fine-Tuning neu kalibrieren kann.
Wie schnell ist Strands Decider auf echter Hardware?
Die Schlagzeilenzahl des Launch-Beitrags ist ein Median von 115 ms auf einer RTX 3090. Die ist echt, und sie ist eine GPU-Zahl. Hier das größere Bild, mit allen Werten aus dem Repo, seinen Pull Requests oder Hacker News:
| Hardware | Latenz pro Frage | Quelle |
|---|---|---|
| RTX 3090 (GPU) | Median 115 ms, p95 299 ms | README |
| M3 Pro (Apple Silicon) | warmer Median 153 ms unter 300 Token, 234 ms über alle Aufgaben | README |
| M4 Pro (nur CPU) | 0,3 bis 0,5 s nach dem Laden | PR #46 |
| Xeon 8375C, 8 Threads | etwa 1,6 s kurze Eingabe, 16 bis 18 s bei ~3.000 Token | docs/inference.md |
| Graviton 4, bf16 (PR nicht gemergt) | 1,15 s | PR #48 |
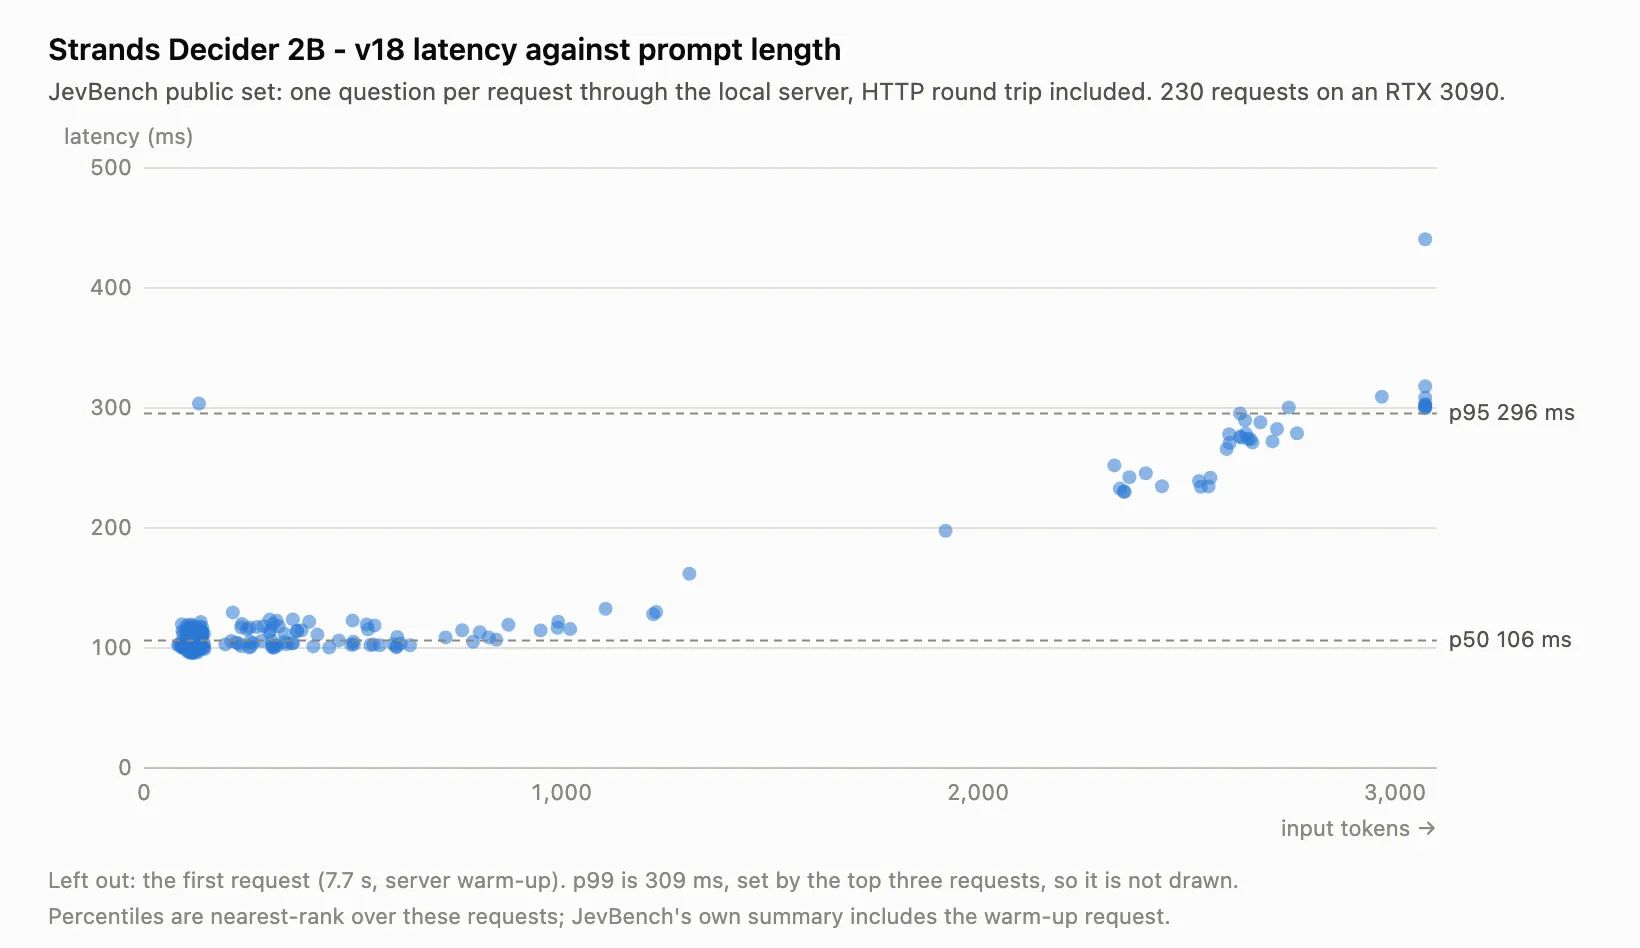
Das Muster zählt mehr als jede einzelne Zahl. Die Latenz wächst grob mit der Eingabelänge, ein langer E-Mail-Verlauf kostet also weit mehr als eine einzeilige Chatnachricht. Und auf der Art CPU-Rechner, die die meisten Teams standardmäßig hochfahren, dauert eine Entscheidung Sekunden. Ein HN-Nutzer sah etwa eine halbe Sekunde auf sechs Kernen, ein anderer maß 1.732 ms in einem reinen CPU-Docker-Container. Wenn die Entscheidung vor einem Kunden sitzt, der auf eine Chat-Antwort wartet, oder in einem Schritt des intelligenten Routings, brauchen Sie eine GPU oder Apple Silicon.
Was kostet Strands Decider?
Das Modell ist kostenlos. Der Betrieb nicht, und es gibt niemanden außer Ihnen, der ihn bezahlt.
- Kein gehosteter Endpunkt. Die Hugging-Face-Seite sagt "This model isn't deployed by any Inference Provider", und es gibt keinen Bedrock-Eintrag. Bedrock taucht im Launch-Beitrag nur als LLM im Agent-Beispiel auf.
- Keine Authentifizierung. Der lokale Server bindet an
127.0.0.1und, in den Worten der Karte, "has no authentication: use it for local experiments." Load Balancer, Authentifizierung und Monitoring davor zu setzen ist Ihre Aufgabe, dieselbe Fleißarbeit, die in den Strands-Harness-Alternativen für Agent-Hosting behandelt wird. - Noch kein offizieller llama.cpp-Build. Brooker erklärte auf HN, dass man nicht nur das LoRA konvertieren kann, denn "there's a whole pointer head and some custom layers." Es gibt einen Community-GGUF-Port und auch einen ONNX-Port, beide inoffiziell.
So schneidet es gegen die beiden gehosteten Optionen ab, mit denen die meisten Teams es vergleichen:
| Strands Decider 2B | TypeSafe Jev | Cloudflare Clef | |
|---|---|---|---|
| Gewichte | Offen, Apache-2.0 | Geschlossen | Offen, Apache-2.0 |
| Größe | 1,9B | Nicht veröffentlicht | 27B (Clef-flash 9B) |
| Gehostete API | Keine | Ja, inkl. Workers AI | Workers AI |
| Preis | Kostenlos, plus Ihre Hardware | $0.042 pro 1M Input-Token, Output kostenlos | $0.24 pro 1M Input (flash $0.09) |
| Kontext | 4.096 Standard | 32.000 | 64K gehostet |
| Selbst feinjustieren | Ja, volles Rezept | Nein | RL-Tuning über das Cloudflare-Team |
| Deep Dive | Dieser Beitrag | Jev-Test | Clef erklärt |
Jevs Preis stammt aus seinem Workers-AI-Eintrag, Clefs von Cloudflares Modellseite. Die komplette Rechnung steht in der Aufschlüsselung der Clef-Preise.
Zum Jev-Preis kosten eine Million Entscheidungen mit je 500 Token etwa $21 an Input-Token. Das ist die Latte, die eine selbst gehostete GPU reißen muss, sobald Sie die Ingenieurstunden für den Betrieb dazurechnen. Für die meisten Teams gelingt das nicht (dieselbe Rechnung wie bei jedem selbst gehosteten Modell, siehe Qwen-Preise), es sei denn, das Volumen ist sehr hoch oder die Daten dürfen Ihr Netzwerk nicht verlassen. Dieser letzte Fall, regulierte Daten, ist der, in dem sich Strands Decider am leichtesten rechtfertigen lässt.
Was hat AWS tatsächlich veröffentlicht?
Hier unterscheidet sich Strands Decider von Jev, und das ist der Teil, auf den ich Entwickler hinweisen würde. Der Launch-Beitrag sagt, der Release enthalte "all the training data and scripts we used to build the model."
- Trainingsdaten. Hugging-Face-Datensätze, ContractNLI und MuSiQue, synthetische Zeilen, die von Open-Weight-Modellen geprüft wurden, und die Ausgabeverteilungen eines eingefrorenen Qwen3.5-4B-Teachers. Jede Quelle und ihre Lizenz ist in data/sources.md aufgelistet.
- Das Rezept. Ein Skript,
training/recipe.sh all. Ein Neutraining dauert etwa11 Stunden auf einer RTX 3090oder etwa1 h 10 min auf acht H100. - Ein vorab registriertes Forschungsprotokoll. Jeder Trainingslauf nennt seine Vorhersagen und Fehlerbedingungen, bevor er läuft. Ich habe das selten bei einem Modell-Release gesehen, und es ist der Grund, warum ich dem Eingeständnis "v21 ist dasselbe wie v19" traue.
Damit ist Strands Decider weniger ein Jev-Konkurrent und eher ein Kit, um einen eigenen Triage-Klassifikator zu bauen. Wenn Ihre Kategorien spezifisch sind (Ihre Produktlinien, Ihre Erstattungsregeln, Ihre Eskalationsstufen), ist das Nachtrainieren auf ein paar tausend eigenen gelabelten Zeilen zur Ticket-Klassifizierung der Weg, auf den die Autoren selbst verweisen. Wenn Fine-Tuning neu für Sie ist, ist das Rezept einer der saubereren Orte, es zu lernen.
Auch das Repo bewegt sich schnell. Am 7. und 8. Oktober gemergte Pull Requests ergänzen Unterstützung für Gemma-4-Torsos (E2B, E4B, 12B und 26B-A4B) und einen soup-Befehl, der mehrere Trainingsläufe zu einem Checkpoint mittelt. Die PRs nennen fünf kommende Checkpoints, und Brooker schrieb auf HN, "we've got some new ones coming this week." Für keinen gibt es bisher veröffentlichte Benchmark-Zahlen, ich würde also abwarten, bevor ich darauf plane.
Was sagen Entwickler über Strands Decider?
Der Launch-Thread auf Hacker News kam innerhalb eines Tages auf über 270 Punkte. Der Ton ist wärmer als bei den Jev-Threads, vor allem weil die Gewichte offen sind. Der klarste positive Bericht kam von jemandem, der es on-device laufen lässt:
"This is a great model. I've been running it on device in chrome extension to filter things like email. It is just the right mix of size, capability and speed to make it generally useful for adhoc bulk classification tasks."
Co-Autor Marc Brooker beschrieb, wohin er die Reise sieht, ein nützliches Denkmodell für alle, die Agents bauen:
"There are a ton a ways to use models like this. Model routing is a popular emerging one. The one that really interests me is hybrid agentic workflows - filling the gap between deterministic workflows (e.g. AWS StepFunctions) and fully agentic workflows that use frontier intelligence."
Die Kritik ist berechtigt und konkret. Ein Thread argumentierte, starke Benchmark-Kalibrierung "does not establish reliability on unfamiliar production inputs" (soltanov). Ein anderer Kommentator merkte an, dass Cloudflares Clef auf llama.cpp läuft, während Strands vorerst sein eigenes CLI und seinen eigenen Server braucht:
"clef from cloudflare runs on llama.cpp - being locked-in to strands cli would be a bummer and will slow down adoption."
Das deckt sich mit meiner Einschätzung. Das Modell ist gut für seine Größe, das Tooling ist jung, und den Nutzen haben im Moment Entwickler, die gern ihre eigene Inferenz hosten.
Wo passt Strands Decider in eine Support-Warteschlange?
Der naheliegende Einsatz ist die Ticket-Triage: welches Team, wie dringend, ist es Spam. Das ist klassische Intent-Klassifizierung, und Entscheidungsmodelle passen gut zu diesem Aufruf. Hier würde ich die Erwartungen sorgfältig setzen.
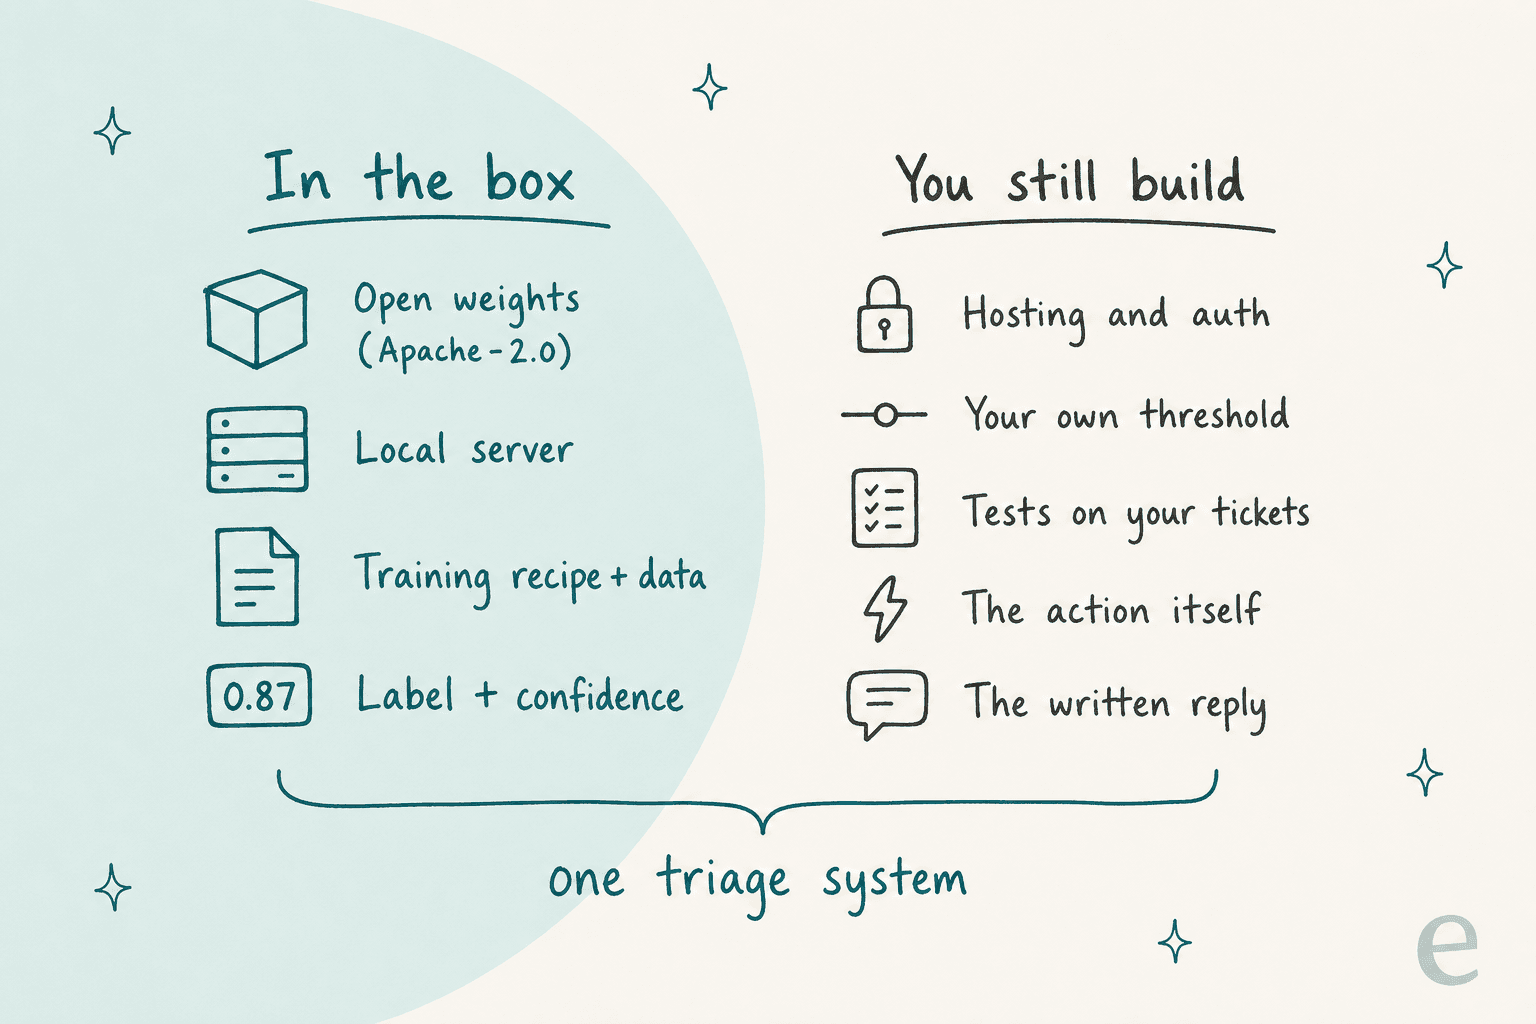
Ein Label ist nur ein Bruchteil eines Triage-Systems. Jemand muss das Modell hosten, einen Schwellenwert wählen, es an echten Tickets testen und dann das Ticket in Zendesk oder Freshdesk tatsächlich taggen, zuweisen oder eskalieren. Und nach alledem braucht der Kunde immer noch eine Antwort.
So sieht das aus, wenn der Konfidenz-Schwellenwert seine Arbeit macht:
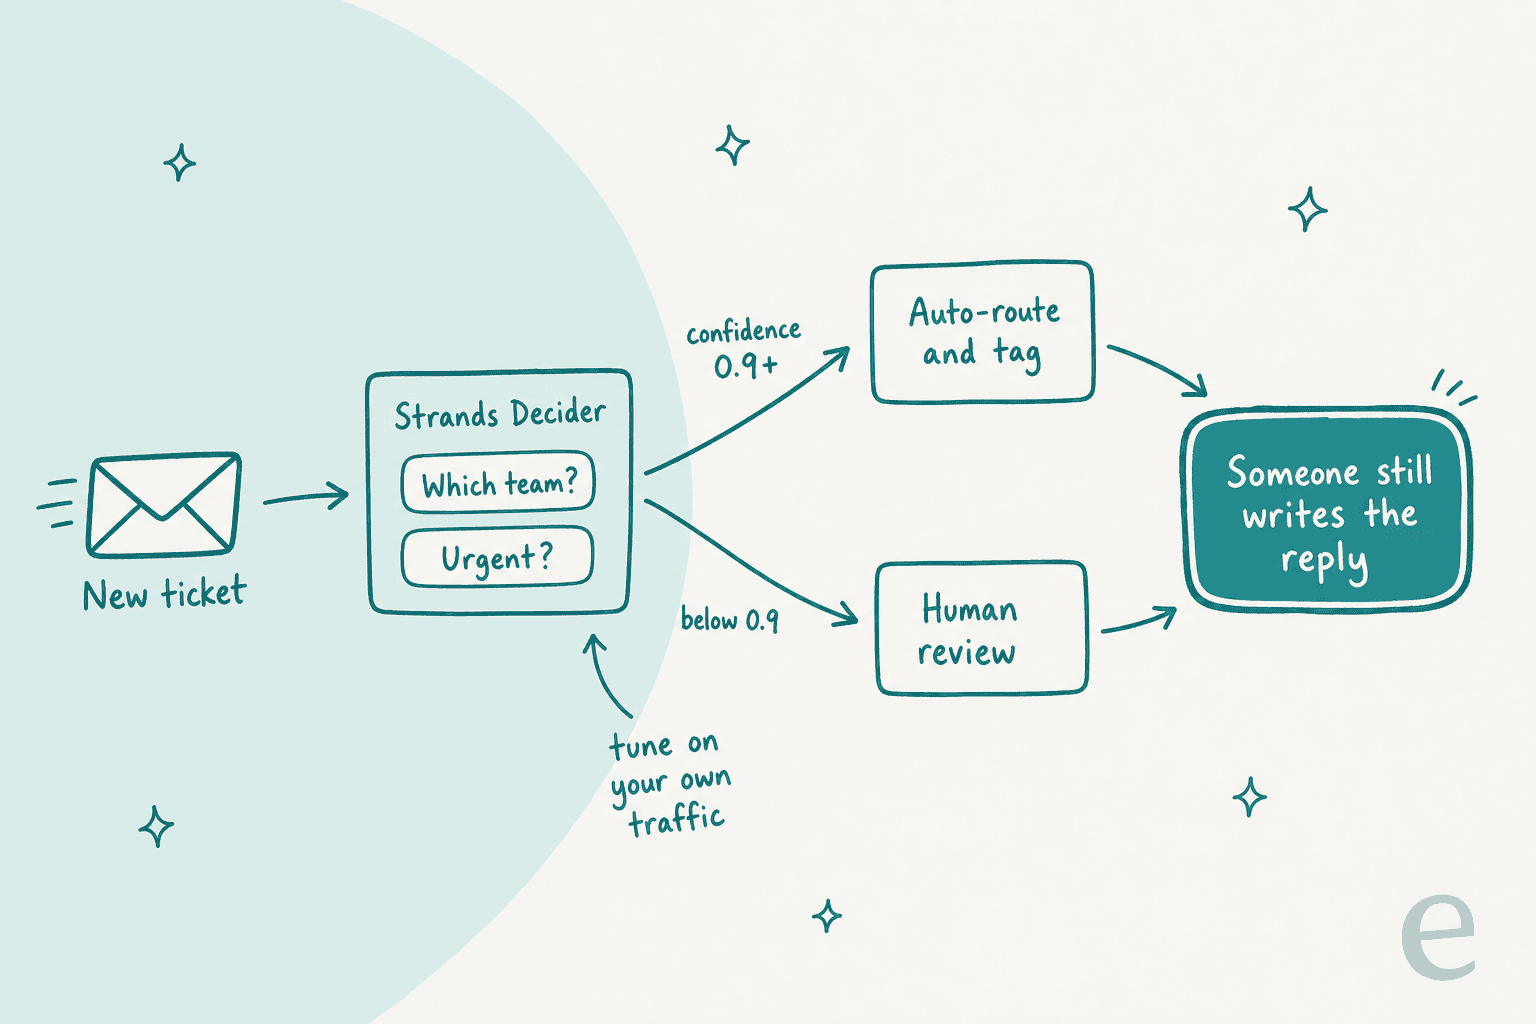
Dieses letzte Kästchen unterschätzen Teams. In einem gegengeprüften eesel-Test an einem echten E-Commerce-Zendesk-Posteingang erreichte die KI-Triage 93% Genauigkeit und erkannte 100% des Spams (etwa 22% des Posteingangs), aber nur 12% der entworfenen Antworten wurden unverändert gesendet. Sortieren ist die leichte Hälfte; die Antwort ist, wo die Arbeit liegt.
Was Käufer verlangen, ist genau das, was ein kalibriertes Entscheidungsmodell verspricht. Ein CX-Leiter mit etwa 7.000 Tickets im Monat sagte es in einem eesel-Verkaufsgespräch so:
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Hier meine Empfehlung nach Situation:
- Sie sind Entwickler und bauen einen Agent oder eine eigene Pipeline, Ihre Daten dürfen Ihr Netzwerk nicht verlassen, und Sie haben eine GPU: Strands Decider ist eine großartige Basis. Trainieren Sie es auf Ihren eigenen Labels nach.
- Sie wollen einen Entscheidungsaufruf ohne jedes Hosting: Starten Sie stattdessen mit Jev. Clef und OpenAIs Decisions API sind die anderen gehosteten Optionen.
- Sie leiten ein Support-Team und wollen Tickets sortiert und beantwortet haben: Sie brauchen gar kein Entscheidungsmodell. Sie brauchen etwas, das die Entscheidung trifft und in Ihrem Helpdesk danach handelt. Der Überblick zu KI-Triage-Tools behandelt diesen Weg, und der Glossareintrag zu Auto-Triage erklärt die Begriffe.
eesel für Triage, Routing und die Antwort
Wenn die Aufgabe, die Sie sich für Strands Decider vorstellen, "meine Support-Warteschlange sortieren" ist, erledigt eesels KI-Helpdesk-Teammate sie von Anfang bis Ende. Es lässt sich in wenigen Minuten an Zendesk, Freshdesk oder Gorgias anbinden (die Zendesk-Integration ist das häufigste Setup), lernt aus Ihren früheren Tickets und Ihrem Help Center und taggt, routet, eskaliert und schreibt dann die Antwort.

Dieselbe Aufteilung, auf der Strands Decider beruht, ein leichtes Modell für die schnelle Entscheidung und ein schwereres für den schwierigen Teil, ist bereits eine Einstellung. Jede eesel-Automatisierung hat die Option "Model strength": das übliche Modell für Entwürfe und mehrstufige Arbeit oder ein leichteres für Aufgaben wie Tagging oder Ticket-Routing. Ereignisse, die nicht zu Ihren Anweisungen passen, werden übersprungen und mit einem Grund protokolliert, also genau das "leave them alone"-Verhalten, das jener CX-Leiter wollte. Jede Aktion lässt sich in Aktionen und Freigaben auf Auto, Needs approval oder Disabled setzen, sodass Erstattungen hinter einem menschlichen Klick bleiben können, während das Tagging allein läuft.
Wenn Sie zu Strands Decider gegriffen hätten, weil Sie gern im Terminal arbeiten, bietet das eesel CLI dasselbe Teammate über die Kommandozeile. npx @eesel/cli funktioniert ohne Konto (ein temporärer Workspace mit $5 Guthaben), jeder Befehl gibt JSON aus, und Fehler kommen als eine JSON-Zeile mit einem retryable-Flag zurück, sodass Claude Code, Cursor oder Codex das gesamte Setup steuern können. Ein Entwickler oder ein Coding-Agent kann einen Triage-Job mit eesel automations enable <platform> <key> --instructions "..." einrichten, eine Änderung vorab mit --dry-run prüfen und zurückgehaltene Aktionen mit eesel approvals approve <id> freigeben. Es ist derselbe Agent wie im Dashboard, und Änderungen werden in beide Richtungen synchronisiert. Mehr dazu in meinem Blick auf den Markt der Agent-CLIs.
Bevor irgendetwas live geht, lässt der Simulations-Skill den Agent über Ihre echten früheren Tickets laufen und bewertet jede Antwort, sodass Sie die Genauigkeit an Ihrem eigenen Aufkommen sehen statt an einem Benchmark. Der Gratis-Tarif enthält 100 Credits ohne Karte, und kostenpflichtige Tarife beginnen bei $299 im Monat für 500 Tickets oder Chats laut eesel-Preisen, ohne Gebühr pro Platz.
Probieren Sie eesel an einem Ausschnitt Ihrer Warteschlange aus und sehen Sie, wie viele Tickets es diese Woche sortieren und beantworten würde.
Häufig gestellte Fragen
Was ist Strands Decider?
Strands Decider 2B ist ein Open-Source-Entscheidungsmodell, das das Strands-Labs-Team von AWS am 1. Oktober 2026 veröffentlicht hat. Es liest einen Text samt typisierten Fragen (Ja/Nein, Auswahl oder Bewertung auf einer Skala) und gibt in einem einzigen Forward Pass jede Antwort mit einem Konfidenzwert zurück, statt Text zu generieren. Es ist für Aufgaben wie Ticket-Triage, Routing und Guardrails gebaut.
Ist Strands Decider kostenlos?
Ja. Gewichte, Code, Trainingsdaten und Rezept stehen unter Apache-2.0, der Download kostet also nichts. Zahlen müssen Sie für die Hardware, auf der es läuft, denn es gibt weder auf Bedrock noch bei einem Hugging-Face-Inference-Anbieter einen gehosteten Endpunkt. Vergleichen Sie das mit den Jev-Preisen oder den Clef-Preisen: Beide sind gehostet und werden pro Token abgerechnet.
Wie genau ist Strands Decider 2B?
Das Referenzmodell v21 erreicht auf dem öffentlichen JevBench-Set 0,762 (176 von 231 Aufgaben), v19 kommt auf 0,723. Das liegt nahe an der Spitze der 2B-Klasse, doch Reasoning-LLMs wie GPT-6 Luna erreichen bei denselben Aufgaben 0,996. Das Repo selbst sagt, v21 und v19 seien gleich genau, wenn man sechs Trainingsläufe mittelt.
Läuft Strands Decider auf einer CPU?
Ja, aber rechnen Sie mit Sekunden statt Millisekunden. Das Repo misst auf einem Xeon mit 8 Threads etwa 1,6 Sekunden pro Frage bei kurzer Eingabe und 16 bis 18 Sekunden bei rund 3.000 Token. Auf einer RTX-3090-GPU liegt der Median bei 115 ms. Für einen Live-Schritt im Routing sollten Sie eine GPU oder Apple Silicon einplanen.
Strands Decider vs. Jev: Was sollte ich nehmen?
Nehmen Sie Strands Decider, wenn Sie offene Gewichte, Self-Hosting oder die Möglichkeit zum Fine-Tuning auf eigene Fragen brauchen. Nehmen Sie TypeSafe Jev, wenn Sie eine gehostete API ohne eigene Server und einen Kontext von 32.000 Token wollen. Der Überblick zu Jev-Alternativen deckt den Rest des Feldes ab.
Kann ich Strands Decider für die Triage von Support-Tickets nutzen?
Ja. Das Beispiel auf der Hugging-Face-Karte routet eine Beschwerde über Auszahlungen an Billing, Sales oder Retail und markiert die Dringlichkeit. Sie müssen es aber selbst hosten, einen Konfidenz-Schwellenwert an Ihren eigenen Tickets abstimmen und den Schritt bauen, der taggt, routet oder antwortet. Ein KI-Helpdesk-Teammate wie eesel übernimmt diese ganze Schleife direkt in Ihrem Helpdesk.
Gibt es eine Strands-Decider-API auf AWS Bedrock?
Stand 8. Oktober 2026 nicht. Der einzige Server ist ein lokaler (strands-decider serve), der an 127.0.0.1 gebunden ist und keine Authentifizierung hat. Bedrock taucht im Launch-Beitrag nur als LLM im Agent-Beispiel auf. Wenn Sie eine gehostete Entscheidungs-API wollen, schauen Sie sich OpenAIs Decisions API, Jev oder Clef an.