

Ein Test der Gemini Decisions API lohnt sich, wenn dein Code täglich tausendmal denselben geschlossenen Check macht: dieses Ticket weiterleiten, zeigt dieses Foto einen Schaden, verstößt diese Antwort gegen eine Richtlinie. Gemini Decision 1 beantwortet bis zu 1.000 Ja/Nein-, Auswahl- und Rubrik-Fragen in einem Durchgang und liefert Wahrscheinlichkeiten statt Text, für 0,10 $ pro Million Input-Token bei null abgerechneten Output-Token. Sein Vorteil gegenüber den anderen Decision-Modellen ist der Input: Es liest Audio, Video und PDFs direkt. Seine Lücken sind kein Caching, kein Batch und noch kein Vertex AI. Es sortiert Tickets, kann sie aber nicht beantworten, und genau das ist die Aufgabe, die eesels KI-Helpdesk-Teammitglied in deinem Helpdesk übernimmt. Mit der eesel CLI kann ein Coding-Agent deine Triage-Regeln und Hilfeartikel hochladen und dann Testtickets durchspielen, bevor etwas live geht.
Was ist die Gemini Decisions API?
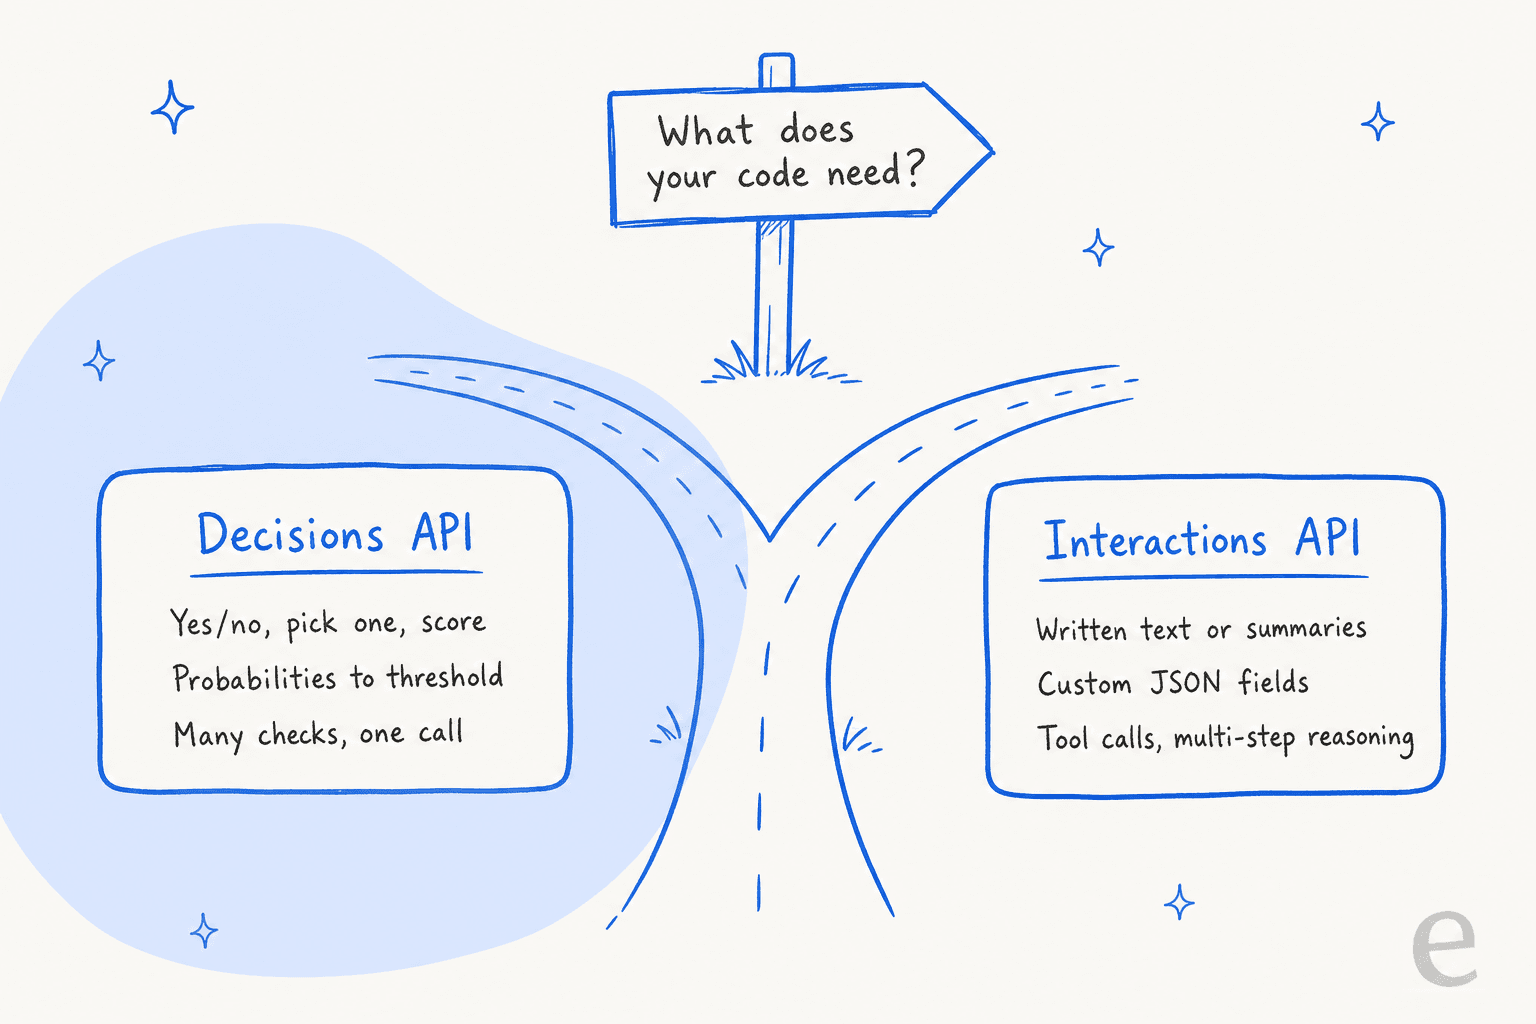
Die Gemini Decisions API ist ein neuer Gemini-API-Endpunkt für schnelle Entscheidungen mit geschlossenem Antwortraum. Google hat sie am 11. November 2026 zusammen mit einem neuen Modell namens Gemini Decision 1 (gemini-decision-1) gestartet. Du schickst einen gemeinsamen Input und eine Liste typisierter Fragen, und sie schickt pro Frage eine Antwort mit kalibrierter Wahrscheinlichkeit und einem Confidence-Score zurück.
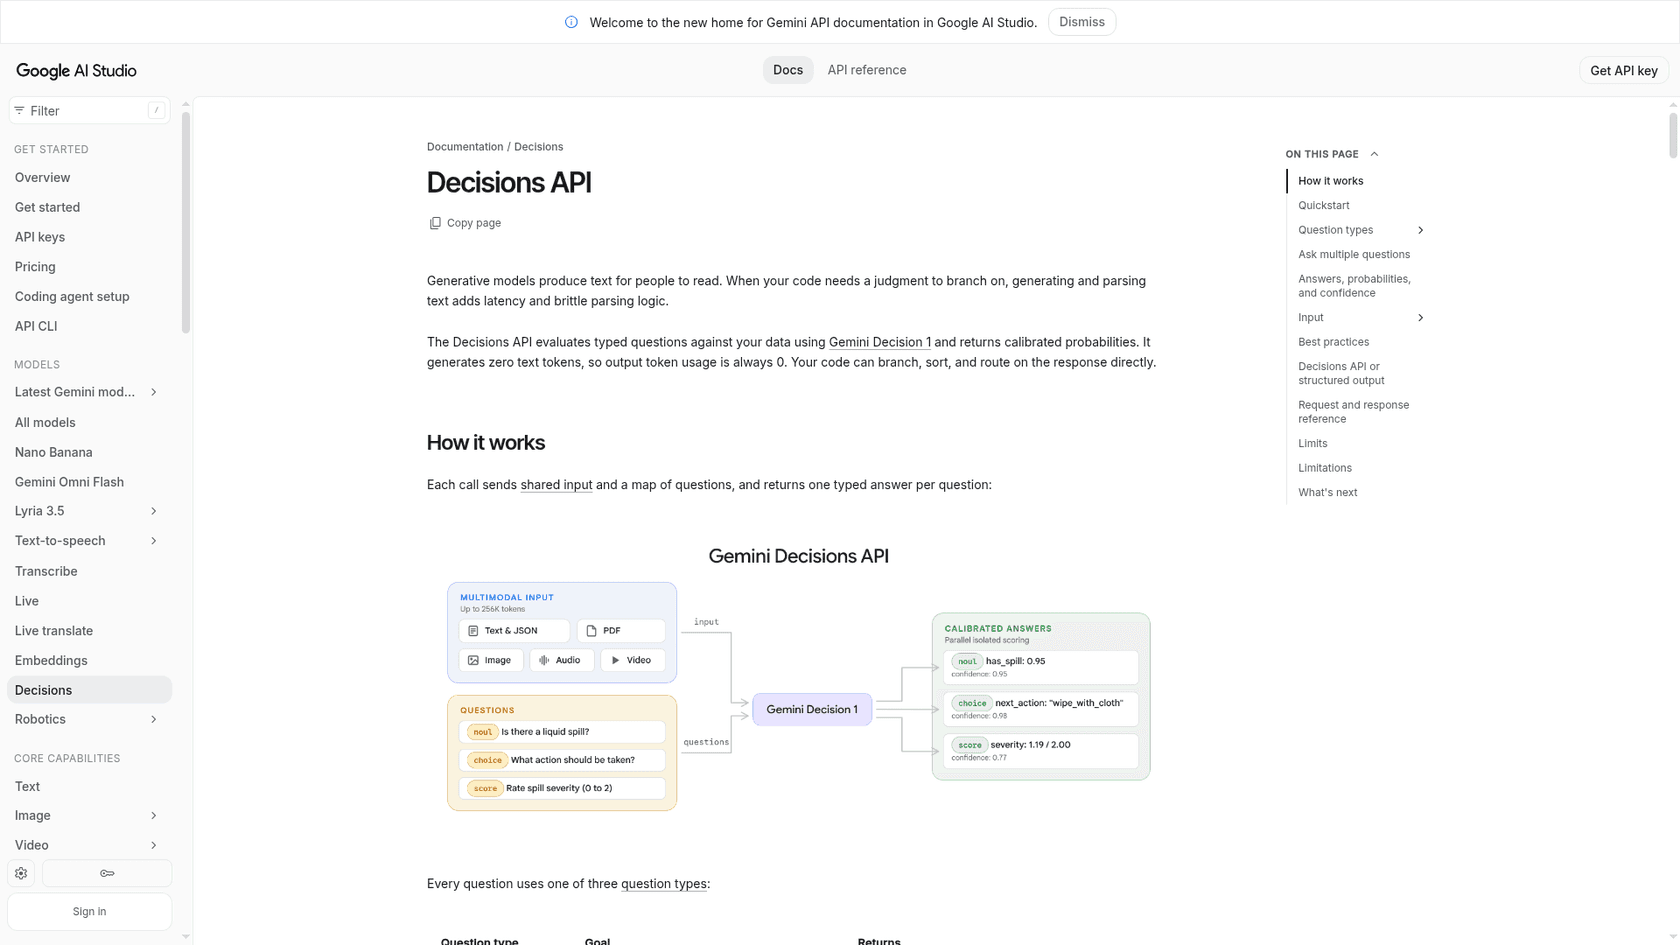
Der entscheidende Satz in den Decisions-API-Docs lautet: „generates zero text tokens, so output token usage is always 0." Dein Code verzweigt anhand einer Zahl, statt einen Satz zu parsen.
Ich baue bei eesel Integrationen und APIs, und der Teil dieser Arbeit, den ich am liebsten nie wieder schreiben würde, ist der Klebecode um ein LLM, das eigentlich nur ein Wort zurückgeben soll. Du fragst nach „billing" oder „shipping", bekommst „Billing." mit Punkt zurück, oder einen höflichen Absatz, und schreibst einen Parser plus einen Retry. Ein Decision-Endpunkt entfernt diese ganze Schicht. Das ist hier das eigentliche Versprechen, mehr als die Geschwindigkeit.
Das hat Google zum Start bestätigt:
| Spezifikation | Gemini Decision 1 |
|---|---|
| Modell-ID | gemini-decision-1 |
| Eingaben | Text, Bilder, Audio, Video und PDFs, gemischt in einer Anfrage |
| Ausgabe | Wahrscheinlichkeiten und Confidence-Scores, 0 Output-Token |
| Fragetypen | Ja/Nein (noul), Auswahl, Bewertung |
| Fragen pro Anfrage | 1 bis 1.000 |
| Kontextfenster | 262.144 Token, gemeinsamer Input plus alle Fragen |
| Latenz (Googles Angabe) | 150 bis 250 ms Ende-zu-Ende |
| Preis | 0,10 $ pro 1 Mio. Input-Token, kostenlose Stufe in AI Studio |
| Wo es läuft | Gemini Developer API (v1beta), OpenRouter. Google Cloud „demnächst" |
| Nicht unterstützt | Textgenerierung, Thinking, Function Calling, Caching, Batch API, Flex und Priority |
Google kommt spät in diese Kategorie, und das räumt Google auch offen ein. TypeSafe Jev hat sie im September begonnen, und die OpenAI Decisions API ging Anfang Oktober in die öffentliche Beta. Ein Hacker-News-Kommentator hat das Timing klar auf den Punkt gebracht:
"It took OpenAI 2 weeks after Jev to release a decision end point, and now google does it 2 months later."

Wie funktioniert Gemini Decision 1?
Gemini Decision 1 liest deinen Input einmal und bewertet jede zulässige Antwort in einem einzigen Forward-Pass, statt eine Antwort Token für Token zu generieren. Deshalb ist die Ausgabe kostenlos und die Latenz bleibt flach, wenn du Fragen hinzufügst. Google gibt an, die mediane Modell-Rechenzeit liege bei 50 bis 100 ms, nahezu konstant von 1 bis 100 Fragen pro Anfrage, bei Inputs bis zu 16.000 Token.
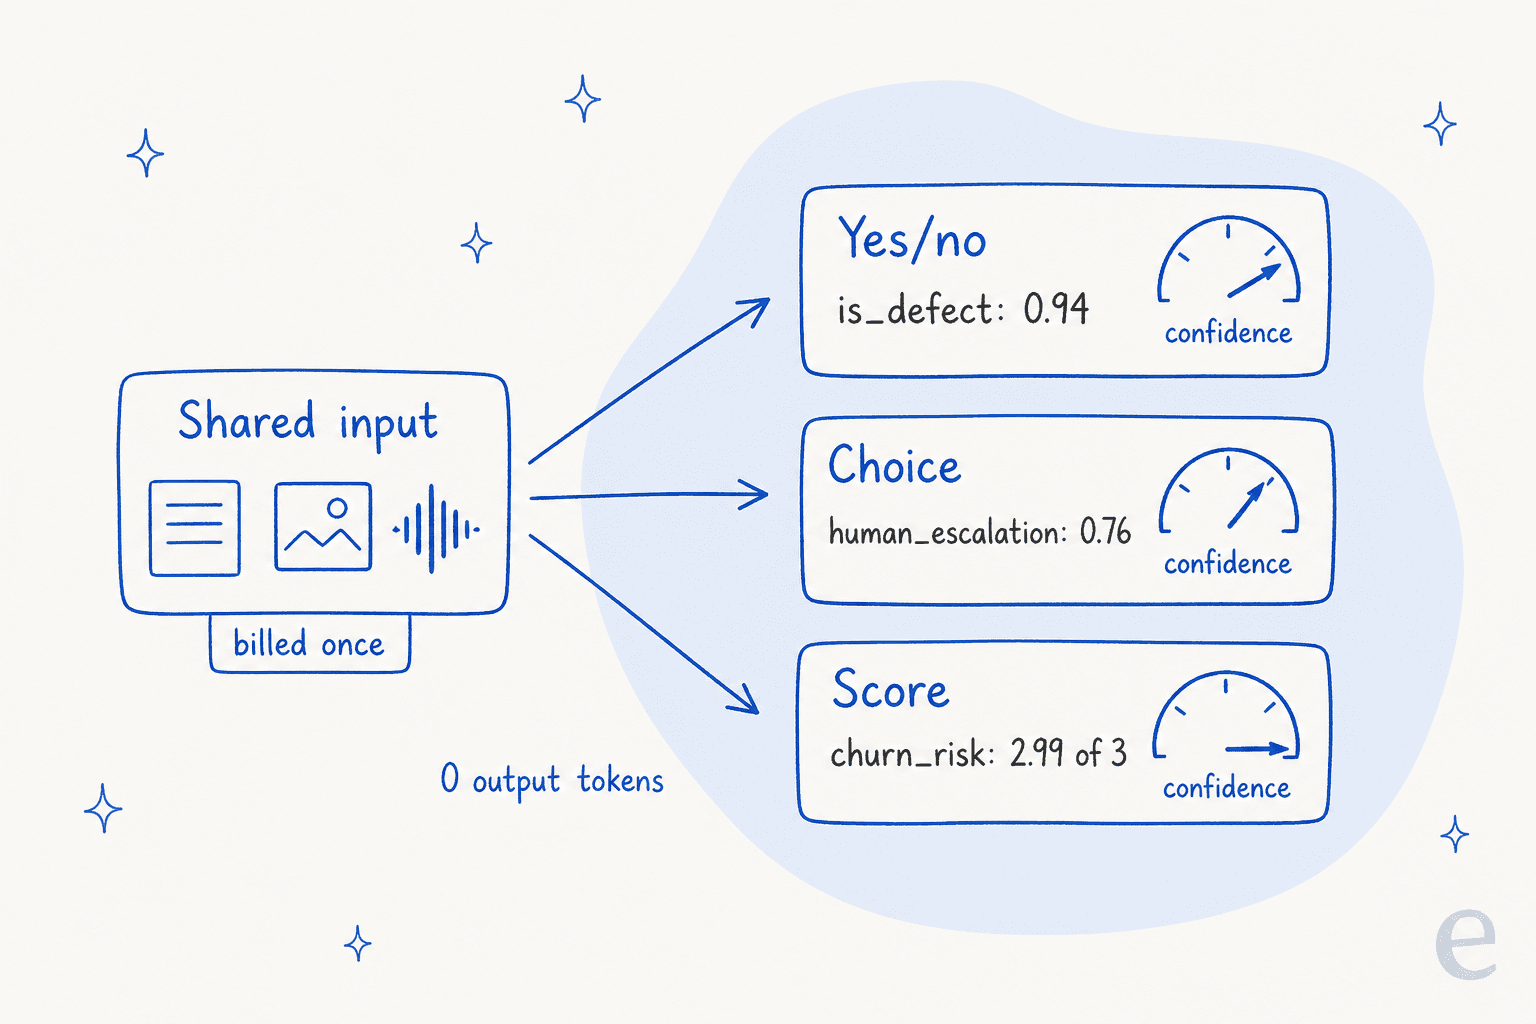
Die Zahlen in diesem Diagramm stammen direkt aus Googles eigenem Support-Ticket-Beispiel in den Docs, das sich lohnt, genauer durchzugehen.
Die drei Fragetypen
Jede Frage ist einer von drei Typen, und du kannst sie in einem Aufruf mischen:
- Ja/Nein (
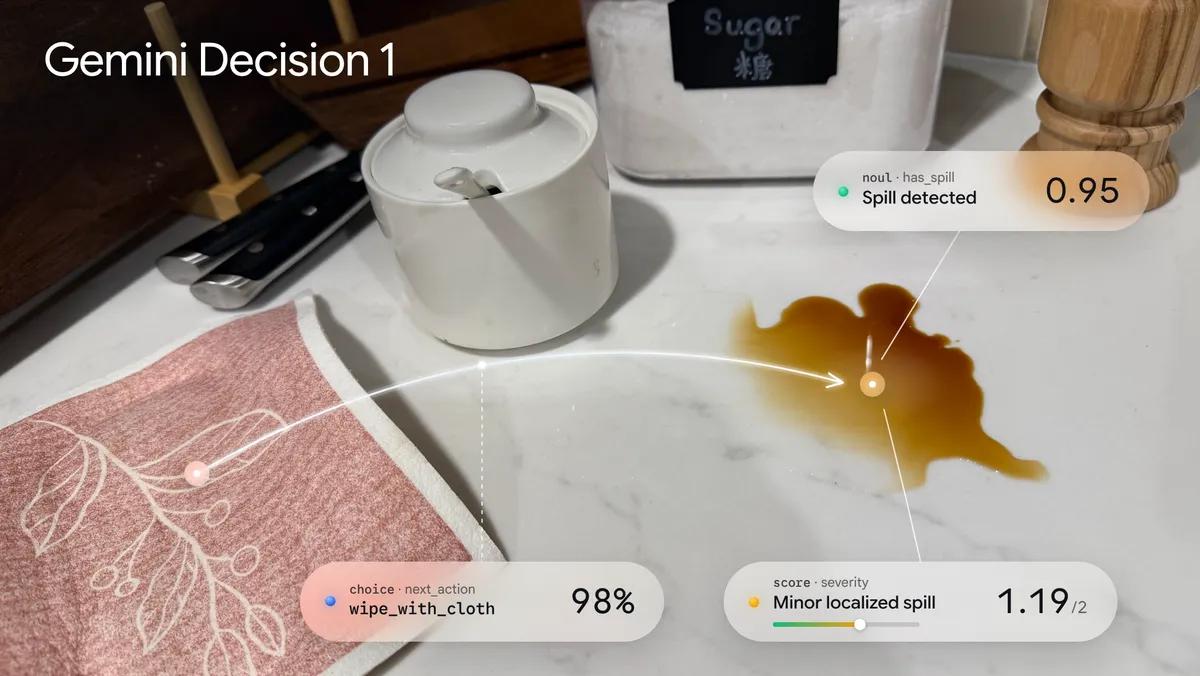
noul) gibt die Wahrscheinlichkeit zurück, dass eine Aussage zutrifft, von 0,01 bis 0,99. Du kannst einetrue_descriptionundfalse_descriptionergänzen, wenn „Ja" mehrdeutig ist. Der seltsame Name folgt Jevs API (HN-Kommentatoren vermuten, er kommt von „Bernoulli"), während OpenAI dasselbe einenpredicatenennt. - Auswahl wählt eine Option aus 2 bis 255 und gibt die Gewinneroption plus eine Wahrscheinlichkeit für jede Option zurück, die sich zu 1 summieren.
- Bewertung (Score) bewertet den Input nach einer geordneten Rubrik mit 2 bis 255 Stufen (Google empfiehlt 2 bis 10) und gibt einen wahrscheinlichkeitsgewichteten Mittelwert zurück. Ein Score von 1,12 bedeutet „überwiegend Stufe 1, etwas Stufe 2".
Ein Support-Beispiel aus Googles Docs
Googles eigenes Mehrfragen-Beispiel ist ein Support-Ticket. Der Input sind Bestelldaten (Kopfhörer, 240 $, Gold-Tier) plus die Nachricht „Audio cuts out on the left earcup. Fix it today or I cancel my membership." Drei Fragen laufen dagegen:
| Frage | Typ | Antwort | Confidence |
|---|---|---|---|
| Liegt ein Hardwaredefekt vor? | Ja/Nein | 0,94 | 0,94 |
| Welche Lösung passt? | Auswahl | human_escalation (0,76), replacement 0,18 | 0,76 |
| Wie wahrscheinlich ist Abwanderung? | Bewertung, 0 bis 3 | 2,99 („droht mit Kündigung") | 0,99 |
Das Ganze hat 324 Input-Token und 0 Output-Token verbraucht. Die eigentliche Verknüpfung macht dann der Code: Liegt die Defekt-Wahrscheinlichkeit über 0,9 und die Auswahl-Confidence über 0,6, wird die Aktion ausgeführt, sonst geht es an eine Person. Google nennt das „atomic checks, composed in code", und das ist der richtige Umgang mit solchen Modellen. Jede Frage sieht die anderen nicht, daher ändert eine zusätzliche Frage nie die übrigen.
Genauso funktioniert gutes Ticket-Routing in einem Helpdesk. Du willst keinen einzigen riesigen Prompt, der alles entscheidet. Du willst kleine, testbare Checks (Intent, Dringlichkeit, Sentiment) und eine klare Regel, wann eine Person übernimmt. Die Helpdesk-Seite davon behandle ich in meinen Leitfäden zu KI-Ticket-Klassifizierung und Tickets mit Intent-Erkennung routen.
Fallstricke, die die Docs nennen
Die Docs haben ein paar Regeln, die dich erwischen, wenn du sie nur überfliegst:
- Options-Keys werden alphabetisch sortiert, bevor bewertet wird. Ein Catch-all namens
none_of_the_abovelandet vorshipping, nenne ihn alsoother. - Auswahl verteilt immer Wahrscheinlichkeit über deine Optionen, selbst wenn keine passt. Prüfe die Confidence, oder füge einen separaten Ja/Nein-Scope-Check hinzu wie „Geht es in dieser Nachricht um eine Bestellung?"
- Das Modell sieht deine Frage-Keys nie. Schreib die vollständige Frage in
instructions. - Rechne im Code. Vergleiche Daten, Beträge und Zeiträume selbst, und gib dann das Ergebnis mit hinein.
- Behandle Input als nicht vertrauenswürdig. Google warnt, dass Nutzertext „can argue for its own classification", also behalte bei Auszahlungen und Rückerstattungen eine Person oder einen zweiten Check. Das ist dieselbe Logik hinter KI-Guardrails in jedem Support-Setup.
Was unterscheidet sie von Jev und OpenAI?
Die Input-Typen. Gemini Decision 1 liest Text, Bilder, Audio, Video und PDFs in einer Anfrage, mit einem 262K-Fenster. Die meisten Konkurrenten sind reiner Text oder Text plus Bilder, mit 24K bis 65K Token.
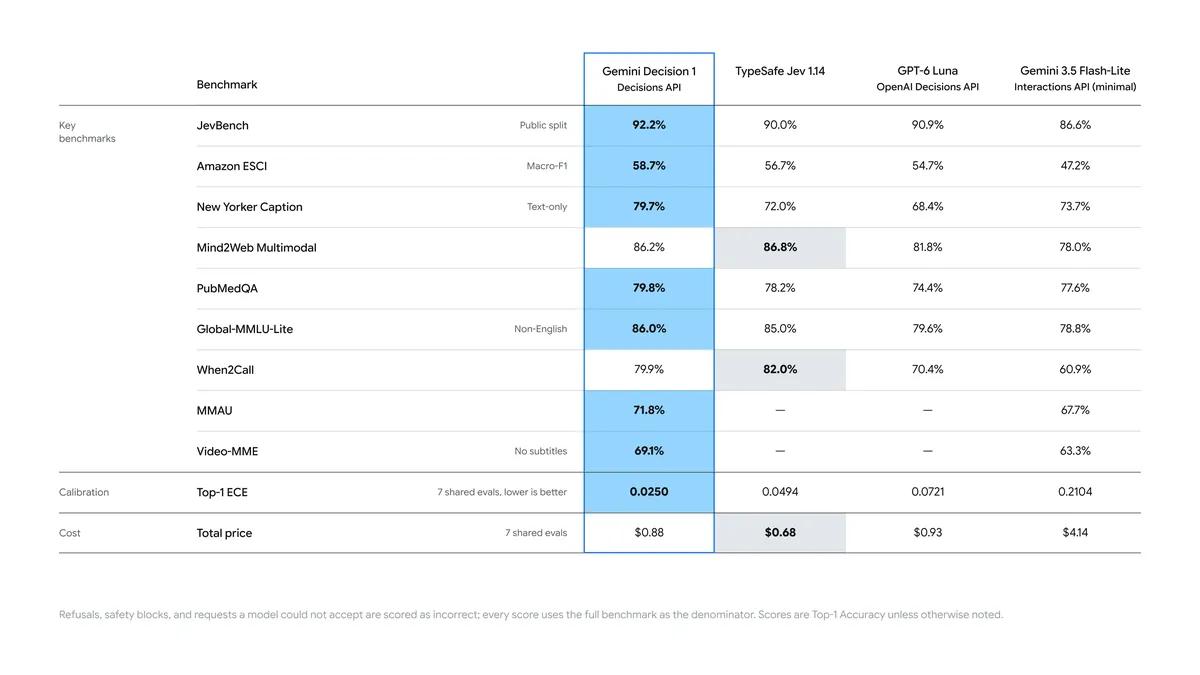
Googles Launch-Post sagt, Decision 1 „leads across the suite, with the lowest calibration error." Behandle das als Google, das seine eigenen Hausaufgaben benotet, bis eine unabhängige Stelle das nachprüft. So sieht die Kategorie auf der jeweiligen Anbieterseite aus:
| Modell | Input-Preis pro 1M | Output | Kontext | Liest |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | Kostenlos | 262.144 | Text, Bilder, Audio, Video, PDFs |
| OpenAI Decisions API (GPT-6 Luna) | 0,10 $ | Kostenlos | Lunas Fenster, 2x Input ab 272K | Text, eingebettete Bilder |
| TypeSafe Jev | 0,042 $ | Kostenlos | 32.000 | Text |
| Microsoft-Decision-1 | 0,042 $ | Kostenlos | 32.768 | Nicht angegeben |
| Cloudflare Clef | 0,24 $ | Kein Output-Preis | 65.536 | Text, JSON, Bilder, Video |
| Cloudflare Clef-flash | 0,038 $ | Kein Output-Preis | 24.576 | Text, JSON, Bilder, Video |
| Strands Decider 2B | Kostenlos (Self-Hosting) | Kostenlos | 3K bis 4K Run-Fenster | Text |
Gemini-Zahlen geprüft am 12. November 2026. Zahlen der Konkurrenten laut jeweiliger Anbieterseite, zuletzt geprüft am 11. Oktober 2026.
Drei Dinge fallen auf:
- Gemini trifft Openais Preis exakt und kostet pro Token etwa das 2,4-Fache von Jev. Du zahlst für multimodalen Input und das große Fenster.
- Audio und PDFs sind neu für diese Kategorie. Googles eigene Beispiele kombinieren „a call recording with account metadata or a scanned PDF claim with damage photos." Keine separate Gebühr für Transkription oder OCR.
- Beim Hosting ist weniger möglich, als es aussieht. Keine offenen Gewichte, kein Self-Hosting und noch kein Vertex AI. Jev läuft auf Cloudflare, Microsofts Modell auf Azure, und Strands läuft überall.
Der Hacker-News-Thread zum Launch kam beim Thema Preis gegenüber Input zum selben Schluss:
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."
Wenn deine Inputs reine Text-Tickets sind, kosten dich Jev oder Clef-flash pro Entscheidung weniger. Wenn deine Inputs Voicemails, Anrufaufnahmen, Fotos von defekten Produkten oder PDF-Rechnungen sind, ist Gemini das einzige gehostete Decision-Modell, das mir bekannt ist, das alle davon direkt verarbeitet. Für einen breiteren Blick auf die reinen Text-Optionen siehe meine Übersicht zu Jev-Alternativen.
Wie viel kostet die Gemini Decisions API?
Gemini Decision 1 kostet in der kostenpflichtigen Stufe 0,10 $ pro Million Input-Token, und Output ist immer kostenlos, weil es keinen gibt. Die kostenlose Stufe ist für Prototyping „Free of charge", wobei Google diese Daten zur Produktverbesserung nutzen darf (bei der kostenpflichtigen Stufe nicht).
Zwei Abrechnungsdetails zählen mehr als der Preis selbst:
- Der gemeinsame Input wird pro Anfrage einmal abgerechnet, egal wie viele Fragen du stellst. Jede Frage fügt nur ihre eigenen Instruction- und Kriterien-Token hinzu. Also kosten zehn Fragen zu einem Ticket deutlich weniger als zehn Aufrufe.
- Nichts wird vergünstigt. Es gibt kein Context-Caching, keine Batch API und keine Flex-Stufe, also wird derselbe Systemkontext, der bei jeder Anfrage mitgeschickt wird, jedes Mal voll abgerechnet. Mit einem Setup aus Gemini 3.5 Flash-Lite bekämst du zumindest gecachten Input für 0,03 $.
Google behauptet, Decision 1 sei auf seiner Benchmark-Suite „nearly 5x cheaper" als Flash-Lite. Mein eigenes Überschlagsbeispiel kommt zum selben Schluss. Nimm 10.000 Tickets im Monat, je 600 Token, drei Fragen zu je rund 60 Token:
- Decision 1: 7,8 Mio. Input-Token x 0,10 $ = etwa 0,78 $ im Monat.
- Flash-Lite mit Structured Output: 7,8 Mio. x 0,30 $ = 2,34 $, plus etwa 600.000 Output-Token x 2,50 $ = 1,50 $, also rund 3,84 $, vor jeglichen Thinking-Token.
In beiden Fällen ist die Modell-Rechnung für die Triage Kleingeld, verglichen mit den Kosten, jedes Ticket von einer Person lesen zu lassen. Trag hier deine eigenen Zahlen ein:
Was kannst du damit bauen?
Google nennt vier Einsatzzwecke: eine Anfrage an ein Modell, eine Queue, einen Agenten oder ein Tool weiterleiten; Inputs und Outputs gegen viele Policy-Regeln gleichzeitig prüfen; entscheiden, welche Tools ein Agent braucht oder ob kompaktiert, eskaliert oder gestoppt werden soll; und Kandidaten gegen eine Rubrik filtern oder ranken. Googles eigene Teams nutzen es bereits produktiv:
- Gemini Notebook leitet jede Anfrage an die richtige Modellstufe und Thinking-Stufe weiter, was laut Google alltägliche Anfragen mit bis zu 40 % geringerer Latenz bedient.
- Google Search nutzt es als Sicherheitsschicht für MCP-Tools und fängt feindliche Inhalte innerhalb seines Latenzbudgets ab.
- CC von Google Labs wählt eine Emoji-Reaktion aus mehr als 200 Optionen in einem Sekundenbruchteil.
- Stitch nutzt es in einem schnellen Canvas-Experiment, das in Sekunden spielbare Wireframes baut.
Für Support-Teams liegen die Einsatzmöglichkeiten auf der Hand, und Googles eigene Doku-Beispiele sind meist Support-Tickets. Hier würde ich es einsetzen:
- Triage und Routing. Abteilung, Priorität und Sprache in einem Aufruf, bevor eine Person oder ein Agent das Ticket sieht. Das ist klassische Auto-Triage.
- Eskalations-Checks. „Droht der Kunde mit Kündigung?" und „Ist das ein rechtliches oder sicherheitsrelevantes Thema?" als Ja/Nein-Fragen mit einem festen Schwellenwert, die eine Eskalations-Regel füttern.
- Antwort-QA. Einen Antwortentwurf vor dem Senden gegen zehn Policy-Regeln prüfen (keine versprochenen Rückerstattungen, keine Konkurrentennamen, korrekter Ton). Das ist der günstige Ersatz dafür, jeden Entwurf von einem LLM beurteilen zu lassen.
- Voicemail- und Foto-Aufnahme. Eine Anrufaufnahme auf Intent oder das Foto eines Kunden auf sichtbaren Schaden bewerten, ohne einen Transkriptionsschritt.
- Sentiment- und Abwanderungs-Scoring nach einer Rubrik, sodass ein „2,99 von 3" ein Ticket in der Queue nach oben schieben kann.
Was es nicht tut, ist die Antwort zu schreiben. Jede dieser Aufgaben endet mit „und dann antwortet etwas dem Kunden". Als im Launch-Thread jemand fragte, wo diese Modelle nützlich sind, fasste eine Antwort es als „Routing, classification, replacement for LLM-as-judge." zusammen. Das ist der ehrliche Umfang.
Was bedeutet das für ein Support-Team?
Für die meisten Support-Teams ist die Gemini Decisions API ein Bauteil, kein Produkt. Wenn du Engineers hast und Triage in deinen eigenen Stack einbauen willst, ist das ein günstiger, schneller Weg dafür, und der Confidence-Score gibt dir eine klare Stelle für die Übergabe an eine Person. Wenn nicht, müsstest du die Routing-Regeln, Schwellenwerte, Test-Infrastruktur und Helpdesk-Schreibvorgänge selbst bauen, und nichts davon ist im Lieferumfang.
Genau diese umgebende Schicht ist eesels KI-Helpdesk-Teammitglied. Es tritt deiner bestehenden Queue in Zendesk, Freshdesk oder HubSpot bei, trifft dieselben Kategorisierungs-, Routing- und Eskalations-Entscheidungen, und übernimmt dann den Teil, den ein Decision-Modell nicht kann: Es entwirft oder sendet die Antwort aus deinen eigenen Makros und deinem Help Center. Bevor es ein Live-Ticket berührt, wird es gegen deine historischen Konversationen simuliert, denn ein selbstsicheres falsches Label ist trotzdem falsch.
Zwei eesel-Kunden zeigen, wie das aussieht:
- smava, eine deutsche Kreditvergleichsseite auf Zendesk, kommt einer Lehrbuch-Aufgabe für ein Decision-Modell sehr nahe. In einem Monat hat eesel 27.000 Tickets über zwei Marken bearbeitet, 14.600 davon kategorisiert (Sprache, Antwortfähigkeit und Kategorie in Zendesk-Felder geschrieben) und 15.300 Antwortentwürfe aus 820 synchronisierten Makros und Artikeln erstellt.
- MentorShow, eine französische Online-Lernplattform auf HubSpot, lässt jedes Ticket analysieren und mit einem Antwortentwurf versehen. In einem Monat waren das 1.200 gelesene Konversationen und Tickets und 432 Entwürfe auf Französisch, Englisch oder Spanisch.
In beiden Fällen sind die Labels nur deshalb nützlich, weil etwas darauf reagiert. Das ist die Lücke zwischen einer Decision API und einem Teammitglied.
Solltest du die Gemini Decisions API nutzen?
Nutze sie, wenn du ohnehin Code um LLM-Aufrufe schreibst, die ein Wort zurückgeben, und besonders, wenn deine Inputs Audio, Bilder oder PDFs sind. Das Single-Pass-Modell mit vielen Fragen ist eine echte Verbesserung gegenüber dem Parsen von JSON aus einem generativen Modell, und 0,10 $ pro Million Token bei kostenlosem Output ist schwer zu schlagen.
Wähle sie, wenn du multimodale Entscheidungen, mehr als 32K Kontext oder Dutzende Checks auf demselben Input brauchst und mit Googles Developer API zurechtkommst. Wähle etwas anderes, wenn deine Inputs reiner Text sind (Jev und Clef-flash sind günstiger pro Token), du heute Vertex AI oder Self-Hosting brauchst, oder du auf gecachten oder gebatchten Input setzt, um die Kosten niedrig zu halten.
Und wenn du eigentlich willst, dass Tickets sortiert und beantwortet werden, spar dir die Verkabelung. Für einen breiteren Blick vergleicht meine Übersicht beste KI für Ticket-Triage die Tools, die beides können.
Teste eesel für Triage, die in einer Antwort endet
Ein Decision-Modell kann dir sagen, dass ein Ticket mit 0,94 Confidence ein Billing-Defekt ist. eesel übernimmt dieses Ticket in Zendesk, Freshdesk oder HubSpot, labelt es, routet es und entwirft die Antwort, die dein Team geschrieben hätte, zuerst getestet an deinen eigenen vergangenen Tickets. smava nutzt es, um 27.000 deutsche Zendesk-Tickets im Monat zu sortieren und Entwürfe zu schreiben. Sieh dir die Preise an, oder teste eesel kostenlos.
Häufig gestellte Fragen
Was ist die Gemini Decisions API?
Die Gemini Decisions API ist ein Google-Endpunkt, gestartet am 11. November 2026, der geschlossene Fragen (Ja/Nein, eine Option wählen oder nach einer Rubrik bewerten) zu einem Input beantwortet und kalibrierte Wahrscheinlichkeiten statt generierten Text zurückgibt. Sie läuft auf dem Modell Gemini Decision 1 und gehört zur gleichen Kategorie der Decision-Modelle wie TypeSafe Jev.
Was kostet die Gemini Decisions API?
Gemini Decision 1 kostet in der kostenpflichtigen Stufe 0,10 $ pro Million Input-Token, bei null abgerechneten Output-Token, und die kostenlose Stufe ist für Prototyping kostenlos. Der gemeinsame Input wird pro Anfrage einmal abgerechnet, egal wie viele Fragen du stellst. Zum Vergleich: Gemini 3.5 Flash-Lite Preise liegen bei 0,30 $ Input und 2,50 $ Output pro Million Token.
Welches Modell nutzt die Gemini Decisions API?
Sie nutzt gemini-decision-1, ein spezialisiertes multimodales Modell, das Optionen in einem einzigen Prefill-Durchgang bewertet. Es hat ein Input-Limit von 262.144 Token und ein Output-Limit von null. Es kann keinen Text generieren, keine Tools aufrufen und nicht denken, daher ergänzt es Modelle wie Gemini 4 Carbon, statt sie zu ersetzen.
Wie unterscheidet sich die Gemini Decisions API von Structured Output?
Structured Output lässt ein generatives Modell JSON schreiben, das zu deinem Schema passt, und du zahlst für jedes Output-Token. Die Gemini Decisions API schreibt nie Text: Sie gibt eine Wahrscheinlichkeit für jede zulässige Antwort zurück, die du mit einem Schwellenwert versehen kannst. Google sagt, man solle Structured Output nutzen, wenn man extrahierte Werte oder individuelle Objekte braucht, derselbe Trade-off wie OpenAI JSON-Modus gegenüber einem Decision-Endpunkt.
Ist die Gemini Decisions API besser als die OpenAI Decisions API?
Sie kosten gleich viel, 0,10 $ pro Million Input-Token bei kostenlosem Output. Gemini liest Audio, Video und PDFs zusätzlich zu Text und Bildern, während die OpenAI Decisions API Text und eingebettete Bilder nimmt. Googles Benchmark-Chart sieht Decision 1 vorn, aber das ist Googles eigener Test und wurde noch nicht unabhängig nachgeprüft.
Kann ich die Gemini Decisions API für Support-Ticket-Triage nutzen?
Ja. Googles eigene Docs nutzen Support-Beispiele: ein Ticket an Billing oder Versand routen, auf einen Produktdefekt prüfen und Abwanderungsrisiko in einem Aufruf bewerten. Das passt gut für Ticket-Triage, aber es trifft nur die Entscheidung. Du brauchst trotzdem ein System, das die Antwort schreibt, und genau da kommt ein Helpdesk-Agent ins Spiel.
Ist die Gemini Decisions API auf Vertex AI verfügbar?
Noch nicht. Stand 12. November 2026 läuft sie nur über die Gemini Developer API (v1beta) via Google AI Studio, und Google sagt, Unterstützung für Gemini in Google Cloud komme demnächst. Sie ist auch auf OpenRouter verfügbar. Wenn du sie heute auf Vertex brauchst, sieh dir Gemini-Alternativen an oder warte.
Was sind die Limits der Gemini Decisions API?
Eine Anfrage nimmt 1 bis 1.000 Fragen, 2 bis 255 Optionen pro Auswahl-Frage und 2 bis 255 Stufen pro Bewertungsfrage, alles innerhalb eines 262.144-Token-Fensters. Es gibt kein Context-Caching, keine Batch API und keine Flex- oder Priority-Stufen, also wird wiederholter Input jedes Mal voll abgerechnet. Frage-Instruktionen sind nur Text, und Inputs, die die Sicherheitsfilter auslösen, geben einen HTTP 400 statt Antworten zurück, plane also einen Eskalationsweg ein.