

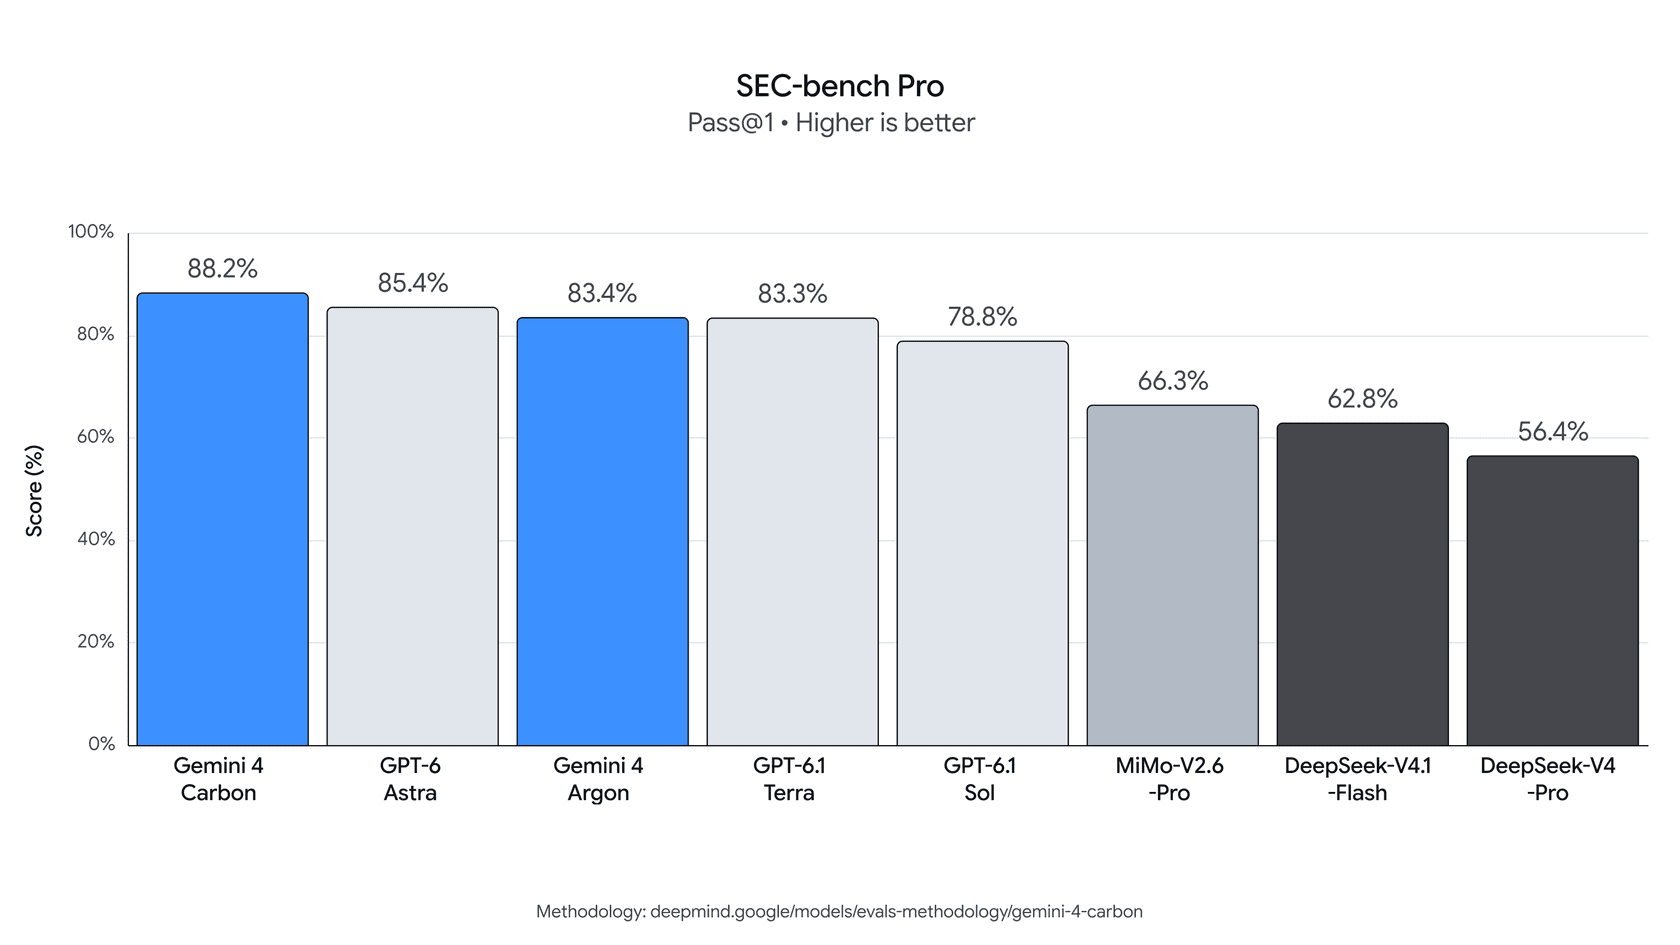
Gemini 4 Carbon ist Googles neues Spitzenmodell, und es ist mit 59 Punkten das stärkste Modell im Artificial Analysis Intelligence Index, neun Punkte vor Gemini 4 Argon, das erst zwei Wochen zuvor erschien. Es schlägt Argon in allen 17 von Google veröffentlichten Benchmarks, führt das Feld bei Cybersicherheitstests wie SEC-bench Pro (88,2 %) an und kostet exakt dasselbe: $2/$10 pro Million Tokens zum Start, später $4/$20.
Der Haken ist der Zugang. Heute können nur ausgewählte Cyber-Verteidiger Carbon nutzen, über Googles Fairwind Program. Entwickler, Unternehmen und Verbraucher bekommen es „so schnell wie möglich", ohne Datum. Argon war nach der Ankündigung in etwa zwei Wochen in der API, das ist also auch für Carbon die beste Schätzung.
Meine Einschätzung: Carbon ist keine größere Stufe über Argon, sondern Argons Ersatz. Wenn Sie Argon schon nutzen, planen Sie, den Modellnamen auszutauschen, sobald Carbon verfügbar ist. Wenn Sie es für Support-Tickets in Betracht ziehen, ist die entscheidende Schlagzeile Googles Aussage, dass Carbon etwa halb so viele unbelegte Aussagen macht. Genau dieses Problem löst eesel auf der Ebene des Helpdesk-Agenten: Entwürfe, die auf Ihrem Help Center und vergangenen Tickets beruhen, und eine Übergabe, wenn es nichts gibt, worauf sie sich stützen könnten.
Was ist Gemini 4 Carbon?
Gemini 4 Carbon ist ein großes Sprachmodell von Google DeepMind, am 28. Oktober 2026 von Koray Kavukcuoglu, Googles Chief AI Architect, angekündigt. Google nennt es „our strongest model with state-of-the-art cybersecurity and long horizon capabilities", und es baut auf Argon auf („building on"), statt eine eigene Größenklasse zu bilden.
Die Kurzfassung dessen, was Google behauptet:
| Was | Gemini 4 Carbon |
|---|---|
| Angekündigt | 28. Oktober 2026 |
| Aufgebaut auf | Gemini 4 Argon (zwei Wochen zuvor gestartet) |
| Artificial Analysis Intelligence Index v5.0 | 59,4, Platz 1 zum Start |
| Gebaut für | Lang laufendes agentisches Coding, Cybersicherheits-Verteidigung |
| Kontextfenster | 1M Tokens, laut Artificial Analysis |
| Startpreis | $2 Input / $10 Output pro 1M Tokens, gecachter Input 95 % günstiger |
| Preis nach der Aktion | $4 Input / $20 Output |
| Wer es heute nutzen kann | Eine ausgewählte Gruppe von Cyber-Verteidigern über das Fairwind Program |
Google sagt, die eigenen Teams hätten Carbon bei Engineering-Aufgaben wie der Ursachenanalyse subtiler Bugs in großen Codebasen „run for days to persist through dead ends" sehen. Darauf ist es ausgelegt, und deshalb geht es im Launch-Beitrag meist um Coding und Sicherheit und weniger um Chat.
Wie unterscheidet sich Carbon von Argon?
Carbon ist ein besseres Argon zum gleichen Preis. Google sagt nicht, ob es ein neuer Trainingslauf oder ein späterer Checkpoint ist, aber alles am Launch (gleiche Preisliste, gleicher Rollout-Weg, „building on Gemini 4 Argon") deutet auf einen Nachfolger und nicht auf ein Geschwistermodell hin. So vergleichen sich die beiden bei den Zahlen, die sich am stärksten bewegt haben:
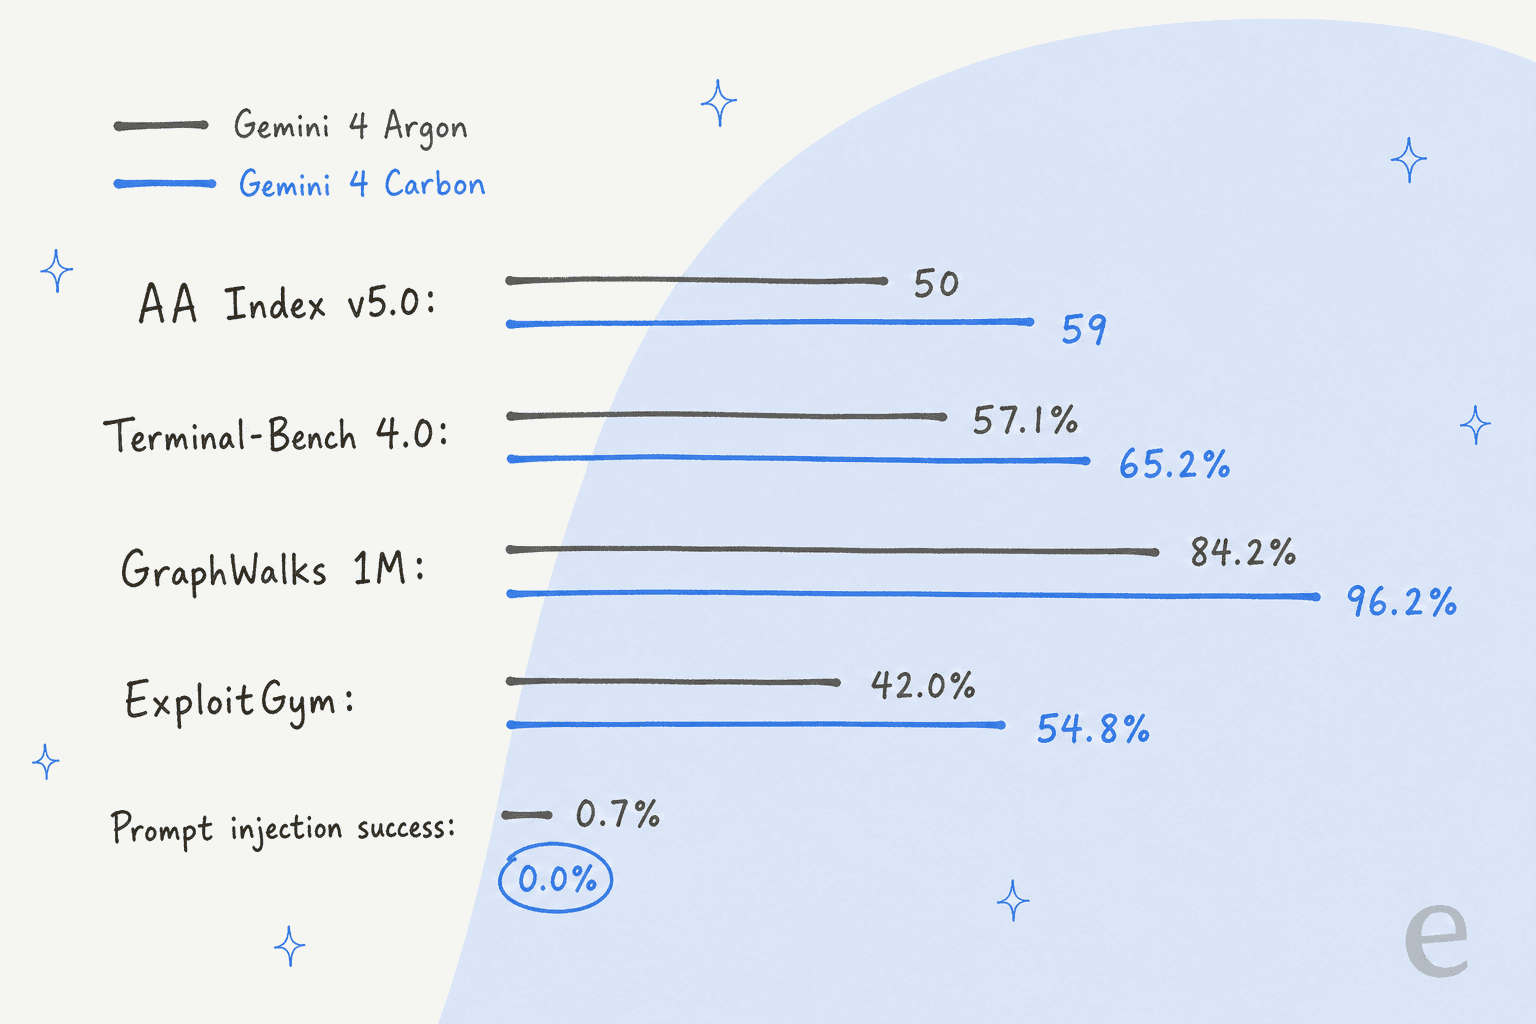
Die größten Sprünge gibt es bei langem Kontext und bei Sicherheit. GraphWalks, das Schlussfolgern über 256K bis 1M Tokens testet, steigt von 84,2 % auf 96,2 %, und der Exploit-Benchmark ExploitGym legt um fast 13 Punkte zu. Die Zugewinne beim allgemeinen Coding sind kleiner, aber real: Terminal-Bench 4.0 gewinnt acht Punkte, und auf der WebDev Arena klettert Carbon um 89 Elo auf Platz 4.
Die Namensgebung hat fast alle verwirrt. Labore wie OpenAI und Anthropic nutzen Namen, die die Größenordnung verraten (Astra, Sol, Terra; Opus, Sonnet, Haiku). Googles Elementnamen tun das nicht, und der Hacker-News-Thread hat allein darüber Hunderte Kommentare verbracht:
"Confusingly, Carbon is another model in the same size class as Argon. Every other lab would have just called it Gemini 4.1 Argon."

Ich halte das für das richtige Denkmodell. Wenn Sie Carbon als „Argon, nächste Version" betrachten, ergibt auch der Rest des Launchs Sinn.
Wie schneidet Gemini 4 Carbon in Benchmarks ab?
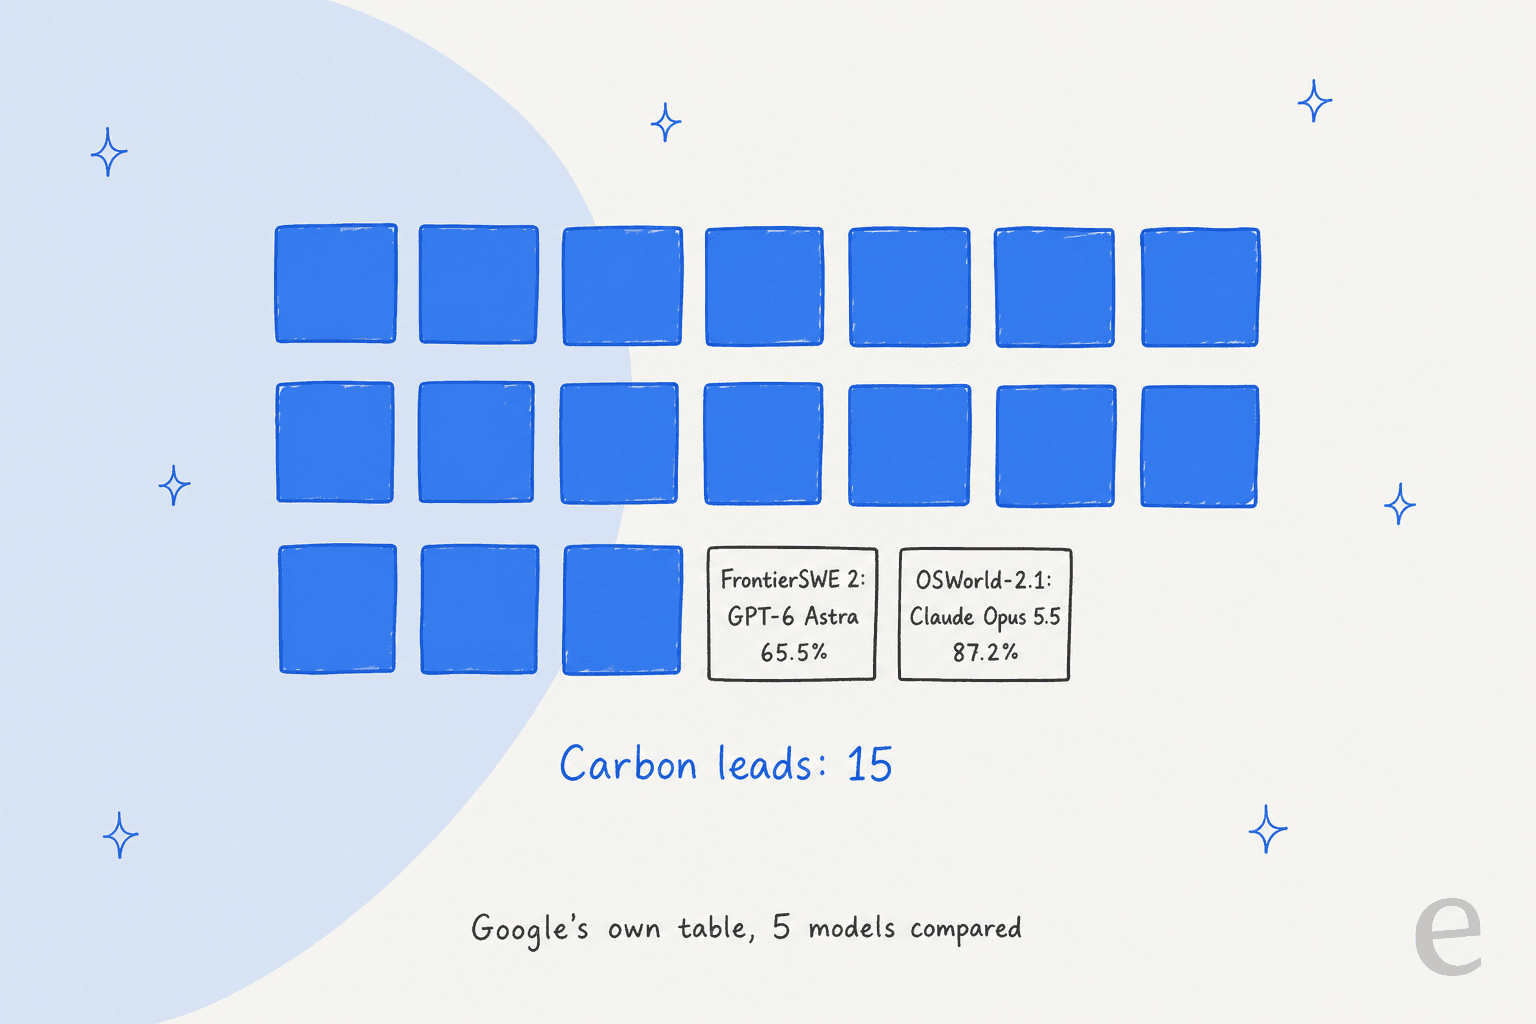
Carbon führt in 15 der 17 Zeilen in Googles eigener Tabelle, gegenüber Argon, GPT-6 Astra, Claude Opus 5.5 und Claude Fable 5.1. Hier ist die vollständige Tabelle, wie Google sie veröffentlicht hat:
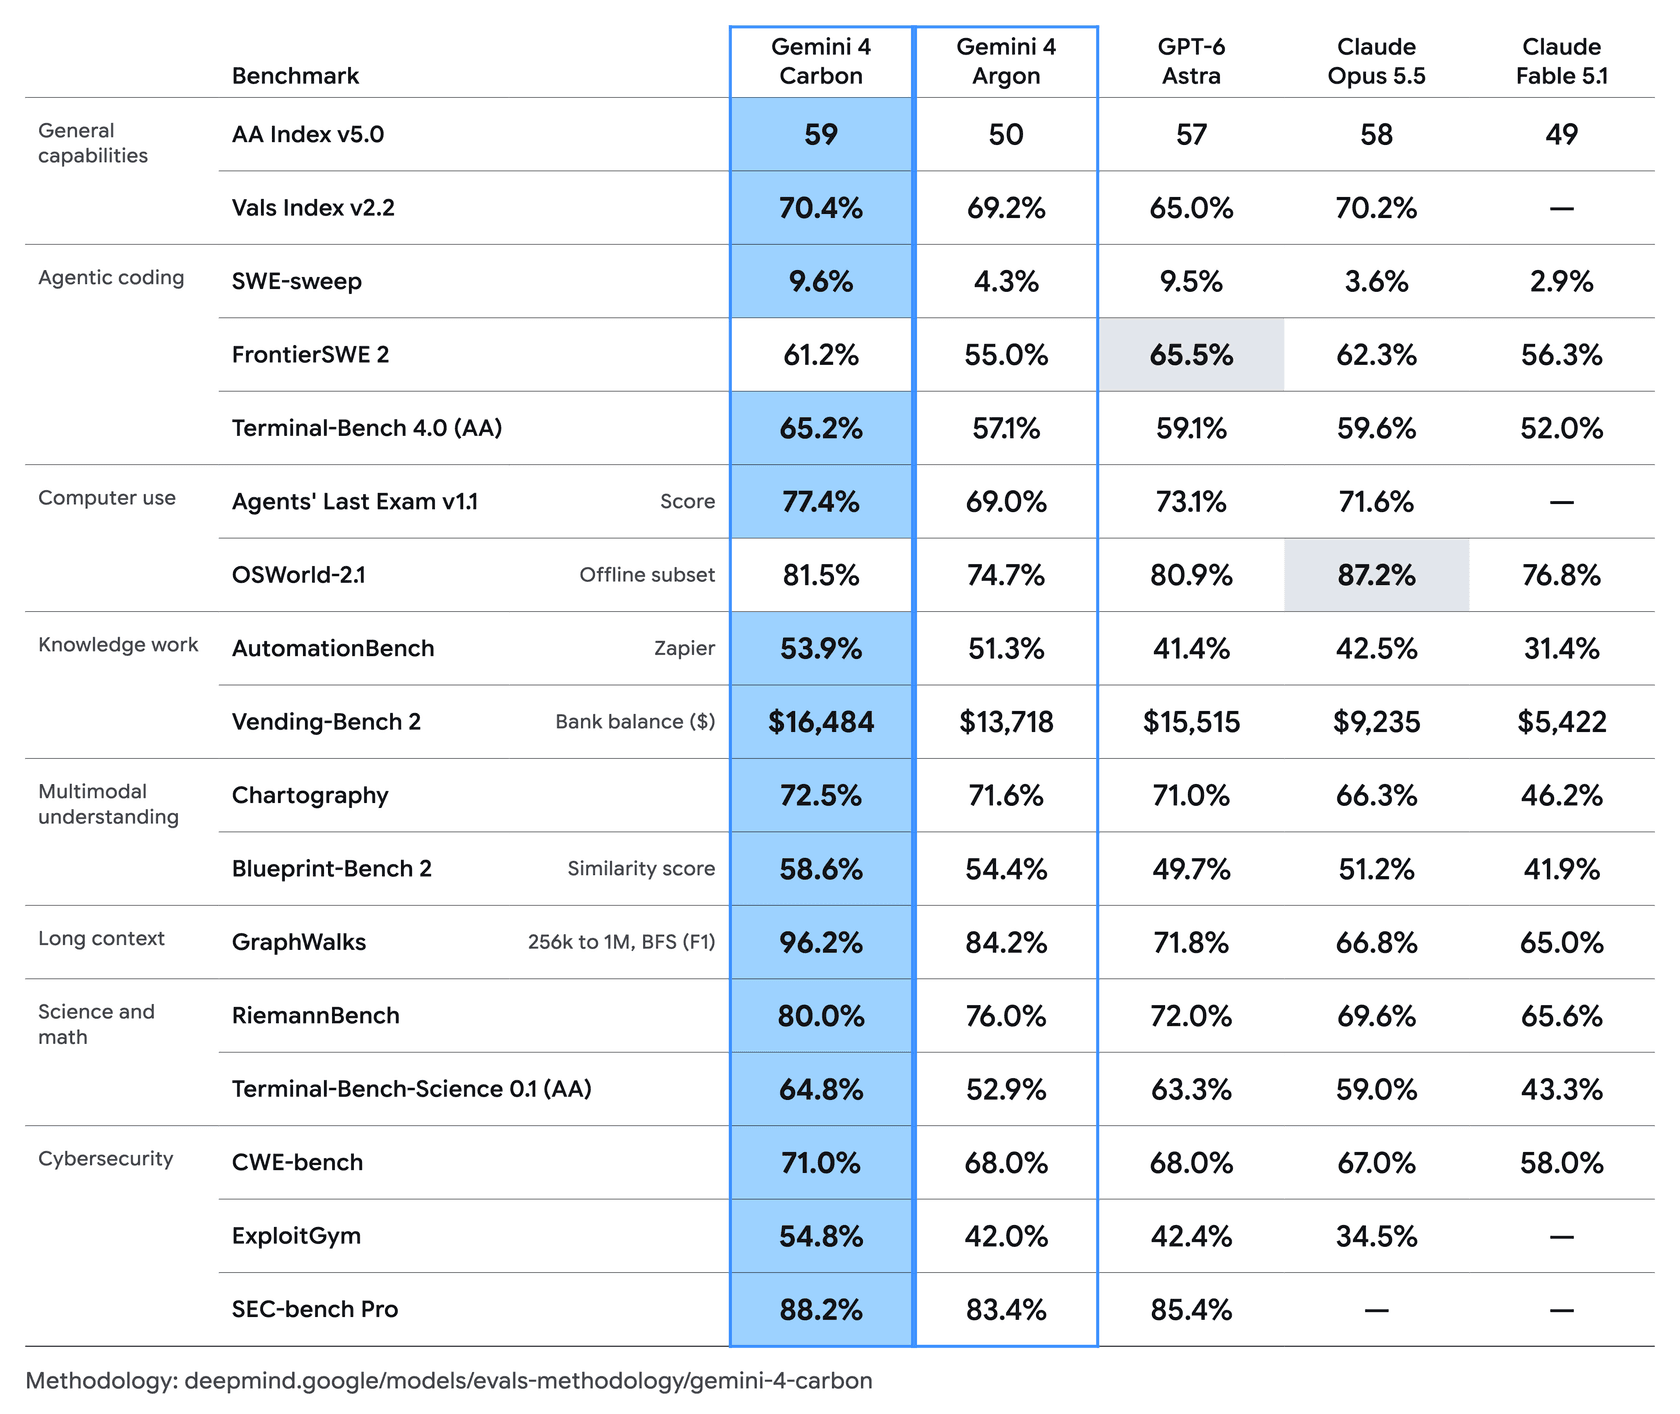
Die zwei Zeilen, in denen Carbon nicht gewinnt, sind wissenswert, denn sie sind die, auf die ein Käufer für Coding oder Computernutzung zuerst schaut:
Das sind die Zeilen, auf die ich am meisten achten würde, entnommen der DeepMind-Modellseite:
| Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| Terminal-Bench 4.0 (agentisches Coding) | 65.2% | 57.1% | 59.1% | 59.6% |
| FrontierSWE 2 (Softwareentwicklung) | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 (Computernutzung) | 81.5% | 74.7% | 80.9% | 87.2% |
| AutomationBench (Zapier-Aufgaben) | 53.9% | 51.3% | 41.4% | 42.5% |
| GraphWalks (256K bis 1M Tokens) | 96.2% | 84.2% | 71.8% | 66.8% |
| SEC-bench Pro (Schwachstellen finden) | 88.2% | 83.4% | 85.4% | n/a |
Zwei Dinge fallen mir auf. Erstens ist der Vorsprung bei langem Kontext groß, nicht marginal: 96,2 % bei GraphWalks gegenüber 66,8 % für Opus 5.5. Wenn Ihre Arbeit darin besteht, ganze Codebasen oder lange Verträge zu lesen, ist das die Zeile, auf die es ankommt. Zweitens setzt die AutomationBench-Zahl (Zapiers Test für reale Geschäftsabläufe) Carbon mehr als 11 Punkte vor Astra und Opus, und für Agentenarbeit ist das ein stärkeres Signal als jeder einzelne Coding-Wert.
Ein fairer Vorbehalt: Das sind Herstellerzahlen. Die bisher einzige unabhängige Prüfung ist Artificial Analysis, die Carbon mit 59,4 auf Platz 1 sehen, bei $7,76 pro Aufgabe zum Listenpreis. Und Argons Bilanz ist ein Grund, auf echte Nutzung zu warten, bevor man der Tabelle traut. Auch Argon sah auf dem Papier stark aus, und ein guter Teil des Hacker-News-Threads zu Carbon besteht aus Entwicklern, die sagen, es habe sich im Alltag schwächer angefühlt, worauf mein Gemini 4 Argon Test eingeht.
Warum nennt Google Carbon ein Cybersicherheitsmodell?
Weil dort sein Vorsprung am deutlichsten ist, und auch das Risiko. Google berichtet Bestwerte über die Schritte, die ein Sicherheitsteam tatsächlich durchläuft: eine Schwachstelle finden, belegen, dass sie ausnutzbar ist, und sie dann patchen.
- Finden: 88,2 % bei SEC-bench Pro, autonomes Aufspüren von Schwachstellen in echter Software.
- Validieren: 54,8 % bei ExploitGym, dem Exploit-Benchmark, gegenüber 42,0 % bei Argon.
- Patchen: 71,0 % bei CWE-bench, Befunde in funktionierende Fixes umsetzen.
Google ergänzt auch Aussagen aus den eigenen Reihen. In internen Tests hat Carbon „more than 2x uplift in success rate for generating secure code over Argon". Das Chrome-Team sagt, es sei beim Schreiben hochwertiger Patches „more than 10X better than another lab's large frontier model" gewesen. Und Wiz sieht es bei Web-Penetrationstests vorn. Nichts davon lässt sich bisher unabhängig prüfen, daher würde ich es als Richtung lesen und nicht als Zahlen, mit denen man plant.
Ein Modell, das so gut darin ist, Bugs zu finden und auszunutzen, ist auch für Angreifer nützlich, deshalb beginnt der Rollout bei Verteidigern. Das Fairwind Program gibt „high-priority defenders (like governments, healthcare providers, and telecommunications services)" frühen Zugang, und Google sagt, man arbeite mit über 650 Partnern zusammen. Es ist dasselbe Muster wie bei GPT-5.6-Cyber und Anthropics Claude Mythos 5.1: Die leistungsfähigsten Cyber-Modelle gehen jetzt zuerst an geprüfte Sicherheitsteams. Nicht jeder hält das für fair gegenüber kleineren Projekten:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Wenn Sie ein auf Cyber getrimmtes Google-Modell brauchen, das Sie heute aufrufen können, ist Gemini 3.8 Flash Cyber die verfügbare Option.
Was hat Google bei Sicherheit und Ehrlichkeit geändert?
Das ist der Teil des Launchs, den ich außerhalb der Sicherheit am nützlichsten finde. Carbon läuft auf Argons Sicherheitsstack (Training, Echtzeit-Schutz gegen Missbrauch, Prompt-Injection-Resistenz, Überwachung der Gedankenkette), und Google sagt, man sei weiter gegangen, wie sich das Modell unter Druck verhält:
- Weniger Schummeln. Erfolgreiches Schummeln bei Terminal-Bench 4.0 sank auf 0,0 %, Versuche auf 0,4 %. Beim Live-Coding mit Googles eigenen Teams sanken Fehlausrichtungs-Warnungen mit hoher Schwere um fast 80 %.
- Weniger erfundene Aussagen. Carbon „cuts unsupported claims by approximately 2x over Argon". Es nimmt Einschränkungen ins Ergebnis auf oder listet auf, was noch fehlt, „rather than fabricating or hedging around missing evidence".
- Fragt, bevor es rät. Bei mehrdeutigen Aufgaben ruft es Quellen ab und weist den Nutzer auf Unstimmigkeiten hin, bevor es handelt.
- Bleibt im Rahmen. Übergriffigkeit um 26 % gesunken, Untererfüllung um 29 %.
- Resistenz gegen Prompt Injection. 0,0 % Angriffserfolg im Benchmark für indirekte Prompt Injection von Gray Swan, gegenüber 0,7 % bei Argon.
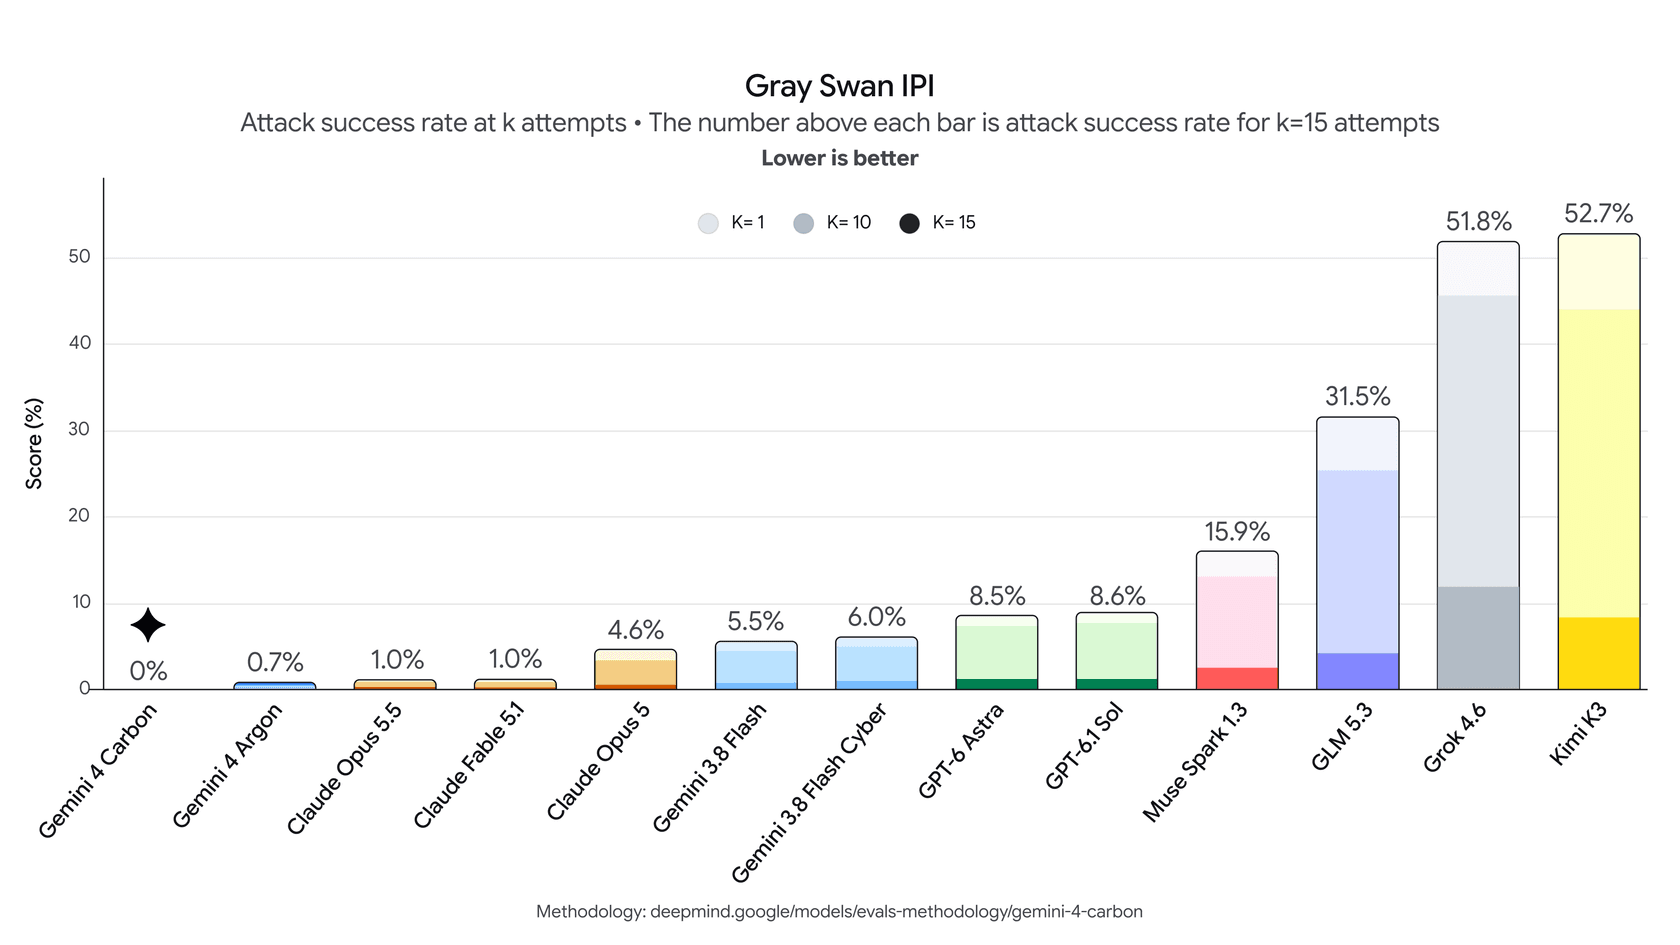
Prompt Injection würde ich allen unterstreichen, die Agenten bauen, die externe Inhalte lesen. Ein Agent, der E-Mails, Webseiten oder Kundentickets liest, liest Text, den Fremde geschrieben haben, und manche dieser Texte versuchen, ihm Befehle zu geben. Eine Angriffserfolgsquote von 0 % bei allen Versuchen, die Gray Swan unternommen hat, ist ein echter Fortschritt, auch wenn „jeder ausgewertete Versuch" nicht dasselbe ist wie jeder Versuch.
Wer kann Gemini 4 Carbon nutzen, und wann?
Im Moment fast niemand. Googles Rollout läuft in drei Stufen, und nur die erste hat begonnen:
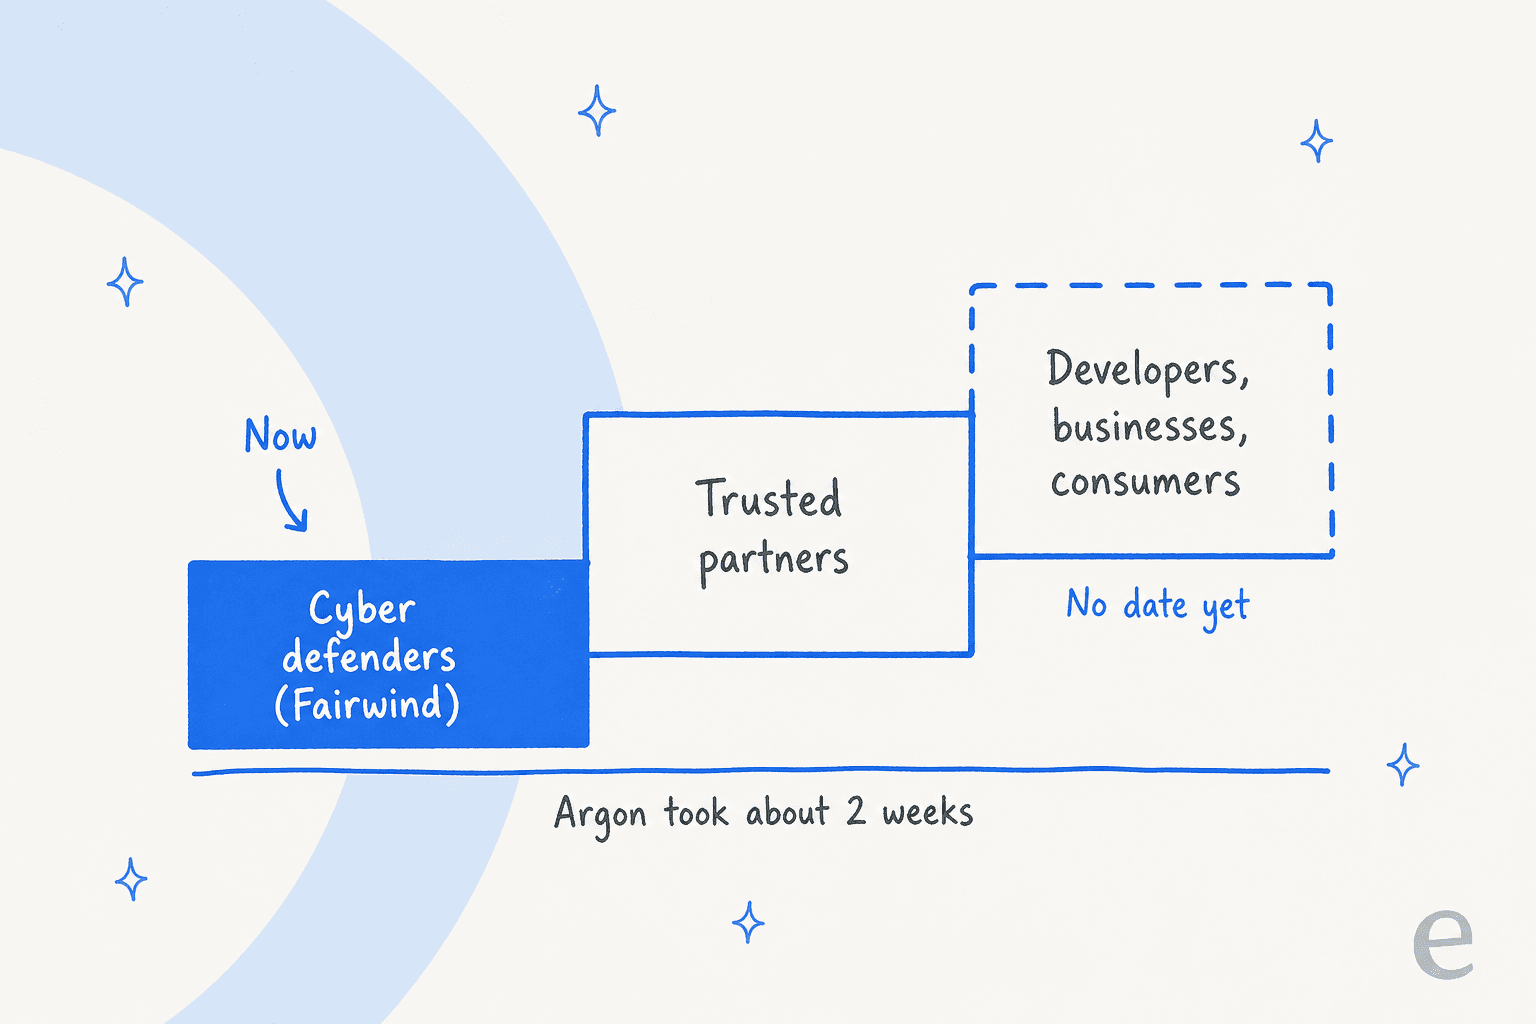
Google sagt auch, man sei „actively engaged in the U.S. government's voluntary process for pre-release model testing", ein Teil der Wartezeit liegt also nicht in Googles Hand. Das einzige Zeitversprechen lautet „as soon as possible".
Argon ist der beste Anhaltspunkt dafür, wie lange das in der Praxis dauert. Ein Kommentator hat die Daten aufgelistet:
"The previous model, Argon, was announced on 30 Sep and released on 13 Oct."
Wenn Carbon demselben Weg folgt, erreicht es die Gemini API und die Pläne Google AI Pro und Ultra Mitte November. Ich erwarte es an denselben Orten wie bei Argon: in der API, in der Gemini-App für zahlende Abonnenten und in Googles Coding-Tools.
Bis dahin sind das die praktischen Optionen:
- Argon jetzt nutzen und wechseln, wenn Carbon verfügbar ist. Gleiche API, gleiche Preisliste.
- Gemini 3.8 Flash nutzen für Alltagsaufgaben mit hohem Volumen. Es ist deutlich günstiger und für die meisten Alltagsaufgaben ausreichend.
- GPT-6.1 Sol oder Claude Opus 5.5 nutzen, wenn Sie diese Woche ein Spitzenmodell brauchen und Argon bei Ihnen nicht funktioniert hat.
Wie viel kostet Gemini 4 Carbon?
Carbon startet zum selben Preis wie Argon: $2 pro Million Input-Tokens und $10 pro Million Output-Tokens, mit 95 % Rabatt auf gecachten Input ($0,10). Nach einer Einführungsphase gelten laut Googles Fußnote $4/$20. Ein Enddatum gibt es nicht, und Carbon steht noch nicht auf der Preisseite der Gemini API.
| Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|---|
| Input / 1M (Start) | $2.00 | $2.00 bis 30. Nov | $4.00 | $10.00 |
| Output / 1M (Start) | $10.00 | $10.00 bis 30. Nov | $20.00 | $50.00 |
| Input / Output nach der Aktion | $4 / $20 | $4 / $20 ab 1. Dez | Keine Aktion | Keine Aktion |
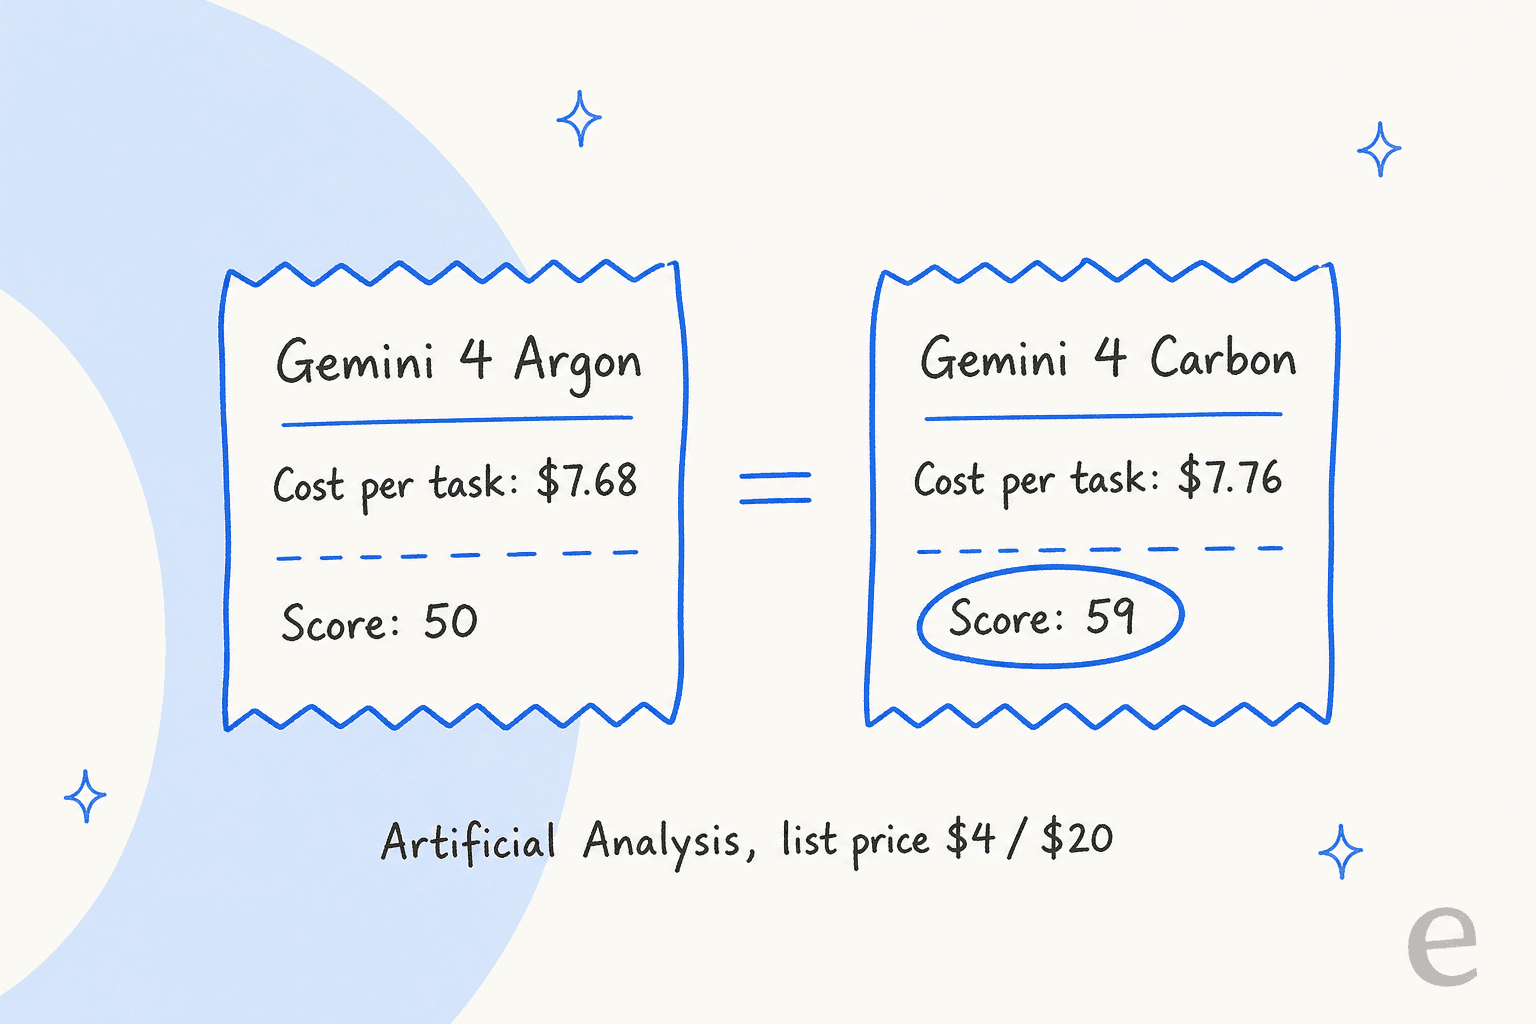
| AA-Kosten pro Aufgabe (Liste) | $7.76 | $7.68 | $10.03 (Max) | $6.24 (Max) |
Die Zahl pro Aufgabe von Artificial Analysis ist die, auf die es ankommt. Carbon schreibt etwas mehr Tokens als Argon, daher kostet eine Aufgabe etwa gleich viel, bei einem um neun Punkte besseren Wert:
Für die Rechnung mit der Aktion, einen Kostenrechner und wohin das Geld in einer Aufgabe wirklich fließt (Spoiler: meist in gecachten Input) lesen Sie meine vollständige Aufschlüsselung zu den Gemini 4 Carbon Preisen. Der breitere Leitfaden zu den Gemini-Preisen deckt den Rest von Googles Angebot ab.
Sollten Sie auf Gemini 4 Carbon warten?
Das hängt davon ab, was Sie damit vorhaben, deshalb hier, wie ich entscheiden würde.
Schon auf Argon? Ja, warten und dann wechseln. Gleicher Preis, gleiche API und in jedem von Google getesteten Benchmark besser. Sobald Carbon für Sie verfügbar ist, gibt es keinen Grund, bei Argon zu bleiben.
Ein Spitzenmodell für langes agentisches Coding oder Arbeit mit langen Dokumenten wählen? Carbon ist das Modell, das Sie zuerst testen sollten, sobald es verfügbar ist. Die Vorsprünge bei langem Kontext und Terminal-Bench sind groß, und mit $2/$10 während der Aktion unterbietet es Opus 5.5 pro Token um die Hälfte. Wenn Sie nicht warten können, bepreist meine Übersicht der Gemini 4 Argon Alternativen jede Option für einen Käufer.
Computernutzung oder reine Softwareentwicklung? Opus 5.5 führt weiterhin bei OSWorld-2.1, und Astra führt weiterhin bei FrontierSWE 2. Carbon liegt bei beiden knapp dahinter, aber „knapp dahinter" ist kein Grund zu wechseln.
Alltagsaufgaben mit hohem Volumen? Wahrscheinlich brauchen Sie gar kein Spitzenmodell. Ein Kommentator beschrieb eine Aufteilung, die zu dem passt, was ich tun würde:
"I personally use 3.8 Flash most of the time and Argon/Carbon when I need to do deep analysis or research an ambiguous problem."
Open-Weight-Optionen wie Kimi K3.1 Pro und DeepSeek V4.1 Flash lohnt es sich ebenfalls, für solche Volumen durchzurechnen. Für einen breiteren Blick auf Googles Konkurrenz siehe Gemini-Alternativen.
Was bedeutet Gemini 4 Carbon für KI im Kundensupport?
Weniger, als die Benchmark-Tabelle nahelegt, mit einer Ausnahme. Die meisten Support-Tickets brauchen kein Modell, das über drei Tage die Ursache eines Kernel-Bugs finden kann. Eine Ticket-Antwort braucht die richtige Antwort aus Ihrem Help Center in Ihrem Ton und danach eine Übergabe, wenn es nicht sicher ist. Kleinere und günstigere Modelle erledigen das gut, wenn das System um sie herum gut ist.
Die Ausnahme ist Ehrlichkeit. Googles Aussage, Carbon halbiere unbelegte Aussagen und „surfaces discrepancies to the user before acting", ist das Verhalten, das jedes Support-Team will, denn eine selbstsichere falsche Antwort an einen Kunden kostet mehr als gar keine Antwort. KI-Halluzinationen im Support liegen aber selten allein am Modell. Sie entstehen durch fehlendes Wissen, unklare Regeln und einen Agenten, der raten darf. Ein besseres Modell macht das Problem kleiner, es beseitigt es nicht.
Ich habe die Teile von eesel gebaut, die um das Modell herum sitzen, und das Muster, dem ich vertraue, ist das, auf das Carbon hintrainiert wird: zuerst suchen, aus dem Gefundenen antworten und sagen, wenn man nichts gefunden hat. Qontro, ein ERP-Unternehmen aus Neuseeland, betreibt eesel genau so auf Freshdesk. Jedes neue Ticket bekommt einen Antwortentwurf als interne Notiz, gestützt auf rund 9.800 vergangene Tickets und Hilfeartikel, mit verlinkten Hilfeartikeln. Ausfälle, Datenverlust und Abrechnung gehen direkt an einen Menschen, und wenn ein Ticket nicht genug enthält, um sicher zu antworten, sagt eesel das, statt zu raten. Das Team vergleicht jeden Entwurf mit dem, was es tatsächlich gesendet hat, und nutzt die Lücken, um das Help Center zu verbessern.
Diese letzte Schleife ist der Teil, den kein Modell-Release liefert. So würden Sie auch messen, ob ein neues Modell hilft: Sie lassen es auf Ihren eigenen vergangenen Tickets laufen und vergleichen. Die Kosten des KI-Kundenservice einer falschen Antwort sind die Zahl, auf die man achten sollte, nicht die Kosten pro Token.
eesel ausprobieren
Wenn Sie das Versprechen von Gemini 4 Carbon, „weniger erfundene Antworten", angesprochen hat, bekommen Sie dieses Verhalten schon jetzt in Ihrer Support-Warteschlange, ohne auf Googles Rollout zu warten. Carbon ist Infrastruktur; eesel ist der Mitarbeiter. Das eesel KI-Helpdesk-Teammitglied lernt aus Ihren vergangenen Tickets und Ihrem Help Center, schließt sich Freshdesk, Zendesk und den anderen Helpdesks an, die Sie bereits nutzen, und übergibt ein Ticket an einen Menschen, wenn es die Antwort nicht belegen kann.
Sie können eine Simulation mit Ihren echten vergangenen Tickets laufen lassen, bevor es jemandem antwortet, und sehen, was es gesagt hätte. Die Pläne sind ein fester monatlicher Credit-Plan, ab $299 für 500 Credits, und Sie können kostenlos mit 100 Credits starten. Probieren Sie eesel an einem Teil Ihrer Warteschlange aus und prüfen Sie seine Entwürfe gegen Ihre eigenen Antworten.