

Die beste Gemini 4 Carbon Alternative für die meisten Teams ist Gemini 4 Argon, das Modell, auf dem Carbon aufbaut: Es ist heute per API zum gleichen Einführungspreis von $2/$10 verfügbar und erfand bei Artificial Analysis in 4% der Fälle Antworten, gegenüber 11% bei Carbon. Carbon selbst ist über Googles Fairwind Program auf Cyber-Verteidiger beschränkt, ohne Termin für alle anderen.
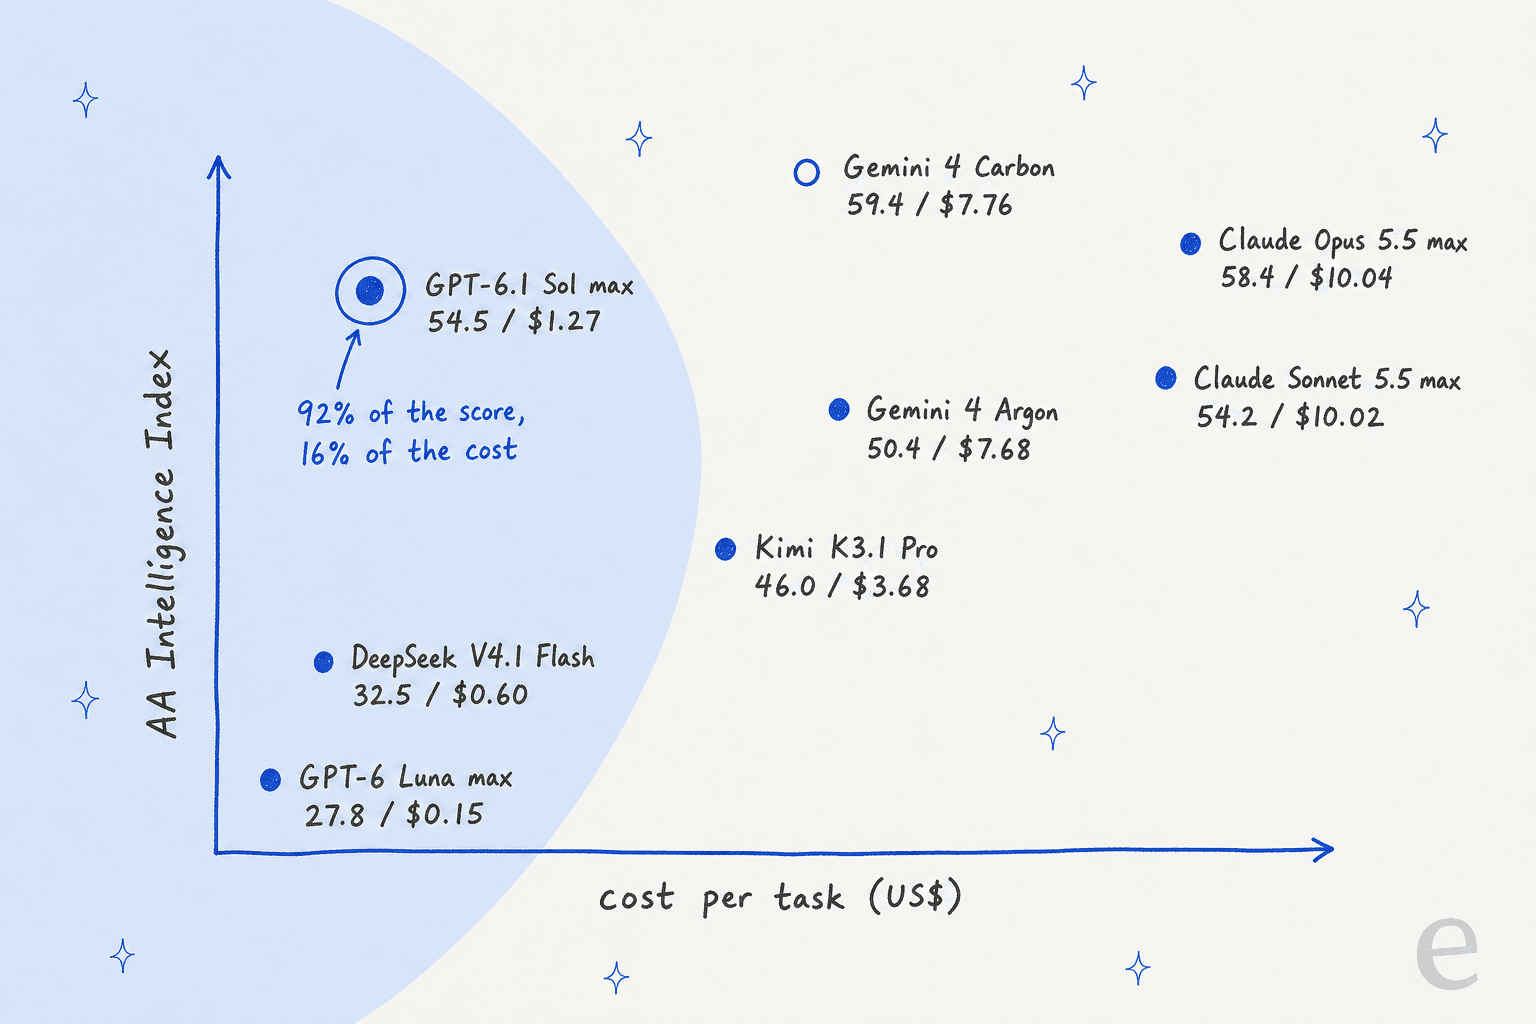
Wenn Sie Carbon wegen des Scores wollten, erreicht GPT-6.1 Sol mit maximalem Aufwand 92% des Index-Scores von Carbon bei 16% der Kosten pro Aufgabe ($1,27 vs. $7,76). Claude Opus 5.5 liegt beim reinen Score am nächsten (58,4), ist aber pro Aufgabe am teuersten. Kimi K3.1 Pro, DeepSeek V4.1 Flash und GPT-6 Luna decken langen Kontext, offene Gewichte und günstige Triage ab.
Wenn Sie Carbon für einen Support-Agenten im Auge hatten, zählt das Modell weniger als das, was es liest. Ich baue die Integrationen hinter eesel, wo ein KI-Helpdesk-Teammitglied mit jedem dieser Modelle aus Ihrem Help Center und früheren Tickets antwortet; SamCart betreibt einen Agenten für Freshdesk-Tickets und einen weiteren für den Website-Chat und antwortet auf Basis von 280 Hilfeartikeln.
Warum suchen Leute nach Gemini 4 Carbon Alternativen?
Weil es fast niemand nutzen kann. Google hat Gemini 4 Carbon angekündigt am 28. Oktober 2026 und gesagt, dass es "starting this week" an einen Teil der Cyber-Verteidiger geht, dann schrittweise an mehr vertrauenswürdige Partner, wobei Entwickler, Unternehmen und Verbraucher unter "coming soon" stehen. Für die letzte Gruppe gibt es keinen Termin.
Die Hürde läuft über das Fairwind Program, das Google als Frühzugang für vorrangige Verteidiger beschreibt, "like governments, healthcare providers, and telecommunications services". Es arbeitet mit über 650 Partnern und führt Hintergrundprüfungen bei bewerbenden Organisationen durch. Wenn Sie ein Support-Team oder ein SaaS-Produkt betreiben, sind Sie das nicht, zumindest vorerst nicht.
Das ist ein wenig schade, denn Carbon ist stark. Es führt den Artificial Analysis Intelligence Index mit 59,4 an, schlägt Argon in allen 17 Zeilen von Googles eigener Benchmark-Tabelle und startet zum Preis von Argon: $2 pro Million Input-Tokens und $10 pro Million Output-Tokens, nach der Einführungsphase $4/$20. Ich habe alles in meinem Gemini 4 Carbon Erklärartikel durchgesehen.
Der Hacker-News-Thread zum Launch (735 Punkte) traf die Stimmung ziemlich gut:
"I can't tell if they're withholding access to manufacture some sense of scarcity but the delays are really prolonged."

Der Präzedenzfall von Argon hilft ein wenig. Argon wurde am 30. September angekündigt und am 13. Oktober veröffentlicht, etwa zwei Wochen später, wie ein Hacker-News-Kommentator anmerkte. Aber Argon war nie auf ein Sicherheitsprogramm beschränkt, deshalb würde ich keinen Produktlaunch darauf planen, dass Carbon derselben Uhr folgt.
Wie ich diese Alternativen ausgewählt habe
Ich bin dort gestartet, wo auch ein Käufer starten würde. Ich habe ChatGPT in einem neuen Chat nach den besten Alternativen für einen KI-Support-Agenten gefragt, nachdem Carbon nur noch für Cyber-Zwecke zugänglich ist. Es nannte GPT-6.1 Sol, Gemini 4 Argon, Claude Sonnet 5.5 und GPT-6 Luna und schlug ein Zwei-Modelle-Setup vor, bei dem ein günstiges Modell die Triage übernimmt und ein stärkeres die schwierigen Fälle. Alle vier haben es auf diese Liste geschafft, und diese Routing-Idee prägt den letzten Abschnitt.
Dann habe ich die Modelle ergänzt, die bei den eigenen Benchmarks mit Carbon konkurrieren, und jeden Preis am 29. Oktober 2026 auf der Preisseite des Anbieters geprüft. Die Bewertungsdaten stammen von Artificial Analysis, das Carbon, Argon und die übrigen zum Listenpreis durch denselben Index geschickt hat. Pro Modell habe ich drei Zahlen herangezogen:
- Intelligence Index v5.0, der Spitzen-Score, den Carbon anführt.
- Kosten pro Aufgabe, was eine Index-Aufgabe zum Listenpreis tatsächlich gekostet hat, inklusive aller Reasoning-Tokens. Diese Zahl zeigt, ob eine günstige Preisliste in der Praxis wirklich günstig ist.
- Halluzinationsrate bei AA-Omniscience: wie oft das Modell eine falsche Antwort gibt, obwohl es hätte sagen sollen, dass es etwas nicht weiß. Für alles, was Kunden gegenübersteht, ist mir diese Zahl am wichtigsten.
eesel setzt seit Jahren KI-Agenten auf Live-Support-Warteschlangen an, und wir haben gesehen, wie selbstsicher klingende Bots stillschweigend falsche Antworten geben. Deshalb läuft jeder eesel-Rollout heute gegen die historischen Tickets eines Teams, bevor er einem echten Kunden antwortet, und deshalb bekommt die Halluzinationsspalte hier genauso viel Gewicht wie der Spitzen-Score.
Gemini 4 Carbon Alternativen im Überblick
Hier ist die ganze Liste in einer Tabelle. Die Preise sind Standard-API-Preise pro Million Tokens am 29. Oktober 2026. Die AA-Zahlen gelten bei der jeweils höchsten Aufwandsstufe des Modells, sofern nicht anders angegeben, zum Listenpreis.
| Modell | Heute nutzbar? | Input / Output (pro 1 Mio.) | Gecachter Input | AA Index v5.0 | AA Kosten pro Aufgabe | Rate erfundener Antworten | Kontextfenster | Offene Gewichte | Am besten für |
|---|---|---|---|---|---|---|---|---|---|
| Gemini 4 Carbon (Referenz) | Nur Cyber-Verteidiger | $2 / $10 Einführung, dann $4 / $20 | 95% Rabatt auf Input | 59.4 | $7.76 | 11% | 1M | Nein | Sicherheit und Coding, falls Sie Zugang bekommen |
| Gemini 4 Argon | Ja, Gemini API | $2 / $10 bis 30. Nov., dann $4 / $20 | $0.10, dann $0.20 | 50.4 | $7.68 | 4% | 1,048,576 | Nein | Wenigste erfundene Antworten |
| GPT-6.1 Sol | Ja, OpenAI API | $2 / $10 | $0.10 | 54.5 | $1.27 | 52% | 1,050,000 | Nein | Bester Score pro Dollar |
| Claude Opus 5.5 | Ja, Claude API | $4 / $20 | $0.20 | 58.4 | $10.04 | 50% | 1M | Nein | Nächster am reinen Score |
| Claude Sonnet 5.5 | Ja, Claude API | $2 / $10 | $0.10 | 54.2 | $10.02 | 43% | 1M | Nein | Schreibqualität, Tool-Nutzung |
| Kimi K3.1 Pro | Ja, Kimi API | $2 / $10 | $0.20 | 46.0 | $3.68 | 37% | 1,048,576 | Noch nicht | Langer Kontext, Agentenarbeit |
| DeepSeek V4.1 Flash | Ja, DeepSeek API | $0.15 / $0.60 Nebenzeit, $0.30 / $1.20 Spitzenzeit | $0.003 Nebenzeit | 32.5 | $0.60 | 64% | 1M | Ja | Self-Hosting, niedrigste Rechnung |
| GPT-6 Luna | Ja, OpenAI API | $0.10 / $0.50 | $0.01 | 27.8 | $0.15 | 79% | 1,050,000 | Nein | Günstige Triage und Routing |
Zwei Dinge springen ins Auge. Erstens teilen sich fünf dieser Modelle Carbons Preisliste von $2/$10, der Token-Preis trennt sie also nicht. Die Kosten pro Aufgabe tun es, weil sie erfassen, wie viele Tokens jedes Modell beim Nachdenken verbrennt. Zweitens reicht die Spalte der erfundenen Antworten von 4% bis 79%, eine weit größere Spanne als bei den Index-Scores.
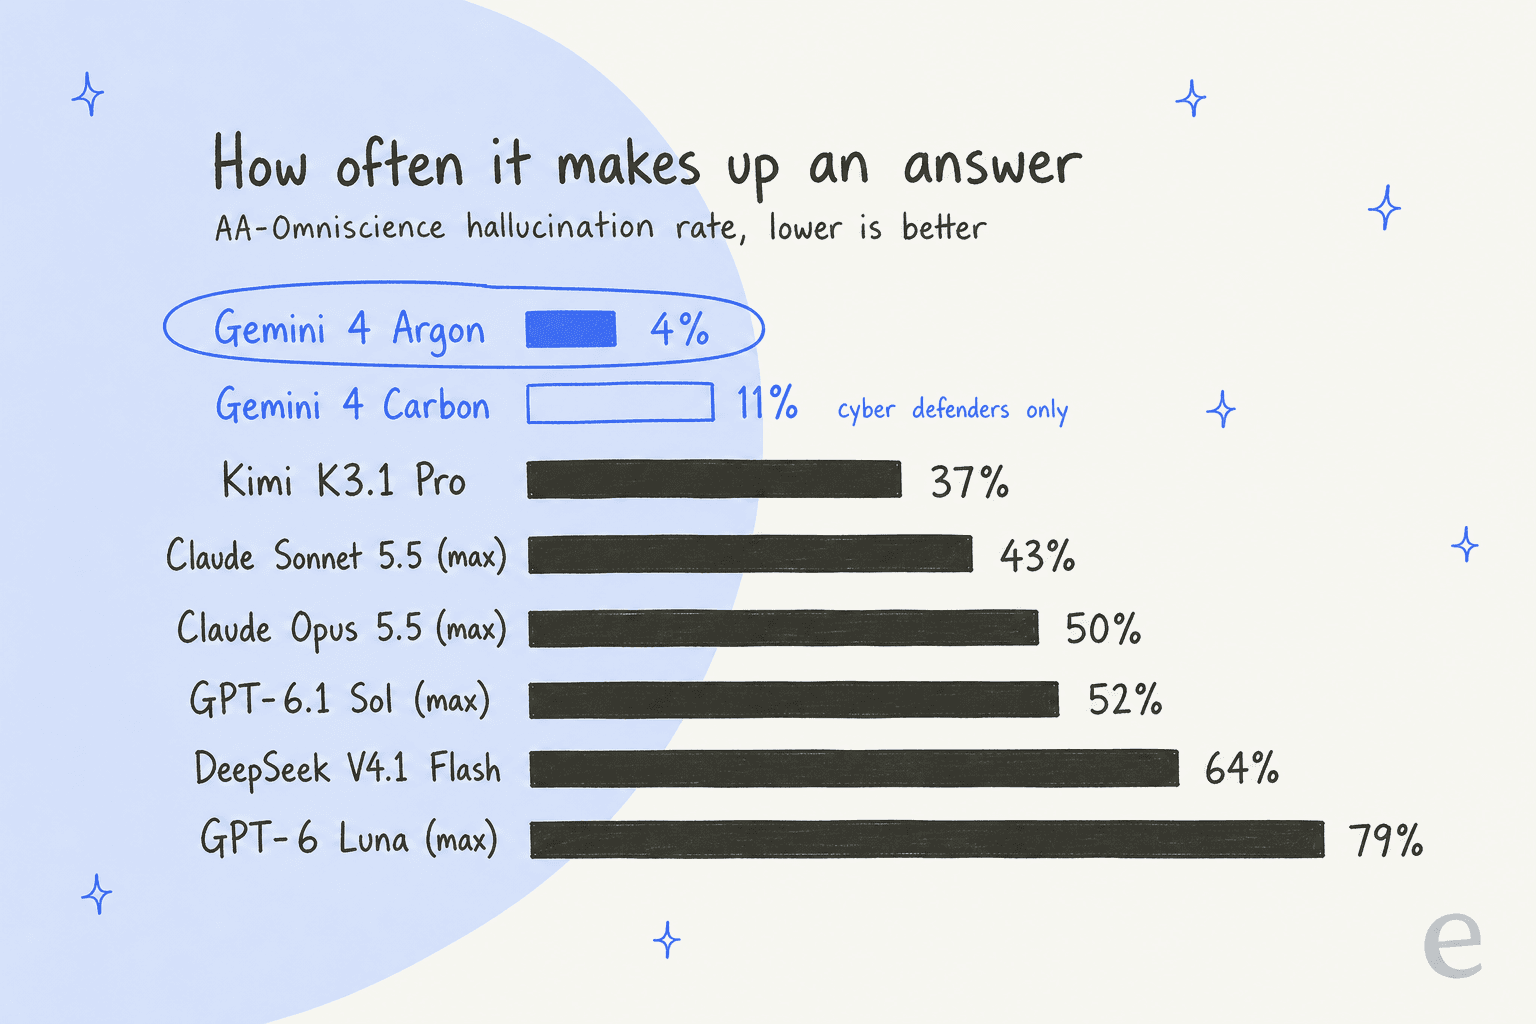
Dieses Diagramm ist der Grund, warum meine erste Wahl nicht das Modell mit dem nächsten Score ist. Wenn Carbon Sie angezogen hat, weil Google sagt, es sei ehrlicher darüber, was es nicht weiß, ist Argon bei genau diesem Test bereits vorn.
1. Gemini 4 Argon
Am besten für: Teams, die Carbon für einen kundennahen Agenten wollten und weniger erfundene Antworten wichtiger finden als einen höheren Score.
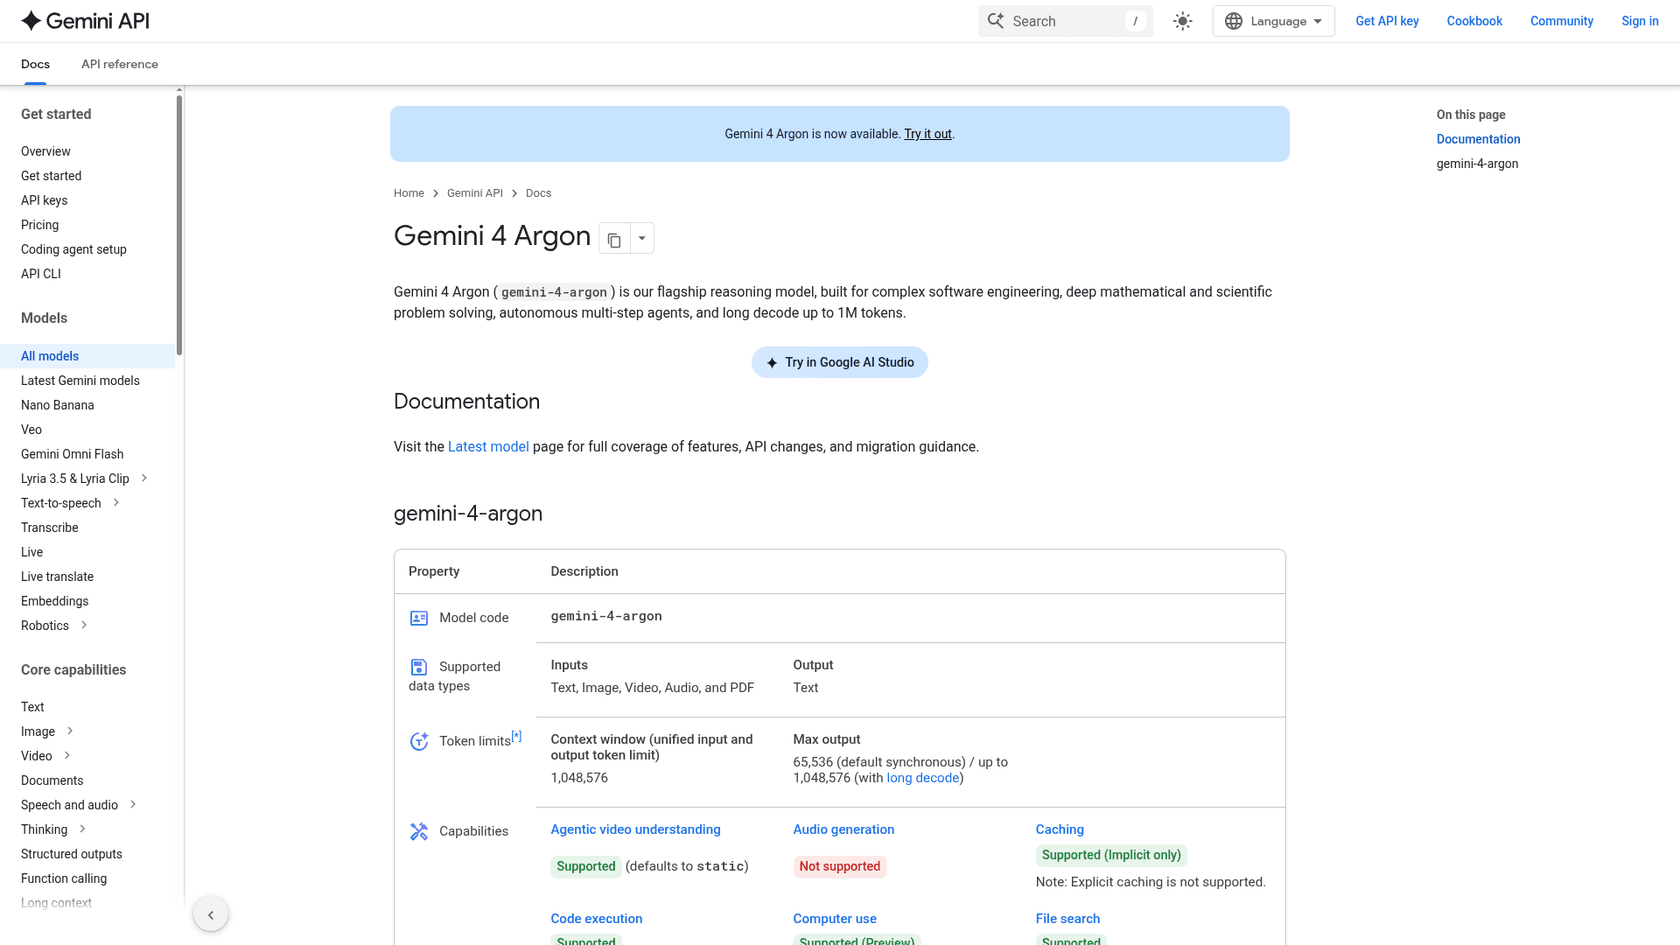
Argon ist das Modell, auf dem Carbon aufbaut, also die naheliegende erste Station. Es ist allgemein über die Gemini API und Google AI Studio verfügbar, mit einem Kontextfenster von 1.048.576 Tokens und bis zu 1M Output-Tokens mit Long Decode. Wenn Ihr Code bereits Gemini aufruft, ist der spätere Wechsel zu Carbon nur eine Änderung des Modellnamens.
Bei Artificial Analysis erreicht Argon 50,4 gegenüber 59,4 bei Carbon, Carbon ist also das klügere Modell. Aber Argons Halluzinationsrate liegt bei 4% gegenüber 11% bei Carbon, die niedrigste aller geprüften Modelle, und bei AutomationBench (mehrstufige Geschäftsabläufe) erreichte es 77,5% gegenüber 77,8% bei Carbon. Argon kostete pro Index-Aufgabe sogar etwas weniger ($7,68 vs. $7,76). Für einen Support-Agenten ist der Unterschied, der wirklich zählt, ziemlich klein.
"For what it's worth: Argon is a pretty good model, and this is coming from someone who just sticks with Opus 5.5 mostly across the board. For the current introductory price, it provides an exceptional value."
Vorteile
- Gleiche Preisliste wie Carbon, Ihr Kostenmodell ändert sich also nicht, wenn Carbon sich öffnet.
- Mit deutlichem Abstand die niedrigste Rate erfundener Antworten in dieser Liste.
- Google Search Grounding enthält 5.000 kostenlose Anfragen pro Monat.
Nachteile
- Es denkt lang: 116K Output-Tokens pro AA-Aufgabe, die Rechnung pro Aufgabe ist also hoch für den Score.
- Nur implizites Caching. Sie können einen Cache nicht explizit festlegen, wie es bei Claude geht.
- Nicht jeder schätzt es. Ein Hacker-News-Nutzer nannte es "a clear tier below" aktuellen Claude- und Sol-Modellen.
Preise
| Stufe (pro 1 Mio. Tokens) | Input | Output | Gecachter Input |
|---|---|---|---|
| Standard, bis 30. Nov. 2026 | $2.00 | $10.00 | $0.10 |
| Standard, ab 1. Dez. 2026 | $4.00 | $20.00 | $0.20 |
| Batch oder Flex, bis 30. Nov. | $1.00 | $5.00 | $0.05 |
| Priority, bis 30. Nov. | $3.60 | $18.00 | $0.18 |
Search Grounding sind 5.000 kostenlose Anfragen pro Monat, danach $14 pro 1.000, laut Googles Preisseite. Für Argon gibt es keine kostenlose Stufe. Mein Beitrag zu den Gemini 4 Argon Preisen geht den Preisschritt im Dezember durch.
Mein Fazit: Starten Sie hier, wenn Sie etwas bauen, das Kunden antwortet. Planen Sie die Verdopplung des Preises am 1. Dezember ein, und wenn es Ihnen vor allem um Tempo und Kosten geht, schauen Sie stattdessen auf Sol. Weitere Optionen habe ich in meiner Übersicht zu Gemini 4 Argon Alternativen behandelt.
2. GPT-6.1 Sol
Am besten für: Teams, die Carbons Intelligenz wollten, aber auf die Rechnung achten.
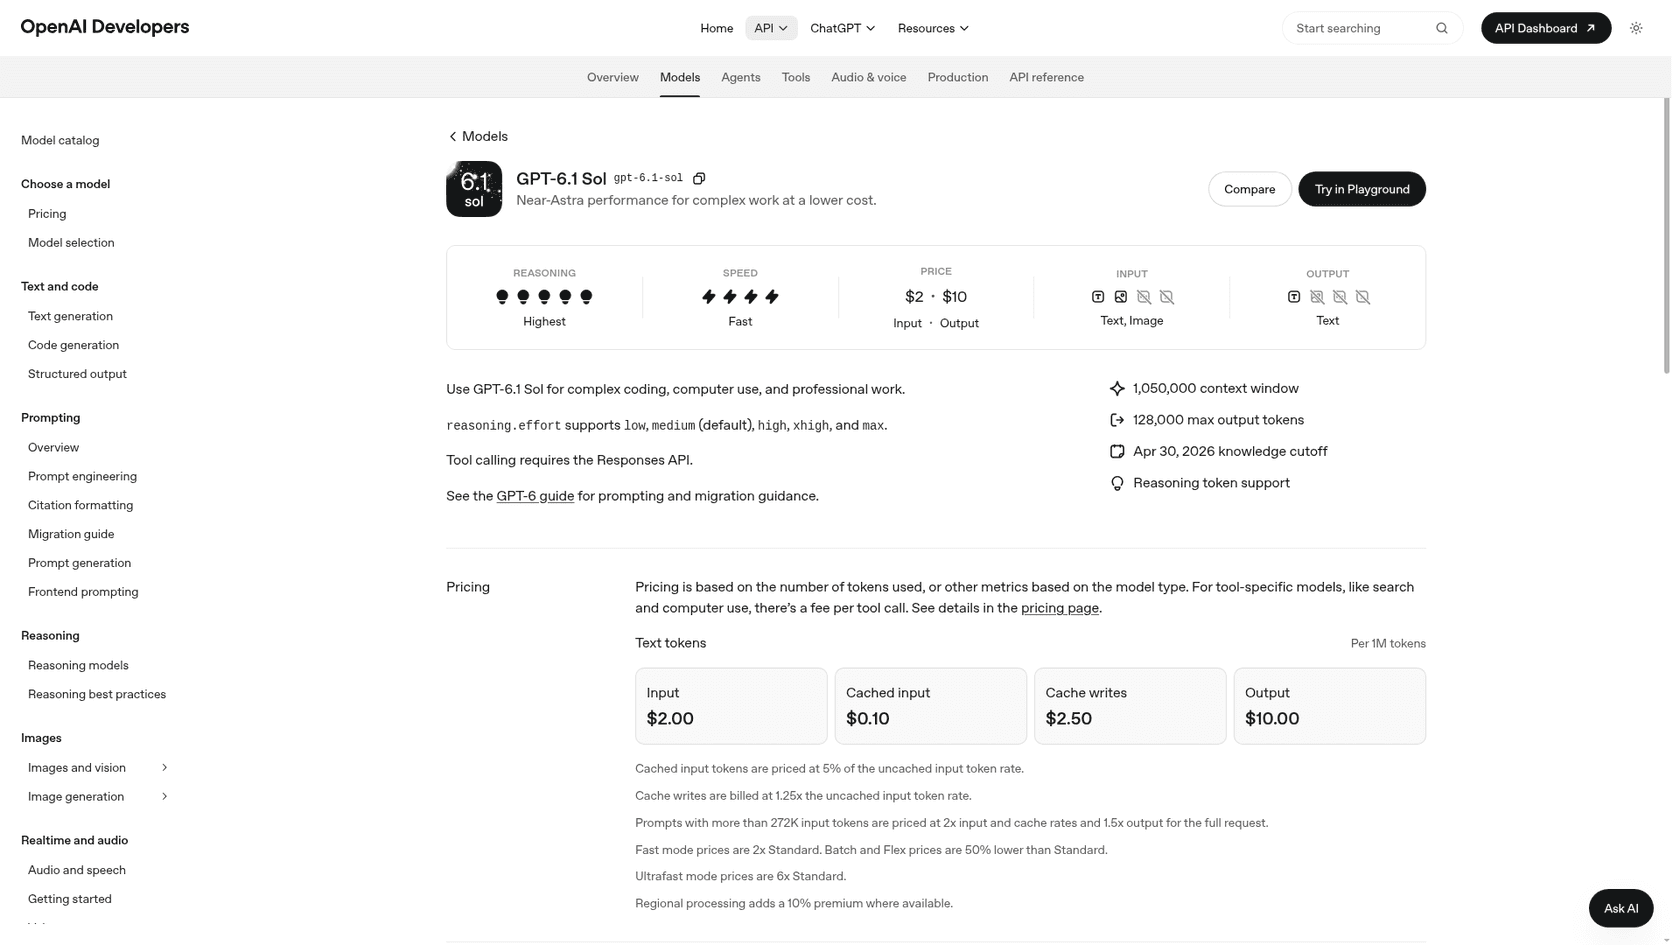
Sol war ChatGPTs erster Vorschlag für einen Support-Agenten, und die Zahlen stützen das. OpenAIs Modellseite nennt es "Near-Astra performance for complex work at a lower cost", mit einem Kontextfenster von 1.050.000 Tokens und Reasoning-Aufwand von low bis max.
Bei maximalem Aufwand erreicht Sol im Artificial Analysis Index 54,5 Punkte bei $1,27 pro Aufgabe, gegenüber $7,76 bei Carbon. Das sind 92% von Carbons Score bei 16% der Kosten. Bei xhigh sind es 52,3 für $0,76 und bei medium 46,1 für $0,36, die Einstellung, mit der ich einen Support-Agenten starten würde.
Vorteile
- Bester Score pro Dollar von allem in dieser Liste.
- Fünf Aufwandsstufen, ein Modell kann also günstige und schwierige Tickets abdecken.
- Batch-Preise halbieren die Rechnung auf $1/$5 für alles, was warten kann.
Nachteile
- Erfand bei AA-Omniscience mit maximalem Aufwand in 52% der Fälle Antworten. Es muss in Ihren eigenen Inhalten verankert werden.
- Tool Calling erfordert die Responses API, älterer Chat-Completions-Code braucht also eine Migration.
- Prompts über 272K Input-Tokens werden mit 2x Input und 1,5x Output berechnet.
Preise
| Modus (pro 1 Mio. Tokens) | Input | Output | Gecachter Input |
|---|---|---|---|
| Standard | $2.00 | $10.00 | $0.10 |
| Batch / Flex | $1.00 | $5.00 | $0.05 |
| Fast | $4.00 | $20.00 | $0.20 |
| Ultrafast | $12.00 | $60.00 | $0.60 |
Die Preise stammen von OpenAIs Preisseite. Mein Leitfaden zu den GPT-6.1 Sol Preisen enthält durchgerechnete Beispiele.
Mein Fazit: die Standardwahl, wenn Sie keinen Grund haben, bei Google zu bleiben. Lassen Sie es nur Kunden nicht aus dem Gedächtnis antworten. Mein GPT-6.1 Sol Test behandelt, wo es ausrutscht.
3. Claude Opus 5.5
Am besten für: Teams, die das Nächstliegende an Carbons Score wollen und dafür zahlen.
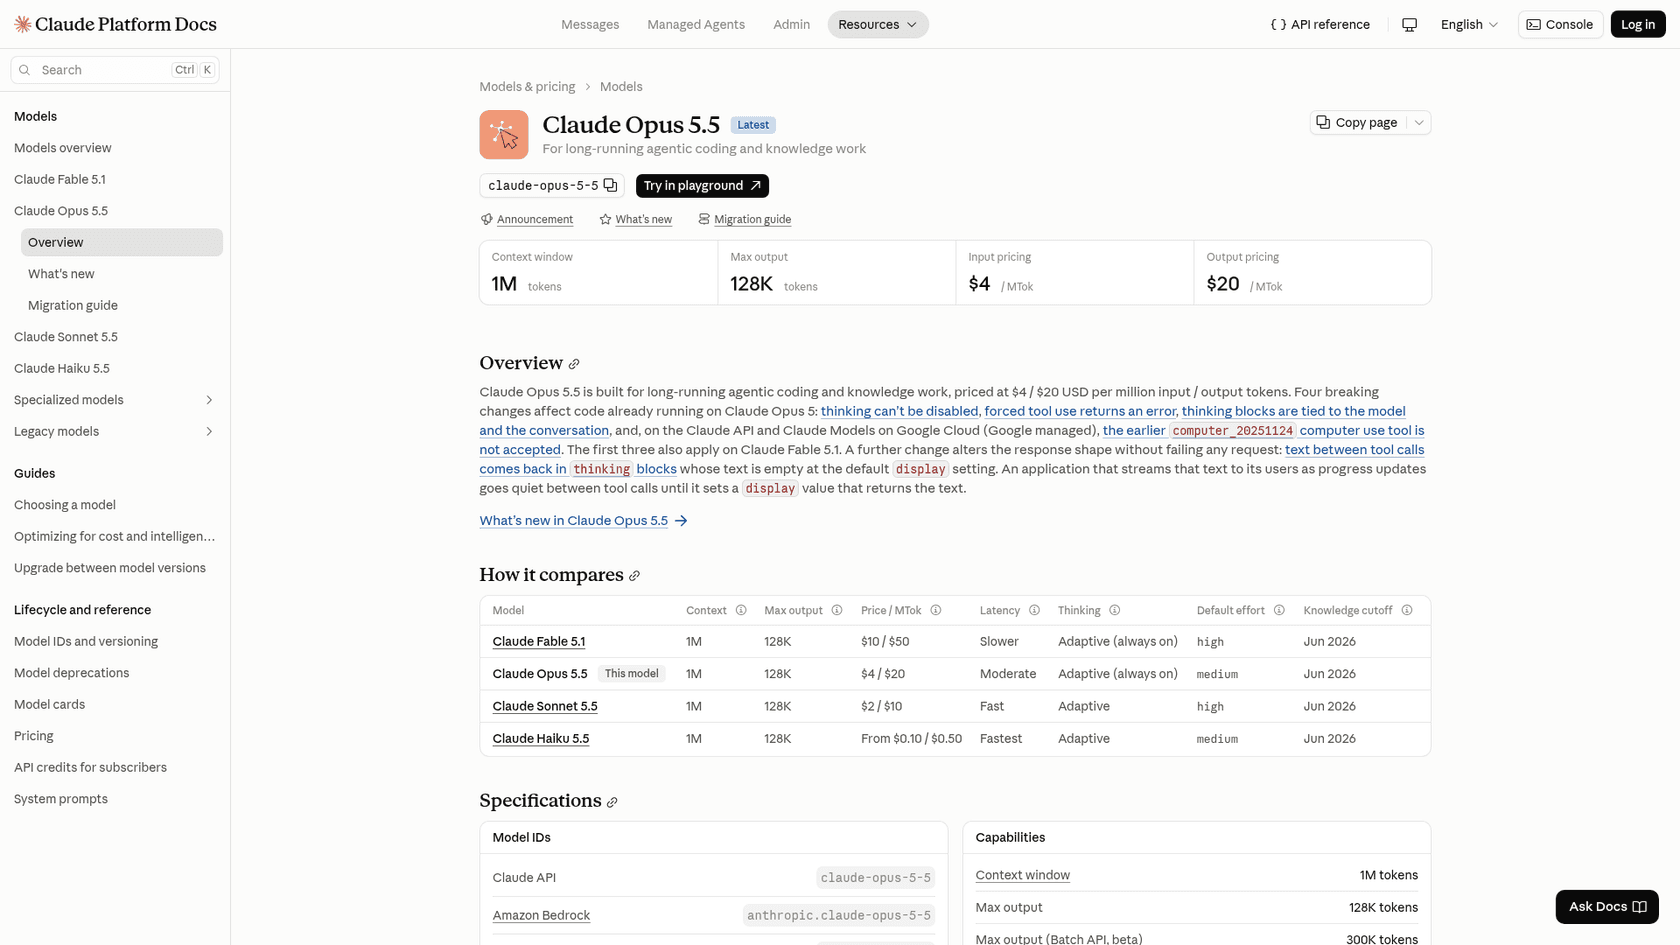
Opus 5.5 ist das Modell, das Carbon nur knapp geschlagen hat. Bei Artificial Analysis erreicht es mit maximalem Aufwand 58,4, einen Punkt hinter Carbons 59,4, und in Googles eigener Tabelle führt es bei der Computernutzung OSWorld-2.1 immer noch mit 87,2% gegenüber 81,5% bei Carbon. Anthropic positioniert es für "long-running agentic coding and knowledge work".
Der Haken ist finanziell die Rechnung. Bei maximalem Aufwand kostete eine AA-Aufgabe $10,04, am meisten in dieser Liste. Xhigh ist der bessere Kompromiss: 57,0 für $6,05, was Carbon bei den Kosten pro Aufgabe immer noch schlägt. Anthropic merkt außerdem an, dass Opus 5.5 gegenüber Opus 5 einiges API-Verhalten geändert hat (Thinking lässt sich nicht deaktivieren, erzwungene Tool-Nutzung gibt einen Fehler zurück), prüfen Sie also vor dem Umstieg den Migrationsleitfaden.
"I've found its worse in most tasks, especially when ranked on a cost-per-task metric."
Diese Antwort bezog sich auf Claude Fable 5.1 im Vergleich zu Opus 5.5 und fasst treffend zusammen, warum hier Opus und nicht Fable die Anthropic-Wahl ist.
Vorteile
- Der nächste kaufbare Wert zu Carbons reinem Score.
- Prompt-Cache-Treffer kosten 5% des Inputs ($0,20 pro Million), günstiger als die üblichen 10%.
- Auch für Anthropics Cyber Verification Program zugelassen, falls Sicherheit Teil der Aufgabe ist.
Nachteile
- Höchste Kosten pro Aufgabe bei maximalem Aufwand ($10,04).
- Erfand bei AA-Omniscience mit maximalem Aufwand in 50% der Fälle Antworten.
- Der Fast-Modus kostet $8/$40, das Doppelte des Standards.
Preise
| Modus (pro 1 Mio. Tokens) | Input | Output | Cache-Lesen |
|---|---|---|---|
| Standard | $4.00 | $20.00 | $0.20 |
| Batch | $2.00 | $10.00 | n/a |
| Fast-Modus | $8.00 | $40.00 | n/a |
Aus Anthropics Preisdokumentation. Mehr Details in meinem Beitrag zu den Claude Opus 5.5 Preisen.
Mein Fazit: Wählen Sie Opus 5.5 bei xhigh, wenn die Arbeit schwer und lang ist, etwa agentisches Coding oder tiefe Recherche. Für eine Support-Warteschlange ist es mehr Modell, als die meisten Tickets brauchen. Mein Claude Opus 5.5 Test hat die Details.
4. Claude Sonnet 5.5
Am besten für: kundennahes Schreiben und Tool-Nutzung, bei denen der Ton zählt.
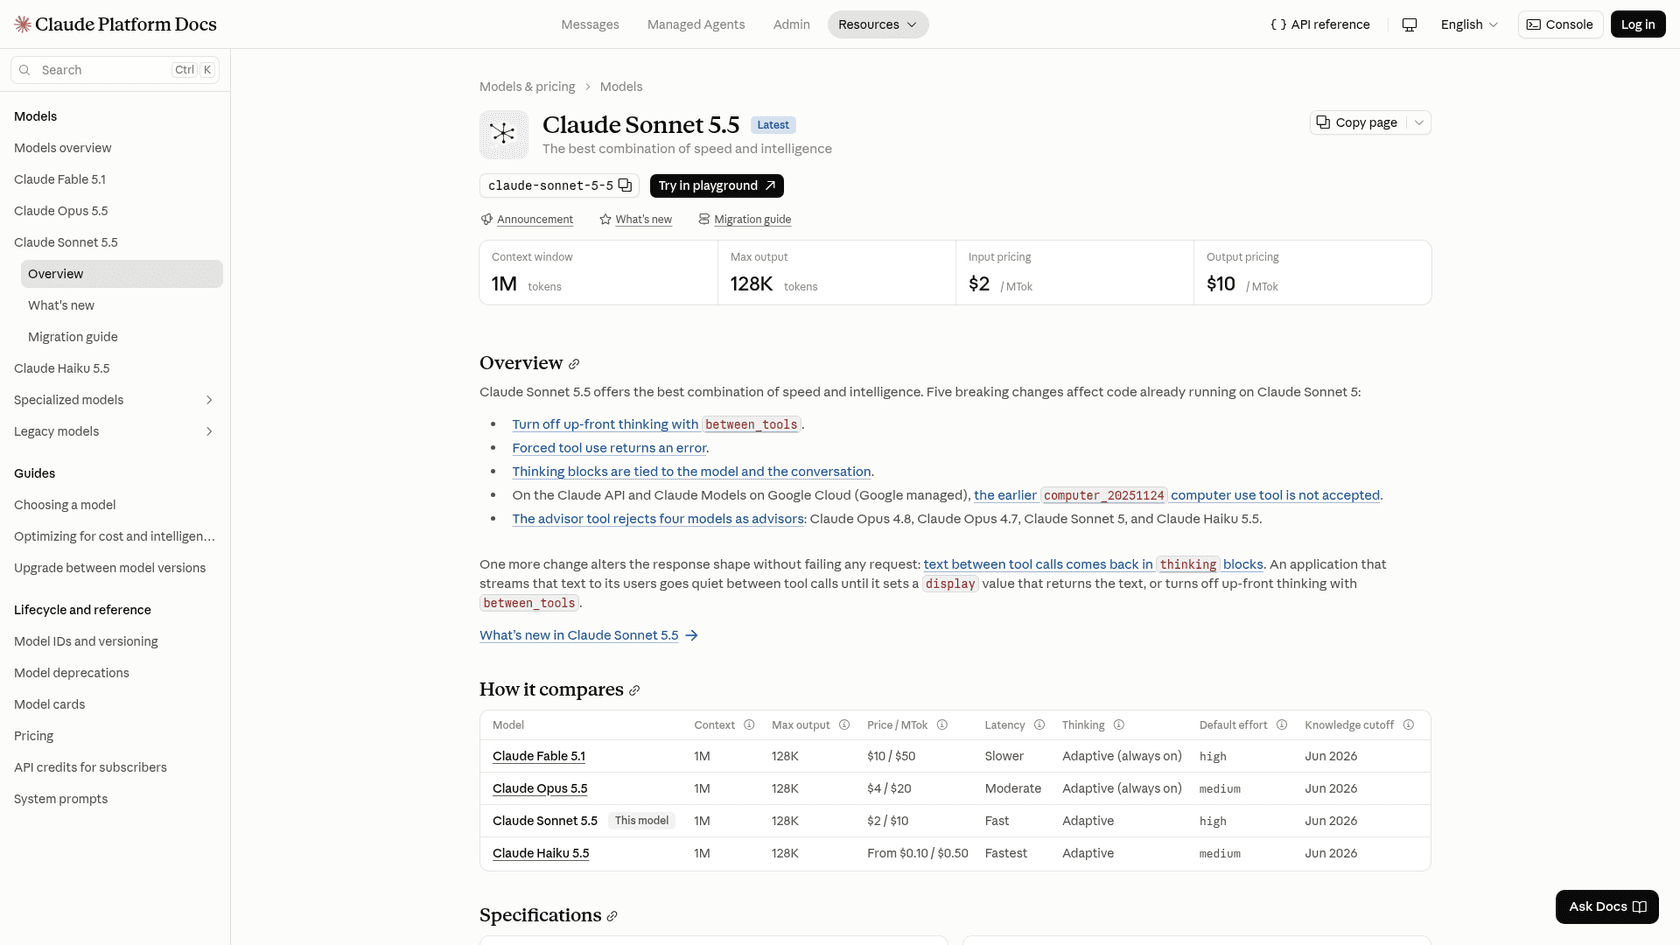
Sonnet 5.5 ist das dritte Modell, das ChatGPT vorgeschlagen hat, für "nuanced, high-quality customer conversations". Anthropic nennt es "the best combination of speed and intelligence" in seiner Palette, zum gleichen Preis von $2/$10 wie Carbons Einführungspreis.
Die Scores hängen stark vom Aufwand ab. Bei max erreicht Sonnet bei Artificial Analysis 54,2, nahe an Sol, aber dieser Durchlauf kostete $10,02 pro Aufgabe. Bei high Aufwand fällt es auf 41,1 für $1,64. Seine Halluzinationsrate ist bei maximalem Aufwand die beste der hier gelisteten Frontier-Modelle von Anthropic und OpenAI (43%), und sein AutomationBench-Wert bei max (71,8%) liegt nur hinter den beiden Gemini-4-Modellen und Kimi.
Vorteile
- Anthropics mittleres Modell: schneller als Opus 5.5 bei halbem Token-Preis.
- Cache-Treffer für $0,10 pro Million, 5% des Inputs.
- Gleiche API und Tools wie Opus, Sie können also zwischen ihnen routen.
Nachteile
- Max-Aufwand kostet pro Aufgabe so viel wie Opus 5.5.
- Der Score-Abfall von max auf high Aufwand ist steil (54,2 auf 41,1).
- Keine offenen Gewichte, kein Self-Hosting.
Preise
| Modus (pro 1 Mio. Tokens) | Input | Output | Cache-Lesen |
|---|---|---|---|
| Standard | $2.00 | $10.00 | $0.10 |
| Batch | $1.00 | $5.00 | n/a |
Aus Anthropics Preisdokumentation. Mein Leitfaden zu den Claude Sonnet 5.5 Preisen schlüsselt die Aufwandskosten auf.
Mein Fazit: eine starke Standardwahl für Support-Antworten, mit mittlerem oder hohem Aufwand und Grounding betrieben. Verzichten Sie auf max Aufwand, außer die Aufgabe ist schwer. Mehr in meinem Claude Sonnet 5.5 Test.
5. Kimi K3.1 Pro
Am besten für: lange Tickets, lange Dokumente und mehrstufige Tool-Arbeit zu einer Frontier-Preisliste.
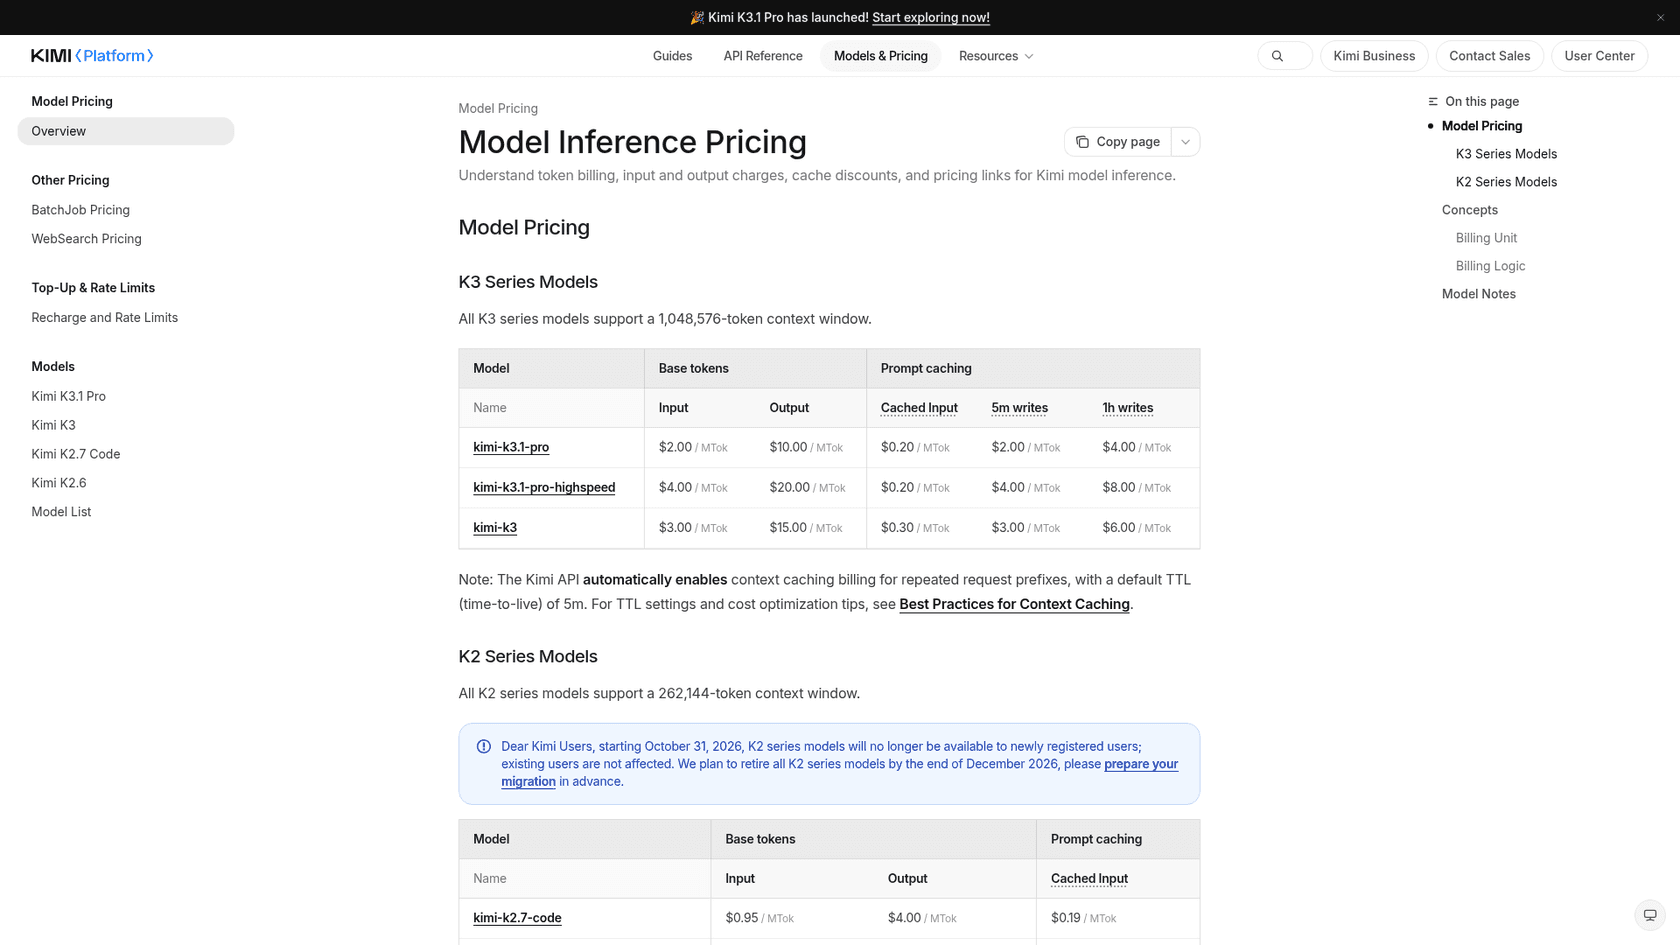
Kimi K3.1 Pro von Moonshot ist so etwas wie der Stille in dieser Liste. Es erreicht im Artificial Analysis Index 46,0, unter den anderen, liefert aber das beste Long-Context-Reasoning-Ergebnis in meinem Vergleich (86,3% beim Long-Context-Test von AA, gegenüber 79,3% bei Carbon) und 73,3% bei AutomationBench. Seine Halluzinationsrate von 37% ist die niedrigste außerhalb der Gemini-4-Familie.
Es kostet $3,68 pro AA-Aufgabe, die Hälfte von Carbon, und ist mit etwa 36 Output-Tokens pro Sekunde das langsamste Modell hier. Für einen Support-Agenten, der Antworten im Hintergrund entwirft, ist dieses Tempo in Ordnung, für Live-Chat nicht.
Vorteile
- Bester Long-Context-Wert der Gruppe.
- Zweitniedrigste Rate erfundener Antworten unter den kaufbaren Modellen.
- Gleiche Preisliste von $2/$10 wie Carbons Einführungspreis.
Nachteile
- Langsamer Output, daher keine Wahl für Live-Chat.
- Niedrigerer Spitzen-Score als die US-Frontier-Modelle.
- Offene Gewichte sind noch nicht verfügbar, es ist also vorerst nur per API nutzbar.
Preise
| Modell (pro 1 Mio. Tokens) | Input | Output | Gecachter Input |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
Von der Kimi Platform Preisseite. Mein Beitrag zu den Kimi K3.1 Pro Preisen enthält die Rechnung pro Aufgabe.
Mein Fazit: einen Test wert, wenn Ihre Tickets lang und unordentlich sind oder Ihr Agent große Dokumente liest. Nutzen Sie die Highspeed-Stufe, wenn Latenz zählt. Mehr in meinem Kimi K3.1 Pro Test.
6. DeepSeek V4.1 Flash
Am besten für: Teams, die offene Gewichte, Self-Hosting oder die niedrigste Rechnung pro Token brauchen.
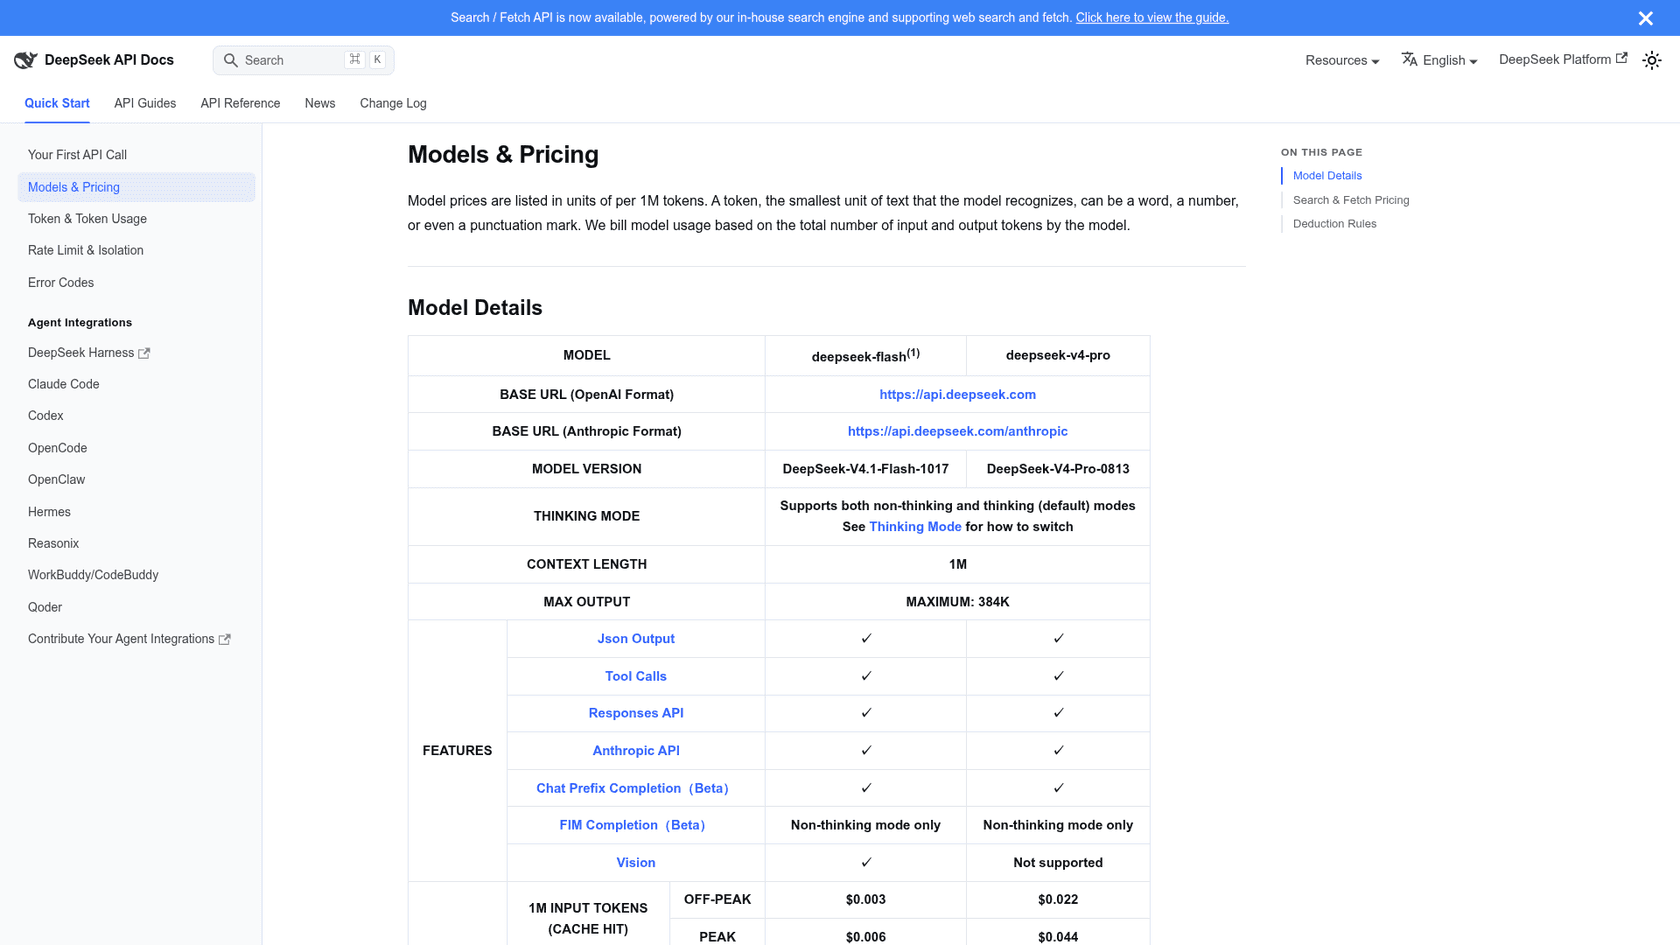
DeepSeek V4.1 Flash ist das einzige Modell in dieser Liste mit offenen Gewichten, was wichtig ist, wenn Ihre Daten Ihre eigenen Server nicht verlassen dürfen. Per API läuft es zu $0,15 Input und $0,60 Output in den Nebenzeiten, wobei die Spitzenzeiten (werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC) das Doppelte kosten, laut DeepSeeks Preisseite.
Es erreicht im Artificial Analysis Index mit maximalem Aufwand 32,5 bei $0,60 pro Aufgabe, und seine Halluzinationsrate liegt bei 64%. Es ist ein fähiges, günstiges Arbeitstier, kein Modell der Carbon-Klasse, und braucht klare Führung.
"I use DeepSeek too but it's more of a workhorse model, requires a lot more guiding and sometimes struggles to get where I want it."
Vorteile
- Offene Gewichte, Sie können es selbst hosten.
- Günstigste API-Rechnung hier nahe am Frontier, mit Cache-Treffern für $0,003 pro Million in den Nebenzeiten.
- 1M Kontext, 384K maximaler Output, Tool Calls und Vision.
Nachteile
- Deutlich niedrigerer Score als Carbon (32,5 vs. 59,4).
- 64% Rate erfundener Antworten, es muss also verankert werden.
- Spitzenzeit-Preise verdoppeln die Kosten an Werktagsmorgen in Asien und Europa.
Preise
| Pro 1 Mio. Tokens | Nebenzeit | Spitzenzeit |
|---|---|---|
| Input, Cache-Treffer | $0.003 | $0.006 |
| Input, Cache-Fehlschlag | $0.15 | $0.30 |
| Output | $0.60 | $1.20 |
DeepSeeks Search und Fetch APIs kosten $0,75 pro 1.000 Anfragen, wobei die Abrechnung serverseitiger Tool-Calls am 1. November 2026 beginnt. Mein Beitrag zu den DeepSeek V4.1 Flash Preisen behandelt den Spitzenzeit-Plan.
Mein Fazit: wählen Sie es, wenn Self-Hosting oder Kosten pro Token die Bedingung sind. Wählen Sie es nicht als Carbon-Ersatz bei der Qualität. Siehe meinen DeepSeek V4.1 Flash Test.
7. GPT-6 Luna
Am besten für: ein günstiges Erstdurchlauf-Modell, das einfache Tickets sortiert und beantwortet, bevor ein stärkeres Modell den Rest sieht.
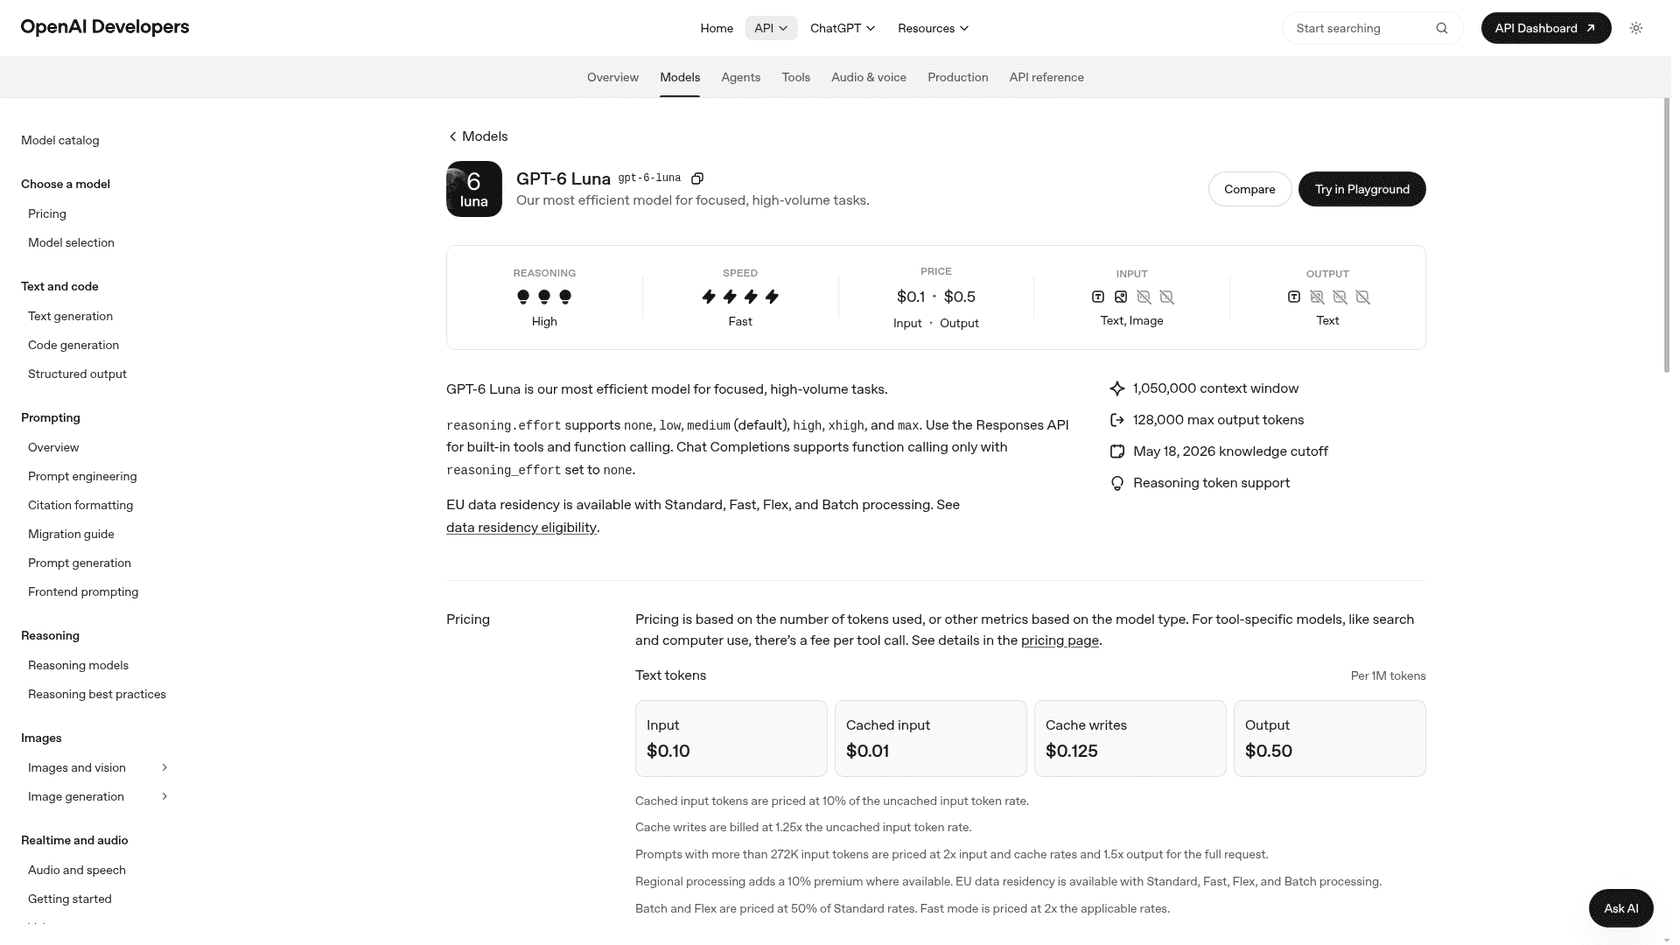
Luna ist ChatGPTs vierter Vorschlag, für "high-volume, repetitive requests". OpenAI nennt es sein "most efficient model for focused, high-volume tasks", und mit $0,10 Input und $0,50 Output pro Million Tokens ist es 20-mal günstiger als Carbons Einführungspreis.
Allein ist es kein Carbon-Ersatz. Luna erreicht im Artificial Analysis Index mit maximalem Aufwand 27,8 bei $0,15 pro Aufgabe und erfand bei AA-Omniscience in 79% der Fälle Antworten. Seine Aufgabe ist die Triage: das Ticket taggen, die Frage zum Bestellstatus aus Ihren Daten beantworten und alles andere weiterreichen.
Vorteile
- Günstigstes pro Aufgabe in dieser Liste.
- Schnell, mit einem Fenster von 1.050.000 Tokens.
- Gleiche API wie Sol, das Routing zwischen beiden ist also einfach.
Nachteile
- Höchste Rate erfundener Antworten hier (79% bei maximalem Aufwand).
- Nicht geeignet für alles, was Urteilsvermögen erfordert.
- Nur Text-Output.
Preise
| Modus (pro 1 Mio. Tokens) | Input | Output | Gecachter Input |
|---|---|---|---|
| Standard | $0.10 | $0.50 | $0.01 |
| Batch / Flex | $0.05 | $0.25 | $0.005 |
| Fast | $0.20 | $1.00 | $0.02 |
Von OpenAIs Preisseite. Wenn Sie ein günstiges Triage-Modell mit weniger erfundenen Antworten wollen: Claude Haiku 5.5 kostet für Prompts bis 100K Tokens dasselbe $0,10/$0,50 und erreichte bei maximalem Aufwand eine Halluzinationsrate von 34%.
Mein Fazit: nutzen Sie Luna (oder Haiku 5.5) als günstige erste Schicht, nie als einziges Modell. Mehr in meiner Aufschlüsselung der GPT-6 Luna Preise.
Was, wenn Sie Carbon für echte Sicherheitsarbeit brauchten?
Dann geben Sie sich nicht mit einem allgemeinen Modell zufrieden, sondern bewerben Sie sich für ein beschränktes Programm, denn allgemeine Modelle blockieren absichtlich einen Teil der Cyber-Arbeit. Es gibt drei Wege:
| Weg | Modell, das Sie bekommen | Wie Sie hineinkommen | Kosten |
|---|---|---|---|
| Google Fairwind | Gemini 4 Carbon | Interessenformular, Hintergrundprüfung, bisher 650+ Partner | Carbons $2/$10 Einführung, dann $4/$20 |
| OpenAI Daybreak | GPT-5.6-Cyber und Daybreak-Zugangsstufen | Bewerbung; OpenAI bietet $1 Milliarde an Daybreak-Credits für Verteidiger an | $12.50 / $75 pro 1 Mio. für gpt-5.6-cyber laut OpenAIs Preisliste |
| Anthropic Cyber Verification Program | Claude Opus 5.5, Sonnet 5.5 und Mythos 5.1 mit weniger Cyber-Blockaden | Eine Bewerbung pro Organisation; Entscheidung innerhalb von sieben Werktagen | Standard-Preise der Claude API |
Anthropics Programm ist von den dreien am leichtesten zugänglich. Sein Update vom Oktober 2026 fügte drei Zugangsstufen hinzu und nennt Opus 5.5 sein "most capable cyber model yet". Unabhängige Forscher, Maintainer und Bug-Bounty-Jäger können sich als Einzelpersonen bewerben, erhalten vorerst aber nur die Defense-Stufe. Mein Beitrag zu den GPT-5.6-Cyber Alternativen vergleicht diese Programme ausführlicher.
Nicht jeder mag die Zugangsbeschränkung:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Für Routineaufgaben der Sicherheit brauchen Sie womöglich gar kein Programm. Anthropic sagt, seine allgemein verfügbaren Modelle ließen sich weiterhin für sicheres Code-Review, Threat Modeling, das Patchen bekannter Probleme und die Triage von Sicherheitswarnungen nutzen.
Welche Gemini 4 Carbon Alternative sollten Sie wählen?
Gehen Sie davon aus, wofür Sie Carbon wollten. Die Karte unten zeigt, wie ich die Entscheidung routen würde.
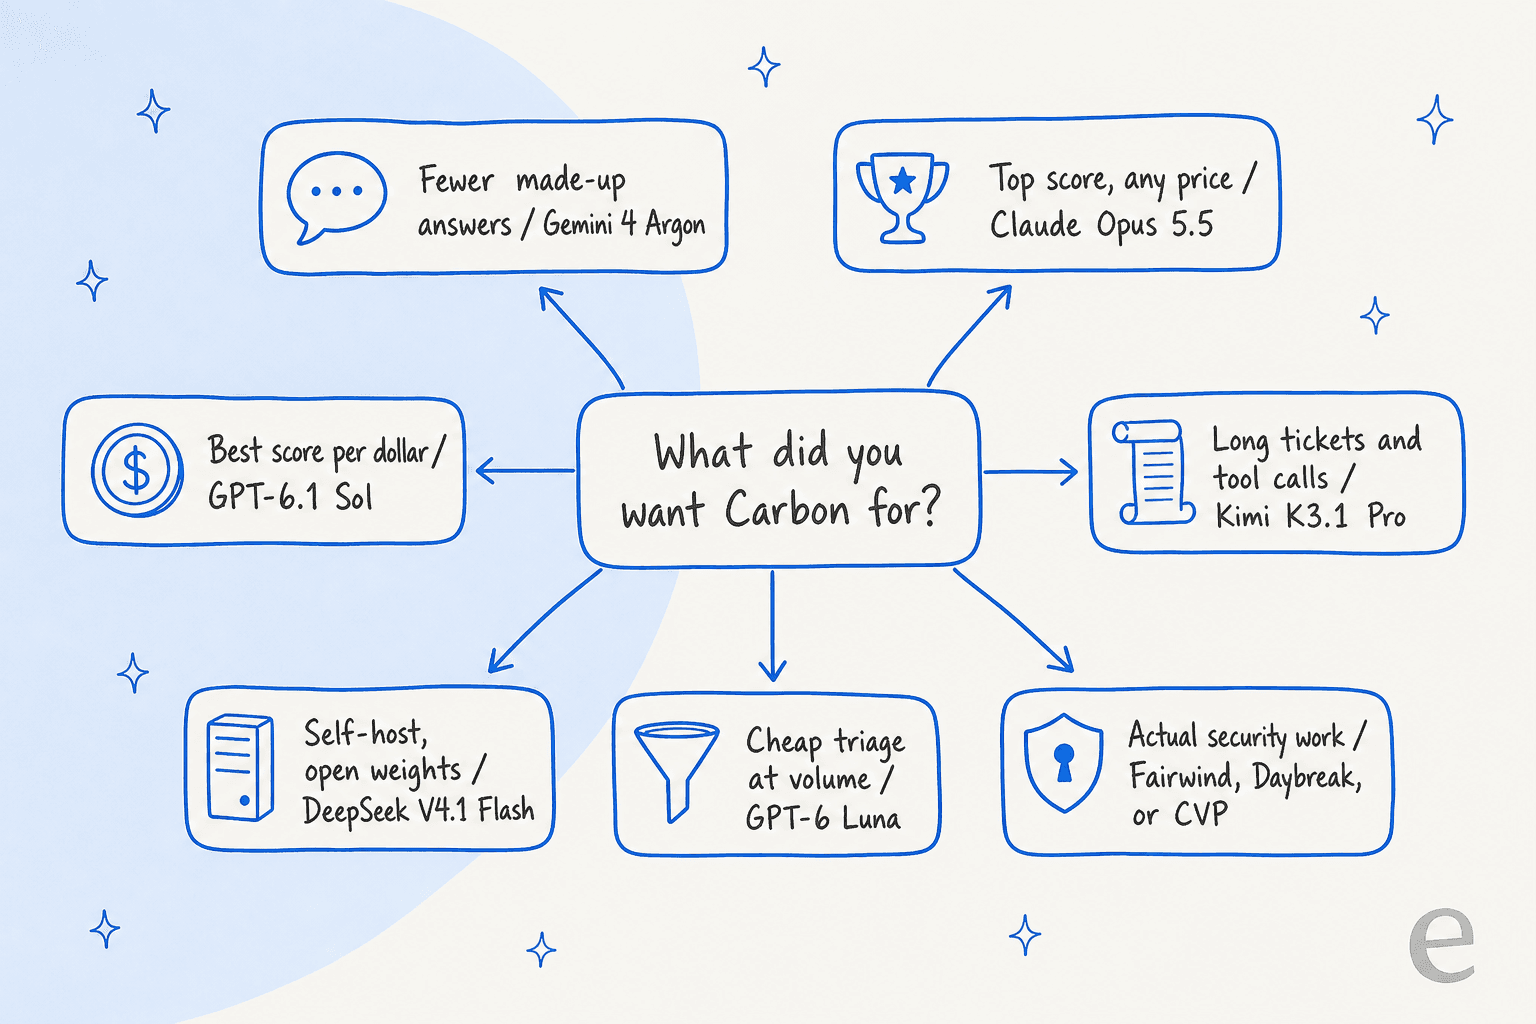
Für die meisten Leser ist die ehrliche Antwort ein Modellpaar, nicht ein einzelnes Modell. ChatGPTs Zwei-Modelle-Vorschlag stimmt: Ein günstiges Modell wie Luna oder Haiku 5.5 übernimmt die einfache Arbeit mit hohem Volumen, und ein stärkeres (Argon, Sol oder Sonnet 5.5) die schwierigen Fälle. Da fünf dieser Modelle pro Token gleich viel kosten, läuft die Wahl des stärkeren Modells auf Kosten pro Aufgabe und Rate erfundener Antworten hinaus, nicht auf die Preisliste.
Und eines sei hier klar gesagt: Der Abstand zwischen Carbon und Argon in einer Support-Warteschlange ist kleiner als der Abstand zwischen einem verankerten und einem nicht verankerten Agenten. Alle diese Modelle erfinden Antworten, wenn man sie etwas fragt, das Ihre Dokumentation nicht abdeckt. Die Lösung ist die Schicht um das Modell, und genau daran arbeite ich.
Wie wirkt sich diese Wahl in einem echten Support-Agenten aus?
In eesel ist das Modell nur eine Einstellung. Die Arbeit, die entscheidet, ob Kunden richtige Antworten bekommen, ist das, was das KI-Teammitglied liest und was es tun darf. Wenn ein Team sein Helpdesk verbindet, lernt der Agent aus früheren Tickets, Help Center und internen Dokumenten, folgt schriftlichen Regeln dazu, was an eine Person übergeben wird, und wird an historischen Tickets simuliert, bevor er jemandem live antwortet.
Zwei Kunden auf Freshdesk zeigen, wie das aussieht. Qontro, ein ERP-Softwareunternehmen, erhält bei jedem Freshdesk-Ticket einen Antwortentwurf mit bereits verlinkten Hilfeartikeln, entwarf in einem Monat 190 Tickets und antwortet auf Basis von 9.800 früheren Tickets und Hilfeartikeln. SamCart betreibt einen Agenten pro Kanal, einen für Freshdesk-Tickets und einen für den Website-Chat, mit einem Plan für 8.000 Interaktionen pro Monat.
Keiner von beiden brauchte ein Frontier-Sicherheitsmodell. Sie brauchten einen Agenten, der "ich hole jemanden" sagt, statt zu raten. Wenn Sie Modelle für eine Support-Warteschlange abwägen, geht mein Leitfaden zum besten Support-Ticket-Modell tiefer auf diesen Zielkonflikt ein, ebenso der Beitrag zu LLMs für den Kundensupport.
eesel testen
Wenn Sie hier sind, weil Sie Carbon in einem Support-Agenten wollten, ist eesel der kürzere Weg. Es ist ein KI-Helpdesk-Teammitglied, das sich in Freshdesk, Zendesk und andere Helpdesks einklinkt, aus Ihren früheren Tickets und Ihrem Help Center lernt und an Ihrem eigenen Ticketverlauf getestet wird, bevor es einem Kunden antwortet. Sie bekommen die Modellwahl abgenommen und das Grounding, das jedes dieser Modelle davon abhält, Dinge zu erfinden.
Die Tarife finden Sie auf der eesel Preisseite, oder testen Sie eesel kostenlos an Ihren eigenen Tickets.