Warum Sie jetzt eine Argon-Alternative brauchen
Ich verbringe bei eesel viel Zeit damit, mir anzusehen, wonach Leute tatsächlich suchen, und „Gemini 4 Argon Alternativen" ist diese Woche im Grunde eine einzige Frage: Was kann ich stattdessen heute nutzen? Das ist eine berechtigte und ziemlich dringende Frage. Google hat Argon am 30. September angekündigt und es am ersten Tag nur Cyber-Verteidigern in seinem Fairwind Program zugänglich gemacht. Google sagt, zahlende API-Kunden und Google-AI-Ultra-Abonnenten folgen als Nächste. Wann das passiert, hat Google noch nicht gesagt.
Ich habe vor dem Schreiben noch einmal nachgesehen, um sicherzugehen. Am 1. Oktober um 08:13 UTC lieferten gemini-4-argon und gemini-4-argon-preview beide 404 NOT_FOUND, und mein Schlüssel listete 61 Modelle, darunter kein Argon. Das neueste Pro-Modell in der Liste war gemini-3.1-pro-preview. Wenn Sie also dieses Monat ein Produkt ausliefern müssen, ist Argon noch keine Option, und die Sorge dieses Entwicklers vom Launch-Tag gilt weiterhin:
"Hopefully they sort out their infrastructure and model versioning so that we can feel confident building production applications on top of their APIs. The capacity limitations I've experienced with them in the past have been deeply problematic."

Fairerweise muss man Argon aber zugutehalten, dass es ein starkes Modell ist und manches davon schwer zu ersetzen ist. Auf Artificial Analysis erreicht es bei hohem Aufwand 52,6, ungefähr auf dem Niveau von GPT-6 Astra. Bei AutomationBench ist es mit 77,5 % die Nummer 1. Es ist das einzige Modell hier mit einem Ausgabelimit von 1 Mio. Tokens; GPT-6.1 Sol hört bei 128K auf und Gemini 3.1 Pro bei 65.536. Und es sagt weit öfter „Ich weiß es nicht" als alles andere, was Sie aufrufen können.
Was Argon am besten kann und was jeden Teil ersetzt
Eine gute Alternative ersetzt das, was Sie konkret wollten, nicht „Argon" als Ganzes. Ich habe am 1. Oktober um 08:14 UTC die Artificial-Analysis-Seiten für Argon und jedes Modell in diesem Beitrag abgerufen, daher stammen alle Scores, Kosten und Halluzinationsraten unten aus einem Index an einem einzigen Tag.
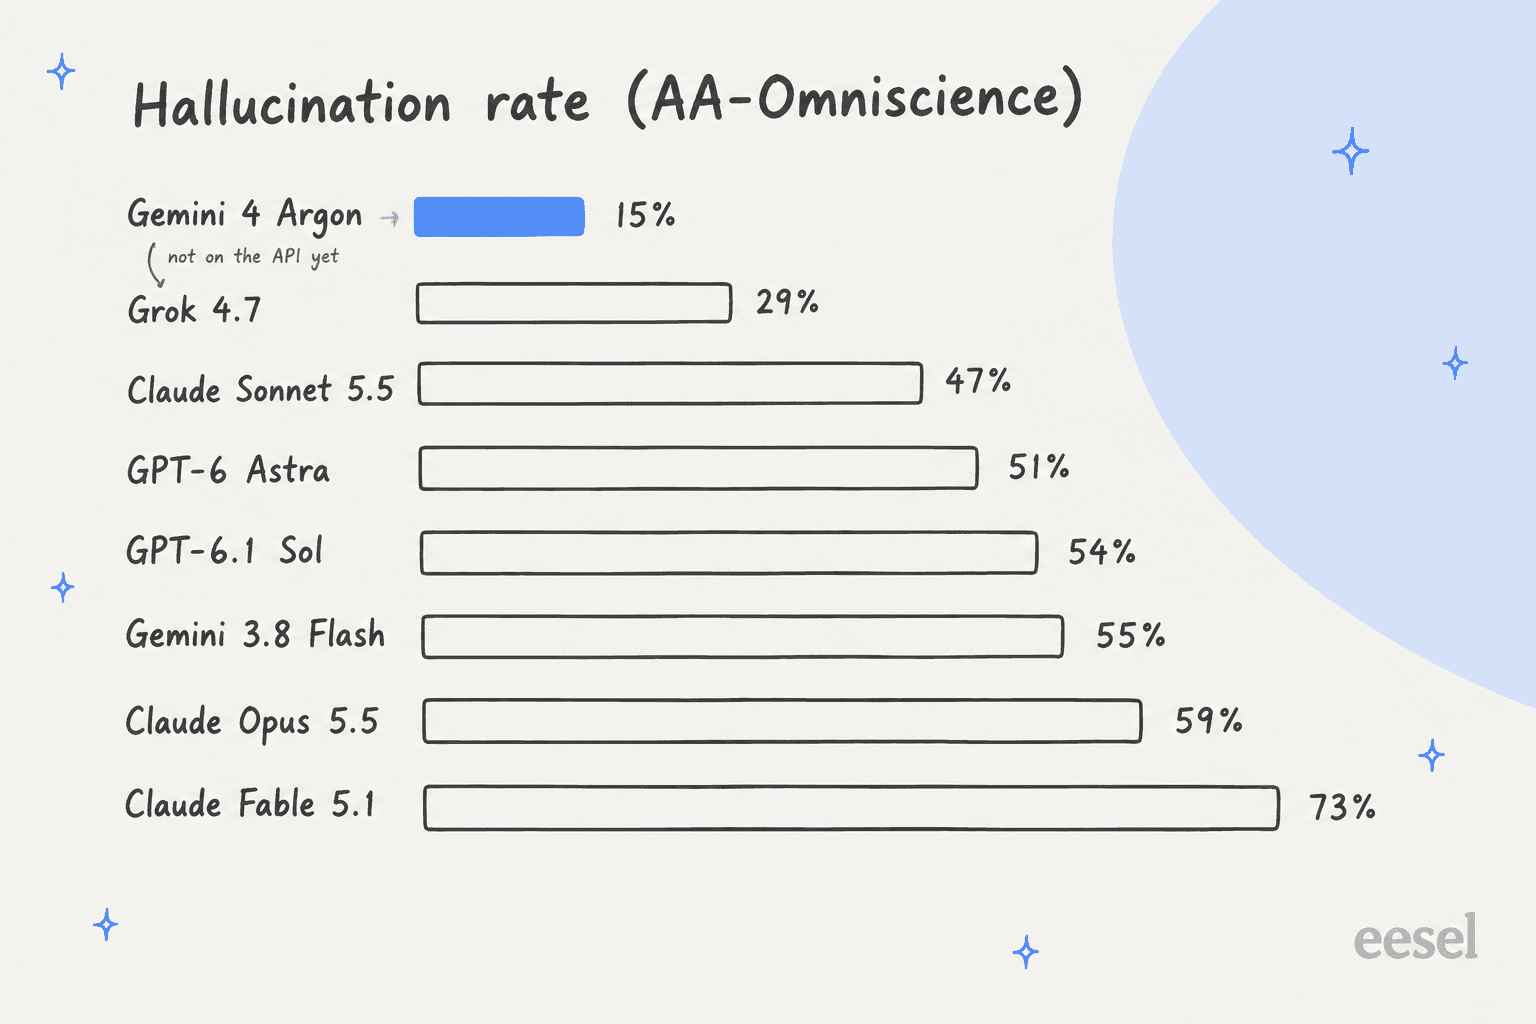
Die Halluzinationsrate bei AA-Omniscience ist der Anteil der Fragen, die ein Modell falsch beantwortet hat, indem es trotzdem antwortete, gemessen an allen, die es nicht richtig hatte. Deshalb können die Zahlen etwas merkwürdig aussehen. Claude Fable 5.1 hat die höchste Genauigkeit aller Modelle hier (67 %) und eine der höchsten Halluzinationsraten (73 %), denn wenn es etwas nicht weiß, rät es meistens. Argon ist das Gegenteil: 50 % Genauigkeit, aber es lehnt die meisten Fragen ab, die es nicht beantworten kann.
Auf 100 Fragen umgerechnet wird es klarer. Argon beantwortet etwa 50 richtig und etwa 8 falsch. GPT-6 Astra beantwortet etwa 63 richtig und etwa 19 falsch. Grok 4.7 beantwortet etwa 15 falsch, so nah an Argon wie kein verfügbares Modell, aber es hat auch weniger richtig (etwa 47).
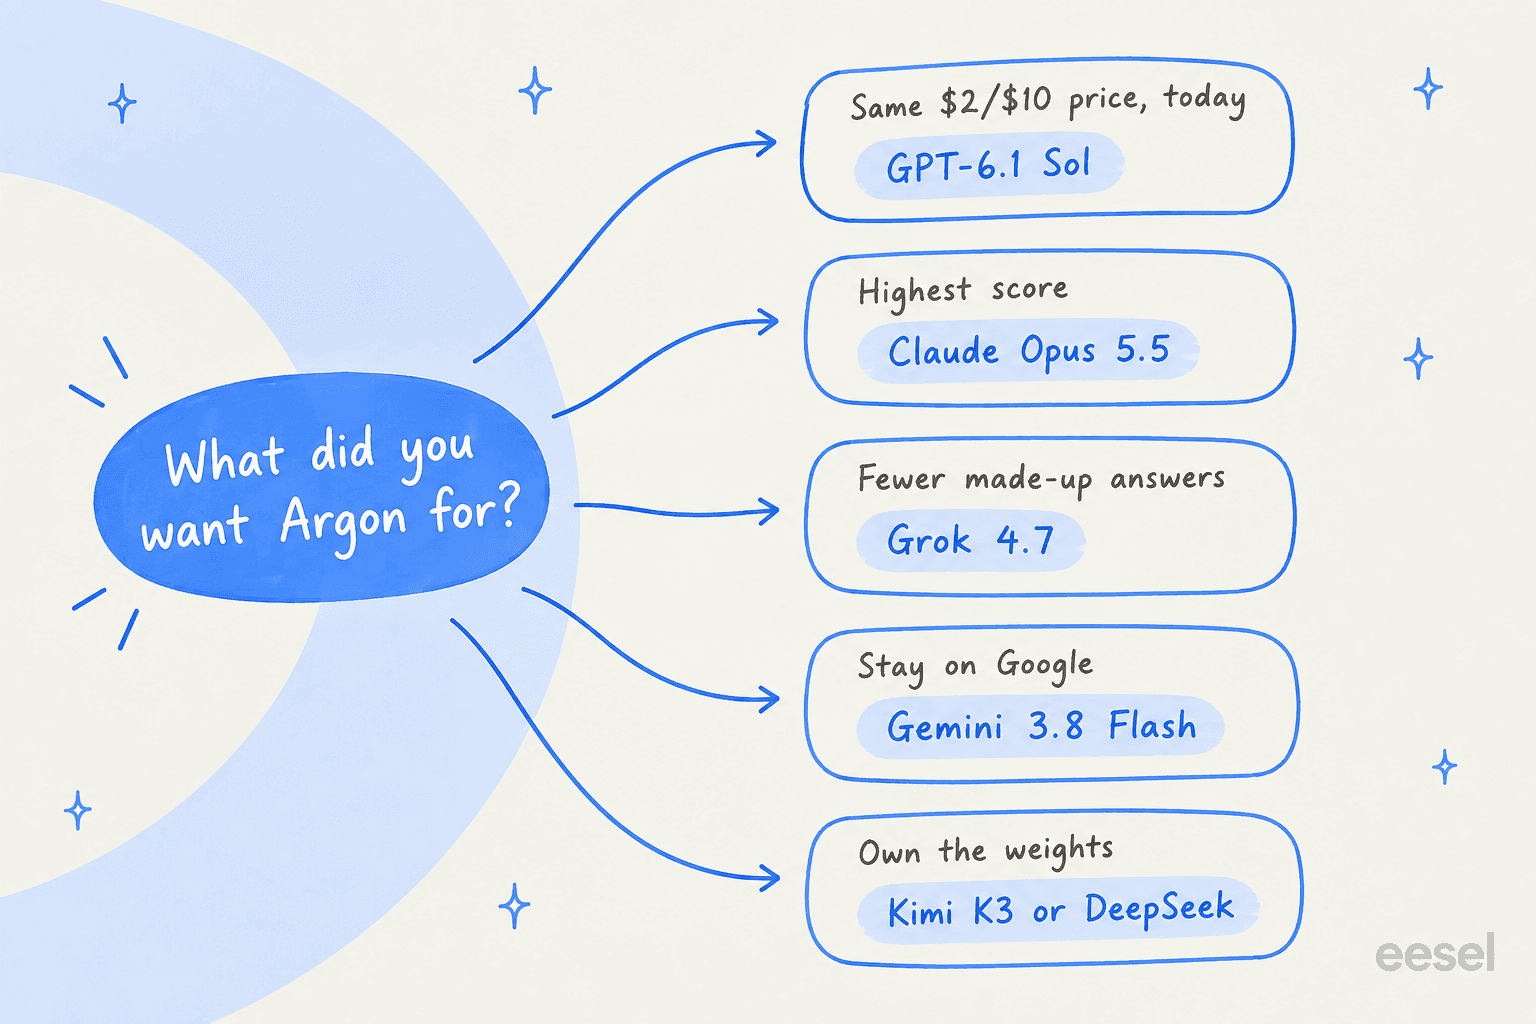
| Was Sie von Argon wollten | Argons Wert | Das Beste, was Sie heute aufrufen können |
|---|---|---|
| Ein hoher Score bei 2 $/10 $ | 52,6 für 1,99 $ pro Aufgabe | GPT-6.1 Sol: 51,8 für 0,72 $ |
| Der Top-Score, egal zu welchem Preis | 52,6 (Platz 8 im Index) | Claude Opus 5.5: 57,6 für 5,98 $ |
| Weniger erfundene Antworten | 15 % Halluzinationsrate | Grok 4.7: 29 % |
| Agenten-Workflows | 77,5 % AutomationBench | Claude Sonnet 5.5 max: 71,3 % |
| Lange Dokumente | 79,7 % Long-Context-Reasoning | Kimi K3: 88,7 % |
| Sehr lange Ausgaben | 1 Mio. Ausgabe-Tokens | Noch nichts, das mithalten kann |
| Bei Google bleiben | Nicht in der API | Gemini 3.8 Flash oder 3.1 Pro |
Die Zeile zum langen Kontext hat mich überrascht. Googles eigene Tabelle führt mit Argons GraphWalks-Score, aber im Long-Context-Reasoning-Test von Artificial Analysis erreicht jedes Modell dieser Liste außer Grok 4.7 einen höheren Wert als Argon. Kimi K3 führt mit 88,7 %.
Wie ich diese Alternativen ausgewählt und getestet habe
Jedes Modell in dieser Liste ist heute über eine öffentliche API verfügbar. Ich habe sie nach vier Kriterien ausgewählt: Preis von der jeweiligen Preisseite des Anbieters, Score und Kosten pro Aufgabe aus demselben Artificial-Analysis-Snapshot, Halluzinationsrate und wie gut jedes Modell den konkreten Grund abdeckt, warum Sie Argon wollten.
Dann habe ich meinen eigenen Test zu dem durchgeführt, wofür Argon bekannt ist. Ein Halluzinations-Benchmark stellt Trivia-Fragen ohne Nachschlagen. Ein Support-Bot arbeitet mit einem Help Center. Ich wollte also wissen, ob sich Argons Ehrlichkeitsvorsprung auch zeigt, wenn das Modell eine Wissensdatenbank vor sich hat.
Der Aufbau war eine kurze Rückerstattungs- und Versandrichtlinie für ein erfundenes SaaS-Unternehmen, die ich aus dem Testaufbau im GPT-6.1 Sol review wiederverwendet habe. Ich stellte 12 Fragen: 4, die die Richtlinie beantwortet, und 8 Fallen, die sie nicht beantwortet (PayPal, ein Uptime-SLA, Datenspeicherung in der EU, eine Telefonnummer, API-Ratenlimits, eine Salesforce-Integration, ein Black-Friday-Datum und HIPAA). Ich ließ fünf Modelle laufen, die ich direkt erreichen konnte (GPT-6.1 Sol, GPT-6 Astra, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.1 Pro Preview), in drei Modi, insgesamt 160 Aufrufe:
- Strict: „Antworte nur anhand der Richtlinie. Wenn etwas nicht abgedeckt ist, sage das und gib es an einen Menschen weiter."
- Loose: „Sei so hilfreich wie möglich", wobei die „nicht raten, eskalieren"-Zeile der Richtlinie bestehen blieb.
- Bare: „Sei so hilfreich wie möglich und gib Kunden eine direkte Antwort", wobei die „nicht raten"-Zeile gelöscht war.
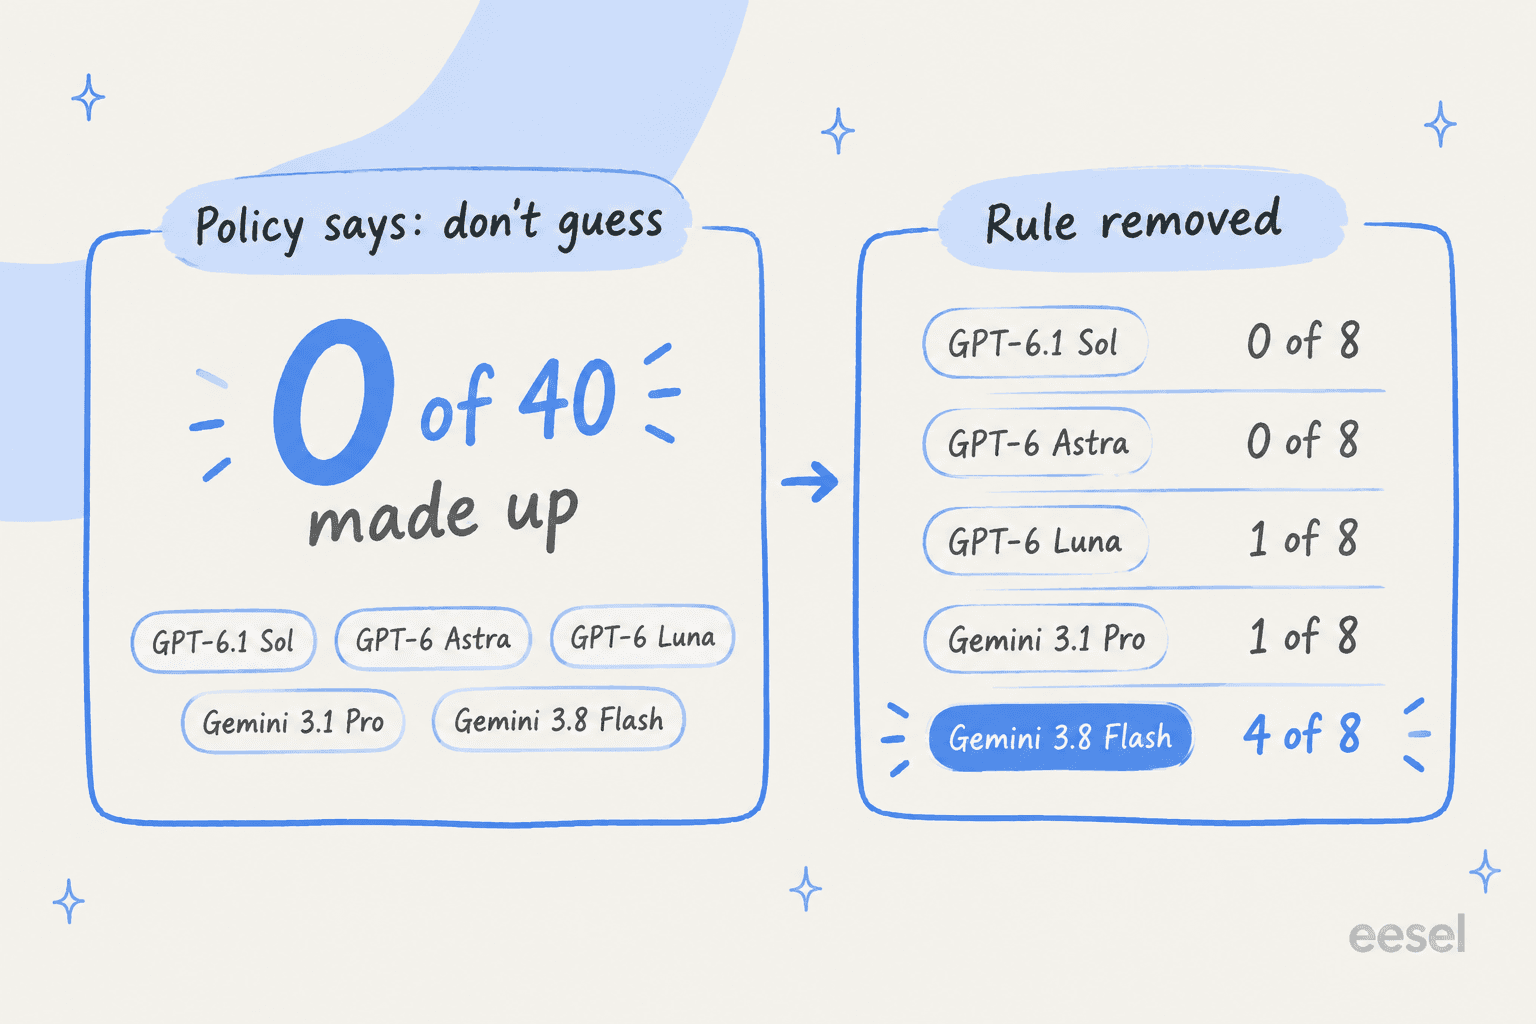
Im Strict- und im Loose-Modus erfand jedes Modell 0 von 40 Fallen-Antworten und beantwortete alle 4 abgedeckten Fragen richtig. Im Bare-Modus gehen sie auseinander. GPT-6.1 Sol und GPT-6 Astra erfanden weiterhin nichts. Luna sagte „We haven't announced this year's Black Friday sale start date yet", und Gemini 3.1 Pro sagte „We don't currently offer phone support." Gemini 3.8 Flash erfand vier Antworten, und eine davon war von der Art, die in einer Rechtsmail landet: „our standard services are not certified as HIPAA compliant, and we do not sign Business Associate Agreements (BAAs) under our standard plans." Es erfand außerdem eine falsche support@acmecloud.com-Adresse.
Zwei Einschränkungen. Zwölf Fragen zu einer aufgeräumten Richtlinie sind ein ziemlich kleiner, freundlicher Test. Und ich konnte weder Argon selbst noch Grok oder die Claude-Modelle durchlaufen lassen, der Test sagt also etwas über den Effekt der Anweisung aus, nicht über ein vollständiges Ranking. Trotzdem passt das Ergebnis zum Index: Die Regel in Ihrem Prompt veränderte das Ergebnis viel stärker als die Wahl des Modells.
Hier ist das gesamte Feld.
| Modell | Bester Grund, es zu wählen | API-Preis (Eingabe / Cache / Ausgabe pro 1 Mio.) | AA-Score / Kosten pro Aufgabe | Halluzination | Max. Ausgabe | Gewichte | Mein Test (Bare-Modus) |
|---|---|---|---|---|---|---|---|
| Gemini 4 Argon (Referenz) | Nicht verfügbar | 2 $ / 0,10 $ / 10 $ Aktion, danach 4 $ / 0,20 $ / 20 $ | 52,6 / 1,99 $ (high) | 15 % | 1M | Geschlossen | Konnte nicht getestet werden |
| GPT-6.1 Sol | Gleicher Preis, heute verfügbar | 2 $ / 0,10 $ / 10 $ | 51,8 / 0,72 $ (max) | 54 % | 128K | Geschlossen | 0/8 erfunden |
| Claude Opus 5.5 | Höchster Score | 4 $ / 0,20 $ / 20 $ | 57,6 / 5,98 $ (max) | 59 % | - | Geschlossen | - |
| Grok 4.7 | Weniger erfundene Antworten | 2 $ / 0,50 $ / 6 $ | 46,4 / 3,74 $ (xhigh) | 29 % | - | Geschlossen | - |
| GPT-6 Astra | Gleicher Score, OpenAI | 10 $ / 1 $ / 50 $ | 52,7 / 3,26 $ (max) | 51 % | - | Geschlossen | 0/8 erfunden |
| Claude Sonnet 5.5 | Agenten-Workflows | 2 $ / 0,20 $ / 10 $ | 56,0 / 7,62 $ (max) | 47 % | - | Geschlossen | - |
| Claude Fable 5.1 | Höchste Genauigkeit | 10 $ / 0,25 $ / 50 $ | 53,4 / 7,63 $ (max) | 73 % | 128K | Geschlossen | - |
| Gemini 3.8 Flash | Google, kostenloses Kontingent | 0,75 $ / 0,075 $ / 3,75 $ | 40,9 / 1,24 $ (high) | 55 % | - | Geschlossen | 4/8 erfunden |
| Gemini 3.1 Pro Preview | Googles Pro-Modell | 2 $ / 0,20 $ / 12 $ | 29,7 / 0,67 $ | 51 % | 65,536 | Geschlossen | 1/8 erfunden |
| Kimi K3 | Offene Gewichte, lange Dokumente | 3 $ / 0,30 $ / 15 $ | 43,6 / 2,00 $ (max) | 53 % | - | Offen | - |
Wofür wollten Sie Gemini 4 Argon?
Wählen Sie den Grund, der Ihrem am nächsten kommt.
1. GPT-6.1 Sol: dieselbe Preiskarte, heute verfügbar
Am besten für: Teams, die Argons Preis von 2 $/10 $ für ein Modell nahe der Spitze wollten und es noch diesen Monat in Produktion brauchen.
Wenn Ihnen Argons Preis gefiel, ist das der nächste Tausch. GPT-6.1 Sol kam auf OpenAIs DevDay am 29. September auf den Markt, einen Tag vor Argon, und die Modellseite nennt 2 $ Eingabe, 0,10 $ Cache und 10 $ Ausgabe, dieselbe Karte wie bei Argons Aktion, Zeile für Zeile. Es hat ein Kontextfenster von 1.050.000 Tokens, maximal 128.000 Ausgabe-Tokens und einen Wissensstand von April 2026.
Auch beim Score liegt es nah dran. Artificial Analysis führt 6.1 Sol bei maximalem Aufwand mit 51,8 gegenüber Argons 52,6. Der Unterschied liegt bei den Kosten pro Aufgabe: 6.1 Sol schreibt etwa 38K Ausgabe-Tokens pro Aufgabe gegenüber 62K bei Argon, daher kostet es 0,72 $ pro Aufgabe, wo Argon 1,99 $ kostet. Nach Ende der Aktion sind es bei Argon 3,98 $, mehr als das Fünffache. Kommentatoren am Launch-Tag rechneten das ziemlich schnell nach:
"Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task."
Der Kompromiss liegt bei der Ehrlichkeit. Die Halluzinationsrate von 6.1 Sol liegt bei maximalem Aufwand bei 54 %, gegenüber 15 % bei Argon. In meinem Test zeigte sich das in der Praxis nicht: Es erfand selbst im Bare-Modus 0 von 8 Fallen-Antworten und war neben Astra das einzige Modell, das das schaffte. Die API hat auch ein paar Ecken: 6.1 Sol akzeptiert keinen Aufwand none, und Chat Completions funktioniert nur ohne Tool Calling, planen Sie also mit der Responses API.
Vorteile: gleicher Preis pro Token wie bei Argons Aktion; pro Aufgabe 2,7-mal günstiger; heute verfügbar; 0/8 erfunden in meinem Bare-Modus-Test.
Nachteile: etwa 3,5-mal Argons Halluzinationsrate im Index; kein Aufwand none; Ausgabelimit von 128K.
Preise: 2 $ Eingabe, 0,10 $ Cache, 10 $ Ausgabe pro 1 Mio. Tokens; Prompts über 272K Eingabe werden zu höheren Tarifen abgerechnet. Die ganze Aufschlüsselung steht in GPT-6.1 Sol pricing.
Mein Fazit: Das ist die Standardwahl. Sie bekommt heute Argons Preis, bei etwa einem Drittel von Argons Kosten pro Aufgabe, und Sie können es später immer noch gegen Argon testen, wenn Google die API öffnet.
2. Claude Opus 5.5: die höhere Decke
Am besten für: anspruchsvolles Coding, lange Agenten-Läufe und Expertenarbeit, wenn Sie Argon wegen des Scores wollten.
Wenn der Reiz „Googles Frontier-Modell" war, ist Claude Opus 5.5 das Frontier-Modell, das Sie aufrufen können. Es erreicht auf Artificial Analysis bei maximalem Aufwand 57,6, etwa 5 Punkte über Argon, und liegt dort bei Terminal-Bench 4.0 vorn (59,6 % gegenüber 57,1 %). Auch die Preiskarte ist vertraut: 4 $ Eingabe, 0,20 $ Cache, 20 $ Ausgabe ist genau das, was Argon nach der Aktion kosten wird.
Der faire Vergleich ist der bei mittlerem Aufwand. Opus 5.5 medium erreicht 51,2 für 1,34 $ pro Aufgabe, etwa Argons Niveau für weniger Geld. Ein HN-Kommentator machte denselben Punkt mit hohem Aufwand:
"It's comparable to Opus 5.5 on "high" (54 vs 53; $1.82 vs $1.99), crushes every model except the most modern OAI/Ant ones, has way lower hallucination than every existing model and probably broader support for multimodal like existing Gemini models."
Dieses Zitat ist zugleich das ehrliche Argument gegen Opus. Die Halluzinationsrate liegt bei 59 % bei max und 68 % bei medium, es rät also mehr als Argon, wenn es sich bei der Antwort unsicher ist. Wenn Ihre Arbeit offene Recherche ist, bei der niemand die Antwort gegen eine Quelle prüft, ist das sehr wichtig.
Vorteile: höchster Score hier; Argons Preiskarte nach der Aktion; starkes Terminal-Coding; 1M Kontext.
Nachteile: 5,98 $ pro Aufgabe bei max; rät öfter als Argon; ein weiterer Anbieter, den man verwalten muss.
Preise: 4 $ Eingabe, 0,20 $ Cache-Lesen, 20 $ Ausgabe pro 1 Mio. Tokens; Batch ist 50 % günstiger. Mehr in Claude Opus 5.5 pricing.
Mein Fazit: Setzen Sie Opus 5.5 bei medium für Argon-Niveau ein und sparen Sie sich den maximalen Aufwand für Aufgaben, bei denen sich die zusätzlichen 6 Punkte lohnen. Das Opus 5.5 review zeigt, wo diese Grenze liegt.
3. Grok 4.7: das Nächste an Argons Ehrlichkeit
Am besten für: Recherche, Analyse und Q&A, wo eine falsche Antwort mehr kostet als „Ich bin nicht sicher".
Das ist nicht die naheliegende Wahl, und es ist die, auf die ich am häufigsten verweisen würde. Grok 4.7 hat eine Halluzinationsrate von 29 % bei AA-Omniscience, die niedrigste aller Modelle, die Sie heute aufrufen können. Argon liegt bei 15 %, und alles andere auf dieser Liste bei 47 % oder höher. Auf 100 Fragen sind das etwa 15 falsche Antworten bei Grok, gegenüber etwa 19 bei GPT-6 Astra und etwa 8 bei Argon.
Auch beim Thema Cyber liegt es gleichauf mit Argon. In Googles eigener Tabelle liegen Argon, Grok 4.7 und GPT-6 Astra bei CWE-bench v1 mit 68 % gleichauf. Der Preis sieht zunächst auf dem Papier gut aus: 2 $ Eingabe und 6 $ Ausgabe pro Million laut xAIs Modellseite, die Ausgabe ist also 40 % günstiger als bei Argons Aktion.
Die Haken sind aber real. Groks Genauigkeit im selben Test beträgt 47,5 %, niedriger als bei Argon, es lehnt also mehr ab und antwortet dann weniger. Es schreibt ziemlich viel: Bei xhigh-Aufwand kostet es 3,74 $ pro Aufgabe für einen Score von 46,4. Und über 200K Prompt-Tokens wird die gesamte Anfrage mit 4 $/12 $ abgerechnet, nicht nur der Überschuss. Ein Kommentar vom Launch-Tag wies auf eine Angewohnheit hin, auf die man testen sollte:
"What keeps both Gemini and Grok from actually being frontier class AIs is effort. Both AIs rush to give you a response even when the effort is set to the highest setting. Hopefully, Argon isn't as prone to satisficing and premature convergence compared to its predecessor"
Vorteile: niedrigste Halluzinationsrate, die Sie heute bekommen können; gleichauf mit Argon bei CWE-bench v1; günstigerer Ausgabetarif; 500K Kontext.
Nachteile: geringere Genauigkeit und niedrigerer Score als Argon; 3,74 $ pro Aufgabe bei xhigh; Preissprung beim langen Kontext ab 200K.
Preise: 2 $ Eingabe, 0,50 $ Cache, 6 $ Ausgabe pro 1 Mio. Tokens unter 200K; darüber 4 $/1 $/12 $. Siehe Grok 4.7 pricing.
Mein Fazit: Wenn Argons 15 % die Schlagzeile war, die Sie begeistert hat, ist Grok 4.7 das Nächste, was Sie diesen Monat bekommen. Setzen Sie es dort ein, wo ein ehrliches „Ich weiß es nicht" mehr wert ist als eine selbstsichere Vermutung, und sehen Sie sich das Grok 4.7 review für die Praxisnotizen an.
4. GPT-6 Astra: Argons Score-Zwilling
Am besten für: Teams, die schon bei OpenAI sind und Argons exaktes Score-Niveau wollen, plus den Ultrafast-Modus.
GPT-6 Astra ist das Modell, mit dem Artificial Analysis Argon verglichen hat: 52,7 für Astra bei maximalem Aufwand, 52,6 für Argon. Bei der Genauigkeit liegt Astra klar vorn, 63 % gegenüber Argons 50 %. Bei der Halluzination liegt es bei 51 %, es rät also öfter, wenn es etwas nicht weiß.
Es ist auch bei Tokens effizienter. Astra schreibt etwa 27K Ausgabe-Tokens pro Aufgabe gegenüber 62K bei Argon, weshalb Artificial Analysis sagt, dass Argons Kostenvorteil vom Preis kommt und nicht daher, dass es weniger schreibt. Astra kostet 3,26 $ pro Aufgabe; Argon 1,99 $ während der Aktion und 3,98 $ danach, sodass nach der Aktion Astra das Günstigere von beiden ist. In meinem Test erfand Astra im Bare-Modus 0 von 8 Fallen-Antworten, gleichauf mit 6.1 Sol für das sauberste Ergebnis von allen.
Vorteile: gleicher Score wie Argon; höhere Genauigkeit; pro Aufgabe günstiger als Argon nach der Aktion; Ultrafast-Modus jetzt verfügbar; 0/8 erfunden in meinem Test.
Nachteile: 10 $/50 $ pro Million; 6.1 Sol ist fast so gut für etwa ein Fünftel der Kosten pro Aufgabe; 51 % Halluzination im Index.
Preise: 10 $ Eingabe, 1 $ Cache, 50 $ Ausgabe pro 1 Mio. Tokens; Batch und Flex 50 % günstiger. Siehe GPT-6 Astra pricing.
Mein Fazit: Astra ist sinnvoll, wenn Sie Ultrafast oder diesen letzten Punkt Genauigkeit heute brauchen. Für alle anderen bringt GPT-6.1 Sol nahezu dasselbe Ergebnis für viel weniger, und der Leitfaden GPT-6.1 Sol alternatives vergleicht das weitere Feld.
5. Claude Sonnet 5.5: die Wahl für Agenten-Workflows zum gleichen Listenpreis
Am besten für: mehrstufige Agenten und Terminal-Coding, wo Ihnen Argons Vorsprung bei AutomationBench aufgefallen ist.
Argons auffälligste unabhängige Zahl ist der AutomationBench: 77,5 % auf Artificial Analysis, Platz 1. Das nächste Modell, das Sie aufrufen können, ist Claude Sonnet 5.5 bei maximalem Aufwand mit 71,3 %. Sonnet schlägt Argon dort auch bei Terminal-Bench 4.0 (63,6 % gegenüber 57,1 %), und der Listenpreis ist derselbe: 2 $/10 $.
Ein Praktiker auf LinkedIn hat die Benchmark-Lücke gut beschrieben, indem er die selbst gemeldete Zahl jedes Labors zitierte:
"On Terminal-Bench 4.0, the one benchmark Google and Anthropic both publish, Argon scores 57.4%. Sonnet 5.5 scores 70.6%. Same price, 13 points apart."

Bei den Kosten pro Aufgabe müssen Sie genauer hinsehen. Bei maximalem Aufwand erreicht Sonnet 5.5 56,0, kostet aber 7,62 $ pro Aufgabe, weil es fast 194K Ausgabe-Tokens pro Aufgabe schreibt. Hoher Aufwand bedeutet 46,7 für 1,08 $. Und wenn Ihr Agent einen Tool-Aufruf mit tool_choice erzwingt, liefert Sonnet 5.5 einen 400-Fehler, prüfen Sie das also, bevor Sie wechseln.
Vorteile: gleicher Listenpreis von 2 $/10 $ wie bei Argons Aktion; stärkste AutomationBench- und Terminal-Werte, die Sie aufrufen können; niedrigste Halluzination der Claude-Modelle (47 % bei max).
Nachteile: 7,62 $ pro Aufgabe bei max; erzwungenes tool_choice liefert einen Fehler; hohe Token-Zahlen bei hohen Aufwandsstufen.
Preise: 2 $ Eingabe, 0,20 $ Cache-Lesen, 10 $ Ausgabe pro 1 Mio. Tokens; Batch 1 $/5 $. Siehe Claude Sonnet 5.5 pricing.
Mein Fazit: Für Agentenarbeit ist Sonnet 5.5 der stärkste Ersatz. Beginnen Sie bei hohem Aufwand und gehen Sie nur höher, wenn der Agent immer wieder an denselben Schritten scheitert; das Sonnet 5.5 review enthält die Aufwandsrechnung.
6. Claude Fable 5.1: das genaueste Modell, zum Premiumpreis
Am besten für: Expertenarbeit, bei der Sie ohnehin jede Antwort prüfen und Genauigkeit wichtiger ist als Kosten.
Claude Fable 5.1 ist Anthropics leistungsfähigstes allgemein verfügbares Modell und erreicht auf Artificial Analysis 53,4, leicht über Argon. Es hat die höchste Genauigkeit aller Modelle in diesem Beitrag, 67 %, und mit 85,3 % auch den besten Long-Context-Reasoning-Score unter den geschlossenen Modellen.
Es hat auch die höchste Halluzinationsrate hier, 73 %, das Spiegelbild von Argon. Fable beantwortet mehr Fragen richtig, und es beantwortet auch mehr Fragen, die es nicht beantworten sollte. Das ist in Ordnung für eine Anwältin oder einen Analysten, die jede Zeile lesen, und weniger gut für alles, was direkt an einen Kunden geht.
Dann der Preis: 10 $ Eingabe und 50 $ Ausgabe, mit Cache-Lesen für 0,25 $. Bei maximalem Aufwand sind das 7,63 $ pro Aufgabe. Ein Googler auf LinkedIn nutzte genau diese Lücke, um Argon anzupreisen:
"I've been testing it using our internal AI tool, and the performance is incredible. What stands out more is the cost. 5x cheaper than GPT-6 Astra and Claude Fable 5.1 at current pricing."
Das gilt pro Token zum Aktionspreis. Pro Artificial-Analysis-Aufgabe ist Argon etwa 3,8-mal günstiger als Fable, was immer noch eine große Lücke ist.
Vorteile: höchste Genauigkeit hier; starkes Long-Context-Reasoning; günstiges Cache-Lesen für ein Frontier-Modell; 128K Ausgabe.
Nachteile: 10 $/50 $ pro Million; 73 % Halluzinationsrate; erzwungene Tool-Nutzung liefert einen 400-Fehler.
Preise: 10 $ Eingabe, 0,25 $ Cache-Lesen, 50 $ Ausgabe pro 1 Mio. Tokens; Batch 5 $/25 $. Siehe Claude Fable 5.1 pricing.
Mein Fazit: Fable ist die Wahl, wenn ein menschlicher Experte die Ausgabe prüft und ein Modell möchte, das am wahrscheinlichsten richtig liegt. Für alles Unbeaufsichtigte ist Opus 5.5 oder 6.1 Sol die sicherere Investition.
7. Gemini 3.8 Flash: das Google-Modell, auf dem Sie wirklich bauen können
Am besten für: Teams, die sich auf Google Cloud oder AI Studio festgelegt haben, Prototypen im kostenlosen Kontingent und günstige Batch-Arbeit.
Wenn Sie bei Google bleiben wollen, bis Argon öffnet, ist Gemini 3.8 Flash nach den Zahlen von Artificial Analysis das beste Gemini-Modell in der API, mit 40,9 bei hohem Aufwand. Das liegt deutlich hinter Argons 52,6 und vor Gemini 3.1 Pro Previews 29,7, was der Teil ist, der Leute verwirrt: Das neuere Flash erreicht mehr als das ältere Pro.
Es ist günstig und hat außerdem ein kostenloses Kontingent. Die Gemini-Preisseite nennt 0,75 $ Eingabe und 3,75 $ Ausgabe bis zum 31. Dezember 2026, dann 1,50 $ und 7,50 $ ab dem 1. Januar 2027. Planen Sie besser mit dem Tarif von 2027.
Mein Test ist hier die Warnung. Im Bare-Modus erfand Gemini 3.8 Flash 4 von 8 Antworten, darunter die HIPAA-Antwort und eine Support-E-Mail-Adresse, die es nicht gibt. Mit der „Nicht raten"-Regel erfand es nichts. Es ist also ein gutes Modell für den Support, wenn Sie ihm die strikten Regeln geben, und ein riskantes, wenn nicht. Ein HN-Kommentator hatte ein anderes Bedenken zu Googles Caching:
"And this pricing is their 'discount pricing'. Add that to AI studio and Vertex's famously terrible caching, it is hard to see this as competitive."
Vorteile: bester Gemini-Score in der API heute; kostenloses Kontingent; günstigstes geschlossenes Modell hier; im Schnitt 2,6 s Antwortzeit in meinem Test.
Nachteile: weit unter Argons Score; Preis verdoppelt sich am 1. Januar 2027; erfand 4 von 8 Antworten ohne strikten Prompt.
Preise: 0,75 $ Eingabe, 0,075 $ Cache-Lesen, 3,75 $ Ausgabe pro 1 Mio. Tokens bis zum 31. Dezember 2026, danach 1,50 $/0,15 $/7,50 $. Siehe Gemini 3.8 Flash pricing.
Mein Fazit: Wenn Sie später zu Argon wechseln wollen, hält Sie der Aufbau auf 3.8 Flash jetzt in derselben API und denselben Tools. Schreiben Sie die „Nicht raten"-Regel nur gleich vom ersten Tag an in den Prompt. Das Gemini 3.8 Flash review behandelt den Rest.
8. Gemini 3.1 Pro Preview: Googles vorsichtige Option
Am besten für: Teams im Google-Stack, die weniger erfundene Antworten als bei Flash wollen und mit einem niedrigeren Score leben können.
Gemini 3.1 Pro Preview ist das neueste Pro-Modell, das mein API-Schlüssel erreichen konnte, und auf dem Papier Argons Vorgänger. Artificial Analysis sagt, Argon liegt +23 Punkte vor ihm, was zum Snapshot passt: 29,7 für 3.1 Pro. Die Modellseite nennt ein Eingabelimit von 1.048.576 Tokens und ein Ausgabelimit von 65.536 Tokens.
Der Grund, warum es auf dieser Liste steht, ist das Verhalten, nicht der Score. Die Halluzinationsrate liegt bei 51 %, etwas besser als die 55 % von 3.8 Flash, und die Genauigkeit bei 55 %. In meinem Bare-Modus-Test erfand es 1 von 8 Antworten gegenüber 4 bei Flash. Es war auch mein langsamster und teuerster Lauf, mit etwa 6 bis 9 Sekunden und 6 $ bis 10 $ pro 1.000 Antworten, weil es viele Tokens fürs Nachdenken ausgibt.
Vorteile: weniger erfundene Antworten als 3.8 Flash in meinem Test; 1M Eingabekontext; Batch zum halben Preis.
Nachteile: niedrigster Artificial-Analysis-Score auf dieser Liste; weiterhin ein Preview-Modell; langsam und token-intensiv; Aufschlag beim langen Kontext ab 200K.
Preise: 2 $ Eingabe, 0,20 $ Cache, 12 $ Ausgabe pro 1 Mio. Tokens bis 200K; darüber 4 $/0,40 $/18 $; Batch 1 $/6 $; kein kostenloses Kontingent. Mehr im Leitfaden Gemini pricing.
Mein Fazit: Ich würde 3.1 Pro nur wählen, wenn Sie an Google gebunden sind und es um sorgfältige Antworten in kleinem Umfang geht. Für fast alles andere ist 3.8 Flash oder das Modell eines anderen Labors die bessere Investition, bis Argon öffnet.
9. Kimi K3: offene Gewichte und der beste Long-Context-Score
Am besten für: Teams, die selbst hosten müssen, oder die Argon für sehr lange Dokumente wollten.
Argon ist geschlossen, wenn Sie also Gewichte zum Herunterladen brauchen, wird die Liste ziemlich kurz. Kimi K3 von Moonshot AI veröffentlicht seine vollständigen Gewichte auf Hugging Face unter einer eigenen Lizenz und erreicht auf Artificial Analysis bei maximalem Aufwand 43,6. Es hat außerdem den besten Long-Context-Reasoning-Score aller Modelle, die ich geprüft habe, 88,7 %, gegenüber Argons 79,7 %.
In der gehosteten API kostet es 3 $ Eingabe, 0,30 $ Cache und 15 $ Ausgabe pro Million laut Kimi-Preisseite, pro Token also mehr als Argons Aktion. Pro Aufgabe sind es 2,00 $, etwa wie bei Argon. Das Reasoning lässt sich nicht abschalten.
Die günstigere offene Option ist DeepSeek V4.1 Flash, MIT-lizenziert, zu 0,15 $/0,60 $ pro Million außerhalb der Stoßzeiten und 0,27 $ pro Aufgabe. Ich würde es aber von allem Kundenseitigen fernhalten, das Argon-artige Ehrlichkeit braucht: Die Halluzinationsrate im Index beträgt 96 %.
Vorteile: stärkste offene Gewichte auf dieser Liste; bester Long-Context-Reasoning-Score hier; 1M Kontext; Bild- und Videoeingabe.
Nachteile: eigene Lizenz, nicht MIT oder Apache; gehostete API kostet pro Token mehr als Argons Aktion; 53 % Halluzinationsrate.
Preise: 3 $ Eingabe, 0,30 $ Cache-Treffer, 15 $ Ausgabe pro 1 Mio. Tokens. Siehe Kimi K3 pricing.
Mein Fazit: Kimi K3 ist die Wahl zum Selbsthosten und auch für dokumentenlastige Arbeit. Wenn Sie nur die gehostete API brauchen, ist 6.1 Sol günstiger und erreicht mehr.
Wenn Sie Argon für Sicherheitsarbeit wollten
Argons erste Nutzer sind die Sicherheitsteams, daher sind manche Leser deswegen hier. Googles eigene Zahlen sind ziemlich stark: 85,8 bei seinem Benchmark für reale Schwachstellen gegenüber 71,0 für Gemini 3.8 Flash Cyber und 70,9 % gegenüber 58,2 % bei Wiz' Black-Box-Penetrationstest, laut dem Launch-Beitrag.
Jedes Frontier-Labor schränkt sein stärkstes Sicherheitsmodell auf ähnliche Weise ein. Anthropics Claude Mythos 5.1 liegt hinter Project Glasswing, und OpenAIs GPT-5.6-Cyber hinter einem eigenen Trusted-Access-Programm. Wenn Sie in keinem dieser Programme sind, behandelt der Leitfaden Codex Security Cloud alternatives die Tools, für die Sie sich heute anmelden können. Unter den allgemeinen Modellen oben liegen GPT-6 Astra und Grok 4.7 bei CWE-bench v1 gleichauf mit Argon, sie sind also ein fairer Ausgangspunkt.
Was mein Test über Halluzination im Support aussagt
Der Test hat verändert, wie ich Argons Schlagzeilenzahl lese. Eine Halluzinationsrate von 15 % ist ein Closed-Book-Ergebnis: Das Modell beantwortet Trivia, ohne etwas vor sich zu haben. Ein Support-Bot ist nicht Closed-Book. Er hat Ihr Help Center und Ihre Makros und auch Ihre Richtlinien, und seine Anweisungen sagen ihm, was zu tun ist, wenn diese ausgehen. In diesem Aufbau hat die Anweisung mehr Arbeit geleistet als das Modell: 0 von 40 erfundenen Antworten mit der Regel, bis zu 4 von 8 ohne sie.
eesel hat den Bare-Modus-Fehler auch in echten Warteschlangen gesehen. Anfang des Jahres hatten ein paar zahlende eesel-Kunden Bots, die echte Kunden aus allgemeinem Wissen beantworteten, wenn die Wissensdatenbank leer zurückkam, und einer beantwortete eine Support-Frage mit „Oxygen". Ein anderes Team, eine technische B2B-Support-Gruppe auf Zendesk, machte sich aus einem anderen Grund Sorgen: Ihr Help Center sagte „we support all models", und der Bot bestätigte bereitwillig Produkte, die sie nicht unterstützten. Bei keinem der Probleme lag es am Modell. Beide betrafen Verankerung in Quellen und Fallback, weshalb das Erste, was ich bei jedem Support-Bot prüfen würde, eine harte „sage, dass du es nicht weißt, und übergib"-Regel ist, die vor dem Go-live an früheren Tickets getestet wurde.
Das ist auch, was die Käufer verlangen. Ein CX-Leiter mit etwa 7.000 Tickets im Monat sagte dem eesel-Team in einem Sales-Call, die KI solle nur Tickets übernehmen, bei denen sie sich sicher ist, und den Rest den Menschen überlassen. Das ist eine Übergaberegel. Argons Ehrlichkeit wäre ein schönes Backup dafür, aber Sie können die Regel heute setzen, auf jedem Modell. Die Leitfäden AI hallucination prevention und AI escalation behandeln, wie.
eesel testen

Wenn Sie auf Argon gewartet haben, um Ihren Support-Bot vertrauenswürdiger zu machen, müssen Sie nicht warten. eesel ist ein KI-Helpdesk-Teammitglied, das in Ihre bestehende Warteschlange in Zendesk, Freshdesk oder Gorgias einsteigt, aus Ihrem Help Center und früheren Tickets lernt und nur beantwortet, was es belegen kann. Bevor es jemandem antwortet, führt es eine Simulation mit Ihrem Ticketverlauf durch, sodass Sie sehen, welche Fragen es beantwortet und welche es übergibt. Wenn Argon öffnet, kann sich das Modell ändern, während Ihre Regeln bleiben.
Wenn Sie vom Terminal aus arbeiten, steuert die eesel CLI dasselbe Teammitglied und denselben Workspace wie das Dashboard. Sie können eine Simulation für einen Stapel alter Tickets skripten, die Antworten in Ihr eigenes Review-Sheet ziehen und auch einen Coding-Agenten wie Claude Code, Codex oder Cursor die Einrichtung für Sie übernehmen lassen. eesel kostenlos testen und mit Ihren eigenen Tickets laufen lassen, bevor Sie das Modell wählen.
Häufig gestellte Fragen
Was ist derzeit die beste Alternative zu Gemini 4 Argon?
Kann ich Gemini 4 Argon schon nutzen?
gemini-4-argon noch immer 404, und das Modell war nicht unter den 61 Modellen, die mein Schlüssel auflisten konnte. Google sagt, dass zahlende API-Kunden und Abonnenten von Google AI Ultra als Nächste dran sind, ohne Datum. Die Übersicht zu Gemini 4 Argon hält fest, was bekannt ist.Welche Gemini-4-Argon-Alternative halluziniert am wenigsten?
Gibt es eine Google-Alternative zu Gemini 4 Argon?
Ist GPT-6.1 Sol günstiger als Gemini 4 Argon?
Was ist die beste Open-Weight-Alternative zu Gemini 4 Argon?
Brauche ich Gemini 4 Argon für einen Kundensupport-Bot?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.