Was Cohere Embed 5 eigentlich ist
Cohere ist das Enterprise-KI-Unternehmen hinter den Command-Modellen, Rerank und dem Dokumenten-Parser Parse 5. Ein Embedding-Modell ist der unauffällige Teil jedes Such- oder RAG-Systems: Es wandelt einen Textabschnitt (oder ein Bild) in eine Liste von Zahlen um, und Chunks mit ähnlicher Bedeutung liegen dann nah beieinander. Wenn ein Nutzer etwas fragt, wird auch diese Frage in Zahlen umgewandelt, und das System holt die nächstgelegenen Chunks.
Ist das Embedding-Modell schwach, wird die richtige Antwort schlicht nie abgerufen, und geschicktes Prompting behebt das nicht. Es ist dieselbe Schicht, die auch die KI-Unternehmenssuche antreibt.
Embed 5 löst Embed 4 als Cohere-Flaggschiff ab und kommt in zwei Stufen: Pro, "optimized for maximum quality across multimodal, multilingual, financial, code, and parsed-document retrieval", und Fast, das "brings highly competitive performance to latency- and cost-sensitive workloads".
Ich baue bei eesel beruflich KI-Agenten, und Retrieval ist die Schicht, in der die meiste Debugging-Zeit landet. Diese Spezifikationen habe ich deshalb zuerst gesucht. Hier stehen sie nebeneinander, entnommen Coheres Modelldokumentation und dem Launch-Beitrag:
| Embed 5 Pro | Embed 5 Fast | Embed 4 (Vorgänger) | |
|---|---|---|---|
| API-Modell-ID | embed-v5.0-pro | embed-v5.0-fast | embed-v4.0 |
| Textpreis (pro 1 Mio. Tokens) | 0,12 $ | 0,08 $ | 0,12 $ |
| Bildpreis (pro 1 Mio. Tokens) | 0,40 $ | 0,40 $ | 0,47 $ |
| Kontextlänge | 128K Tokens | 128K Tokens | 128K Tokens |
| Eingaben | Text, Bilder, zusammengeführt Text + Bild | Text, Bilder, zusammengeführt Text + Bild | Text, Bilder, gemischt |
| Ausgabedimensionen | 256 bis 2048 (Standard 2048) | 256 bis 2048 (Standard 2048) | 256 bis 1536 (Standard 1536) |
| Formate | float, int8, binary | float, int8, binary | float, int8, binary |
| Sprachen | 100+ | 100+ | Mehrsprachig |
| Am besten für | Offline-Indexierung, qualitätskritische Suche | Live-Anfragen, Agenten-Schleifen, hohes Volumen |
Die Preise von Embed 4 stammen aus den Cohere-Preisen von Microsoft Foundry, da Coheres eigene Preisseite Embed 4 nicht mehr führt. Wenn Sie von der 3er-Serie von OpenAI kommen: Die API-Preise enden weiterhin bei 0,13 $ für text-embedding-3-large. In der Cohere-Tabelle gibt es zwei kleine Details, die gern übersehen werden. Die Standard-Ausgabe ist von 1536 auf 2048 Dimensionen gestiegen, was für den Speicher wichtig ist (dazu unten mehr), und Bildeingaben sind günstiger geworden, von 0,47 $ auf 0,40 $ pro 1 Mio. Tokens.
So funktioniert Embed 5: mit Pro indexieren, mit Fast abfragen
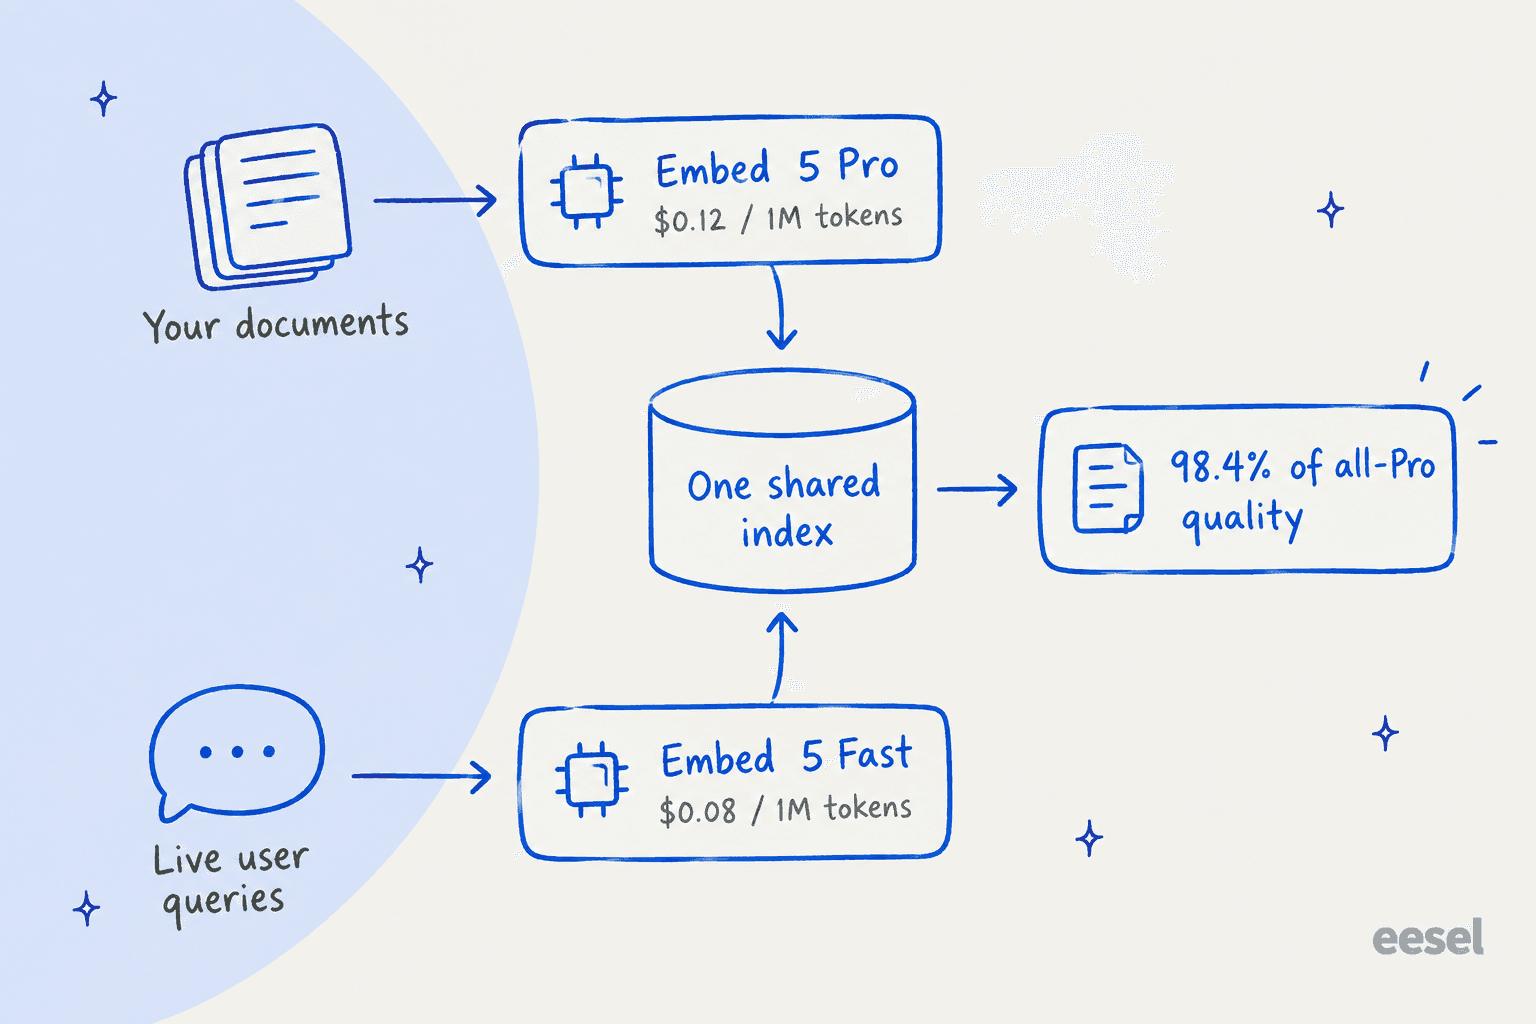
Dieses Feature würde ich zur Grundlage meiner Architektur machen, und es ist das mit dem geringsten Hype. Die meisten Embedding-Familien, auch die OpenAI-Embeddings-API, zwingen Sie, ein Modell zu wählen und dabei zu bleiben, weil Vektoren aus zwei verschiedenen Modellen nicht vergleichbar sind. Cohere hat Pro und Fast in einen gemeinsamen Raum trainiert, sodass eine mit Fast eingebettete Anfrage direkt mit Dokumenten verglichen werden kann, die mit Pro eingebettet wurden.
Das ist wichtig, weil Indexierung und Abfrage Gegensätzliches verlangen. Die Indexierung passiert einmal (oder bei jeder Dokumentänderung), und niemand wartet darauf, also wollen Sie hier die beste Qualität, die man kaufen kann. Die Abfrage ist etwas anderes: Sie passiert bei jeder einzelnen Nutzeranfrage und innerhalb Ihres Latenzbudgets, also zählt Geschwindigkeit. Mit einem gemeinsamen Raum können Sie beide Seiten getrennt wählen.
Cohere hat jede Kombination über 40 Entwicklungs-Datensätze laufen lassen und die Werte so normalisiert, dass Pro-Dokumente plus Pro-Anfragen 100 ergeben:
| Mittlere Retrieval-Qualität | Dokumente mit Fast indexiert | Dokumente mit Pro indexiert |
|---|---|---|
| Anfragen mit Fast | 96.6 | 98.4 |
| Anfragen mit Pro | 97.3 | 100 |
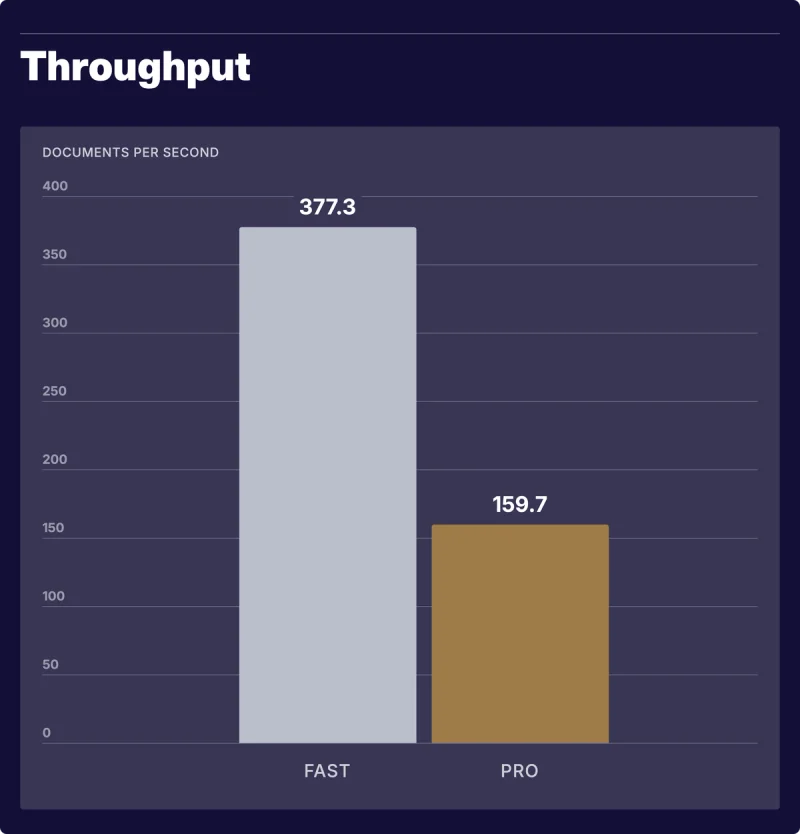
Pro-Index plus Fast-Anfragen landet also bei 98,4, ein Verlust von 1,6 %, während Fast die Arbeit zur Abfragezeit mit etwa 2,4-fachem Durchsatz von Pro erledigt (377,3 gegenüber 159,7 Dokumenten pro Sekunde in Coheres Test). Cohere selbst empfiehlt genau dieses Muster, und in der Fußnote steht der Haken, den man kennen sollte: Beide Seiten müssen dieselbe Ausgabedimension verwenden. Die Kombination funktioniert auch mit Matryoshka-Kürzung und int8-Quantisierung, ein komprimierter Index ist also möglich.
Einige API-Details aus der Embed-Referenz, die beeinflussen, wie Sie das Modell aufrufen:
input_typeist Pflicht. Verwenden Siesearch_documentbeim Indexieren undsearch_queryzur Abfragezeit. Es gibt außerdem die Modiclassificationundclustering.- 96 Eingaben pro Aufruf. Jede Eingabe kann Text- und Bildteile mischen, bei einer Gesamtgrenze von 20 MB Payload.
- Kürzung steht standardmäßig auf
END. Bei 128K Kontext greift das selten, aber wenn Sie lieber einen Fehler bekommen, als stillschweigend das Ende eines langen Dokuments zu verlieren, setzen SietruncateaufNONE. - Ratenlimits gelten pro Eingabe, nicht pro Anfrage: 2.000 Text-Eingaben pro Minute bei Trial- und Produktions-Keys sowie 5 gegenüber 400 Bild-Eingaben pro Minute, laut der Seite zu den Ratenlimits. Trial-Keys sind kostenlos, aber auf 1.000 Aufrufe im Monat begrenzt und nicht für den Produktionseinsatz erlaubt.
Die Benchmarks: stark, aber lesen Sie das Kleingedruckte
Die von Cohere veröffentlichten Zahlen sind gut. Unten die ViDoRe-V3-Haupttabelle, sie deckt Unternehmensdokumente aus acht Bereichen ab:
| Modell | ViDoRe-V3-Durchschnitt | Textpreis pro 1 Mio. Tokens |
|---|---|---|
| Cohere Embed 5 Pro | 85.8 | 0,12 $ |
| Cohere Embed 5 Fast | 84.5 | 0,08 $ |
| Voyage 4 Large | 83.7 | 0,12 $ |
| Gemini Embedding 2 | 83.2 | 0,20 $ |
| Cohere Embed 4 | 77.0 | 0,12 $ |
| OpenAI text-embedding-3-large | 75.5 | 0,13 $ |
| Jina Embeddings v5 Text Small | 74.5 | 0,05 $ |
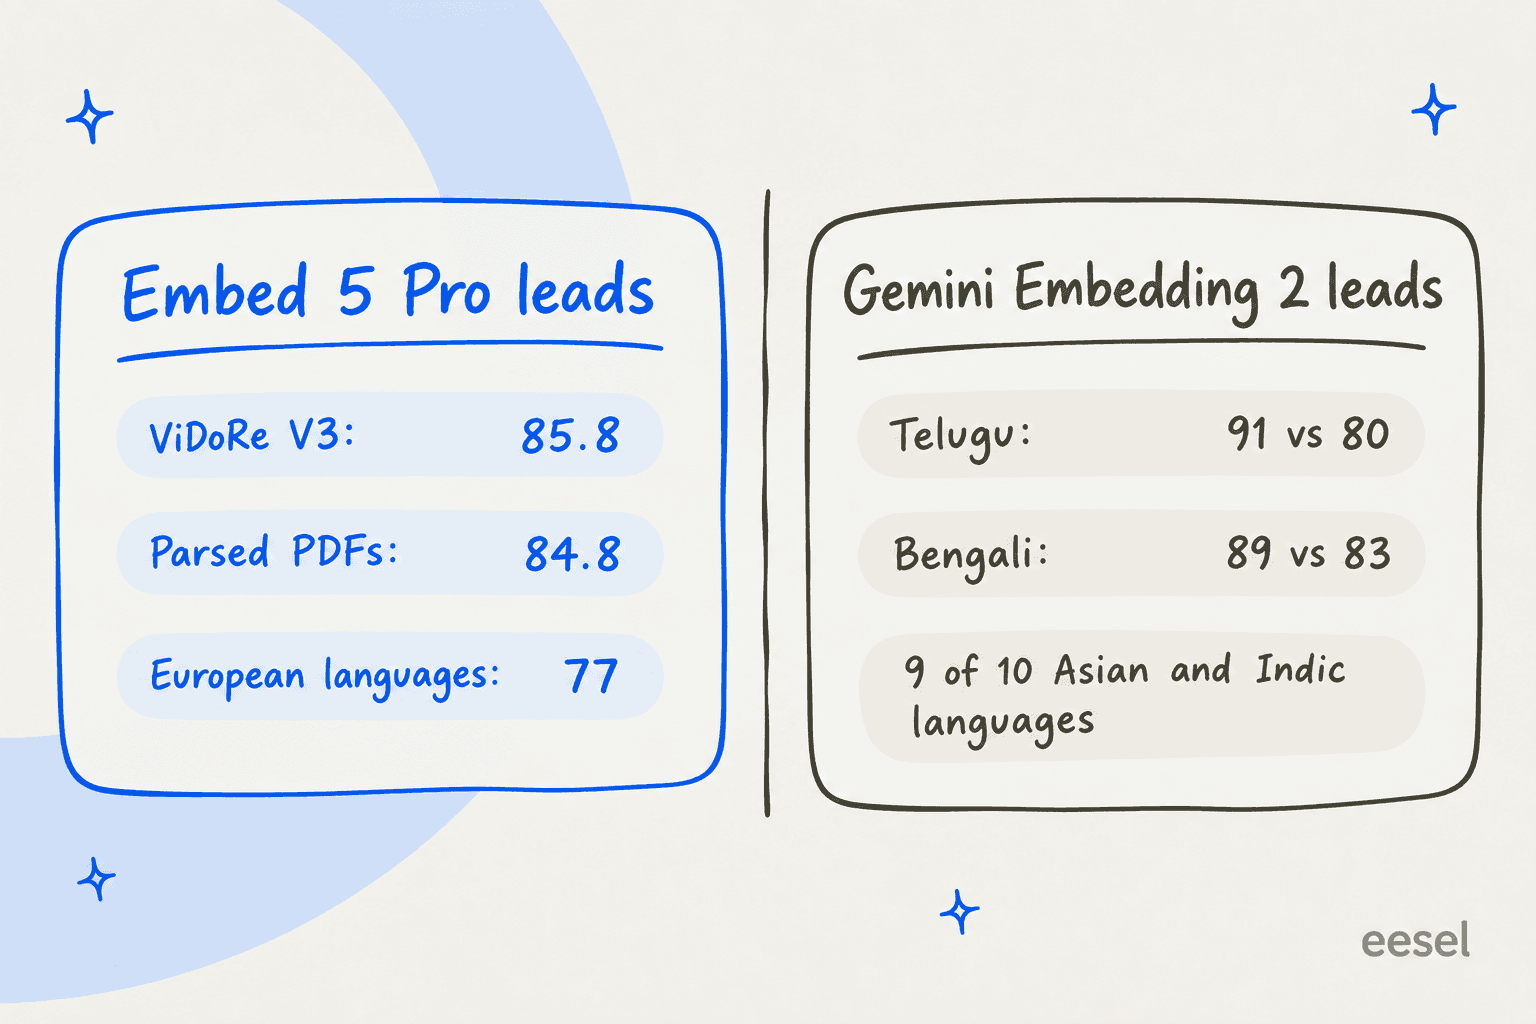
Im selben Test gewinnt Pro 8,8 Punkte gegenüber Embed 4, die größten Sprünge gibt es bei HR (+11,4) und bei Industriedokumenten (+10,3). Es führt auch Coheres Suite für geparste PDFs mit 84,8 an. Beim Finanz-Retrieval liegt es auf Platz eins bei FinanceBench (80,1) und FinQA (90,0) sowie ViDoRe V3 Finance (85,0), jeweils mit Fast auf Platz zwei.
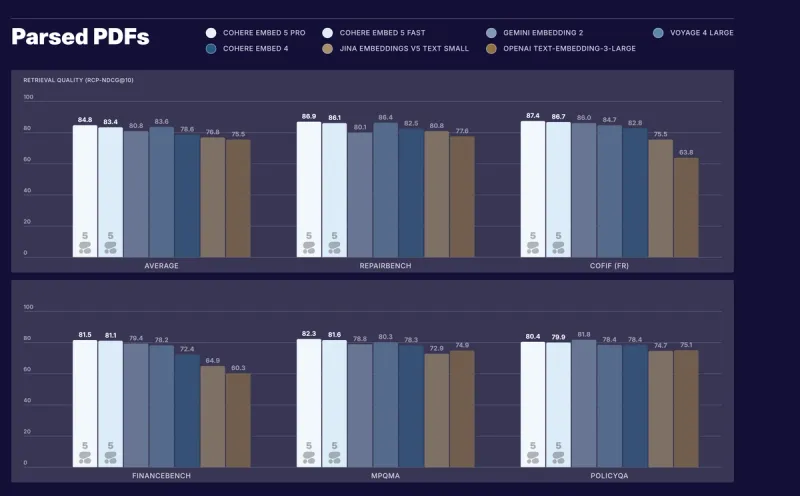
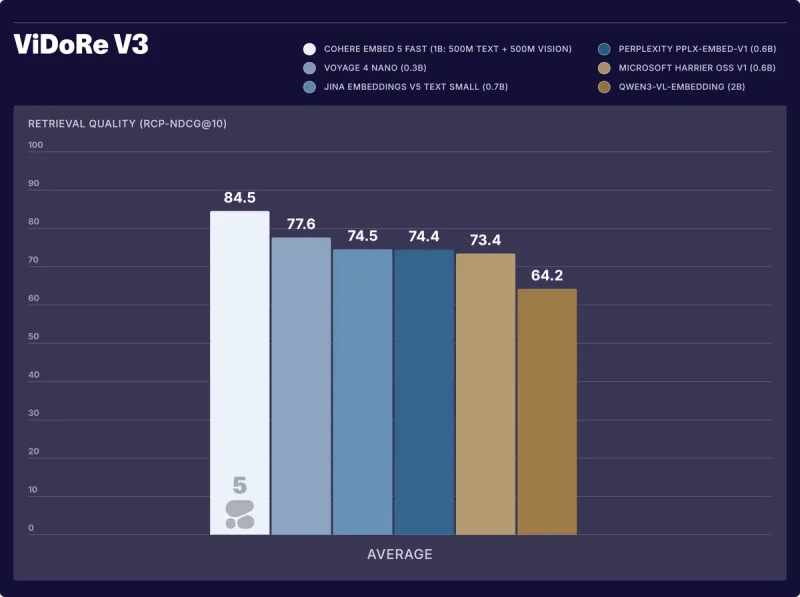
Das für mich beeindruckendste Ergebnis ist tatsächlich Fast. Im Vergleich mit anderen kompakten Modellen erreicht es auf ViDoRe V3 84,5, wo Voyage 4 Nano 77,6 und Qwen3-VL-Embedding 64,2 schafft. Die Legende in Coheres eigener Grafik (unten) führt Fast mit etwa 1B Parametern, 500M Text plus 500M Vision, und der Launch-Beitrag sagt, es schlage Qwen3-VL-Embedding-2B um etwa 20 Punkte, obwohl es nur etwa halb so groß ist.
Nun das Kleingedruckte, denn eine faire Einordnung braucht es.
Es ist eine neue Metrik, vom Anbieter durchgeführt. Embed 5 ist die erste Modellfamilie, die mit RCP-nDCG@10 bewertet wurde, einer Methode, die Cohere am selben Tag veröffentlicht hat. Coheres eigene Fußnote sagt, dass Modelle durch das Neuordnen einer festen Kandidatenmenge bewertet werden, "scores therefore reflect reranking quality rather than first-stage retrieval performance." Das ist eine vernünftige Messmethode, und der Code ist öffentlich, aber es ist nicht dieselbe Zahl, die Sie bei einer einfachen Top-10-Suche über Ihren gesamten Index erhalten würden. Außerdem sind einige Datensätze intern, etwa das Set "High Finance", das Cohere selbst annotiert hat.
Gemini Embedding 2 gewinnt bei den meisten nicht-europäischen Sprachen. Pro führt bei den europäischen Sprachen (Durchschnitt 77 über Deutsch, Französisch, Spanisch, Italienisch und Russisch). Aber in Coheres eigener Tabelle mit zehn Sprachen schlägt Gemini Embedding 2 Pro in 9 von 10: Japanisch, Koreanisch, Arabisch, Persisch, Hindi, Bengalisch, Telugu, Indonesisch und Thai. Pro liegt nur bei Chinesisch knapp vorn (82 gegenüber 81). Telugu zeigt den größten Abstand, 91 gegenüber 80.
Wenn Ihre Support-Warteschlange oder Dokumentbasis stark auf Hindi, Thai oder Bengalisch setzt, ist diese Tabelle das Nützlichste am ganzen Launch, und Cohere gebührt Anerkennung, sie überhaupt abgedruckt zu haben. Für ein Team, das eine mehrsprachige Wissensdatenbank in Europa und auf Englisch betreibt, ist Pro nach diesen Zahlen die stärkere Wahl.
Die Reaktion der Community ist noch früh und dünn, wie man einen Tag nach einem Launch erwartet. Die nützlichste Stimme eines Praktikers, die ich gefunden habe, ist eine ältere und bezieht sich auf Coheres Embeddings im Allgemeinen, nicht auf Embed 5 selbst:
"My experience with Cohere and interacting with their sales engineers has been boring, I say that is the most flattering way possible. Embeddings are a core service at this point like VMs and DBs. They just need to work and work well and thats what they're selling."

Das passt ziemlich gut zum Angebot hier. Embed 5 will nicht aufregend sein, es will die langweilige, verlässliche Schicht unter Ihrer Suche sein.
Cohere-Embed-5-Preise
Die Abrechnung für Embed 5 erfolgt pro Eingabe-Token, es gibt keine Gebühr für die Ausgabe. Hier alles, was Cohere veröffentlicht, von der Preisseite und aus dem Launch-Beitrag:
| Option | Embed 5 Pro | Embed 5 Fast | Abrechnungseinheit |
|---|---|---|---|
| Cohere API, Text | 0,12 $ pro 1 Mio. Tokens | 0,08 $ pro 1 Mio. Tokens | Eingabe-Tokens |
| Cohere API, Bilder | 0,40 $ pro 1 Mio. Tokens | 0,40 $ pro 1 Mio. Tokens | Bild-Tokens |
| Trial-Key | Kostenlos, 1.000 Aufrufe im Monat | Kostenlos, 1.000 Aufrufe im Monat | Nicht für den Produktionseinsatz |
| Model Vault Small | 3,00 $/Stunde oder 2.000 $/Monat | 3,00 $/Stunde oder 2.000 $/Monat | Pro dedizierter Instanz |
| Model Vault Medium | 5,00 $/Stunde oder 3.250 $/Monat | 5,00 $/Stunde oder 3.250 $/Monat | Pro dedizierter Instanz |
| Amazon SageMaker | 2,39 $ bis 8,48 $ pro Host-Stunde | 2,39 $ bis 3,36 $ pro Host-Stunde | Softwaregebühr plus AWS-Instanzkosten |
| Microsoft Foundry | Noch nicht veröffentlicht (Vorschau) | Noch nicht veröffentlicht (Vorschau) |
Die SageMaker-Preise stammen aus den AWS-Marketplace-Einträgen für Embed 5 Pro, mit einem entsprechenden Eintrag für Fast. Cohere rechnet am Ende jedes Monats ab, oder früher, sobald 250 $ offen sind. Den Rest des Katalogs (Rerank, Parse, Command) finden Sie in meinem ausführlichen Leitfaden zu Cohere-Preisen. Wenn Sie auch PDFs parsen, behandelt die Aufschlüsselung der Parse-5-Preise diesen Posten.
Drei Hinweise zur Abrechnung, die ich vor der Budgetierung gern gewusst hätte:
- Die Anzahl der Bild-Tokens ist nicht dokumentiert. Der Preis gilt pro 1 Mio. Bild-Tokens, aber Cohere veröffentlicht keine Formel für Tokens pro Bild. Die API-Antwort meldet Bilder als Anzahl (
"images": 1). Lassen Sie also einen kleinen Testlauf laufen und lesen Sie die Rechnung, bevor Sie eine Million Seitenbilder einbetten. - Model Vault lohnt sich nur bei sehr hohem Volumen. Eine Small-Instanz für 2.000 $ im Monat entspricht zu API-Preisen etwa 16,7 Milliarden Pro-Tokens oder 25 Milliarden Fast-Tokens. Darunter ist die API günstiger. Wenn Sie Vault wählen, sind die eigentlichen Gründe Isolation und garantierte Kapazität, nicht der Preis.
- Noch nicht auf Bedrock. Amazon Bedrock führt weiterhin Embed 4 mit 0,12 $ pro 1 Mio. Tokens, ohne Embed-5-SKU. OpenRouter hat überhaupt keine Cohere-Embedding-Modelle.
Warum der Token-Preis hier die unwichtigste Zahl ist
Rechnen wir ein realistisches Support-Szenario durch, denn in dieser Welt verbringe ich meine Arbeitstage. Angenommen, Sie haben 2.000 Help-Center-Artikel (je etwa 1.500 Tokens) und 200.000 vergangene Tickets (je etwa 600 Tokens), zusammen rund 123 Millionen Tokens. Alles einmal mit Pro einzubetten kostet etwa 14,76 $. Mit Fast etwa 9,84 $. Fünfzigtausend Kundenfragen im Monat mit je 30 Tokens sind 1,5 Millionen Tokens, etwa 12 Cent bei Fast. Mit anderen Worten: Die Embedding-Rechnung ist praktisch ein Rundungsfehler.
Was sich nicht wegrundet, ist der Speicher, der mit Dimensionen und Präzision skaliert. Coheres eigenes Beispiel: Ein float32-Vektor mit 2048 Dimensionen sind 8 KB, ein int8-Vektor mit 1024 Dimensionen 1 KB und ein binärer Vektor mit 256 Dimensionen 32 Bytes.
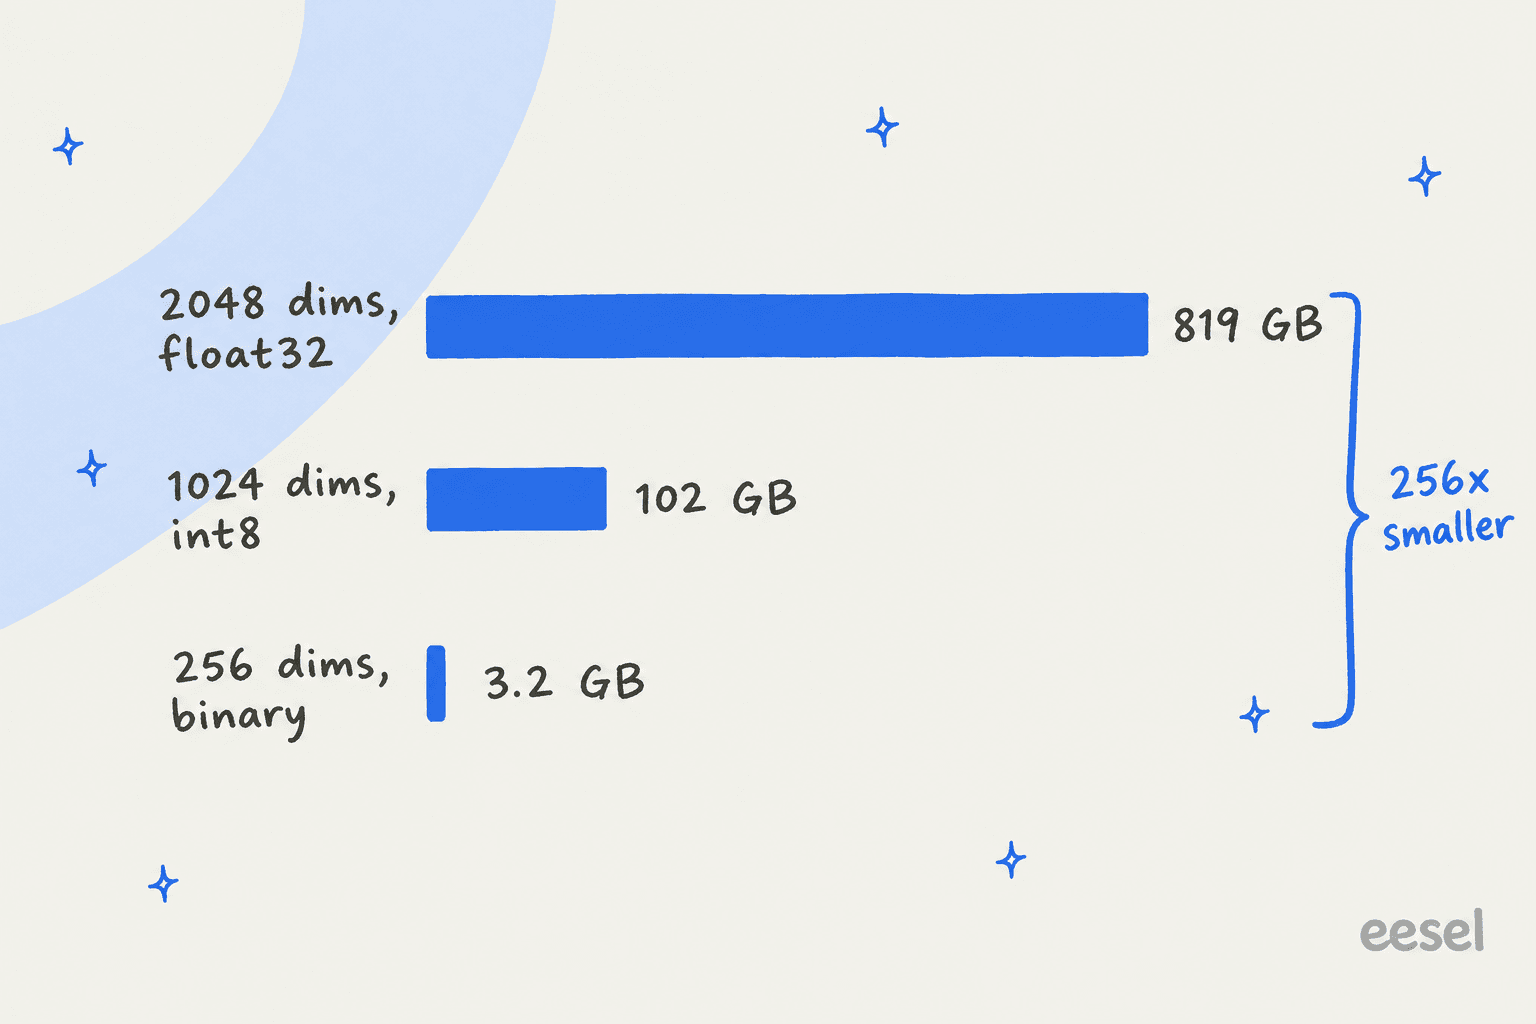
Bei 100 Millionen Chunks belegt die standardmäßige float32-Ausgabe etwa 819 GB an rohen Vektoren. Im Standard-Tarif von Pinecone (oder einem gehosteten Vektorspeicher) mit 0,33 $ pro GB im Monat sind das etwa 270 $ im Monat vor dem Index-Overhead, jeden Monat. Dieselben Chunks als 1024-dim int8 sind etwa 102 GB, rund 34 $ im Monat. Diese 100 Millionen Chunks einmal einzubetten (bei etwa 500 Tokens je Chunk) kostet mit Pro etwa 6.000 $, einmalig. Wählen Sie Dimensionen und Präzision vor der Indexierung, denn eine spätere Änderung heißt, alles von Grund auf neu einzubetten.
Coheres Empfehlung passt dazu: "For most deployments, we recommend 1,024-dimensional int8 vectors as the ideal performance-efficiency point," und int8 "retains near-full-precision retrieval quality." Binär ist die kleinste Variante, verliert etwas Genauigkeit und eignet sich gut als schneller erster Durchgang vor einem Reranker.
Upgrade von Embed 4: Was Sie einplanen sollten
Wenn Sie heute Embed 4 nutzen, ist das Upgrade mehr als nur ein neuer Modellname. Das sollten Sie einplanen:
- Alles neu indexieren. Cohere sagt, dass Pro und Fast einen Raum teilen. Zur Vergleichbarkeit von Embed-4-Vektoren mit Embed-5-Vektoren sagt es nichts, gehen Sie also davon aus, dass sie nicht vergleichbar sind, und planen Sie ein vollständiges Neu-Einbetten ein. Bei den obigen Preisen ist das meist günstig in Dollar, aber teuer in Engineering-Zeit.
- Achten Sie auf die Standarddimension. Embed 4 hatte standardmäßig 1536, Embed 5 hat 2048. Wenn der Index Ihrer Vektordatenbank auf 1536 festgelegt ist, übergeben Sie
output_dimension=1536(Embed 5 unterstützt das) oder bauen Sie den Index neu auf. - Prüfen Sie Ihre Cloud. Wenn Sie Cohere über Bedrock oder Oracle OCI nutzen, ist Embed 5 dort noch nicht verfügbar. Die Launch-Kanäle sind die Cohere API, Model Vault, Microsoft Foundry und SageMaker.
- Batch-Jobs. Cohere sagt, Batch-Embedding sei für großvolumige Aufnahme verfügbar, aber die Tabelle in der Dokumentation führt für v5-Modelle nur den Standard-Embed-Endpunkt auf. Prüfen Sie daher die Unterstützung von Embed Jobs für Ihr Modell, bevor Sie eine Bulk-Pipeline darauf aufbauen.
Bevor Sie dem Modell die Schuld geben (oder das Lob), prüfen Sie zuerst den Rest der Pipeline. Diese Antwort in einem r/Rag-Thread über das Fine-Tuning von Embeddings ist der praktischste Rat zu Modellwechseln, der mir begegnet ist:
"more than I expected. but only after chunking was already clean. dirty chunks make every embedding model look bad."

Das deckt sich mit meiner eigenen Erfahrung. Ein durchgespieltes Beispiel liefert der Leitfaden zur semantischen Suche über Zendesk Guide, der die Chunking-Seite behandelt. Ein besseres Embedding-Modell hilft am meisten, wenn das Chunking bereits solide ist und Sie Hybridsuche und einen Reranker im Einsatz haben.
Wo Embed 5 passt und wo nicht
Embed 5 ist eine großartige Wahl, wenn Sie ein Plattform-Team sind, das einen eigenen Such- oder RAG-Stack baut, besonders über lange, visuell reiche oder Finanzdokumente. Der 128K-Kontext bedeutet weniger unglückliche Chunk-Trennungen, und die zusammengeführte Text-plus-Bild-Eingabe kümmert sich um Folien und gescannte Seiten. Dazu gibt Ihnen die Aufteilung in Pro und Fast einen sauberen Regler zwischen Geschwindigkeit und Qualität. Kombinieren Sie es mit Parse 5, um PDFs in Markdown umzuwandeln, und mit Rerank, um Treffer zu sortieren, und Sie haben Coheres gesamten Retrieval-Stack. Cohere hat außerdem angekündigt, dass die verwaltete Suchplattform Compass Cloud nun in der privaten Beta ist.
"Cohere seems to be doing a lot on the search side this year with their parsing model, Compass Cloud announcement, and now Embed 5... exciting stuff"
Es ist die falsche Ebene des Stacks, wenn Ihr eigentliches Ziel ein Alltagswerkzeug ist, etwa eine KI-Wissensdatenbank für Ihr Team oder eine KI, die Kundenfragen aus Ihrem Help Center und vergangenen Tickets beantwortet. Ein Embedding-Modell liefert Ihnen Vektoren. Sie brauchen weiterhin Chunking, eine Vektordatenbank, einen Reranker, ein Generierungsmodell wie GPT-6.1 Sol, Leitplanken und einen Weg, Antworten in Ihr Helpdesk einzubinden.
Wenn Sie tiefer in die Abwägungen einsteigen wollen, beginnen Sie mit RAG versus reine LLMs. Speziell für Help Center gibt es einen eigenen Leitfaden zu RAG versus Fine-Tuning.
Die härteste Lektion aus dem Betrieb von KI in Live-Support-Warteschlangen hat nichts mit der Retrieval-Qualität zu tun, sondern damit, was passiert, wenn das Retrieval leer zurückkommt. Ich habe Bots zahlender Kunden gesehen, die echten Kunden mit selbstsicheren, erfundenen Behauptungen antworteten, weil die Wissensdatenbank nichts Passendes enthielt und das Modell die Lücke aus seinen Trainingsdaten füllte. Ein besseres Embedding-Modell macht das seltener, aber nicht unmöglich. Die Lösung liegt in der Schicht darüber: ein harter Fallback, wenn nichts Relevantes gefunden wird, und Tests an echten Tickets vor dem Start.
Probieren Sie eesel, wenn Sie die Antworten wollen, nicht die Pipeline
Wenn Sie wegen eines Support-Problems über Embedding-Modelle lesen, ist eesel die Abkürzung. eesel ist eine Plattform für KI-Teammates, und der KI-Helpdesk-Teammate ist der komplette Retrieval-Stack, bereits zusammengebaut: Er verbindet sich mit Ihrem Help Center, Ihrer Dokumentation und Ihren vergangenen Tickets und entwirft oder sendet Antworten in Ihrem Helpdesk, in Slack oder über einen teilbaren Link. Keine Vektoren dimensionieren, kein Index, der neu aufgebaut werden muss, wenn ein neues Modell erscheint.
Er bindet sich in die Helpdesks ein, die die meisten Support-Teams ohnehin nutzen. Bei Zendesk antwortet er aus Makros und gelösten Tickets, bei Freshdesk und Gorgias arbeitet er dieselbe Warteschlange ab wie Ihre Agenten.

Bevor er einen Live-Kunden berührt, simuliert eesel den Rollout an Ihren historischen Tickets, sodass Sie vorab die Antworten sehen, die er gesendet hätte, und die Lösungsrate. So würde ich mir wünschen, dass sich jede automatisierte Ticketlösung ihren Platz in einer Live-Warteschlange verdient.
Und wenn Sie hier sind, weil Sie gern im Terminal arbeiten: Die eesel-CLI lässt Sie denselben Teammate über die Kommandozeile betreiben: eine Integration mit eesel integrations connect verbinden, seine festen Anweisungen bearbeiten, ausstehende Aktionen genehmigen oder ablehnen und jeden Lauf mit eesel activity lesen. Jeder Befehl liefert JSON und unterstützt --dry-run, sodass auch Skripte und Coding-Agenten wie Claude Code ihn steuern können. Es gibt eine vollständige Anleitung zum Verwalten von Agenten im Terminal und einen kürzeren Beitrag zur CLI für den Kundensupport.
eesel testen – kostenlos an Ihren eigenen Tickets.
Häufig gestellte Fragen
Was ist Cohere Embed 5?
embed-v5.0-pro) und Embed 5 Fast (embed-v5.0-fast), beide mit 128K-Token-Kontextfenster und über 100 Sprachen.Was kostet Cohere Embed 5?
0,12 $ pro 1 Mio. Text-Tokens und Embed 5 Fast 0,08 $. Bildeingaben kosten bei beiden 0,40 $ pro 1 Mio. Bild-Tokens. Dedizierte Model-Vault-Instanzen beginnen bei 3,00 $ pro Stunde (2.000 $ im Monat). Die weitere Cohere-Preisliste finden Sie in dieser Übersicht zu Cohere-Preisen.Was ist der Unterschied zwischen Embed 5 Pro und Embed 5 Fast?
Ist Cohere Embed 5 besser als die Embeddings von OpenAI?
Muss ich meine Daten neu einbetten, wenn ich von Embed 4 auf Embed 5 wechsle?
output_dimension daher explizit, wenn Ihr Index-Schema festgelegt ist.Ist Cohere Embed 5 auf Amazon Bedrock verfügbar?
Kann ich Cohere Embed 5 für die Suche im Kundensupport nutzen?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.