Was Xiaomi MiMo V2.6 wirklich ist
Ich baue beruflich Integrationen und APIs, deshalb ist mein erster Instinkt bei jedem Launch dieser Art, die Marketingseite zu überspringen und die Model Card zu lesen. Die MiMo-V2.6-Card hält, was sie verspricht.
MiMo V2.6 ist eine Familie nativ omnimodaler Sprachmodelle mit offenen Gewichten von Xiaomis MiMo-Team, veröffentlicht am 22. September 2026. „Nativ omnimodal" leistet in diesem Satz echte Arbeit: Dasselbe Modell verarbeitet Text, Bilder, Video und Audio, statt nachträglich einen Vision-Adapter an ein Textmodell anzuflanschen. Jeder Checkpoint der Familie kommt mit einem 1-Millionen-Token-Kontextfenster.
Das Release-Motto lautet „Scaling Reinforcement Learning Toward Self-Improvement", und Xiaomi rahmt die gesamte Serie als Schritt auf einem rekursiven Self-Improvement-Pfad: RL-Rechenleistung auf überprüfbare, komplexe Aufgaben skalieren und das Modell seine eigene Fähigkeitsgrenze weiter verschieben lassen. Das ist die Art von Satz, bei der ich normalerweise die Augen verdrehe, aber der Tech-Report hat genug konkrete Methodik dahinter, dass es sich wie Engineering liest und nicht wie eine Pressemitteilung.
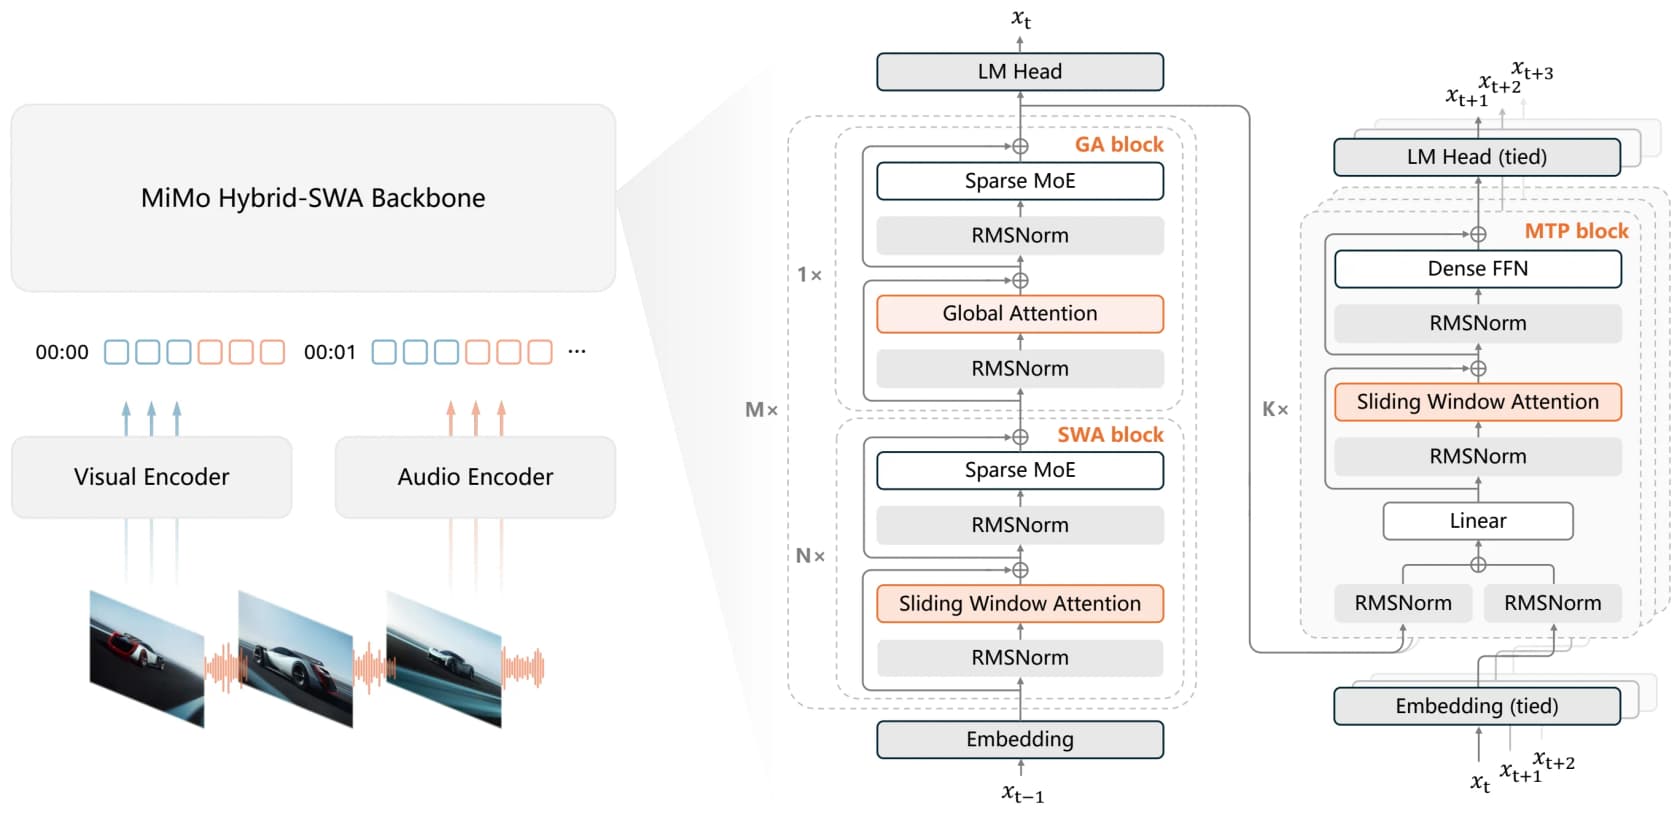
Wenn Sie die Ein-Absatz-Version der Architektur wollen: Pro ist ein spärliches Mixture-of-Experts-Modell mit einem hybriden Attention-Backbone: 70 Schichten, die lokale Sliding-Window-Attention (Fenster 128) mit globaler Attention verschachteln, 384 geroutete Experten, von denen 8 pro Token feuern, ein 681M-Parameter-Vision-Encoder, dedizierte Audio-Encoder und ein 5-schichtiger Multi-Token-Prediction-Decoder, der pro Forward Pass mehrere Token vorhersagt, um das Decoding zu beschleunigen. Um es zu nutzen, müssen Sie sich um nichts davon kümmern, aber es erklärt, wie ein „1-Billionen-Parameter"-Modell günstig zu betreiben bleibt: Nur 42B dieser Parameter sind bei einem gegebenen Token aktiv.
Die Modellfamilie, von Flash bis zu einem Pro mit 1 Billion Parametern
MiMo V2.6 ist nicht ein Modell, sondern vier Checkpoints für vier verschiedene Aufgaben. Genau hier entsteht online ein Großteil der Verwirrung, deshalb lohnt es sich, das klar aufzuschlüsseln.
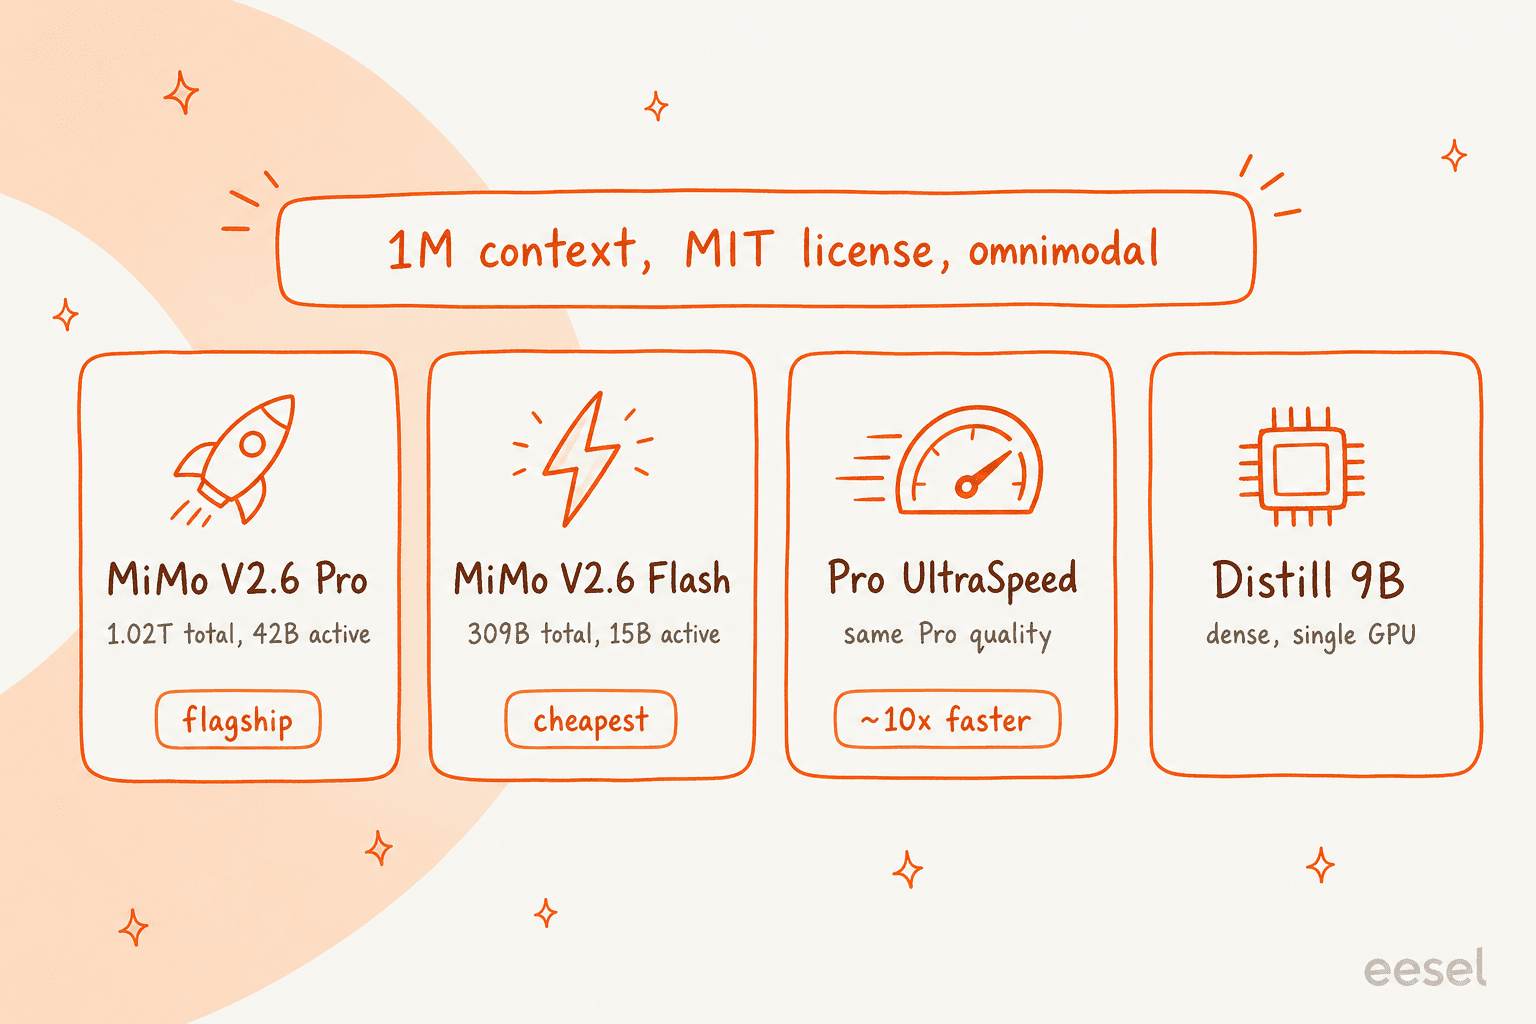
| Modell | Architektur | Parameter gesamt | Aktive Parameter | Kontext | Am besten für |
|---|---|---|---|---|---|
| MiMo V2.6 Pro | Sparse MoE | 1,02T | 42B | 1M | Die anspruchsvollste, langfristige agentische Arbeit |
| MiMo V2.6 Flash | Sparse MoE | 309B | 15B | 1M | Die beste Balance aus Intelligenz, Geschwindigkeit und Kosten |
| MiMo V2.6 Pro UltraSpeed | Derselbe Pro-Checkpoint, Speed-Build | ~1T | 42B | 1M | Pro-Qualität, wenn schnelle Ausgabe zählt |
| MiMo V2.6 Distill-Qwen-9B | Dense (SFT von Qwen3.5-9B) | 9B | 9B | n/a | Single-GPU- und offene agentische RL-Forschung |
Ein paar Dinge sind hervorzuheben. Pro wird als Xiaomis bislang leistungsfähigstes Modell vermarktet. Flash ist das Modell, zu dem die meisten tatsächlich greifen werden, da es die Balance bietet, die sich die meisten Workloads wünschen. UltraSpeed ist derselbe Pro-Checkpoint, nur mit rund 10-facher Ausgabegeschwindigkeit ausgeliefert (Xiaomis Blog behauptet sogar bis zu 20-fach), was viel ausmacht, wenn Sie Antworten an einen wartenden Nutzer streamen. Und das 9B-Distill ist ein überwachtes Fine-Tuning von Qwen3.5-9B auf von MiMo generierten Daten, veröffentlicht als Ausgangspunkt für offene Forschung und nicht als Produktivmodell.
Der eigentliche Sprung liegt zwischen den Generationen. Das vorherige Flaggschiff, MiMo V2.5 Pro, erzielte 19,0 Punkte auf dem DeepSWE-v1.1-Coding-Benchmark. V2.6 Pro erzielt auf derselben Rangliste 71,9. Bei Terminal Bench 4.0 ging es von 1,5 auf 34,9. Das sind keine schrittweisen Fortschritte, sondern die Art von Sprung, die man nur sieht, wenn ein Labor seinen Trainingsansatz ändert, was laut Xiaomi genau passiert ist.
Die Benchmarks, mit denen Xiaomi führt, und die, bei denen nicht
Jeder Modell-Launch pickt sich seine Charts heraus, deshalb bin ich direkt zur Evaluationstabelle auf der Model Card gegangen, die MiMo V2.6 mit Claude Opus 5, GPT-5.6 Sol und Claude Fable 5 vergleicht. Hier ist die ehrliche Aufteilung.
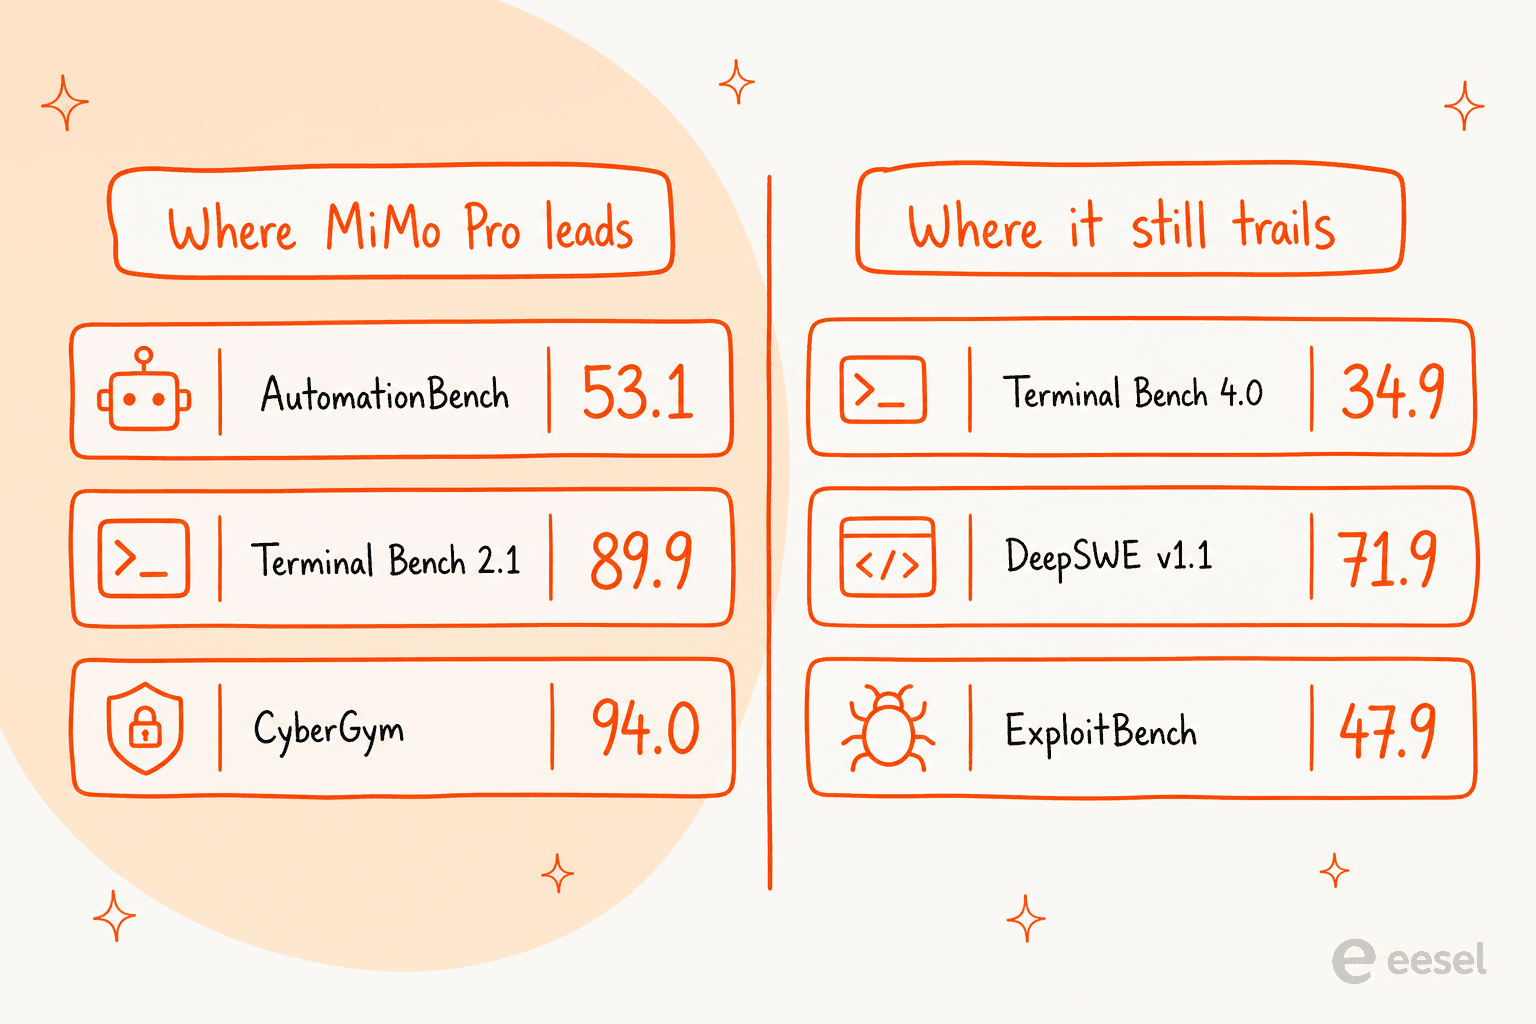
Wo Pro nach Xiaomis Zahlen die geschlossene Spitzenklasse klar anführt:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| MiMo Visual Coding | 72,3 | 70,0 | 73,4 |
Und wo es zurückliegt, was Xiaomi ehrenhalber direkt neben den Erfolgen veröffentlicht:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
Das Muster ist konsistent und, wie ich finde, glaubwürdig: MiMo V2.6 Pro ist bei allgemeinen agentischen Aufgaben und Tool-Nutzung ganz vorn mit dabei und fällt bei den schwierigsten langfristigen Coding- und Exploit-Benchmarks zurück. Als Xiaomi den Vergleich in seinem Launch-Blog um GPT-6 Astra, DeepSeek V4.1 Flash und GLM 5.3 erweiterte, hielt dieselbe Form: Pro liegt bei AutomationBench und Terminal Bench 2.1 nahe an der Spitze des Feldes und hinter GPT-6 Astra bei Terminal Bench 4.0 (59,6) und ExploitGym.
Eine Zahl verdient eine Anmerkung. Pro erzielt einen bemerkenswerten Wert von 94,0 bei CyberGym (Flash liegt mit 95,1 sogar noch höher), wo das vorherige V2.5 Pro nur 40,0 schaffte. Cybersicherheit ist eindeutig ein Bereich, in dem Xiaomi intensiv trainiert hat, auch wenn das deutlich kompetitivere ExploitBench eine bescheidenere Geschichte erzählt, weshalb ich das CyberGym-Ergebnis eher als beeindruckend denn als endgültig einordnen würde.
Die unabhängige Kennzahl, die mehr zählt als jede einzelne Rangliste
Einzelne Benchmarks sind verrauscht. Der aggregierte Index von Artificial Analysis ist derjenige, den ich tatsächlich beobachte, weil er viele Evaluationen zu einem einzigen vergleichbaren Score zusammenfasst und ihn entscheidend gegen die Kosten aufträgt.
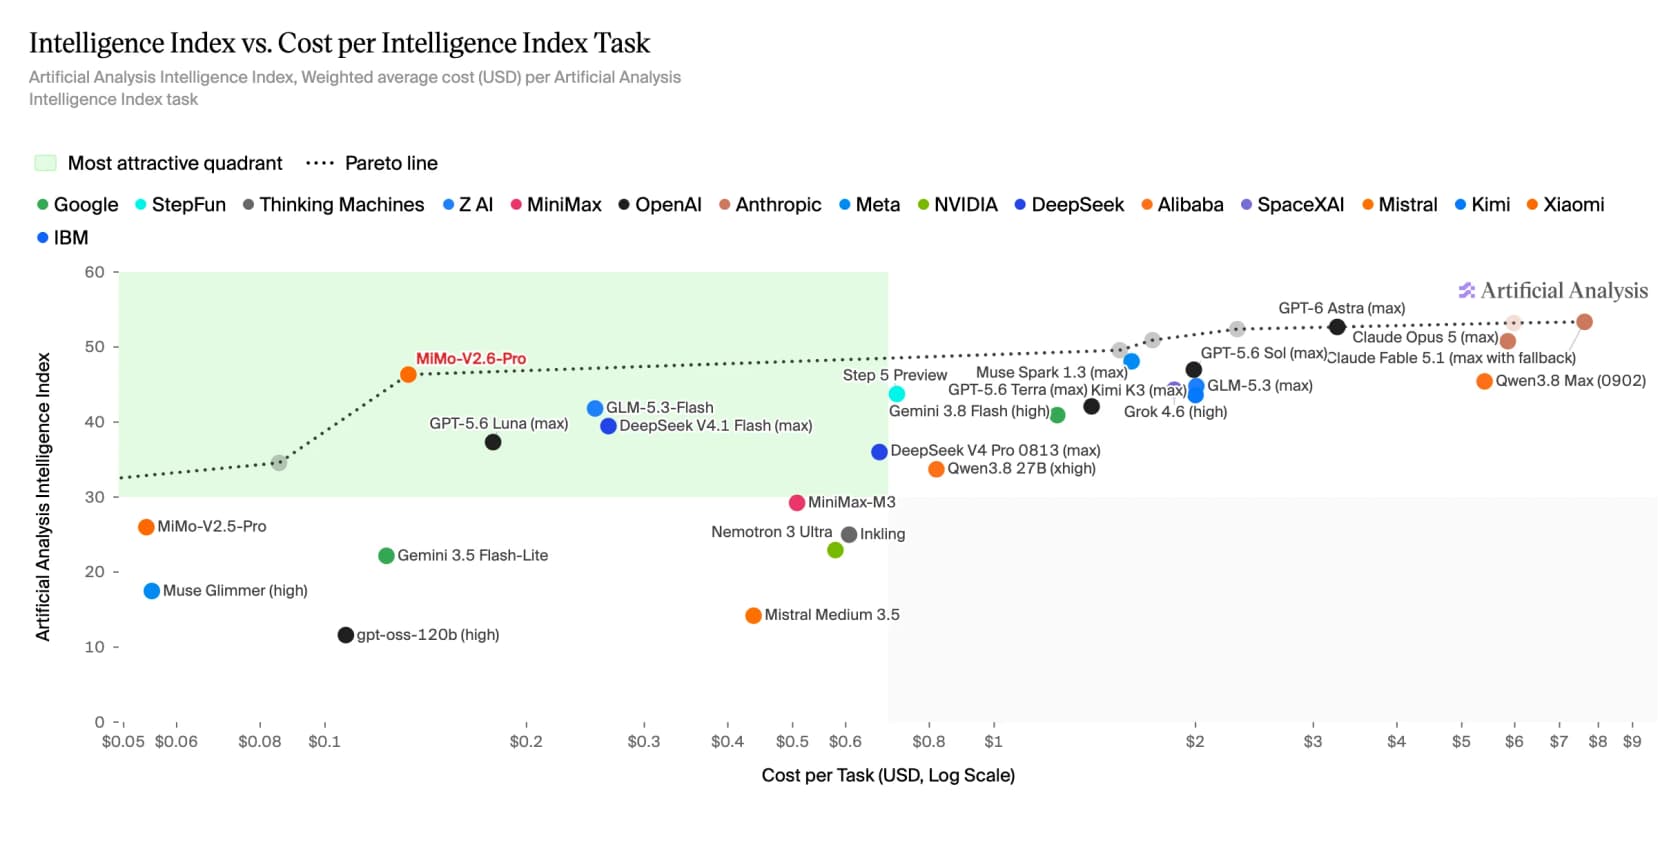
MiMo V2.6 Pro erreicht einen Intelligence Index von 46, das beste Modell mit offenen Gewichten in der Rangliste, und liegt damit in dem, was Artificial Analysis wörtlich als „attraktivsten Quadranten" bezeichnet. Die geschlossene Spitzenklasse erzielt bei der reinen Intelligenz höhere Werte (GPT-6 Astra, Opus 5 und Fable 5.1 liegen alle im unteren bis mittleren 50er-Bereich), aber sie tut dies zu 3 bis 8 $ pro Aufgabe. MiMo erreicht seine 46 für etwa 0,13 $.
Dieses Verhältnis von Preis zu Intelligenz ist der ganze Pitch, und deshalb hat dieser Launch einige Nerven blankgelegt. Wie es ein Kommentator im Launch-Thread formulierte, sei das Modell „im grünsten Quadranten von Intelligenz gegen Geschwindigkeit bei AA gelandet", während der Preis identisch zur Vorgängergeneration blieb. Wenn Sie 85 bis 90 % der Intelligenz der Spitzenklasse für ein Vierzigstel der Kosten bekommen, ändert sich die Rechnung für viele Anwendungsfälle.
Wie man es tatsächlich betreibt: Gewichte, API und Preis
Das ist der Teil, der mich am meisten interessiert, denn ein Benchmark-Score ist nutzlos, wenn Sie das Modell nicht in Ihren Stack bekommen. MiMo V2.6 ist erfreulich einfach zugänglich, egal ob Sie selbst hosten oder einfach einen Endpunkt ansprechen wollen.
Die Gewichte sind unter einer MIT-Lizenz offen, was so freizügig ist, wie es nur geht (kommerzielle Nutzung erlaubt, kaum Bedingungen). Sie können Pro, Flash und das 9B-Distill von Hugging Face und ModelScope herunterladen, und Xiaomi liefert einen FP8-Checkpoint, sodass Sie nicht zur vollen Präzision gezwungen sind.
Bei der Hardware sollten Sie realistisch bleiben, was Pro benötigt. Der eigene Startbefehl der Model Card betreibt Pro über zwei Knoten mit 16-facher Tensor-Parallelität, das ist also ein Multi-Node-GPU-Cluster und nichts, das man auf einer übrig gebliebenen Workstation hochfährt. Flash ist mit einem einzelnen 8-GPU-Knoten deutlich zugänglicher, und das 9B-Distill läuft auf einer einzelnen GPU, mit bereits verfügbaren Community-GGUF-Quants für llama.cpp, LM Studio und Ollama. Wenn Sie unsere Artikel zu individuellen KI-Modellen verfolgt haben, überrascht Sie das nicht: Offene Gewichte sind kostenlos, aber die Betriebsrechnung ist real.
Wenn Sie ganz auf Infrastruktur verzichten möchten: MiMo V2.6 ist auf Xiaomis eigener API-Plattform, in MiMo Studio und Desktop sowie auf OpenRouter gehostet. Hier sind die OpenRouter-Preise pro Million Token, geprüft in der Launch-Woche:
| Modell | Input / 1M | Output / 1M | Kontext |
|---|---|---|---|
| MiMo V2.6 Flash | 0,14 $ | 0,28 $ | 1M |
| MiMo V2.6 Pro | 0,435 $ | 0,87 $ | 1M |
| MiMo V2.6 Pro UltraSpeed | 4,35 $ | 8,70 $ | 1M |
Zwei Dinge fallen auf. Flash ist mit 0,14 $ Input / 0,28 $ Output günstig für ein omnimodales Modell mit 1M Kontext. Und UltraSpeed ist ein sauberes 10-Faches sowohl bei Geschwindigkeit als auch beim Preis von Pro, also eine bewusste Prämie für latenzkritische Arbeit, kein besseres Modell. Für die meisten Teams ist Flash die vernünftige Standardwahl, und Pro ist das, worauf man eskaliert, wenn eine Aufgabe es wirklich braucht.
Was die Leute nach dem Ausprobieren gesagt haben
Benchmarks sind Xiaomis Geschichte. Ich wollte die Geschichte der Nutzer, also habe ich die Launch-Diskussion durchgelesen, und die vorherrschende Reaktion drehte sich überhaupt nicht um die Scores. Es ging darum, wie offen Xiaomi das Modell trainiert hat.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Dieses Detail über das Verwerfen eines Cyber-Datensatzes, weil er die Coding-Scores verschlechtert hat, ist genau die Art von Zugeständnis, das Labore öffentlich fast nie machen, und es ist ein großer Grund dafür, dass der Launch selbst bei Skeptikern Vertrauen gewonnen hat. Die schärfste technische Einschätzung im Thread kam von einem langjährigen MiMo-Nutzer, der die Ranglisten selbst durchgezählt hat:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
Es war nicht nur Lob. Die wiederkehrende Sorge, die jedes starke offene Modell aus China begleitet, ist Benchmaxxing: großartige Scores, enttäuschende reale Arbeit. Ein Kommentator wurde bei der Vorgängergeneration deutlich:
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
Das Gegengewicht kam von Leuten, die die Linie bereits produktiv einsetzen. Die Einschätzung eines Softwareentwicklers zur Wert-Rechnung ist die, an die ich immer wieder denke:
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models (late last year/early this year)... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
Erwähnenswert ist, dass sich dieses letzte Zitat auf V2.5 bezieht, das mehrere Leute bei schwierigeren Aufgaben auch „schnell, aber dumm" nannten, weshalb der eigentliche Test für V2.6 ist, ob es diese Lücke im täglichen Einsatz schließt und nicht nur auf den Charts. Auf X wurde der Launch größtenteils als Seitenhieb gegen Grok 4.7 gelesen, das am selben Tag erschien, mit Reaktionen, die von „Besser als Grok 4.7" bis zu einem gemäßigteren „Warten wir erst mal die Praxistests ab." reichten.
Wo MiMo V2.6 in das Rennen der offenen Modelle passt
Tritt man einen Schritt zurück, ist MiMo V2.6 ein weiterer Datenpunkt in einem Trend, der immer schwerer zu übersehen ist: Modelle mit offenen Gewichten aus chinesischen Laboren landen immer wieder nahe an der Spitzenklasse, während sie auf deutlich günstigerer Hardware laufen. DeepSeek V4.1 Flash, GLM 5.3, Qwen 3.8 Max und jetzt MiMo V2.6 liefern sich alle Duelle in derselben Intelligenzklasse, die früher allein den geschlossenen Modellen gehörte.
Dahinter steckt ein echter strategischer Sog, und ein Kommentator hat das gut formuliert:
"Chinese models are increasingly closer to the frontier, while being able to run on much cheaper hardware than what US frontier models run on... the rest of the world is going to see the risks and the availability of good enough open weight models for their purposes and be more likely to lean in favor of self-hosted Chinese models or local inference clouds."
Das ist die eigentliche Wettbewerbsgeschichte: nicht „schlägt MiMo Opus auf einer Rangliste", sondern „bekommt man gut genug Intelligenz auf eigener Hardware zu einem Preis, der die geschlossene Spitzenklasse wie einen Luxus wirken lässt". Für viele Teams lautet die Antwort inzwischen ja. Wenn Sie einen breiteren Überblick wollen, ist unsere Zusammenstellung der besten Open-Source-KI-Agenten eine gute nächste Lektüre, und unser DeepSeek-Review sowie unser Kimi-K3-Review decken die engsten offenen Konkurrenten ab.
Was das bedeutet, wenn Sie KI auf eine Support-Queue setzen
Hier muss ich ehrlich zu meiner eigenen Voreingenommenheit sein, denn ich habe die letzten Jahre damit verbracht, KI auf laufende Support-Queues zu bringen, und der MiMo-V2.6-Launch bestätigt etwas, das wir auf die harte Tour gelernt haben: das Modell ist nicht mehr der Engpass.
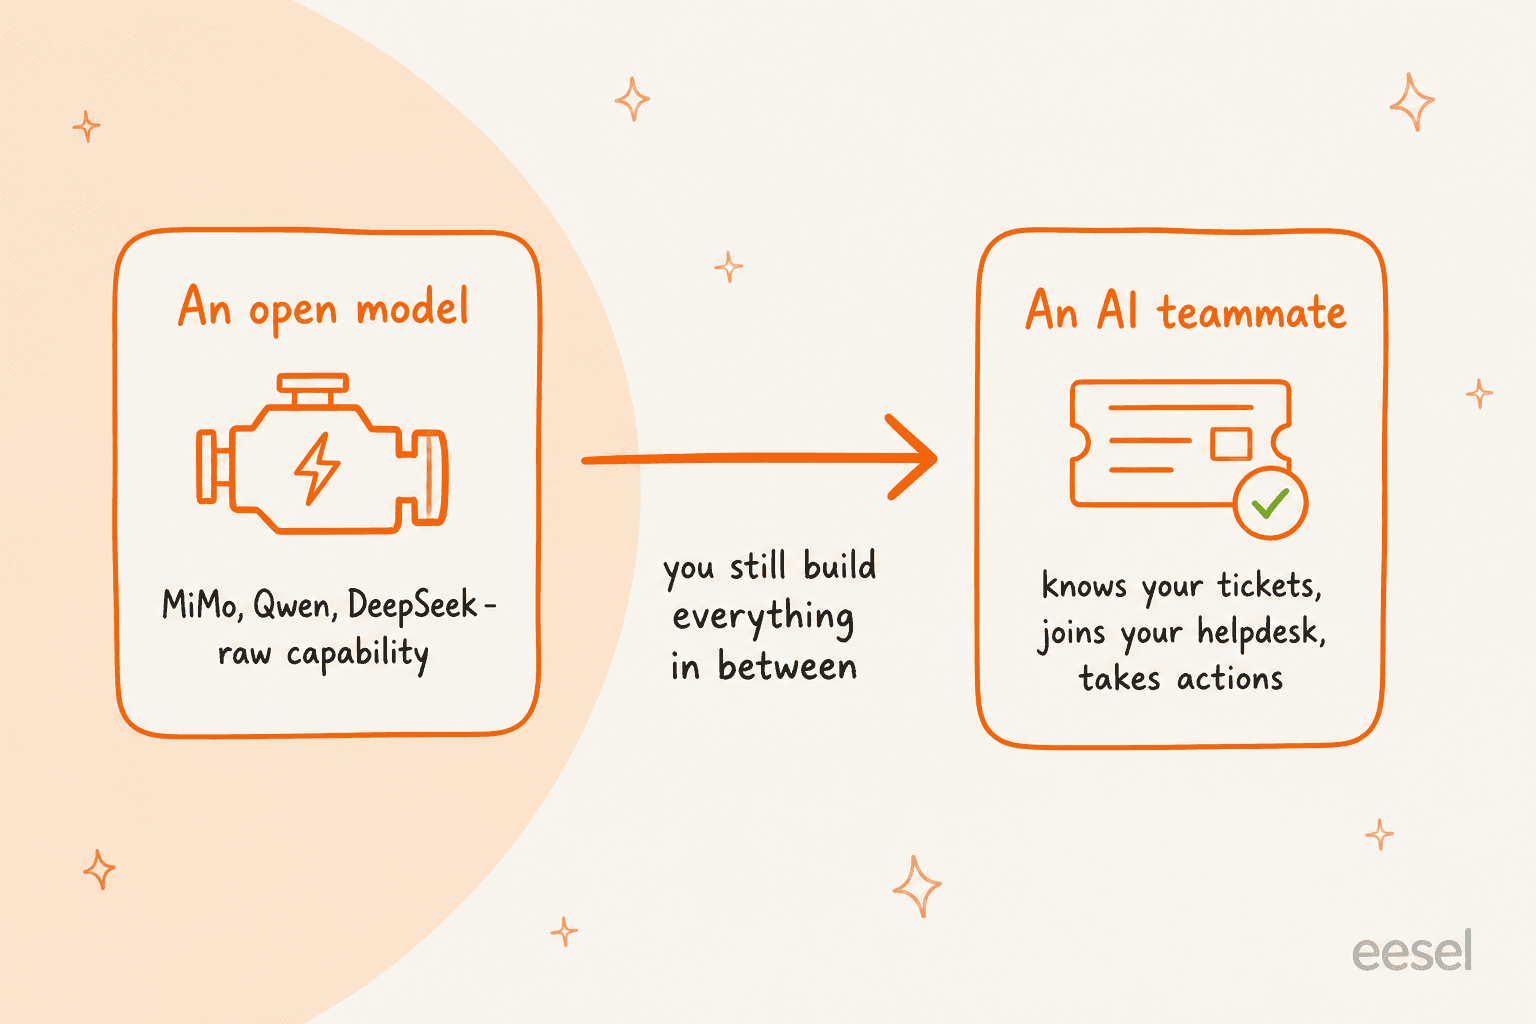
MiMo V2.6, DeepSeek, Qwen, Claude, GPT: Jedes von ihnen kann eine flüssige, korrekt klingende Antwort auf eine Kundenfrage schreiben. Das war vor ein paar Jahren der beängstigende Teil. Er ist jetzt gelöst. Was keines von ihnen von sich aus leistet, ist die eigentliche Aufgabe: Ihr spezifisches Hilfecenter und vergangene Tickets lesen, Ihre Rückerstattungsrichtlinie statt einer plausibel klingenden erfundenen befolgen, eine Bestellung nachschlagen, das Ticket taggen und weiterleiten, wissen, wann an einen Menschen eskaliert werden muss, und, am wichtigsten, getestet werden, bevor es einem echten Kunden antwortet.
Diesen letzten Punkt würde ich nicht kompromittieren. Wir haben erlebt, wie selbstbewusst klingende Modelle auf echten Queues falsche Antworten geben, weshalb jeder Rollout, den wir durchführen, zuerst an historischen Tickets simuliert wird, sodass Sie sehen, wie er Tausende Ihrer vergangenen Gespräche gehandhabt hätte, bevor er ein echtes berührt. Ein Benchmark-Score von 46 im AA-Index sagt Ihnen nichts darüber, wie ein Modell mit Ihrer eigenwilligen Rückgaberichtlinie im Grenzfall umgeht. Eine Simulation über Ihre letzten 5.000 Tickets schon.
Wenn Sie also von MiMo V2.6 begeistert sind (und das sollten Sie sein, es ist ein großartiger Motor), lautet die richtige Frage nicht „welches Modell", sondern „was umgibt das Modell". Das Modell ist inzwischen eine Massenware. Das System drumherum ist das Produkt.
eesel ausprobieren
Der ganze Punkt dieses Beitrags ist, dass ein offenes Modell wie MiMo V2.6 Infrastruktur ist, rohe Leistungsfähigkeit, die Sie erst noch in etwas verwandeln müssen, das eine Aufgabe erledigt. eesel ist die Schicht, die aus einem Modell einen funktionierenden Teamkollegen macht. Sie stellen einen einsatzbereiten KI-Helpdesk-Agenten ein, der sich in den Helpdesk einklinkt, den Sie bereits nutzen (Zendesk, Freshdesk, Gorgias, Help Scout und 1000+ Integrationen), auf Ihren vergangenen Tickets und Ihrem Hilfecenter trainiert und beginnt, Antworten zu entwerfen oder zu versenden, ganz ohne Model-Ops.

Der Unterschied ist das, was MiMos eigene Benchmarks Ihnen nicht geben können: Bevor ein eesel-Agent einem einzigen echten Kunden antwortet, simulieren Sie ihn an Ihrer echten Ticket-Historie und sehen die genaue Lösungsrate und die Antworten, die Sie erhalten hätten. Und weil eesel eine Teamkollegen-Plattform ist, läuft auf demselben Account auch ein KI-Blog-Autor, falls Ihnen gefallen hat, was MiMo fürs Engineering leistet: Auch für das Schreiben gibt es einen Teamkollegen. Für Entwickler stellt eesel denselben Teamkollegen über ein öffentliches CLI, API und MCP bereit, sodass eine Person, ein Skript oder ein Coding-Agent es alle vom Terminal aus steuern können.
Sie können kostenlos starten, ohne Kreditkarte und ohne Verkaufsgespräch, und in wenigen Minuten einen live einsatzbereiten Teamkollegen haben. Das Modell ist günstig geworden. Es tatsächlich dazu zu bringen, die Arbeit zu erledigen, ist immer noch der interessante Teil.
Häufig gestellte Fragen
Was ist Xiaomi MiMo V2.6?
Was kostet Xiaomi MiMo V2.6?
Ist Xiaomi MiMo V2.6 besser als DeepSeek oder Kimi K3?
Kann ich Xiaomi MiMo V2.6 selbst hosten?
Sollte ich Xiaomi MiMo V2.6 für den Kundensupport einsetzen?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.