Die 8 besten Xiaomi MiMo V2.6 Alternativen 2026

Rama Adi Nugraha

Katelin Teen
Zuletzt bearbeitet September 23, 2026
Warum nach einer MiMo V2.6 Alternative suchen
Lassen Sie mich zunächst fair zu MiMo sein, denn es hat die Aufmerksamkeit verdient. Das 1T-Parameter-Pro-Modell führt das 2,8T-Parameter-Modell Kimi K3 in 14 von 15 Benchmarks an, die ein Kommentator von Hand ausgezählt hat, und das bei einem Bruchteil der Größe, wobei Xiaomi den Preis gegenüber V2.5 konstant gehalten hat. Es ist MIT-lizenziert, nativ omnimodal und kommt mit einem 1M-Token-Kontext. Die Reaktion der Community fiel ungewöhnlich warm aus, und zwar vor allem wegen der Transparenz und weniger wegen der Scores.
Warum also überhaupt vergleichen? Ein paar ehrliche Gründe:
- Der Benchmark-Vorsprung ist dort am schmalsten, wo es am meisten zählt. Bei Terminal Bench 4.0 erreicht MiMo-V2.6-Pro 34,9 Punkte, deutlich unter GPT-6 Astras 59,6 und Claude Opus 5s 49,0. Bei den schwierigsten echten Coding-Ranglisten führt MiMo das offene Feld günstig an, liegt aber hinter den Spitzenmodellen zurück. Wenn Ihre Arbeit auf diesen Aufgaben basiert, kann sich die zusätzliche Ausgabe für ein Spitzenmodell auszahlen.
- Datenresidenz ist eine echte Einschränkung. Die gehostete API von MiMo läuft unter chinesischem Recht, und das Selbst-Hosting des Pro-Checkpoints erfordert eine 2-Node-, 16-GPU-Box. Für regulierte oder Kundendaten ist das ein echtes Hindernis, keine Kleinigkeit.
- Skepsis gegenüber "Benchmaxxing". Eine wiederkehrende Sorge in der Community ist, dass Index-Vorsprünge den Produktionscode nicht überstehen. Ein Hacker-News-Kommentator brachte es unverblümt auf den Punkt:
"No chinese lab has caught up yet... the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."

Das ist eine Sichtweise, und das Gegenteil wird auch gut begründet (viele Entwickler berichten, dass die günstigen chinesischen Modelle plus ein überwachendes Spitzenmodell die teuren US-Modelle beim ROI schlagen). Aber gerade diese Uneinigkeit ist der Grund, Ihre Alternativen zu kennen.
Wie ich diese Alternativen ausgewählt habe
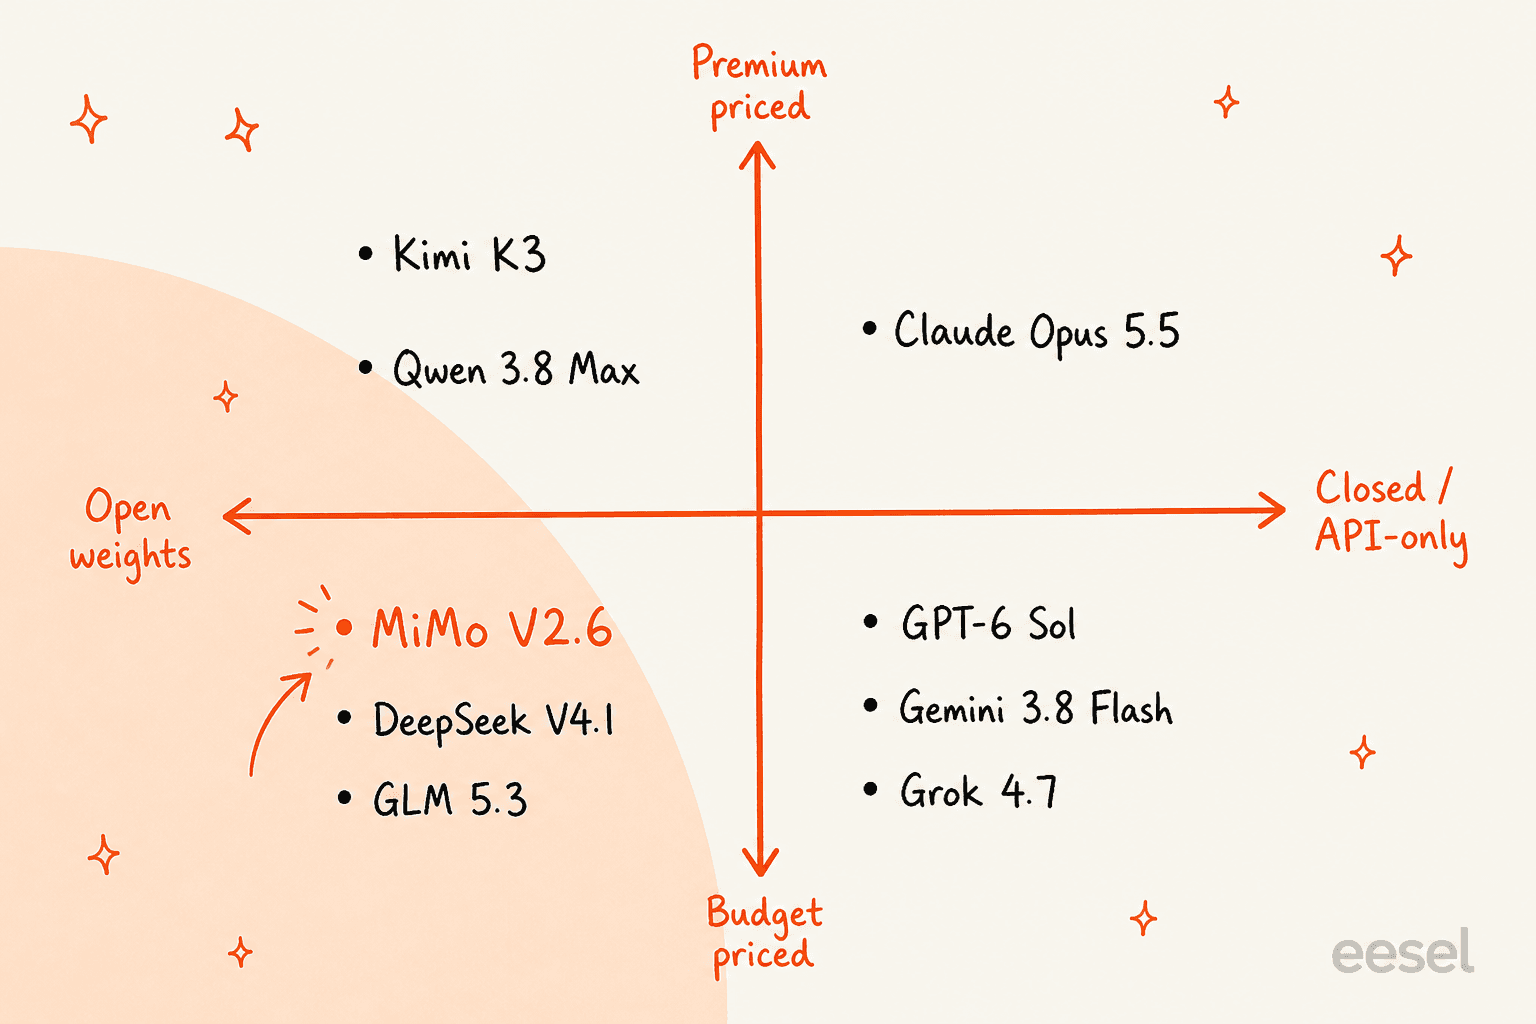
Ich habe die Shortlist auf Modelle beschränkt, die tatsächlich verfügbar sind und die ein echtes Team neben MiMo V2.6 in Betracht ziehen würde. Das bedeutete drei Filter: aktuell (alle wurden in den letzten Monaten von 2026 gestartet oder neu bepreist), vergleichbar (sie tauchen in denselben Benchmark-Tabellen auf, an denen MiMo gemessen wird) und eigenständig (jedes gewinnt auf einer anderen Achse, damit die Liste nicht acht Varianten desselben Kompromisses ist).
Ich habe mich bei jeder Zahl auf Primärquellen gestützt: die eigenen Modellkarten und Preisseiten der Anbieter, OpenRouter-Listings und den Artificial-Analysis-Index für eine neutrale Einschätzung von Intelligenz gegen Kosten. Wo die Community einen scharfen, überprüfbaren Punkt hatte, habe ich ihn mit einem Permalink zitiert. Die Preise unten sind pro 1M Token, sofern nicht anders angegeben.
MiMo V2.6 Alternativen auf einen Blick
| Modell | Typ | Parameter | Kontext | Preis /1M (ein / aus) | AA Intelligence | Am besten für |
|---|---|---|---|---|---|---|
| MiMo V2.6 Pro | Offen (MIT) | 1.02T / 42B aktiv | 1M | $0.435 / $0.87 | 46 | Günstigstes Spitzenmodell mit offenen Gewichten |
| DeepSeek V4.1 | Offen (MIT) | 552B MoE | 1M | $0.15 / $0.60 (außerhalb Spitzenzeiten) | Workhorse-Klasse | Günstiges toolnutzendes Arbeitspferd |
| Kimi K3 | Offen | 2.8T / 104B aktiv | 1M | $3 / $15 | 57 | Größtes offenes Modell |
| Qwen 3.8 Max | Offen (gehostet) | 2.4T / 95B aktiv | 1M | $2 / $6 | 58 | Lokal-freundliche kleine Varianten |
| GLM 5.3 Flash | Offen | 320B / 18B aktiv | 1M | $0.15 / $0.50 | 57 | Günstiges Open-Modell für echten Code |
| Claude Opus 5.5 | Geschlossen | Nicht angegeben | 1M | $5 / $25 | 58 | Höchste Reasoning-Obergrenze |
| GPT-6 Sol | Geschlossen | Nicht angegeben | 1.05M | $2 / $10 | 48 | Günstigste pro abgeschlossener Aufgabe |
| Gemini 3.8 Flash | Geschlossen | Nicht angegeben | 1M | $0.75 / $3.75 | 59 | Riesiger multimodaler Kontext |
| Grok 4.7 | Geschlossen | Größeres Basismodell | 500K | $2 / $6 | 46 | Agenten-Loops im großen Umfang, Live-X-Daten |
1. DeepSeek V4.1
Am besten für: Teams, die das günstigste leistungsfähige offene Modell mit echter Erfolgsbilanz wollen.
DeepSeek V4.1 Flash wurde am 10.09.2026 allgemein verfügbar, und DeepSeek hat das ältere V4 Pro darin aufgehen lassen und diese Anfragen zu Flash-Tarifen an V4.1 Flash geleitet. Es ist das Referenzmodell für chinesische offene Modelle, und MiMo wird immer wieder als das günstigere Backup zu ihm dargestellt und nicht umgekehrt. Die Architektur ist wirklich neuartig: ein 552B-Parameter kausaler Encoder-Decoder, der 8B aktive Parameter für die Eingabe und 16B für die Ausgabe verwendet, mit einem KV-Cache, der etwa 4x kleiner ist als in der letzten Generation. Die Gewichte sind MIT-lizenziert mit nativ integriertem Vision-Support.
In DeepSeeks eigener Tabelle führt V4.1 bei Terminal-Bench 2.1 (90,6), DeepSWE (74,2) und HLE-mit-Tools (63,9, knapp über Opus 5). Community-Benchmarks messen 250-400 Token/Sekunde, womit Gemini Flash als schnellste Option, die viele ausprobiert hatten, abgelöst wird.
Vorteile:
- Günstigstes ernstzunehmendes offenes Modell: Eingabe außerhalb der Spitzenzeiten mit Cache-Miss kostet 0,15 $, Ausgabe 0,60 $ pro 1M, und die Nebenzeit deckt die meisten Geschäftsstunden in den USA und der EU ab.
- MIT-Gewichte, native multimodale Vision, 1M-Kontext.
- Ein bewährtes, weit verbreitetes Arbeitspferd, keine Woche-eins-Veröffentlichung.
Nachteile:
- Das rohe Reasoning ist der Schwachpunkt: HLE von 36,8 liegt unter GPT-6 Sol und Opus 5. Es ist ein Tool-Nutzer, kein Reasoning-Champion.
- Spitzenzeit-Tarife (01:00-04:00 und 06:00-10:00 UTC) verdoppeln den Preis, sodass die Kosten ein bewegliches Ziel sind.
- Die kostenpflichtigen API-Bedingungen schweigen zur Nutzung für Training, statt es zu erlauben, und Daten werden in der VR China verarbeitet, also überlegen Sie zweimal, bevor Sie Kundendaten durchleiten.
Fazit: Wenn Sie der Preis von MiMo angezogen hat, ist DeepSeek V4.1 der direkteste Wechsel und mit ziemlicher Sicherheit die sicherere Wahl bei der Reife. Wählen Sie es, wenn Sie einen günstigen Motor für toolintensive Arbeit wollen und mit dem Datenresidenz-Vorbehalt leben können.
2. Kimi K3
Am besten für: Teams, die das größte offene Modell auf dem Markt wollen und bereit sind, für die Obergrenze zu zahlen.
Moonshots Kimi K3 startete am 16.07.2026 als 2,8T-Parameter-Modell mit 104B aktiv, und Moonshot hat die offenen Gewichte pünktlich veröffentlicht, was nicht jedes Labor tut. Es erreicht 57 Punkte im Artificial-Analysis-Index, gut für Platz vier insgesamt, und ist das Modell, mit dem MiMo am häufigsten verglichen wird, um den Punkt Größe-gegen-Leistung zu belegen.
Der Haken ist, dass K3 der Ort ist, an dem die Lektion "größer ist nicht günstiger" zuschlägt. Seine API kostet 3 $ Eingabe und 15 $ Ausgabe pro 1M, dasselbe Band wie ein mittelklassiges geschlossenes Modell, und Reasoning kann auf keiner Stufe abgeschaltet werden. Diese Auszählung von GodelNumbering ist es wert, zitiert zu werden, weil sie genau die Spannung einfängt:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Vorteile:
- Offene Gewichte, 1M-Kontext, native Vision, starke allgemeine Intelligenz (AA-Index 57).
- Wirklich leistungsfähig bei schwierigem Reasoning, wo MiMo schwächer ist.
Nachteile:
- Etwa 50x MiMos Ausgabepreis bei 15 $ pro 1M, und etwa auf demselben Niveau wie die Claude-Sonnet-Preisklasse.
- Reasoning ist immer aktiv, also ist es ein Latenzkosten-Faktor, den Sie nicht herunterregeln können.
- 1.561 GB an Gewichten machen Selbst-Hosting zu einem ernsthaften Hardware-Projekt.
Fazit: K3 ist das offene Modell, zu dem Sie greifen, wenn Sie maximale Leistungsfähigkeit wollen und die Größe Sie nicht abschreckt, aber beim reinen Preis-Leistungs-Verhältnis schlagen sowohl MiMo als auch DeepSeek es. Wählen Sie K3, wenn die Obergrenze wichtiger ist als die Rechnung.
3. Qwen 3.8 Max
Am besten für: Teams, die eine offene Modellfamilie mit wirklich lokal-freundlichen kleinen Varianten wollen.
Alibabas Qwen 3.8 Max wurde am 02.08.2026 allgemein verfügbar, ein 2,4T / 95B-aktiv-MoE mit 1M-Kontext. Im Artificial-Analysis-Ranking liegt es auf Platz 6 mit einem Index von 58, und es ist auch auf LMArena stark (Text #5, Vision #2). Die API-Preise liegen bei 2 $ Eingabe und 6 $ Ausgabe pro 1M über Qwen Cloud.
Der Grund, warum Qwen immer wieder als MiMo-Alternative auftaucht, ist die Familie, nicht nur das Flaggschiff. Der Community-Favorit für lokale Inferenz sind die kleineren Qwen-Modelle, die ein Kommentator als "crazy good for how small it is" bezeichnete und die sich unbegrenzt auf einer Workstation-Klasse-Box betreiben lassen. Die gehosteten Max-Gewichte wurden veröffentlicht, aber unter einer nicht-Apache-Lizenz; die freizügige, wirklich lokale Option ist das kleinere Qwen3.8-27B (Apache 2.0).
Vorteile:
- Starke allgemeine Intelligenz (AA 58) und ausgezeichnete Werte bei menschlichen Präferenzen.
- Eine echte Größenleiter, einschließlich eines freizügig lizenzierten kleinen Modells für lokale Läufe.
- Vernünftige gehostete Preise mit 2 $ / 6 $.
Nachteile:
- Das gehostete Max und die offene Basis sind nicht feature-gleich (Vision, Non-Thinking und 1M-Standardkontext sind nur gehostet verfügbar).
- Der eigene Coding-Harness begrenzt die Ausgabe auf 65K Token, sodass er von Haus aus nie die volle 131K-Obergrenze abruft.
- Automatisierte Composite-Scores und menschliche Präferenzen zeigen in unterschiedliche Richtungen, also vertrauen Sie keinem einzelnen Zahlen-Urteil.
Fazit: Qwen 3.8 Max ist die Wahl, wenn Sie eine offene Familie wollen, in die Sie hineinwachsen können, von einem laptop-freundlichen kleinen Modell bis zu einem spitzennahen Flaggschiff. Wenn "lokal" eine harte Anforderung ist, bietet Qwen den saubersten Weg von allen Modellen hier.
4. GLM 5.3 Flash
Am besten für: Teams, die das günstigste offene Modell wollen, das bei echtem Code standhält.
Z.ais GLM 5.3 Flash startete am 26.08.2026 als erstes nativ multimodales GLM-5-Modell, ein 320B / 18B-aktiv-MoE mit 1M-Kontext und offenen Gewichten. Es erreicht einen Artificial-Analysis-Index von 57 bei rund 0,045 $ pro Aufgabe, was es genau in MiMos Budgetklasse einordnet. Die API-Preise liegen bei 0,15 $ Eingabe und 0,50 $ Ausgabe pro 1M (die Launch-Aktion von 0,075 $ / 0,25 $ ist ausgelaufen).
GLM ist das offene Modell, das Leute speziell nennen, wenn das Gespräch auf echtes Coding statt auf Benchmarks kommt. Im selben skeptischen Hacker-News-Thread lautete das Gegenargument, dass GLM plus ein überwachendes Spitzenmodell die teuren US-Modelle in der Praxis bereits schlägt:
"I mean DSv4.1 Flash and GLM 5.3 kept in check by a supervising frontier like Astra or Fable already in my experience clowns massively on ever using Opus or Sonnet."
Vorteile:
- Sehr günstig (0,15 $ / 0,50 $) mit starkem AA-Index (57), offenen Gewichten, 1M-Kontext.
- Einen echten Ruf dafür, bei produktiven Coding-Aufgaben standzuhalten.
- Ein separates textbasiertes Flaggschiff (GLM-5.3 bei 1,40 $ / 4,40 $) für schwereres Coding und Cyber-Arbeit.
Nachteile:
- Die First-Party-API ist langsam (~49 Token/Sekunde); Sie brauchen einen Drittanbieter-Host wie Databricks für echten Durchsatz.
- Thinking kann nicht deaktiviert werden.
- Wie bei den anderen chinesischen offenen Modellen gelten dieselben Fragen zu Datenresidenz und Trainingsnutzung.
Fazit: GLM 5.3 Flash ist die Wahl für Preis-Leistung-plus-Coding. Wenn DeepSeek der günstige Generalist und Kimi das große Modell ist, ist GLM dasjenige, das man ausprobiert, wenn der Workload überwiegend aus Code besteht und die Rechnung trotzdem winzig bleiben muss.
5. Claude Opus 5.5
Am besten für: Teams, die die höchste Reasoning-Obergrenze für die schwierigste agentische Arbeit brauchen.
Wenn MiMos Schwachpunkt die Spitze der Schwierigkeitskurve ist, dann ist Claude Opus 5.5 das Modell, das sie beherrscht. Anthropics Flaggschiff belegt den #1 Platz im Artificial-Analysis-Intelligence-Index (58) und führt MiMo komfortabel bei Terminal Bench 4.0 und den schwierigsten Coding-Agenten-Ranglisten an. Es kostet 5 $ Eingabe und 25 $ Ausgabe pro 1M bei einem flachen 1M-Kontext (kein Long-Context-Aufschlag), und Cache-Lesevorgänge kosten ein Zehntel davon.
Das ehrliche Gegengewicht sind die Kosten pro Aufgabe. Opus verbraucht viele Ausgabe-Token: im Artificial-Analysis-Index liegt es bei maximalem Aufwand bei rund 5,98 $ pro Aufgabe, gegenüber MiMos 0,13 $. Sie zahlen Spitzenpreise für eine Spitzenobergrenze.
Vorteile:
- Top-Reasoning- und agentische Scores; die Obergrenze, die MiMo bei den schwierigsten Ranglisten nicht erreicht.
- Flache 1M-Kontextpreise, ausgereiftes Tooling und eine klare Haltung zum Umgang mit Daten für regulierte Arbeit.
Nachteile:
- Teuer pro Token, und noch mehr pro abgeschlossener Aufgabe, weil es bei hohem Aufwand ausführlich wird.
- Langsame Zeit bis zum ersten Token bei maximalem Aufwand, was allem schadet, worauf ein Mensch wartet.
- Geschlossene Gewichte, sodass Selbst-Hosting und echte lokale Inferenz ausgeschlossen sind.
Fazit: Opus 5.5 ist das Anti-MiMo: nicht die Preis-Leistungs-Wahl, sondern die Leistungswahl. Greifen Sie danach, wenn die Aufgabe wirklich das beste verfügbare Reasoning braucht und das Budget es verkraften kann, und kombinieren Sie es mit einem günstigeren Modell für die routinemäßigen 80 %.
6. GPT-6 Sol
Am besten für: Teams, die ein gehostetes Spitzenmodell zu den niedrigsten Kosten pro abgeschlossener Aufgabe wollen.
OpenAIs GPT-6 Sol startete am 22.09.2026, am selben Tag wie MiMo, und seine ganze Geschichte dreht sich um Preis-Leistung. Es kostet 2 $ Eingabe und 10 $ Ausgabe pro 1M, eine flache Senkung um 50 % gegenüber GPT-5.6 Sol, mit einem 1,05M-Kontext. Sein Artificial-Analysis-Intelligence-Index (48) liegt auf dem Niveau der vorherigen Generation, das ist also eine Preissenkung im Gewand eines Versionssprungs, kein Leistungssprung, aber genau das macht es zu einer starken MiMo-Alternative für gehostete Arbeit.
Die Zahl, die zählt, sind die Kosten pro Aufgabe, wo Sol ungewöhnlich effizient ist, weil es weit weniger Ausgabe-Token als Opus verbraucht. Im Artificial-Analysis-Index liegt es bei maximalem Aufwand bei rund 1,06 $ pro Aufgabe gegenüber Opus 5.5s 5,98 $, also etwa 5,6x günstiger für ein Modell, das bei der Intelligenz nur eine Stufe zurückliegt. Auch die Faktentreue hat sich verbessert, die Halluzinationsrate bei maximalem Aufwand fiel von 92 % auf 60 %.
Vorteile:
- Günstig für ein gehostetes Spitzenmodell: 2 $ / 10 $, und dramatisch günstiger pro abgeschlossener Aufgabe als Opus.
- Riesiger 1,05M-Kontext, vollständiges Responses-Tool-Set und eine große Verbesserung der Faktentreue gegenüber 5.6.
- Die Zuverlässigkeit und Datenhaltung eines US-Spitzenlabors.
Nachteile:
- Die Intelligenz stagniert gegenüber der Vorgängergeneration, wenn Sie also einen echten Sprung brauchten, finden Sie ihn hier nicht.
- Geschlossene Gewichte und keine Gratisstufe speziell für Sol.
- Long-Context-Anfragen werden zu einer höheren Stufe abgerechnet (4 $ / 15 $), derselbe 200K-Schwellenwert, den OpenAI und xAI beide berechnen.
Fazit: GPT-6 Sol kommt dem Konzept "MiMo-Ökonomie mit der Zuverlässigkeit eines Spitzenlabors" am nächsten. Wenn Sie ein gehostetes Modell wollen, sich um die Gesamtrechnung sorgen und kein Opus-Niveau an Reasoning brauchen, ist Sol die Preis-Leistungs-Standardwahl.
7. Gemini 3.8 Flash
Am besten für: Teams, die massiven multimodalen Kontext von einem Spitzenlabor günstig wollen.
Googles Gemini 3.8 Flash erschien am 02.09.2026, sein drittes Flash-Release in sechs Wochen. Es ist kein neues Basismodell (die Modellkarte sagt es viermal, dass es auf 3.7 Flash basiert), weshalb sich der Preis nicht bewegt hat: 0,75 $ Eingabe und 3,75 $ Ausgabe pro 1M bis Ende 2026, dann 1,50 $ / 7,50 $ ab Januar. Es hat einen Spitzen-Artificial-Analysis-Intelligence-Index von 59 und nimmt Text, Bild, Audio, Video und PDF entgegen.
Der unterberichtete Haken ist die Reaktionsfähigkeit. Artificial Analysis misst eine Zeit bis zum ersten Token von 13,30 Sekunden gegenüber einem Klassenmedian von 2,99 Sekunden, obwohl es bei der reinen Ausgabegeschwindigkeit auf Platz #3 von 196 liegt. Durchsatz ist nicht dasselbe wie Latenz, was es für alles disqualifiziert, worauf ein Mensch live wartet, aber gut für einen über Nacht laufenden Batch-Agenten geeignet ist. Interessanterweise rät Google selbst effizienzorientierten Entwicklern, bei 3.7 Flash zu bleiben.
Vorteile:
- Top-Intelligence-Index (59) zu einem wirklich günstigen Preis für ein Spitzenmodell.
- Der breiteste native multimodale Input aller Modelle hier, mit 1M-Kontext.
- Eine kostenlose Stufe sowie großzügige Batch- und Flex-Rabatte.
Nachteile:
- Langsam bis zum ersten Token, also eine schlechte Wahl für Live-Chat oder Support-Antworten.
- Ausführlich (etwa 120M Ausgabe-Token, um den Index zu durchlaufen, gegenüber einem Median von 71M), was die tatsächliche Rechnung aufbläht.
- Googles eigene Empfehlung lautet, dass 3.7 Flash die Effizienzwahl ist, was den Upgrade-Fall trübt.
Fazit: Gemini 3.8 Flash ist das multimodale Batch-Arbeitspferd. Wenn Ihr MiMo-Anwendungsfall dokumenten-, bild- oder videointensiv ist und asynchron läuft, ist dies die zu schlagende Spitzenalternative. Wenn eine Person auf die Ausgabe wartet, suchen Sie anderswo.
8. Grok 4.7
Am besten für: Teams, die hochvolumige Agenten-Loops betreiben und Live-X-Daten sowie spitzennahe Qualität wollen.
xAIs Grok 4.7 startete am 21.09.2026, aufbauend auf einem größeren Basismodell und trainiert für mehrstündige agentische Aufgaben. Es ist der interessante Spiegel zu MiMo im Artificial-Analysis-Index: beide landen bei 46, und das gleichtägige Timing ist der Grund, warum "MiMo mogged Grok" die Runde machte. Die Preise liegen bei 2 $ Eingabe und 6 $ Ausgabe pro 1M unter 200K Prompt-Token, und 4 $ / 12 $ darüber, wobei die Long-Tarife für die gesamte Anfrage gelten.
Grocks echter Vorteil gegenüber den offenen Modellen hier ist natives Tooling: Live-Web- und X-Suche, Code-Ausführung und ein Design, das auf lange Agenten-Läufe abgestimmt ist, plus den stärksten Sicherheits-Stack, den xAI je ausgeliefert hat. Es ist spitzennah statt spitzenführend (Fable führt weiterhin bei Peak-Coding und Terminal-Arbeit), aber es ist so bepreist, dass es tatsächlich im großen Umfang läuft.
Vorteile:
- Dieselbe AA-Intelligenz wie MiMo (46), aber mit dem gehosteten Tooling eines Spitzenlabors und Live-X- und Web-Suche.
- Für Volumen in Agenten-Loops bepreist bei 2 $ / 6 $, mit einem starken neuen Sicherheits- und Ablehnungs-Stack.
- Große Verbesserungen bei Terminal und Coding gegenüber Grok 4.6.
Nachteile:
- 500K-Kontext ist der kleinste der Gruppe, und der Preisaufschlag über 200K gilt für alle Token einer Anfrage.
- Es verliert gegen GPT-6 Sol und Fable bei einigen professionellen Benchmarks wie HealthBench.
- Geschlossene Gewichte, und kein Test mit historischen Tickets für supportähnliche Tests.
Fazit: Grok 4.7 ist die Wahl "spitzennah bei Volumen", besonders wenn Echtzeit-X- oder Web-Daten Teil der Aufgabe sind. Wenn Sie von MiMos Preis angezogen wurden, aber gehostetes Tooling wollen und mit dem kleineren Kontext leben können, ist es ein fairer Tausch.
Was all diese Benchmarks übersehen
Hier ist, was uns drei Jahre lang KI auf echten Support-Queues gelehrt haben: Das Modell ist der geringste Teil davon. Jede Option oben ist ein Motor, und ein guter Motor ist kein fertiges Auto. Für sich allein kennt ein rohes Modell Ihr Produkt nicht, kann Ihren Helpdesk nicht sehen, kann keine Aktion ausführen und kann nicht sicher gegen Ihre echte Historie getestet werden, bevor es mit einem Kunden spricht.
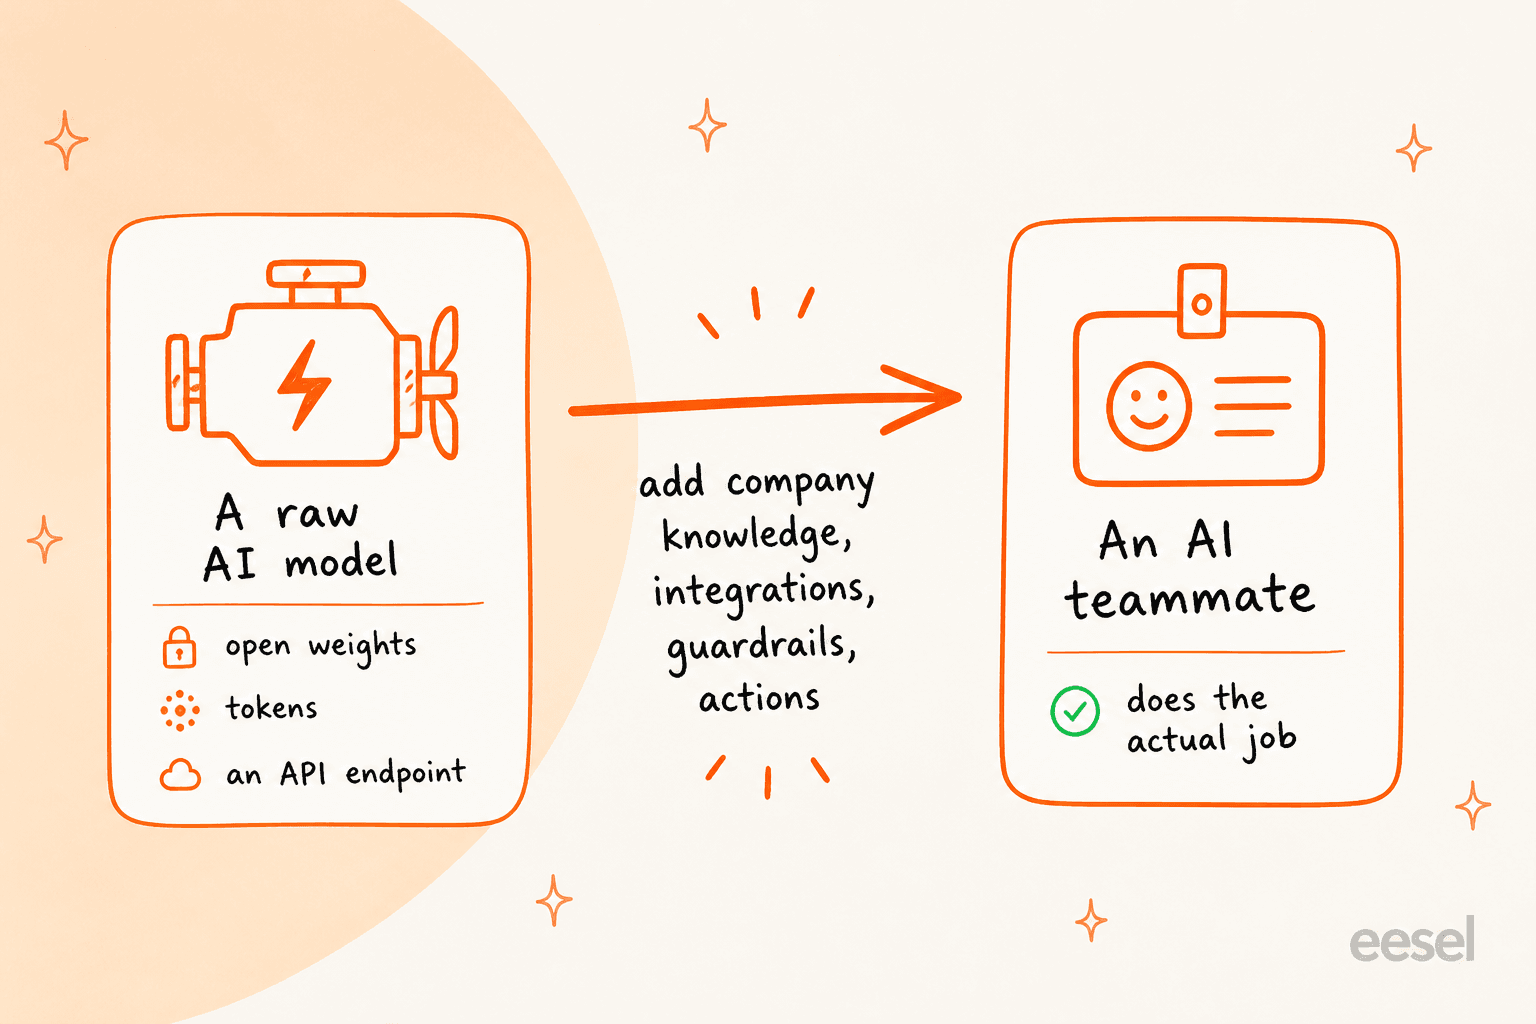
Wir haben das auf die harte Tour gelernt, als wir zusahen, wie ein überzeugend klingender Bot leise falsche Antworten gab, weshalb wir jetzt jeden Rollout gegen historische Tickets simulieren, bevor er live geht. Diese Lücke zwischen "einem klugen Modell" und "einem Teamkollegen, der die Arbeit erledigt" ist genau das, was Benchmarks nicht messen, und dort steckt der Großteil der echten Arbeit: Wissen verbinden, Integrationen verdrahten, Leitplanken setzen und zuerst an den eigenen Daten beweisen, dass es funktioniert.
Die nützlichere Frage ist also oft nicht "welches Modell?", sondern "wer wird die Arbeit erledigen?". Wenn die Antwort Ihr Engineering-Team ist, das ein Modell in all das einwickelt, dann wählen Sie aus den acht oben nach Preis, Obergrenze und Lizenzierung aus. Wenn die Antwort "ich will einfach das Ergebnis" lautet, wird das Modell zu einem Implementierungsdetail.
Probieren Sie eesel
eesel arbeitet am anderen Ende dieser Entscheidung. Statt Ihnen einen Motor und ein Bauprojekt zu übergeben, gibt es Ihnen einen einsatzbereiten KI-Teamkollegen für Ihren Helpdesk, der Ihre Integrationen und Ihren Unternehmenskontext bereits kennt, und lässt das darunterliegende Modell austauschbar bleiben. Das ist der ganze Sinn der Sichtweise "das Modell ist Infrastruktur": Sie stellen den Teamkollegen ein, nicht den Motor.
Konkret tritt der KI-Helpdesk-Teamkollege innerhalb von Minuten Ihrer bestehenden Queue bei, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und – entscheidend – simuliert gegen Ihre echte Ticket-Historie, bevor er jemals einen echten Kunden beantwortet, sodass Sie die prognostizierte Lösungsrate und Qualität vorab sehen, statt einfach einen Schalter umzulegen und zu hoffen. Und weil eesel darauf ausgelegt ist, programmatisch gesteuert zu werden, gibt es auch eine vollständige eesel CLI: Sie können denselben Teamkollegen und Workspace von einem Terminal aus bedienen, ihn in Skripten automatisieren oder einen Coding-Agenten wie Claude Code oder Cursor ihn steuern lassen, was der natürliche Fit ist, wenn Sie ohnehin nach einem rohen Modell zum Skripten gesucht haben.
Wenn Sie MiMo V2.6 oder eine seiner Alternativen für die Support-Automatisierung abwägen, lohnt sich ein Blick, bevor Sie sich auf ein Build festlegen. Probieren Sie eesel kostenlos aus, und lassen Sie das Modell der einfache Teil sein.
Häufig gestellte Fragen
Was ist die beste Xiaomi MiMo V2.6 Alternative?
Gibt es günstigere Alternativen zu Xiaomi MiMo V2.6?
Welche MiMo V2.6 Alternativen bieten offene Gewichte?
Ist Xiaomi MiMo V2.6 gut genug, um die Alternativen zu überspringen?
Muss ich überhaupt ein Modell auswählen, um Support zu automatisieren?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.