Cohere Embed 5 Preise im Überblick
Cohere hat die Embed-5-Familie am 30. September 2026 in zwei Stufen vorgestellt. Beide teilen sich 128K Kontext und über 100 Sprachen, dazu Eingaben als Text, Bild oder fusionierte Text-plus-Bild-Eingabe. Ich habe jeden veröffentlichten Preis zusammengetragen und in eine Tabelle gesetzt, direkt aus Coheres Preisseite, dem Launch-Beitrag und den Cloud-Marketplace-Einträgen:
| Option | Preis | Abrechnung nach | Am besten für |
|---|---|---|---|
| Testschlüssel | Kostenlos, 1.000 Aufrufe/Monat | k. A. (keine Produktionsnutzung) | Testen |
| Embed 5 Pro, Text | 0,12 $ / 1 Mio. Tokens | Eingabe-Tokens | Dokumente indexieren |
| Embed 5 Fast, Text | 0,08 $ / 1 Mio. Tokens | Eingabe-Tokens | Abfragen, Agent-Schleifen |
| Embed 5 Pro oder Fast, Bilder | 0,40 $ / 1 Mio. Tokens | Bild-Tokens | Seitenbilder, Folien |
| Model Vault Small (Pro oder Fast) | 3,00 $/Std. oder 2.000 $/Monat | Dedizierte Instanz | Gleichbleibend hohes Volumen |
| Model Vault Medium (Pro oder Fast) | 5,00 $/Std. oder 3.250 $/Monat | Dedizierte Instanz | Sehr hohes Volumen |
| Amazon SageMaker | 2,39 bis 8,48 $/Host/Std. Softwaregebühr + Instanz | Stunde | Teams, die bereits auf AWS sind |
| Microsoft Foundry | In der Preview gelistet, noch kein Preis | k. A. | Teams auf Azure |
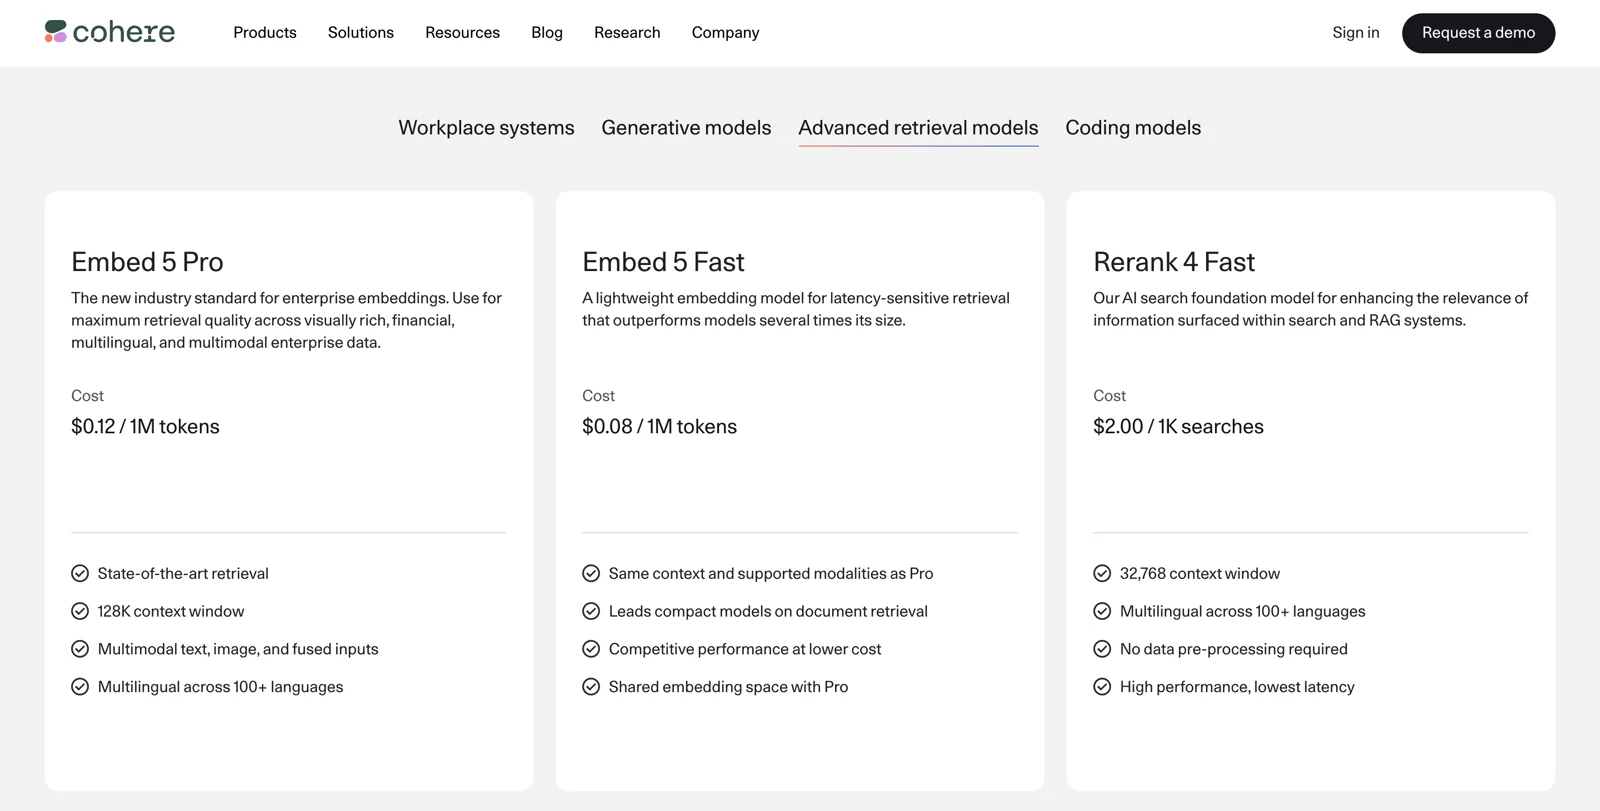
Auf demselben Tab stehen außerdem Parse 5 für 1,50 $ pro 1.000 Seiten und Rerank 4 ab 2,00 $ pro 1.000 Suchen. Zusammen mit Embed 5 bilden sie den kompletten Retrieval-Stack, den Cohere verkauft. Beim Lesen der Karten sind mir zwei Dinge aufgefallen. Erstens: Model Vault berechnet für Pro und Fast denselben Satz, das heißt, auf einer dedizierten Instanz verschwindet die ganze Logik „Fast ist günstiger“, und der einzige Grund für Fast ist dort die Geschwindigkeit. Zweitens: Embed 4 ist von der Preisseite komplett verschwunden, obwohl die Modell-Dokumentation es noch ohne Hinweis auf eine Abkündigung führt. Wenn Sie heute auf Embed 4 sind, bricht nichts, aber das Signal, wohin Cohere Sie haben will, ist ziemlich klar. (Mein Cohere-AI-Test deckt den Rest des Angebots ab.)
Ich baue bei eesel Integrationen, und der Teil von eesel, der ein Help Center und ein paar Jahre Tickets in etwas verwandelt, das eine KI durchsuchen kann, ist genau diese Schicht. Wenn ich Embedding-Preiskarten lese, lese ich sie deshalb so, wie ein Klempner ein Angebot für Rohre liest. Der Preis pro Einheit zählt, klar, aber eigentlich bepreisen Sie alles, woran die Rohre angeschlossen sind.
Was sich gegenüber Embed 4 geändert hat
Die Kurzfassung: Cohere hat den Preis gehalten und dafür fast alles andere bewegt. Hier der direkte Vergleich, mit den Embed-4-Sätzen aus Azures Cohere-Preisen und Coheres Preis-Snapshot vom August:
| Embed 4 | Embed 5 Pro | Embed 5 Fast | |
|---|---|---|---|
| Text, pro 1 Mio. Tokens | 0,12 $ | 0,12 $ | 0,08 $ |
| Bilder, pro 1 Mio. Tokens | 0,47 $ | 0,40 $ | 0,40 $ |
| Model Vault Small | 4,00 $/Std., 2.500 $/Monat | 3,00 $/Std., 2.000 $/Monat | 3,00 $/Std., 2.000 $/Monat |
| Standard-Dimensionen | 1536 | 2048 | 2048 |
| ViDoRe-V3-Wert (Cohere) | 77,0 | 85,8 | 84,5 |
Sie bekommen also einen Qualitätssprung von 8,8 Punkten zum gleichen Textpreis, 15 % günstigere Bilder und eine dedizierte Instanz, die 500 $ im Monat weniger kostet. Fast dagegen gab es vorher gar nicht.
Die Zeile, die ich einkreisen würde, ist die der Standard-Dimensionen. Der Preis pro Token ist gleich, aber jeder Vektor wird standardmäßig um ein Drittel größer. Wenn Sie das Modell wechseln und die Standardeinstellungen behalten, bleibt Ihre Embedding-Rechnung gleich und Ihre Vektordatenbank-Rechnung steigt. Die Lösung kommt weiter unten, sie ist einfach und spart echtes Geld.
Was ein abrechenbarer Token ist
Coheres Abrechnungsdokumentation sagt, Embed werde „nach der Anzahl der eingebetteten Tokens“ berechnet, und Tokens, die Cohere im Hintergrund hinzufügt, werden nicht berechnet. Sie zahlen nur für die Eingabe. Es gibt gar keine Ausgabe-Token-Gebühr, weil ein Embedding-Aufruf eine Liste von Zahlen zurückgibt und keinen Text.
Ein paar Details, die die echte Rechnung prägen:
- Batching ändert den Preis nicht. Jeder Embed-Aufruf nimmt bis zu 96 Texte oder Eingaben entgegen, gut für den Durchsatz, aber der Preis pro Token bleibt gleich.
- Bilder werden pro Token berechnet, aber die Umrechnung ist nicht veröffentlicht. Die Dokumentation erklärt die Größenanpassung (Bilder über 2.458.624 Pixel werden herunterskaliert), nennt aber keine Formel für Tokens pro Bild. Machen Sie daher zuerst einen kleinen Test, bevor Sie ein Budget für ein großes PDF-Archiv festlegen.
- Es gibt keinen genannten Batch-Rabatt. Der Launch-Beitrag sagt, Batch-Embedding sei verfügbar, aber die Embed-Jobs-Anleitung sagt weiterhin, es funktioniere nur mit v3.0-Modellen. Planen Sie nicht mit einem 50-%-Batch-Satz wie bei Google.
- Testschlüssel sind eng begrenzt. Text-Embedding läuft mit 2.000 Eingaben pro Minute bei Test und Produktion, aber Bild-Embedding liegt bei 5 Eingaben pro Minute im Test gegenüber 400 in Produktion.
Alles danach ist einfache Arithmetik: Eingabe-Tokens mal Satz. Es ist dasselbe Abrechnungsmodell wie bei der OpenAI-API und den meisten anderen gehosteten Embedding-Diensten.
Der Trick: mit Pro indexieren, mit Fast abfragen
Für mich ist das das Nützlichste am ganzen Launch, und es ist eigentlich ein Preis-Feature im Gewand eines technischen. Pro und Fast teilen sich einen Embedding-Raum, sodass eine von Fast eingebettete Abfrage einen von Pro gebauten Index durchsuchen kann, ohne dass Sie etwas neu aufbauen müssen.
"For many customers, we recommend the following deployment pattern: index with Pro, query with Fast."
Cohere hat jede Kombination über 40 Entwicklungsdatensätze getestet. Mit einem reinen Pro-Setup als 100 erreichte ein Pro-Index mit Fast-Abfrage 98,4, ein Fast-Index mit Pro-Abfrage 97,3 und reines Fast 96,6. In den Fußnoten steckt ein Haken: Beide Seiten müssen dieselbe Ausgabedimension verwenden.
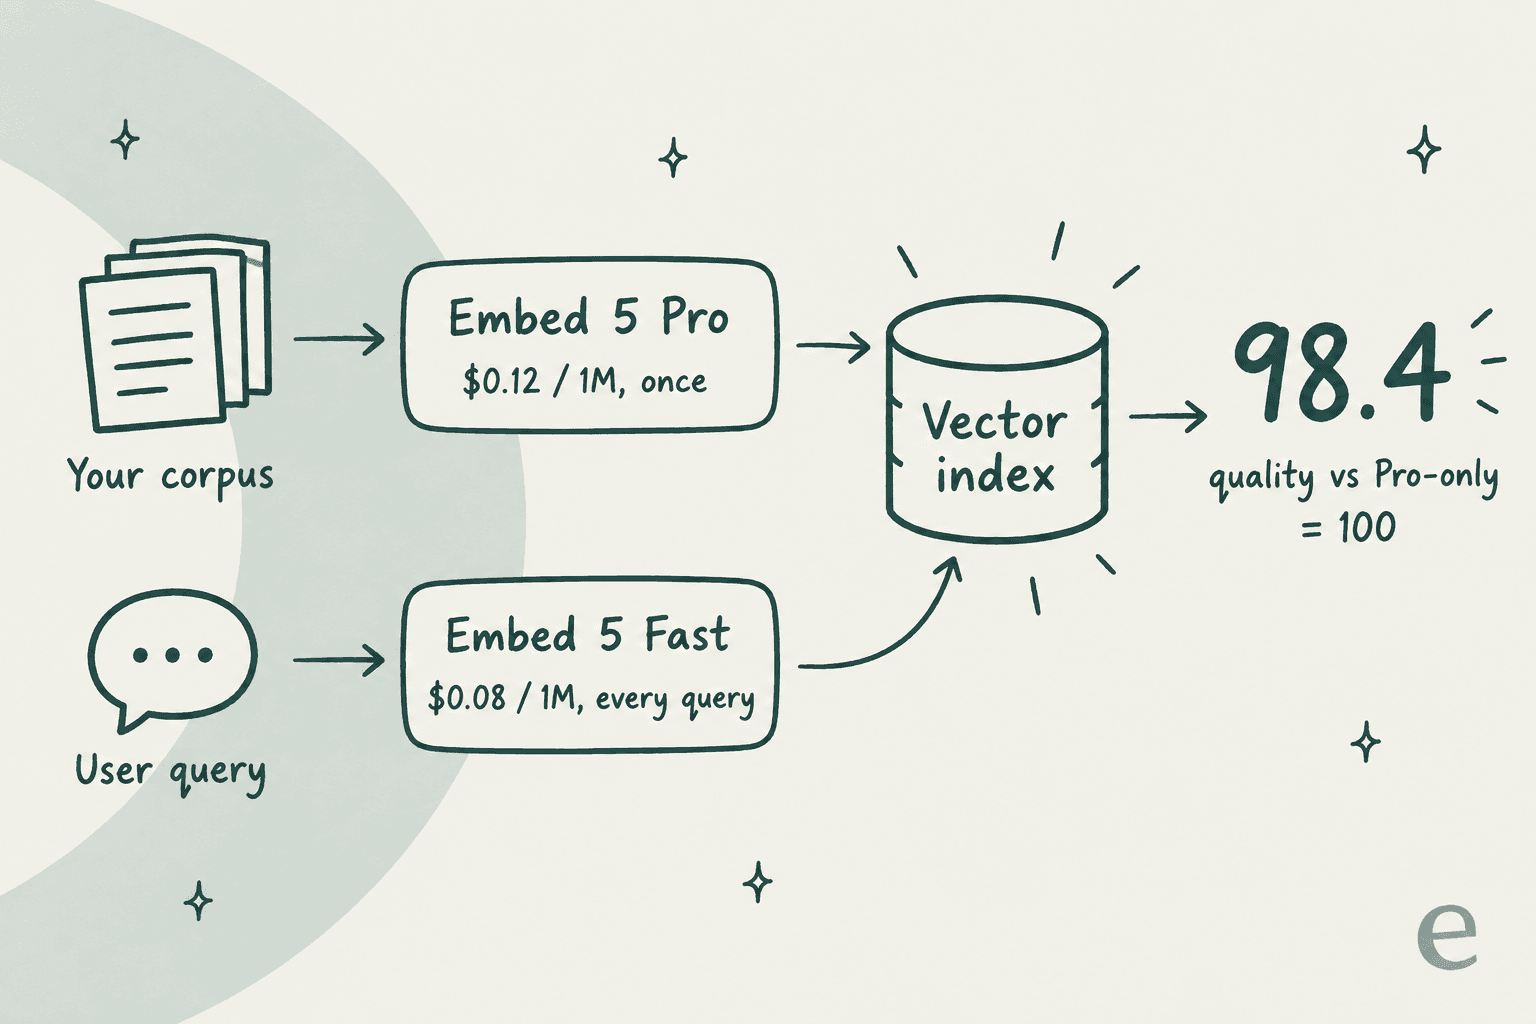
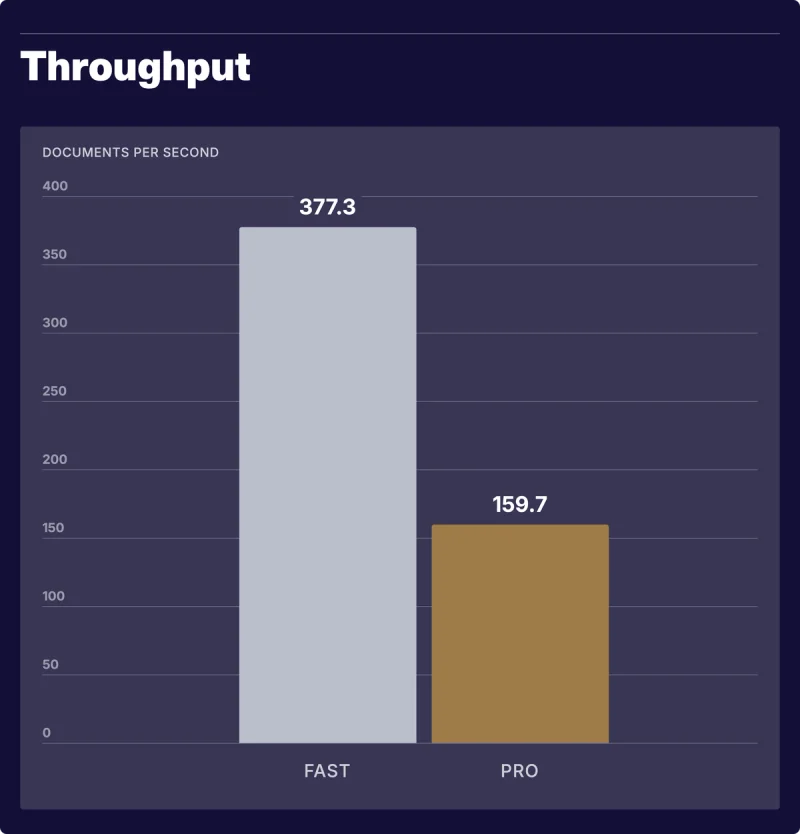
Warum zählt das für die Kosten? Weil in den meisten Such- und RAG-Systemen (hier eine Support-RAG-Pipeline, wenn Sie die ganze Form sehen wollen) das Indexieren einmal passiert (plus Updates), Abfragen aber für immer. So zahlen Sie den Pro-Satz für den Teil, den Sie selten machen, und den Fast-Satz für den Teil, den Sie jede Sekunde machen. Fast verarbeitete in Coheres Durchsatztest außerdem 377,3 Dokumente pro Sekunde gegenüber 159,7 bei Pro, Abfragen werden also nicht nur günstiger, sondern auch schneller.
Hier würde ich allerdings der gängigen Lesart etwas widersprechen, denn für die meisten Teams ist die Abfrageseite winzig. Ein Support-Bot mit 30.000 Fragen im Monat bei etwa 100 Tokens pro Frage sendet 3 Millionen Abfrage-Tokens: das sind 0,36 $ bei Pro oder 0,24 $ bei Fast. Die Schlagzeile „Fast spart Geld“ stimmt im Maßstab von Agent-Schleifen, in denen ein Modell pro Aufgabe Dutzende Suchen abfeuert. Für ein normales Help Center wählen Sie Fast wegen der Latenz und machen sich dann keine Gedanken mehr über die Kosten.
Die Kosten, die die Preisseite nicht zeigt: Vektorspeicher
Jeder Vektor, den Sie erzeugen, muss irgendwo liegen, meist in einer Vektordatenbank, und dieses Irgendwo berechnet Ihnen monatlich Geld. Von einem ganzen Embedding-Budget ist das der Teil, den ich am häufigsten unterschätzt sehe, weil die Embedding-API pro Dokument eine Einmalzahlung ist, die Datenbank aber Miete.
Embed 5 lässt Sie die Ausgabegröße (256, 512, 768, 1024, 1536 oder 2048 Dimensionen) und das Format (float, int8, binary und ein paar Varianten) wählen. Coheres eigenes Beispiel: 100 Millionen Chunks im Standard von 2048 Dimensionen als float belegen 819 GB, während 256 Dimensionen binary 3,2 GB belegen, also 256-mal weniger.
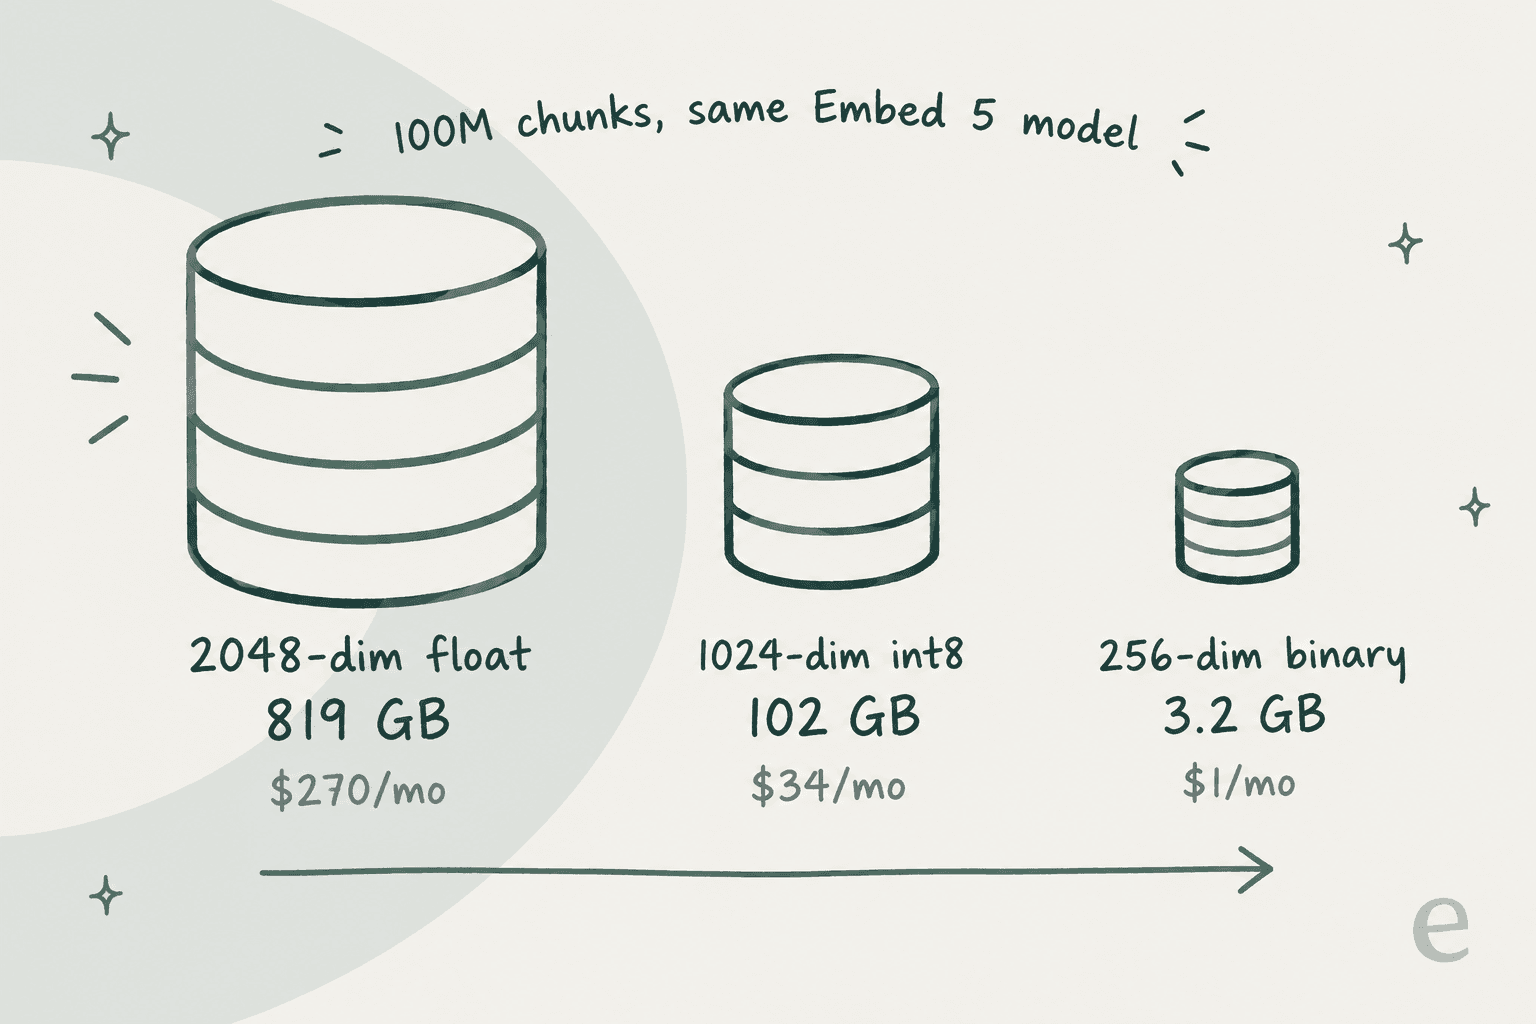
Ich habe diese drei Größen im Serverless-Tarif von Pinecone mit 0,33 $ pro GB und Monat bepreist (nur rohe Vektor-Bytes, ohne Index-Overhead und Metadaten). Das ergibt eine Lücke von 270 $ im Monat gegenüber 34 $ gegenüber etwa 1 $. Über zwei Jahre kostet die Standard-float-Einstellung allein für den Speicher rund 6.500 $, mehr als die 6.000 $, die es kostet, 50 Milliarden Tokens mit Pro überhaupt erst einzubetten.
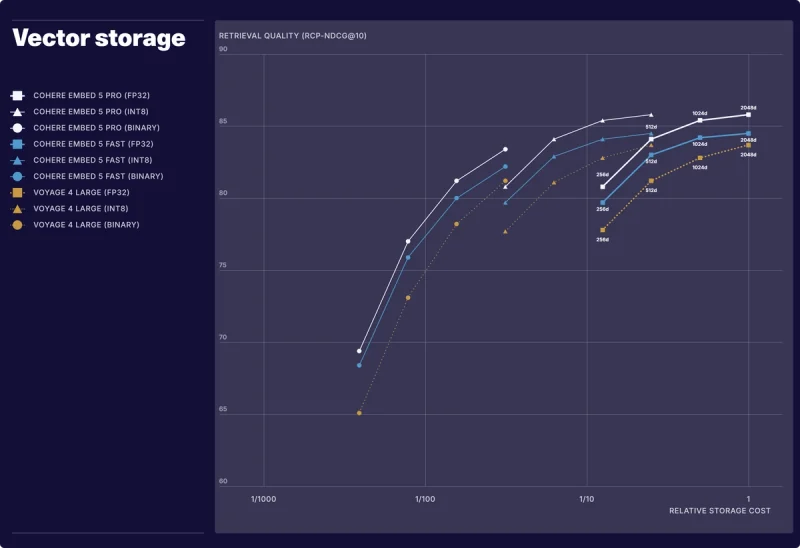
Was Sie durch Verkleinern an Qualität verlieren, ist kleiner, als man denkt. Coheres Diagramm trägt die Retrieval-Qualität gegen die relativen Speicherkosten ab, und die int8-Linien liegen fast auf den float-Linien. Coheres eigene Empfehlung ist 1024-Dimensionen-int8, und das ist auch die Einstellung, mit der ich beginnen würde.
Andere Datenbanken bepreisen anders, und mit ihnen ändert sich die Form der Rechnung. Weaviate Cloud berechnet pro Million gespeicherter Vektordimensionen (ab 0,00465 $ bei Flex), 2048 Dimensionen kosten also buchstäblich das Doppelte von 1024. Pinecone berechnet außerdem 16 bis 18 $ pro Million Read Units im Standard-Tarif, mit 50 $ Monatsminimum, und bei kleinen Indizes zählt das mehr als der Speicher. Die Datenbankoptionen habe ich ausführlicher in meiner Übersicht zu den Weaviate-Preisen und in der Zusammenstellung der Weaviate-Alternativen verglichen.
Wenn Sie gar keine Datenbank betreiben möchten: OpenAIs gehostete Option behandelt mein Leitfaden zu Vector Stores, allerdings binden Sie sich damit an OpenAIs eigene Embedding-Modelle.
Embed-5-Rechnung schätzen
Tragen Sie hier Ihren eigenen Korpus und Ihren eigenen Traffic ein. Der Rechner nutzt die veröffentlichten API-Sätze und Pinecones Speichersatz von 0,33 $/GB, die Speicherzeile ist daher am besten als Untergrenze zu verstehen.
Wechseln Sie einmal von 1024-Dimensionen-int8 auf 2048-Dimensionen-float, also auf die Standardwerte von Embed 5. Bei einer Million Chunks bewegt sich die Indexierungsrechnung überhaupt nicht, während die Speicherzeile auf das 8-Fache springt.
API vs. Model Vault vs. Cloud-Marktplätze
Model Vault ersetzt den Zähler pro Token durch eine feste Miete für eine dedizierte Single-Tenant-Instanz. Die Break-even-Rechnung ist einfach genug:
| Instanz | Monatlich | Break-even bei Pro | Break-even bei Fast |
|---|---|---|---|
| Small | 2.000 $ | ~16,7 Mrd. Tokens/Monat | ~25 Mrd. Tokens/Monat |
| Medium | 3.250 $ | ~27,1 Mrd. Tokens/Monat | ~40,6 Mrd. Tokens/Monat |
Sechzehn Milliarden Tokens im Monat sind etwa 550 Millionen am Tag. Nur sehr wenige Teams betten so viel ein, deshalb bleibt die API für fast alle die günstigere Option. Cohere veröffentlicht außerdem nicht, wie viele Tokens eine Small-Instanz pro Monat durchschieben kann. Klären Sie den Durchsatz also mit dem Vertrieb, bevor Sie annehmen, dass eine Instanz Ihre Spitze abdeckt.
Trotzdem kaufen Leute Model Vault, und der Grund ist eher Kontrolle als Preis. Es gibt keine geteilte Mandantenfähigkeit und der Durchsatz ist garantiert, was auch eine sauberere Geschichte für Security-Reviews ergibt. Das passt zu Coheres gesamtem Pitch rund um den Unternehmenseinsatz. Wenn alles vollständig in Ihrem eigenen Netzwerk laufen muss, lassen sich beide Modelle über eine private Bereitstellung auf vLLM selbst hosten, mit einem vom Vertrieb festgelegten Preis.
Die Marktplätze sind dann ein dritter Weg. Auf Amazon SageMaker wird Embed 5 als stündliche Softwaregebühr pro Host abgerechnet (2,39 $ auf einer ml.g5.xlarge, bis zu 8,48 $ auf der größten Pro-Instanz) plus die SageMaker-Instanz selbst. Microsoft Foundry listet beide Modelle in der Preview, noch ohne Preis. Amazon Bedrock und Oracle OCI führen Stand 1. Oktober weiterhin nur Embed 4, bei Bedrock für 0,12 $ pro 1 Mio. Tokens. Wenn Ihr Unternehmen zugesagte Cloud-Ausgaben hat, kann der Marktplatz-Weg auch bei schlechterem Rohsatz sinnvoll sein.
Rechenbeispiele: Was ein echtes Team zahlt
Unten stehen drei Szenarien mit den veröffentlichten Sätzen und, sofern nicht anders vermerkt, mit 1024-Dimensionen-int8-Speicher.
Help Center und Ticket-Historie eines Support-Teams. 2.000 Hilfeartikel mit etwa 800 Tokens und 50.000 frühere Tickets mit etwa 400 Tokens ergeben 21,6 Millionen Tokens. Indexieren mit Pro kostet einmalig 2,59 $. Abfragen mit 30.000 im Monat über Fast kosten 0,24 $ im Monat. Die Vektoren passen in Pinecones kostenlosen 2-GB-Tarif. Die Embedding-Rechnung ist hier ein Rundungsfehler. Die echten Kosten liegen im Engineering für Chunking und Synchronisierung, dazu Berechtigungen und die LLM-Schicht obendrauf, derselbe Zielkonflikt, den ich in semantische Suche über Zendesk Guide durchgehe.
Ein Dokumentenarchiv für ein internes Suchtool. 20 Millionen Chunks mit 500 Tokens sind 10 Milliarden Tokens. Indexieren mit Pro kostet 1.200 $, mit Fast wären es 800 $. Der Speicher bei 2048-Dimensionen-float liegt bei etwa 164 GB, also 54 $ im Monat bei Pinecone. Bei 1024 int8 sind es etwa 20 GB, also 6,76 $ im Monat. Wenn das nächste Modell erscheint, kostet ein Re-Index wieder die vollen 1.200 $, und wenn die PDFs zuerst geparst werden müssen, kommt mit Parse 5 eine eigene Rechnung pro Seite dazu.
Ein hochfrequenter Agent, der bei jedem Schritt sucht. 500 Millionen Abfrage-Tokens am Tag sind 15 Milliarden im Monat. Bei Fast sind das 1.200 $ im Monat, bei Pro 1.800 $. Keines von beiden überschreitet die Model-Vault-Grenze von 2.000 $, die API gewinnt also, es sei denn, Sie brauchen dedizierte Kapazität.
Die Lehre aus allen dreien: Die Embedding-API ist fast nie der teure Teil. Speicher und Re-Indexierung sind es, ebenso die Menschen, die die Pipeline pflegen.
Wie sich die Embed-5-Preise vergleichen
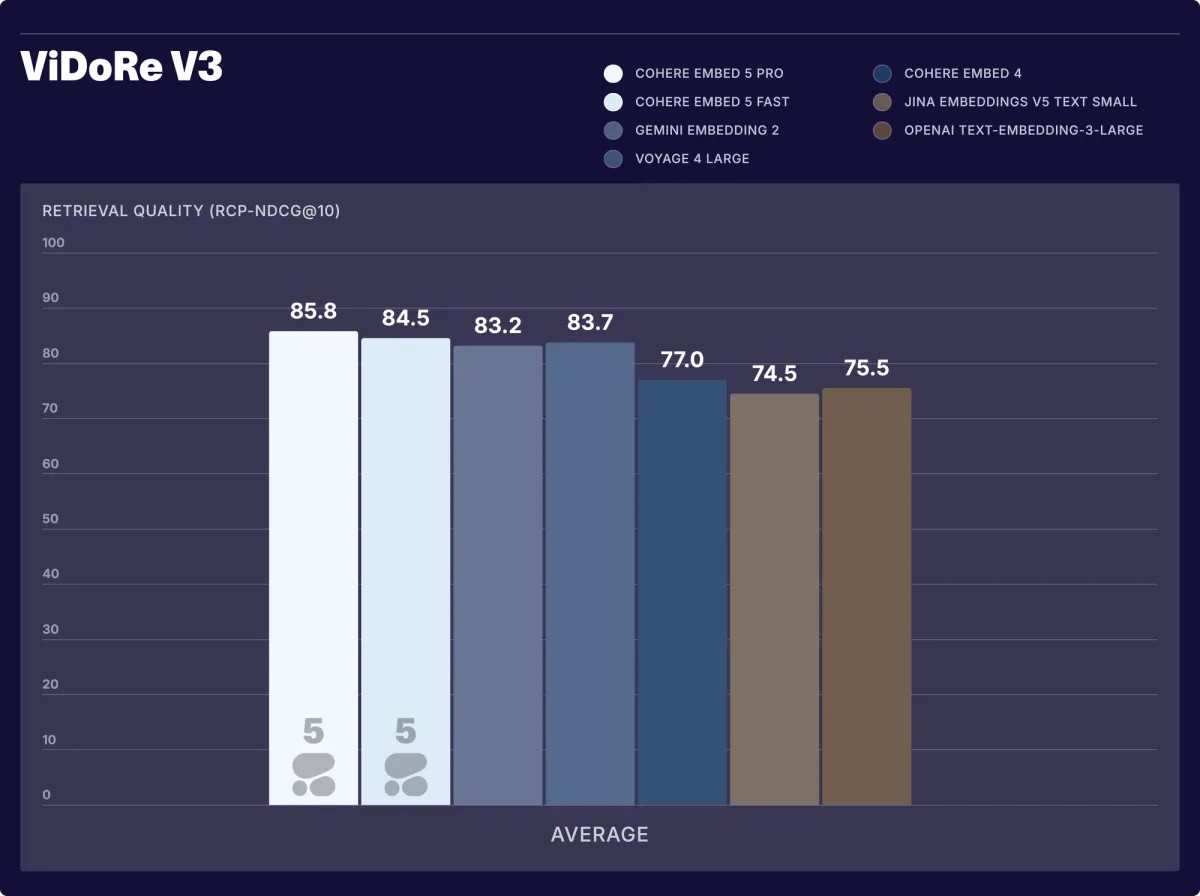
Ich habe Embed 5 neben die anderen Flaggschiff-Embedding-Modelle gestellt, jeder Preis von der Preisseite des Anbieters. Die Werte sind Coheres ViDoRe-V3-Zahlen aus dem Launch-Beitrag, lesen Sie sie also als Coheres eigenen Test und nicht als unabhängigen.
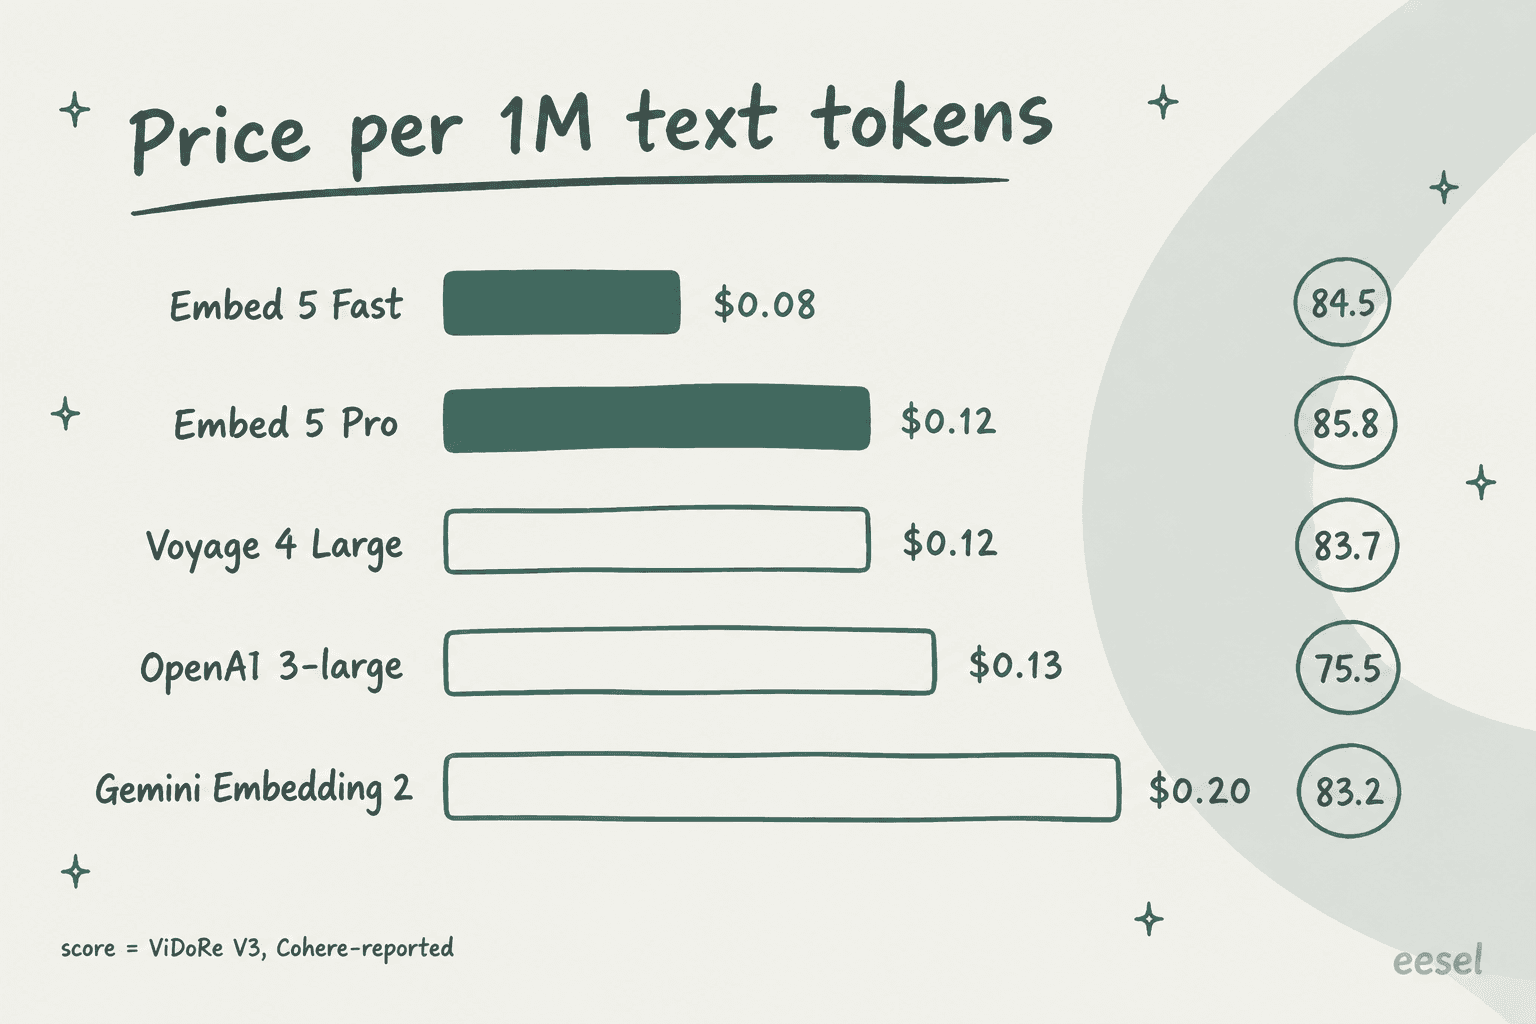
| Modell | Text / 1 Mio. Tokens | Batch | Kostenloser Tarif | ViDoRe V3 (Cohere) |
|---|---|---|---|---|
| Cohere Embed 5 Pro | 0,12 $ | Nicht angegeben | Test mit 1.000 Aufrufen/Monat | 85,8 |
| Cohere Embed 5 Fast | 0,08 $ | Nicht angegeben | Test mit 1.000 Aufrufen/Monat | 84,5 |
| Voyage 4 Large | 0,12 $ | 33 % Rabatt | 200 Mio. Tokens | 83,7 |
| Gemini Embedding 2 | 0,20 $ | 0,10 $ | Ja | 83,2 |
| OpenAI text-embedding-3-large | 0,13 $ | k. A. | Keiner | 75,5 |
| OpenAI text-embedding-3-small | 0,02 $ | k. A. | Keiner | k. A. |
| Jina Embeddings v5 | 0,045 bis 0,05 $ | k. A. | 10 Mio. Tokens, nicht kommerziell | 74,5 (v5 Small) |
| Mistral embed | 0,10 $ | k. A. | k. A. | k. A. |
Embed 5 Fast ist das günstigste Modell in der Spitzengruppe, und Pro entspricht beim Preis Voyage 4 Large und liegt in Coheres Test leicht vorn. Gemini Embedding 2 kostet zum vollen Satz das 2,5-Fache von Fast, auch wenn der Batch-Preis von 0,10 $ das beim Offline-Indexieren stark relativiert (die vollen Sätze in meinem Leitfaden zu den Gemini-Preisen). Die OpenAI-Embeddings-API kostet einen Cent mehr als Pro bei einem deutlich niedrigeren Wert in diesem Benchmark.
Zwei ehrliche Einschränkungen gehören hierher. Wenn der reine Preis pro Token Ihr einziges Ziel ist, liegen OpenAIs 3-small und Voyage 4 Lite beide bei 0,02 $, einem Viertel von Fast. Und Coheres eigene Mehrsprachigkeitstabelle zeigt Gemini Embedding 2 vor Pro bei 9 der 10 getesteten asiatischen und nahöstlichen Sprachen, mit Telugu als größter Lücke (91 vs. 80). Wenn Ihr Korpus überwiegend auf Hindi, Japanisch oder Arabisch ist, lohnt es sich, Gemini zu testen, bevor Sie sich festlegen. Mistrals Embed-Modell für 0,10 $ ist eine weitere Option für europäische Daten, siehe meine Notizen zu den Mistral-AI-Preisen. Eine breitere Liste bietet mein Beitrag zu den Cohere-AI-Alternativen, der die Anbieter über Embeddings hinaus vergleicht.
Was Entwickler sagen
Embed 5 ist beim Schreiben einen Tag alt, es gibt also noch keine echten Nutzerbewertungen dazu. Was es gibt, ist eine stetige Bilanz für Coheres Embeddings insgesamt, und das Thema, das immer wieder auftaucht, ist Zuverlässigkeit:
"It has the most crisp, steady P50 of any external service I've used in a long time."

Kritik betrifft meist die Kosten bei hohem Volumen und die Abhängigkeit von einer geschlossenen API, was für jedes gehostete Embedding-Modell gilt:
"The API can also become expensive when you start using it more frequently."

"Voyage for embeddings + rerank is totally defensible - Cohere is popular partly because it's been the default in a lot of examples, not because it's always better."

Ich finde den letzten Punkt fair, und die Embed-5-Zahlen stützen beide Seiten: Pro gewinnt Coheres eigenen Benchmark, aber nur mit 2,1 Punkten Vorsprung vor Voyage 4 Large bei gleichem Preis. Wenn Sie Voyage schon gut betreiben, gibt es keinen dringenden Grund zur Migration. Wenn Sie auf Embed 4 sind, kostet der Wechsel auf Embed 5 pro Token nichts extra und ist fast ein reiner Gewinn. Die Cohere-Integration von LangChain macht den Wechsel zu einer Ein-Zeilen-Änderung am Modell, den Korpus müssen Sie aber trotzdem neu einbetten.
Welcher Embed-5-Preispfad passt zu Ihnen
Hier meine Empfehlungen, nach Situation:
- Sie prototypen. Nutzen Sie den Testschlüssel, dann einen Pay-as-you-go-Produktionsschlüssel. Denken Sie noch nicht an Model Vault.
- Sie bauen Suche oder RAG über einen festen Korpus. Mit Pro indexieren, mit Fast abfragen, mit 1024-Dimensionen-int8 speichern. Das ist das günstigste hochwertige Setup, das Cohere bietet.
- Sie betreiben Agenten, die ständig suchen. Fast auf beiden Seiten, wenn Sie den 2,4-fachen Durchsatz brauchen; Pro-Index plus Fast-Abfragen, wenn Qualität wichtiger ist.
- Sie betten Dutzende Milliarden Tokens im Monat ein oder brauchen Isolation. Bepreisen Sie Model Vault und fragen Sie den Vertrieb vor Vertragsabschluss nach dem Durchsatz pro Instanz. Auf AWS vergleichen Sie es mit SageMaker und den Bedrock-Agent-Preisen, die Sie vielleicht schon zahlen.
- Sie betten überwiegend asiatische Inhalte ein. Testen Sie zuerst Gemini Embedding 2 gegen Pro mit Ihren eigenen Daten.
- Sie wollen nur einen Support-Bot, der aus Ihren Dokumenten antwortet. Überspringen Sie die Embedding-Entscheidung ganz und schauen Sie sich eine KI-Wissensdatenbank oder ein Helpdesk-Teammitglied an, das das Retrieval für Sie erledigt.
eesel ausprobieren, wenn das Ziel Support-Antworten sind
Die meisten, die Embedding-Modelle bepreisen, bauen keine Suchmaschine um ihrer selbst willen. Oft wählen sie zwischen RAG und Fine-Tuning für ein Help Center. Am Ende wollen sie einen Bot, der Kunden aus einem Help Center und früheren Tickets antwortet. An diesem Punkt würde ich anhalten und fragen, ob Sie den Stack überhaupt besitzen müssen.
Bei eesel habe ich Teams diese Entscheidung von beiden Seiten treffen sehen. Ein niederländisches Webhosting-Unternehmen auf Zendesk, das etwa 1.700 $ im Monat ausgab, verließ eesel, um intern eine eigene KI zu bauen. Die Einschätzung des Teams danach hatte nichts mit Modellkosten zu tun:
"A lot of their friction came from setup complexity (handovers, Zendesk integration, business hours logic) and a lack of clear guidance on how to configure things correctly."
Das ist der Teil, den Embedding-Preisseiten nie zeigen. Die Vektoren sind billig. Die Übergaben und Integrationen sowie die Regeln darum herum sind die eigentliche Arbeit.

eesel ist ein KI-Helpdesk-Teammitglied, das in Ihre bestehende Warteschlange in Zendesk, Freshdesk und anderen Helpdesks einsteigt, aus Ihrer Wissensdatenbank und früheren Tickets lernt und Sie echte Tickets durch es laufen lassen lässt, bevor es mit einem Kunden spricht. Es gibt kein Embedding-Modell zu wählen und keine Dimensionszahl zu tunen, und eine Vektordatenbank-Rechnung bekommen Sie auch nicht.
Die Preise sind feste Credit-Tarife ab 299 $ für 500 Credits im Monat, wobei ein bearbeitetes Ticket oder ein Chat einen Credit kostet.
Wenn Sie Entwickler sind, heißt dieser Weg nicht, dass Sie die Kontrolle verlieren, was ich ausführlicher in meinem Leitfaden zur Customer-Support-Agent-API behandle. Mit dem eesel CLI können Sie Integrationen verbinden, die Anweisungen des Teammitglieds bearbeiten, ausstehende Aktionen genehmigen oder ablehnen und sein Aktivitätsprotokoll aus einem Terminal lesen, mit JSON-Ausgabe und einem --dry-run-Flag für Skripte. Coding-Agenten wie Claude Code können es auch über MCP steuern.
Mehr zu diesem Workflow habe ich in Agenten aus dem Terminal verwalten und im Beitrag zum CLI für den Support geschrieben.
eesel testen Sie kostenlos und sehen Sie, wie Ihr Help Center als funktionierendes Support-Teammitglied aussieht, ohne einen einzigen Embedding-Aufruf zu schreiben.
Häufig gestellte Fragen
Wie viel kostet Cohere Embed 5?
Was ist der Preisunterschied zwischen Embed 5 Pro und Embed 5 Fast?
Ist Cohere Embed 5 teurer als Embed 4?
Gibt es einen kostenlosen Tarif für Cohere Embed 5?
Ab wann ist Cohere Model Vault günstiger als die Embed-5-API?
Wie schneiden die Preise von Cohere Embed 5 im Vergleich zu OpenAI-Embeddings ab?
Brauche ich Cohere Embed 5, um einen KI-Support-Agenten zu bauen?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.