

Was ist EmbeddingGemma 2?
EmbeddingGemma 2 ist ein offenes Embedding-Modell von Google DeepMind, angekündigt am 6. Oktober 2026.
Ein Embedding-Modell hat eine Aufgabe: Es wandelt eine Eingabe in eine Zahlenliste (einen Vektor) um, sodass ähnliche Dinge nah beieinander landen. Das ist der Motor unter der semantischen Suche, dem Clustering und der Retrieval-Hälfte von RAG.
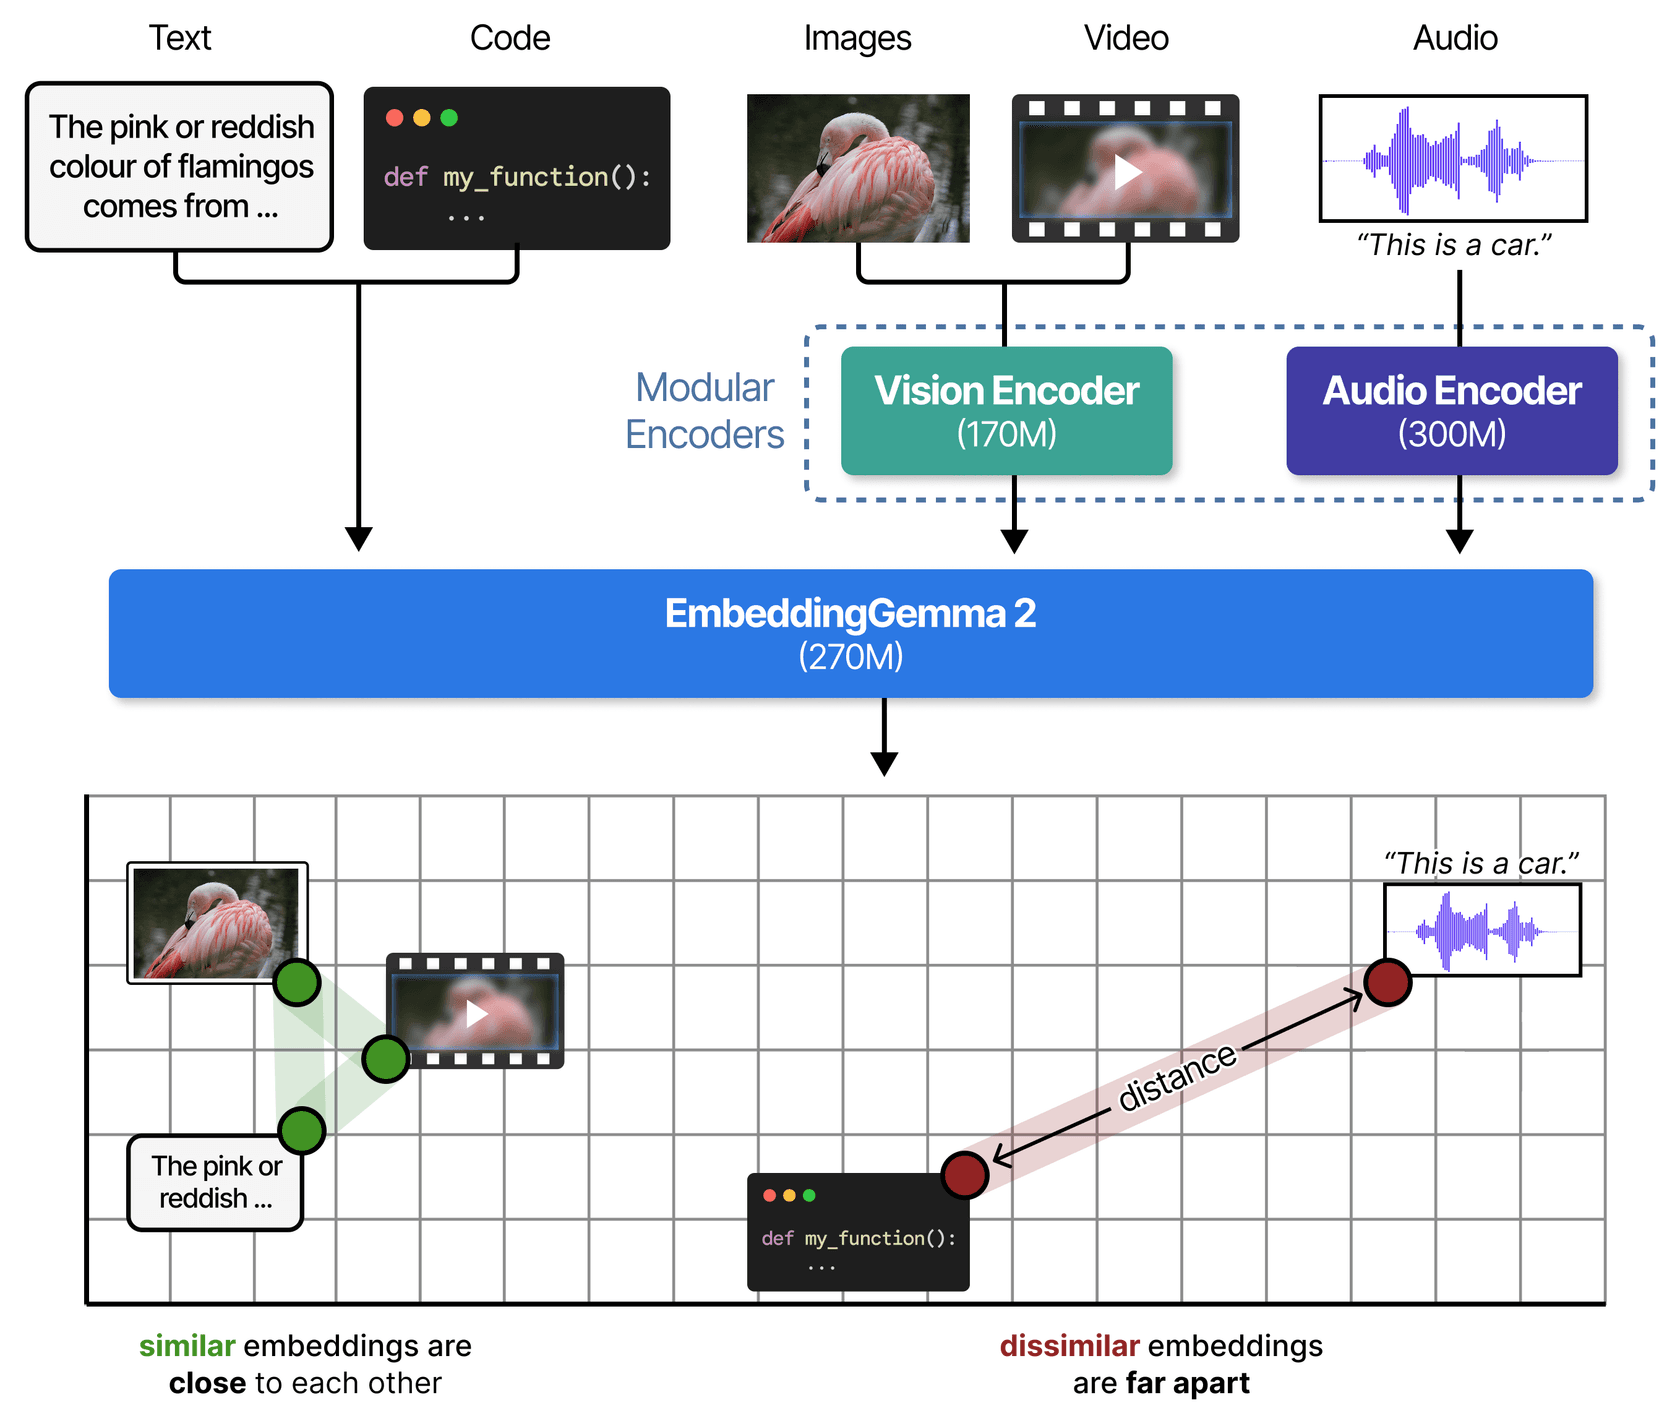
Das erste EmbeddingGemma, ein reines Textmodell mit 308M, erschien 2025 und kam laut Google auf über 20 Millionen Downloads. Version 2 behält die Idee eines kleinen Modells, das überall läuft, und macht es mit vier weiteren Eingabetypen multimodal. Laut Model Card bildet es Text (einschließlich Code), Bilder, Video und Audio oder beliebige Mischungen daraus in einem einzigen 768-dimensionalen Raum ab.
Kurz zu meinem Hintergrund: Ich bin Software-Engineer bei eesel und baue die AI-Agenten, die das Help Center eines Kunden durchsuchen, bevor sie ein Ticket beantworten. Wenn ich einen Embedding-Modell-Launch lese, interessiert mich weniger das Leaderboard als drei Fragen: Was findet es, was das letzte verpasst hat, was kostet der Betrieb, und was geht kaputt. Ich habe dieses Modell nicht in Produktion eingesetzt. Meine Einschätzung stützt sich auf Googles Model Card und Doku, den Developer Guide und die ersten drei Tage an Praxisberichten auf Hacker News.
EmbeddingGemma 2 auf einen Blick
| Spec | EmbeddingGemma 2 | Quelle |
|---|---|---|
| Veröffentlicht | 6. Oktober 2026 | Google blog |
| Parameter | 740M gesamt: 270M Text, 170M Vision, 300M Audio | Model card |
| Eingaben | Text, Code, Bilder, Video, Audio und gemischte Eingaben | Model card |
| Ausgabe | 768 Dimensionen, kürzbar auf 512, 256, 128 | Developer guide |
| Kontextfenster | 8,192 Tokens (v1: 2,048) | Model card |
| Sprachen | 100+ | Gemma docs |
| RAM, quantisiert, Pixel 11 Pro | ~191MB nur Text, ~567MB voll | Google AI Edge |
| Lizenz | Apache 2.0 | Gemma docs |
| Preis | Kostenlose Gewichte; Sie zahlen für Rechenleistung | n/a |
| Basis | Gemma-4-Decoder-Architektur | Gemma docs |
Wie funktioniert EmbeddingGemma 2?
Im Kern ist es ein kleines Textmodell mit zwei optionalen Add-ons vorne dran. Der Kern ist ein Modell mit 270M Parametern (ein 130M-Transformer plus ein 140M-Embedder), angepasst aus dem Gemma 4-Decoder. Ein 170M-Vision-Encoder verarbeitet Bilder, Videoframes und visuelle Dokumente wie PDFs und Folien. Ein 300M-Audio-Encoder nimmt rohe Sprache und Geräusche entgegen. Alles läuft durch dasselbe Backbone und kommt als ein Vektor mit 768 Zahlen heraus.
Das Clevere daran: Die Add-ons sind beim Laden optional. Sie setzen vision_config oder audio_config auf None, und dieser Encoder wird nie geladen, was Speicherplatz und Arbeitsspeicher spart. Laut Googles Developer Guide laden alle vier Setups aus demselben Checkpoint und teilen sich einen Vektorraum. Eine Anfrage, die mit dem reinen 270M-Text-Setup eingebettet wurde, kann Dokumenten entsprechen, die mit dem vollen Modell eingebettet wurden.
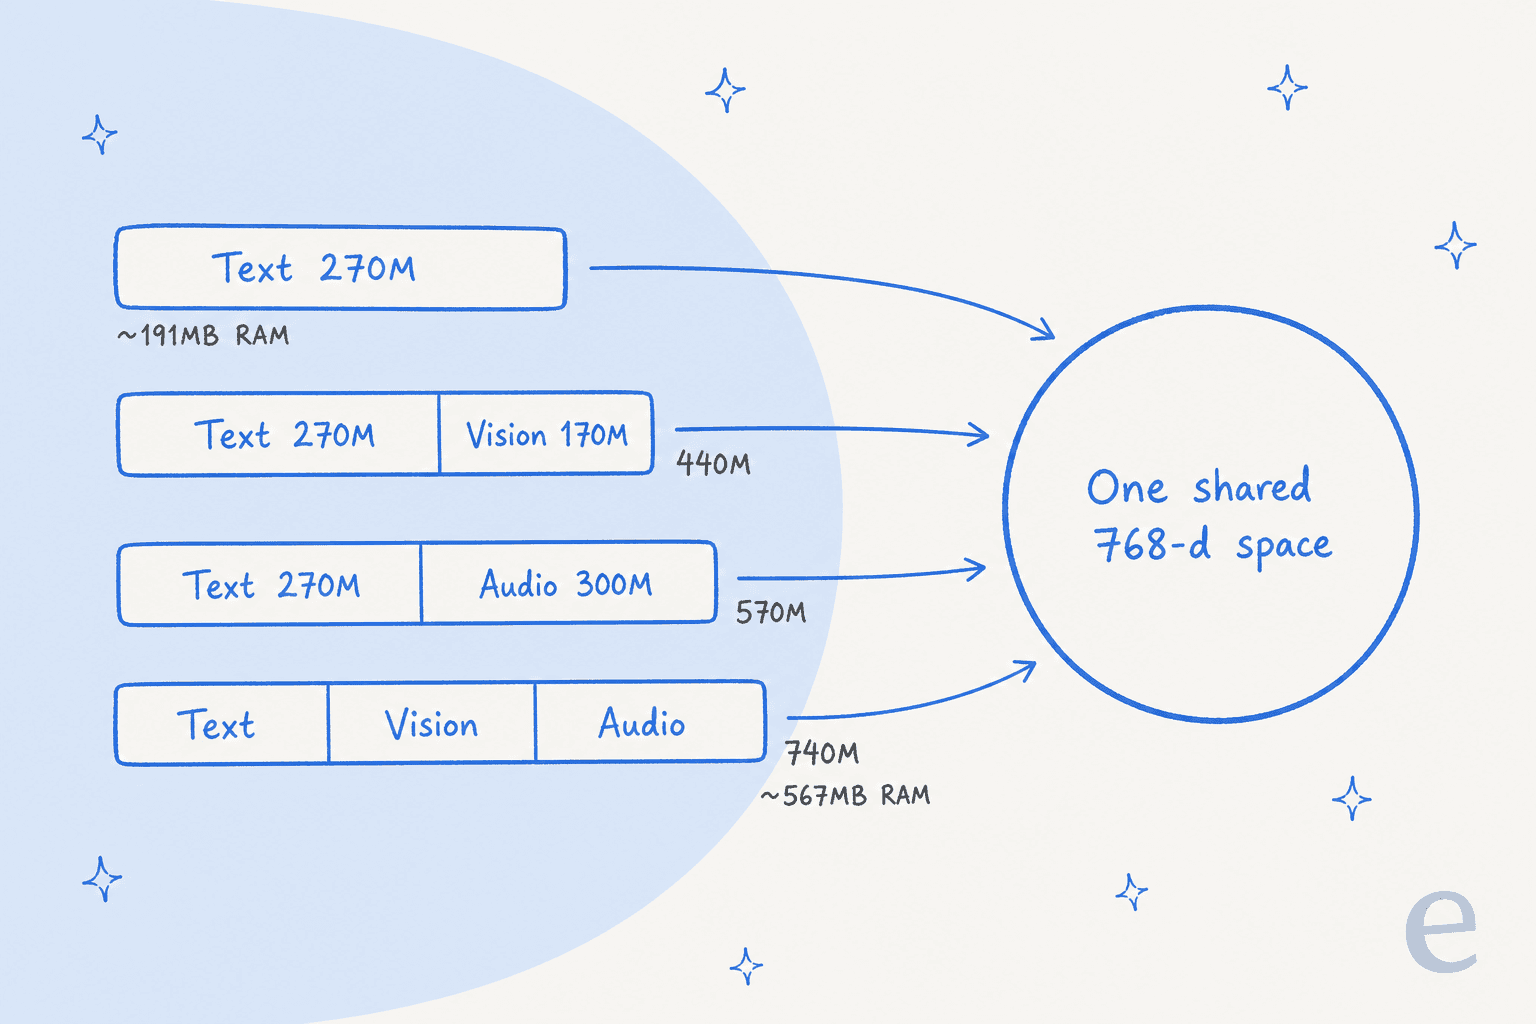
Das hat einen praktischen Vorteil, den ich sehr mag. Sie können mit reinem Text starten und später Bilder ergänzen, ohne einen einzigen vorhandenen Vektor neu zu berechnen, sagt der Guide. Wer schon einmal eine Million Dokumente neu eingebettet hat, weil das Modell gewechselt wurde, weiß, wie viel das wert ist.
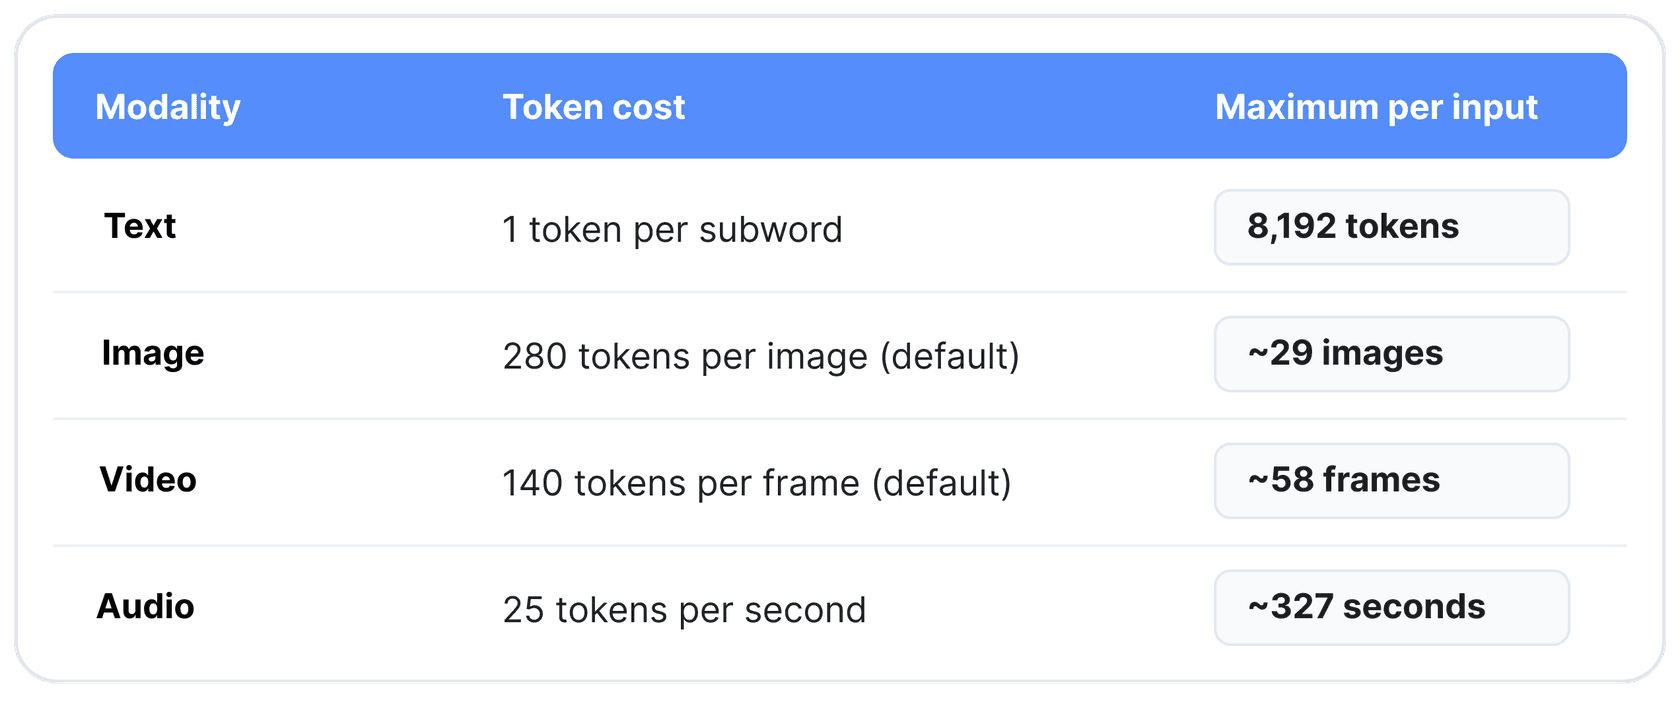
Die Eingaben teilen sich das Kontextfenster mit 8.192 Tokens zu festen Raten, gezählt in Tokens. Ein Bild kostet standardmäßig 280 Tokens, ein Videoframe 140 und eine Sekunde Audio 25. In einem einzigen Aufruf passen also etwa 29 Bilder, 58 Videoframes oder 327 Sekunden Audio, laut Model Card.
Ein paar Mechaniken, die Sie vor dem Programmieren kennen sollten:
- Video wird standardmäßig mit 1 Frame pro Sekunde abgetastet, und Audio muss 16 kHz Mono sein.
- Bilddetails sind ein Regler. Die Multimodal-Doku nennt fünf Budgets pro Bild: 70, 140, 280, 560 oder 1.120 Tokens. Mehr Tokens bedeuten feinere Details und langsamere Läufe.
- Sie können mischen. Eine Eingabe kann Text mit den Platzhaltern
<|image|>,<|video|>und<|audio|>kombinieren, etwa eine Produktseite mit Foto und Demo-Clip, und trotzdem kommt ein einziger Vektor heraus. - Text bekommt ein Task-Präfix, Medien nicht. Anfragen sehen so aus:
task: search result | query: ..., Dokumente so:title: ... | text: .... Ohne Präfix funktioniert es auch, kostet aber Präzision.
Was hat sich gegenüber EmbeddingGemma 1 geändert?
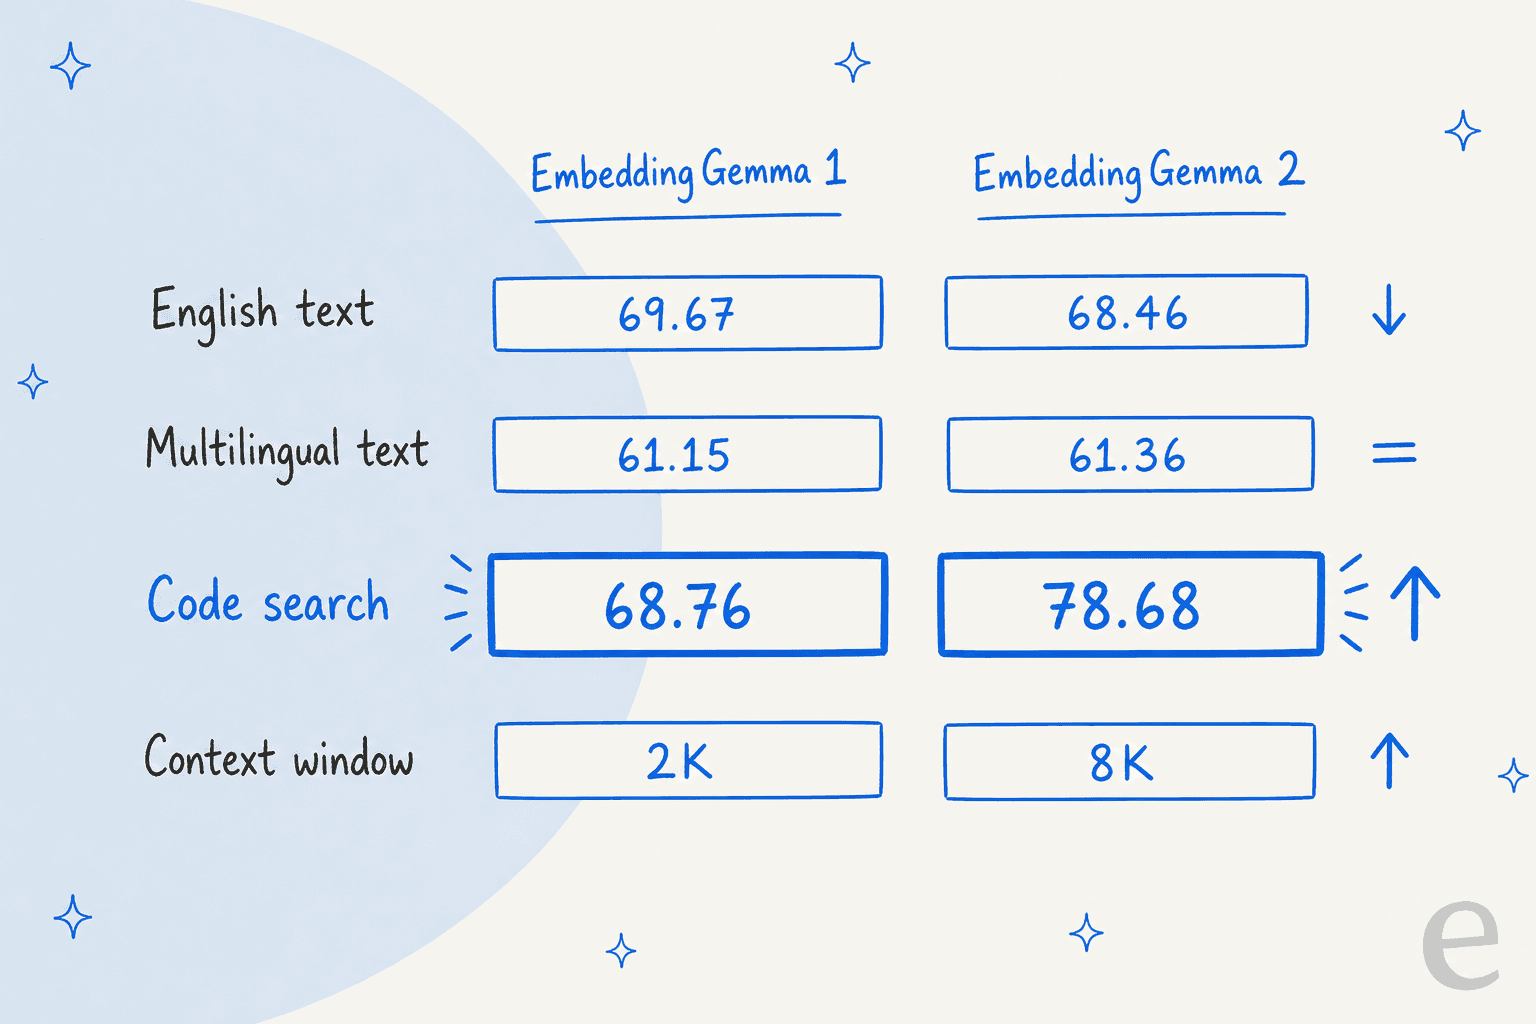
Hier würde ich langsamer werden, denn die Launch-Darstellung und die Zahlen erzählen leicht unterschiedliche Geschichten. Googles Ankündigung sagt, v2 erreiche bei mehrsprachigem Text die Leistung von v1 und springe bei Code nach oben. Das stimmt. Aber die Model Card enthält auch MTEB Englisch, und dort liegt v2 etwas zurück.
| Benchmark (768 Dim.) | EmbeddingGemma 1 | EmbeddingGemma 2 | Änderung |
|---|---|---|---|
| MTEB English v2 | 69.67 | 68.46 | -1.21 |
| MTEB Multilingual v2 | 61.15 | 61.36 | +0.21 |
| MTEB Code v1 | 68.76 | 78.68 | +9.92 |
| Kontextfenster | 2,048 Tokens | 8,192 Tokens | 4x |
| Eingaben | Text | Text, Code, Bild, Video, Audio | +4 |
| Lizenz | Gemma-Bedingungen, geschützter Download | Apache 2.0 | Offen |
Die v1-Zahlen stammen von der EmbeddingGemma-300M-Card, die v2-Zahlen von der v2-Card. Frühe Praxistester kamen zum selben Ergebnis:
"for text, benchmarks are identical to the first EmbeddingGemma. but you can use this new one and enable/disable what you don't need. can keep only text for ex."

Mein Fazit ist einfach. Wenn Sie nur englischen Text durchsuchen, ist v2 ein Schritt zur Seite, und das Upgrade lohnt sich nur, wenn Ihnen der viermal längere Kontext hilft (weniger, größere Chunks) oder die Apache-Lizenz ein Produkt freischaltet. Wenn Sie Code oder alles andere als Text durchsuchen, ist es ein großer Schritt. Für ein Help Center, das überwiegend aus Artikeln besteht, ist mein Beitrag zu RAG vs. Fine-Tuning wichtiger als dieses Upgrade.
Was die neuen Benchmarks sagen
Für die neuen Eingabetypen gibt es kein v1 zum Vergleich, die Werte der Model Card stehen also für sich. Google nennt es „best-in-class“ unter den multimodalen Embedding-Modellen unter 1B bei MTEB Code und MAEB, dem Audio-Benchmark. Das ist eine Herstellerbehauptung ohne direkte Vergleichstabelle auf der Card, nehmen Sie sie also als Ausgangspunkt.
| Eingabe | Benchmark | Wert |
|---|---|---|
| Bild | MIEB lite | 64.64 |
| Bild | MMEB v2 Image (Hit@1) | 57.28 |
| Visuelle Dokumente | MMEB v2 VisDoc (NDCG@5) | 67.84 |
| Video | MMEB v2 Video (Hit@1) | 50.67 |
| Audio | MSEB Retrieval (MRR@10) | 69.54 |
| Audio | MAEB | 49.39 |
Zwei Dinge aus dem HN-Thread möchte ich hervorheben. Ein Kommentator fragte, warum es nicht mit SigLIP 2 verglichen wird, Googles eigenem Bild-Text-Modell. Ein anderer ließ es lokal laufen und stellte fest, dass das Zero-Shot-Klassifikationsbeispiel aus Googles eigener Demo danebenlag:
"I got this running locally, and funnily enough the exact example they have for classifying "Cancel my flight and refund my credit card immediately." failed. It said the request does not involve a payment, charge, or refund, with a p(true) of 0.22 (where true means it is financial)."
Das tut ein wenig weh, wenn man es für das Ticket-Routing im Blick hat, denn „Erstattung oder nicht“ ist genau das Label, das ein Support-Team haben will. Ein Datenpunkt ist kein Urteil, aber ein guter Grund, mit Ihren eigenen Tickets zu testen, bevor Sie es irgendwo anschließen.
Es gibt außerdem einen leiseren Stolperstein in der Multimodal-Doku: Ähnlichkeitswerte sind über Modalitäten hinweg nicht kalibriert. Ein unverwandtes Gemälde erreichte gegenüber einem Foto der Golden Gate Bridge 0,585, mehr als unverwandte Textprompts. Vergleichen Sie den Rang innerhalb einer Suche, nicht die Rohwerte zwischen Bildern und Text.
Wie schnell und klein ist es wirklich?
Hier verdient sich EmbeddingGemma 2 das Etikett „On-Device“. Googles AI-Edge-Team hat Zahlen pro Gerät veröffentlicht, um ein Bild mit einem Budget von 70 Tokens einzubetten:
| Gerät | Chip | Latenz pro Bild | Bilder/Sek. |
|---|---|---|---|
| iPhone 18 Pro | CPU | 191 ms | 5.2 |
| iPhone 18 Pro | GPU | 69.8 ms | 14.3 |
| Pixel 11 Pro XL | NPU | 48.9 ms | 20.6 |
| MacBook M5 Pro | GPU | 37.3 ms | 26.9 |
| Dell XPS 16 | NPU | 49.8 ms | 20.1 |
| Raspberry Pi 5 | CPU | 1,761 ms | 0.6 |
Praxiswerte von einem Laptop sehen ähnlich aus. Ein HN-Kommentator teilte den Durchsatz auf einem M3 Pro:
"Text: 78 embeddings/second on small texts - Image: 4 embeddings/second - Audio: 6 embeddings/second for 30 second chunks (which is how the encoder works) - Video: 0.2 embeddings/second per minute of video"
Beachten Sie die Lücke. Video mit 0,2 pro Minute Material bedeutet, dass eine Stunde Video auf diesem Laptop etwa fünf Minuten zum Indexieren braucht. Gut für eine Bibliothek mit Produktdemos. Zu langsam für Live-Video mit hohem Volumen.
Speicherplatz ist der andere Hebel. Das Modell nutzt Matryoshka-Training, sodass Sie Vektoren von 768 Zahlen auf 512, 256 oder 128 kürzen und den Großteil der Qualität behalten können. Laut Developer Guide belegen eine Million 768-dim-Vektoren in bfloat16 etwa 1,5GB, bei 128 Dimensionen etwa 250MB.
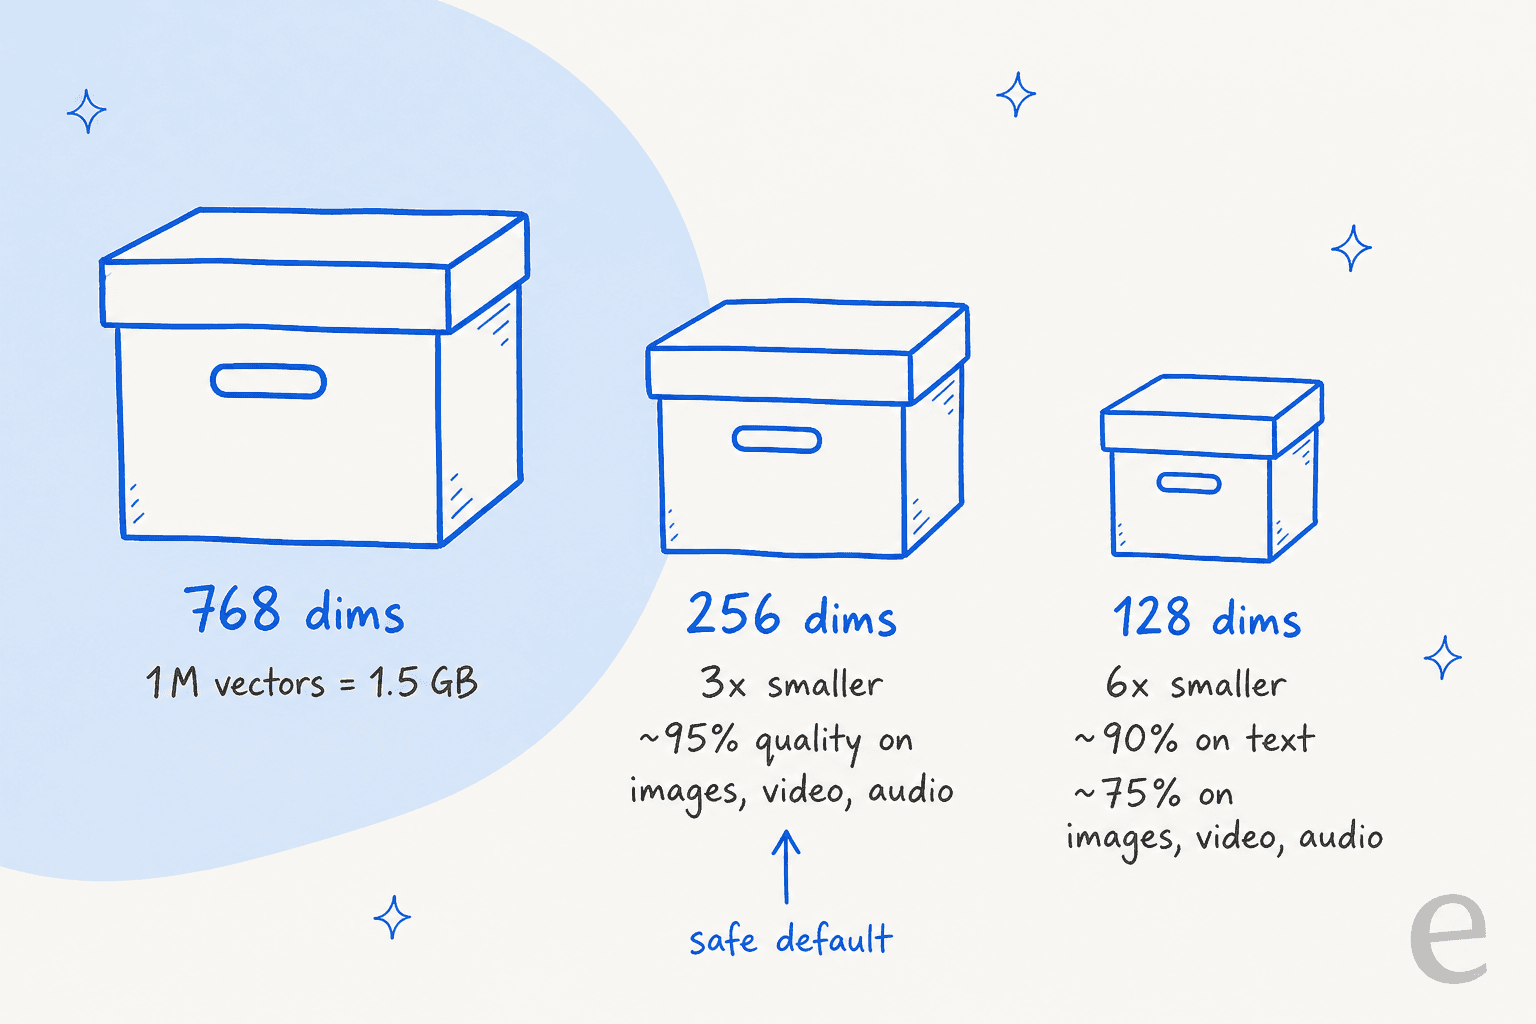
Der Haken: Medien verschlechtern sich beim Stauchen schneller als Text. Auf der Model Card fällt MMEB v2 von 59,01 bei 768 Dimensionen auf 45,65 bei 128. Bei einem gemischten Index würde ich bei 256 Dimensionen aufhören und nur für reine Text-Shortlists, die Sie anschließend neu ranken, auf 128 gehen. Zwei Regeln der Card, die Sie erwischen, wenn Sie sie ignorieren: Vektoren nach dem Kürzen neu normalisieren und es nie in float16 laufen lassen. Die Aktivierungen laufen über, und Sie bekommen NaNs oder stillschweigend schlechtere Vektoren ohne Fehlermeldung.
Welches EmbeddingGemma-2-Setup sollten Sie laden?
Da Sie Speicher nur für die geladenen Encoder zahlen, ist die erste Entscheidung, was Ihr Index tatsächlich enthält. Wählen Sie die nächstliegende Option:
Was kommt in Ihren Suchindex?
Tippen Sie auf eine Option, um das Setup zu sehen, mit dem ich starten würde.
vision_config=None, audio_config=None. Ehrlicher Hinweis: Bei rein englischer Suche erreichte v1 etwas mehr (69,67 vs. 68,46). Wechseln Sie wegen des 8K-Kontexts oder Apache 2.0, nicht wegen der Genauigkeit. 256 Dimensionen sind ein sicherer Speicherschnitt.CodeRetrieval für Anfragen und setzen Sie den Dateinamen in den Dokumenttitel. Bleiben Sie bei 512 oder 768 Dimensionen; Code verliert beim Kürzen am schnellsten Qualität.audio_config=None. Vision deckt Bilder, PDFs, Folien und Diagramme ab (MMEB v2 VisDoc 67,84). Erhöhen Sie das Bildbudget auf 560 oder 1.120 Tokens, wenn Ihre Screenshots kleinen Text enthalten. Behalten Sie 256 Dimensionen oder mehr.vision_config=None. Audio auf 16 kHz Mono resamplen und in Chunks teilen; ein Aufruf fasst etwa 327 Sekunden. Es erkennt Sprachinhalt, nicht nur „das ist Sprache“, aber testen Sie zuerst mit Ihren eigenen Anrufen.Wie betreibt man EmbeddingGemma 2?
Die Gewichte liegen auf Hugging Face und Kaggle (neu auf der Plattform? Starten Sie mit meiner Hugging-Face-Erklärung), und die Unterstützung am ersten Tag ist breit: sentence-transformers (ab v6.1.0), Transformers, vLLM, SGLang, MLX, llama.cpp GGUF, Ollama, LM Studio und Googles eigenes LiteRT für Handys. Der kürzeste Weg, direkt aus der Model Card:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
Wenn Sie Python lieber nicht anfassen möchten: Der Ollama-Build passt in die meisten lokalen RAG-Stacks, und Frameworks wie LangChain und LlamaIndex behandeln es wie jeden anderen Embedder.
Ein durchgespieltes Support-Beispiel finden Sie in meiner Anleitung zur Support-RAG-Pipeline oder in diesem Guide zur semantischen Suche in Zendesk. Sie brauchen weiterhin einen Ort für die Vektoren; Qdrant hat am Launch-Tag einen Guide veröffentlicht, und mein Beitrag zu RAG vs. Vektordatenbanken hilft bei der Auswahl.
Auf Handys bringt Google es „in den kommenden Wochen“ als verwalteten ML Kit-Dienst auf Android, mit NPU-Beschleunigung. Bis dahin ist die App AI Edge Gallery der einfachste Weg, es auszuprobieren. Die Demo Instant Media Search durchsucht Ihre Kamerarolle beim Tippen, offline, und der Video Moments Finder springt für Anfragen wie „Hund fängt Frisbee“ ohne Transkript zu Zeitstempeln.
Selbst hosten oder Gemini Embedding 2 nutzen?
Das ist die zweite Umdeutung, die ich anbieten würde. EmbeddingGemma 2 ist kostenlos herunterladbar, und viele nehmen an, das mache es zur günstigen Option. Für die meisten Teams ist es nicht viel günstiger, weil Googles gehostetes Schwestermodell schon sehr günstig ist.
Gemini Embedding 2 ist Googles bezahlte multimodale Embedding-API und das einzige Embedding-Modell auf der aktuellen Preisliste der Gemini API. (Wenn Sie Googles API allgemeiner abwägen, lesen Sie OpenAI API vs. Gemini API.) Mein Beitrag zu den Gemini-Preisen deckt den Rest ab; hier sind die Embedding-Preise:
| Eingabe | Standard (pro 1M Tokens) | Batch | Pro Einheit (Standard) |
|---|---|---|---|
| Text | $0.20 | $0.10 | n/a |
| Bild | $0.45 | $0.225 | $0.00012 pro Bild |
| Audio | $6.50 | $3.25 | $0.00016 pro Sekunde |
| Video | $12.00 | $6.00 | $0.00079 pro Frame |
Nun ein durchgerechnetes Beispiel für ein mittelgroßes Support-Team. Angenommen, 2.000 Hilfeartikel mit etwa 800 Tokens je Artikel (1,6M Tokens), 10.000 Produkt-Screenshots und 100 Stunden aufgezeichnete Anrufe:
- Artikel: 1,6M Tokens x $0.20 = $0.32
- Screenshots: 10.000 x $0.00012 = $1.20
- Anrufe: 360.000 Sekunden x $0.00016 = $57.60
Das sind unter $60, um die gesamte Bibliothek einmal einzubetten, zu Standardpreisen, und im Batch die Hälfte. Eine gemietete GPU für die $1 bis $2 pro Stunde, die ein HN-Kommentator nannte, würde allein bis zum Start länger laufen. Ich würde die Wahl also so formulieren:
- Nutzen Sie Gemini Embedding 2, wenn Ihre Daten an Googles API gehen dürfen und Sie null Einrichtung wollen. Beachten Sie nur, dass Daten im kostenlosen Tarif zur Verbesserung von Google-Produkten verwendet werden können, im bezahlten Tarif nicht.
- Nutzen Sie EmbeddingGemma 2, wenn die Daten das Gerät oder Ihre eigenen Server nicht verlassen dürfen (Gesundheit, Recht, interner Support), wenn Sie es offline brauchen oder Anfragen auf einem Handy ohne Roundtrip einbetten wollen. Das sind echte Gründe. Kosten allein meist nicht.
Simon Willison hat das Argument für offene Embedder gut formuliert:
"I really appreciate that EmbeddingGemma 2 is under the Apache 2.0 license. For embedding models in particular, I don't think it makes sense to use a closed, proprietary, hosted-only model."
Sein Punkt betrifft eher Lock-in als den Preis. Jeder Vektor in Ihrem Index ist an das Modell gebunden, das ihn erzeugt hat. Wird ein gehostetes Modell eingestellt, betten Sie alles neu ein. Mit offenen Gewichten bleibt das Modell, mit dem Sie indexiert haben, verfügbar, solange Sie eine Kopie behalten.
Warum Support-Teams der multimodale Teil interessieren sollte
Hier ist der Blickwinkel, den ich in der Launch-Berichterstattung nicht gesehen habe. Die meisten Texte über RAG für den Kundenservice gehen davon aus, dass das Wissen aus Text besteht. In der Praxis ist ein großer Teil das nicht, und es kommt in den Sales-Calls von eesel ständig zur Sprache.
Eine DTC-Supplement-Marke mit etwa 7.000 Tickets im Monat sagte, ihre Antworten steckten in ClickUp-SOPs, nicht transkribierten Loom-Videos und alten Makros. Ein IT-Dienstleister im öffentlichen Sektor mit rund 3.000 komplexen Tickets im Monat arbeitet mit Freshdesk und bildlastiger technischer Doku. Teams für technische Produkte fragen immer wieder nach einer AI, die die Diagramme in ihren PDFs und die Fotos lesen kann, die Kunden an Tickets anhängen. Reine Text-Embedder sehen davon nichts, solange es niemand transkribiert oder beschriftet, weshalb so viele Support-Wissensdatenbank-Tools Medien noch als Anhang statt als Antwort behandeln.
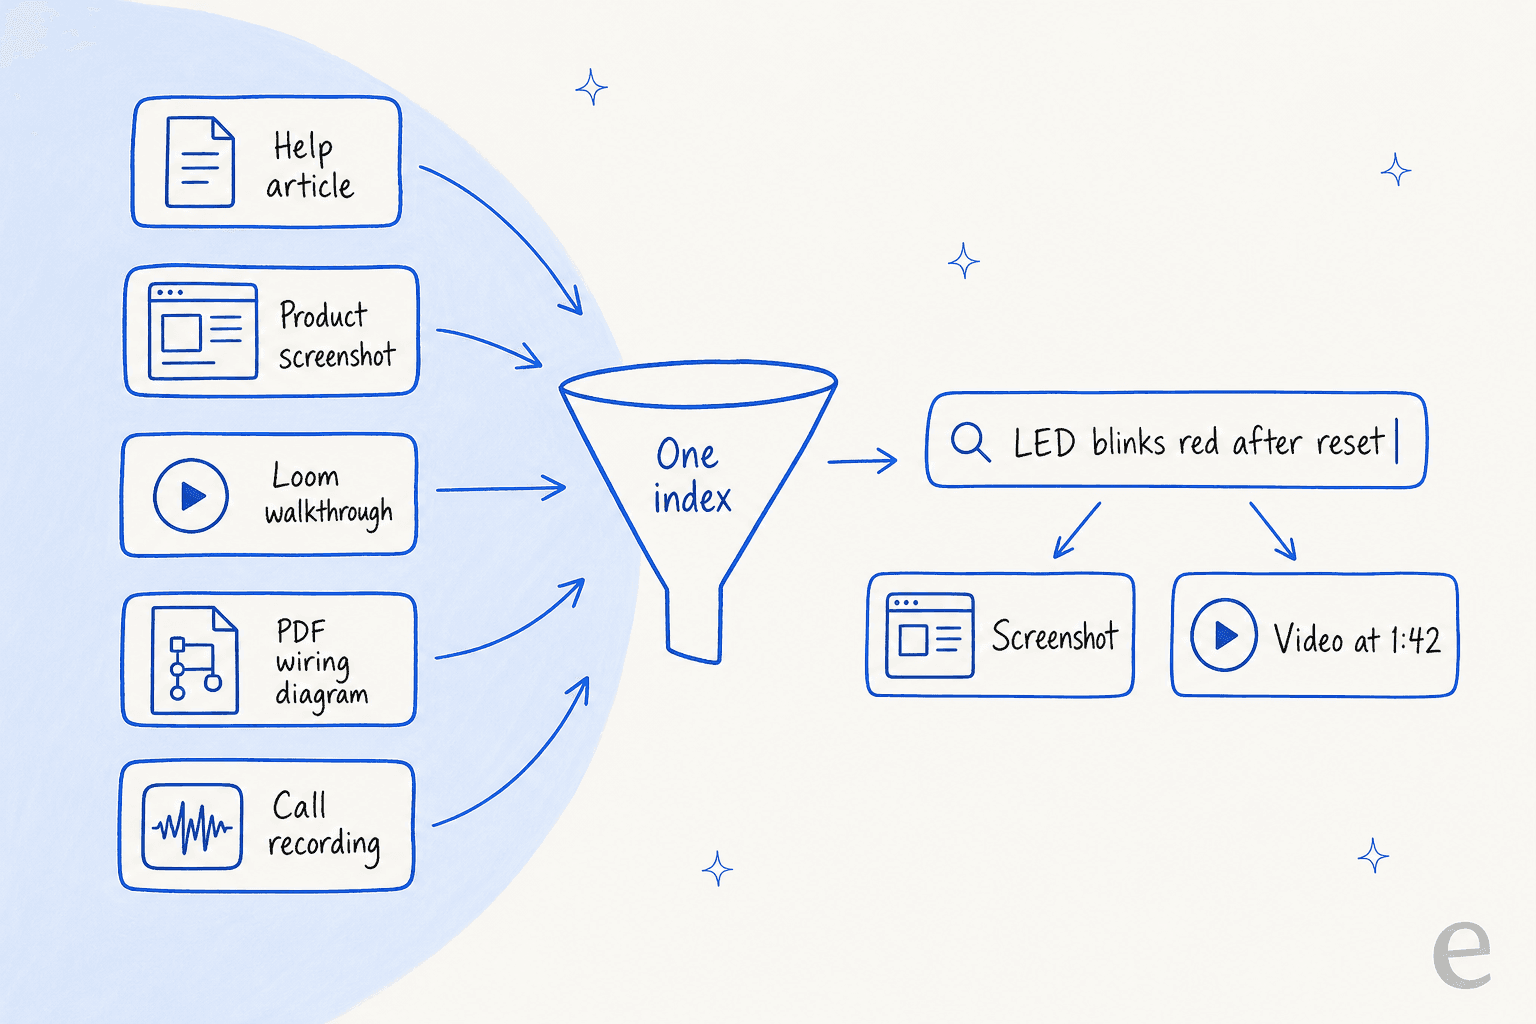
Ein gemeinsamer Raum ist die Lösung dafür. Indexieren Sie Screenshot, Walkthrough und Artikel zusammen, und eine Textanfrage wie „LED blinkt nach Reset rot“ kann den richtigen Frame des richtigen Videos zurückholen. Ein HN-Leser, ein Anwalt, beschrieb dieselbe Idee für Fallakten:
"I could imagine using it to search a case file for "undamaged roof before Hurricane Katrina" and "damaged roof after Hurricane Katrina" and being able to locate both deposition testimony and pertinent photographs in the body of evidence."
Aber Retrieval ist nur die Hälfte eines Support-Bots, und meiner Erfahrung nach nicht die Hälfte, die wehtut. Anfang dieses Jahres sahen einige zahlende eesel-Kunden, darunter ein dänischer Solarenergie-Anbieter, wie ihr Bot Antworten erfand, wenn die Suche in der Wissensdatenbank leer blieb. Er füllte die Lücke aus den Trainingsdaten des Modells, ein Lehrbuchfall von AI-Halluzination, und schickte erfundene Abo-Details an echte Kunden.
Ein besserer Embedder hätte das nicht behoben. Eine harte Regel „kein Treffer, an einen Menschen übergeben“ hat es getan, dazu Simulationen des Bots gegen frühere Tickets vor dem Go-live. Wenn Sie auf EmbeddingGemma 2 aufbauen, planen Sie diese Schicht von Anfang an ein; mein Guide zum Stoppen von AI-Halluzinationen behandelt die Muster.
Wer sollte EmbeddingGemma 2 nutzen?
| Sie sind | Meine Einschätzung |
|---|---|
| Sie bauen Suche über eine Codebasis oder Speicher für Coding-Agenten | Nutzen Sie es. +9,92 Punkte bei MTEB Code sind der klarste Gewinn dieses Releases. |
| Sie durchsuchen Fotos, Screenshots, PDFs, Audio oder Video | Nutzen Sie es, mit 256 Dimensionen oder mehr, und testen Sie mit Ihren eigenen Dateien. |
| Sie liefern On-Device- oder Offline-Suche in einer App aus | Nutzen Sie es. 191MB für Text sind klein genug für ein Handy, und Android-ML-Kit-Support kommt. |
| Sie nutzen bereits EmbeddingGemma 1 nur für englischen Text | Bleiben Sie dabei, außer Sie brauchen 8K Kontext oder die Apache-Lizenz. |
| Sie betreiben Support-Suche in der Cloud ohne Datenbeschränkungen | Gemini Embedding 2 ist weniger Arbeit für etwa dasselbe Geld. |
| Sie wollen einen funktionierenden Support-Bot, keine Pipeline | Sparen Sie sich den Bau. Das Modell ist nur ein Teil von fünf. |
Für Vergleiche mit anderen Optionen decken meine Beiträge zu Cohere Embed 5 und zur OpenAI-Embeddings-API die wichtigsten gehosteten Alternativen ab, und kleine Sprachmodelle geht tiefer auf den On-Device-Trend ein, zu dem dieses Modell gehört.
Für das größere Feld vergleicht meine Übersicht zu Knowledge-Retrieval-Tools die fertigen Produkte.
Das Fazit
EmbeddingGemma 2 ist ein gutes, ehrliches Release. Das modulare Design ist klug, die Apache-Lizenz beseitigt ein echtes Hindernis, und Code- sowie multimodale Suche machen einen klaren Schritt nach vorn, in einem Paket, das klein genug für ein Handy ist. Wenn Ihre Daten nicht nur Text sind, ist es das erste offene Modell, das ich ausprobieren würde.
Lesen Sie nur über die Schlagzeile hinaus. Bei englischem Text liegt es gleichauf mit dem Modell, das es ersetzt, die „best-in-class“-Aussagen stammen von Google selbst, und für die meisten Cloud-Teams kostet die gehostete API etwa so viel wie der Eigenbetrieb. Wählen Sie es für Datenschutz, Offline-Nutzung, Code oder Medien, und Sie werden zufrieden sein. Wählen Sie es in der Erwartung eines großen Sprungs bei reiner Textsuche, und Sie werden ihn nicht sehen.
eesel ausprobieren
Wenn Sie hier sind, weil Sie einen Support-Bot auf einem frischen Embedding-Modell bauen wollen, hier die Abkürzung: Der Embedder findet Textstellen, aber jemand muss sie trotzdem lesen, die Antwort schreiben und wissen, wann er schweigt. eesels AI-Helpdesk-Teammate erledigt diese Aufgabe in Zendesk, Freshdesk oder Gorgias. Er lernt aus Ihrem Help Center, Ihrer Doku an Orten wie Confluence und Google Docs und Ihren früheren Tickets und führt dann eine Simulation über Hunderte Ihrer echten Tickets aus, sodass Sie seine Antworten sehen, bevor ein Kunde sie sieht. Wenn die Suche leer bleibt, übergibt er das Ticket an einen Menschen, statt zu raten.

Es gibt einen kostenlosen Tarif mit 100 Credits und ohne Karte, und die bezahlten Tarife finden Sie auf der Preisseite. Probieren Sie eesel aus und spielen Sie die Tickets des letzten Monats nach, bevor Sie irgendetwas bauen.