

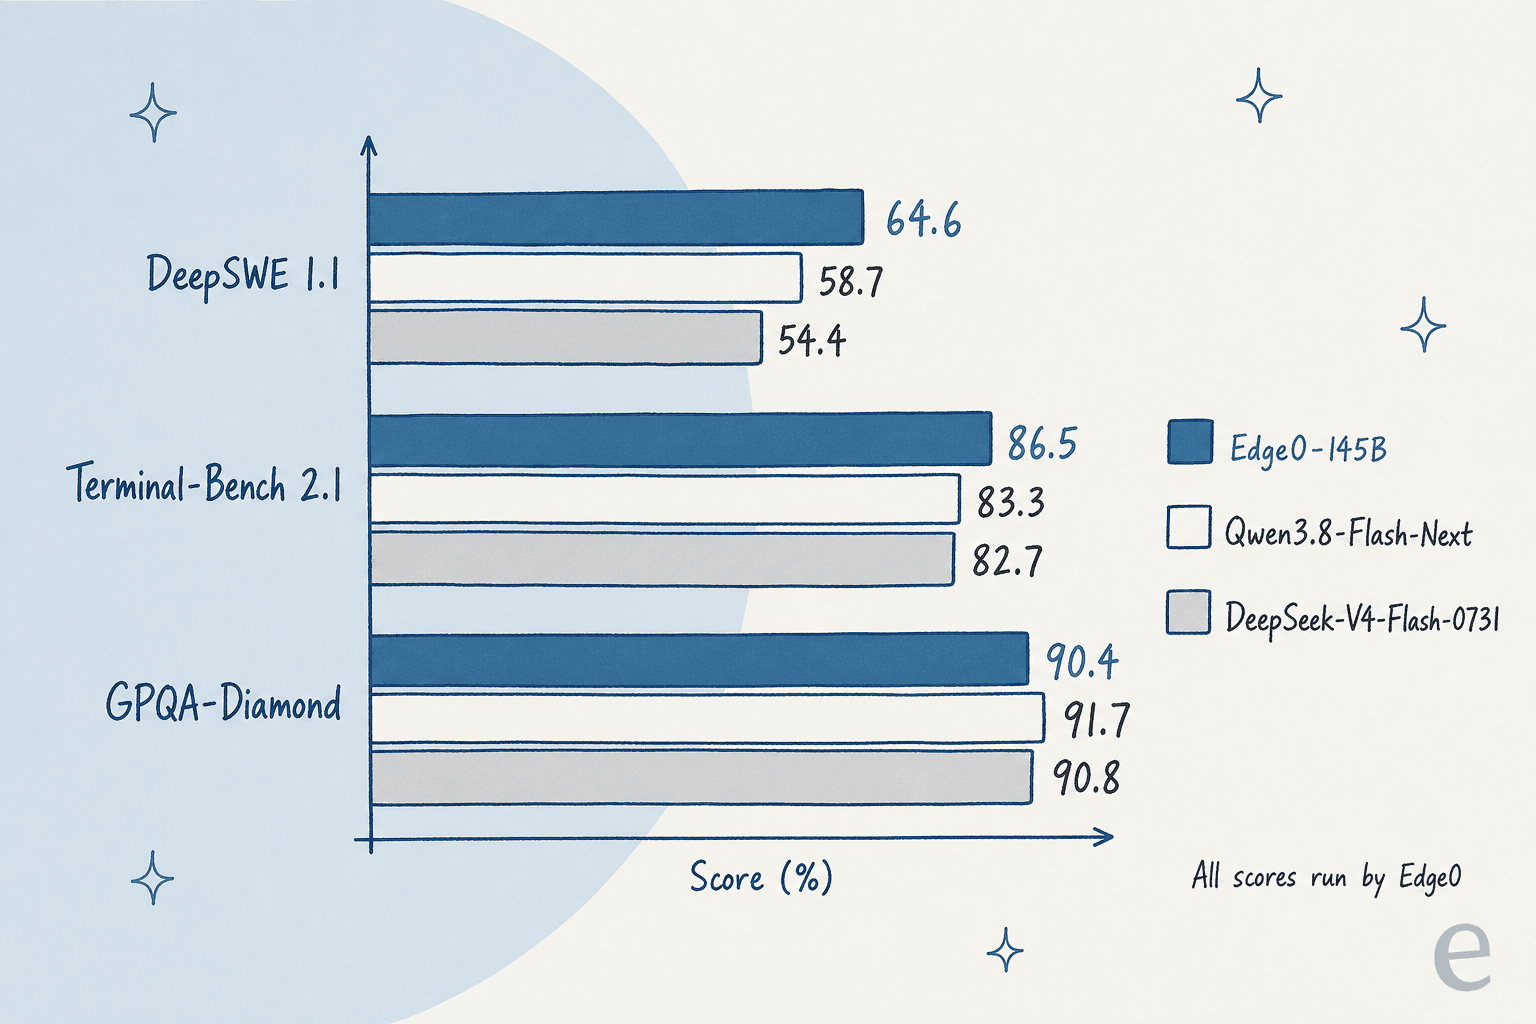
Edge0-145B ist ein Modell mit 145 Milliarden Parametern, gebaut, um auf einer einzigen Consumer-Grafikkarte zu laufen, und das Engineering darunter ist real. In Edge0s eigenen Tests erreicht es 86.5 bei Terminal-Bench 2.1 und 64.6 bei DeepSWE 1.1, vor seinem Basismodell Qwen3.8-Flash-Next.
Die Launch-Versprechen brauchen allerdings Fußnoten. Die "29GB"-Zahl lässt rund 31 GiB System-RAM weg, macOS-Unterstützung ist nicht im Release, und die Gewichte tragen eine Lizenz, die kommerzielle Services einschränkt. Mein Urteil: 3/5, einen Test auf einer NVIDIA-Maschine wert, aber noch nicht wert, deinen Stack darum herum neu zu bauen.
Für Support-Teams, die auf Privatsphäre achten, zählt das Modell weniger als das, was der Bot lesen darf. eesel antwortet nur aus deinem freigegebenen Wissen, und mit der eesel CLI kann jeder Coding-Agent dieses Wissen hochladen und Testfragen stellen, bevor irgendetwas live geht.
Wie ich Edge0-145B getestet habe
Edge0 hat den Release am 13. November veröffentlicht, dieser Test ist also zwei Tage danach entstanden. Ich baue Integrationen und APIs bei eesel, also lese ich Releases wie dieses so, wie ich die Doku jedes Anbieters lese: Der Launch-Post sagt dir, was sie dich glauben lassen wollen, und das README sagt dir, was wirklich ausgeliefert wird. Ich habe mit drei Quellen gearbeitet, in dieser Vertrauensreihenfolge:
- Edge0s eigene Release-Dateien. Das GitHub-README, die Hugging-Face-Modellkarte, und die Lizenz-Herkunftsdatei im Repo. Diese tragen die gemessenen Zahlen.
- Edge0s Launch-Post. Nützlich für Intention und Demos, aber wo er dem README widerspricht, halte ich mich ans README.
- Frühe Nutzer. Der Hacker-News-Launch-Thread kam über 330 Punkte und 100 Kommentare, mit ein paar Leuten, die es auf eigener Hardware ausprobiert haben.
Ich habe keine eigene Benchmark-Suite gefahren, und kein unabhängiges Labor wie Artificial Analysis hatte am 14. November eine Seite für Edge0-145B. Behandle jeden Wert unten als Edge0s eigenen. Wenn du erst die breitere Modell-Landschaft willst, decken die Artikel meiner Kollegen zu DeepSeek V4 Flash und Qwen 4 Max die beiden Familien ab, mit denen Edge0 sich vergleicht.
Was ist Edge0-145B?
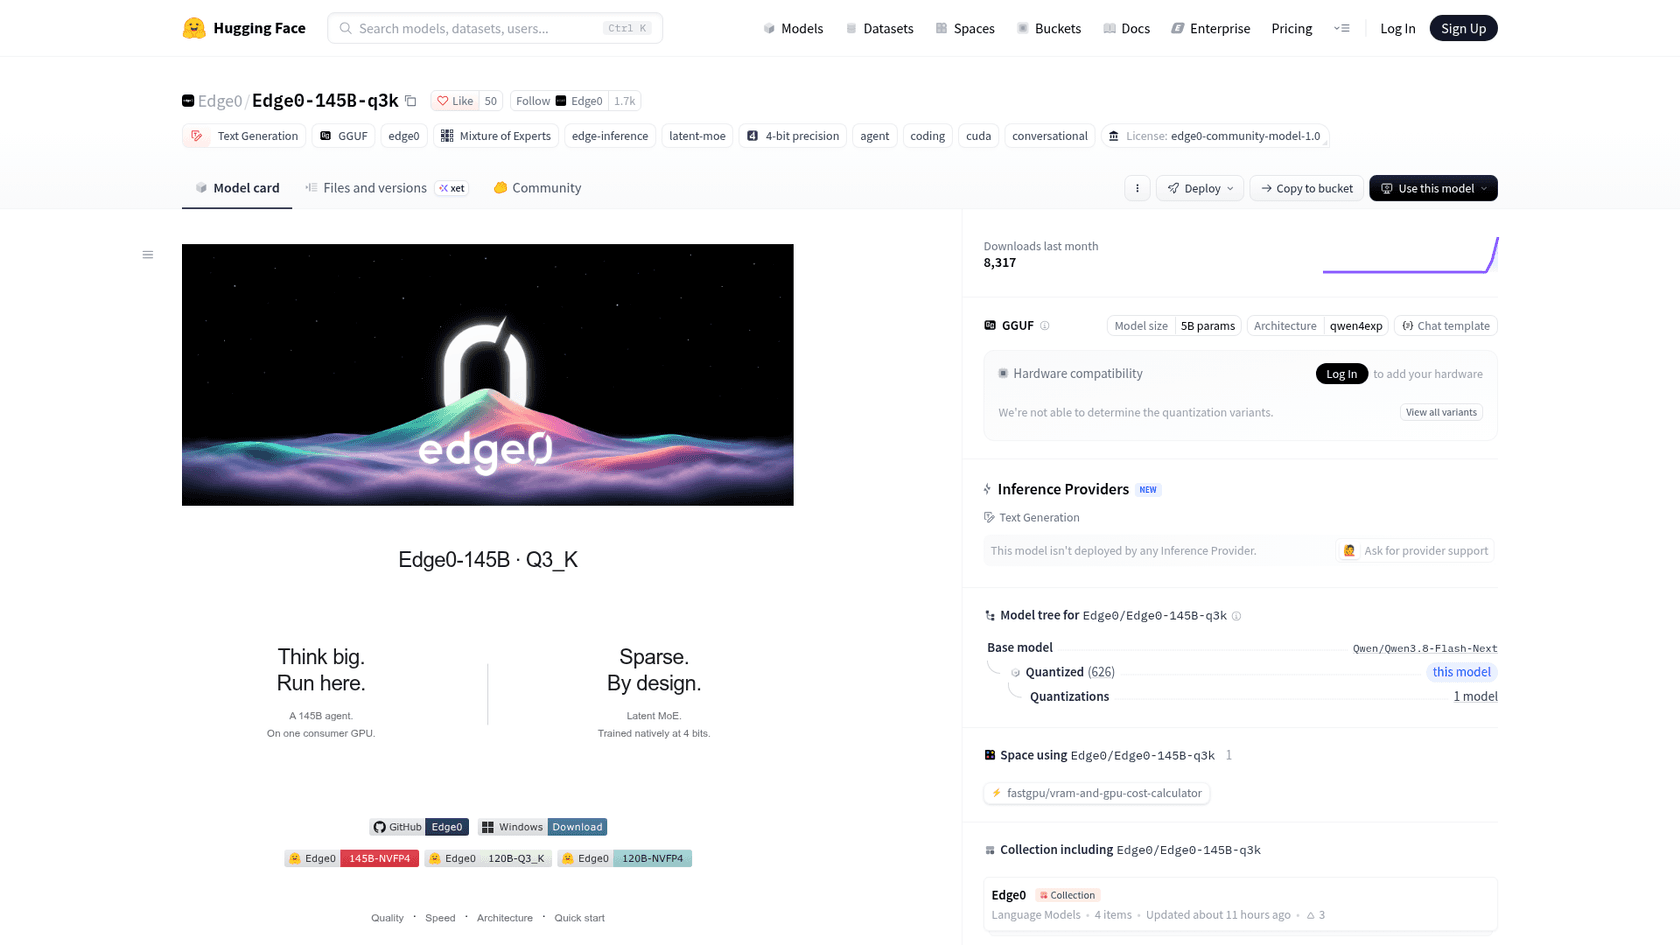
Edge0-145B ist ein latentes Mixture-of-Experts-Modell von Edge0, einem Team, das zuvor im September das Telefon-Modell Edge0-35B und die Audio8-Sprachmodelle ausgeliefert hat. Es hat 145B Parameter insgesamt, aber nur etwa 10.12B aktiv pro Token, was erklärt, wie es auf Hardware passt, die niemals ein dichtes 145B-Modell halten könnte.
So beschreibt die Modellkarte es:
| Spezifikation | Edge0-145B | Edge0-120B |
|---|---|---|
| Gesamt- / aktive Parameter | 145B / 10.12B | 120B / nicht angegeben |
| Layer und Experten | 48 Layer, 512 Experten, 10 geroutet + 1 geteilt pro Token | Gleich |
| Latente Expertenbreite | 1,792 | 1,280 |
| Kontextfenster | 256K (KV int8, 32K residieren) | 256K |
| Builds auf Hugging Face | Q3_K (40.81 GiB), NVFP4 (47.79 GiB) | Q3_K (27.98 GiB), NVFP4 (32.96 GiB) |
| Basismodell | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
| Engine | edge0-strata (Fork von Strata) | edge0-strata |
Zwei Zeilen dieser Tabelle erzählen den Großteil der Geschichte. Das Basismodell ist Qwen, und die Engine ist ein Fork des Open-Source-Projekts Strata. Edge0 sagt das klar im README, obwohl der Launch-Post Qwen überhaupt nicht erwähnt. Genau diese Lücke ist es, worauf sich die meisten frühen Kommentatoren eingeschossen haben:
"Based on Qwen3.8-Flash-Next and Strata. They made some interesting tweaks and did some fine tuning on the model, but it's interesting how much marketing speak was layered on their website to hide this fact."

Ein Derivat zu sein ist kein Fehler. Die meisten guten offenen Modelle starten heute von der Basis eines anderen, und die echte Frage ist, ob Edge0s Änderungen etwas bringen. Darauf scheint die Antwort ja zu lauten.
Was Edge0-145B gut macht
Drei Dinge sind aufgefallen, und alle drei drehen sich um Engineering statt um rohe Intelligenz.
Das Expertendesign ist clever
Edge0 teilt sich zwei große Matrizen über jede Gruppe von 64 Experten, und jeder Experte behält nur einen kleinen Satz eigener Parameter. Die Modellkarte beschreibt das Ergebnis genau: Jeder Experte ist ein fester Datensatz von 1,630,720 Bytes, sodass die Engine ein paar tausend der meistgenutzten Experten auf der Grafikkarte halten und den Rest aus dem Systemspeicher streamen kann. Die Kosten dieses Streamings richten sich danach, wie viele Experten resident bleiben, nicht danach, wie groß das Modell ist.
Edge0 hat das Modell außerdem von Anfang an in dieser Form trainiert, nativ mit 4 Bit, statt ein Cloud-Modell nachträglich zu verkleinern. Spekulatives Decoding über einen 1.26B-Draft-Kopf verteilt die Kosten jedes Gewichts-Lesevorgangs über mehrere Ausgabe-Tokens. Nichts davon ist Magie, aber es ist sorgfältige Arbeit, und deshalb läuft ein 145B-Modell überhaupt auf einer 24-GB-Karte.
Seine Coding- und Agenten-Werte übertreffen das Basismodell
Edge0s Benchmark-Tabelle zeigt die größten Zugewinne genau dort, wo sie für lokale Agenten zählen:
| Modell | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 51.3 | 75.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| Claude Opus 4.6 (Max) | n/a | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
Das Muster ist auf eine Art ehrlich: Edge0-145B übertrifft seine Basis bei den beiden Agenten-Benchmarks und liegt bei Wissen und logischem Denken (GPQA, HLE, IFBench) leicht zurück. Genau das würde man von einem Fine-Tuning erwarten, das auf Coding-Agenten zielt. Terminal-Bench im Besonderen neigt dazu zu zeigen, wie gut ein Modell eine Shell steuert, und ein früher Nutzer hat das eingeordnet:
"This score is roughly on par with 5.6 Terra max, which in my direct experience is perfectly capable of driving a cloud agent harness that can do pretty complex knowledge work."
Wer lieber mit aktuellen gehosteten Modellen vergleicht, findet in den Tests meiner Kollegen zu GPT-6.1 Terra und Claude Opus 5.5 die unabhängigen Zahlen, die Edge0s Tabelle fehlen.
Es ist schnell auf der richtigen Hardware
Auf Edge0s eigener 24-GB-RTX-5090-D-Maschine erreichte der Q3_K-Build 121.2 Tokens pro Sekunde beim Agenten-Decoding und 3,554.9 Tokens pro Sekunde bei einem 16K-Token-Prefill. Das ist schnell genug, dass sich eine lokale Coding-Schleife interaktiv anfühlt. Die Launch-Demos (eine Blender-Stadtszene, ein Drohnen-Programm, eine KiCad-Platine) zeigen, wofür diese Geschwindigkeit gut ist: Dutzende Runden aus Planen, Ausführen und Prüfen ohne Rechnung pro Token. Die Edge0-GitHub-Seite hat die vollständige Geschwindigkeitstabelle und ein zweiminütiges Showcase-Video.
Wo Edge0-145B schwächelt
Hier erzählen der Launch-Post und die Release-Dateien unterschiedliche Geschichten. Jeder Punkt unten stammt aus Edge0s eigenen Dokumenten.
"29GB Spitzenspeicher" ist nicht der ganze Fußabdruck
Der Launch-Post stellt 29GB Spitzenspeicher heraus und sagt, das Modell laufe auf einem 48GB-Laptop. Derselbe Post beschreibt später eine Expertenbibliothek von rund 40GB im Systemspeicher und rund 48GB Vokabulardaten auf der SSD. Die gemessenen Zahlen aus dem README klären das:
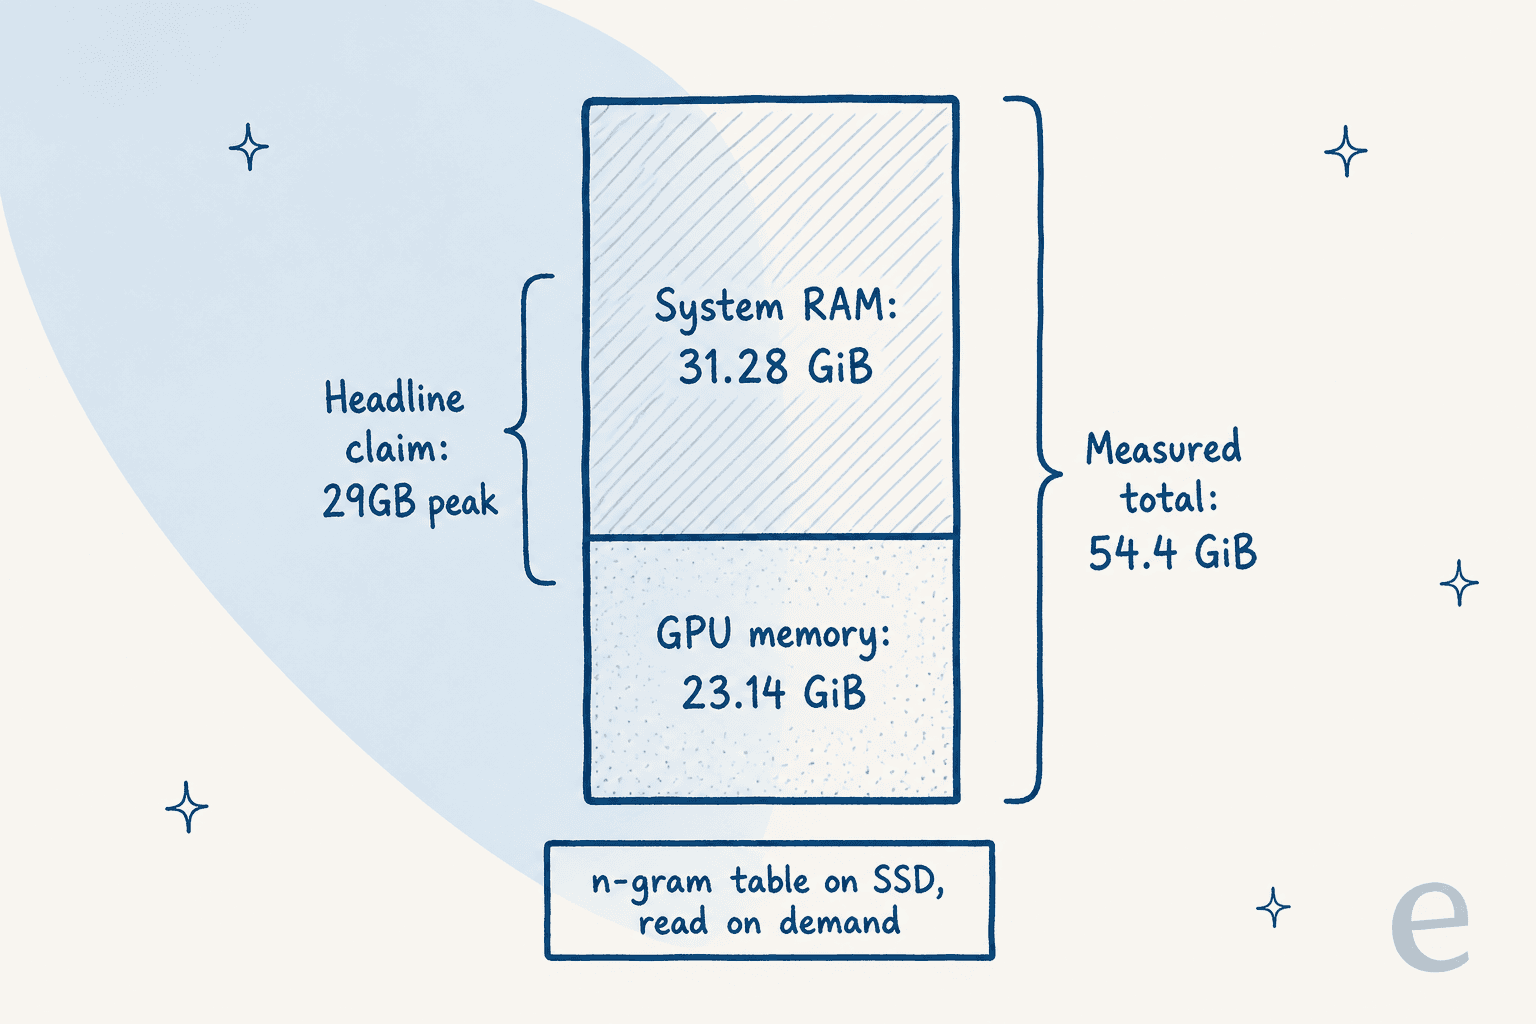
Mit aktivierter Expertenresidenz nutzte der Q3_K-Build 23.14 GiB GPU-Speicher plus 31.28 GiB System-RAM. Der NVFP4-Build nutzte 23.25 GiB plus 38.27 GiB. Die 29GB-Zahl sieht aus wie eine Teilmenge davon, am wahrscheinlichsten die GPU-Seite plus etwas Spielraum, dargestellt als das Ganze.
Um fair zu Edge0 zu sein: Es hat das Modell auch in einem engeren Budget laufen lassen: 16 GiB VRAM und 20 GiB RAM, mit ungecachten Experten, die von der SSD gelesen werden. Es funktionierte trotzdem, mit 36.8 Tokens pro Sekunde im Chat und 44.9 im Agentenmodus. Eine kleinere Maschine kann es also laufen lassen, nur viel langsamer. Ein Hacker-News-Leser, der gehofft hatte, es auf einem 48GB-MacBook laufen zu lassen, fasste die Enttäuschung zusammen:
"If we're talking about ~70GB combined RAM footprint then that's not going to cut it. Still very interesting though."
macOS steht im Launch-Post, nicht im Release
Der Launch-Post sagt, die Unterstützung ab Tag eins umfasse macOS, Windows und Linux, einschließlich Apple-M-Chips. Die Plattformtabelle des READMEs sagt etwas Engeres: Die Modelle 145B und 120B laufen auf Linux oder Windows mit einer NVIDIA-GPU und CUDA 13, und die Spalten für macOS, iOS und Android sind für sie leer. Edge0 hat zwar ein Ergebnis auf einem Apple M2 Ultra veröffentlicht (57.0 Tokens pro Sekunde beim Agenten-Decoding) und fügt hinzu, dass das "keine macOS-Release-Verfügbarkeit belegt". Die Edge0-Chat-Desktop-App ist vorerst nur für Windows.
So sieht das in der Praxis aus:
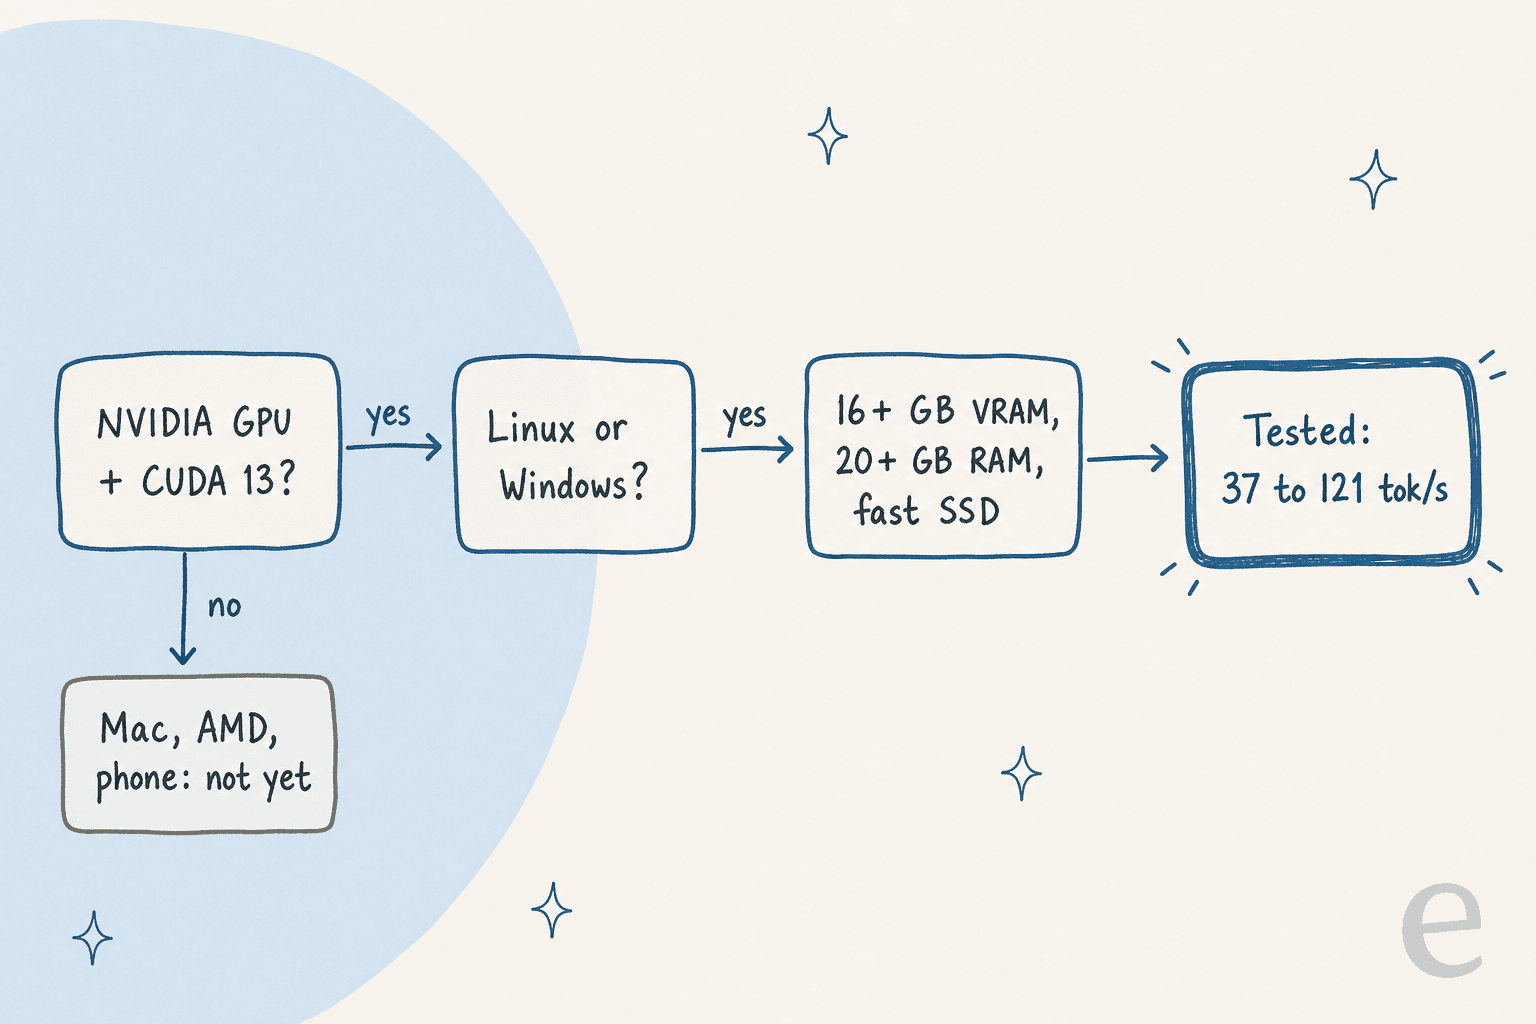
Mac-Nutzer können weiterhin das ältere Edge0-35B auf Metal laufen lassen. Für das 145B brauchst du heute eine NVIDIA-Maschine.
Die Benchmarks sind selbstgemeldet, und sie stimmen nicht ganz überein
Jeder Edge0-, Qwen-, DeepSeek- und Claude-Wert in der Tabelle kommt aus Edge0s internen Evaluierungen. Edge0 sagt, das vollständige Setup und die Reproduktionsschritte würden "mit unserem technischen Bericht veröffentlicht", und der bisher einzige veröffentlichte technische Bericht deckt das 35B-Modell ab. Die Zahlen verschieben sich auch zwischen den Dokumenten: Der Launch-Post listet Edge0-120B mit 53.6 bei DeepSWE und 81.3 bei Terminal-Bench, während das README 51.3 und 75.3 listet.
Die ersten praktischen Erfahrungsberichte sind gemischt. Ein Tester auf einer NVIDIA DGX Spark konnte keine brauchbare Antwort bekommen:
"It spent 8,000+ tokens at default thinking and never produced a coherent answer."
Ein Test ist kein Urteil, aber ein Grund, auf eine unabhängige Auswertung zu warten, bevor man der Tabelle traut. Der DeepSeek V4.1 Flash Test meiner Kollegen zeigt, wie das aussieht, wenn ein Labor die Zahlen selbst gefahren hat.
"Open Source" kommt mit einem kommerziellen Haken
Der Launch-Post sagt, Edge0 mache die Modelle "open source". Der Framework-Code ist Apache 2.0, und Strata bleibt bei MIT. Die Gewichte sind anders. Die Modellkarte stellt sie unter die Edge0 Community Model License 1.0, wobei Qwens Materialien weiterhin unter der Qwen Community License stehen. Persönliche Nutzung, Forschung, Modifikation, interne Nutzung und kommerzielle Nutzung der Ausgaben sind erlaubt. Das Modell zu verkaufen oder zu bündeln, einen kommerziellen Modell-Service zu betreiben oder einen kommerziellen Coding- oder Office-Assistenten anzubieten, braucht eine separate schriftliche Lizenz.
Für einen Hobbyisten oder ein internes Tooling-Team ist das in Ordnung. Für jeden, der ein Produkt darauf aufbauen will, lies die Lizenz vor dem README. Der Hugging-Face-Test auf unserem Blog zeigt, wie diese individuellen Lizenzen auf dem gesamten Hub auftauchen.
Edge0-145B gegen die Alternativen
So würde ich es neben das einordnen, was ein Entwickler diese Woche tatsächlich in Betracht ziehen würde:
| Wenn du willst... | Wähle | Warum |
|---|---|---|
| Den stärksten lokalen Coding-Agenten auf einer NVIDIA-Karte | Edge0-145B | Beste selbstgemeldete Terminal-Bench- und DeepSWE-Werte in seiner Klasse, 91.7 bis 121.2 Tok/s auf 24-GB-Karten |
| Dieselbe Familie mit weniger Überraschungen | Qwen3.8-Flash-Next | Das Basismodell, breitere Runtime-Unterstützung, nahe Werte beim logischen Denken |
| Ein lokales Modell auf einem Mac, schon heute | Edge0-35B oder ein anderes Metal-fähiges offenes Modell | Edge0-145B hat noch keine macOS-Runtime |
| Unabhängige Benchmarks und keine Hardware | DeepSeek V4 Flash oder Kimi K3.1 Pro | Gehostet, von Dritten gemessen, niedrige Preise pro Token |
| Spitzenqualität, und du zahlst dafür | Claude Opus 5.5 oder GPT-6 Sol | Beim härtesten logischen Denken immer noch vorne |
Wenn Kosten dich zum Lokalen treiben, rechne zuerst nach. Die Leitfäden zu Anthropic-API-Preisen und OpenAI-API-Preisen helfen dir, Rechnungen pro Token mit einer GPU zu vergleichen, die bei der Arbeit auch rund 120W zieht.
Mein Urteil zu Edge0-145B
| Bereich | Note | Anmerkung |
|---|---|---|
| Engineering | 4.5/5 | Experten mit geteilten Matrizen und SSD-Streaming sind ein echter Schritt für lokale Inferenz |
| Coding- und Agenten-Werte | 4/5 | Stark, aber nur selbstgemeldet |
| Ehrlichkeit der Launch-Versprechen | 2/5 | 29GB, macOS und "Open Source" brauchen alle Fußnoten |
| Einfachheit der Einrichtung | 2.5/5 | Aus dem Quellcode bauen, nur NVIDIA plus CUDA 13, App nur für Windows |
| Lizenz | 2.5/5 | In Ordnung für interne Nutzung, einschränkend für Produkte |
Insgesamt: 3/5. Wenn du eine RTX 4090 oder 5090 hast und einen lokalen Coding-Agenten willst, ist es einen Nachmittag wert. Wenn du auf einem Mac bist, ein Produkt planst oder einen unabhängigen Nachweis brauchst, warte auf den technischen Bericht und eine Auswertung von Dritten. Entwickler, die bereits Claude Code nutzen, können es über seinen Anthropic-kompatiblen lokalen Endpoint testen, auch wenn ich diese Kombination selbst nicht getestet habe.
Was dieser Test für Support-Teams bedeutet
Das Argument, das Support-Leiter erreichen wird, ist Privatsphäre: das Modell auf deiner eigenen Hardware laufen lassen, und Ticketdaten verlassen niemals das Gebäude. Ich verstehe den Reiz. In Sales-Calls ist die Datenfrage oft die erste. Ein technischer Prüfer bei einem Halbleiter-Hardware-Unternehmen fragte uns, ob der Bot bei einer unbekannten Antwort auf "irgendein anderes ChatGPT" zurückfallen würde, und ob sich das abschalten lässt. Ein dänischer Telematik-Käufer sorgte sich um Kartennummern und Passwörter in Tickets.
Keine der beiden Sorgen drehte sich wirklich darum, wo das Modell läuft. Beide drehten sich darum, was die KI lesen und sagen darf. Ein lokales Modell, das aus seinem allgemeinen Training antwortet, ist immer noch das "andere ChatGPT", vor dem sich dieser Prüfer sorgte. Was es für sie löste, war ein Agent, der nur aus freigegebenem Wissen antwortet und sagt, wenn er etwas nicht weiß, plus Schwärzung für sensible Felder.
So funktioniert eesel, und deshalb würde ich Edge0 als Infrastruktur einordnen, während eesel der Mitarbeiter ist. Du stellst ein KI-Helpdesk-Teammitglied ein, das sich deinem bestehenden Helpdesk anschließt, aus deinem Hilfe-Center, deinen Makros und vergangenen Antworten lernt, und gegen historische Tickets simuliert wird, bevor es mit Kunden spricht. Edge0s Lizenz würde auch den größten Teil davon blockieren, was ein Support-Anbieter mit einem Modell macht, da ein kommerzieller Modell-Service eine separate Vereinbarung braucht.
Zwei Kunden zeigen, wie eine sorgfältige Einrichtung aussieht. Dokument 24, ein dänischer Dienst für Rechtsdokumente, lässt eesel dänische Antworten als interne Notizen aus rund 2.600 Webseiten und Zendesk-Einträgen entwerfen, und die Notiz sagt es, wenn das Wissen eine Frage nicht abdeckt. smava, ein deutsches Kreditvergleichsunternehmen im regulierten Finanzwesen, lässt rund 27.000 Zendesk-Tickets im Monat durch eesel laufen, das 14.600 kategorisierte und 15.300 Antwortentwürfe vorbereitete, die auf die Freigabe eines Beraters warten.
Mehr dazu, wie man Bots auf dem Boden hält, in unserem Leitfaden zu KI-Halluzinationen im Support, der Erklärung zu MCP für Kundensupport, und dem Überblick über Open-Source-Chatbot-Plattformen, falls Self-Hosting eine Pflichtanforderung ist.
Teste eesel
Wenn du einen Edge0-145B Test liest, weil dein Support-Team KI will, ohne Tickets an eine Blackbox zu übergeben, fang mit dem Teil an, der wirklich über Privatsphäre und Genauigkeit entscheidet: was der Agent liest und wann er übergibt. eesel bindet sich an Zendesk, Freshdesk und die anderen großen Helpdesks an, antwortet nur aus deinem freigegebenen Wissen, und lässt dich zusehen, wie es echte vergangene Tickets beantwortet, bevor es live geht. Die Preise sind ein fester monatlicher Kreditplan, nicht pro Sitzplatz.
Entwickler können denselben Workspace über die eesel CLI steuern. Ein Coding-Agent, auch einer, der auf ein lokales Modell zeigt, kann freigegebenes Wissen wie exportierte Hilfeartikel und gespeicherte Antworten hochladen, die Anweisungen des Teammitglieds anpassen, und Testfragen stellen, um die Antworten zu prüfen. Das Verbinden des Helpdesks selbst braucht weiterhin jemanden mit Admin-Zugriff, der es freigibt.
Teste eesel kostenlos, oder buche eine Demo, um es an deinen eigenen Tickets laufen zu sehen.