

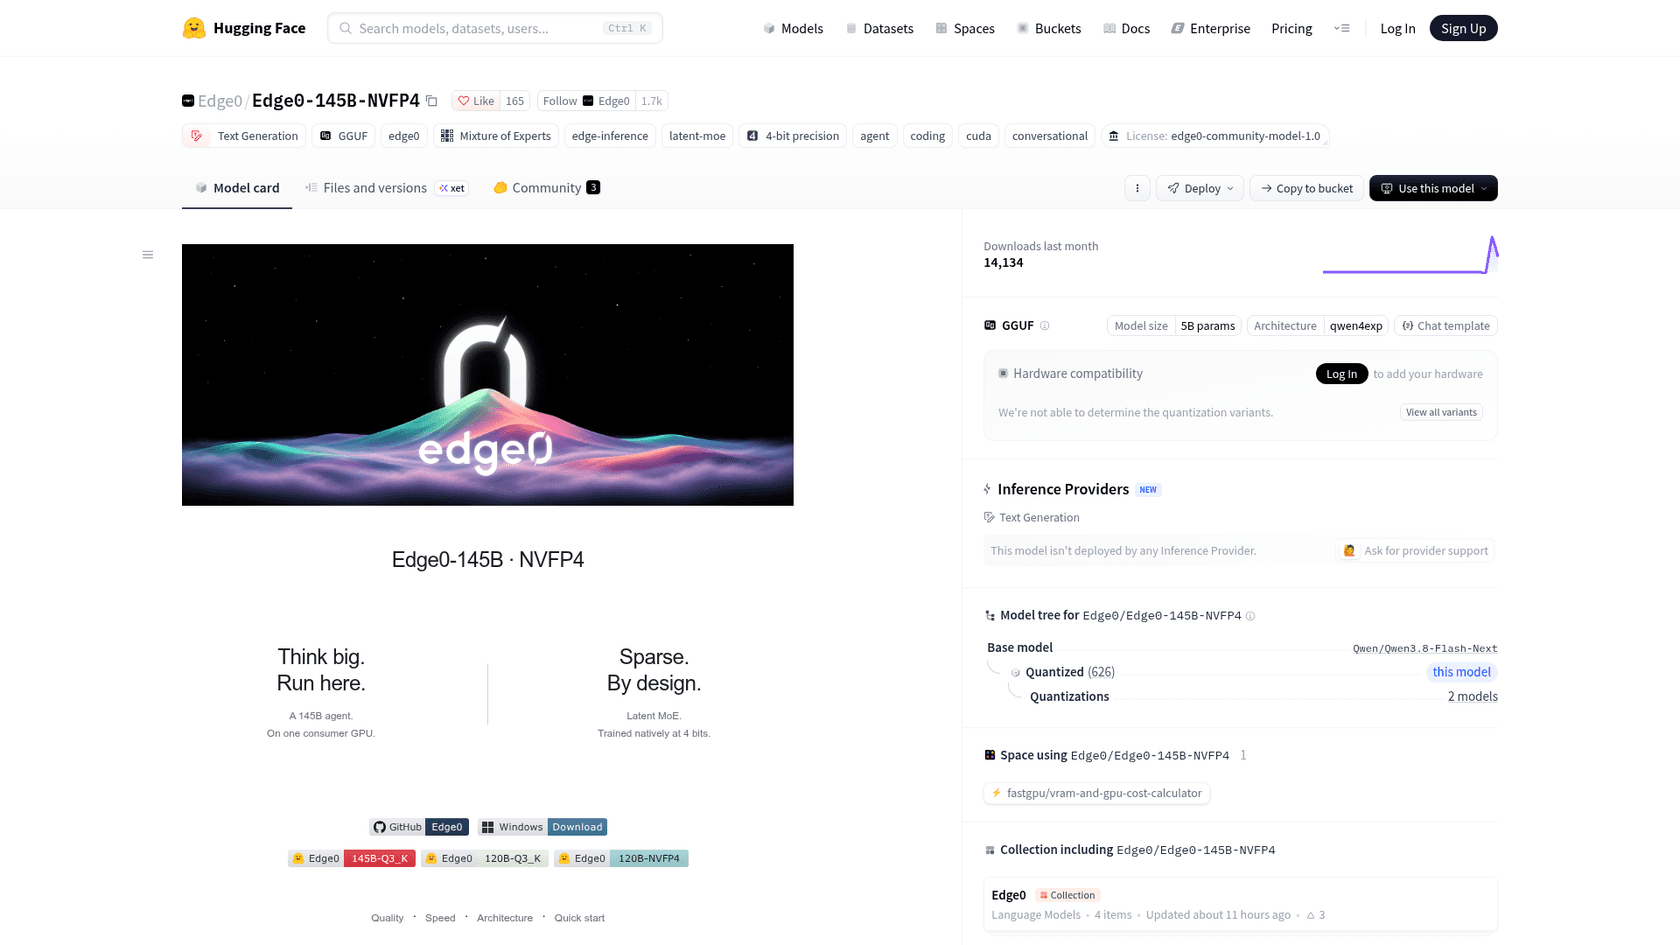
Edge0-145B ist ein kostenloses, offenes 145B-Coding- und Agentenmodell, das auf einer einzelnen NVIDIA-GPU mit 16 GiB Speicher plus 20 GiB System-RAM läuft, indem es heiße Experten auf der Karte hält und den Rest aus RAM und SSD liest. Es ist eine stark überarbeitete Version von Qwen3.8-Flash-Next, und in Edge0s eigenen Tests schlägt es diese Basis beim Coding. Zwei Dinge, über die der Launch-Post hinweggeht: macOS wird noch nicht unterstützt, und die Lizenz blockiert kommerzielle Modell-Dienste ohne separate Vereinbarung. Wenn dein Ziel KI auf Support-Tickets ist statt einer lokalen GPU, macht eesel das mit gehosteten Modellen, und die eesel CLI lässt einen Coding-Agenten freigegebene Hilfeartikel hochladen und die Antworten testen, bevor irgendetwas live geht.
Was ist Edge0-145B?
Edge0-145B ist ein offenes Sprachmodell von Edge0, angekündigt am 12. November 2026 zusammen mit einem kleineren Geschwistermodell, Edge0-120B. Edge0s Launch-Post stellt es als das erste Modell mit 145 Milliarden Parametern vor, das für den Betrieb auf einem privaten Computer gebaut wurde, mit Coding-, Reasoning- und Agentenfähigkeiten nahe an Cloud-Modellen.
Ich baue die KI-Agenten in eesels Produkt, deshalb lese ich solche Launches zuerst auf den Mechanismus und erst danach auf das Marketing. Das hat sich hier als wichtig erwiesen, denn die Hugging-Face-Model-Card und das GitHub-Repo erzählen eine genauere Geschichte als der Launch-Post. Ich habe keine RTX-Karte auf meinem Schreibtisch, also stammt alles Folgende aus diesen Dokumenten und den Release Notes, nicht aus einem eigenen Lauf. Für ein Urteil zur Qualität geht die Edge0-145B-Review meines Kollegen separat darauf ein.
Hier ist, was Edge0 selbst über das Modell veröffentlicht hat:
| Spezifikation | Edge0-145B |
|---|---|
| Gesamtparameter | 145B, davon etwa 10.12B aktiv pro Token |
| Basismodell | Abgeleitet von Qwen3.8-Flash-Next |
| Architektur | Latentes Sparse-Mixture-of-Experts, 48 Layer, 512 Experten pro Layer |
| Experten pro Token | 10 geroutet plus 1 geteilt |
| Kontext | 256K Token (int8-KV-Cache, 32K auf der GPU gehalten) |
| Builds | Q3_K mit 40.81 GiB, NVFP4 mit 47.79 GiB |
| Spekulatives Decoding | Eingebauter 1.26B-Draft-Head |
| Engine | edge0-strata, ausgeführt über edge0-infer |
| Plattformen heute | Linux und Windows, NVIDIA-GPU mit CUDA 13 |
| Lizenz | Edge0 Community Model License 1.0 plus Qwen Community License |
Das Basismodell ist der Teil, den der Launch-Post vergräbt. Die Model Card listet Qwen/Qwen3.8-Flash-Next als Basis, und die Danksagungen nennen sowohl Qwen als auch die offene Strata-Inference-Engine. Das ist bei offenen Gewichten normale Praxis, und es ist nützlich zu wissen: Wenn du bereits Qwen3.8-Flash-Next betreibst, ist Edge0-145B eine neu architektierte, neu trainierte Version eines Modells, das du kennst, nicht eine fremde Familie.
Wie passt ein 145B-Modell auf eine GPU?
Es passt nicht, nicht alles auf einmal. Der Trick ist, dass bei jedem Token nur etwa 10B der 145B Parameter arbeiten, sodass die Engine nur diese nah an der GPU braucht. Edge0 kombiniert vier Ideen, um das umzusetzen:
- Geteilte Experten-Matrizen. In einem normalen Mixture-of-Experts-Modell speichert jeder Experte seinen eigenen vollständigen Satz an Gewichten. Edge0 projiziert jedes Token auf eine kleinere „latente" Breite herunter, und die großen Projektionsmatrizen werden von den Experten gemeinsam genutzt. Jeder Experte behält nur einen kleinen Eintrag (etwa 1.6 MB), sodass Tausende davon im GPU-Speicher Platz finden.
- Drei Speicherebenen. Häufig genutzte Experten liegen auf der GPU. Der Rest liegt im System-RAM. Eine Lookup-Tabelle mit 51.2B Parametern, die das Modell nur sparsam liest, bleibt auf der SSD und wird bei Bedarf gelesen.
- CPU und GPU zusammen. Die GPU berechnet die Experten, die sie bereits hält, während die CPU die anderen parallel übernimmt.
- Spekulatives Decoding. Ein kleiner 1.26B-Draft-Head schlägt mehrere Token vor, und das Hauptmodell prüft sie in einem Durchgang, was die Kosten des Gewichte-Lesens über mehr Output verteilt.
Edge0 hat das Modell außerdem von Anfang an in dieser Form trainiert, statt nachträglich ein Cloud-Modell zusammenzupressen. Die Architektur erklärt sowohl die gute Nachricht (es läuft auf einer Gaming-Karte) als auch den Haken (es ist stark auf System-RAM- und SSD-Geschwindigkeit angewiesen), worum es im nächsten Abschnitt geht.
Welche Hardware brauchst du wirklich?
Hier widersprechen sich der Launch-Post und die Release-Dateien. Die Schlagzeile des Launch-Posts lautet „29 GB Spitzenspeicher" auf „einem kompatiblen privaten Laptop, etwa einem MacBook Pro". Die Dateien geben ein vollständigeres Bild.
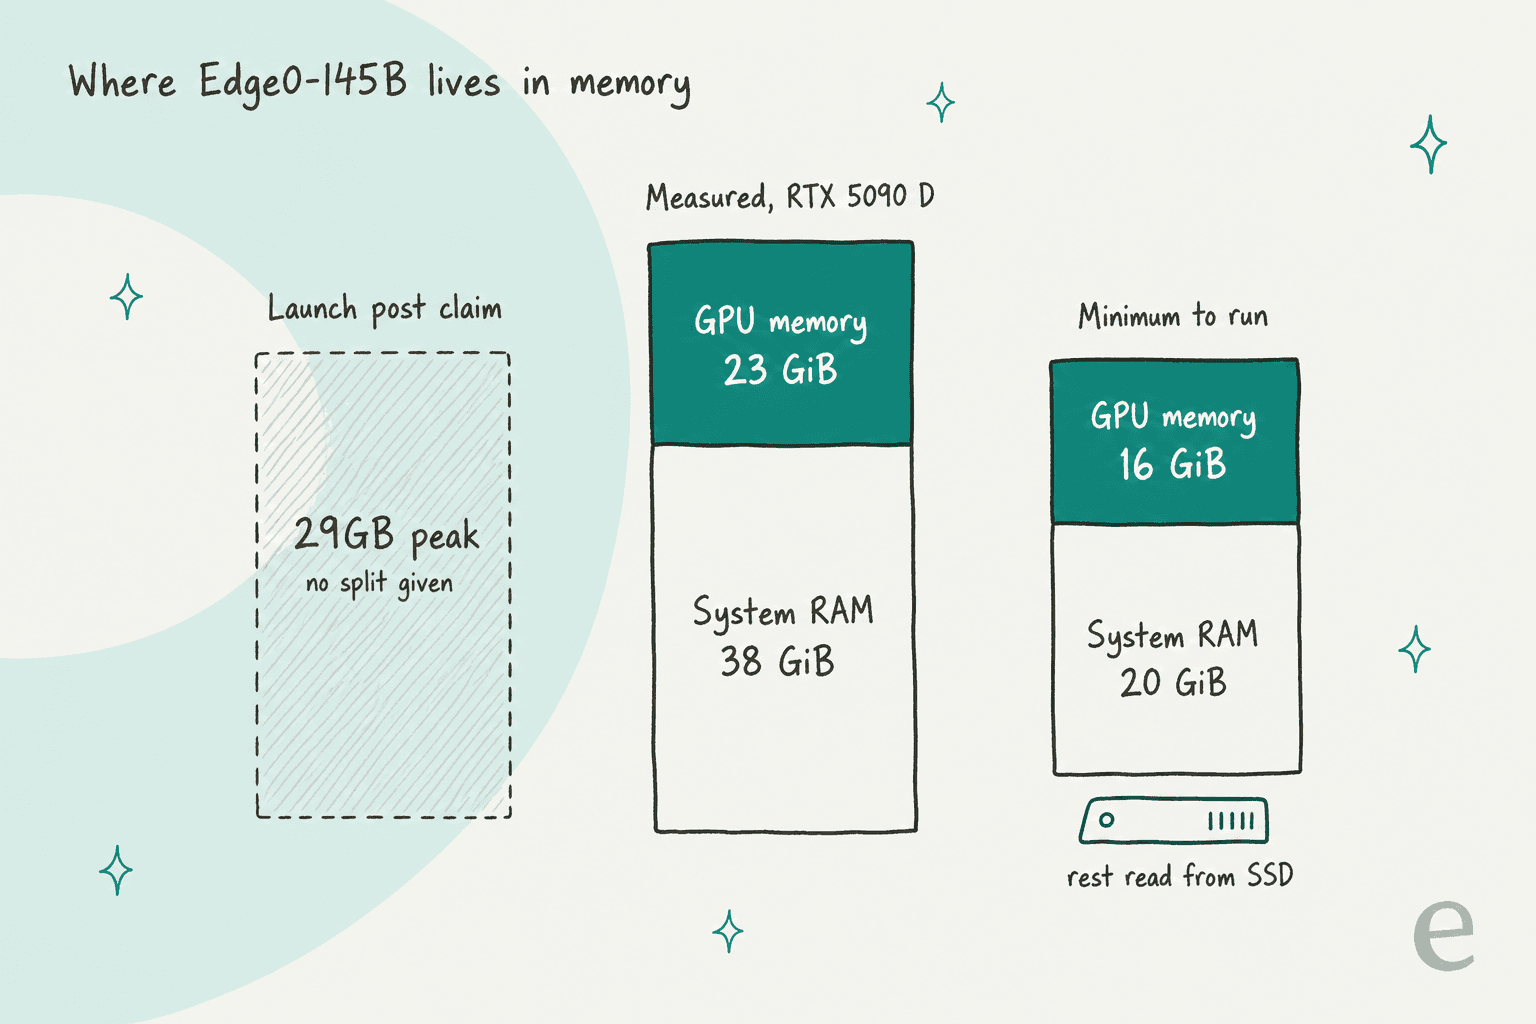
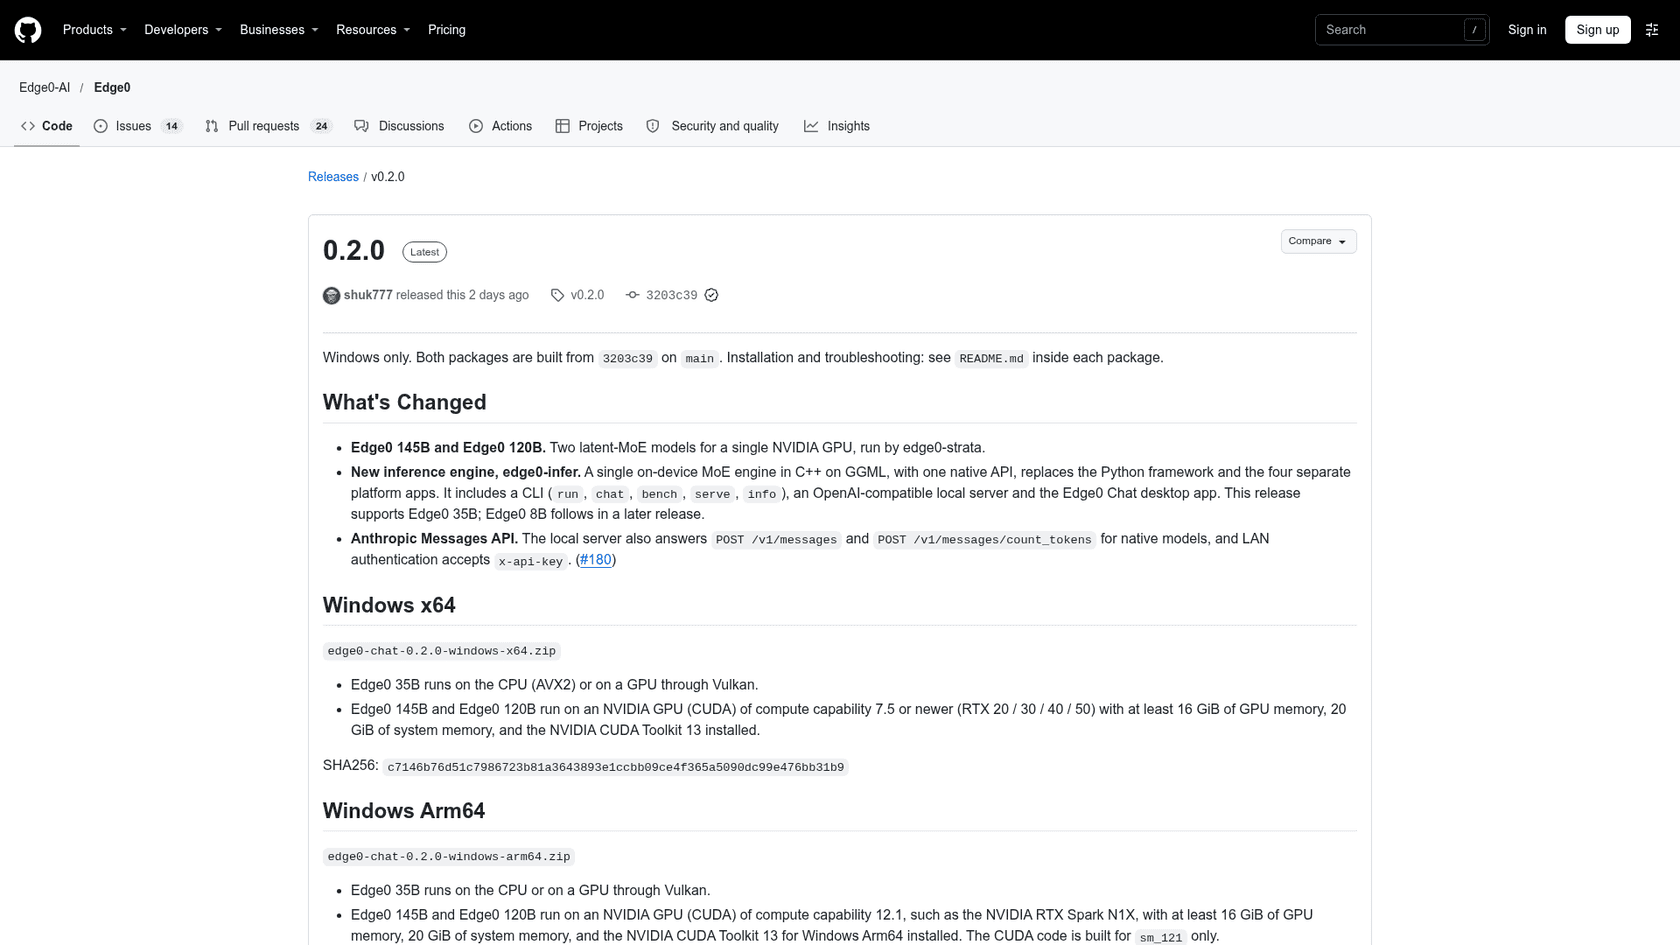
Die Release Notes zu v0.2.0 legen das Minimum für Windows x64 fest: eine NVIDIA-GPU mit Compute Capability 7.5 oder neuer (RTX-20er-, 30er-, 40er- oder 50er-Serie), mindestens 16 GiB GPU-Speicher, 20 GiB Arbeitsspeicher und das CUDA Toolkit 13. Auf Windows Arm64 ist das Ziel der RTX Spark N1X.
Bei voller Geschwindigkeit braucht es mehr. Die Model Card sagt, dass der NVFP4-Build mit aktivierter Residency 23.25 GiB VRAM plus 38.27 GiB Host-RAM auf einer RTX 5090 D 24 GB nutzte, und der Q3_K-Build 23.14 GiB plus 31.28 GiB. Die Werte von 16 GiB plus 20 GiB stammen von derselben Karte mit angewendeten Limits, bei niedrigerer Geschwindigkeit.
Die Mac-Behauptung ist die größere Lücke. Die Plattform-Tabelle im GitHub-README markiert macOS für die 145B- und 120B-Modelle als nicht unterstützt, und die Model Card sagt, ihr Apple-M2-Ultra-Benchmark "does not establish macOS release availability". Leser auf Hacker News haben das am ersten Tag bemerkt:
"The blog post mentions Mac repeatedly, saying things like 'day-one support covers macOS'. But the released stuff so far seems to be CUDA only."

Wenn du also auf Apple Silicon bist, ist das kleinere Edge0-35B das Edge0-Modell, das heute läuft. Für alles Größere auf einem Mac ist ein gehostetes Modell wie Qwen 3.8 Max oder DeepSeek V4.1 Flash vorerst der praktische Weg.
Wähle deine Maschine, um zu sehen, wo du landest:
Kann meine Maschine Edge0-145B betreiben?
Wie schnell ist Edge0-145B?
Schnell auf der richtigen Karte. Die Geschwindigkeitstabelle der Model Card, alles aus Edge0s eigenen Messungen, in Token pro Sekunde:
| Maschine | Build | 16K-Prefill | Chat-Decode | Agent-Decode |
|---|---|---|---|---|
| RTX 5090 D 24 GB | Q3_K | 3,554.9 | 99.7 | 121.2 |
| RTX 5090 D 24 GB | NVFP4 | 3,165.7 | 79.6 | 98.3 |
| RTX 4090 24 GB | Q3_K | 3,179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60 GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| Apple M2 Ultra (Metal) | Q3_K | 800.3 | 60.9 | 57.0 |
| 16 GiB VRAM + 20 GiB RAM | Q3_K | 335 | 36.8 | 44.9 |
„Agent Decode" läuft schneller als Chat, weil der Agenten-Output (Code, Tool-Calls) vorhersagbarer ist, sodass die Vermutungen des Draft-Heads öfter treffen. Zwei praktische Hinweise: Der Q3_K-Build ist auf derselben Karte kleiner und schneller als NVFP4, und die RTX 5090 D ist eine China-Marktvariante der 5090, sodass eine Standard-5090 mindestens genauso schnell sein sollte.
Wie gut ist es, laut Edge0?
In Edge0s internen Auswertungen führt Edge0-145B bei den beiden Agenten- und Coding-Tests vor seiner Qwen-Basis und liegt bei Wissen leicht dahinter:
| Modell | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 | 79.3 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 89.2 | 79.5 | 30.8 | 82.0 |
| Claude-Opus-4.6 (Max) | n/a | 78.2 | 91.3 | 62.5 | 40.0 | 78.0 |
Drei Vorbehalte, bevor du dich auf diese Zahlen stützt. Erstens hat Edge0 diese selbst durchgeführt, und ein vollständiger technischer Bericht mit Reproduktionsschritten ist versprochen, aber noch nicht erschienen. Zweitens ist der Cloud-Vergleich Claude Opus 4.6, zwei Generationen hinter dem aktuellen Claude Opus 5.5 und Claude Fable 5.2. Drittens widersprechen sich Edge0s eigene Seiten beim 120B: Der Launch-Post gibt ihm 53.6 bei DeepSWE und 81.3 bei Terminal-Bench, während das GitHub-README 51.3 und 75.3 nennt.
Terminal-Bench ist trotzdem ein nützliches Signal für Agentenarbeit, wie ein Entwickler anmerkte:
"TerminalBench scores often correspond to real world performance for coding agents that rely heavily on bash."
Wenn du einen breiteren Weg suchst, um Modelle an deinen eigenen Aufgaben zu beurteilen, behandeln meine Notizen zum Benchmarking von KI-Support-Agenten und die Übersicht zu LLM-Tracking-Tools die Methode.
Wie installierst und betreibst du Edge0-145B?
Es gibt zwei Wege, und beide brauchen das NVIDIA-Setup von oben.
Die Desktop-App (nur Windows). Lade edge0-chat-0.2.0-windows-x64.zip von der Releases-Seite herunter, lade einen Modellordner von Hugging Face herunter, öffne Edge0 Chat und wähle den Ordner. Edge0 sagt, die Kernfunktionen der App funktionieren offline ohne Konto oder Nutzungslimit.
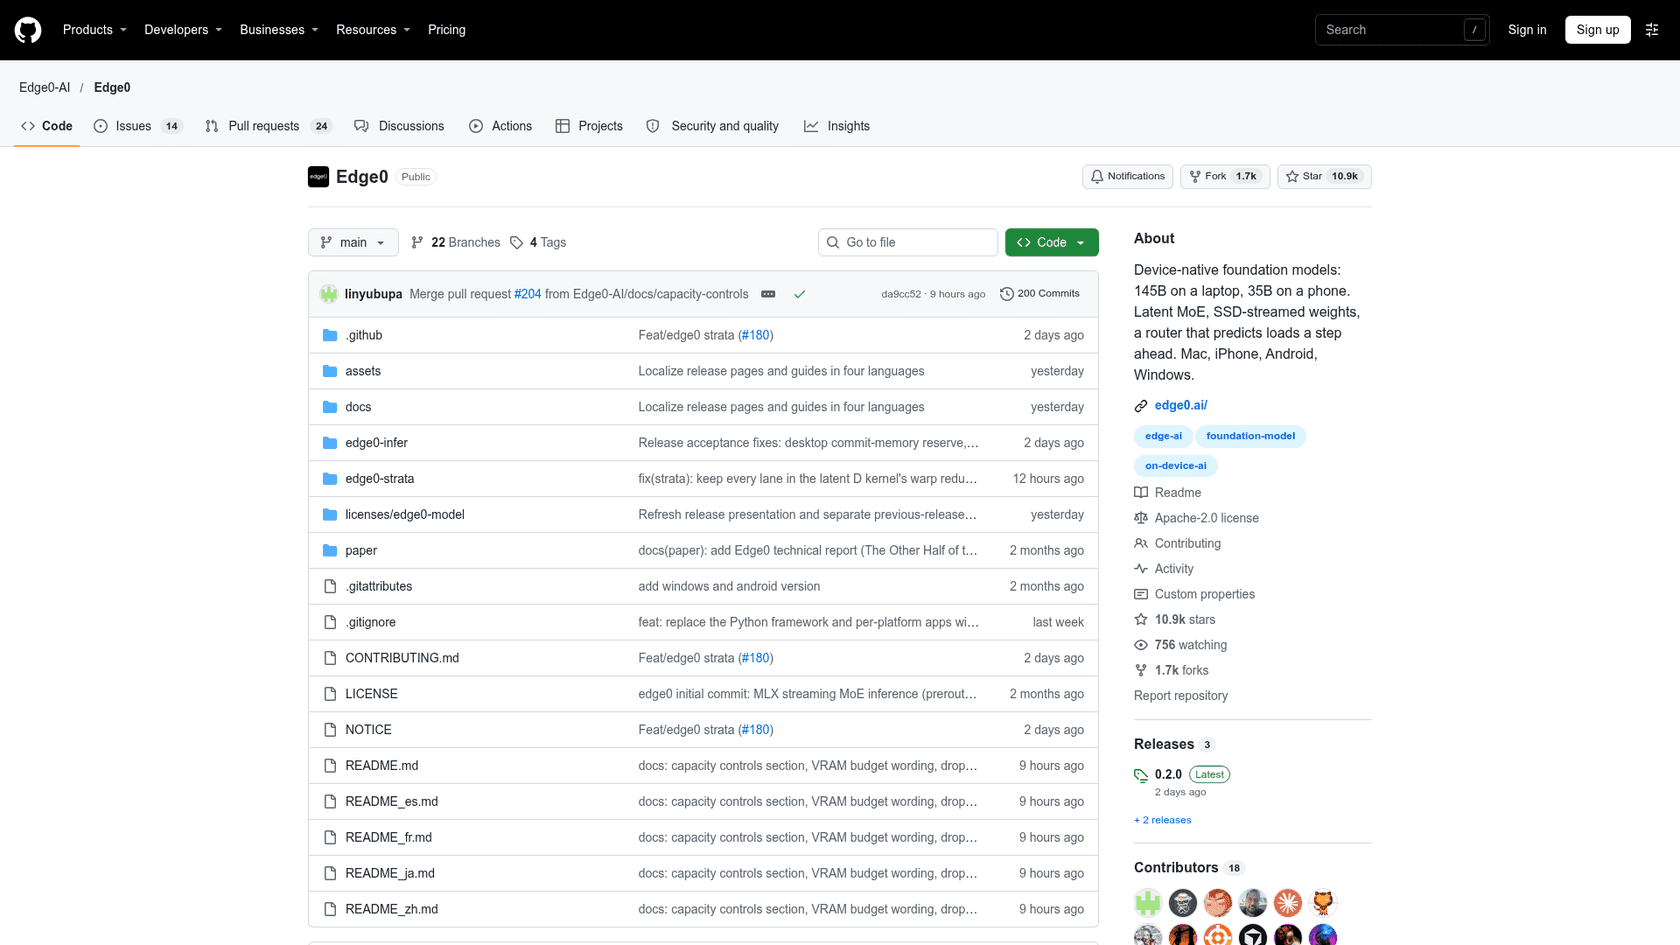
Die Kommandozeile (Linux oder Windows). Klone das Repo, baue die edge0-strata-Engine und edge0-infer nach den Anweisungen im Repo, und zeige dann auf einen Modellordner:
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-Q3_K
Sobald die Gewichte geladen sind, gibt es Listening: http://127.0.0.1:8000 aus und stellt OpenAI- und Anthropic-kompatible Endpunkte unter dem Modellnamen edge0_145b bereit. edge0-infer chat öffnet stattdessen eine interaktive Sitzung.
Zwei Einstellungen zählen am meisten, wenn der Speicher knapp ist. --mmap-experts liest ungecachte Experten von der SSD, statt sie im RAM zu halten, und --resident-budget-gib 20 begrenzt den RAM-Experten-Cache auf 20 GiB, was eine statische Experten-Profildatei braucht. Beide liegen in der model.json des Modellordners, sodass die App und die CLI sie übernehmen.
Nutzung aus einem Coding-Agenten
Weil der lokale Server das Anthropic-Messages-Format spricht, können Tools, die eine eigene Base-URL akzeptieren, im Prinzip darauf zeigen. Für Claude Code bedeutet das, ANTHROPIC_BASE_URL auf http://127.0.0.1:8000 zu setzen und edge0_145b als Modell zu wählen, das gleiche Muster wie für jeden eigenen Endpunkt. Meine Leitfäden zu Claude-Code-Umgebungsvariablen und Modellauswahl behandeln die Variablen.
OpenClaw und andere OpenAI-kompatible Tools können den /v1/chat/completions-Endpunkt nutzen. Ich habe keinen der beiden Wege selbst getestet, also behandle das als den dokumentierten, nicht als den geprüften Weg.
Was erlaubt die Lizenz?
Der Launch-Post nennt Edge0-145B „open-source". Die Lizenz ist enger, als dieses Wort nahelegt, ein Punkt, der innerhalb von Minuten auf Hacker News aufkam:
"This is not open source, this is open weights"
Laut der Model Card erlaubt die Edge0 Community Model License 1.0:
- Private Nutzung, Forschung und Veränderung
- Nicht-kommerzielles Teilen und interne Nutzung in einem Unternehmen
- Kommerzielle Nutzung der vom Modell erzeugten Ausgaben
Sie verlangt eine separate schriftliche Lizenz von Edge0 für:
- Den Verkauf oder die kommerzielle Bündelung des Modells
- Den Betrieb eines kommerziellen Modell-Dienstes
- Einen eigenständigen kommerziellen Coding- oder Office-Assistenten, der darauf aufbaut
Qwens Community-Lizenz gilt zusätzlich, da das Modell von Qwen-Material abgeleitet ist. Der Engine-Code selbst ist Apache-2.0. In der Praxis: in Ordnung für die eigene Maschine eines Entwicklers oder ein internes Tool, nicht in Ordnung als Engine eines Produkts, das du verkaufst, ohne vorher mit Edge0 zu sprechen. Meine Übersicht zu Open-Source-KI-Agenten listet Tools mit lockereren Bedingungen, falls das ein Hindernis ist.
Was bedeutet Edge0-145B für Support-Teams?
Der Reiz für den Support ist offensichtlich: Kundendaten, die deine Hardware nie verlassen, und keine Token-Rechnung. Das ist ein echtes Anliegen, von dem ich höre. In einem eesel-Sales-Call wollte ein technischer Prüfer bei einem Hardware-Unternehmen die Zusicherung, dass die KI nur aus freigegebenem Wissen antwortet, nicht aus dem Web oder allgemeinen Trainingsdaten, bevor es weiterging.
Aber ein lokales Modell beantwortet eine andere Frage. Wo das Modell läuft, entscheidet, wo Daten verarbeitet werden. Was es einem Kunden sagt, hängt von der Schicht darum ab: welche Hilfeartikel und früheren Tickets es lesen kann, was es tut, wenn es keine Antwort findet, wann es an einen Menschen übergibt, und ob jemand es vorher an echten Unterhaltungen getestet hat. Ein 145B-Modell auf einer RTX-Karte kommt mit nichts davon, und die Lizenz schließt aus, es ohne Vereinbarung zu einem kommerziellen Support-Assistenten zu machen.
Diese Schicht ist die Aufgabe von eesels KI-Helpdesk-Teammitglied. Es tritt der Queue bei, die du bereits in Zendesk oder Freshdesk betreibst, antwortet aus deinem eigenen Wissen und wird an früheren Tickets simuliert, bevor es live geht.
SE Ranking betreibt einen eesel-Agenten pro Produkt auf Zendesk über drei Produkte hinweg, bearbeitet 4,650 Unterhaltungen im Monat aus etwa 16,800 Seiten Wissen, wobei Rückerstattungen und Anfragen nach einem Menschen an das Team übergeben werden. Innr, ein niederländisches Smart-Lighting-Unternehmen, lässt eesel Freshdesk-Antworten in der eigenen Sprache des Kunden aus 1,500 Hilfeartikeln und früheren Tickets entwerfen.
Wenn du Modelle für deine eigenen Support-Inhalte abwägst, gehen meine Leitfäden zum Verbinden von Claude mit deinem Helpdesk, zu MCP für Kundensupport und zu KI-Agenten-Übergaben weiter, als eine Model Card kann.
Solltest du Edge0-145B ausprobieren?
Ja, wenn du eine RTX-Karte mit 16 GiB oder mehr, 32 GiB oder mehr RAM und eine schnelle SSD hast, und ein starkes lokales Coding-Modell ohne Token-Rechnung willst. Nutze den Q3_K-Build, führe ihn in Claude Code oder deinem üblichen Agenten an einer Aufgabe aus, die du schon gelöst hast, und vergleiche mit deinem Cloud-Modell.
Warte, wenn du auf einem Mac, auf AMD bist, oder planst, es in einem kommerziellen Produkt auszuliefern. Die ersten beiden brauchen Plattform-Support, der nicht erschienen ist, und das dritte braucht ein Lizenzgespräch. In der Zwischenzeit ist Qwen3.8-Flash-Next die Basis, die man beobachten sollte, und meine Beiträge zu Qwen im Überblick und Kimi K3 behandeln die nächstgelegenen offenen Alternativen.
eesel für KI in deiner Support-Queue ausprobieren
Wenn der Grund, warum du dir Edge0-145B angesehen hast, KI war, die deine Kunden beantwortet, bringt dich eesel dorthin, ohne eine GPU zu kaufen. Es ist ein KI-Helpdesk-Teammitglied, das sich in Zendesk, Freshdesk und andere Helpdesks einbindet, nur aus deinem Helpcenter und früheren Tickets antwortet und an historischen Unterhaltungen getestet wird, bevor es eine Live-Unterhaltung berührt, so wie SE Ranking es über drei Produkte hinweg betreibt. Sieh dir die Preise an oder probiere eesel kostenlos aus.
Häufig gestellte Fragen
Was ist Edge0-145B?
Welche Hardware braucht Edge0-145B?
Kann ich Edge0-145B auf einem Mac betreiben?
Ist Edge0-145B Open Source?
Was kostet Edge0-145B?
Wie schneidet Edge0-145B im Vergleich zu Qwen3.8-Flash-Next ab?
Kann ich Edge0-145B mit Claude Code nutzen?
edge0-infer serve OpenAI- und Anthropic-kompatible Endpunkte auf 127.0.0.1:8000 mit dem Modellnamen edge0_145b bereitstellt, sodass Tools, die eine eigene Base-URL akzeptieren, darauf zeigen können. Setze ANTHROPIC_BASE_URL auf den lokalen Server und wähle das Modell, wie in meinem Leitfaden zu Claude-Code-Umgebungsvariablen. Prüfe die Lizenz, bevor du es in einem kommerziellen Produkt einsetzt.