

Ripple-65B Preview ist ein dichtes Modell mit 65B Parametern unter Apache 2.0, das bei agentischem Coding mit Open-Weight-Modellen mithält, die acht- bis fünfzehnmal so groß sind, gehostet für $0.20 / $0.60 pro Million Tokens. Der Vorsprung ist allerdings knapp. Ricursives eigene Tabelle führt es nur bei 2 von 22 Benchmarks vorn, und Terminal-Bench 2.1 ist ein Sieg mit 0,4 Punkten Abstand zu Reflection Beam. Der eigentliche Grund, sich dafür zu interessieren: Es passt auf einen einzigen DGX Spark. Probieren Sie es aus, wenn Sie ein selbst betreibbares Coding-Modell wollen; warten Sie auf unabhängige Tests, wenn Sie Belege brauchen. Für Support-Teams ist das Modell der leichte Teil, und eesel ist das Teammitglied, das darauf aufbaut.
Was ist Ripple-65B?
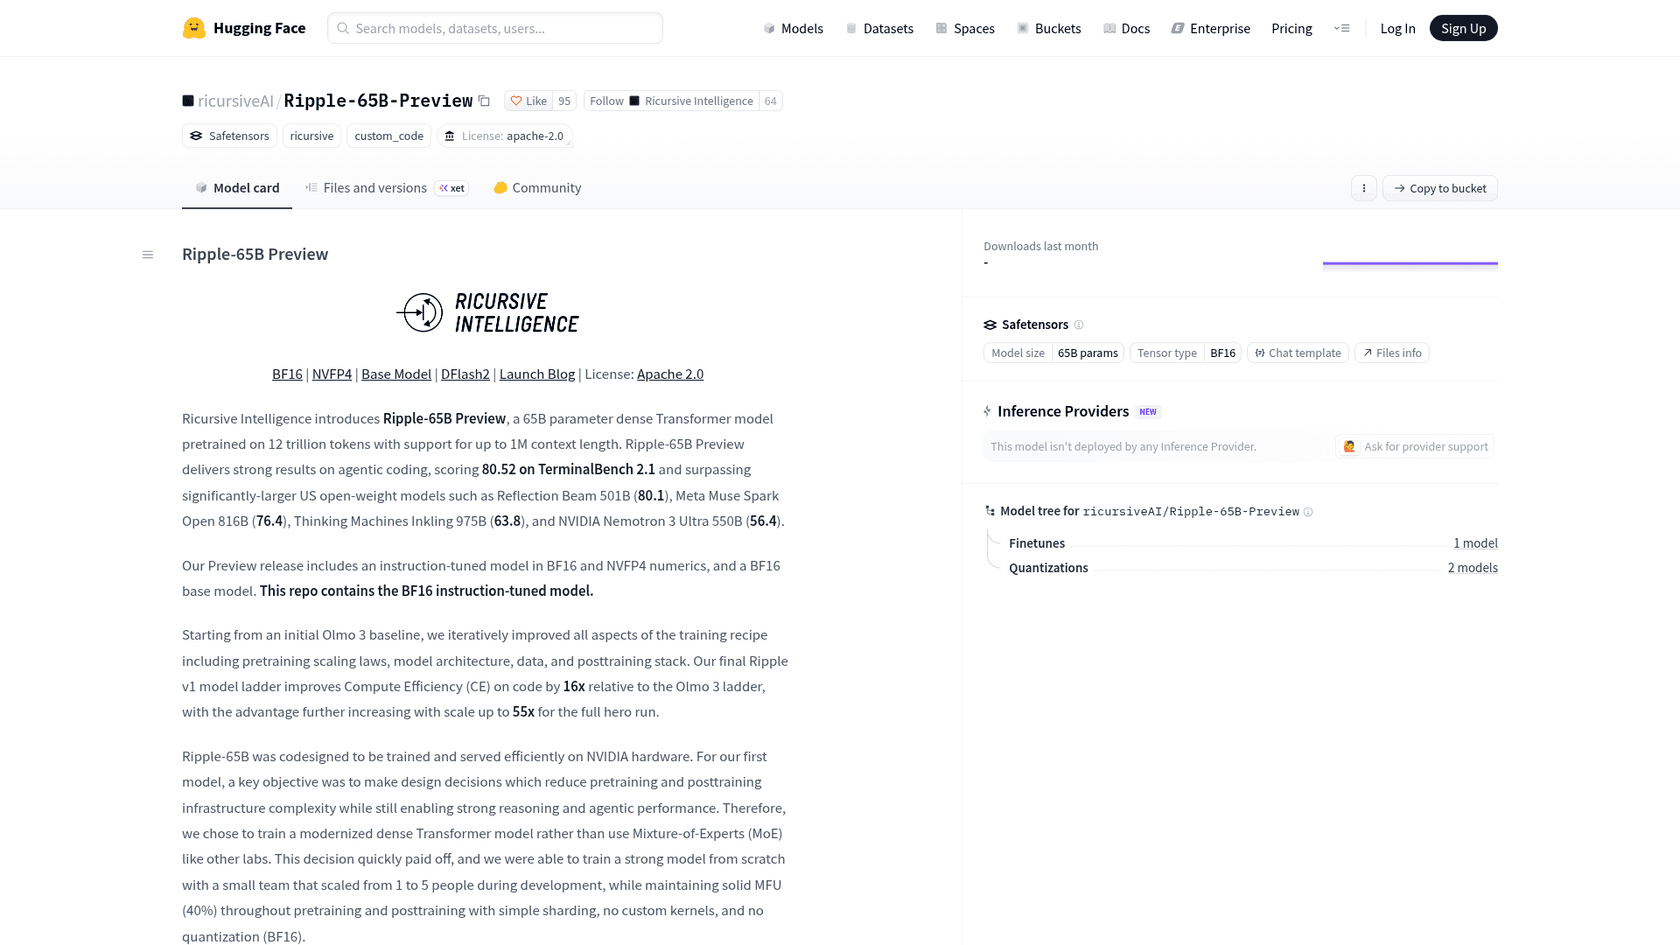
Ripple-65B Preview ist das erste öffentliche Modell von Ricursive Intelligence, einem Labor aus Palo Alto, das von Anna Goldie und Azalia Mirhoseini mitgegründet wurde und KI für Chipdesign entwickelt. Es wurde am 4. November 2026 veröffentlicht. Ricursive nennt es "a general-purpose variant of the proprietary model that powers our AI chip design platform."
Die Eckdaten in Kürze:
- Größe: 64,8B Parameter, bei jedem Token alle aktiv. Es ist also ein dichtes Transformer-Modell, kein Mixture of Experts.
- Training: von Grund auf mit 12 Billionen Tokens aus Text und Code vortrainiert, überwiegend Englisch. Keine Bilder, kein Audio.
- Kontext: bis zu 1M Tokens unterstützt, die Konfiguration erlaubt 2M Positionen.
- Lizenz: Apache 2.0 für jeden Checkpoint, kommerzielle Nutzung ist also in Ordnung.
- Fokus: Ricursive sagt, die Preview habe "relatively light posttraining, with a focus on agentic coding."
Es erscheint als vier Hugging-Face-Repos: das instruktionsgetunte BF16-Modell (etwa 130 GB), eine als "Experimental" gekennzeichnete NVFP4-Version (etwa 57 GB), ein Basismodell ohne Post-Training und ein 4B-"DFlash2"-Draft-Modell, das die Generierung per Speculative Decoding beschleunigt.
Ich baue bei eesel Integrationen und API-Funktionen. Wenn ein Modell wie dieses erscheint, lese ich deshalb zuerst nicht die Launch-Grafik, sondern die Konfigurationsdatei, das Chat-Template und die Serving-Skripte, denn dort sieht man, was man am Montag tatsächlich nutzen kann. Alles Folgende stammt aus diesen Dateien, der Modellkarte und den Anbieterseiten, geprüft am 5. November 2026.
Was ist neu an Ripple-65B?
Drei Dinge heben es von den anderen US-amerikanischen Open-Weight-Veröffentlichungen dieses Jahres ab.
Es ist dicht, während alle anderen auf MoE gesetzt haben. Reflection Beam, Meta Muse Spark Open, Inkling und Nemotron 3 Ultra nutzen alle Mixture-of-Experts-Architekturen, bei denen pro Token nur ein Teil des Modells läuft. Ripple lässt jedes Mal alle 65B laufen. Ricursives Argument aus der Modellkarte: Ein dichtes Modell "reduce[s] pretraining and posttraining infrastructure complexity", wodurch ein Team, das von 1 auf 5 Personen wuchs, es mit "simple sharding, no custom kernels, and no quantization" trainieren konnte. Auch die Form ist ungewöhnlich: schmal und tief, mit einer schmalen versteckten Schicht von 5.120 Breite, 80 Schichten hoch gestapelt, und vier Attention-Schichten mit kurzem Fenster auf jede volle.
Es soll günstig in der Herstellung sein. Ricursive sagt, es habe $32M für das gesamte Projekt ausgegeben, und der Blog betont, dass dies "our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging" und die finalen Läufe umfasst, nicht nur einen einzelnen Trainingslauf. Der Vergleich "ein Zehntel der Kosten" ist weicher, als er klingt. Seine Fußnote stützt sich auf einen TechCrunch-Bericht, wonach Reflection $150M pro Monat für Rechenleistung zugesagt hat, sowie auf Reflections Aussage, Beam habe etwa acht Wochen gedauert. Es ist also Ricursives Schätzung der Ausgaben eines Konkurrenten, keine von Reflection veröffentlichte Zahl.
Es brauchte weniger Reinforcement-Learning-Läufe. Ricursive sagt, es habe seinen Terminal-Bench-Wert mit 1,4M Rollouts erreicht, "roughly 70x fewer rollouts than Reflection Beam." Außerdem habe man keine Post-Training-Daten gekauft, sondern eigene synthetische Daten-Pipelines gebaut.
Was sagen die Benchmarks von Ripple-65B?
Ripple-65B erreicht 80,5 bei Terminal-Bench 2.1, die Schlagzeilenzahl, die testet, ob ein Modell reale Aufgaben in einem Terminal abschließen kann. Damit liegt es knapp vor Reflection Beam mit 80,1 und vor Muse Spark Open (76,4), Inkling (63,8) und Nemotron 3 Ultra (56,4), jeweils nach den selbst berichteten Werten der Labore.
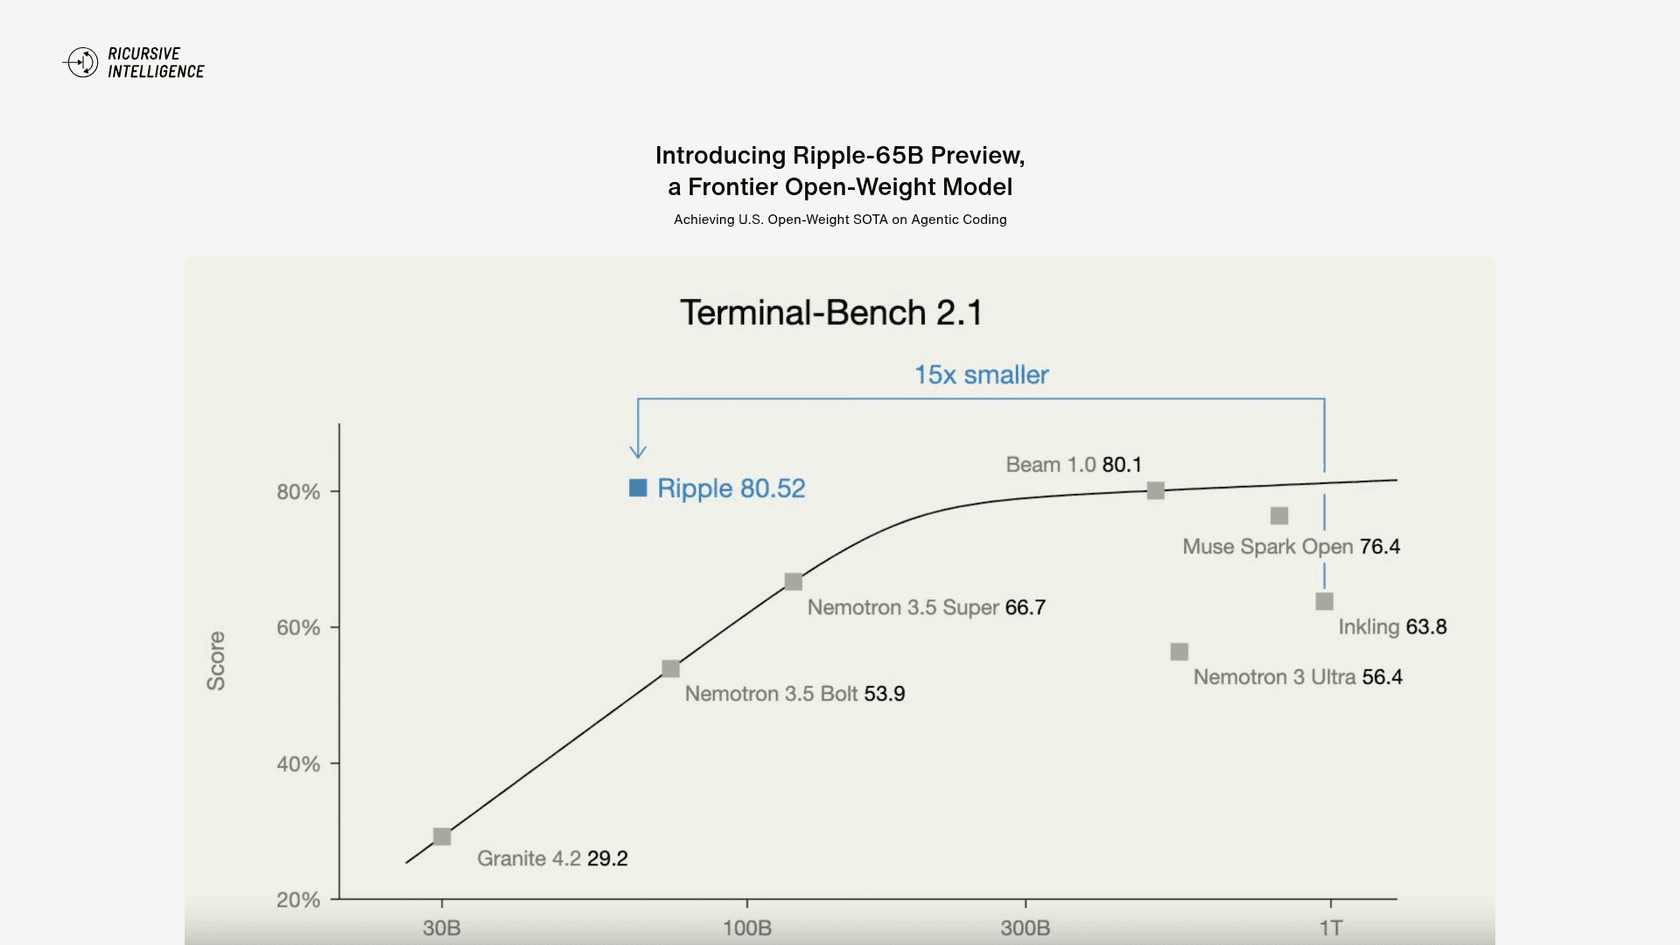
Diese Grafik ist der ganze Pitch: Score gegen Größe, mit Ripple weit links der Kurve. Sie ordnet auch kleinere US-Modelle wie Nemotron 3.5 Bolt (53,9) und Nemotron 3.5 Super (66,7) auf derselben Linie ein. Größenbereinigt liegt Ripple beim Coding klar vorn.
Die vollständige Tabelle auf der Modellkarte erzählt eine gemischtere Geschichte. Hier sind die Zeilen, die für Coding-Agenten zählen, Ricursives eigene Zahlen:
| Benchmark | Ripple-65B | Reflection Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Aktive Parameter | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1 (selbst berichtet) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminal-Bench 2.1 (Ricursive-Wiederholung) | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
| GPQA Diamond | 85.2 | 90.6 | 89.0 | 87.2 | 87.0 |
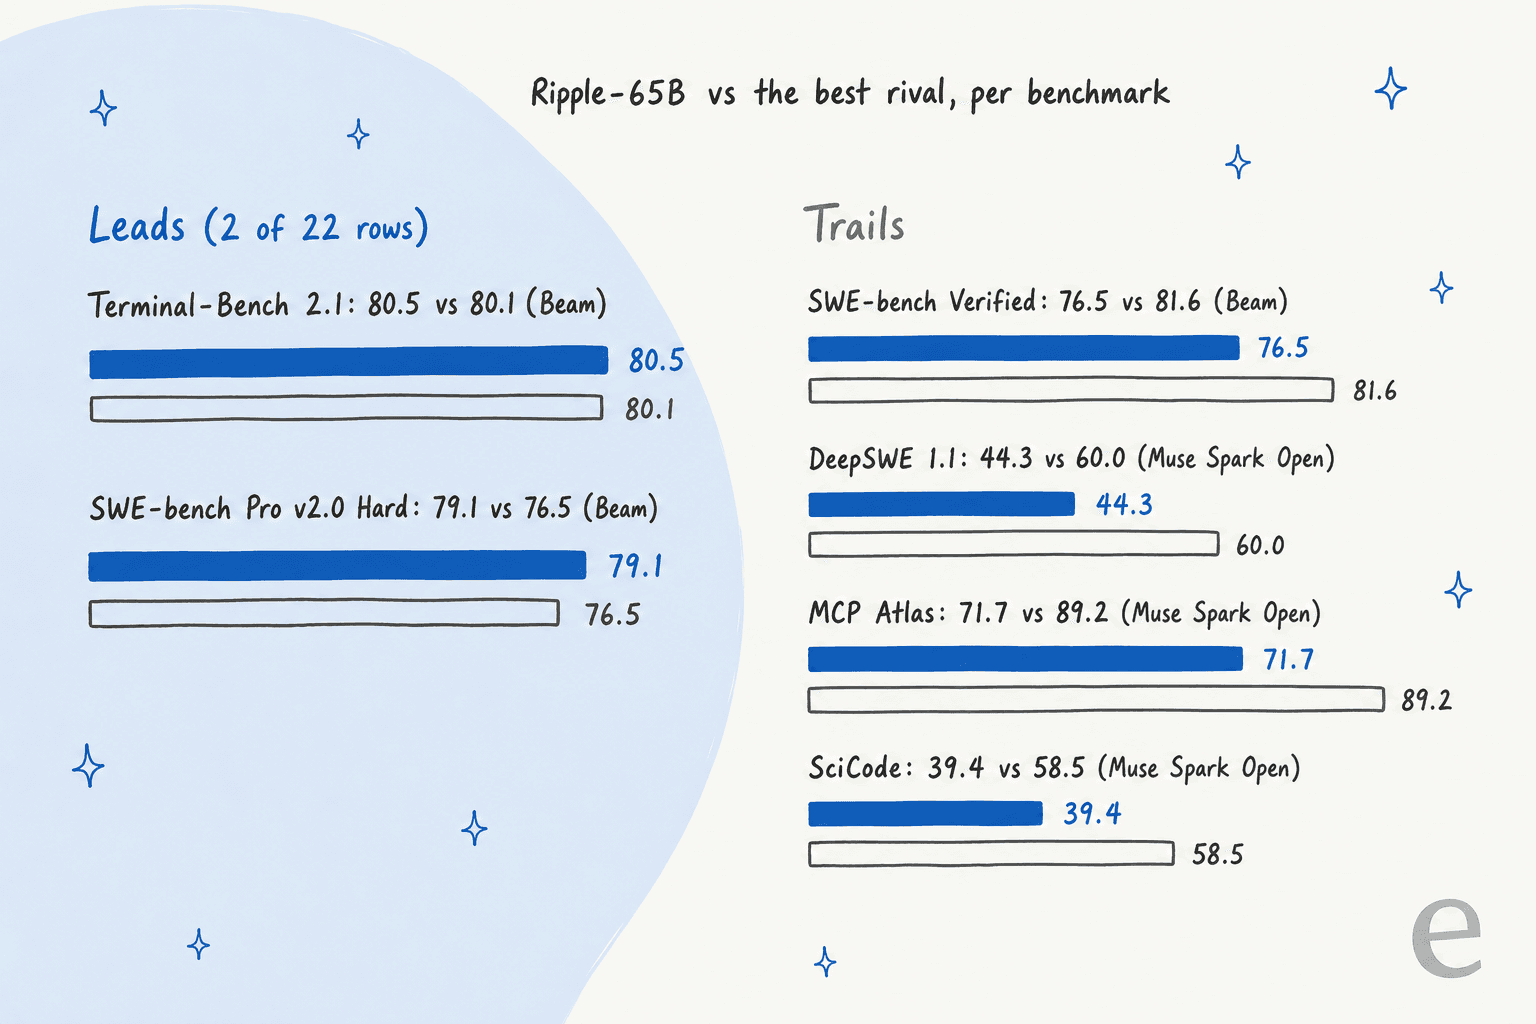
Beim genauen Lesen der Tabelle fallen vier Dinge auf.
- Es führt bei 2 von 22 Zeilen. Terminal-Bench 2.1 und SWE-bench Pro v2.0 Hard. Bei SWE-bench Verified und Pro v1.0 liegt Reflection Beam vorn. Bei DeepSWE, MCP Atlas und SciCode ist es Muse Spark Open.
- Die Wiederholung hilft Ripple am meisten. Als Ricursive Terminal-Bench 2.1 mit dem offiziellen Terminus-2-Harness wiederholte, fiel Beam von 80,1 auf 70,8, während Muse Spark Open auf 78,7 stieg. Die Karte sagt, die Werte seien auf diesem Harness "universally lower" gewesen, außer bei Muse, und nennt ihre Ergebnisse "a best-effort attempt at a fair comparison." Das ist ehrlich, bedeutet aber auch, dass die größere Lücke aus Ricursives eigenen Testläufen stammt.
- Mehrere Werte der Rivalen sind Ricursives Läufe, nicht die der Rivalen. Die Karte markiert hauseigene Ergebnisse kursiv, und das betrifft die meisten niedrigen Zahlen, etwa die 2,0 von Inkling bei SWE-bench Pro v2.0 Hard. Ricursives Launch-Blog nennt für einige derselben Zellen andere Werte (39,6 für Inkling, 72,4 für Muse), behandeln Sie diese Zeilen also mit Vorsicht, bis der Tech-Report erscheint.
- Chinesische Open-Weight-Modelle fehlen. Der Vergleich ist als "U.S. open-weight" gerahmt, es gibt also kein DeepSeek, Qwen oder Kimi in der Instruct-Tabelle. Wenn DeepSeek V4.1 Flash oder Qwen 3.8 Flash Next auf Ihrer Shortlist stehen, müssen Sie selbst vergleichen.
Keiner dieser Benchmarks wurde bisher von einem externen Labor geprüft. Bis jemand sie wiederholt, lautet die sichere Lesart: "ein dichtes 65B-Modell, das bei Coding mit den besten US-Open-Weight-Modellen mithält", nicht "das beste Open-Weight-Coding-Modell".
Was kostet Ripple-65B?
Die Gewichte sind unter Apache 2.0 kostenlos. Gehostet kostet Ripple-65B $0.20 pro Million Input-Tokens und $0.60 pro Million Output-Tokens, gecachter Input $0.05. Das gilt direkt bei GMI Cloud genauso wie bei OpenRouter, wo GMI Cloud der einzige Anbieter ist.
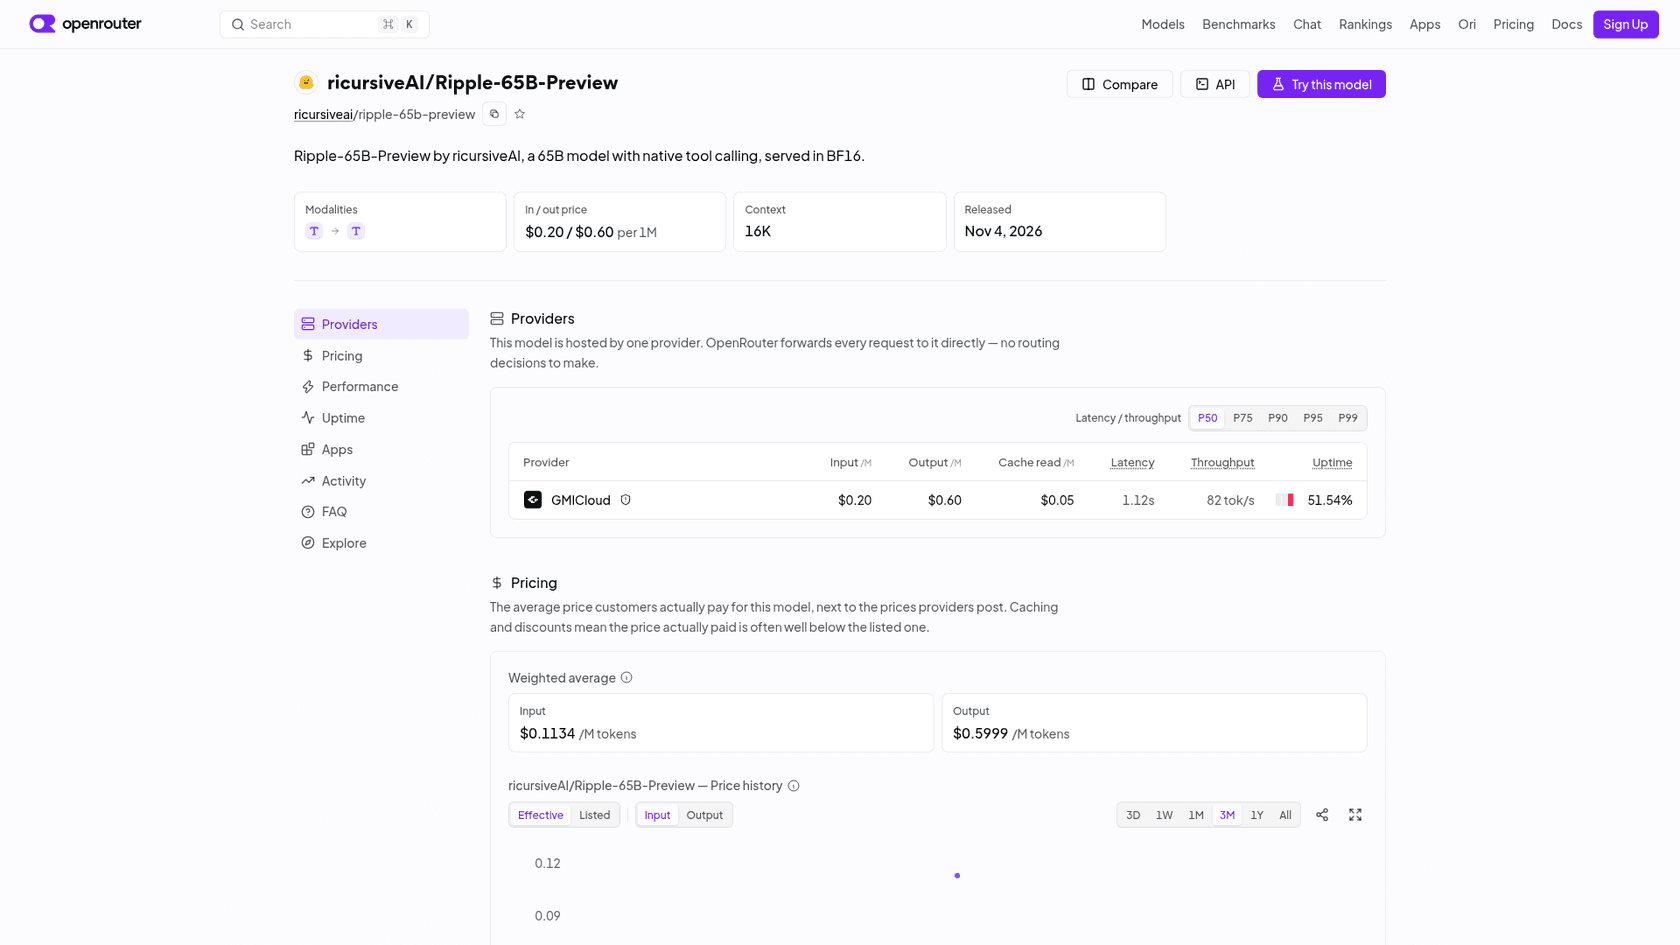
So schneidet das im Vergleich mit ähnlichen Modellen ab, nach den OpenRouter-Listenpreisen vom 5. November 2026:
| Modell | Input / 1M | Output / 1M | Gecachter Input / 1M | Kontext auf OpenRouter |
|---|---|---|---|---|
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | 16,384 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | 1,048,576 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | 1,048,576 |
| Inkling | $1.00 | $4.05 | $0.17 | 524,288 |
| Inkling Small | $0.45 | $1.20 | $0.10 | 524,288 |
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | 1,048,576 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | 1,050,000 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1,000,000 |
Ripple ist in dieser Tabelle die günstigste US-Open-Weight-Option beim Output. Zwei Dinge im Eintrag sind aber wichtiger als der Preis.
- Der gehostete Kontext beträgt 16K. OpenRouter begrenzt ihn auf 16.384 Tokens mit einem Output-Limit von 14.745 Tokens, obwohl die Modellkarte und GMIs eigene Seite 1M nennen. Ein Coding-Agent in einem echten Repo verbraucht 16K schnell, prüfen Sie das also, bevor Sie Ripple irgendwo anbinden.
- Ein Anbieter bedeutet knappe Kapazität. Mit GMI Cloud als einzigem Host zeigte OpenRouters Uptime-Anzeige bei meiner Prüfung etwa 51 % für den Vortag. Ricursive hat außerdem gesagt, Ripple komme zu Together AI und Fireworks. Am 5. November stand auf Togethers Seite noch "This model is coming soon to Together's Serverless API."
Kann man Ripple-65B lokal ausführen?
Ja, auf NVIDIA-Hardware, und das ist der interessanteste Teil der Veröffentlichung. Ricursive liefert zwei dokumentierte Setups, und das Kontextfenster hängt davon ab, welches Sie wählen.
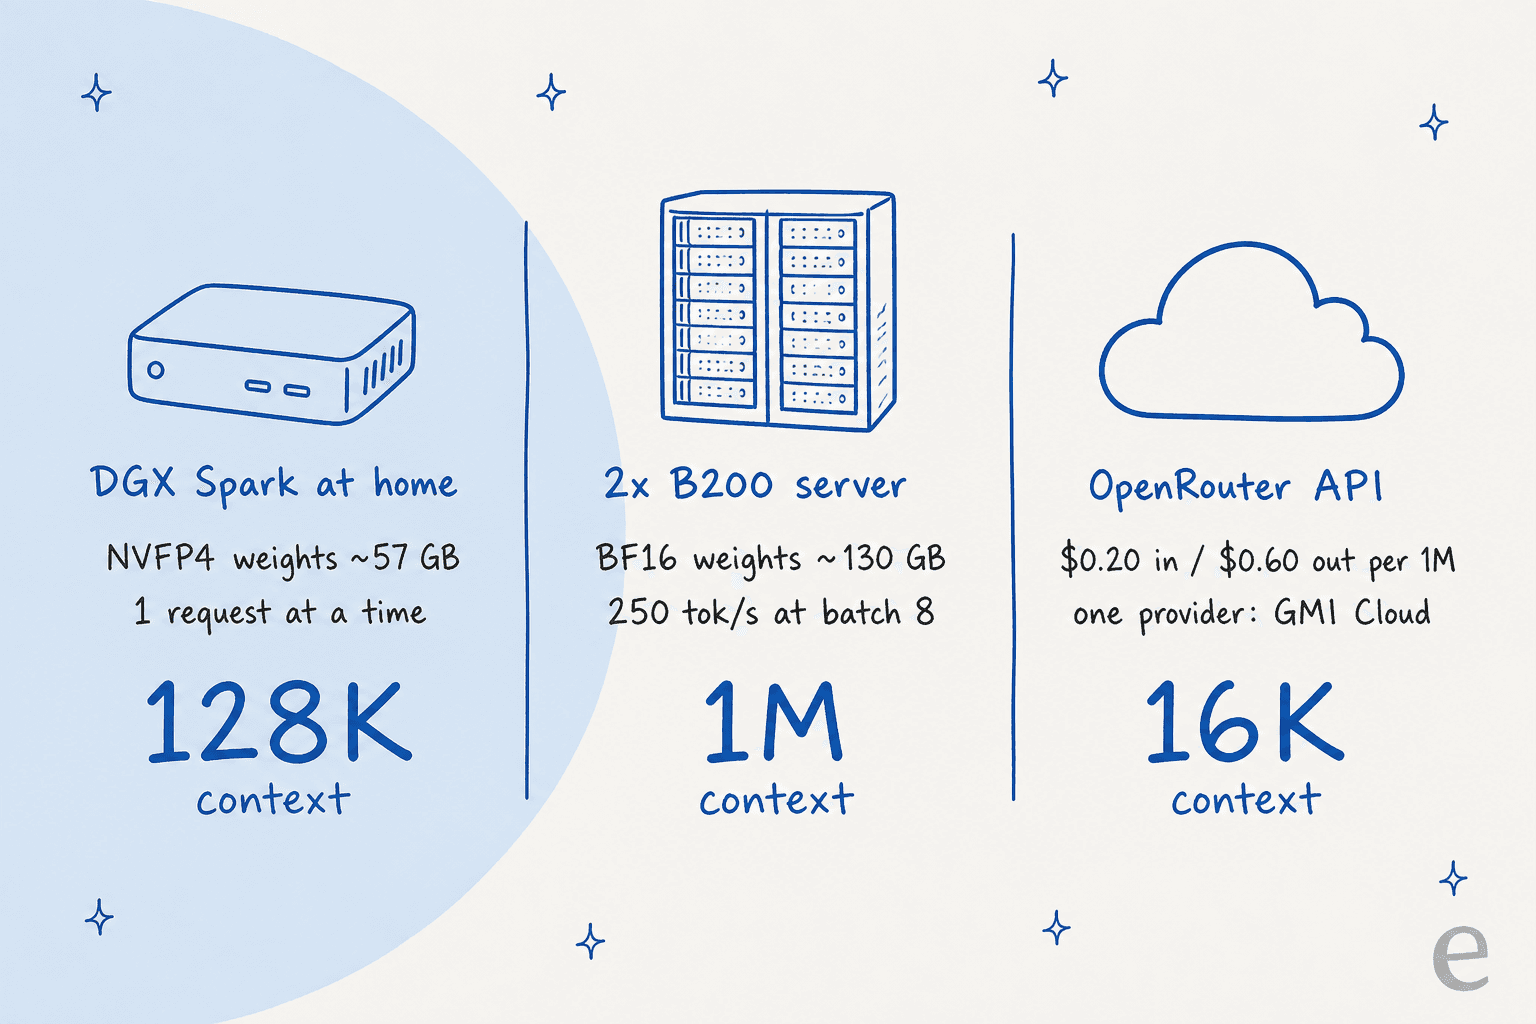
Auf einem DGX Spark. Das NVFP4-Repo enthält ein Notebook und ein spark.py-Skript für NVIDIAs Desktop-KI-Box. Es lädt die NVFP4-Gewichte (4 Bit für die Feed-Forward-Schichten, BF16 für Attention) plus das DFlash2-Draft-Modell und bedient eine Anfrage gleichzeitig bei 128K Kontext. Das Skript verweigert den Start auf allem, was kein GB10-Chip ist. Ricursive veröffentlicht keine Tokens-pro-Sekunde-Zahl für den Spark.
Auf zwei B200-GPUs. Das BF16-Repo enthält ein Server-Setup mit SGLang 0.5.19, das den vollen 1M-Kontext bedient, wobei Ricursive "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels" nennt. Mit vier GPUs erhalten Sie zwei unabhängige Kopien.
Auf einem Mac oder anderer Hardware. Es gibt keinen offiziellen Weg. Im Launch-Post des Mitgründers hieß es "You can run Ripple-65B locally and efficiently on a MacBook Pro", aber weder im Blog noch in einer der vier Modellkarten finden sich Anleitungen für MacBook, MLX oder llama.cpp. Community-GGUF-Konvertierungen tauchten binnen eines Tages auf Hugging Face auf; Ricursive hat sie nicht getestet.
Die Geschwindigkeit ist die offene Frage. Ein dichtes Modell liest für jedes Token alle Gewichte und hängt daher stark an der Speicherbandbreite, der Schwachstelle des Spark. Das kam schon Stunden nach dem Launch zur Sprache:
"What tok/s are you getting on the Spark? 65B dense on ~273GB/s of memory bandwidth has to crawl in an agent loop."
Das Draft-Modell ist Ricursives Antwort darauf: Beim Speculative Decoding rät das kleine Modell mehrere Tokens, die das große in einem Durchgang prüft. Ob das Agent-Schleifen auf einem Spark auf eine brauchbare Geschwindigkeit bringt, hatte bis zum 5. November öffentlich niemand gemessen.
Wie ruft man Ripple-65B aus Code auf?
GMI Cloud und OpenRouter bieten beide einen OpenAI-kompatiblen Chat-Endpunkt, also funktioniert jedes SDK oder Agent-Framework, das dieses Format spricht. Auf OpenRouter lautet die Modell-ID ricursiveai/ripple-65b-preview:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ricursiveai/ripple-65b-preview",
    "messages": [{"role": "user", "content": "Write a bash one-liner that finds the 10 largest files in a repo."}],
    "temperature": 0
  }'
Ein paar Details aus dem Chat-Template, die Sie kennen sollten, bevor Sie darauf aufbauen:
- Tool-Calling ist nativ. Tools stehen im System-Prompt, und Aufrufe kommen als JSON in
<tool_call>-Tags zurück, die SGLangsripple-Parser in Standard-tool_callsumwandelt. Wenn Sie einen Aufruf mittool_choice: "required"erzwingen, setzen Siestrict: true, denn Ricursive stellte fest, dass "non-strict required calls produced extra argument fields." - Reasoning ist immer an. Das Template wickelt das Denken in
<think>-Tags und "does not implement a thinking on/off switch or reasoning-effort levels." Sie zahlen bei jedem Aufruf Output-Tokens für dieses Denken. - Keine Sampling-Standardwerte. Ricursive nennt keine empfohlene Temperatur; die eigenen Beispiele nutzen 0.
Wenn Sie Ripple mit einem Coding-Agenten wie Claude Code oder einer agentischen Coding-CLI betreiben wollen, ist der gehostete 16K-Kontext die Grenze, an die Sie zuerst stoßen. Self-Hosting ist heute der Weg darum herum.
Was sagen Entwickler über Ripple-65B?
Der Haupt-Hacker-News-Thread erreichte am Launch-Tag 181 Punkte und 61 Kommentare. Zwei Themen dominierten: die Darstellung der Benchmarks und die Frage, ob ein dichtes 65B-Modell zu Hause praktikabel ist.
Bei der Darstellung lautete die häufigste Kritik, dass der Vergleich bei US-Modellen aufhört:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"

Andere verwiesen auf die Größe des Vorsprungs selbst:
"Still they score 0.42 percentage points higher than the second-best model on their chosen benchmark, so it's hardly a meaningful lead."
Das Gegenargument kam von Leuten, für die "in den USA gebaut" eine echte Anforderung ist, kein Marketinglabel:
"US Gov won't let Chinese models be hosted on any internal infra ... So there is absolutely a market for US-made or non-Chinese models there."
Beim Betrieb zu Hause gingen die Meinungen auseinander. Ein Kommentator erwartete, dass "inference will be prohibitively slow on consumer grade hardware", und sah die Veröffentlichung als gedacht für Chipdesign-Teams in Air-Gap-Umgebungen, was zu Ricursives eigenem Geschäft passt. Besitzer von Mac Studios mit viel Speicher waren optimistischer, da 130 GB Gewichte weit unter dem liegen, was ihre Cluster fassen. Gemessene Geschwindigkeiten hatte bis zum Morgen des 5. November niemand gepostet.
Die Kostenaussage kam am besten an. swyx nannte die Veröffentlichung "the avengers of open model SOTA" und zitierte die Fußnote, dass die $32M den gesamten F&E-Aufwand abdecken, was für die meisten das auffälligste Detail war.
Sollten Sie Ripple-65B für den Kundensupport nutzen?
Wahrscheinlich nicht als Gehirn eines Support-Bots, und der Grund ist die Passung, nicht die Qualität. Ripple-65B ist ein Coding-Modell mit leichtem Post-Training. Die Zeilen in Ricursives eigener Tabelle, die der Support-Arbeit am nächsten kommen, sind mittelmäßig: 31,27 bei τ³-bench Banking, das Gespräche mit Kunden zur Regelbefolgung testet (Beam erreicht 36,1), und 71,67 bei MCP Atlas, das Tool-Nutzung testet (Muse Spark Open erreicht 89,2). Der eine starke Fall ist Datenkontrolle: Wenn Kundendaten Ihr Netzwerk nie verlassen dürfen, ist ein Apache-2.0-Modell auf eigener Hardware eine echte Option, und Ripple ist eines der kleinsten starken.
Selbst dann ist das Modell der leichte Teil. Um Tickets gut zu beantworten, brauchen Sie auch Anbindungen an die Wissensdatenbank, Eskalationsregeln, Schutz vor erfundenen Antworten und eine Möglichkeit, Antworten zu prüfen, bevor Kunden sie sehen. Das ist der Zielkonflikt bei Build vs. Buy für KI-Support, und es ist der größte Teil der Arbeit.
Diese Lücke schließt eesel. eesel ist eine Plattform für KI-Teammitglieder, und das KI-Helpdesk-Teammitglied schließt sich Ihrem bestehenden Helpdesk an, lernt aus Ihrem Help Center und früheren Tickets und arbeitet in Ihrer Queue. Ich habe selbstbewusst klingende Bots in Live-Queues falsche Antworten geben sehen, deshalb läuft jeder eesel-Rollout zuerst gegen historische Tickets, sodass Sie lesen können, was es gesagt hätte, bevor es einen Kunden berührt.
Timengo ist ein gutes Beispiel am technischen Ende. Das Unternehmen verkauft in Dänemark Software für sichere E-Mail und Digital Post, und eesel entwirft seine technischen Support-Antworten auf Dänisch aus rund 5.300 früheren Tickets und Help-Center-Artikeln und bereitet in einem Monat etwa 300 Freshdesk-Tickets vor. SE Ranking betreibt drei Produkte auf Zendesk mit je einem eesel-Agenten, die in einem Monat 4.650 Konversationen bearbeiteten.
Und wenn Sie sich für Ripple interessiert haben, weil Sie gern im Terminal arbeiten, passt die eesel-CLI zu dieser Gewohnheit. Ein Coding-Agent kann damit freigegebenes Wissen wie exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Teammitglieds bearbeiten und Testfragen stellen, um die Antworten zu prüfen, bevor etwas live geht. Die Anbindung des Helpdesks selbst muss weiterhin jemand mit Admin-Zugriff freigeben. Mehr zu diesem Ablauf finden Sie unter KI-Agenten vom Terminal aus verwalten.
Wer sollte Ripple-65B nutzen?
Das ist mein Fazit, nachdem ich jede von Ricursive veröffentlichte Datei gelesen habe:
- Ausprobieren, wenn Sie ein Coding-Modell wollen, das Ihnen vollständig gehört. Apache 2.0, ein lokaler Weg auf einer einzigen Box und $0.60 pro Million Output-Tokens gehostet machen es günstig, es gegen Ihr eigenes Repo zu testen, und es ist ein natürlicher Kandidat für Teams, die nur in den USA gebaute Modelle betreiben dürfen.
- Selbst hosten, wenn Sie langen Kontext brauchen. Das gehostete 16K-Limit schließt ernsthafte Agentenarbeit heute aus; der 1M-Kontext kommt nur mit eigenen GPUs.
- Warten, wenn Sie Belege brauchen. Es gibt noch keinen Tech-Report, die Benchmark-Quellen widersprechen sich bei einigen Zellen, und kein externes Labor hat die Zahlen wiederholt. Ein paar Wochen unabhängiger Tests werden vieles klären.
- Woanders schauen, wenn allein der Preis entscheidet. DeepSeek V4.1 Flash ist bei Input und Output günstiger, und Kimi K3.1 Pro wurde breiter getestet. Für eine größere Shortlist siehe die besten KI-Coding-Assistenten.
Das faire Fazit: Ripple-65B Preview zeigt, dass ein kleines Team mit einem dichten 65B-Modell beim Coding in den Bereich von US-Open-Weight-Modellen kommen kann, die acht- bis fünfzehnmal so groß sind, für gemeldete $32M. Das ist ein echtes Ergebnis. "State of the art" gilt nur innerhalb einer engen Kategorie, und ob es für Ihre Arbeit gilt, finden Sie heraus, indem Sie es an Ihren eigenen Aufgaben ausführen.
eesel ausprobieren
Wenn Sie zu Ripple-65B gekommen sind, weil Sie hofften, ein offenes Modell könne Ihrem Team Tickets abnehmen, können Sie sich den Aufbau der Support-Schicht sparen. Das KI-Helpdesk-Teammitglied von eesel verbindet sich in Minuten mit Zendesk, Freshdesk, Gorgias und mehr, lernt aus Ihren früheren Tickets und zeigt Ihnen, wie es sie beantwortet hätte, bevor es live geht. Die Tarife beginnen bei $299 pro Monat, und es gibt eine kostenlose Stufe zum Testen.
