

Ripple-65B ist das beste in den USA gebaute offene Modell, das auf einer einzigen Maschine läuft, aber insgesamt nicht das beste offene Coding-Modell. Es erreicht 80.5 in Terminal-Bench 2.1, einen Hauch über Reflections Beam (80.1), einem Modell, das fast achtmal so groß ist. Abseits dieser Zeile führt Beam bei fünf Coding- und Agent-Tests, und seine API bietet 1M Tokens Kontext, wo Ripples 16,384 bietet.
Mein Urteil: 3.5/5. Wähle Ripple für US-Gewichte unter Apache 2.0, die auf einen DGX Spark passen; nimm Beam, wenn du einfach eine API willst. Für einen Support-Agenten erspart dir ein fertiges Teammate wie eesel die Modellwahl, und seine CLI lässt einen Coding-Agenten deine Hilfedokumente laden und Antworten vor dem Livegang testen.
Was ist Ripple-65B, in einer Minute?
Ripple-65B Preview ist ein Open-Weight-Sprachmodell, das am 4. November 2026 von Ricursive Intelligence veröffentlicht wurde, einem Labor, das KI für Chipdesign baut. Ricursive hat es von Grund auf trainiert und nennt es "a general-purpose variant of the proprietary model that powers our AI chip design platform." Wenn du die komplette Spezifikation willst, findest du sie im Ripple-65B-Erklärstück meines Kollegen; dieser Beitrag ist das Urteil.
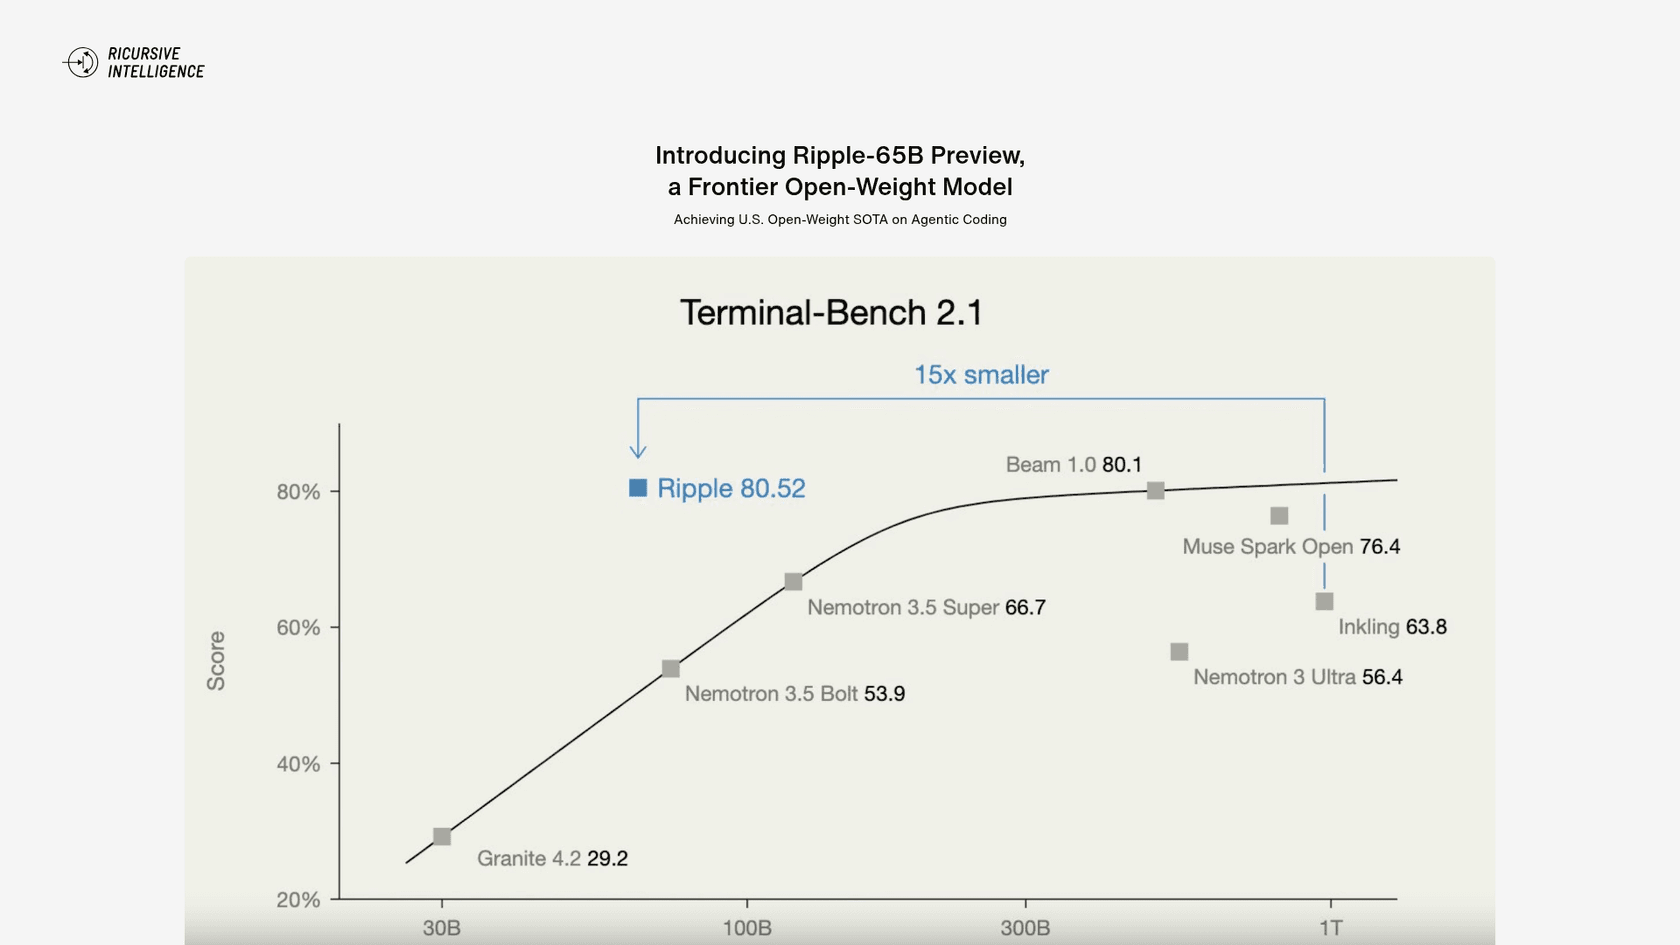
Das Datenblatt aus der Model Card:
| Spezifikation | Ripple-65B Preview |
|---|---|
| Parameter | 65B gesamt, alle aktiv (dicht, kein Mixture-of-Experts) |
| Schichten | 80, mit 4 Sliding-Window-Schichten auf 1 globale Schicht |
| Trainingsdaten | 12T Tokens, nur Text, überwiegend Englisch und Code |
| Kontext (angegeben) | Bis zu 1M Tokens |
| Lizenz | Apache 2.0 |
| Checkpoints | BF16 Instruct, NVFP4 Instruct (experimentell), Base, DFlash2-Draft-Modell |
| Reasoning | Denkt immer in <think>-Tags, kein Ein/Aus-Schalter, keine Aufwandsstufen |
| Gesamte F&E-Kosten | $32M, laut Ricursive |
Die letzte Zeile ist der Teil, über den alle reden. Ricursive sagt, $32M decken die gesamten Forschungs- und Entwicklungskosten von Grund auf ab, und nennt das "one-tenth the cost of the previous open-weight SOTA on agentic coding." Die Fußnote zeigt, dass dieses "one-tenth" Ricursives eigene Schätzung von Beams Rechenkosten ist, gebaut aus einem Pressebericht und Reflections Trainingszeitplan, also nimm es als grobe Einordnung und nicht als geprüften Vergleich.
Wie habe ich es getestet?
Ich baue die Integrationen hinter eesels KI-Agenten, also lese ich eine Model Card so, wie ich eine API-Spezifikation vor dem Produktiveinsatz lesen würde: welche Zahlen es gibt, woher sie stammen und was kaputtgeht, wenn man es tatsächlich aufruft. Eines hat mir eesels jahrelange Erfahrung mit Agenten auf echten Helpdesks gezeigt: Ein Leaderboard sagt dir nicht, was ein Modell auf deinen eigenen Tickets tut, weshalb jeder eesel-Rollout vor dem Livegang gegen vergangene Tickets simuliert wird.
Für Ripple hatte ich am Launch-Tag keinen API-Zugang, um mein eigenes Testset laufen zu lassen, daher stützt sich dieser Test ausschließlich auf Primärquellen:
- Ricursives Launch-Beitrag sowie die Model Card auf Hugging Face mit den Inferenz-Skripten.
- Die Live-Einträge bei OpenRouter, GMI Cloud und Together AI, geprüft am 5. November 2026.
- Die Entwicklerreaktionen des ersten Tages auf Hacker News und X.
Ripple ist noch nicht bei Artificial Analysis gelistet, also ist jeder Benchmark unten Ricursives eigene Zahl. Ich nenne jeweils die Seite, von der sie stammt, denn die beiden Seiten stimmen, wie du sehen wirst, nicht immer überein.
Wie schneidet Ripple-65B gegen Beam und die anderen US-Open-Modelle ab?
Bei den zwei Zeilen, mit denen Ricursive wirbt, gewinnt Ripple. Bei den meisten anderen nicht. Hier die Instruct-Tabelle aus der Model Card, reduziert auf die Coding- und Agent-Zeilen, die für Käufer eines Coding-Modells zählen:
| Benchmark | Ripple-65B | Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 (selbst gemeldet) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| τ³-bench banking | 31.27 | 36.1 | 14.4 | 23.7 | 22.6 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
Zwei Dinge fallen auf. Erstens: Der Vorsprung bei Terminal-Bench gegenüber Beam beträgt 0.4 Punkte, bei ehrlicher Lesart ein Gleichstand. Zweitens schlägt Beam Ripple in fünf Coding- und Agent-Zeilen, und Muse Spark Open, das ich in meinem Muse-Spark-Open-Test besprochen habe, holt DeepSWE, MCP Atlas und SciCode.
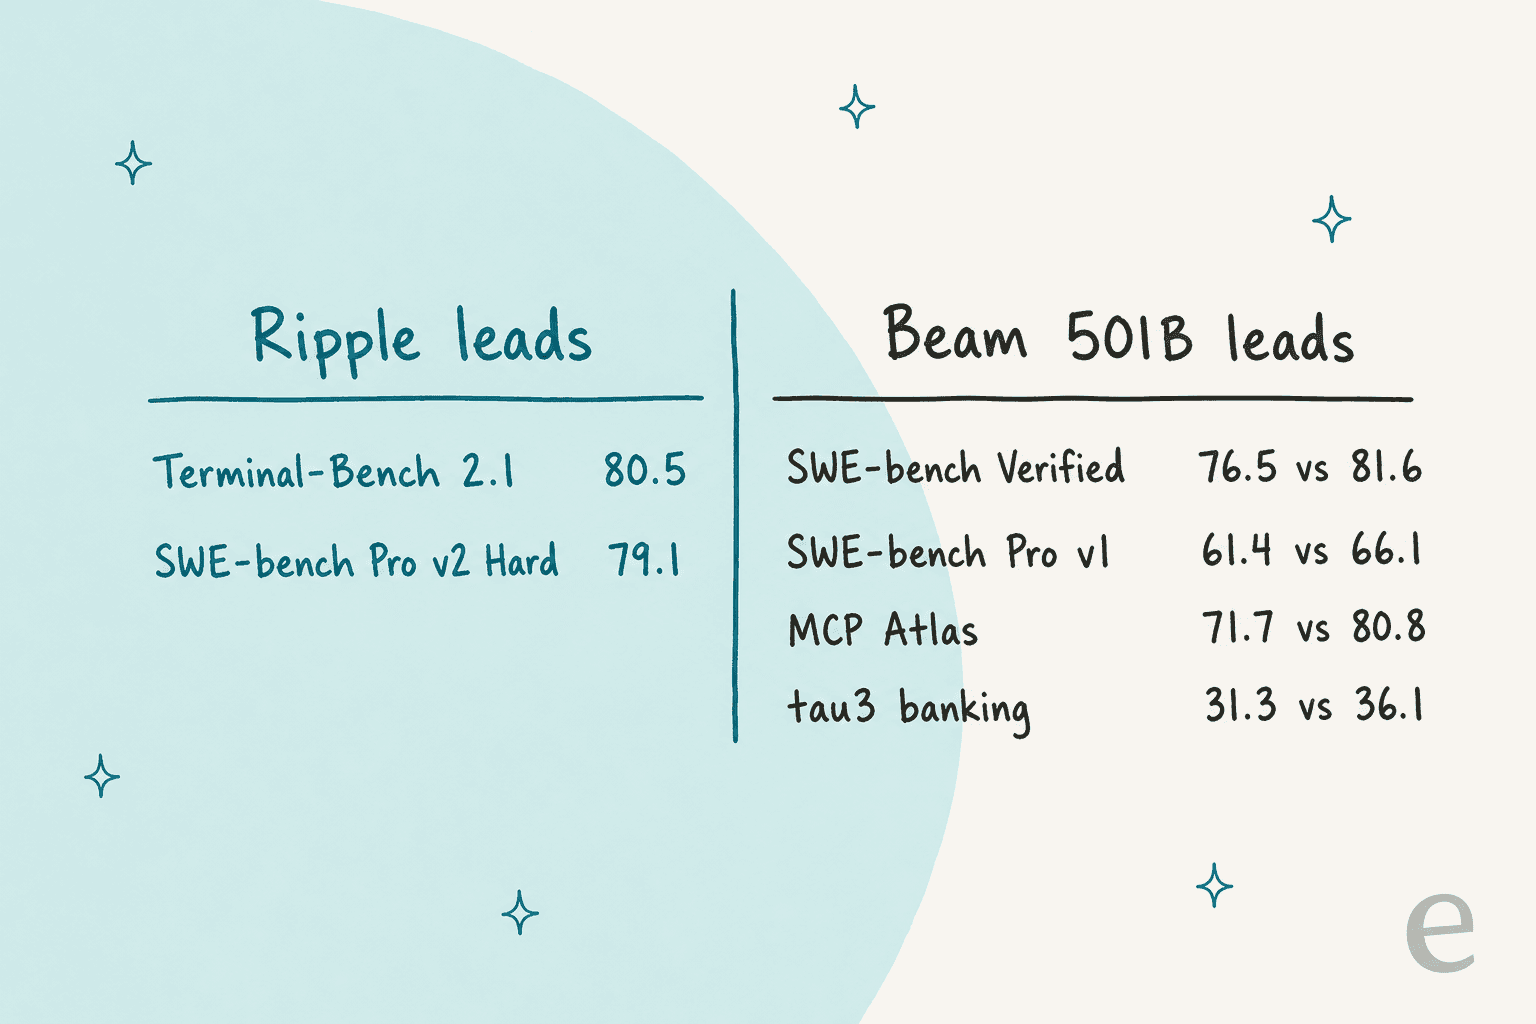
Trotzdem ist es ein echtes Ergebnis, wenn ein 65B-Modell bei seiner besten Zeile mit einem 501B-Modell gleichzieht. Beam hat 23B aktive Parameter pro Token, Ripple hat alle 65B aktiv, der Vergleich ist also weniger schief, als "8x kleiner" vermuten lässt, aber beim Speicherbedarf lässt sich Ripple viel leichter hosten.
Welchen Zahlen kannst du trauen?
Ricursive ist offen, was die Unschärfe betrifft. Die Model Card sagt, die Werte der Konkurrenz seien "official model card scores where available", der Rest seien eigene interne Läufe. Außerdem wird vermerkt, dass die Terminal-Bench-2.1-Werte auf dem offiziellen Terminus-2-Harness "universally lower (with the exception of Muse Spark Open)" ausfielen, weshalb beide angegeben werden.
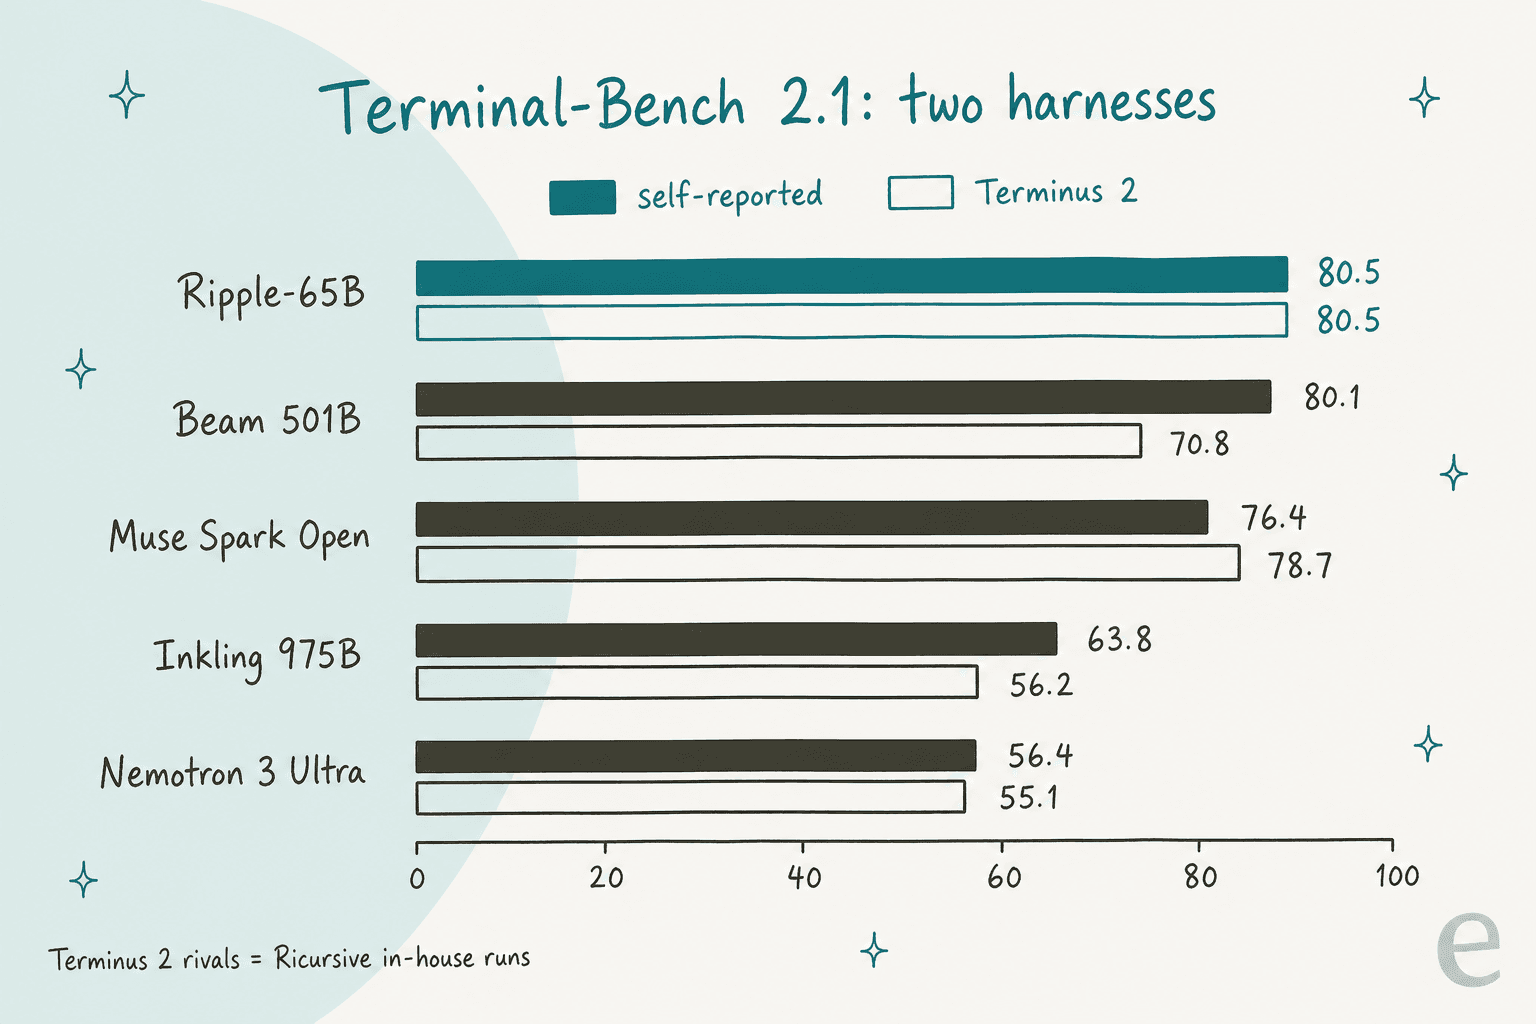
Auf demselben Terminus-2-Harness wächst Ripples Vorsprung vor Beam auf fast 10 Punkte (80.5 vs. 70.8). Das ist die interessanteste Zahl der Veröffentlichung und zugleich die, die ich zuerst nachprüfen würde, denn der Beam-Wert dort stammt aus Ricursives eigenem Lauf, nicht von Reflection.
Die zweite Unstimmigkeit: Das Launch-Diagramm und die Model Card widersprechen sich bei einigen Konkurrenzwerten. Bei SWE-bench Pro v2.0 Hard zeigt der Launch-Beitrag Muse Spark Open mit 72.4 und Inkling mit 39.6, während die Model Card 52.3 und 2.0 nennt. Ripples eigene Zahlen stimmen auf beiden Seiten überein. Es ist ein Preview-Launch, und das wird wohl noch bereinigt, aber bis dahin würde ich die Konkurrenzspalten als ungefähr betrachten.
Was kostet Ripple-65B?
Ripple ist günstig im Aufruf, mit einem großen Haken. Die Preise unten stammen aus dem jeweiligen Eintrag des Anbieters, geprüft am 5. November 2026:
| Route | Eingabe / 1M | Ausgabe / 1M | Cache-Lesen / 1M | Kontext |
|---|---|---|---|---|
| GMI Cloud | $0.20 | $0.60 | $0.05 | 1,000,000 angegeben |
| OpenRouter (von GMI bereitgestellt) | $0.20 | $0.60 | $0.05 | 16,384, max. Ausgabe 14,745 |
| Together AI | Demnächst | Demnächst | n/a | 1M angegeben |
| Hugging-Face-Gewichte | Kostenlos (Apache 2.0) | Deine Hardware | n/a | Bis zu 1M auf 2x B200 |
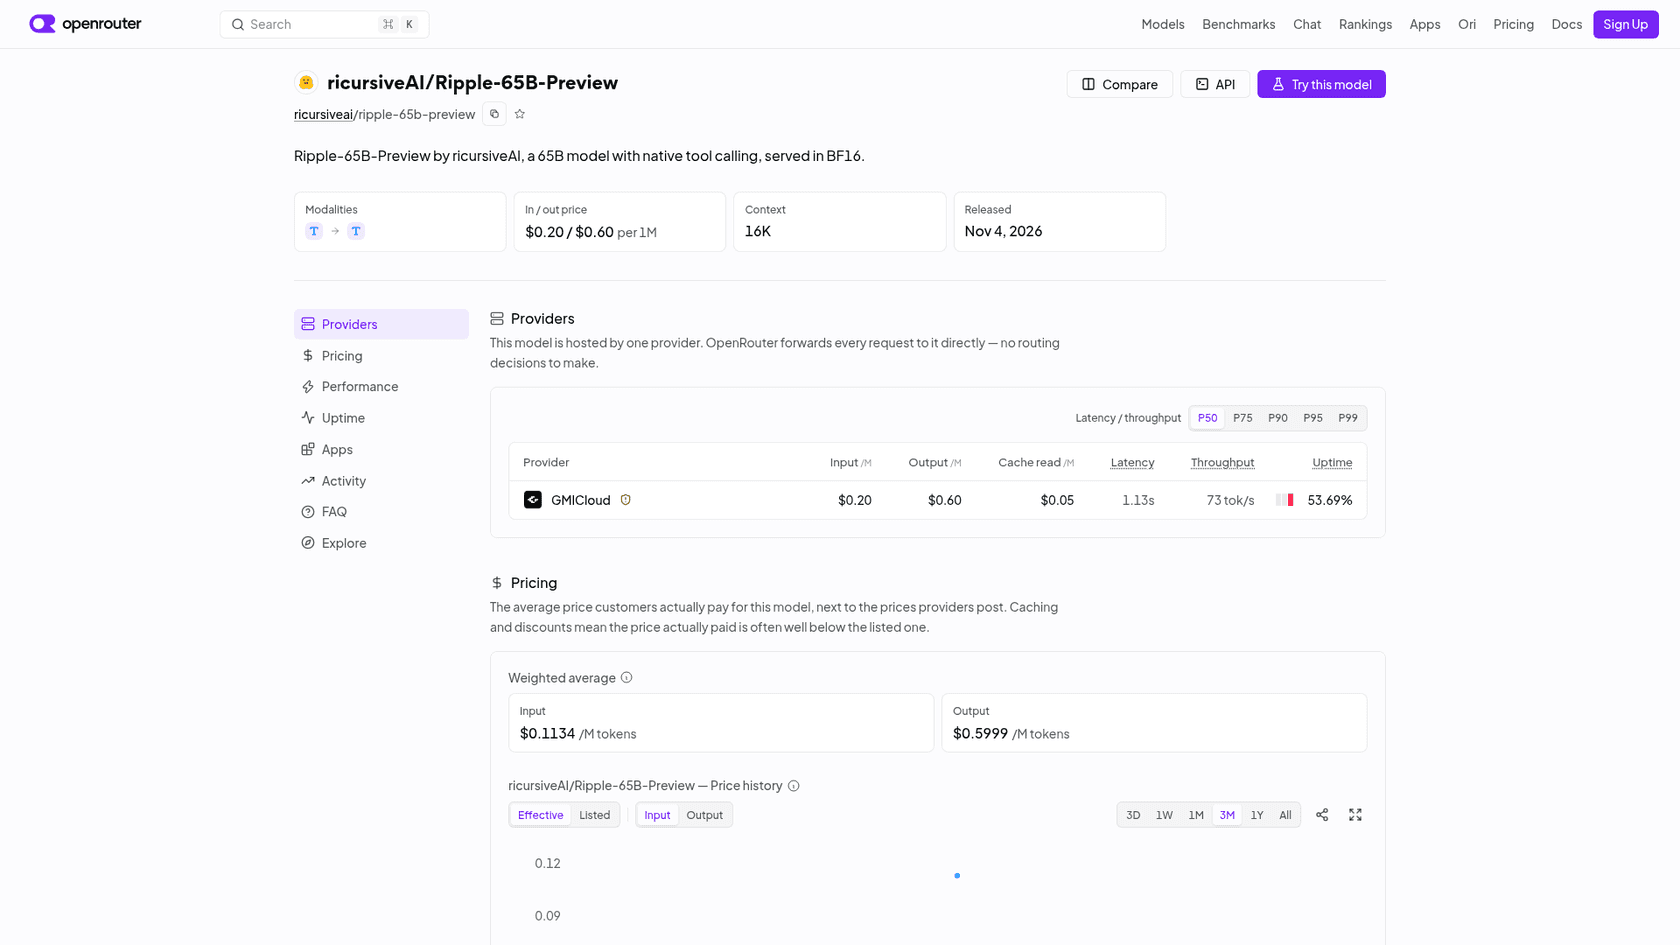
Der Haken ist das 16K-Fenster. Ein Coding-Agent wie Claude Code oder die Tools aus meinem Leitfaden zu KI-Coding im Terminal kann 16,384 Tokens verbrauchen, bevor er das Repo fertig gelesen hat. Über OpenRouter ist Ripple heute zu kurzsichtig für das agentische Coding, für das es gebaut wurde. Als ich die Seite festhielt, zeigte sie außerdem einen einzelnen Anbieter mit 53.69% Uptime und 73 Tokens pro Sekunde, was an Tag zwei normal ist, aber nichts, was man schon produktiv einsetzen sollte.
So rechnet sich eine Sitzung mit 10M Eingabe- und 1M Ausgabe-Tokens gegenüber den offenen Konkurrenten, mit OpenRouters Listenpreisen:
| Modell | Eingabe / Ausgabe pro 1M | Kosten für 10M rein + 1M raus | Kontext auf OpenRouter |
|---|---|---|---|
| Ripple-65B Preview | $0.20 / $0.60 | $2.60 | 16,384 |
| Beam 1.0 501B | $0.25 / $1.00 | $3.50 | 1,048,576 |
| Qwen3.8 27B | $0.15 / $1.875 | $3.38 | 1,024,000 |
| DeepSeek V4.1 Flash | $0.045 / $0.50 | $0.95 | 1,048,576 |
| Inkling | $1.00 / $4.05 | $14.05 | 524,288 |
| Muse Spark Open | $1.25 / $4.25 | $16.75 | 1,048,576 |
Ripple ist in dieser Sitzung also $0.90 günstiger als Beam, bei 64-mal weniger Kontext. Für die meisten API-Käufer lohnt dieser Tausch nicht. DeepSeek V4 Flash bleibt die Budget-Wahl, und Qwen 3.8 ist der naheliegende nicht-amerikanische Vergleich, den Ricursive aus seinem Diagramm gelassen hat. Ebenso Kimi K3.
Kannst du es wirklich auf eigener Hardware betreiben?
Ja, und genau hier verdient Ripple seinen Platz. Ein dichtes 65B-Modell ist klein genug für eine einzelne Maschine, und Ricursive liefert die Skripte dafür. Was das Launch-Marketing überspielt, ist, wie viel jede Route von dir verlangt:
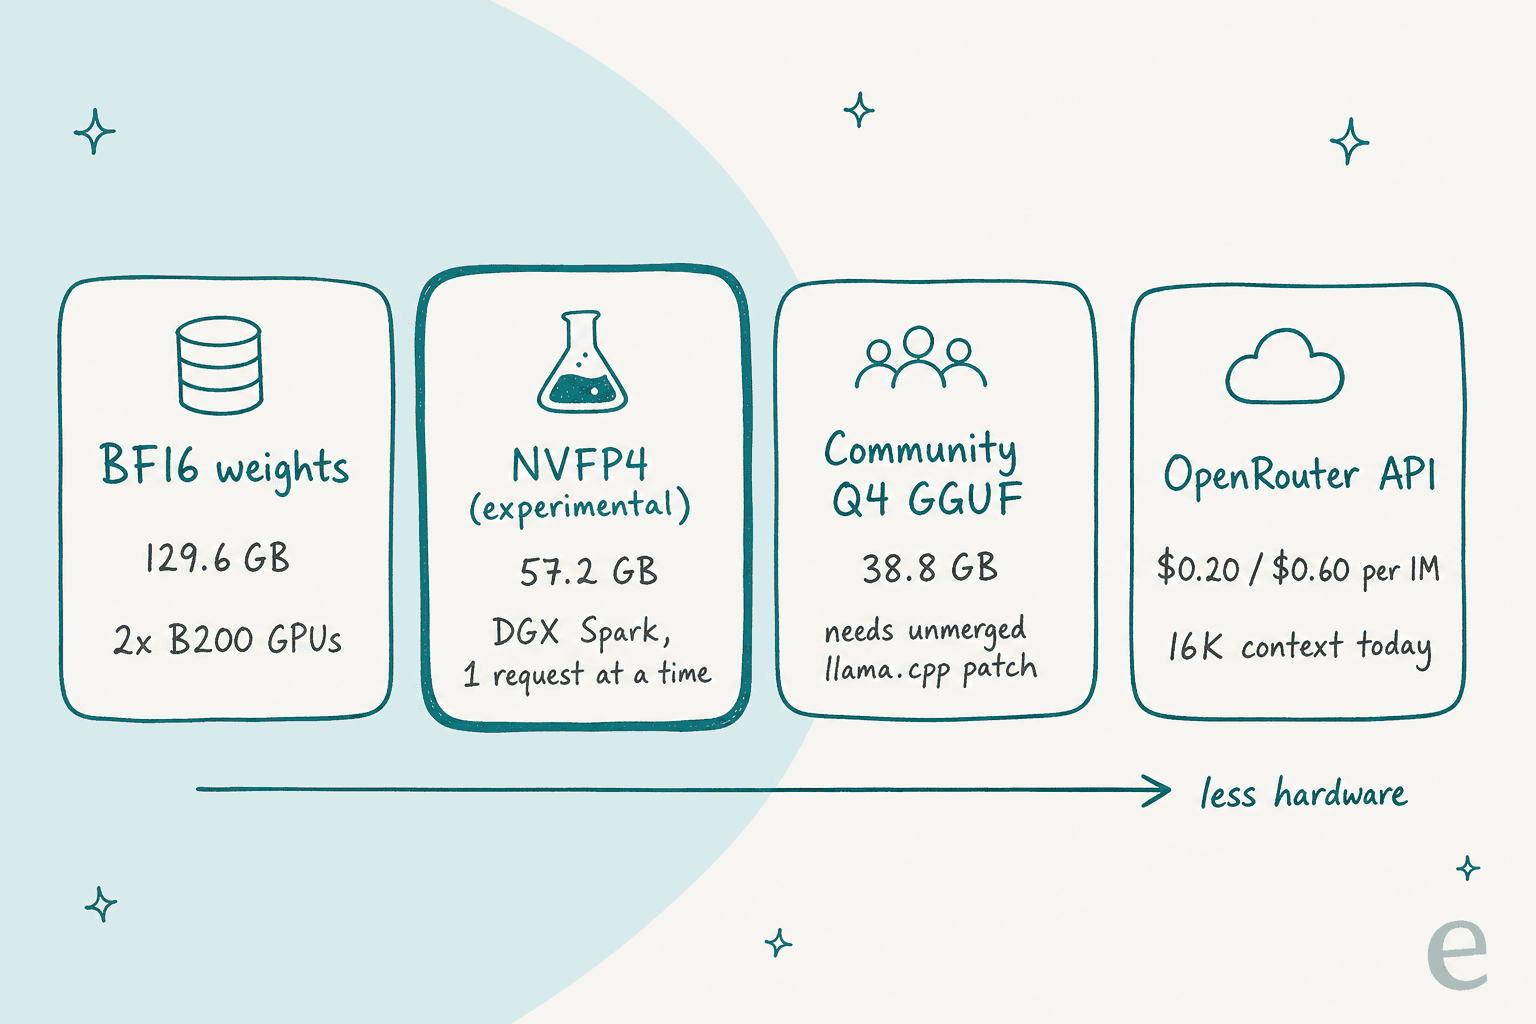
- BF16 auf 2x B200. Das Server-README nutzt SGLang 0.5.19 mit dem DFlash2-Draft-Modell und 1M Kontext als Standard. Die Karte nennt
250Tokens pro Sekunde bei Batch 8. - NVFP4 auf einem DGX Spark. Der NVFP4-Checkpoint ist als experimentell gekennzeichnet, hält die Attention in BF16, und das lokale Skript bearbeitet eine Anfrage nach der anderen bei 128K Kontext.
- Community-GGUF. AtomicChats Quant hat bei Q4_K_M
38.8 GB, aber Standard-llama.cpp, Ollama und LM Studio können es nicht laden, bis ein llama.cpp-Patch landet. - Kein MLX-Build. Ricursives Mitgründer schrieb, man könne es "on a MacBook Pro" ausführen, aber keine offizielle Anleitung deckt Apple Silicon bisher ab.
Ein Hacker-News-Kommentator brachte den Kompromiss dichter Modelle gut auf den Punkt:
"it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware"

Und die andere Seite, von jemandem mit der passenden Hardware:
"Speaking as someone who has High-Memory Mac Studios, it is great that there is finally a model that will run at usable speeds with high quality."
Zwei kleinere Stolperfallen für alle, die es in einen Agenten einbauen. Das Chat-Template "does not implement a thinking on/off switch or reasoning-effort levels", also zahlt jede Antwort für einen Reasoning-Durchlauf. Und um einen Tool-Aufruf zu erzwingen, braucht es strikte Schemas: Die Karte warnt, "Non-strict required calls produced extra argument fields." OpenRouters Endpunkt akzeptiert vorerst nur tool_choice mit none oder auto.
Was sagen Entwickler dazu?
Die Reaktionen des ersten Tages teilen sich klar. Die Trainingskosten werden von fast allen gelobt, die "State of the art"-Rahmung stößt auf Gegenwind. Von der X-Seite:
"this is like the avengers of open model SOTA"
Das war swyx als Reaktion auf die $32M Gesamt-F&E-Kosten. Auf Hacker News, wo der Thread 182 Punkte erreichte, war die meistbeantwortete Kritik die enge Kategorie:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"
Mehrere Kommentatoren wiesen darauf hin, dass das Diagramm nur US-Open-Modelle vergleicht und Qwen weglässt. Einer stellte Ripples Terminal-Bench-Wert neben den von Alibaba:
"This model scores 80.5 on Terminal Bench 2.1 For reference Qwen 3.8 Flash Next (which is bigger than this model but probably cheaper to run due to MoE) scores 84.3, and Qwen 3.8-27B scores 73.0."
Und der Kommentar, der für mich erklärt, für wen dieses Modell wirklich gedacht ist:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States."
Das ist der eigentliche Markt. Wenn dein Sicherheitsteam Gewichte chinesischer Labore ausgeschlossen hat, waren die Alternativen in dieser Größe dünn gesät, und Ripple ist jetzt das stärkste US-Open-Modell, das auf eine einzelne Workstation passt.
Solltest du Ripple-65B für einen Support-Agenten nutzen?
Ich würde es nicht als erste Wahl nehmen, und der Grund steht in Ricursives eigener Tabelle. τ³-bench banking ist das, was auf der Karte einem Kundenservice-Test am nächsten kommt: ein Agent, der Richtlinien folgt und Tools für einen Bankkunden aufruft. Ripple erreicht dort 31.27, hinter Beams 36.1. Dazu das immer aktive Reasoning (langsamere erste Antworten), das leichte Post-Training "with a focus on agentic coding" und der 16K-Kontext im Hosting: Es ist für einen anderen Job gebaut. Mein Leitfaden zum besten LLM für Support geht tiefer darauf ein, was dort zählt.
Der größere Punkt: Ein Modell ist Infrastruktur. Für ein Support-Team ist das Schwierige alles drumherum: das Helpdesk lesen, aus vergangenen Tickets lernen, wissen, wann übergeben wird. Dafür ist eesel da. Es ist ein KI-Teammate, das du für eine Aufgabe einstellst, wie das KI-Helpdesk-Teammate, statt eines Modells, das du hostest. Drei Kunden zeigen, wie das aussieht:
- SE Ranking betreibt einen eesel-Agenten pro Produkt auf Zendesk und bearbeitete
4,650Gespräche in einem Monat, wobei Erstattungen, Testverlängerungen und Tier-2-Fragen ans Team gingen. - Timengo nutzt es auf Freshdesk, um Antworten auf technische Tickets aus etwa
5,300vergangenen Tickets und Hilfeartikeln zu entwerfen, und eesel antwortet dort nie selbstständig an einen Kunden. - SamCart betreibt getrennte Agenten auf Freshdesk und Website-Chat und antwortet auf Basis von etwa
280Help-Center-Artikeln.
Wenn du Tools gern vom Terminal aus steuerst, lässt die eesel-CLI einen Coding-Agenten wie Claude Code, Codex oder Cursor freigegebenes Wissen hochladen, etwa exportierte Hilfeartikel und Richtlinien, dann dem Agenten mit eesel chat Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Das Helpdesk selbst anzubinden braucht weiterhin jemanden mit Admin-Zugriff, der es freigibt. Mehr zu diesem Muster im Leitfaden zur KI-Agenten-CLI, und der Erklärtext zum MCP-Server behandelt den anderen Weg hinein.
Die Haken vor dem Wechsel
- Der gehostete Kontext ist 16K. Für einen Chat in Ordnung, für Agentenarbeit im Repo-Maßstab zu klein, bis GMI oder Together ihn anheben.
- Die Benchmarks sind noch nicht unabhängig. Kein Eintrag bei Artificial Analysis, und das Launch-Diagramm und die Model Card widersprechen sich bei einigen Konkurrenzwerten.
- Das lokale Setup ist NVIDIA-zentriert. Offizielle Wege brauchen B200s oder einen DGX Spark; Mac-Nutzer warten auf Community-Builds.
- Es denkt immer. Das Reasoning lässt sich für schnelle, einfache Antworten nicht abschalten.
- Es ist ein Preview. Ricursive nennt das Post-Training "relatively light", und der NVFP4-Build ist experimentell.
Fazit: Für wen lohnt sich Ripple-65B?
Meine Bewertung: 3.5/5. Ripple ist ein beeindruckendes erstes Modell eines fünfköpfigen Trainingsteams, und die $32M Gesamtkosten sind wichtig dafür, wohin sich offene Modelle entwickeln. Aber der Spitzensieg ist ein Gleichstand mit 0,4 Punkten, und wer Modelle nach eigenen Maßstäben vergleicht, findet Beam in mehr Zeilen vorn.
- Nimm es, wenn du Apache-2.0-Gewichte eines US-Labors brauchst, einen DGX Spark oder zwei B200 hast und dein Agent im Terminal lebt. Das ist eine echte Nische, und Ripple besetzt sie.
- Lass es, wenn du eine API aufrufst. Beam 1.0 kostet
$0.25/$1.00mit 1M-Fenster, und DeepSeek V4 Flash ist deutlich günstiger, wenn dir die Herkunft des Labors egal ist. - Warte einen Monat, wenn du auf einem Mac arbeitest. Sobald die llama.cpp-Unterstützung gemergt ist und jemand echte Tokens-pro-Sekunde-Zahlen veröffentlicht, wird der lokale Fall deutlich klarer.
Für das größere Feld deckt mein Inkling-Test das größte US-Open-Modell ab. Der GLM-5.3-Flash-Test behandelt eine günstigere chinesische Option.
Die Übersicht der Kimi-K3-Alternativen reiht die offenen Modelle nebeneinander. Auf der geschlossenen Seite ist Claude Sonnet 5.5 weiterhin das Modell, das die meisten Coding-Agenten standardmäßig nutzen, dicht gefolgt von GPT-5.6.
eesel ausprobieren
Wenn du hier bist, weil du ein Modell für einen Support-Agenten auswählst, kannst du diesen Schritt überspringen. eesel ist ein KI-Teammate, das sich in Zendesk, Freshdesk oder Gorgias einklinkt, aus deinen vergangenen Tickets und deinem Help Center lernt und an deinen echten Gesprächen getestet wird, bevor es jemandem antwortet. SE Ranking kam vom Setup zu 4,650 Gesprächen pro Monat über drei Produkte. Pläne beginnen bei $299/month für 500 Credits auf der Preisseite, mit kostenloser Testphase. Probiere eesel aus und lass es zuerst gegen deine eigene Warteschlange laufen.
