

Was ist Reflection AI Beam?
Beam ist das erste Modell von Reflection AI, einem Labor, das zwei ehemalige Google-DeepMind-Forschende 2024 gegründet haben. Technisch ist es ein spärliches Mixture-of-Experts-Modell (MoE) mit 501 Milliarden Parametern insgesamt, 23 Milliarden aktiv pro Token. Das Trainingsziel waren Coding- und Reasoning-Aufgaben, dazu Agenten-Workloads.
Damit liegt es auch in derselben Klasse wie Kimi K3, Qwen3.8 Max und DeepSeek V4 Flash.
Es steht außerdem neben der anderen US-Open-Weight-Wette dieses Jahres, Inkling.
Ich baue beruflich KI-Agenten, daher lese ich einen Launch-Beitrag wie das Datenblatt eines Autos vor der Probefahrt: Die Zahlen, auf die es ankommt, landen später in deiner Rechnung und in deinen Latenz-Logs. Bei Beam sind die Zahlen vor allem deshalb interessant, wie sie zustande kamen:
- Pretraining:
23.8TTokens, vollständig in unter vier Wochen auf6,144NVIDIA-GB300-GPUs gelaufen, laut Reflections Launch-Beitrag. - Reinforcement Learning:
10.5KGB300-GPUs über vier Wochen, mit mehr als100 millionRollouts in fast einer Million Trainingsumgebungen. - Architektur:
52Schichten, abwechselnd lokale und globale Attention sowie feinkörnig geroutete Experten mit nahezu gleichmäßiger Auslastung (der meistgenutzte Experte läuft mit nur1.04xder Durchschnittslast). - Eingabe: nur Text. Bild-, Audio- und Dateieingaben werden über die API nicht unterstützt, laut den OpenAI-Kompatibilitätsdocs.
- Lizenz: Apache 2.0, "diesen Monat" versprochen, zusammen mit quantisierten FP8- und NVFP4-Versionen, laut Reflections Launch-Thread.
Der Launch hat viel Aufmerksamkeit bekommen. Der offizielle Beitrag auf X überschritt 8,492 Likes, während der Hacker-News-Thread in den ersten Tagen 549 Punkte und 174 Kommentare erreichte.
Was heute nutzbar ist und was angekündigt wurde
Die meiste Berichterstattung zum Launch überspringt diesen Teil, und das ist schade, denn er entscheidet, ob Beam überhaupt in deine Planung für diesen Monat gehört. Die Ankündigung beschreibt das Modell, das Reflection trainiert hat, und die Entwicklerdokumentation beschreibt das Modell, das du tatsächlich aufrufen kannst. Im Moment sind das nicht dasselbe.
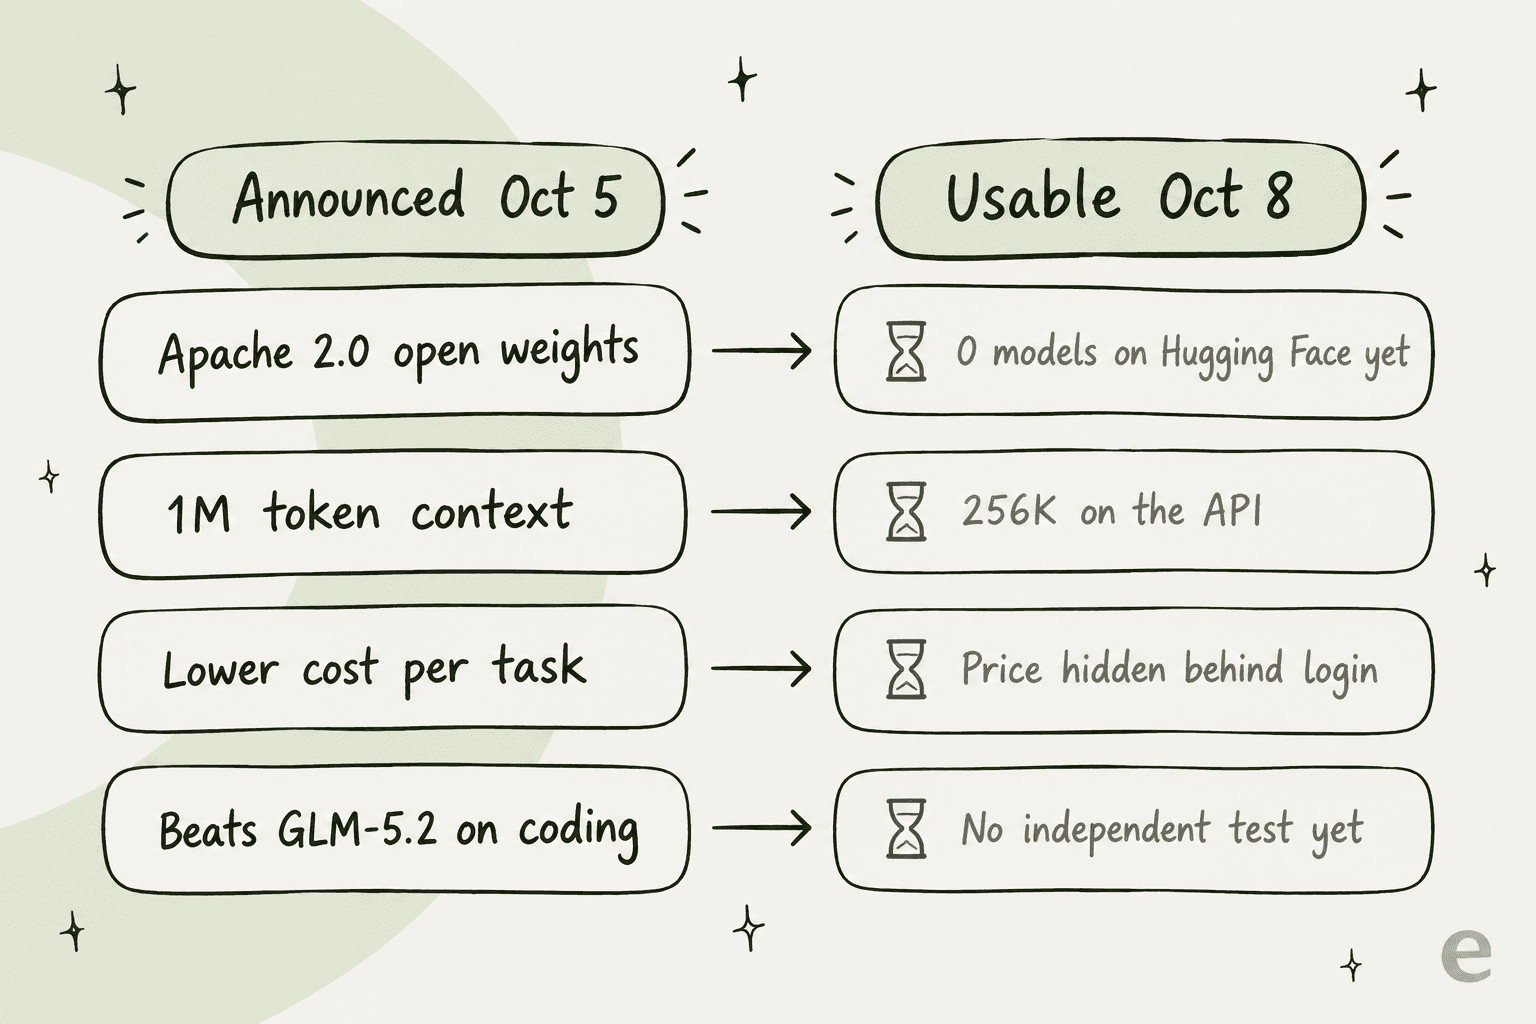
| Was der Launch sagt | Was API und Docs sagen (8. Okt. 2026) | |
|---|---|---|
| Gewichte | Apache 2.0 "diesen Monat" | Reflections Hugging-Face-Organisation hat 0 Modelle |
| Kontextfenster | Effektiver Kontext auf 1M Tokens erweitert | 256K Kontext, 128K maximale Ausgabe, "may change during beta" (Models) |
| Zugang | Früher Zugang für "a select group of users" | Warteliste; Keys erst nach Freischaltung (Authentication) |
| Preis | "Lower cost" durch Effizienz | Kein öffentlicher Tarif; die Preisseite liegt hinter dem Login |
| Rate Limits | Nicht erwähnt | Limits pro Organisation und ein tägliches Token-Kontingent, keine Zahlen veröffentlicht (Rate limits) |
| Reasoning | Steuerbarer Aufwand | Immer aktiv, fünf Stufen von low bis max, Standard medium (Reasoning) |
| Wissensstand | Nicht angegeben | 30. Juni 2026 |
Das Kontextfenster ist die Lücke, die ich am stärksten hervorheben würde. Wenn dein Plan ein Workflow mit langen Dokumenten oder ganzen Repos ist, der auf "1M Tokens" aufbaut, begrenzt dich die Beta-API heute auf ein Viertel davon. Ich würde das kein gebrochenes Versprechen nennen, denn Trainingsfähigkeit und Serving-Limits sind zwei verschiedene Dinge, aber es ändert, was du im Oktober bauen kannst.
Hacker-News-Nutzer adrian_b hat die Frist klar benannt:
"They claim that they will release the model as open weights later this month. That means that they have the 31th of October as the deadline to make true their claims."

Wie Beam funktioniert: 23B arbeiten, 501B gespeichert
Das MoE-Design ist praktisch die ganze Geschichte von Beam, deshalb lohnt sich eine Minute in einfachen Worten. Ein Mixture-of-Experts-Modell teilt seine Gewichte in viele kleine "Experten"-Netze auf, und für jedes Token wählt ein Router eine Handvoll davon aus, und nur diese Experten rechnen tatsächlich. Deshalb kann ein 501B-Modell pro Token ungefähr so viel kosten wie ein dichtes 23B-Modell.
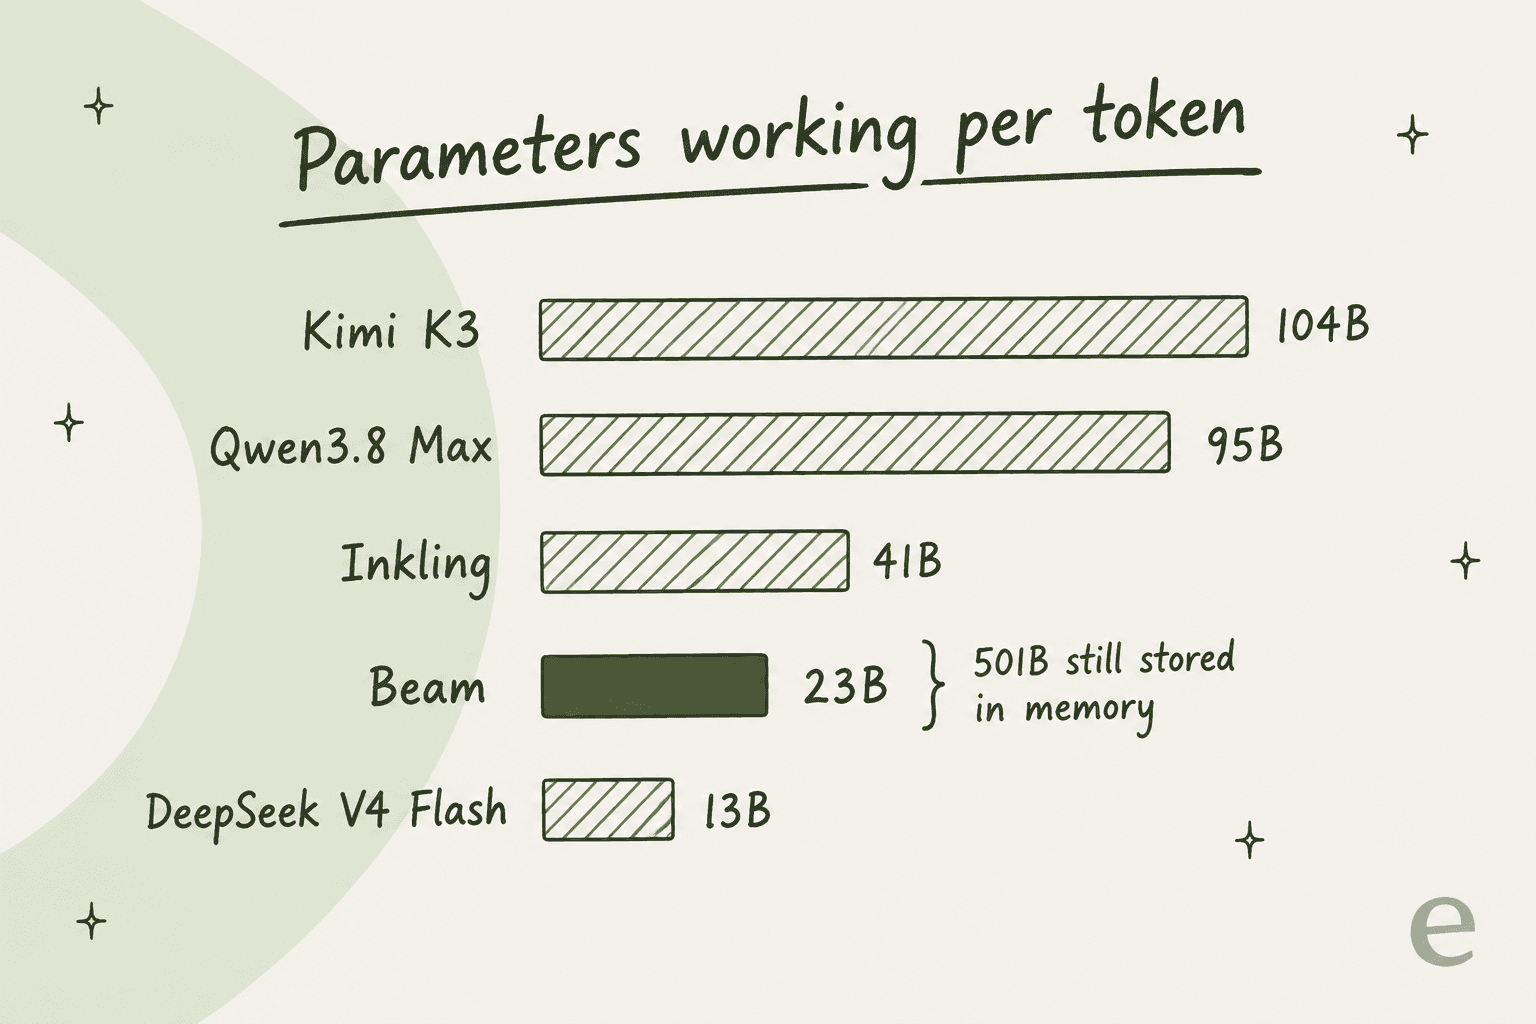
Der Haken, den viele übersehen: Aktive Parameter bestimmen deine Rechenrechnung, Gesamtparameter bestimmen deine Hardware-Rechnung. Alle 501B müssen im Speicher liegen, denn beim nächsten Token kann der Router jeden Experten wählen. Pro Token ist Beam also günstig im Betrieb, aber nicht klein im Hosting. Neben Kimi K3 mit 2.8T gesamt und 104B aktiv ist Beam in beiden Hinsichten leichter zu stemmen, und neben DeepSeek V4 Flash, das nur 13B aktiviert, leistet es mehr Arbeit pro Token.
Die Länge des Reasoning ist der andere Hebel. Reflection hat Beam mit einer Längenstrafe trainiert, die richtige Antworten belohnt und unnötige Tokens entmutigt, und macht diesen Kompromiss dann über den Parameter reasoning_effort verfügbar. In den Effizienzdiagrammen wird der Score gegen die Zahl der Tokens aufgetragen, die jedes Modell verbraucht:
Unter dem Diagramm nennt Reflection selbst eine ehrliche Einschränkung: Die Rechenschätzungen lassen Prompt-Prefill, Attention-Kosten und Serving-Overhead aus und sind "represent an approximate compute comparison rather than measured inference cost." Anders gesagt: Du siehst die Form der Effizienz, keine Rechnung.
Beam-Benchmarks: Wo es tatsächlich landet
Reflection hat eine breite Benchmark-Tabelle veröffentlicht, und das ist ihm anzurechnen, denn sie enthält Modelle, die Beam schlagen. Unten stehen die Zeilen, die ich für Agenten- und Coding-Arbeit ansehen würde, und jede Zahl stammt aus Reflections eigener Tabelle. "NR" steht für not reported (nicht berichtet).
| Benchmark | Beam | GLM-5.2 | Kimi K3 | Qwen3.8 Max | DeepSeek V4.1 Flash | Inkling |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | NR | NR | NR | NR | 77.6 |
| SWE-bench Pro v1 | 65.5 | 62.1 | NR | 67.7 | NR | 54.3 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 88.3 | 86.6 | 90.6 | 63.8 |
| DeepSWE v1.1 | 44.4 | 44.0 | 68.0 | 51.0 | 74.2 | NR |
| MCP Atlas | 78.7 | 77.8 | 82.3 | 84.5 | NR | 76.0 |
| tau3 banking | 38.0 | 37.1 | 37.1 | 55.2 | NR | 25.0 |
| HLE (no tools) | 36.2 | 40.5 | 46.9 | 43.6 | 39.1 | 29.7 |
| GPQA Diamond | 90.5 | 91.2 | 93.5 | 92.6 | 90.9 | 87.2 |
Liest du quer über die Zeilen, ist das Bild ziemlich klar: Beam liefert sich Schlagabtausch mit GLM-5.2 und schlägt Inkling deutlich, liegt aber hinter Kimi K3, Qwen3.8 Max und DeepSeek V4.1 Flash, wo diese gemeldet wurden. Reflections eigene Darstellung passt dazu: Beam sei "competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks," während "frontier open models like Kimi K3 remain ahead on raw capability."
Die Schlagzeilenzahl 80.9 bei SWE-bench Verified braucht eine Fußnote, und ein X-Nutzer namens LuChai hat sie gut formuliert:
"The 80.9 on SWE Bench Verified is the standout, but worth flagging that GLM-5.2 and Qwen 3.8 Max are both NR there"
Bisher gibt es auch keine unabhängige Instanz. Stand 8. Oktober ist Beam nicht auf Artificial Analysis gelistet (die Liste mit 696 Modellen hat keinen Beam-Eintrag) und fehlt auch im tau-bench-Leaderboard von Sierra. Zum Vergleich: Artificial Analysis bewertet Qwen3.8 Max derzeit mit 45.4, Kimi K3 mit 43.6 und GLM-5.2 mit 33.7 auf seinem Intelligence Index. Wenn Beam wirklich nahe an GLM-5.2 liegt, erwarte ich es nach einem Test irgendwo in den 30ern, und Mistral Large 4, eine weitere aktuelle westliche Veröffentlichung, ist dafür ein nützlicher Maßstab.
Außerdem gefiel mir, dass Reflection zeigt, dass sein RL-Lauf ohne Plateau weiter besser wurde, ein ordentliches Zeichen für das nächste Modell der Reihe.
Was wird Reflection AI Beam kosten?
Kurze Antwort: Außerhalb der Warteliste weiß es noch niemand. Sowohl die Reflection-Plattform als auch ihre Seite /pricing zeigen nichts als einen Anmeldebildschirm. Laut den Geschäftsbedingungen sind Gebühren "set forth in the pricing documentation" auf der Plattform, und diese Dokumentation liegt hinter demselben Login.
Die Fehler- und Abrechnungsdocs verraten eine Sache, nämlich die Form der Abrechnung:
- Ein Guthaben oder ein vorausbezahltes Guthaben (
402 insufficient_credits,prepaid_balance_exhausted) - Eine verifizierte Karte, bevor manche Organisationen API-Keys erstellen können (
403 payment_method_required) - Abrechnungsstufen und ein tägliches Token-Kontingent, die dein Tarif festlegt
Da es keinen Beam-Preis zu nennen gibt, hier die Spanne, in der Beam landen müsste, damit seine Effizienzgeschichte zählt. Unten stehen die API-Tarife der Hersteller für die Modelle aus Reflections Vergleichstabelle, pro 1M Tokens:
| Modell | Input | Gecachter Input | Output | Quelle |
|---|---|---|---|---|
| Kimi K3 | $3.00 | $0.30 | $15.00 | Kimi platform |
| Qwen3.8 Max | $2.00 | $0.25 | $6.00 | Qwen Cloud |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.ai pricing |
| DeepSeek V4.1 Flash | $0.30 | $0.006 | $1.20 (peak) | DeepSeek pricing |
| Reflection Beam | Nicht veröffentlicht | Nicht veröffentlicht | Nicht veröffentlicht | Nur Warteliste |
Angenommen, Beam landet bei der Qualität nahe GLM-5.2. Dann zahlt sich das Effizienzargument nur aus, wenn es bei oder unter GLM-5.2s $1.40 / $4.40 liegt, und es muss sich weiter gegen DeepSeek V4.1 Flash behaupten, das in den meisten von Reflections eigenen Zeilen höher punktet, zu einem Bruchteil dieser Tarife. Wie diese Zahlen pro Aufgabe ausfallen, siehst du in meinen ausführlicheren Analysen zu GLM-Preisen und Qwen3.8 Max Preisen.
Self-Hosting verändert die Rechnung, aber nicht die Hardware-Kosten. Eine X-Antwort auf einen Beitrag nach dem Motto "run it on your desk" hielt das deutlich dagegen:
"m5 studio 512GB is like $20 grand... this is realistically a $40k investment, to use 6 month old AI."
Datenbedingungen, die du vor echten Daten lesen solltest
Reflections Bedingungen teilen den Dienst in zwei Arten. Bei kostenpflichtigen Standard Services lizenzierst du deine Inhalte an Reflection "solely to operate and provide the Services." Bei kostenlosen oder Discounted Services ist die Lizenz deutlich breiter und umfasst das Recht, deine Inhalte zu "create derivative works of, and otherwise exploit". In beiden Fällen werden Inhalte 30 Tage lang für Sicherheit und Compliance aufbewahrt, markierte Inhalte bis zu 12 Monate. Wenn du Beam mit Kundengesprächen in einem vergünstigten Early-Access-Tarif testest, würde ich diese Klausel zweimal lesen.
So nutzt du Beam jetzt
Sobald du von der Warteliste runter bist, lässt sich die API leicht einbinden. Reflection betreibt einen OpenAI-kompatiblen Endpunkt unter https://api.reflection.ai/openai/v1, das heißt, Code auf Basis der OpenAI-SDKs funktioniert, nachdem du Base-URL und Key tauschst. Die Modell-ID ist Beam-501B-A23B.
Ein paar Stolperfallen in den Docs solltest du vor dem Bauen kennen:
- Nur Chat Completions und Models werden unterstützt. Keine Responses API, Embeddings, Batch, Files oder Assistants.
stop-Sequenzen werden akzeptiert, aber ignoriert. Die Generierung stoppt dort nicht, verlasse dich also nicht darauf fürs Parsen.- Reasoning lässt sich nicht abschalten. Wähle
lowfür Tempo,maxfür schwierige Aufgaben. Der Reasoning-Text kommt in einem eigenen Feldreasoning_contentzurück. nist fest auf 1 und Logprobs sind aus. Wenn dein Eval-Harness pro Aufruf mehrere Completions sampelt, braucht er eine Schleife.- Tool Calling und strukturierte Ausgaben funktionieren, einschließlich
parallel_tool_callsundjson_schema.
Für Coding-Arbeit liefert Reflection seinen eigenen Terminal-Agenten mit, die Mirror CLI, mit Beam als Standardmodell. Sie ist noch in früher Beta und unterstützt parallele Worktrees und AGENTS.md-Anweisungen sowie MCP-Verbindungen zu Tools wie Linear und Notion. Reflections Quickstart zeigt außerdem, wie du Beam in Pi, OpenCode und Hermes Agent einbindest, was praktisch ist, wenn du schon in einem davon arbeitest.
Wenn du noch ein Harness auswählst, behandeln meine Beiträge zum Pi Coding Agent und zum agentischen Coding-CLI diese Seite.
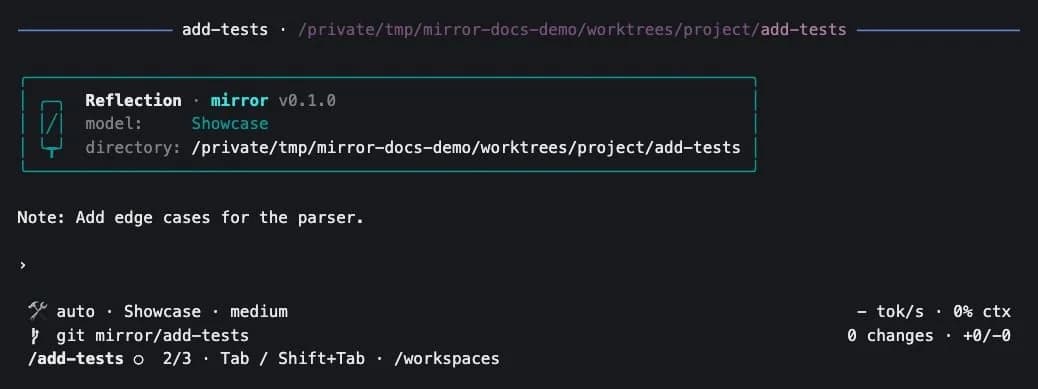
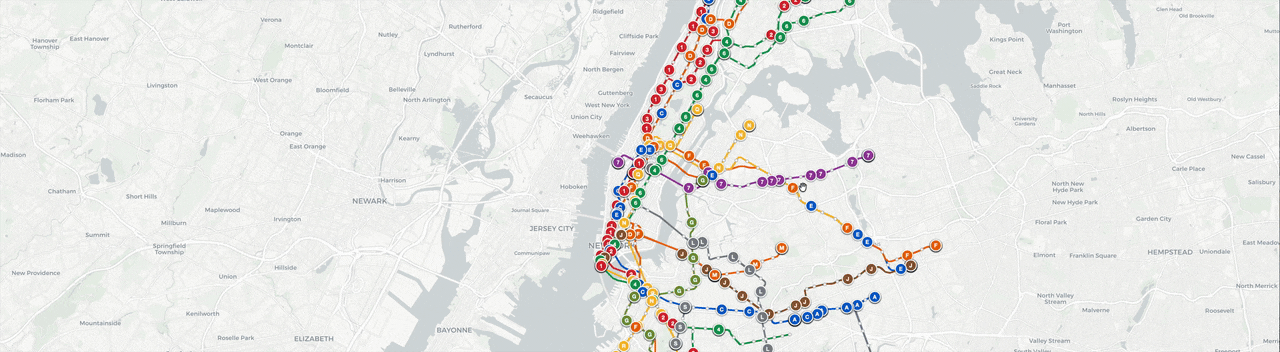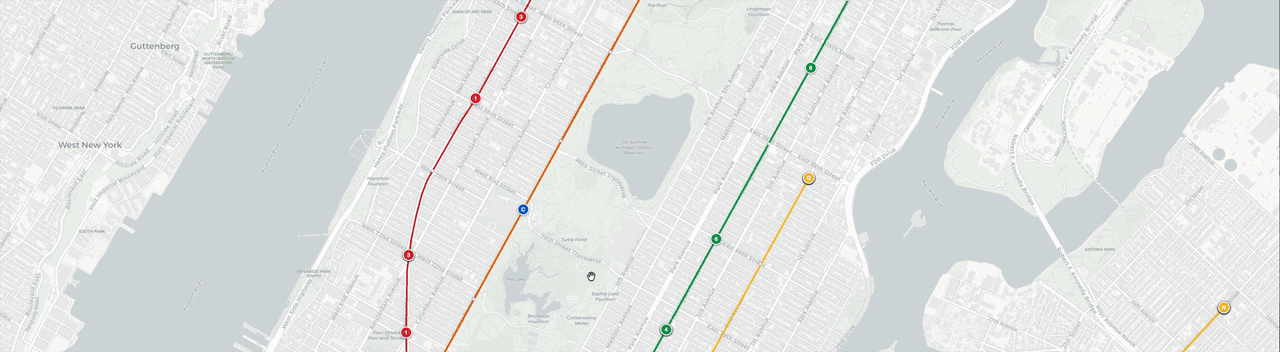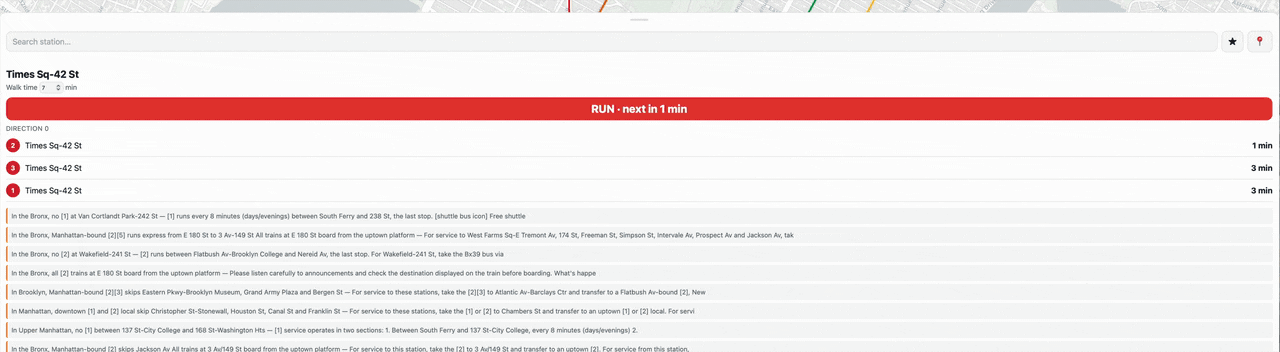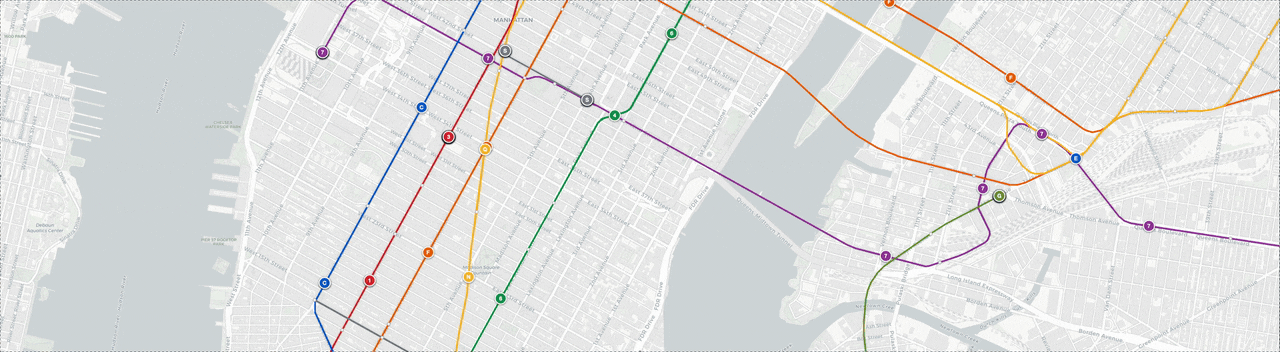
Reflections eigene Demos setzen stark auf diesen Agenten-Aspekt. Meine liebste ist die Live-Karte der New Yorker U-Bahn, bei der Beam die MTA-Docs durchsuchte und die Authentifizierung herausfand, dann die U-Bahn-Geometrie fand und sowohl Frontend als auch Backend baute:
Eine Demo brauchte nach dem Launch eine Korrektur. Reflections Demo "Land or Water" behauptete zuerst, das Rätsel sei erst wenige Tage alt und könne deshalb nicht in den Trainingsdaten sein. Nachdem ein HN-Nutzer darauf hingewiesen hatte, dass es älter war, antwortete ein Reflection-Teammitglied, dass die Bildunterschrift geändert wurde. Es ist eine Kleinigkeit und wurde offen gehandhabt, aber man sollte es beim Lesen der Demos im Kopf behalten.
Was Entwickler über Beam sagen
Ich habe den Hacker-News-Thread und r/LocalLLaMA sowie X und LinkedIn durchgesehen, und dieselben drei Themen kamen immer wieder vor.
"Show me the weights." Solange die Gewichte nicht erscheinen, zählen viele Beam schlicht nicht als offen. Die Moderatoren von r/LocalLLaMA haben den Launch-Thread genau deshalb entfernt:
"Until such time that weights become available, this is off-topic for LocalLLaMA."

"It's a generation behind, but it's American." Die meisten Kommentierenden sehen Beam ungefähr bei GLM-5.2, einem Modell aus dem Juni. Die Begeisterung gilt eher dem Herkunftsort, und für Teams, die keine Modelle chinesischer Herkunft einsetzen dürfen, ist das die ganze Entscheidung:
"I'm in a similar situation to you where we can't use Chinese AI models but we want to host on-prem due to data sovereignty concerns. ... I'm also keeping an eye on Reflection Beam"
"Nice efficiency claim, now let someone check it." Selbst die positiven Stimmen kommen mit dieser Einschränkung. Tyler Folkman, Chief AI Officer bei JobNimbus, fasste zusammen, wie Praktiker es einordnen werden:
"Nobody outside Reflection has verified any of this yet. ... When Beam's weights ship, I'm sizing them for my boxes by active parameters and quantized footprint, not the leaderboard."

Reflection bekam auch Anerkennung für seine Offenheit. Ein HN-Kommentator lobte Reflection dafür, dass es zugibt, dass Kimi K3 vorn liegt, "instead of making false claims." Dem stimme ich zu, denn ein Launch-Beitrag, der die Modelle nennt, die einen schlagen, ist seltener, als er sein sollte.
Ist Beam ein gutes Modell für den Kundensupport?
Diese Frage interessiert mich am meisten, denn meine Tage gehören der KI, die Support-Tickets beantwortet. Die gute Nachricht ist, dass Reflection einen Score für einen Benchmark gemeldet hat, der echter Support-Arbeit tatsächlich ähnelt.
tau3 banking stammt aus Sierras tau-bench. Es setzt das Modell in einen simulierten Bank-Helpdesk mit 698 Richtliniendokumenten und lässt es Kundenanfragen über Tools lösen. Eine Aufgabe gilt nur als bestanden, wenn das Kundenkonto im richtigen Zustand endet, das heißt: Eine höfliche, aber falsche Antwort bringt null Punkte. Jede Aufgabe braucht etwa 18.6 Dokumente und 9.5 Tool-Aufrufe.
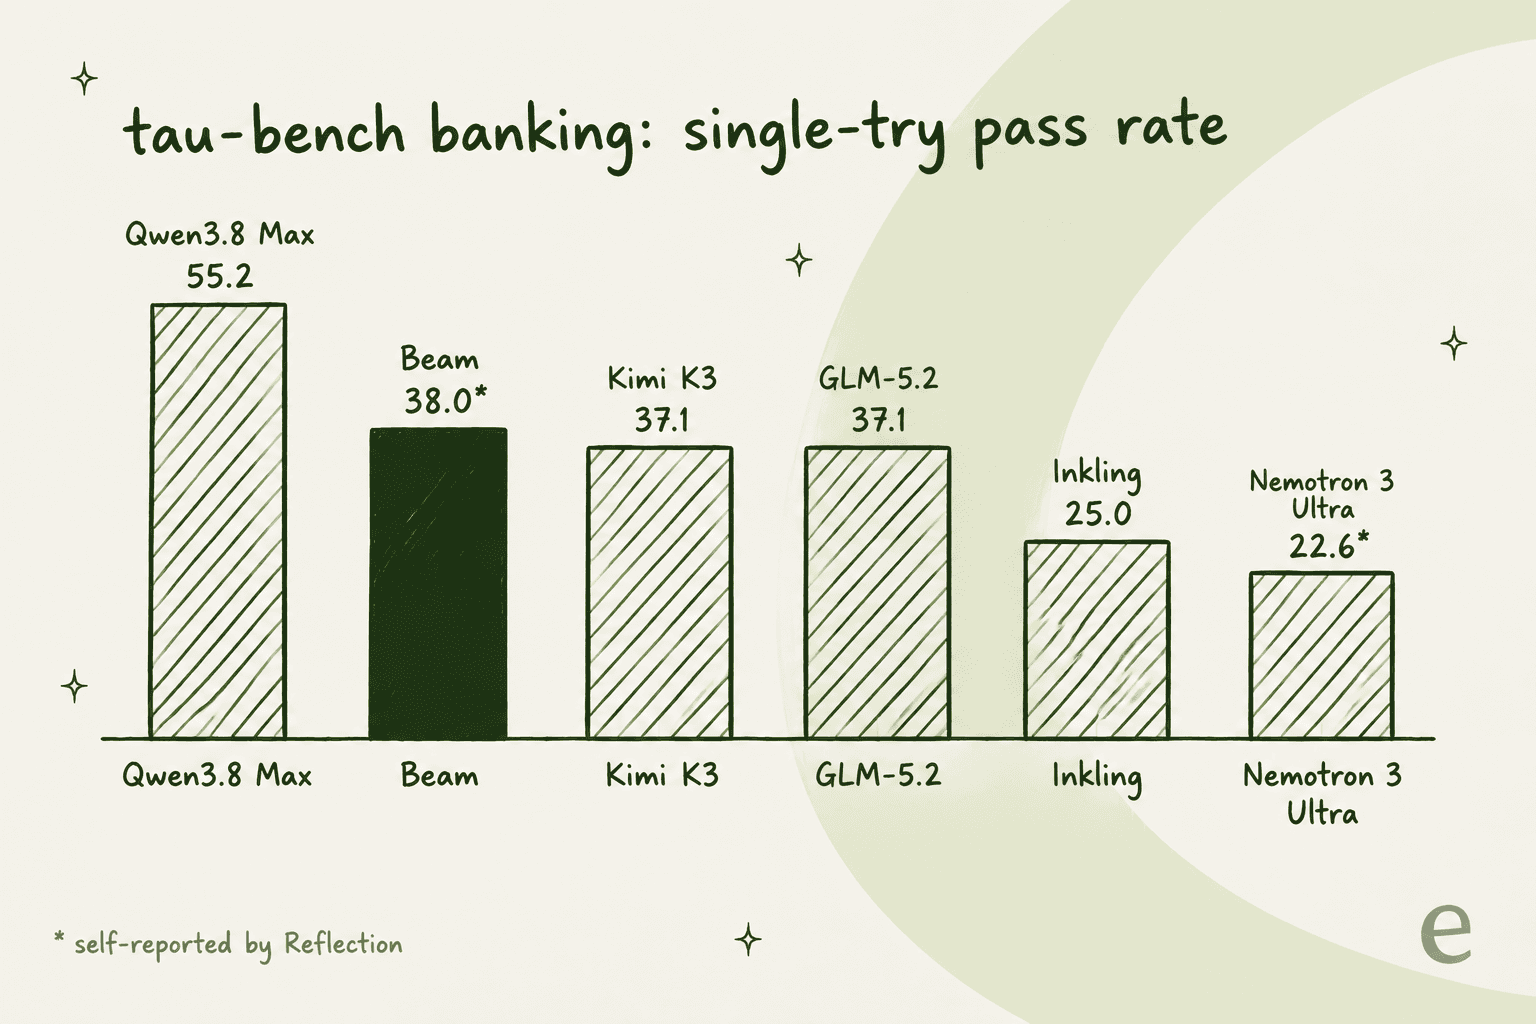
Beams 38.0 liegt ungefähr gleichauf mit Kimi K3 und GLM-5.2 (beide 37.1 auf Sierras Leaderboard) und deutlich hinter Qwen3.8 Max mit 55.2. Reflection sagt nicht, welcher Testaufbau die 38.0 lieferte, deshalb würde ich sie als nah dran statt als exakt behandeln. Das ganze Feld sackt außerdem ab, sobald Konsistenz gefragt ist: Auf Sierras Board fällt Qwen3.8 Max von 55.2 auf 35.1, wenn eine Aufgabe alle vier Versuche bestehen muss.
Diese letzte Zahl ist die eigentliche Lehre für Support-Teams, und ich habe sie in meiner Analyse zum besten KI-Modell für Support-Tickets ausführlich behandelt: Selbst das beste Modell beantwortet ein richtlinienlastiges Ticket nur etwa in einem Drittel der Fälle jedes Mal richtig. Ein neues Modell einzutauschen behebt das nicht.
Es behebt sich durch die Schicht um das Modell, also dadurch, Antworten in deiner echten Wissensdatenbank und in früheren Tickets zu verankern und Antworten mit geringer Sicherheit an einen Menschen zu eskalieren, plus Tests an deinem eigenen Verlauf, bevor etwas live geht. Mein Implementierungsleitfaden führt durch diese Einführungsreihenfolge.
Ich habe dieses Scheitern in echten Warteschlangen gesehen. Ein Fahrzeug-Telematik-Team auf Zendesk hatte einen Bot, der Kunden selbstsicher sagte "yes, we support your car model", für Marken, die nicht in ihrer Datenbank standen, nur weil ein Hilfeartikel "we support all models" sagte. Kein Benchmark-Score hätte das gefunden, aber eine Simulation mit ihren eigenen früheren Tickets hätte es.
Für den Support im Speziellen ist Beam also ein vernünftiger Kandidat als Motor, sobald es einen Preis hat und die Gewichte draußen sind, erst recht, wenn deine Firma Modelle chinesischer Herkunft ausschließt. Allein ist es aber kein Support-Agent. Dafür brauchst du einen KI-Helpdesk-Agenten, der deine Warteschlange kennt, und meine Übersicht der KI-Helpdesks vergleicht die, die das tun.
Wer ist Reflection AI?
Reflection wurde 2024 von Misha Laskin (CEO) und Ioannis Antonoglou mitgegründet, beide ehemalige Google-DeepMind-Forscher. In seinem Launch-Beitrag führt Laskin seinen eigenen Wechsel von der Physik zur KI auf AlphaGo im Jahr 2016 zurück.
Hinter dem Labor steht viel Geld. Reflections eigener Beitrag kündigte 2025 eine Finanzierung von $2 billion an, von Investoren wie NVIDIA, Sequoia, Lightspeed, DST, CRV und Eric Schmidt, und sein Newsroom nennt eine Pre-Money-Bewertung von $25 billion für die Runde im April 2026. Im Launch-Beitrag begründet Laskin außerdem, warum sie sich für Open entschieden haben:
"Open also means safer. The best defence is a distributed one."
Antonoglou ergänzte auf X, das Team trainiere "already training the next, larger model." Beam ist also ausdrücklich das erste einer Reihe.
Eine Klarstellung kam ebenfalls auf HN auf: Dieses Reflection hat keinen Bezug zum Modell "Reflection 70B" von 2024. Ein Kommentator korrigierte die Verwechslung im Launch-Thread, und die Person, die sie aufgebracht hatte, nahm sie zurück.
Also, solltest du auf Beam warten?
So würde ich es je nach Leser einordnen:
| Wenn du... | Meine Einschätzung |
|---|---|
| Ein Team bist, das ein in den USA gebautes offenes Modell braucht (Behörden, regulierte Branchen, Richtlinie "keine Modelle chinesischer Herkunft") | Tritt jetzt der Warteliste bei und plane eine Evaluierung für Anfang November |
| Heute Coding-Agenten mit kleinem Budget baust | Nutze jetzt DeepSeek V4 Flash oder GLM, teste Beam erneut, sobald es auf Artificial Analysis steht |
| Das stärkste offene Modell suchst | Kimi K3 oder Qwen3.8 Max, laut Reflections eigener Tabelle |
| Self-Hosting planst | Warte auf die FP8- und NVFP4-Gewichte, dimensioniere dann nach dem Speicher für 501B, nicht nach der Rechenleistung für 23B |
| Ein Modell für eine Support-Warteschlange auswählst | Wähle zuerst den Agenten, dann das Modell; siehe unten |
eesel für Support-Teams, die das Modellrennen beobachten
Wenn du hier gelandet bist, weil du ein Modell für Kundenantworten auswählst, ist die Abkürzung, dass du deine Warteschlange nicht auf einen einzelnen Launch setzen musst. eesels KI-Helpdesk-Teammitglied verbindet sich mit Zendesk, Freshdesk oder Gorgias, lernt aus deinen früheren Tickets und deinem Help Center und führt dann eine Simulation mit deinem echten Ticketverlauf durch, bevor es jemandem antwortet. Wenn ein besseres oder günstigeres Modell erscheint, wird das Teammitglied besser, und du musst nichts neu aufbauen.

Es funktioniert auch für das Terminal-Publikum, das einen Beam-Beitrag liest. Mit dem eesel CLI kannst du dasselbe Teammitglied aus einer Shell betreiben, etwa um einen Helpdesk zu verbinden, seine ständigen Anweisungen zu bearbeiten, ausstehende Aktionen zu genehmigen oder abzulehnen und sein Aktivitätsprotokoll zu lesen. Jeder Befehl gibt JSON zurück, und ein --dry-run-Flag zeigt den genauen Aufruf, bevor er gesendet wird. Außerdem ist jeder Workspace ein MCP-Server, sodass ein Coding-Agent wie Claude Code ihn direkt steuern kann.
Ergebnisse kommen meist schnell, wenn der Agent in deinen eigenen Daten verankert ist. So hat Gridwise es nach der Testphase formuliert:
"In the first month, eesel is resolving 73% of our tier 1 requests."

Teste eesel kostenlos mit 100 Credits, ohne Karte, oder sieh dir die bezahlten Tarife auf der Preisseite an.