

Ripple-65B kostet $0.20 pro Million Input-Tokens und $0.60 pro Million Output, gecachter Input liegt bei $0.05, und dahinter steht nur ein Anbieter: GMI Cloud, direkt oder über OpenRouter. Für eine Coding-Agent-Sitzung mit 1M Input-Tokens (80 % gecacht) und 50K Output sind das etwa $0.11, ein Fünftel günstiger als Reflection Beam und ungefähr gleichauf mit GPT-5.6 Luna. Self-Hosting lohnt sich selten: Zwei gemietete B200 kosten etwa $7,300 im Monat und schlagen die API erst bei rund 91 Aufgaben pro Stunde, ohne Pause. Wenn Sie Ripple für eine Support-Warteschlange bepreisen wollten: Das Modell ist der günstige Teil; das KI-Helpdesk-Teammitglied von eesel deckt den Rest ab, und über die CLI kann ein Coding-Agent Ihre Hilfedokumente laden und Antworten vor dem Go-live testen.
Wie viel kostet Ripple-65B?
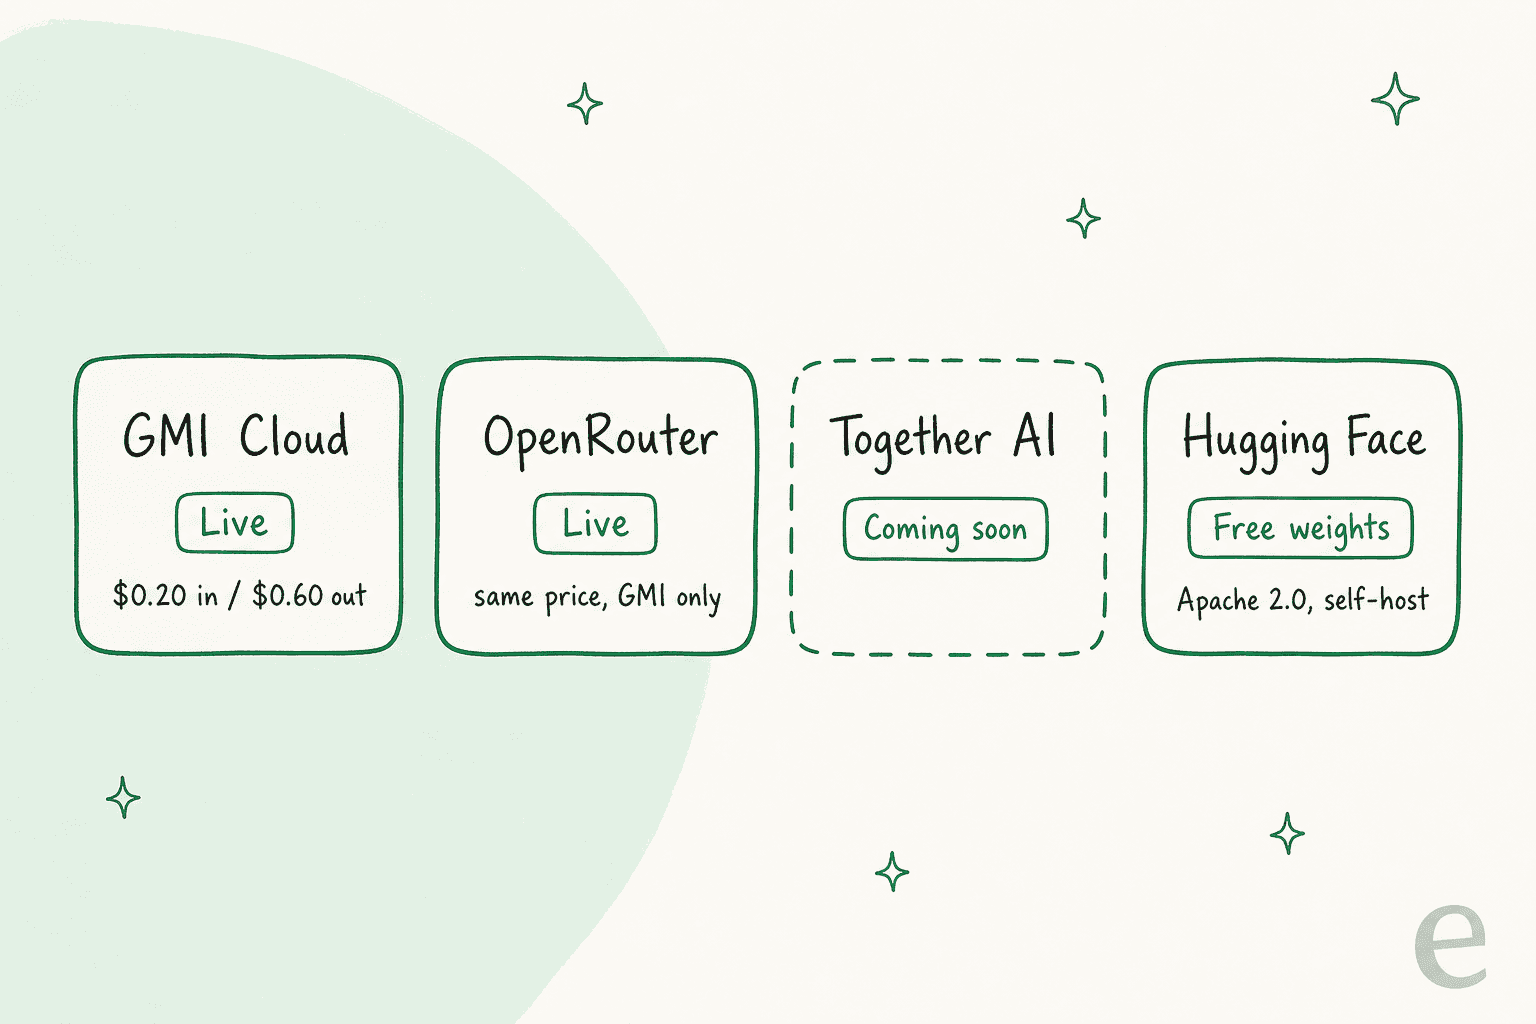
Ricursive Intelligence hat Ripple-65B Preview am 4. November 2026 als dichtes 65B-Coding-Modell unter Apache 2.0 veröffentlicht (das Ripple-65B-Überblick erklärt, was es ist und wie es abschneidet). Die Gewichte kosten nichts. Der gehostete Zugang kostet überall gleich viel, weil es überall dieselben GPUs eines Unternehmens sind.
| Weg | Input / 1M | Output / 1M | Gecachter Input / 1M | Kontext | Status (5. Nov. 2026) |
|---|---|---|---|---|---|
| GMI Cloud (direkt) | $0.20 | $0.60 | $0.05 | 1,000,000 | Live, BF16, kein kostenloser Tarif gelistet |
| OpenRouter | $0.20 | $0.60 | $0.05 | 1,048,576 in der API (Seite zeigt 16K) | Live, GMI Cloud ist der einzige Anbieter |
| Together AI | Nicht gelistet | Nicht gelistet | Nicht gelistet | 1M im Spezifikationsfeld | „Coming soon“ |
| Hugging Face Gewichte | Kostenlos | Kostenlos | k. A. | Bis zu 1M | Apache 2.0, kein gehosteter Inferenz-Anbieter |
Ein paar Details sind wichtiger als der Listenpreis:
- Abgerechnet wird pro Token, in beide Richtungen. Output kostet das Dreifache von Input. Ein Coding-Agent, der viel liest und wenig schreibt, hängt an den $0.20; einer, der lange Diffs schreibt, zahlt mehr von den $0.60.
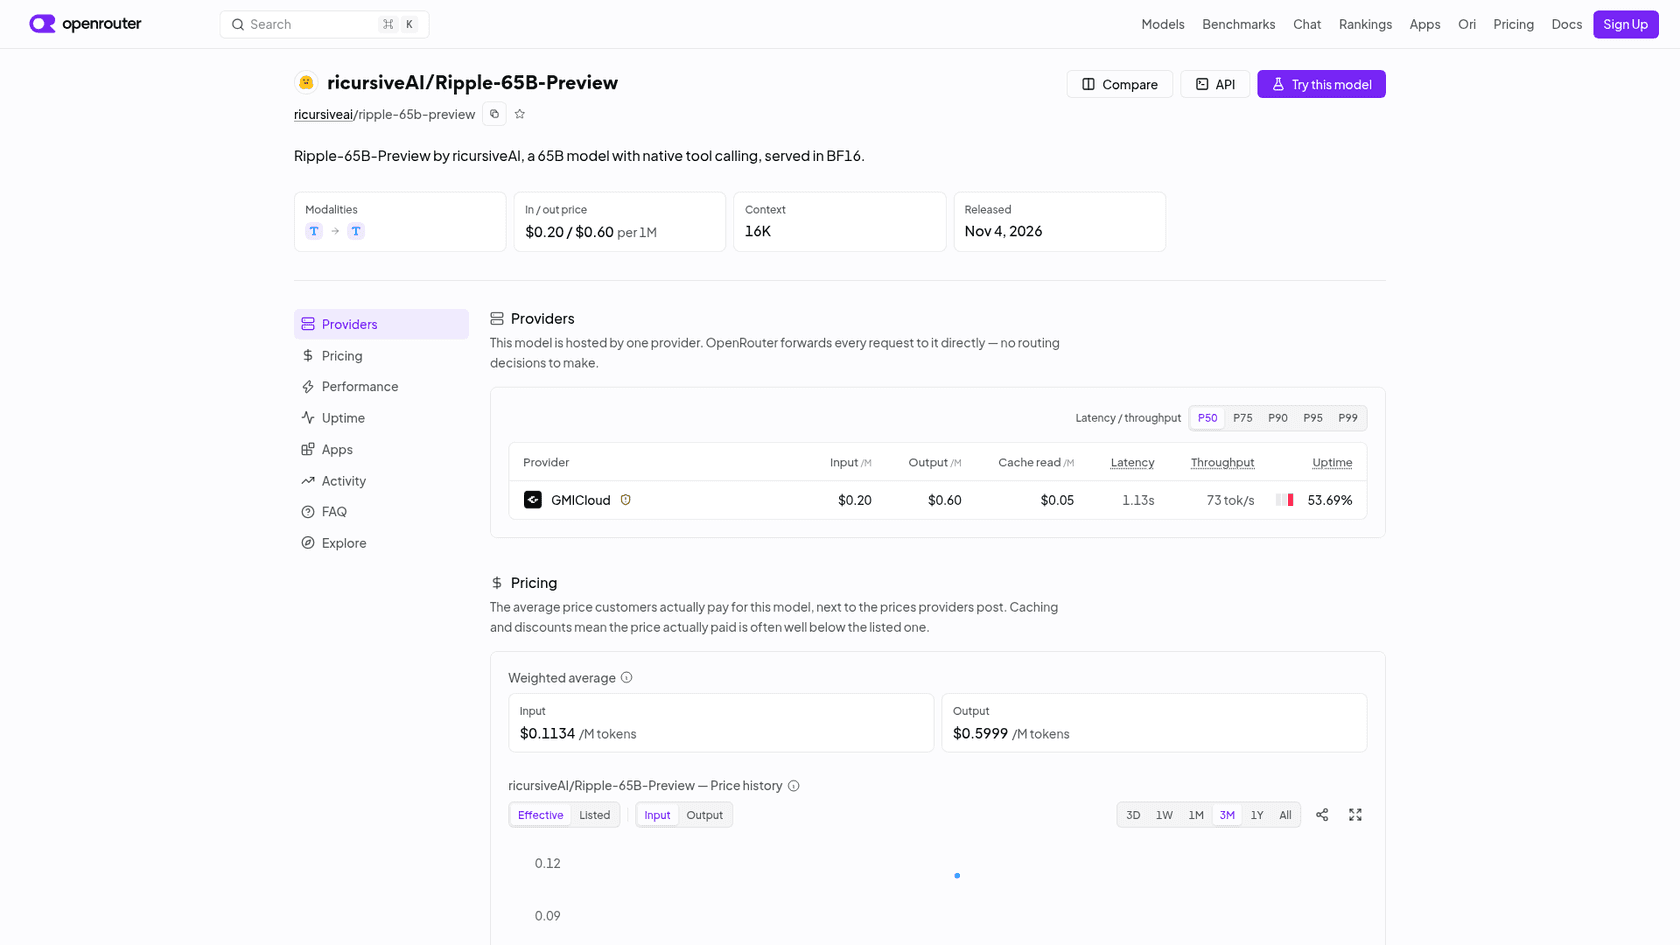
- Caching ist ein großer Hebel. GMI berechnet $0.05 pro gecachtem Input-Token und listet keine Cache-Schreibgebühr. Das Preisfeld von OpenRouter zeigte einen gewichteten Durchschnitt von etwa $0.11 pro Million tatsächlich bezahlter Input-Tokens, weil wiederholte Prompts den Cache treffen.
- Es gibt keinen kostenlosen Tarif. OpenRouter hat keine
:free-Variante, und die Modellseite von GMI zeigt keine.
Das Kontextfenster änderte sich, während ich dies schrieb
Am Morgen des 5. November begrenzte die Endpoints-API von OpenRouter Ripple auf 16,384 Tokens Kontext und 14,745 Tokens Output. Am Nachmittag meldete dieselbe API 1,048,576 Tokens Kontext und 131,072 Output, während die Modellseite oben weiter „16K“ anzeigte. Die Seite von GMI nannte die ganze Zeit 1,000,000. Meine Einschätzung: Das größere Fenster wird gerade ausgerollt, und die Seite hinkt hinterher. Bevor Sie einen Agenten budgetieren, der ein langes Kontextfenster braucht, senden Sie einen langen Prompt und prüfen Sie, dass nichts abgeschnitten wird.
Wo kann man Ripple-65B heute kaufen?
Aktuell an genau einem Ort mit zwei Eingängen. OpenRouter leitet jede Anfrage zum gleichen Preis an GMI Cloud weiter, die Wahl ist also eine Frage der Bequemlichkeit: OpenRouter, wenn Sie schon mehrere Modelle über einen Schlüssel routen, GMI direkt, wenn Sie den OpenAI-kompatiblen Endpunkt ohne Zwischenschicht wollen.
Ein Anbieter hat Kosten, die nicht auf der Preisliste stehen: Kapazität. Die Verfügbarkeit des GMI-Endpunkts lag bei OpenRouter am 5. November, als ich nachsah, über den Vortag zwischen 51 % und 60 %. Das sind normale Anlaufprobleme für ein Modell, das erst am Vortag hinzugefügt wurde, aber für alles mit Kundenkontakt ist es hart. Ricursive hat gesagt, dass Ripple zu Together AI und Fireworks kommt; die Seite von Together steht noch auf „coming soon“ mit einem „Notify me“-Button und ohne Preis.
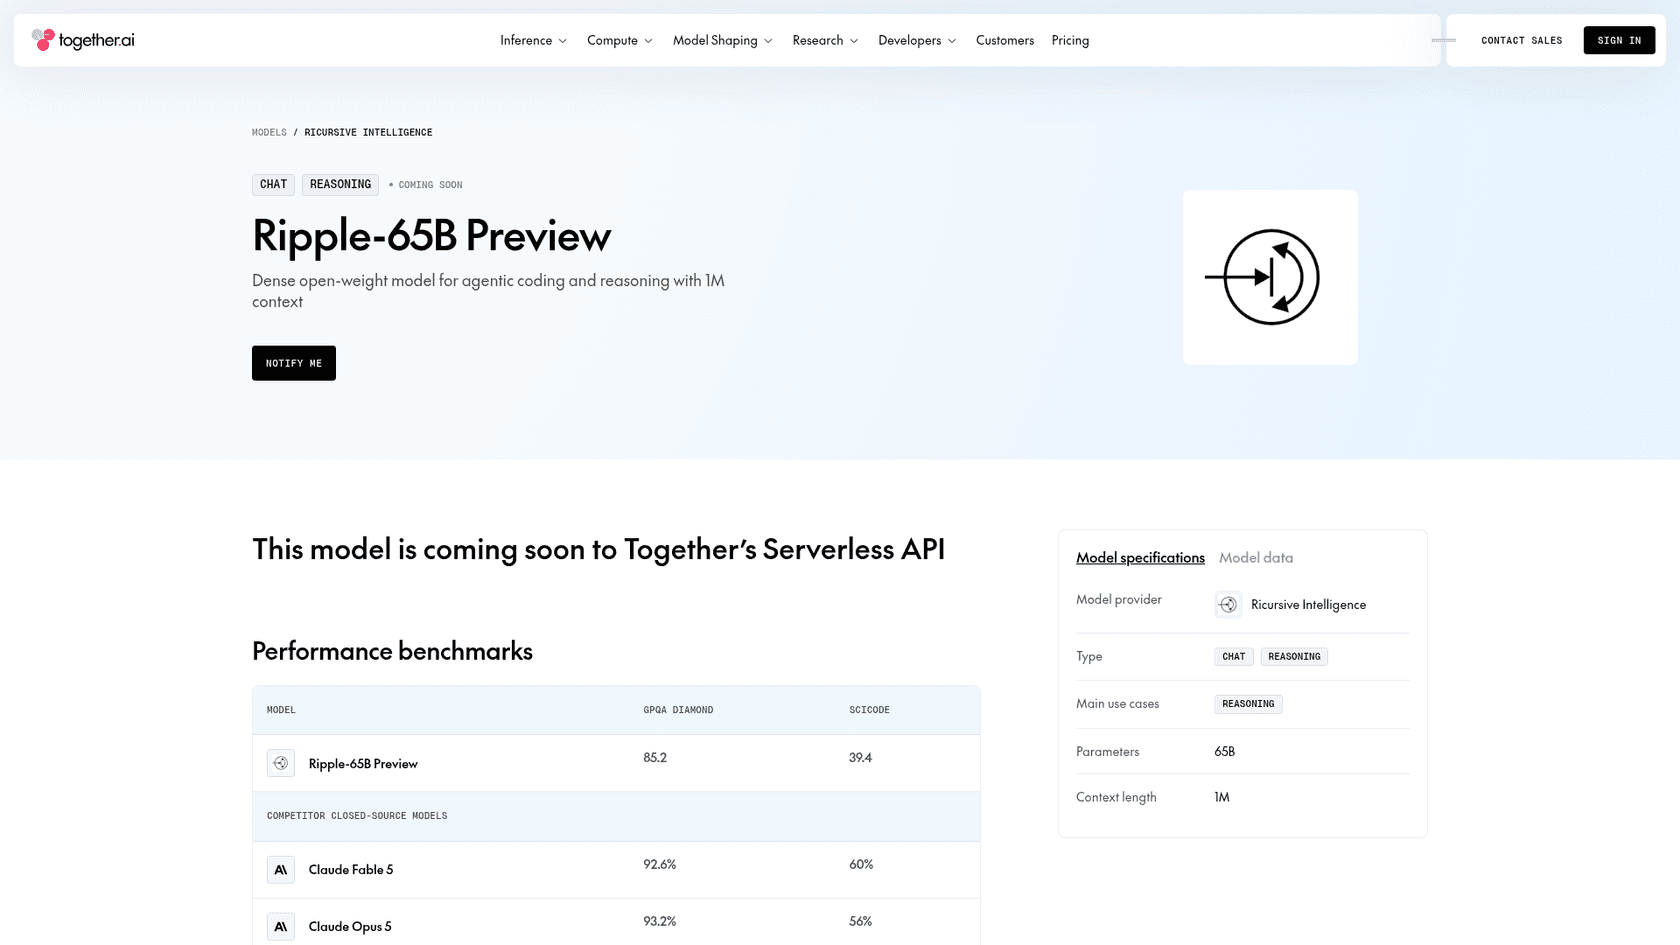
Wenn Sie heute einen zweiten Anbieter für den Failover brauchen, haben Sie keinen. Das ist das stärkste Argument, ein paar Wochen zu warten, bevor Ripple Produktionslast trägt, und es hat nichts mit dem Preis zu tun.
Was kostet eine Coding-Agent-Aufgabe mit Ripple-65B?
Preise pro Million sagen wenig, bis man einen echten Job durchrechnet. Hier also ein Käufer: eine Coding-KI-Agent-Sitzung, die über alle Runden 1M Input-Tokens sendet, davon 80 % Cache-Treffer, und 50K Output-Tokens schreibt. Das ist ein realistisches Muster für einen Agenten, der ein Repo liest, Tests ausführt und ein paar Dateien patcht.
Bei Ripple ist die Rechnung kurz:
- 200K frischer Input × $0.20 pro Million = $0.04
- 800K gecachter Input × $0.05 pro Million = $0.04
- 50K Output × $0.60 pro Million = $0.03
- Summe: etwa $0.11 pro Aufgabe, oder $110 pro 1,000 Aufgaben
Ohne Caching kostet dieselbe Aufgabe $0.23, mehr als das Doppelte. Hier dieselbe Aufgabe bei ähnlichen Modellen, nach den Listenpreisen von OpenRouter vom 5. November 2026:
| Modell | Input / 1M | Output / 1M | Gecacht / 1M | Kosten pro Aufgabe | Pro 1,000 Aufgaben |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | $0.048 | $48 |
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | $0.110 | $110 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.116 | $116 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | $0.140 | $140 |
| Qwen3.8 27B | $0.15 | $1.875 | $0.0375 | $0.154 | $154 |
| Inkling Small | $0.45 | $1.20 | $0.10 | $0.230 | $230 |
| Nemotron 3 Ultra 550B | $0.60 | $2.40 | $0.12 | $0.336 | $336 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | $0.583 | $583 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $0.980 | $980 |
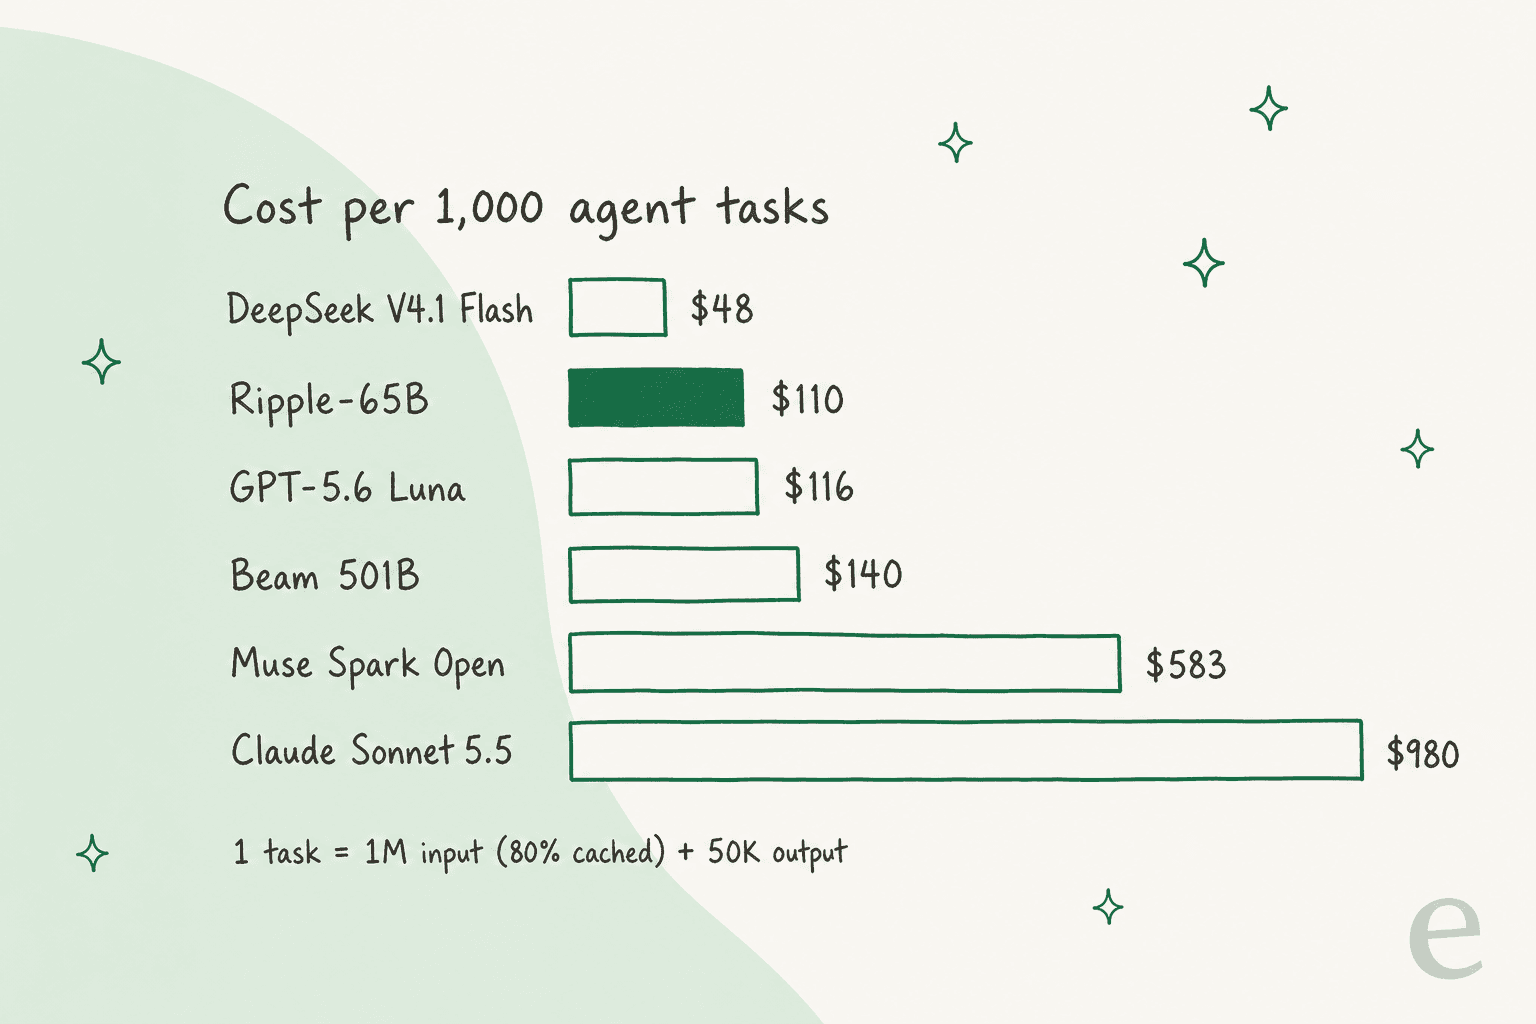
Zwei Dinge fallen auf. Erstens ist Ripple das günstigste in den USA entwickelte Open-Weight-Modell der Tabelle, etwa 21 % unter Beam, dem Modell, mit dem es bei Terminal-Bench 2.1 gleichauf liegt (80.5 gegenüber 80.1 laut Modellkarte). Wenn Sie nur US-Modelle nutzen dürfen, ist das der entscheidende Vergleich, und Ripple gewinnt ihn beim Preis.
Zweitens ist es nicht das günstigste Modell überhaupt. DeepSeek V4.1 Flash erledigt dieselbe Aufgabe für weniger als die Hälfte, und GPT-5.6 Luna liegt innerhalb eines Cents. „Günstig“ ist also nur dann ein Grund für Ripple, wenn Sie die Liste schon auf US-Open-Weights eingegrenzt haben. Für das breitere Feld rechnen meine Analysen zu den Kimi K3.1 Pro-Preisen und den DeepSeek V4.1 Flash-Preisen dieselbe Art von Rechnung.
Wollen Sie Ihre eigenen Zahlen einsetzen? Dieser Rechner bepreist einen Monat Agent-Arbeit für jedes Modell neu. Stellen Sie Aufgabenvolumen und Token-Mix ein, und er zeigt, wo Ripple landet und ob ein gemieteter 2x-B200-Server die API schlagen würde.
Wann schlägt Self-Hosting von Ripple-65B die API?
Später, als man denkt. Apache 2.0 macht Self-Hosting legal und lizenzkostenfrei, und ein dichtes 65B-Modell ist klein genug, um zu locken. Aber die API ist schon knapp kalkuliert, Ihre Hardware muss also gut ausgelastet sein, um mitzuhalten.
Ricursive veröffentlicht zwei Wege, es zu betreiben, beide auf der Hugging-Face-Modellkarte und im NVFP4-Repo:
- Rechenzentrum: BF16 auf zwei NVIDIA-B200-GPUs mit SGLang und einem DFlash2-Draft-Modell, das laut Karte "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels." erreicht.
- Schreibtisch: ein experimenteller NVFP4-Build auf einem NVIDIA DGX Spark, begrenzt auf eine Anfrage gleichzeitig und 128K Kontext.
Was jede Option im Vergleich zur API kostet:
| Option | Kosten | Was man bekommt | Break-even gegenüber der API |
|---|---|---|---|
| Ripple-API | $0.20 / $0.60 pro 1M | Bezahlung pro Token, ein Anbieter | k. A. |
| 2x B200, gemietet | GMI Cloud "from $5.00/GPU-hour" = $10/Stunde, etwa $7,300 für einen Monat mit 730 Stunden | 1M Kontext, Batch-Betrieb | ~66,000 Aufgaben im Monat, oder ~91 pro Stunde rund um die Uhr |
| DGX Spark, gekauft | $6,950 im NVIDIA-Marktplatz (128 GB) | Eine Anfrage gleichzeitig, 128K Kontext | ~63,000 Aufgaben über die Lebensdauer des Geräts |
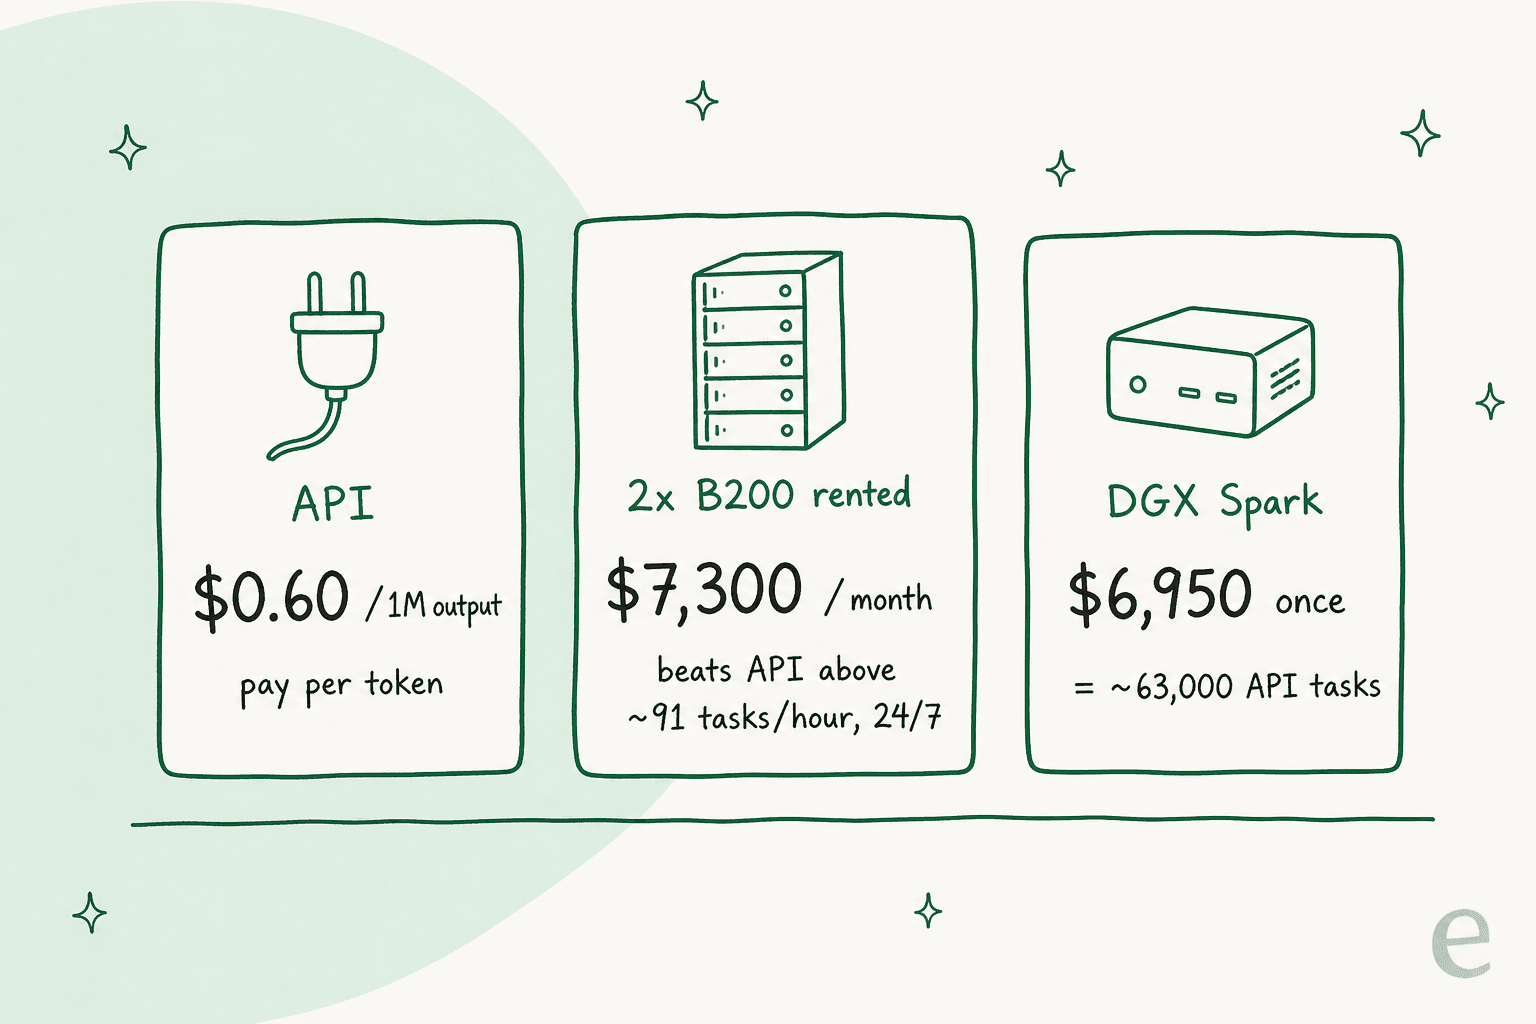
Die B200-Rechnung hängt davon ab, wie man diese 250 tok/s liest. Gelten sie pro Anfrage, ergeben acht gleichzeitige Anfragen etwa 2,000 Output-Tokens pro Sekunde, also bestenfalls 144 meiner Beispielaufgaben pro Stunde. Der Server muss dann zu etwa 63 % ausgelastet sein, jede Stunde des Monats, nur um mit der API gleichzuziehen (und das noch vor Prefill-Zeit, leeren Nächten und den Stunden eines Ingenieurs). Gelten sie als Summe über alle acht, schafft der Server höchstens etwa 18 Aufgaben pro Stunde und holt die API nie ein. Ricursive sagt nicht, was gilt. B200 sind auf der Seite von GMI außerdem als „limited availability“ markiert, und $5.00 ist ein „from“-Preis.
Der DGX Spark ist ein anderer Kauf. Für $6,950 entspricht er etwa 63,000 Agent-Aufgaben über die API oder 11.6 Milliarden Output-Tokens, und er bedient jeweils eine Anfrage. Niemand kauft ihn, um bei Ripple zu sparen. Man kauft ihn, damit Code und Daten das Haus nie verlassen, und ein paar HN-Kommentatoren haben genau das argumentiert:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States. It doesn't mean these models are competitive when looked at from a global view but it is also not an irrelevant differentiation."

Andere waren bei der lokalen Geschwindigkeit skeptischer. Ein dichtes 65B-Modell liest für jedes Token alle Gewichte, anders als ein Mixture-of-Experts-Modell, das nur einen Teil aktiviert:
"But as is, it's probably hard to become popular amongst hobbyists and local model enthusiasts like Qwen's 27B class models or MOE models because it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware, and seems like the goal/mission of the company behind this model is to automate chip design."
Mein Fazit: Betreiben Sie Ripple selbst, wenn Vorschriften Sie dazu zwingen oder wenn Sie zwei B200 die meiste Zeit des Tages auslasten können. Für alle anderen ist die $0.60-API der günstigere Weg, und das Ripple-65B-Review liefert die Benchmark-Details, um zu entscheiden, ob es sich überhaupt lohnt.
Warum ist Ripple-65B so günstig bepreist?
Teils wegen der Größe. Mit 65B dichten Parametern in BF16 passt es auf zwei B200, während Konkurrenten wie Inkling (975B) und Muse Spark Open (816B) pro Kopie deutlich mehr Speicher brauchen. Teils wegen der Positionierung: Ricursive ist ein neues Labor, das in ein Feld günstigerer chinesischer Modelle startet, und sein Argument ist Effizienz. Es sagte, das ganze Modell sei aus einem kleinen Budget entstanden:
"Ripple was built on a $32 million compute budget, one-tenth the cost of the previous open-weight SOTA on agentic coding. We're grateful to the open-source community, whose tools and research helped make this possible."
Das sind Trainingskosten, keine Betriebskosten, und sie bestimmen nicht den API-Preis; den setzt GMI Cloud. Aber es erklärt, warum der Start auf Preis-Leistung statt auf reine Benchmark-Werte setzte. Behandeln Sie den heutigen Preis als Einführungspreis eines einzelnen Anbieters. Sobald Together AI und Fireworks es listen, kann sich der Preis in beide Richtungen bewegen, und ein zweiter Anbieter wird für die Zuverlässigkeit wichtiger sein als für die Kosten.
Ist Ripple-65B günstig genug für Ihre Support-Warteschlange?
Die Tokens sind günstig genug. Eine Support-Antwort ist ein viel kleinerer Job als eine Coding-Sitzung, oft ein paar tausend Input-Tokens und ein paar hundert Output-Tokens. 10,000 Antworten im Monat mit 3,000 Tokens Input und 300 Output kosten bei Ripple unter $8. Der Preis ist nicht das Hindernis.
Die Eignung ist es. Ripple ist ein Coding-Modell mit leichtem Post-Training, und seine Werte in den Support-nahen Zeilen der eigenen Tabelle von Ricursive sind mittelmäßig: 31.27 bei τ³-bench Banking (Beam: 36.1) und 71.67 bei MCP Atlas Tool Use (Muse Spark Open: 89.2), laut Modellkarte. Und das Modell ist die günstigen 5 % eines Support-Agenten. Der Rest ist die Synchronisierung der Wissensdatenbank, Eskalationsregeln, Guardrails gegen erfundene Antworten und eine Möglichkeit, Antworten zu prüfen, bevor Kunden sie sehen. Das sind die echten Kosten jeder Build-vs-Buy-Entscheidung, und sie werden in Ingenieurmonaten bezahlt, nicht in Tokens.
Das ist der Teil, den eesel übernimmt. Das KI-Helpdesk-Teammitglied von eesel arbeitet in Ihrem bestehenden Helpdesk, lernt aus Ihrem Help Center und früheren Tickets und wird an historischen Tickets getestet, bevor es jemandem antwortet, denn ich habe selbstsichere Bots in Live-Warteschlangen falsche Antworten geben sehen. Timengo, das in Dänemark sichere E-Mail- und Digital-Post-Software verkauft, lässt eesel technische Antworten auf Dänisch aus etwa 5,300 früheren Tickets entwerfen und bereitet so rund 300 Freshdesk-Tickets im Monat vor. SE Ranking betreibt einen eesel-Agenten pro Produkt in Zendesk, und sie bearbeiteten 4,650 Konversationen in einem Monat.
Wenn Sie zu Ripple gekommen sind, weil Sie im Terminal leben, wird Ihnen die eesel-CLI vertraut vorkommen: Ein Coding-Agent kann freigegebenes Wissen wie exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Teammitglieds anpassen und Testfragen ausführen, bevor etwas live geht. Die Anbindung des Helpdesks selbst muss weiterhin ein Admin freigeben. Eine Anleitung gibt es unter KI-Agenten vom Terminal aus verwalten.
Lohnt sich Ripple-65B?
Hier lande ich, nachdem ich es auf jede mir mögliche Weise durchgerechnet habe:
- Zahlen Sie für die API, wenn Sie ein in den USA entwickeltes Open-Weight-Coding-Modell testen. Mit etwa $0.11 pro Agent-Aufgabe bei Caching ist es das günstigste seiner Klasse und 21 % unter Beam.
- Warten Sie ein paar Wochen, wenn es Produktionslast tragen soll. Ein Anbieter, eine tägliche Verfügbarkeit von 51-60 % und ein Kontextfenster, das sich mitten am Tag änderte, sind Probleme der Startwoche, und ein zweiter Anbieter wird die meisten davon lösen.
- Betreiben Sie es selbst nur, wenn Vorschriften die Daten im Haus halten oder Sie zwei B200 etwa zwei Drittel jeder Stunde auslasten können.
- Schauen Sie woanders, wenn der Preis allein entscheidet. DeepSeek V4.1 Flash kostet weniger als die Hälfte, und die Übersicht der besten KI-Coding-Assistenten deckt das breitere Feld ab.
eesel testen
Wenn Sie ein offenes Modell bepreist haben, damit es Ihrem Team Tickets abnimmt: Die Token-Rechnung war nie der teure Teil. Das KI-Helpdesk-Teammitglied von eesel verbindet sich in Minuten mit Zendesk, Freshdesk, Gorgias und mehr, lernt aus Ihren früheren Tickets und zeigt Ihnen, wie es sie beantwortet hätte, bevor es live geht. Die Tarife beginnen bei $299 im Monat, mit einem kostenlosen Tarif zum Testen.
