

LongCat 2.5 ist einen Test wert, wenn Sie einen günstigen Coding-Agenten suchen, der auch Screenshots und Videos lesen kann. Es ist Meituans Modell mit 1.6T Parametern und nativer Bild- und Videoeingabe, zu einem Preis von 0,30 $ für Eingabe und 1,20 $ für Ausgabe pro Million Tokens, genauso viel wie DeepSeek V4.1 Flash zu Spitzenzeiten. Der Haken steckt in Meituans eigener Benchmark-Tabelle: DeepSeek V4.1 Flash gewinnt bei gleichem Preis die meisten Coding-Vergleiche, und die Gewichte von LongCat 2.5 sind weiterhin "coming soon". Nutzen Sie es für Agentenaufgaben mit hohem Bildanteil, und halten Sie Kundendaten heraus, bis Meituan eine Datenrichtlinie veröffentlicht. Für den Support ist ein Helpdesk-Teamkollege wie eesel, den Sie an früheren Tickets testen, sicherer.
Was ist LongCat 2.5?
LongCat 2.5 ist das neueste Modell von Meituans LongCat-Team. Es wurde am 2. November 2026 auf der LongCat API Platform allgemein verfügbar, fünf Wochen nach der Veröffentlichung einer Preview-Version am 25. September. Meituans Änderungsprotokoll nennt drei Hauptmerkmale: "Native Multimodality, Beyond Text", "Long-Horizon Agents for Complex Engineering" und "Works Across Agent Harnesses".
Falls Sie die letzte Runde verpasst haben: LongCat 2.0 war ein Mixture-of-Experts-Basismodell mit 1.6 Billionen Parametern und etwa 48B aktiven Parametern pro Token, veröffentlicht unter einer MIT-Lizenz mit Gewichten auf Hugging Face. Es war ein reines Textmodell, entwickelt für agentische Coding-Aufgaben.
Ich bin Softwareentwickler in dem Team, das die KI-Agenten von eesel baut. Deshalb lese ich Modellankündigungen mit einer Frage im Hinterkopf: Was müsste ich ändern, um das Ding tatsächlich zum Laufen zu bringen? Dieser Beitrag basiert auf Meituans LongCat-2.5-Tech-Blog, der Plattformdokumentation und dem Änderungsprotokoll, dem Ankündigungsbeitrag auf X sowie den Berichten von Entwicklern, die die kostenlose Preview genutzt haben.
Was hat sich gegenüber LongCat 2.0 geändert?
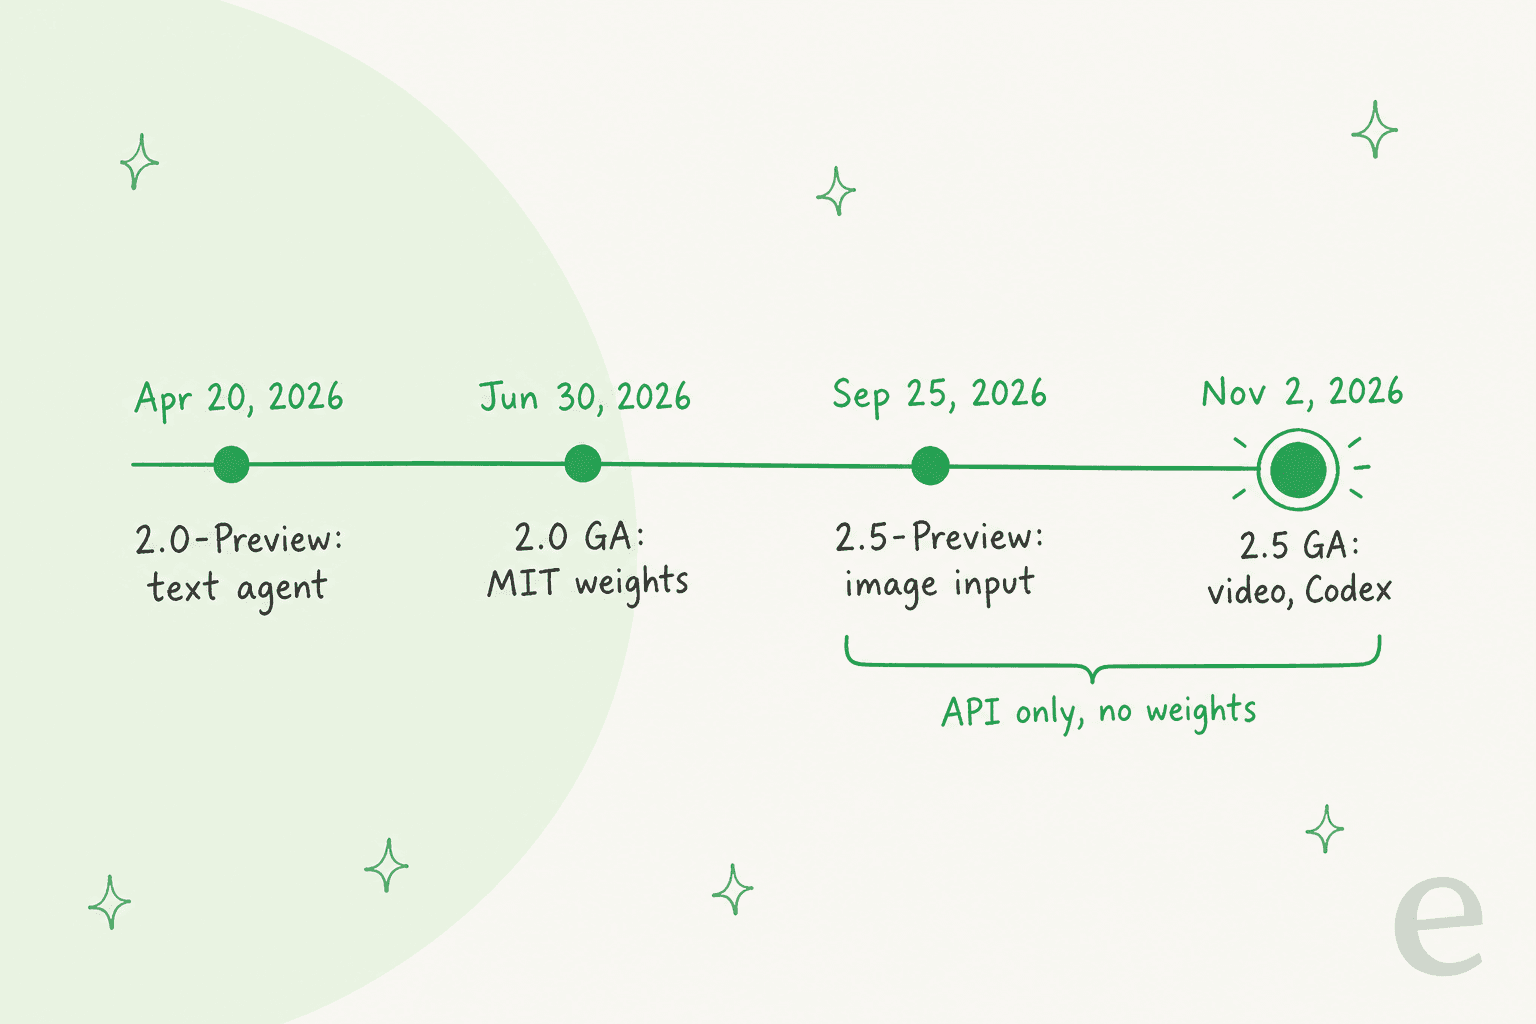
Gleicher Körper, neue Sinne. Meituans Tech-Blog sagt, 2.5 habe "1.6 trillion total parameters and approximately 48 billion activated per token" und "builds on LongCat-2.0". Es ist also kein neues, größeres Modell. Es ist das Mixture-of-Experts-Design von 2.0, ergänzt um Bildverarbeitung und deutlich mehr Agententraining. Hier ist der zeitliche Ablauf.
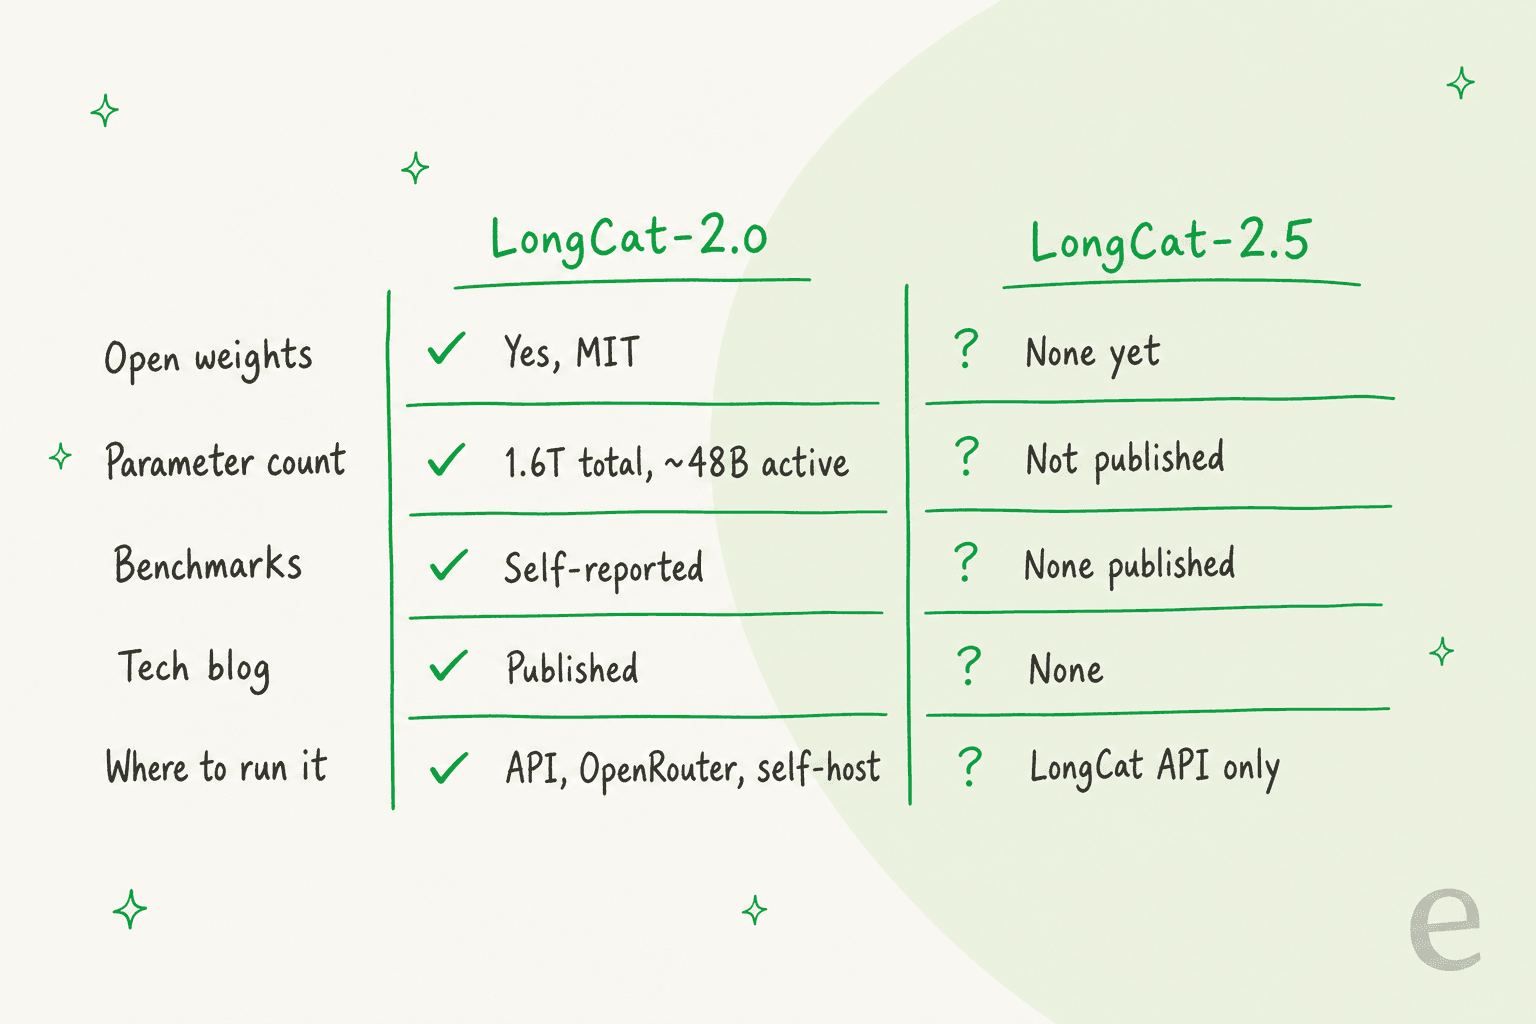
Bei 2.0 dauerte es von der Preview bis zu den MIT-Gewichten etwa zehn Wochen. 2.5 ist über Preview und GA hinweg seit fünf Wochen verfügbar. Im Tech-Blog stehen "GitHub Coming soon" und "HuggingFace Coming soon", und bisher ist weder auf Hugging Face noch auf GitHub etwas erschienen. "Coming soon" ist ein Hinweis, kein Datum, und Meituan hat keinen Zeitplan genannt.
Bild- und Videoeingabe
Das ist die wichtigste Neuerung. In der Dokumentation zum visuellen Verständnis steht "The LongCat-2.5 model accepts images and videos alongside text", und die Limits sind großzügig:
| Eingabe | Formate | Größenlimit | Pro Anfrage | Übermittlung |
|---|---|---|---|---|
| Bilder | PNG, JPG, JPEG, WebP, GIF | Jeweils 10 MB | Bis zu 50 | Base64-Daten-URL oder öffentliche URL |
| Video | Nicht aufgeführt | Jeweils 100 MB, unter 3.600 Sekunden | Bis zu 10 | Nur öffentliche URL |
Die Preview kündigte nur Bildverständnis an. Video kam mit der GA-Version hinzu. Die Ausgabe bleibt rein textbasiert. Es ist also ein Modell, das Screenshots und Bildschirmaufnahmen liest, nicht eines, das Bilder erstellt. SVG- und HEIC-Dateien werden nicht unterstützt, und ein Bild mit einem Seitenverhältnis über 200:1 löst einen Fehler aus. Auf der Preisseite gibt es außerdem keine separate Preiszeile für Bilder oder Videos. Sie bezahlen für die Tokens, in die sie umgewandelt werden.
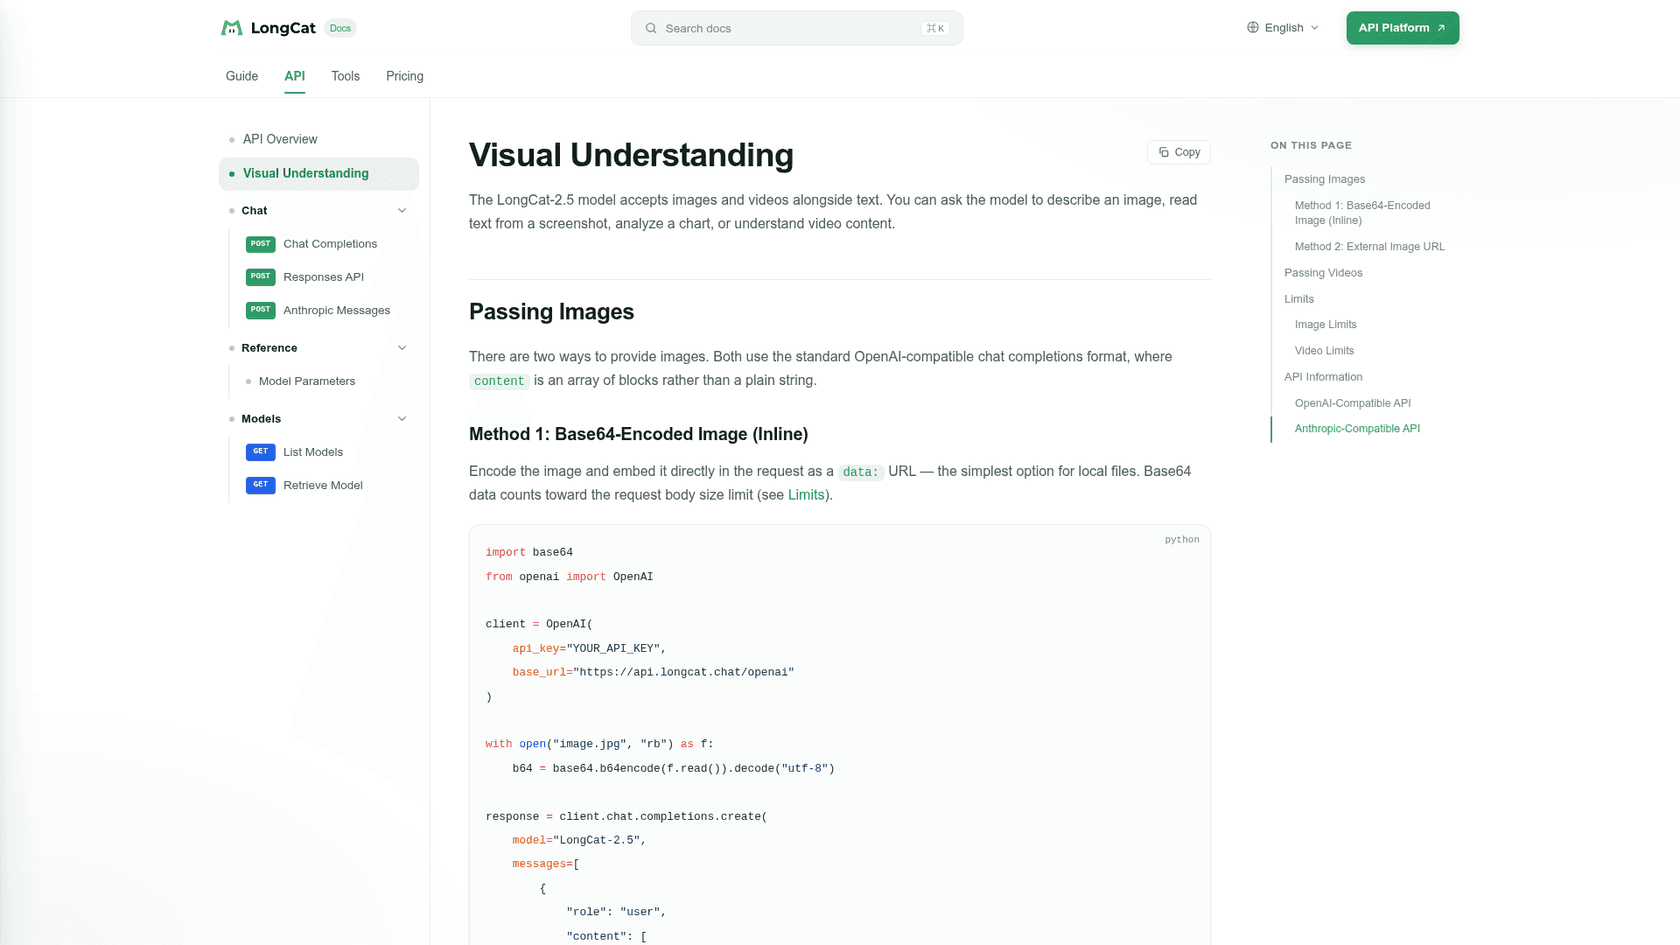
Warum das fürs Coding wichtig ist: Das Änderungsprotokoll bewirbt es für "visual coding, creative design, and 3D tasks". Einfach ausgedrückt: Sie können einen Screenshot eines fehlerhaften Layouts einfügen und den Agenten bitten, das CSS zu korrigieren. In dieselbe Richtung ging DeepSeek V4 Flash Vision, und hier hatte 2.0 eine echte Lücke.
Wie die Bildverarbeitung funktioniert
Die meisten Bildmodelle setzen einen Bildencoder auf ein Textmodell auf. LongCat 2.5 wandelt Bilder in dieselbe Art von Tokens um wie Wörter. Im Tech-Blog heißt es, das Modell "represents visual signals as multi-level discrete tokens", sodass das Basismodell einen einzigen gemischten Strom aus Text- und Bildtokens liest. Ein fester Tokenizer bedeutet, dass Bildtokens einmal berechnet und offline zwischengespeichert werden können. Deshalb konnte Meituan den Bildencoder vollständig aus dem Training entfernen.
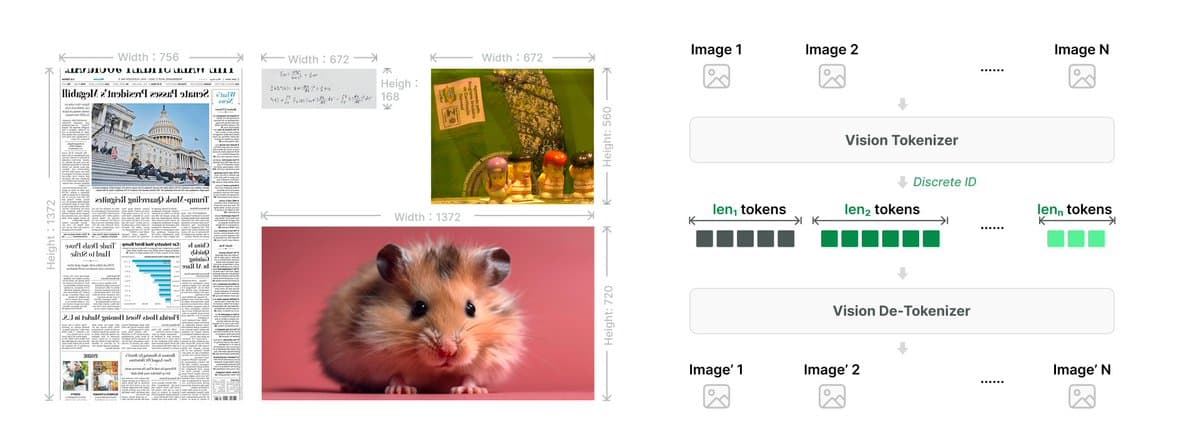
Das praktische Ergebnis ist die native Auflösung: Aus einem hohen Screenshot werden mehr Tokens statt eines zusammengestauchten Vorschaubilds. Auf der Agentenseite beschreibt Meituan "large-scale long-horizon reinforcement learning" anhand von Aufgaben aus gefilterten GitHub-Pull-Requests, mit Strafen für "repetitive reasoning and repeated tool calls". Behalten Sie diese letzte Aussage für den Community-Abschnitt im Hinterkopf.
Codex ergänzt die Liste der Agentenumgebungen
Die Preview nannte Claude Code, Hermes, OpenClaw, OpenCode und Kilo Code. Die GA-Version ergänzt Codex, und die Dokumentation enthält jetzt einen neuen Responses-Endpunkt im OpenAI-Format (POST /openai/v1/responses), den Codex benötigt. Dieser Endpunkt bietet Aufwandsstufen von none bis xhigh, standardmäßig aktivierte parallele Tool-Aufrufe und eine JSON-Schema-Ausgabe. Die Tool-Seitenleiste listet insgesamt 13 Einrichtungsanleitungen auf, von Cline bis Hermes Agent.
Ein echtes 1M-Kontextfenster, auf dem Papier
Das Marketing für 2.0 sprach von 1M Kontext, während die ausgelieferte Konfiguration bei 256K endete. Für 2.5 gibt es keine Konfiguration zum Überprüfen, nur die API. Die Seite zu den Modellparametern definiert das Kontextfenster als 1.048.576 Tokens für Eingabe plus Ausgabe pro Anfrage. Bei der Ausgabe widerspricht sich die Dokumentation selbst:
- Die Seite zu den Modellparametern erlaubt
max_tokensbis zu 262.144. - Sowohl der Schnellstart als auch die FAQ nennen eine maximale Ausgabe von 128K.
- Meituans eigene Claude-Code-Konfiguration setzt die Ausgabe auf
131072, also 128K.
Ich würde mit 128K Ausgabe planen und alles darüber als Bonus behandeln, den Sie testen.
Was sagen die Benchmarks von LongCat 2.5?
Meituans Zahlen zeigen einen großen Sprung gegenüber 2.0 und ein Modell, das bei Agentenaufgaben nahe an der Leistungsspitze von 2025-2026 liegt. Die eigene Tabelle zeichnet in dieser Preisklasse ein weniger schmeichelhaftes Bild. Alle folgenden Zahlen stammen aus der Evaluierungstabelle im Tech-Blog, von Meituan mit aktiviertem Thinking ermittelt.
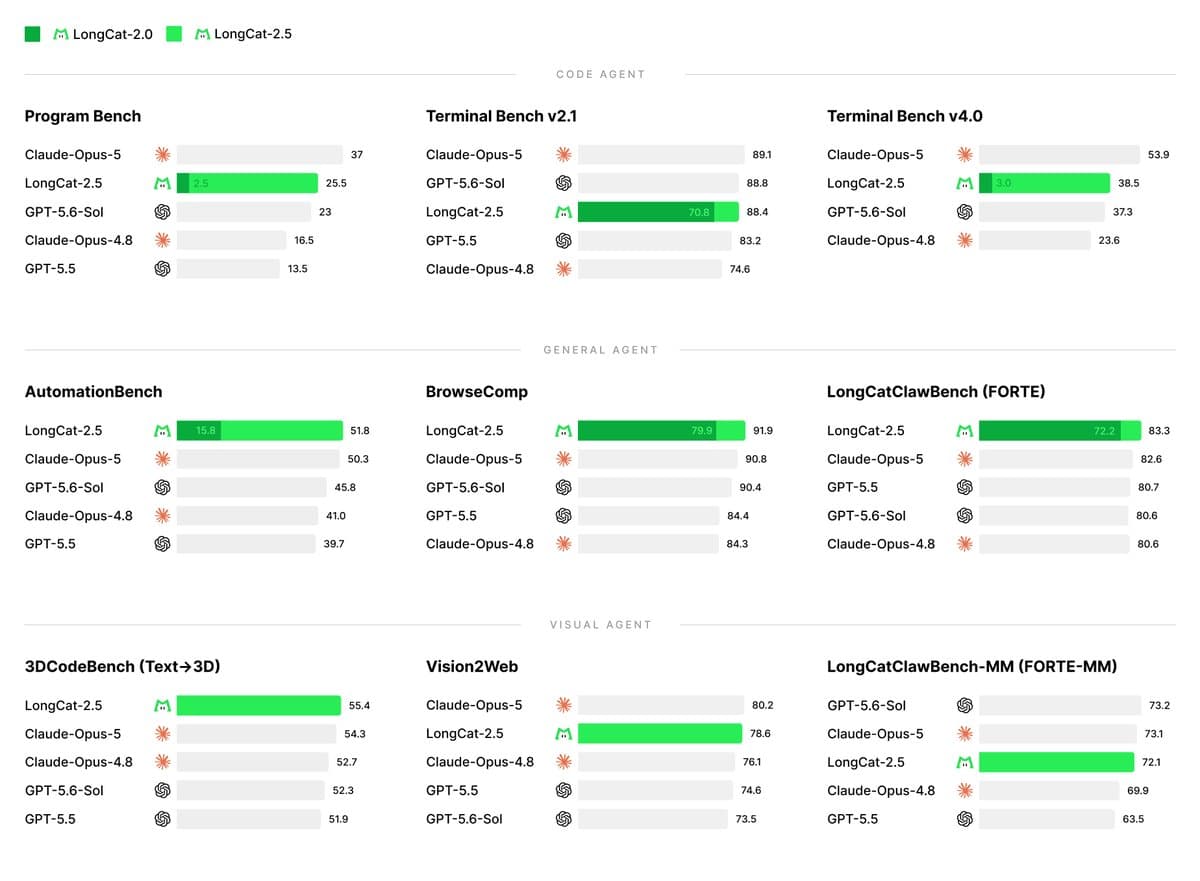
Der Sprung von 2.0 auf 2.5 ist auf dem Papier real. Terminal Bench 4.0 steigt von 3.0 auf 38.5, AutomationBench von 15.8 auf 51.8 und DeepSWE v1.1 von 9.7 auf 64.6. Das bringen Monate an Agententraining für langfristige Aufgaben.
Der Haken ist die Auswahl der Vergleichsmodelle. Die wichtigsten Diagramme vergleichen mit GPT-5.5, GPT-5.6-Sol, Claude Opus 4.8 und Claude Opus 5. Es gibt kein Claude Opus 5.5, kein GPT-6.1 Sol und kein Kimi K3.1 Pro. Die vollständige Tabelle weiter unten auf der Seite ergänzt GLM-5.3, Kimi K3 und DeepSeek V4.1 Flash. Diese letzte Spalte würde ich zuerst lesen, denn das ist das Modell zum exakt gleichen Preis.
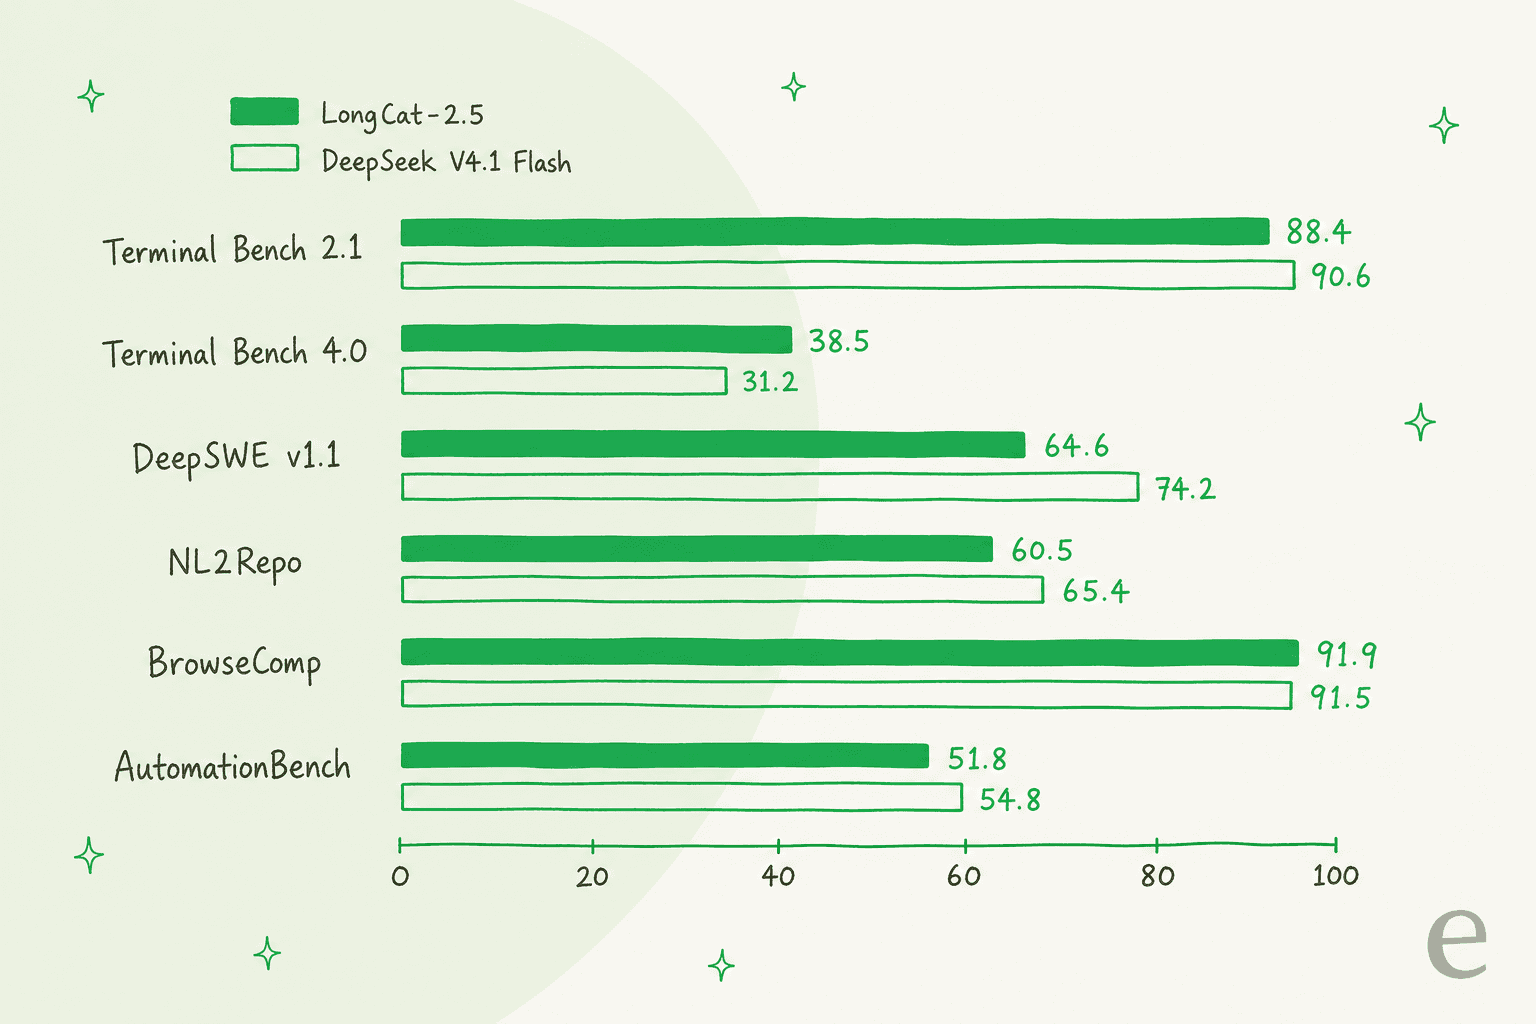
| Benchmark (Meituans Tabelle) | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| VideoMME | 85.2 | - | - | 90.0 | - |
Quelle: LongCat-2.5-Tech-Blog. Die Ergebnisse anderer Modelle sind eine Mischung aus Zahlen, die Meituan aus öffentlichen Berichten übernommen hat, und eigenen Testläufen. Dazu heißt es im Blog, sie "are indicative only".
Klar gelesen: In Meituans eigenen Coding-Vergleichen gewinnt DeepSeek V4.1 Flash häufiger, als es verliert. LongCat 2.5 liegt bei Terminal Bench 4.0, Program Bench, SWE Atlas codebase Q&A und BrowseComp vorn und ist das einzige der beiden Modelle mit veröffentlichten Videoergebnissen. Bei den langfristigen Coding-Aufgaben, um die sich die Veröffentlichung dreht, liegt das außerhalb der Spitzenzeiten günstigere DeepSeek-Modell vorn.
Unabhängige Tests haben noch nicht aufgeholt. Artificial Analysis führt nur LongCat 2.0 und LongCat Flash Lite auf, und die OpenRouter-Modell-API liefert ein Meituan-Modell zurück: meituan/longcat-2.0. Ein nützlicher Abgleich: Artificial Analysis hat für LongCat 2.0 bei Terminal-Bench 2.1 einen Wert von 50,2 % gemessen, während Meituans Tabelle 2.0 einen Wert von 70.8 gibt. Unterschiedliche Testumgebungen, aber ein Abstand von 20 Punkten ist ein Grund, selbst zu testen, statt einer der beiden Spalten zu vertrauen.
Wie viel kostet LongCat 2.5?
LongCat 2.5 kostet 0,30 $ pro Million Eingabetokens und 1,20 $ pro Million Ausgabetokens, mit zwischengespeicherter Eingabe zu 0,006 $. Jede Zahl auf der Seite trägt die Kennzeichnung "Discounted Price (limited-time)".
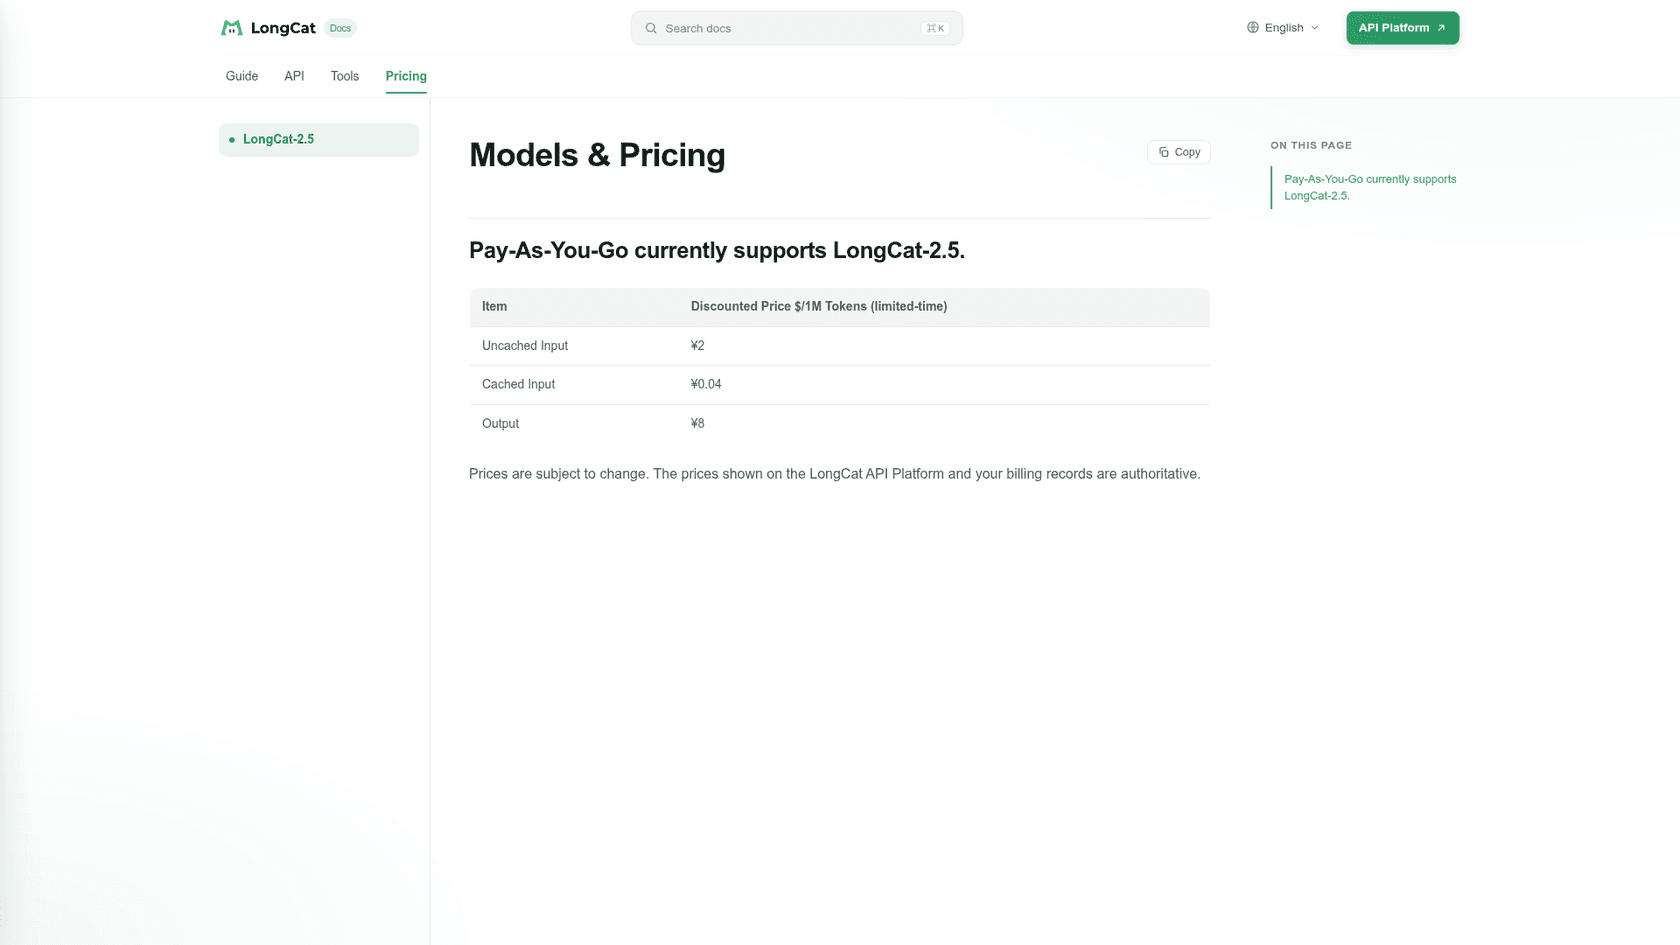
| Posten | USD pro 1M Tokens | CNY pro 1M Tokens |
|---|---|---|
| Nicht zwischengespeicherte Eingabe | 0,30 $ | ¥2 |
| Zwischengespeicherte Eingabe | 0,006 $ | ¥0.04 |
| Ausgabe | 1,20 $ | ¥8 |
| Aufschlag für Kontextlänge | Keiner | Keiner |
| Aufschlag für Bilder oder Videos | Keiner aufgeführt | Keiner aufgeführt |
Quelle: LongCat-2.5-Preise und API Pay-As-You-Go.
Zwei Dinge fallen auf. Zwischengespeicherte Eingabe kostet 2 % des Preises für nicht zwischengespeicherte Eingabe. Das macht für Coding-Agenten, die bei jedem Durchgang dieselben Dateien erneut senden, einen großen Unterschied. Außerdem gibt es bei keiner Länge eine Preisstaffelung. Eine Anfrage mit 900K Tokens kostet pro Token also genauso viel wie eine mit 9K.
Meituans eigenes Rechenbeispiel: Eine Anfrage mit 600.000 nicht zwischengespeicherten Eingabetokens, 400.000 zwischengespeicherten Eingabetokens und 500.000 Ausgabetokens kostet 0,7824 $. Nur erfolgreiche Aufrufe (HTTP 200) werden berechnet, vorausbezahltes Guthaben verfällt nie, und es gibt keine Mindestabnahme.
Was passiert, wenn der Rabatt endet?
Das weiß niemand, und darin liegt das eigentliche Preisrisiko. Die Seite für 2.5 zeigt nur die Rabattspalte. Eine alte, nicht verlinkte LongCat-2.0-Preisseite zeigt weiterhin den Listenpreis von 2.0 neben demselben Rabatt: 0,75 $ für Eingabe, 0,015 $ für zwischengespeicherte Eingabe und 2,95 $ für Ausgabe. Falls 2.5 irgendwann zum Listenpreis von 2.0 wechselt, steigen die Ausgabekosten auf etwa das 2,5-Fache. Meituan hat nicht gesagt, dass das passieren wird, und auch nicht, dass es nicht passieren wird.
Der Preisvergleich
| Modell | Eingabe / 1M | Zwischengespeichert / 1M | Ausgabe / 1M | Kontext / max. Ausgabe | Preisseite des Anbieters |
|---|---|---|---|---|---|
| LongCat 2.5 (Aktionspreis) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 128K | LongCat |
| DeepSeek V4.1 Flash (Spitzenzeiten) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 384K | DeepSeek |
| DeepSeek V4.1 Flash (außerhalb der Spitzenzeiten) | 0,15 $ | 0,003 $ | 0,60 $ | 1M / 384K | DeepSeek |
| Qwen 3.8 Max | 2,00 $ | 0,25 $ | 6,00 $ | 1M / 131K | QwenCloud |
| Kimi K3.1 Pro | 2,00 $ | 0,20 $ | 10,00 $ | 1M | Kimi |
| Kimi K3 | 3,00 $ | 0,30 $ | 15,00 $ | 1M | Kimi |
Die interessante Zeile ist DeepSeek. Der Aktionspreis von LongCat 2.5 entspricht auf den Cent genau dem Spitzenzeittarif von DeepSeek V4.1 Flash, und DeepSeek halbiert ihn außerhalb der Spitzenzeiten. 2.5 ist also nicht auf eine Weise günstig, die sonst niemand bietet. Es liegt in derselben günstigen Preisklasse wie das meistgenutzte Budgetmodell der Kategorie, das unabhängige Ergebnisse, eine längere maximale Ausgabe und einen veröffentlichten API-Leitfaden hat. LongCats Vorteil muss daher aus der Videoeingabe und der Coding-Qualität kommen, die Sie selbst messen.
Das Bezahlen ist einfacher geworden
Bei 2.0 ließ sich Guthaben nur über Alipay und WeChat Pay aufladen, was die meisten westlichen Teams ausschloss. Die Pay-As-You-Go-Seite führt für die USD-Seite jetzt Kredit- und Debitkarten sowie Google Pay auf. Außerhalb des chinesischen Festlands können Sie sich per E-Mail ohne Identitätsprüfung registrieren. Token Packs (ein festes Kontingent mit 30 Tagen Gültigkeit, verkauft in zeitlich begrenzten Aktionen um 10:00, 16:00, 21:00 und 23:00 Uhr Pekinger Zeit) gibt es weiterhin, aber ihre Größen und Preise sind nur in der Konsole nach der Anmeldung sichtbar.
Verifizierte Unternehmen erhalten außerdem Mengenrabatte auf Pay-As-You-Go-Ausgaben:
| Monatliche Ausgaben (USD-Seite) | Monatliche Ausgaben (CNY-Seite) | Rabatt |
|---|---|---|
| 75 $ oder mehr | ¥500 oder mehr | 10 % Rabatt |
| 300 $ oder mehr | ¥2.000 oder mehr | 20 % Rabatt |
| 1.200 $ oder mehr | ¥8.000 oder mehr | 30 % Rabatt |
| 6.000 $ oder mehr | ¥40.000 oder mehr | 40 % Rabatt |
Quelle: LongCat-FAQ.
Wie führen Sie LongCat 2.5 in Claude Code oder Codex aus?
Sie richten die Agentenumgebung auf LongCats Endpunkt im Anthropic- oder OpenAI-Format aus und setzen den Modellnamen auf LongCat-2.5. Die Claude-Code-Anleitung trägt das in ~/.claude/settings.json ein:
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_longcat_api_key",
    "ANTHROPIC_BASE_URL": "https://api.longcat.chat/anthropic",
    "ANTHROPIC_MODEL": "LongCat-2.5",
    "ANTHROPIC_SMALL_FAST_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "LongCat-2.5",
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "131072",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}
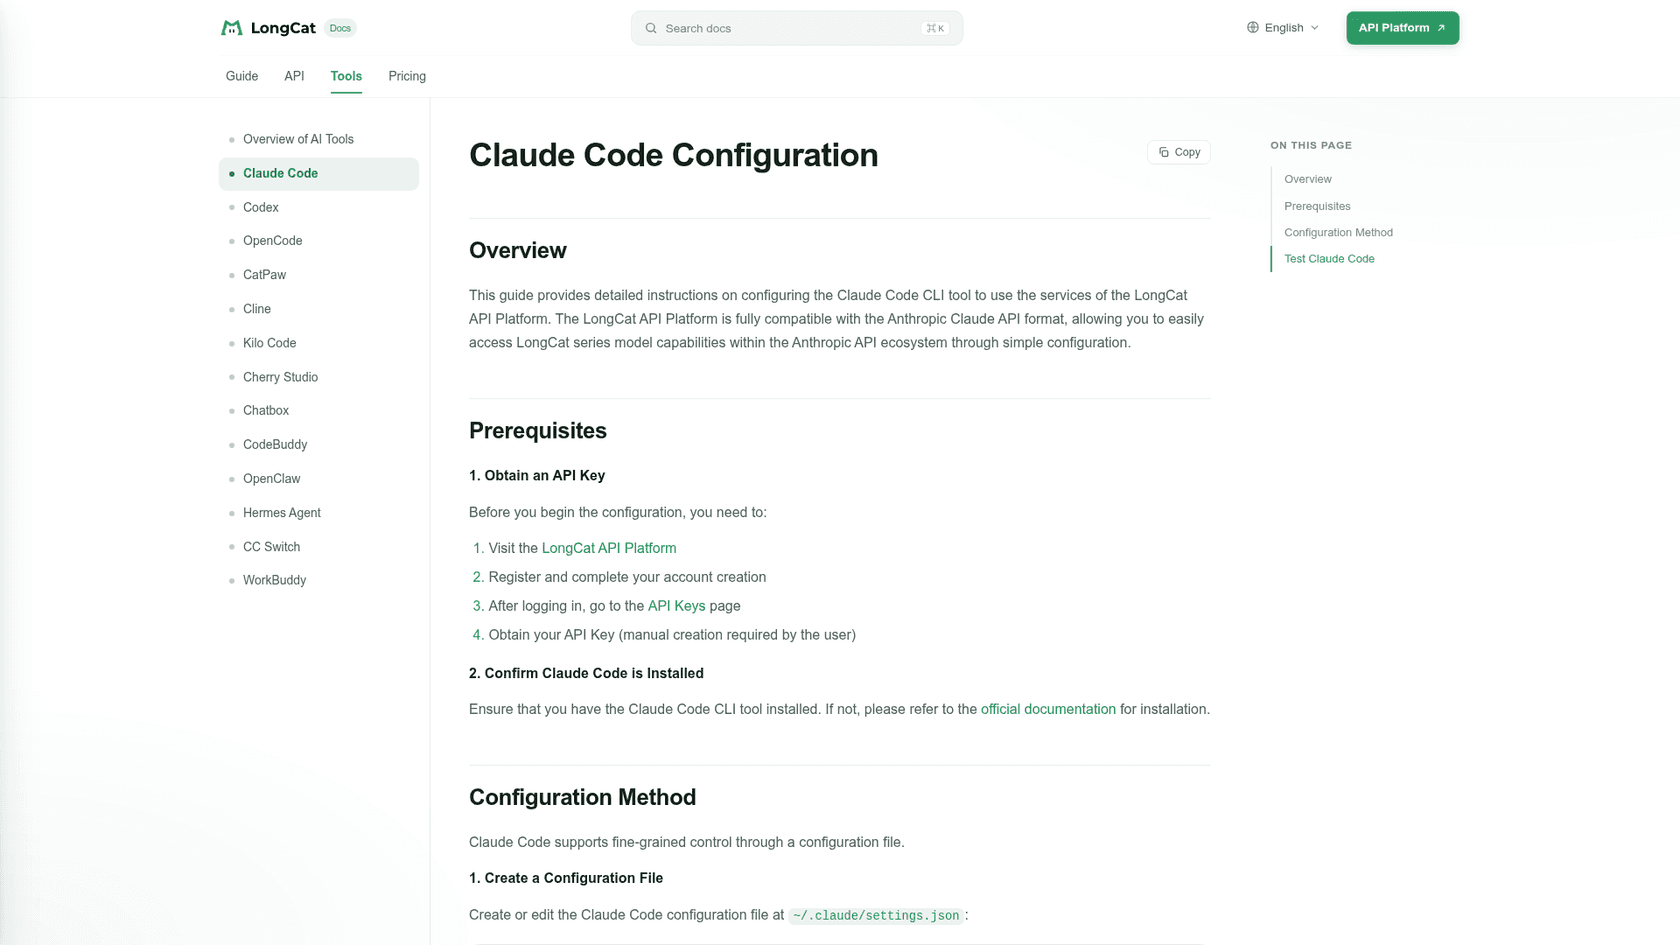
Beachten Sie, dass jeder Modellslot auf dasselbe Modell verweist, einschließlich des „kleinen, schnellen“ Modells, das Claude Code normalerweise für günstige Hintergrundaufrufe verwendet. Bei 1,20 $ für die Ausgabe ist das in Ordnung, aber Sie verlieren damit den Geschwindigkeitsunterschied, den Sie mit einem tatsächlich kleinen Modell hätten.
Für Codex setzen Sie model = "LongCat-2.5", model_reasoning_effort = "high", die Basis-URL https://api.longcat.chat/openai/v1 und wire_api = "responses" in ~/.codex/config.toml, mit dem Schlüssel in ~/.codex/auth.json.
Drei Besonderheiten, die ich vor dem ersten Lauf kennen möchte:
- Die Temperatur ist fest eingestellt. Sie beträgt 1.0 bei aktiviertem Thinking und 0.7 bei deaktiviertem Thinking. Andere Werte werden stillschweigend überschrieben statt abgelehnt (Modellparameter). Wenn Ihre Evaluierungsumgebung verschiedene Temperaturwerte durchläuft, tut sie nicht das, was Sie denken.
- Ratenlimits sind nicht veröffentlicht. Die Limits gelten pro API-Schlüssel und liefern einen 429-Fehler mit
retry_after: 60zurück, aber in der API-Übersicht findet sich nirgends eine Angabe zu Anfragen oder Tokens pro Minute. - Alte Modell-IDs können verschwinden. LongCat 2.0 und 2.5-Preview sind aus sämtlichen Tabellen unterstützter Modelle verschwunden, ohne datierte Abkündigung. Wenn Sie
LongCat-2.0fest hinterlegt haben, testen Sie es heute.
Wenn Sie sich vor der Auswahl einen umfassenderen Überblick über Coding-Agenten im Terminal verschaffen möchten, vergleicht die Übersicht zu agentischen Coding-CLIs sie direkt miteinander.
Was sagen Entwickler über LongCat 2.5?
Die Preview lief zwei Wochen lang kostenlos in OpenCode. Deshalb gibt es mehr praktische Rückmeldungen als bei einem erst einen Tag alten Modell üblich. Das häufigste Thema sind Schleifen bei langen Aufgaben.
"Longcat is fantastic until it get stuck in loops. I think around 200k tokens of context it loses it. I have been compacting and continuing."

Das passt dazu, dass Meituan im Training Strafen für "repetitive reasoning and repeated tool calls" ergänzt hat. Ob die GA-Version das behoben hat, wäre das Erste, was ich testen würde. Der faire Gegenpunkt ist, dass diejenigen, die es auf eine eng begrenzte Rolle beschränkten, damit zufrieden waren:
"Longcat is ok as cheap vision agent, tiny tasks, commit. But definitely not as planner, creative writing."
Ein Entwickler ließ die kostenlose Preview selbst durch Terminal-Bench 2.1 laufen und erreichte 48,7 % pass@1. Mit etwa 0.54M Tokens pro Versuch war sie von den vier getesteten Modellen das token-effizienteste (r/opencode). Das ist eine Preview, eine andere Testumgebung und ein anderer Aufbau als bei Meituans 88.4. Lesen Sie es deshalb als Plausibilitätsprüfung, nicht als Urteil.
Auf Hacker News konzentrierte sich der Thread zur Veröffentlichung auf den Preis und die Auswahl der Konkurrenten:
"Same price as DS4.1F ... On benchmarks they seem comparable. The wild cards are the cache hit rate and speed."

"LongCat-2.5's chart skips Opus 5.5 and every current frontier model. This always happens, and people defend it because they say it's not fair to compare them. But it absolutely is!"
Und noch eine Erinnerung daran, dass der Endnutzer-Chat weniger ausgereift ist als die API: Ein HN-Kommentator stellte fest, dass der Link zum longcat.ai-Chat auf eine Anmeldeseite einer anderen Domain weiterleitete und Antworten standardmäßig auf Mandarin kamen. Wenn Sie nur über die Chat-App testen, testen Sie nicht das, was Ihnen die API bietet.
Sollten Sie LongCat 2.5 für den Kundensupport verwenden?
Nicht als Modell hinter einer Support-Warteschlange, zumindest noch nicht. Der Grund ist weder der Preis noch die Qualität. Es sind die Daten. Die LongCat-FAQ und die Abrechnungsseiten sagen nichts darüber, wie lange Prompts gespeichert werden oder ob API-Daten für das Training verwendet werden. Wenn ein Prompt den Namen, die Bestellung und die Adresse eines Kunden enthält, entscheidet dieses Schweigen die Frage. Das ist dasselbe Hindernis, auf das ich im Beitrag zu 2.0 hingewiesen habe.
Es gibt außerdem einen grundsätzlicheren Punkt. Ein Modell ist Infrastruktur. Um Tickets gut zu beantworten, brauchen Sie auch die Anbindungen an die Wissensdatenbank, die Eskalationsregeln, den Tonfall und eine Möglichkeit, Antworten zu prüfen, bevor Kunden sie sehen. Das bedeutet viel Entwicklungsarbeit auf einer API, genau die Abwägung, um die es bei Eigenentwicklung oder Kauf für KI-Support geht.
Diese Lücke schließt eesel. eesel ist eine Plattform für KI-Teamkollegen. Ihr KI-Helpdesk-Teamkollege tritt Ihrem bestehenden Helpdesk bei, lernt aus Ihrem Helpcenter und früheren Tickets und antwortet in Ihrer Warteschlange. Bevor er live geht, wird er mit Ihren historischen Tickets getestet, damit Sie lesen können, was er geantwortet hätte. Ich habe erlebt, wie selbstbewusst klingende Bots in echten Warteschlangen falsche Antworten gaben. Genau deshalb wird jeder eesel-Rollout an früheren Tickets simuliert, bevor er ein aktives Ticket bearbeitet.
SE Ranking zeigt gut, wie das in der Praxis aussieht. Das Unternehmen betreibt drei Produkte auf Zendesk mit jeweils einem eesel-Agenten. In einem Monat bearbeiteten diese Agenten 4.650 Konversationen, darunter 2.100 Live-Chats, bei denen eesel die erste Antwort gab, auf Grundlage von etwa 16.800 Wissensseiten. SamCart betreibt einen Agenten für Freshdesk-Tickets und einen weiteren im Website-Chat, die auf Basis von 280 Helpcenter-Artikeln antworten.
Und wenn Sie sich LongCat 2.5 ansehen, weil Sie gern mit Claude Code oder Codex arbeiten, kommt eesel Ihnen dort entgegen. Mit der eesel CLI (@eesel/cli) können Sie einen Helpdesk verbinden, die dauerhaft geltenden Anweisungen des Agenten lesen und bearbeiten, Aktionen genehmigen oder ablehnen und nachlesen, was der Agent in jedem Lauf getan hat, alles vom Terminal aus. Jeder Befehl gibt JSON aus, und Schreiboperationen unterstützen --dry-run, sodass ein Coding-Agent sie sicher steuern kann. Jeder Workspace ist außerdem ein MCP-Server, den Sie zu Claude Code hinzufügen können. Der Coding-Agent richtet den Support-Teamkollegen ein; er muss nicht selbst einer werden.
Wer sollte LongCat 2.5 nutzen?
Meine Einschätzung, nachdem ich jede von Meituan veröffentlichte Seite gelesen habe:
- Probieren Sie es aus, wenn Sie Coding-Agenten mit begrenztem Budget betreiben und einen möchten, der Screenshots oder Bildschirmaufnahmen lesen kann. Bei 0,30 $ / 1,20 $ und zwischengespeicherter Eingabe zu 2 % kostet ein Nachmittag mit Tests an Ihrem eigenen Repository nur ein paar Dollar. Vergleichen Sie es direkt mit DeepSeek V4.1 Flash zum gleichen Preis.
- Warten Sie, wenn Sie offene Gewichte, eine Lizenz oder Self-Hosting benötigen. Laut Meituan sind die Gewichte "coming soon", und selbst dann braucht ein 1.6T-Modell einen Multi-GPU-Knoten. Heute ist LongCat 2.0 das einzige der beiden Modelle, das Sie herunterladen können.
- Verzichten Sie vorerst darauf, wenn Ihre Prompts Kundendaten oder regulierte Daten enthalten. Ohne veröffentlichte Richtlinie zur Aufbewahrung oder zum Training gibt es kein grünes Licht, unabhängig vom Preis.
- Wählen Sie stattdessen DeepSeek, wenn es ausschließlich um langfristige Coding-Aufgaben geht. Bei gleichem Preis liegt DeepSeek V4.1 Flash in Meituans eigener Tabelle bei DeepSWE, NL2Repo und Terminal Bench 2.1 vorn und ist außerhalb der Spitzenzeiten günstiger. Wenn Sie unabhängig gemessene Ergebnisse benötigen, kosten Kimi K3.1 Pro und Qwen 3.8 Max mehr, sind aber getestet worden.
Das faire Fazit: LongCat 2.5 ist ein echtes Upgrade gegenüber 2.0, mit integrierter statt nachträglich aufgesetzter Bildverarbeitung, zu einem unveränderten Preis. Für reines Coding ist es in seiner Preisklasse nur nicht die naheliegende Wahl, und das zeigt seine eigene Benchmark-Tabelle.
Testen Sie eesel
Wenn Sie bei LongCat 2.5 gelandet sind, weil Sie hoffen, ein günstiges Modell könnte Ihrem Team Tickets abnehmen, sparen Sie sich die Integrationsarbeit. Der KI-Helpdesk-Teamkollege von eesel verbindet sich in wenigen Minuten mit Zendesk, Freshdesk, Gorgias und den übrigen Systemen, lernt aus Ihren bisherigen Tickets und zeigt Ihnen vor dem Live-Betrieb, wie er sie beantwortet hätte. Die Tarife beginnen bei 299 $ pro Monat, mit einer kostenlosen Stufe zum Testen.

Testen Sie eesel kostenlos.