

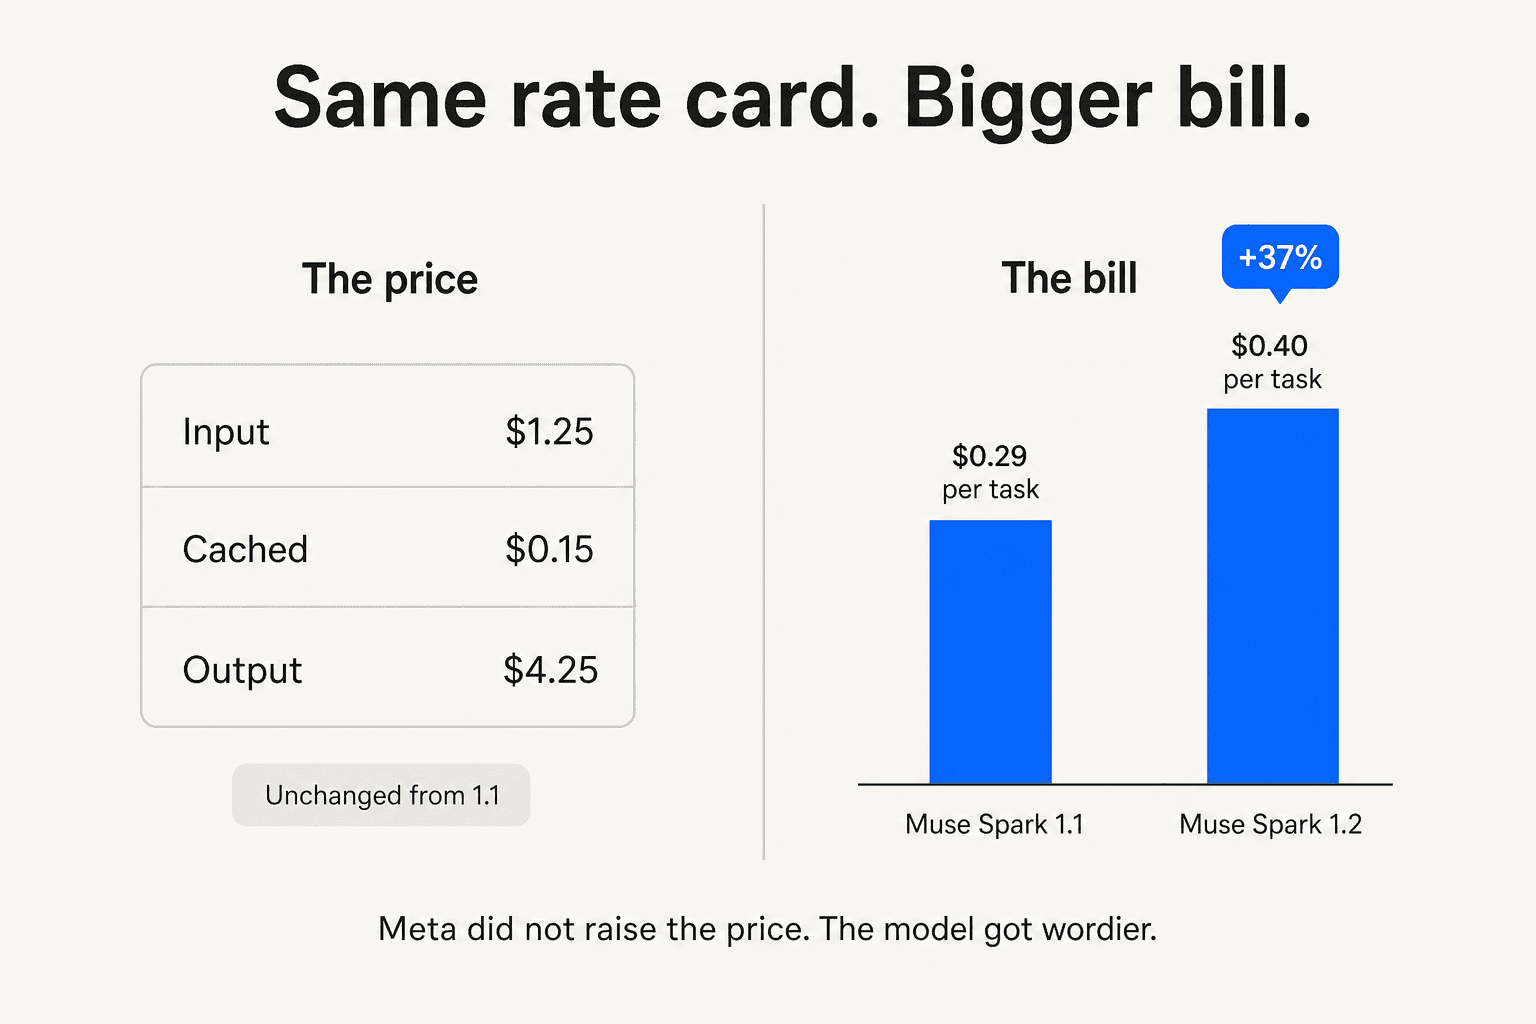
Meta hat an der Muse-Spark-Preisliste keine einzige Zahl geändert, und das Modell kostet im Betrieb trotzdem 37 % mehr. Der Standard-Tarif kostet 1,25 $ pro Million Input-Tokens, 0,15 $ gecacht, 4,25 $ Output, genau wie 1.1. Der Contributor-Tarif kostet 0,10 $ / 0,002 $ / 0,20 $, wenn Sie Meta mit Ihrem Traffic trainieren lassen. Aber Artificial Analysis hat gemessen, dass die Kosten pro Benchmark-Aufgabe von 0,2923 $ bei 1.1 auf 0,3992 $ bei 1.2 gestiegen sind, und der Grund ist nicht der, den alle angenommen haben.
Das Reasoning wurde günstiger. Das zusätzliche Geld ging in Cache-Lesezugriffe und in die Antwort selbst, die pro Aufgabe 78 % länger wurde. Die Zahl, die man beobachten sollte, ist also, wie viele Tokens das Modell in Ihrem Namen ausgibt, und dazu sagt Metas Preisliste nichts.
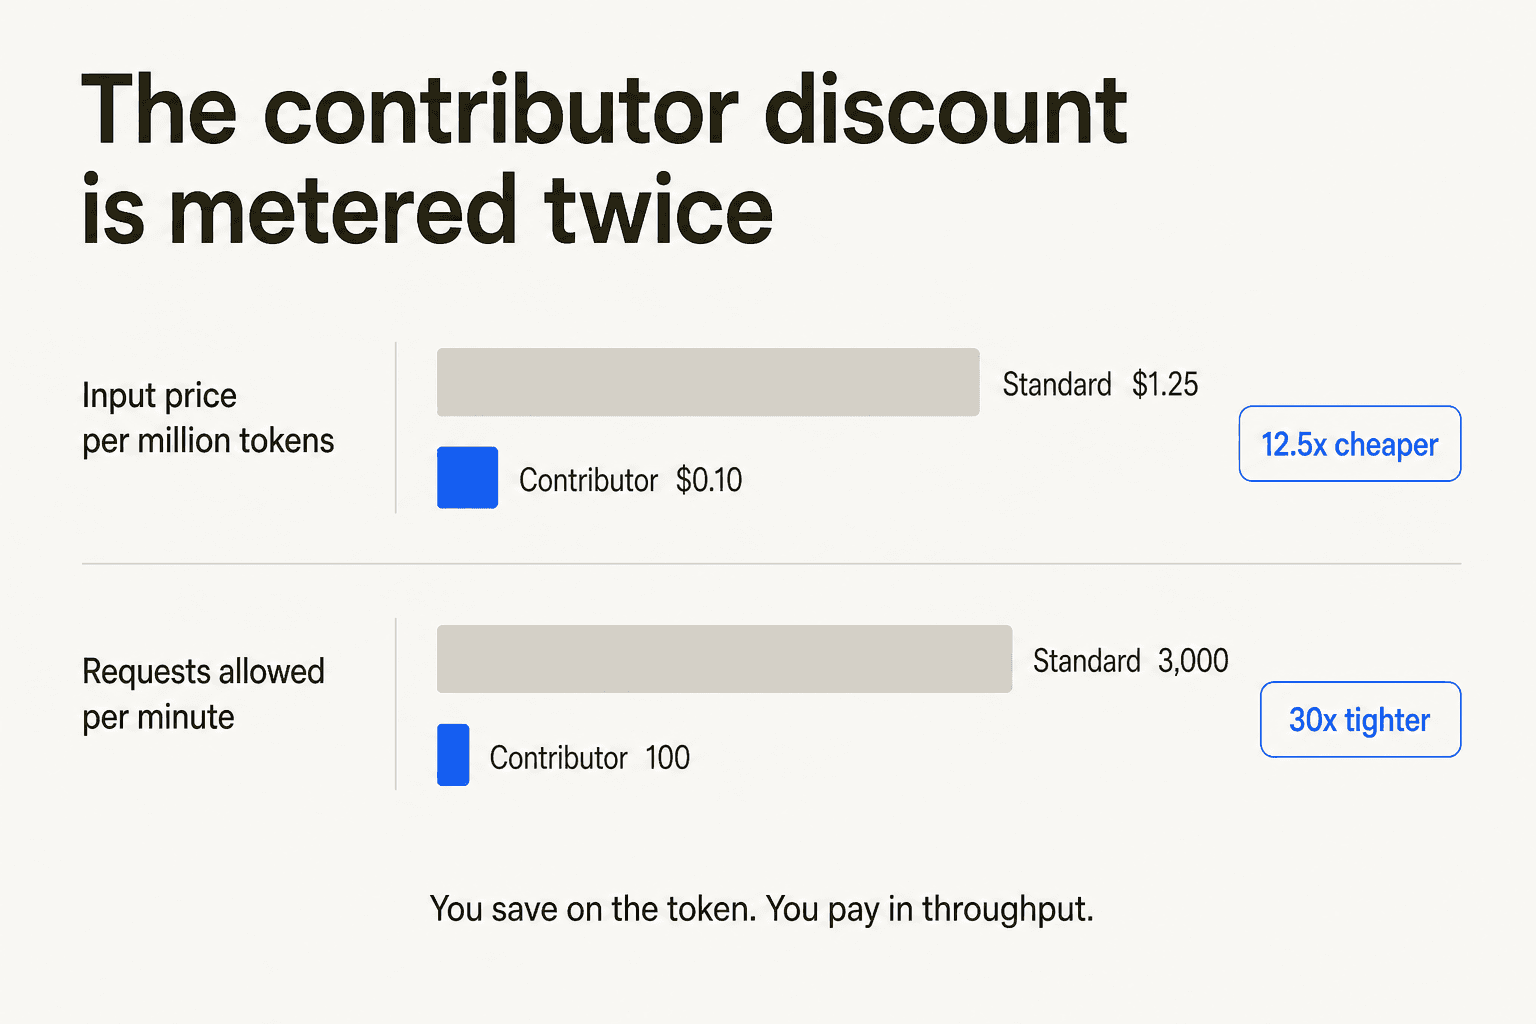
Zwei Dinge sollten Sie vor der Tarifwahl prüfen. Der Contributor-Rabatt wird doppelt bemessen: 12,5-mal günstigerer Input und ein 30-mal engeres Limit von 100 Anfragen pro Minute gegenüber 3.000. Und bei 1.1 zu bleiben spart nichts, denn Meta bewertet beide Checkpoints identisch.
Wenn Sie das für eine Support-Queue statt für ein Nebenprojekt kalkulieren, lautet die ehrliche Antwort, dass keine Token-Preisliste diese Rechnung vorhersagen kann. Ein gelöstes Ticket besteht aus mehreren Aufrufen, Retrieval und Wiederholungen. Deshalb berechnet eesel 1 Credit pro Ticket, egal wie lang es ist, und lässt Sie die Kosten an Ihrem eigenen Ticketverlauf simulieren, bevor etwas live geht.
Meta Muse Spark 1.2 Preise, die vollständige Preisliste
Hier ist jede veröffentlichte Zahl, geprüft gegen Metas eigene Seiten am 17. August 2026. Alle Preise in US-Dollar pro Million Tokens.
| Modell-ID | Tarif | Kontext | Input | Gecachter Input | Output | Formulierung in Metas Datenrichtlinie |
|---|---|---|---|---|---|---|
muse-spark-1.2-contributor | Contributor | 1,048,576 | $0.10 | $0.002 | $0.20 | "Used to improve our products." |
muse-spark-1.2 | Standard | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
muse-spark-1.1 | Standard | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
Diese dritte Zeile übersehen die meisten Berichte. Metas Model-API-Seite führt den Vorgänger-Checkpoint zum exakt gleichen Preis, und die Preisdokumentation bestätigt, dass beide Checkpoints die Standardpreise teilen. Es gibt keinen günstigen Legacy-Tarif, auf den man ausweichen könnte. Wenn das Verhalten von 1.2 Sie mehr kostet, holt ein Downgrade das Geld nicht zurück. Das ist anders als bei den Muse Spark 1.1 Preisen zum Launch, als es der einzige Checkpoint auf der Liste war.
Ein paar Dinge sollten hier klar gesagt werden, bevor ich darauf eingehe, was die Preisliste verbirgt.
Es gibt keine Prämie für langen Kontext. Meta sagt das auf der Seite zu Preisen und Rate Limits ausdrücklich: Sie zahlen dasselbe, ob das Fenster fast leer oder fast voll ist. Mehrere Anbieter erhöhen den Preis ab einer Kontextschwelle, und wenn Sie in jeden Aufruf ein großes, stabiles Präfix packen, summiert sich dieser Unterschied schnell.
Prompt Caching ist automatisch und kostenlos aktiviert. Metas Prefix Caching hat "no flag or key to manage", auf der Preisliste gibt es keine Cache-Schreibgebühr, und gecachte Tokens sind ein rabattierter Teil des Inputs und kein Aufschlag. Mit prompt_cache_retention: "24h" können Sie längere Aufbewahrung anfragen, Meta nennt das aber einen Hinweis und keine Garantie.
Und Metas eigenes Gerüst ist kostenlos. Die Dokumentation vermerkt, dass Meta jedem Prompt eine kleine Menge Steuerungskontext hinzufügt und diese Tokens "are not billed and are excluded from the token counts reported in your usage." Das ist eine kleine Höflichkeit, aber genau die Art von Posten, die auf anderen Rechnungen leise auftaucht.
Die Preisliste hat sich nicht bewegt. Die Rechnung stieg um 37 %.
Das macht das Schreiben über die Preise von Muse Spark 1.2 so seltsam. Meta hat am 5. August ein neues Modell veröffentlicht, den Preis gleich gelassen, und die Kosten für dieselbe Arbeit stiegen um mehr als ein Drittel.
Artificial Analysis lässt dieselbe Suite aus neun Evaluierungen gegen jedes Frontier-Modell laufen, der Vergleich zwischen den Versionen ist also so kontrolliert, wie öffentliche Daten es hergeben. Es veröffentlicht zwei getrennte Kostenmaße, und man sollte sie auseinanderhalten, weil sie sich nicht gemeinsam bewegen.
Die gewichteten Kosten pro Aufgabe stiegen von 0,2923 $ bei 1.1 auf 0,3992 $ bei 1.2, ein Plus von 36,6 %. Die Gesamtkosten für einen Durchlauf der ganzen Suite stiegen von 547,32 $ auf 639,27 $, ein Plus von 91,96 $ oder 16,8 %. Die erste Zahl sagt voraus, was eine bestimmte Arbeit Sie kostet, und mit ihr beginne ich. Die zweite zeigt, wohin das Geld ging, und das schlüssele ich im nächsten Abschnitt auf.
Ich will genau sagen, was die 37 % sind und was nicht. Es ist ein Benchmark-Workload, nicht Ihr Workload. Aber es ist derselbe Benchmark bei beiden Versionen, bepreist mit derselben Preisliste, und damit eine saubere Antwort auf eine Frage: Wie viel mehr gibt dieses Modell für eine Arbeitseinheit aus? Über ein Drittel mehr, kostenlos, ohne dass jemand eine Preisänderung verkündet hat.
Das ist die Falle, in die ich Teams immer wieder laufen sehe, und sie hat nichts speziell mit Meta zu tun. Ein Interessent saß einmal mit mir im Gespräch und rechnete seine eigenen Zahlen durch, kam auf rund 30.000 $ im Monat für ein Unternehmen, das auf 150.000 Tickets zuwächst, und die ganze Verwirrung kam aus der Lücke zwischen der Einheit, die er zählte, und der, nach der er abgerechnet wurde. Ein anderer bekam ein Kontingent von 3.000 Interaktionen im Monat angeboten, bearbeitete aber etwa 500 Tickets am Tag mit je vier Wortwechseln, was das Kontingent in anderthalb Tagen aufbraucht. Keiner von beiden war schlecht im Rechnen. In beiden Fällen blieb der Multiplikator zwischen "dem, was ich zähle" und "dem, was Sie abrechnen" unsichtbar, bis die Rechnung kam. Die Preisliste von Muse Spark hat genau diese Form.
Wohin die zusätzlichen 92 $ tatsächlich gingen
Fast alle, auch eine frühere Version meiner eigenen Muse-Spark-1.2-Analyse, nahmen an, der Kostensprung komme von mehr Nachdenken. Reasoning-Modelle werden teurer, indem sie härter nachdenken, und 1.2 wurde als der klügere Checkpoint beworben. Das ist eine vernünftige Vermutung.
Sie ist auch falsch, und die veröffentlichte Kostenaufschlüsselung sagt das.
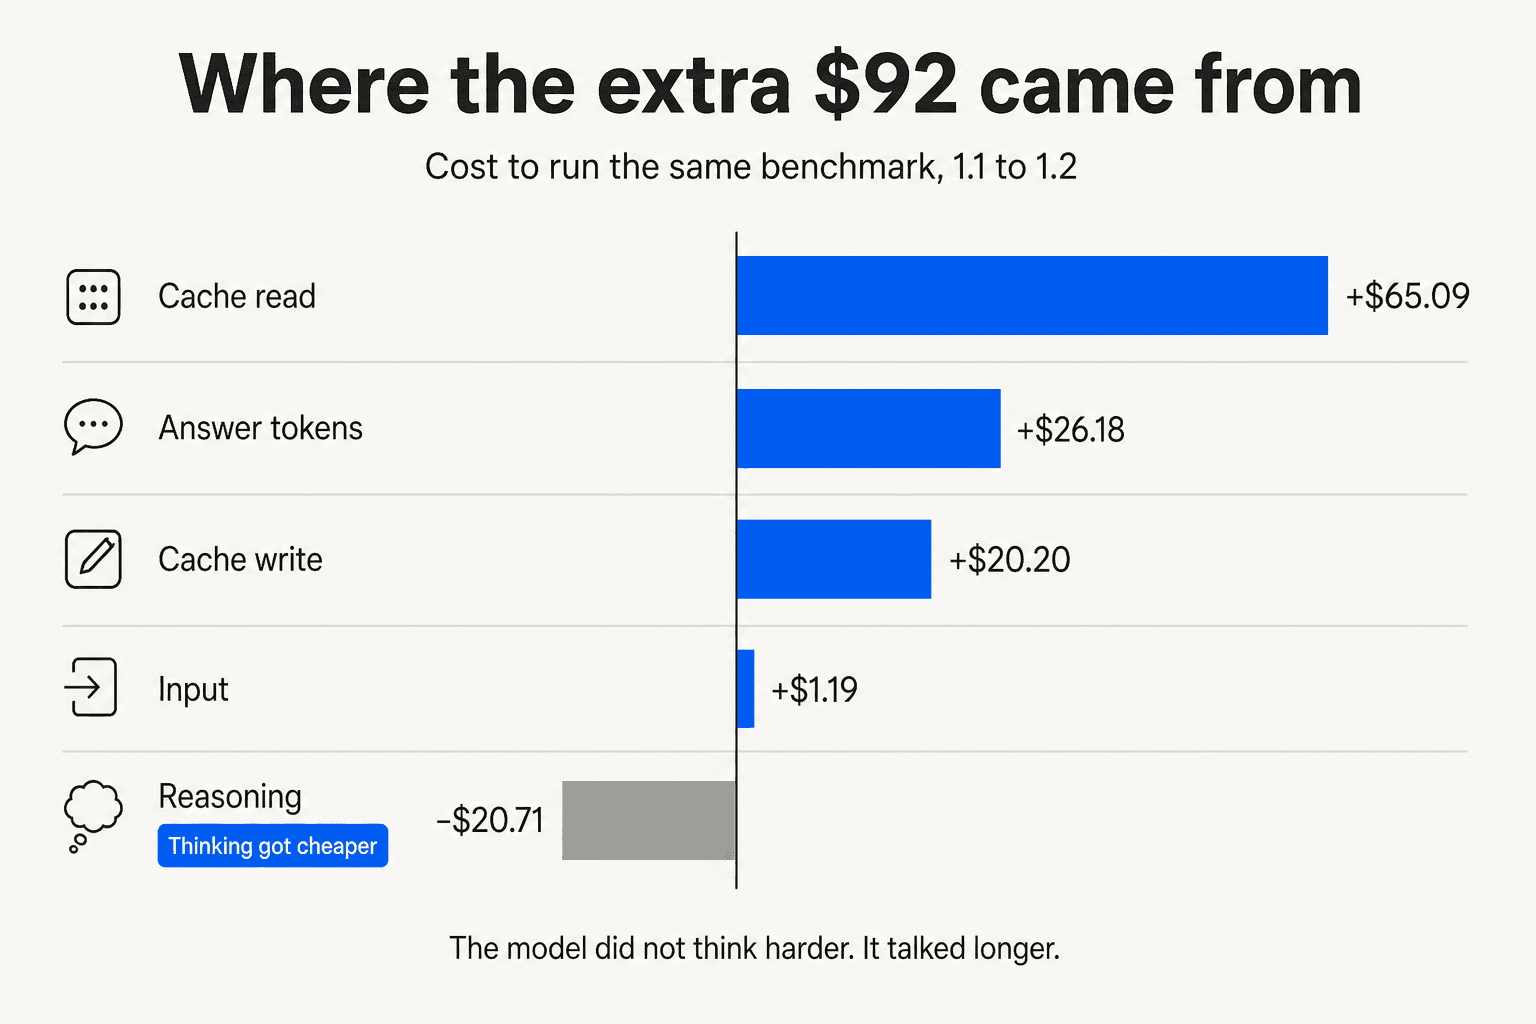
| Token-Typ | Muse Spark 1.2 | Muse Spark 1.1 | Änderung |
|---|---|---|---|
| Reasoning | $339.82 | $360.53 | -$20.71 |
| Cache-Lesen | $136.85 | $71.76 | +$65.09 |
| Cache-Schreiben | $82.21 | $62.01 | +$20.20 |
| Antwort (Output) | $63.61 | $37.42 | +$26.18 |
| Input ohne Cache | $16.78 | $15.59 | +$1.19 |
| Gesamt | $639.27 | $547.32 | +$91.96 |
Reasoning ist die einzige Zeile, die günstiger wurde. 1.2 gab $20.71 weniger für verdeckte Denk-Tokens aus als 1.1. Der Anstieg kam von überall sonst, und das Cache-Lesen ist mit fast einer Verdopplung der größte Treiber.
Die Token-Zahlen pro Aufgabe erklären, warum. Die Antwort-Tokens pro Aufgabe stiegen von 7.237 auf 12.874, ein Sprung von 78 %. Die Reasoning-Tokens pro Aufgabe stiegen nur um 16 %, von 15.158 auf 17.557. Gleichzeitig lief der gesamte Index mit etwa demselben Output-Budget, 95 Mio. Tokens gegen 94 Mio.
Die praktische Übersetzung lautet: Muse Spark 1.2 denkt nicht härter als 1.1, es schreibt länger. Wenn Ihr Workload KI-Agenten über mehrere Runden laufen lässt, fließen ausführlichere Antworten direkt in den Kontext des nächsten Aufrufs zurück, genau der Mechanismus, der die Cache-Lese-Zeile verdoppelt hat. Ausführlichkeit summiert sich auf eine Weise, wie es reines Nachdenken nicht tut.
Das ist ein Hebel, den Sie tatsächlich bedienen können. Fordern Sie kürzere Antworten an, begrenzen Sie die Output-Tokens und kürzen Sie die Teile Ihrer Prompt-Kette, die frühere Antworten weitertragen. Das ist gewöhnliche LLM-Optimierung, dieselbe Disziplin, die die Anthropic-API-Preise berechenbar hält, und derselbe Grund, warum die OpenAI API Leute überrascht, die nie auf die Output-Länge schauen.
Der Contributor-Tarif ist 12,5-mal günstiger und 30-mal enger
Die Zwei-Preis-Struktur ist das, was alle über Muse Spark zitieren, meist falsch, weil der Rabatt bei Input und Output verschieden ist. Input fällt um das 12,5-Fache. Output um das 21,25-Fache. Gecachter Input um das 75-Fache.
Metas Formulierung ist ungewöhnlich direkt. Die Dokumentation beschreibt Contributor als "heavily discounted token pricing in exchange for permission", mit Ihren Prompts und Completions künftige Modelle zu trainieren, gedacht für "prototyping, testing integrations, and scaling experiments where training on your data is acceptable." Und der Tarif ist keine Kontoeinstellung, die man umlegt. In Metas Worten: "Tier is a model attribute". Sie widersprechen dem Training, indem Sie eine andere Modell-ID aufrufen.
Der Hacker-News-Thread am Launch-Tag drehte sich fast ausschließlich darum, ob dieser Handel fair ist, und die Meinungen gingen scharf auseinander.
"What are you talking about? This is one of the most honest offers ever made by a corporation. "We'll use your data, and we'll compensate you for it." Where is the problem?"

Nicht alle fanden, dass das Versprechen des Standard-Tarifs den Aufpreis wert ist. Als ein Kommentator argumentierte, Meta trainiere unabhängig von der Rechnung mit allem, widersprach Simon Willison mit einer sarkastischen Darstellung dessen, was dieser Vorwurf tatsächlich bedeutet: dass ein Unternehmen zwei Datenrichtlinien drucken und eine davon wissentlich verletzen würde. Der vertragliche Unterschied ist das Produkt.
Aber das Argument, das niemand führte, ist für ein Produktionsbudget das wichtigste. Hier sind die veröffentlichten Limits:
| Tarif | Anfragen pro Minute | Tokens pro Minute |
|---|---|---|
| Standard | 3,000 | 4,000,000 |
| Contributor | 100 | 3,000,000 |
Der Contributor-Tarif kostet 12,5-mal weniger pro Input-Token und erlaubt 30-mal weniger Anfragen pro Minute. Die Token-Obergrenze sinkt nur um 25 %, die Drosselung ist also absichtlich ungleichmäßig. Meta hat gezielt den Anfrage-Pfad zusammengedrückt. Contributor ist auf Volumen bepreist und für Prototyping begrenzt, eine stimmige Produktentscheidung und eine unangenehme Überraschung, wenn man sie erst nach dem Bauen entdeckt.
Ein X-Nutzer ist direkt darauf gestoßen und hat es in fünf Worten gesagt: Die Anfragen pro Minute "seem to be severely limited". Das ist der einzige konkrete Rate-Limit-Bericht, den ich auf einer überprüfbaren Plattform finden konnte, was zeigt, wie wenige Leute Contributor über einen Hobby-Workload hinaus belastet haben.
Zwei weitere Mechaniken, die Sie kennen sollten, bevor Sie um diese Zahlen planen. Limits werden pro Team gebündelt, nicht pro API-Key, weitere Keys schaffen also keinen zusätzlichen Spielraum. Und Background Responses haben zusätzlich zu RPM und TPM ein eigenes Limit von 600 Übermittlungen pro Minute und Team.
Finden Sie heraus, welchen Tarif Sie tatsächlich nutzen können
Der Preis ist die zweite Frage. Der Durchsatz ist die erste, denn kein Rabatt hilft, wenn die Obergrenze unter Ihrer Untergrenze liegt. Geben Sie hier Ihre Zahlen ein, und die Antwort ergibt sich.
Die Zähler neben dem Token-Zähler
Token-Preise sind die Schlagzeile, aber nicht die ganze Rechnung. Vier andere Dinge berechnen oder begrenzen Sie.
Web-Search-Grounding wird separat abgerechnet mit 2,50 $ pro 1.000 Suchanfragen, zusätzlich zu den Tokens der Anfrage. Wenn Ihr Agent jede Antwort mit Suche untermauert, läuft ein zweiter Zähler parallel zum ersten, und er fehlt am ehesten in einer Tabelle, die auf der Modellseite aufbaut.
Es gibt keine Batch-API und keinen Batch-Rabatt. Die Navigation der Dokumentation führt gar keine Batch-Oberfläche auf. Der einzige asynchrone Weg sind Background Responses, ein Übermittlungsmodus mit eigenem Limit und kein rabattierter Tarif. Wenn Sie mit den Batch-Rabatten gerechnet haben, die andere Anbieter veröffentlichen, existiert diese Ersparnis hier nicht.
Es gibt kein Fine-Tuning-Angebot für Muse Spark. Die Modell-Dokumentation listet drei Inferenz-Modell-IDs und sonst nichts. Fine-Tuning auf Metas Entwicklerseite betrifft Llama-Gewichte, ein anderes Produkt mit anderer Kostenstruktur.
Es gibt kein hartes Ausgabenlimit, und das ist die Beschwerde, die Leute tatsächlich vom Anmelden abgehalten hat. Zwei verschiedene Hacker-News-Nutzer sagten am selben Tag dasselbe.
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Das ist eine Lücke in der Abrechnungs-UX und keine beim Preis, und sie ist an einem Nachmittag behebbar, aber bei einem Modell, dessen ganzer Pitch günstige Tokens sind, ist es bemerkenswert, dass die Conversion am fehlenden Deckel scheitert.
Wie die Preise von Muse Spark 1.2 im Vergleich abschneiden
Listenpreise schmeicheln und täuschen in beide Richtungen, die entscheidende Spalte sind also die gemessenen Kosten pro Aufgabe bei einem festen Benchmark. Hier ist Muse Spark gegen die Modelle, mit denen es tatsächlich konkurriert, nach den Zahlen der Rangliste von Artificial Analysis.
| Modell | Intelligence Index | Kosten pro Aufgabe | Gemischt $/Mtok | Input | Output |
|---|---|---|---|---|---|
| Claude Opus 5 (max) | 63.05 | $2.34 | $3.85 | $5.00 | $25.00 |
| GPT-5.6 Sol (max) | 60.93 | $1.23 | $4.35 | n/a | n/a |
| Kimi K3 (max) | 59.70 | $0.84 | $2.31 | $3.00 | $15.00 |
| Qwen3.8 Max | 58.08 | $1.13 | $1.18 | $2.00 | $6.00 |
| Muse Spark 1.2 (xhigh) | 56.76 | $0.40 | $0.78 | $1.25 | $4.25 |
| GPT-5.6 Terra (max) | 56.58 | $0.51 | $1.74 | n/a | n/a |
| Gemini 3.7 Flash (high) | 56.03 | $0.40 | $0.58 | $0.75 | $3.75 |
| GPT-5.6 Luna (max) | 52.32 | $0.05 | $0.17 | n/a | n/a |
| DeepSeek V4 Flash (max) | 51.77 | $0.11 | $0.23 | $0.44 | $1.32 |
Die Lesart aus Käufersicht ist eindeutig, und sie ist gut für Meta. Muse Spark 1.2 ist das günstigste Modell auf dieser Liste mit einem Wert über 56. Alles Klügere kostet mindestens 2,8-mal mehr pro Aufgabe. Opus 5 liegt beim 5,9-Fachen. Der nächste direkte Vergleich ist GPT-5.6 Terra, das im Grunde gleichauf liegt und $0.51 kostet gegen $0.40 bei Muse Spark, Meta ist bei gleicher Intelligenz also 22 % günstiger.
Eine Korrektur, die man beachten sollte, weil sie Vergleiche zwischen Beiträgen verfälscht. Artificial Analysis mischt auf diesen Seiten im Verhältnis 7:2:1 aus Cache-Treffer, Input und Output und nicht im älteren, weit verbreiteten Verhältnis 3:1 aus Input und Output. Die Rechnung geht auf: (0.7 × $0.15) + (0.2 × $1.25) + (0.1 × $4.25) = $0.78. Wenn Sie einen gemischten Wert sehen, der auf einer 3:1-Annahme beruht, ist er mit dieser Tabelle nicht vergleichbar.
Und GPT-5.6 Luna ist die Zeile, die jede einfache Geschichte vom Günstigen als Schwachen widerlegt: $0.05 pro Aufgabe, achtmal günstiger als Muse Spark, bei 52,3 im Index. Mein Beitrag zu GPT-5.6 Luna geht darauf ein, worauf es dafür verzichtet.
Für die Zeilen unmittelbar über Muse Spark enthalten die Kimi K3 Preise die vollständige Preisliste. Die Open-Weights-Option am günstigen Ende der Liste steht in meinem DeepSeek V4 Flash Test.
Was die Preisliste auslässt
Ein Preisbeitrag sollte bei den Lücken so klar sein wie bei den Zahlen, denn an den Lücken geht ein Budget schief.
Geschwindigkeit und Latenz sind für 1.2 unveröffentlicht. Artificial Analysis hat für diesen Checkpoint keine Messung zu Output-Geschwindigkeit, Time-to-First-Token oder End-to-End-Antwortzeit, und die Rangliste zeigt in allen drei Spalten einen Strich. Muse Spark 1.1 hat sie, mit 225,9 Tokens pro Sekunde und 1,38 Sekunden bis zum ersten Token, aber diese gehören zum alten Checkpoint und sollten nicht 1.2 zugeschrieben werden. Wenn die Antwortzeit Teil Ihrer Kostenrechnung ist, warten Sie auf Daten, die es noch nicht gibt.
Es gibt kein Zero-Data-Retention-Programm. Ich habe die gesamte Navigation der Dokumentation geprüft und keine Seite zu Datenaufbewahrung, Datenschutz oder ZDR gefunden, weder Self-Service noch vertriebsgesteuert. Die nächste Kontrolle ist ein Flag für die Antwortspeicherung: store: false in der Responses API verhindert, dass GET /v1/responses/{id} Ihre Antwort zurückgibt, und Meta stellt klar, dass es "does not disable caching." Der Tarif ist der einzige Hebel für Daten.
Die API ist noch in der Public Preview. Metas Produktseite beginnt jetzt mit "Public preview. Now available with expanded global access", was besser ist als die geografisch beschränkte Darstellung zum Launch, aber Preview bleibt Preview. Preise und Limits auf einer Preview-Oberfläche können sich ändern, anders als bei einer Preisliste in allgemeiner Verfügbarkeit.
Und ein kleinerer Punkt, der zählt, wenn Sie den günstigen Tarif testen: Der Zugang kann entzogen werden. Ein Entwickler meldete mitten in der Arbeit einen 403-Fehler, ohne Vorwarnung, mit dem Text "Your access has been restricted due to repeated policy violations". Contributor ist wie eine Aktion bepreist und wie eine Aktion begrenzt.
Was ein Entwickler tatsächlich bezahlt hat
Alles oben sind Listenpreise und Benchmark-Läufe. Der nützlichste Datenpunkt, den ich fand, ist jemand, der seine echten Sitzungskosten meldet, was seltener ist, als es sein sollte.
"even with this subsidized pricing, less than an hour of usage resulted in slightly over $1 of cost (fig. 1). if i do this all month it'll be more expensive than the highest Anthropic/OpenAI subscription"
Das war im Contributor-Tarif, dem günstigen, den Leute am Launch-Tag als absurd unterbepreist bezeichneten. Eine Stunde agentische Programmierarbeit kam bei 0,10 $ pro Million Input-Tokens auf über einen Dollar.
Denselben Punkt machte innerhalb eines Tages nach dem Launch ein Praktiker auf LinkedIn, als Warnung statt als Beleg.
"But token price isn't the full picture. What matters is cost per task. Different models burn different amounts of tokens to solve the same problem. We don't have that data yet for Muse Spark 1.2. Cheap tokens mean nothing if the model takes twice as many shots to get there."

Er schrieb das, bevor die Daten zu den Kosten pro Aufgabe existierten. Die Daten kamen und gaben ihm recht, in eine Richtung, die niemand vorhergesagt hatte: 1.2 verbraucht mehr Tokens als sein Vorgänger, weil es länger antwortet, während sein Denken etwas günstiger wurde.
Warum Tokens die falsche Einheit für eine Support-Queue sind
Ich beobachte bei eesel seit drei Jahren, wie KI Live-Support-Queues bearbeitet, und in dieser ganzen Zeit habe ich nie ein Team gesehen, das eine Support-Rechnung erfolgreich aus einer Token-Preisliste vorhergesagt hat. Die Rechnerei ist einfach genug. Die Einheit überlebt nur den Kontakt mit einem echten Ticket nicht.
Ein gelöstes Ticket ist nicht ein Prompt. Es ist Retrieval über ein Help Center und eine Makro-Bibliothek, ein Durchgang zur Ticket-Klassifizierung, ein Entwurfsdurchgang, meist eine Wiederholung, wenn der erste Entwurf falsch ist, manchmal ein Tool-Aufruf, um eine Bestellung nachzuschlagen, und dann die ganze Konversation als Kontext weitergetragen, wenn der Kunde antwortet. Jeder dieser Schritte multipliziert. Ein günstiger Preis pro Token, multipliziert mit einer unbekannten Zahl von Schritten, ist kein Budget, sondern eine Hoffnung. Welches Modell Sie wählen, zählt weit weniger als diese Struktur, wie ich bei der Wahl des besten Modells für Support-Tickets argumentiert habe.
Und Sie können mit echten Zahlen sehen, wie das schiefgeht. Support-Teams unterschätzen regelmäßig um einen Faktor, und am schlimmsten trifft es die mit dem höchsten Volumen, gerade weil sich der Multiplikator aufsummiert. Das ist dieselbe strukturelle Falle wie in der Muse-Spark-1.2-Geschichte: Der Preis blieb gleich, und der Verbrauch bewegte sich. Meine Übersicht zu den Kosten für KI im Kundenservice zeigt das vollständigere Bild dessen, was Teams am Ende zahlen.
Deshalb berechnet eesel 1 Credit pro Ticket, egal wie lang, statt pro Token oder pro Arbeitsplatz, und es ist das Erste, was ich jedem sage, der mit einer Token-Preisliste ankommt. Eine Lösung ist die Einheit, die das Unternehmen ohnehin zählt, sie lässt sich einer Support-Leitung im Budgetgespräch erklären, und sie preist sich nicht still um, wenn ein Modell längere Antworten schreibt. Dasselbe Argument steht hinter meinem Ansatz zu den Kosten pro Lösung.
Es ist auch der Grund, warum der Zähler ans Ticketsystem gehört und nicht ans Modell, und warum der ehrliche Vergleich für eine Support-Leitung gegen einen Menschen läuft und nicht gegen eine API. Das habe ich bei den Kosten von KI gegen menschliche Agenten durchgerechnet.
Die andere Hälfte ist, die Zahl zu kennen, bevor man sich festlegt. Ich simuliere jeden Rollout vorab gegen die historischen Tickets eines Kunden, was eine Lösungsquote und Kosten gegen echten Traffic liefert statt gegen einen Benchmark. Diese Gewohnheit kam daher, dass ich selbstsicher klingende Bots in der Produktion leise falsche Antworten geben sah, eine eigene Disziplin, die in KI-Halluzinationen verhindern behandelt wird, und sie löst nebenbei auch das Prognoseproblem. Mehr dazu steht im Leitfaden Selbst bauen oder kaufen, der die Entscheidung behandelt, die die meisten Leser einer Preisliste tatsächlich treffen.
eesel ausprobieren
Wenn Sie Muse Spark 1.2 kalkulieren, weil Sie Support-Automatisierung auf einer rohen Modell-API aufbauen wollen, ist der Token-Preis die uninteressanteste Zahl im Projekt. eesel setzt auf Ihrem Helpdesk auf, liest Ihre bestehende Wissensdatenbank und vergangene Tickets und beginnt innerhalb von Minuten, Erstkontakt-Konversationen zu lösen, zu 1 Credit pro Ticket, sodass die Rechnung geleistete Arbeit abbildet und nicht verbrauchte Tokens.
Zuerst lohnt sich die Simulation. Richten Sie sie auf Ihren Ticketverlauf, und bevor etwas in die Nähe eines Kunden kommt, erhalten Sie eine Lösungsquote und prognostizierte Kosten auf Ihrem eigenen Traffic, also die Prognose, die eine Token-Preisliste strukturell nicht liefern kann.

Ein Engineering Lead, der genau diese Entscheidung getroffen hat, begründete es schlicht. Anonymisiert, er leitet ein Bitcoin-Automaten-Hardwareunternehmen mit einer Wissensdatenbank aus über 300 Artikeln in Confluence und Telegram:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Kostenlos testbar, und Sie sehen die simulierten Zahlen, bevor Sie irgendetwas entscheiden.
Das Fazit zu den Preisen von Muse Spark 1.2
Mit 1,25 $ Input und 4,25 $ Output ist Muse Spark 1.2 der beste Gegenwert auf der Frontier-Liste über 56 im Intelligence Index, und Meta verdient Anerkennung dafür, beim Upgrade nicht neu bepreist zu haben, für den fehlenden Aufschlag bei langem Kontext und dafür, Caching automatisch statt als Konfigurationsaufgabe zu gestalten.
Planen sollten Sie damit, dass das Modell im Betrieb 37 % teurer wurde, ohne dass sich der Preis änderte, weil es 78 % länger antwortet als 1.1. Begrenzen Sie Ihre Output-Tokens, achten Sie darauf, was Ihre Prompt-Kette weiterträgt, und prüfen Sie Ihre Spitzenlast an Anfragen pro Minute, bevor Sie annehmen, dass der Contributor-Tarif für Sie überhaupt infrage kommt.
Und wenn der Workload eine Support-Queue ist, kalkulieren Sie in Lösungen. Das ist die einzige Einheit, die je eine echte Rechnung überstanden hat.