

Wie viel kostet Meta Muse Wonder?
Muse Wonder erschien am 12. Oktober 2026 als erste Frontier-Modellfamilie von Meta Superintelligence Labs. Ich bin Softwareentwickler mit ein paar Jahren SEO-Erfahrung, und als ich mir ansah, wonach Leute direkt nach dem Launch suchen, waren "Muse Wonder Preise" eigentlich zwei Fragen in einer: Was kostet ein Token, und welches Wonder bekomme ich für dieses Geld überhaupt? Dieser Beitrag beantwortet beides, direkt aus Metas eigener Seite zu Preisen und Rate Limits, der Modell-Dokumentation und den Abo-Bedingungen.
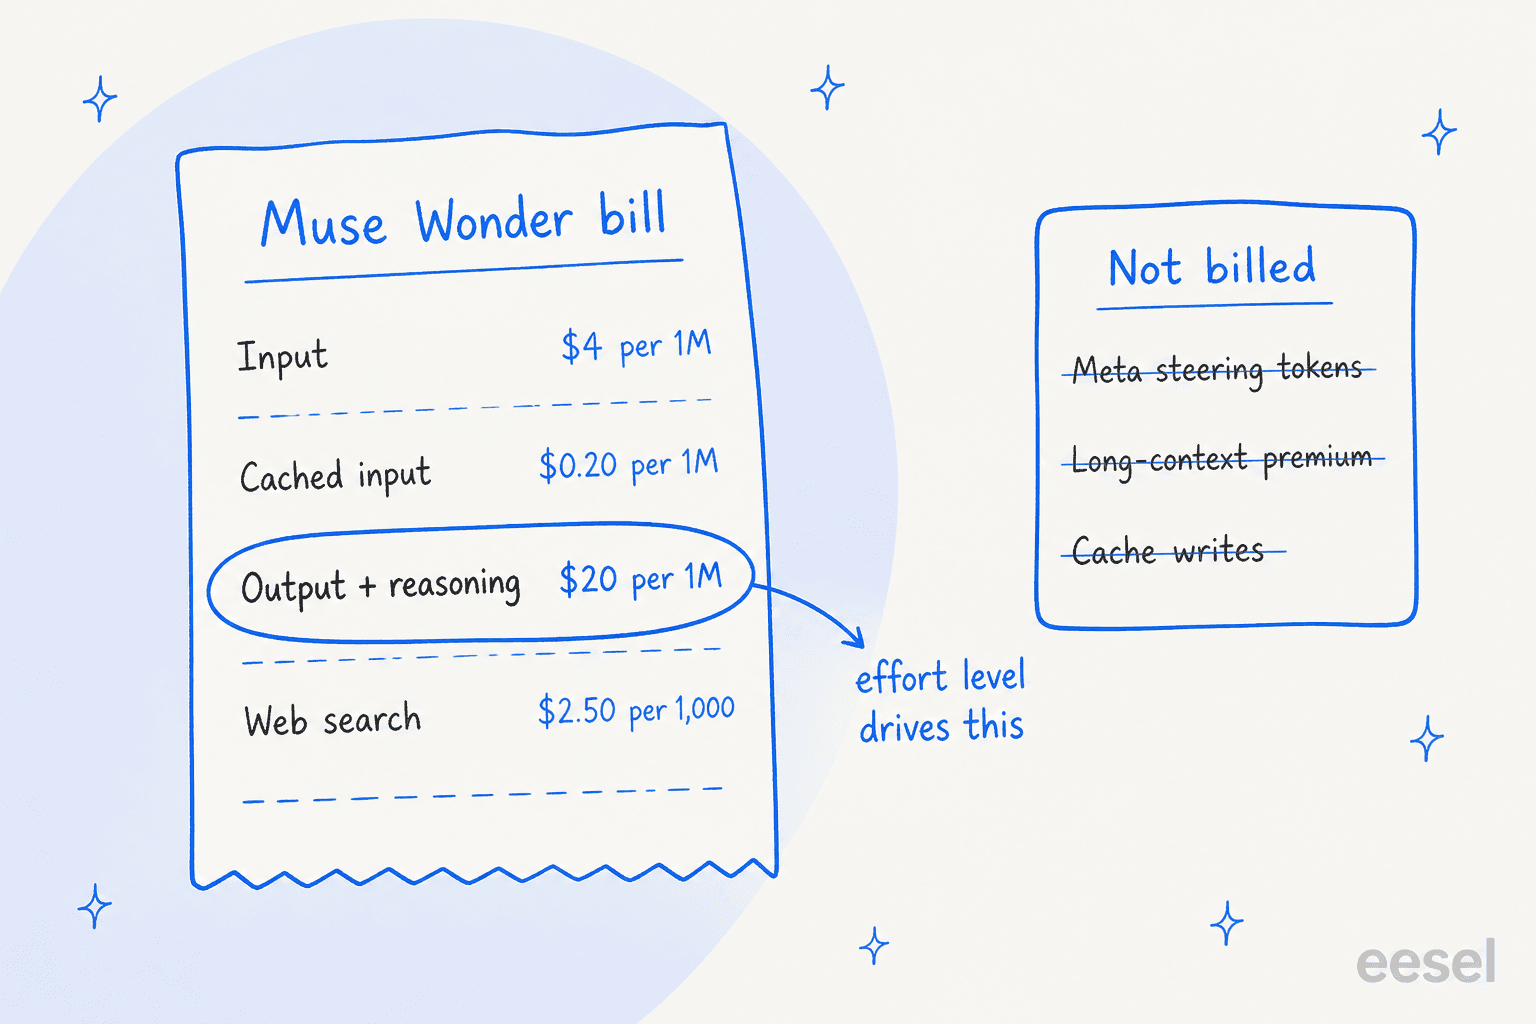
Hier die vollständige API-Preisliste für muse-wonder-1.0:
| Wofür du zahlst | Muse Wonder (Standard-Modus) | Contributor-Modus |
|---|---|---|
| Input | 4,00 $ pro 1 Mio. Tokens | Nicht verfügbar |
| Gecachter Input | 0,20 $ pro 1 Mio. Tokens | Nicht verfügbar |
| Output (inklusive Reasoning) | 20,00 $ pro 1 Mio. Tokens | Nicht verfügbar |
| Websuche (Grounding) | 2,50 $ pro 1.000 Anfragen | Nicht verfügbar |
| Aufschlag für langen Kontext | Keiner | n/a |
| Rate Limit | 3.000 Anfragen und 4 Mio. Tokens pro Minute, pro Team | n/a |
Zwei Dinge unterscheiden diese Preisliste von den meisten Frontier-Modellen. Meta berechnet denselben Preis, egal ob dein Kontextfenster mit 1.048.576 Tokens "mostly empty or almost full" ist, und der Steuerungskontext, den Meta in jeden Prompt einfügt, ist "not billed". OpenRouter listet Wonder mit denselben 4 $/20 $ und derselben Suchgebühr von 2,50 $, die Rechnung ändert sich also auch über einen Router nicht.
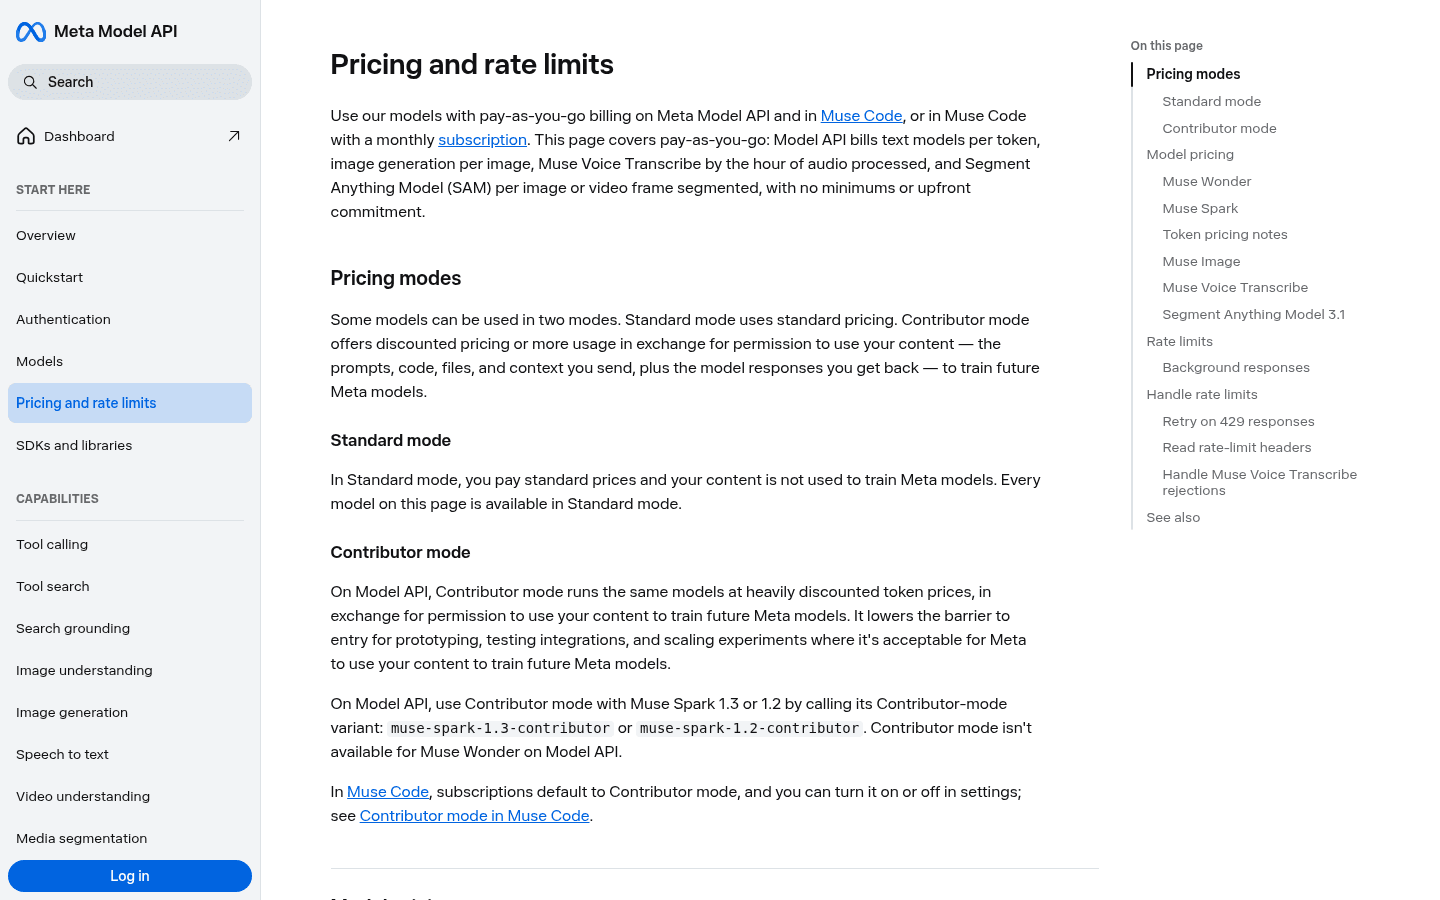
Die fehlende Stufe ist die eigentliche Geschichte. Bei Muse Spark 1.3 senkt der Contributor-Modus den Preis auf 0,10 $ Input und 0,20 $ Output, wenn du Meta auf deinen Inhalten trainieren lässt. Metas Seite sagt klar: "Contributor mode isn't available for Muse Wonder on Model API." Zum ersten Mal ist Meta nicht die günstige Option im Raum.
Woraus sich eine Muse-Wonder-Rechnung wirklich zusammensetzt
Ein Token-Preis nennt nur den Tarif. Deine Rechnung hängt davon ab, welche Tokens du erzeugst, und bei einem Reasoning-Modell ist das vor allem Output.
Metas Reasoning-Dokumentation nennt drei Regeln, die du vor der Budgetplanung kennen solltest:
- Reasoning-Tokens werden als Output abgerechnet. "Reasoning tokens are billed at the same rate as visible output tokens." Sie erscheinen nicht in der Antwort, tauchen aber als
reasoning_tokensim usage-Objekt auf und kosten 20 $ pro Million. - Reasoning lässt sich nicht abschalten. Wird der Effort auf "none" gesetzt, antwortet Wonder mit HTTP 400. Die günstigste Einstellung ist "minimal", die Skala reicht hinauf über low, medium, high und xhigh bis max.
- Max kostet mehr, nicht mehr pro Token. Die Stufe "max" nutzt "more reasoning tokens at the same per-token price." Und in der API schaltet max Wonder Full nicht frei.
Der Effort-Level ist also der größte Preisregler, den du in der Hand hast, weit mehr als die Input-Seite. Meta veröffentlicht nicht, wie viele Reasoning-Tokens jede Stufe bei Wonder verbraucht, miss das also an deinen eigenen Prompts, bevor du dich auf eine Monatsschätzung festlegst. Metas eigener Rat lautet, "the lowest level that gives you acceptable results" zu verwenden.
Caching spielt dir hier in die Hände. Metas Prompt-Caching läuft automatisch: keine Flags, keine Cache-Keys nötig und keine Zusatzgebühr fürs Speichern eines Präfixes. Wiederholte System-Prompts und Gesprächsverläufe fallen von 4 $ auf 0,20 $ pro Million, ein Rückgang um 95 % auf diesen Teil des Inputs. Stabile Inhalte nach vorn, die variable Nachricht ans Ende, und der Großteil des Inputs eines langen Chats landet im gecachten Tarif.
Gleiche Preisliste wie Claude Opus 5.5, andere Rechnung
Zum Launch fasste ein Hacker-News-Kommentator die Preisreaktion in einer Zeile zusammen:
"$4/$20 in vs out making it higher than Sol and on par with Opus."

Auf dem Papier stimmt das genau. Muse Wonder und Claude Opus 5.5 haben 4 $ Input, 0,20 $ Cache-Lesezugriffe und 20 $ Output gemeinsam. Aber die beiden Preislisten behandeln alles rund um diese Zahlen unterschiedlich, und dort verschiebt sich deine Rechnung.
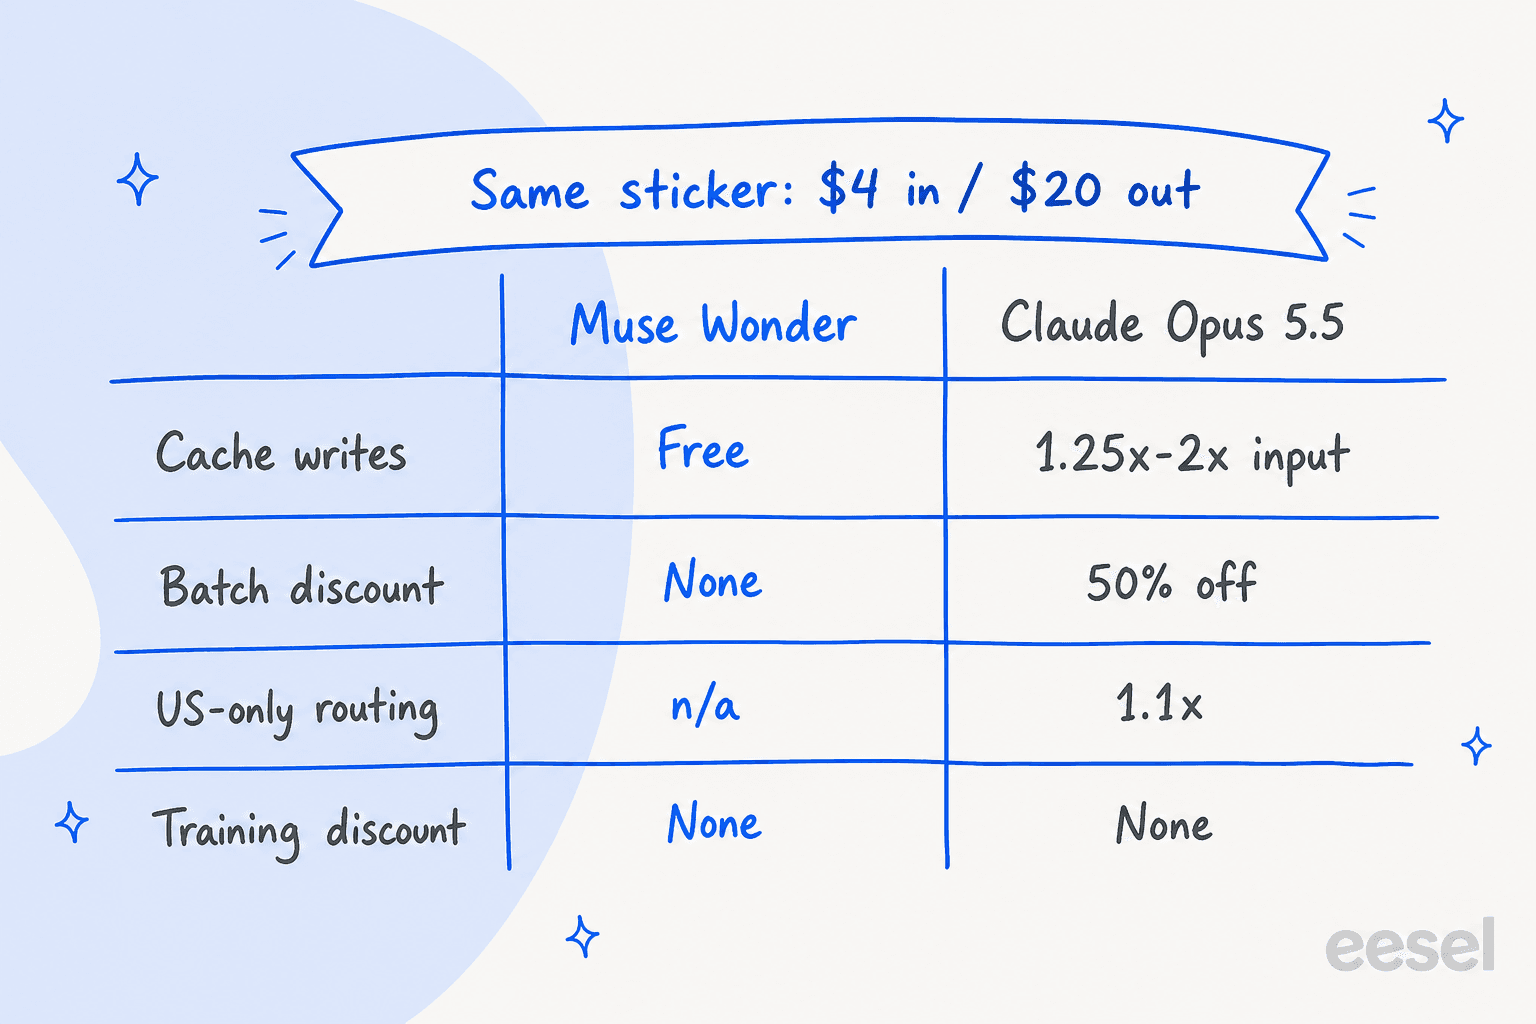
| Preisdetail | Muse Wonder | Claude Opus 5.5 |
|---|---|---|
| Input / gecacht / Output pro 1 Mio. | 4,00 $ / 0,20 $ / 20,00 $ | 4,00 $ / 0,20 $ / 20,00 $ |
| In den Cache schreiben | Keine Gebühr | 5 $ pro 1 Mio. (5 Minuten) oder 8 $ pro 1 Mio. (1 Stunde) |
| Batch-Rabatt | Keiner aufgeführt | 50 % Rabatt: 2 $ Input, 10 $ Output |
| Option für schnellere Ausgabe | Keine aufgeführt | Fast Mode zu 8 $ Input, 40 $ Output |
| Regional gebundenes Routing | Keines aufgeführt | 1,1x für Inferenz nur in den USA |
| Aufschlag für langen Kontext | Keiner | Keiner |
| Rabatt für Datenfreigabe | Keiner | Keiner |
Die Opus-Zahlen stammen von Anthropics Preisseite. Lies die Tabelle als zwei Abwägungen:
- Interaktive, cachelastige Arbeit spricht für Wonder. Jedes Mal, wenn Opus 5.5 ein Präfix in den Cache schreibt, berechnet es für diese Tokens das 1,25- oder 2-Fache des Input-Preises. Wonder nicht. Bei einer Chat-App oder einem Coding-Agent, der seinen Cache häufig neu aufbaut, ist das eine kleine, aber echte Ersparnis.
- Alles, was warten kann, spricht für Opus. Anthropics Batch API halbiert Input und Output. Metas Preisliste führt keinen Batch-Rabatt auf (die Funktion für Hintergrundantworten hat ein Einreichungslimit, keinen niedrigeren Preis). Ein nächtlicher Job, der 100 Mio. Tokens an Dokumenten zusammenfasst und 5 Mio. Tokens zurückschreibt, kostet bei Wonder 500 $ und bei Opus 5.5 Batch 250 $.
Die andere Sicht ist Leistung pro Dollar. Im Artificial-Analysis-Index, den Meta in seinem Launch-Beitrag zeigt, erreicht das API-Modell 52 Punkte und Opus 5.5 58 Punkte, bei gleichem Preis. Mein Muse-Wonder-Test geht alle 14 Benchmark-Zeilen durch, aber die Kurzfassung lautet: Das Modell, das sechs davon gewinnt, Wonder Full, steht nicht auf dieser Preisliste.
So steht Wonder im Vergleich zum restlichen Feld, jeweils zu Standardpreisen von der Seite des jeweiligen Anbieters:
| Modell | Input pro 1 Mio. | Gecachter Input pro 1 Mio. | Output pro 1 Mio. | Batch-Rabatt |
|---|---|---|---|---|
| Muse Wonder | 4,00 $ | 0,20 $ | 20,00 $ | Keiner aufgeführt |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ | 50 % |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ | 50 % |
| Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ | 50 % |
| Muse Spark 1.3 | 1,25 $ | 0,15 $ | 4,25 $ | Keiner aufgeführt |
| Muse Spark 1.3 Contributor | 0,10 $ | 0,002 $ | 0,20 $ | Keiner aufgeführt |
Gib dein eigenes Monatsvolumen in den Rechner unten ein. Das letzte Feld, Arbeit, die einen Tag warten kann, übergehen die meisten Launch-Berichte.
Muse Wonder Full Preise: nur über Muse Code
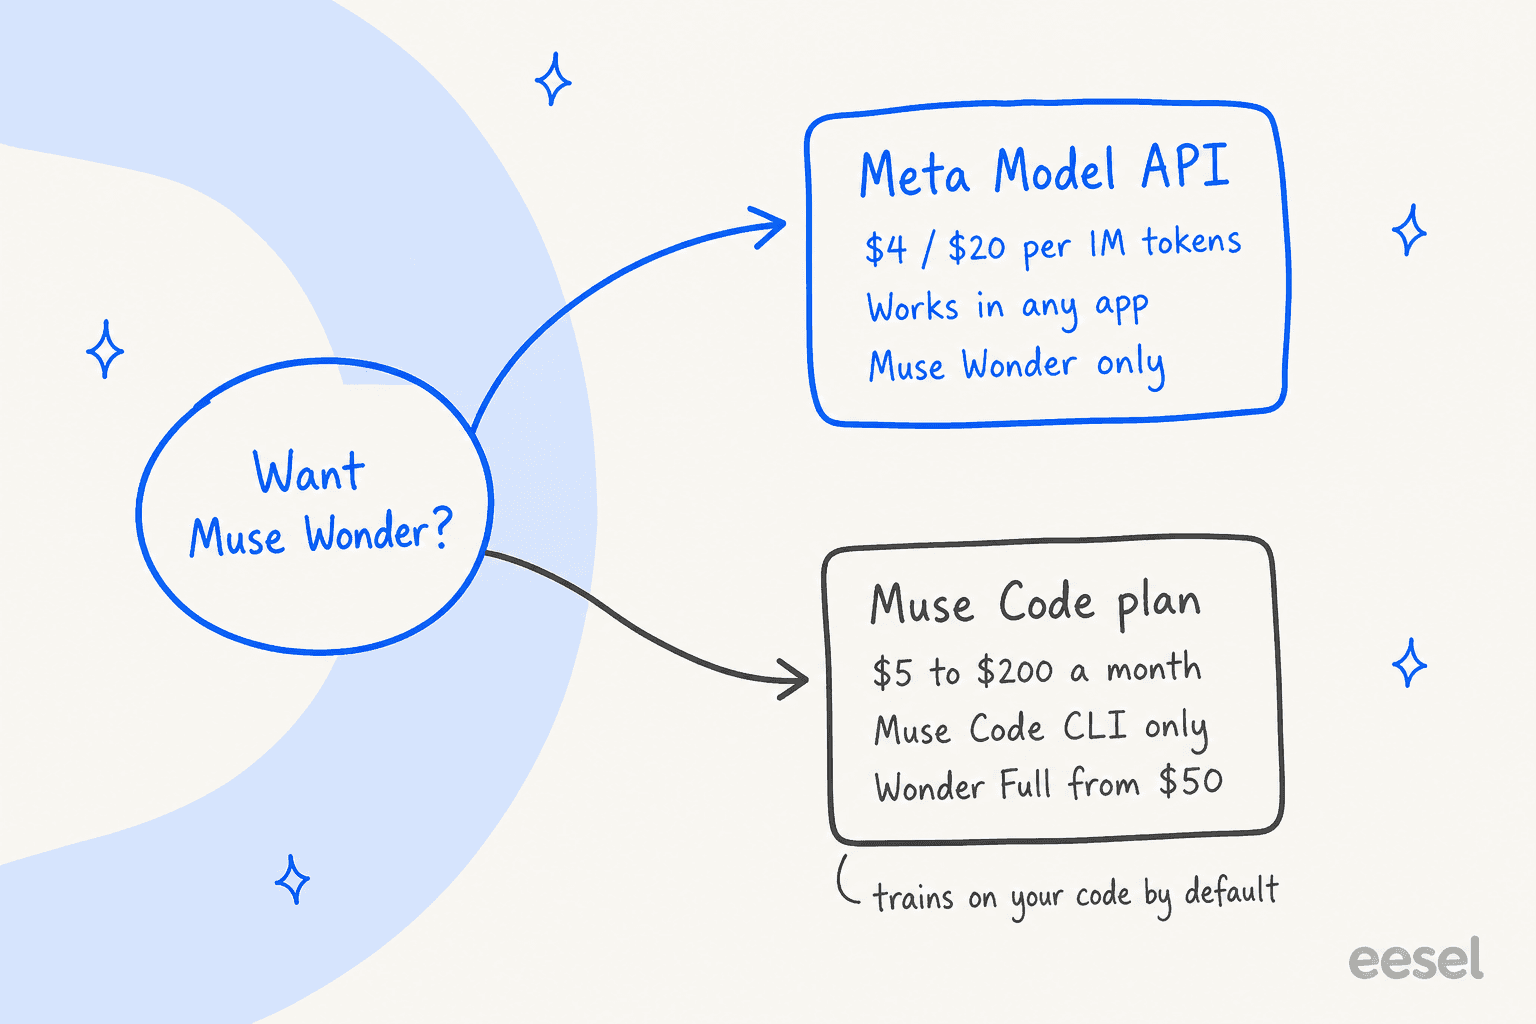
Wenn du wegen des Benchmark-Diagramms hier bist, gilt der Token-Preis oben nicht für dich. Metas Modell-Dokumentation führt Wonder Full in der Model API als "Not available". Es wird nur in Metas Coding-Agent Muse Code verkauft, in den beiden obersten Abo-Plänen.
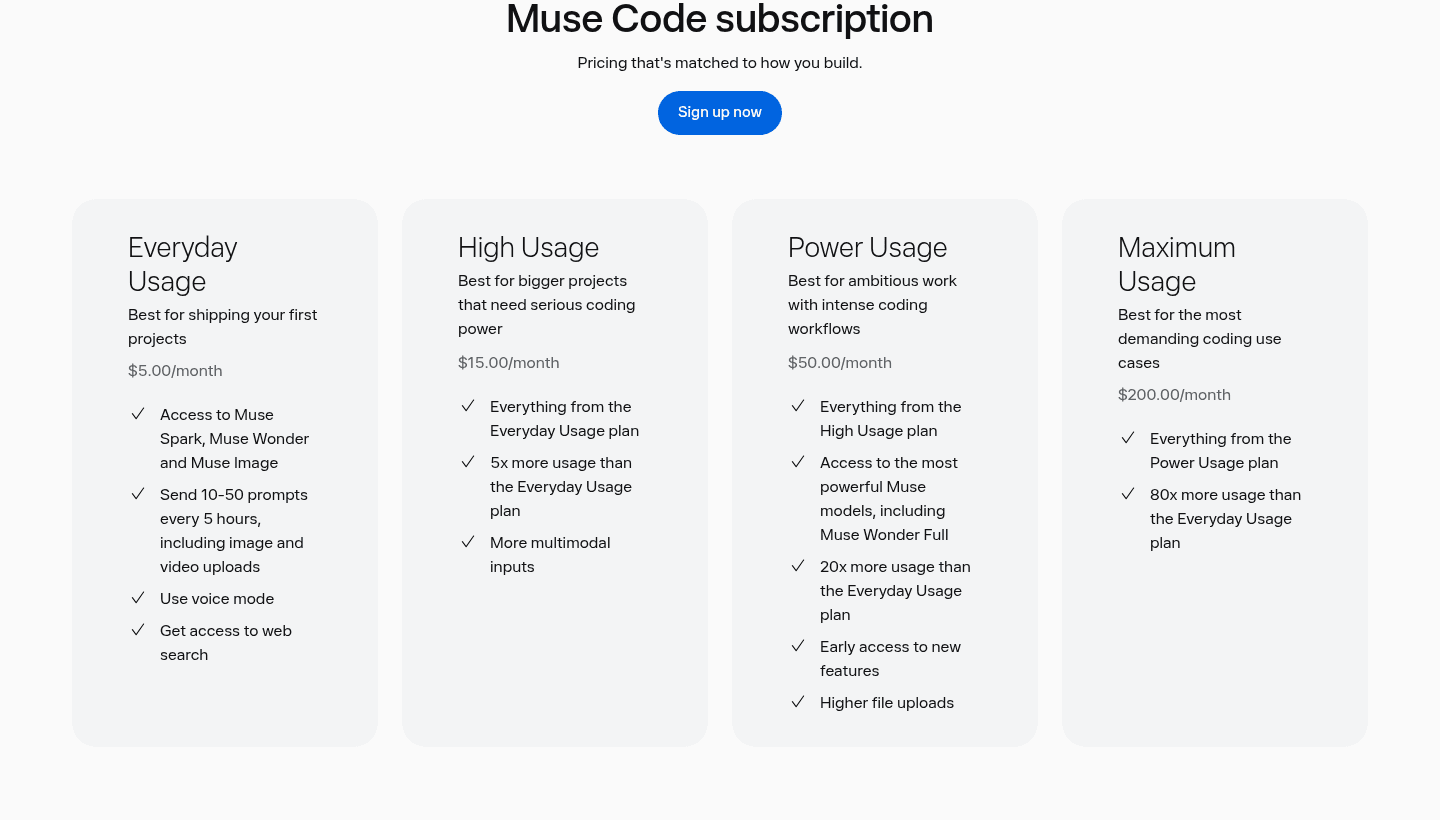
| Plan | Preis | Nutzungskontingent | Muse Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | 5 $/Monat | 10-50 Prompts alle 5 Stunden | Ja | Nein |
| High Usage | 15 $/Monat | 5x Everyday | Ja | Nein |
| Power Usage | 50 $/Monat | 20x Everyday | Ja | Ja |
| Maximum Usage | 200 $/Monat | 80x Everyday | Ja | Ja |
Die Preise stammen von der Muse-Code-Seite. Die Abo-Regeln enthalten fünf Details, die die echten Kosten verändern:
- Der Schlüssel funktioniert nur in Muse Code. Ein Abo "works only through the Muse Code CLI." Jeder andere API-Schlüssel, den du erstellst, wird nutzungsbasiert abgerechnet, ein Plan für 50 $ kann also kein eigenes Produkt antreiben.
- Der Contributor-Modus ist standardmäßig aktiv. Pläne "default to Contributor mode", was dir mehr Nutzung gibt, wenn Meta dafür auf deinen Prompts, deinem Code und deinen Dateien trainiert. Du kannst ihn jederzeit ausschalten.
- Limits gelten für Prompts, nicht für Tokens. Erreichst du dein Limit, wechselst du in einen höheren Plan oder wartest auf die Aktualisierung. Bei Maximum Usage gibt es nichts mehr zum Hochstufen, also wartest du.
- Upgrades werden anteilig berechnet, Downgrades warten. Ein Upgrade "takes effect immediately" mit anteiliger Abrechnung; ein Downgrade beginnt im nächsten Abrechnungszeitraum.
- Keine Rückerstattung. Wenn du kündigst, behältst du den Zugang bis zum Ende des Zeitraums, ohne Gutschrift "unless required by law". Du musst mindestens 18 sein, und die Verfügbarkeit "may vary by region".
Beim Einstiegsplan fand ein früher Nutzer das Kontingent knapp:
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
Einen vollständigen Blick auf die Kosten des Coding-Agents jenseits von Wonder findest du in meinem Leitfaden zu den Muse-Code-Preisen, und vergleiche ihn mit den Claude-Code-Preisen bei gleichem Budget.
Was Muse Wonder in der Praxis kostet: drei Rechenbeispiele
Tarife lassen sich leicht vergleichen, Rechnungen nicht, deshalb hier drei beispielhafte Workloads. Die Token-Volumen sind meine Annahmen, gewählt als runde und realistische Werte, keine von Meta veröffentlichten Zahlen. Alle Preise sind die Standardtarife von Meta und Anthropic.
1. Ein einzelner Entwickler mit einem Coding-Agent. Sagen wir 150 Mio. Input-Tokens im Monat, davon 90 % gecacht (dein Repo-Kontext wird ständig wiederverwendet), und 4 Mio. Output-Tokens inklusive Reasoning.
| Muse Wonder API | Muse Code Power Usage | |
|---|---|---|
| Ungecachter Input (15 Mio.) | 60 $ | Inklusive |
| Gecachter Input (135 Mio.) | 27 $ | Inklusive |
| Output (4 Mio.) | 80 $ | Inklusive |
| Monatssumme | 167 $ | 50 $ pauschal |
| Modell, das du bekommst | Muse Wonder | Muse Wonder und Wonder Full |
Wenn deine Nutzung ins Kontingent von Power passt, gewinnt der Plan beim Preis und liefert dir das stärkere Modell. Der Haken: Du bist in Metas CLI, teilst standardmäßig Code mit Meta und bist durch Prompts begrenzt. Ein zahlender Nutzer auf HN berichtete außerdem, dass die Muse-Code-Sandbox auf seinen Mac- und Linux-Rechnern nie funktionierte, teste sie also im ersten Abrechnungszeitraum. Wenn du andere Tools im selben Budget abwägst, sind mein Überblick über die besten KI-Coding-Assistenten und die Muse-Code-Alternativen gute Startpunkte.
2. Ein nächtlicher Dokumenten-Job. 100 Mio. Input-Tokens ohne Cache-Wiederverwendung, 5 Mio. Output, und niemand braucht die Ergebnisse vor dem Morgen.
| Modell | Monatliche Kosten |
|---|---|
| Muse Wonder | 500 $ |
| Claude Opus 5.5 (Batch API) | 250 $ |
| Muse Spark 1.3 | 146,25 $ |
Hier schmerzt das fehlende Batch-Angebot von Wonder. Solange Wonders Output für deine Dokumente nicht klar besser ist, erledigt Opus 5.5 denselben nächtlichen Job für den halben Preis, und Metas eigene Dokumentation verweist Arbeit mit hohem Volumen ohnehin auf Muse Spark. Anthropics Batch-Regeln sind in meinem Leitfaden zu den Anthropic-API-Preisen beschrieben, die von OpenAI in der Batch-API-Referenz.
3. Ein interner Support-Agent. 5.000 Tickets im Monat. Jedes Ticket sendet rund 20.000 Input-Tokens (davon 15.000 ein gecachter System-Prompt und Help-Center-Kontext) und erzeugt 2.000 Output-Tokens.
| Posten | Volumen | Kosten Muse Wonder |
|---|---|---|
| Ungecachter Input | 25 Mio. Tokens | 100 $ |
| Gecachter Input | 75 Mio. Tokens | 15 $ |
| Output und Reasoning | 10 Mio. Tokens | 200 $ |
| Summe | 5.000 Tickets | 315 $, etwa 0,06 $ pro Ticket |
Dasselbe Volumen kostet bei Muse Spark 1.3 85 $ und bei GPT-6 Astra 825 $. Die Modellrechnung für Support ist also bei jedem dieser Preise klein. Im nächsten Abschnitt komme ich darauf zurück, warum das täuscht.
Lohnt sich der Preis von Muse Wonder?
Meine Einschätzung, nach Käufergruppe:
- Entwickler, die Agents bauen. Wonders API-Preis ist fair, aber zum selben Tarif erreicht Opus 5.5 auf Metas eigenem Diagramm mehr Punkte und bietet Batch-Preise. Ich würde beide an deinen echten Aufgaben A/B-testen und nur wechseln, wenn sich Wonders Langzeitgedächtnis (es gewinnt MemoryBench mit 85,6) in deinen Ergebnissen zeigt. Wenn du mehr Optionen willst, sind die Opus-5.5-Alternativen und ein anbieterübergreifender API-Vergleich nützliche nächste Lektüre.
- Einzelne Entwickler, die das beste Meta-Modell wollen. Der Plan Power Usage für 50 $ ist hier das echte Angebot: Wonder Full plus eine Pauschalrechnung. Schalte den Contributor-Modus am ersten Tag aus, wenn es ein Arbeits-Repo ist.
- Kostensensible Teams mit hohem Volumen. Fang nicht mit Wonder an. Metas eigene Dokumentation lenkt "high-volume, latency-sensitive, or cost-sensitive work" zu Muse Spark, und auch die Preisliste des günstigeren DeepSeek V4 Flash ist einen Blick wert. Ebenso Kimi K3 für 3 $/15 $.
- Teams, die einen zweiten Frontier-Anbieter brauchen. Wonders übersichtliche Preisliste (kein Aufschlag für langen Kontext, nicht berechnete Steuerungs-Tokens, kostenlose Cache-Schreibvorgänge) macht es zu einer einfachen Ergänzung neben Gemini 4 Argon. Es lohnt sich auch ein Preisvergleich mit GPT-6.1 Sol. Denk daran, dass es weiterhin als Preview gekennzeichnet ist.
Muse-Wonder-Preise für Support-Teams: die Token-Rechnung ist der kleine Teil
Rechenbeispiel 3 setzte die Modellkosten für 5.000 Support-Tickets auf etwa 315 $ im Monat. Diese Zahl ist real, und sie ist auch der Grund, warum so viele Teams beschließen, ihren eigenen Support-Bot zu bauen. Genau diese Argumentation habe ich von einem abgewanderten Mittelstandskunden von eesel gehört, der zu einem günstigeren Tool wechselte und schrieb:
"But long term we will just build our own, which is so possible now with AI."
Er sagte auch, dass er geblieben wäre, wenn der Support von eesel schneller gewesen wäre, was fair ist, und das zitiere ich lieber, als es wegzulassen. Aber die 315 $ decken nur das Modell ab. Der Rest des Projekts ist eine Helpdesk-Anbindung an Zendesk oder Freshdesk, das Synchronhalten des Wissens, die Entscheidung, wann an einen Menschen übergeben wird, das Testen der Antworten, bevor sie Kunden erreichen, und jemand, der die Verantwortung trägt, wenn etwas kaputtgeht.
Meine Notizen zur Anbindung von Muse an Zendesk zeigen, wie viel Verbindungsarbeit dafür nötig ist. Das beste Modell für Support-Tickets zu wählen ist nur der erste Schritt; die Aufschlüsselung zu Muse für den Kundensupport behandelt den Rest.
Die Preiseinheit verändert auch das Risiko. Bei Tokens kann ein Ticket, das bei Effort "high" zehn Tool-Aufrufe durchläuft, ein Vielfaches einer einzeiligen Antwort kosten. Bei einem Plan pro Ticket ist es in beiden Fällen ein Ticket. Diese Planbarkeit ist ein großer Teil dessen, wofür du bei einem KI-Support-Agent zahlst, und der Grund, warum er sich anders verhält als ein Chatbot, den du selbst zusammensteckst.
eesel einstellen, statt Tokens zu berechnen
Muse Wonder ist ein Modell, das du pro Token mietest; eesel ist der Teammate, der die Arbeit macht. eesel ist eine Plattform für KI-Teammates, auf der du einsatzbereite Teammates für bestimmte Rollen einstellst, und aktuell sind das ein KI-Helpdesk-Teammate und ein KI-Blog-Autor.
Der Helpdesk-Teammate verbindet sich mit Zendesk, Freshdesk, Gorgias und mehr, lernt aus deinen früheren Tickets, deinem Help Center und deinen Dokumenten und antwortet nur mit dem, was du freigegeben hast. Bevor er einem einzigen Kunden antwortet, kannst du ihn an deinen historischen Tickets simulieren und genau lesen, was er gesagt hätte. Die Preise gelten pro Ticket, nicht pro Token: Ein Ticket oder Chat ist ein Credit, ab 299 $ im Monat für 500 Credits, mit 100 kostenlosen Credits zum Ausprobieren, laut der eesel-Preisseite.

Wenn du Muse Wonder durchgerechnet hast, um KI auf deine Support-Queue zu setzen, spar dir die Token-Rechnung. Probiere eesel kostenlos aus und sieh zu, wie es Antworten auf deine eigenen Tickets entwirft.