

GPT-6.2 Sol kostet 2 $ pro Million Input-Token, 0,10 $ im Cache und 10 $ Output, genau das, was GPT-6.1 Sol kostete. Pro schwieriger Aufgabe ist es etwa 20 % günstiger, weil es weniger Token verbraucht. Aber ein reiner Modellwechsel kann an zwei Stellen teurer werden. In meinem Test cachte GPT-6.2 Sol nichts aus dem obersten instructions-Feld, während 6.1 Sol das tat, was 5,45 $ pro 1.000 Support-Tickets in 29,20 $ verwandelt. Und es gibt keine Flex-Stufe mehr, sodass Jobs, die auf 6.1 Sol Flex liefen, nun 20 % bis 100 % mehr kosten, sofern sie nicht zur Batch-API wechseln.
Wie viel kostet GPT-6.2 Sol?
GPT-6.2 Sol kostet 2 $ pro Million Input-Token und 10 $ pro Million Output-Token in der Standard-Stufe, mit zwischengespeicherter Eingabe bei 0,10 $. OpenAI veröffentlichte es am 17. November 2026 zusammen mit GPT-6.2 Astra, und der Launch-Beitrag sagt, es „übernimmt die Sätze von GPT-6.1 Sol". Wenn Sie sich für das Modell selbst interessieren, deckt der GPT-6.2 Sol Überblick ab, was sich geändert hat und wie es benchmarkt.
Wenn Sie es für eine Support-Warteschlange bepreisen, überspringt ein KI-Helpdesk-Teammitglied wie eesel den Token-Zähler, und mit der eesel CLI kann ein Coding-Agent freigegebene Hilfeartikel hochladen und Testfragen dagegen laufen lassen, bevor etwas live geht. Den Helpdesk selbst anzubinden, braucht weiterhin einen Admin, der das freigibt.
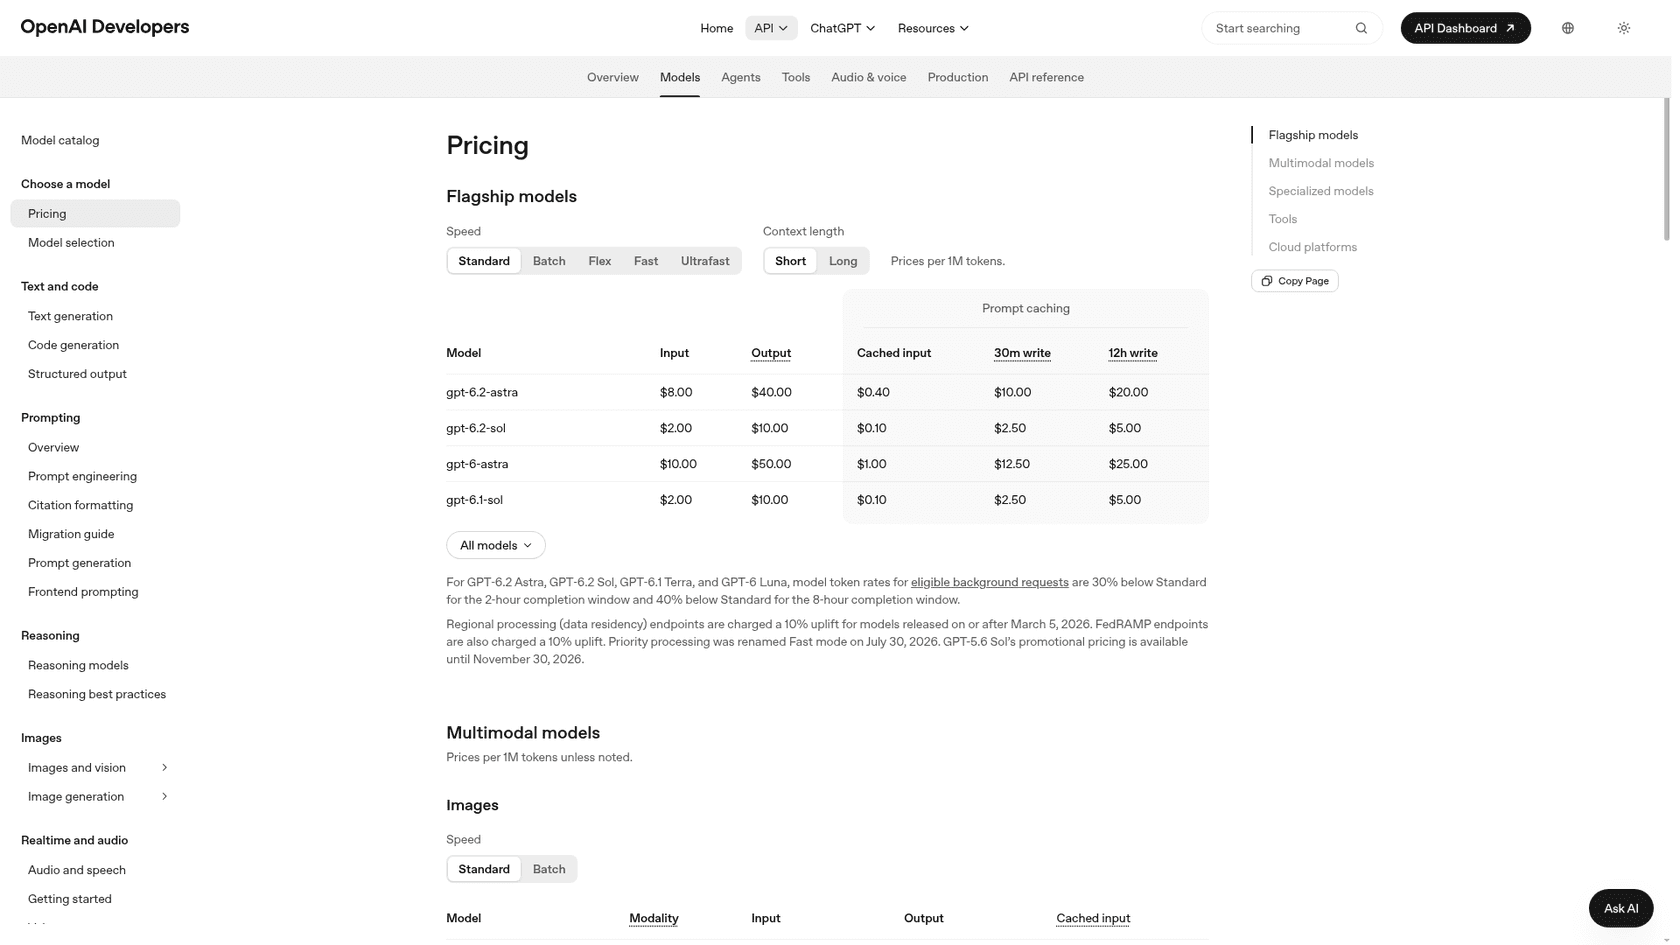
Ich verbringe einen großen Teil meiner Woche damit, wie Leute nach Modellpreisen suchen, und die Anfrage hinter „GPT-6.2 Sol Preise" ist fast immer dieselbe: Ändert das Upgrade meine Rechnung? Also habe ich es so bepreist, wie eesel einen Support-Agenten bepreist, pro Ticket, und meinen eigenen Caching-Test mit beiden Sol-Versionen durchgeführt. Hier ist jede Messgröße von OpenAIs Preisseite und der GPT-6.2 Sol Modellseite, pro Million Token:
| Stufe | Input | Zwischengespeicherte Eingabe | 30-Min.-Cache-Schreibvorgang | 12-Std.-Cache-Schreibvorgang | Output |
|---|---|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 2,50 $ | 5,00 $ | 10,00 $ |
| Standard, über 272.000 Input | 4,00 $ | 0,20 $ | n/a | n/a | 15,00 $ |
| Batch | 1,00 $ | 0,05 $ | 1,25 $ | 2,50 $ | 5,00 $ |
| Background, 8-Stunden-Fenster | 1,20 $ | 0,06 $ | 1,50 $ | 3,00 $ | 6,00 $ |
| Background, 2-Stunden-Fenster | 1,40 $ | 0,07 $ | 1,75 $ | 3,50 $ | 7,00 $ |
| Fast | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Ultrafast (bis 28. Feb. 2027) | 6,00 $ | 0,30 $ | 7,50 $ | 15,00 $ | 30,00 $ |
| Ultrafast (ab 1. März 2027) | 12,00 $ | 0,60 $ | 15,00 $ | 30,00 $ | 60,00 $ |
| Flex | Nicht verfügbar |
Die Background-Zeilen sind meine Rechnung auf Basis von OpenAIs Regel, dass berechtigte Background-Anfragen „30 % unter Standard für das 2-Stunden-Fenster und 40 % unter Standard für das 8-Stunden-Fenster" laufen. Die Long-Context-Zeile stammt von der Modellseite: Jenseits von 272.000 Input-Token verdoppeln sich „input and cache rates" und der Output kostet das 1,5-Fache des Short-Context-Satzes für die gesamte Anfrage. Sie listet keine Long-Context-Preise für Cache-Schreibvorgänge, daher habe ich diese Felder leer gelassen.
Das Modell hat ein Kontextfenster von 1.050.000 Token, maximal 922.000 Input-Token, maximal 128.000 Output-Token und einen Wissensstand vom 1. Juni 2026. Die API „lehnt außerdem Anfragen ab, die den Reasoning-Aufwand auf none setzen", sodass low die günstigste Einstellung ist, die Sie wählen können. Regionale Datenresidenz-Endpunkte kosten 10 % extra, wie bei jedem Modell, das nach dem 5. März 2026 veröffentlicht wurde.
Wofür werden Sie genau abgerechnet?
Jede GPT-6.2-Sol-Anfrage landet auf bis zu vier Messgrößen, und sie sind sehr unterschiedlich bepreist:
- Frische Eingabe zu 2 $ pro Million: die Nachricht des Kunden und alles andere, das sich geändert hat.
- Zwischengespeicherte Eingabe zu 0,10 $ pro Million: der Teil am Anfang des Prompts, der exakt mit einer kürzlichen Anfrage übereinstimmt.
- Cache-Schreibvorgänge zu 2,50 $ (30 Minuten) oder 5 $ (12 Stunden) pro Million: wenn ein wiederverwendbares Präfix zum ersten Mal gespeichert wird.
- Output zu 10 $ pro Million: die Antwort plus jedes verborgene Reasoning-Token, das OpenAIs Reasoning-Leitfaden als Output abrechnet.
OpenAIs Leitfaden zum Prompt-Caching sagt, Cache-Schreibvorgänge seien „keine zusätzliche Gebühr": Jedes Input-Token wird einmal abgerechnet, zu einem der drei Input-Sätze. Lesevorgänge bei GPT-6.2 Sol kosten „0,05x des normalen Input-Satzes", ein Rabatt von 95 %, wo die meisten anderen aktuellen OpenAI-Modelle 90 % erhalten. Das kleinste cachefähige Präfix sind 1.024 Token.
Das macht ein zwischengespeichertes Token zu einem Zwanzigstel des Preises eines frischen Tokens. Bei jeder App, die bei jedem Aufruf dieselben Anweisungen oder dasselbe Wissen sendet, zählt die Cache-Trefferrate mehr als der Listenpreis. Deshalb hat mich das nächste Ergebnis überrascht.
Cacht GPT-6.2 Sol Ihren Prompt überhaupt?
Nur, wenn der Prompt am richtigen Ort steht. Ich habe es am 18. November 2026 über die Responses API getestet: ein 8.300-Token-Help-Center für ein fiktives SaaS-Unternehmen, drei verschiedene Kundenfragen in Folge, niedriger Aufwand, zweimal auf beiden Sol-Modellen ausgeführt. Die einzige Variable war, wo das Help-Center lag.
| Modell | Prompt-Position | Aufruf 1 | Aufrufe 2 und 3 |
|---|---|---|---|
| GPT-6.1 Sol | Oberstes instructions-Feld | 8.295 Token in den Cache geschrieben | 8.283 Token aus dem Cache gelesen |
| GPT-6.1 Sol | Developer-Nachricht | 8.295 geschrieben | 8.283 gelesen |
| GPT-6.2 Sol | Oberstes instructions-Feld | 0 geschrieben | 0 gelesen |
| GPT-6.2 Sol | Developer-Nachricht | 8.295 geschrieben | 8.283 gelesen |
Beide Durchläufe lieferten identische Zahlen. Derselbe Code, der bei GPT-6.1 Sol perfekt cachte, hört also auf zu cachen, sobald Sie die Modell-ID auf gpt-6.2-sol ändern, ohne dass ein Fehler auftritt. Sie zahlen dann 2 $ pro Million für jedes Prompt-Token, statt 0,10 $. eesels Launch-Tag-Test von GPT-6.2 Astra zeigte dasselbe Verhalten, es sieht also nach einer Änderung der gesamten 6.2-Generation aus, nicht nach einer Eigenheit von Sol.
OpenAIs Dokumentation weist in dieselbe Richtung, ohne es direkt zu sagen. Der Caching-Leitfaden vermerkt, dass „oberste instructions keinen expliziten Breakpoint enthalten können" und dass wiederverwendbare Developer-Anweisungen „in einen input_text-Block innerhalb einer Developer-Nachricht" gehören. Der Launch-Beitrag empfiehlt außerdem, „Prompt-Präfixe unverändert zu lassen und neue Anweisungen anzuhängen".
Hier ist, was das mit einem Support-Agenten macht, der einen 12.500-Token-Prompt (Anweisungen plus Help-Center-Inhalt) mit 600 Token neuem Input und 300 Token Output pro Ticket wiederverwendet:
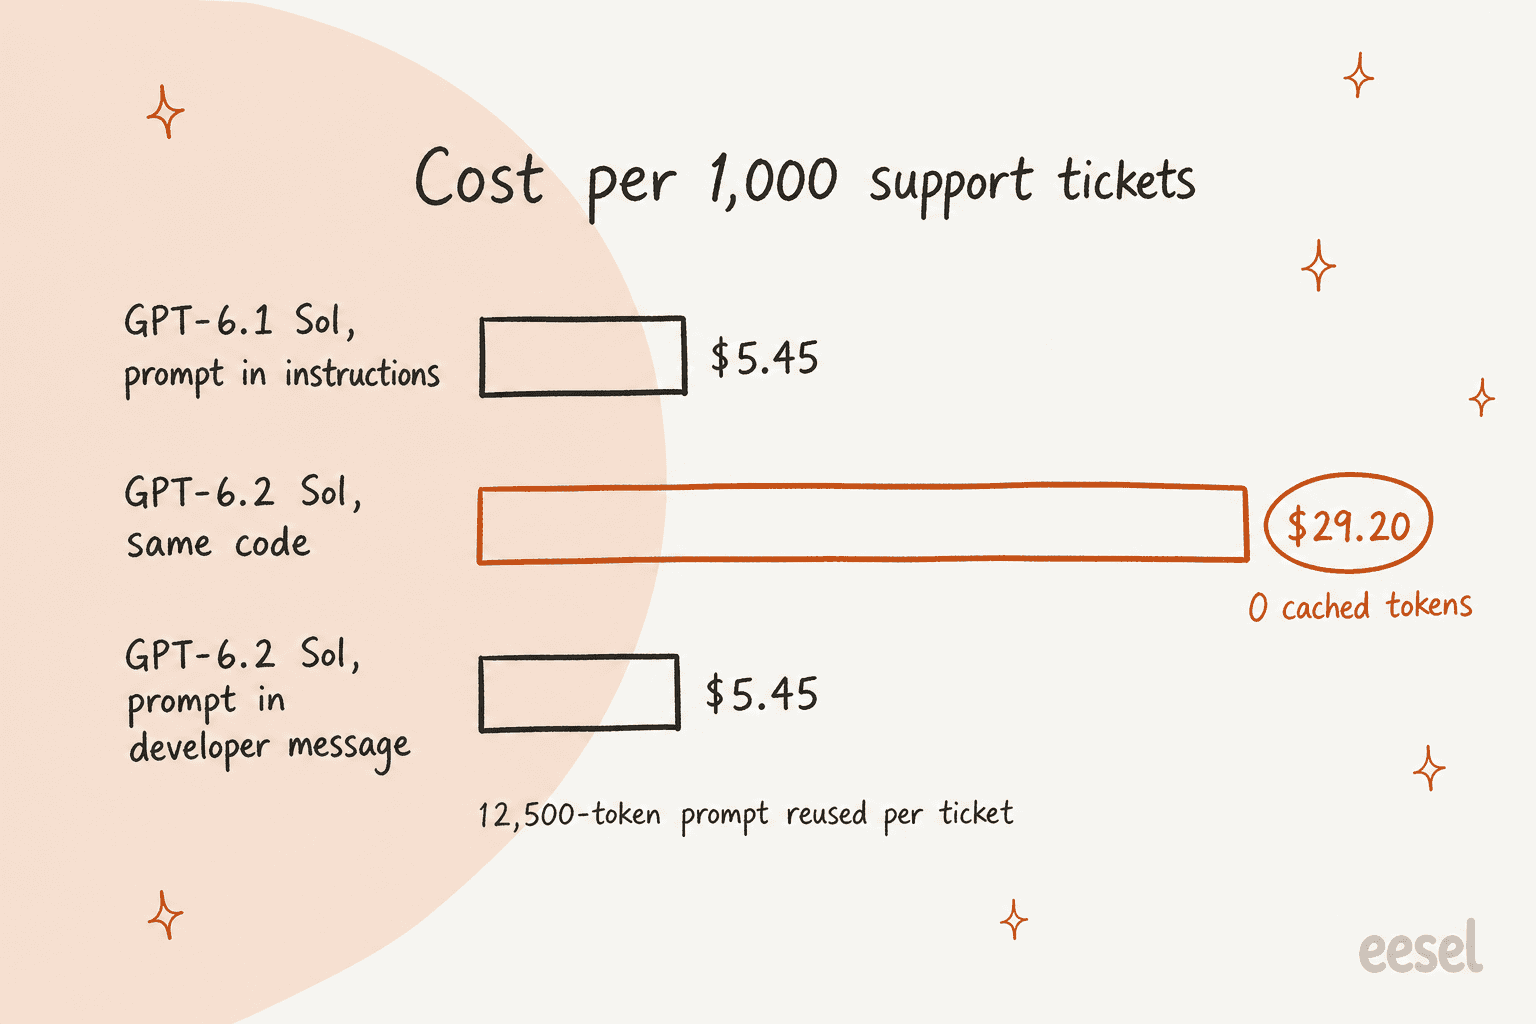
Das ist ein 5,4-facher Anstieg pro Ticket durch ein Modell-Upgrade, das preisneutral sein sollte. Die Korrektur sind wenige Zeilen Code: Verschieben Sie den Prompt in eine Developer-Nachricht und prüfen Sie dann cached_tokens im usage-Block Ihrer ersten Aufrufe. Wenn Sie direkt von GPT-5.6 Sol oder älter migriert sind, sagt OpenAIs Migrationsleitfaden außerdem, prompt_cache_retention durch prompt_cache_options.ttl zu ersetzen.
Was ist aus den Flex-Preisen geworden?
GPT-6.2 Sol hat sie nicht. OpenAIs Flex-Tabelle listet GPT-6.1 Sol bei 1 $/5 $, zusammen mit GPT-6 Astra, GPT-6.1 Terra und GPT-6 Luna, aber keine Zeile für 6.2 Sol:
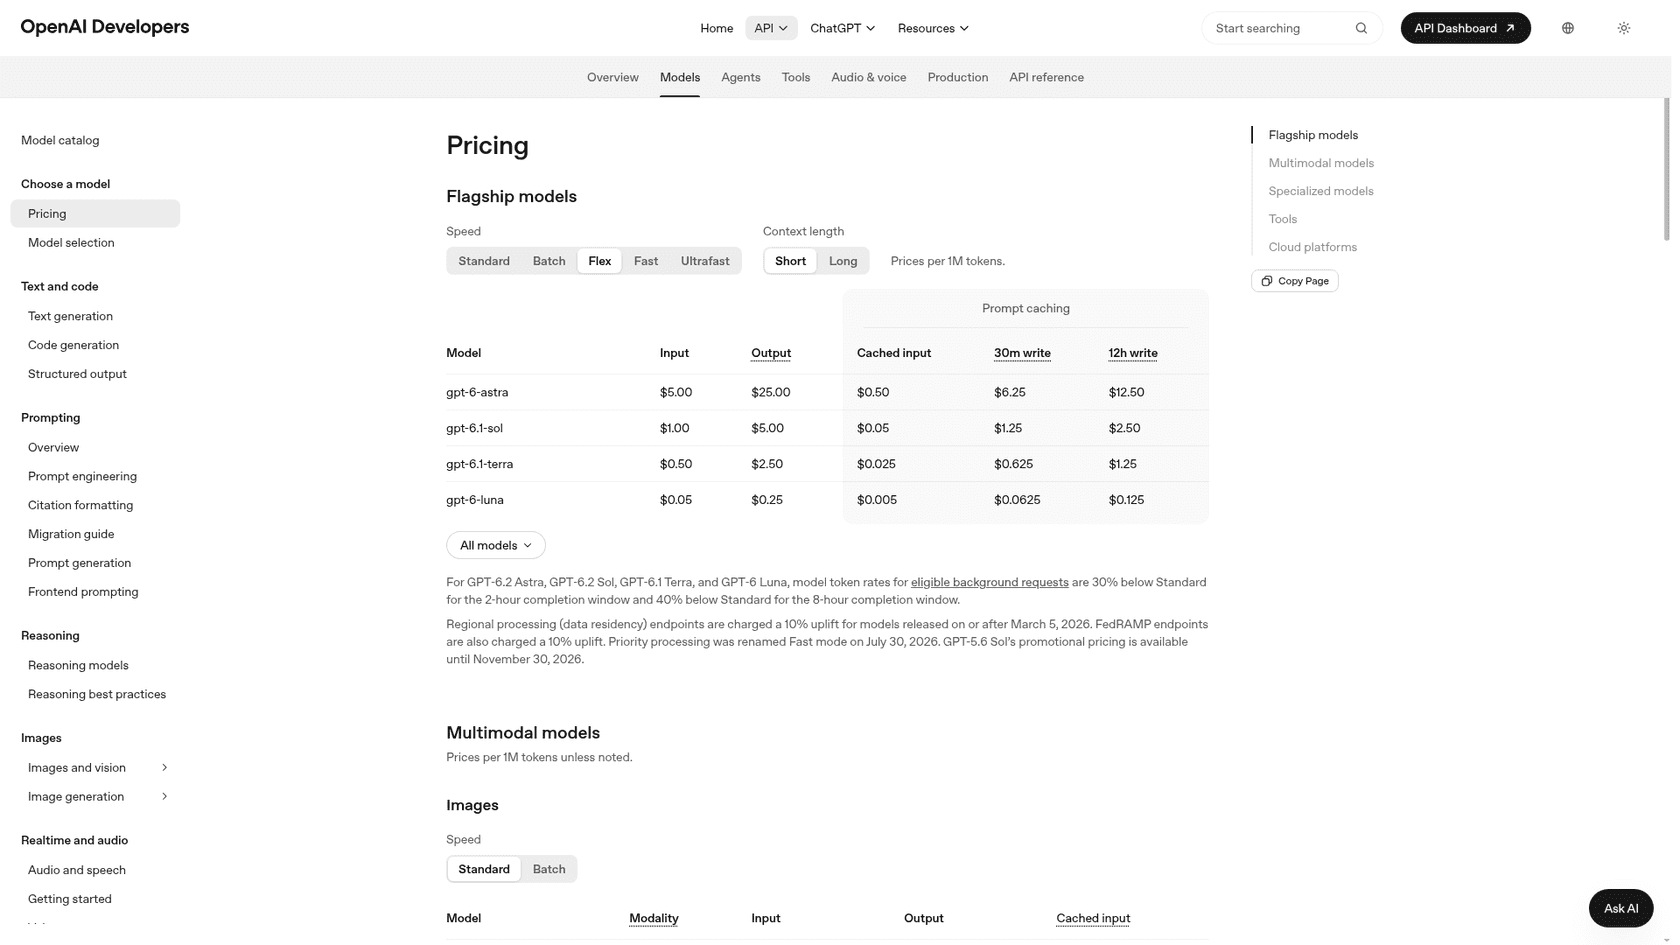
Entwickler haben es innerhalb von Stunden nach dem Launch bemerkt:
"Did they remove the flex pricing? I see it here:- https://developers.openai.com/api/docs/models/gpt-6.1-sol but not here:- https://developers.openai.com/api/docs/models/gpt-6.2-sol"

Flex war wichtig, weil es Token „zu Batch-API-Sätzen" bepreiste, laut OpenAIs Flex-Leitfaden, während es trotzdem einen normalen API-Aufruf beantwortete, nur langsamer und mit „gelegentlich nicht verfügbaren Ressourcen". Es passte zu Evals, Datenanreicherung und Nachtjobs. Bei GPT-6.2 Sol haben solche Jobs drei Rabatt-Routen, jede mit einem Haken:
- Batch-API (50 % Rabatt). Derselbe Preis wie das alte Flex, aber Sie reichen eine Datei ein und holen die Ergebnisse später ab, der Code ändert sich also.
- Background, 8-Stunden-Fenster (40 % Rabatt). Ein Flag auf einem normalen Responses-Aufruf, aber 20 % mehr als Flex.
- Background, 2-Stunden-Fenster (30 % Rabatt). Schnellere Bearbeitung, 40 % mehr als Flex.
Laut OpenAIs Background-Leitfaden sind die rabattierten Fenster in der öffentlichen Beta, erfordern Standard-Verarbeitung und teilen sich das Batch-Ratenlimit. Es gibt auch einen Caching-Haken: „Standard-Anfragen außerhalb der rabattierten Bearbeitungsfenster können Cache-Einträge, die von 2h- oder 8h-Background-Anfragen erstellt wurden, nicht wiederverwenden, selbst wenn der Prompt identisch ist." Sie können also keinen Cache über Nacht aufwärmen und ihn günstig aus Ihrer Live-App lesen.
Hier ist ein Nachtjob, der 50.000 alte Tickets mit etwa 2.000 Input-Token und 200 Output-Token pro Ticket taggt:
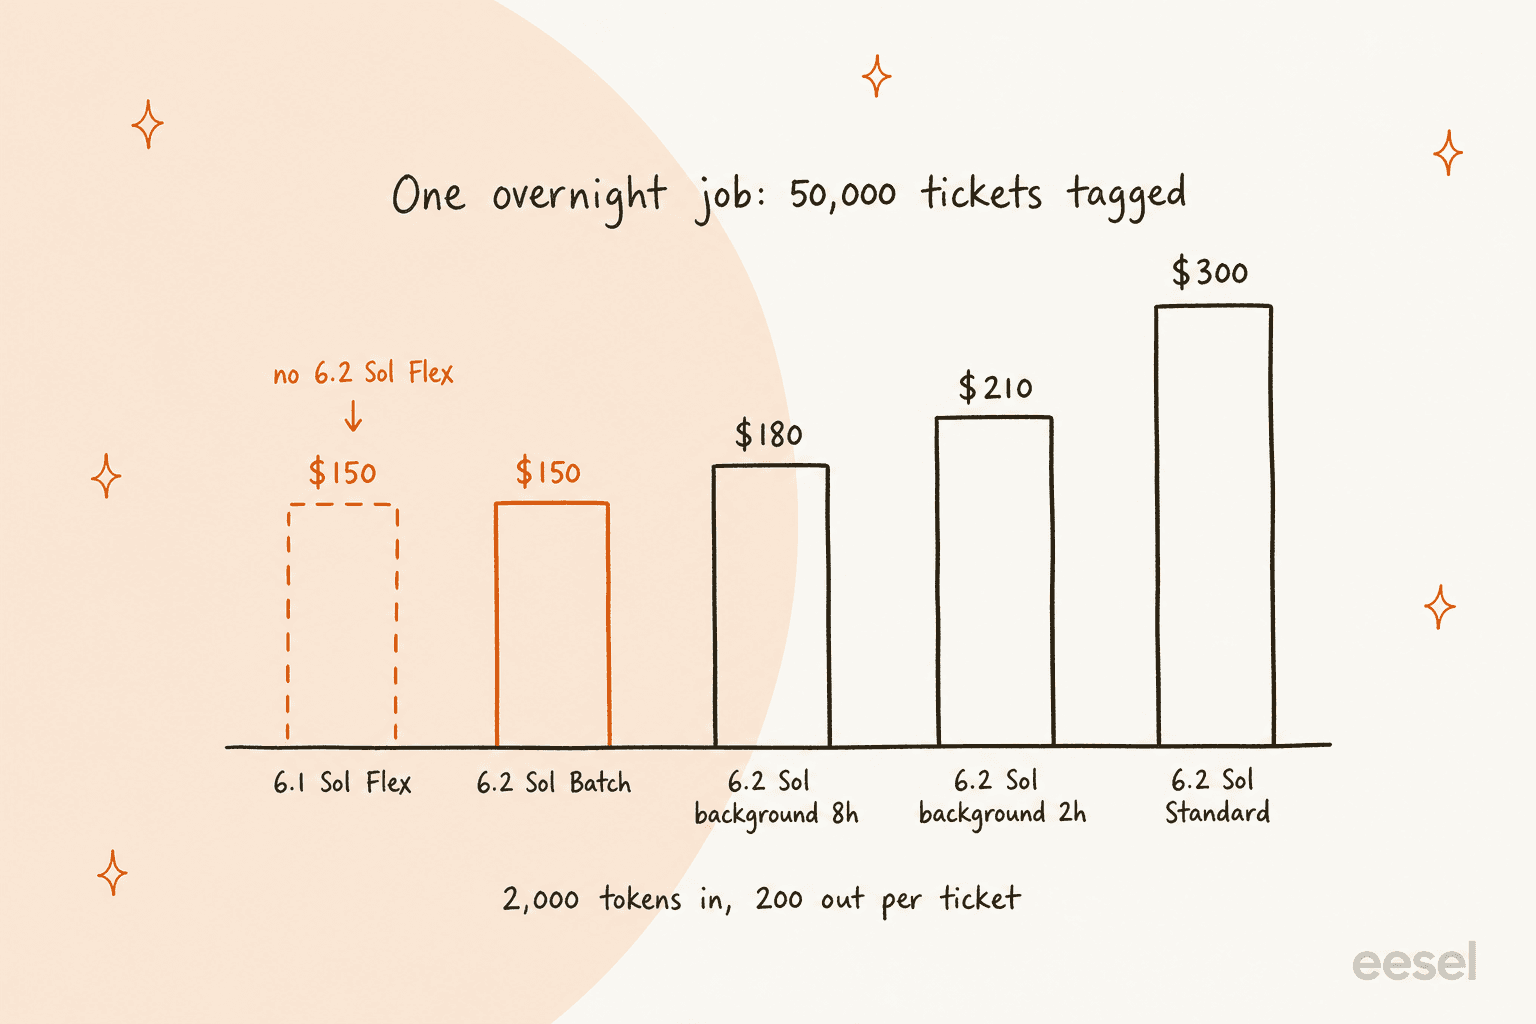
Wenn ein solcher Job jede Nacht läuft, beträgt die Lücke zwischen Batch und Standard 4.500 $ im Monat. Für reines Tagging oder Triage könnte ein kleineres Modell die bessere Ersparnis sein: GPT-6.1 Terra hat weiterhin Flex bei 0,50 $/2,50 $, und GPT-6 Luna geht noch tiefer.
Ist GPT-6.2 Sol pro Aufgabe günstiger als GPT-6.1 Sol?
Bei langer, schwieriger Arbeit ja, um etwa 20 %. Bei kurzen Antworten ist es minimal teurer. Beides stimmt, und was Sie davon spüren, hängt davon ab, wie viel das Modell nachdenken muss.
Artificial Analysis setzt die Kosten, um seinen Intelligence Index laufen zu lassen, auf 1,01 $ pro Aufgabe für GPT-6.2 Sol gegenüber 1,27 $ für GPT-6.1 Sol bei maximalem Aufwand, mit einer Punktzahl von 57 gegenüber 55. Gleiche Sätze, weniger Token: Artificial Analysis zählte 60,9 Millionen Output-Token für 6.2 Sol bei max gegenüber 63,7 Millionen bei 6.1 Sol. Es ordnet 6.2 Sol außerdem „auf Augenhöhe mit GPT-6 Astra bei etwa 15 % der Kosten pro Aufgabe" ein.
Kurze Support-Antworten erzählen eine andere Geschichte. In eesels 60-Lauf-Tickettest für die GPT-6.2 Sol Bewertung, mit 15 Tickets bei niedrigem und mittlerem Aufwand auf beiden Modellen, bestand jedes Setup alle 15:
| Setup | Kosten pro 1.000 Tickets | Durchschn. Output-Token |
|---|---|---|
| GPT-6.2 Sol, mittel | 1,42 $ | 60 |
| GPT-6.2 Sol, niedrig | 1,41 $ | 58 |
| GPT-6.1 Sol, mittel | 1,35 $ | 55 |
| GPT-6.1 Sol, niedrig | 1,32 $ | 52 |
GPT-6.2 Sol schrieb etwas längere Antworten, und beim gleichen Preis pro Token erklärt das den größten Teil des Unterschieds von 5 % bis 7 %. Diese Tickets nutzten einen kurzen Prompt ohne Help-Center-Inhalt, deshalb sind sie so günstig im Vergleich zum 12.500-Token-Beispiel oben.
Auf Hacker News landete ein Entwickler, der OpenAIs Diagramme las, beim gleichen Fazit zum Aufwand-Trade-off:
"Looks like 6.1-sol high+ is equivalent to 6.2-sol medium at the same price. So a bit smarter at a cheaper cost."
Welchen Reasoning-Aufwand sollten Sie bezahlen?
Für die meisten Apps: mittel. Reasoning-Token werden als Output zu 10 $ pro Million abgerechnet, der Aufwand ist also genauso eine Preiseinstellung wie eine Qualitätseinstellung. Artificial Analysis zählte diese Output-Token über seinen vollständigen Intelligence Index für GPT-6.2 Sol:
| Aufwand | AA Intelligence Index | Output-Token für den Index | Output gegenüber max |
|---|---|---|---|
| Niedrig | 41 | 7,2 Mio. | 12 % |
| Mittel | 53 | 14,6 Mio. | 24 % |
| Hoch | 55 | 22,7 Mio. | 37 % |
| Xhigh | 56 | 33,3 Mio. | 55 % |
| Max | 57 | 60,9 Mio. | 100 % |
Mittel behält 53 der 57 Punkte von max bei einem Viertel der Output-Token. Der Wechsel von xhigh zu max verdoppelt den Output fast für einen einzigen Punkt. OpenAIs Migrationsleitfaden empfiehlt außerdem, neue Integrationen mit medium zu starten.
Bei kurzen Aufgaben wie Support-Antworten macht sich die Einstellung kaum bemerkbar. Die Läufe mit niedrigem und mittlerem Aufwand in diesem Tickettest kosteten 1,41 $ und 1,42 $ pro 1.000 Tickets, weil das Modell vor einer Antwort aus drei Sätzen ohnehin kaum nachdenkt. Verwenden Sie Ihre Optimierungszeit auf den Cache, nicht auf den Aufwand, außer Ihr Agent führt lange, mehrstufige Jobs aus.
Was würde GPT-6.2 Sol für Ihr Volumen kosten?
Geben Sie Ihre eigenen Zahlen in den Rechner ein. Er vergleicht GPT-6.2 Sol mit GPT-6.1 Sol und GPT-6.2 Astra bei derselben Arbeitslast, mit OpenAIs veröffentlichten Sätzen. Cache-Fehlschläge werden als 30-Minuten-Cache-Schreibvorgänge abgerechnet. Der Schalter für die Prompt-Position bildet ab, was ich in meinem Test gesehen habe: Bei den 6.2-Modellen wird ein Prompt im obersten instructions-Feld bei jeder Anfrage als frischer Input abgerechnet.
Bei den Standardwerten kosten 8.000 Anfragen im Monat mit 95 % Cache-Trefferrate 55,60 $ auf GPT-6.2 Sol. Stellen Sie die Prompt-Position auf das instructions-Feld um, kostet derselbe Monat 233,60 $, während GPT-6.1 Sol bei 55,60 $ bleibt. Wechseln Sie die Stufe auf ein Background-Fenster, sehen Sie die Flex-Lücke aus dem letzten Abschnitt.
Was kostet GPT-6.2 Sol bei unterschiedlichen Teamgrößen?
Hier ist die 12.500-Token-Support-Arbeitslast bei drei monatlichen Volumen, zu Standard-Sätzen. Die mittlere Spalte setzt voraus, dass der Prompt in einer Developer-Nachricht mit 95 % Trefferrate steht; die dritte zeigt, was passiert, wenn er im instructions-Feld steht.
| Tickets pro Monat | GPT-6.2 Sol, zwischengespeichert | GPT-6.2 Sol, instructions-Feld | GPT-6.2 Sol, Batch | GPT-6.2 Astra, zwischengespeichert |
|---|---|---|---|---|
| 1.000 | 6,95 $ | 29,20 $ | 3,48 $ | 27,80 $ |
| 8.000 | 55,60 $ | 233,60 $ | 27,80 $ | 222,40 $ |
| 50.000 | 347,50 $ | 1.460,00 $ | 173,75 $ | 1.390,00 $ |
Batch passt nur zu Arbeit, auf die niemand wartet, etwa Entwürfe von Zusammenfassungen der Tickets der letzten Woche. Live-Antworten bleiben auf Standard. Die Aufschlüsselung GPT-6.2 Astra Preise zeigt, warum Astra bei derselben Arbeitslast das Vierfache kostet.
Zur Einordnung: MentorShow, eine französische Online-Lernplattform, sagte eesel, dass sie zwischen 5.000 und 13.000 Tickets im Monat erhält. Ihr eesel-Agent liest jede neue HubSpot-Unterhaltung, prüft den Datensatz des Mitglieds und eine Wissensdatenbank mit 123 Artikeln und hinterlässt eine interne Notiz mit einem Antwortentwurf in der Sprache des Mitglieds. Bei diesem Volumen kommen GPT-6.2-Sol-Token mit funktionierendem Cache auf etwa 35 $ bis 90 $ im Monat. Mit dem instructions-Feld-Fehler sind es 146 $ bis 380 $.
So oder so sind die Token die kleine Zeile bei den KI-Kundenservice-Kosten. Die größeren Posten sind Retrieval, Function Calling für Bestellabfragen, Eskalationsregeln und die Observability, um zu sehen, was der Agent gesagt hat.
Deshalb hängen die Kosten eines KI-Support-Agenten mehr von Bauen gegenüber Kaufen ab als vom Modell.
Ist GPT-6.2 Sol günstiger als Claude Sonnet 5.5?
Beim Listenpreis sind sie identisch. Anthropics Preisseite listet Claude Sonnet 5.5 bei 2 $ Input, 10 $ Output und 0,10 $ Cache-Lesevorgang pro Million Token. Die Unterschiede stecken im Kleingedruckten:
| Pro Million Token | GPT-6.2 Sol | Claude Sonnet 5.5 | GPT-6.2 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Input | 2,00 $ | 2,00 $ | 8,00 $ | 4,00 $ |
| Output | 10,00 $ | 10,00 $ | 40,00 $ | 20,00 $ |
| Cache-Lesevorgang | 0,10 $ | 0,10 $ | 0,40 $ | 0,20 $ |
| Günstigster Cache-Schreibvorgang | 2,50 $ (30 Min.) | 2,50 $ (5 Min.) | 10,00 $ (30 Min.) | 5,00 $ (5 Min.) |
| Längerer Cache-Schreibvorgang | 5,00 $ (12 Std.) | 4,00 $ (1 Std.) | 20,00 $ (12 Std.) | 8,00 $ (1 Std.) |
| Prompts über 272.000 | 2x Input, 1,5x Output | Gleicher Satz bis 1 Mio. | 2x Input, 1,5x Output | Gleicher Satz bis 1 Mio. |
| Batch | 50 % Rabatt | 50 % Rabatt | 50 % Rabatt | 50 % Rabatt |
Drei Dinge entscheiden, was für Sie günstiger ist:
- Ruhige Warteschlangen begünstigen Sol. Derselbe Schreibvorgang für 2,50 $ kauft 30 Minuten bei Sol und 5 Minuten bei Sonnet. Treffen Anfragen im Abstand von 10 Minuten ein, bleibt Sols Cache warm, während Sonnet ihn immer wieder neu schreibt.
- Riesige Prompts begünstigen Sonnet. Anthropic berechnet „denselben Satz pro Token" über das gesamte 1-Millionen-Fenster. Eine Anfrage mit 400.000 Token und einer Antwort von 4.000 Token kostet 1,66 $ auf GPT-6.2 Sol und 0,84 $ auf Sonnet 5.5. Das Aufteilen von Dokumenten unter 272.000 schließt den Großteil dieser Lücke.
- Die Token-Zahl pro Aufgabe entscheidet den Rest. Bei gleichen Sätzen gewinnt das Modell, das in weniger Token antwortet. Das ist von der Arbeitslast abhängig, testen Sie also beide mit Ihren eigenen Prompts.
Wenn Sie breiter vergleichen: Claude Opus 5.5 kostet doppelt so viel pro Token, und bestes KI-Modell für Support vergleicht das Feld bei Tickets.
Was kostet GPT-6.2 Sol in ChatGPT?
In ChatGPT zahlen Sie ein pauschales Abonnement, nicht pro Token. OpenAI sagt, GPT-6.2 Sol sei „für alle Plus-, Pro-, Enterprise- und Edu-Nutzer in ChatGPT Work und Codex verfügbar", wobei Enterprise und Edu Zugriff erhalten, sobald ein Workspace-Admin ihn aktiviert.
| Tarif | Preis | Zugriff auf GPT-6.2 Sol |
|---|---|---|
| Free | 0 $ | Nicht im Launch-Beitrag genannt |
| Go | 8 $/Monat | Nicht im Launch-Beitrag genannt |
| Plus | 20 $/Monat | Ja, in ChatGPT Work und der Codex-App |
| Pro (Pro 100, Pro 200, Pro 500) | Ab 100 $/Monat | Ja; Pro 200 erhält erstmals Ultrafast mit Sol, Pro 500 erhält Ultrafast mit Sol oder Astra |
| Enterprise und Edu | Vertrieb kontaktieren | Ja, sobald ein Admin es aktiviert |
Die Preise stammen von ChatGPTs Preisseite. Die Pro-Tarife enthalten außerdem monatliche API-Guthaben: 100 $, 200 $ oder 500 $, je nach Stufe, vorbehaltlich OpenAIs Teilnahmebedingungen. Beim zwischengespeicherten Satz von 6,95 $ pro 1.000 Tickets deckt ein Guthaben von 200 $ etwa 28.800 GPT-6.2-Sol-Tickets im Monat ab. Der Leitfaden ChatGPT-Preise hat die vollständige Tarifaufschlüsselung.
Lohnt sich GPT-6.2 Sol für den Kundensupport?
Beim Preis ja. Es ist ein Viertel der Token-Kosten von GPT-6.2 Astra und bestand alle 15 Tickets in eesels Test. Die echten Risiken liegen anderswo. Artificial Analysis maß bei Sol eine Halluzinationsrate von 55 % bei maximalem Aufwand, das Modell rät also eher, als zuzugeben, dass es etwas nicht weiß. In diesem Test verwandelte es eine Sendungsnummer in einen ups.com-Link, den das Bestell-Tool nie geliefert hatte. Ein günstiges Modell, das rät, braucht trotzdem Absicherung, Halluzinationsprävention und Tests an echten Tickets, bevor es Kunden antwortet.
Es gibt auch die Frage, ob Sie überhaupt eine Token-Rechnung wollen. Diese kann sich bewegen, ohne dass sich Ihr Code ändert: Der Cache hört nach einem Upgrade auf zu treffen, eine Rabattstufe verschwindet, oder Ultrafast verdoppelt sich am 1. März 2027. In einem eesel-Verkaufsgespräch sagte ein budgetbewusster Käufer dem Team, der Preis eines früheren Anbieters habe sich mehr als verdoppelt, und bat vor der Unterschrift um eine vertragliche Preisbindung. Token-Preise können das nicht bieten.
Das ist die Abwägung Bauen oder Kaufen. Bauen Sie auf GPT-6.2 Sol, bekommen Sie günstige Token, plus die Aufgabe, cached_tokens, Stufen und Preisseiten im Blick zu behalten. Kaufen Sie, werden die Modellwahl und ihre Abrechnungseigenheiten zum Problem jemand anderes.
eesel ausprobieren
Wenn Sie die Preise von GPT-6.2 Sol prüfen, weil Sie KI in Ihrer Support-Warteschlange wollen, gibt Ihnen eesels KI-Helpdesk-Teammitglied das ohne Token-Zähler. Es bindet sich in den Helpdesk ein, den Sie bereits nutzen, lernt aus Ihren früheren Tickets und Ihrem Help Center und lässt Sie es gegen historische Tickets laufen, sodass Sie jede Antwort lesen können, bevor sie einen echten Kunden erreicht. Die Pläne sind feste Credit-Bündel, ab 299 $ für 500 Credits, sodass eine Caching-Änderung oder eine neue Stufe bei OpenAI nicht auf Ihrer Rechnung auftaucht.
Lesson Pro, eine Gruppe von Anbietern privater Nachhilfe, betreibt es über zwei Zendesk-Konten: In einem Monat bearbeitete es 1.900 Tickets, hinterließ 1.700 interne Notizen für das Team und entwarf 560 Antworten zur Freigabe durch einen Menschen, mit Antworten aus rund 4.000 Tickets, Artikeln und Webseiten.

Sie können eesel kostenlos ausprobieren auf einem Teil Ihrer Warteschlange, oder es mit der direkten Nutzung von ChatGPT vergleichen, falls Sie noch über den Bauen-Weg nachdenken.
Häufig gestellte Fragen
Wie viel kostet GPT-6.2 Sol?
Ist GPT-6.2 Sol teurer als GPT-6.1 Sol?
Gibt es bei GPT-6.2 Sol Flex-Preise?
Wie erhalte ich den Rabatt auf zwischengespeicherte Eingabe bei GPT-6.2 Sol?
cached_tokens im usage-Block der Responses API, um das zu bestätigen.