Was ist die OpenAI Decisions API?
Die Decisions API ist ein neuer OpenAI-Endpunkt für eine enge Aufgabe: die Wahl zwischen vorab definierten Optionen. So beschreibt sie OpenAIs DevDay-2026-Rückblick:
"Decisions API enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers. Developers supply context using text or images, and get back answers they can use to classify content, route requests, or choose an agent's next action."
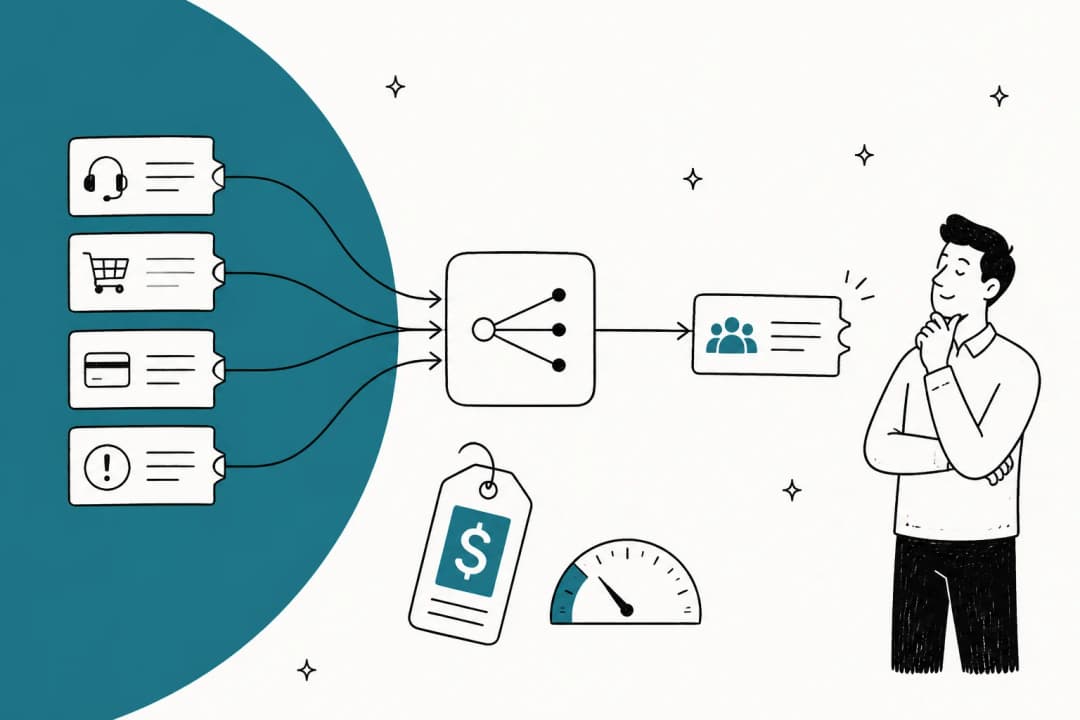
Ich baue beruflich KI-Agenten, und die meisten Modellaufrufe in einem Agenten schreiben gar nichts. Es sind kleine Weggabelungen: Welches Team ist für dieses Ticket zuständig, braucht das einen Menschen? Ein allgemeines Modell kann das gut beantworten, nur geht es den langsamen Weg und erzeugt erst Text. Die Decisions API ist OpenAIs Wette darauf, dass diese Art von Aufruf eine eigene Spur verdient.
Sie steht neben den größeren DevDay-Launches, etwa den Dauerbetrieb-Agenten OpenAI Dots, dem Modell GPT-6.1 Sol und Codex Security Cloud.
Sie bekam weniger Bühnenzeit als diese. Das Keynote-Segment dauert unter einer Minute und beginnt etwa bei 22:15 in der Keynote, und in derselben Woche kam auch ChatGPT Space. Trotzdem: Wenn du eine Support-Queue betreibst, passt dieser Launch am engsten zu deinem Arbeitsalltag.
Wie funktioniert die Decisions API?
Du gibst drei Dinge hinein und bekommst eins zurück. Der Ablauf sieht, soweit OpenAI ihn beschrieben hat, so aus:
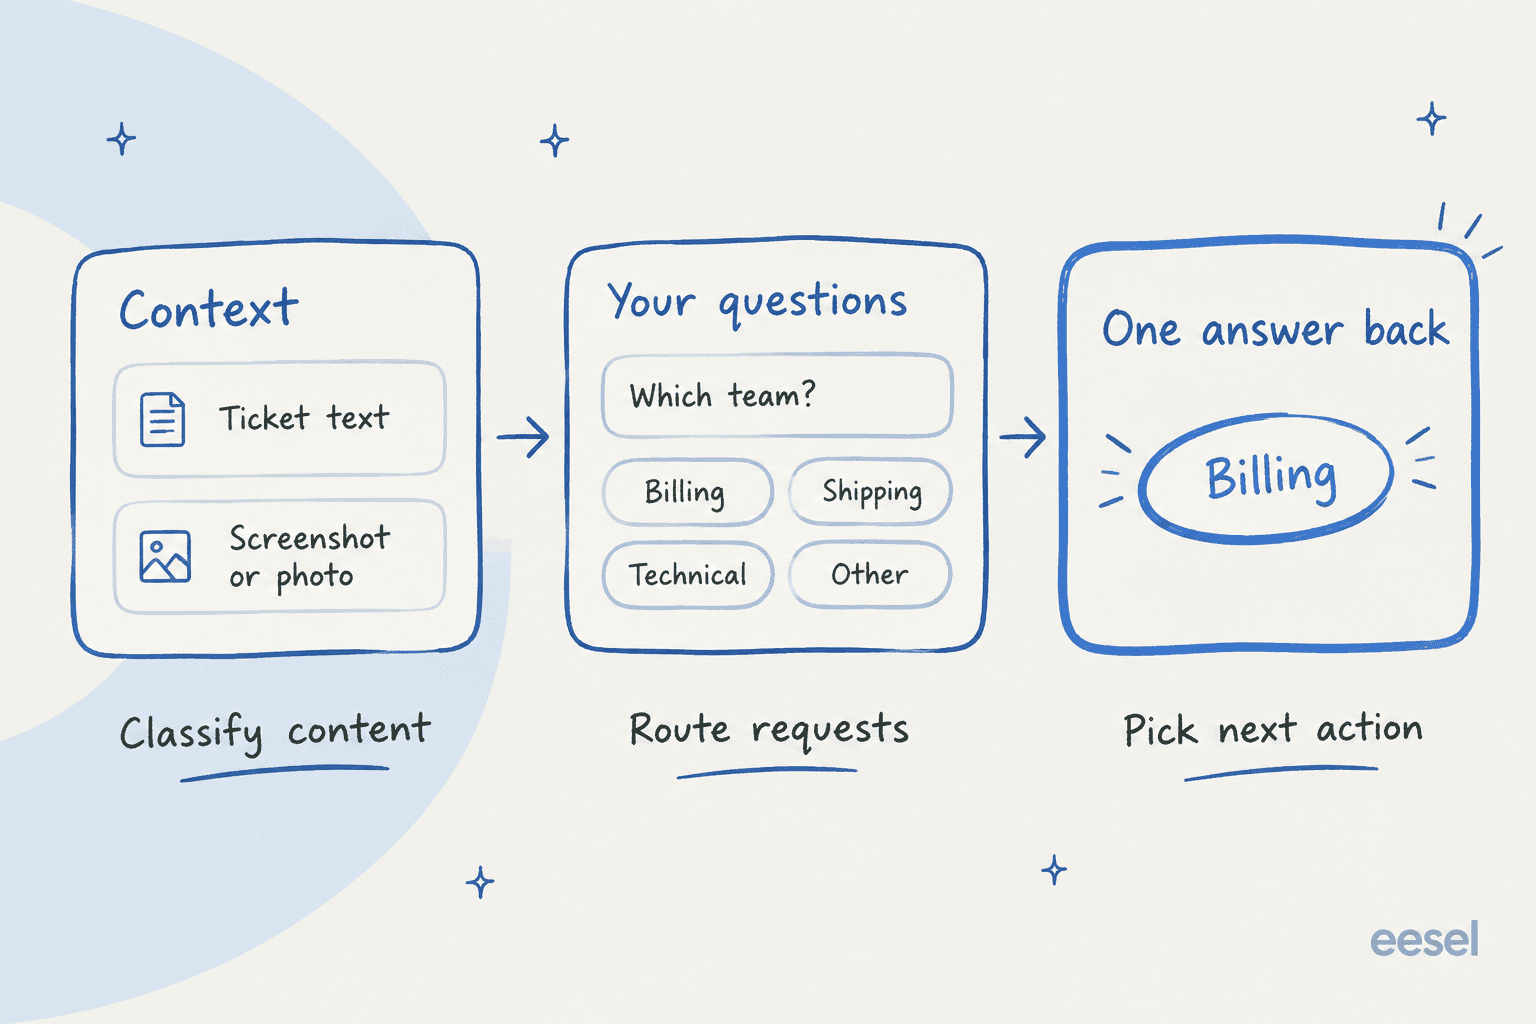
- Kontext. Text oder Bilder, also ein Ticket-Text, ein Chat-Verlauf oder ein Produktfoto, das der Kunde angehängt hat.
- Fragen mit endlichen Antworten. Du definierst jede Frage samt der vollständigen Liste der Antworten, die sie zurückgeben darf.
- Eine Auswahl als Rückgabe. Eine Antwort aus deiner Liste, und dann handelt dein Code.
Das Support-Beispiel stammt tatsächlich vom Entwickler-Account von OpenAI selbst, in einem Thread von @OpenAIDevs:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use."
Unter der Haube läuft sie auf GPT-6 Luna, das OpenAI auf der Luna-Modellseite sein „most efficient model for focused, high-volume tasks“ nennt. Die Keynote erklärt das Tempo so, dass eine vordefinierte Menge an Optionen es Luna erlaubt, in einem Bruchteil einer Sekunde zu antworten. Nichts muss Wort für Wort ausgeschrieben werden, also gibt es weniger Wartezeit.
Wenn du darauf aufbauen willst, sind die Punkte, die OpenAI noch nicht erklärt hat, mindestens so wichtig:
- Das Request- und Response-Schema, da es keine API-Referenzseite gibt.
- Ob ein Aufruf mehrere Fragen tragen kann und wie viele Antworten jede Frage haben darf.
- Ob die Antwort einen Konfidenzwert enthält. Presseberichte sagen ja, aber ich habe keine OpenAI-Seite oder -Veröffentlichung gefunden, die einen erwähnt.
- Die Abrechnungseinheit und die Rate Limits, außerdem, ob Batch oder Flex gelten.
Ein Hacker-News-Leser vermutete im DevDay-Thread den Mechanismus: "I think they simply use the LLMs softmax scores (uncalibrated confidence)". Das ist eine plausible Lesart, bestätigt hat sie aber niemand.
Kannst du die OpenAI Decisions API schon nutzen?
Nur, wenn OpenAI dich ausgewählt hat. Im Rückblick steht, sie sei "available in limited preview today with a broad release planned in the coming days", und der OpenAI-Developers-Thread ergänzt: "preview access is limited to selected API customers for testing."
Ich habe nachgesehen, was das praktisch bedeutet. POST https://api.openai.com/v1/decisions ist eine echte Route, und ein normaler Key bekommt von ihr diese Antwort:
{"error":{"message":"Decision API is not enabled for this user.","type":"invalid_request_error","param":null,"code":null}}
Das ist ein HTTP 403, also eine Feature-Sperre und keine fehlende Route. Benachbarte Pfade wie /v1/decisions/create und /v1/beta/decisions liefern 404. Die Sperre greift schon bei leerem Body, die Fehler verraten also auch nichts über die Form der Anfrage. Ich bekam am 1. Oktober dasselbe 403 und am 2. Oktober wieder, drei Tage nach dem Versprechen „in den kommenden Tagen“.
Auch die Spuren auf Papier sind dünn. Stand 2. Oktober:
| Was ich geprüft habe | Ergebnis |
|---|---|
Doku-Leitfaden (/api/docs/guides/decisions) | 404 |
API-Referenz (/api/reference/decisions) | 404 |
| API-Changelog, Einträge vom 29. Sep | Kein Eintrag zur Decisions API |
| API-Preisseite | Keine Zeile zur Decisions API |
| Eigener Ankündigungsbeitrag | Keiner, nur der DevDay-Rückblick |
GET /v1/models | Keine Modell-ID mit „decision“ |
Im Moment ist die Decisions API also ein Versprechen und ein gesperrter Endpunkt. Das ist für eine Vorschau ziemlich normal, heißt aber, dass du sie weder Lasttests unterziehen noch bepreisen und auch ihre Limits nicht nachlesen kannst.
Was bringt die Decisions API gegenüber Structured Outputs?
Ein HN-Kommentator stellte wenige Stunden nach dem Launch die naheliegende Frage:
"It seems a bit silly since OpenAI LLMs already can output structured data."

Ein fairer Einwand. Du kannst Luna schon heute aus einer festen Liste antworten lassen: Nutze die Responses API, setze Reasoning auf none und übergib ein striktes JSON-Schema, dessen einziges Feld ein Enum deiner Antworten ist. Unten steht die genaue Anfrage, die ich ausgeführt habe, während die Decisions API gesperrt blieb:
{"model":"gpt-6-luna","reasoning":{"effort":"none"},
 "input":[{"role":"developer","content":"Route the support ticket. Which queue?"},
          {"role":"user","content":"I was charged twice for my order #4471"}],
 "text":{"format":{"type":"json_schema","name":"route","strict":true,
   "schema":{"type":"object","properties":{"queue":{"type":"string","enum":["billing","shipping","technical","other"]}},
   "required":["queue"],"additionalProperties":false}}}}
Sie lieferte in allen drei Durchläufen {"queue":"billing"}, bei 60 Input-Tokens und 12 Output-Tokens. Das ergibt $0.000012 pro Aufruf zu Lunas Standard-Preisen. Wer schon mal OpenAI Function Calling genutzt hat, kennt die Idee, nur an kürzerer Leine, und es ist auch der Aufbau hinter den meisten KI-Ticket-Routings für SaaS heute.
Es gibt aber einen Haken, den ein Kommentator in einem früheren HN-Thread zu OpenAI und Jev nannte:
"It's not guaranteed to be correct: it's guaranteed to be formatted in a particular way. You can get the same thing with grammars on any LLM."
Das Formatproblem ist also schon gelöst. Was die Decisions API obendrauf verspricht, ist Tempo, plus was auch immer die Genauigkeits-Abstimmung durch „focusing Luna's intelligence“ am Ende bedeutet. Nach dem, was bisher öffentlich ist, vergleichen sich die beiden so:
| Decisions API | Luna + Structured Outputs | |
|---|---|---|
| Status | Begrenzte Vorschau, ausgewählte Kunden | Jetzt verfügbar |
| Input | Text oder Bilder | Text und Bilder |
| Output | "A selection" aus deinen Antworten | JSON, das zu deinem Schema passt |
| Tempo | "Less than a few hundreds of milliseconds end to end" (Angabe von OpenAI-Mitarbeitenden) | 1,46 s Median in meinem Test |
| Preis | Nicht veröffentlicht | $0.10 Input / $0.50 Output pro 1M Tokens |
| Konfidenzwert | Nicht bestätigt | Standardmäßig keiner |
| Doku | Noch keine | Leitfaden zu Structured Outputs |
Wie schnell ist die Decisions API?
Die einzige schriftliche Tempo-Angabe von OpenAI stammt von einem Mitarbeiter, in der Doku steht nichts. Thibault Sottiaux, der bei OpenAI arbeitet, schrieb am Launch-Tag:
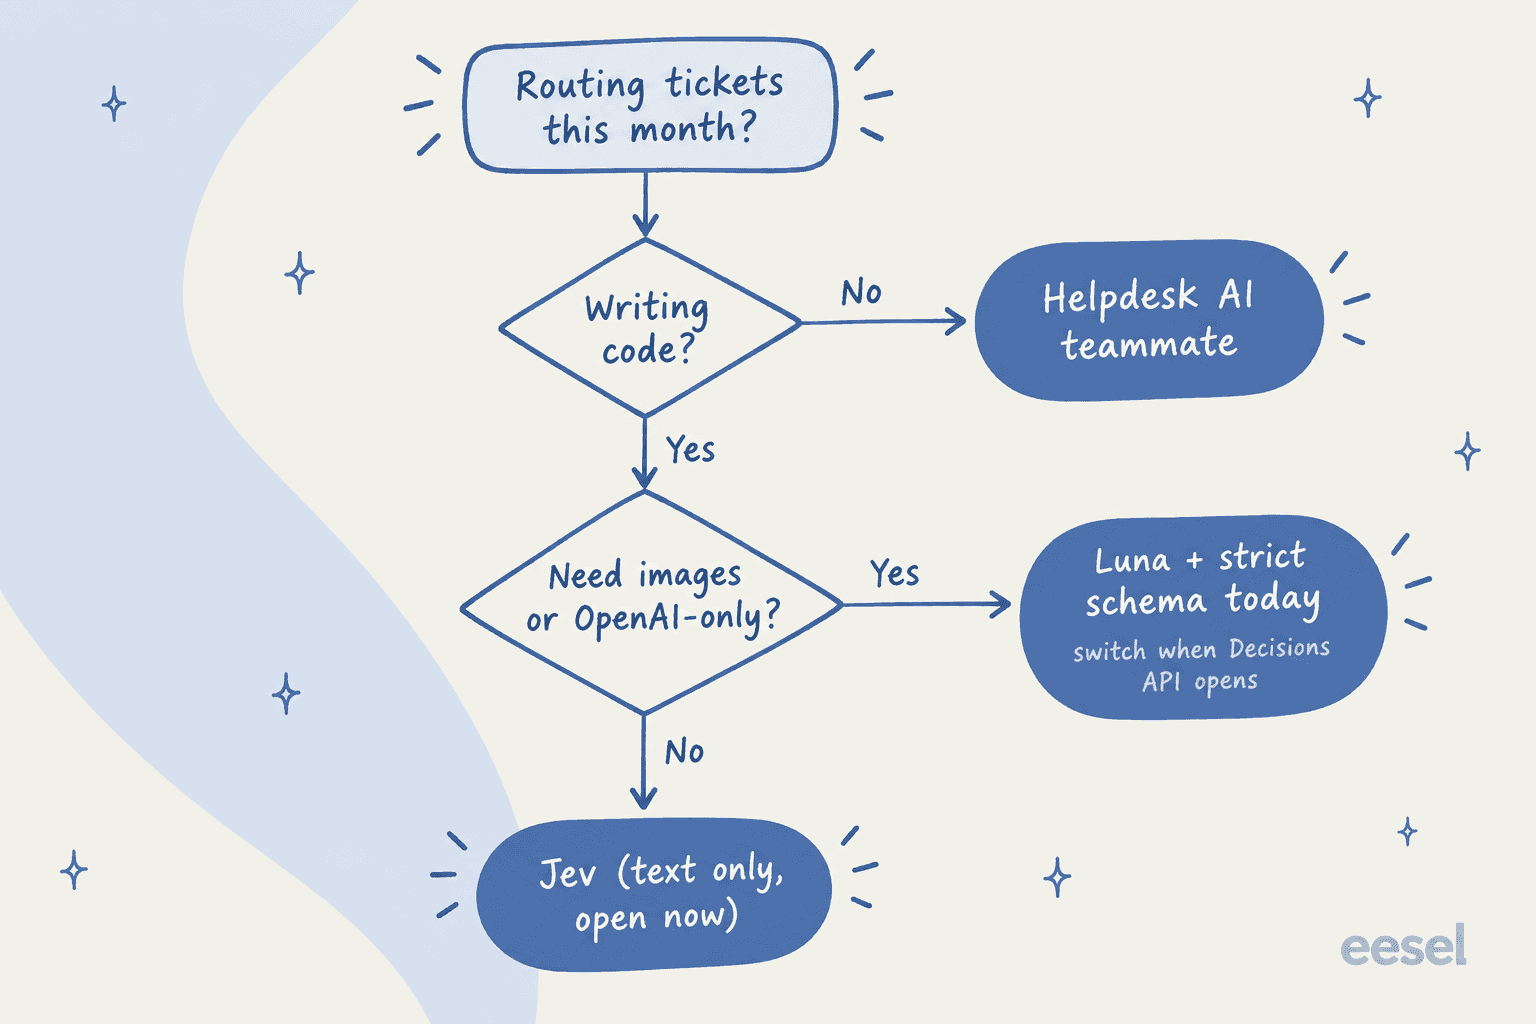
"Decisions API, for lightning fast constrained decision making powered by Luna. Supports visual inputs, and tuned to be able to make decisions in less than a few hundreds of milliseconds end to end."
Um zu sehen, was sie schlagen müsste, habe ich 20 Support-Tickets pro Setup zweimal durch Luna geschickt und nach einer Queue und einer Priorität gefragt, außerdem danach, ob das Ticket sicher automatisch beantwortet werden kann. Das sind insgesamt 160 Aufrufe, Ende-zu-Ende von einem Laptop aus gemessen, die Netzwerklaufzeit ist also mit drin.
| Setup (mein Test) | Median | Schnellster | Langsamster |
|---|---|---|---|
| GPT-6 Luna, Reasoning none | 1,46 s | 0,95 s | 2,79 s |
| GPT-6 Luna, Reasoning low | 1,62 s | 0,95 s | 3,20 s |
| GPT-6 Luna, Reasoning medium | 2,33 s | 1,44 s | 5,75 s |
| GPT-6.1 Sol, Reasoning low | 2,17 s | 1,52 s | 4,98 s |
Hält OpenAIs Angabe, wäre die Decisions API etwa fünfmal schneller als mein bestes Luna-Setup. Wo diese Lücke zählt und wo nicht:
- E-Mail- und Ticket-Triage. Kaum. Niemand merkt, ob ein Ticket in 300 ms oder in 1,5 Sekunden getaggt wurde.
- Live-Chat. Ja. Eine Pause von 1,5 Sekunden, bevor der Bot überhaupt entschieden hat, wer antworten soll, summiert sich über ein Gespräch.
- Agenten. Hier zählt es am meisten. Ein Agent, gebaut mit etwas wie OpenAI AgentKit, der pro Aufgabe 20 kleine Entscheidungen trifft, wartet auf Luna 30 Sekunden, bei der angegebenen Geschwindigkeit nur ein paar Sekunden.
In manchen Presseberichten taucht ein Diagramm „150 ms vs 1.6 s“ auf. Diese Zahlen habe ich auf keiner OpenAI-Seite und in keinem Beitrag gefunden, ich würde also nicht damit planen, bevor die Doku erscheint.
Wie schneidet sie im Vergleich zu TypeSafe Jev ab?
Über diesen Launch zu sprechen, ohne TypeSafe Jev zu erwähnen, ist schwer. TypeSafe hat Jev am 15. September als Modell nur für typisierte Entscheidungen gestartet, zwei Wochen später tauchte die Decisions API auf. Ein HN-Kommentator sagte es im DevDay-Thread ohne Umschweife: "Decisions API is a validation for Jev and the entire space it created."
Nach dem, was jede Firma veröffentlicht hat, sieht der Vergleich so aus:
| OpenAI Decisions API | TypeSafe Jev | |
|---|---|---|
| Zugang | Begrenzte Vorschau | Offen für alle seit 27. Sep |
| Input | Text oder Bilder | Nur Text, laut Jev-Modellseite |
| Fragetypen | Fragen mit festen Antworten | Choice, Score und Noul (Wahrscheinlichkeit für wahr oder falsch) |
| Output | Eine Auswahl | Auswahl plus Wahrscheinlichkeiten und Konfidenz |
| Preis | Nicht veröffentlicht | $0.042 pro 1M Input-Tokens, Output kostenlos |
| Tempo | "Less than a few hundreds of milliseconds" | "70ms-500ms" Ende-zu-Ende, laut Launch-Beitrag |
| Optionen pro Frage | Nicht veröffentlicht | Bis zu 255 pro Choice |
| Rate Limits | Nicht veröffentlicht | 100K Tokens/s oder 40 Requests/s |
Für die meisten Teams kommt es auf zwei Zeilen an. Jev nimmt keine Bilder, wenn deine Queue also voller Screenshots und Schadensfotos ist, spricht das für OpenAI. Dafür liefert Jev zu jeder Antwort eine Wahrscheinlichkeit, und die brauchst du genau, um zu entscheiden, wann du nicht handelst.
Mein Jev-Review beschreibt, wie es sich im Test geschlagen hat. Für die Preisrechnung gibt es die Aufschlüsselung zu Jev-Preisen, auch zur schnelleren Stufe Jev Ultrafast.
Beim Preis neigt der frühe Luna-Vergleich schon zu Jev:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Bedenke, dass das Lunas Listenpreis ist und kein Decisions-API-Preis. OpenAI könnte den Endpunkt nach der Öffnung ganz anders bepreisen.
Wofür kannst du die Decisions API im Support einsetzen?
OpenAI nannte drei Aufgaben, und jede hat eine klare Support-Variante:
- Inhalte klassifizieren. Ein Ticket taggen nach Anliegen, Produkt oder Stimmung, Spam erkennen oder eine Erstattungsanfrage von einer Rückgabe unterscheiden.
- Anfragen routen. Ein Ticket an Billing, Shipping oder Technik schicken, oder in eine Sprach- oder Stufen-Queue. Das ist das klassische intelligente Routing, die Aufgabe, die OpenAI als eigenes Beispiel wählte. Dasselbe Muster funktioniert für E-Commerce-Routing.
- Die nächste Aktion eines Agenten wählen. Entscheiden, ob er die Bestellung nachschlagen, eine Rückfrage stellen, antworten oder an einen Menschen eskalieren soll, normalerweise auf Basis von Intent-Erkennung.
Die ersten beiden meinen die meisten Teams mit Ticket-Triage, und typisierte Entscheidungen funktionieren dort schon gut. Die meisten Helpdesks liefern auch eine native Version, von Freshdesk Auto-Triage bis zu einer langen Liste von Zendesk-Klassifizierungs-Apps. In einem Test mit echtem Traffic bei einem Schmuck-Onlineshop mit etwa 1.000 Tickets im Monat auf Zendesk und Shopify erreichten eesels typisierte Aufrufe 93 % Triage-Genauigkeit und fingen 100 % des Spams ohne einen einzigen Fehlalarm ab, wobei Spam 22 % dieses Postfachs ausmachte.
Mein eigener Test zeigte, wo die Probleme anfangen. Jedes Setup wählte 40 von 40 Mal die richtige Queue. Bei „Ist eine automatische Antwort sicher?“ kam Luna ohne Reasoning aber nur auf 33 von 40, und selbst GPT-6.1 Sol nur auf 39 von 40. Routing ist der leichte Fall, zu wissen, wann man nicht handelt, der schwere. Eine falsche Queue kostet dich ein paar Minuten, eine falsche automatische Antwort geht direkt an einen Kunden.
Käufer ziehen die Grenze an derselben Stelle. Ein CX-Lead einer Nahrungsergänzungsmarke mit etwa 7.000 Tickets im Monat auf Gorgias sagte eesel in einem Sales-Call, sie könnten nicht jede KI-Antwort von Hand prüfen, die KI müsse also von allem die Finger lassen, bei dem sie sich nicht sicher ist:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Ein Decisions-Endpunkt gibt dir die Antwort. Liefert er nicht auch eine kalibrierte Konfidenz, sagt er dir nicht, wann du ein Ticket in Ruhe lassen sollst, diese Regel musst du also weiter selbst bauen. Bevor du einem Klassifikator eine Aktion anvertraust, lohnt sich ein Blick auf Fehlalarme beim KI-Tagging.
Was wird die Decisions API kosten?
Niemand außerhalb von OpenAI weiß es bisher. Es gibt keine Preiszeile, und OpenAI hat nicht gesagt, ob pro Token, pro Aufruf oder pro Frage abgerechnet wird. Der einzige öffentliche Anhaltspunkt ist vorerst Lunas eigene Preisliste:
| GPT-6 Luna Stufe | Input pro 1M | Gecachter Input pro 1M | Output pro 1M |
|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.50 |
| Batch / Flex | $0.05 | $0.005 | $0.25 |
| Fast | $0.20 | $0.02 | $1.00 |
Zu diesen Preisen kostete mein Test mit 160 Aufrufen $0.047 pro 1.000 Tickets ohne Reasoning und $0.089 bei mittlerem Aufwand. Selbst ein Monat mit 10.000 Tickets bleibt deutlich unter einem Dollar. Die komplette Rechnung und die versteckten Kosten samt Preiskampf mit Jev stehen in meinem Beitrag zu den Decisions-API-Preisen, und der breitere OpenAI-API-Preisleitfaden enthält die Preise aller Modelle. Allein beim Preis ist die Entscheidung nie der teure Teil eines Support-Stacks.
Solltest du jetzt auf der Decisions API aufbauen?
Noch nicht, außer du bist in der Vorschau. Dasselbe Feature kannst du heute schon bauen und den Endpunkt später austauschen. So würde ich entscheiden:
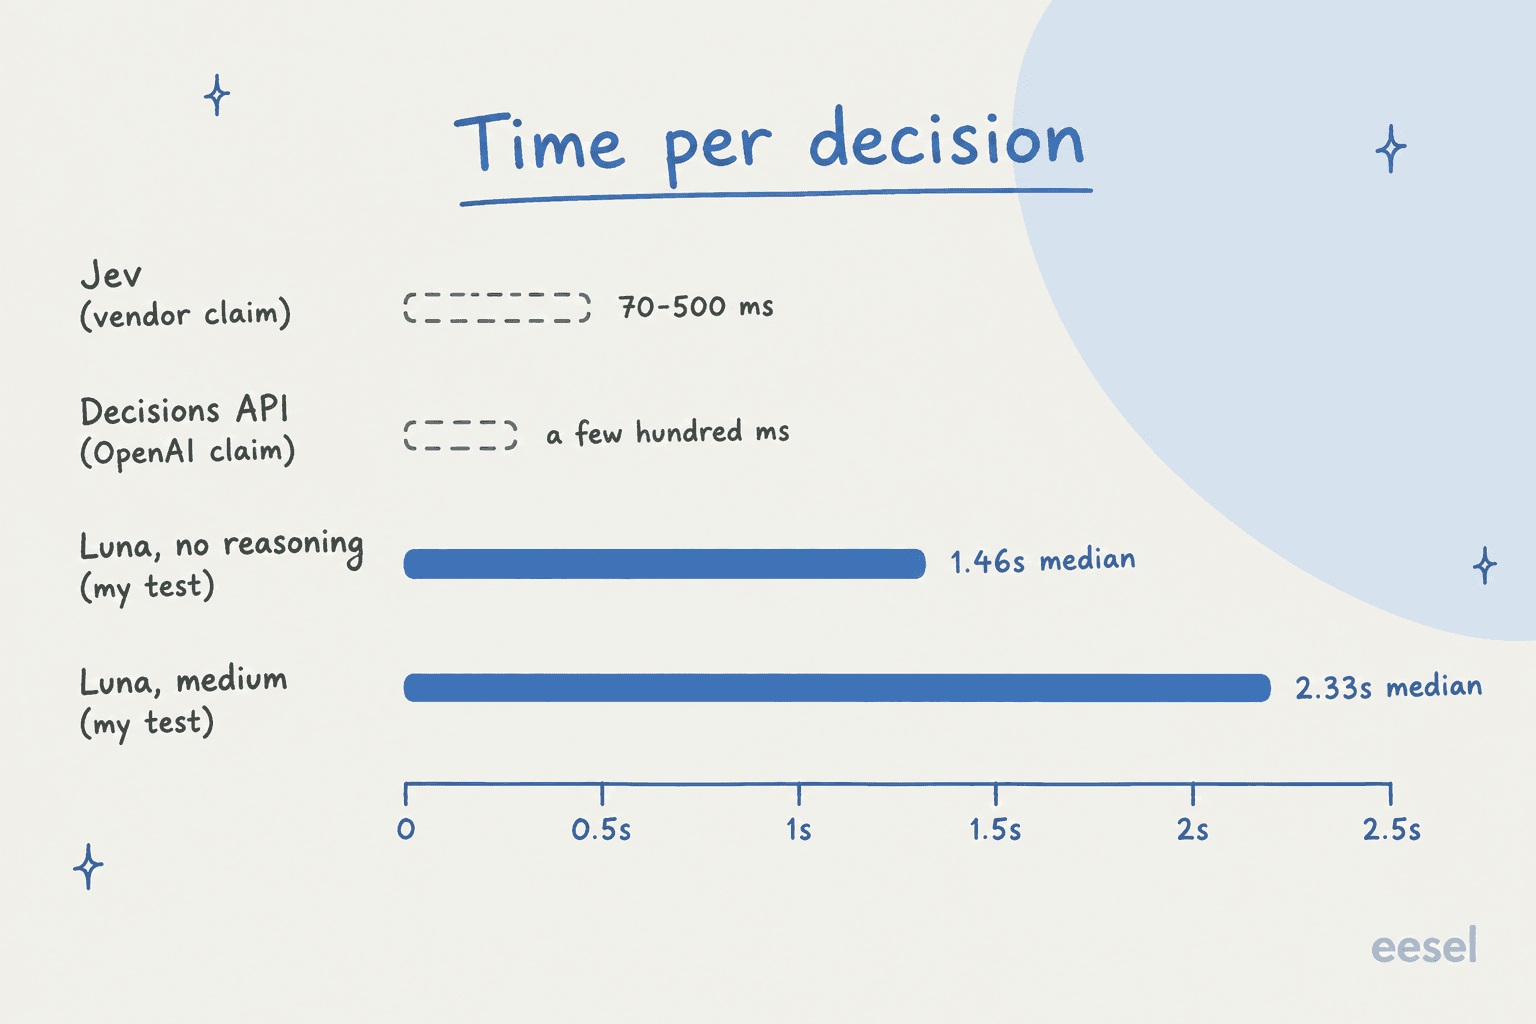
- Du schreibst Code und bleibst bei OpenAI. Liefere Luna mit striktem Enum-Schema und Reasoning auf
noneoderlowaus. Halte die Fragen und die Antwortliste an einem Ort, dann bleibt der Umstieg auf/v1/decisionseine kleine Änderung. Der Beitrag zu Luna-Alternativen behandelt andere kleine Modelle als Ausweichlösung, etwa Gemini 3.5 Flash-Lite. - Du brauchst Antworten unter einer Sekunde bei Text. Teste Jev jetzt. Es ist offen und bepreist, und es liefert auch Wahrscheinlichkeiten. Die Liste der Jev-Alternativen deckt den Rest dieses Feldes ab.
- Deine Inputs sind Bilder. Bleib bei OpenAI. Luna nimmt heute Bilder, und laut API-Changelog hat OpenAI am 25. September einen Bildkodierungsfehler behoben, der das "degraded image understanding" verursacht hatte, wiederhole also ältere Bild-Evals.
- Du willst Routing in Zendesk oder Freshdesk, keine API. Dann kannst du die Endpunkt-Frage ganz überspringen. Starte mit meinem Leitfaden dazu, wie du Ticket-Triage automatisierst, oder dem Überblick über die beste KI für Ticket-Triage. Zendesk-Teams können auch Zendesk Intelligent Triage vergleichen.
Beim Timing haben die Skeptiker einen Punkt:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Ich wäre weniger hart. Eine gesperrte Vorschau ohne Preis ist normal, und die Bildeingabe ist ein echter Unterschied. Trotzdem ist „keine Doku, kein Preis, keine Benchmarks“ Grund genug, diese Woche keine Roadmap darauf zu bauen.
eesel für sicheres Ticket-Routing
Die Decisions API ist Infrastruktur. Sie wählt eine Antwort aus deiner Liste, und alles rund um diese Antwort musst du selbst bauen, etwa die Helpdesk-Anbindung und die Tags, die Regel „an einen Menschen weitergeben“ und ein Protokoll dessen, was sie getan hat. eesel ist das Teammate, das diese Aufgabe schon erledigt. Das KI-Helpdesk-Teammate steigt in deine Queue in Zendesk oder Freshdesk ein, lernt aus deinem Help Center und früheren Tickets und routet, taggt und antwortet dann, mit Eskalationsregeln, die du in einfachem Deutsch schreibst.

Nach meinem Test ist die Entscheidung „Ist eine automatische Antwort sicher?“ der wichtigste Teil, und genau darauf legt eesel seinen Aufwand. Bevor es eine Live-Queue anfasst, spielt eesel Hunderte deiner früheren Tickets nach und bewertet seine Antworten daran, was dein Team tatsächlich gesendet hat, damit die riskanten Fälle auffallen, bevor ein Kunde sie sieht. Jedes Ticket, bei dem es sich nicht sicher ist, geht an einen Menschen.
Wenn du lieber aus Code baust, führt die eesel CLI dasselbe Teammate und denselben Workspace aus einem Terminal aus. eesel instructions bearbeitet die Routing-Regeln, eesel activity listet jedes Ticket auf, das es angefasst hat, und mit eesel approvals kann ein Mensch eine Aktion freigeben, bevor sie passiert. Jeder Befehl gibt JSON aus und unterstützt --dry-run, sodass Skripte und Coding-Agenten wie Claude Code oder Cursor es steuern können, und jeder Workspace funktioniert auch als MCP-Server.
Die Preise gelten pro Ticket, nicht pro Token: Ein Ticket oder Chat ist ein Credit, Pläne starten bei $299 für 500 Credits, und der kostenlose Tarif bietet 100 Credits ohne Karte. Probier eesel an einem Ausschnitt deiner Queue aus und sieh, bei welchen Tickets es sich sicher genug ist, sie zu übernehmen.
Häufig gestellte Fragen
Was ist die OpenAI Decisions API?
Ist die OpenAI Decisions API schon verfügbar?
Was kostet die OpenAI Decisions API?
Wie unterscheidet sich die Decisions API von Structured Outputs?
Ist die OpenAI Decisions API eine Kopie von TypeSafe Jev?
Kann ich die OpenAI Decisions API zum Routen von Support-Tickets nutzen?
Gibt die Decisions API einen Konfidenzwert zurück?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.