Warum überhaupt über GPT-6 Sol hinausschauen
Lass mich Sol zuerst fair behandeln, denn das hat es verdient. Es erschien am 23. September 2026 als Mittelklasse der GPT-6-Familie, zwischen GPT-6 Luna und dem Flaggschiff GPT-6 Astra. OpenAIs Botschaft ist einfach und ehrlich: die gleiche allgemeine Intelligenz wie GPT-5.6 Sol, etwa halb so viele Faktenfehler, zum halben API-Preis. Es hat ein Kontextfenster von 1.050.000 Tokens, Websuche, Code-Interpreter, eine gehostete Shell, Computer-Nutzung und MCP-Unterstützung eingebaut. Für die meisten alltäglichen Chats, Extraktionen und Entwürfe liefert es eine sehr gute Antwort zu einem fairen Preis.
Warum schaut man sich dann überhaupt um? Ein paar konkrete Gründe tauchen immer wieder auf.
Erstens, der Preis bei hohem Volumen. Sols 2 $ Input und 10 $ Output pro 1 Million Tokens liegen im Mittelfeld, nicht günstig. Wenn du ein Modell in einer Agenten-Schleife laufen lässt, die es tausende Male am Tag aufruft, entscheidet der Output-Preis über deine Rechnung, und mehrere Modelle weiter unten berechnen nur einen Bruchteil von Sols 10 $.
Zweitens, es ist an OpenAI gebunden. Sol hat geschlossene Gewichte und ist auf der API überhaupt nicht in der kostenlosen Stufe verfügbar, Tier 1 ist also dein Minimum. Wenn deine Compliance-Vorgaben Self-Hosting erfordern oder du einfach das Risiko eines einzelnen Anbieters vermeiden willst, hilft dir Sol hier nicht weiter.
Drittens, es ist ein Value-Release, kein Fähigkeitssprung. Bei der allgemeinen Intelligenz liegt es etwa auf Höhe des Modells, das es ersetzt. Wenn du wirklich ein klügeres Modell für schwieriges Coding oder Agentenarbeit über lange Zeiträume brauchst, musst du weiter oben in der Palette schauen, nicht seitlich.
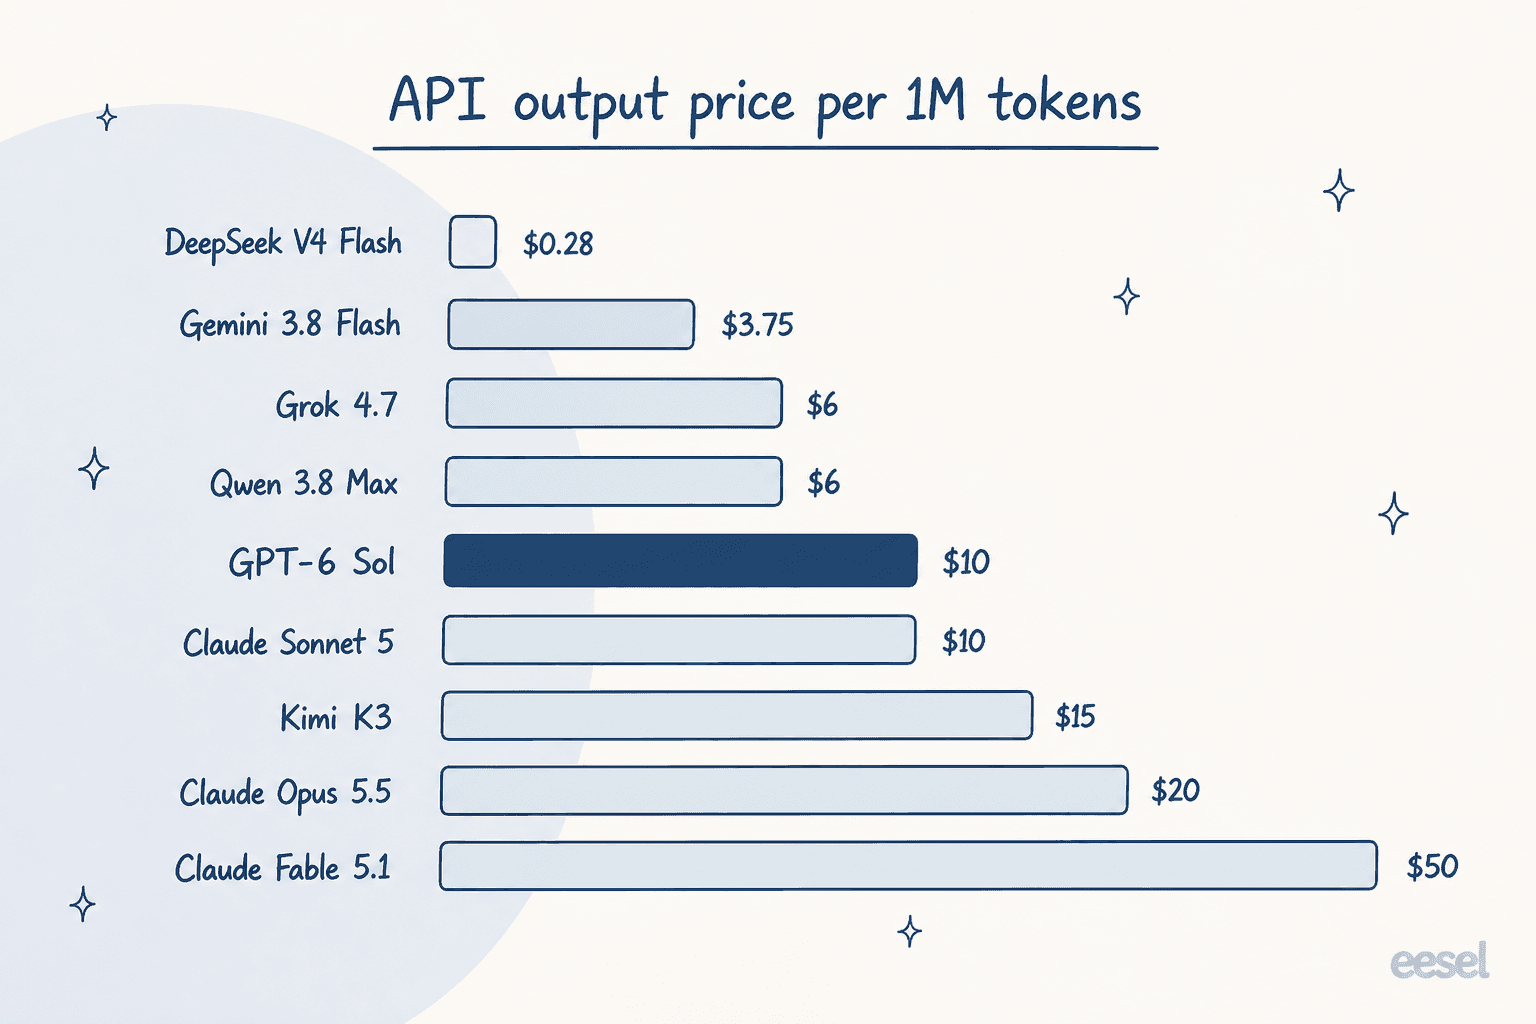
Diese Output-Preisspanne erzählt die ganze Geschichte in einem Bild. Sols 10 $ liegen genau in der Mitte, mit Budget-Modellen, die auf der einen Seite eine Größenordnung günstiger sind, und Frontier-Modellen, die auf der anderen Seite fünfmal teurer sind. In welche Richtung du gehst, hängt ganz von der Aufgabe ab.
Wie ich diese Alternativen ausgewählt habe
Ich habe die Liste auf Modelle beschränkt, die real, allgemein verfügbar sind und die ein Team heute tatsächlich in Produktion nehmen könnte. Ich habe vier Dinge abgewogen:
- Preis, ehrlich betrachtet. Echte Input- und Output-Raten pro 1 Million Tokens, plus die Fallstricke (Aufschläge für langen Kontext, Cache-Preise, Aktionspreise, die auslaufen).
- Leistung fürs Geld. Wo das Modell bei öffentlichen Benchmarks und unabhängigen Messungen wie Artificial Analysis liegt, nicht nur bei der eigenen Grafik des Anbieters.
- Offenheit. Nur geschlossene API oder offene Gewichte, die du herunterladen und hosten kannst.
- Passung zur Aufgabe. Ausgewogenes Arbeitspferd, Frontier-Obergrenze, Budget-und-Geschwindigkeit oder Self-Host. Niemand braucht acht Modelle; man braucht das richtige für die eigene Situation.
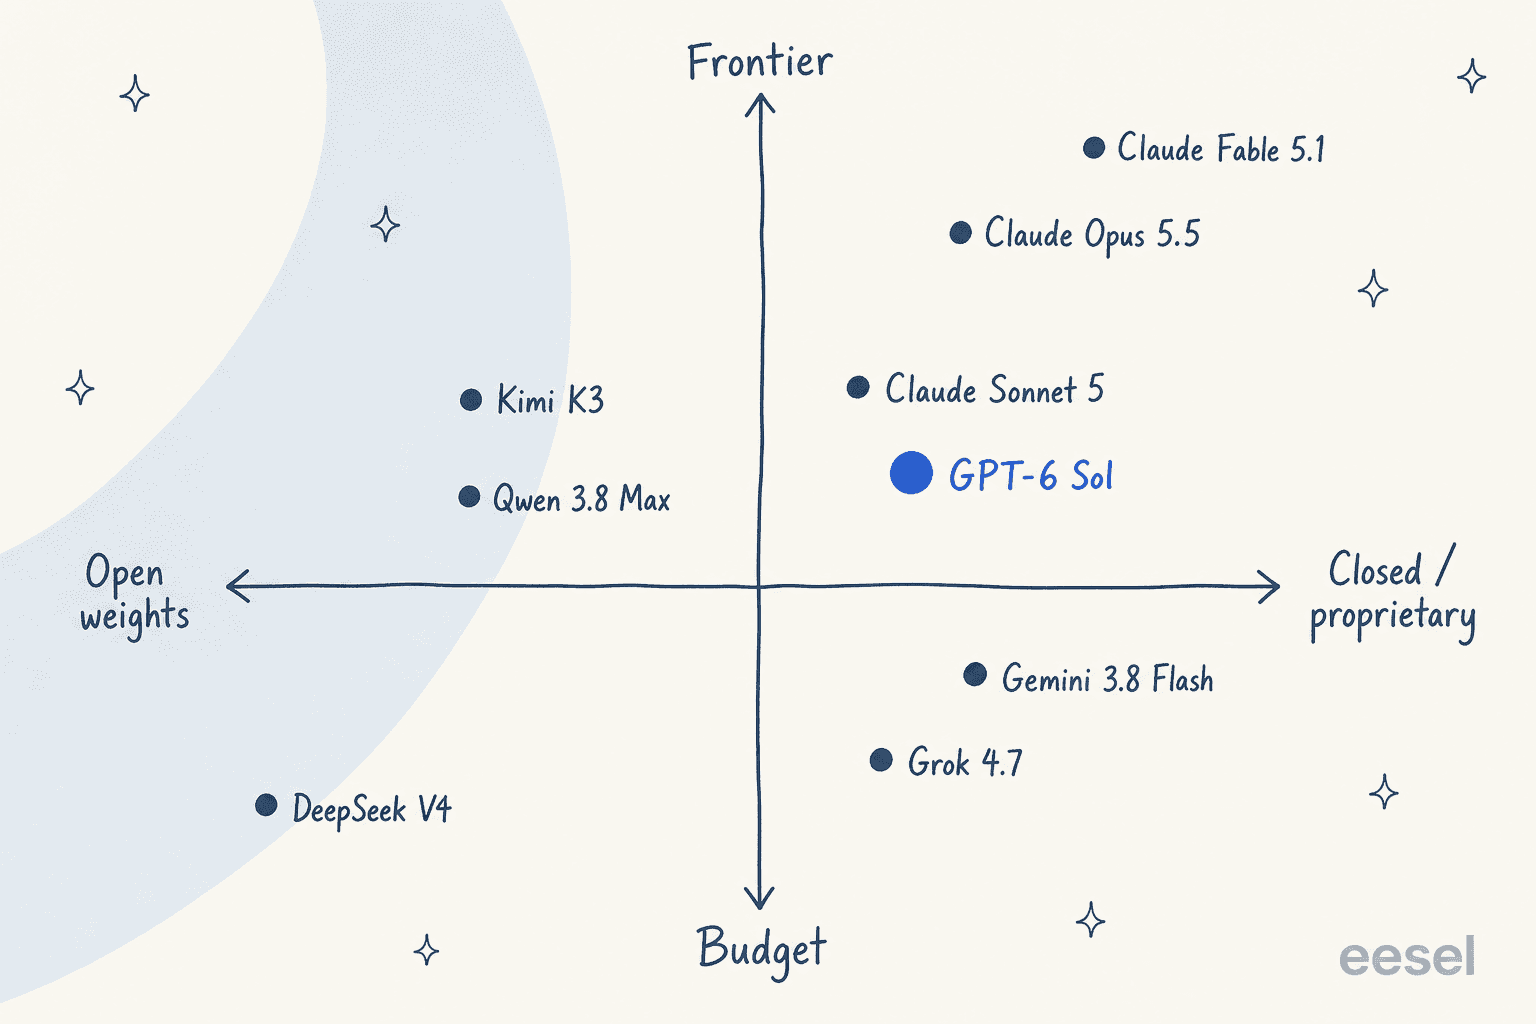
Hier das gesamte Feld auf einen Blick, bevor wir sie einzeln durchgehen.
| Modell | Am besten für | API-Preis (Input/Output pro 1M) | Kontext | Gewichte |
|---|---|---|---|---|
| Claude Sonnet 5 | Drop-in-Tausch zum gleichen Preis | $2 / $10 | 1M | Closed |
| Claude Opus 5.5 | Höhere Obergrenze, per Effort-Stufe einstellbar | $4 / $20 | 1M | Closed |
| Google Gemini 3.8 Flash | Günstigste schnelle Option im großen Maßstab | $0.75 / $3.75 | 1M | Closed |
| Grok 4.7 | Günstigerer Output in Agenten-Schleifen | $2 / $6 | 500K | Closed |
| Kimi K3 | Open-Weight-Flaggschiff | $3 / $15 | 1M | Open |
| DeepSeek V4 | Absolutes Budget + Self-Host | $0.14 / $0.28 (Flash) | ~1M | Open |
| Qwen 3.8 Max | Offenes Ökosystem, mehrsprachig | $2 / $6 | 1M | Open (Basis) |
| Claude Fable 5.1 | Frontier-Obergrenze für schwierige Aufgaben | $10 / $50 | 1M | Closed |
Kurz zur Frage „wer ist am klügsten", weil sie sofort aufkommt. In der Artificial-Analysis-Intelligence-Index-Momentaufnahme vom Tag, an dem Sol und Opus 5.5 beide erschienen, lag Opus 5.5 bei 58 (Platz 1 von 212 Modellen) gegenüber Sols 48. Das ist ein echter Abstand. Aber AA skaliert seinen Index regelmäßig neu, daher habe ich vermieden, hier neben jedem Modell eine einzelne Indexzahl einzufügen; einen Wert aus der Momentaufnahme einer Woche gegen den einer anderen zu vergleichen, ist genau die Art, wie versehentlich Unsinn veröffentlicht wird. Wo ich unten einen Benchmark zitiere, geschieht das auf einer Basis, der ich vertraue.
1. Claude Sonnet 5 – der Drop-in zum gleichen Preis
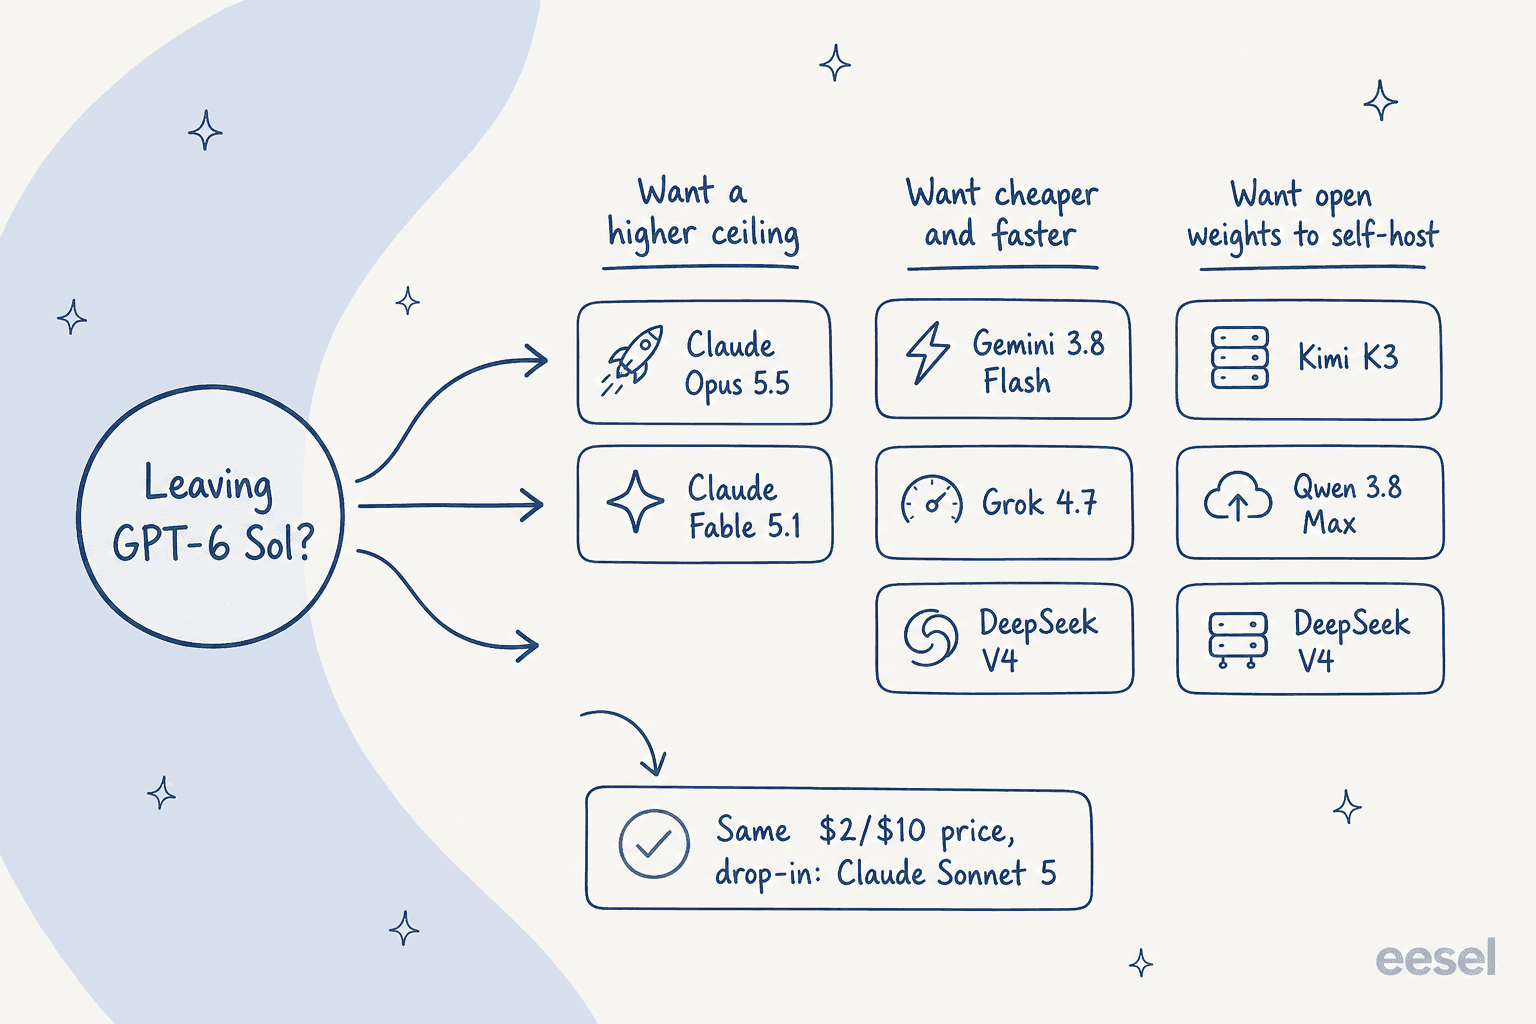
Am besten für: Teams, die ein ausgewogenes Arbeitspferd zu genau Sols Preis wollen, ohne OpenAI-Lock-in.
Wenn Sol das ausgewogene Alltagsmodell ist, dann ist Claude Sonnet 5 derselbe Slot aus dem anderen großen Labor. Und die Preisgestaltung ist nicht nur ähnlich, sie ist identisch: 2 $ Input und 10 $ Output pro 1 Million Tokens, mit Cache-Reads zu 0,20 $. Diese 2 $/10 $ waren kurzzeitig ein Einführungspreis, der auf 3 $/15 $ steigen sollte, aber Anthropic hat die Erhöhung im August 2026 gestrichen, sodass es jetzt der dauerhafte Standardpreis ist, keine auslaufende Aktion.
Für das gleiche Geld bekommst du ein anderes Set an Stärken. Sonnet 5 hat ein 1M-Token-Kontextfenster und den Ruf für klarere Langform-Prosa und stabilere lange Coding-Sessions. Wo es hinterherhinkt: die Aktualität des Wissens. Sein Trainings-Cutoff liegt bei Januar 2026, älter als bei Sol, und Anthropic hat weniger direkte Benchmark-Zahlen im Klartext veröffentlicht als OpenAI.
Vorteile: identische Preise von 2 $/10 $; starkes Schreiben und Coding; 1M Kontext; Absicherung gegen das Risiko, nur auf OpenAI zu setzen, durch einen zweiten Anbieter.
Nachteile: älterer Wissens-Cutoff; weniger veröffentlichte Benchmarks zum Nachprüfen; keine eingebaute kostenlose Stufe auf der API.
Meine Einschätzung: Wenn der einzige Grund, warum du bei Sol bist, „es war die vernünftige Standardwahl" lautet, ist Sonnet 5 die erste Alternative, die du ausprobieren solltest, denn der Wechsel kostet dich preislich nichts und bringt dir Optionalität. Wähle es, wenn dir Prosaqualität wichtig ist oder du Lock-in bei einem einzigen Anbieter vermeiden willst; bleib bei Sol, wenn du stark auf OpenAIs Tool-Ökosystem setzt.
2. Claude Opus 5.5 – ein echter Sprung nach oben
Am besten für: Teams, die mehr rohe Leistungsfähigkeit als Sol brauchen und bereit sind, den Effort-Regler zur Kostenkontrolle zu nutzen.
Opus 5.5 ist das interessante Modell, weil die naive Lesart danebenliegt. Auf dem Papier kostet es mehr als Sol: 4 $ Input, 20 $ Output pro Million, doppelt so viel wie Sols Rate pro Token. Es führte auch den Launch-Tag-Index von Artificial Analysis mit 58 gegenüber Sols 48 an. Es ist also klüger und teurer, und man würde annehmen, dass die Kosten pro Aufgabe dem Preisschild folgen.
Tut sie aber nicht, und das ist der nicht offensichtliche Punkt, den es zu verinnerlichen gilt. Weil du Opus 5.5 über den Reasoning-Effort einstellst, kann die effort-angepasste Kostenrechnung den Vergleich umdrehen. Im direkten Vergleich erzielte Opus 5.5 bei mittlerem Effort 51 Punkte für etwa 1,34 $ pro Aufgabe und schlug damit Sol bei maximalem Effort mit 48 Punkten für 1,06 $ mit einem deutlichen Qualitätsvorsprung für einen kleinen Preisaufschlag. Ganz oben ist Sol pro Aufgabe deutlich günstiger (1,06 $ gegenüber Opus' 5,98 $ bei Maximum), weil Opus deutlich mehr Output-Tokens verbraucht. Aufgabenlänge und Effort sind der entscheidende Faktor, nicht der Modellname.
Opus 5.5 ist zudem Anthropics erstes Opus, das günstiger als sein Vorgänger wird, eine Preissenkung um 20 %, und Anthropic empfiehlt es inzwischen als Startpunkt für die meisten Aufgaben. Die Community sieht das bei der Wortfülle gemischter:
writes like gemini, a drastic improvement over the opus 5.1 claudeisms

Vorteile: klarer Fähigkeitssprung gegenüber Sol; der Effort-Regler lässt dich bei kürzeren Aufgaben günstig Qualität einkaufen; 20 % Preissenkung gegenüber Opus 5; Wissensstand Juni 2026.
Nachteile: teuer pro Aufgabe bei maximalem Effort; kann weiterhin ausschweifend sein; Overkill für einfache Extraktion oder Chat.
Meine Einschätzung: Wähle Opus 5.5, wenn Sols Antworten nicht ganz gut genug sind und du den Effort-Regler tatsächlich anpasst. Wenn du sowieso alles auf Maximum laufen lässt und den Regler nie anfasst, zahlst du für Fähigkeiten, die du nicht nutzt.
3. Google Gemini 3.8 Flash – die günstige, schnelle Option
Am besten für: Workloads mit hohem Volumen, bei denen Kosten und Durchsatz alles andere schlagen.
Wenn dein Engpass das Budget ist, ist Gemini 3.8 Flash der naheliegende Schritt. Es kostet bis zum 31. Dezember 2026 0,75 $ Input und 3,75 $ Output pro Million, danach ab dem 1. Januar 2027 genau das Doppelte (1,50 $/7,50 $). Selbst zum 2027er-Preis unterbietet es Sols Output-Preis. Es hat ein 1M-Token-Eingabefenster, eine kostenlose Stufe, und bei Artificial Analysis liegt es bei der reinen Output-Geschwindigkeit auf Platz drei von 196 Modellen.
Zwei ehrliche Einschränkungen. Erstens: Es ist kein neues Basismodell; Googles eigene Modellkarte schreibt gleich viermal, dass es „auf Gemini 3.7 Flash basiert", und Google rät effizienzorientierten Entwicklern wortwörtlich, bei 3.7 zu bleiben. Zweitens: Durchsatz ist nicht dasselbe wie Reaktionsfähigkeit: AA maß die Zeit bis zum ersten Token mit 13,3 Sekunden gegenüber einem Klassenmedian von 3 Sekunden. Das ist für einen nächtlichen Batch-Job in Ordnung und ein echtes Problem für alles, worauf ein Mensch wartet, etwa eine Live-Chat-Antwort.
Vorteile: günstigste schnelle Option hier; riesiger Kontext; kostenlose Stufe; exzellenter Durchsatz.
Nachteile: langsame Latenz bis zum ersten Token; kein wirklich neues Modell; kann ausschweifend sein und zusätzliche Tokens verbrauchen.
Meine Einschätzung: Greif zu Gemini 3.8 Flash für große Batch- und Hintergrundjobs, bei denen die Kosten pro Token dominieren. Für alles Latenz-Empfindliche disqualifiziert sich das langsame erste Token, und ich würde stattdessen zu Grok oder Sonnet schauen.
4. Grok 4.7 – günstigerer Output für Agenten-Schleifen
Am besten für: agentische Workloads, die das Modell ständig aufrufen und auf den Output-Preis achten.
Grok 4.7 von xAI erschien am 21. September 2026 und zieht bei Sol beim Input gleich (2 $), unterbietet es aber beim Output: 6 $ pro Million gegenüber Sols 10 $, unterhalb eines 200K-Token-Prompts. Es basiert auf einem größeren, neuen Basismodell als Grok 4.6 mit einem längeren Reinforcement-Learning-Lauf, der auf mehrstündige agentische Aufgaben ausgerichtet ist, und liefert einen echten Sprung bei Agenten-Benchmarks, mit fast einer Verdopplung seines Terminal-Bench-4.0-Werts gegenüber 4.6.
Achte auf zwei Dinge. Die Preisgestaltung bei langem Kontext ist eine Falle, die man zweimal lesen sollte: Oberhalb von 200K Prompt-Tokens springt die Rate auf 4 $/12 $ und gilt für alle Tokens der Anfrage, nicht nur den Überschuss. Und bei manchen Evals verliert Grok 4.7 tatsächlich gegen Sol; bei HealthBench Professional erzielt es 56,7 gegenüber Sols 60,5, es ist also nicht überall ein klarer Sieg.
Vorteile: günstigerer Output als Sol; große agentische Verbesserung gegenüber 4.6; starker Sicherheits-Stack; 500K Kontext.
Nachteile: schmerzhafter Preissprung bei langem Kontext; verliert in manchen Bereichen gegen Sol; die „Fast"-Variante gibt es nur in Cursor und Grok Build, nicht auf der öffentlichen API.
Meine Einschätzung: Grok 4.7 ist preislich darauf ausgelegt, mit hohem Volumen in Agenten-Schleifen zu laufen, und genau dort würde ich es einsetzen. Halte die Anfragen nur unter der 200K-Token-Grenze, sonst frisst der Preis für langen Kontext die Ersparnis wieder auf.
5. Kimi K3 – das Open-Weight-Flaggschiff
Am besten für: Teams, die ein Frontier-Modell wollen, das sie tatsächlich herunterladen können.
Kimi K3 von Moonshot AI ist der Ausreißer nach oben, wenn Offenheit zählt. Es ist ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern (104 Mrd. aktiv), mit 1M-Token-Kontext, und entscheidend: Die Gewichte erschienen pünktlich auf Hugging Face, wo der Safetensors-Index die vollen 2,8 Billionen unabhängig von der Pressemitteilung bestätigt. Du kannst es selbst betreiben.
Auf der gehosteten API kostet es 3 $ Input und 15 $ Output pro Million, in derselben Preisklasse wie Claude Sonnet, das ist also nicht das Schnäppchen, das K2 war; der Wert liegt in den offenen Gewichten, nicht in der API-Rate. Bei Benchmarks schlägt es die vorherige Generation der Frontier-Modelle und liegt hinter der aktuellen Spitzenklasse wie Fable 5.1 und GPT-5.6 Sol. Eine Eigenheit, die man kennen sollte: Reasoning lässt sich auf keiner Stufe abschalten, die günstigste Einstellung ist also eine Latenz-Kontrolle, keine echte Kostenstufe.
Vorteile: wirklich offene Gewichte, verifiziert auf Hugging Face; Qualität nahe der Frontier-Klasse; 1M Kontext; native Bildverarbeitung.
Nachteile: API-Preis liegt im Mittelfeld, nicht günstig; Reasoning immer aktiv; öffentliche Bild-URLs werden nicht akzeptiert (nur base64).
Meine Einschätzung: Wenn dein Grund, Sol zu verlassen, ist, dass es closed ist, ist Kimi K3 das stärkste Open-Weight-Flaggschiff zum Selbst-Hosten. Wenn du nur eine günstigere gehostete API willst, sind die 3 $/15 $ nicht die Antwort, und ich würde stattdessen zu DeepSeek schauen.
6. DeepSeek V4 – der Budget-König zum Selbst-Hosten
Am besten für: die absolut günstigste Option pro Token, mit dem Bonus offener Gewichte.
Bei DeepSeek V4 stürzt die Preiskurve regelrecht ab. Die Flash-Stufe kostet 0,14 $ Input und 0,28 $ Output pro Million, etwa ein Fünfunddreißigstel von Sols Output-Preis, dazu noch offene Gewichte. Es gibt hier eine wirklich seltsame Wendung, die man kennen sollte: Nach einem Retraining Ende Juli schneidet die günstige Flash-Stufe derzeit besser ab als die teurere Pro-Stufe, und zwar bei allen neun agentischen Benchmarks, die DeepSeek veröffentlicht, und auch Artificial Analysis führt Flash in seinem eigenen Index vor Pro. Die teurere Stufe ist gerade einfach der ältere Build.
Wo Pro sich weiterhin bewährt, ist bei Recall und dem Auffinden von Details in langem Kontext, etwa bei SimpleQA-Verified und 1M-Token-Retrieval. Und eine faire Einschränkung: Auf der Human-Preference-Rangliste von LMArena liegt Pro weiterhin vor Flash, der automatisierte Index und menschliche Bewerter sind sich also uneinig. Lies beide, bevor du dich festlegst.
Vorteile: mit Abstand am günstigsten hier; offene Gewichte; Flash schlägt weit über seinem Preis.
Nachteile: die Benennung der Stufen ist gerade wirklich verwirrend; Pros Reasoning lässt sich nicht günstig herunterregeln; kleineres Ökosystem als bei den großen Laboren.
Meine Einschätzung: Für kostensensible Arbeit mit hohem Volumen ist DeepSeek V4 Flash preislich unschlagbar und überraschend leistungsfähig. Starte trotz der Namen mit Flash, nicht Pro, und benchmarke an der eigenen Aufgabe, bevor du annimmst, die günstige Stufe sei schlechter.
7. Qwen 3.8 Max – die Wahl für das offene Ökosystem
Am besten für: Teams, die eine offene Basis, starke Mehrsprachigkeit und eine große Cloud im Rücken wollen.
Qwen 3.8 Max von Alibaba wurde am 2. August 2026 allgemein verfügbar. Es ist ein Mixture-of-Experts-Modell mit 2,4 Billionen Parametern (95 Mrd. aktiv) mit 1M Kontext, mit einem Preis von 2 $ Input und 6 $ Output pro Million, gleichauf mit Sol beim Input und besser beim Output. Auf LMArena ist es stark: Platz fünf im Text-Board und Platz zwei bei Vision zum Zeitpunkt der Prüfung.
Die Offenheits-Geschichte hat ein Sternchen. Die Basisgewichte erschienen tatsächlich als Qwen3.8-2.4T-A95B, aber unter einer eigenen qwen3.8-max-Lizenz statt Apache 2.0, und die offene Basis ist funktional nicht gleichwertig zum gehosteten Max (das Vision, Non-Thinking-Modus und eingebaute Tools hinzufügt). Wenn du ein permissiv lizenziertes Qwen willst, ist das kleinere Qwen3.8-27B das mit Apache 2.0. Lies also die Lizenz, bevor du darauf aufbaust.
Vorteile: günstigerer Output als Sol; stark auf LMArena, besonders bei Vision und Mehrsprachigkeit; offene Basisgewichte verfügbar.
Nachteile: Max-Lizenz ist individuell, nicht Apache; der offenen Basis fehlen die gehosteten Funktionen; automatisierte und menschliche Rankings zeigen in unterschiedliche Richtungen.
Meine Einschätzung: Qwen 3.8 Max ist eine gute Wahl, wenn du in einem offenen Ökosystem leben willst und Wert auf Mehrsprachigkeit und Vision-Arbeit legst. Nimm nur nicht an, „offen" bedeute „Apache-lizenzierter Drop-in für das gehostete Max", denn das ist es nicht.
8. Claude Fable 5.1 – die Frontier-Obergrenze
Am besten für: die schwierigsten Coding- und Langzeit-Agentenaufgaben, bei denen Qualität die Kosten klar schlägt.
Wenn Sol nicht klug genug ist und der Effort-Regler bei Opus 5.5 immer noch nicht reicht, ist Fable 5.1 die Spitze von Anthropics Claude-5-Familie. Es ist teuer, 10 $ Input und 50 $ Output pro Million, fünfmal Sols Output-Preis, und es tut nicht so, als wäre das anders. Was du kaufst, ist die Obergrenze: Es führt das Feld an bei Terminal-Bench-Science (52,6 %), CursorBench (73,4 %) und HLE-with-Tools (65 %), und es führte die eigene GDPval-Elo-Tabelle des Grok-Teams vor jedem dort gelisteten Konkurrenten an.
Die Praxisbeispiele bleiben am ehesten hängen: Anthropic nennt eine 38-stündige unbeaufsichtigte Agenten-Session bei Ramp und ein Forschungsteam, das ein jahrealtes Problem knackte. Die eine Änderung, die den Preis abmildert, ist die Senkung der Cache-Reads auf 0,25 $ pro Million, günstiger pro gecachtem Token als bei Opus 5.5. Wissenswert, bevor du damit baust: Fable 5.1 entfernte erzwungene Tool-Nutzung (tool_choice any/tool liefert jetzt 400er-Fehler) und fügt allen Ausgaben ein statistisches Text-Wasserzeichen für die Einhaltung des EU-KI-Gesetzes hinzu.
Vorteile: wirklich Frontier-Qualität; große agentische Praxisläufe; günstige Cache-Reads; 1M Kontext.
Nachteile: mit Abstand das teuerste Modell hier; Wasserzeichen und False-Positives bei Ablehnungen frustrieren manche Entwickler; Overkill für Alltagsaufgaben.
Meine Einschätzung: Fable 5.1 ist für die meisten Workloads kein Sol-Ersatz, es ist das Modell, zu dem du eskalierst für die 5 % der Aufgaben, die wirklich schwierig sind. Leite deinen einfachen Traffic zu etwas Günstigem und reserviere Fable für die Arbeit, die es tatsächlich braucht.
Die Frage, die beim Modellwechsel niemand wirklich stellt
Das ist es, worauf ich immer wieder stoße, und deshalb habe ich das Ende vor der Liste geschrieben. Die meisten Leute, die GPT-6-Sol-Alternativen für ein echtes Produkt vergleichen, besonders für den Kundenservice, stellen die falsche Frage. Sie optimieren den Motor, während das, was über Erfolg oder Misserfolg entscheidet, alles ist, was um den Motor herum gebaut ist.
Ich habe die letzten Jahre damit verbracht, KI-Agenten in live laufende Support-Queues bei Tausenden von Unternehmen einzusetzen, und das Muster ändert sich nie. Das Modell ist selten der Flaschenhals. Der Flaschenhals ist: Hat es den echten Kontext deines Unternehmens, kann es echte Aktionen in deinem Helpdesk ausführen, und kannst du ihm vertrauen, bevor es einen echten Kunden berührt? Das haben wir auf die harte Tour gelernt, weshalb jedes eesel-Rollout jetzt zuerst gegen deine historischen Tickets simuliert, sodass du die Lösungsquote und die exakten Antworten auf echte vergangene Tickets siehst, bevor irgendetwas live geht. Eine reine Modell-API gibt dir nichts davon. Sie gibt dir einen sehr klugen Text-Vervollständigungs-Endpunkt und eine Rechnung.
Sol gegen Sonnet 5 oder Gemini Flash zu tauschen ändert deine Token-Kosten. Es verschafft dir für sich genommen keinen Support-Agenten. Das ist eine andere Schicht, und genau darüber würde ich die eigentliche Entscheidung treffen.
eesel ausprobieren

So denke ich darüber: Ein Modell ist Infrastruktur, und eesel ist der Mitarbeiter, den du einstellst, um darauf zu laufen. Du wählst eesel nicht statt GPT-6 Sol oder Claude oder Gemini; du wählst das Teammitglied, und es nutzt im Hintergrund jeweils das Modell, das für die Aufgabe richtig ist. Aktuell besteht dieses Team aus einem einsatzbereiten KI-Helpdesk-Teammitglied, das deiner bestehenden Support-Queue beitritt und dabei dein Help Center und vergangene Tickets bereits kennt, sowie einem KI-Blog-Autor für Content. Jedes kommt mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für seine Rolle, und es wird pro Lösung abgerechnet, nicht pro Token, sodass ein geschwätziges Modell deine Rechnung nicht sprengt.
Wenn du überhaupt zu den Leuten gehörst, die Modell-APIs vergleichen, ist die eesel-CLI wahrscheinlich der schnellste Weg, das zu sehen. Sie ist eine agentenfreundliche Oberfläche über dasselbe Teammitglied und denselben Workspace: Du kannst sie vom Terminal aus steuern, in Skripten automatisieren und Coding-Agenten wie Claude Code, Codex und Cursor direkt damit arbeiten lassen, neben dem MCP-Server, Webhooks und Netzwerkzugriffskontrollen. Derselbe Agent wie im Dashboard, nur headless. Du kannst eesel kostenlos ausprobieren und ihn an deinen eigenen Tickets simulieren, bevor du dich auf irgendetwas festlegst.
Häufig gestellte Fragen
Was ist die beste GPT-6-Sol-Alternative 2026?
Gibt es eine günstigere Alternative zu GPT-6 Sol?
Was ist eine gute Open-Weight-Alternative zu GPT-6 Sol?
Ist GPT-6 Sol besser als Claude Sonnet 5?
Funktionieren GPT-6-Sol-Alternativen für die Automatisierung im Kundenservice?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.