Was GPT-6 Sol eigentlich ist
Bevor es zu den Benchmarks geht, kurz der Rahmen. OpenAI hat GPT-6 Sol und GPT-6 Luna am 22. September gemeinsam veröffentlicht, unterhalb des Flaggschiffs Astra, das am 3. September kam. OpenAIs Linie dazu: "Build with Sol, scale with Luna" – Sol ist das leistungsfähige Mittelklasse-Modell, gegen das man entwickelt, Luna ist die ultragünstige Stufe, auf die man bei hohem Volumen ausweicht.
Wer nur die nüchterne Spezifikations- und Preisübersicht ohne Urteil sucht, findet sie in meinen Beiträgen GPT-6 Sol im Überblick und GPT-6-Sol-Preise. Hier geht es darum, ob es tatsächlich gut ist.
Auf dem Papier ist Sol ein ernstzunehmendes Modell. Es hat ein 1.050.000-Token-Kontextfenster, 128K maximale Ausgabe, einen Wissensstand von April 2026 und das komplette Responses-API-Werkzeugset: Web- und Dateisuche, Code Interpreter, eine gehostete Shell, Computer Use und MCP. Das Reasoning läuft über sechs Stufen, von none bis max, mit medium als Standard. Es nimmt Text und Bild auf, gibt Text aus.
Ich baue beruflich KI-Agenten, deshalb interessiert mich weniger die Schlagzeilen-Kontextzahl als das Verhalten des Modells innerhalb einer Agentenschleife. Und genau hier liegt der interessante Teil dieses Tests, denn die Benchmark-Geschichte und die Verhaltens-Geschichte zeigen in leicht unterschiedliche Richtungen.
Ich habe die letzten gut drei Jahre damit verbracht, KI auf Live-Support-Warteschlangen zu setzen und Modell um Modell in der Produktion zu beobachten. Das Muster ändert sich fast nie: Die Launch-Grafik sagt das eine, die tatsächliche Erfahrung etwas anderes. Statt das Framing "die nächste Generation" für bare Münze zu nehmen, lese ich GPT-6 Sol daher als zwei getrennte Dinge in einem Release: ein kleines Intelligenz-Update und ein großes Preis-Update.
Die zwei Geschichten in einem Release
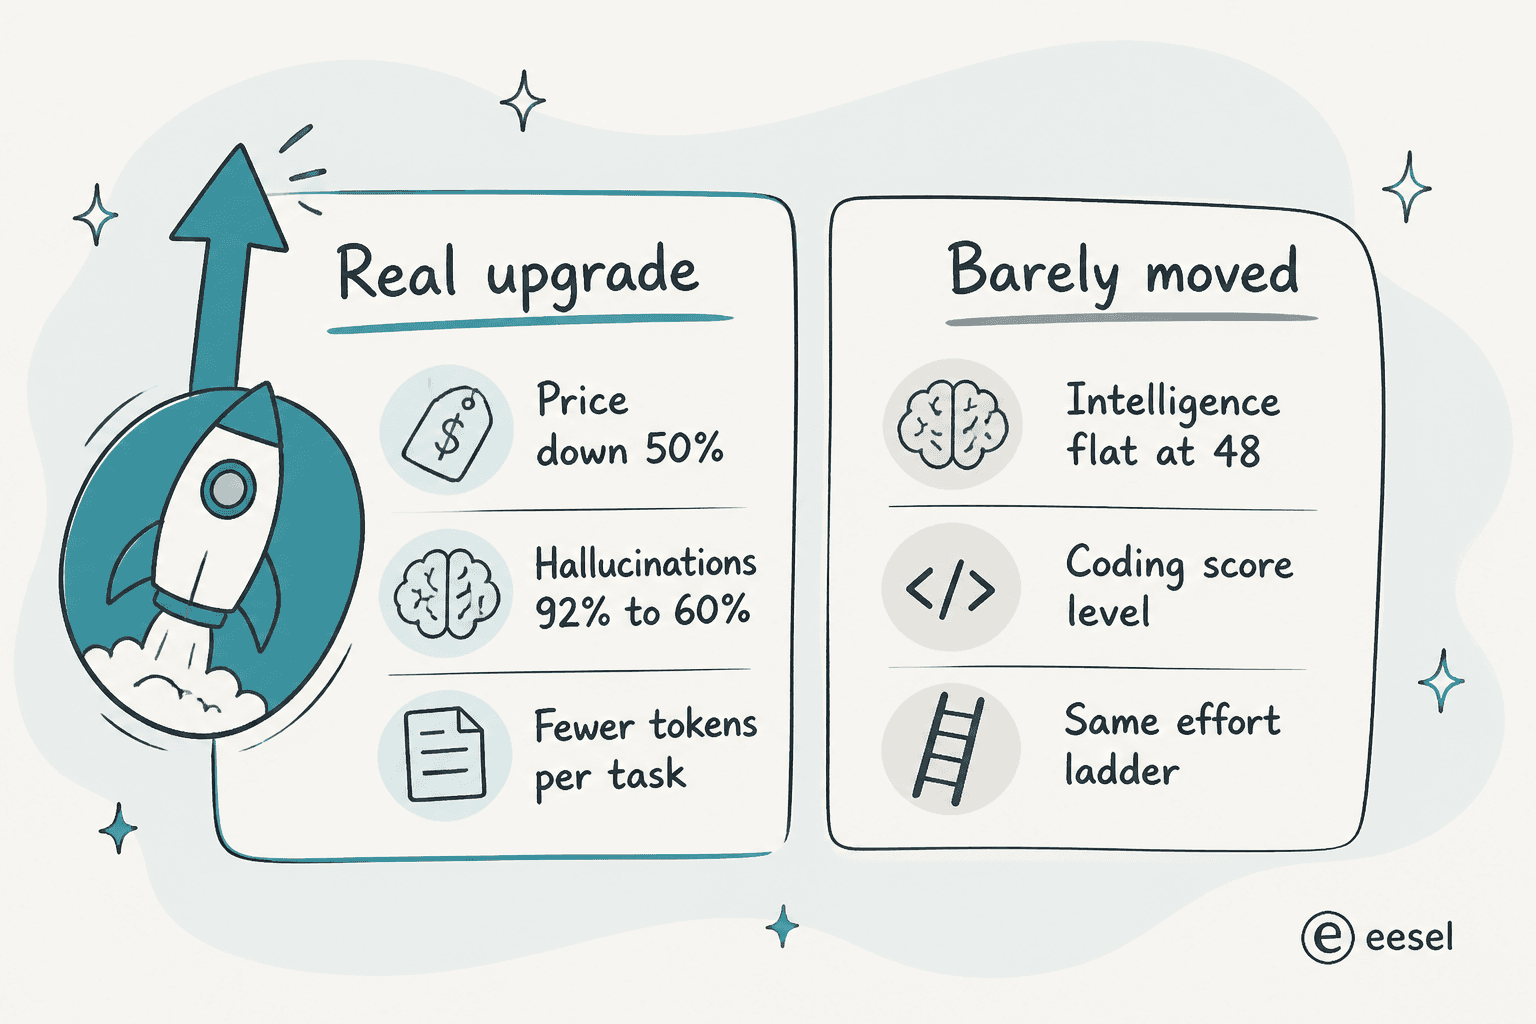
Geschichte eins ist die, mit der OpenAI wirbt: Sol ist deutlich günstiger geworden. Bei 2 $/10 $ unterbietet es GPT-5.6 Sol um die Hälfte, und Artificial Analysis maß die Kosten für den gesamten Intelligence Index mit 1,06 $ pro Aufgabe, etwa 50 % weniger als GPT-5.6 Sol mit 1,99 $. Gecachte Eingaben fallen auf 0,20 $, ein Rabatt von 90 %. Für jeden mit echtem Volumen ist das der gesamte Pitch – und ein starker dazu.
Geschichte zwei steckt in derselben Benchmark-Tabelle: Die Intelligenz hat sich kaum bewegt. Im AA Intelligence Index erreicht GPT-6 Sol bei maximalem Aufwand 48 Punkte, was AA als gleichauf mit GPT-5.6 beschreibt: "Fortschritte in manchen Evals, Rückschritte in anderen." Der Coding Agent Index erzählt dieselbe Geschichte: weitgehend flach, zu einem niedrigeren Preis.
Es gibt einen echten Fähigkeitsgewinn, und er verdient klare Nennung, weil man leicht darüber hinwegliest: Faktentreue. OpenAI gibt an, dass Sol nur etwa halb so viele Fehler macht wie GPT-5.6 Sol, und AAs Halluzinationsrate bei maximalem Aufwand bestätigt das mit einem Rückgang von rund 92 % auf 60 %. Wer das Modell nutzt, um echte Fragen zu beantworten statt Wegwerf-Code zu schreiben, dem sind weniger selbstsicher falsche Antworten womöglich mehr wert als ein weiterer Punkt oder zwei bei der reinen Denkleistung.
"Insgesamt denke ich, dass für die meisten Anthropic der Gewinner von heute war. Ich persönlich bevorzuge in sehr, sehr frühen Tests Opus 5.5 auf medium gegenüber GPT-6 Sol Max. Ähnliche Preisklasse, mehr Fähigkeiten."

Der Kommentar ist fair und die ehrliche Gegenposition zu Sol: Wer das Budget hat, findet ein klügeres Modell. Aber er vergleicht auch Sol bei maximalem Aufwand mit Opus bei medium, und wie ein anderer Leser in einer Antwort anmerkte, sind das keine gleichwertigen Einstellungen. Das bringt mich zum Teil dieses Tests, der mir am wichtigsten erscheint.
Wie es sich in einem Agenten tatsächlich verhält
Rohe Punktzahlen erfassen nicht, wie sich die Arbeit mit einem Modell anfühlt. Zwei Verhaltensweisen tauchten in den Entwickler-Reaktionen immer wieder auf, und beide decken sich mit dem, was ich beim Einbinden von OpenAI-Modellen in Agentenschleifen gesehen habe.
Das erste ist Token-Effizienz. GPT-6 Sol verbraucht im AA-Index etwa 31.000 Output-Token pro Aufgabe, gegenüber rund 119.000 bei Opus 5.5. Das sind knapp 4x weniger Token für eine ähnlich gute Antwort, was ein großer Grund ist, warum es sich schnell anfühlt und die Rechnung niedrig bleibt. Es ist auch der leise Grund, warum ein "pro Token günstigeres" Modell pro fertiger Aufgabe sogar noch günstiger sein kann, als der Listenpreis vermuten lässt.
Das zweite ist Übereifer, und hier hat Sol einen echten Nachteil:
"OpenAI-Modelle sind auch deutlich eifriger als die von Anthropic, die eher auf der trägeren Seite liegen. Unbeaufsichtigt wird Sol/Astra versuchen, ein sha256-verifiziertes Raketenschiff zu bauen, wenn man sie bittet, eine Race Condition in der eigenen To-do-Listen-App zu beheben."
Ich musste darüber lachen, weil es zutrifft. Gibt man Sol eine kleine Aufgabe ohne enge Eingrenzung, überkonstruiert es munter drauflos. In einem Agenten heißt das: Sie verlassen sich stärker auf Ihre Anweisungen und Guardrails als bei einem trägeren Modell. Kein Fehler im eigentlichen Sinn, eher eine Persönlichkeit – aber eine, um die man herum designen muss.
Die Kehrseite dieser Persönlichkeit ist die Prosa. Dan Shipper von Every brachte den Unterschied im Schreibstil klar auf den Punkt:
"Sol verbessert sich gegenüber GPT-5.6 – unter anderem mit besserem Ruby-Code in @kieranklaassens Tests –, aber Opus 5.5 hat die höhere Obergrenze für lange, autonome Builds."
Seine vollständige Einschätzung ist die klarste Zusammenfassung dieses Vergleichs, die ich gelesen habe: Sol schreibt sauberen, minimalen Text und stellt die wichtige Idee voran, während Opus die höhere Obergrenze für lange autonome Arbeit hat. Das ist der Trade-off in einem Satz.
Die Aufwands-Leiter ist die eigentliche Entscheidung
Das übersehen die meisten Sol-Tests: Bei sechs Reasoning-Stufen ist "wie gut ist GPT-6 Sol" die falsche Frage. Die richtige lautet "wie gut bei welchem Aufwand, zu welchem Preis."
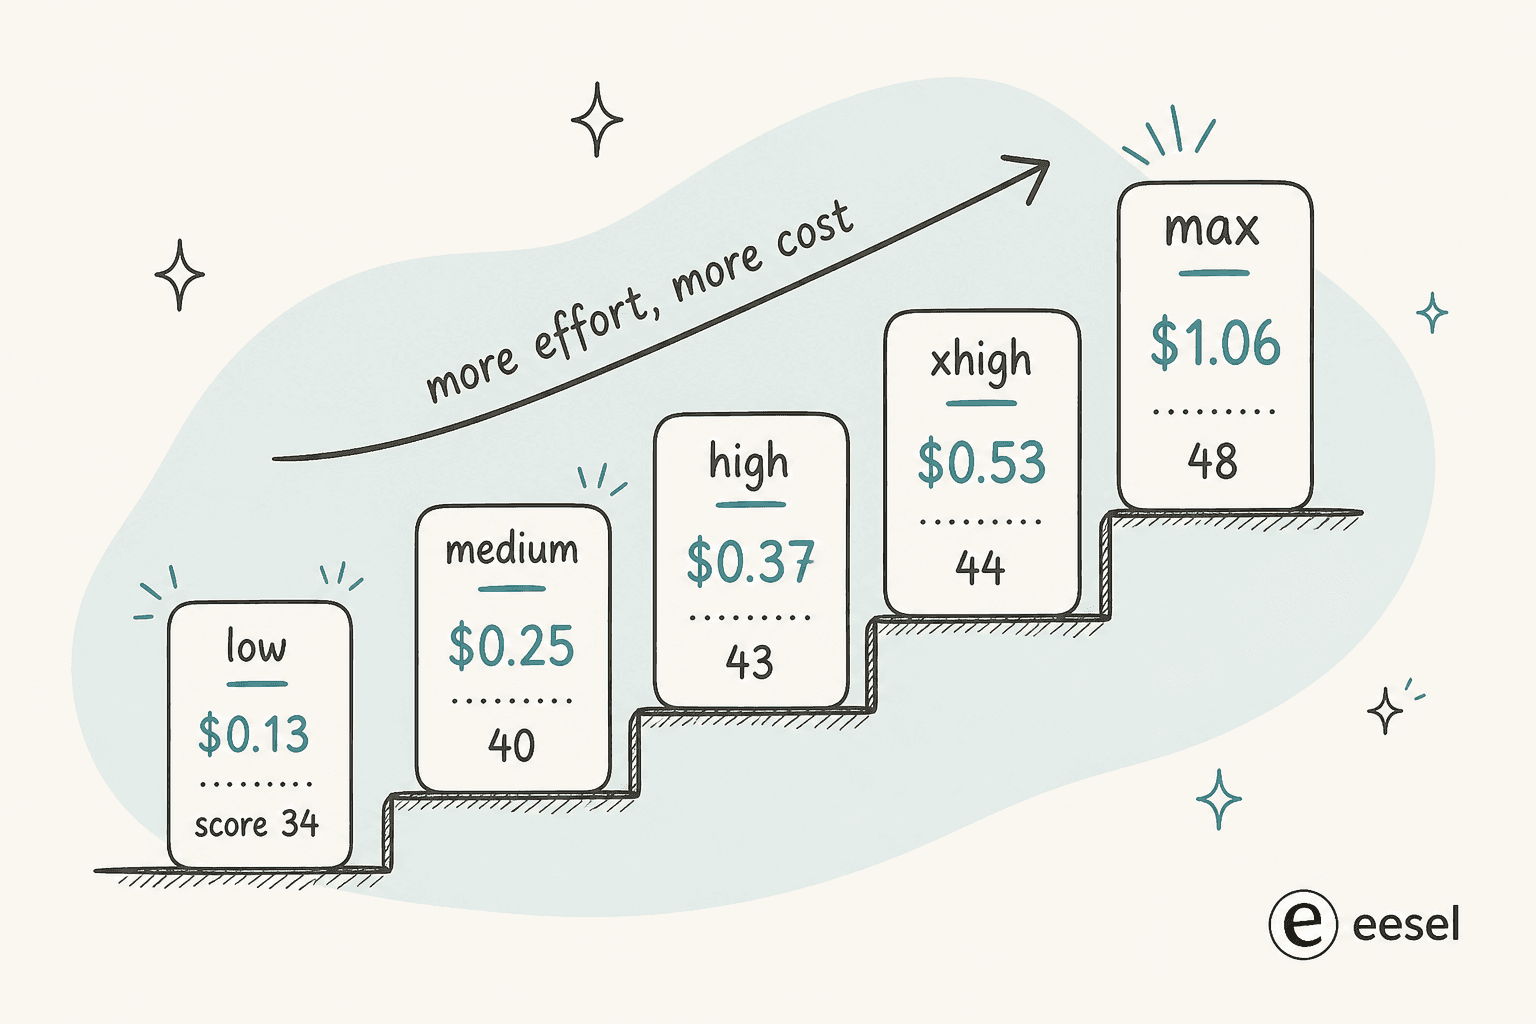
AA veröffentlichte die vollständige Aufwandskurve, und die Spanne ist groß. Low effort erreicht 34 Punkte bei 0,13 $ pro Aufgabe; max effort erreicht 48 Punkte bei 1,06 $. Das ist ein 8-facher Kostensprung für 14 Indexpunkte. Für einen Großteil der echten Arbeit liegt die Mitte dieser Leiter im Sweet Spot, nicht die Spitze. Der Auswahlhelfer unten ist das mentale Modell, das ich nutze, um zu entscheiden, welche Stufe ich wähle.
Welche GPT-6-Sol-Aufwandsstufe?
Wählen Sie die Aufgabe. Werte und Kosten pro Aufgabe stammen aus dem Artificial Analysis Intelligence Index.
Hier liegt auch der ehrliche Vorbehalt zur Obergrenze. Selbst bei max liegt Sols 48 unter Opus 5.5s 58 und unter OpenAIs eigenem Astra. Wenn Ihre Arbeit wirklich die Spitze des Marktes braucht, ist Sol nicht die richtige Wahl. Aber die meiste Arbeit braucht das nicht, und genau diese Lücke sparen Sie sich zum halben Preis.
Preise: der eigentliche Grund, sich dafür zu interessieren
Ich sage es geradeheraus: Der Preis ist der eigentliche Test. So schlägt sich Sol gegenüber seinen Geschwistern und seinem engsten Rivalen.
| Modell | Input/Output (pro 1M) | Gecachter Input | AA Intelligence | Kosten pro AA-Aufgabe |
|---|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,01 $ | nicht gelistet | n/a |
| GPT-6 Sol | 2 $ / 10 $ | 0,20 $ | 48 | 1,06 $ |
| GPT-6 Astra | 10 $ / 50 $ | 1,00 $ | ~61 | höher |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,20 $ | 58 | 5,98 $ |
Zwei Dinge fallen auf. Erstens ist Sol bei den Token-Preisen halb so teuer wie Opus 5.5, was ein Leser als Argument nutzte, dass beide nicht einmal in derselben Klasse spielen. Zweitens, und das hat mich überrascht: Weil Sol so viel weniger Output-Token verbraucht, liegen die Kosten pro fertiger Aufgabe (1,06 $) näher an einem Fünftel von Opus 5.5 (5,98 $), nicht bei der Hälfte. Die Lücke pro Token unterschätzt die tatsächliche Lücke in der Praxis.
Zwei Vorbehalte gehören zur Ehrlichkeit dazu. Der Fast-Modus verdoppelt den Preis auf 4 $/20 $, und Eingaben über 272.000 Token treffen auf einen Long-Context-Aufschlag, der, wie ein Leser anmerkte, Sols Preisvorteil schmälert, sobald man riesige Kontexte füttert. Wenn Ihr Workflow wirklich langkontext-lastig ist, rechnen Sie noch einmal nach. Mein Beitrag GPT-6-Sol-Preise hat die vollständige Stufentabelle, und der Leitfaden Codex-Preise erklärt, wie sich das innerhalb des Abos statt der API niederschlägt.
Wer es wirklich nutzen sollte
Nach alledem hier meine klare Empfehlung.
Nutzen Sie GPT-6 Sol, wenn Sie Ihren Alltag in Codex oder der API mit alltäglichem Coding, Textentwürfen und Q&A verbringen und ein schnelles, günstiges, vorhersehbares Modell wollen, das nicht unnötig Token verbrennt. Wer bislang GPT-5.6 Sol genutzt hat, bekommt ein klares Upgrade: gleiche Intelligenz, halbe Kosten, weniger Halluzinationen. Meine Wahl als Standard bei hohem Volumen.
Schauen Sie sich anderswo um, wenn Sie die höchste Obergrenze für lange, autonome, mehrstündige Builds brauchen – dann verdienen sich Opus 5.5 oder Astra ihren Aufpreis –, oder wenn Ihre Arbeit stark langkontext-lastig ist, wo der Aufschlag die Ersparnis auffrisst. Und wenn Sie KI-Agenten bauen: Sols Übereifer bedeutet engere Eingrenzung und Guardrails, nicht weniger davon.
Für einen vollständigen Vergleich zur Spitzenfrage geht mein Beitrag GPT-6 Sol vs. Opus 5.5 und der kritische GPT-6-Astra-Test tiefer, als ich es hier kann, und die OpenAI-Modellübersicht zeigt die ganze Produktpalette.
Die Lücke zwischen einem Modell und einer Fachkraft
Hier ist die Falle, in die ich Teams jede Launch-Woche aufs Neue tappen sehe – und ein guter Abschluss. Ein Benchmark-Spitzenreiter ist noch kein arbeitendes Teammitglied. GPT-6 Sol ist ein schneller, günstiger, fähiger Motor, aber eben nur ein Motor: Wer die rohe API an die Support-Warteschlange hängt, übernimmt Retrieval, Guardrails, die Helpdesk-Integration, das Testen und jede falsche Antwort, die es am ersten Tag selbstsicher ausliefert.
Genau dieser letzte Teil hat mir meine Narben eingebracht. Wir haben schon erlebt, wie ein selbstsicher klingender Bot leise falsche Antworten in einer Live-Warteschlange gibt – deshalb wird jeder Rollout heute gegen Tausende historische Tickets simuliert, bevor er echte Kund:innen berührt. Ein rohes Modell liefert davon nichts.
Genau darauf baut eesel: Ein Modell ist Infrastruktur, eesel ist die Fachkraft. eesel ist eine Plattform für KI-Teammitglieder, und Sie stellen einsatzbereite Teammitglieder für konkrete Aufgaben ein. Die aktuelle Besetzung: ein KI-Helpdesk-Teammitglied und ein KI-Blog-Autor, jeweils mit den Fähigkeiten, Integrationen und dem Firmenkontext für ihre Rolle ausgestattet. Das Helpdesk-Teammitglied übernimmt Ihre bestehende Warteschlange, lernt aus Ihren vergangenen Tickets und rechnet pro Lösung ab, sodass Sie es an den Kosten einer menschlichen Fachkraft messen können, statt zu raten. Das ist der Unterschied zwischen einem rohen Conversational-AI-Experiment und echten Support-Kosteneinsparungen, die sich in Zahlen ausdrücken lassen.

Und wer Sol gerade deshalb mochte, weil es im Terminal lebt, findet bei eesel dasselbe. Die eesel-CLI steuert dasselbe Teammitglied und denselben Workspace über die Kommandozeile: Eine Person kann sie interaktiv nutzen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex oder Cursor können sie headless bedienen. Sie können Quellen verbinden, Anweisungen einspielen, eine Simulation über historische Tickets laufen lassen und Aktivitäten prüfen, alles ohne das Dashboard zu öffnen. Es ist dieselbe agentenfreundliche, MCP-fähige Oberfläche, die Sie sich wünschen würden, wenn Sie selbst auf Sol aufbauen würden – nur dass Retrieval und Guardrails schon erledigt sind. Sie können eesel kostenlos testen.
Häufig gestellte Fragen
Der FAQ-Block oben beantwortet die häufigsten Fragen zum GPT-6-Sol-Test, von den Preisen bis zum Vergleich mit Astra und Opus 5.5. Wer zwischen Modellen entscheidet, beginnt am besten mit dem Vergleich GPT-6 Sol vs. Opus 5.5 und schaut sich dann das Ranking der besten KI-Agenten an, wenn es darum geht, wirklich Tickets zu lösen statt nur Prompts zu beantworten.
Häufig gestellte Fragen
Lohnt sich GPT-6 Sol gegenüber GPT-5.6 Sol?
Wie viel kostet GPT-6 Sol?
Ist GPT-6 Sol besser als Claude Opus 5.5?
Worin ist GPT-6 Sol am stärksten?
Wie unterscheidet sich GPT-6 Sol von GPT-6 Astra?
Kann ich GPT-6 Sol für den Kundensupport nutzen?
Ist GPT-6 Sol im kostenlosen Plan verfügbar?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.