Was GPT-6 Sol wirklich ist
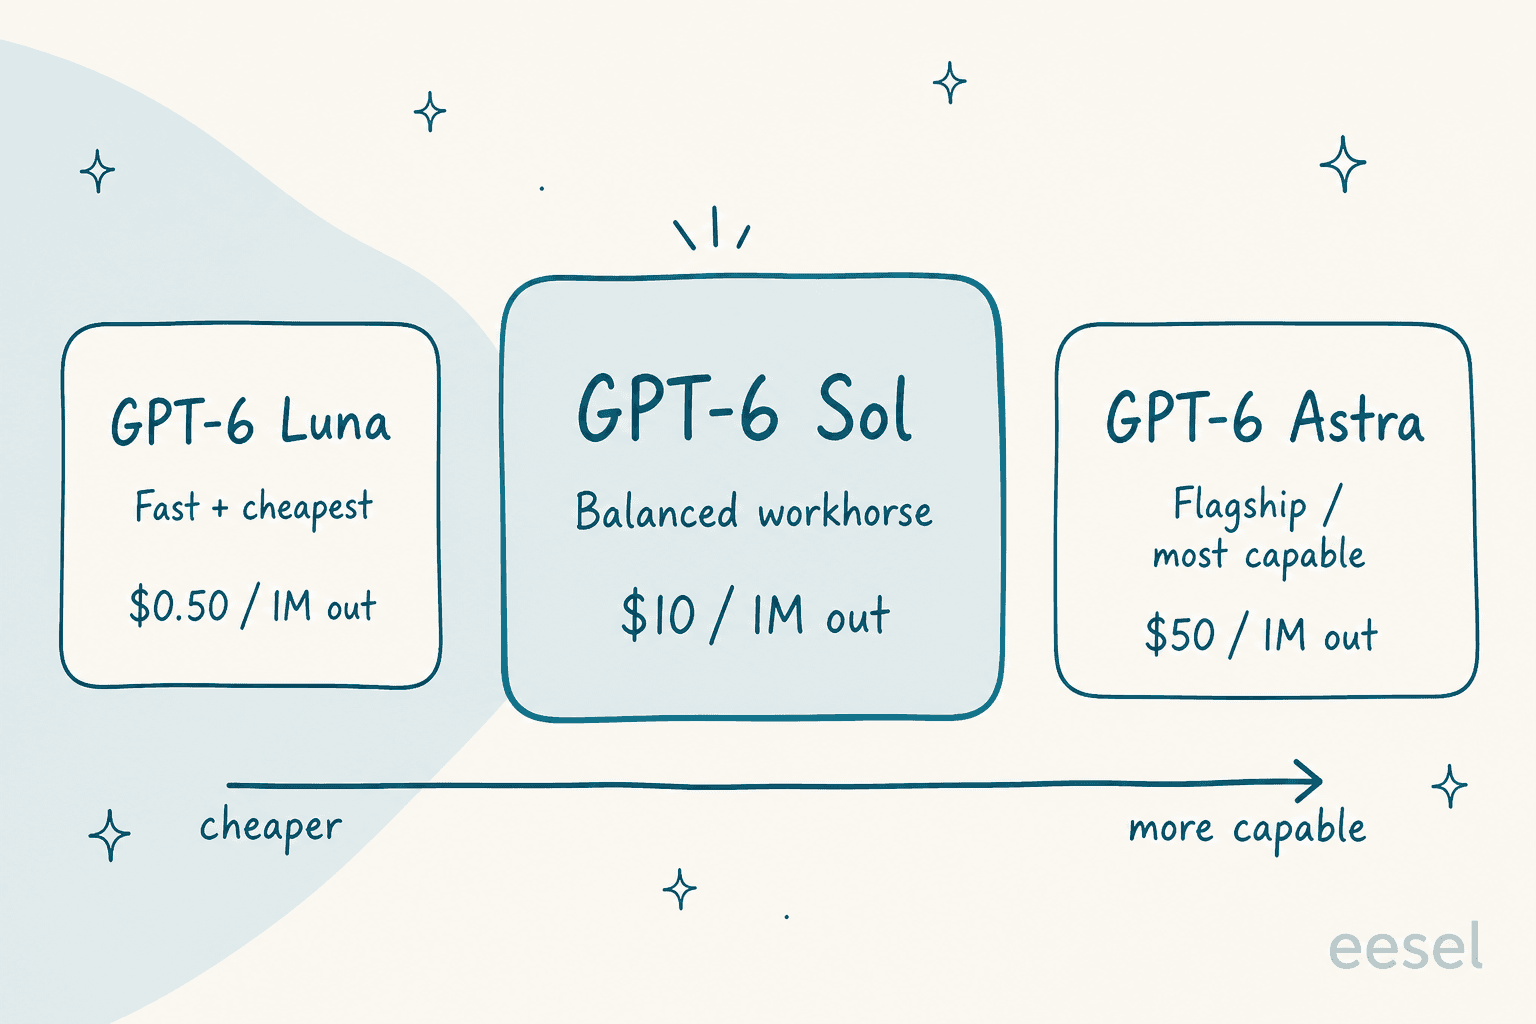
GPT-6 Sol ist das ausgewogene Modell der mittleren Stufe in OpenAIs GPT-6-Reihe. Es erschien zusammen mit dem kleineren GPT-6 Luna am 23. September 2026, drei Wochen nach dem Flaggschiff GPT-6 Astra. OpenAIs eigener Kurzsatz sagt genau, wie man die beiden neuen Modelle einordnen sollte: "Build with Sol. Scale with Luna." Sol ist das Alltagsmodell, Luna die günstige Option für hohes Volumen, und Astra ist der Spitzenmotor, den man einsetzt, wenn eine Aufgabe ihn wirklich braucht.
Unter der Haube liefert die Modellkarte die für die Entwicklung relevanten Spezifikationen: Die Modell-ID lautet gpt-6-sol, mit einem Kontextfenster von 1.050.000 Token, maximal 922.000 Token Input, 128.000 Token Output und einem Wissensstand vom 20. April 2026. Es verarbeitet Text und Bilder als Input und liefert Text zurück, und der Reasoning-Aufwand reicht von none über medium (Standard) bis max. Über die Responses API stehen Websuche, ein Code Interpreter, eine gehostete Shell, Computernutzung und MCP-Unterstützung zur Verfügung. Mit anderen Worten: die gleiche Werkzeugpalette wie beim Flaggschiff, zum Preis des Arbeitspferds.
Die eine Zahl, die zählt: der halbe Preis
Das ist der Grund, warum es GPT-6 Sol überhaupt gibt. Auf der API-Preisseite kostet Sol in der Standardstufe 2 $ pro Million Input-Token und 10 $ pro Million Output-Token, mit zwischengespeichertem Input für 0,20 $ und Cache-Writes für 2,50 $. Das ist ein pauschaler Rabatt von 50 % gegenüber den 4 $/20 $ von GPT-5.6 Sol.
Beide neuen Modelle erhielten die gleiche Behandlung. GPT-6 Luna sinkt auf 0,10 $ Input und 0,50 $ Output. Auf OpenRouter wurde der Sol-Preis von 2 $/10 $ bereits am ersten Tag bestätigt, und das klarste Community-Urteil zum Launch, aus einem viel beachteten Hacker-News-Kommentar, war unverblümt: "~gleiche Leistung für das 0,5-Fache des Preises." Das ist das ganze Produkt in einem Satz.
Wer das vollständige Bild will, einschließlich der Batch- und Flex-Stufen, die den Preis noch einmal halbieren, der Fast-Modus-Stufe, die ihn verdoppelt, und dem Long-Context-Aufschlag: All das habe ich im eigenen Leitfaden GPT-6-Sol-Preise aufgeschlüsselt. Die Kurzfassung für diesen Beitrag: Für die meisten Standard-Workloads ist Sol jetzt der günstigste Weg, die Intelligenz der letzten Generation aus OpenAIs API herauszuholen.
Der Realitätscheck bei den Benchmarks
Hier müssen Launch-Rhetorik und Zahlen getrennt betrachtet werden, denn "halber Preis" ist nur dann eine gute Nachricht, wenn die Qualität gehalten hat.
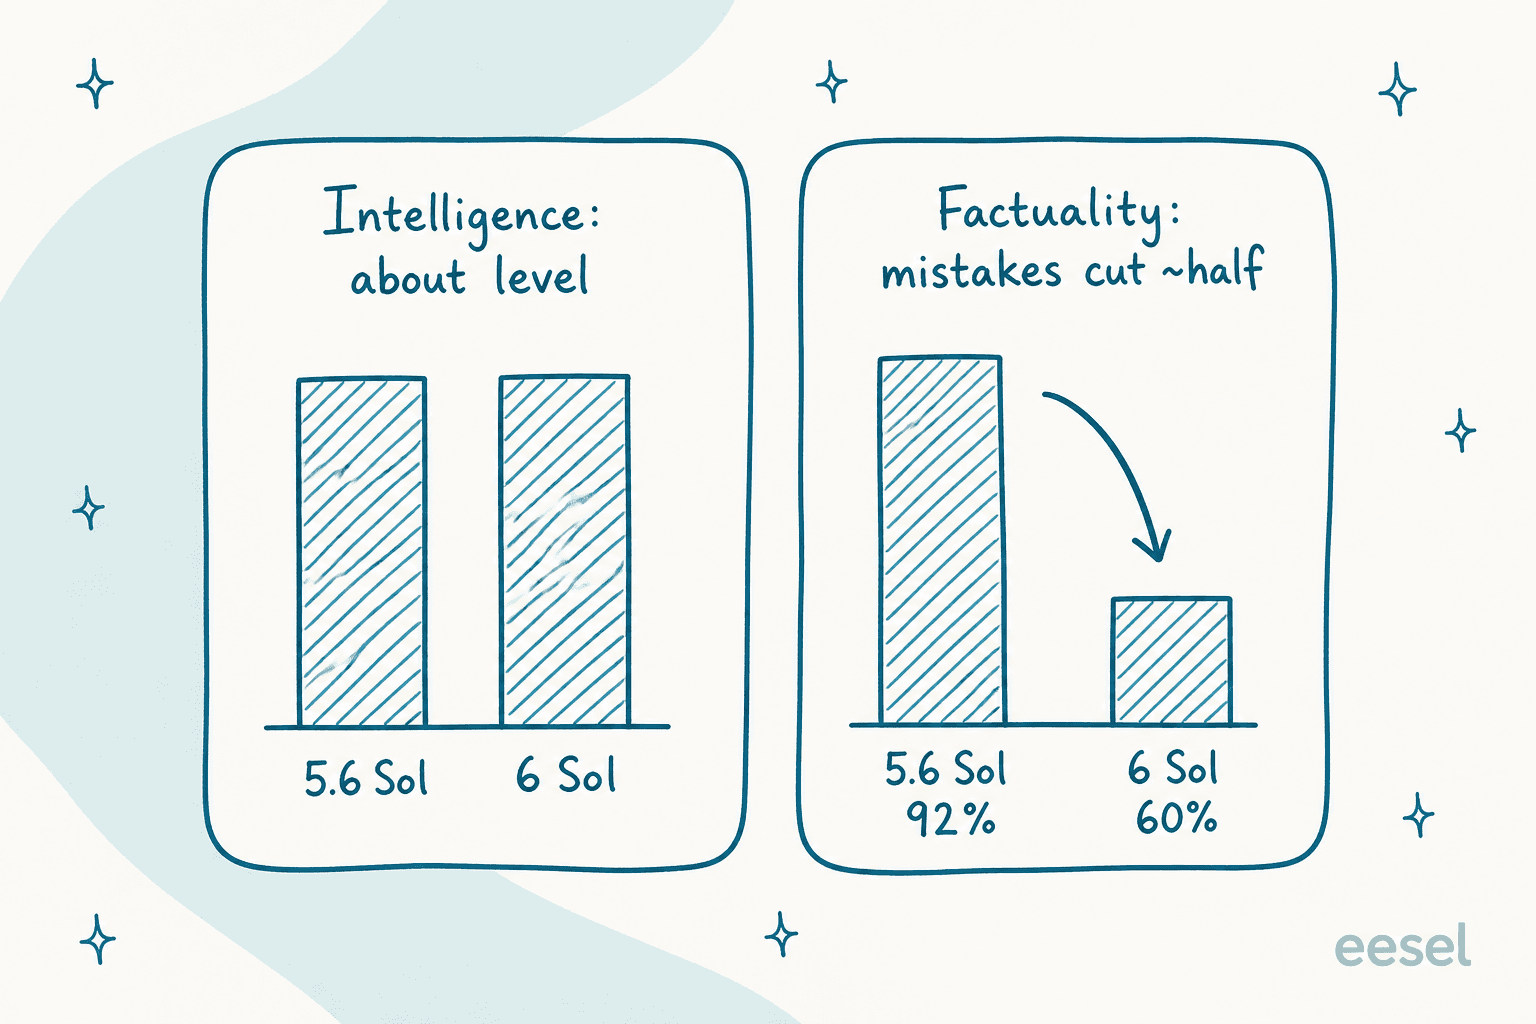
Bei der allgemeinen Intelligenz blieb sie in etwa konstant. Artificial Analysis berichtete, dass GPT-6 Sol sowohl beim Intelligence Index als auch beim Coding Agent Index gleichauf mit GPT-5.6 Sol liegt, mit "Fortschritten bei manchen Evals, Rückschritten bei anderen." Die agentischen Benchmarks erzählen die gleiche moderate Geschichte: AutomationBench-AA bei 62 gegenüber 60, Terminal-Bench 4.0 bei 44 gegenüber 40, und AA-Omniscience klettert leicht von 22 auf 27. Das sind Deltas eines Punkt-Releases, kein Generationssprung, und OpenAI gibt auch nichts anderes vor.
Die eigentliche Verbesserung liegt woanders, leiser: bei der Faktentreue. OpenAI zufolge macht GPT-6 Sol etwa halb so viele Faktenfehler wie GPT-5.6 Sol und nähert sich dem Niveau von Astra an. Unabhängige Max-Effort-Tests senkten die Halluzinationsrate von 92 % auf 60 % (bei Luna verbesserte sie sich von 93 % auf 77 %). Für alles, bei dem eine falsche, aber selbstbewusst vorgetragene Antwort teuer wird, und Kundensupport ist genau diese Art von Arbeit, ist ein günstigeres Modell mit weniger Halluzinationen ein besseres Geschäft als ein paar Benchmark-Punkte.
Beim Coding gibt es einen fairen Vorbehalt. OpenAIs eigenes DeepSWE-v1.1-Ergebnis setzt Sol bei 68,8 %, innerhalb von etwa einem Punkt des besten Werts von Anthropics Fable 5, und bei etwa 80 % geringeren Kosten pro Aufgabe. Beim Preis-Leistungs-Verhältnis für Coding-Agenten ist Sol also sehr wettbewerbsfähig. Es erreicht das jedoch, weil es günstig ist, nicht weil es klüger ist als sein Vorgänger.
Wie GPT-6 Sol sich innerhalb der Familie einordnet
Am klarsten lässt sich Sol im Vergleich zu seinen beiden Geschwistern einordnen. Luna ist die Volumen-Option, Astra die Spitze, und Sol ist diejenige, auf die die meisten Teams standardmäßig zurückgreifen sollten.
| Modell | Input / Output (pro 1 Mio.) | Kontext | Am besten für | Im kostenlosen ChatGPT? |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | 1.050.000 | Aufgaben mit hohem Volumen und Kostenfokus | Ja (Free + Go) |
| GPT-6 Sol | $2.00 / $10.00 | 1.050.000 | Alltäglicher Standard für Build-and-Ship | Nein (ab Plus) |
| GPT-6 Astra | $10.00 / $50.00 | 1.050.000 | Autonome Computernutzung, Coding, Sicherheit | Nein (ab Plus) |
Quelle: OpenAI-API-Preise. Das Muster ist bewusst gewählt: das gleiche riesige Kontextfenster bei allen drei Modellen, eine Verfünffachung des Output-Preises bei jeder Stufe und eine klare Aufgabe für jedes. Die meisten, die aus reinem Neues-Modell-Reflex zu Astra greifen würden, bekämen 95 % des Werts bereits mit Sol – genau die Entscheidung, zu der OpenAI mit "Build with Sol" anstößt.
Welches GPT-6-Modell sollten Sie tatsächlich verwenden?
Wenn Sie für ein echtes Projekt zwischen den dreien wählen, kommt es meist darauf an, was die Aufgabe ist, nicht darauf, welches Modell am neuesten ist. Wählen Sie unten Ihren Anwendungsfall.
Was bauen Sie gerade?
So erhalten Sie Zugang
GPT-6 Sol wurde am Launch-Tag ausgerollt, aber wo Sie es bekommen, hängt davon ab, wie Sie arbeiten.
- API: Die Modell-ID lautet
gpt-6-sol, verfügbar über Responses und Chat Completions. Es gibt keinen kostenlosen Zugang, Tier 1 ist also das Minimum, beginnend bei 500 Anfragen pro Minute. Die üblichen Rate-Limits skalieren mit Ihrer Nutzungsstufe. - ChatGPT und Codex: Sol steht Plus- (20 $), Pro-, Business-, Enterprise- und Edu-Nutzern zur Verfügung, laut Launch-Hinweis. Free- und Go-Nutzer (8 $) erhalten in der Desktop-App nur Luna.
- Speziell für Codex: Da Sol das "Build-with"-Modell ist, fügt es sich natürlich in agentisches Coding ein, und die Wirtschaftlichkeit ist für tagelange Sitzungen günstiger als bei Astra. Wer hier kalkuliert, sollte einen Blick auf die Aufschlüsselung der Codex-Preise werfen.
Der Zugang über ein ChatGPT-Abo ist ein etwas besseres Geschäft, als der reine API-Rabatt vermuten lässt, da die 50%ige API-Senkung sich mit den bestehenden Plan-Kontingenten summiert. Wenn Sie Sol jedoch in ein Produkt einbinden, ist die API der Ort, an dem sich die Preisgeschichte tatsächlich niederschlägt.
Was GPT-6 Sol für Entwickler bedeutet
Wenn Sie mit der API entwickeln, ist die praktische Erkenntnis einfach: Das ist ein kostenloses Upgrade. Richten Sie Ihre bestehende GPT-5.6-Sol-Integration auf gpt-6-sol aus, und Sie erhalten in etwa die gleiche Ausgabequalität, weniger Halluzinationen und eine Rechnung, die sich gerade halbiert hat. Es gibt kaum einen Grund, das nicht zu tun, und das gemeinsame 1-Mio.-Kontextfenster bedeutet, dass Sie auf der Input-Seite nichts einbüßen.
Wo ich langsamer machen würde, ist überall dort, wo Sie versucht waren, direkt zu Astra zu greifen. Die Kosten eines KI-Agenten werden bei langen Aufgaben von Output-Token dominiert, und Astra kostet beim Output das 5-Fache von Sol. Solange Ihr Workload nicht wirklich die autonome, mehrstufige Art ist, für die Astra gebaut wurde, erledigt Sol die Aufgabe für ein Fünftel des Preises. Modellieren Sie das anhand Ihres eigenen Traffics, bevor Sie sich festlegen, genauso wie Sie jede Entscheidung zu den Kosten des KI-Kundensupports abwägen würden.
Hier lohnt sich auch ein Blick auf die eesel-CLI, wenn Sie lieber vom Terminal aus arbeiten. Sie ist eine agentenfreundliche Möglichkeit, denselben eesel-Workspace zu steuern, den auch das Dashboard bereitstellt: Eine Person kann sie manuell bedienen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können sie direkt aufrufen. Wenn Sie also der Typ Entwickler sind, der gpt-6-sol lieber von der Kommandozeile aus auf einen Support-Workflow ansetzt, statt sich durch eine Oberfläche zu klicken, existiert dieser Weg – und er steuert denselben getesteten Teamkollegen statt eines separaten Add-ons.
Was es bedeutet, wenn Sie ein Support-Team leiten
Hier möchte ich nützlich sein statt atemlos, denn ich baue in genau diesem Bereich, und die ehrliche Antwort ist etwas kontraintuitiv.
Wenn Sie Kundensupport oder internes Ops leiten, ändert ein günstigeres, etwas wahrheitsgetreueres Modell weniger, als der Launch suggeriert. Ein rohes Modell wie Sol ist Infrastruktur. Es ist ein leistungsfähiger Motor, aber von Haus aus kennt es Ihre Rückerstattungsrichtlinie nicht, es kann Ihre letzten 50.000 Tickets nicht sehen, es hat keinen Zugriff auf Ihr Bestellsystem, und es gibt keine sichere Möglichkeit, es an Ihrer echten Warteschlange zu testen, bevor es beginnt, Kunden zu antworten. Die meisten Menschen setzen "das Modell wurde günstiger und genauer" mit "mein Support wurde besser" gleich, dabei sind das zwei sehr unterschiedliche Projekte.
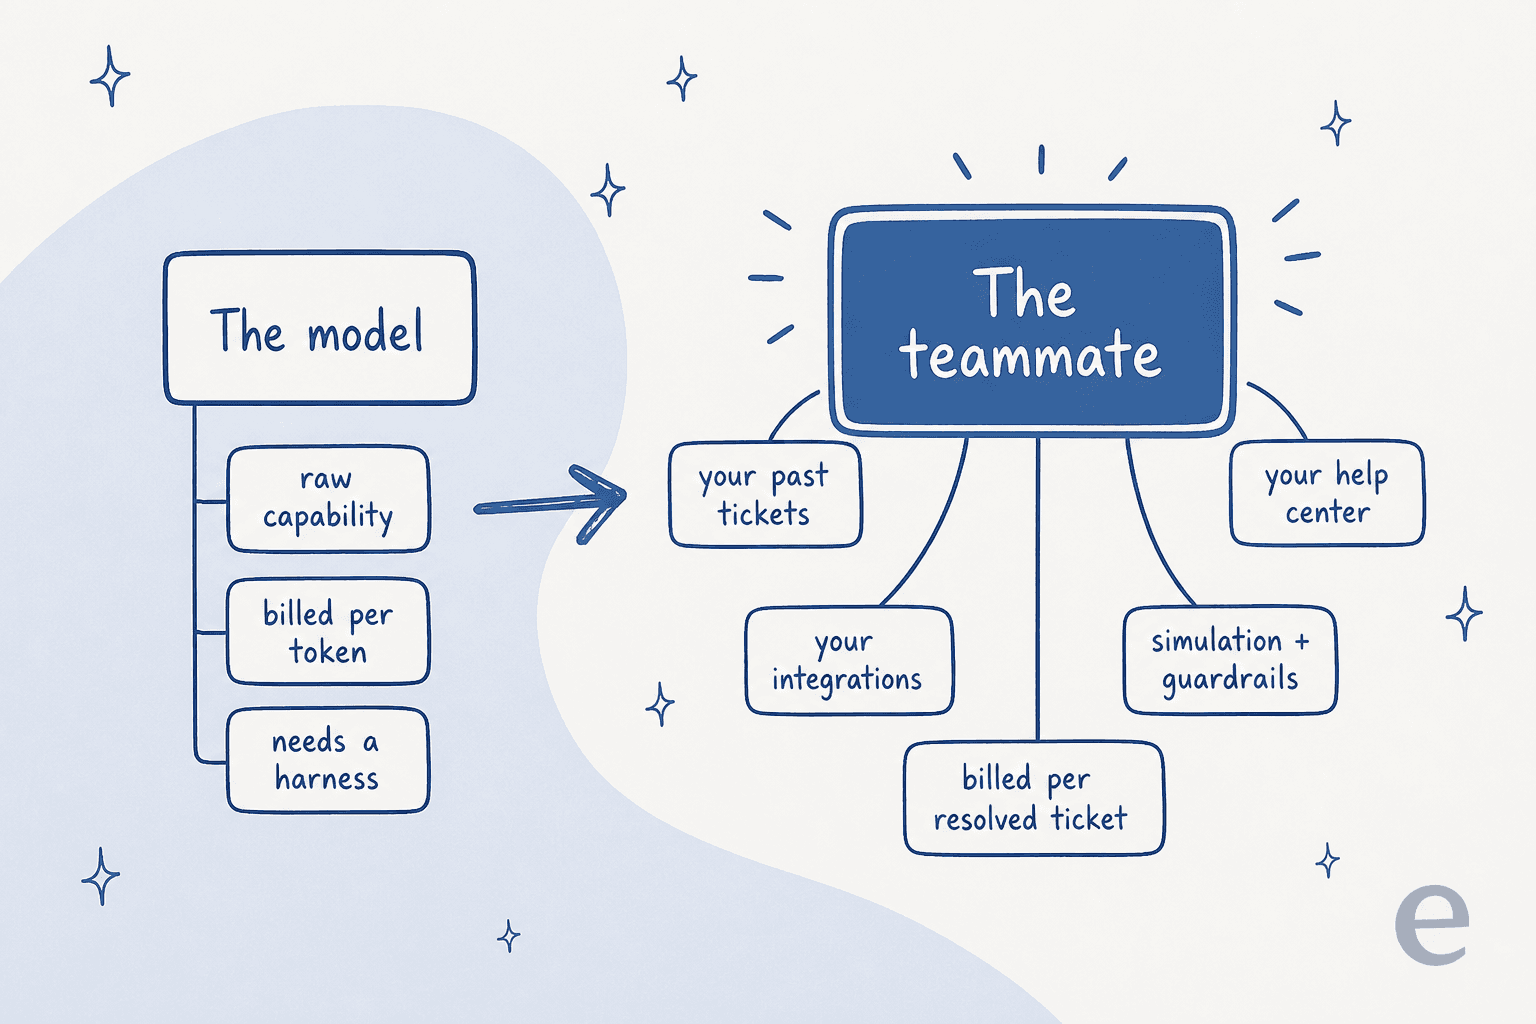
Die Arbeit, die die Lösungsrate wirklich bewegt, ist die Schicht rund um das Modell: die Anbindung an Ihr Wissen, die Einbindung in das Helpdesk, das Sie bereits nutzen, die Ausstattung mit Aktionen, die es sicher ausführen kann, und die Möglichkeit, es an Ihrer eigenen Historie zu simulieren, bevor es live geht. Ich habe Jahre damit verbracht, KI auf Live-Support-Warteschlangen einzusetzen, und die Lektion, die sich immer wiederholt, ist: Ein selbstbewusst klingender Bot auf einem großartigen Modell muss trotzdem an Ihren echten früheren Tickets getestet werden, denn das ist der einzige Weg, um zu wissen, wie er sich verhalten wird. Ein günstigeres Modell mit weniger Halluzinationen ist ein netter Rückenwind. Es war nie der ganze Job.
Das ist auch der Grund, warum ich nicht überstürzt Ihre Support-Automatisierung in der Woche umstellen würde, in der ein neues Modell erscheint. Die besten KI-Helpdesk-Agenten und KI-Agenten sind von Natur aus modellflexibel, sodass Sie das Upgrade übernehmen, sobald ein deutlich besseres oder günstigeres Modell erscheint, ohne irgendetwas neu aufzubauen. Das Unterscheidungsmerkmal war nie, welches Modell Sie angeflanscht haben. Es ist alles andere.
eesel ausprobieren
Wenn Ihr eigentliches Interesse an GPT-6 Sol lautet: "Wie bekomme ich eine KI, die mehr Tickets löst, und das günstig", dann ist das die Aufgabe, für die ein KI-Teamkollege gebaut ist, und genau dort setzt eesel an. GPT-6 Sol ist der Motor; eesel ist der Teamkollege, den Sie einstellen, um ihn zu steuern. Der KI-Helpdesk-Agent trainiert mit Ihren früheren Tickets und Ihrem Help Center, bindet sich in das Helpdesk ein, das Sie bereits nutzen, statt es zu ersetzen, und lässt Sie ihn simulieren an Tausenden Ihrer echten historischen Tickets, sodass Sie genau sehen, wie er sich verhalten wird, bevor er ein Live-Gespräch berührt.

Die Abrechnung erzählt dieselbe Geschichte wie das Produkt. Statt pro Token fürs Denken zu zahlen, zahlen Sie pro gelöstem Ticket, das tatsächlich bearbeitet wird, ohne Gebühren pro Sitzplatz und ohne Plattform-Minimum, sodass die Kosten den Ergebnissen folgen statt dem Modell-Geplauder. Und weil eesel modellflexibel ist, ist ein günstigeres, genaueres Modell wie GPT-6 Sol ein Vorteil, den Sie kostenlos erben, keine Migration, die Sie selbst durchführen müssen.
GPT-6 Sol ist ein echtes, willkommenes Release: die gleiche Intelligenz wie die letzte Generation, weniger Fehler, halber Preis. Aber für die meisten Teams war das Modell nie der Engpass. Einen getesteten, angebundenen, verantwortlichen Teamkollegen in Ihren bestehenden Workflow zu bringen, das ist es – und dafür lohnt es sich, Ihre Energie einzusetzen. Sie können kostenlos starten, ohne Kreditkarte, ihn auf einen Ausschnitt Ihrer Warteschlange ansetzen und die Lösungszahlen an Ihren eigenen Tickets sehen.
Häufig gestellte Fragen
Was ist GPT-6 Sol?
Wie viel kostet GPT-6 Sol?
Ist GPT-6 Sol besser als GPT-5.6 Sol?
Ist GPT-6 Sol im kostenlosen Plan verfügbar?
Was ist der Unterschied zwischen GPT-6 Sol und GPT-6 Astra?
Wie greife ich über die API auf GPT-6 Sol zu?
gpt-6-sol, verfügbar über die Responses- und Chat-Completions-APIs mit einem Kontextfenster von 1.050.000 Token und maximal 128.000 Token Output. Die üblichen OpenAI-Rate-Limits gelten je nach Nutzungsstufe, beginnend bei 500 Anfragen pro Minute in Tier 1. Es unterstützt Websuche, Code Interpreter, eine gehostete Shell, Computernutzung und MCP.Sollte ich meine Support-Automatisierung auf GPT-6 Sol umstellen?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.