Warum Menschen nach einer GPT-6-Luna-Alternative suchen
Lass mich erst mal fair zu Luna sein, denn das hat es verdient. Als OpenAI am 23. September 2026 Sol und Luna vorstellte, war die Schlagzeile eine pauschale Preissenkung von 50 % gegenüber der GPT-5.6-Generation. Simon Willison fasste die Stimmung im Launch-Thread zusammen:
"GPT-6 Luna being half the price of GPT-5.6 Luna is a really big deal."

Mit $0.10/$0.50 pro 1M Tokens, einem 1,05M-Token-Kontextfenster und Bildeingaben ist Luna viel Modell fürs Geld. Es ist zudem das Standard-Billigmodell für Millionen Menschen, da es das einzige GPT-6-Modell in ChatGPT Free und Go ist. Ein weiterer Kommentator brachte den Wert auf den Punkt:
"6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model."
Warum also überhaupt vergleichen? Drei echte Gründe tauchen immer wieder auf:
- Preis bei hohem Volumen. Wenn du täglich Millionen Tokens durch einen Classifier, eine Zusammenfassungs-Engine oder eine Batch-Pipeline schickst, summiert sich selbst Lunas winzige Output-Rate, und ein paar Modelle listen niedriger.
- Offene Gewichte. Luna ist geschlossen und nur per API nutzbar. Wenn du aus Datenschutz-, Souveränitäts- oder Kostengründen selbst hosten musst, musst du OpenAI ganz verlassen.
- Eine bestimmte Stärke. Reichere multimodale Eingaben (Audio, Video, PDF), schnellere Antwortzeiten für ein Live-Chat-Widget oder eine Datenrichtlinie, die alles auf westlicher Infrastruktur hält. Luna ist ein starker Generalist, aber bei keinem davon führend.
Hier siehst du, wo die acht Alternativen bei der einen Zahl liegen, mit der die meisten starten: dem Output-Preis pro 1M Tokens.
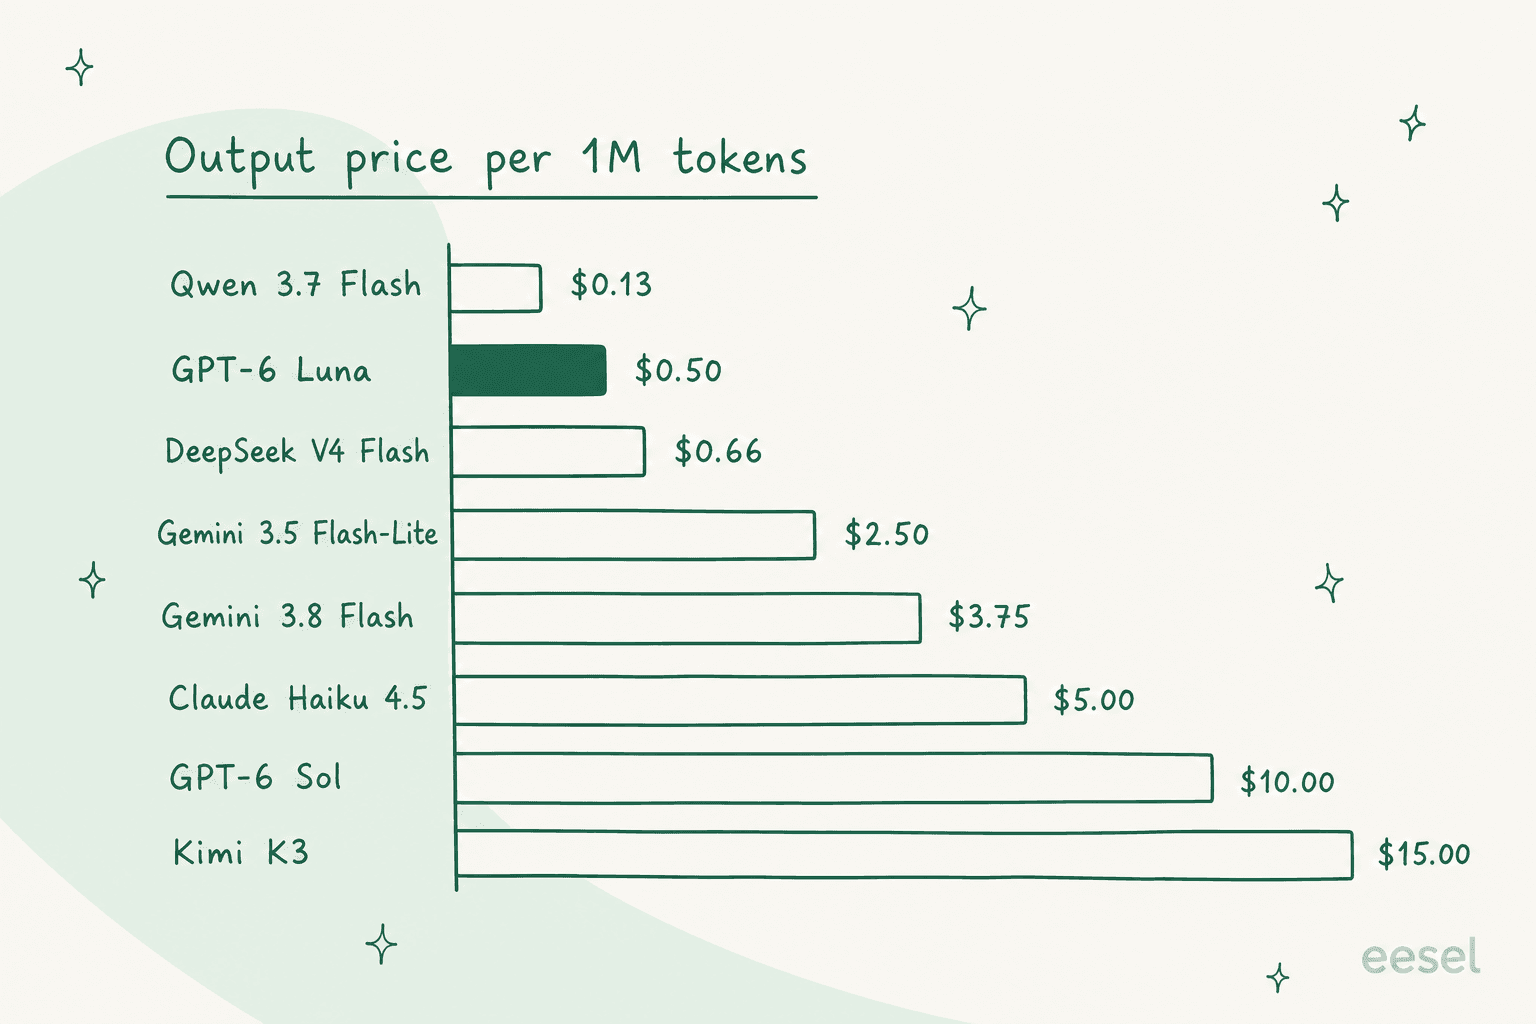
Wie ich diese Alternativen ausgewählt habe
Ich habe die Liste auf Modelle beschränkt, die wirklich in Lunas Gewichtsklasse spielen: günstig, schnell und für Hochvolumen- oder leichte Aufgaben gebaut, nicht die Frontier-Flaggschiffe aus der OpenAI-Modellliste, zu denen du greifen würdest, um den ganzen Tag Code zu schreiben. GPT-6 Astra oder Claude Opus habe ich hier nicht aufgenommen, denn ein Modell zum 20- bis 100-Fachen von Lunas Output-Preis ist keine „Alternative", sondern ein anderes Budget. (Wenn du wirklich eine Frontier-Engine suchst, ist mein Überblick über GPT-6-Astra-Alternativen die bessere Lektüre.)
Für jedes Modell habe ich mir den echten Preis pro Token aus der eigenen Preistabelle des Anbieters angesehen, das Kontextfenster, ob die Gewichte offen sind, was es als Eingabe verarbeiten kann und wo es wirklich glänzt oder schwächelt. Alle Preise unten stammen aus Primärquellen, und wo die Preisgestaltung eines Modells ungewöhnlich ist (Staffelungen, Peak-/Off-Peak-Aufschläge, eine geplante Erhöhung), habe ich das ausdrücklich erwähnt, denn genau solche Eigenheiten machen aus einem „günstigeren" Modell eine böse Überraschung auf der Rechnung.
Hier das gesamte Feld auf einen Blick.
| Modell | Am besten für | Input $/1M | Output $/1M | Kontext | Offene Gewichte | Bildeingabe |
|---|---|---|---|---|---|---|
| GPT-6 Luna (aktuell) | Die ausgewogene Standardwahl | $0.10 | $0.50 | 1.05M | Nein | Ja |
| Gemini 3.8 Flash | Multimodale Batch-Aufgaben | $0.75 | $3.75 | 1M | Nein | Ja |
| Gemini 3.5 Flash-Lite | Günstigste multimodale Option | $0.30 | $2.50 | 1M | Nein | Ja |
| Claude Haiku 4.5 | Zuverlässigkeit pro Dollar | $1.00 | $5.00 | 200K | Nein | Ja |
| DeepSeek V4 Flash | Günstigste offene Gewichte | $0.22 (off-peak) | $0.66 (off-peak) | 1M | Ja (MIT) | Nein |
| Qwen 3.7 Flash | Niedrigste Rate bei kleinen Prompts | $0.03-$0.20 | $0.13-$0.80 | 1M | Nein | Ja |
| Kimi K3 | Schwergewicht mit offenen Gewichten | $3.00 | $15.00 | 1M | Ja | Ja |
| GPT-6 Sol | Bei OpenAI bleiben, mehr Spielraum | $2.00 | $10.00 | 1.05M | Nein | Ja |
| Grok 4.7 | Agenten-Loops und Echtzeit | $2.00 | $6.00 | 500K | Nein | Ja |
Nun zu den Modellen selbst.
1. Gemini 3.8 Flash
Am besten für: Teams, die multimodale Eingaben und einen enormen Durchsatz für nicht-interaktive Nachtarbeit wollen.
Gemini 3.8 Flash ist Googles neuestes Flash-Modell, und die ehrliche Einordnung liefert Google selbst: Es baut direkt auf Gemini 3.7 Flash auf, nicht auf einer neuen Basis. Das Modellblatt sagt das in aller Deutlichkeit, in vier separaten Abschnitten. Für denselben Preis wie 3.7 bekommst du ein Modell, das „härter arbeitet" – es macht zusätzliche Denkschritte und ruft häufiger Tools auf, was bei schweren Aufgaben großartig und bei leichten verschwenderisch ist.
Wo es Luna klar schlägt, sind die Eingaben: Text, Bild, Audio, Video und PDF gehen alle rein, gegenüber Lunas Text-und-Bild. Es erzielt zudem einen starken Artificial-Analysis-Intelligence-Index von 59, deutlich über dem Median der Klasse.
Vorteile:
- Vollständig multimodale Eingaben (Audio, Video, PDF), die Luna nicht verarbeitet.
- Wirklich schneller Rohdurchsatz: 302 Tokens/Sek., nahe der Spitze von Artificial Analysis' Geschwindigkeitstabelle.
- Ein kostenloser Tarif und ein 1M-Token-Kontextfenster.
Nachteile:
- Die zu wenig beachtete Zahl ist die Time to First Token: Artificial Analysis maß
13.3sgegenüber einem Klassenmedian von etwa3s. Das disqualifiziert alles, worauf ein Mensch wartet, wie eine Chat-Antwort, ist aber für einen nächtlichen Batch-Job irrelevant. - Der Preis verdoppelt sich am 1. Januar 2027 auf
$1.50/$7.50. Google selbst rät effizienzorientierten Entwicklern, bei 3.7 Flash zu bleiben.
Preise: $0.75 Input / $3.75 Output pro 1M bis zum 31. Dezember 2026, danach genau 2x ab Januar 2027. Batch und Flex kosten 50 % weniger. Die vollständige Gemini-Preisübersicht zeigt alle Stufen.
Meine Einschätzung: Wähle Gemini 3.8 Flash statt Luna, wenn du Audio oder Video füttern musst und die Aufgabe nicht interaktiv ist. Für ein Live-Chat-Widget schließt diese Time-to-First-Token-Zahl es aus, da würde ich stattdessen zu Flash-Lite oder Luna greifen.
2. Gemini 3.5 Flash-Lite
Am besten für: den günstigsten Weg zu Googles multimodalen Eingaben bei hohem Volumen.
Wenn Gemini 3.8 Flash das Modell ist, das „härter arbeitet", dann ist Flash-Lite das, das „einfach günstig und schnell" sein will. Es ist das Budget-Mitglied mit hohem Durchsatz der Gemini-3.5-Reihe und Googles direkteste Antwort auf Luna. Es nimmt dieselbe reiche Palette an Eingaben (Text, Bild, Video, Audio, PDF) und gibt Text zurück, mit einem Kontextfenster von rund 1M Tokens. Das breitere Feld der Gemini-Alternativen lohnt einen Blick, wenn du mehr Google-Optionen willst.
Der herausragende Wert ist die Geschwindigkeit: Artificial Analysis platziert es nahe der Spitze des Felds bei der Output-Geschwindigkeit, rund 490 Tokens/Sek. – eine ganz andere Welt als das Latenzproblem von 3.8 Flash. Der Kompromiss ist die Intelligenz: Der Intelligence Index liegt bei 36, also ist das ein Arbeitspferd für Klassifikation, Extraktion und Routing, nicht für denklastige Aufgaben.
Vorteile:
- Multimodale Eingaben zu einem wirklich niedrigen Preis.
- Sehr schneller Output, was es für interaktive Nutzung tauglich macht, wo 3.8 Flash es nicht ist.
- Laut Googles eigenem Vergleich bei beiden Preismetriken günstiger als Claude Haiku 4.5.
Nachteile:
- Eine echte funktionale Lücke, die man kennen sollte: Die Modellseite listet Computer Use als nicht unterstützt, also ist es nicht das richtige Modell, um einen browsersteuernden Agenten darauf zu bauen.
- Geringere rohe Intelligenz als Luna, also ein engeres Werkzeug.
Preise: $0.30 Input / $2.50 Output pro 1M (Standard). Batch und Flex halbieren das auf $0.15/$1.25. Der kostenlose Tarif trainiert auf deinen Inhalten, ist also nichts für sensible Daten.
Meine Einschätzung: Das ist das Gemini-Modell, das ich für günstige, hochvolumige Text-und-Bild-Aufgaben tatsächlich gegen Luna antreten lassen würde. Sein Output-Preis liegt über dem von Luna, aber bei allem mit einem Bild drin können die multimodale Unterstützung und die Geschwindigkeit den Unterschied wert sein.
3. Claude Haiku 4.5
Am besten für: Teams, die die Zuverlässigkeit und Anweisungstreue der Claude-Familie zum Preis einer schnellen Stufe wollen.
Claude Haiku 4.5 ist Anthropics kleines, schnelles Modell und mit $1.00/$5.00 das teuerste in der echten „günstig"-Klasse hier. Wofür du bezahlst, ist Anthropics Ruf für sorgfältige Anweisungstreue und eine geringere Neigung, aus der Spur zu laufen – das zählt stark, wenn der Modell-Output etwas Automatisiertes speist.
Das Kontextfenster ist kleiner als bei den anderen (200K statt 1M), was für die meisten Aufgaben in Ordnung ist und eine echte Einschränkung für alle, die eine ganze Codebasis oder Wissensdatenbank in einen einzigen Prompt stopfen.
Vorteile:
- Starke, vorhersehbare Anweisungstreue im Claude-Stil.
- Schnelle Antworten, funktioniert also für interaktive Anwendungen.
- Das Claude-Ökosystem, die Tools und die Dokumentation sind exzellent.
Nachteile:
- Zehnmal Lunas Output-Rate, bei reinem Volumen also die teure Wahl in dieser Gruppe.
- 200K Kontext ist hier das kleinste.
- Keine offenen Gewichte und keine Riesenkontext-Option wie bei den 1M-Token-Modellen.
Preise: $1.00 Input / $5.00 Output pro 1M Tokens. Prompt-Caching und Batch-Rabatte gelten und senken die effektive Rate bei repetitiven Workloads.
Meine Einschätzung: Wenn dir Zuverlässigkeit den Schlaf raubt und deine Prompts in 200K passen, ist Haiku den Aufpreis gegenüber Luna wert. Wenn du auf die niedrigste Rechnung aus bist, ist es nicht das Richtige – eines der chinesischen offenen Modelle unten erledigt dieselbe Routinearbeit für einen Bruchteil der Kosten.
4. DeepSeek V4 Flash
Am besten für: die günstigste Option mit offenen Gewichten, die du wirklich herunterladen und selbst hosten kannst.
DeepSeek V4 Flash ist die Wahl für Budget-Champions, und diejenige, bei der die Preis-Fußnoten am wichtigsten sind. Es ist ein Mixture-of-Experts-Modell mit 284B Gesamt- / 13B aktiven Parametern, veröffentlicht unter einer MIT-Lizenz mit herunterladbaren Gewichten, sodass du es auf eigener Hardware laufen lassen kannst.
Zwei Dinge solltest du wissen, bevor du dich über den Listenpreis freust. Erstens ist es reines Text-Modell, es ist also keine Bildeingabe dokumentiert. Zweitens nutzt die First-Party-API Peak- und Off-Peak-Preise: $0.22/$0.66 pro 1M außerhalb der Stoßzeiten, steigend auf $0.44/$1.32 zur Stoßzeit. Die Stoßzeiten liegen zwischen 01:00 und 10:00 UTC (chinesische Geschäftszeiten), sodass eine US- oder europäische Warteschlange größtenteils zum günstigeren Off-Peak-Satz abgerechnet wird – eine nette, aber fragile Eigenheit.
Es gibt auch eine subtilere Kostenfalle, die direkt im Luna-Launch-Thread aufkam. Ein Kommentator verglich seine eigenen DeepSeek- und Luna-Rechnungen, und jemand widersprach:
"This isn't right. You're comparing cost per token, but DeepSeek V4 Flash uses more tokens. Artificial Analysis found GPT 6 Luna to be significantly cheaper than DeepSeek."
Das ist die ganze Kategorie in einem Austausch: DeepSeek ist geschwätzig, und ein redseliges Modell braucht mehr Tokens, um denselben Job zu beenden, daher bedeutet die niedrigere Rate pro Token nicht immer eine niedrigere Rechnung.
Vorteile:
- MIT-offene Gewichte, du kannst also selbst hosten und Daten intern behalten.
- Die niedrigste veröffentlichte Rate pro Token unter allen leistungsfähigen Modellen hier (Off-Peak).
- Riesiger 1M-Token-Kontext und eingebautes Reasoning.
Nachteile:
- Nur Text, keine dokumentierte Bildeingabe.
- Geschwätziger Output kann die Ersparnis pro Token bei echten Aufgaben zunichtemachen.
- Die Bedingungen der bezahlten API schweigen zur Trainingsnutzung, statt sie ausdrücklich zu erlauben, und Daten unterliegen chinesischem Recht – also kein Drop-in für Kundendaten.
Preise: Off-Peak $0.22 Input / $0.66 Output, Peak $0.44/$1.32, jeweils pro 1M. Reasoning-Tokens werden zum Output-Satz abgerechnet, und Thinking ist standardmäßig aktiv – also einplanen.
Meine Einschätzung: Wenn du offene Gewichte und den absoluten Kosten-Boden willst, ist DeepSeek V4 Flash das, was du testen solltest – aber teste mit deinen echten Prompts und miss die Token-Zahl, nicht nur die Rate. Bei Kundendaten solltest du die „schweigende" Trainingsrichtlinie als Grund sehen, selbst zu hosten statt die First-Party-API zu nutzen.
5. Qwen 3.7 Flash
Am besten für: die niedrigste Headline-Rate bei kleinen Prompts, wenn du mit dünner Dokumentation leben kannst.
Alibabas Qwen 3.7 Flash hat die niedrigste Zahl auf der ganzen Tabelle, $0.03/$0.13 pro 1M, aber es gibt einen Sternchenhinweis, den du nicht überspringen darfst: Der Preis ist nach Prompt-Größe gestaffelt. Diese günstige Rate gilt nur unter 32K Tokens. Sie steigt auf $0.10/$0.40 von 32K bis 256K und auf $0.20/$0.80 von 256K bis 1M. Die Rate des „günstigsten Vision-Modells" und der „1M-Kontext" können also nicht gleichzeitig in einem Aufruf gelten.
Der andere ehrliche Hinweis: Fast nichts an diesem Modell ist unabhängig verifiziert. Alibaba hat keine Benchmarks, keine Architektur und keine Parameterzahl veröffentlicht, und die Gewichte sind geschlossen. Die einzige Drittanbieter-Bewertung, Roboflows Vision-Test, platziert es auf Rang 22 von 23 insgesamt, aber auf Rang 1 von 23 beim Preis. Und „Flash" bedeutet hier günstig, nicht schnell: Es läuft mit rund 59 Tokens/Sek., deutlich langsamer als Geminis Flash-Lite.
Vorteile:
- Die niedrigste Input-Rate pro Token hier, bei kleinen Prompts.
- Akzeptiert Bildeingaben, anders als DeepSeek.
- 1M-Token-Kontext verfügbar (in der höchsten Preisstufe).
Nachteile:
- Gestaffelte Preise bedeuten, die günstige Rate verschwindet bei großen Prompts (6,7-mal mehr beim Input in der höchsten Stufe).
- Langsamer Output und dünne, unverifizierte Dokumentation.
- Geschlossene Gewichte, ein einzelner Anbieter, also kein Self-Hosting und kein Fallback-Routing.
Preise: drei Stufen nach Prompt-Größe, von $0.03/$0.13 unter 32K bis $0.20/$0.80 bei 256K-1M. Vergleiche mit dem vollständigen Bild der Qwen-Preise, bevor du dich festlegst.
Meine Einschätzung: Qwen 3.7 Flash passt hervorragend zu hochvolumigen Vision-Aufgaben mit kurzen Prompts, bei denen der Preis alles ist und du die Qualität selbst prüfen kannst. Bei allem, was großen Kontext oder dokumentierte Benchmarks braucht, würde ich passen. Mein Beitrag zu Qwen-Alternativen zeigt die breitere Qwen-Familie, wenn du mehr Spielraum willst.
6. Kimi K3
Am besten für: Teams, die ein wirklich offenes Schwergewicht wollen und dafür bezahlen.
Kimi K3 ist der Ausreißer auf dieser Liste, und ich habe es absichtlich aufgenommen. Mit $3/$15 pro 1M ist es nicht günstig; es liegt in derselben Preisklasse wie Claude Sonnet, etwa das 30-Fache von Lunas Output-Rate. Warum steht es also hier? Weil es das offene Modell ist, zu dem Leute greifen, wenn sie ein leistungsfähiges Modell wirklich besitzen wollen, und seine Gewichte tatsächlich pünktlich auf Hugging Face erschienen.
Es ist ein Mixture-of-Experts-Modell mit 2,8T Gesamt- / 104B aktiven Parametern, nativer Vision, 1M-Token-Kontext und einem Artificial-Analysis-Intelligence-Index von 57 – das bringt es nahe an die Spitze des gesamten Felds, nicht nur des günstigen Endes.
Vorteile:
- Offene Gewichte, die wie versprochen erschienen und auf Hugging Face überprüfbar sind.
- Hohe Intelligenz, deutlich über dem Rest dieser Liste.
- Native Vision und ein 1M-Token-Kontext.
Nachteile:
- Kein Budget-Modell. Es ist nur im Sinne von „offen und leistungsfähig" eine Luna-Alternative, nicht im Sinne von „günstig".
- Reasoning lässt sich nicht abschalten und läuft standardmäßig auf maximalem Aufwand, also sind Latenz und Token-Verbrauch hoch.
Preise: $3 Input / $0.30 Cache-Hit / $15 Output pro 1M. Die Consumer-App-Tarife reichen von einem kostenlosen Plan bis zu $199/Monat. Mein Überblick über Kimi-K2.5-Alternativen deckt das breitere Feld offener Modelle ab.
Meine Einschätzung: Wenn du dir von einer „Luna-Alternative" eigentlich ein offenes, leistungsfähiges Modell zum Selbsthosten erhofft hast, ist Kimi K3 die Wahl, und DeepSeek V4 Flash der günstigere Cousin. Wenn du die niedrigste Rechnung wolltest, ist Kimi komplett der falsche Ansatz.
7. GPT-6 Sol
Am besten für: bei OpenAI zu bleiben, wenn Lunas Spielraum ausgeht.
Manchmal ist die beste Alternative zu Luna das Modell eine Stufe höher in derselben Familie. GPT-6 Sol ist OpenAIs Mid-Tier-GPT-6-Modell für $2/$10, und es existiert genau für den Moment, in dem Lunas Antworten nicht mehr gut genug sind, du aber weder Anbieter noch SDKs noch Datenvereinbarungen wechseln willst.
OpenAIs eigene Einordnung lautet „mit Sol bauen, mit Luna skalieren", und die Benchmark-Geschichte ist ehrlich: Sols Intelligence- und Coding-Indizes liegen etwa auf Höhe von GPT-5.6, das ist also eher eine Preissenkung als ein Fähigkeitssprung, mit einem echten Gewinn bei der Faktentreue (OpenAI berichtet von etwa halb so vielen Fehlern wie beim vorherigen Sol).
Vorteile:
- Dieselbe API, dieselben Tools und Datenbedingungen wie Luna, der Wechsel ist also eine Ein-Zeilen-Änderung.
- Vollständiges Responses-API-Toolset: Websuche, Code-Interpreter, gehostete Shell, Computer Use, MCP.
- Merklich leistungsfähiger als Luna bei schwierigen Aufgaben, mit einem großen Zugewinn bei der Faktentreue.
Nachteile:
- Das 20-Fache von Lunas Output-Preis, also ein Kostenanstieg, keine Ersparnis.
- Nicht in den Free- oder Go-Plänen enthalten; du brauchst Plus, Pro, Business oder die API.
Preise: $2 Input / $10 Output pro 1M im Standard, Batch und Flex mit 50 % Rabatt. Die vollständige Preisseite zu GPT-6 Sol enthält die Long-Context- und Fast-Mode-Raten.
Meine Einschätzung: Sol ist keine Alternative für jemanden, der nach Preis sucht, sondern der natürliche Upgrade-Pfad, wenn Lunas Qualität der Flaschenhals ist. Greif dazu, wenn das Problem, das du lösen willst, Genauigkeit ist, nicht Kosten.
8. Grok 4.7
Am besten für: Agenten-Loops im großen Maßstab und Aufgaben, die Echtzeit- oder X-Daten wollen.
Grok 4.7 von xAI ist mit $2/$6 die teuerste der Mid-Tier-Optionen, aber für eine bestimmte Aufgabe gebaut: lange, mehrstündige agentische Aufgaben. Es läuft auf einem neuen, größeren Basismodell als 4.6 mit einem längeren Reinforcement-Learning-Lauf, gewichtet auf mehrstufige Arbeit, und versteht nativ xAIs eigenen Agenten-Harness.
Das Versprechen lautet „nah an der Frontier zu einem volumenfreundlichen Preis". In xAIs eigenen Tabellen erzielt es starke agentische und Terminal-Werte, auch wenn die Krone für Coding und Terminal weiterhin Modellen wie Fable 5.1 gehört. Fairerweise verliert es auch bei manchen Benchmarks, etwa bei HealthBench, wo sowohl GPT-6 Sol als auch Fable es schlagen.
Vorteile:
- Stark bei langfristigen agentischen Aufgaben, mit einer Context-Compaction-API für sehr lange Läufe.
- Zugriff auf Echtzeit- und X-Daten über xAIs Tools.
- Ein leistungsfähiges Modell zum Preis von Grok 4.6.
Nachteile:
- Die teuerste Mid-Tier-Option hier, und die Long-Context-Rate (
$4/$12über 200K Prompt-Tokens) gilt für jeden Token in der Anfrage, nicht nur für den Überhang. - 500K Kontext, kleiner als bei den 1M-Token-Modellen.
- Die Nicht-Token-Zähler (Suche, Code-Ausführung) summieren sich in Agenten-Loops.
Preise: $2 Input / $6 Output unter 200K Prompt-Tokens, $4/$12 darüber, jeweils pro 1M. Tool-Aufrufe werden separat abgerechnet, z. B. Web- und X-Suche mit $5/1.000 Aufrufen.
Meine Einschätzung: Grok 4.7 ist für günstige Textaufgaben kein wirklicher Luna-Konkurrent. Es ist die Wahl, wenn der Job ein langer agentischer Lauf ist, besonders einer, der Live-Daten braucht. Für simples, hochvolumiges Zusammenfassen oder Klassifizieren ist es im Vergleich zu Luna überdimensioniert und überteuert.
Die zwei Fragen, die eigentlich entscheiden
Wenn man die Modellnamen weglässt, läuft der ganze Vergleich auf zwei Fragen hinaus.
Die erste ist offen oder geschlossen. Die meisten hier sind geschlossene, reine API-Modelle. Wenn Self-Hosting eine harte Anforderung ist, schrumpft deine Shortlist schnell.
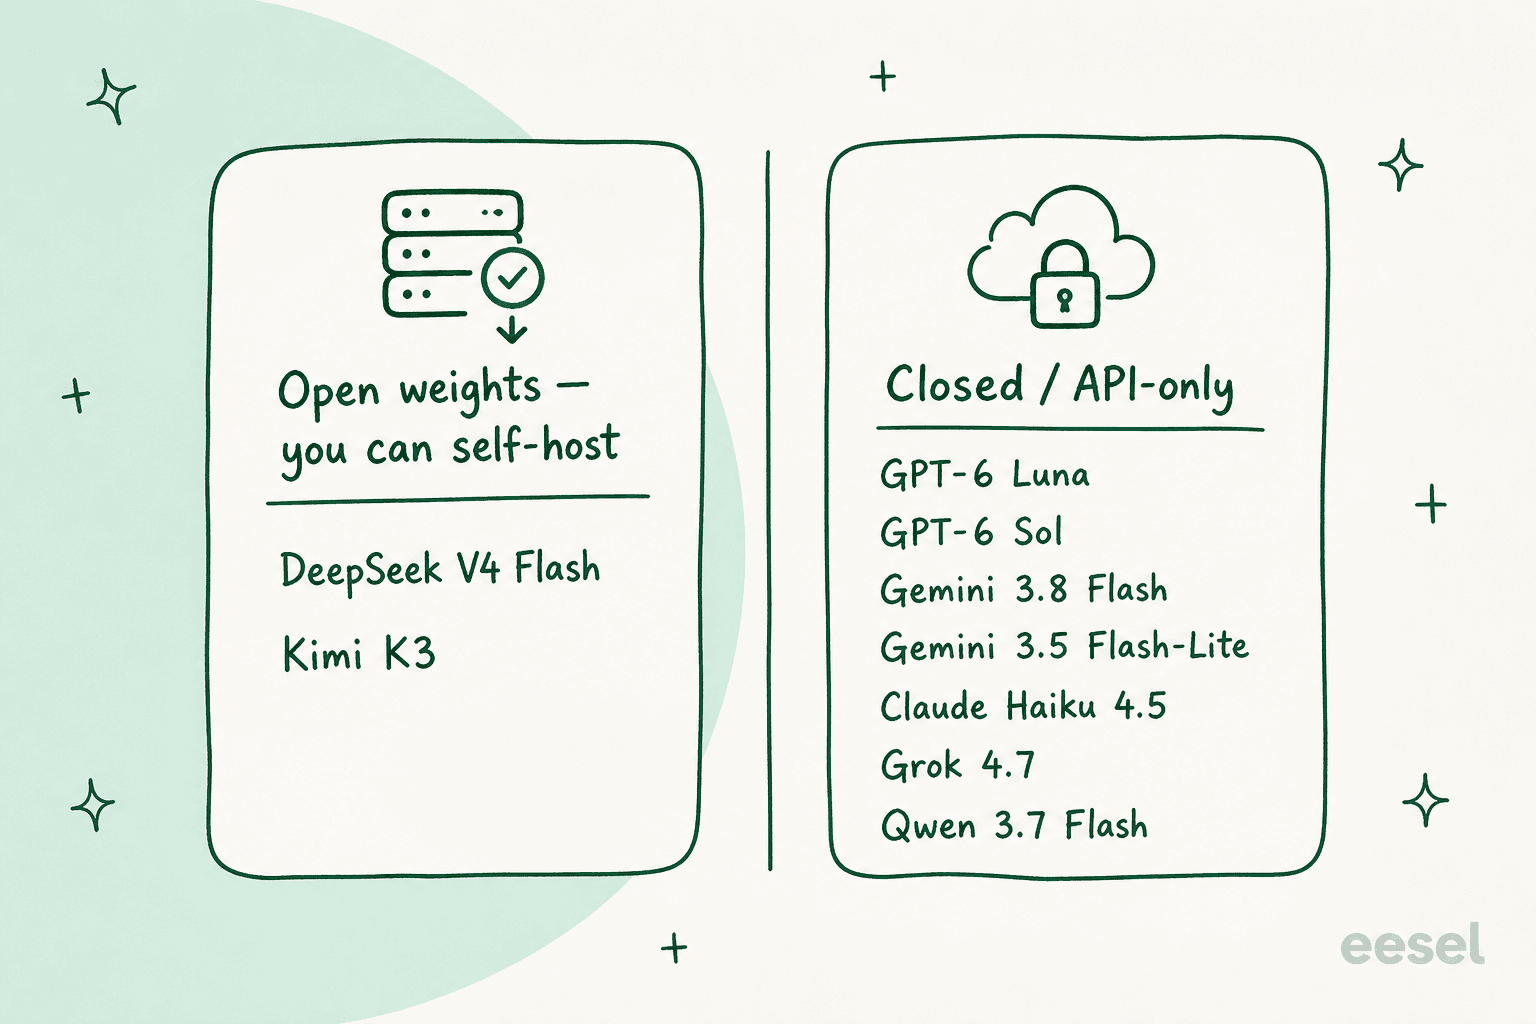
Derselbe Trade-off zeigt sich, wann immer du die besten KI-Agenten vergleichst: Die Lizenz entscheidet über deine Architektur, bevor es die Benchmarks tun. Die zweite Frage ist die, die jede Tabellenkalkulation stolpern lässt: am günstigsten pro Token ist nicht am günstigsten pro Aufgabe. Ein Modell, das ein Drittel von Lunas Preis listet, aber doppelt so viele Tokens braucht, um denselben Job zu erledigen, spart dir nichts. Der einzige Weg, das herauszufinden, ist, deine echten Prompts durch zwei oder drei Kandidaten laufen zu lassen und die tatsächliche Rechnung zu vergleichen, nicht die Preistabelle. Das ist auch der Grund, warum das ChatGPT-Abo für die individuelle Nutzung im Stillen alle diese API-Raten schlagen kann, da eine pauschale Monatsgebühr die Preisgestaltung pro Token komplett umgeht.
Der Teil, den das Modell nicht löst
Das ist die Sache, die ich hören wollen würde, wenn ich diesen Text lesen würde. Wenn du ein günstiges Modell auswählst, um einen echten, wiederkehrenden Job anzutreiben, und für die meisten Teams, die einen Beitrag wie diesen lesen, ist dieser Job Kundensupport, dann sind die Modellwahl nur die leichten 10 % der Arbeit.
Ich habe die letzten Jahre damit verbracht, Teams dabei zuzusehen, wie sie KI auf Live-Support-Warteschlangen loslassen, und das Muster ist immer dasselbe. Das rohe Modell ist Tokens rein, Text raus. Bevor es einem Kunden sicher antworten kann, muss trotzdem jemand das Retrieval bauen, damit es dein Help Center kennt, die Guardrails, damit es sich nicht selbstbewusst eine Erstattungsrichtlinie ausdenkt, die Integrationen, damit es eine Bestellung nachschlagen kann, die Tests, damit du herausfindest, wie es sich verhält, bevor ein Kunde es tut, und den Eskalationspfad für den Moment, in dem an einen Menschen übergeben werden sollte. Ein KI-Co-Pilot für den Kundenservice muss jeden einzelnen dieser Punkte lösen. Das sind die 90 %.
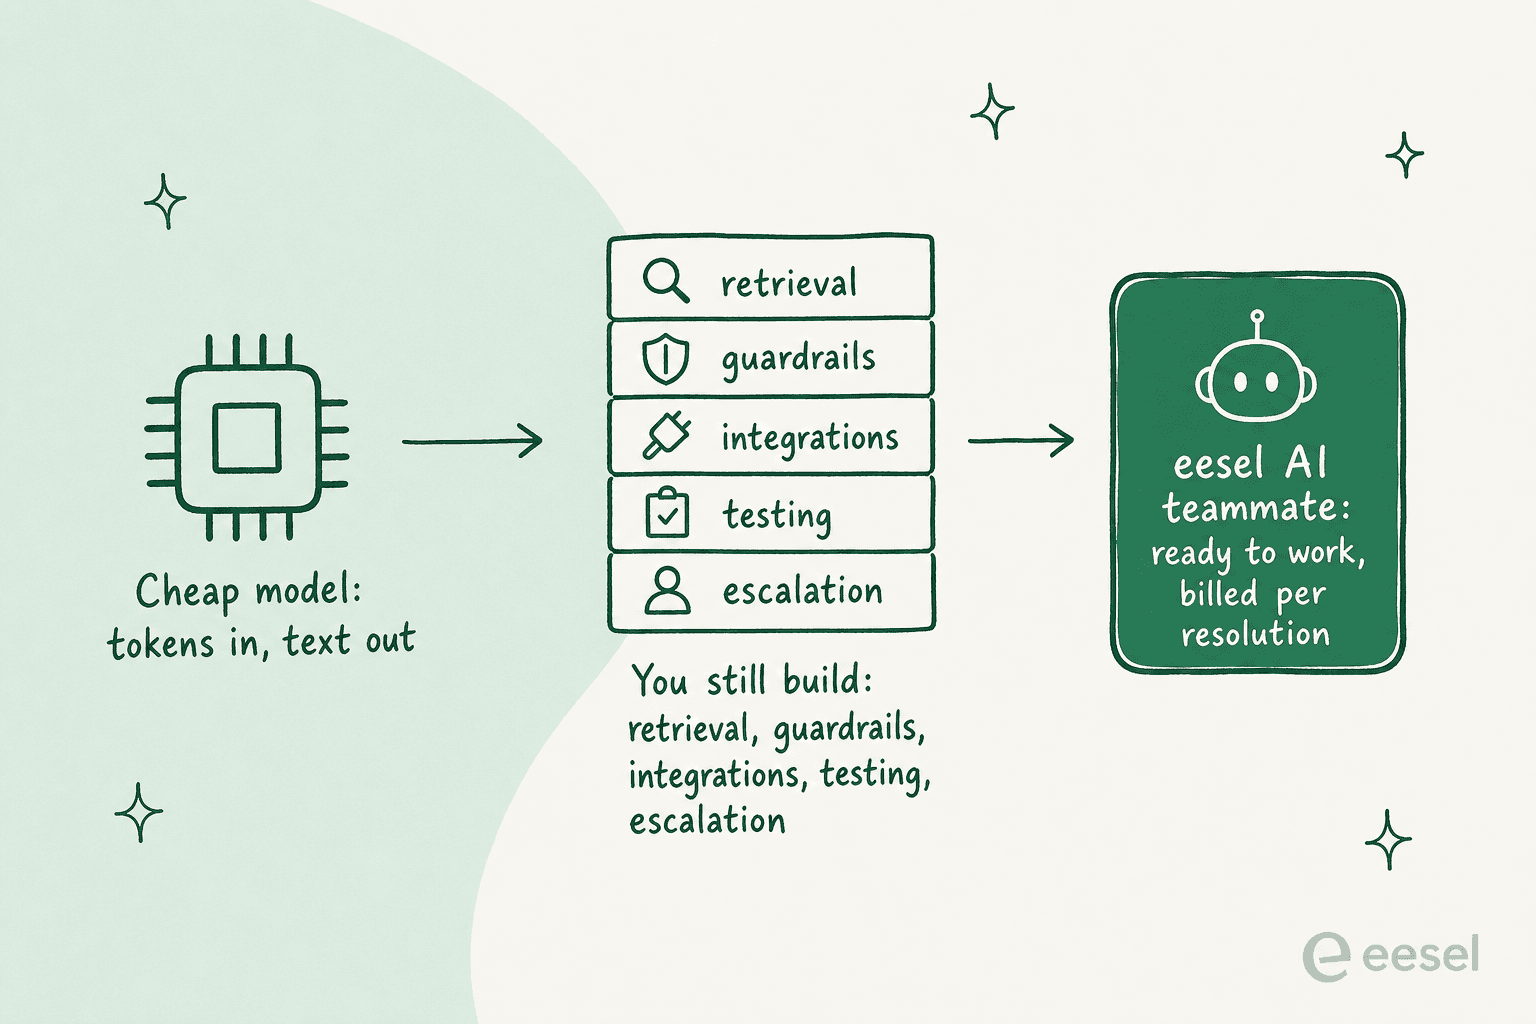
Der teuerste Fehler, den ich sehe, ist ein Team, das ein günstiges Modell direkt in die Warteschlange schickt, zusieht, wie es einem echten Kunden selbstbewusst eine falsche Antwort gibt, und erst dann nach den fehlenden 90 % sucht. Deshalb wird jeder Rollout, dem ich vertrauen würde, erst gegen historische Tickets simuliert, damit du die falschen Antworten siehst, bevor sie je einen Menschen erreichen.
eesel AI ausprobieren
Hier kann ich direkt darüber sprechen, was ich baue. Die Modelle oben sind Infrastruktur. eesel AI ist der Mitarbeiter, der darauf läuft. Statt dir ein Modell und einen Stapel Einzelteile zu verkaufen, liefern wir einsatzbereite KI-Teamkollegen für bestimmte Jobs, und der, den die meisten Leser hier wollen, ist der KI-Helpdesk-Teamkollege.

Er tritt deiner bestehenden Warteschlange bei, lernt aus deinen vergangenen Tickets und deinem Help Center, und wird pro Lösung abgerechnet, du bezahlst also für erledigte Jobs statt für verbrannte Tokens. Und weil du ihn gegen deine eigenen historischen Tickets simulieren kannst, bevor er eine echte Warteschlange anfasst, siehst du vorher genau, wie er echte Kunden behandelt hätte.
Wenn du das alles lieber vom Terminal oder per Skript steuerst, gibt es auch die eesel-CLI. Sie ist eine agentenfreundliche Möglichkeit, denselben Teamkollegen und Workspace zu bedienen: Eine Person kann sie von Hand ausführen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können sie direkt steuern. Du kannst eine Quelle verbinden, Anweisungen pushen, eine Simulation starten, einen Lauf auslösen und Aktivitäten zurücklesen, alles ohne das Dashboard zu öffnen. Wenn der Grund, warum du rohe Modell-APIs vergleichst, ist, dass du programmatische, headless Kontrolle willst, dann ist das die dafür gebaute Oberfläche, aufbauend auf einem Teamkollegen, der die 90 % bereits übernimmt, die das Modell nicht löst.
Du kannst eesel AI kostenlos ausprobieren, und wenn Support der Job ist, ist das ein deutlich kürzerer Weg, als ein günstiges Modell selbst zu verdrahten.
Häufig gestellte Fragen
Was sind die besten GPT-6-Luna-Alternativen 2026?
Gibt es eine günstigere Alternative zu GPT-6 Luna?
Was ist das günstigste GPT-6-Modell?
Welche GPT-6-Luna-Alternative eignet sich am besten für den Kundensupport?
Haben GPT-6-Luna-Alternativen offene Gewichte?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.