GPT-6-Sol-API-Preise: die Standardstufe
Hier ist die Zahl, wegen der die meisten hier sind. Auf der API-Preisseite liegen die GPT-6-Sol-Standardpreise bei 2,00 $ pro Million Input-Tokens und 10,00 $ pro Million Output-Tokens. Gecachter Input sinkt auf 0,20 $, und Cache-Writes kosten 2,50 $ pro Million.
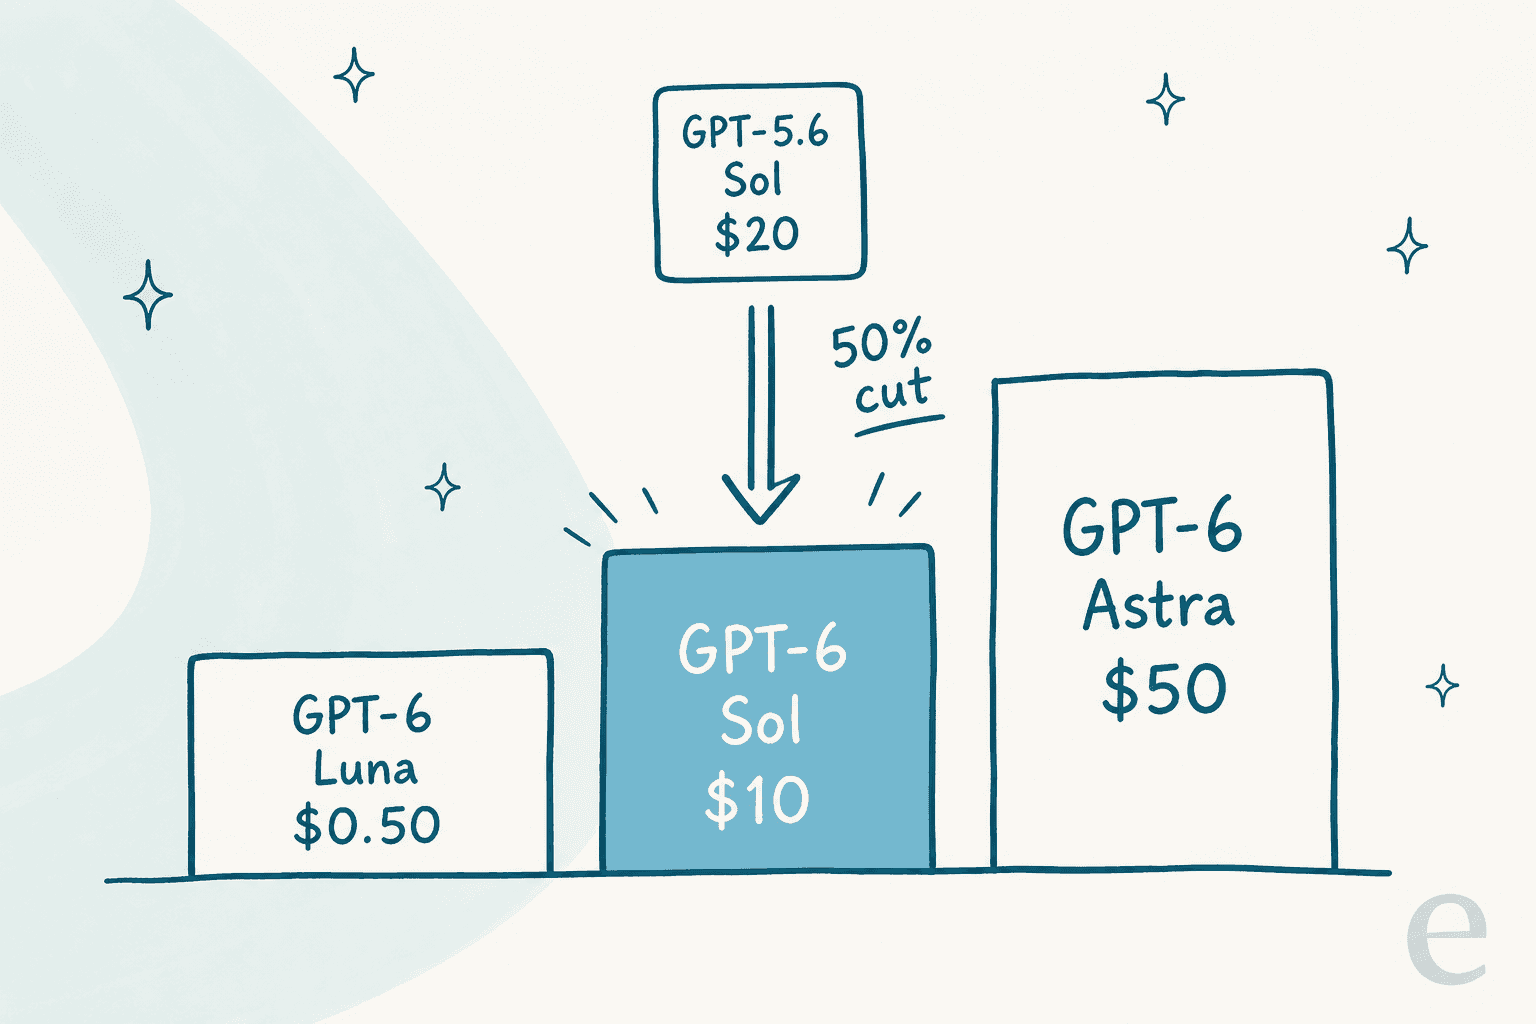
Das platziert Sol genau in der Mitte der OpenAI-Modellreihe: deutlich über dem Leichtgewicht Luna und weit unter dem Flaggschiff Astra. Hier sehen Sie, wo die GPT-6-Familie in der Standard-Kurzkontext-Stufe steht, mit dem auslaufenden GPT-5.6 Sol zum Vergleich:
| Modell | Input (pro 1M) | Gecachter Input | Output (pro 1M) | Position |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Flaggschiff |
| gpt-6-sol | $2.00 | $0.20 | $10.00 | Mittlere Stufe (neu) |
| gpt-6-luna | $0.10 | $0.01 | $0.50 | Günstigste |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Vorherige mittlere Stufe |
Quelle: OpenAI-API-Preise. Die Tabelle erzählt eine einfache Geschichte: GPT-6 Sol ist das alte GPT-5.6 Sol zum halben Preis. OpenRouter bestätigte am Launch-Tag dieselben Tarife, Sol mit „2 $/M Input und 10 $/M Output“. OpenAIs eigene Einordnung im Launch-Beitrag lautet „Build with Sol. Scale with Luna“, was zeigt, wo jedes Modell positioniert sein soll.
Die 50%ige Senkung: was sich geändert hat und was nicht
Eine Preissenkung dieser Größenordnung geht normalerweise mit einer Geschichte über neue Fähigkeiten einher. Diese hier größtenteils nicht, und das sollte man ehrlich sagen.
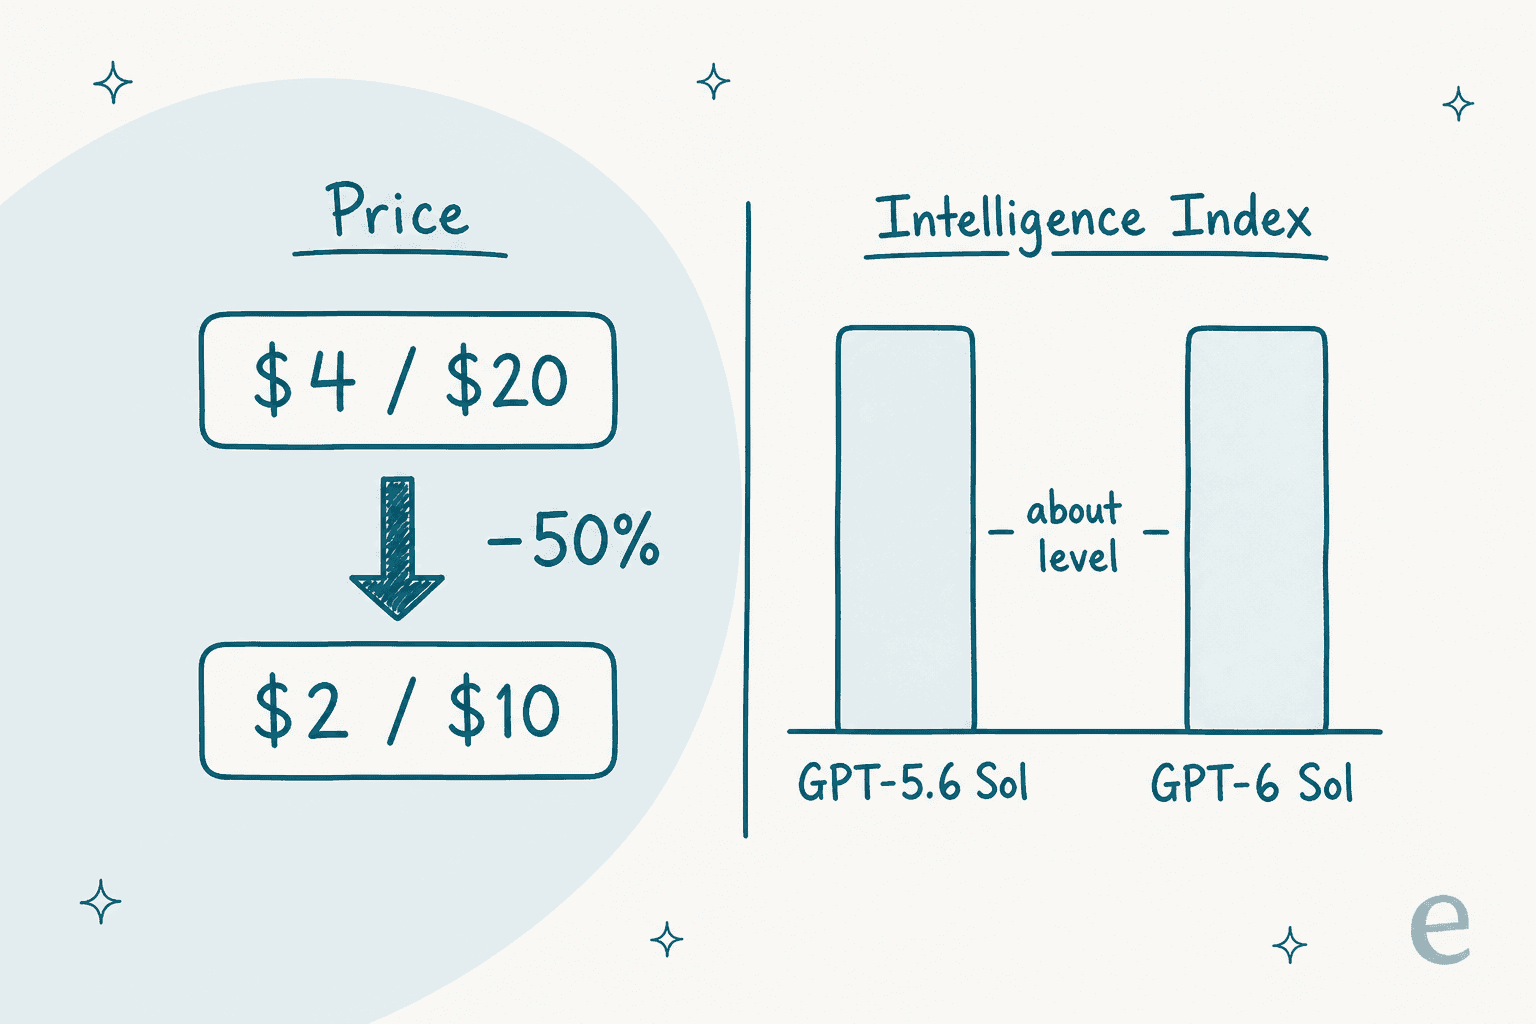
Beim reinen Intelligenzmaß berichtete Artificial Analysis, dass GPT-6 Sol und Luna „die Kosteneffizienz-Grenze durch Halbierung der Kosten verschieben“, während Intelligence Index und Coding Agent Index „auf dem Niveau von GPT-5.6 bleiben, mit Fortschritten in einigen Bewertungen und Rückschritten in anderen“. Das Bild ist also: der Preis hat sich stark bewegt, die Intelligenz kaum.
Verbessert haben sich bei Sol Zuverlässigkeit und Coding-Durchsatz, und OpenAI stützte sich stark auf beides:
- Faktentreue. OpenAI berichtet, dass GPT-6 Sol etwa halb so viele Faktenfehler macht wie GPT-5.6 Sol und sich damit der Zuverlässigkeit von Astra zu einem Bruchteil der Kosten annähert. Artificial Analysis verzeichnete einen Rückgang der Halluzinationsrate bei maximaler Anstrengung von 92 % auf 60 %.
- Coding. OpenAI berichtet 68,8 % auf DeepSWE v1.1, nur etwa einen Punkt unter dem besten Wert von Claude Fable 5 bei rund 80 % geringeren Kosten pro Aufgabe.
- Agentische Evaluierungen. Artificial Analysis verzeichnete kleine Zugewinne bei AutomationBench (62 % vs. 60 %) und Terminal-Bench 4.0 (44 % vs. 40 %) sowie einen Sprung beim AA-Omniscience Index von 22 auf 27.
Die Community sah es genauso. In der Launch-Diskussion brachte es ein Entwickler unumwunden auf den Punkt:
"I'd have loved improved performance for 2x the price than ~equal performance for 0.5x the price."

Das ist der ehrliche Rahmen für die GPT-6-Sol-Preise. Wenn Sie bereits GPT-5.6 Sol nutzten, ist das eine Rechnungssenkung, die Sie geschenkt bekommen. Wenn Sie gehofft hatten, die „6“ bedeute einen Sprung bei der reinen Intelligenz, dämpfen die Benchmark-Werte diese Erwartung.
Service-Stufen: die 4-fache Schwankung, die die meisten übersehen
Der Standardtarif ist ein Ausgangspunkt, nicht die ganze Geschichte. GPT-6 Sol läuft auf denselben Service-Stufen wie der Rest der Familie, und die Lücke zwischen der günstigsten und der teuersten beträgt das Vierfache für exakt dasselbe Modell. Das ist der größte Hebel, den Sie bei den Kosten haben.
| Stufe | Input (pro 1M) | Gecachter Input | Output (pro 1M) | Kompromiss |
|---|---|---|---|---|
| Batch | $1.00 | $0.10 | $5.00 | 50 % Rabatt, asynchron, bis zu 24 Std. |
| Flex | $1.00 | $0.10 | $5.00 | 50 % Rabatt, langsamer, kann in Warteschlange landen |
| Standard | $2.00 | $0.20 | $10.00 | Standardlatenz |
| Fast mode | $4.00 | $0.40 | $20.00 | 2x, niedrigste Latenz |
Quelle: OpenAI-API-Preise. Ein paar Dinge, die Sie vor der Wahl wissen sollten:
- Batch und Flex kosten gleich viel, sind aber für unterschiedliche Aufgaben gedacht. Batch eignet sich für asynchrone Arbeit, die Sie einreichen und später abholen; Flex ist für interaktive Anfragen, die Sie bereit sind, langsamer laufen zu lassen oder in eine Warteschlange zu stellen. Beide halbieren Ihre Rechnung.
- Der Fast-Modus verdoppelt den Tarif für die niedrigste Latenz und akzeptiert entweder
service_tier: "priority"oderservice_tier: "fast". - Der Fast-Modus hat einen regionalen Haken. Bei EU-Datenresidenz kann er auf Standard zurückfallen, gehen Sie also nicht überall davon aus.
Wenn ein Workload Latenz toleriert, halbiert die Standardeinstellung auf Batch oder Flex Ihre Sol-Ausgaben erneut, zusätzlich zu den 50 %, die Sie bereits beim Umstieg von GPT-5.6 gespart haben. Das summiert sich: Eine batchfähige Aufgabe auf GPT-6 Sol kostet 1 $/5 $, ein Viertel der letztmonatigen GPT-5.6-Sol-Standardrechnung.
Die Fallstricke: Long Context und die Spezifikation
Zwei Details verstecken sich im Kleingedruckten der Modellseite, und beide können ein Budget still und leise umgestalten.
Erstens: Long Context wird für die gesamte Anfrage zu einem höheren Tarif abgerechnet. Sols Kontextfenster ist mit 1.050.000 Tokens groß, aber jeder Prompt mit mehr als 272.000 Input-Tokens kippt die gesamte Anfrage auf den Long-Context-Tarif: 4 $ pro Million Input und 15 $ pro Million Output in der Standardstufe. Das sind 2x beim Input und 1,5x beim Output, angewendet auf jeden Token der Anfrage, nicht nur auf die, die über der Schwelle liegen.
| Standardstufe | Kurzer Kontext (≤272K) | Langer Kontext (>272K) |
|---|---|---|
| Input (pro 1M) | $2.00 | $4.00 |
| Gecachter Input | $0.20 | $0.40 |
| Output (pro 1M) | $10.00 | $15.00 |
Zweitens lohnt es sich, die Spezifikation zu kennen, bevor Sie sich festlegen. GPT-6 Sol nimmt bis zu 922.000 Input-Tokens entgegen und liefert bis zu 128.000 zurück, mit einem Wissensstand vom 20. April 2026. Es akzeptiert Text und Bild als Eingabe, Text als Ausgabe, und bietet Reasoning-Effort von none bis hin zu max, mit medium als Standard. Außerdem liefert es das vollständige Responses-API-Toolset: Websuche, Code Interpreter, gehostete Shell, Computer Use und MCP. Und eine Untergrenze, die man sich merken sollte: Sol ist nicht in der kostenlosen Stufe verfügbar, daher ist Tier 1 der Einstiegspunkt für Entwickler.
Schätzen Sie Ihre GPT-6-Sol-API-Rechnung
Listenpreise bleiben abstrakt, bis Sie Ihre eigenen Zahlen einsetzen. Geben Sie die Millionen Input- und Output-Tokens ein, die Sie pro Monat erwarten, wählen Sie eine Service-Stufe, und das Tool errechnet die monatlichen Kosten. Der Long-Context-Aufschlag wird automatisch berücksichtigt.
Das Muster, das die meisten Teams beobachten: Output-Tokens dominieren die Rechnung, da der Output-Tarif das Fünffache des Input-Tarifs beträgt. Wenn Ihr Workload lange Antworten erzeugt, fließt dort das Geld hin, und dort lohnt sich der Wechsel einer batchfähigen Aufgabe zu Batch am schnellsten.
GPT-6-Sol-Preise in ChatGPT und Codex
Wenn Sie die API nicht direkt ansprechen, erreicht Sie GPT-6 Sol über ChatGPT Work und Codex, und Ihr Plan zieht eine klare Grenze, wer Zugriff bekommt.
| Plan | Preis | GPT-6-Sol-Zugriff |
|---|---|---|
| Free | $0 | Nein (nur Luna) |
| Go | $8/mo | Nein (nur Luna) |
| Plus | $20/mo | Ja |
| Pro | From $100/mo | Erweitert |
| Business / Enterprise / Edu | Per seat | Ja |
Quelle: OpenAI-Launch-Ankündigung. Ein paar Dinge stechen hervor:
- Sol beginnt bei Plus. Der 20-$/Monat-Plus-Plan ist der Einstiegspunkt für ChatGPT-Nutzer, die Sol wollen. Weder Free noch der 8-$-Go-Plan enthalten es; sie erhalten GPT-6 Luna in der Desktop-App.
- Auch Codex bekommt Sol. OpenAI hat beide Modelle zu denselben Stufen in Codex integriert, sodass Coding-Agent-Nutzer ab Plus Sol direkt auswählen können.
- Enterprise ist pro Sitzplatz. Bei Business und Enterprise ist Sol pro Sitzplatz verfügbar, ebenso beim Edu-Zugang, was demselben Muster wie der Rest der OpenAI-Reihe folgt.
Nicht jeder war überzeugt, dass die Abo-Ersparnis der API-Senkung entspricht. Ein Entwickler merkte an, dass Änderungen der Nachrichtenlimits darauf hindeuteten, dass sich die 50%ige API-Senkung innerhalb der ChatGPT-Pläne eher wie eine Senkung um ein Drittel auswirkte – prüfen Sie also lieber Ihr eigenes Kontingent, statt anzunehmen, dass der Listenrabatt eins zu eins durchschlägt.
Wie sich die GPT-6-Sol-Preise einordnen
Zoomen wir heraus: Wo steht Sol im Vergleich zum Rest der Spitzenmodelle? Kurz gesagt: OpenAI nutzte Sol, um in der Mitte des Marktes hart über den Preis zu konkurrieren.
- Im Vergleich zur eigenen Modellreihe: Mit 2 $/10 $ kostet Sol ein Fünftel von GPT-6 Astra (10 $/50 $) und das 20-Fache von Luna (0,10 $/0,50 $). Für die meisten Alltagsaufgaben ist Sol der Sweet Spot; für langfristige agentenbasierte Arbeit oder Sicherheitsaufgaben kann sich der Aufpreis für Astra weiterhin lohnen.
- Im Vergleich zu Anthropic: Sol unterbietet Fable 5.1 mit 10 $/50 $ deutlich, während OpenAI an der Spitze Coding-Werte im Abstand von nur einem Punkt beansprucht.
- Im Vergleich zu Google: Es liegt über den leichtesten Gemini-Optionen wie Gemini 3 Flash, konkurriert aber direkt mit den mittleren Stufen auf Basis von Preis pro Intelligenz.
Das größere Bild im Launch-Thread war, dass geschlossene Modelle immer günstiger werden, ohne wesentlich intelligenter zu werden – mehrere Entwickler bezeichneten das als Wettlauf nach unten beim Preis. Das sind gute Nachrichten, wenn Sie Tokens einkaufen. Es ist aber auch eine Erinnerung daran, dass ein günstigeres Modell nichts am schwierigeren Teil ändert, KI in einen echten Workflow zu bringen – und das ist alles rund um das Modell.
Was die GPT-6-Sol-Preise bedeuten, wenn Sie ein Support-Team leiten
Hier möchte ich nützlich sein, statt nur Tarife aufzuzählen, denn ich beschäftige mich damit, wie diese Modelle tatsächlich eingesetzt werden, und die ehrliche Antwort ist etwas kontraintuitiv.
Wenn Sie Kundensupport oder interne Abläufe leiten, ändert ein günstigeres Spitzenmodell weniger, als die Schlagzeile vermuten lässt. Ein rohes Modell wie Sol ist Infrastruktur. Es ist ein leistungsfähiger Motor, kennt aber von Haus aus weder Ihre Rückerstattungsrichtlinie noch Ihre letzten 50.000 Tickets, hat keinen Zugriff auf Ihr Bestellsystem und keine sichere Möglichkeit, an Ihrer echten Warteschlange getestet zu werden, bevor es anfängt, Kunden zu antworten. Es wird pro Token fürs Denken abgerechnet, nicht pro gelöstem Problem. Eine 50%ige Token-Senkung ist real, aber sie ist ein Rabatt auf den günstigsten Teil des Projekts.
Die Einheit, die für ein Support-Team wirklich zählt, sind Kosten pro Lösung, nicht Kosten pro Token. Eine Token-Rechnung ist unvorhersehbar: Sie schwankt mit der Prompt-Länge, Wiederholungsversuchen und wie gesprächig das Modell an einem bestimmten Tag ist. Ich habe erlebt, wie selbstbewusst klingende Bots in Live-Warteschlangen still und leise falsche Antworten gaben – genau deshalb sollte jedes Rollout zunächst an Ihren eigenen historischen Tickets simuliert werden, bevor es in die Nähe eines Kunden kommt. Das ist die Lücke zwischen einem Modell und einem System drumherum: Ihr Wissen, Ihre Integrationen, sichere Aktionen und eine Möglichkeit, es zunächst an Ihrer Historie zu testen.
Das ist auch der Grund, warum ich Ihre Support-Automatisierung nicht in der Woche eines neuen Modell-Launches auf eine andere Plattform umziehen würde. Die besten KI-Helpdesk-Agenten und Kundenservice-Tools sind bewusst modellflexibel gestaltet, sodass Sie bei einem günstigeren oder smarteren Modell das Upgrade erben, ohne etwas neu aufzubauen und ohne Ihr Budget rund um einen neuen Token-Tarif neu zu verhandeln.
eesel ausprobieren
Wenn Ihr Interesse am Preis von Sol eigentlich lautet „Was kostet mich eine KI, um Tickets tatsächlich zu lösen?“, ist das genau die Aufgabe, für die ein KI-Teammitglied gebaut ist, und dort setzt eesel an. GPT-6 Sol ist der Motor; eesel ist der Mitarbeiter, den Sie einstellen, um ihn zu steuern. Der KI-Helpdesk-Agent trainiert mit Ihren vergangenen Tickets und Ihrem Hilfe-Center, dockt an das Helpdesk an, das Sie bereits nutzen, statt es zu ersetzen, und lässt Sie ihn an Tausenden Ihrer echten historischen Tickets simulieren, sodass Sie sehen, wie er performen wird und was er kosten wird, bevor er je ein Live-Gespräch berührt.
Die Abrechnung erzählt eine Geschichte, die ein Token-Tarif nicht erzählen kann. Statt pro Token fürs Denken zu zahlen, zahlen Sie 40 Cent pro Ticket, das tatsächlich bearbeitet wird, ohne Gebühren pro Sitzplatz und ohne Plattform-Minimum, sodass sich die Kosten an Ergebnissen orientieren statt am Geplapper des Modells. Sie können kostenlos mit 50 $ Nutzungsguthaben und ohne Kreditkarte starten.

Und da dies eine an Entwickler gerichtete Preisfrage ist, lohnt es sich zu wissen, dass sich der gesamte eesel-Workspace vom Terminal aus steuern lässt, nicht nur über ein Dashboard. Die eesel-CLI (npx @eesel/cli) lässt eine Person, ein Skript oder einen Coding-Agenten wie Claude Code, Codex oder Cursor dasselbe Teammitglied bedienen: ein Helpdesk verbinden, die stehenden Anweisungen lesen und bearbeiten, mit eesel activity vergangene Läufe einsehen und Änderungen hinter eesel approvals absichern. Jeder Befehl gibt JSON aus, und --dry-run zeigt den genauen Server-Aufruf, den ein Schreibvorgang ausführen würde, bevor er gesendet wird. So lässt sich dieselbe Abrechnung pro Lösung, die Sie in diesem Rechner modellieren würden, in Ihr eigenes Tooling einbinden, statt sie nur in einer UI durchzuklicken.
Die GPT-6-Sol-Preise sind ein echtes Schnäppchen bei Tokens, und für Coding und Alltagsarbeit lohnt sich die 50%ige Senkung. Aber für die meisten Support-Teams war der Token-Tarif nie die entscheidende Zahl. Ein getestetes, verbundenes, rechenschaftspflichtiges Teammitglied in Ihren bestehenden Workflow zu bringen, abgerechnet nach Ergebnis, ist der Teil, in den es sich lohnt, Ihr Budget zu investieren.
Häufig gestellte Fragen
Wie viel kostet GPT-6 Sol über die API?
Ist GPT-6 Sol günstiger als GPT-5.6 Sol?
Was ist der Long-Context-Aufschlag von GPT-6 Sol?
Wie viel kostet GPT-6 Sol in ChatGPT und Codex?
Was ändern Batch und der Fast-Modus an den GPT-6-Sol-Preisen?
GPT-6 Sol vs. GPT-6 Astra: welche Preise soll ich nutzen?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.