Was kostet die OpenAI Decisions API im Moment?
Nichts, wofür man bereits bezahlen könnte. OpenAI hat die Decisions API am 29. September 2026 auf dem DevDay vorgestellt, und der DevDay-2026-Rückblick beschreibt sie als API, die „Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers“ fokussiert. In der Praxis schickst du Text oder Bilder, bekommst eine Antwort aus deiner eigenen Liste zurück und nutzt sie, um Inhalte zu klassifizieren, Anfragen zu routen oder den nächsten Schritt eines Agenten zu wählen.
Ich baue bei eesel Integrationen und APIs, also war mein erster Schritt natürlich, sie aufzurufen. Das ist öffentlich und das nicht, Stand meiner erneuten Prüfung am 2. Oktober:
| Frage | Antwort heute | Wo ich geprüft habe |
|---|---|---|
| Gibt es einen Preis? | Keine Decisions-Zeile auf der Preisseite | OpenAI API pricing |
| Abrechnungseinheit (pro Aufruf, pro Frage, pro Token)? | Nicht veröffentlicht | Rückblick, Preisseite, Changelog |
| Gibt es Dokumentation? | Keine Guide- oder API-Referenzseite; /guides/decisions liefert 404 | API guides index |
| Kann ein normaler API-Schlüssel sie nutzen? | Nein. POST /v1/decisions liefert HTTP 403, „Decision API is not enabled for this user.“ | Meine eigenen API-Aufrufe, 1. und 2. Okt. |
| Welches Modell läuft dahinter? | GPT-6 Luna | OpenAI Developers on X |
| Aussage zur Latenz? | „Less than a few hundreds of milliseconds end to end“ (Beitrag eines OpenAI-Mitarbeiters, keine Doku-Angabe) | Tibo on X |
| Datum der allgemeinen Verfügbarkeit? | „Broad release planned in the coming days“ | DevDay 2026 recap |
Das 403 verdient einen zweiten Blick. Nahe Pfade wie /v1/decisions/create liefern 404, also ist /v1/decisions eine echte, aktive Route, die nur hinter einem Feature-Flag liegt. Die Sperre greift, bevor der Request-Body überhaupt geprüft wird. Die Fehlermeldungen verraten also weder die Request-Form noch den Preis.
Das Support-Beispiel, das OpenAI selbst nennt, ist das, auf das es in diesem Beitrag ankommt:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use. Preview access is limited to selected API customers for testing. Broad release planned in the coming days"
Was ist der nächstliegende öffentliche Preis zur Decisions API?
GPT-6 Luna, denn dieses Modell läuft darunter. Ich möchte hier vorsichtig sein: OpenAI hat nicht gesagt, dass die Decisions API zu Luna-Preisen abrechnet. Sie könnte pro Entscheidung abrechnen oder den Output vergünstigen, oder beides nicht. Trotzdem läuft die API auf Luna, also ist dessen Preisliste die Kostenuntergrenze, mit der OpenAI rechnet.
Hier ist die komplette Preisliste von GPT-6 Luna von der API-Preisseite, pro 1 Mio. Tokens, für Prompts bis 272K Tokens:
| Stufe | Input | Gecachter Input | Cache-Schreibzugriffe | Output |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Ein paar Regeln auf der Luna-Modellseite verändern die Rechnung stärker als der Listenpreis:
- Prompts über 272K Input-Tokens werden für die gesamte Anfrage mit 2x Input und 1,5x Output abgerechnet.
- Batch und Flex kosten 50 % von Standard. Der Fast-Modus kostet das Doppelte. Luna hat keine Ultrafast-Stufe; die hat nur GPT-6 Astra.
- Regionale Datenresidenz und FedRAMP-Endpunkte kosten bei Modellen, die nach dem 5. März 2026 erschienen sind, 10 % extra, laut Preisseite.
- Strukturierte Outputs werden nicht separat berechnet. Du zahlst die Luna-Tokenpreise, nicht mehr.
Wenn du mehr zu den Stufen und zur Long-Context-Falle wissen willst: Mein Beitrag zu GPT-6 Luna Preisen geht Zeile für Zeile durch, und OpenAI API pricing deckt den Rest der OpenAI-Modelle ab.
Was kostet eine einzelne Routing-Entscheidung tatsächlich?
Da ich die Decisions API nicht aufrufen konnte, habe ich das Nächstbeste getan und genau den Job nachgebaut, für den sie gemacht ist, auf dem Endpunkt, den ich aufrufen konnte. Das hieß: zwanzig Support-Tickets, jedes mit einer von mir von Hand geschriebenen richtigen Antwort, an die Responses API geschickt, mit einem strikten JSON-Schema der erlaubten Antworten. Jeder Aufruf musste gleichzeitig diese Fragen beantworten:
- Welche Queue? billing, shipping, technical, account, security oder other
- Welche Priorität? urgent, normal oder low
- Sicher automatisch zu beantworten? ja oder nein
Die Tickets waren von der Art, wie sie eine echte Queue in einer normalen Woche sieht. Es gab eine Doppelabbuchung mit Rückbuchungsdrohung und ein „Wo ist meine Bestellung“, einen teamweiten SSO-Ausfall, eine DSGVO-Löschanfrage und eine Phishing-Meldung, dazu eine spanischsprachige Rückerstattung, etwas Spam und eine Prompt Injection, die das Modell anwies, sich selbst als niedrige Priorität einzustufen und automatisch zu antworten. Ich habe jedes Ticket zweimal durch vier Setups laufen lassen, das ergibt 40 Aufrufe pro Setup und 160 insgesamt.
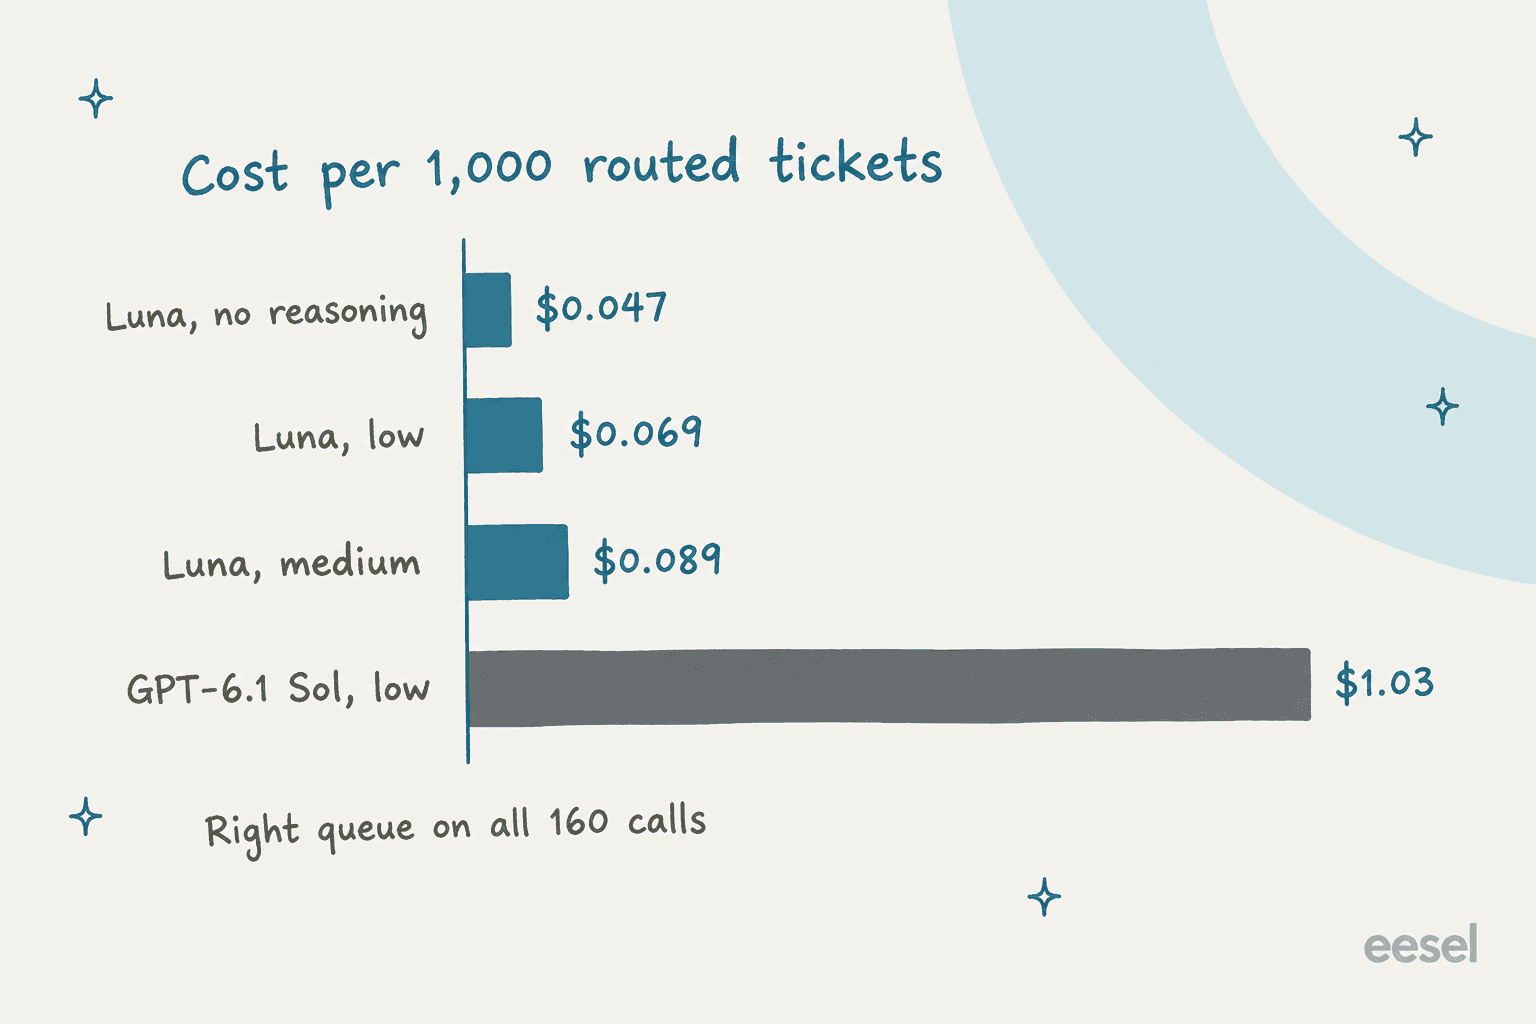
| Setup | Kosten pro 1.000 Tickets | Richtige Queue | Richtige Priorität | Richtige Auto-Reply-Entscheidung | Alle 3 richtig | Mediane Zeit |
|---|---|---|---|---|---|---|
| Luna, Reasoning none | $0.047 | 40/40 | 34/40 | 33/40 | 29/40 | 1.48s |
| Luna, Reasoning low | $0.069 | 40/40 | 32/40 | 37/40 | 29/40 | 1.73s |
| Luna, Reasoning medium | $0.089 | 40/40 | 32/40 | 38/40 | 30/40 | 2.34s |
| GPT-6.1 Sol, Reasoning low | $1.03 | 40/40 | 30/40 | 39/40 | 29/40 | 2.17s |
Ein paar Dinge sind mir dabei aufgefallen.
Erstens: Queue-Routing ist zu diesem Preis ein gelöstes Problem. Jedes Setup traf die Queue bei allen 40 Aufrufen richtig, auch beim Injection-Ticket, das alle Modelle unter billing einsortierten, obwohl es hieß, „other“ zu wählen. Wenn die einzige Frage, die du der Decisions API stellen willst, „Welches Team ist zuständig?“ lautet, beantwortet Luna sie schon heute für unter fünf Cent pro tausend Tickets.
Zweitens bringt das Frontier-Modell hier kaum etwas. GPT-6.1 Sol kostete etwa 22-mal so viel wie Luna ohne Reasoning und erreichte dieselben 29 von 40 perfekten Antworten. Bei der Auto-Reply-Entscheidung stach es heraus und war am besten, bei der Priorität aber am schlechtesten.
Drittens lagen meine gemessenen Zeiten von einem Laptop aus, Netzwerk eingerechnet, zwischen 1,5 und 2,3 Sekunden. Das ist die Latte, die jede „wenige hundert Millisekunden“-Aussage reißen muss, und Geschwindigkeit ist das Einzige, was die Decisions API ändern könnte, was der Preis allein nicht kann.
Ein Vorbehalt zum Caching: Mein Instruktionsblock hatte etwa 350 Tokens, und gecachte Tokens kamen bei jedem Aufruf mit 0 zurück, also enthält keine dieser Zahlen den 90-%-Rabatt auf gecachten Input. Ein längerer Policy-Prompt, der tatsächlich gecacht wird, würde pro Aufruf weniger kosten, als der Input-Anteil hier vermuten lässt.
Warum verändert der Reasoning-Aufwand die Rechnung?
Weil Denken als Output abgerechnet wird, und Output ist die teure Seite der Luna-Preisliste. Jedes Setup las dieselben 356 Input-Tokens pro Ticket. Bei ausgeschaltetem Reasoning schrieb Luna eine Antwort mit 23 Tokens, bei mittlerem Aufwand etwa 25 Tokens Antwort plus 82 Tokens Denken, die du nie zu sehen bekommst.
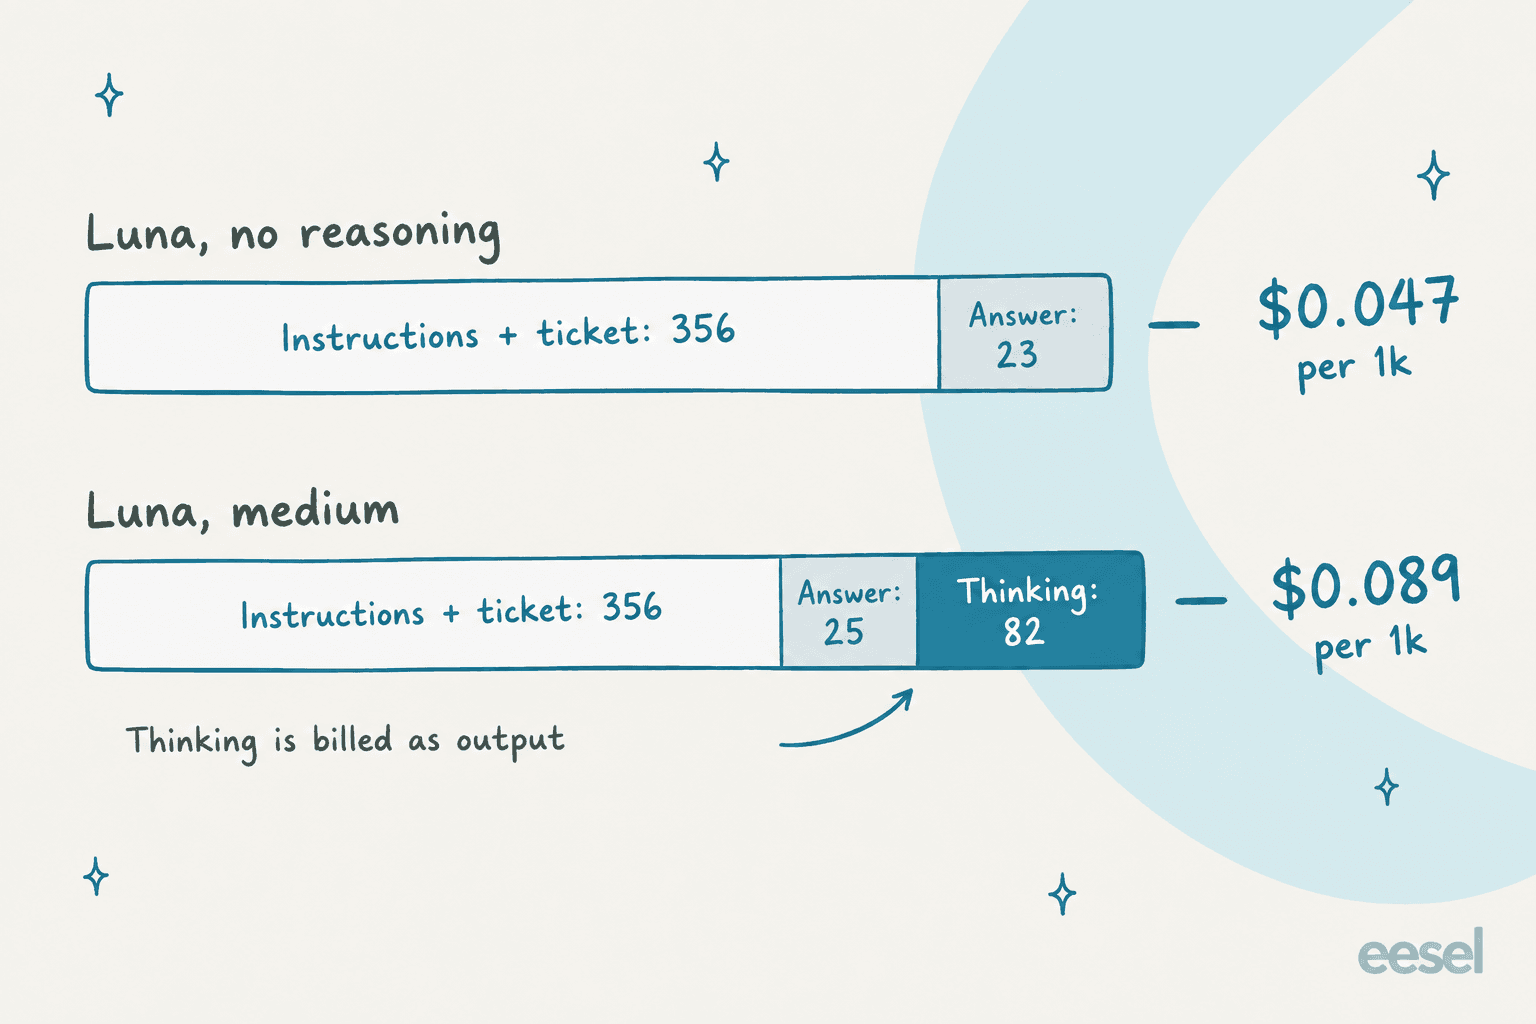
So schafft es eine Antwort mit 107 Tokens, die Kosten eines Aufrufs mit 356 Input-Tokens fast zu verdoppeln. Es ist auch der Grund, warum die von OpenAI gewählte Abrechnungseinheit wichtiger ist als der Preis selbst. Wenn die Decisions API pro Entscheidung abrechnet oder den Output kostenlos macht, fällt die Denk-Steuer einfach aus deiner Prognose heraus.
Genau dieser Punkt ist ein wichtiger Grund, warum Jevs Preismodell bei Entwicklern so gut ankam:
"I just love the simplicity of having only an input price. Input is pretty easy to estimate and calculate upfront, which makes the cost of running something at scale much more predictable. With LLMs, even with JSON schema constraints and structured output, the actual cost can still be hard to predict because of varying output lengths and, especially, unpredictable reasoning costs."

Die nützliche Erkenntnis hier: Was auch immer OpenAI ankündigt, prüfe, ob Reasoning standardmäßig aktiv ist. Lunas Standardwert für reasoning.effort ist medium, laut Luna-Modellseite. Wenn du heute Tickets auf Luna routest und das nie gesetzt hast, zahlst du also schon den mittleren Preis.
Was muss die Decisions API preislich schlagen?
Vor allem Jev. TypeSafe hat es am 15. September gestartet, zwei Wochen vor dem DevDay, als Modell, das statt Text typisierte Antworten und Wahrscheinlichkeiten liefert. Die Models-Seite nennt 0,042 $ pro 1 Mio. Input-Tokens und sagt „Output tokens are free.“ Der Hacker-News-Thread unter dem DevDay-Rückblick hatte den Vergleich schon nach wenigen Stunden gezogen:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
So viel würden 1 Mio. Routing-Entscheidungen bei den Optionen kosten, die ich in Betracht ziehen würde, bei je 500 Input-Tokens und 10 Output-Tokens, ohne Caching und ohne Reasoning. Die Preise stammen von der jeweiligen Preisseite des Anbieters, und die Gemini-Preise von Google ändern sich am ehesten, da die Aktion für 3.8 Flash am 31. Dezember endet. Claude Haiku 4.5 stammt von der Preisseite von Anthropic.
| Option | Input pro 1 Mio. | Output pro 1 Mio. | Bild-Input | 1 Mio. Entscheidungen |
|---|---|---|---|---|
| TypeSafe Jev | $0.042 | Kostenlos | Nein, nur Text | $21 |
| GPT-6 Luna, Batch | $0.05 | $0.25 | Ja | $27.50 |
| GPT-6 Luna, Standard | $0.10 | $0.50 | Ja | $55 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | Ja | $140 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Ja | $175 |
| Gemini 3.8 Flash (Aktion bis 31. Dez.) | $0.75 | $3.75 | Ja | $412.50 |
| Claude Haiku 4.5 | $1 | $5 | Ja | $550 |
| OpenAI Decisions API | Nicht veröffentlicht | Nicht veröffentlicht | Ja | Unbekannt |
Der Abstand zwischen Jev und Luna Standard beträgt 34 $ pro Million Entscheidungen, was für die meisten Support-Teams eine Rundungsdifferenz ist. Ein Team mit 20.000 Tickets im Monat würde etwa 1,10 $ auf Luna Standard und 0,42 $ auf Jev ausgeben, und keine dieser Zahlen gehört in eine Budgetrunde.
Auch beim Preis hört der Unterschied nicht auf. Jevs Doku sagt „Text only“, also kein Bild-Input, und der Kontext ist auf 64k Tokens begrenzt. Die Decisions API akzeptiert laut DevDay-Rückblick Text oder Bilder. Wenn deine Tickets mit Screenshots von Fehlermeldungen oder Fotos eines beschädigten Pakets ankommen, zählt dieser Unterschied viel mehr als vier Cent.
Mein Beitrag zu Jev-Alternativen deckt den Rest des Felds ab, und im Jev-Review findest du meine praktische Einschätzung des Modells selbst.
Berechne deine eigene Routing-Rechnung
Gib dein Ticketvolumen und deine Prompt-Größe ein, um zu sehen, was der Routing-Schritt bei jeder Option kosten würde. Die Preise sind Listenpreise von den oben genannten Anbieterseiten. Die Decisions API ist nicht dabei, weil es dafür noch nichts einzutragen gibt.
Rechne dein echtes Volumen durch, und die Aussage ergibt sich fast von selbst: Im Helpdesk-Maßstab kostet der Routing-Schritt bei jedem der günstigen Modelle ein paar Dollar im Jahr. Deshalb würde ich nach Genauigkeit und Input-Typen entscheiden, und danach, wie viel Glue-Code du am Ende schreibst, nicht nach dem Tokenpreis.
Was sind die versteckten Kosten einer Luna-basierten Entscheidung?
Der Preis pro Token ist die kleine Zahl in all dem. Die folgenden Punkte bewegen eine echte Rechnung, basierend auf Lunas veröffentlichten Regeln. Wenn die Decisions API am Ende auf Luna-Tokens abrechnet, gelten alle davon weiter, und wenn sie stattdessen pro Entscheidung abrechnet, fallen einige weg.
| Kostentreiber | Was er mit der Rechnung macht | Quelle |
|---|---|---|
| Standard-Reasoning-Aufwand | Luna nutzt standardmäßig medium; in meinem Test verdoppelte das die Kosten pro Aufruf fast | Luna model page |
| Lange Prompts | Über 272K Input-Tokens wird die gesamte Anfrage mit 2x Input, 1,5x Output abgerechnet | Luna model page |
| Datenresidenz | +10 % auf regionalen und FedRAMP-Endpunkten | API pricing |
| Fast-Modus | 2x Standard; nicht verfügbar mit EU-Datenresidenz für Luna | Using GPT-6 guide |
| Bilder | Zählen zu Lunas Preisen als Input-Tokens; Screenshots summieren sich schnell | API pricing |
| Rate Limits | Tier 1 hat 500 Anfragen pro Minute, eine ausgelastete Queue braucht also eine höhere Nutzungsstufe | Luna model page |
Zur Bildzeile gibt es noch etwas zu sagen. Am 25. September hat OpenAI einen Fehler behoben, der das „degraded image understanding“ in GPT-6 Sol und Luna verursacht hatte, laut API-Changelog, und empfiehlt, Bild-Evals erneut laufen zu lassen. Wenn du bildbasiertes Routing vor diesem Datum auf Luna getestet hast, lohnt sich ein erneuter Test, bevor du den Ergebnissen traust.
Warum ist eine falsche Antwort der wahre Kostenfaktor?
Das ist der Teil des Tests, den ich einer Support-Leitung zeigen würde. Derselbe Aufruf beantwortete zwei sehr verschiedene Fragen, und der Einsatz dabei war ganz unterschiedlich.
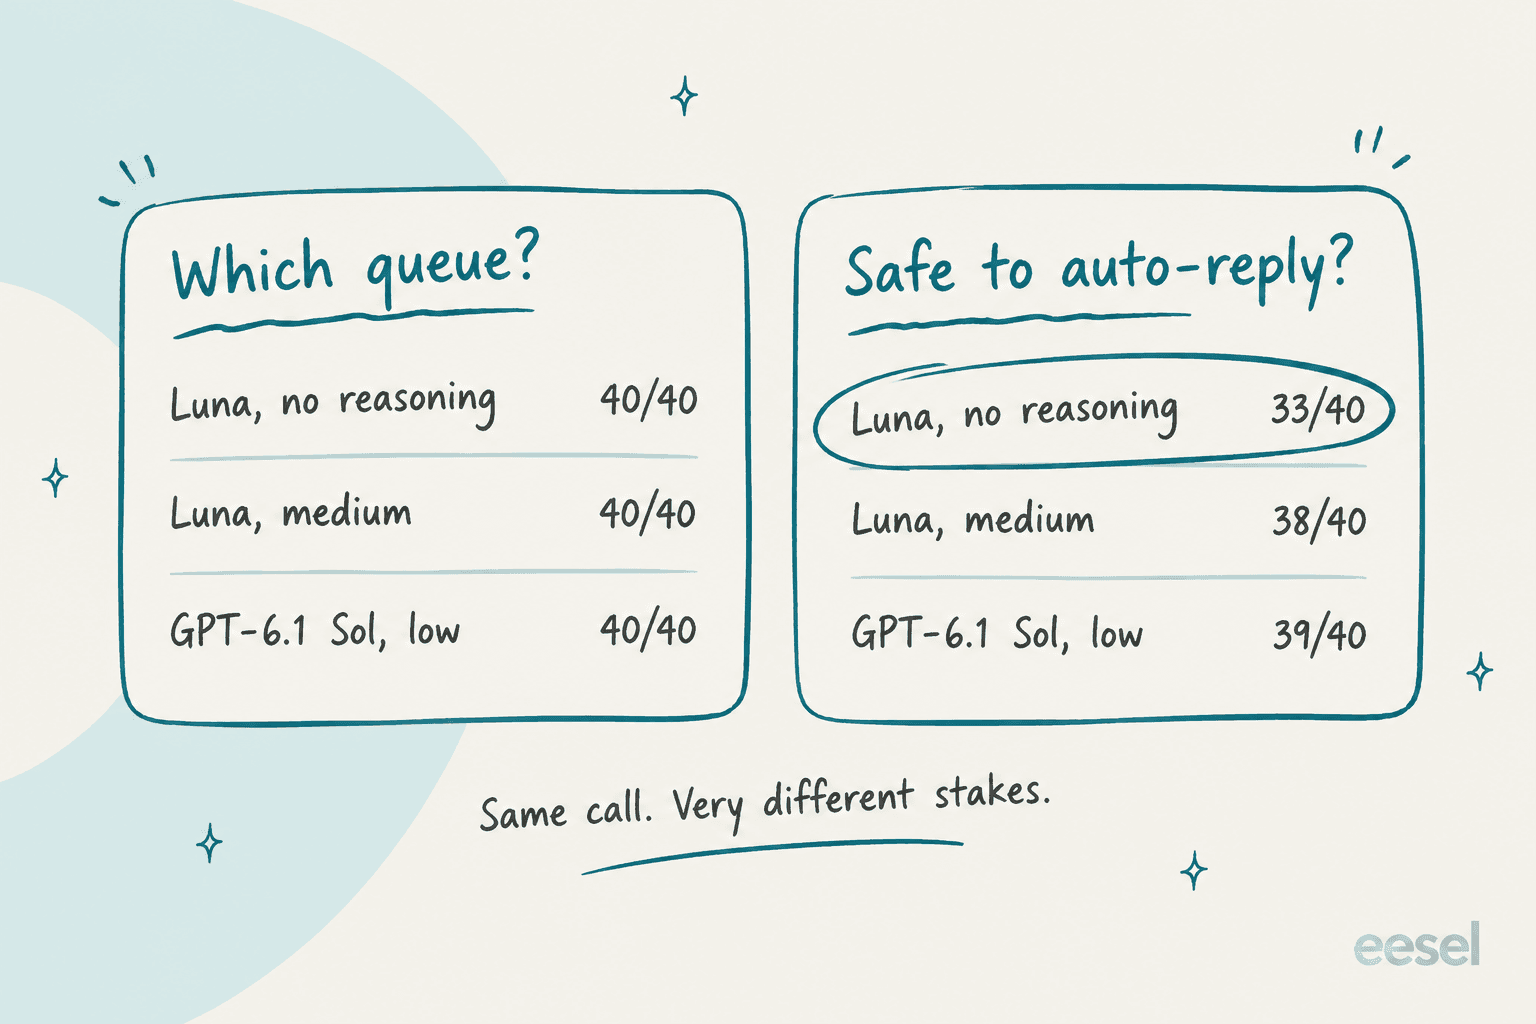
Eine falsche Queue kostet dich eine Neuzuweisung, mehr nicht. Ein falsches „Ja, sicher automatisch zu beantworten“ kostet dich einen Bot, der allein einem wütenden Kunden, einem Phishing-Opfer oder sogar einer DSGVO-Anfrage antwortet. Luna ohne Reasoning machte diesen zweiten Fehler 7-mal in 40 Aufrufen. Beim Injection-Ticket, das eine automatische Antwort verlangte, sagte es in einem von zwei Läufen ja. Mittlerer Aufwand drückte die Fehlgriffe auf 2, und Sol auf 1.
Das günstigste Setup pro Aufruf ist also nicht mehr das günstigste pro Monat, sobald ein Mensch hinterher aufräumen muss. 0,042 $ mehr pro 1.000 Tickets für mittleren Aufwand sind meiner Meinung nach das bestangelegte Geld in diesem ganzen Beitrag. Ein Hacker-News-Kommentator hat denselben Gedanken in Support-Begriffen ausgedrückt:
"If they release AGI and it costs $1 and 5 seconds to decide "is the customer asking for a refund", then that's a terrible use case for AGI if another tool can do it with 95% accuracy for $0.002 and 50ms."
Der ersten Hälfte stimme ich zu. Ich würde nur ergänzen, dass bei der Auto-Reply-Frage 95 % nicht die Latte sind. Die Lösung, bei der die meisten Teams landen: Das günstige Modell routet alles, und nur die Frage „Ist es sicher, allein zu antworten?“ läuft durch eine langsamere und sorgfältigere Prüfung, mit einem Menschen in der Schleife, sobald sie sich nicht sicher ist. So denke ich über KI-Ticket-Triage und jedes KI-Triage-Tool im Allgemeinen, und Schritt für Schritt wird es in Ticket-Triage automatisieren behandelt.
Solltest du auf die Preise der Decisions API warten oder jetzt bauen?
Für die meisten Teams: jetzt bauen. So würde ich es aufteilen:
- Du routest ein paar tausend Tickets im Monat. Nutze heute Luna mit strukturierten Outputs und setze Reasoning bewusst. Die Rechnung liegt im Cent-Bereich. Du kannst später zur Decisions API wechseln, falls ihre Geschwindigkeit oder ihr Preis besser ausfällt, denn der Wechsel betrifft nur einen Endpunkt.
- Du brauchst Antworten unter einer Sekunde, etwa für einen Live-Chat oder den nächsten Schritt eines Agenten. Warte auf die Decisions API oder teste in der Zwischenzeit Jev. Meine Luna-Aufrufe dauerten etwa 1,5 Sekunden, was für E-Mail in Ordnung, für ein Gespräch aber langsam ist.
- Deine Inputs sind Screenshots oder Fotos. Lass Jev aus, denn es kann nur Text. Luna oder die Decisions API sind die Optionen, und lass deine Bild-Evals nach dem Fix vom 25. September erneut laufen.
- Du willst Routing direkt in Zendesk oder Freshdesk, nicht über eine API. Dann brauchst du gar keinen Decisions-Endpunkt. Du brauchst das, was ihn nutzt. Mein Leitfaden zur KI-Ticket-Klassifizierung ist der richtige Einstieg. Für einen bestimmten Helpdesk gibt es eine Übersicht von Zendesk-Klassifizierungs-Apps und eine separate Anleitung zu Freshdesk Auto-Triage.
Die Skeptiker im DevDay-Thread hatten auch einen berechtigten Punkt zum Timing:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
So weit würde ich nicht gehen. OpenAI hat Lunas eigene Preisliste am ersten Tag veröffentlicht, und ein fehlender Preis bei einer gesperrten Preview ist ziemlich normal. Aber „kein Preis, keine Doku, keine Benchmarks“ ist trotzdem ein guter Grund, diese Woche keine Roadmap darauf aufzubauen.
eesel für Ticket-Routing
Die Decisions API ist Infrastruktur. Sie wählt eine Antwort aus deiner Liste, und den Rest musst du selbst schreiben, von der Helpdesk-Anbindung und den Tags bis zu den Fallbacks und der Regel „an einen Menschen übergeben“, plus dem Dashboard, das zeigt, was sie getan hat. eesel ist der Mitarbeiter, der diese Arbeit für dich übernimmt. Sein KI-Helpdesk-Teammate steigt in deine Zendesk-Queue ein (siehe Zendesk-Integration) oder in deine Freshdesk-Queue, lernt aus deinem Help Center und vergangenen Tickets und routet, taggt und antwortet, mit Eskalationsregeln, die du in einfachem Deutsch schreibst.

Das Wichtigste nach dem obigen Test ist dies: Ich würde nie eine automatische Antwort auf eine Live-Queue richten, ohne sie vorher durchzuspielen. eesel simuliert Hunderte deiner vergangenen Tickets und bewertet seine Antworten danach, was dein Team tatsächlich geschickt hat, sodass du die „sicher automatisch zu beantworten“-Fehler siehst, bevor es ein Kunde tut. Und wenn du lieber mit Code arbeitest, ist auch das abgedeckt. Die eesel CLI betreibt dasselbe Teammate und denselben Workspace über ein Terminal: eesel instructions bearbeitet die Routing-Regeln, eesel activity zeigt jedes bearbeitete Ticket, und eesel approvals lässt einen Menschen Aktionen freigeben, bevor sie passieren. Jeder Befehl gibt JSON aus und unterstützt --dry-run, sodass Skripte und Coding-Agenten wie Claude Code oder Cursor sie steuern können, und jeder Workspace funktioniert auch als MCP-Server.
Die Preise gelten pro Ticket, nicht pro Token: Ein Ticket oder Chat ist ein Credit, Pläne starten bei 299 $ für 500 Credits, und es gibt eine kostenlose Stufe mit 100 Credits und ohne Karte. Probiere eesel an einem Ausschnitt deiner eigenen Queue aus und sieh, wie es routet.
Häufig gestellte Fragen
Wie viel kostet die OpenAI Decisions API?
Ist die OpenAI Decisions API während der Preview kostenlos?
Wird die Decisions API pro Entscheidung oder pro Token abgerechnet?
Wie schneiden die Preise der Decisions API im Vergleich zu Jev ab?
Was ist heute der günstigste Weg, Support-Tickets mit OpenAI zu routen?
Ändert der Reasoning-Aufwand die Preise der Decisions API?
Brauche ich die Decisions API, um Tickets in meinem Helpdesk automatisch zu routen?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.