Was kostet Bedrock Managed Agents?
AWS' Preiszeile für die Preview besteht aus einem Satz: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New).
Zwei Jahre SEO haben mir bei Preisanfragen eines beigebracht: Das Wort "kostenlos" führt mehr Leute zum falschen Schluss als jedes andere. Wer nach "bedrock managed agents pricing" sucht, will die Zahl, die seine Finanzabteilung sehen wird, und diese Zahl ist nie $0. Die Entwicklerdokumentation sagt genau, was "underlying resources" umfasst: "You incur charges for model inference and the AWS resources that your application uses", und das AgentCore-Beispiel "can continue to incur charges when no BMA turn is running" (AWS docs).
Wenn der Dienst selbst neu für dich ist: Mein Leitfaden zu Bedrock Managed Agents erklärt, wie Sessions, der Exec-Server und Ausführungsumgebungen zusammenspielen. Dieser Beitrag dreht sich nur um die Rechnung.
Hier ist jeder Posten, der auftauchen kann, in einer Tabelle:
| Kostenposten | Preis in der Preview | Abrechnungseinheit | Wann er anfällt |
|---|---|---|---|
| BMA-Servicegebühr | $0 | n/a | Immer (Änderung bei GA möglich) |
| OpenAI-Modell-Tokens | In-Region-Rate, z. B. $0.22 in / $1.32 out für GPT-5.6 Luna | Pro 1M Input-, Cache- und Output-Tokens | Bei jedem Turn |
| AgentCore Runtime v2 CPU | $0.1276 pro vCPU-Stunde | Pro Sekunde, nur aktive CPU | Wenn AgentCore deine Ausführungsumgebung ist |
| AgentCore Runtime v2 Arbeitsspeicher | $0.0169 pro GB-Stunde | Pro Sekunde, ungenutzter Speicher wird nach 120 Sekunden freigegeben | Wenn AgentCore deine Ausführungsumgebung ist |
| NAT-Gateway | $0.045 pro Stunde + $0.045 pro GB | Pro Stunde (angebrochene Stunden zählen voll) | AWS' AgentCore-Beispiel-Stack |
| S3, S3 Files, CloudWatch | Standard-AWS-Raten | Speicher und Anfragen | Skills, Ausgaben und Logs |
| Selbst gehostete Rechenleistung | Was dein Host kostet | Deine bestehende Rechnung | Wenn du codex exec-server selbst betreibst |
So sieht das Gesamtbild aus. Nicht alle Posten wiegen gleich schwer, deshalb geht es im Rest dieses Beitrags um die, die zählen.
Posten 1: Modell-Tokens und der In-Region-Aufschlag von 10 %
Jedes OpenAI-Modell auf Bedrock listet seine Preise auf einer eigenen Modellkarte. Das für BMA entscheidende Detail steht in den Einschränkungen der Preview: Cross-Region-Inference wird nicht unterstützt. Das heißt, jede BMA-Anfrage zahlt die In-Region-Rate, und AWS sagt das deutlich: "Commercial In-Region prices include a 10% fee over OpenAI rates" (GPT-5.6 Luna card).
Hier sind die Standard-Tier-Raten für kurzen Kontext (272K Input-Tokens oder weniger) pro Million Tokens für die OpenAI-Modelle, die ich für einen Agenten in Betracht ziehen würde, alle von ihren Bedrock-Karten auf der OpenAI-Modellseite von AWS:
| Modell | Input (BMA-Rate) | Cache schreiben | Cache lesen | Output (BMA-Rate) | OpenAIs eigene Rate (in / out) |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.11 | $0.1375 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-5.6 Luna | $0.22 | $0.275 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6.1 Sol | $2.20 | $2.75 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $2.75 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $5.50 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $13.75 | $1.10 | $55.00 | $10.00 / $50.00 |
Vier Details auf diesen Karten verändern deine Schätzung stärker, als die Tabelle vermuten lässt:
- Langer Kontext verdoppelt den Input. Sobald eine Anfrage über 272.000 Input-Tokens geht, gilt die Rate für langen Kontext "to the full request", nicht nur für den Überschuss (GPT-6.1 Sol card). Bei GPT-5.6 Sol sind das $8.80 für Input und $33.00 für Output. Ein Agent, der ein großes Kontextfenster durch jeden Turn schleppt, erreicht das schnell.
- Keine Priority- oder Flex-Rabatte. Jede Karte oben sagt, dass die Tiers Priority und Flex nicht unterstützt werden, es gibt also keinen günstigeren Batch-Tier für Nachtjobs. Standard ist alles, was du bekommst.
- Caching ist nicht einheitlich. Die Karte von GPT-6.1 Sol listet Cache-Preise, sagt aber "Explicit prompt caching is not supported for this Bedrock model." Prüfe die Karte des konkreten Modells, bevor du mit dem Cache-Lese-Rabatt von 90 % rechnest.
- Die neuesten Modelle liegen in einer einzigen Region. Auf dem
bedrock-mantle-Endpoint, den BMA nutzt, sind GPT-6 Luna und GPT-6.1 Sol nur inus-east-1verfügbar. Wenn du in Oregon oder Ohio deployst, bist du auf die GPT-5.6-Familie beschränkt.
Die neueste Generation ist hier auch die günstigste pro Token: GPT-6 Luna kostet bei Input und Output halb so viel wie GPT-5.6 Luna. Wenn ohnehin ein Luna deine Wahl wäre, teste zuerst GPT-6 Luna. Meine Beiträge zu den GPT-6-Luna-Preisen und den GPT-6.1-Sol-Preisen vergleichen sie mit dem Rest von OpenAIs Lineup.
Posten 2: AgentCore-Runtime-Stunden
BMA führt deine Tools nicht selbst aus; sie laufen auf Rechenleistung, die du stellst: entweder dein eigener Host oder die Runtime von Amazon Bedrock AgentCore, die im AWS-Beispiel der Standard ist. Wenn du AgentCore nutzt, zahlst du dessen Runtime-Raten (AgentCore pricing):
| AgentCore-Runtime-Ressource | Verbrauchsrate | Fest zugesagtes Basisvolumen |
|---|---|---|
| v2 microVM CPU | $0.1276 pro vCPU-Stunde | $0.0997 pro vCPU-Stunde (Start bis Oktober 2026) |
| v2 microVM Arbeitsspeicher | $0.0169 pro GB-Stunde | $0.0132 pro GB-Stunde (Start bis Oktober 2026) |
| v1 microVM CPU | $0.0895 pro vCPU-Stunde | n/a |
| v1 microVM Arbeitsspeicher | $0.00945 pro GB-Stunde | n/a |
| Runtime-Instanzen (EC2) | EC2-On-Demand-Rate | plus 12 % Verwaltungsgebühr |
Dieses Abrechnungsmodell ist für Agenten freundlicher, als es zunächst aussieht. AWS sagt, die CPU "scales to zero during I/O wait (waiting for LLM responses, tool / API calls, or database queries)", und bei v2 werde "idle memory is reclaimed automatically" nach 120 Sekunden. Da ein Agent die meiste Zeit auf das Modell wartet, wird für den Großteil seiner Laufzeit gar keine CPU berechnet.
Die eigene Preisseite von AWS hat ein durchgerechnetes Beispiel, das einem Support-Agenten nahekommt: 1 Million Sessions im Monat, je 10 Minuten, 90 % I/O-Wartezeit, 1 vCPU und bis zu 2,5 GB. Die Summe liegt bei $0.006703 pro Session, also $6.703 im Monat für die Million. Und das ist nur die Runtime, noch bevor du einen einzigen Token bezahlt hast.
Worauf du achten solltest: Das BMA-AgentCore-Beispiel setzt Idle-Timeout und maximale Lebensdauer der Runtime auf 28.800 Sekunden, also acht Stunden. Ungenutzter Speicher wird zwar freigegeben, aber eine vergessene Session ist trotzdem eine Session.
Posten 3: das NAT-Gateway, das abrechnet, während dein Agent schläft
Der AgentCore-Beispiel-Stack von AWS erstellt eine VPC mit privaten Subnetzen, einem S3-Gateway-Endpoint und einem NAT-Gateway. Laut Amazon-VPC-Preisen in US East kostet ein NAT-Gateway $0.045 pro Stunde plus $0.045 pro verarbeitetem GB, und angebrochene Stunden werden als volle Stunden berechnet.
Über einen Monat mit 730 Stunden sind das $32.85, bevor dein Agent irgendetwas tut. Für ein Produktionsteam ist das wenig Geld. In einem Dev-Account, in dem jemand das Beispiel an einem Freitag ausprobiert und dann vergessen hat, ist es ein Posten, der jeden Monat wieder auftaucht, bis jemand die Aufräumschritte ausführt. Deshalb empfehlen die AWS-Docs selbst, das Beispiel in einem Entwicklungs-Account laufen zu lassen.
Die übrigen Speicherposten (S3-Buckets für Skills und Ausgaben, S3-Files-Mounts, CloudWatch-Logs) kosten bei Testvolumen normalerweise Cent-Beträge. Da sie mit der Schreibmenge deines Agenten wachsen, lohnt es sich, sie in deiner AWS-Rechnung zu prüfen, sobald du in Produktion bist.
Was eine Agent-Aufgabe wirklich kostet
Das ist das Rechenbeispiel, das ich verwende. Eine Aufgabe, bei der der Agent etwas Code und Dokumentation liest und dann ein Ergebnis schreibt. Das sind 200.000 Input-Tokens und 20.000 Output-Tokens, ohne Caching, 10 Minuten auf einer AgentCore-Session mit 2 vCPU / 4 GB, bei der die CPU zu 20 % der Zeit ausgelastet ist.
- Runtime: 120 aktive Sekunden x 2 vCPU x $0.1276 pro Stunde = $0.0085, plus 600 Sekunden x 4 GB x $0.0169 pro Stunde = $0.0113. Rechne mit $0.02, und weniger, wenn v2 ungenutzten Speicher freigibt.
- Tokens bei GPT-5.6 Luna: 0.2M x $0.22 + 0.02M x $1.32 = $0.070.
- Tokens bei GPT-5.6 Sol: 0.2M x $4.40 + 0.02M x $22.00 = $1.32.
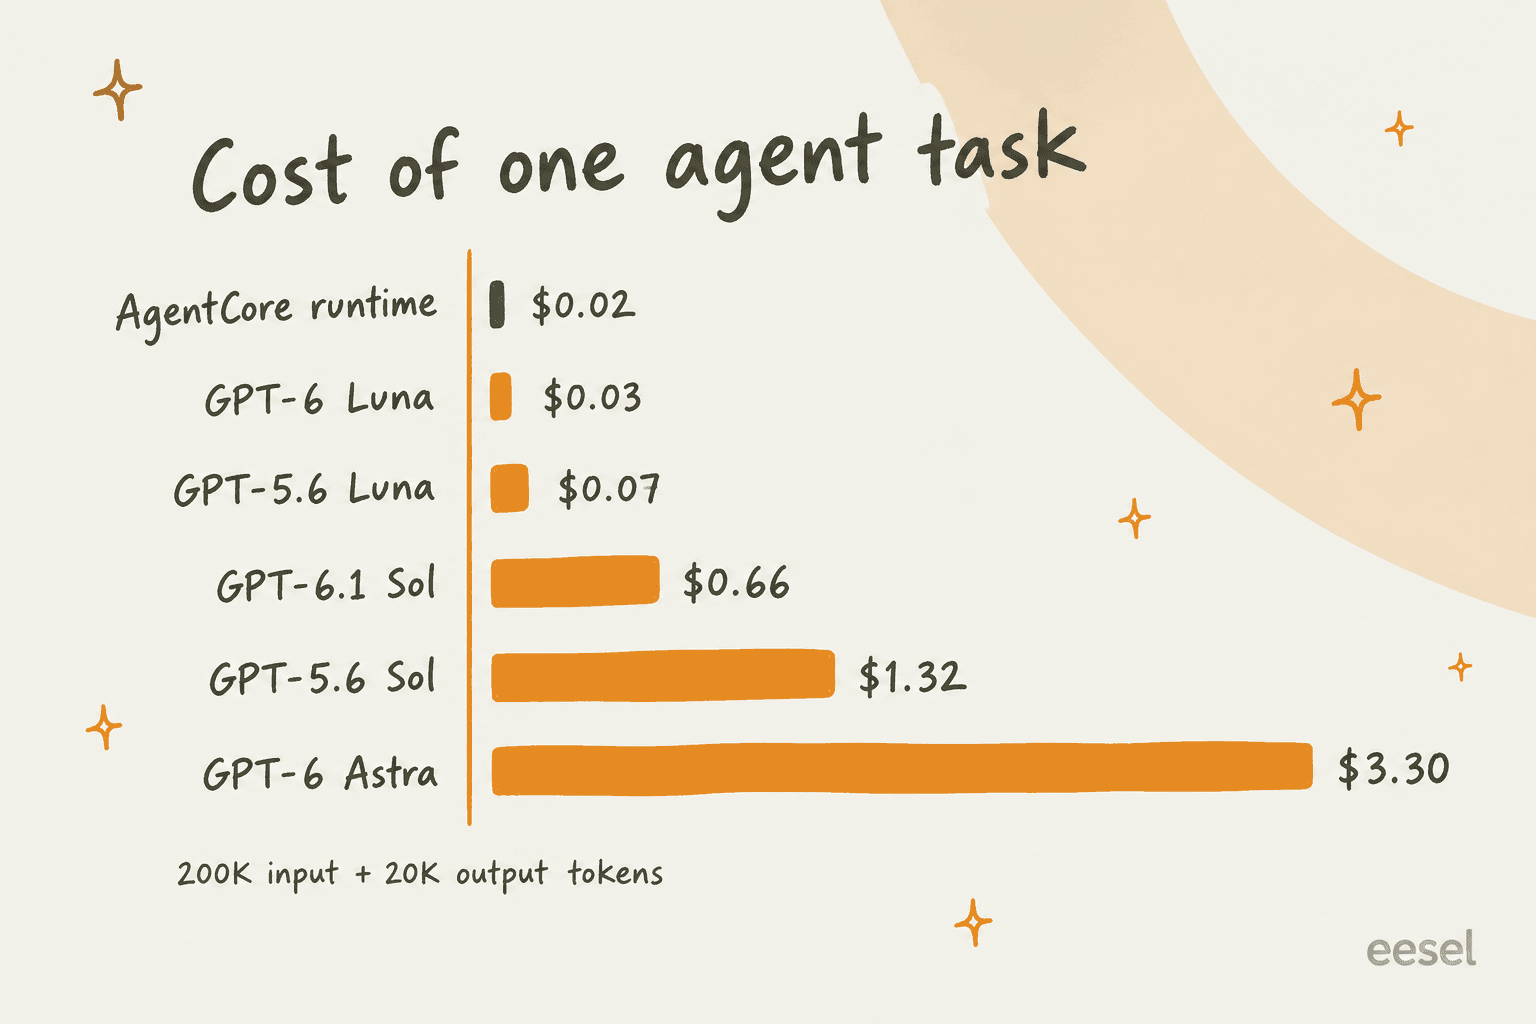
Wenn du aus diesem Beitrag nur eines mitnimmst, dann dieses Diagramm. Die Runtime ist der kleinste Balken im Diagramm. Von GPT-6 Luna zu GPT-6 Astra bei derselben Aufgabe ist ein Sprung um das 100-Fache bei den Token-Kosten, während die AgentCore-Runtime bei etwa zwei Cent bleibt. Wenn du eine BMA-Rechnung senken willst, ist die Modellwahl der Hebel. Am Tuning der vCPUs ändert sich kaum etwas.
So skaliert das über einen Monat mit GPT-5.6 Luna, bei laufendem NAT-Gateway:
| Aufgaben pro Monat | Tokens | AgentCore-Runtime | NAT-Gateway | Monatssumme | Pro Aufgabe |
|---|---|---|---|---|---|
| 1.000 | $70 | $20 | $33 | $123 | $0.123 |
| 10.000 | $704 | $198 | $33 | $935 | $0.093 |
| 100.000 | $7.040 | $1.977 | $33 | $9.050 | $0.091 |
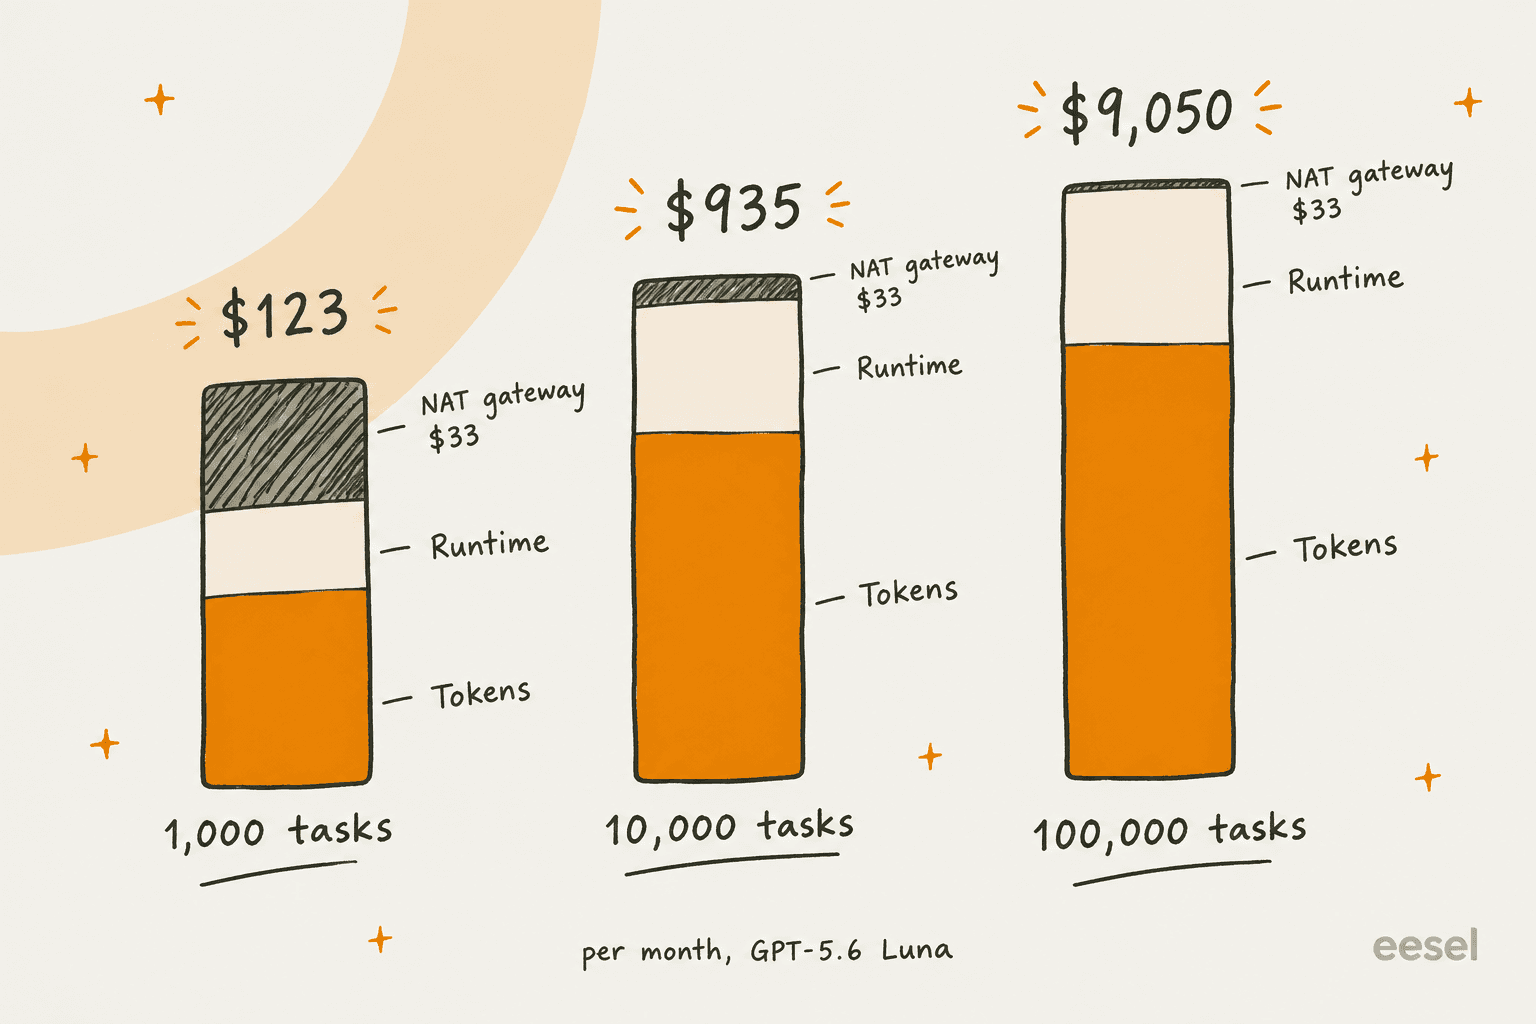
Bei geringem Volumen macht das feste NAT-Gateway über ein Viertel der Rechnung aus. Bei 100.000 Aufgaben ist es Rauschen, und Tokens machen fast 80 % aus. Der Rat dreht sich also mit der Größenordnung: Kleine Teams sollten selbst hosten oder den Beispiel-Stack zwischen Tests abbauen, große Teams sollten ihre Energie in die Modellwahl und ins Prompt-Caching stecken (den wiederkehrenden Kontext cachefähig machen).
Du kannst im Rechner unten eigene Zahlen eintragen, er nutzt dieselben Raten wie die Tabellen oben:
@@WIDGET@@
Lohnt sich der AWS-Aufschlag von 10 %?
Ich vermute, das ist die Frage, die die meisten Käufer eigentlich stellen. Die Antwort fällt günstiger für AWS aus, als die Überschrift vermuten lässt. Hier ist dieselbe 10-Minuten-Aufgabe mit GPT-5.6 Luna, auf vier Arten kalkuliert:
| Setup | Tokens | Runtime | Pro Aufgabe |
|---|---|---|---|
| OpenAI Agents API, selbst gehostete Sandbox | $0.064 (OpenAI-Rate) | $0 | $0.064 |
| Bedrock Managed Agents, selbst gehostet | $0.070 (In-Region-Rate) | $0 | $0.070 |
| Bedrock Managed Agents auf AgentCore | $0.070 | etwa $0.020 | $0.090 |
| OpenAI Agents API, gehosteter 4-GB-Container | $0.064 | $0.06 | $0.124 |
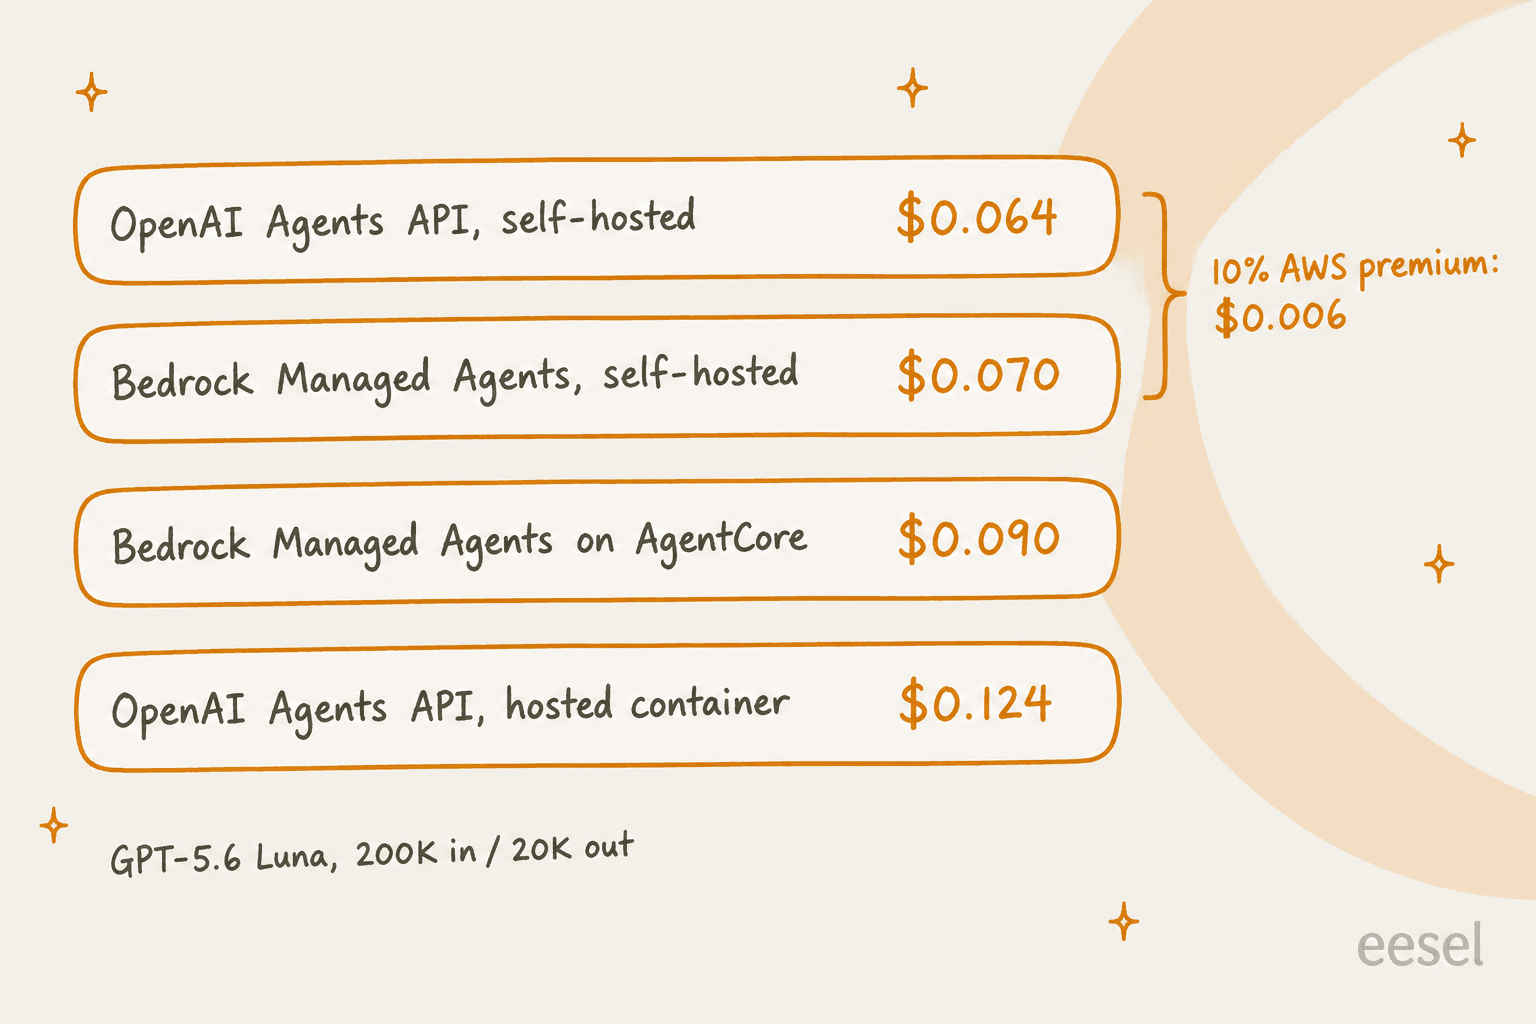
Die Zeile mit dem gehosteten Container nutzt OpenAIs veröffentlichten Preis von $0.12 pro 20-Minuten-Session für einen 4-GB-Container, minutengenau abgerechnet mit 5 Minuten Minimum (OpenAI pricing). Mein Beitrag zu den Agents-API-Preisen geht jede Containergröße durch.
Der AWS-Aufschlag bei dieser Aufgabe beträgt also etwa $0.006. Bei einer Million Aufgaben im Monat ist das echtes Geld (rund $6.400), aber es ist weniger als die Lücke zwischen OpenAIs gehostetem Container und AgentCores I/O-bewusster Abrechnung. Angenommen, du würdest sonst OpenAIs gehostete Sandbox nutzen: Dann kann BMA auf AgentCore pro Aufgabe günstiger sein, nicht teurer. Wenn du ohnehin selbst hosten würdest, kostet dich BMA genau die 10 %.
Was der Aufschlag kauft, ist der Teil, der in einem Security-Review zählt: Agent-Runtime, Modell-Inferenz und deine Tools bleiben alle in deinem AWS-Account, unter dem Vertrag von AWS. Die Beschaffungslogik hat ein Hacker-News-Kommentator gut auf den Punkt gebracht:
"A lot of companies already have data processing agreements and compliance sign-off for using AWS. Many are hesitant to send their data to AI startups with an incentive to train their models and a history of being.... loose with how they intake training data. Even when they do give assurances otherwise. AWS is more trusted in this aspect. If this ends up similar to Claude on Bedrock, it's the same price."

Es ist nicht ganz derselbe Preis geworden, aber nah dran: 10 % mehr für die In-Region-Garantie. Wenn dein Unternehmen schon AWS-Verträge unterschrieben hat und für einen neuen KI-Anbieter Monate an Freigaben bräuchte, sind diese 10 % wahrscheinlich die günstigste Compliance-Arbeit, die du dieses Jahr kaufst.
Wie sich die Preise von BMA mit anderen Managed-Agent-Runtimes vergleichen
Jedes große Labor verkauft inzwischen einen verwalteten Agent-Loop, und jedes berechnet die Runtime auf seine Art. Tokens kommen immer extra dazu, zu den Modellraten des jeweiligen Anbieters:
| Runtime | Runtime-Gebühr | Abrechnungseinheit | Modelle |
|---|---|---|---|
| Bedrock Managed Agents | $0 in der Preview, plus deine Rechenleistung | n/a | OpenAI auf Bedrock |
| Claude Managed Agents | $0.08 pro Session-Stunde | Zeit im Status running | Nur Claude |
| OpenAI Agents API | $0.03 bis $1.92 pro 20-Minuten-Container | Pro Minute, 5 Minuten Minimum | Nur OpenAI |
| Gemini Managed Agents | Rechenleistung in der Preview nicht berechnet | n/a | Nur Gemini |
| AgentCore-Harness | Keine Harness-Gebühr, plus AgentCore Runtime | CPU und Arbeitsspeicher pro Sekunde | Jedes Bedrock-, OpenAI-, Gemini- oder LiteLLM-kompatible Modell |
Aktuell sind zwei davon auf der Runtime-Ebene kostenlos, und beide sind Previews. Das ist das Muster, das man bemerken sollte: Die Einführungspreise in dieser Kategorie sind großzügig, und keines der Labore hat gesagt, was seine Preview nach der General Availability kosten wird.
Der AgentCore-Harness ist die einzige AWS-native Option, die bereits generell verfügbar und modellunabhängig ist und keine separate Harness-Gebühr hat. Solange du nicht gezielt auf OpenAIs Harness festgelegt bist, bekommst du damit dieselbe Runtime-Abrechnung und mehr Modellauswahl. Claude Managed Agents fügt eine Runtime-Gebühr hinzu, liefert aber heute mehr Funktionen: Memory Stores, Multiagent und Sandboxes von Drittanbietern. Mein Beitrag zu den Anthropic-API-Preisen enthält die Token-Seite dieses Vergleichs, und die Übersicht der Alternativen zur OpenAI Agents API deckt das größere Feld ab.
Es gibt auch einen strategischen Aspekt, den ein LinkedIn-Beitrag besser formuliert hat, als ich es könnte:
"Near-zero switching costs between frontier models on the same bill sounds like a buyer's market. It is, for now. When you can swap Claude for GPT-5.5 with a one-line code change, models start looking interchangeable, and the platform hosting them all owns the customer relationship and the pricing power."

Das ist ein Grund, deinen Agent-Code portabel zu halten, kein Grund, BMA zu meiden.
Versteckte Kosten, die du einplanen solltest
Die Preislisten selbst sind klar genug. Teams stolpern über das, was auf keiner Preisliste steht:
- Die GA-Gebühr, die niemand angekündigt hat. AWS hat weder einen Preis noch ein Datum nach der Preview veröffentlicht. Als Platzhalter würden Claudes $0.08 pro Session-Stunde etwa $0.013 zur 10-Minuten-Aufgabe oben addieren. Behandle das als Budget-Szenario, nicht als Prognose.
- Kontextwachstum über die Turns. Jeder Turn sendet das bisherige Gespräch erneut, daher kann eine Aufgabe mit 20 Turns weit mehr kosten als 20 Kopien des ersten Turns. Caching hilft bei den Modellen, die es unterstützen, und die 272K-Long-Context-Klippe tut bei den anderen weh.
- Was BMA noch nicht enthält. Die Preview hat kein eingebautes Langzeitgedächtnis, daher sagt AWS, du sollst "provision and authorize any application-specific datastore separately" (preview limitations). Wenn du AgentCore Memory ergänzt, kostet es $0.25 pro 1.000 neue Events plus $0.75 pro 1.000 gespeicherte Langzeit-Einträge im Monat (AgentCore pricing).
- Menschliche Prüfung. Für Aktionen mit externer Wirkung sagen dir die Sicherheits-Docs, dass du Autorisierung und jede Human-in-the-Loop-Prüfung selbst durchsetzen musst. Das ist Entwicklungszeit, kein AWS-Posten.
- Entwicklungszeit, Punkt. Sie ist der größte Posten von allen, und sie taucht nie auf der AWS-Rechnung auf.
Zu diesem letzten Punkt lohnt es sich, die Kritiker von AgentCore selbst zu hören:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Nach den Zahlen oben würde ich widersprechen, dass die Runtime teuer ist. Die zweite Hälfte dieses Kommentars ist aber die wahre Kostenfrage jeder verwalteten Runtime: Das Produkt zu bauen bleibt an dir hängen.
Lohnt sich Bedrock Managed Agents für einen Support-Agenten?
Hier sehe ich die Rechnung am häufigsten schiefgehen. Jemand kalkuliert einen Support-Agenten auf BMA, sieht etwa neun Cent pro Gespräch und beschließt, es werde spottbillig. Die Token-Rechnung stimmt ja auch. Sie lässt aber die Helpdesk-Anbindung, das Retrieval über deine Wissensdatenbank, Eskalationsregeln, Tests an echten Tickets und den Bereitschafts-Entwickler aus, der es wartet.
Ich habe bei eesel über Jahre erlebt, wie das in beide Richtungen ausgeht. Ein abgewanderter Mid-Market-Kunde, der nach einer defekten Integration und langsamem Support ging, sagte dem eesel-Team "long term we will just build our own, which is so possible now with AI." Und in die andere Richtung: Ein Engineering Lead bei einem Hardware-Unternehmen mit einer Wissensdatenbank von über 300 Artikeln erklärte, warum man sich fürs Kaufen entschieden hat:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Beides sind vernünftige Entscheidungen. Wenn du Entwickler hast, die einen KI-Agenten selbst besitzen wollen, und du OpenAI-Modelle innerhalb von AWS brauchst, werden dich die Preise von BMA nicht aufhalten. Wenn du BMA mit dem Einkauf eines fertigen Agenten vergleichst, vergleiche die vollen Kosten von Selbstbau vs. Kauf statt nur die Token-Rechnung. Mein Leitfaden zum Bauen von Support-Agenten listet jedes Teil auf, zu dem du dich verpflichten würdest.
eesel: der Support-Agent mit festem Preis
Wenn du in Wirklichkeit einen KI-Helpdesk-Teammitglied kalkulierst, nimmt eesel den Token-Zähler aus dem Budget. Es verbindet sich mit Zendesk, Freshdesk, Gorgias und dem Rest deines Helpdesks und lernt aus deinen vergangenen Tickets und deinem Help Center. Bevor es einem echten Kunden antwortet, wird es in einer Simulation an Hunderten deiner historischen Tickets getestet.
Die Preise folgen einem Credit-Plan statt einer Token-Rechnung: ein kostenloser Plan mit 100 Credits, dann bezahlte Pläne ab $299 im Monat für 500 Credits, wobei ein bearbeitetes Ticket oder ein Chat einen Credit kostet, mit allen Funktionen und unbegrenzten Seats. Die Finanzabteilung kann diese Zahl in eine Tabelle eintragen, ohne Kontextwachstum zu raten, und im Kundensupport sah Gridwise im ersten Monat 73 % seiner Tier-1-Anfragen gelöst.
Und wenn du BMA im Blick hattest, weil du Agenten über ein Terminal oder ein Skript steuern willst, tut die eesel CLI das für dasselbe Teammate, das du im Dashboard siehst. Du kannst Integrationen verbinden, seine Anweisungen bearbeiten, ausstehende Aktionen genehmigen oder ablehnen und seine Aktivität lesen, mit JSON-Ausgabe und --dry-run bei Schreibvorgängen. Auch Coding-Agenten wie Claude Code, Codex und Cursor können sie bedienen, was ich in meinem Beitrag zur AI-Agent-CLI behandelt habe.
Probiere eesel kostenlos aus und sieh, was ein Support-Agent kostet, wenn die Verkabelung schon erledigt ist.
Häufig gestellte Fragen
Was kostet Bedrock Managed Agents?
Ist Bedrock Managed Agents während der Preview kostenlos?
Warum kosten Bedrock Managed Agents mehr als die API von OpenAI?
Was ist der günstigste Weg, Bedrock Managed Agents zu betreiben?
Wie schneiden die Preise von Bedrock Managed Agents im Vergleich zu Claude Managed Agents ab?
Ändern sich die Preise von Bedrock Managed Agents bei General Availability?
Sollte ich einen Support-Agenten auf Bedrock Managed Agents bauen, um Geld zu sparen?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.