Was ist Amazon Bedrock Managed Agents?
Amazon Bedrock Managed Agents, powered by OpenAI, ist eine verwaltete Laufzeitumgebung für zustandsbehaftete KI-Agenten auf AWS. Du erstellst eine Session mit Modell, Anweisungen, Tools und einer Ausführungsumgebung, schickst ihr Nachrichten, und der Service führt die Agent-Schleife und die Modellaufrufe aus. In AWS' Worten ist er "built on a customized version of OpenAI's Agents API engineered to be AWS-native" (AWS What's New), und die Produktseite sagt, er "combines OpenAI models with the Codex harness and Amazon Bedrock AgentCore" (AWS).
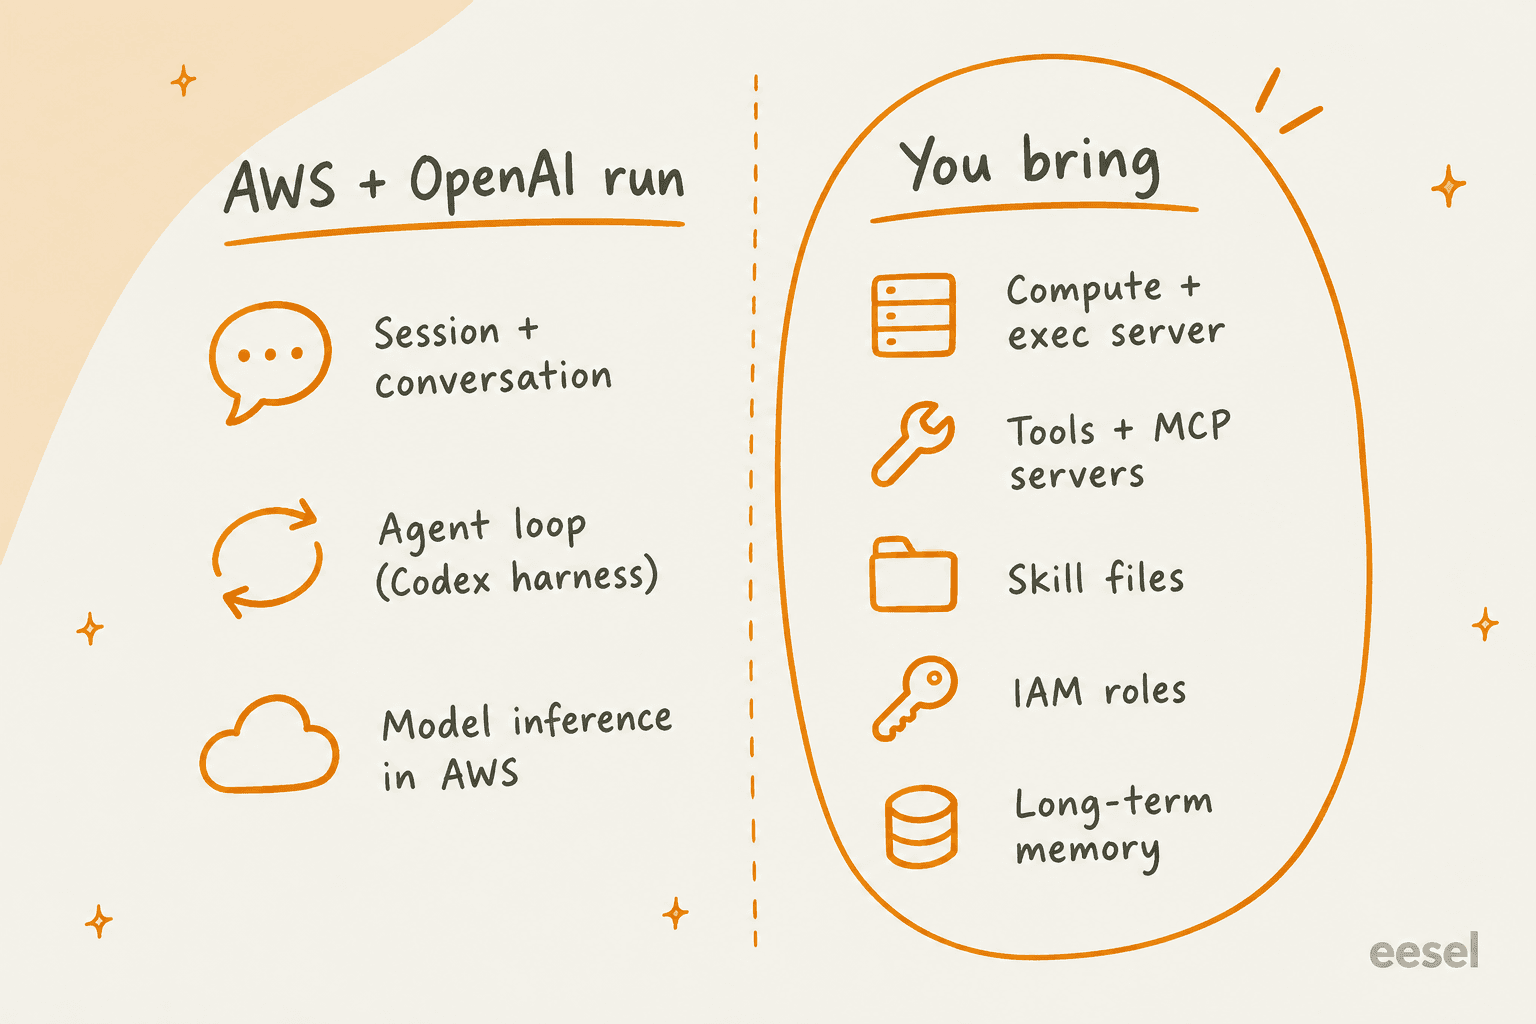
Ich baue eesels Integrationen und APIs, also habe ich genau diese Art Schleife schon mehrfach von Hand verdrahtet. Und das Erste, was man wissen muss, versteckt die Marketingseite ein wenig: "Managed" deckt hier die Konversation und die Reasoning-Schleife ab, nicht die Maschine, auf der dein Agent arbeitet. Diese Maschine betreibst du selbst.
Bis hierher hat es eine Weile gedauert, hier die Zeitleiste, alles aus Primärquellen:
| Datum | Was passierte | Quelle |
|---|---|---|
| 27. Feb. 2026 | Amazon und OpenAI kündigen eine Partnerschaft an, darunter eine "Stateful Runtime Environment" auf Bedrock | Amazon |
| 28. Apr. 2026 | BMA in eingeschränkter Preview angekündigt, zusammen mit OpenAI-Modellen und Codex auf Bedrock | OpenAI |
| 1. Jun. 2026 | OpenAI-Modelle und Codex auf Bedrock werden GA; BMA noch "coming soon" | AWS ML blog |
| 29. Sep. 2026 | BMA startet als öffentliche Preview in 3 US-Regionen | AWS What's New |
Die genannten Launch-Kunden sind Box und Salesforce. In Amazons Launch-Beitrag sagt Box-CTO Ben Kus, es bringe OpenAIs Modelle zusammen "with the scale, security, and infrastructure of AWS", und Salesforce kombiniert es mit seinem Produkt Headless 360 auf der AWS-Produktseite.
Wenn du meinen Leitfaden zur OpenAI Agents API gelesen hast, wird dir die Form vertraut vorkommen: dieselbe Harness-Linie wie OpenAI Codex (dessen Preise separat sind), dieselben Objekte für Agent, Session und Events. Der Unterschied liegt vor allem darin, wer die Schleife hostet und wer die Anfragen signiert.
Wie Bedrock Managed Agents funktioniert
AWS' Doku teilt den Service in sechs Teile auf (AWS docs):
- Session: eine zustandsbehaftete Konversation mit einem Agenten. Sie nennt ein Modell, Anweisungen, Tools, eine IAM-Rolle und eine Ausführungsumgebung.
- Turn: die Arbeit als Antwort auf eine Nachricht: Reasoning, Tool-Aufrufe und Ausgabe.
- Ausführungsumgebung: Compute, das du bereitstellst und in dem Befehle und lokale Tools tatsächlich laufen.
- Exec-Server: der Prozess
codex exec-server, der deine Umgebung über eine ausgehende Verbindung mit BMA verbindet. - Items und Events: Items sind die dauerhafte Aufzeichnung dessen, was passiert ist; Events sind ein Live-Stream des Fortschritts.
- Session-Rolle: die IAM-Rolle, die BMA übernimmt, um das Modell aufzurufen (und, falls du sie nutzt, um AgentCore Runtime zu starten).
AWS hat ein eigenes Diagramm, wie diese Teile miteinander kommunizieren:
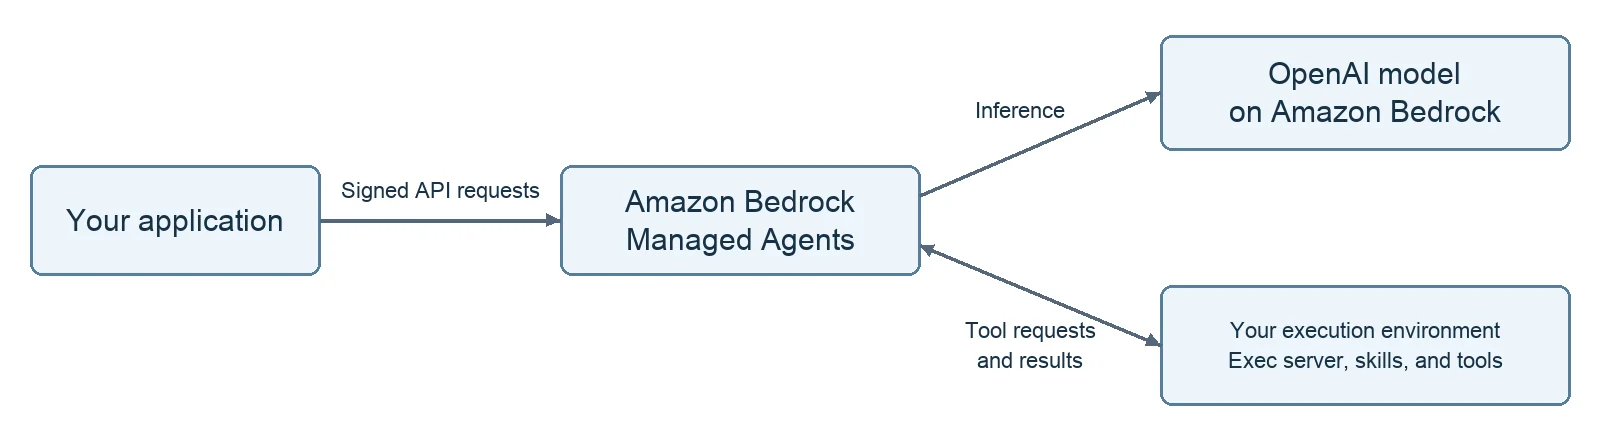
Überrascht hat mich die Box unten rechts. Bei Claude Managed Agents oder OpenAIs gehosteter Agents API kannst du den Anbieter eine Sandbox für dich betreiben lassen. Bei BMA gibt es überhaupt keine Anbieter-Sandbox. Tools "execute in the compute environment that you provide" (AWS docs), also liegen Exec-Server, Workspace, Netzwerkregeln und alle MCP-Server bei dir.
Das ist also der Tausch, den ich in jedem Vergleich der besten KI-Agenten wieder sehe. Du verzichtest auf Bequemlichkeit und bekommst eine saubere Sicherheitsgeschichte: Modellinferenz, Agent-Laufzeit und deine Tools bleiben alle innerhalb von AWS, und die AWS-Produktseite sagt genau das: "The agent runtime and model inference remain inside AWS" (AWS).
Die API ist klein
Die REST-Oberfläche der Preview besteht aus sieben Operationen am regionalen Endpunkt bedrock-mantle, alle mit AWS SigV4 signiert statt mit einem OpenAI-API-Schlüssel (API reference): eine Session erstellen, auflisten, abrufen und löschen, Events senden, Events streamen und Items auflisten. Du schickst eine Nachricht, indem du ein agent.session.input.message-Event postest, und liest die Ergebnisse dann vom Items-Endpunkt, 1 bis 100 pro Seite (sessions guide).
Zwei Details in der Doku ersparen dir einen Nachmittag:
- Ein erfolgreiches Senden liefert einen leeren Body. Das bedeutet "angenommen", nicht "fertig". Der Abschluss zeigt sich in Session-Status, Items und Events.
- Eine
idle-Session ist kein Beweis, dass die Aufgabe geklappt hat. AWS sagt, du sollst die Ausgabe-Items und bei Befehlen den Exit-Code prüfen. Das Abbrechen eines Turns "does not undo side effects from tools that already completed."
Skills und Tools
Ein Skill ist ein Ordner mit einer SKILL.md-Datei, abgelegt unter einem der Capability-Verzeichnisse der Session (bis zu 32 Pfade). Tools kommen von STDIO-MCP-Servern, die in deiner Umgebung laufen (mein Leitfaden zum KI-Agent-MCP-Server erklärt das Muster), und du kannst jeden Server mit einer allowed_tools-Liste einschränken (skills and tools). Wenn du Skills in Claude Code genutzt hast, ist das Format so nah dran, dass du dich zu Hause fühlst.
AWS ist bei der Sicherheit offen: "Treat instructions from documents, websites, and tool responses as untrusted input" (security docs). Das ist ein Rat zu Prompt Injection, und er wirkt etwas anders, sobald der Agent eine echte Shell auf einem echten Host hat.
Wo dein Agent wirklich läuft: selbst gehostet oder AgentCore
Du hast zwei Ausführungsumgebungen, und die Wahl bestimmt den Großteil deines Setup-Aufwands und einen Teil deiner Rechnung (AWS docs):
| Selbst gehostetes Compute | AgentCore Runtime | |
|---|---|---|
| Was du bereitstellst | Einen Host, einen Workspace, Netzwerkzugang und einen laufenden codex exec-server | Eine AgentCore Runtime mit dem Exec-Server und seinem Adapter, eingebaut in einen ARM64-Container |
| Was AWS' Beispiel-Stack erstellt | Nur IAM-Rollen (keinen Host) | Runtime, VPC mit privaten Subnetzen, 1 NAT-Gateway, versionierte S3-Buckets für Skills und Ausgaben, S3-Files-Mounts |
| Wer den Exec-Server startet | Du, in einem zweiten Terminal | BMA aktiviert die Runtime für dich |
| Beispiel-Zeitlimits | Du entscheidest | 28.800 Sekunden (8 Stunden) Leerlauf und maximale Lebensdauer |
| Gut für | Entwicklungsrechner, bestehende Container, schnelle Tests | Verwaltetes Compute pro Session, das in deinem Konto bleibt |
AgentCore ist AWS' breitere Agent-Plattform und das Standard-Compute für BMA. AWS' Argument ist, dass du dich mit wachsenden Agenten auf mehr davon stützen kannst: Autorisierung, Agent- und Tool-Erkennung, Observability und Evaluierung (AWS).
Wenn du nur sehen willst, dass etwas funktioniert, ist der selbst gehostete Weg am schnellsten. Der AgentCore-Weg ist der, den du tatsächlich ausliefern würdest, und dort beginnen sich auch die Kosten zu stapeln, die nicht in der Zeile "no additional charge" auftauchen.
Was die Preview enthält und was sie auslässt
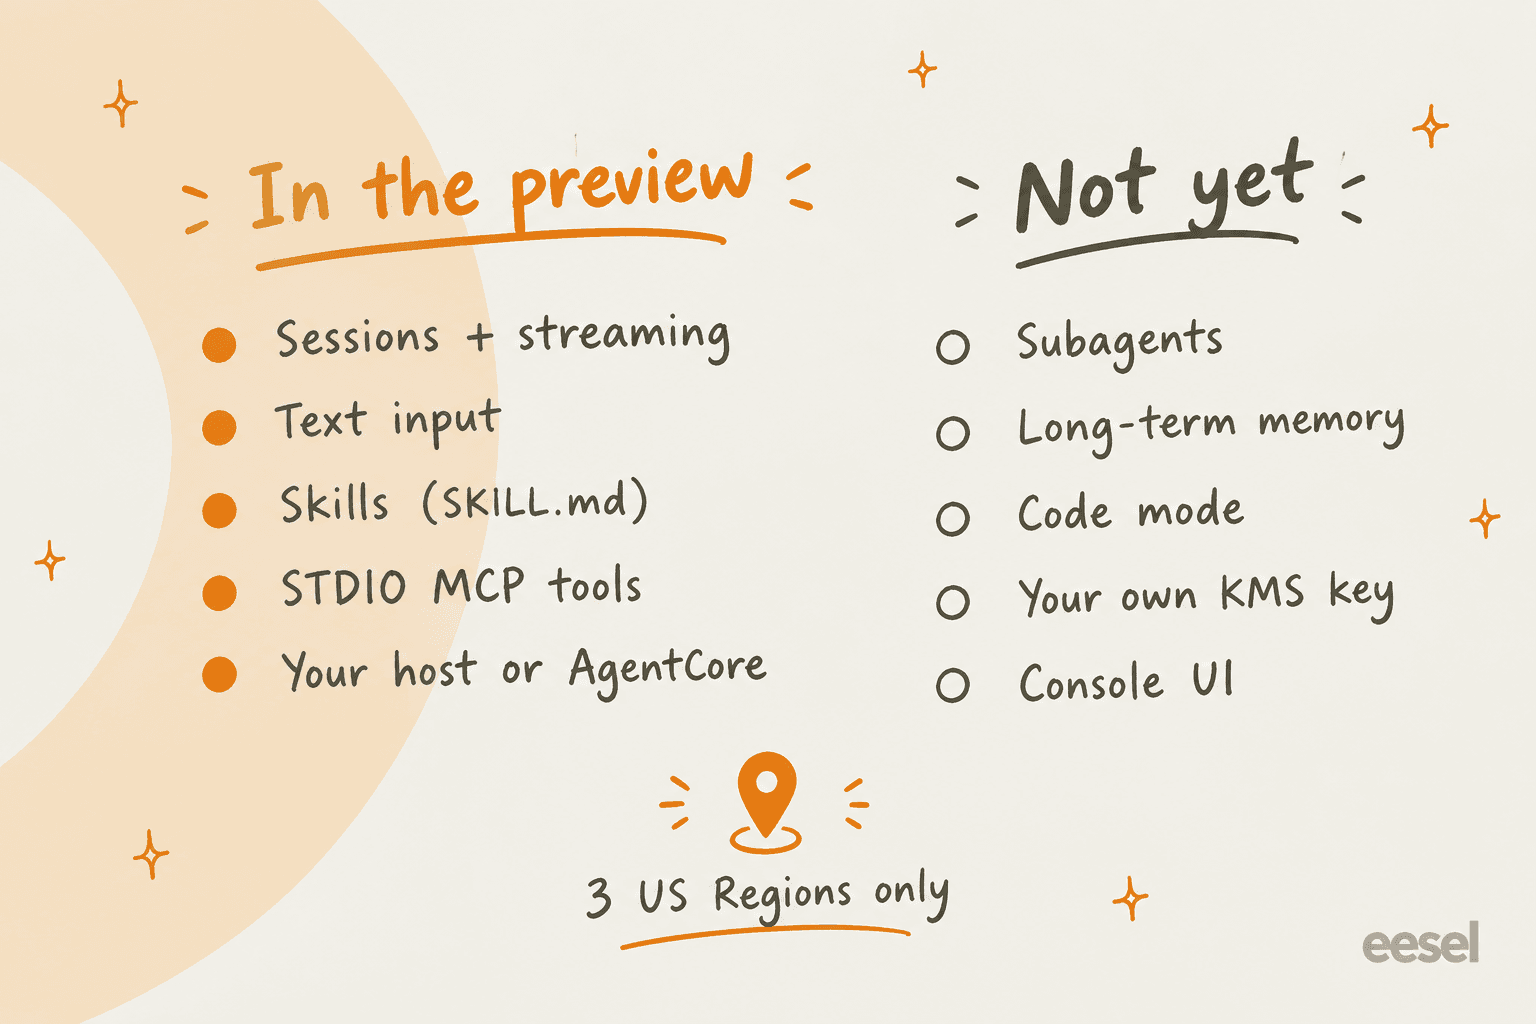
Wenn du vor einer Entscheidung nur einen Abschnitt zweimal lesen willst, dann diesen. AWS' Seite zu den Preview-Einschränkungen ist bei den Grenzen ungewöhnlich klar:
- Eingabe nur als Text. Die dokumentierte Session-Eingabe ist Text.
- Keine Subagenten, kein Code Mode. AWS sagt, du sollst sie in einer Session-Konfiguration gar nicht aktivieren, also sind Muster der Subagenten-Orchestrierung vorerst vom Tisch.
- Kein Langzeitgedächtnis. "The preview does not provide a built-in long-term memory integration; provision and authorize any application-specific datastore separately."
- Keine regionsübergreifende Inferenz. Das spielt für den Preis eine Rolle, wie du unten siehst.
- Kein vom Kunden verwalteter KMS-Schlüssel für servicegeführte Session-Daten.
- Keine Konsole. Alles läuft über die API und AWS' Beispiel-Bundle.
- Keine eigene Turn-List-API. Turns korrelierst du über die
turn_id-Werte der Items.
Hier gibt es eine Lücke, die man leicht übersieht. Das Launch-Marketing sagt, die verwaltete Laufzeit "handles inference, memory, and skills" (AWS) und jeder Agent "supports human approval before consequential actions", laut derselben Preview-Ankündigung. In beiden Punkten sagt die Entwicklerdoku etwas Engeres. Gedächtnis bedeutet Kontext innerhalb einer Session, und für Aktionen mit externen Auswirkungen sagt der Sicherheitsleitfaden, du sollst "enforce authorization and any required human review in the application or tool implementation" (security docs). Das Human-in-the-Loop-Gate baust du also selbst, es lässt sich nicht einfach einschalten.
Für eine Preview ist nichts davon ungewöhnlich. Es bedeutet aber, dass die heute nutzbare Version eher "eine verwaltete Schleife plus ein gutes Beispiel-Repo" ist als eine fertige Agent-Plattform. OpenAIs eigene BMA-Seite fügt eine Warnung hinzu, die man wörtlich nehmen sollte: "Shared concepts don't imply identical API contracts or feature availability." Kopiere keine OpenAI-Agents-API-Anfrage und erwarte, dass sie auf Bedrock funktioniert.
Was Bedrock Managed Agents kostet
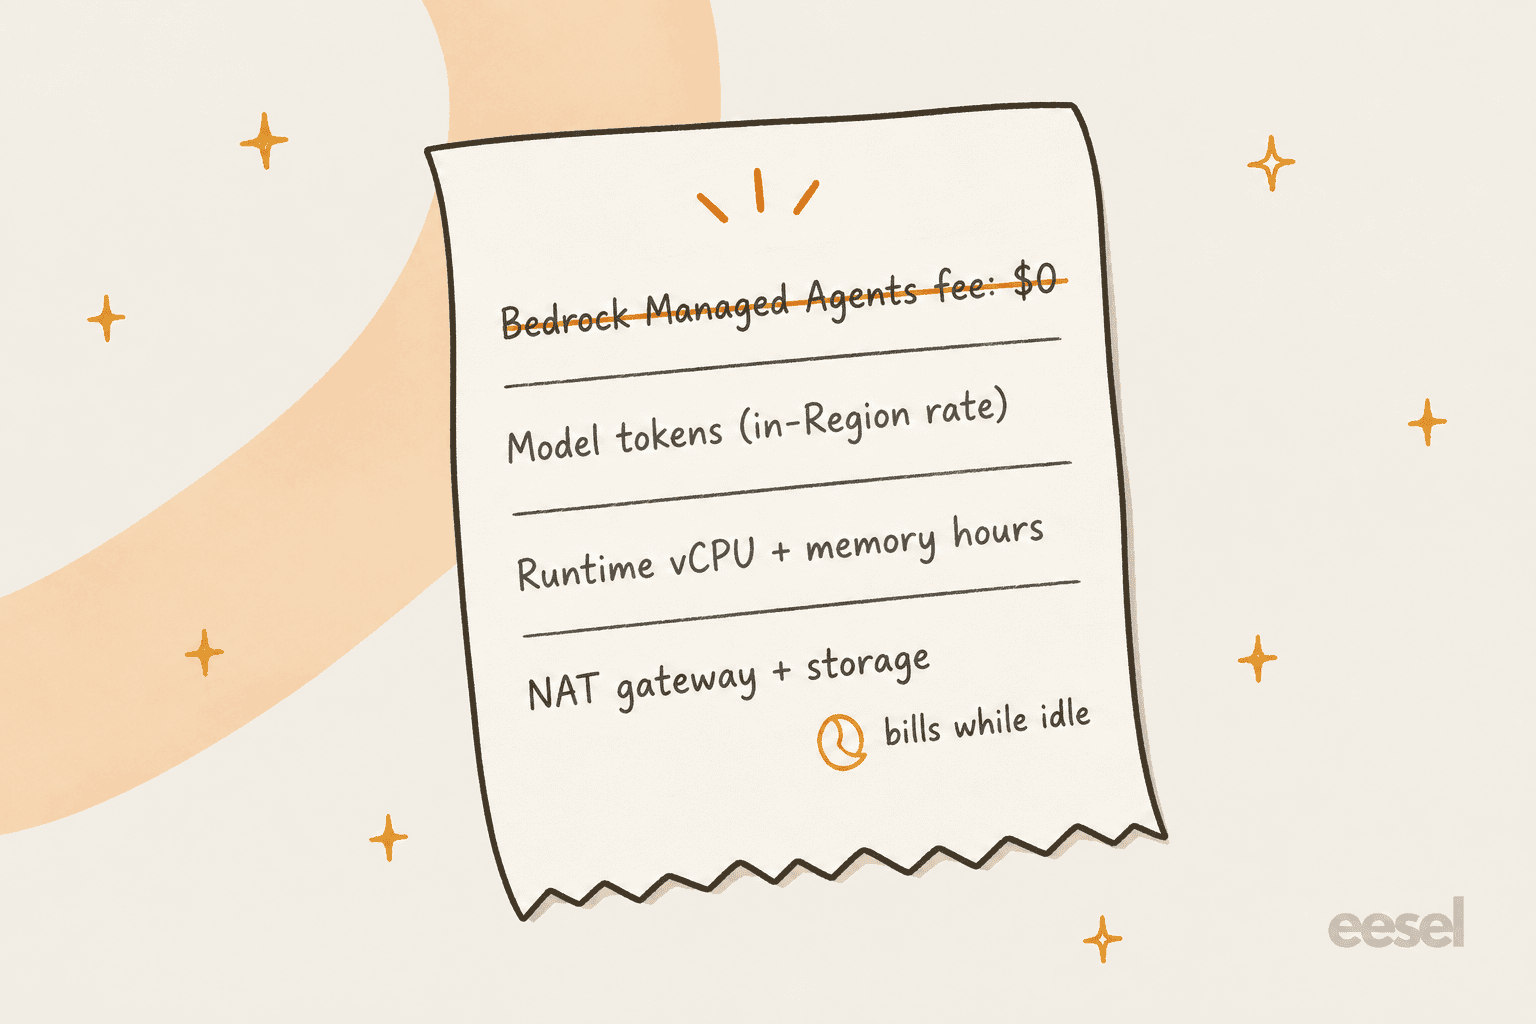
AWS' Preiszeile ist kurz: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New). Die Doku legt dar, was "underlying resources" heißt: Modellinferenz plus alle AWS-Ressourcen, die deine App nutzt, und das AgentCore-Beispiel "can continue to incur charges when no BMA turn is running" (AWS docs).
Zeile 1: Modell-Tokens zum In-Region-Preis
Jedes OpenAI-Modell auf Bedrock hat seinen Preis auf der Modellkarte. Der Haken: BMAs Preview unterstützt keine regionsübergreifenden Inferenzprofile, du zahlst also den In-Region-Preis, und AWS vermerkt, dass "Commercial In-Region prices include a 10% fee over OpenAI rates" (GPT-5.6 Luna card). Hier die Preise für kurzen Kontext (272K Eingabe-Tokens oder weniger) pro Million Tokens:
| Modell | Eingabe (In-Region) | Eingabe aus Cache | Ausgabe (In-Region) | Globaler Preis, wie bei OpenAI (Ein / Aus) |
|---|---|---|---|---|
| GPT-5.6 Luna (BMA-Beispiel-Standard) | $0.22 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6 Luna | $0.11 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-6.1 Sol | $2.20 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $1.10 | $55.00 | $10.00 / $50.00 |
Jeder Preis stammt von der Bedrock-Karte des jeweiligen Modells, alle verlinkt von AWS' OpenAI-Modelle-Seite. AWS veröffentlicht keine feste Liste der von BMA unterstützten Modelle, und die GPT-6.1-Sol-Karte vermerkt, dass explizites Prompt Caching für dieses Modell auf Bedrock nicht unterstützt wird. Prüfe also dein Modell, bevor du mit Cache-Rabatten rechnest. Anfragen mit langem Kontext (über 272K Eingabe, ein Bruchteil des Kontextfensters von über 1M) kosten nochmal mehr. GPT-5.6 Sol springt auf $8.80 Eingabe und $33.00 Ausgabe.
Zeile 2: Runtime-Stunden
Wenn du AgentCore Runtime nutzt, zahlst du dessen Compute-Preise. Auf v2-MicroVMs sind das $0.1276 pro vCPU-Stunde und $0.0169 pro GB-Stunde, sekundengenau abgerechnet, und AWS sagt, CPU wird nicht berechnet, während der Agent auf I/O wartet, etwa auf die Antwort des Modells (AgentCore pricing). Bei Selbst-Hosting zahlst du einfach, was dein Host ohnehin kostet.
Zeile 3: das NAT-Gateway, das niemand erwähnt
AWS' AgentCore-Beispiel-Stack erstellt ein NAT-Gateway. Zum veröffentlichten US-Ost-Preis sind das $0.045 pro Stunde plus $0.045 pro verarbeitetem GB, und angebrochene Stunden werden als volle Stunden berechnet (Amazon VPC pricing). Einen Monat lang (730 Stunden) laufen gelassen, sind das etwa 33 $ im Monat, bevor dein Agent irgendetwas tut. Für ein Unternehmen ist das wenig Geld. Trotzdem ist es genau die Zeile, die drei Monate später auf einem Dev-Konto auftaucht, weil jemand die Cleanup-Schritte vergessen hat.
Ein durchgerechnetes Beispiel
Angenommen, eine Agent-Aufgabe liest eine Codebasis und einige Dokumente: 200.000 Eingabe-Tokens, 20.000 Ausgabe-Tokens, etwa 10 Minuten auf einer AgentCore-Session mit 2 vCPU / 4 GB.
- Mit GPT-5.6 Luna: $0.044 Eingabe + $0.026 Ausgabe = etwa $0.07 an Tokens.
- Mit GPT-5.6 Sol: $0.88 Eingabe + $0.44 Ausgabe = etwa $1.32 an Tokens.
- Runtime-Obergrenze: 2 vCPU x $0.1276 + 4 GB x $0.0169 = $0.32 pro Stunde, wenn die CPU die ganze Zeit ausgelastet wäre, also grob $0.05 für 10 Minuten, in der Praxis weniger, weil das Warten auf das Modell nicht als CPU berechnet wird.
Das Fazit: Die Modellwahl verschiebt die Rechnung etwa um das 19-Fache; die Runtime kaum. Bei geringem Volumen fallen dir die Fixkosten (NAT-Gateway, Speicher) auf, bei hohem Volumen die Tokens. Wenn du dieselbe Rechnung für OpenAIs gehostete Version willst, behandelt mein Beitrag zu den Agents-API-Preisen die Container-Preise pro 20 Minuten, und mein AWS-Preise-Leitfaden den Rest der AWS-Rechnung.
Wie es im Vergleich zu anderen verwalteten Agent-Laufzeiten abschneidet
Jedes große Labor verkauft inzwischen irgendeine Version von "wir betreiben die Agent-Schleife für dich". Wirklich unterscheiden sie sich darin, wo zwei Dinge liegen: die Schleife und die Tools.
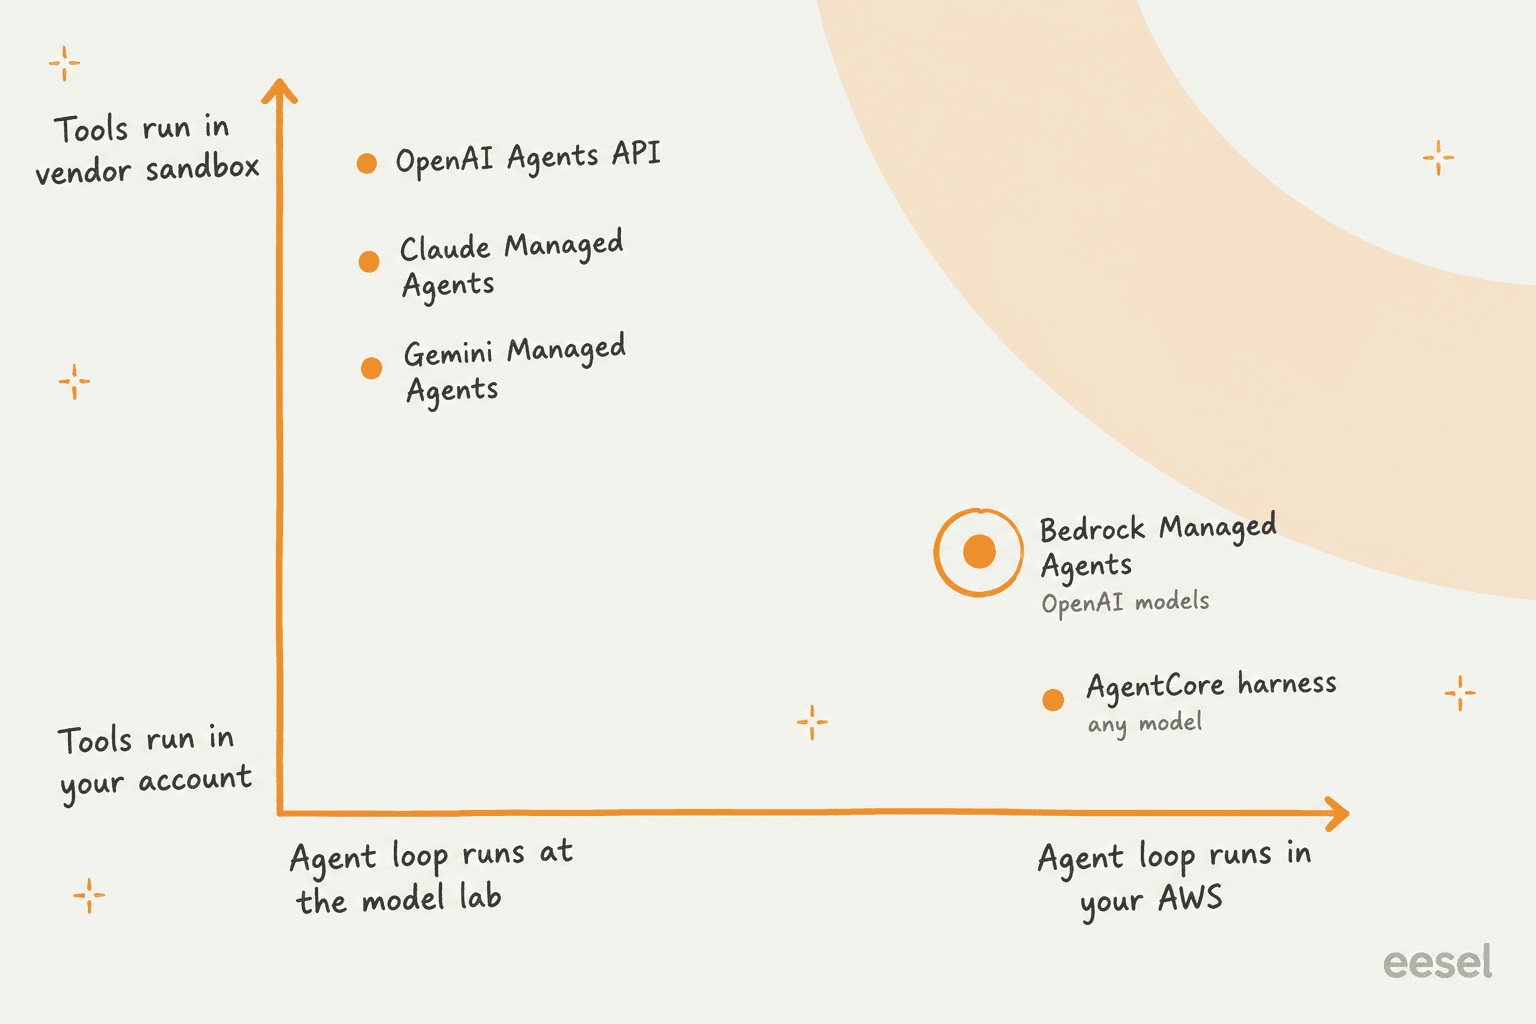
Claude Managed Agents und OpenAIs Agents API bieten auch selbst gehostete Sandboxes, das Cluster oben links ist also ihr Standard und nicht ihr einziger Modus. Selbst dann bleibt die Orchestrierung beim Labor: Bei Anthropics Version fließen Tool-Ein- und Ausgaben weiterhin zu Anthropics Control Plane, und bei OpenAI verschiebt die Wahl einer selbst gehosteten Sandbox nur die Tool-Ausführung. BMA ist hier die einzige Option, die OpenAIs Harness, OpenAIs Modelle und deine Tools alle innerhalb von AWS hält.
| Bedrock Managed Agents | Claude Managed Agents | OpenAI Agents API | Gemini Managed Agents | AgentCore-Harness | |
|---|---|---|---|---|---|
| Status | Öffentliche Preview, 3 US-Regionen | Beta | Öffentliche Beta (10. Sep. 2026) | Öffentliche Preview (19. Mai 2026) | Allgemein verfügbar |
| Modelle | OpenAI auf Bedrock | Nur Claude | Nur OpenAI | Nur Gemini | Bedrock, OpenAI, Gemini, jeder LiteLLM-Anbieter |
| Wo Tools laufen | Nur dein Host oder AgentCore | Anthropic-Sandbox oder deine | OpenAI-Sandbox, deine, Partner-Anbieter oder keine | Google-Sandbox (4 CPU / 16 GB) | MicroVM pro Session in deinem Konto |
| Runtime-Gebühr | Keine während der Preview | $0.08 pro Session-Stunde, solange sie läuft | $0.03 bis $1.92 pro 20-Min-Container; keine bei Selbst-Hosting | Compute nicht berechnet in der Preview | $0.1276 pro vCPU-Stunde + $0.0169 pro GB-Stunde |
| Langzeitgedächtnis | Nein (Preview) | Memory Stores | Nicht veröffentlicht | Nein (Dateien 7 Tage aufbewahrt) | AgentCore Memory |
| MCP | STDIO in deiner Umgebung | Remote-Server + Tunnel | Remote oder lokal | Remote-HTTP | Über AgentCore Gateway |
| Subagenten | Nein | Ja (Multiagent) | Ja | Nicht veröffentlicht | Nicht veröffentlicht |
Ein paar Dinge in dieser Tabelle verdienen einen zweiten Blick.
Das AgentCore-Harness ist BMAs engster Konkurrent, und es kommt ebenfalls von AWS. Es ist GA, unterstützt "any model provided by Amazon Bedrock, OpenAI, Google Gemini, or any LiteLLM-compatible provider", und es gibt keine separate Harness-Gebühr (AgentCore harness). AWS hat außerdem die ursprünglichen Bedrock Agents in den Wartungsmodus versetzt: Sie wurden in Bedrock Agents Classic umbenannt und am 30. Juli 2026 für Neukunden geschlossen, und AWS verweist neue Projekte auf das Harness (AWS docs). Wenn du dich also nicht ausdrücklich auf OpenAIs Harness festgelegt hast, würde ich dort anfangen.
Claude Managed Agents ist heute das vollständigere Produkt. Es hat Memory Stores, Multiagent-Orchestrierung, Anbieter-Sandboxes und Remote-MCP und ist außerdem über Anthropics Claude Platform auf AWS erreichbar. Auf diesem Weg verarbeitet aber Anthropic und nicht AWS die Daten. Wenn deine Anforderung lautet "AWS ist der einzige Auftragsverarbeiter", ist BMA (oder Claude in Amazon Bedrock, das ich in Claude Code auf Bedrock behandelt habe) die sauberere Antwort. Eine breitere Liste findest du in meiner Übersicht der OpenAI-Agents-API-Alternativen.
So legst du mit Bedrock Managed Agents los
Der schnellste Weg ist AWS' selbst gehostetes Beispiel. Wenn dein AWS CLI schon eingerichtet ist, plane eine Stunde ein. AWS' Tutorial zum Selbst-Hosting enthält die vollständigen Befehle:
- Tools installieren. Node.js 20+, AWS CLI v2,
curlmit SigV4-Unterstützung,jqund Codex CLI 0.154.0 oder neuer (enthältcodex exec-server). - Region und Endpunkt wählen.
us-east-1,us-west-2oderus-east-2, mit dem Endpunkthttps://bedrock-mantle.<region>.api.aws. - Das Beispiel-Bundle herunterladen und die Codex-Binärdatei, die zu deinem Host passt (für AgentCore immer Linux ARM64).
- Die IAM-Rollen deployen mit
npm ci,npx cdk bootstrapundnpm run deployaus dem Ordnerself-hosted/. Du bekommst eine Client-Rolle und eine Session-Rolle, die BMA übernimmt. - Eine Session erstellen, den Exec-Server anbinden, einen Turn senden. Die nummerierten Skripte des Bundles (
0.create-session.sh,1.attach-exec-server.sh,2.submit-turn.sh,3.read-result.sh) führen dich durch.
Die meisten ersten Läufe scheitern am IAM-Modell. Es gibt drei Identitäten: den Aufrufer (braucht BMA-Berechtigungen plus iam:PassRole auf die Session-Rolle), die Session-Rolle (der bedrock-mantle.amazonaws.com vertraut und der bedrock-mantle:CreateInference für dein Modell erlaubt ist) und die Identität, die deine Ausführungsumgebung nutzt (security docs). Die Seite zur Fehlerbehebung solltest du vor dem Start als Lesezeichen setzen, besonders den Teil, in jedem Terminal AWS_PROFILE zu prüfen. Nutze außerdem einen eigenen Workspace, denn "the agent can use the files, tools, and permissions available to that environment."
Was Entwickler sagen
Die öffentliche Preview ist erst diese Woche gestartet, Praxis-Feedback ist also noch dünn. Vorhanden sind Launch-Reaktionen von Leuten, die in AWS leben, und sie sind sich beim Reiz weitgehend einig:
"Bedrock Managed Agents (limited preview): AWS runs OpenAI's agent harness, and all inferences run through Bedrock. Basically, you'd use the OpenAI SDK against AWS-owned infrastructure, and your data stays in AWS.
AgentCore Runtime is the only one that's GA right now, so it's the only viable option if you need something for production."

Der Compliance-Aspekt kommt im Hacker-News-Thread zum ursprünglichen Launch immer wieder auf:
"This would be a nice compliance win. One less sub-processor and all our data is already on AWS so less worrying about sending it off somewhere else"

Auch die Skeptiker sind hörenswert. Analyst Mitch Ashley formulierte die Lock-in-Frage klar:
"The question for enterprise architects is whether AgentCore stays open enough to govern non-AWS execution, or quietly becomes the lock-in seam."
Und ein Hacker-News-Kommentator hielt sich beim Compute-Layer, den BMA standardmäßig nutzt, nicht zurück:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Dieser letzte Satz, "on top of building our actual product", ist die ganze Geschichte verwalteter Agent-Laufzeiten. Sie verkleinern den Infrastrukturjob, aber der Produktjob bleibt deiner.
Wer Bedrock Managed Agents nutzen sollte (und wer nicht)
Nutze es, wenn du schon tief in AWS steckst, dein Sicherheits- oder Einkaufsteam AWS freigegeben hat, aber keinen neuen KI-Anbieter, und du gezielt OpenAIs Harness und Modelle willst. Das IAM-pro-Agent-Modell, CloudTrail-Logging und die Geschichte "nichts verlässt das Konto" sind der eigentliche Wert, und mit OpenAI-Modellen bekommst du sie kaum anderswo.
Warte, wenn du Subagenten, Langzeitgedächtnis, Bildeingabe oder etwas außerhalb von drei US-Regionen brauchst. Das ist nicht in der Preview, und es gibt kein GA-Datum.
Lass es sein, wenn du nicht an OpenAI-Modelle gebunden bist (das AgentCore-Harness ist GA und modellunabhängig) oder wenn der Anbieter auch die Sandbox betreiben soll (Claude Managed Agents oder OpenAIs gehostete Agents API).
Und denk gründlich nach, wenn dein eigentliches Ziel ein Business-Agent ist, etwa einer, der Support-Tickets beantwortet. Ein Support-Agent ist ein Produkt, keine Laufzeitumgebung. Dieses Muster begegnet mir oft. In eesels eigenen Kündigungsnotizen sind mehrere Kunden, darunter eine AR-/Bautechnikfirma und eine DTC-Beauty-Marke, gegangen, um ihren Support-Agenten direkt auf einer LLM-API zu bauen. Andere gingen den umgekehrten Weg. Ein Engineering Lead bei einem Bitcoin-ATM-Hardwareunternehmen mit einer Confluence-Wissensbasis von über 300 Artikeln erklärte dem eesel-Team, warum sie sich fürs Kaufen entschieden haben:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
BMA macht den "Bauen"-Weg kürzer. Es nimmt dir weder die Helpdesk-Integration noch den Wissensabruf, die Eskalationslogik oder das Testing ab. Und genau diese Teile dauern Monate.
eesel für Teams, die den Agenten wollen, nicht die Rohrleitungen
Bedrock Managed Agents ist Infrastruktur. eesel ist der Mitarbeiter. Genauer ist eesel eine KI-Teammate-Plattform, auf der du einsatzbereite Teammates für klar definierte Aufgaben einstellst, und für den Support ist das der KI-Helpdesk-Teammate: Er schließt sich in Minuten an Zendesk, Freshdesk, Gorgias und den Rest deines Helpdesks an, lernt aus deinen früheren Tickets und deinem Help Center und wird in einer Simulation gegen Hunderte deiner historischen Tickets laufen gelassen, bevor er je einem echten Kunden antwortet. Laut eesels eigenen Kundenzahlen löste Gridwise im ersten Monat 73 % seiner Tier-1-Tickets.
Wenn du BMA vor allem deshalb angesehen hast, weil du Agenten gern vom Terminal aus steuerst, hat eesel das auch. Die eesel CLI (@eesel/cli) bedient denselben Teammate und Workspace, den du im Dashboard siehst: Integrationen verbinden, die Standardanweisungen des Agenten bearbeiten, ausstehende Aktionen mit eesel approvals genehmigen oder ablehnen und jeden Lauf mit eesel activity lesen. Jeder Befehl gibt JSON aus, schreibende Befehle unterstützen --dry-run, damit du den genauen Aufruf siehst, bevor er gesendet wird, und die Headless-Authentifizierung funktioniert in CI. Coding-Agenten wie Claude Code, Codex und Cursor können sie steuern, und jeder Workspace stellt außerdem einen MCP-Server bereit. Es ist dieselbe Idee wie BMAs API-first-Design, nur auf einen fertigen Support-Agenten gerichtet statt auf eine leere Schleife.
eesel testen kostenlos. Die Preise beginnen mit einem kostenlosen Plan mit 100 Credits, danach bezahlte Pläne ab $299 im Monat für 500, und ein bearbeitetes Ticket oder ein Chat ist ein Credit.
Häufig gestellte Fragen
Was ist Amazon Bedrock Managed Agents?
Was kostet Bedrock Managed Agents?
Ist Bedrock Managed Agents allgemein verfügbar?
Was ist der Unterschied zwischen Bedrock Managed Agents und der OpenAI Agents API?
Hat Bedrock Managed Agents ein Gedächtnis?
Welche Modelle unterstützt Bedrock Managed Agents?
Sollte ich Bedrock Managed Agents für den Kundensupport nutzen?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.