

GPT-6.1 Terra kostet 1 $ pro Million Eingabe-Tokens und 5 $ pro Million Ausgabe-Tokens, mit zwischengespeicherter Eingabe zu $0.05, laut OpenAIs Preisseite. Das ist pro Token die Hälfte von GPT-6.1 Sol und weniger als die Hälfte des alten GPT-5.6 Terra.
Der Listenpreis entscheidet aber nicht über Ihre Rechnung. Drei Dinge tun das: die Effort-Stufe ($0.05 pro Aufgabe bei low, $0.40 bei max, laut Artificial Analysis), die 272K-Regel für lange Kontexte, die den Preis der gesamten Anfrage verdoppelt, und Caching, das die Eingabe um 95 % senkt, aber das Schreiben des Caches mit dem 1,25-Fachen berechnet.
Meine Empfehlung: Terra mit low oder medium betreiben, Prompts unter 272K halten und Batch für alles nutzen, was warten kann. Im GPT-6.1-Terra-Test habe ich 80 Support-Ticket-Tests durchgeführt, und das Modell kostete weniger als einen Cent pro Ticket. Für ein Support-Team sind die Tokens der günstige Teil. smava lässt mit eesel rund 27.000 deutsche Tickets im Monat in Zendesk sortieren und beantworten, und entscheidend dafür waren 820 Makros und Artikel, nicht der Preis des Modells.
Was kostet GPT-6.1 Terra?
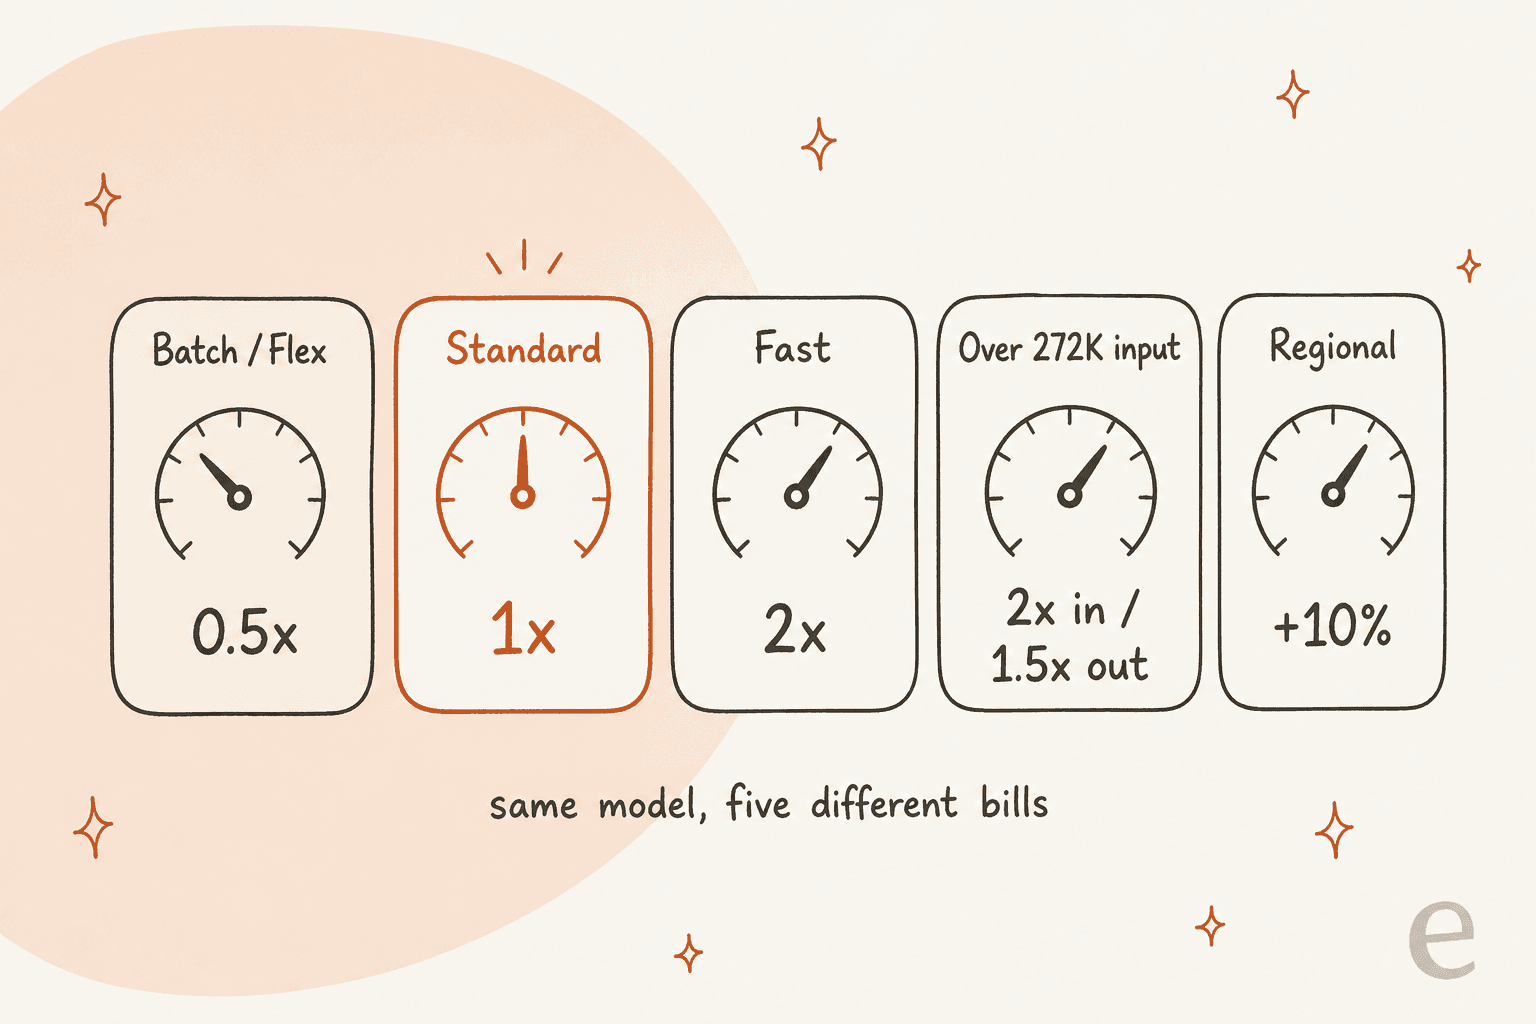
GPT-6.1 Terra kostet bei Standard-Geschwindigkeit $1.00 pro Million Eingabe-Tokens, $0.05 pro Million zwischengespeicherter Eingabe-Tokens und $5.00 pro Million Ausgabe-Tokens. Ich baue die API-Seite der eesel-Integrationen, deshalb lese ich Preisseiten wie API-Dokumentation: Ich suche nach den Multiplikatoren, die sich unter der Schlagzeilenzahl verstecken. Terra hat fünf davon.
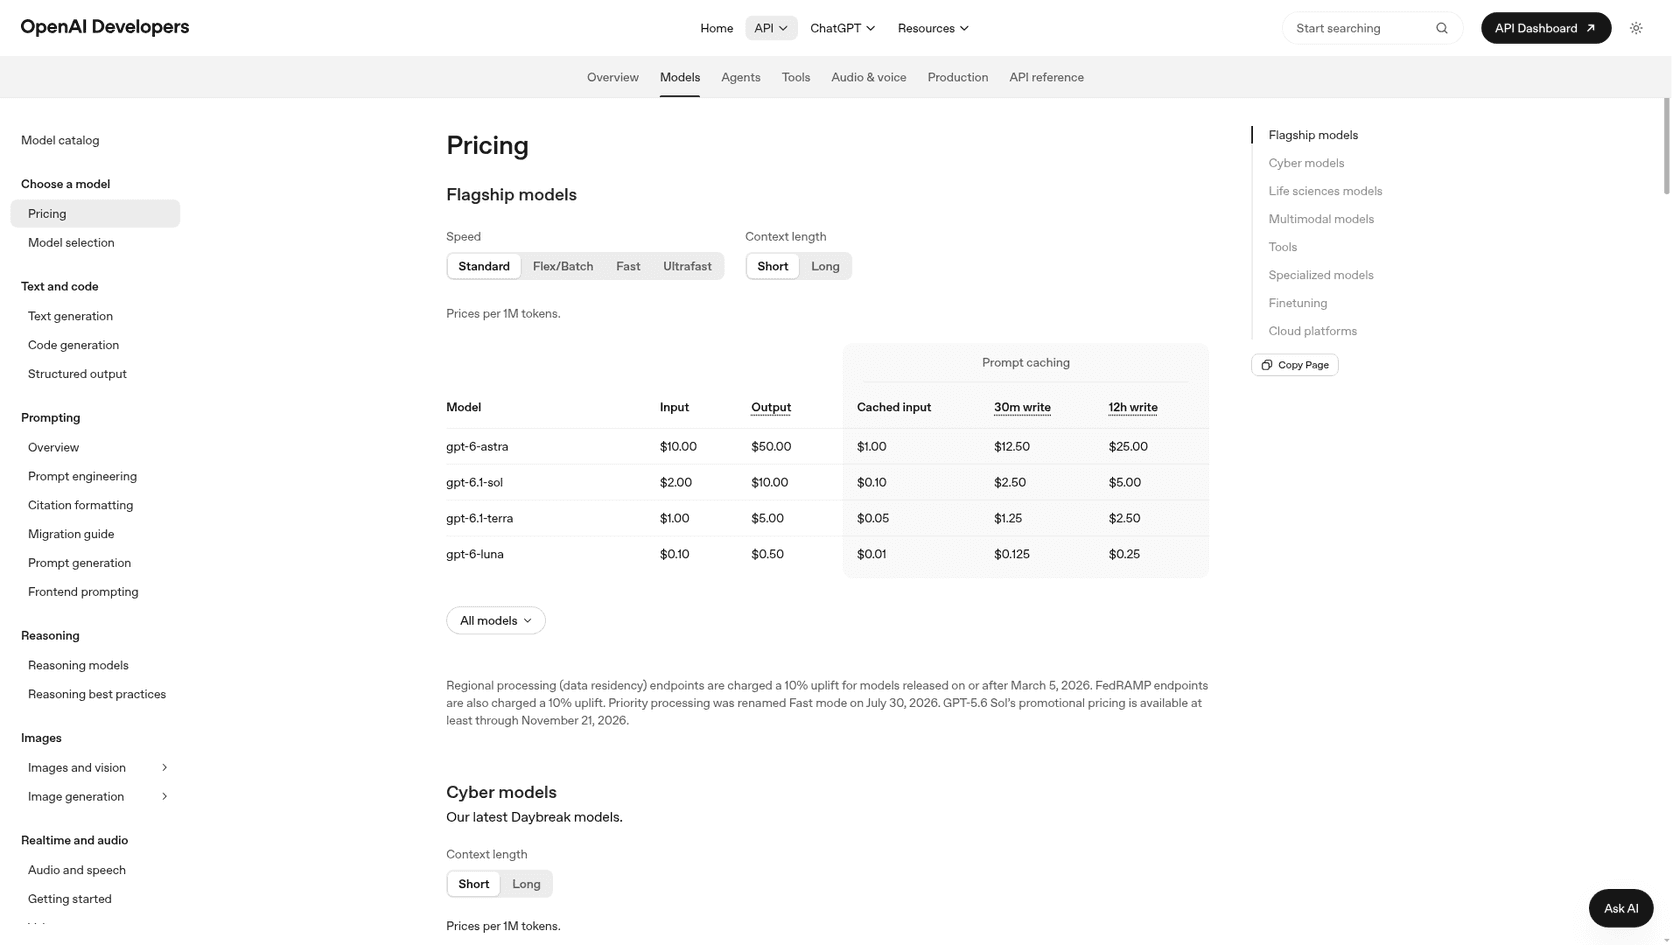
Hier die vollständige Preistabelle, pro Million Tokens:
| Stufe | Eingabe | Zwischengespeicherte Eingabe | Cache-Schreiben (30 Min.) | Cache-Schreiben (12 Std.) | Ausgabe |
|---|---|---|---|---|---|
| Standard (bis 272K Eingabe) | $1.00 | $0.05 | $1.25 | $2.50 | $5.00 |
| Standard (über 272K Eingabe) | $2.00 | $0.10 | $2.50 | $5.00 | $7.50 |
| Batch / Flex | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Fast | $2.00 | $0.10 | $2.50 | $5.00 | $10.00 |
| Ultrafast | Nicht angeboten |
Quelle: OpenAI-API-Preise und die Modellseite zu GPT-6.1 Terra. Regionale Verarbeitung (Datenresidenz) und FedRAMP-Endpunkte schlagen mit 10 % auf. Ultrafast gibt es derzeit nur für Sol und Astra.
Ein paar Dinge in dieser Tabelle sollte man langsam lesen:
- Reasoning-Tokens werden als Ausgabe abgerechnet. Jede Effort-Stufe über
noneerzeugt Denk-Tokens, die Sie nie sehen, und jedes kostet$5pro Million. Deshalb verschiebt der Effort die Rechnung stärker als alles andere. - Cache-Lesen kostet 5 % der Eingabe, Cache-Schreiben 125 %. Die Modellseite sagt, dass zwischengespeicherte Eingabe mit 5 % des nicht zwischengespeicherten Satzes berechnet wird und dass das Schreiben
$1.25bei 30 Minuten Aufbewahrung und$2.50bei 12 Stunden Aufbewahrung kostet. - Der Preis für lange Kontexte gilt für die gesamte Anfrage. OpenAIs Formulierung lautet „2x input and cache rates and 1.5x output for the full request.“ Ein Token über 272K, und jedes Token in diesem Aufruf kostet mehr.
Wenn Sie den gesamten OpenAI-Katalog nebeneinander brauchen, enthält der Leitfaden zu den OpenAI-API-Preisen jedes Modell, und die Liste der OpenAI-Modelle erklärt, wo welches passt.
Was kostet eine Aufgabe mit GPT-6.1 Terra tatsächlich?
Eine Aufgabe kostet in der Benchmark-Suite von Artificial Analysis zwischen $0.05 und $0.40, und die Effort-Einstellung macht den ganzen Unterschied. Gleiches Modell, gleicher Token-Preis, 8-fache Spanne:
| Terra-Effort | Intelligence Index | Kosten pro Aufgabe | Zeit pro Aufgabe |
|---|---|---|---|
none (ohne Reasoning) | 33.5 | $0.11 | k. A. |
low | 36.2 | $0.05 | 29s |
medium | 41.3 | $0.10 | 63s |
high | 43.9 | $0.13 | 96s |
xhigh | 45.4 | $0.19 | 160s |
max | 48.1 | $0.40 | 384s |
Quelle: Artificial Analysis, Modellseiten pro Effort. Artificial Analysis nennt low und medium die Pareto-optimalen Einstellungen, das heißt, kein von ihm erfasstes Modell ist an diesen Punkten zugleich günstiger und klüger.
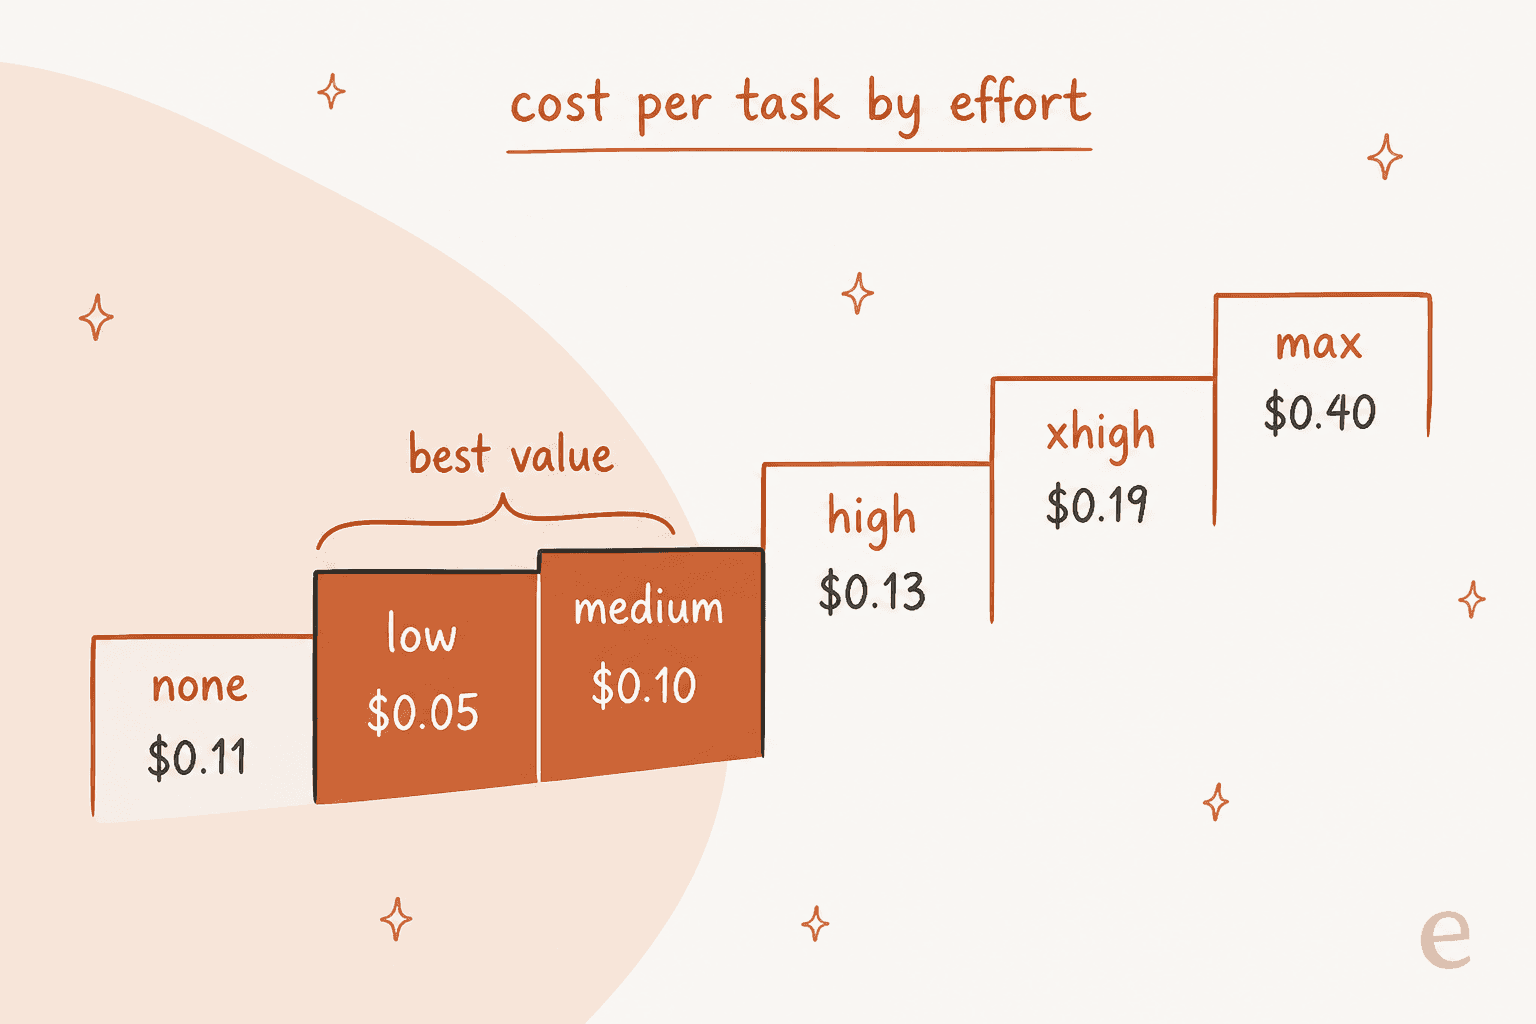
Zwei Details haben mich überrascht. Erstens kostet none in dieser Suite mehr pro Aufgabe als low, das Gegenteil dessen, was die Namen nahelegen. simonw sah in einem Test am Launch-Tag auf Hacker News etwas Ähnliches: Beide Einstellungen gaben bei seinem Prompt null Reasoning-Tokens aus, und low kam trotzdem günstiger weg. Gehen Sie nicht davon aus, dass none die Sparstufe ist; messen Sie nach.
Zweitens ist max der Punkt, an dem Terra nicht mehr die günstige Option ist. Von medium auf max kostet es 4-mal mehr und dauert 6-mal länger, für 7 Index-Punkte mehr. Dort liefert GPT-6.1 Sol bei medium ($0.21 pro Aufgabe, Index 47.8) etwa dieselbe Punktzahl für ungefähr die Hälfte des Geldes. Hacker-News-Leser haben das binnen Stunden herausgefunden:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."

Und von jemandem, der es in Produktion einsetzt:
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."
Das deckt sich mit dem, was ich in meinem eigenen Terra-Test gemessen habe. Bei 16 Support-Tickets über die Responses API erzielte Terra bei low dasselbe Ergebnis wie bei medium und kostete $0.75 pro 1.000 Tickets statt $0.92:
| Setup | Korrekt (von 16) | Kosten pro 1.000 Tickets | Mittlere Zeit |
|---|---|---|---|
Terra, none | 15 (1 Fehler) | $0.65 | 2.5s |
Terra, low | 15 | $0.75 | 2.7s |
Terra, medium | 15 | $0.92 | 3.1s |
GPT-6.1 Sol, medium | 16 | $1.62 | 3.9s |
GPT-6 Luna, medium | 15 | $0.14 | 4.1s |
Die Einstellung none war am günstigsten, aber sie teilte einem spanischsprachigen Kunden mit, seine Adressänderung sei „vermerkt“, obwohl sie kein Werkzeug hatte, um irgendetwas zu ändern. Das sind 10 Cent Ersparnis pro 1.000 Tickets, bezahlt mit einem Versprechen, das Ihr Team nicht halten kann. Ich würde bei low anfangen.
Warum kostet ein langer Prompt doppelt so viel?
Weil der Satz für lange Kontexte für die gesamte Anfrage gilt, nicht nur für die Tokens jenseits der Grenze. Unter 272K Eingabe-Tokens zahlen Sie $1/$5. Darüber wird der ganze Aufruf mit $2/$7.50 abgerechnet.
Der Sprung ist steil. Eine Anfrage mit 270K Eingabe und 2K Ausgabe kostet $0.28. Mit 10K mehr Eingabe kostet sie $0.58, mehr als das Doppelte, für 4 % mehr Text.
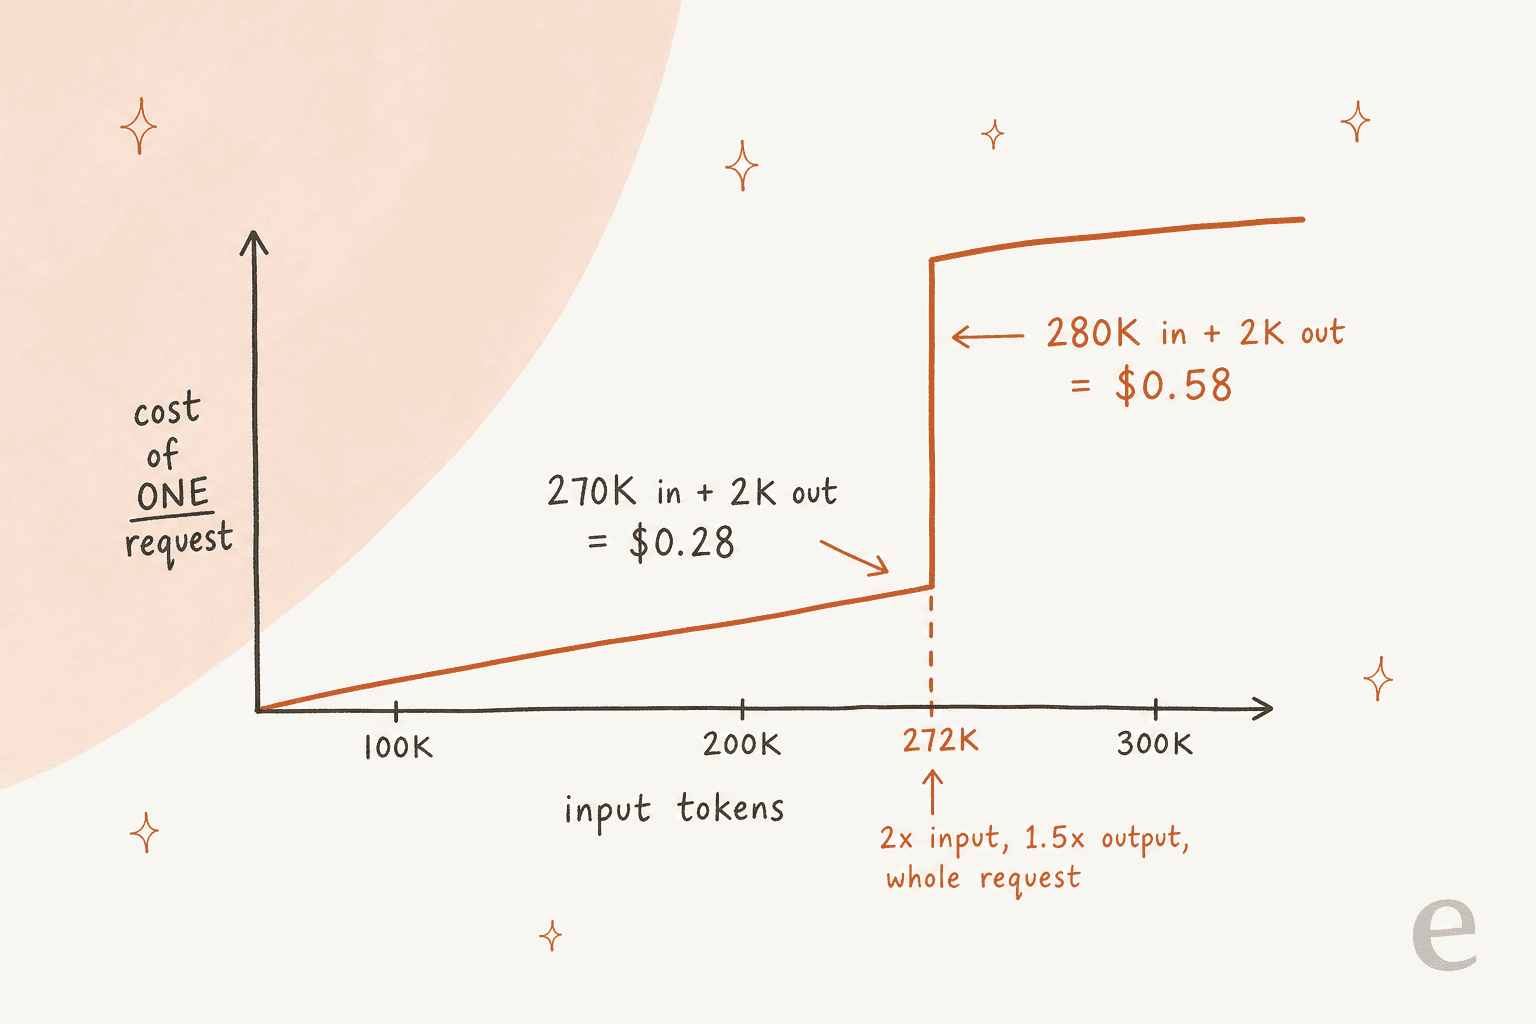
Terras Kontextfenster umfasst 1,050,000 Tokens, es nimmt also bereitwillig einen Vertrag oder Log-Dump mit 400K Tokens entgegen. Das kostet es, und das kostet das Aufteilen:
| Vorgehen | Rechnung | Kosten |
|---|---|---|
| Eine Anfrage mit 400K Tokens, 4K Ausgabe | 400K x $2 + 4K x $7.50 | $0.83 |
| Zwei Anfragen mit je 200K Tokens, je 4K Ausgabe | 2 x (200K x $1 + 4K x $5) | $0.44 |
Aufteilen spart 47 %, solange die Aufgabe das Aufteilen übersteht. Zusammenfassungen, Extraktion und Prüfung pro Abschnitt tun das meist. Eine Frage, die das ganze Dokument auf einmal braucht, nicht, und dann zahlen Sie den Satz für lange Kontexte.
Der leise Weg über die Grenze ist eine Agenten-Schleife. Jede Runde sendet die Unterhaltung erneut, sodass eine Sitzung, die bei 50K beginnt, bis Runde 20 unbemerkt über 272K treiben kann. Wenn Sie Terra als Agent betreiben, protokollieren Sie die Eingabe-Tokens pro Aufruf und kürzen oder fassen Sie den Verlauf zusammen, bevor es so weit kommt. Der Leitfaden zu OpenAI Function Calling beschreibt, wie Tool-Ergebnisse zu diesem Verlauf beitragen.
Spart Prompt-Caching bei Terra Geld?
Ja, wenn der Traffic stetig ist. Zwischengespeicherte Eingabe kostet $0.05 pro Million, 95 % Rabatt. Der Haken ist das Schreiben: Ein Präfix im Cache abzulegen kostet $1.25 pro Million für 30 Minuten oder $2.50 für 12 Stunden, und das ist mehr, als ihn einfach ohne Cache zu senden.
Nehmen wir eine Support-Antwort mit einem System-Prompt samt Richtlinienblock von 4.000 Tokens, der sich nie ändert, 2.000 Tokens Ticket- und Help-Center-Kontext, der sich ändert, und 400 Tokens Ausgabe:
| Szenario | Pro Ticket | Pro 1.000 Tickets |
|---|---|---|
| Kein Caching | $0.0080 | $8.00 |
| Präfix zwischengespeichert und gelesen (volle Warteschlange) | $0.0042 | $4.20 |
| Präfix jedes Mal geschrieben (ein Ticket alle 30 Min.) | $0.0090 | $9.00 |
In einer vollen Warteschlange wird das Präfix einmal pro Zeitfenster geschrieben und tausendfach gelesen, sodass Caching die Rechnung fast halbiert. In einer ruhigen, in der jede Anfrage nach Ablauf des Caches eintrifft, zahlen Sie jedes Mal den Schreibaufschlag und stehen etwa 12 % schlechter da als ganz ohne Caching.
OpenAIs Modellleitfaden rät, cached_tokens und cache_write_tokens zu verfolgen, um die Nettokosten zu verstehen, und das ist die richtige Gewohnheit. Die 12-Stunden-Aufbewahrung lohnt sich nur, wenn ein Präfix über Stunden, aber seltener als alle 30 Minuten wiederverwendet wird, etwa bei einem nächtlichen Job.
Was kostet Terra pro Monat?
Hier eine Last, über alle Stufen bepreist: 1 Million Anfragen im Monat, jede mit 2.000 Eingabe-Tokens und 300 Ausgabe-Tokens.
| Stufe | Eingabekosten | Ausgabekosten | Monatssumme |
|---|---|---|---|
| Standard | $2,000 | $1,500 | $3,500 |
| Batch / Flex | $1,000 | $750 | $1,750 |
| Fast | $4,000 | $3,000 | $7,000 |
| Standard + regional | $2,200 | $1,650 | $3,850 |
Batch ist die einfachste Ersparnis. Wenn Ergebnisse innerhalb des Batch-Fensters eintreffen dürfen (Klassifizierung, nächtliche Zusammenfassungen, Nachträge), zahlen Sie die Hälfte. Der Leitfaden zur OpenAI Batch API beschreibt die Einrichtung. Der Fast-Modus lohnt sich nur bei nutzerseitigen Aufrufen, bei denen Latenz Sie einen Kunden kostet.
Um Ihre eigene Last zu bepreisen, tragen Sie hier Ihre Zahlen ein:
Die Voreinstellung ist ein Monat mit 100.000 Tickets und einem Prompt von 6.000 Tokens, was auf etwa $800 kommt. Tragen Sie Ihre echte Prompt-Größe ein, nicht die aus Ihrem Prototyp. Abgerufene Help-Center-Abschnitte und der Gesprächsverlauf machen einen Prompt meist 5- bis 10-mal größer als erwartet.
Wie schlägt sich Terra preislich gegen andere Modelle?
Terra ist die zweite Sprosse von OpenAIs Leiter aus vier Modellen. Hier dieselbe Last mit 1 Million Anfragen (2.000 Eingabe, 300 Ausgabe) über OpenAIs Familie und die engsten Konkurrenten:
| Modell | Eingabe / Ausgabe pro 1M | Zwischengespeicherte Eingabe | AA-Kosten pro Aufgabe | Monatsrechnung (Beispiel) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | k. A. | $350 |
| GPT-6.1 Terra | $1.00 / $5.00 | $0.05 | $0.40 (max) | $3,500 |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | $0.21 (medium) | $7,000 |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | $3.26 (max) | $35,000 |
| GPT-5.6 Terra (Vorgänger) | $2.00 / $12.00 | k. A. | $1.40 (max) | $7,600 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $0.10 | $0.88 (high) | $7,000 |
| Claude Haiku 5.5 | $0.10 / $0.50 | $0.01 | $0.08 (high) | $350 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 außerhalb der Spitzenzeit | $0.003 | $0.26 (max) | $480 |
| Gemini 3.8 Flash | $0.75 / $3.75 bis 31. Dez. | $0.075 | $3.49 (high) | $2,625 |
Quellen: OpenAI-API-Preise, die jeweilige Preisseite der Anbieter, Stand 28. Oktober 2026, und Artificial Analysis für die Kosten pro Aufgabe. Haikus Preis gilt bis zu einem Prompt von 100K.
Gegenüber dem Vorgänger ist der Rückgang real. OpenAIs Launch-Thread sagte es schlicht:
"It's a significant step up over GPT‑5.6 Terra, with 50% lower standard API prices."
Pro Token liegt Terra im Mittelfeld: 10-mal Luna und Haiku, die Hälfte von Sol und Sonnet. Pro Aufgabe gehört es zu den günstigsten Modellen mit einem Intelligence Index über 45. Wenn Ihre Arbeit schmales Tagging und Routing ist, ist Luna zu einem Zehntel des Preises der bessere Kauf. Wenn es um anspruchsvolles Coding geht, verweist OpenAI selbst auf Sol oder GPT-6 Astra. Der Beitrag zu den GPT-6.1-Terra-Alternativen geht jede Option ausführlich durch.
Was kostet Terra in ChatGPT und Codex?
In ChatGPT gibt es keinen separaten Terra-Preis. Es ist in den Plänen Plus, Pro, Enterprise und Edu in ChatGPT Work und Codex enthalten, laut OpenAIs Launch-Beitrag. OpenAI sagt, Ihr Nutzungskontingent reiche mit Terra weiter als mit GPT-5.6 Terra und viel weiter als mit Sol oder Astra.
In einem Abo senkt die Wahl von Terra also nicht die Rechnung, sondern dehnt das Kontingent. Wenn Sie bei Routinearbeit mit Sol an Limits stoßen, ist der Wechsel dieser Aufgaben zu Terra die günstige Lösung. Die Leitfäden zu den ChatGPT-Work-Preisen und den Codex-Preisen beschreiben, was jeder Plan enthält, und ChatGPT Enterprise erklärt die Workspace-Stufe.
Welche versteckten Kosten und Limits gibt es?
Die meisten sind einzeln klein und summieren sich zusammen. Das ist die Liste, die ich vor einer Entscheidung prüfen würde:
- Keine kostenlose API-Stufe. Die Modellseite führt Free als „Not supported“. Sie brauchen ab dem ersten Aufruf ein bezahltes Konto.
- Ratenlimits beginnen niedrig. Die Build-Stufe bietet
5,000Anfragen und1,000,000Tokens pro Minute. Bei 2.300 Tokens pro Anfrage sind das etwa 430 Anfragen pro Minute. Launch geht bis4,000,000TPM und Grow bis40,000,000. Der Leitfaden zu den OpenAI-Ratenlimits erklärt, wie Sie aufsteigen. - Tool-Aufrufe kosten extra. Websuche und Dateisuche werden zusätzlich zu den Tokens pro Aufruf oder pro GB abgerechnet, und von integrierten Tools genutzte Tokens werden zu Terras Sätzen berechnet, laut Preisseite.
- Regionale Verarbeitung kostet +10 %. Datenresidenz und FedRAMP-Endpunkte tragen den Aufschlag für Modelle, die am oder nach dem 5. März 2026 erschienen sind, was Terra einschließt.
- Wiederholungen und Evals. Ein fehlgeschlagener Tool-Aufruf oder eine neu generierte Antwort wird voll berechnet. Planen Sie einen Puffer ein und führen Sie OpenAI-Agent-Evals an einem festen Satz aus, bevor Sie Effort-Stufen ändern, damit Sie Kosten bei gleicher Qualität vergleichen.
| Ratenlimit-Stufe | Anfragen pro Minute | Tokens pro Minute | Batch-Warteschlangenlimit |
|---|---|---|---|
| Free | Nicht unterstützt | ||
| Build | 5,000 | 1,000,000 | 3,000,000 |
| Launch | 10,000 | 4,000,000 | 200,000,000 |
| Grow | 15,000 | 40,000,000 | 15,000,000,000 |
Quelle: Modellseite zu GPT-6.1 Terra.
Lohnt sich GPT-6.1 Terra für den Kundensupport?
Für Entwürfe und Triage ja, und die Token-Rechnung ist der kleinste Posten im Budget. Ein realistisches Support-Ticket mit einem Prompt von 6.000 Tokens kostet bei Standard etwa $0.008. Ein Monat mit 10.000 Tickets sind $80 Modellkosten, oder etwa $42 mit zwischengespeichertem Präfix.
Was ein Support-Team wirklich Geld kostet, ist die falsche Antwort. In meinem Test sagte die günstigste Einstellung einem Kunden, eine Adressänderung sei erledigt, obwohl sie es nicht war, und dieses eine Ticket würde mit Nachfrage und Erstattung mehr kosten als ein Jahr Token-Ersparnis. eesel setzt seit Jahren KI-Agenten in echten Support-Warteschlangen ein und baut die Integrationen dafür, und ich lerne immer wieder dieselbe Lektion: Das Modell ist die kleinere Hälfte der Arbeit. Die größere Hälfte ist, was es liest, was es tun darf und wann es an einen Menschen übergibt. Die Aufschlüsselung der Kosten für KI im Kundenservice zeigt das Gesamtbild, und KI-Halluzinationen im Support behandelt den oben beschriebenen Fehlerfall.
Die smava-Geschichte zeigt, wie diese Hälfte aussieht. Ihr eesel-Agent arbeitet in KI für Zendesk, bearbeitet etwa 27.000 Tickets im Monat über zwei Kreditmarken, bereitete in einem Monat 15.300 Antwortentwürfe vor und entwirft aus den 820 Makros und Help-Center-Artikeln, die das Team bereits in Zendesk pflegt. In der regulierten Finanzbranche ist eine Antwort, die etwas verspricht, was das Team nicht einhält, echter Schaden, weshalb der Wortlaut aus den Makros stammt und nicht aus der Fantasie des Modells. Dokument 24 fährt dasselbe Muster auf Dänisch: 670 Antwortentwürfe im Monat bleiben als interne Notizen, die das Team prüft und sendet, eine gute Lösung für mehrsprachigen Kundensupport.
eesel ausprobieren
Wenn Sie Terra bepreisen, weil Sie KI wollen, die Tickets entwirft oder beantwortet, brauchen Sie die Pipeline vielleicht gar nicht selbst zu bauen. eesel ist eine Plattform für KI-Teammitglieder, und der KI-Helpdesk-Agent schließt sich Ihrer bestehenden Zendesk-, Freshdesk- oder Gorgias-Warteschlange an, lernt aus Ihren früheren Tickets und Ihrem Help Center und entwirft oder antwortet mit den von Ihnen festgelegten Eskalationsregeln. Sie können ihn an Ihren eigenen historischen Tickets testen, bevor er einen echten Kunden berührt.
Die Abrechnung erfolgt pro Ticket, nicht pro Token: eesels Pläne beginnen bei $299 im Monat für 500 Credits, wobei ein Ticket ein Credit ist, egal wie lang der Verlauf wird, mit 100 kostenlosen Credits zum Ausprobieren. So liegen Modellwahl, Prompt-Größe und die 272K-Regel auf eesels Seite des Tisches statt auf Ihrer. SamCart betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren im Website-Chat, beide antworten aus 280 Help-Center-Artikeln.
Wenn Sie es lieber per Code steuern möchten, bedient die eesel CLI dasselbe Teammitglied aus einem Terminal, und jeder Workspace ist außerdem ein MCP-Server, sodass eine Codex-Sitzung mit GPT-6.1 Terra Ihren Support-Agenten als Tool aufrufen kann. Probieren Sie eesel aus und sehen Sie die Entwürfe an Ihren eigenen Tickets.
Häufig gestellte Fragen
Was kostet GPT-6.1 Terra?
Was kostet GPT-6.1 Terra pro Aufgabe?
Ist GPT-6.1 Terra günstiger als GPT-6.1 Sol?
Wie hoch ist der Preis für lange Kontexte bei GPT-6.1 Terra?
Hat GPT-6.1 Terra eine kostenlose Stufe?
gpt-6.1-terra nicht unterstützt, und die Ratenlimits beginnen in der Build-Stufe bei 5.000 Anfragen und 1 Million Tokens pro Minute. Der Leitfaden zu den OpenAI-Ratenlimits erklärt, wie die Stufen steigen. In ChatGPT ist Terra in den Plänen Plus, Pro, Enterprise und Edu enthalten.