

Was kostet Elorian Glimpse?
Ich bin Alicia und entwickle bei eesel Funktionen und KI-Agenten. Ein großer Teil meiner Woche geht in die Lücke zwischen dem, was ein Modell pro Token kostet, und dem, was es pro erledigter Aufgabe kostet, denn in dieser Lücke geraten KI-Budgets aus dem Ruder. Bevor ich bei Glimpse etwas gerechnet habe, habe ich also Elorians Launch-Beitrag, die Plattform-Bedingungen und die Anbieterseiten Zeile für Zeile gelesen. Vision ist auch in meinem Berufsalltag ein aktuelles Thema: In den Sales-Calls von eesel in diesem Jahr wollten Support-Teams technischer Produkte immer wieder KI, die Diagramme in ihren PDFs und die Fotos lesen kann, die Kunden an Tickets anhängen. Ich wollte also die echten Kosten eines Modells kennen, das genau für solches Hinschauen gebaut ist.
Glimpse wurde am 16. Oktober 2026 veröffentlicht, als erstes Modell von Elorian, einem Startup des Gründers Andrew Dai, der zuvor bei Google DeepMind die Datenarbeit für Gemini mitgeleitet hat. Elorian nennt es ein „Visual-Thinking“-Modell: Es nimmt Bilder und Video entgegen, zoomt in Bereiche hinein, schaut sich kurze Abschnitte mit höherer Bildrate erneut an und antwortet erst dann in Text. Es ist eine Research Preview, nachtrainiert auf einem Open-Weights-Basismodell.
Das gibt es heute zu kaufen und so viel kostet es:
| Zugang | Eingabe (pro 1 Mio. Token) | Gecachte Eingabe (pro 1 Mio.) | Ausgabe (pro 1 Mio. Token) | Hinweise |
|---|---|---|---|---|
| Elorian API | $0.60 | Nicht veröffentlicht | $3.00 | Anmeldung auf der Elorian-Plattform |
| OpenRouter | $0.60 | $0.06 | $3.00 | Jede Anfrage geht an Together AI |
| Together AI dediziert | Vertrieb kontaktieren | Vertrieb kontaktieren | Vertrieb kontaktieren | Single-Tenant-GPUs, Abrechnung pro Stunde |
| Elorian Chat-Oberfläche | Kostenlos | Kostenlos | Kostenlos | Web-Chat, keine API |
Bei den technischen Daten nennt OpenRouter ein Kontextfenster von 262,144 Token und bis zu 256,000 Ausgabe-Token. Eingaben sind Text, Bilder und Video. Die Ausgabe ist nur Text.
In Elorians eigenen Unterlagen fehlen zwei Dinge, die wichtig sind. Für die Elorian-API selbst gibt es keinen veröffentlichten Cache-Preis, und es gibt nirgends einen Batch-Rabatt. Wer Caching heute belegt haben will, findet es nur im Listing von OpenRouter.
Wie schneiden die Glimpse-Preise gegenüber Astra, Sol, Opus 5.5 und Gemini ab?
Elorians Launch-Beitrag vergleicht Glimpse mit vier Frontier-Modellen, und die Preiszeilen stehen ganz oben in der Ergebnistabelle. Hier ist diese Tabelle, direkt von der Launch-Seite:
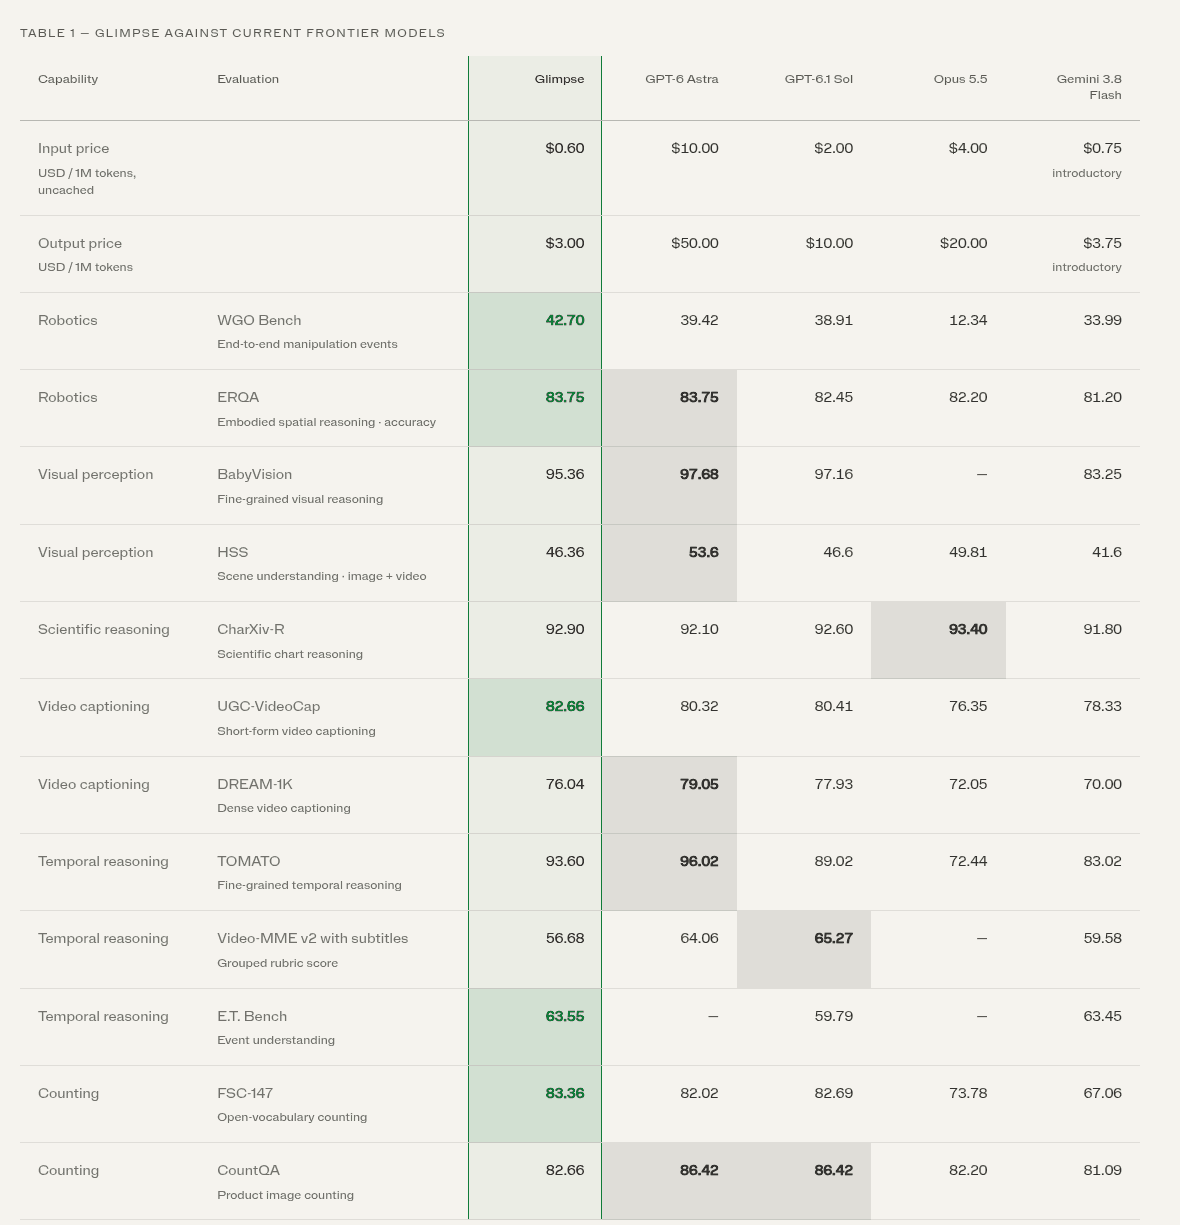
Ich habe jeden Konkurrenzpreis auf der jeweiligen Anbieterseite geprüft und die Cache-Preise ergänzt, denn Caching verändert das Bild bei bildlastigen Aufgaben, bei denen dieselben Referenzframes immer wieder gesendet werden:
| Modell | Eingabe (pro 1 Mio.) | Gecachte Eingabe (pro 1 Mio.) | Ausgabe (pro 1 Mio.) | Glimpse-Ersparnis bei der Ausgabe |
|---|---|---|---|---|
| Elorian Glimpse | $0.60 | $0.06 (OpenRouter) | $3.00 | - |
| Gemini 3.8 Flash (bis 31. Dez. 2026) | $0.75 | $0.075 | $3.75 | 20 % |
| Gemini 3.8 Flash (ab 1. Jan. 2027) | $1.50 | $0.15 | $7.50 | 60 % |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | 70 % |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | 85 % |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 94 % |
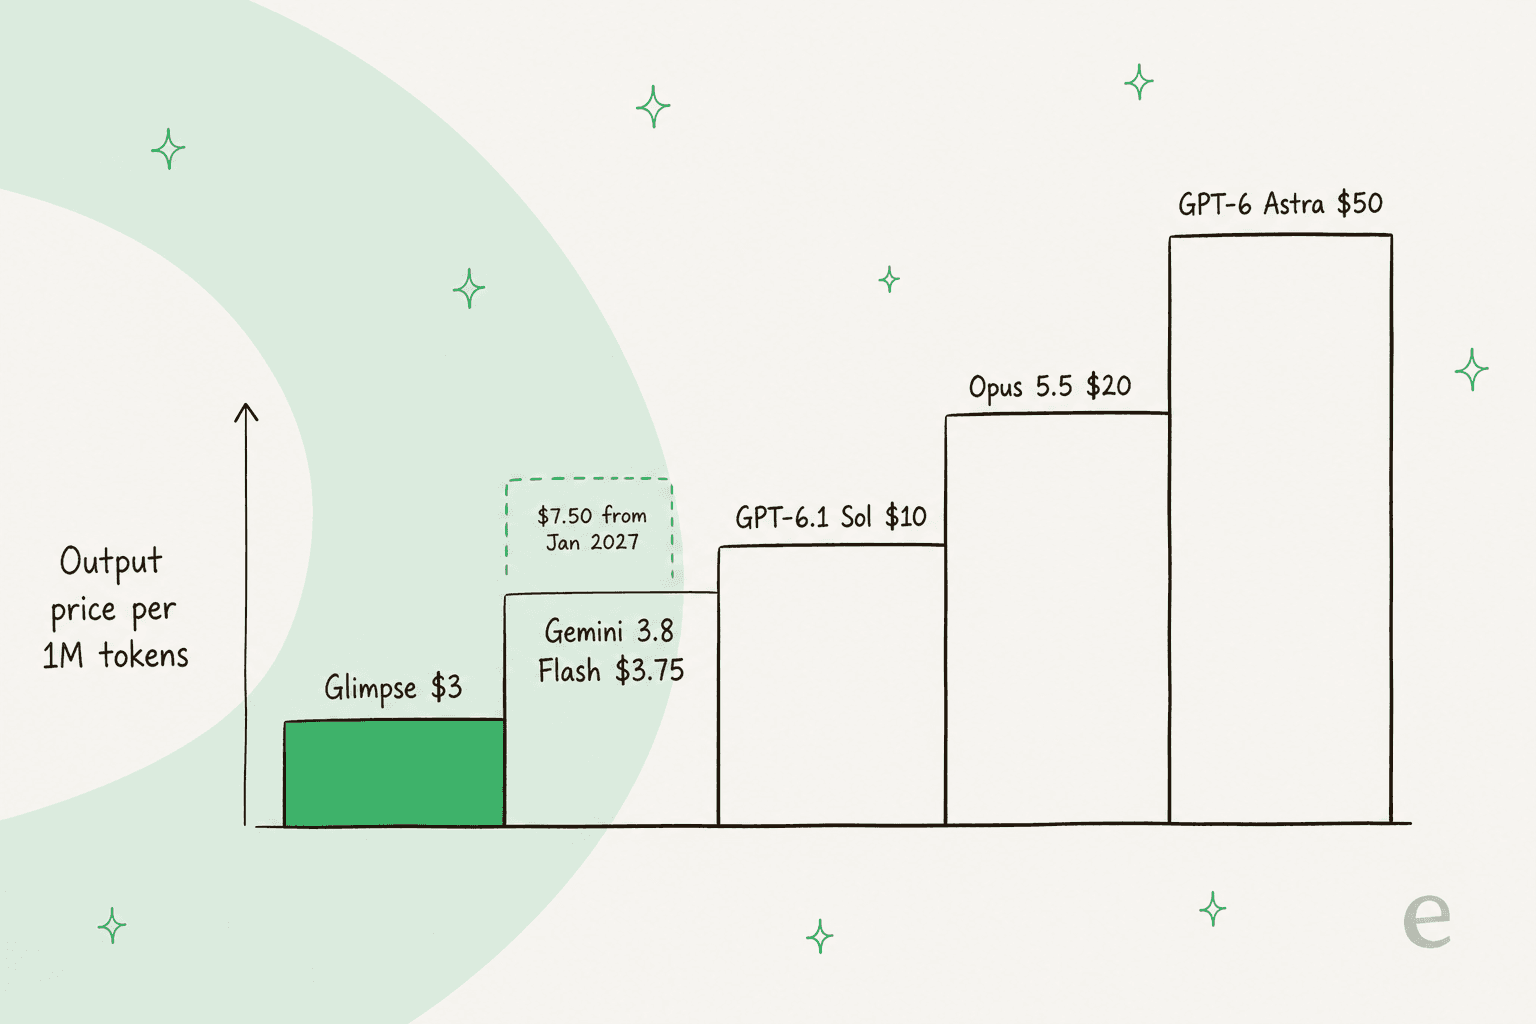
Die meiste Aufmerksamkeit verdient die Gemini-Zeile. Elorian schreibt beim Flash-Preis sorgfältig „introductory“, und dieses Wort hat Gewicht: Gemini 3.8 Flash steigt am 1. Januar 2027 von $0.75 und $3.75 auf $1.50 und $7.50. Heute unterbietet Glimpse Flash um 20 %. In zehn Wochen unterbietet es Flash um 60 %. Wenn Sie zwischen den beiden für ein Projekt wählen, das bis ins Jahr 2027 läuft, rechnen Sie mit der 2027-Spalte, nicht mit der vom Oktober.
Am anderen Ende ist der Astra-Vergleich die Schlagzeile, mit der Elorian wirbt, und sie hält der Preisliste stand. GPT-6.1 Sol liegt mit $2 und $10 in der Mitte, Opus 5.5 bei $4 und $20.
Bei offenen und günstigen Alternativen mit Vision sind die Vorschau DeepSeek V4 Flash Vision und Nemotron 3.5 Super VL pro Token beide noch günstiger, auch wenn keines davon wie Glimpse darauf ausgelegt ist, Video erneut anzuschauen.
Die vollständigen Preislisten der Hersteller finden Sie in den Leitfäden zu OpenAI-API-Preisen, Gemini-Preisen und Anthropic-API-Preisen.
Warum ist die echte Ersparnis kleiner als 94 %?
Weil Glimpse darauf ausgelegt ist, zweimal hinzuschauen, und Hinschauen kostet Token. Das sagt Elorian im Launch-Beitrag selbst: „Looking that closely takes time, and tokens. Token efficiency is our next highest focus.“
Der klarste Beleg ist Elorians eigene Roboter-Demo. Glimpse und GPT-6 Astra waren beide der Planer für dieselbe Roboter-Policy (π0.5 von Physical Intelligence) bei derselben Aufgabe: den Frischkäse in die Schüssel legen und dann die Schüssel auf den Schrank stellen. Beide schafften es. Laut Launch-Beitrag kostete die Planung mit Glimpse $0.035 pro Episode und die mit Astra $0.249.
Das ist ein Faktor von 7,1. Der Abstand in der Preisliste beträgt 16,7. Der Unterschied muss aus der Token-Anzahl stammen, und bei dieser Aufgabe bedeutet das, dass Glimpse etwa 2,3-mal so viele Token wie Astra brauchte, um dasselbe Ergebnis zu erreichen. Das ist meine Rechnung aus Elorians zwei Zahlen, keine von Elorian veröffentlichte Angabe, und sie stammt aus einer einzigen Demo. Aber sie ist die richtige Art Warnung für alle, die mit der 94-%-Schlagzeile budgetieren.
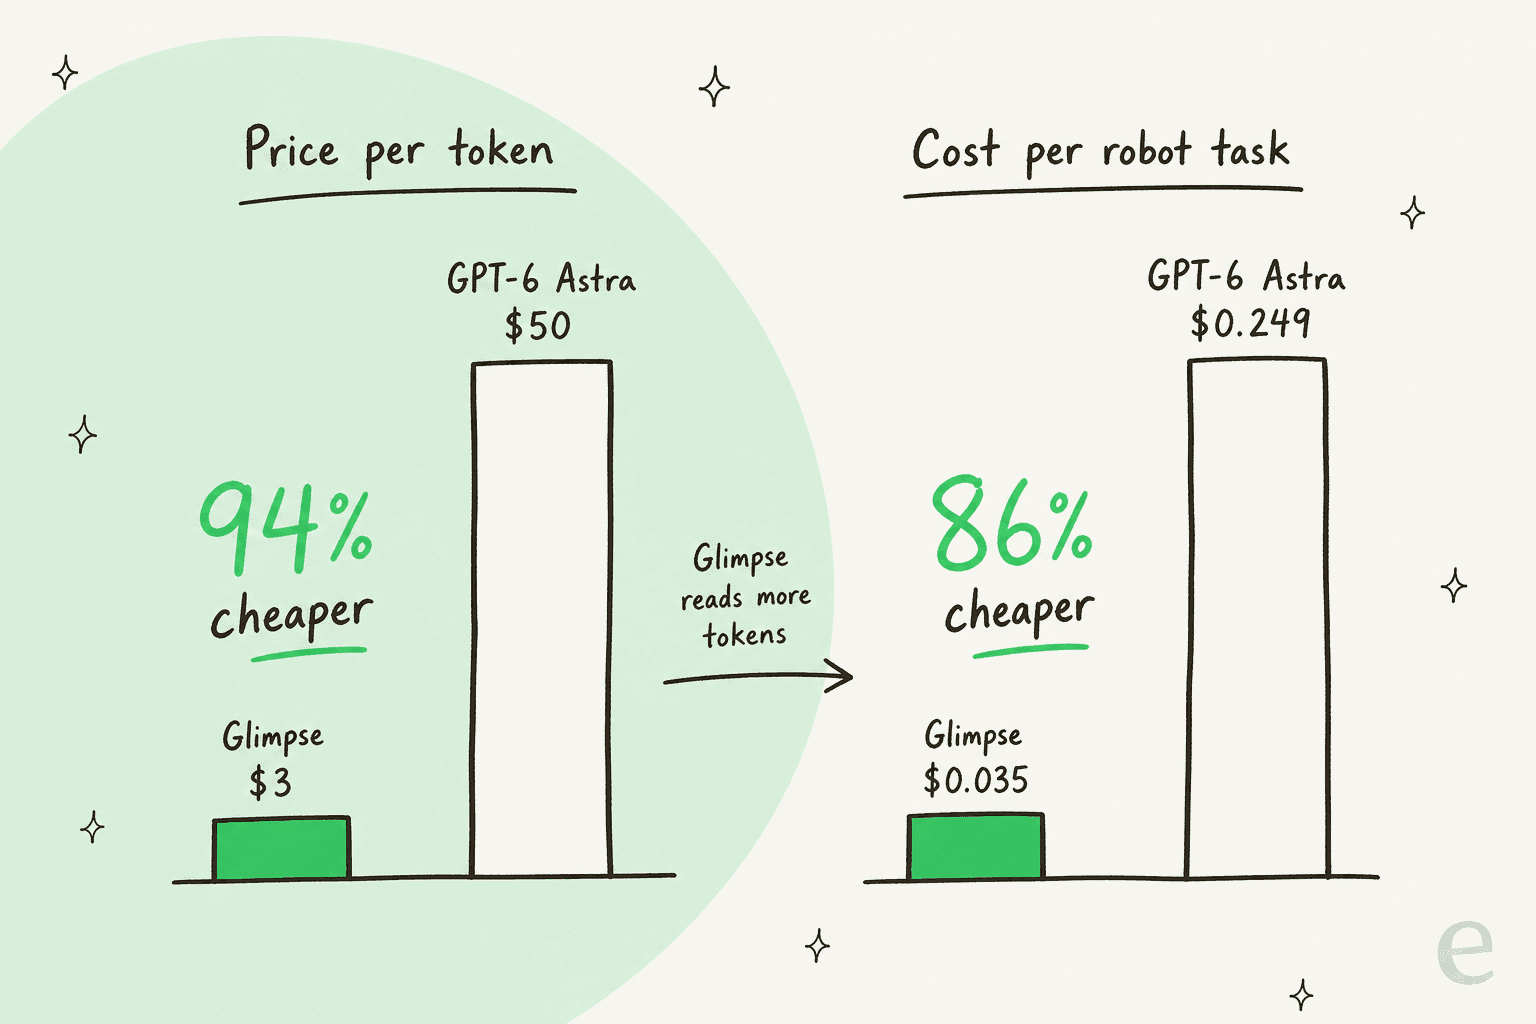
Eine Ersparnis von 86 % ist immer noch ein sehr gutes Geschäft, und für die Robotik verändert sie, was bezahlbar ist. Brian Zhan, ein Investor in Elorian, hat genau für diese Demo die Rechnung pro Stunde aufgemacht:
"A check every 2s is 1,800 calls per robot-hour. Glimpse is 7x cheaper than GPT-6 Astra and ~1s faster per call. The same budget on Astra buys one check every 14s."
Beachten Sie die „7x“, nicht „16x“. Selbst Elorians eigene Unterstützer nennen bei echten Rechnungen die Zahl pro Aufgabe. Das zusätzliche Hinschauen zeigt sich auch darin, wie frühe Tester das Modell beschreiben:
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
Vier Ausschnitte und ein Zoom ergeben eine bessere Antwort. Sie kosten aber auch Token für vier Ausschnitte und einen Zoom.
Wohin geht die Glimpse-Rechnung tatsächlich?
OpenRouter veröffentlicht Live-Traffic zu jedem gehosteten Modell. Das gibt einen seltenen Einblick, wie echte Workloads bei Glimpse Geld ausgeben. In den ersten drei Tagen zeigte die OpenRouter-Seite 557M Prompt-Token, 57.2M Reasoning-Token und 13.2M Completion-Token.
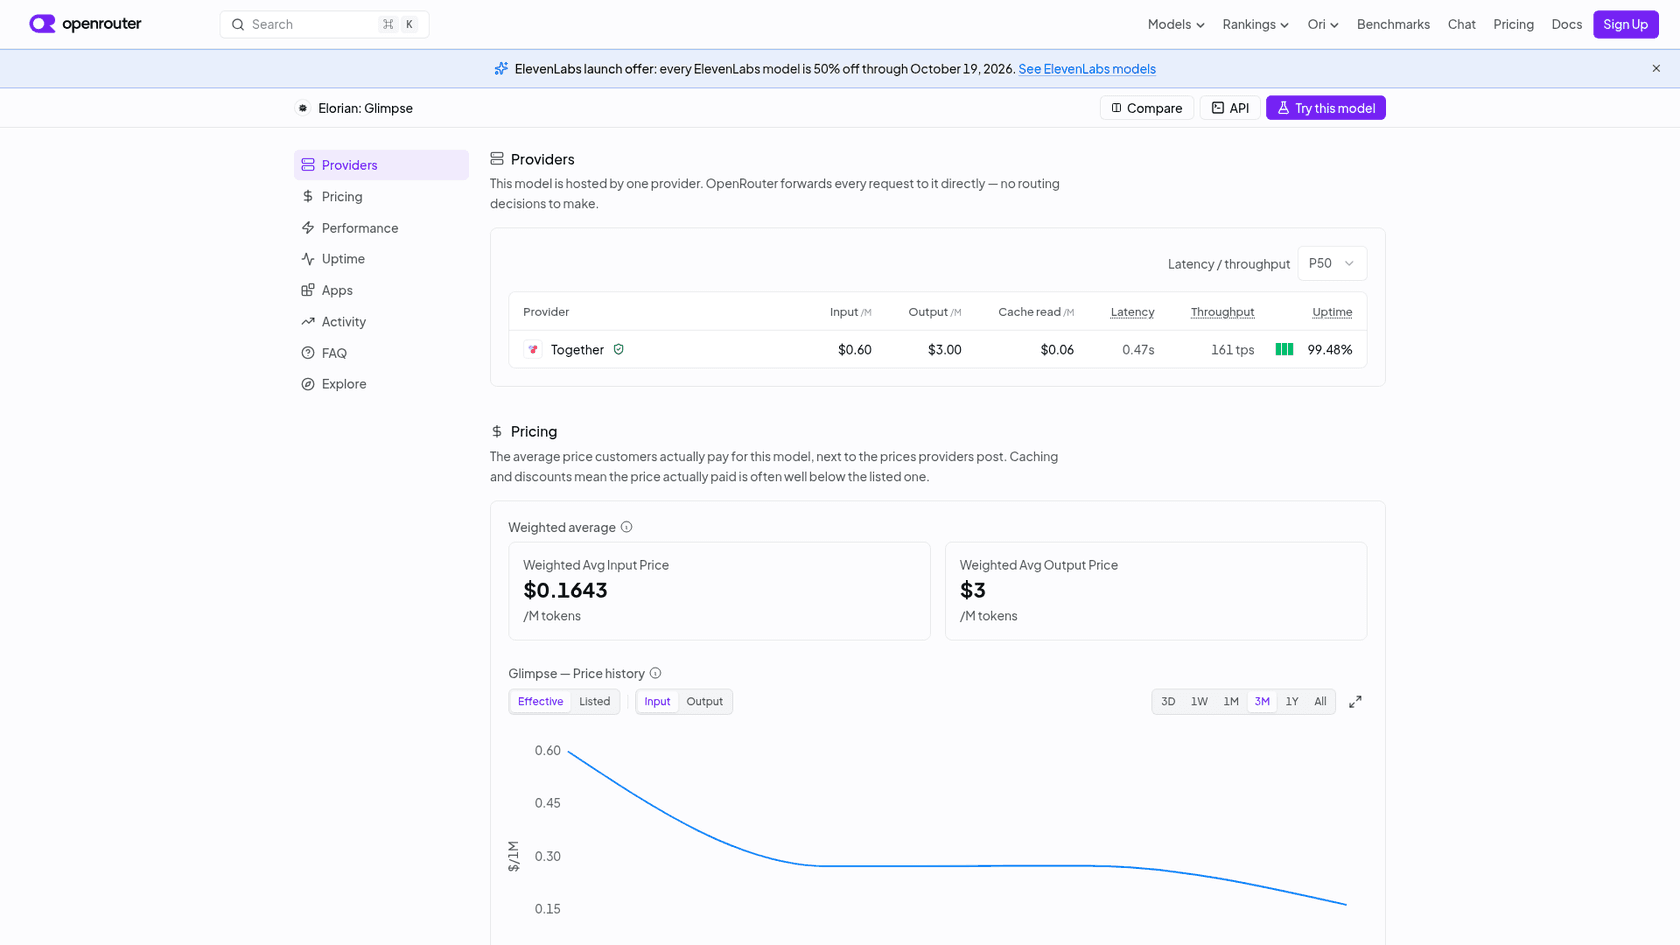
Zwei Zahlen auf dieser Seite erklären den Großteil der Rechnung:
- Cache-Trefferquote von 80,7 %. Der Großteil der Eingabe kam für
$0.06aus dem Cache, was den durchschnittlich gezahlten Eingabepreis auf$0.1643pro Million drückt, etwa 73 % unter dem Listenpreis von$0.60. - Reasoning macht 81 % der Ausgabe aus. Von den
70.4MAusgabe-Token waren57.2MDenken und nur13.2Mdie sichtbare Antwort. Auf OpenRouter werden Reasoning-Token als Ausgabe abgerechnet, und zwar zum vollen Satz von$3.
Zusammen genommen kippt das Geld. Die Eingabe macht 89 % der Token aus, aber nur etwa $91 der rund $303 Ausgaben. Die Ausgabe kostet etwa $211, also 70 %, und allein das Denken kostet mehr als die gesamte Eingabe zusammen.
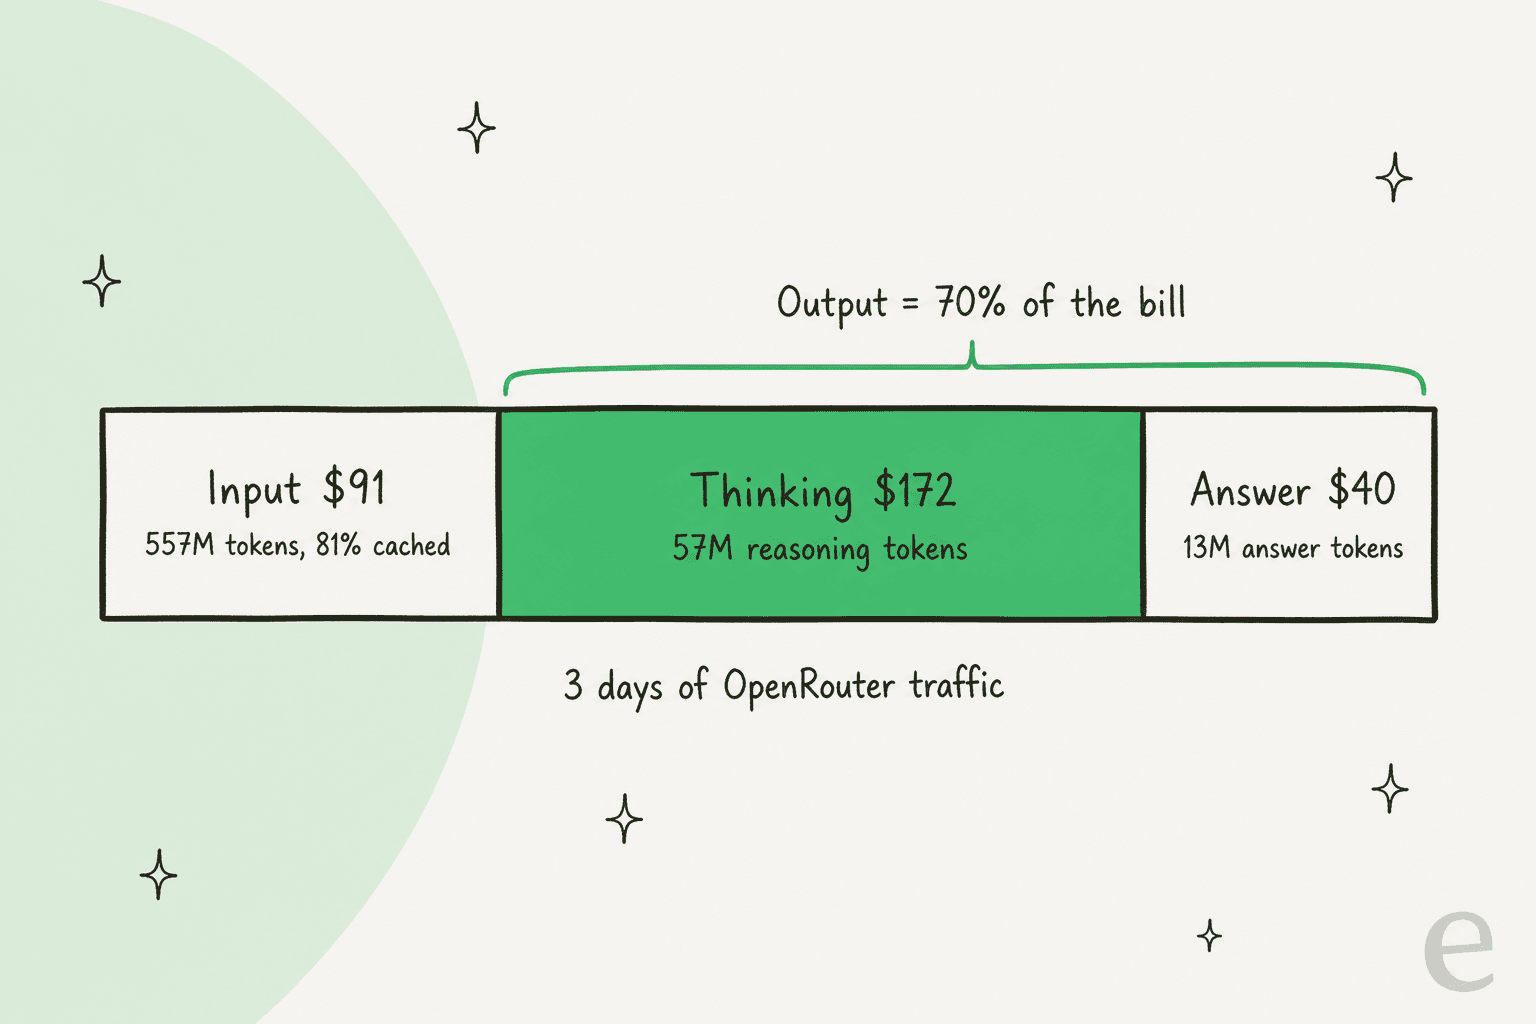
Das ist ein Traffic-Mix, nicht Ihr Mix. Die wichtigsten Apps, die in diesen ersten Tagen Glimpse-Traffic sendeten, waren Coding-Agenten und Hermes Agent, die lange, stabile Prompts erneut senden und gut cachen. Eine Pipeline, die bei jedem Aufruf einen neuen Videoclip sendet, cacht deutlich weniger, und die Eingabe nimmt einen größeren Anteil ein. Die Lehre bleibt aber gültig: Bei Glimpse ist das Reasoning der Hebel, nicht das Bild. Mit dem Parameter reasoning von OpenRouter können Sie den Aufwand oder ein maximales Reasoning-Budget festlegen, und das ist der erste Regler, an dem ich bei einer Kostenprüfung drehen würde.
Schätzen Sie Ihre eigene Glimpse-Rechnung
Tragen Sie Ihr eigenes Anfragevolumen und Ihre Token-Größen ein. Den „Glimpse-Token-Multiplikator“ gibt es wegen des Roboter-Beispiels oben: Setzen Sie ihn auf 1.0, wenn Sie annehmen, dass Glimpse dieselben Token wie die anderen Modelle verbraucht, oder auf etwa 2.3, passend zu dem, was Elorians eigene Demo nahelegt.
Mit den Standardwerten (10.000 Anfragen, je 20.000 Eingabe-Token und 3.000 Ausgabe-Token, kein Caching) kommt Glimpse auf $210 im Monat, gegenüber $262.50 für Gemini 3.8 Flash, $700 für Sol, $1,400 für Opus 5.5 und $3,500 für Astra. Schieben Sie den Multiplikator nun auf 2.3, springt Glimpse auf $483, mehr, als Gemini 3.8 Flash heute kostet. Schalten Sie die Preise für 2027 ein, steigt Flash auf $525, und Glimpse gewinnt wieder. Dieser Ausschlag ist die ganze Kaufentscheidung in einem Regler.
Ist die Glimpse-Chat-Oberfläche kostenlos?
Ja. Gründer Andrew Dai hat das im Launch-Thread gesagt:
"Free on the chat interface at https://platform.elorian.ai with an API available too."
Elorians Launch-Beitrag wiederholt das mit einem Button „Try Glimpse free on the Elorian platform“. Die Anmeldung läuft über Google oder E-Mail, und für Unternehmenskonten gibt es einen eigenen Kontakt.
Veröffentlichte Nutzungsgrenzen für den kostenlosen Chat habe ich nicht gefunden. Die Plattform-Bedingungen, zuletzt aktualisiert am 12. Oktober 2026, beschreiben, wie die bezahlte Nutzung abläuft, sobald Sie darüber hinausgehen:
- Gebühren werden in US-Dollar berechnet und sind nicht erstattungsfähig, außer wo das Gesetz es verlangt; Erstattungsanfragen werden im Einzelfall geprüft.
- Die Abrechnung kann über vorausbezahltes Guthaben oder ein laufendes Abonnement erfolgen.
- Wenn Sie die automatische Zahlung aktivieren, belastet Elorian Ihre Karte regelmäßig für die Nutzung, und Sie kündigen sie, indem Sie Elorian vor dem nächsten Abrechnungsdatum kontaktieren.
- Kostenlose Testphasen und Beta-Angebote sind nicht garantiert und können enden.
Der kostenlose Chat ist der richtige Startpunkt. Er zeigt sogar den „visual scratch space“ des Modells beim Zoomen und erneuten Anschauen. Das ist der schnellste Weg, ein Gefühl dafür zu bekommen, wie viele Schritte Ihre Art von Bild braucht und damit wie viele Token die API Ihnen berechnet.
Welche versteckten Kosten und Stolperfallen gibt es?
Die Preisliste ist kurz, deshalb liegen die echten Überraschungen im Verhalten des Modells. Die Angaben stammen aus den Live-Metriken von OpenRouter und Elorians eigenen Hinweisen:
| Stolperfalle | Was die Zahlen sagen | Warum es Sie Geld kostet |
|---|---|---|
| Fehler bei Tool-Aufrufen | 9.20% Fehlerquote auf OpenRouter | Fehlgeschlagene Aufrufe werden meist wiederholt, und Wiederholungen werden erneut berechnet |
| Fehler bei strukturierter Ausgabe | 10.38% Fehlerquote | Pipelines mit striktem Schema wiederholen etwa jeden 10. Aufruf |
| Lange Latenz-Ausreißer | P50 Ende-zu-Ende 12.48s, P90 76.17s | Gut für Batch-Labeling, langsam für alles, worauf eine Person wartet |
| Ein Anbieter | Together ist der einzige Host, 99.48% Verfügbarkeit | Kein Ausweichanbieter, wenn Together eine schlechte Stunde hat |
| Research Preview | Elorians eigene Bezeichnung | Preise und Verhalten können sich ändern, und es gibt noch keine Batch-Stufe |
Die Fehlerquoten würde ich am genauesten beobachten. Bei einer Wiederholungsquote von 10 % liegt Ihr effektiver Preis etwa 10 % über dem, was der Rechner angibt, und bei Aufrufen mit viel Reasoning wiederholt ein Retry den teuren Teil. Wenn Sie strukturierte Daten aus Bildern extrahieren, validieren Sie früh und begrenzen Sie die Wiederholungen.
Zum Punkt „Open Weights“: Glimpse ist auf einem Open-Weights-Basismodell nachtrainiert, aber die Glimpse-Gewichte selbst sind nicht öffentlich. Elorians Hugging-Face-Seite listet keine Modelle. Selbst hosten ist heute keine Option. Am nächsten kommt ein dediziertes Deployment bei Together, dessen Preisseite dedizierte H100 für $5.49 pro GPU und Stunde auf Abruf nennt. Das lohnt sich nur bei stetigem, hohem Volumen, und Sie würden es über das Vertriebsteam von Together vereinbaren.
Was kostet Glimpse bei echten Workloads?
Hier sind drei durchgerechnete Beispiele mit Elorians Preisen. Wo ich Token-Größen annehmen musste, sage ich das.
1. Roboterplanung, mit Elorians eigenen Kosten pro Episode. Bei $0.035 pro Episode kosten 1.000 Planungsepisoden $35 mit Glimpse gegenüber $249 mit GPT-6 Astra. Das ist das einzige Beispiel mit von Elorian gemessenen statt angenommenen Token-Zahlen, also das vertrauenswürdigste. Es ist auch der Anwendungsfall, über den Elorian und seine Investoren am meisten sprechen, neben Gemini Robotics 2 und Gemini 4 Argon.
2. Video-Labeling bei 10.000 Clips im Monat. Nehmen Sie 20.000 Eingabe-Token pro Clip und 3.000 Ausgabe-Token an, ohne Caching, weil jeder Clip neu ist. Das sind $210 im Monat mit Glimpse und $262.50 mit Gemini 3.8 Flash zu heutigen Preisen. Braucht Glimpse das 2,3-Fache an Token, um knifflige Abschnitte erneut anzuschauen, werden es $483, und Flash ist bis Januar günstiger.
3. Ein Screenshot-Leser für Support-Tickets. Nehmen Sie 5.000 Tickets im Monat mit je einem Screenshot an, etwa 3.000 Eingabe-Token und 800 Ausgabe-Token pro Ticket. Mit Glimpse sind das grob $21 im Monat. Mit Claude Opus 5.5 sind es $140. In dieser Größenordnung ist die Modellrechnung ein Rundungsfehler gegenüber dem Entwicklungsaufwand, das Modell an Ihr Helpdesk anzubinden, und das sind die echten Kosten, die ich im Leitfaden zu den Kosten für KI im Kundenservice untersuche.
Das Muster in allen dreien: Glimpse ist am günstigsten, wenn die Aufgabe sein sorgfältiges Hinschauen braucht, und die Ersparnis schrumpft, wenn die Aufgabe so einfach ist, dass ein günstigerer Leser in weniger Schritten ans Ziel gekommen wäre.
Für wen lohnt sich Glimpse?
Glimpse ist ein gutes Angebot, wenn das visuelle Reasoning das Produkt ist. Roboteraufnahmen labeln, Objekte über eine bewegte Kamera hinweg zählen, prüfen, ob ein Schritt in einem Video tatsächlich stattgefunden hat: Bei diesen Aufgaben zeigt Elorians eigene Tabelle, dass es Modelle erreicht oder schlägt, die 6x bis 16x mehr kosten. Ein Tester hat die offene Frage gut formuliert:
"Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing."
Wenn das Ihr Problem ist, lässt sich der Preis leicht rechtfertigen, und im kostenlosen Chat können Sie es an Ihrem eigenen Material prüfen, bevor Sie etwas ausgeben.
In drei Fällen würde ich es auslassen oder zumindest zuerst hart testen. Erstens beim einfachen Bildlesen wie OCR oder „welches Produkt ist auf diesem Foto“, wo Gemini 3.8 Flash oder ein günstiges DeepSeek-Modell mit weniger Token antwortet. Zweitens bei allem, worauf ein Kunde in Echtzeit wartet, wegen der langen Latenz-Ausreißer. Drittens bei Pipelines mit striktem Schema, bis die Fehlerquote von 10 % bei strukturierter Ausgabe sinkt.
Für alles dazwischen gilt: Verstehen Sie $0.60 und $3 als Obergrenze für den Preis pro Token, nicht als Prognose Ihrer Rechnung, und setzen Sie von Anfang an ein Reasoning-Budget. Der Leitfaden zur LLM-Optimierung behandelt die weiteren Regler, an denen sich zu drehen lohnt.
Wo eesel ins Spiel kommt
Glimpse ist Infrastruktur: ein sehr fähiges Augenpaar, das Sie aus Ihrem eigenen Code aufrufen. Wenn Sie Vision-Modelle oder eine rohe Customer-Service-API prüfen, weil Kunden ständig Screenshots und Fotos an Ihre Support-Warteschlange schicken, ist das Modell der kleinste Teil dessen, was Sie brauchen. Sie brauchen weiterhin die Helpdesk-Anbindung, das Wissen, die Leitplanken und eine Möglichkeit zu wissen, dass es korrekt antwortet, bevor es mit einem Kunden spricht.
Genau diesen Teil übernimmt eesel. Das KI-Helpdesk-Teammitglied von eesel schaltet sich in Ihr bestehendes Helpdesk ein, etwa Zendesk oder Freshdesk, lernt aus Ihren vergangenen Tickets und dem Help Center und wird vor dem Livegang an Ihren historischen Tickets simuliert, sodass Sie seine Antworten sehen, bevor Ihre Kunden sie sehen. Wenn Sie speziell Modelle für den Support vergleichen, ist die Übersicht der besten Modelle für Support-Tickets eine gute nächste Lektüre.
Testen Sie eesel kostenlos und sehen Sie, was es auf Ihre eigenen Tickets antworten würde.
Häufig gestellte Fragen
Wie viel kostet Elorian Glimpse?
$0.60 pro Million Eingabe-Token und $3.00 pro Million Ausgabe-Token. Auf OpenRouter kosten gecachte Eingabe-Lesezugriffe $0.06 pro Million, weshalb der dort durchschnittlich gezahlte Eingabepreis bei etwa $0.16 liegt. Zum Vergleich: Gemini 3.8 Flash Preise mit $0.75 und $3.75.Ist Elorian Glimpse kostenlos nutzbar?
Ist Glimpse wirklich 94 % günstiger als GPT-6 Astra?
$0.60 und $3 gegenüber $10 und $50 bei Astra. Pro Aufgabe ist der Abstand kleiner. In Elorians eigenem Beispiel zur Roboterplanung kostete Glimpse $0.035 gegenüber $0.249 bei Astra, also 86 % weniger, weil Glimpse vor der Antwort mehr liest. Die Aufschlüsselung der GPT-6 Astra Preise enthält die vollständige Preisliste von Astra.Berechnet Glimpse Reasoning-Token?
$3 pro Million abgerechnet. Im öffentlichen Traffic von OpenRouter für Glimpse machte das Reasoning etwa 81 % aller Ausgabe-Token aus. Das Begrenzen des Reasonings ist daher der größte Hebel für Ihre Rechnung. Dieselbe Regel gilt für die meisten Denkmodelle, darunter Claude Opus 5.5.Wo kann ich Glimpse-API-Zugang kaufen?
$0.60 und $3. Ein dediziertes Deployment wird stattdessen pro GPU-Stunde berechnet, wie andere Optionen in diesem API-Vergleich.