

Was Microsoft-Decision-1 eigentlich ist
Microsoft-Decision-1 ist ein kleines Modell, das keinen Text schreibt. Sie geben ihm eine Situation und eine feste Menge an Antwortoptionen, und es liefert für jede Option eine kalibrierte Wahrscheinlichkeit zurück. Microsoft hat es am 9. Oktober 2026 in Microsoft Foundry und über OpenRouter veröffentlicht, mit einem Launch-Beitrag von Satya Nadella auf X.
Es gehört zu einer schnell wachsenden Kategorie von Entscheidungsmodellen, neben TypeSafe Jev, Cloudflare Clef und Strands Decider. Microsoft hat es durch Post-Training von Alibabas Open-Weight-Modell Qwen3.5-9B gebaut (zur Modellfamilie siehe Qwen-Preise) und sagt, man werde es „bald auf anderen Modellen aufsetzen, darunter Microsoft AI (MAI) und OpenAI“.
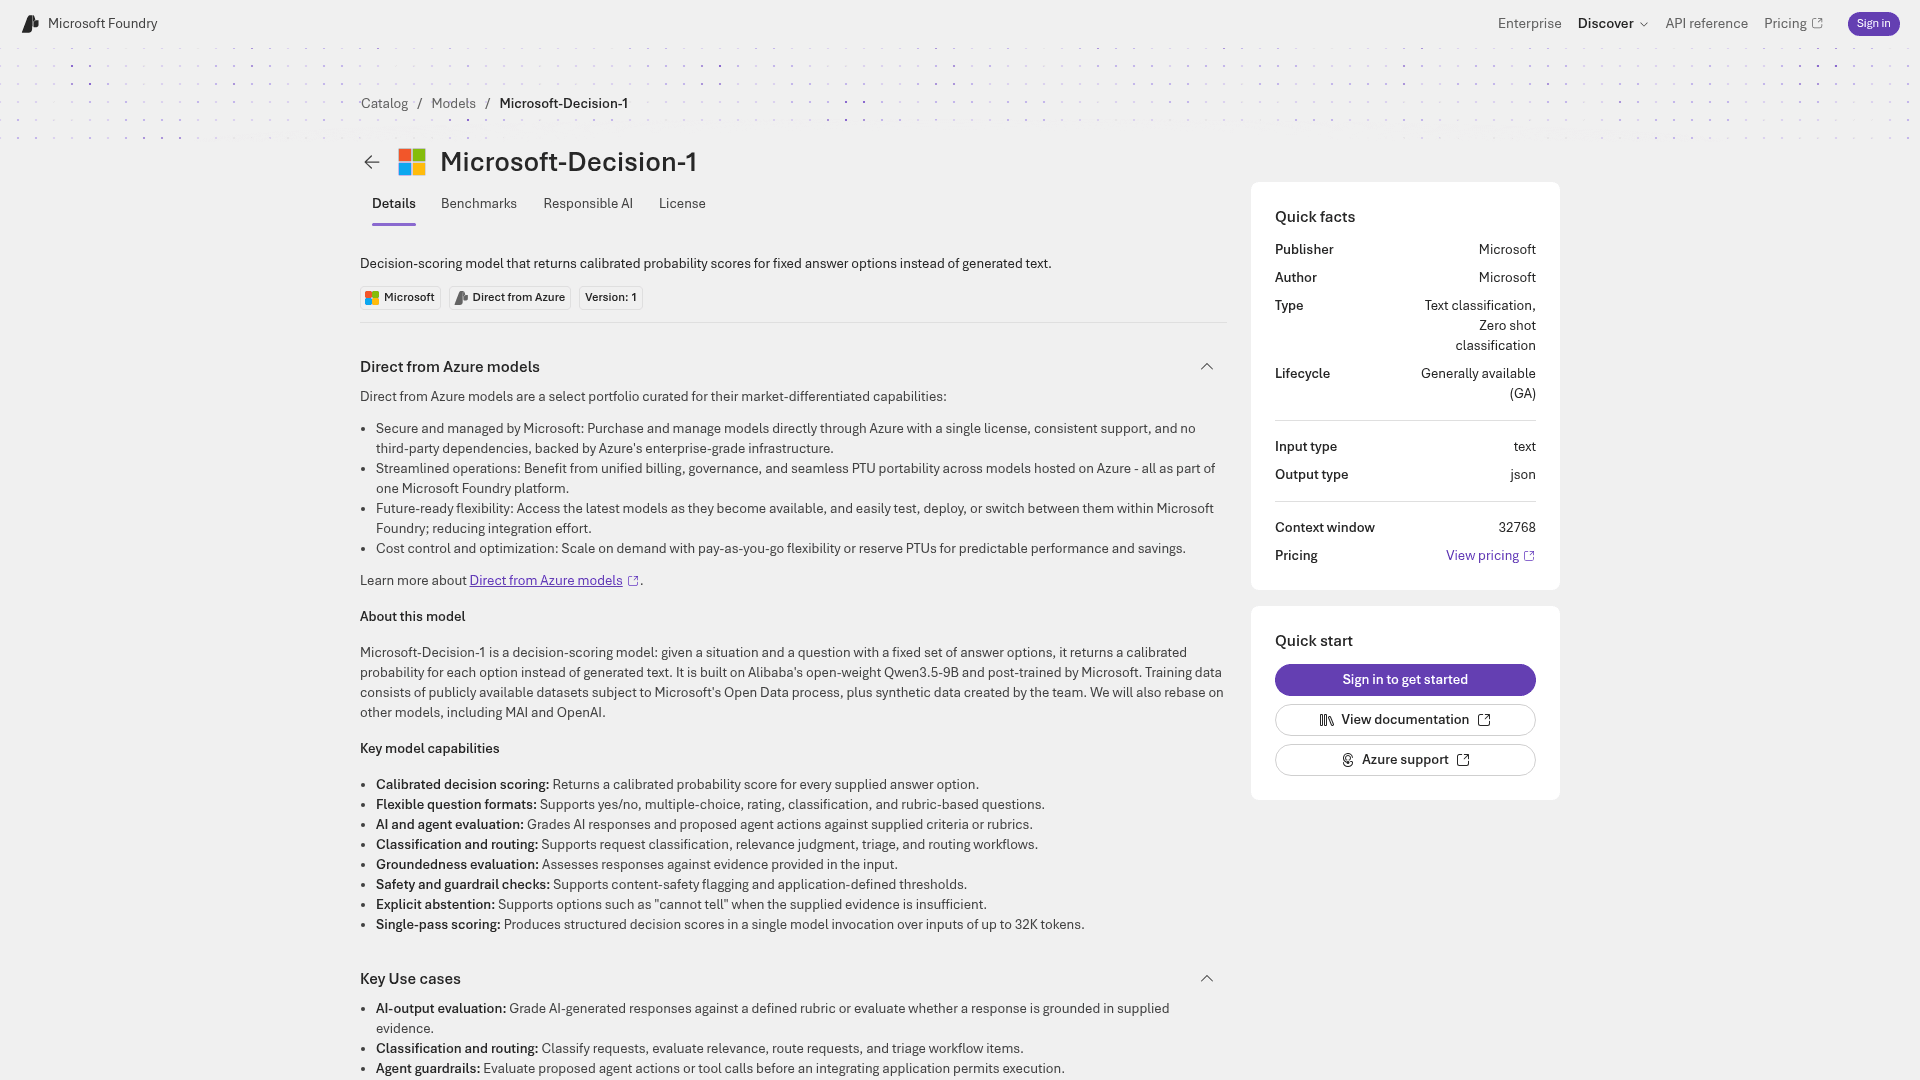
Die wichtigsten Fakten aus der Foundry-Modellkarte:
- Lebenszyklus: „Generally available (GA)“, Version 1, verkauft „Direct from Azure“
- Kontextfenster: 32.768 Tokens
- Input / Output: Text rein, JSON raus. Keine Erklärungen oder Begründungen
- Fragetypen: Ja/Nein, Multiple Choice, Bewertung und rubrikbasierte Benotung
- Gewichte: nicht veröffentlicht. Der Hugging-Face-Pfad liefert einen 404-Fehler
Ich baue beruflich Integrationen und APIs, und diese Form ist mir vertraut. Der Großteil dessen, was ein KI-Support-Agent den ganzen Tag tut, ist kein Schreiben. Er beantwortet kleine Fragen: Ist das Abrechnung oder Technik, ist es dringend, ist der Kunde verärgert, ist der Entwurf sicher zum Senden. Ein Modell, das nur diese Fragen beantwortet, schnell und mit einem Konfidenzwert, ist nützlich. Beim Preis geht es darum, ob dieser Nutzen billig genug ist, um ihn bei jedem einzelnen Ticket abzurufen.
Wie viel kostet Microsoft-Decision-1?
Microsoft nennt es in einem Satz im Launch-Beitrag: „Input tokens cost $0.042 USD per million tokens. Output tokens are free.“
| Posten | Preis | Hinweise |
|---|---|---|
| Input-Tokens | $0.042 pro 1M | Alles, was Sie senden: das Ticket, die Fragen, die Optionen |
| Output-Tokens | Kostenlos | Die zurückkommenden Wahrscheinlichkeiten |
| Kostenloser Tarif | Keiner modellspezifisch | Das allgemeine Azure-Guthaben von $200 / 30 Tage gilt für neue Konten |
| Batch-Rabatt | Nicht veröffentlicht | |
| Rabatt auf Cached Input | Nicht veröffentlicht | |
| Provisioned Throughput (PTU) | Nicht veröffentlicht | Der Katalog erwähnt PTUs nur im allgemeinen „Direct from Azure“-Text |
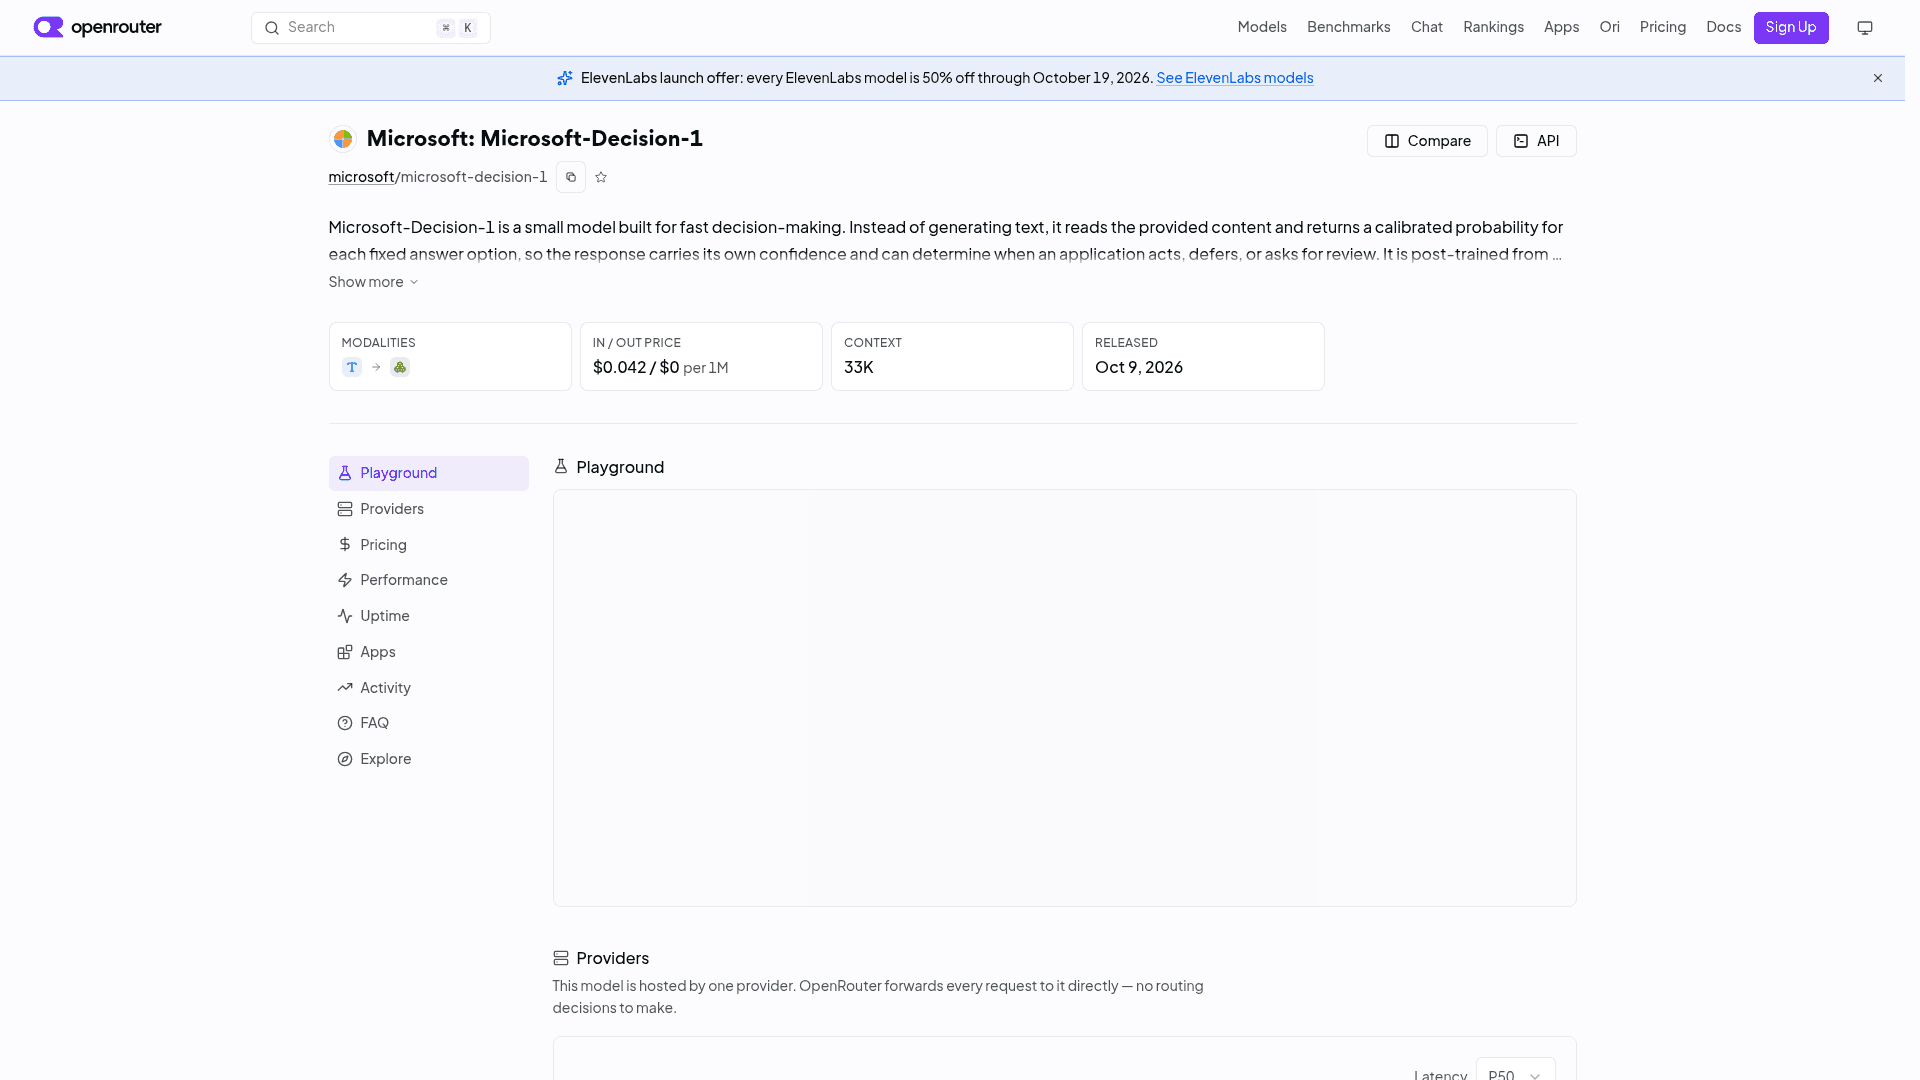
| OpenRouter | $0.042 ein / $0 aus | Ein Anbieter: Azure |
Kostenloser Output ist wichtiger, als es aussieht. Bei einem LLM kostet Sie eine Klassifizierungsantwort Output-Tokens, und Output wird meist mit dem 5-Fachen des Inputs oder mehr berechnet. Hier ist die Antwort kostenlos, sodass die Rechnung allein davon abhängt, wie viel Text Sie senden.
Wo Sie bezahlen
Es gibt zwei Zugänge, und sie kosten dasselbe:
- Microsoft Foundry. Abrechnung über Ihr Azure-Abonnement. Laut Microsoft Learn werden von Azure verkaufte Modelle „über Ihr Azure-Abonnement abgerechnet, von Azure-Service-Level-Agreements abgedeckt und von Microsoft unterstützt“ (Microsoft Learn).
- OpenRouter. Derselbe Preis von $0.042 Input und $0 Output, im Hintergrund von Azure bereitgestellt. Die OpenRouter-Seite zeigt über die ersten Tage einen gewichteten Durchschnittspreis von $0.04152 pro Million Input-Tokens (OpenRouter).
Wenn Ihr Unternehmen bereits auf Azure läuft oder bereits Azure-OpenAI-Modelle einkauft, ist Foundry der naheliegende Weg: eine Rechnung, bestehender Einkauf und das Azure-SLA. OpenRouter ist der schnellere Weg für einen Prototyp, da Sie das Azure-Setup komplett überspringen.
Microsoft-Decision-1 vs. Jev vs. Clef vs. OpenAI: Preis pro Token
Microsofts Launch-Beitrag vergleicht die Kosten nur mit GPT-6 Sol. Daher stammt die Aussage „200-mal günstiger“. Die Zahl ist fair, vergleicht aber ein schmales Entscheidungsmodell mit einem allgemeinen Flaggschiff-Modell, so als würde man den Preis eines Taschenrechners mit dem eines Laptops vergleichen.
Der Vergleich, der zählt, ist der mit den anderen Entscheidungsmodellen. Hier sind die aktuellen Preislisten, Stand 11. Oktober 2026:
| Modell | Anbieter | Input pro 1M | Output pro 1M | Kontext |
|---|---|---|---|---|
| Clef-flash | Cloudflare | $0.038 | keiner angegeben | 24.576 |
| Microsoft-Decision-1 | Microsoft | $0.042 | kostenlos | 32.768 |
| Jev 1.13 | TypeSafe | $0.042 | kostenlos | 64k pro Anfrage |
Decisions API (gpt-6-luna) | OpenAI | $0.10 | kostenlos | 1,05M |
| Clef | Cloudflare | $0.24 | keiner angegeben | 65.536 |
| Strands Decider 2B | AWS (Open Weights) | nur Self-Hosting | nur Self-Hosting | 3k bis 4k getestet |
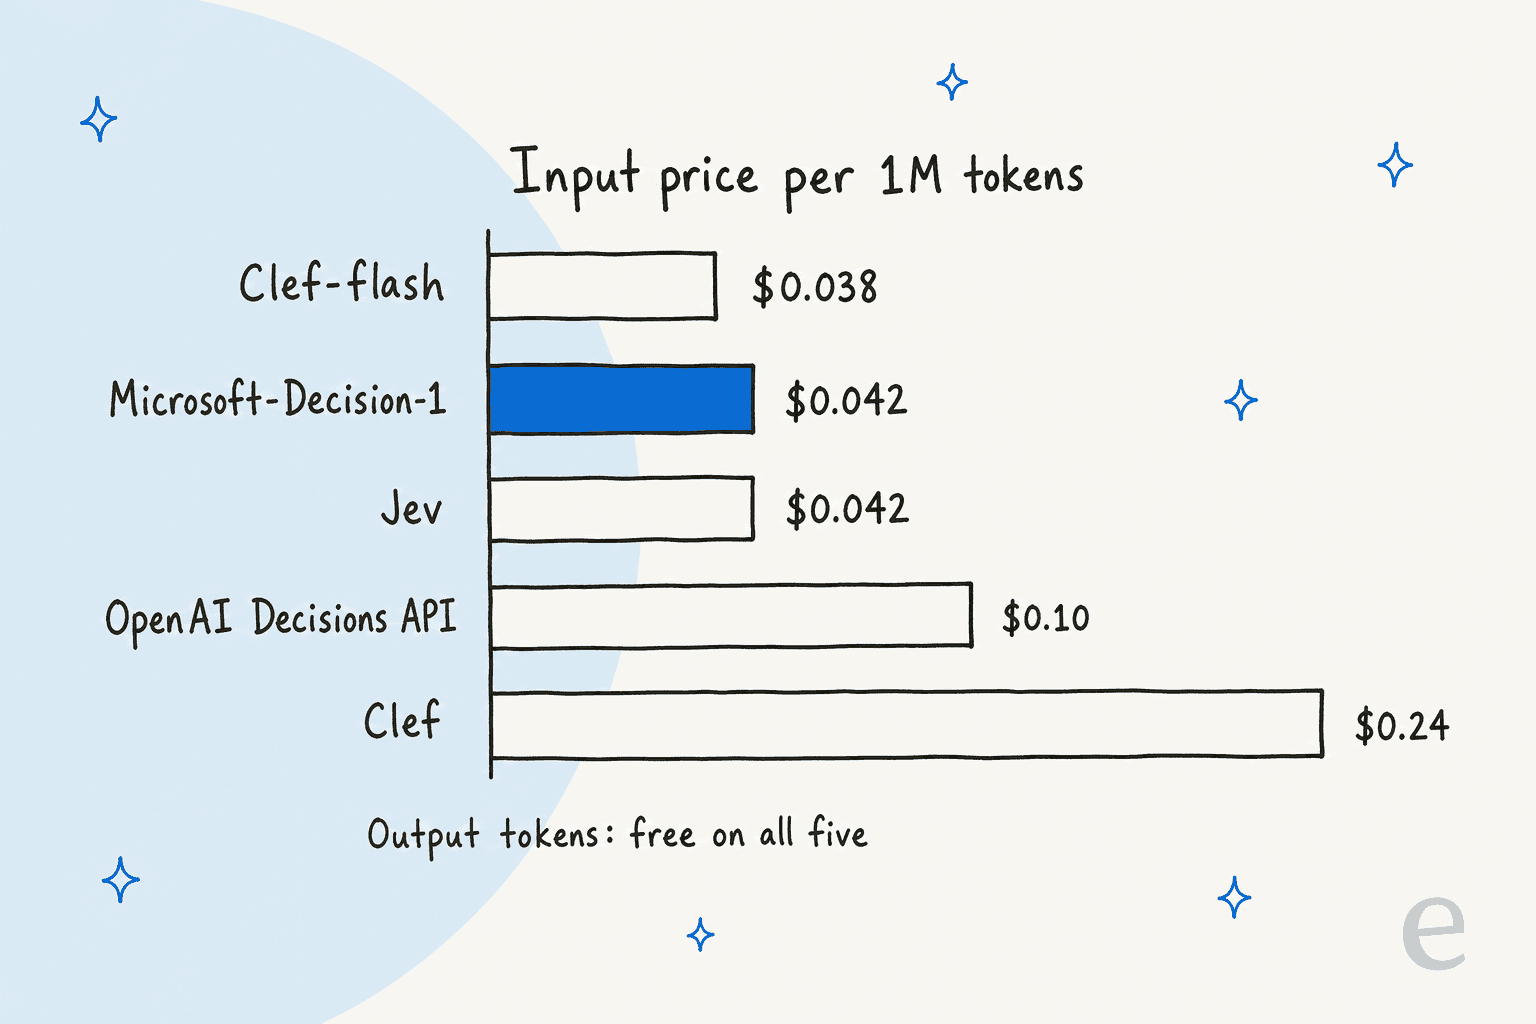
Drei Dinge fallen auf:
- Es liegt auf den Cent genau gleichauf mit Jev. Microsoft hat die Jev-Preise exakt übernommen, was in einem Markt, in dem Jev der Standard ist, kein Zufall sein dürfte.
- Es unterbietet OpenAI um das 2,4-Fache. Die Decisions API von OpenAI ging am 6. Oktober für $0.10 pro Million Input-Tokens in die öffentliche Beta.
- Es ist nicht mehr das günstigste. Cloudflare hat Clef-flash auf $0.038 gesenkt, mit einem kleineren Kontext von 24.576 Tokens. Das sind etwa 10 % weniger als bei Microsoft-Decision-1. Meine frühere Aufschlüsselung der Clef-Preise erklärt, wie Workers AI abrechnet.
Die Entwickler-Community bemerkte den fehlenden Vergleich sofort. Die oberste Antwort unter Nadellas Launch-Beitrag stellte die naheliegende Frage:
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoft aktualisierte den Beitrag später und nahm Jev in die Tabellen zu Genauigkeit und Kalibrierung auf, aber das Kostendiagramm zeigt weiterhin nur GPT-6 Sol. Auf Hacker News formulierte ein Kommentator die Preiskritik unverblümt:
"Looks like yet another non-price-competitive Jev competitor. Microsoft only compares the price of theirs to GPT Sol(!), not GPT Terra, or GPT Luna (which is what OpenAI's Jev wannabe is based on), and certainly not Jev (4/10 the cost of Luna). I can't remember when a new product created So many competitors so quickly. What is very clear is that everyone is saying "Doh!", slapping themselves on the forehead, and scrambling to get a slice of this obvious-in-retrospect massive pie. What no-one appears to have done yet is to come close to Jev on pricing!"

Dieser Kommentar entstand, bevor der Preis breit bekannt war. Tatsächlich kam Microsoft beim Preis an Jev heran: Es hat ihn gematcht.
Pro Token ist nicht pro Entscheidung
Hier der Haken, der Preislisten weniger aussagekräftig macht, als sie wirken. Jedes Modell tokenisiert und formatiert Ihre Anfrage anders, sodass dasselbe Ticket je Modell eine andere Anzahl Tokens kosten kann. Den einzigen praktischen Vergleich, den ich fand, lieferte ein Hacker-News-Nutzer, der Microsoft-Decision-1 in seiner eigenen Testreihe gegen Jev laufen ließ:
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release. Qwen tunes are nice and all but either price or performance makes each example I have tested not viable unless you are able to cheaply self-host and fine-tune further."
Gleiche Preisliste, andere echte Rechnung. Das ist die Testreihe einer einzelnen Person, kein Benchmark, aber der Instinkt ist richtig: Lassen Sie Ihre eigenen Tickets durch beide Modelle laufen und vergleichen Sie die Rechnung, nicht die Preisseite.
Was eine Entscheidung wirklich kostet
Da der Output kostenlos ist, brauchen Sie nur eine Zahl: wie viele Input-Tokens jeder Aufruf enthält. Das sind der Tickettext plus Ihre Fragen und deren Optionsbeschreibungen.
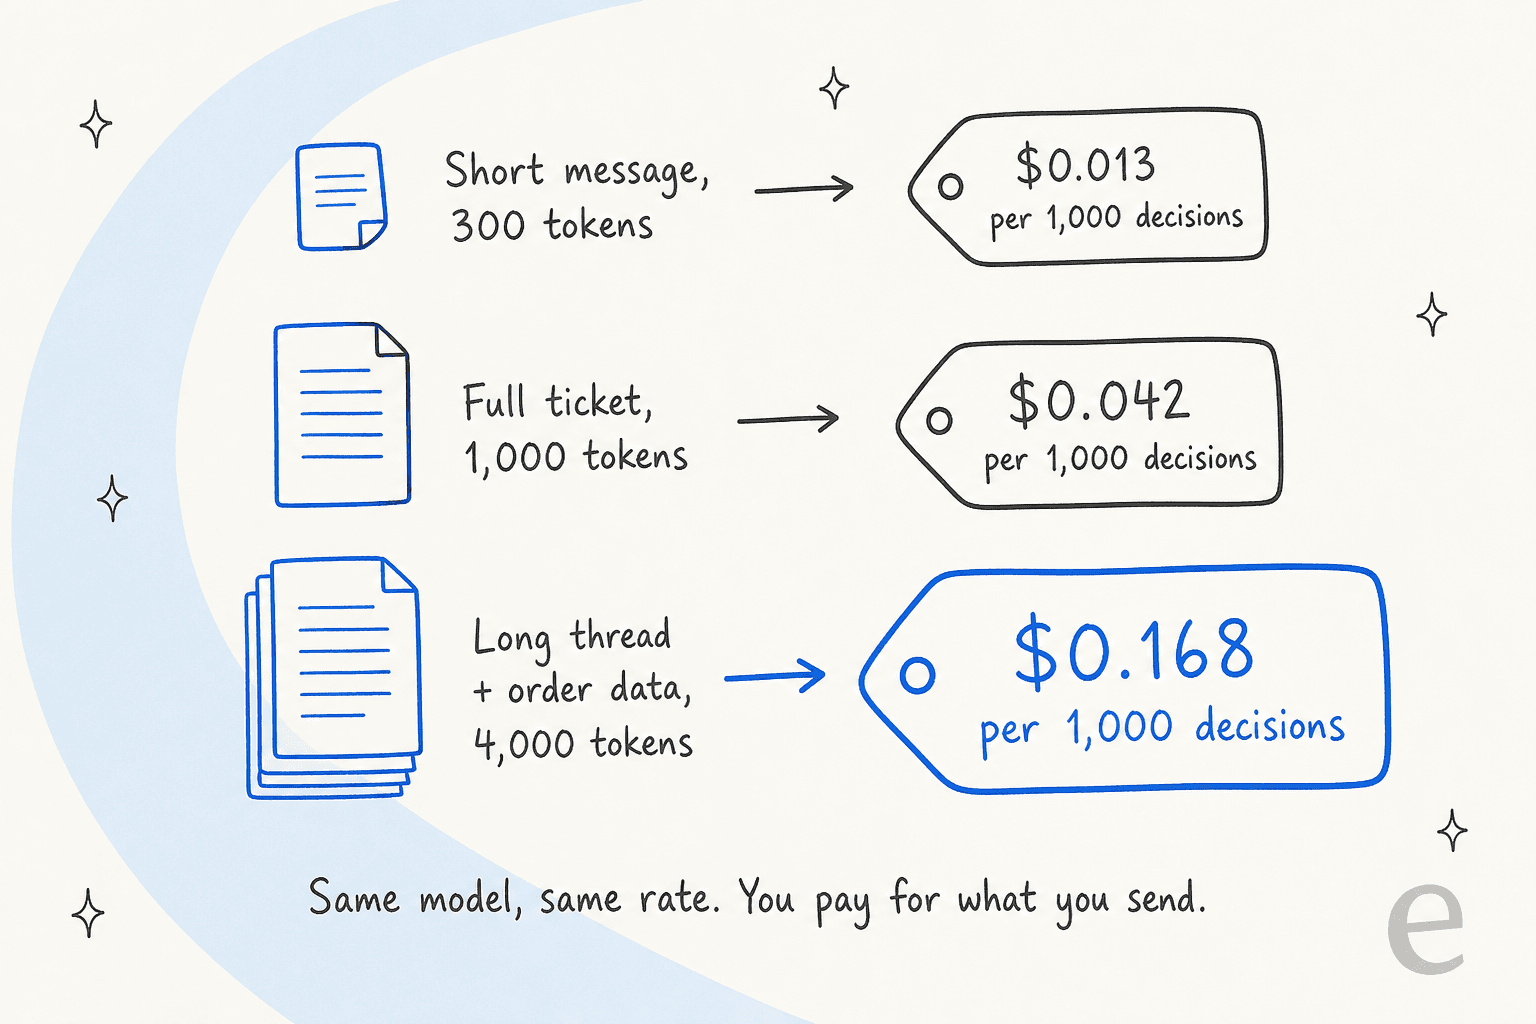
Microsofts eigene Schätzung: Die Klassifizierung von einer Million Texten kostet auf Microsoft-Decision-1 etwa $11, auf GPT-6 Sol etwa $2.434. Rückwärts gerechnet bei $0.042 pro Million Tokens ergibt das etwa 260 Input-Tokens pro Text in ihrem Test. Support-Tickets sind meist länger, und ein langer Thread mit angehängter Bestellhistorie kann mehrere tausend Tokens erreichen.
So viel zahlt ein Support-Team tatsächlich, bei zwei Entscheidungsaufrufen pro Ticket (zum Beispiel einer fürs Routing und einer für „sicher für Auto-Antwort?“):
| Team | Tickets / Monat | Tokens pro Aufruf | Tokens pro Monat | Microsoft-Decision-1 | OpenAI Decisions API | Clef |
|---|---|---|---|---|---|---|
| Kleines Team | 2.000 | 1.000 | 4M | $0.17 | $0.40 | $0.96 |
| Mittelgroß | 10.000 | 1.500 | 30M | $1.26 | $3.00 | $7.20 |
| Große Warteschlange | 100.000 | 2.000 | 400M | $16.80 | $40.00 | $96.00 |
Die Clef-Werte gelten zum Listenpreis, vor dem täglichen Freikontingent von Cloudflare. So oder so kostet eine Warteschlange mit 100.000 Tickets weniger als $20 im Monat zur Bewertung. An diesem Punkt ist nicht das Modell Ihr Kostenfaktor, sondern der Engineering-Aufwand, die Pipeline drumherum zu bauen, zu testen und zu warten.
Ein weiterer Hebel: Ein einzelner Aufruf kann mehrere benannte Fragen zum selben Ticket enthalten (OpenRouter). Wenn Sie „welches Team“, „wie dringend“ und „ist es Spam“ in einer Anfrage stellen, zahlen Sie den Tickettext einmal statt dreimal. Bündeln ist der einfachste Weg, die Rechnung zu senken, und die günstigste LLM-Optimierung, die Sie je machen werden.
Schätzen Sie Ihre eigenen Microsoft-Decision-1 Kosten
Tragen Sie Ihr Volumen, die durchschnittlichen Tokens pro Aufruf und die Zahl der Aufrufe pro Ticket ein. Der Rechner bepreist alle fünf gehosteten Entscheidungsmodelle zu ihren Listenpreisen.
Preisfallen, auf die Sie achten sollten
Die Preisliste ist einfach. Das Kleingedruckte drumherum ist dünn, und genau das ist die Falle. Prüfen Sie einige Dinge, bevor Sie darauf bauen:
- Es steht noch nicht auf der Azure-Preisseite. Der Link „View pricing“ im Katalog führt zur Preisseite für Foundry-Modelle, die andere Microsoft-Modelle auflistet, aber Stand 11. Oktober keine Zeile für Microsoft-Decision-1 enthält. Die $0.042 stammen aus dem Launch-Beitrag und von OpenRouter.
- Keine veröffentlichten regionalen oder Provisioned-Preise. Auf derselben Azure-Seite kostet Microsofts MAI-DS-R1 bei regionalen Deployments das 1,1-Fache im Vergleich zu globalen. Nichts bestätigt, ob Microsoft-Decision-1 demselben Muster folgt. Prüfen Sie das also, bevor Sie eine Option zur Datenresidenz wählen.
- Keine Regionenliste und keine Kontingente. Das Modell fehlt auf Microsofts Seite zur Regionenverfügbarkeit, und Ratenlimits sind nicht dokumentiert.
- Ihr Chat-SDK funktioniert nicht. Auf OpenRouter läuft es über einen separaten Decisions-Endpunkt, und „chat completions SDKs will not work with it.“ Zum Start schrieb ein Entwickler, der es in Foundry bereitgestellt hatte: „it doesn't say what to POST or what to expect back“ (wkcheng, Hacker News). Planen Sie Integrationszeit ein.
- Die Gewichte ändern sich unter Ihnen. OpenRouter vermerkt: „weights are updated continually while the API shape stays the same.“ Wenn Sie einen Konfidenz-Schwellenwert wie „Auto-Routing ab 0.85“ setzen, prüfen Sie ihn nach Updates erneut.
- Die Obergrenze von 32.768 Tokens. Lange E-Mail-Threads mit eingefügten Anhängen können sie überschreiten. Sie müssen kürzen, und Kürzungslogik ist ebenfalls Engineering-Aufwand.
Nichts davon ist ein K.-o.-Kriterium. Es ist der Normalzustand eines Modells, das zwei Tage alt ist. Aber „GA“ auf der Modellkarte und „nicht auf der Preisseite“ bei Azure ist eine Kombination, die eine kurze E-Mail an Ihren Azure-Ansprechpartner wert ist, bevor Sie Volumen zusagen.
Ist es genau genug, um den Preis zu rechtfertigen?
Der Preis zählt nur, wenn die Antworten stimmen. Microsofts Zahlen sind stark, aber es sind Microsofts eigene Tests. Im Vergleich über 36 Benchmarks (147.137 Fragen) meldet Microsoft eine durchschnittliche Genauigkeit von 83,5 %, vor Jev 1.13.0 mit 82,3 % und GPT-6 Luna Decisions mit 79,4 %. Bei der Kalibrierung liegt es mit 92,2 auf Platz drei, gegenüber 93,7 bei Jev.
| Modell | Ø Genauigkeit | Mediane Latenz | Kalibrierung |
|---|---|---|---|
| Microsoft-Decision-1 | 83,5 % | 85 ms (p95 125 ms) | 92,2 |
| Jev 1.13.0 | 82,3 % | 240 ms | 93,7 |
| GPT-6 Luna Decisions | 79,4 % | 300 ms | 89,9 |
| GPT-6 Sol (Referenz) | nicht gerankt | 3,01 s | nicht bewertet |
Quelle: Launch-Beitrag von Microsoft, alle Zahlen von Microsoft erhoben. Microsofts Latenz wurde über Foundry in derselben Region gemessen, die übrigen stammen aus JevBench.
Zwei unabhängige Prüfungen sind erwähnenswert. OpenRouters eigene Messung zeigt eine p50-Latenz von 0,19 Sekunden, langsamer als Microsofts 85 ms, was plausibel ist, da Netzwerksprünge enthalten sind. Und Microsoft-Decision-1 taucht bislang nicht im von der Community betriebenen Jev Decision Index auf, wo der Decider von Perplexity und Jev die ersten beiden Plätze belegen.
Wenn Sie mit Wahrscheinlichkeiten Schwellenwerte setzen, ist die Kalibrierung wichtiger als die Genauigkeit. Ein Hacker-News-Nutzer fasste diesen Zielkonflikt so zusammen: „if you need calibration better use JEV“ (nowittyusername). Der Abstand beträgt 1,5 Punkte, was wenig ist, aber zugunsten von Jev ausfällt.
Microsoft teilte auch interne Ergebnisse: Das Microsoft-Copilot-Team fand das Modell „competitive with GPT5.6 Luna and 100 times faster“, und Xbox Research stellte bei über 10.000 Feedback-Einträgen fest, es sei „200 times less expensive“ als GPT-6 Sol. Nützliche Signale, aber wieder selbst berichtet. Wenn Sie es gegen ein kleines allgemeines Modell abwägen, deckt mein Beitrag zu GPT-5.6 Luna diese Seite ab.
Lohnt sich Microsoft-Decision-1 für Support-Teams?
Bei $0.042 pro Million Tokens spielt der Preis des Modells keine Rolle mehr. Die eigentliche Frage ist, ob Sie das System drumherum selbst bauen wollen.
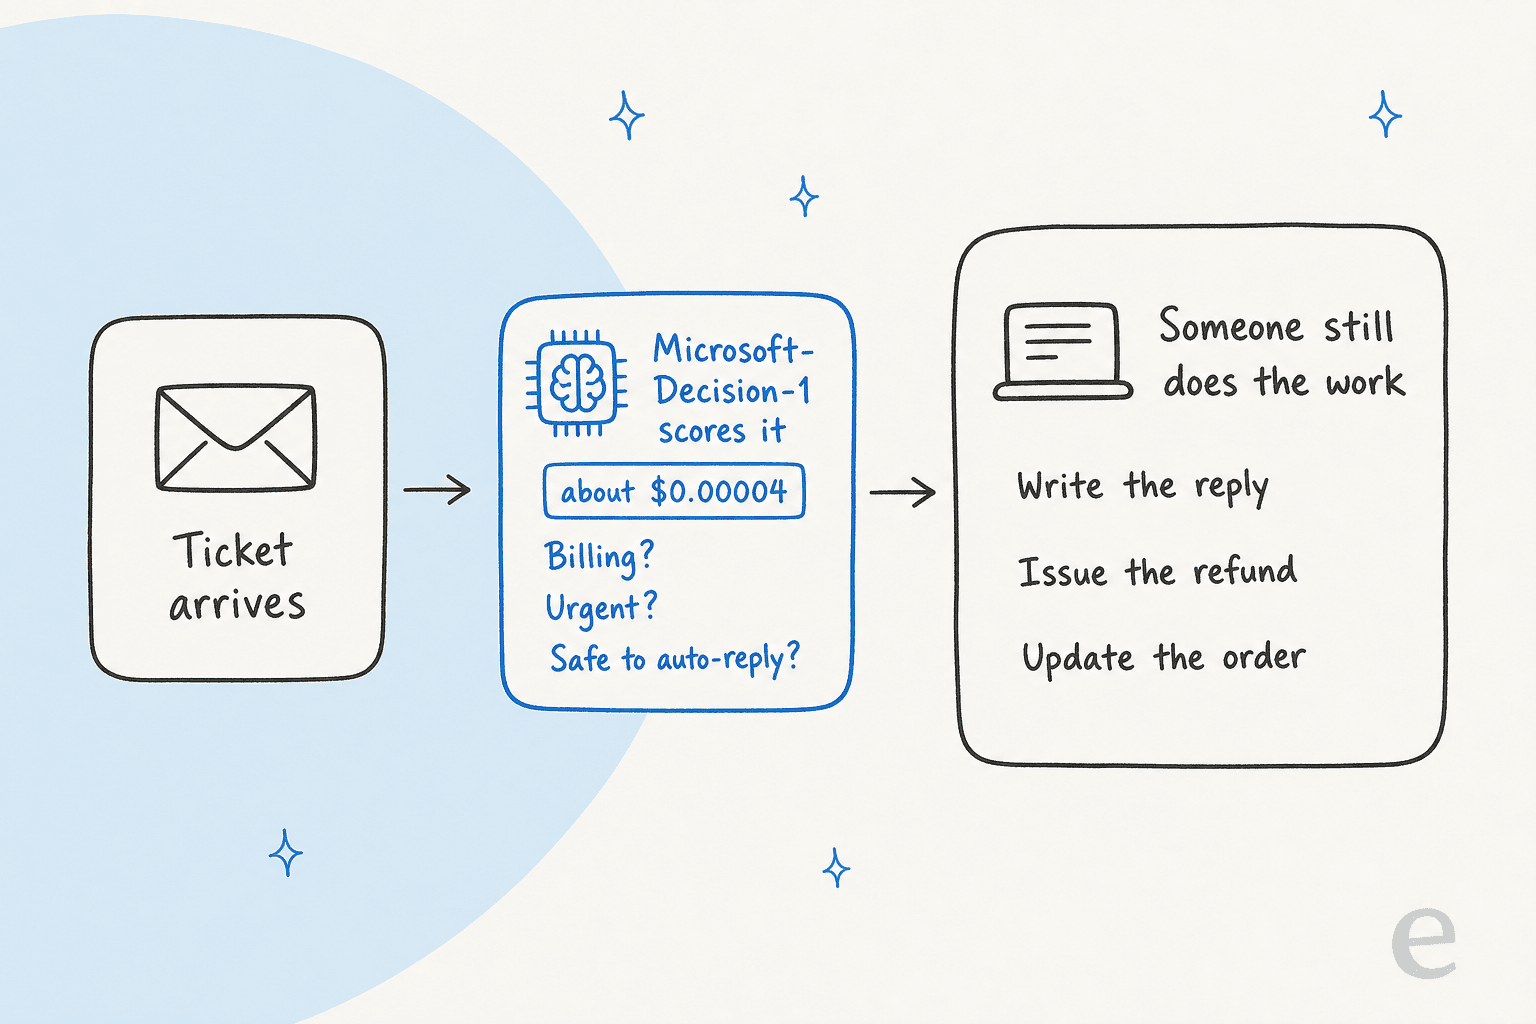
Es liefert Ihnen den Sortierschritt der Ticket-Triage: welche Warteschlange, wie dringend, ist es Spam, ist dieser KI-Entwurf sicher zum Senden.
Was Sie weiterhin selbst bauen müssen, ist alles drumherum: das Ticket über Ihre Helpdesk-API abrufen, die Fragen formulieren (diese Triage-Prompt-Vorlagen sind ein guter Anfang), die Schwellenwerte setzen, anhand der Antwort routen und das Ticket dann tatsächlich lösen.
Dieser letzte Schritt ist der teure, und dort habe ich die echten Fehler gesehen. In einem Test mit echtem Traffic in einem E-Commerce-Zendesk-Postfach erreichte die Triage von eesel 93 % Genauigkeit und erkannte 100 % des Spams, während nur 12 % der KI-Entwürfe ohne Änderungen gesendet wurden. Sortieren ist die leichte Hälfte. Gut zu antworten ist die schwere Hälfte.
Der Wahrscheinlichkeitswert bleibt das Nützlichste an diesen Modellen. Ein CX-Leiter mit 7.000 Tickets im Monat formulierte die Anforderung in einem Verkaufsgespräch mit eesel klar:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eine kalibrierte Wahrscheinlichkeit ist genau das richtige Werkzeug dafür. Mein Fazit:
- Nutzen Sie Microsoft-Decision-1, wenn Sie Entwickler haben, bereits auf Azure laufen und Triage, Routing oder Guardrail-Prüfungen in Ihrem eigenen Produkt oder Ihrer Pipeline wollen.
- Nutzen Sie Jev oder Clef-flash, wenn Sie bei riesigem Volumen Kosten optimieren und nicht an Azure gebunden sind. Der Preisunterschied ist klein, testen Sie also zuerst die Genauigkeit mit Ihren eigenen Daten.
- Verzichten Sie aufs Selbstbauen, wenn Sie eigentlich Tickets sortiert und beantwortet in Ihrem Helpdesk wollen. Das ist ein Produkt, kein Modellaufruf, und Sie können die Ticket-Triage automatisieren, ohne Code zu schreiben. Siehe meine Übersicht der besten KI für Ticket-Triage.
eesel für die Entscheidung und alles, was danach kommt
Wenn Sie Microsoft-Decision-1 bepreisen, weil Sie Tickets geroutet, getaggt und priorisiert haben möchten, sollten Sie den Eigenbau überspringen. eesel ist ein KI-Teammitglied für Ihren Helpdesk. Es lässt sich in wenigen Minuten in Zendesk, Freshdesk, Gorgias und andere einbinden, lernt aus Ihren früheren Tickets und Ihrem Help Center und trifft dieselben Zendesk-Triage- und Eskalationsentscheidungen wie ein Entscheidungsmodell. Dann schreibt es die Antwort, aktualisiert die Bestellung oder übergibt an einen Menschen, wenn es sich nicht sicher ist.

Die Abrechnung erfolgt pro Ticket, nicht pro Token. Die Tarife von eesel beginnen bei $299 im Monat für 500 Credits, wobei ein Ticket oder ein Chat einem Credit entspricht, unabhängig davon, wie viele Schritte der Agent darin ausführt. Bei 5.000 Credits sind es $1,749 im Monat, also etwa 35 Cent pro Ticket. Das ist weit mehr als ein Entscheidungsaufruf, weil es die Arbeit einschließt, nicht nur das Sortieren. Im Vergleich zu den Kosten pro Ticket bei einem menschlichen Agenten sieht es anders aus; meine Aufschlüsselung zu KI vs. Mensch bei den Kosten rechnet diese Zahlen durch, und Zendesk-AI-Preise zeigen, was der native Add-on-Weg kostet. Vor dem Livegang können Sie den Agenten gegen Ihre historischen Tickets simulieren, um zu sehen, was er getan hätte. So würde ich ohnehin jedes dieser Modelle testen.
Wenn Sie Entwickler sind, gibt Ihnen die eesel CLI dasselbe Teammitglied im Terminal. npx @eesel/cli init chat-bubble --site <url> richtet einen Workspace ein, eesel integrations verbindet Ihren Helpdesk, eesel automations verdrahtet Routing-Regeln, und mit eesel approvals genehmigen oder lehnen Sie Aktionen ab, die der Agent zur Prüfung zurückgehalten hat. Es ist derselbe Agent wie im Dashboard, und jeder Befehl gibt JSON aus, sodass Claude Code, Cursor oder ein CI-Skript ihn steuern können. eesel mcp token stellt den Workspace außerdem als MCP-Server bereit. Das ist der praktische Unterschied zu einem Entscheidungsmodell: Das Modell gibt Ihrem Code eine Wahrscheinlichkeit, die CLI gibt Ihrem Code einen KI-Agenten, der darauf handelt.
Sie können eesel kostenlos testen, mit 100 Credits und ohne Karte. Verbinden Sie Ihren Helpdesk, richten Sie ihn auf eine Woche Tickets und vergleichen Sie sein Routing mit dem, was Ihre eigene Entscheidungs-Pipeline tun würde.
Häufig gestellte Fragen
Wie viel kostet Microsoft-Decision-1?
Microsoft-Decision-1 kostet $0.042 pro Million Input-Tokens, Output-Tokens sind kostenlos. Das ist heute die gesamte Preisliste von Microsoft-Decision-1: keine Stufen, keine Gebühr pro Nutzer. Zur Einordnung: Es entspricht auf den Cent genau den Jev-Preisen.
Ist Microsoft-Decision-1 kostenlos nutzbar?
Nein. Es gibt keinen modellspezifischen kostenlosen Tarif. Ein neues Azure-Konto erhält das allgemeine Azure-Guthaben von $200 für 30 Tage, das bei diesem Preis Millionen von Entscheidungen abdecken würde. Wenn Sie Tickets sortieren lassen möchten, ohne etwas zu bauen, sind Tools zur KI-Ticketklassifizierung ein anderer Weg.
Ist Microsoft-Decision-1 günstiger als Jev?
Laut Preisliste nein. Beide nennen $0.042 pro Million Input-Tokens bei kostenlosem Output. Clef-flash von Cloudflare ist inzwischen mit $0.038 etwas günstiger. Ein Hacker-News-Tester berichtete, dass Microsoft-Decision-1 in seiner eigenen Testreihe günstiger als Jev war. Das deutet darauf hin, dass die Token-Anzahl je Modell abweicht, testen Sie also mit Ihren eigenen Eingaben. Meine Übersicht zu Jev-Alternativen deckt das breitere Feld ab.
Wie schneiden die Microsoft-Decision-1 Preise gegenüber der OpenAI Decisions API ab?
Die Decisions API von OpenAI kostet $0.10 pro Million Input-Tokens bei gpt-6-luna, ebenfalls mit kostenlosem Output. Damit ist Microsoft-Decision-1 pro Token etwa 2,4-mal günstiger. Die Aufschlüsselung zu den Preisen der Decisions API enthält die Details.
Was kostet eine Entscheidung mit Microsoft-Decision-1?
Das hängt davon ab, wie viel Text Sie senden. Ein Support-Ticket mit 1.000 Tokens kostet etwa $0.000042 zur Bewertung, also 4,2 Cent pro 1.000 Tickets. Ein Thread mit 4.000 Tokens samt Bestelldaten kostet das Vierfache. Microsofts eigene Schätzung liegt bei rund $11 für die Klassifizierung von einer Million kurzer Texte. Unter Ticket-Triage steht, wofür diese Entscheidungen meist gebraucht werden.
Kann ich Microsoft-Decision-1 über OpenRouter kaufen?
Ja. OpenRouter führt es zum selben Preis von $0.042 Input und $0 Output, bereitgestellt von Azure. Es nutzt den Decisions-API-Endpunkt von OpenRouter, nicht den Chat-Completions-Endpunkt, daher funktioniert Ihr bestehender Chat-SDK-Code damit nicht ohne Anpassung.
Gibt es bei Microsoft-Decision-1 Batch- oder Cached-Input-Rabatte?
Nicht, soweit Microsoft das veröffentlicht hat. Das Modell steht noch nicht auf der Preisseite für Foundry-Modelle von Azure, und es gibt keinen veröffentlichten Preis für Provisioned Throughput, Batch oder Cached Input. Wenn Sie reservierte Kapazität einplanen, holen Sie zuerst ein Angebot bei Ihrem Azure-Account-Team ein. Für die weitere Kostenplanung siehe Kosten eines KI-Support-Agenten.
Lohnt sich Microsoft-Decision-1 für Kundensupport-Teams?
Für Routing und Triage im eigenen Produkt: ja, der Preis ist so niedrig, dass er kein Posten mehr ist. Die Kosten, die zählen, entstehen nach der Entscheidung, etwa beim Schreiben der Antwort oder beim Auslösen der Erstattung. Genau das übernimmt ein KI-Helpdesk-Agent wie eesel.