

Was ist Microsoft-Decision-1?
Microsoft-Decision-1 ist ein Modell zur Bewertung von Entscheidungen. Sie geben ihm einen Text (Microsoft und OpenRouter nennen ihn state) und eine oder mehrere Fragen mit einer festen Menge an Antworten. Es liefert für jede Antwort eine Wahrscheinlichkeit zurück. Das ist die gesamte Schnittstelle.
Microsoft hat es am 9. Oktober 2026 in einem Beitrag im Command-Line-Blog von Achint Srivastava, VP of Software Engineering im Office of the CTO, angekündigt. Laut Beitrag ist es gebaut für „Routing, Klassifizierung, Priorisierung, Verifizierung und Workflow-Steuerung“ (Microsoft). Satya Nadella postete den Launch am selben Tag und sagte, Microsoft teste es bereits intern bei Incident Response, Qualitätskontrolle und wissenschaftlicher Entdeckung (Satya Nadella auf X).
Falls Ihnen die Kategorie neu ist: Mein Erklärtext zu Entscheidungsmodellen liefert den Hintergrund. Kurz gesagt: TypeSafe Jev hat die Kategorie im September 2026 begründet, Cloudflare, AWS und OpenAI folgten innerhalb weniger Wochen, und Microsoft-Decision-1 ist der erste Beitrag eines Hyperscalers, der das Modell in seiner eigenen Cloud verkauft.
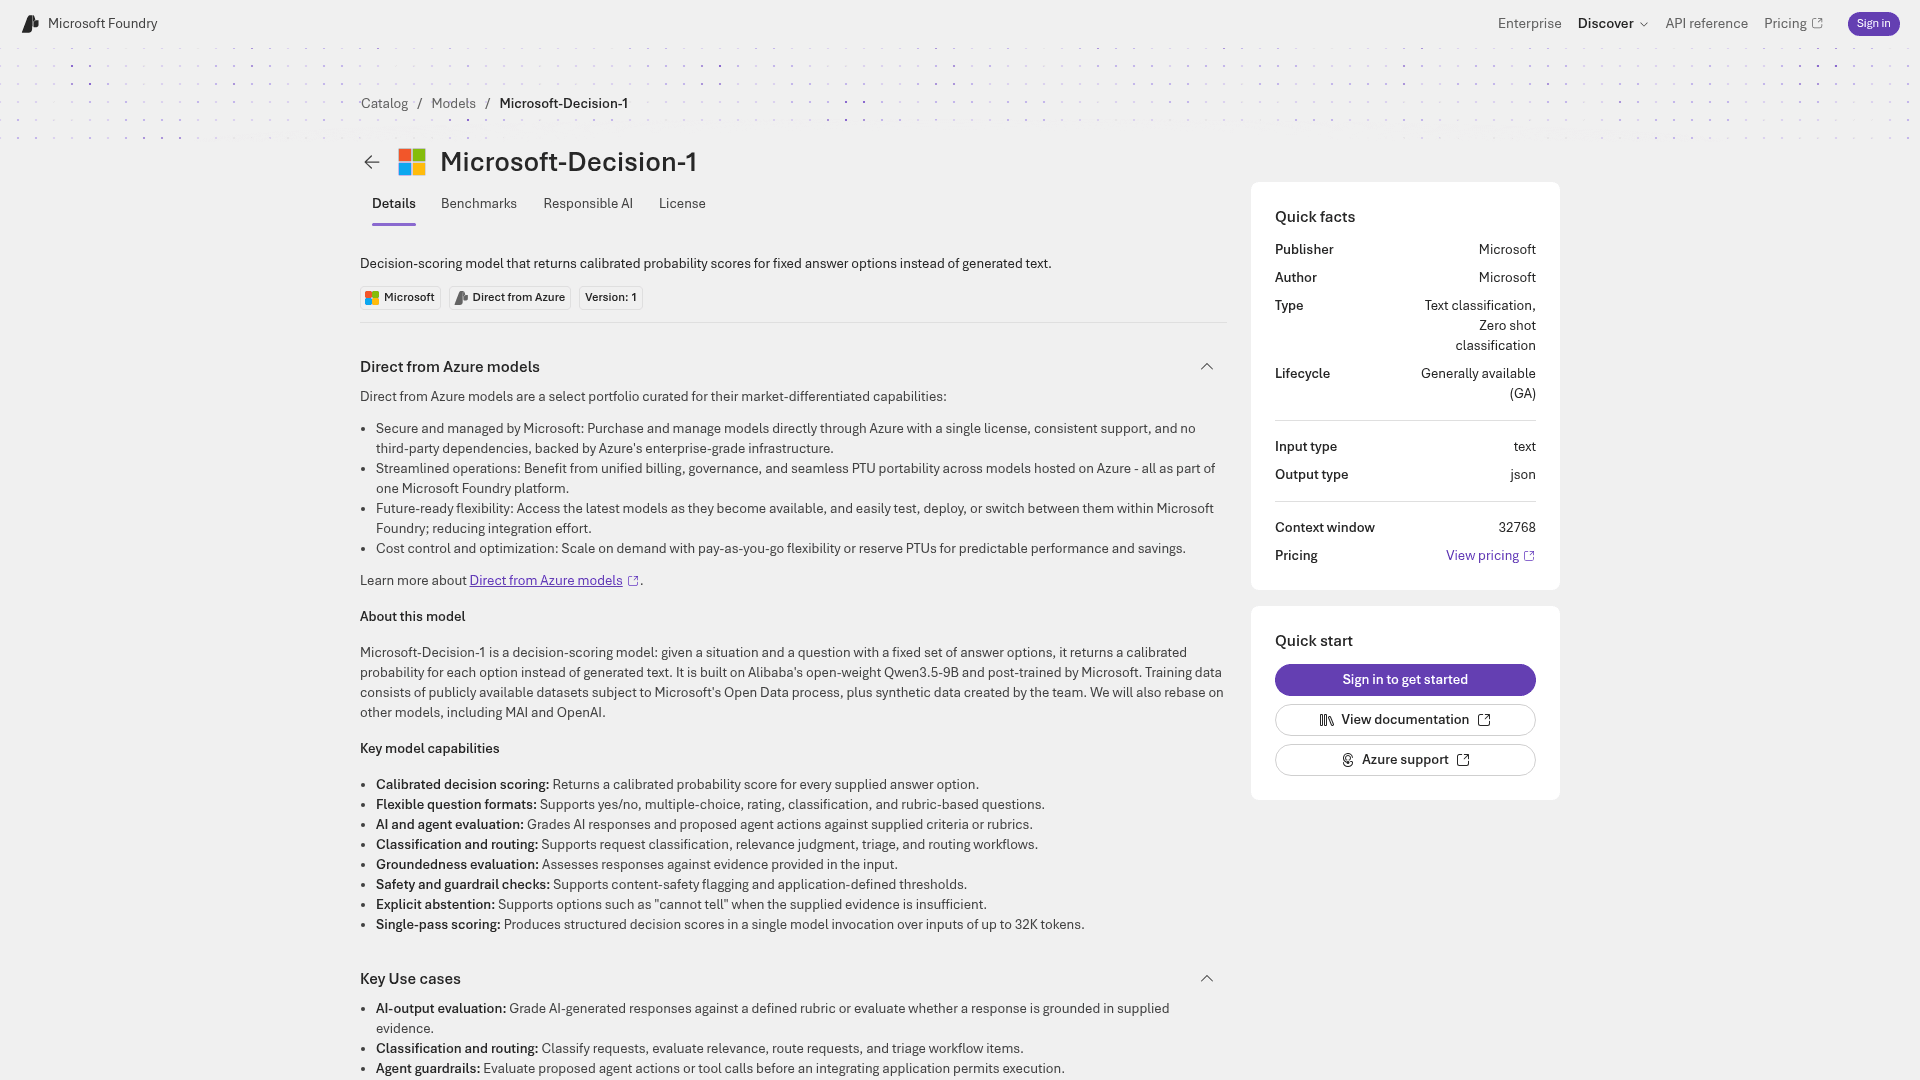
Was es nicht ist, ist genauso wichtig. Microsofts Modellkarte sagt, es sei „nicht für Textgenerierung, offene Fragebeantwortung, Konversation, Übersetzung oder Zusammenfassung gedacht“ (Foundry-Katalog). Es kann keine Antwort, keine Zusammenfassung und keine Codezeile schreiben. Es wählt aus.
Wie funktioniert Microsoft-Decision-1?
Ich baue täglich die Agentenseite von eesel, also habe ich diesen Teil als Erstes gesucht. Die Mechanik ist einfacher, als der Launch-Beitrag klingen lässt.
Microsoft hat Alibabas Open-Weight-Modell Qwen3.5-9B genommen und „für schnelle Entscheidungsbewertung in einem einzigen Durchlauf“ nachtrainiert und sagt, es werde „bald auf andere Modelle umgestellt, darunter Microsoft AI (MAI) und OpenAI“ (Microsoft). Die Trainingsdaten sind „öffentlich verfügbare Datensätze, die Microsofts Open-Data-Prozess unterliegen, plus synthetische Daten des Teams“ (Foundry-Katalog). Die Qwen-Basis ist dieselbe Familie wie bei Cloudflares Clef-flash und AWS Strands Decider.
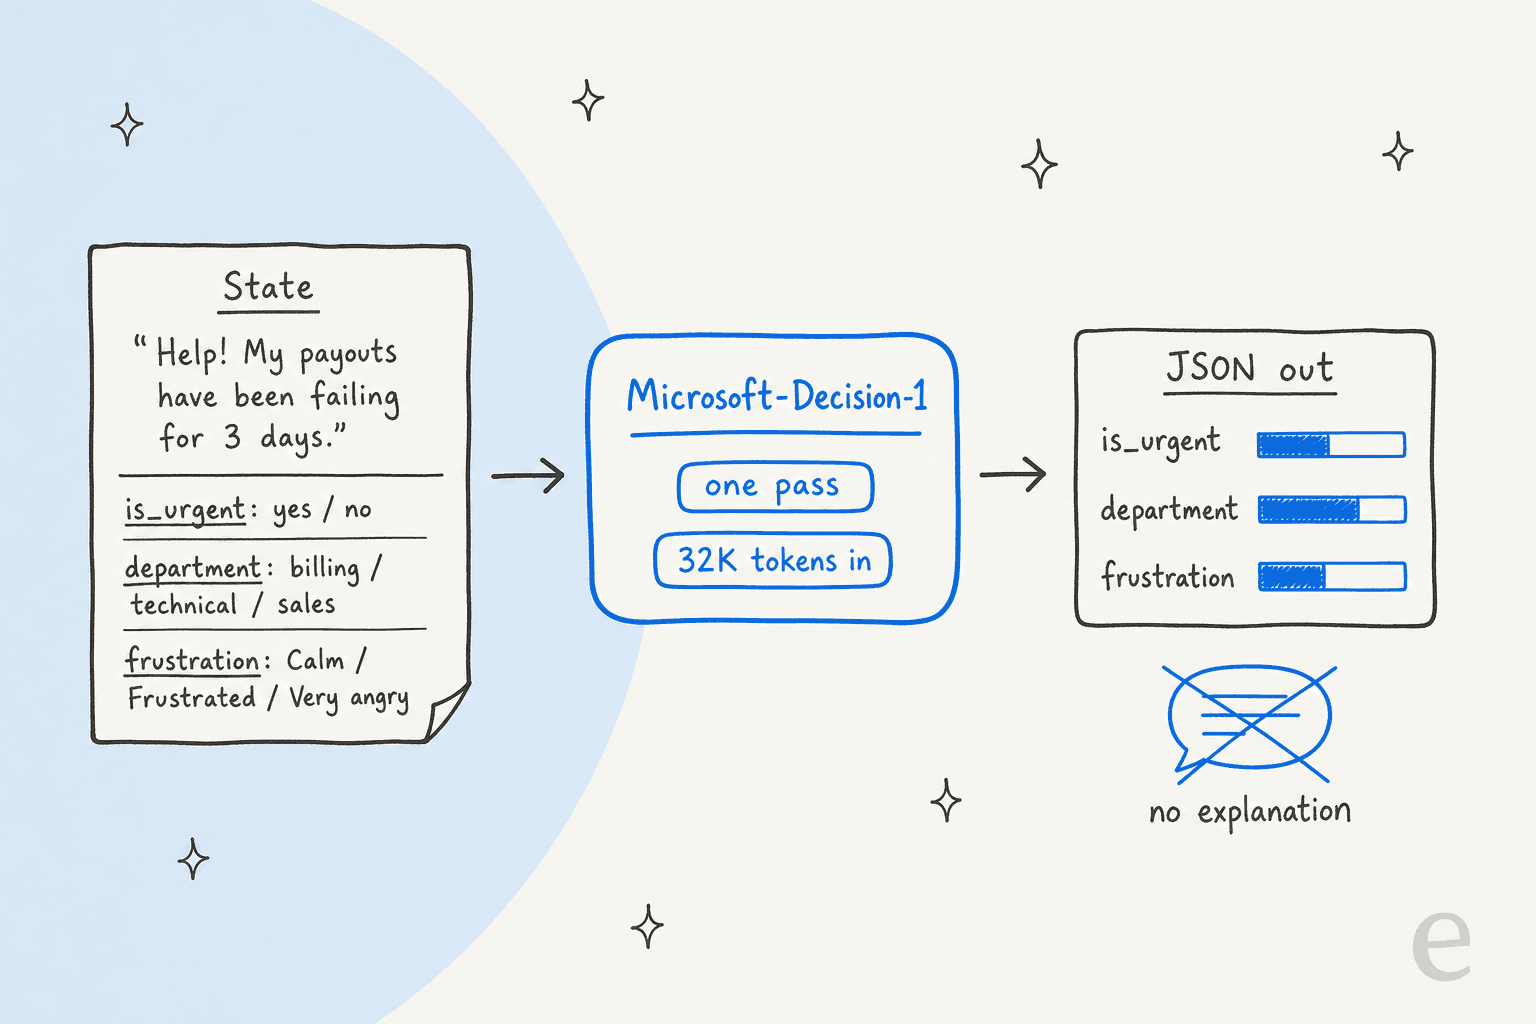
Einfach gesagt passieren in einem Aufruf drei Dinge:
- Es liest den State und jede Frage einmal. Bis zu 32.768 Tokens Text gehen hinein. Microsoft nennt das „Single-Pass-Bewertung“ (Foundry-Katalog).
- Es bewertet jede erlaubte Antwort. Statt „billing“ Buchstabe für Buchstabe zu schreiben, vergibt es gleichzeitig eine Wahrscheinlichkeit für billing, technical und sales.
- Es gibt JSON zurück und hört auf. Es gibt keine Begründung. Die Karte sagt klar, dass das Modell „keine Erklärungen oder Begründungen erzeugt“.
Die Fragetypen entsprechen dem, was Jev-Nutzer schon kennen. Bei OpenRouter kann eine Anfrage mehrere benannte Fragen zum selben State enthalten (OpenRouter):
| Fragetyp | Was gefragt wird | Was zurückkommt | Support-Beispiel |
|---|---|---|---|
noul | Stimmt das? | Eine Wahrscheinlichkeit von 0 (nein) bis 1 (ja) | „Drückt diese Nachricht Dringlichkeit aus?“ |
choice | Welche Option passt? | Die Auswahl plus eine Wahrscheinlichkeit pro Option | „Abrechnung, Technik oder Vertrieb?“ |
score | Wo auf dieser Skala? | Eine Position auf einer geordneten Rubrik | „Ruhig, Frustriert oder Sehr wütend?“ |
Microsofts Katalog nennt noch einige Extras: rubrikbasierte Bewertung von KI-Antworten und Agentenaktionen, Groundedness-Prüfungen gegen vorgelegte Belege, Sicherheitsprüfungen und „explizite Enthaltung“, also eine Option wie „nicht entscheidbar“, wenn die Beleglage dünn ist (Foundry-Katalog). Das Letzte wird unterschätzt. Ein Modell, das sagen kann „hier ist nicht genug zum Entscheiden“, lässt sich viel leichter vor eine echte Warteschlange setzen.
Hier ist die OpenRouter-Beispielanfrage, leicht gekürzt. Es ist ein Support-Ticket, was verrät, wen Microsoft und OpenRouter für die ersten Käufer halten:
const decision = await openrouter.alpha.decisions.create({
  decisionsRequest: {
    model: "microsoft/microsoft-decision-1",
    state: "Help! My payouts have been failing for 3 days.",
    questions: {
      is_urgent: {
        type: "noul",
        instructions: "Does this message convey urgency?",
        criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" }
      },
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Payments, invoicing, refunds",
          technical: "Bugs, outages, integrations",
          sales: "Pricing, upgrades, new accounts"
        }
      },
      frustration: {
        type: "score",
        instructions: "How frustrated is the customer?",
        criteria: ["Calm", "Frustrated", "Very angry"]
      }
    }
  }
});
Ihr Code liest dann die Antworten und entscheidet, was zu tun ist, zum Beispiel eskalieren, wenn is_urgent über 0,8 liegt und die Abteilung Abrechnung ist. Diese Schwellenwertlogik ist der Punkt. Vergleichen Sie das mit dem JSON-Modus bei einem allgemeinen LLM, wo Sie jedes Ausgabe-Token bezahlen und trotzdem ein Label ohne ehrliche Konfidenz bekommen.
Wie bekommt man Zugang zu Microsoft-Decision-1?
Es gibt zwei Türen, und sie verhalten sich unterschiedlich.
Microsoft Foundry, „Direct from Azure“. Der Katalog führt Microsoft-Decision-1 als Version 1 mit dem Lebenszyklus „Generally available (GA)“, Texteingabe, JSON-Ausgabe und einem Kontextfenster von 32.768 Tokens (Foundry-Katalog). Microsofts Learn-Dokumentation ordnet es den direkt von Azure verkauften Modellen zu, die „über Ihr Azure-Abonnement abgerechnet, von Azure-Service-Level-Agreements abgedeckt und von Microsoft unterstützt werden“ (Microsoft Learn). Wenn Sie bereits Azure-OpenAI-Modelle einkaufen, ist das der vertraute Beschaffungsweg.
Die Decisions API von OpenRouter. Kein Azure-Konto nötig. Die Modell-ID lautet microsoft/microsoft-decision-1, es läuft über POST https://openrouter.ai/api/alpha/decisions, und OpenRouter warnt, dass „Chat-Completions-SDKs damit nicht funktionieren“ (OpenRouter). Azure ist der einzige Anbieter dahinter, jede Anfrage landet also trotzdem auf Microsofts Infrastruktur.
| Microsoft Foundry | OpenRouter | |
|---|---|---|
| Status | GA, Version 1 | Live seit 9. Oktober 2026 |
| Konto | Azure-Abonnement | OpenRouter-Schlüssel |
| Abrechnung | Ihre Azure-Rechnung | OpenRouter-Guthaben |
| SLA | Azure-SLAs gelten | Kein Azure-SLA |
| Anfrageformat | Noch nicht öffentlich dokumentiert | Dokumentierte Decisions API |
| Modell-Updates | Version 1 im Katalog | „Gewichte werden laufend aktualisiert, während die API-Form gleich bleibt“ |
| Gemessene Geschwindigkeit | 85 ms p50, Microsofts eigener Test | 0,19 s p50 beim besten Anbieter, OpenRouters Messung |
Zwei Zeilen in dieser Tabelle würden ändern, wie ich es ausliefern würde. Erstens: Foundry ist die sicherere Produktionsheimat, aber das Anfrageformat ist noch nicht öffentlich. Ein Hacker-News-Nutzer, der es am ersten Tag bereitgestellt hat, schrieb:
„Vielleicht suche ich nur an der falschen Stelle, aber ich finde nicht, wie das API-Format aussieht. Ich habe das Modell sogar über Foundry bereitgestellt, und es steht nirgends, was ich senden muss oder was zurückkommt.“

Als ich am 11. Oktober nachsah, gab es immer noch keine Learn-Anleitung für das Modell. Zweitens: OpenRouters Hinweis, dass Gewichte laufend aktualisiert werden, bedeutet, dass ein im letzten Monat abgestimmter Schwellenwert unter Ihren Füßen wegdriften kann. Wenn Sie bei confidence > 0.9 routen, prüfen Sie das nach Updates erneut.
Was behaupten Microsofts Benchmarks?
Microsofts Launch-Beitrag beginnt mit einem Vergleich über 36 Benchmarks mit 147.137 Fragen, die „vom Training ferngehalten wurden“ (Microsoft). Hier der Kern der veröffentlichten Tabelle:
| Modell | Durchschnittliche Genauigkeit | Median-Latenz | Kalibrierung (100 = perfekt) |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85 ms p50, 125 ms p95 | 92,2 |
| Jev 1.13.0 | 82,3 % | 240 ms | 93.7 |
| Quyet-1.0-Large | 81,9 % | 380 ms | 93,1 |
| GPT-6 Luna Decisions | 79,4 % | 300 ms | 89,9 |
| H2O-Lightning-4B v1.1 | 77,2 % | 210 ms | 91,8 |
| Strands-Decider 2B (23 von 36 Benchmarks) | 54,8 % | Nicht gemessen | Nicht bewertet |
| GPT-6 Sol (Referenz) | Nicht gerankt | 3,01 s | Nicht bewertet |
Quelle: Microsofts Ankündigung. Microsoft berichtet außerdem, dass das Modell seine Antwort bei Störungen im Schnitt in 1,3 % der Fälle ändert, bei Umformulierung, Umkehrung oder Mischung der Optionen aber kein einziges Mal. Die Sicherheitstests umfassten 5.250 Anfragen über 11 Benchmarks.
Lesen Sie die Fußnoten, bevor Sie diese Zahlen zitieren. Die Latenz jedes Konkurrenten stammt aus dem angepassten Median von JevBench v1.6.1, geprüft am 7. Oktober. Die 85 ms von Microsoft-Decision-1 wurden „über Foundry in derselben Region gemessen“. Das ist nicht dasselbe Rennen. Und bei der Kalibrierung liegt Microsoft nur auf Platz drei, 1,5 Punkte hinter Jev, was wichtiger ist als der Genauigkeitsvorsprung, wenn Sie oberhalb eines Konfidenz-Schwellenwerts automatisch handeln wollen.
Jev fehlte zunächst in der Tabelle. Die meistgelikte Antwort unter Nadellas Launch-Post mit 335 Likes lautete:
„Wieso ist Jev nicht gerankt? Das ist buchstäblich das Modell Nr. 1, mit dem man das vergleichen wird.“
Die Ankündigung trägt jetzt einen Hinweis der Redaktion, dass sie „gegenüber dem Original um Benchmarks für Jev zu Genauigkeit und Kalibrierung ergänzt wurde“. Ein Lob an Microsoft, das so schnell korrigiert zu haben. Mein Jev-Test sagt mehr über das Modell, an dem es gemessen wird.
Die internen Ergebnisse sind dünner, aber interessant. Microsoft sagt, das Copilot-Team habe es „konkurrenzfähig mit GPT5.6 Luna und 100-mal schneller“ gefunden, und das XBOX-Research-Team habe über 10.000 Feedback-Einträge durchlaufen lassen, „über 14-mal schneller und 200-mal günstiger“ als GPT-6 Sol (Microsoft). Das sind Microsofts Teams, die Microsofts Modell bewerten, ich würde es also als Anwendungshinweise behandeln, nicht als Beweis.
Was wurde unabhängig gemessen?
Noch nicht viel, was zwei Tage nach dem Start normal ist. Das ist alles, was ich außerhalb von Microsoft prüfen konnte.
OpenRouter veröffentlicht für jedes Modell, das es ausliefert, eigene Latenzwerte. Über drei Tage maß es ein p50 des besten Anbieters von 0,19 Sekunden, ein durchschnittliches p50 von 0,27 Sekunden und ein p99 von 0,67 Sekunden bei 99,90 % Verfügbarkeit (OpenRouter).
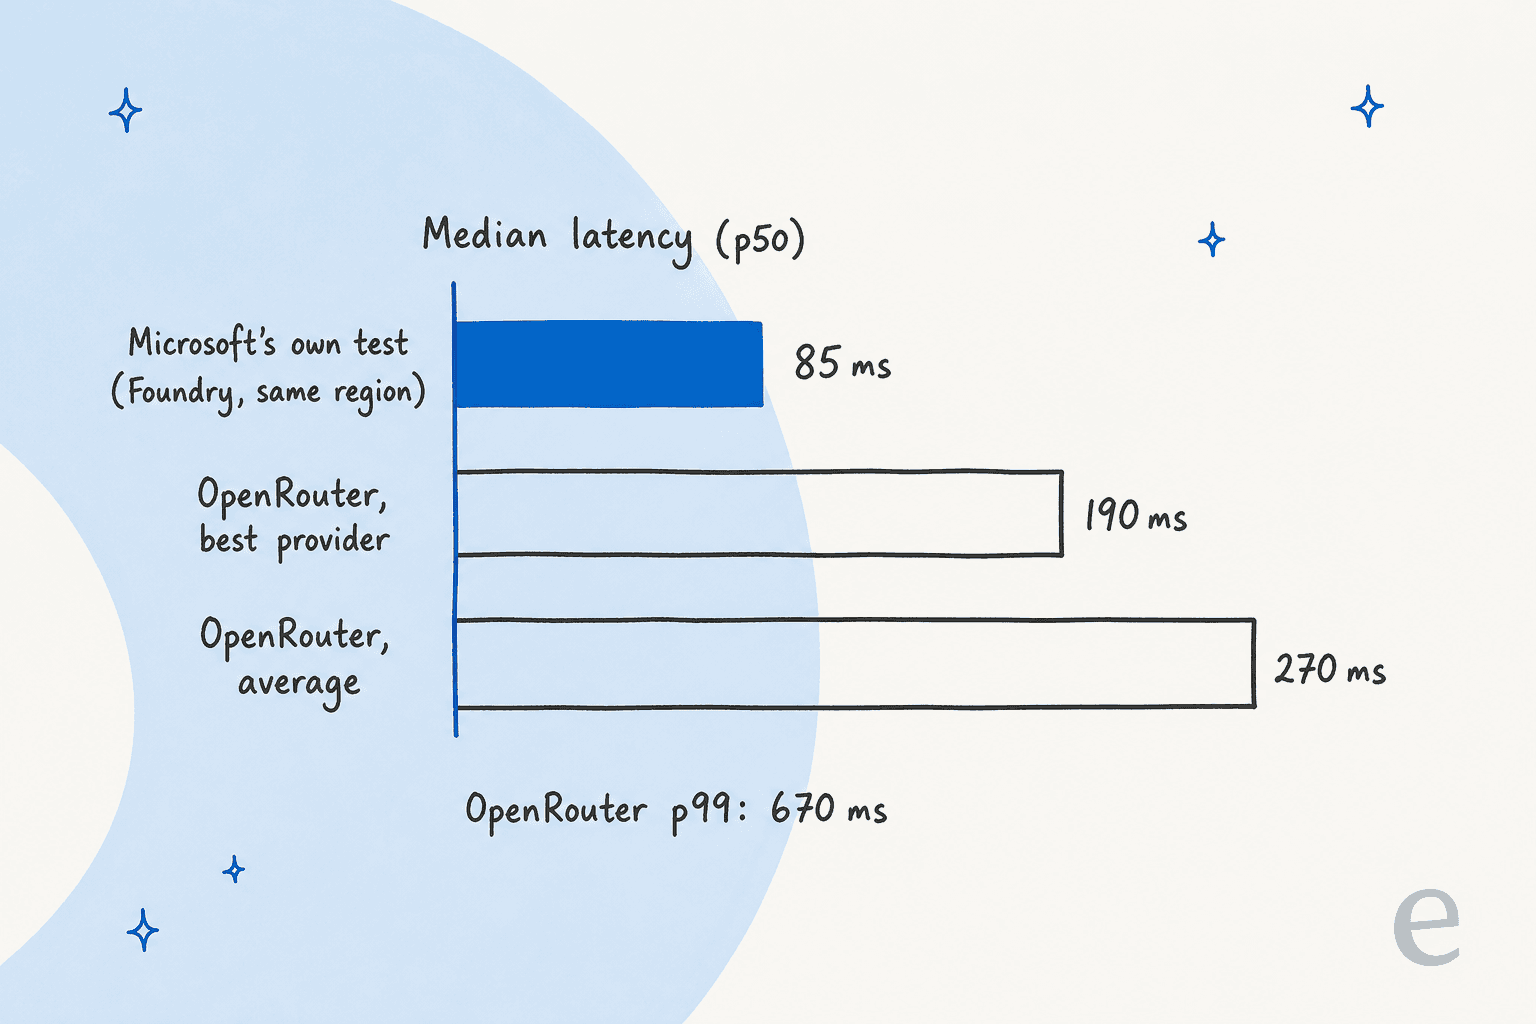
Diese Lücke heißt nicht, dass Microsofts Zahl falsch ist. Sie wird direkt neben dem Modell gemessen, während OpenRouters Messung einen Umweg über einen Router enthält. Wenn Sie es aber über das öffentliche Internet aufrufen, planen Sie mit etwa 200 bis 300 ms, nicht mit 85. Für einen einzelnen Routing-Aufruf pro Ticket ist das immer noch sofort. Für einen Agenten, der 20 Entscheidungen verkettet, gilt Microsofts eigene Rechnung: „100 Millisekunden mehr bei jeder von 20 aufeinanderfolgenden Entscheidungen addieren zwei Sekunden zum gesamten Workflow.“
Den einzigen praktischen Vergleich, den ich fand, lieferte ein Hacker-News-Kommentator, der es gegen Jev laufen ließ:
„In meiner kleinen Testsuite war es günstiger (um den Faktor 0,72), aber mit höherer Latenz (283 ms vs. 369 ms p50) als Jev. Die Ergebnisse waren in allen gemessenen Szenarien sehr ähnlich, das erste dieser Modelle, das ich getestet habe und das seine Existenz als kommerzielles Release tatsächlich rechtfertigt.“
Das ist die kleine Suite einer einzelnen Person, passt aber zur Grundform der Geschichte: ungefähr Jev-Niveau bei den Antworten, zu einem Jev-Preis.
Was fehlt: Der von der Community betriebene Jev Decision Index wurde am 10. Oktober auf v0.3.1 mit 117 Einträgen aktualisiert, und Microsoft-Decision-1 ist nicht dabei. Jev steht bei diesem Ranking mit dem neuen Full-Score bei 60,11, die Messlatte liegt also bereit. Auch die Nutzung ist noch gering. OpenRouters Decision-Rankings zeigen diese Woche Jev 1.13 mit 999 Mio. Anfragen, GPT-6 Luna Decisions mit 11,7 Mio. und Microsoft-Decision-1 außerhalb der Top 10.
Was sind die Grenzen und Unbekannten?
Diesen Abschnitt würde ich zweimal lesen, bevor ich es in Produktion nehme. Manches sind bewusste Umfangsentscheidungen, manches einfach Lücken in der Dokumentation der Startwoche.
- Keine Erklärungen. Es liefert Scores, nie Gründe. Wenn eine Support-Leitung fragt „Warum ging das an die Abrechnung?“, kann das Modell es nicht sagen.
- Nur Text, 32K Kontext. Keine Bilder oder Screenshots, anders als bei Clef oder OpenAIs Decisions API. Ein langer E-Mail-Verlauf mit zitiertem Verlauf kann das Limit erreichen.
- Keine offenen Gewichte. Die Hugging-Face-URL liefert einen 404, Self-Hosting und Fine-Tuning sind also keine Optionen.
- Keine veröffentlichten Regionen, Ratenlimits oder Kontingente. Es fehlt auf Azures Seite zur Regionsverfügbarkeit, und der Lizenz-Tab des Katalogs wurde für nicht angemeldete Besucher nicht angezeigt, ich konnte die Lizenzbedingungen also nicht lesen.
- Noch nicht auf Azures Preisliste. Der Preis von 0,042 $ steht in der Ankündigung und bei OpenRouter, aber die Preisseite für Foundry-Modelle hat keine Zeile dafür. Was das bedeutet, habe ich in meinem Beitrag zu den Microsoft-Decision-1-Preisen aufgeschlüsselt.
- Nicht vorgesehene Einsätze. Microsoft sagt, es „sollte nicht als alleinige Grundlage für Entscheidungen zu Kredit, Beschäftigung, Wohnen, Versicherung, Bildung, Gesundheit, Rechtsansprüchen“ verwendet werden (Foundry-Katalog).
Der erste Punkt löste den schärfsten Kommentar im HN-Thread aus, der 195 Punkte und 65 Kommentare erreichte:
„Das Ergebnis eines ‚Entscheidungs‘-Modells ohne Einblick in die Begründung einer Entscheidung zu verwenden, wirkt sehr vertrauensselig.“
Ich stimme zu, mit einer Wendung. Das Modell muss sich nicht selbst erklären, wenn Sie protokollieren, was es gesehen hat, was es gewählt hat und mit welcher Konfidenz, und die Fälle mit niedriger Konfidenz an einen Menschen schicken. Das ist dieselbe Disziplin, die ich beim Verhindern von KI-Halluzinationen in einem Support-Bot anwenden würde: an echten Verlaufsdaten testen, riskante Entscheidungen absichern, einen Nachweis führen.
Wie schneidet Microsoft-Decision-1 im Vergleich zu Jev, Clef und den anderen ab?
Microsoft-Decision-1 landet in einem dicht besetzten Feld. Die Kurzfassung, wer wer ist, Stand 11. Oktober 2026:
| Modell | Hersteller | Eingabepreis pro 1 Mio. | Kontext | Eingaben | Offene Gewichte | Wo man es betreibt | Jev Decision Index v0.3.1 |
|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 | Microsoft | 0,042 $, Ausgabe kostenlos | 32.768 | Text | Nein | Foundry, OpenRouter | Nicht gelistet |
| Jev 1.13 | TypeSafe | 0,042 $, Ausgabe kostenlos | 64K pro Anfrage | Text | Nein | TypeSafe API, Workers AI, OpenRouter | 60,11 (gemeinsam 2.) |
| Clef | Cloudflare | 0,24 $ | 65.536 | Text, JSON, Bilder, Video | Ja, Apache 2.0 | Workers AI | 53,08 (19.) |
| Clef-flash | Cloudflare | 0,038 $ | 24.576 | Text, JSON, Bilder, Video | Ja, Apache 2.0 | Workers AI | 47,61 (33.) |
| OpenAI Decisions API | OpenAI | 0,10 $, Ausgabe kostenlos | 1.050.000 von GPT-6 Luna | Text, Bilder | Nein | OpenAI API, öffentliche Beta | Nicht gelistet |
| Strands Decider 2B | AWS Strands Labs | Kostenlos zum Self-Hosting | Betrieb mit 3.072 bis 4.096 | Text | Ja, Apache 2.0 | Eigene Hardware | 21,75 (84.) |
Quellen: die jeweilige Dokumentation der Anbieter (zum Beispiel Cloudflares Clef-Seite und OpenAIs Decisions-Leitfaden) und die Daten des Decision Index vom 10. Oktober.
Einiges fällt auf. Microsoft hat Jevs Preis exakt getroffen, und nur Clef-flash ist pro Token günstiger. Clef und OpenAIs API nehmen Bilder an, Microsoft nicht. Und OpenAI nennt seinen Ja/Nein-Typ predicate statt noul, ein Wechsel ist also kein reiner URL-Tausch. Die Kosten dieser API habe ich in meiner Aufschlüsselung der Decisions-API-Preise behandelt.
Der Preisvergleich in Microsofts eigenem Beitrag stieß auf Widerspruch. Microsofts Kostendiagramm setzt Microsoft-Decision-1 bei etwa 11 $ pro Million klassifizierter Texte an, gegenüber etwa 2.434 $ für GPT-6 Sol. Ein HN-Kommentator wies darauf hin, was fehlt:
„Microsoft vergleicht den Preis nur mit GPT Sol(!), nicht mit GPT Terra oder GPT Luna (worauf OpenAIs Jev-Nachahmer basiert) und schon gar nicht mit Jev (4/10 der Kosten von Luna).“
Berechtigter Punkt. Gegenüber einem allgemeinen Modell wie GPT-6 Luna wirkt jedes Entscheidungsmodell billig. Gegenüber seinen echten Konkurrenten ist Microsoft-Decision-1 gleichauf bepreist, nicht günstiger. Wenn Sie das ganze Feld abwägen, geht mein Überblick über Jev-Alternativen Modell für Modell durch.
Ist Microsoft-Decision-1 die richtige Wahl für Ihre Aufgabe?
Wählen Sie die Situation, die Ihrer am nächsten kommt.
Wenn rohe Geschwindigkeit Ihr wichtigstes Kriterium ist, behandelt mein Beitrag zu Jev Ultrafast TypeSafes Tier mit niedriger Latenz, den engsten Konkurrenten zu Microsofts Geschwindigkeitsversprechen.
Was bedeutet Microsoft-Decision-1 für Support-Teams?
Support ist der Anwendungsfall, nach dem alle zuerst greifen, und das aus gutem Grund. Ticket-Triage ist ein Haufen kleiner, begrenzter Fragen mit festen Antworten. Intent-Klassifizierung ist eine choice-Frage. Dringlichkeit und Stimmungsanalyse sind Scores auf einer festen Skala. „Sollte das ein Mensch sehen?“ ist eine Ja/Nein-Frage, das Herzstück der KI-Eskalation. Microsoft-Decision-1 kann all das in einem Aufruf für einen Bruchteil eines Cents beantworten.
Das sollte jede Support-Leitung wissen, bevor sie sich begeistert: Das Sortieren ist der Teil, der bereits gut funktioniert.
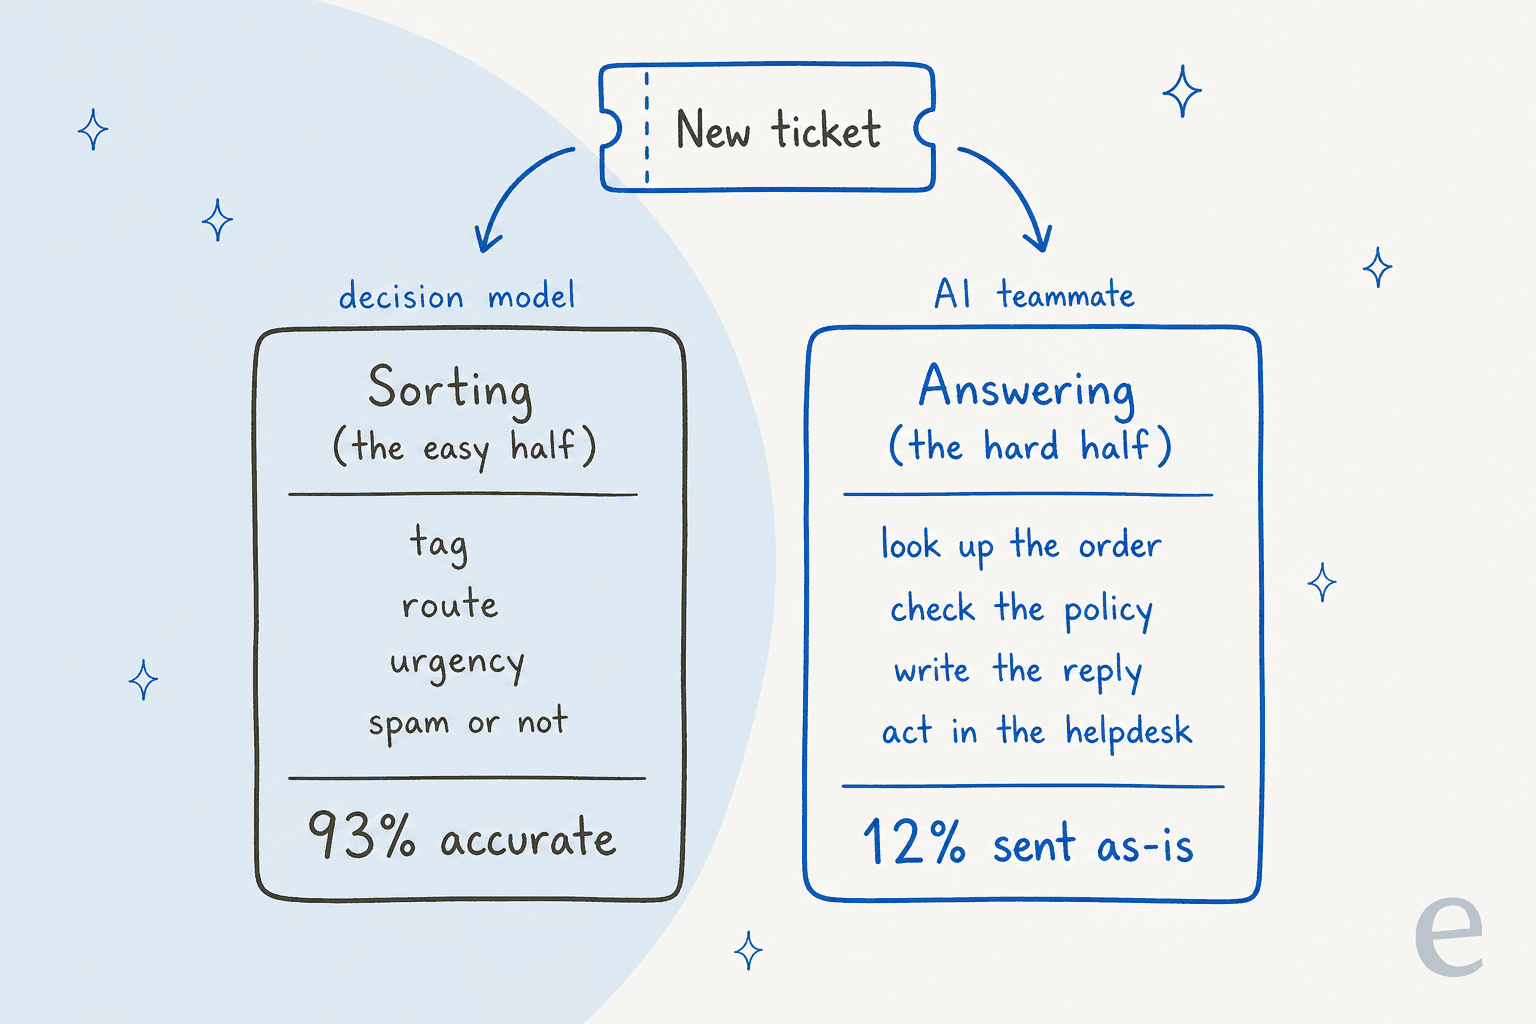
Diese Zahlen stammen aus einem kreuzvalidierten Test mit echtem Zendesk-Aufkommen bei einem E-Commerce-Unternehmen, den ich gesehen habe. Die KI-Triage war 93% genau und erkannte 100% des Spams, der 22% des Posteingangs ausmachte, ohne einen einzigen False Positive. Entworfene Antworten gingen in 88% der Fälle in die richtige Richtung. Aber nur 12 % gingen ohne Änderungen raus, und 7 % enthielten einen sachlichen Fehler. Das Label war leicht. Die Antwort war die eigentliche Arbeit.
Das deckt sich damit, was eesels Kunden tatsächlich wollen. Eine CX-Leiterin mit 7.000 Tickets im Monat sagte es in einem Gespräch so:
„Die KI wird nie 100 % der Fragen beantworten können, aber wenn sie es versucht und nur ‚Tut mir leid, das weiß ich nicht‘ antwortet, kann ich nicht alle meine 7.000 Tickets durchgehen, um zu prüfen, ob die KI wirklich gut geantwortet hat.“
Gewünscht wird zuerst eine sichere Entscheidung (kann ich das bearbeiten?) und erst danach eine Aktion. Ein Entscheidungsmodell liefert den ersten Teil als Zahl. Diese Zahl in einen Tag in Zendesk, eine Neuzuweisung, eine zur Freigabe gehaltene Erstattung und eine Antwort in Ihrer Markenstimme zu verwandeln, ist alles um das Modell herum. Deshalb würde ich Microsoft-Decision-1 als Baustein für Teams sehen, die ihr eigenes KI-Ticket-Routing bauen, nicht als eigenständiges Support-Tool.
Wenn Sie es selbst bauen, ist dies eine sinnvolle Reihenfolge:
- Beginnen Sie mit den Fragen, die Ihre Triagierer schon beantworten. Team, Dringlichkeit, Spam, Ticket-Priorisierung. Formulieren Sie sie als
choice- undscore-Fragen mit denselben Labels, die Ihr Helpdesk verwendet. - Spielen Sie einen Monat vergangener Tickets erneut ab. Vergleichen Sie die Auswahl des Modells mit dem, was Ihr Team tatsächlich getan hat, pro Label und nicht als einen Durchschnitt.
- Legen Sie pro Frage einen Schwellenwert fest. Oberhalb automatisch routen, darunter an einen Menschen schicken, und beides protokollieren.
- Behalten Sie einfache Regeln, wo sie funktionieren. Wenn „Erstattung“ im Betreff immer Abrechnung bedeutet, sind Zendesk-Routing-Regeln kostenlos und driften nie.
- Entscheiden Sie, wer die Antwort schreibt. Das ist der Teil, den ein Entscheidungsmodell nicht kann und den Ihre Kunden tatsächlich sehen.
Für einen breiteren Überblick vergleicht mein Überblick über KI-Triage-Tools, was heute in den einzelnen Helpdesks eingebaut ist, und der Leitfaden zum Automatisieren der Ticket-Triage führt durch die Einrichtung von Anfang bis Ende.
eesel für Ticket-Triage und Antworten testen
Microsoft-Decision-1 ist Infrastruktur: ein schneller, günstiger Weg für Ihren Code, eine Entscheidung zu treffen. eesel ist der Mitarbeiter, der die Entscheidung trifft und dann die Arbeit erledigt. Das KI-Helpdesk-Teammitglied steigt über die Zendesk-Integration, Freshdesk oder Gorgias in Ihre bestehende Warteschlange ein. Es vergibt Tags, leitet weiter und eskaliert und schreibt dann die Antwort aus Ihrem Help Center und vergangenen Tickets.
Die Aufteilung, auf die dieser Beitrag immer wieder zurückkommt, ist bereits eingebaut. Jede Automatisierung hat eine Einstellung „Modellstärke“, mit „einem leichteren Modell für einfache Aufgaben wie Tagging oder Routing“ und dem üblichen Modell fürs Entwerfen (eesel-Dokumentation). Jede Aktion lässt sich auf Auto, Freigabe nötig oder Deaktiviert setzen, und Ereignisse, die der Agent überspringt, werden mit Begründung protokolliert. Bevor etwas live geht, können Sie den Agenten an Ihren eigenen vergangenen Tickets simulieren und sehen, wo er die Antworten Ihres Teams getroffen hätte.

Wenn Sie es lieber über ein Terminal einrichten, führt die eesel-CLI dasselbe Teammitglied aus wie das Dashboard. Jeder Befehl gibt JSON aus, sodass Claude Code, Codex oder Cursor die ganze Einrichtung steuern können. Ein Befehl wie eesel automations enable <platform> <key> --instructions "..." richtet eine Triage-Regel in einfachen Worten ein, eesel approvals listet zurückgehaltene Aktionen zum Freigeben oder Ablehnen auf, und --dry-run prüft einen Schreibvorgang, bevor er passiert. Warum das wichtig ist, habe ich in meinem Beitrag zur Agenten-CLI beschrieben.
Die Preise folgen einem festen monatlichen Credit-Plan: Ein Ticket ist ein Credit, egal wie viel Arbeit darin passiert, ab 299 $ im Monat für 500 Credits, und Sie erhalten 100 kostenlose Credits zum Ausprobieren ohne Karte. Verbinden Sie Ihren Helpdesk, richten Sie es auf die Tickets des letzten Monats und sehen Sie, wie es sie sortiert und was es zurückgeschrieben hätte. eesel testen.
Häufig gestellte Fragen
Was ist Microsoft-Decision-1?
Microsoft-Decision-1 ist ein Entscheidungsmodell, das Microsoft am 9. Oktober 2026 veröffentlicht hat. Sie geben ihm einen Text und eine Reihe fester Antwortoptionen, und es liefert für jede Option eine kalibrierte Wahrscheinlichkeit als JSON zurück, statt Text zu schreiben. Es gehört zu einer schnell wachsenden Gruppe von Entscheidungsmodellen für Routing-, Klassifizierungs- und Prüfaufgaben.
Worauf basiert Microsoft-Decision-1?
Microsoft sagt, es habe Alibabas Open-Weight-Modell Qwen3.5-9B für die Entscheidungsbewertung in einem einzigen Durchlauf nachtrainiert und plane, das Modell später auf Microsoft-AI-(MAI)- und OpenAI-Modelle umzustellen. Die Qwen-Familie steckt auch hinter Cloudflares Clef-flash und AWS Strands Decider.
Wie nutze ich Microsoft-Decision-1?
Es gibt zwei Wege: Sie stellen es über den Microsoft-Foundry-Katalog bereit, wo es direkt von Azure verkauft und über Ihr Azure-Abonnement abgerechnet wird, oder Sie rufen es über die Decisions API von OpenRouter mit der Modell-ID microsoft/microsoft-decision-1 auf. Chat-Completions-SDKs funktionieren damit nicht, planen Sie also eine typisierte Anfrage ein, wie bei TypeSafe Jev.
Was kostet Microsoft-Decision-1?
Microsoft-Decision-1 kostet 0,042 $ pro Million Eingabe-Tokens, Ausgabe-Tokens sind kostenlos, also derselbe Grundpreis wie bei Jev. Auf Azures Foundry-Preisseite gibt es dafür noch keine Zeile. Die Kostenrechnung des Konkurrenten finden Sie in meiner Aufschlüsselung der Jev-Preise.
Ist Microsoft-Decision-1 besser als Jev?
In Microsofts eigener Tabelle mit 36 Benchmarks erreicht Microsoft-Decision-1 im Schnitt 83,5 % Genauigkeit gegenüber 82,3 % für Jev 1.13.0, während Jev bei der Kalibrierung höher liegt (93,7 vs. 92,2). Bisher hat kein unabhängiges Ranking Microsoft-Decision-1 bewertet, betrachten Sie den Vorsprung also als Behauptung. Mein Jev-Test zeigt, was Jev gut kann.
Kann Microsoft-Decision-1 Support-Tickets triagieren?
Ja. Dringlichkeit, Team und Stimmung sind genau die Fragen mit festen Optionen, für die es gebaut wurde, und OpenRouters eigene Beispielanfrage ist eine Support-Nachricht. Sie brauchen aber weiterhin etwas, das den Tag setzt, das Ticket verschiebt und die Antwort schreibt, also die Arbeit eines KI-Helpdesk-Teammitglieds. Den gesamten Ablauf finden Sie unter Ticket-Triage automatisieren.
Erklärt Microsoft-Decision-1 seine Entscheidungen?
Nein. Laut Microsofts Modellkarte ist es rein textbasiert und erzeugt keine Erklärungen oder Begründungen. Wenn Sie zu jeder Entscheidung eine Begründung brauchen, etwa für einen Prüfpfad oder eine Eskalation an einen Menschen, müssen Sie Eingaben und Optionen selbst protokollieren oder für diesen Schritt ein LLM einsetzen.
Sind die Gewichte von Microsoft-Decision-1 offen?
Nein. Es gibt kein Hugging-Face-Repository für Microsoft-Decision-1, und Microsoft hat weder eine Lizenz noch eine Self-Hosting-Option veröffentlicht. Wenn Sie offene Gewichte brauchen: Cloudflares Clef und AWS' Strands Decider stehen unter Apache 2.0.