

Microsoft-Decision-1-Alternativen auf einen Blick
| Modell | Anbieter | Eingabe pro 1M Tokens | Ausgabe | Kontext pro Aufruf | Bilder | So betreiben Sie es | Gewichte und Lizenz | Decision Index v0.3.1 (Full) | Hinweise zu Daten und Compliance | Gratiskontingent |
|---|---|---|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 (Referenz) | Microsoft | $0.042 | Kostenlos | 32,768 | Nein | Azure Foundry, OpenRouter | Geschlossen | Nicht gelistet | Azure-SLA; Regionen nicht veröffentlicht | Allgemein Azure $200, 30 Tage |
| Jev 1.13 | TypeSafe | $0.042 | Kostenlos | 64k pro Anfrage, 32k Zustand + längste Frage | Nein | TypeSafe API, Cloudflare Workers AI | Geschlossen | 60.11 (Referenz, geteilter 2. Platz) | Zero Data Retention im Cloudflare-Eintrag | Keines dokumentiert |
| OpenAI Decisions API | OpenAI | $0.10 | Kostenlos | 1,050,000 (2x Eingabepreis ab 272K) | Ja | OpenAI API, öffentliche Beta | Geschlossen | Nicht gelistet | ZDR und HIPAA für berechtigte Kunden, US- und EU-Datenresidenz | Keines |
| Clef-flash | Cloudflare | $0.038 | Kostenlos | 24,576 | Ja | Workers AI oder Self-Hosting | Offen, Apache 2.0 | 47.61 (#33) | Cloudflare-Kontobedingungen | 10,000 Workers-AI-Neurons pro Tag |
| Clef | Cloudflare | $0.24 | Kostenlos | 65,536 | Ja | Workers AI oder Self-Hosting | Offen, Apache 2.0 | 53.08 (#19) | Cloudflare-Kontobedingungen | 10,000 Workers-AI-Neurons pro Tag |
| Perplexity Decider v1.1 | Perplexity | Ihre GPU-Kosten | k. A. | 8,192 pro Entscheidung | Ja | Self-Hosting, etwa 49 GiB Gewichte | Apache 2.0, authentifizierter Download | 62.75 (#1) | Bleibt auf Ihrer Infrastruktur | Kostenloser Download |
| Rune 26B-A4B v3 | Surogate (Invergent) | Ihre GPU-Kosten | k. A. | 262k | Ja | Self-Hosting mit der surogate-Engine | Apache 2.0, Kontaktdaten-Abfrage | 57.43 (#10) | Bleibt auf Ihrer Infrastruktur | Kostenloser Download |
| Strands Decider 2B | AWS Strands Labs | Ihre GPU-Kosten | k. A. | Getestet mit 4,096 | Optional, nicht trainiert | Self-Hosting, passt auf eine 3090 | Apache 2.0 | 21.75 (#84) | Bleibt auf Ihrer Infrastruktur | Kostenloser Download |
| eesel (kein Modell) | eesel | $299 im Monat für 500 Tickets oder Chats | k. A. | Ganzes Ticket und Verlauf | Ja | Wird in Ihren Helpdesk eingebunden | Gehostetes Produkt | k. A. | HIPAA im Enterprise-Tarif | 100 kostenlose Credits |
Preise und Kontext stammen aus den jeweiligen Anbieter-Dokumentationen, Stand 11. Oktober 2026. Die Decision-Index-Werte stammen vom Jev Decision Index, Version 0.3.1, aktualisiert am 10. Oktober.
Warum über Microsoft-Decision-1 hinausschauen?
Was das Modell kann, habe ich in meinem Microsoft-Decision-1-Überblick beschrieben, was es kostet, in der Preisaufschlüsselung. Es ist ein starker Release. Microsofts eigene Tabelle nennt 83.5 % durchschnittliche Genauigkeit über 36 Benchmarks bei einem Median von 85 ms auf Foundry. Aber ein paar Lücken fallen immer wieder auf:
- Keine offenen Gewichte. Es ist ein nachtrainiertes Qwen3.5-9B, aber die Hugging-Face-Seite, die Microsoft verwenden würde, liefert 404. Man mietet es oder man nutzt es nicht. Wenn Sie die Qwen-Familie fürs Self-Hosting mochten, ist dieses Modell geschlossen.
- Nur Text, 32K Kontext. Screenshots, gescannte Formulare und sehr lange Threads brauchen ein anderes Modell.
- Dünne Azure-Unterlagen. Es ist im Katalog GA, hat aber noch keine Zeile auf Azures Foundry-Preisseite und keine veröffentlichten Regionen, Kontingente oder Batch-Preise. Teams, die über Azure-Modelle einkaufen, wollen diese meist, bevor sie sich festlegen.
- Noch kein unabhängiger Wert. Es steht nicht im Jev Decision Index, daher stammt jede bisherige Genauigkeitszahl von Microsoft selbst.
Der letzte Punkt prägte die meisten Reaktionen am Launch-Tag. Die oberste Antwort unter Satya Nadellas Launch-Post war unmissverständlich:
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoft hat den Post später aktualisiert und Jev in die Tabelle für Genauigkeit und Kalibrierung aufgenommen. Die Frage dahinter bleibt trotzdem die richtige. Decision-Modelle sind inzwischen ein umkämpftes Feld, und welches Decision-Modell Sie wählen, sollte davon abhängen, wo es läuft und was es liest, nicht von Diagrammen am Launch-Tag.
Wie ich diese Alternativen ausgewählt habe
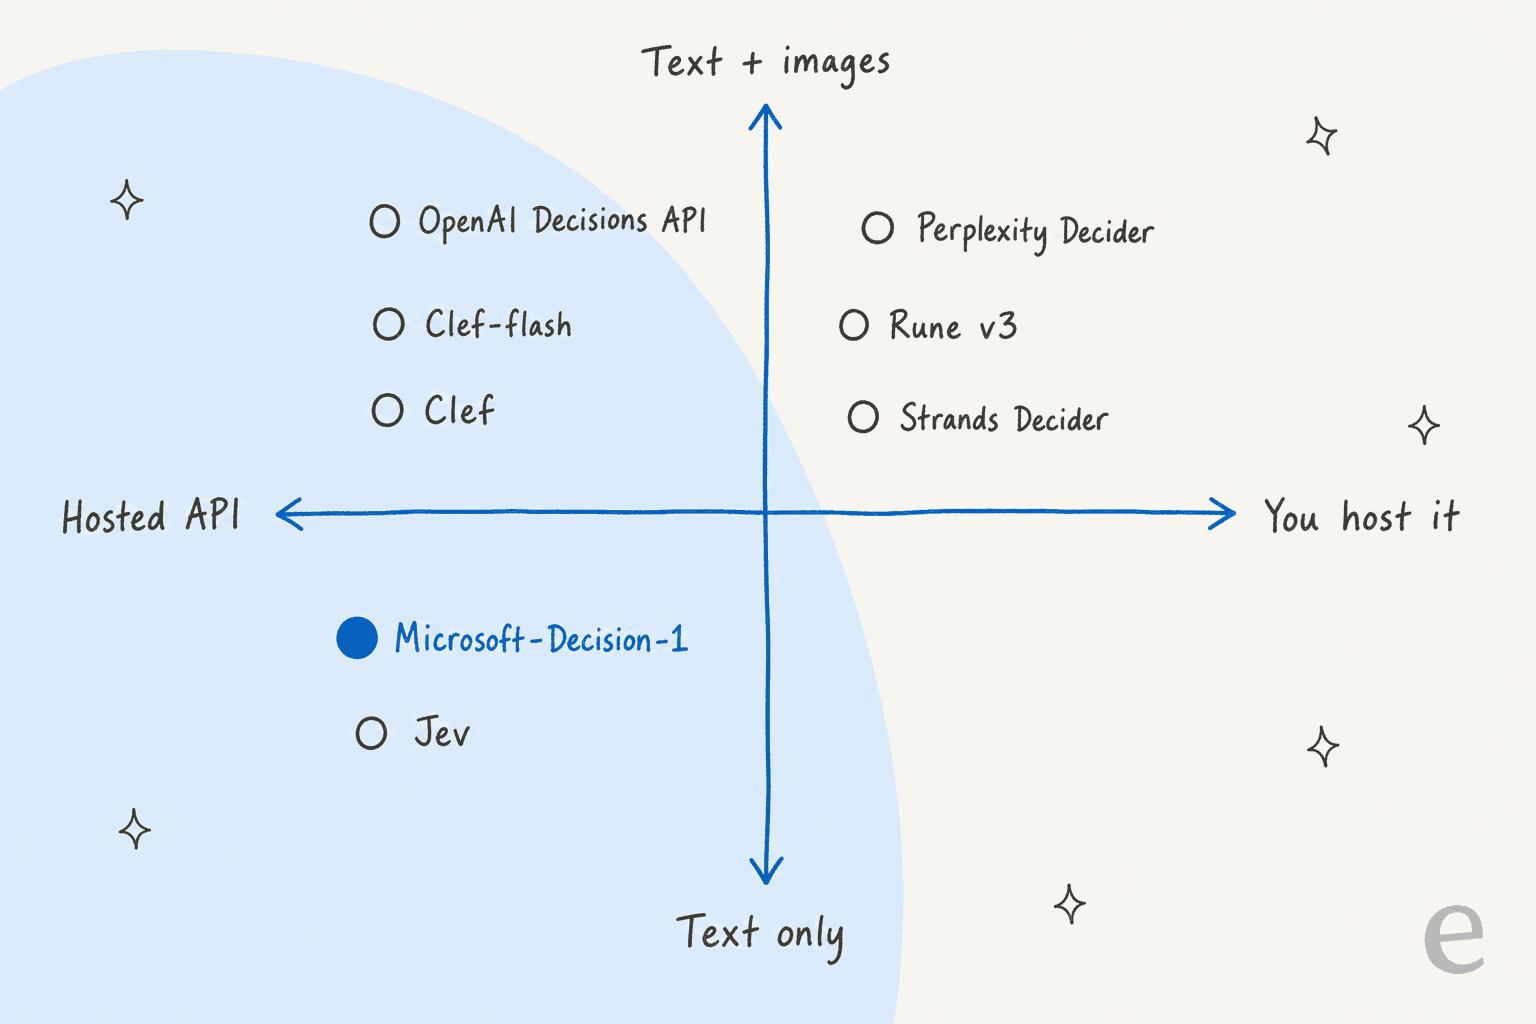
Ich komme von der Suchseite. Meine Aufgabe bei eesel besteht hauptsächlich darin herauszufinden, was Käufer tatsächlich fragen, wenn sie eine Suchanfrage eintippen, und "Microsoft-Decision-1 alternatives" zwei Tage nach dem Launch teilt sich sauber in Preis, Hosting und Eingabetyp. Deshalb habe ich mich auf Modelle beschränkt, die dieselbe Aufgabe erfüllen: Sie senden einen Zustand plus feste Antwortoptionen und erhalten in einem Durchlauf kalibrierte Wahrscheinlichkeiten zurück.
Jedes Modell unten steht entweder in Microsofts eigener Vergleichstabelle oder im Decision Index, oder in beiden. Allgemeine Chat-Modelle mit JSON-Modus habe ich weggelassen, da Function Calling auf einem großen Modell eine ganz andere Kostenkurve hat. Jeder Eintrag nutzt dieselben fünf Überschriften, damit Sie quer vergleichen können.
Wie viel Text kann jedes Modell pro Aufruf lesen?
Der Kontext ist die Spezifikation, die im Support-Alltag zuerst zuschlägt. Ein einzelnes Ticket mit Bestellhistorie, einem Richtlinienauszug und drei Antwortrunden kann 10,000 Tokens überschreiten.
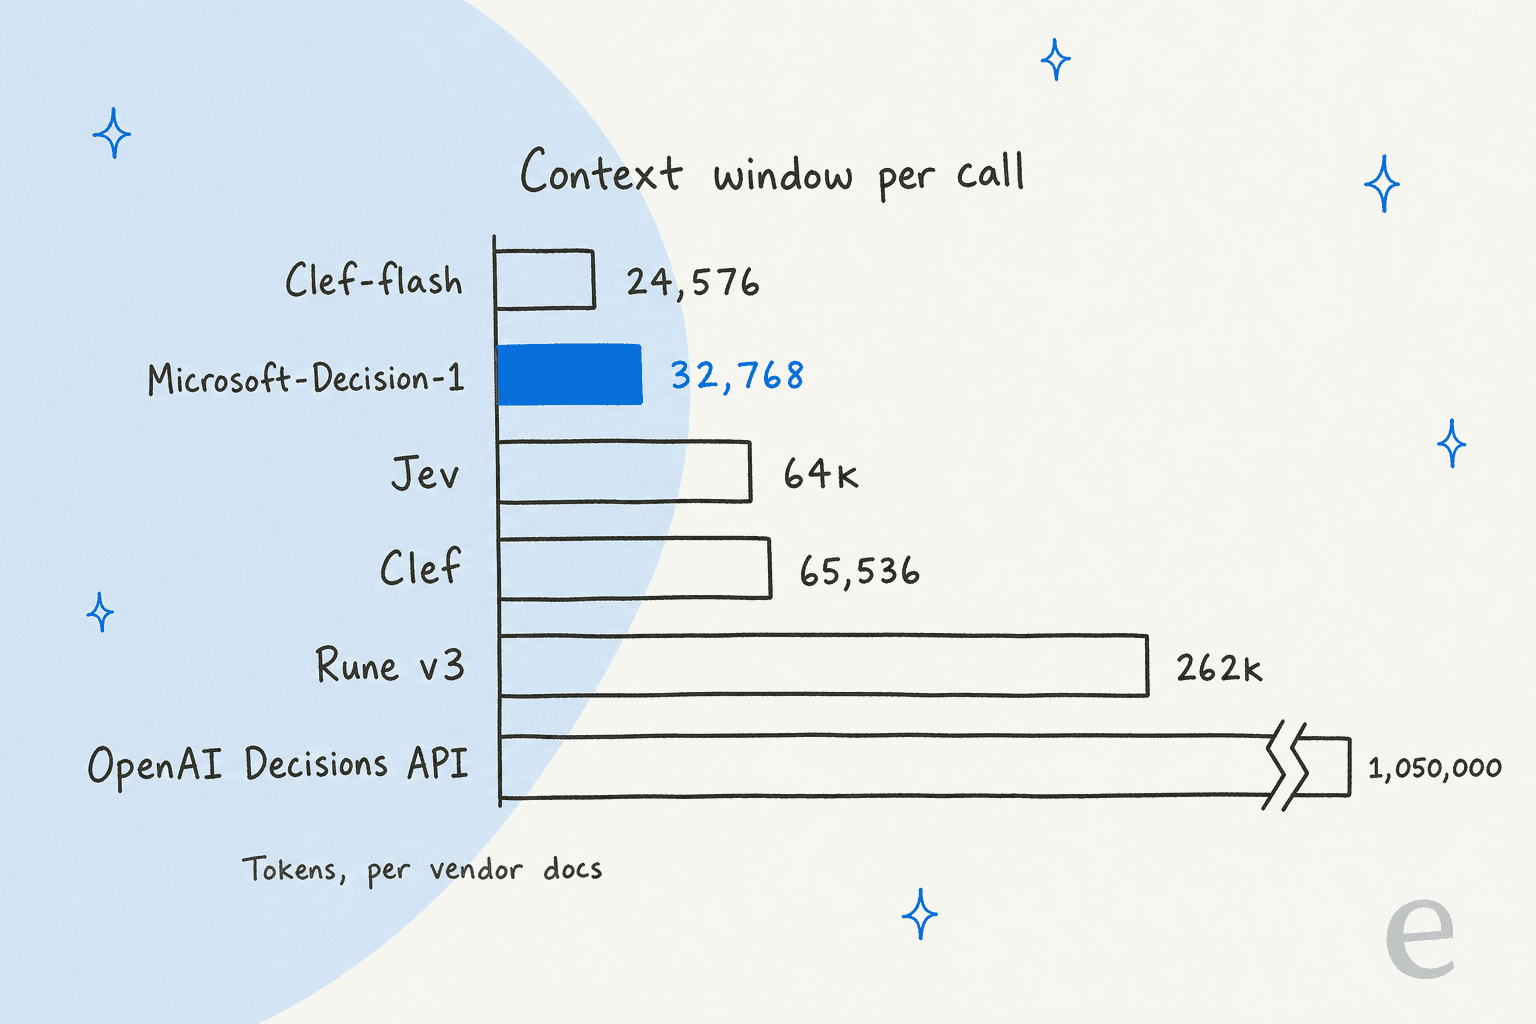
Perplexity Decider fehlt in diesem Diagramm absichtlich. Laut Modellkarte müssen Text und alle Bilder einer Entscheidung in 8,192 Tokens passen, und längere Eingaben werden abgelehnt statt gekürzt. Höchster Wert, kleinstes Fenster.
1. Jev 1.13 (TypeSafe)
Was es ist
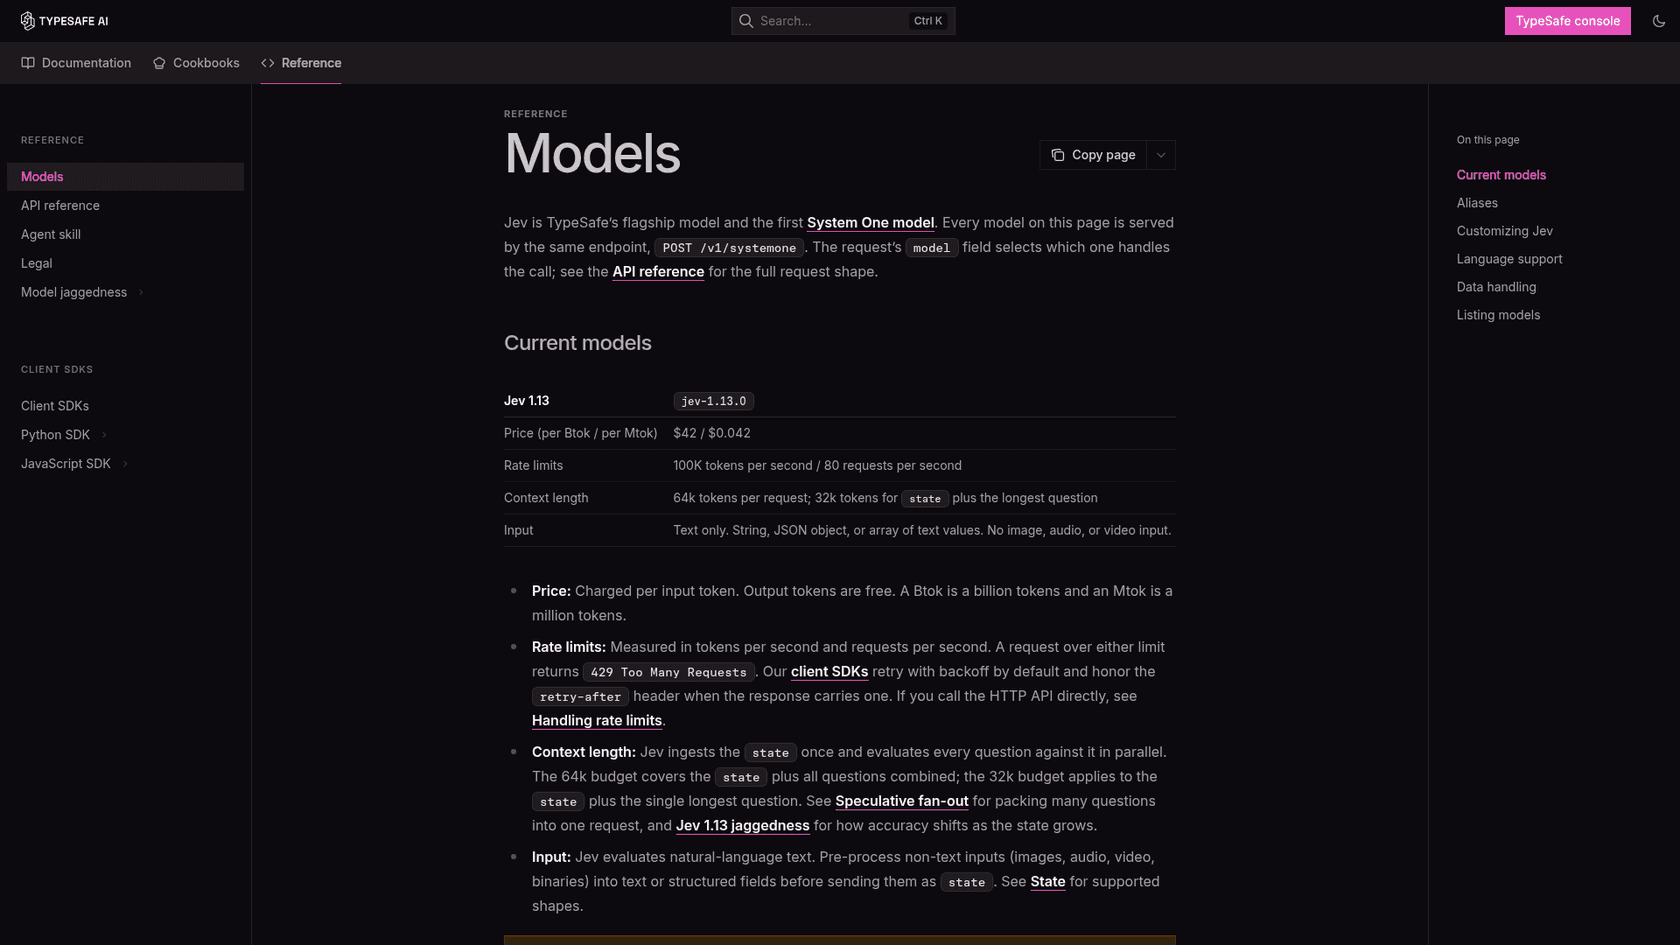
Jev ist das Modell, das die Kategorie begründet hat. TypeSafe stellt es über einen Endpunkt bereit, POST /v1/systemone, und es bewertet jede Frage, die Sie senden, parallel gegen einen gemeinsamen Zustand. Ich habe es in meinem Jev-Überblick ausführlich behandelt.
Wo es Microsoft-Decision-1 schlägt
- Größere Anfragen. Jev nimmt 64k Tokens pro Anfrage, davon 32k für den Zustand plus die längste einzelne Frage, laut TypeSafes Modellseite. Microsoft begrenzt bei 32,768.
- Bessere Kalibrierung. Selbst in Microsofts eigener Tabelle erreicht Jev 93.7 bei der Kalibrierung gegenüber Microsofts 92.2.
- Mehr Bezugsquellen. Neben TypeSafes API gibt es Jev auf Cloudflare Workers AI zum gleichen Preis, mit kostenlosem gecachtem Input und Zero Data Retention.
Wo es zurückbleibt
- Nur Text, wie bei Microsoft. Bilder müssen zuerst in Text umgewandelt werden.
- TypeSafe warnt, dass "Rate limits are adjusting dynamically" und sich ohne Vorankündigung ändern können. Das heutige Limit beträgt 100K Tokens und 80 Anfragen pro Sekunde.
- Microsofts Tabelle sieht es bei der Genauigkeit knapp hinten, 82.3 % zu 83.5 %.
Ein Hacker-News-Tester ließ beide am Tag nach dem Launch durch seine eigene Suite laufen:
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release."

Gleicher Listenpreis, unterschiedliche Rechnungen: Tokenizer zählen unterschiedlich, also testen Sie mit Ihren eigenen Tickets.
Preise
$0.042 pro Million Eingabe-Tokens, Ausgabe kostenlos, kein dokumentiertes Gratiskontingent. Mein Beitrag zu den Jev-Preisen rechnet die Kosten pro Entscheidung durch, und Jev Ultrafast behandelt die Speed-Stufe.
Am besten für
Teams, die eine Microsoft-Decision-1-Alternative mit gleichem Preis und gleicher API-Form, längeren Eingaben und ohne Azure-Abhängigkeit wollen.
2. OpenAI Decisions API (gpt-6-luna)
Was es ist
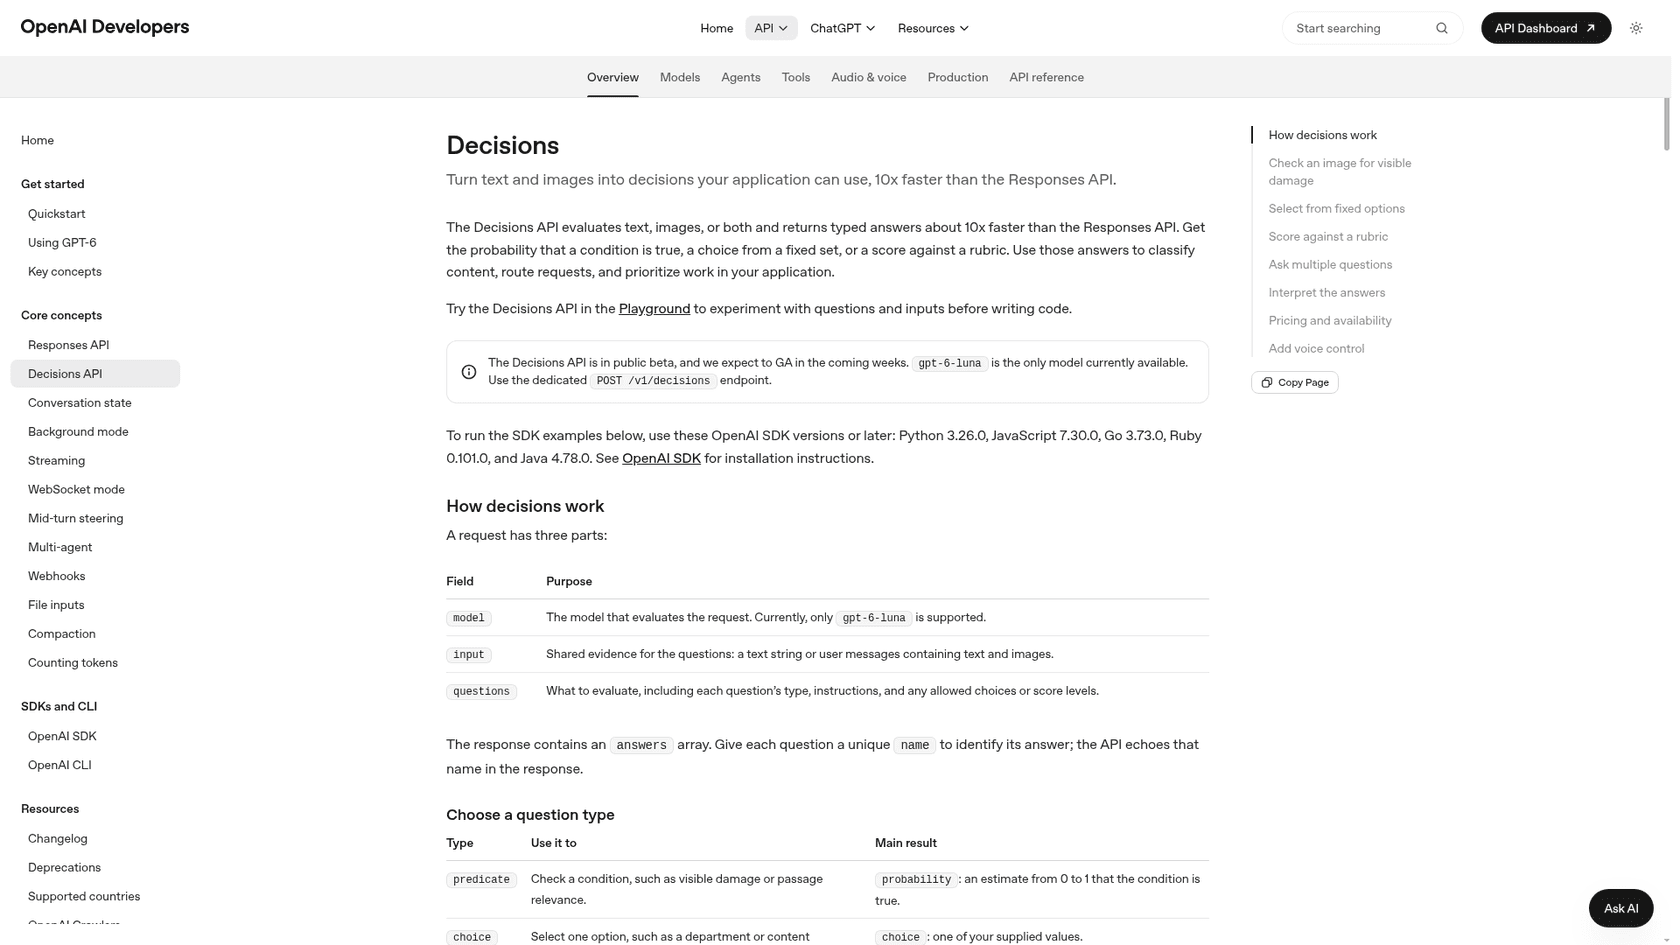
OpenAIs Version derselben Idee, am 6. Oktober als öffentliche Beta veröffentlicht. Sie rufen POST /v1/decisions mit gpt-6-luna auf, mit einer Eingabe aus Text und Bildern und einer Liste von Fragen vom Typ predicate, choice oder score. Mein Decisions-API-Leitfaden enthält die Schritt-für-Schritt-Anleitung.
Wo es Microsoft-Decision-1 schlägt
- Bilder. Es liest Text und Bilder in einem Aufruf. Bilder müssen Inline-Base64-Data-URLs sein.
- Riesiger Kontext. Es erbt das 1,050,000-Token-Fenster von GPT-6 Luna, sodass eine ganze Ticket-Historie hineinpasst.
- Compliance-Optionen. OpenAIs Leitfaden nennt Zero Data Retention und HIPAA für berechtigte Kunden sowie US- und EU-Datenresidenz.
Wo es zurückbleibt
- Es kostet etwa 2,4x mehr pro Token als Microsoft.
- Noch Beta. OpenAI erwartet GA "in the coming weeks".
- Prompts über 272K Tokens werden mit dem 2-Fachen der Eingabe abgerechnet, dazu kommen Aufschläge für regionale Verarbeitung.
- OpenAI veröffentlicht keine Latenz in Millisekunden, nur "about 10x faster than the Responses API". Microsofts Tabelle maß 300 ms Median und 79.4 % Genauigkeit.
Preise
$0.10 pro Million Eingabe-Tokens, ohne Gebühren für Ausgabe, Cache-Lesen oder Cache-Schreiben. Dieser Preis steht im Decisions-Leitfaden, noch nicht auf der Hauptseite zu den OpenAI-API-Preisen. Mehr in meinem Beitrag zu den Luna-Preisen.
Am besten für
Teams, die schon bei OpenAI sind und Screenshots oder lange Threads bewerten lassen müssen oder HIPAA-Unterlagen brauchen.
3. Cloudflare Clef-flash
Was es ist
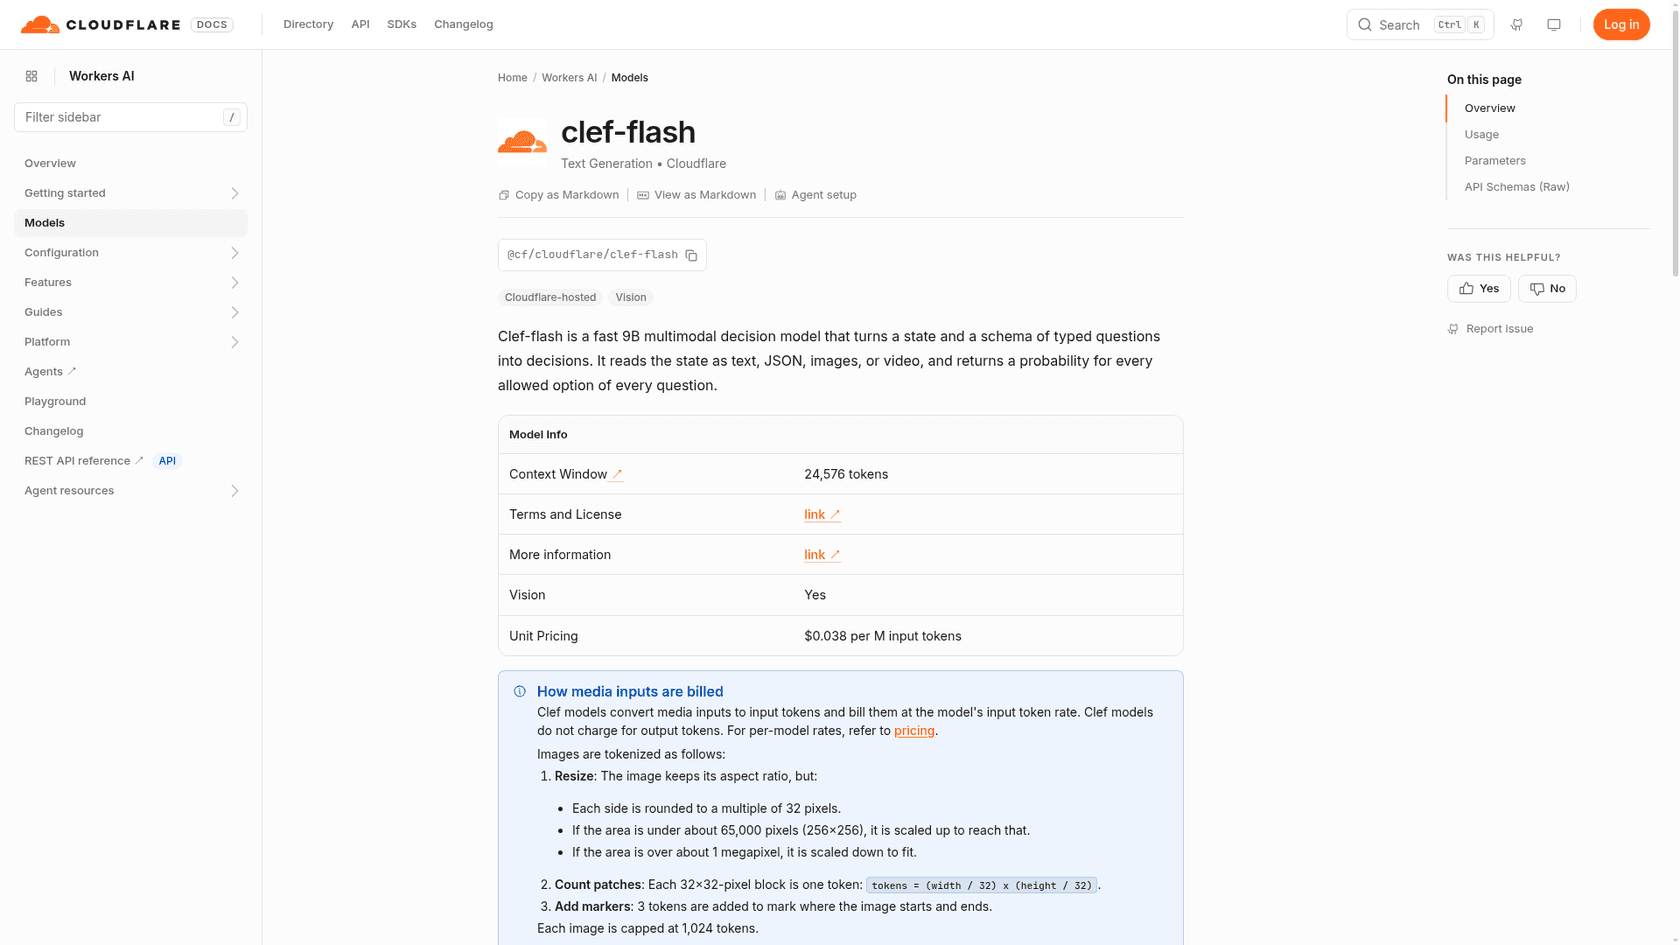
Cloudflares kleines Decision-Modell, ein 9B auf derselben Qwen3.5-9B-Basis wie Microsofts. Es läuft auf Workers AI als @cf/cloudflare/clef-flash, und die Gewichte liegen unter Apache 2.0 auf Hugging Face. Mein Clef-Überblick behandelt beide Clef-Größen.
Wo es Microsoft-Decision-1 schlägt
- Günstigster gehosteter Preis. $0.038 pro Million Eingabe-Tokens, vor einer Woche noch $0.09.
- Bilder. Cloudflares Seite listet Vision-Unterstützung, Bilder werden als Eingabe-Tokens abgerechnet.
- Tägliches Gratiskontingent. Workers AI gibt 10,000 Neurons pro Tag in Free- und Paid-Tarifen. Nach meiner Rechnung sind das etwa 2.9M Clef-flash-Eingabe-Tokens pro Tag.
- Offene Gewichte, sodass Sie es später ins eigene Haus holen können.
Wo es zurückbleibt
- Das Kontextfenster schrumpfte mit der Preissenkung auf 24,576 Tokens, kleiner als bei Microsoft.
- Es liegt im Decision Index auf Platz 33 (47.61), deutlich hinter Clef und Jev.
- Es steht nicht in Microsofts Vergleichstabelle, also gibt es keinen gemeinsamen Benchmark zwischen beiden.
Preise
$0.038 pro Million Eingabe-Tokens und keine Ausgabegebühr. Jenseits der freien Neurons berechnet Workers AI $0.011 pro 1,000 Neurons.
Am besten für
Klassifizierung von Text oder Bildern in hohem Volumen, wo die Kosten pro Aufruf am meisten zählen und die Eingaben kurz bleiben.
4. Cloudflare Clef
Was es ist
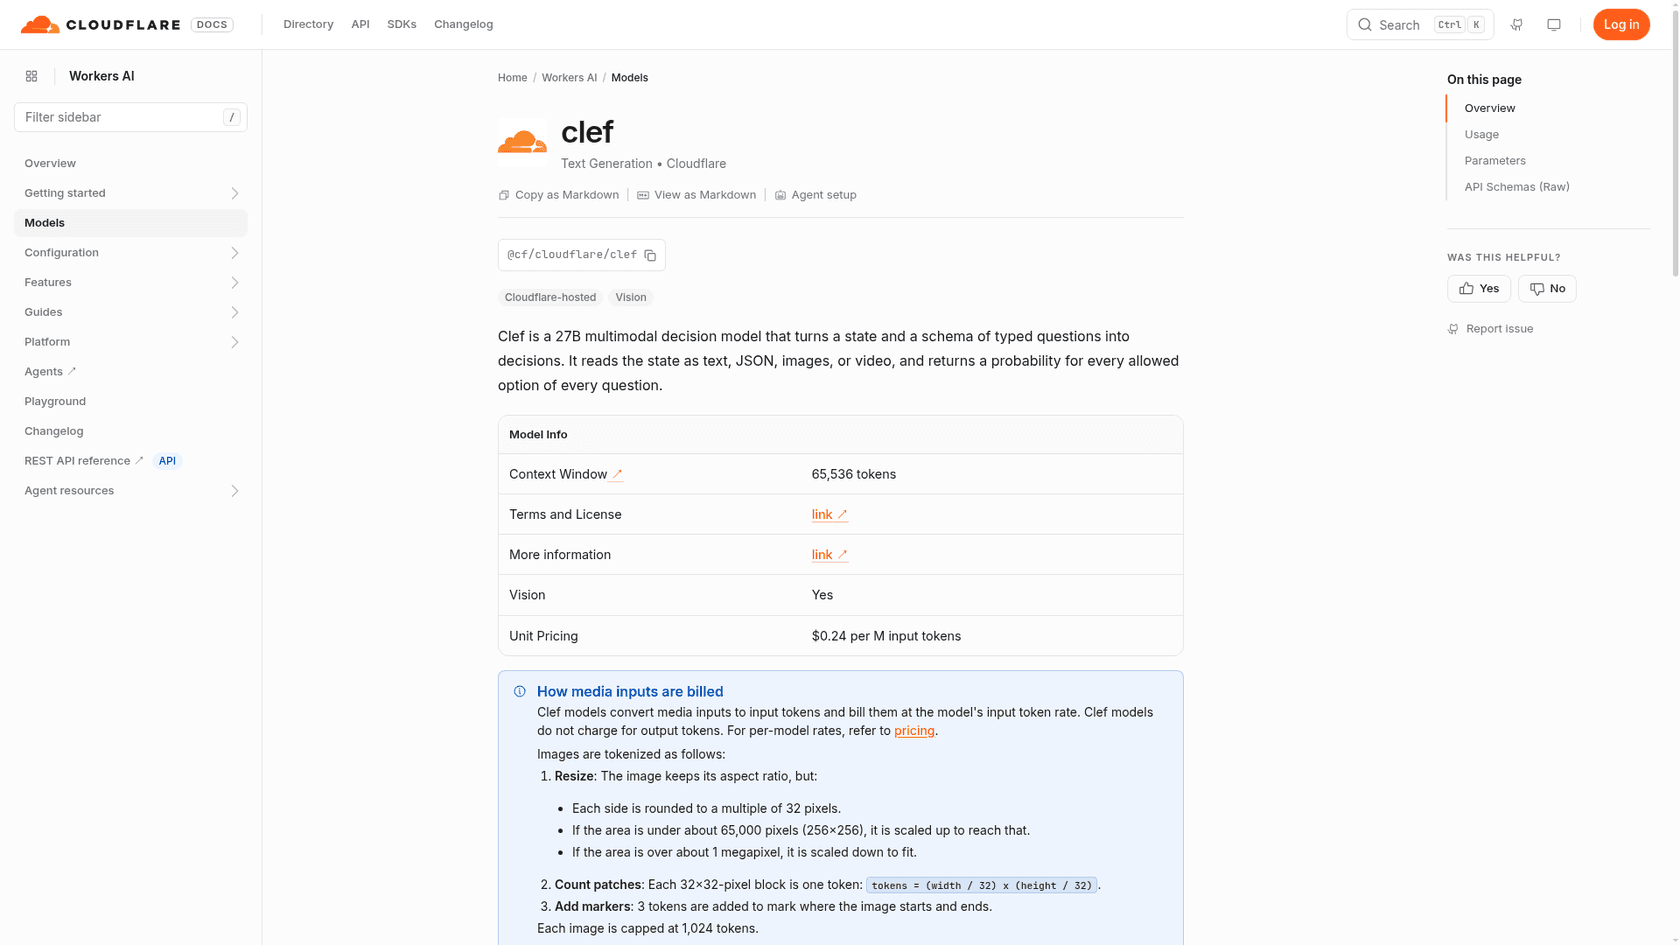
Das größere Clef: ein multimodales 27B-Decision-Modell, nachtrainiert aus Qwen3.8-27B, auf Workers AI gehostet und unter Apache 2.0 veröffentlicht.
Wo es Microsoft-Decision-1 schlägt
- Doppelter Kontext. 65,536 Tokens.
- Bilder und Video im Zustand, laut Cloudflares Modellkarte.
- Ein unabhängiger Wert. Es steht im Decision Index mit 53.08 Full, und sein Wert nur auf öffentlichen Benchmarks von 61.71 ist die höchste öffentliche Zahl unter den hier genannten gehosteten Optionen.
Wo es zurückbleibt
- Mit $0.24 pro Million Eingabe-Tokens kostet es fast das 6-Fache von Microsofts Preis.
- Der Wert im privaten Test rutscht auf Platz 19, die öffentliche Zahl schmeichelt ihm also.
- Cloudflares selbst gemeldeter Median lag bei 209 ms, langsamer als Microsofts angegebene 85 ms.
Preise
$0.24 pro Million Eingabe-Tokens, keine Ausgabegebühr und dieselben 10,000 freien Neurons pro Tag (etwa 458K Clef-Eingabe-Tokens). Mein Beitrag zu den Clef-Preisen enthält die Rechnung.
Am besten für
Teams auf Cloudflare, die längere multimodale Eingaben brauchen und dafür pro Aufruf mehr zahlen.
5. Perplexity Decider v1.1 (27B)
Was es ist
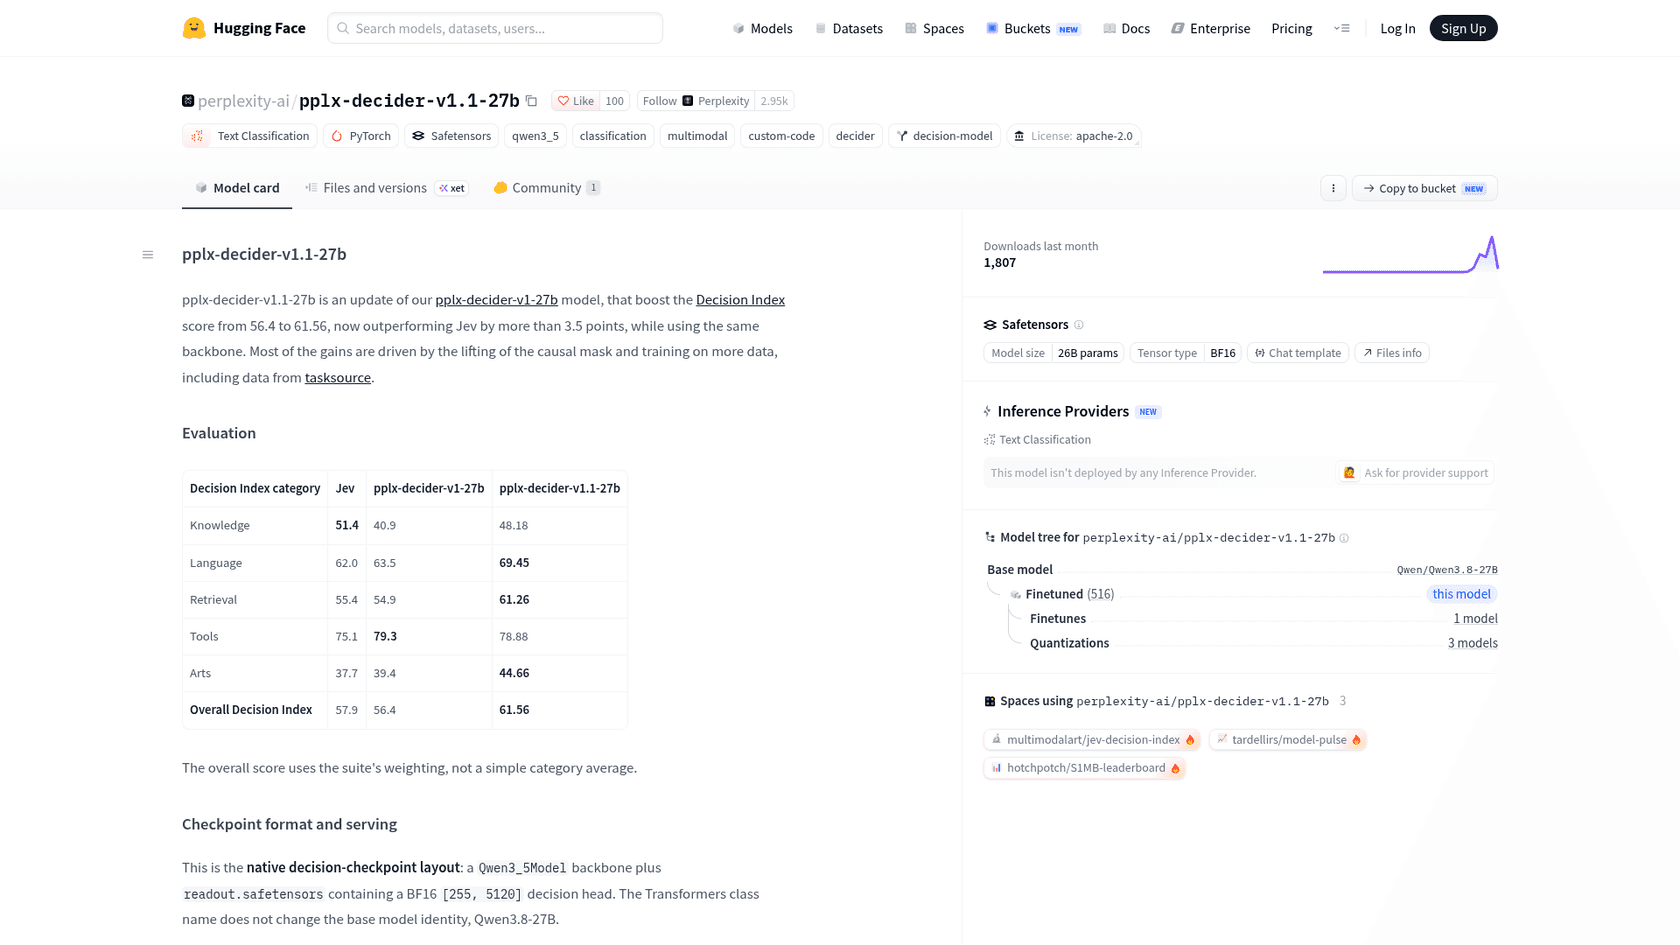
Perplexitys offenes Decision-Modell, ein vollständiges Fine-Tuning von Qwen3.8-27B mit separatem Decision-Head. Perplexity sagt, v1.1 habe den Großteil seiner Verbesserung durch "the lifting of the causal mask" und mehr Trainingsdaten erzielt. Sie laden es von Hugging Face herunter und betreiben es mit dem mitgelieferten Code.
Wo es Microsoft-Decision-1 schlägt
- Bester unabhängiger Wert. Es steht auf Platz eins im Decision Index v0.3.1 mit 62.75, vor Jevs 60.11.
- Die Gewichte gehören Ihnen. Apache 2.0, nichts verlässt Ihre Server.
- Bilder, übergeben als Dateipfade, PIL-Bilder oder Base64-URLs.
Wo es zurückbleibt
- Hartes Limit von 8,192 Tokens pro Entscheidung, Text und Bilder zusammen.
- Sie brauchen eine CUDA-GPU mit Platz für etwa 49 GiB Gewichte plus Arbeitsspeicher sowie ein authentifiziertes Hugging-Face-Konto zum Download.
- Keine gehostete API: Laut Karte bietet kein Inference-Provider es an.
- Die Standard-Inferenz mit kausaler Maske reproduziert den evaluierten Aufbau nicht, Sie müssen also Perplexitys eigenen Code oder einen sorgfältigen Export verwenden.
Preise
Kostenlos zum Download. Ihre Kosten sind GPU-Zeit. Zu den Kosten hat es ein Hacker-News-Kommentator gut auf den Punkt gebracht:
"Open weight model pricing isn't really up to the company that built them (unless they are also serving them, in which case their API price may differ). It's really up to the serving cost and/or pricing of whoever is actually serving the model."
Am besten für
ML-Teams mit freier GPU-Kapazität, die das genaueste offene Modell wollen und ihre Eingaben kurz halten.
6. Surogate Rune 26B-A4B v3
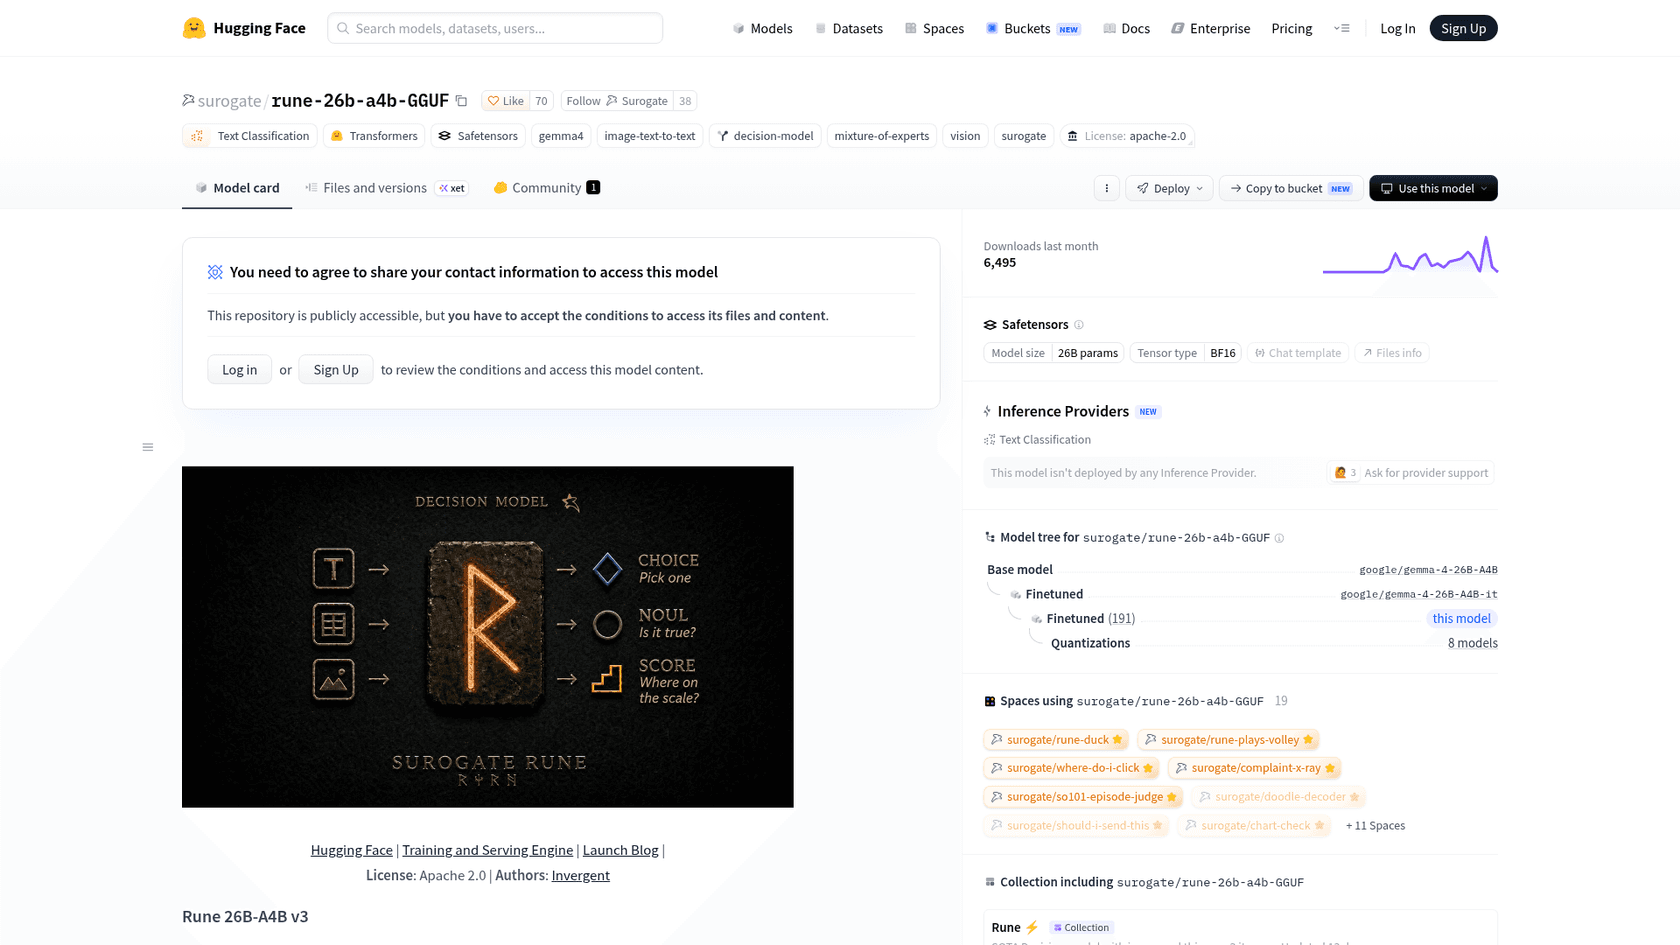
Was es ist
Invergents offenes Decision-Modell, ein vollständiges Fine-Tuning von Gemma 4 26B-A4B (8 von 128 Experten pro Token aktiv). Es beantwortet Fragen vom Typ choice, noul und score und wird am schnellsten von der Open-Source-Engine surogate bedient.
Wo es Microsoft-Decision-1 schlägt
- Lange Eingaben. Die Karte nennt einen 262k-Kontext, das Achtfache von Microsofts.
- Bilder, mit erhaltenem Vision-Tower. Invergents eigener Bildtest erreichte 83.4 % bei 1,120 Bild-Tokens.
- Optionales Thinking. Mit
"thinking": trueüberlegt es bei Fragen, bei denen es unsicher ist, vor der Antwort. Invergent schätzt, dass das seinen Index um etwa 1.8 Punkte hebt, bei etwa 5 Sekunden pro Thinking-Frage. - In Microsofts eigener Tabelle erreichte es 79.7 %, nah an OpenAIs Luna.
Wo es zurückbleibt
- Downloads liegen hinter einem Kontaktdaten-Formular.
- Seine Standard-Wahrscheinlichkeiten sind überkonfident. Die Karte empfiehlt, Antworten bei Temperatur 2 zu lesen, um die Kalibrierung zu korrigieren.
- Invergent maß einen Median von 388 ms pro Anfrage auf einer RTX PRO 6000, langsamer als Microsofts Angabe.
- Platz 10 im Decision Index (57.43), hinter Perplexity und Jev.
Preise
Kostenlos zum Download unter Apache 2.0. Sie zahlen für die Hardware.
Am besten für
Self-Hoster, die lange oder bildlastige Eingaben brauchen und das Serving selbst abstimmen können.
7. Strands Decider (AWS Strands Labs)
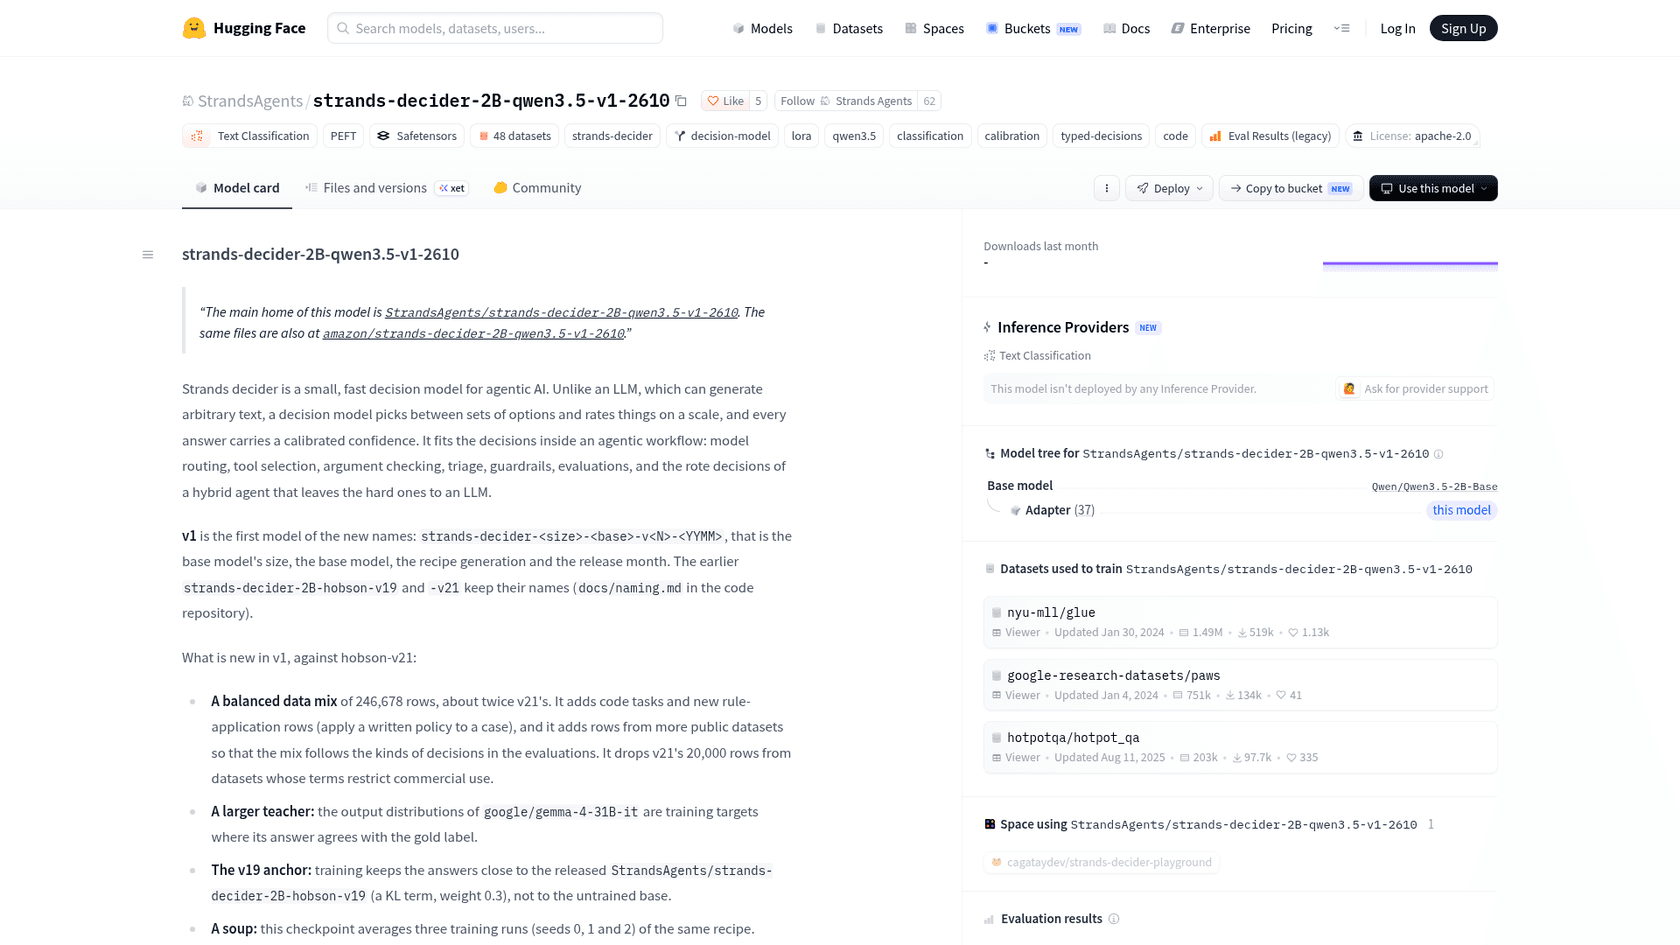
Was es ist
Ein kleines offenes Decision-Modell aus AWS' Strands Labs, gebaut für Agentenschritte wie Tool-Auswahl, Guardrails und Routing. Das Referenzmodell ist ein 2B auf Qwen3.5, und vier Gemma-4-Größen folgten am 10. und 11. Oktober. Den Launch habe ich in meinem Beitrag zu Strands Decider behandelt.
Wo es Microsoft-Decision-1 schlägt
- Läuft auf bescheidener Hardware. Das 2B erreichte in Strands' eigenem Test einen Median von 115 ms auf einer einzelnen RTX 3090.
- Kostenlos und offen, Apache 2.0, und es passt in das größere Strands-Harness für Agenten.
- Optionale Bildeingabe mit
--vision, wobei Strands anmerkt, dass nichts mit Bildern trainiert wurde.
Wo es zurückbleibt
- Die Genauigkeit ist deutlich niedriger. Microsofts Tabelle zeigt 54.8 % bei nur 23 von 36 Benchmarks, und der Decision Index reiht es auf Platz 84 (21.75).
- Es wurde mit Fenstern von 3,072 und 4,096 Tokens getestet.
- Es gibt nirgends eine gehostete API, auch nicht auf Bedrock.
Preise
Kostenlos. Ihre eigene GPU oder CPU.
Am besten für
Günstige, lokale Agenten-Guardrails und Tool-Auswahl, wo Tempo auf kleiner Hardware wichtiger ist als Top-Genauigkeit.
8. eesel (wenn Sie die Entscheidung und die Arbeit wollen)

Was es ist
Kein Modell. Die sieben Optionen oben sind Infrastruktur. eesel ist der Mitarbeiter: ein KI-Helpdesk-Teammitglied, das in Ihre Zendesk-, Freshdesk- oder Gorgias-Queue einsteigt, den Routing-Entscheid trifft und dann die Antwort schreibt oder die Aktion ausführt. Es lernt aus Ihren früheren Tickets und Ihrem Help Center.
Wo es Microsoft-Decision-1 schlägt
- Keine Pipeline zu bauen. Keine Schwellenwerte, Webhooks oder Helpdesk-API-Klebecode.
- Es handelt auf Basis der Antwort. Tags, Priorität, Eskalation und die Antwort selbst.
- Riskante Aktionen können auf Freigabe warten, sodass ein Mensch zustimmt, bevor etwas Unumkehrbares passiert.
Wo es zurückbleibt
- Pro Ticket deutlich teurer als ein einzelner Modellaufruf, weil die Arbeit eingeschlossen ist.
- Es lebt in Ihrem Helpdesk. Wenn Sie Entscheidungen im Codepfad Ihrer eigenen App brauchen, nutzen Sie ein Modell.
Preise
eesels Tarife beginnen bei $299 im Monat für 500 Credits, wobei ein Ticket oder ein Chat ein Credit ist, egal wie lange er läuft. 5,000 Credits kosten $1,749 im Monat. Es gibt einen kostenlosen Start mit 100 Credits und ohne Karte.
Am besten für
Support-Teams, deren eigentliches Ziel sortierte und beantwortete Tickets sind, nicht ein Modell, das man anbinden muss.
Welche Microsoft-Decision-1-Alternative sollten Sie wählen?
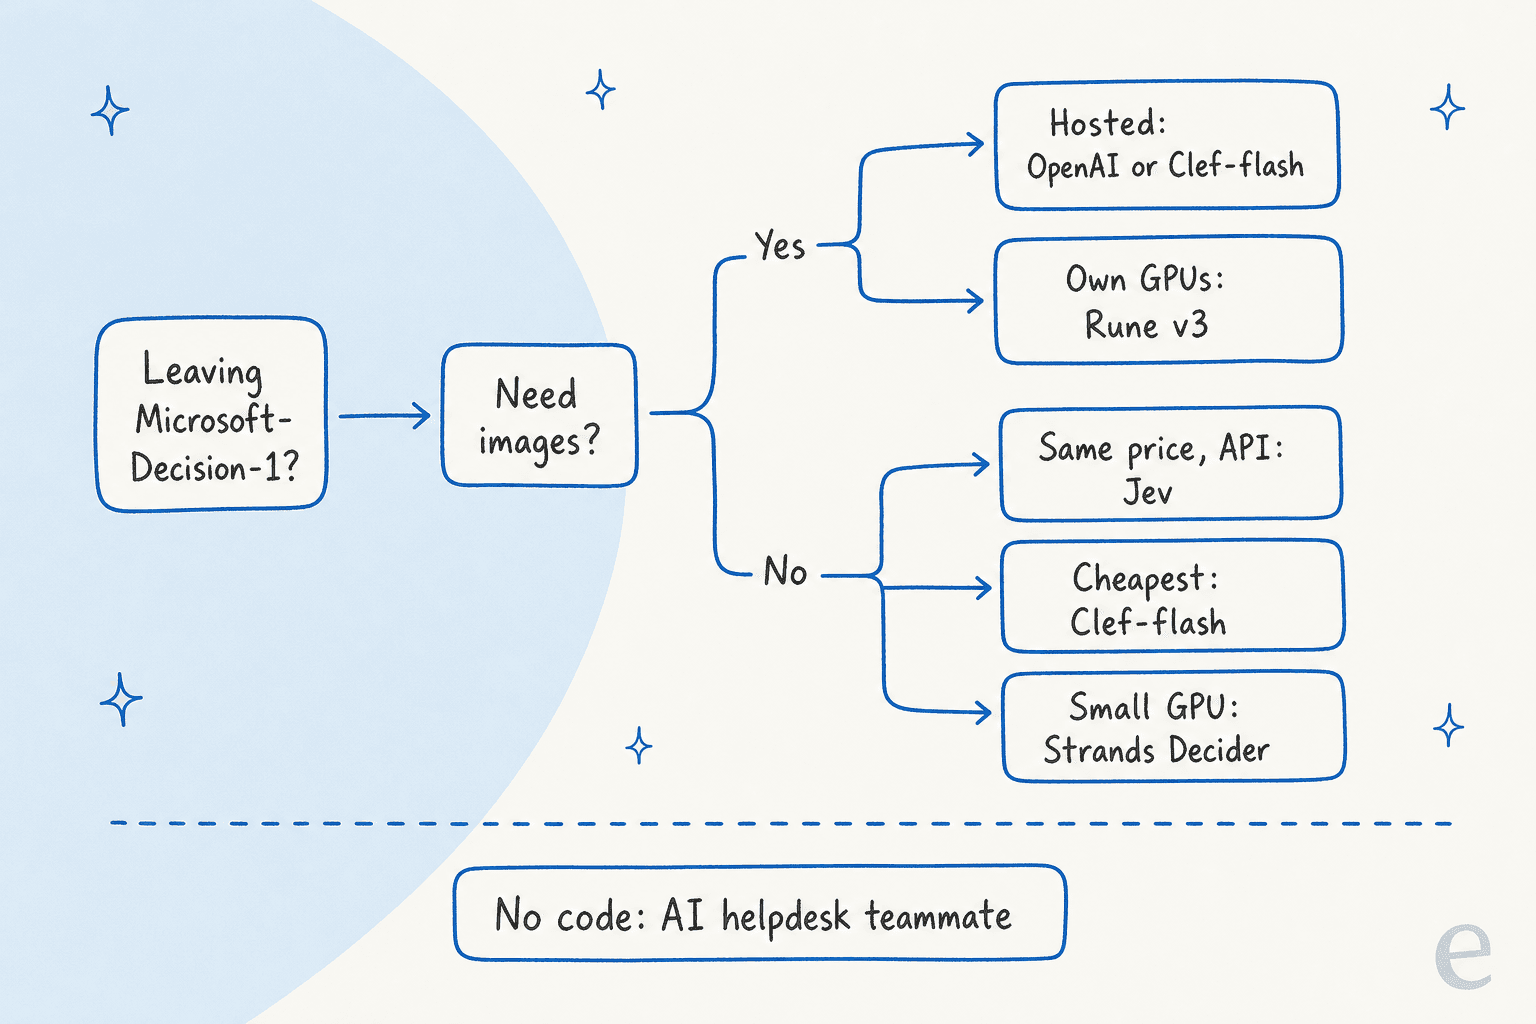
Meine Kurzfassung:
- Gleiche Aufgabe, kein Azure: Jev zum gleichen Preis. Vergleichen Sie beide zuerst mit Ihren eigenen Daten.
- Niedrigste Rechnung: Clef-flash, wenn Ihre Eingaben in 24,576 Tokens passen.
- Bilder oder sehr lange Threads: OpenAIs Decisions API gehostet, Rune v3 selbst gehostet.
- Beste offene Genauigkeit: Perplexity Decider v1.1, wenn 8,192 Tokens reichen.
- Klein und lokal: Strands Decider für Agenten-Guardrails.
Für Support-Teams ist der Anwendungsfall fast immer Ticket-Klassifizierung und Routing. Dort verdient sich der Wahrscheinlichkeitswert seinen Platz: Sie automatisieren nur, wobei das Modell sicher ist. In echten Queues kommt der schwierige Teil danach. In einem Beispiel aus unseren eigenen Daten glich die KI eines Web3-Infrastrukturunternehmens einen kalten Vertriebspitch aus einer Kontaktliste mit früheren Zendesk-Tickets ab, klassifizierte ihn als Spam und entwarf eine höfliche Absage als interne Notiz, statt zu versuchen, ihn zu beantworten. Ein Decision-Modell liefert Ihnen das Label "Spam". Jemand muss trotzdem die Historie lesen und die Notiz schreiben.
Achten Sie auch auf falsch positive Ergebnisse beim Tagging. Eine Fehlerrate von 1 % ist pro Aufruf billig und teuer, wenn sie eine Rückerstattung an den Vertrieb leitet. Mein Überblick über die beste KI für Triage vergleicht Tools, die das von Haus aus erledigen.
Das Modell überspringen, die Entscheidung behalten
Wenn Sie Microsoft-Decision-1-Alternativen vergleichen, weil Sie Tickets geroutet, getaggt und priorisiert haben wollen, brauchen Sie vielleicht gar kein Modell. eesel arbeitet wie ein neuer Mitarbeiter für Ihren Helpdesk: Es lässt sich in Minuten in Zendesk oder Freshdesk einbinden, liest Ihre früheren Tickets, trifft dieselben Triage-Entscheidungen wie ein Decision-Modell und beantwortet dann den Kunden. Sie können es an historischen Tickets simulieren, bevor es ein Live-Ticket anfasst.
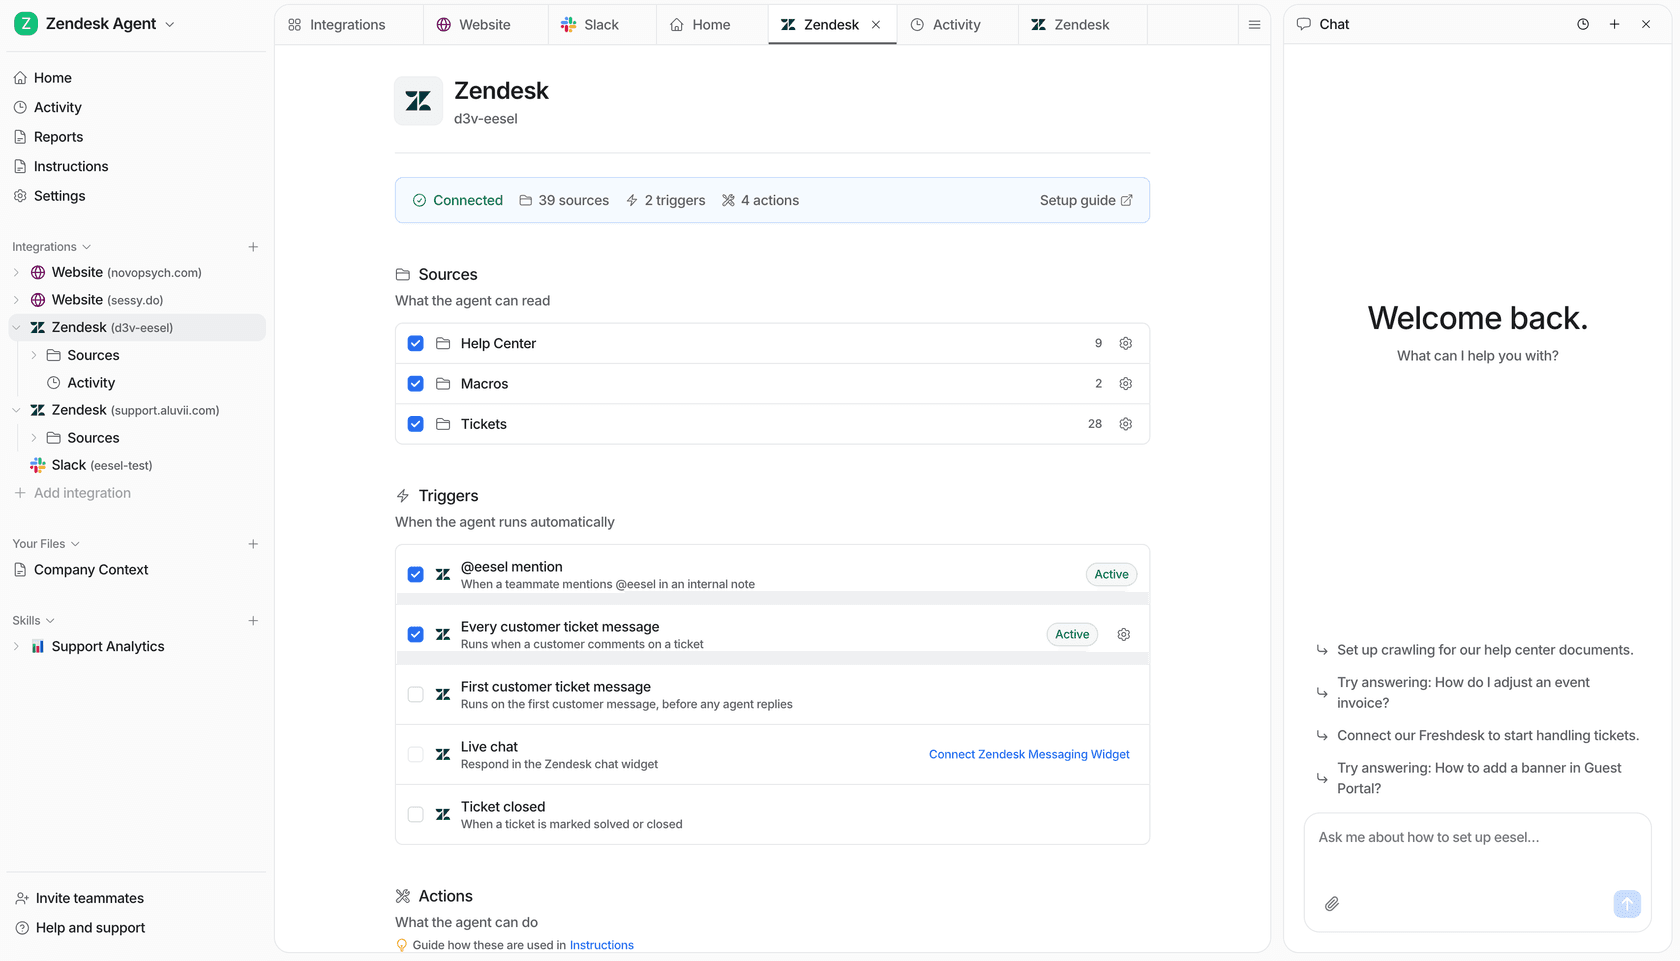
Wenn Sie es lieber aus Code steuern, führt die eesel CLI dasselbe Teammitglied aus wie das Dashboard. Jeder Befehl gibt JSON aus, sodass Sie, ein Skript oder ein Coding-Agent wie Claude Code, Codex oder Cursor es einrichten können. eesel integrations verbindet Ihren Helpdesk, eesel automations enable <platform> <key> --instructions "..." schreibt eine Triage-Regel in einfachen Worten, und eesel approvals listet zurückgehaltene Aktionen zum Genehmigen oder Ablehnen auf. Mehr dazu, warum das wichtig ist, in meinem Beitrag zur Agent-CLI.
eesel testen, kostenlos mit 100 Credits, und auf eine Woche Ihrer Tickets ansetzen. Wenn es sie so gut routet wie Ihre Decision-Pipeline, haben Sie sich den Bau gespart.
Häufig gestellte Fragen
Was sind die besten Alternativen zu Microsoft-Decision-1?
Der naheliegendste Ersatz ist Jev von TypeSafe, das mit $0.042 pro Million Eingabe-Tokens genauso viel kostet. OpenAIs Decisions API bringt Bilder und ein riesiges Kontextfenster mit, Cloudflares Clef-flash ist mit $0.038 die günstigste gehostete Option, und Perplexity Decider, Rune v3 und Strands Decider sind Open-Weight-Alternativen zu Microsoft-Decision-1, die Sie selbst betreiben.
Gibt es eine günstigere Alternative zu Microsoft-Decision-1?
Ja. Cloudflares Clef-flash kostet $0.038 pro Million Eingabe-Tokens gegenüber $0.042 bei Microsoft, bei beiden ist die Ausgabe kostenlos. Die Open-Weight-Modelle kosten im Download nichts, dafür zahlen Sie die GPU. Meine Aufschlüsselung zu den Clef-Preisen behandelt das tägliche Gratiskontingent auf Workers AI.
Ist Jev besser als Microsoft-Decision-1?
In Microsofts eigener Tabelle mit 36 Benchmarks erreichte Microsoft-Decision-1 im Schnitt 83.5 % Genauigkeit gegenüber 82.3 % bei Jev, während Jev bei der Kalibrierung höher lag (93.7 vs. 92.2). Die Preise sind identisch. Jev verarbeitet 64k Tokens pro Anfrage, Microsoft 32,768. Mein Jev-Test zeigt mehr dazu, wie es sich in der Praxis verhält.
Gibt es eine Open-Source-Alternative zu Microsoft-Decision-1?
Microsoft hat keine Gewichte veröffentlicht, daher können Sie es nicht selbst hosten. Perplexity Decider v1.1, Surogate Rune 26B-A4B v3, Cloudflares Clef-Modelle und AWS' Strands Decider erscheinen alle unter Apache 2.0. Perplexity Decider v1.1 führt derzeit den Community-Decision-Index an.
Welche Alternative zu Microsoft-Decision-1 unterstützt Bilder?
OpenAIs Decisions API, Cloudflare Clef und Clef-flash, Perplexity Decider und Rune v3 akzeptieren alle Bilder. Microsoft-Decision-1 und Jev verarbeiten nur Text. Wenn in Ihrem Ticket-Triage-Ablauf Screenshots auftauchen, grenzt allein das die Liste ein.
Wie schneidet Microsoft-Decision-1 im Vergleich zur OpenAI Decisions API ab?
OpenAI berechnet $0.10 pro Million Eingabe-Tokens für gpt-6-luna, etwa das 2,4-Fache von Microsofts Preis, ebenfalls mit kostenloser Ausgabe. Dafür erhalten Sie Bilder, ein Fenster von 1,050,000 Tokens sowie ZDR- und HIPAA-Optionen für berechtigte Kunden. Die API befindet sich noch in der öffentlichen Beta. Siehe meinen Beitrag zu den Decisions-API-Preisen.
Brauche ich ein Decision-Modell, um Support-Tickets zu routen?
Nur wenn Sie Routing in Ihr eigenes Produkt oder Ihre eigene Pipeline einbauen. Wenn das Ziel darin besteht, Tickets in Ihrem Helpdesk zu sortieren und zu beantworten, erledigt ein KI-Helpdesk-Agent Entscheidung und Arbeit ohne Code. Mein Leitfaden zum Automatisieren der Ticket-Triage führt durch beide Wege.