Was ist PostHog Jeeves?
Jeeves ist ein „reasoning Jev-style classifier with a diffusion drafter“, den PostHog am 29. September 2026 veröffentlicht hat. Gebaut hat es Nicholas Waltz, AI Research Engineer im AI-Research-Team von PostHog, der zuvor zwei Jahre in einem YC-Startup RL-Modelle für Drohnenlieferungen entwickelt hat, laut seinem PostHog-Profil.
Um Jeeves zu verstehen, muss man wissen, was es nachbaut. Ein „Entscheidungsmodell“ schreibt keinen Text. Sie schicken ihm einen Zustand (eine E-Mail, ein Ticket, einen JSON-Block) und eine Reihe typisierter Fragen, und es schickt für jede Antwortoption eine Wahrscheinlichkeit zurück. Die Kategorie wurde zwei Wochen vorher bekannt, als TypeSafe Jev vorstellte, mit drei Fragetypen: einem Ja/Nein-noul, einem Auswahl-choice und einem Bewertungsraster score. Jev ist geschlossen und gehostet. Binnen Tagen veröffentlichte Jared Palmers Kev offene, Jev-kompatible Gewichte, und Jeeves nennt Kev als Inspiration.
Was Jeeves hinzufügt, ist das Nachdenken. Die README beschreibt das Problem unverblümt: Jev-artige Modelle „give calibrated decision probabilities, but at low accuracy“, daher „a lot of pipelines therefore rely on a reasoning model as a fallback.“ Dieser Fallback ist meist ein gehostetes LLM, das pro Token abgerechnet wird, die Art Kosten, die ich in Claude Sonnet 5.5 pricing aufgeschlüsselt habe. Jeeves versucht, dieser Fallback zu sein, in Jevs eigener Form.
Die wichtigsten Daten:
| PostHog Jeeves | |
|---|---|
| Basismodell | Qwen3.5-9B mit LoRA und einem Pointer-Head (siehe Qwen-Alternativen) |
| Fragetypen | noul (Ja/Nein), choice, score, in einer Anfrage mischbar |
| API | Jev-kompatibles /v1/systemone, plus ein Drop-in-Python-SDK |
| Lizenz | Code MIT, Gewichte Apache-2.0 (von Qwen3.5 geerbt) |
| Größe der Gewichte | 21 GB bf16, 11.5 GB mit FP8-Linearschichten |
| Hardware | CUDA-GPU; Apple-Silicon-Mac mit 48 GB+ für Inferenz |
| Gehostete API | Keine. Nur Self-Hosting |
| Resonanz beim Launch | 241 Punkte auf Hacker News, 356 GitHub-Sterne |
Ich bin Alicia und baue die KI-Agenten in eesel, ich beschäftige mich also viel mit genau dieser Schicht: dem Teil der Pipeline, der entscheidet, was ein Ticket ist, bevor etwas geschrieben wird. So macht Jeeves das, und hier verdient es sich seinen Platz.
Wie begründet Jeeves, bevor es entscheidet?
Der Mechanismus ist ein hübsches Stück Engineering und erklärt sowohl den Genauigkeitsgewinn als auch die Latenzkosten.
Jeeves lädt den Zustand und jede Frage mit seltenen, kaum genutzten Tokens als Markern in das Qwen-Chat-Template (<|fim_prefix|> für den Zustand, <|box_start|> für jede Option und so weiter). Dann tut es etwas, das Jev nicht tut: Es erzeugt innerhalb eines <think>-Blocks eine freie Begründungskette. Nachdem die Kette geschlossen ist, werden Frage und Optionen wiederholt, und ein kleiner Pointer-Head bewertet jede Option, indem er den versteckten Zustand an einem <decide>-Token mit dem versteckten Zustand am Ende jeder Option vergleicht. Ein Softmax über diese Werte, geteilt durch eine auf Dev-Daten angepasste Temperatur (1.859, laut Hugging-Face-Modellkarte), ergibt die endgültigen Wahrscheinlichkeiten.
Zwei Details aus den Ablationen sind wissenswert, falls Sie so etwas selbst trainieren. Das Ersetzen der seltenen Tokens durch gewöhnliche Wörter wie „State“ verschlechterte die Ergebnisse. Ebenso das Weglassen der wiederholten Frage nach dem Begründungsblock. Das Modell muss kurz vor der Festlegung an die Optionen erinnert werden.
Das Training lief in drei Stufen, alle im Repo dokumentiert:
- Supervised Fine-Tuning: 2 Epochen, 596 Schritte auf 8 GPUs, über 19,126 Fragen aus 12 öffentlichen Datensätzen plus synthetischen Policy-Daten. Die Hälfte der Fragen enthielt eine vom Basismodell gesampelte Begründungskette.
- Reinforcement Learning mit CISPO: die RL-Methode aus MiniMax-M1, auf 9,992 Fragen mit je 8 Rollouts, begrenzt auf 2,560 Denk-Tokens. Der Plan über 624 Schritte wurde bei Schritt 402 gestoppt, weil danach „the head over-sharpens“ und die Kalibrierung schlechter wird.
- Kalibrierung: eine einzelne Temperatur, auf Dev angepasst und mit dem Checkpoint gespeichert.
Den Stopp bei Schritt 402 würde ich unterstreichen. Das Team opferte etwas Rohwert, um die Wahrscheinlichkeiten ehrlich zu halten, und genau deshalb nutzt man überhaupt ein Entscheidungsmodell. Ein Modell, das 90 % sagt und in 70 % der Fälle richtig liegt, ist in einer Routing-Pipeline schlimmer als nutzlos, und es ist dasselbe Grundproblem hinter den meisten KI-Halluzinationen im Support.
Um Tempo zurückzuholen, liefert Jeeves einen Diffusion-Drafter mit, der für spekulatives Decoding mehrere Begründungs-Tokens auf einmal vorschlägt. Bei einer Frage hebt er die Kettengeschwindigkeit mit Block-4-Drafting von 109 auf 176 Tokens pro Sekunde und bei acht gebündelten Fragen auf insgesamt etwa 960 Tokens pro Sekunde.
Wo schlägt Jeeves Jev, und wo verliert es?
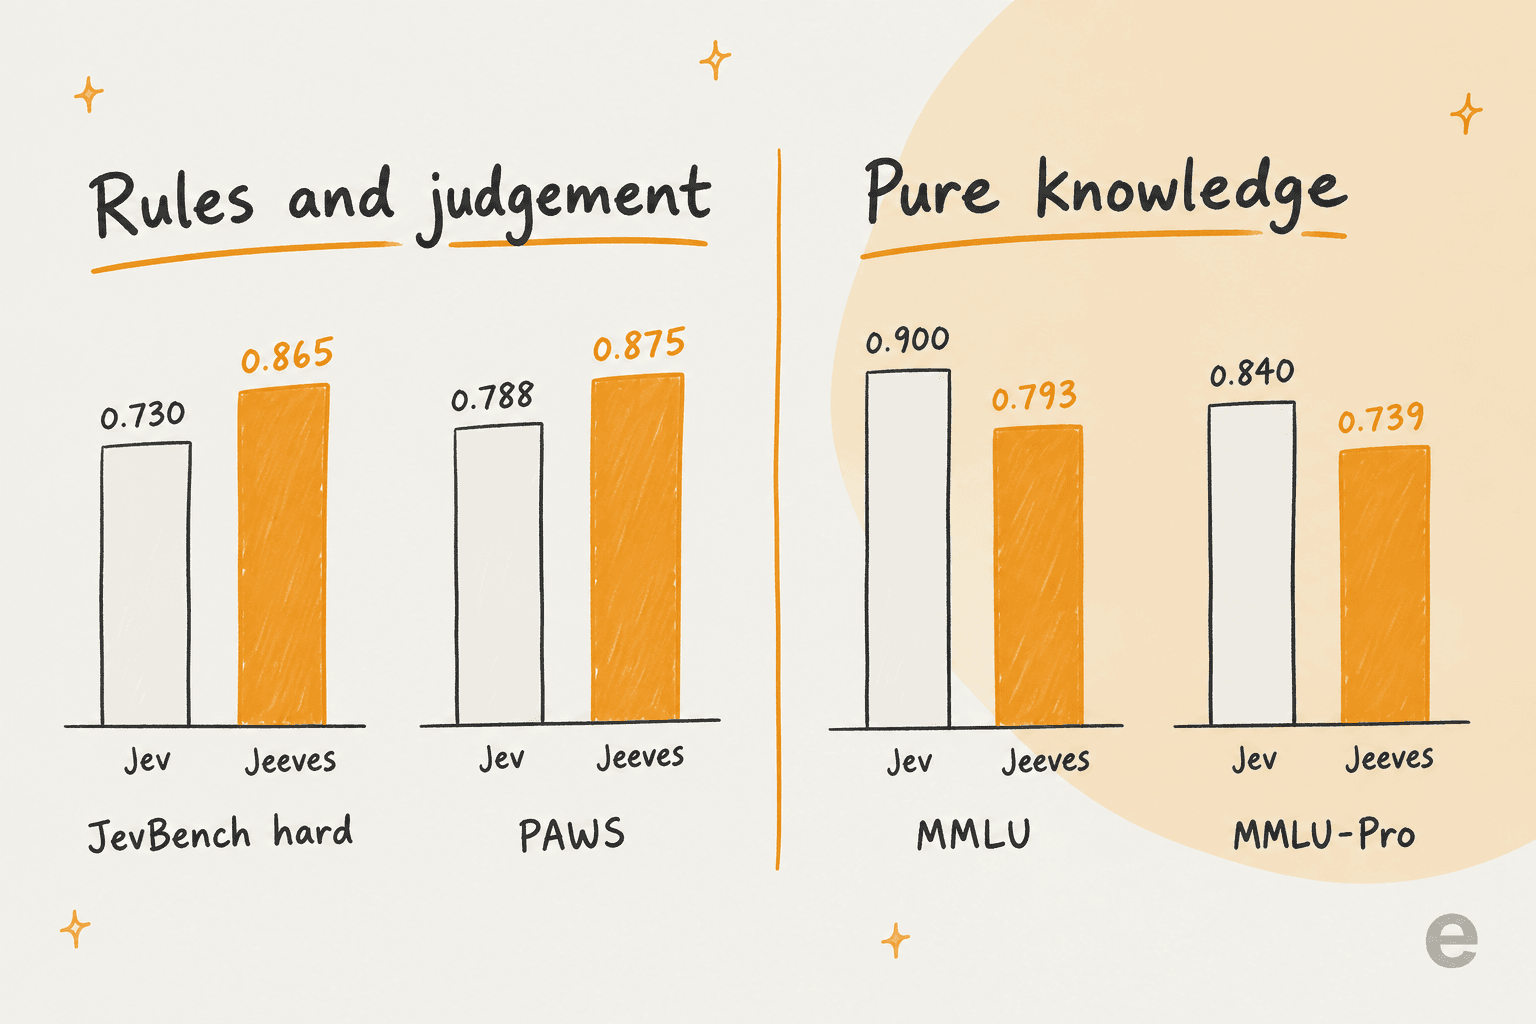
PostHogs Ergebnistabelle ist ungewöhnlich offen, und das Muster darin ist das Nützlichste am Launch.
| Benchmark | Kev-9B | Jev | Jeeves |
|---|---|---|---|
| Test gesamt (zurückgehalten und außerhalb der Domäne) | 0.822 | 0.857 | 0.889 |
| JevBench gesamt (231 öffentliche Items) | 0.715* | 0.866 | 0.935 |
| JevBench hard (111 öffentliche Items) | 0.451* | 0.730 | 0.865 |
| PAWS (Paraphrasenerkennung) | 0.763 | 0.788 | 0.875 |
| Zurückgehaltene Regelstrukturen | 0.896 | 0.885 | 1.000 |
| Kontrastive Policies | 0.900 | 0.963 | 1.000 |
| MMLU | 0.738 | 0.900 | 0.793 |
| MMLU-Pro (10-way) | 0.515 | 0.840 | 0.739 |
| Unbeantwortbares mit p ≥ 0.9 beantwortet (niedriger ist besser) | 0.000 | 0.090 | 0.055 |
| JevBench-Kalibrierungsfehler (niedriger ist besser) | 0.049 | 0.037 |
*PostHog vermerkt, dass für Kev-9B kein JevBench-Ergebnis veröffentlicht ist, diese Zellen sind also Kev-8B. Alle Zahlen aus der Jeeves-README.
Liest man die Tabelle von oben nach unten, zeigt sich eine Trennung. Wo es darum geht, Regeln auf eine unordentliche Eingabe anzuwenden (zurückgehaltene Regelstrukturen, kontrastive Policies, Paraphrasenerkennung, JevBench hard), gewinnt das Nachdenken, teils deutlich. Wo es darum geht, eine Tatsache zu wissen (MMLU, MMLU-Pro), gewinnt Jev um etwa 10 Punkte. Nachdenken kann Wissen nicht herbeizaubern, das ein 9B-Modell nicht hat. Für Wissen verankern Support-Teams das Modell meist in ihren eigenen Dokumenten, der Kompromiss ist in RAG vs Fine-Tuning beschrieben.
Diese Trennung passt gut zur Support-Arbeit. „Fällt diese Erstattungsanfrage in unsere 30-Tage-Regel, wenn das Bestelldatum in Absatz drei vergraben ist?“ ist eine Regelfrage. „Was ist die Hauptstadt von Peru?“ taucht nie in einer Ticket-Warteschlange auf. Wenn Ihre Entscheidungen der ersten Art ähneln, spricht die Tabelle für Sie.
Zwei ehrliche Einschränkungen von PostHog selbst: Die Vergleiche mit Kev und Jev außerhalb von JevBench „use different items from the same sources“, und die Begründungsketten sind nicht sehr lesbar, weil „no language consistency reward was included.“ Sie bekommen die Antwort und eine Kette, aber planen Sie nicht, diese Kette einem Prüfer zu zeigen.
Wie langsam ist „Nachdenken“ in der Praxis?
Hier gab es im Hacker-News-Thread den stärksten und berechtigten Widerspruch.
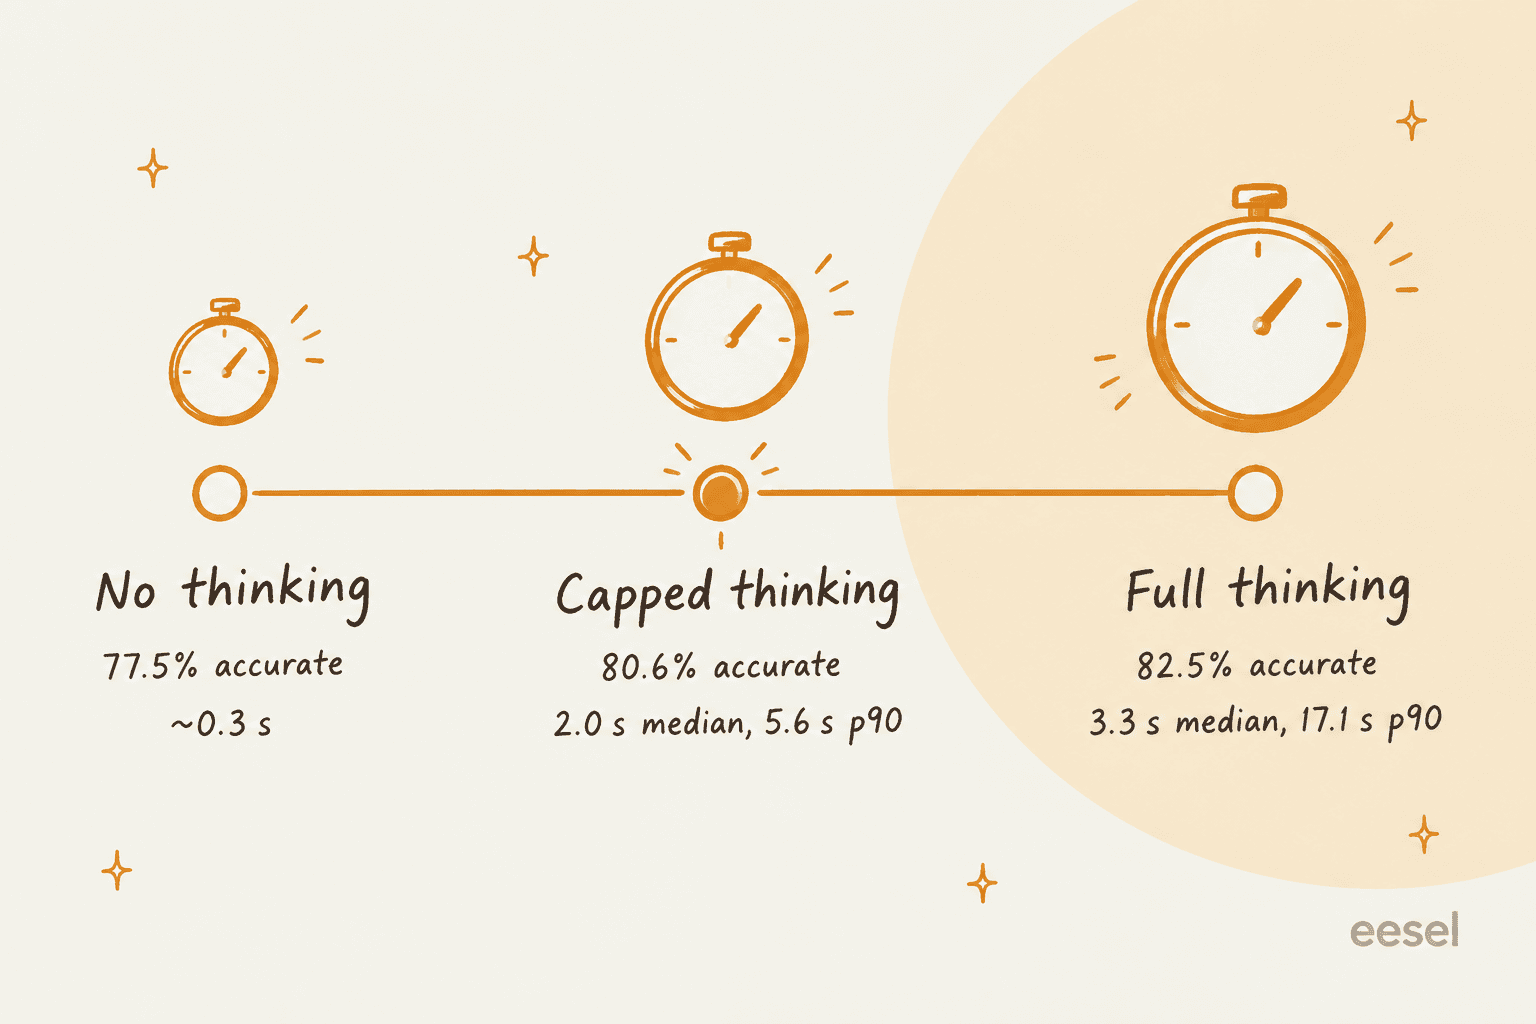
PostHog hat drei Einstellungen an 325 Dev-Fragen gemessen, auf einer H100 mit FP8:
| Einstellung | Genauigkeit | Mittlere Begründungs-Tokens | Latenz Median / p90 |
|---|---|---|---|
| Volles Nachdenken | 0.825 | 1,138 | 3.3 s / 17.1 s |
max_think 768, nothink_threshold 0.9 | 0.806 | 344 | 2.0 s / 5.6 s |
| Kein Nachdenken | 0.775 | 0 | etwa 0.3 s |
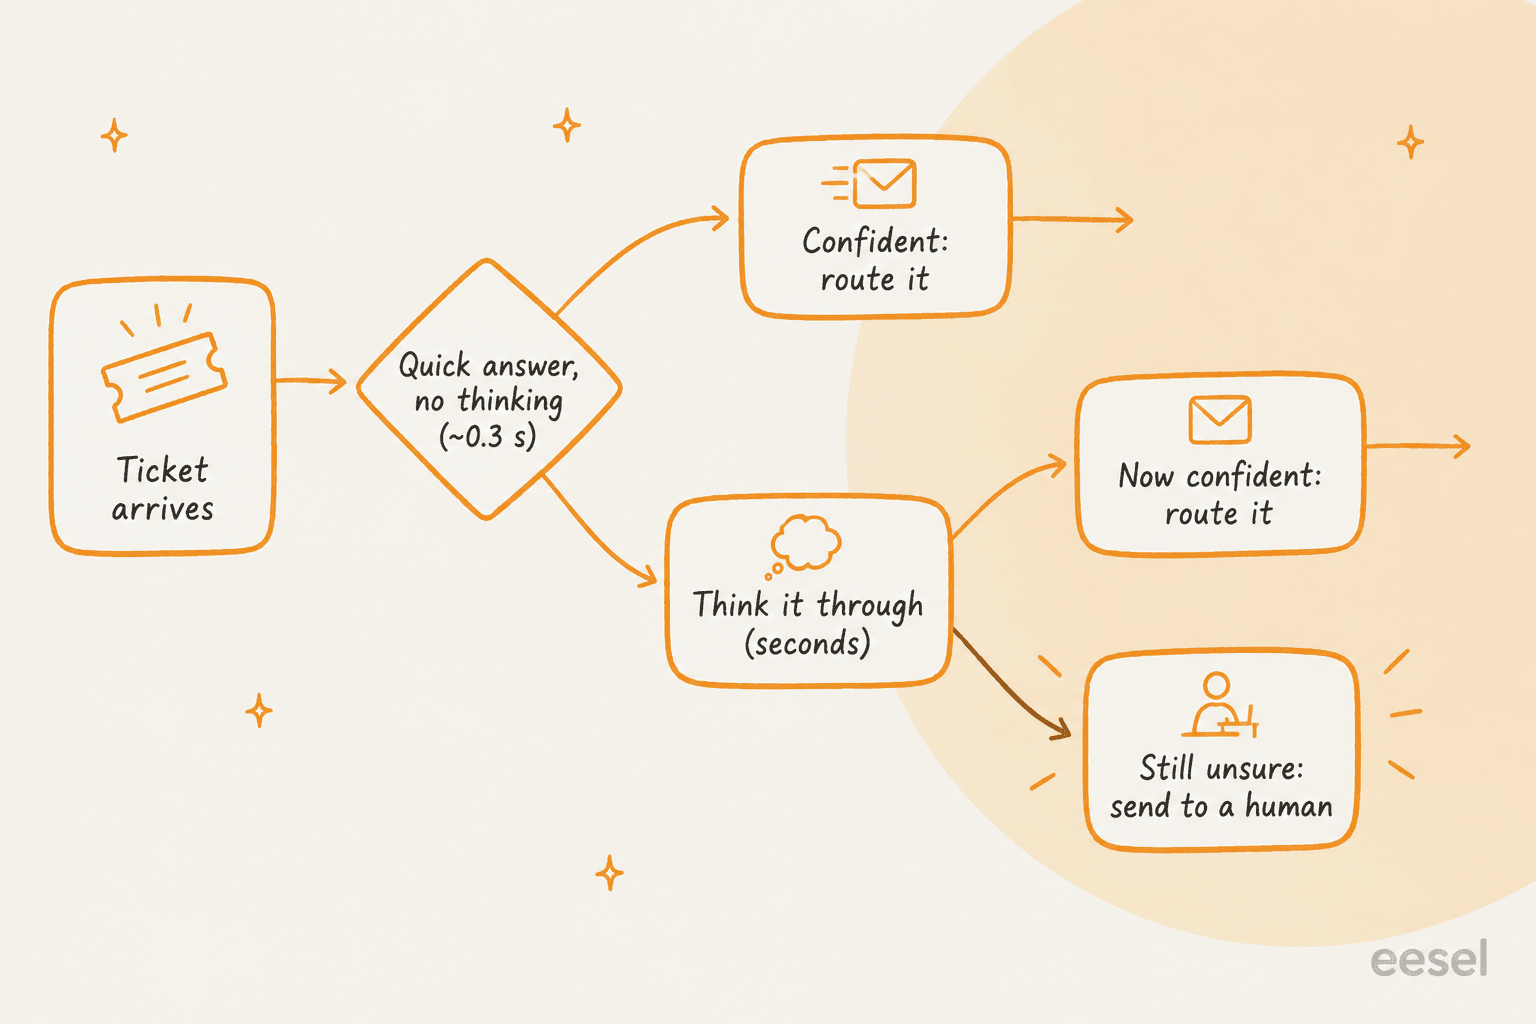
Die mittlere Zeile würde ich tatsächlich einsetzen. max_think schneidet jede Begründungskette bei einem Token-Budget ab, und nothink_threshold überspringt das Nachdenken ganz, wenn die schnelle Antwort bereits sicher ist. Sie behalten den größten Teil des Genauigkeitsgewinns (0.806 vs 0.775) und senken die p90-Latenz um zwei Drittel.
Zum Vergleich: Jevs eigenes Versprechen sind 70 bis 500 Millisekunden pro Aufruf, was ich in meinem Jev-Geschwindigkeitstest behandelt habe. Die HN-Leute haben es bemerkt:
"Cool engineering, but 17s p90 latency kind of defeats the point of a Jev-class model, which is supposed to be fast and cheap."

Das stimmt, wenn man Jeeves als Jev-Ersatz betrachtet. Weniger, wenn man es als das betrachtet, was nach dem schnellen Modell läuft, wenn dieses mit den Schultern zuckt. Ein Kommentator beschrieb die Architektur schlicht:
"Seems like this is the way, a hybrid approach where some of the pipeline will be jev like and some traditional LLM depending on the nature of the work."
Jeeves fasst diesen Hybrid in einem Modell zusammen. Nachdenken aus ist Ihre schnelle Stufe. Nachdenken an ist Ihre langsame Stufe. Und weil beide Stufen eine API und eine Kalibrierung teilen, müssen Sie die Wahrscheinlichkeiten eines Klassifikators nicht mit der Freitextantwort eines LLM abgleichen.
Was passiert bei einem echten Support-Ticket?
Die Demo-Anfrage in der README ist ein Support-Ticket, das machte meine Arbeit leicht. Der Zustand lautet: „Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.“ Drei Fragen kommen mit: welche Abteilung, ob eskaliert werden soll und wie frustriert der Kunde ist.
Jeeves antwortete mit billing 0.46, returns 0.40, shipping 0.14 und einer Choice-Sicherheit von nur 0.19. Eskalation erhielt 0.72. Frustration lag bei 1.5 auf einer Skala von 0 bis 2. Die ganze Anfrage dauerte 8.1 Sekunden, wobei die drei Fragen parallel nachdachten.
Hier dasselbe Ticket (plus ein zusätzlicher Satz) in Kevs Playground mit Kev-4B:
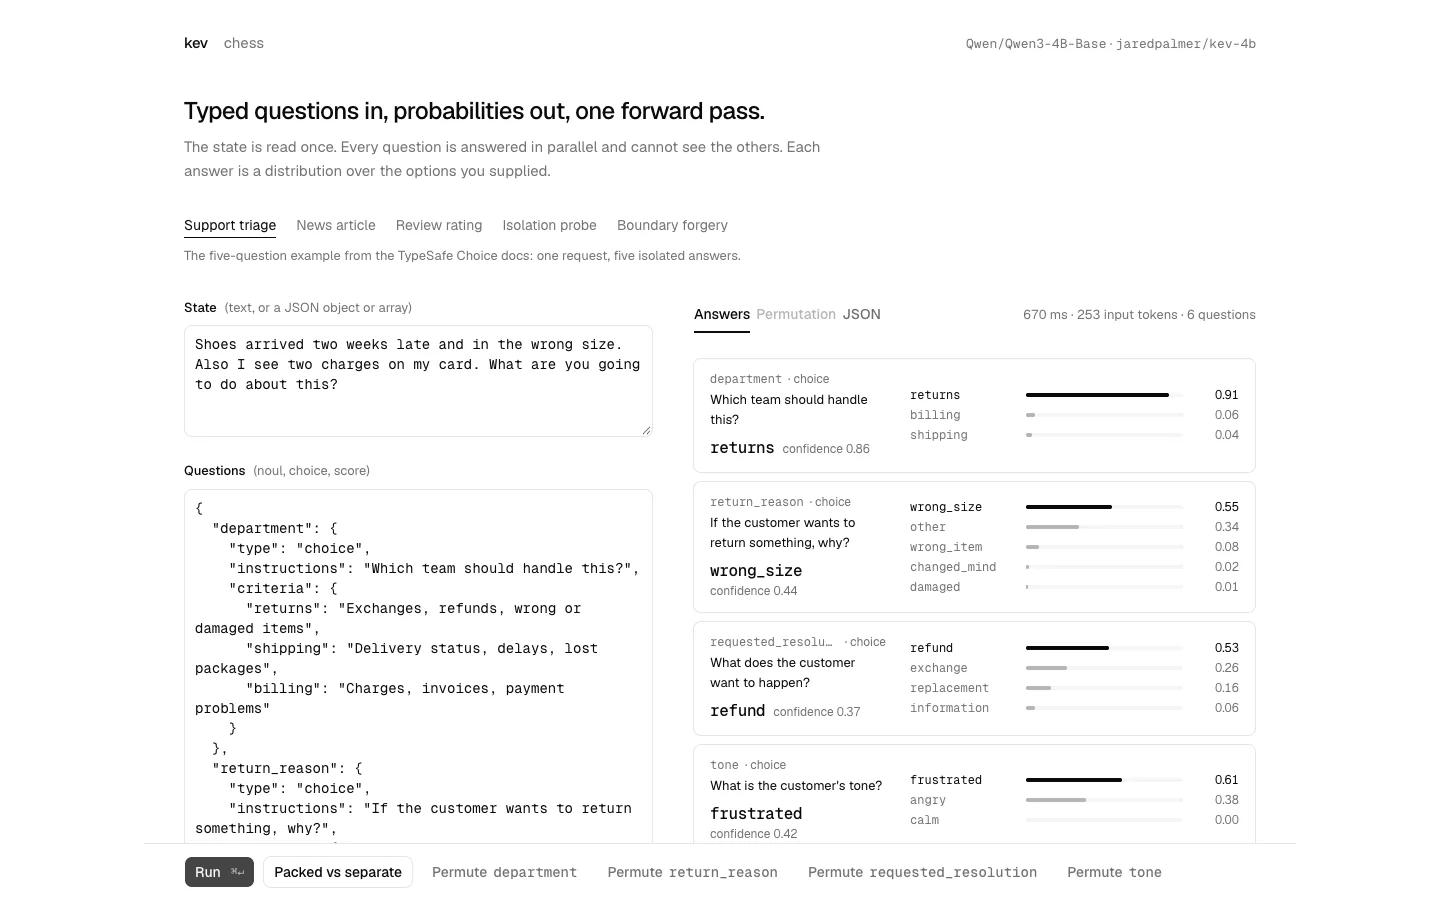
Kev-4B sagte returns mit 0.91 in 670 Millisekunden. Es ist ein kleineres Modell und der Prompt unterscheidet sich leicht, es ist also kein sauberer Direktvergleich. Aber sehen Sie sich das Ticket an. Es enthält tatsächlich zwei Probleme, die zwei Teams gehören. Kev antwortete schnell und klang sicher. Jeeves dachte nach und sagte sinngemäß: „Das ist knapp, und ich bin nicht sicher.“
Für eine Support-Warteschlange ist die zweite Antwort die nützlichere. Eine sichere falsche Zuordnung bedeutet, dass der Kunde in der Retouren-Warteschlange wartet, während seine doppelte Abbuchung unbearbeitet liegt. Eine unsichere Aufteilung ist das Signal, etwas Klügeres zu tun: an Billing routen und Returns taggen, das Ticket aufteilen oder es mit einer sauberen KI-zu-Mensch-Übergabe an eine Person schicken.
Das deckt sich mit dem, was ich bei eesel an echten Warteschlangen gesehen habe. In einem Test mit echtem Traffic in einem E-Commerce-Postfach waren die Entscheidungen der verlässliche Teil: 93 % Triage-Genauigkeit und 100 % Spam-Erkennung ohne Falschpositive. Bei den generierten Antworten haperte es, mit 7 % Faktenfehlern in Entwürfen. Klassifizierung ist die Hälfte der Support-KI, der man früh vertrauen kann, solange das Modell zugibt, wenn es unsicher ist. Ich habe auch gesehen, wie selbstsicher klingende Bots stillschweigend falsche Antworten gaben, weshalb jeder eesel-Rollout gegen historische Tickets simuliert wird, bevor er einen Live-Kunden berührt. Ein kalibriertes „Ich weiß es nicht“ ist mehr wert als ein schneller Tipp.
Wer sollte PostHog Jeeves tatsächlich nutzen?
Jeeves ist ein Forschungs-Release, kein Produkt, und es liest sich so, ähnlich wie ein Großteil der Landschaft der Open-Source-KI-Agenten: vollständiger Trainingscode, Train/Dev/Test-Daten, ein Reproduktionsskript, kein gehosteter Endpunkt. Die Modellseite auf Hugging Face vermerkt, dass das Modell „isn't deployed by any Inference Provider.“
So würde ich es einordnen:
| Sie sind... | Greifen Sie zu | Warum |
|---|---|---|
| Ein ML-Team, das schon Jev oder Kev mit LLM-Fallback betreibt | Jeeves | Gleiche API, ein Modell für beide Stufen, besser bei regellastigen Randfällen |
| Ein Team, das bei jedem Aufruf Entscheidungen unter einer Sekunde braucht | Jev oder Kev | Single Pass, kein Nachdenk-Schwanz |
| Ein Team, das offene Gewichte auf einem Laptop will | Kev-0.8B oder Kev-4B, oder Laya | Deutlich kleinerer Fußabdruck |
| Ein Team, das ein eigenes Entscheidungsmodell trainieren will | Jeeves | Das vollständige SFT-, CISPO- und Drafter-Rezept steckt im Repo |
| Ein Support-Team, das Tickets triagiert und bearbeitet haben will | Ein KI-Helpdesk-Agent | Ein Entscheidungsmodell antwortet nicht, aktualisiert keine Felder und eskaliert nicht |
Erste Community-Tests sind für Moderationsaufgaben ermutigend. Ein HN-Kommentator hat es mit eigenen Daten laufen lassen:
"Update: Jeeves took about 2 hours to moderate 394 data points and performed really well. It's not as good as Jev, but it's super close!"
Beachten Sie die „2 hours“. Das ist wieder die Nachdenk-Steuer auf Hardware, die keine H100 ist. Ein PostHog-Ingenieur, Robbie Coomber, antwortete im selben Thread, dass ein MPS-Port in Arbeit sei, um Apple Silicon zu beschleunigen, und das Repo zeigt, dass er inzwischen gemergt wurde.
Wenn Sie das einbauen, lohnt sich vorab ein Blick auf die vollständige Übersicht der Jev-Alternativen, denn strukturierte Ausgaben bei gehosteten LLMs könnten Ihren Fall ohne GPU abdecken.
Was ein Entscheidungsmodell für Ihr Helpdesk nicht leistet
Hier möchte ich die Perspektive verschieben. Ein Entscheidungsmodell beantwortet „Was ist dieses Ticket?“ sehr gut. Es beantwortet nicht „Was tun wir jetzt?“. Jemand muss weiterhin den Code schreiben, der billing: 0.46 in ein Helpdesk-Tag verwandelt, in eine Antwort, eine Erstattungsprüfung, eine Eskalation mit Notiz und eine Aufzeichnung des Warum.
Hier zeigt sich der Unterschied zwischen Infrastruktur und einem Mitarbeiter. Jeeves, Jev und Kev sind Infrastruktur: hervorragende, günstig zu betreibende Bausteine für Ticket-Klassifizierung, Priorisierung und Stimmungsanalyse. Ein KI-Teammitglied ist der Mitarbeiter, der dieselben Entscheidungen in Ihrem tatsächlichen Helpdesk trifft und dann die Arbeit erledigt. Wenn Sie beides abwägen, zeigt mein Leitfaden zum Automatisieren der Ticket-Triage den Kompromiss zwischen Selbstbau und Einstellen ausführlicher.
eesel ausprobieren

Wenn Sie Jeeves ansehen, weil Sie klügere Triage wollen, möchten Sie wahrscheinlich kein 9B-Modell hosten und den Kleber drumherum schreiben. eesels KI-Helpdesk-Teammitglied steigt in Ihre bestehende Warteschlange in Zendesk, Freshdesk oder Help Scout ein, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und trifft bei jedem Ticket die Entscheidung über Routen, Taggen und Eskalieren, gemäß den Eskalationsregeln, die Sie bereits nutzen. Dann entwirft oder sendet es die Antwort und übergibt die wirklich unsicheren Fälle mit einer Notiz an eine Person. Bevor es live geht, können Sie es an Hunderten Ihrer vergangenen Tickets simulieren und genau sehen, wo es richtig und wo falsch gelegen hätte.
Wenn der Self-Hosting-Reiz von Jeeves eigentlich Kontrolle per Code meint, deckt das die eesel-CLI ab. Sie führt dasselbe Teammitglied von Ihrem Terminal aus: eesel activity listet jeden Lauf und zeigt einen im Detail, eesel approvals lässt Sie Aktionen genehmigen oder ablehnen, die einen Menschen brauchen, und eesel instructions bearbeitet die dauerhaften Regeln des Teammitglieds. Jeder Befehl gibt JSON aus, schreibende Befehle unterstützen --dry-run, damit Sie den genauen Aufruf vorab sehen, und der Workspace dient zugleich als MCP-Server, sodass Coding-Agenten wie Claude Code ihn direkt steuern können. Mehr dazu in meinem Leitfaden zur KI-Agenten-CLI.
Wenn Sie es mit der eingebauten KI Ihres Helpdesks vergleichen, ist der Vergleich eesel vs Zendesk AI die nächste gute Lektüre. Der Start ist kostenlos mit 100 Credits und ohne Karte, und ein Ticket oder Chat zählt als ein Credit, laut Preisseite. Testen Sie eesel an Ihrer eigenen Warteschlange und sehen Sie, wie viele Tickets es letzten Monat richtig geroutet hätte.
Häufig gestellte Fragen
Was ist PostHog Jeeves?
PostHog Jeeves ist ein Open-Weight-9B-Entscheidungsmodell des AI-Research-Teams von PostHog. Sie geben ihm einen Zustand (Text oder JSON) plus typisierte Ja/Nein-, Multiple-Choice- oder Bewertungsfragen, und es schreibt eine Begründungskette, bevor es für jede Option eine kalibrierte Wahrscheinlichkeit zurückgibt. Es übernimmt das Anfrageformat von TypeSafes Jev und passt deshalb in dieselben Klassifizierungs-Pipelines.
Ist PostHog Jeeves kostenlos nutzbar?
Ja. Der Code steht unter MIT-Lizenz, die Gewichte auf Hugging Face unter Apache-2.0, der Download von PostHog Jeeves kostet also nichts. Stattdessen zahlen Sie für die Hardware: eine CUDA-GPU oder einen Apple-Silicon-Mac mit 48 GB oder mehr. Es gibt keine gehostete API, das ist der Hauptunterschied zu Jevs Preisen pro Token.
Wie unterscheidet sich PostHog Jeeves von Jev?
Jev antwortet in einem einzigen Durchlauf ohne sichtbare Begründung. PostHog Jeeves denkt zuerst nach, was die Genauigkeit bei zurückgehaltenen Tests (0.889 vs 0.857) und bei JevBench hard (0.865 vs 0.730) erhöht, aber die p90-Latenz bei vollem Nachdenken auf 17.1 Sekunden treibt. Bei Wissensfragen wie MMLU liegt Jev weiterhin vorn. Der Jev-Test behandelt die Single-Pass-Seite im Detail.
Kann PostHog Jeeves Support-Tickets triagieren?
Es kann den Entscheidungsteil der Ticket-Triage übernehmen: eine Abteilung wählen, Dringlichkeit markieren, Frustration bewerten. Die Demo in der README ist ein Support-Ticket. Es antwortet nicht Kunden, aktualisiert Ihr Helpdesk nicht und eskaliert nicht von selbst, Sie brauchen also weiterhin Code oder einen KI-Helpdesk-Agenten drumherum.
Wie schnell ist PostHog Jeeves?
Auf einer H100 mit FP8 antwortet PostHog Jeeves ohne Nachdenken in etwa 0.3 Sekunden, mit begrenztem Nachdenken im Median in 2.0 Sekunden und mit vollem Nachdenken im Median in 3.3 Sekunden (17.1 Sekunden bei p90). Das ist langsamer als Single-Pass-Entscheidungsmodelle, daher werden die meisten Teams die Option nothink_threshold nutzen wollen, um bei einfachen Fällen das Nachdenken zu überspringen, ähnlich wie bei einem gestuften Eskalationsablauf.
Welche Hardware brauche ich für PostHog Jeeves?
Die Gewichte belegen 21 GB in bf16 oder 11.5 GB mit FP8-Linearschichten. Die README verlangt Python 3.12 und eine CUDA-GPU und sagt, dass die Inferenz auch auf Apple-Silicon-Macs mit 48 GB oder mehr läuft, wenn man die Caches verkleinert. Wer sich gar nicht um GPUs kümmern will, fährt mit einer verwalteten KI-Kundenservice-API einfacher.
Ist PostHog Jeeves besser als Kev?
Nach den veröffentlichten Zahlen von PostHog schlägt Jeeves Kev-9B bei zurückgehaltenen Testdaten (0.889 vs 0.822) und bei JevBench (0.935 vs 0.715 für Kev-8B). Kev ist kleiner und schneller, erscheint in vier Größen von 0.8B bis 27B und läuft auf einem Laptop. Wählen Sie Kev für Tempo, PostHog Jeeves für schwierige Entscheidungen nach Regeln. Beide stehen neben Laya im Feld der offenen Entscheidungsmodelle.


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.