

Block Dessa ist ein Sprach-KI-Modell, das ausschließlich mit Aufnahmen sprechender Menschen trainiert wurde, ganz ohne Text, und Sie können es noch nicht nutzen. Block hat es am 23. Oktober 2026 als Forschungsvorschau angekündigt: Es hört und spricht gleichzeitig, lacht und seufzt von selbst, wurde auf einem NVIDIA GB200 NVL72-Rack trainiert und läuft auf einem MacBook Pro M4 Max. Es gibt eine Warteliste und frühzeitigen Zugang für Sicherheitsforscher, aber keine API, keinen Preis, keine Modellgewichte und keine Benchmark-Ergebnisse.
Meine Einschätzung, nachdem ich Blocks Seite, die 21 Demo-Einträge und einen Hacker-News-Thread mit 199 Kommentaren durchgegangen bin: Dessa ist das am natürlichsten klingende Sprachmodell, von dem ich bisher gehört habe, und gleichzeitig am weitesten davon entfernt, ein Produkt zu sein. Die Kommentatoren, die Sprachagenten entwickeln, kamen immer wieder auf dieselbe Lücke zurück. Es spricht wunderbar, aber nichts, was Block bisher gezeigt hat, ermöglicht es ihm, eine Bestellung nachzuschlagen, einem Skript zu folgen oder ein Tool aufzurufen.
Für Supportteams ist diese Lücke die eigentliche Arbeit. Bei den Warteschlangen, für die ich bei eesel Agenten entwickle, war die Schwierigkeit nie, menschlich zu klingen, sondern mit echten Kontodaten zu arbeiten. Swiftreg beantwortet Tickets zu Nummernschildern anhand aktueller Bestelldaten und nach selbst festgelegten Regeln, bei rund 2.100 Zendesk-Tickets pro Monat. Behalten Sie Dessa als Forschungsmeilenstein im Blick. Wenn Ihre Warteschlange noch in diesem Quartal Hilfe braucht, ist ein KI-Helpdesk-Teamkollege für E-Mail und Chat die Lösung, die sich tatsächlich einsetzen lässt.
Warum ich mich mit Dessa beschäftigt habe
Ich bin Softwareentwickler bei eesel und verbringe meine Tage damit, die KI-Agenten zu bauen, die in den Helpdesks unserer Kunden arbeiten. Alle paar Monate erscheint ein neues Sprachmodell mit einer Demo, die eine Supportleitung dazu bringt, mir zu schreiben und zu fragen: „Sollten wir jetzt auf Telefon-KI setzen?“. Nach GPT-Live-1, Grok Voice Think Fast 2.0 und Decagon Voice 3 ist Dessa das nächste.
Also habe ich getan, was ich bei jeder Veröffentlichung tue: alles gelesen, was der Anbieter tatsächlich veröffentlicht hat, mir die Clips angehört und getrennt, was Block gesagt hat und was andere hineininterpretiert haben. Dieser zweite Teil ist hier wichtiger als sonst, denn Block hat bemerkenswert wenig veröffentlicht, und ein Großteil der Berichterstattung füllt die Lücken mit Vermutungen.
Was ist Block Dessa?
Dessa ist ein Vollduplex-Speech-to-Speech-Modell, entwickelt von einem kleinen KI-Forschungslabor innerhalb von Block, dem Unternehmen hinter Square, Cash App und Afterpay. In Blocks Worten ist es "audio in, audio out", und "everything it knows came from human speech."
Drei Dinge unterscheiden es von den meisten Sprach-KIs, die Sie bisher genutzt haben:
- Es verzichtet vollständig auf Text. Block sagt, das Team habe es "from scratch on nothing but human conversation" trainiert, mit "no text, no pretrained models." Die meisten Sprachassistenten bauen auf einem Textmodell auf.
- Es ist vollduplexfähig. Es "listens and talks at the same time, like you do," und hat aus Daten gelernt, wann es sich einschalten und wann es mit einem "yeah!" oder "got it!" Zuhörsignale geben sollte.
- Es hört und erzeugt Emotionen. Block sagt, es "natively hears and speaks emotion, sarcasm, laughter, a frustrated sigh, a voice cracking with sadness."
Das Labor ist sehr klein. Blocks Seite nennt einen Leiter, Ragavan Thurairatnam, sechs Forscher, drei Praktikanten und zwei ehemalige Praktikanten und sagt, dass das Labor direkt an Jack Dorsey berichtet. Das Team wurde von ehemaligen Mitgliedern von Dessa gegründet, dem Deep-Learning-Startup aus Toronto, das Square übernommen hat, daher der Name. Dieses ursprüngliche Startup war für Deepfake-Erkennung bekannt, eine interessante Vorgeschichte für ein Team, das jetzt das menschlichste klingende Sprachmodell entwickelt.
"We made the first AI model you can have a realistic conversation with that was trained entirely on speech! Dessa is a full-duplex speech-to-speech model that you can run on consumer GPUs. This is a GPT3 moment for speech."
Dieser Ankündigungsbeitrag erhielt 16.807 Likes, und Jack Dorseys eigener Beitrag, in dem er es "the most authentic full-duplex speech model ever built" nannte, überschritt 68.000. Der Hype ist real. Die Frage ist, was dahintersteckt.
Wie funktioniert Dessa anders als andere Sprach-KI?
Die meisten Sprachagenten bestehen heute aus einer Kette von drei Modellen: Speech-to-Text verwandelt Ihre Stimme in Wörter, ein Textmodell schreibt eine Antwort und Text-to-Speech liest sie vor. Über diesen Aufbau habe ich in meinem Vergleich Realtime vs. Whisper vs. TTS geschrieben. Er funktioniert, und so werden die meisten KI-Telefonate und KI-Callcenter-Agenten heute umgesetzt.
Die Sprachausgabe übernimmt oft ein Sprachanbieter wie ElevenLabs. Cartesias Sonic 3 ist eine weitere häufige Wahl.
Blocks Argument lautet, dass der erste Schritt den menschlichsten Teil des Gesprächs verwirft. Die Seite formuliert es unverblümt: Aktuelle Sprach-KI "turns your voice into text and throws away an incredible amount of information text alone can't carry. The most powerful AIs in the world can't hear how you feel."
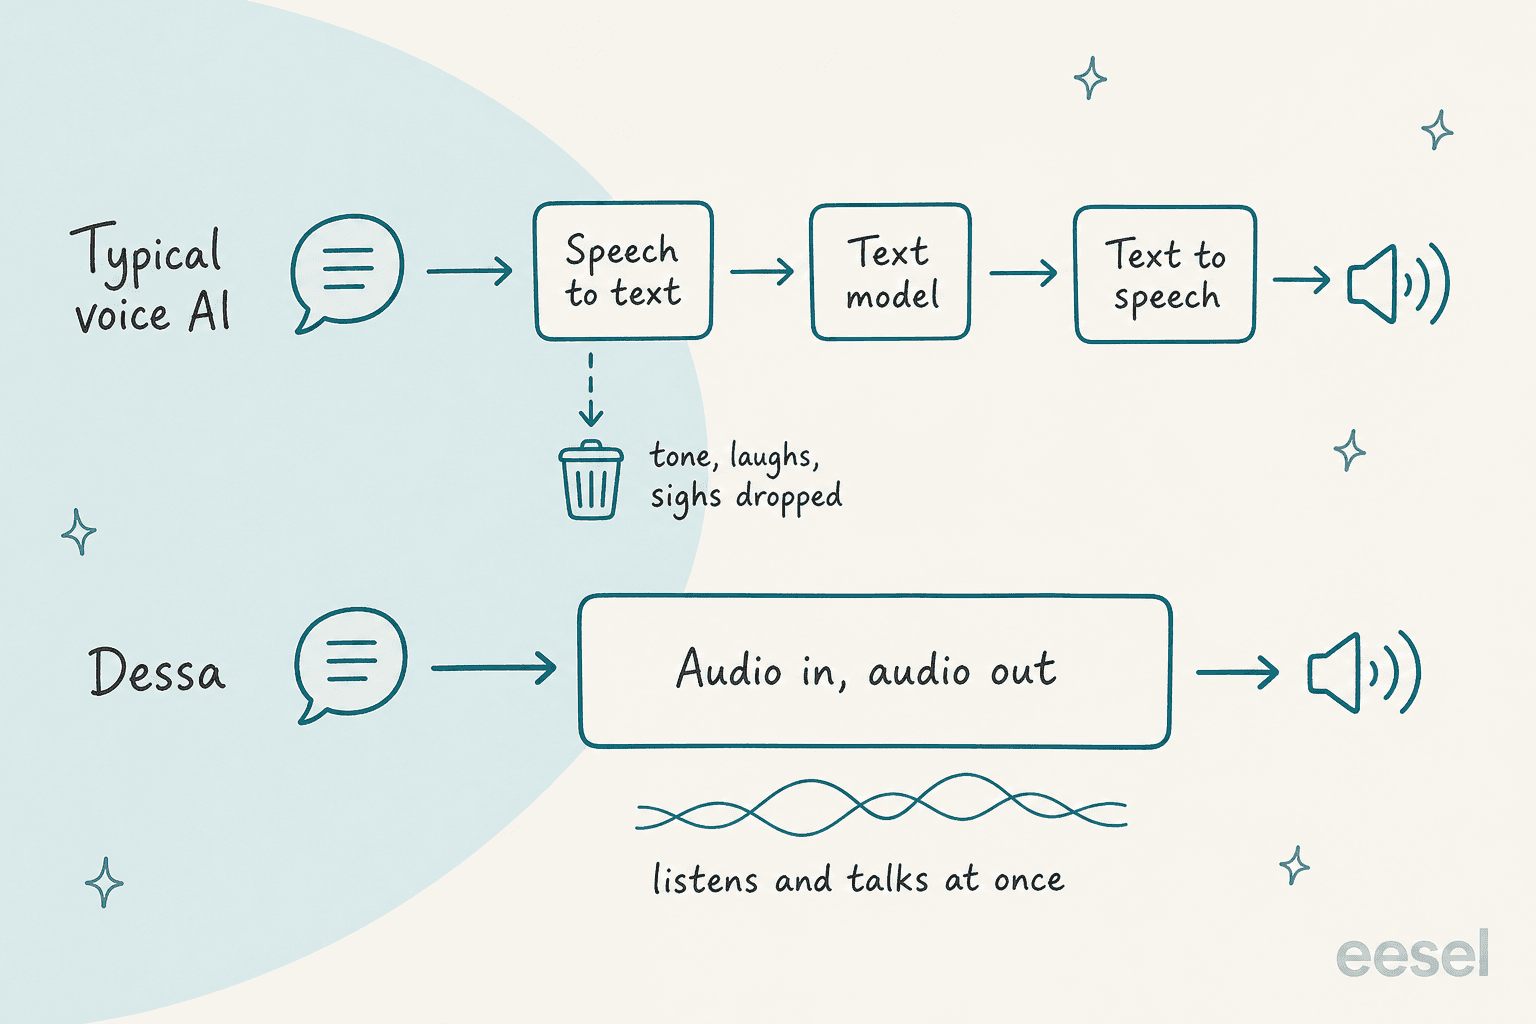
Dessa ersetzt die gesamte Kette durch ein einziges Modell, das Audio hört und Audio erzeugt. Weil es nie in Text umwandelt, sind das Lachen, die Pause und das Seufzen Teil dessen, woraus es lernt und was es erzeugt. Modelle wie OpenAIs gpt-realtime verarbeiten Sprache ebenfalls direkt, und GPT-Live-1 übergibt das anspruchsvolle Denken an ein separates Backend-Modell wie GPT-5.5. Dessas Alleinstellungsmerkmal ist laut Block, dass es überhaupt nie Text gesehen hat.
Das Überraschende ist, sofern Blocks Aussagen zutreffen, die Effizienz. Block sagt:
- Dessa "learned language from hundreds of times fewer words" als große Textmodelle.
- Es wurde auf "only one NVIDIA GB200 NVL72" trainiert, einem einzigen Rack statt einem Rechenzentrum.
- Die Inferenz "runs faster than real time", und es "runs locally on a MacBook Pro M4 Max or better."
Block nennt außerdem offene Forschungsfragen, die es untersuchen möchte: "How efficiently do they learn language and facts compared to text? How efficiently can they learn new languages? What sorts of In-context learning can they perform?" Mir gefällt, dass die Seite das so offen ausspricht. Hier sagt Ihnen ein Forschungslabor, dass es die Antworten noch nicht kennt.
Was zeigen die Dessa-Demos tatsächlich?
Blocks Seite enthält 21 Aufnahmen: sechs hervorgehobene Clips mit Beschreibungen und 15 weitere Beispiele, mit Laufzeiten von 1:42 bis 5:01. Block sagt "Nobody steers it" und erklärt, dass die Untertitel nachträglich hinzugefügt wurden. Jeder Clip wird als zwei synchronisierte Spuren abgespielt, eine für den Menschen und eine für Dessa.
Hier sind die hervorgehobenen Clips und was jeder davon laut Block zeigt:
| Demo-Clip | Länge | Was Block hervorhebt |
|---|---|---|
| Gespräch über die Veröffentlichung | 2:52 | Lacht mitten im Satz, wird lauter, wenn es gebeten wird, lauter zu sprechen |
| Erinnerung an einen Film | 2:39 | Vervollständigt einen Filmtitel, der der Person entfallen war |
| Eine Überraschung zum Jahrestag | 1:52 | Haucht ein überraschtes "oh my god" und klingt anschließend dankbar |
| Ausdrucksstarkes Gespräch | 3:03 | "Huge range in intonation and speed" |
| Lebensberatung | 4:57 | Klingt "genuinely empathetic" |
| Dessa im Gespräch mit GPT-Live-1 | 2:25 | Unterbrechen, Geduld, schnelle Zuhörsignale |
Dieser letzte Clip kommt einem Vergleich am nächsten, den Block anbietet. Zwei KI-Stimmen sprechen miteinander, mit dem Hinweis, dass "the developer of GPT-Live-1 is not affiliated with Block and has not reviewed or endorsed Dessa." Es macht Spaß, zuzuhören, aber es ist ein Stimmungsbild, kein Benchmark.
Auf X gibt es außerdem ein Ratespiel, bei dem ein Praktikant mit dem Modell spielt und, in Blocks Worten, "the model guesses the first one right straight away, and the second doesn't take long either." Ragavan stellte es als Beleg dafür dar, dass Dessa "developed world knowledge", und zwar ausschließlich aus Audio.
Was hat Block uns noch nicht verraten?
Das ist der Teil, den die meiste Berichterstattung zur Veröffentlichung überspringt, und der darüber entscheidet, ob Dessa für Sie relevant ist. Mit Stand vom 27. Oktober 2026 ist Blocks Dessa-Seite die einzige offizielle Beschreibung. Es gibt keinen technischen Bericht, keine wissenschaftliche Veröffentlichung, keine Model Card und kein GitHub-Repository.
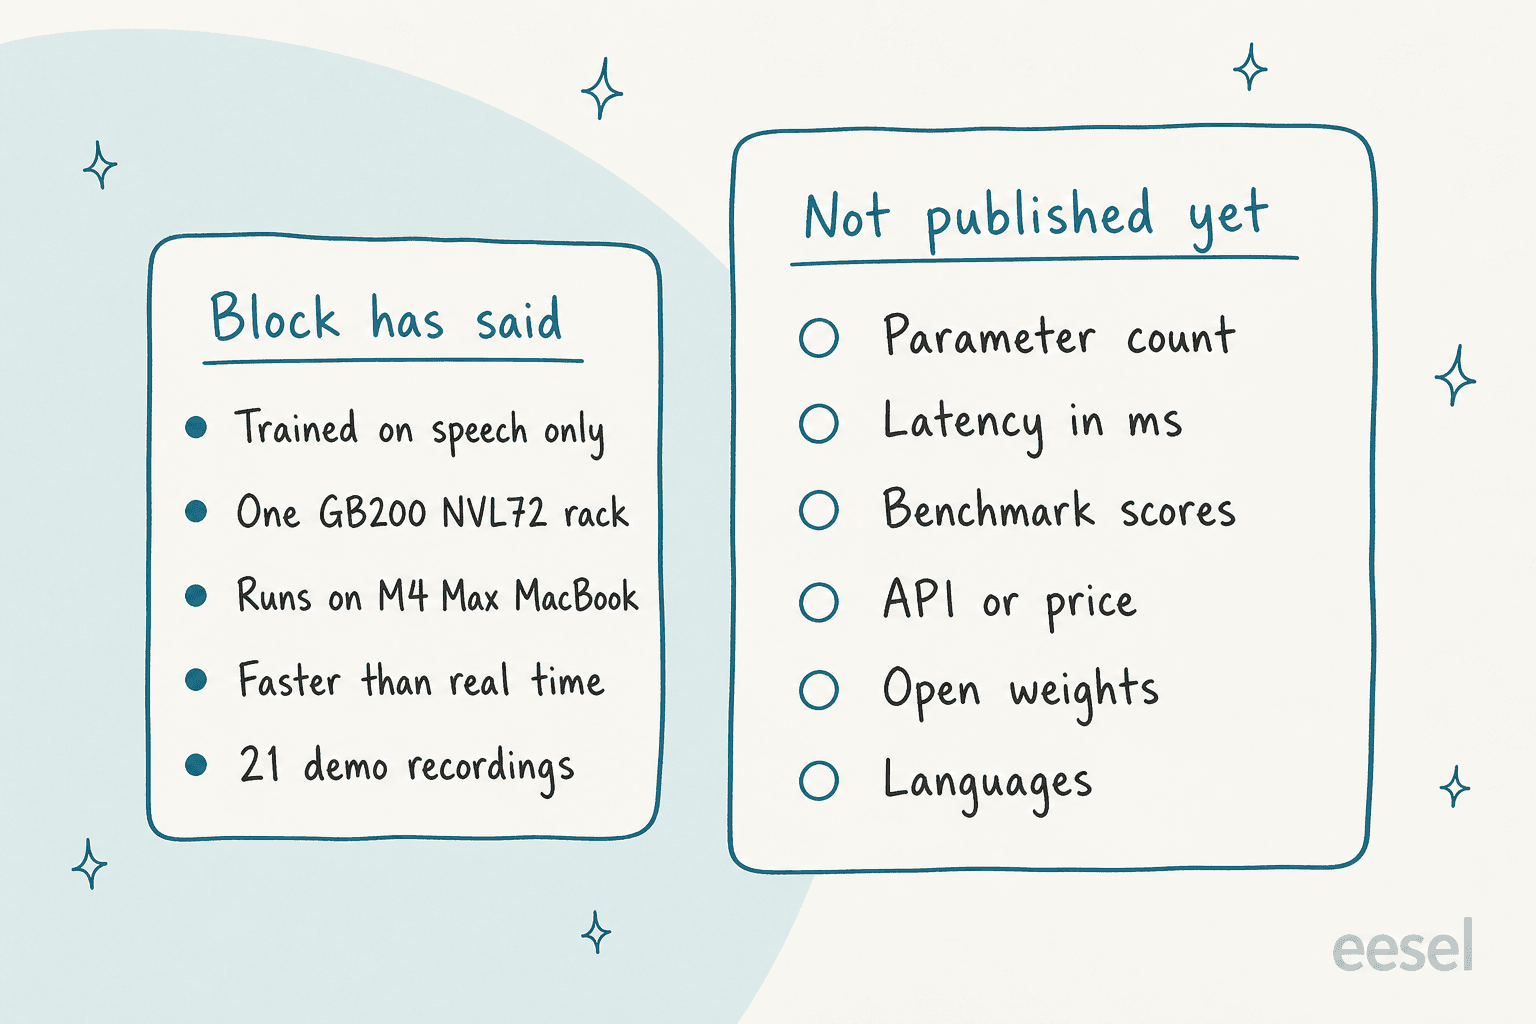
Was fehlt:
- Modellgröße. Keine Parameteranzahl, daher lässt sich "runs on an M4 Max" nicht mit dem Speicherbedarf abgleichen.
- Latenz. "Faster than real time" ist eine Aussage zum Durchsatz. Es gibt keine Angabe zur Zeit bis zur ersten Audioausgabe in Millisekunden, also zu der Zahl, die entscheidet, ob sich ein Anruf natürlich anfühlt.
- Benchmarks. Keine Ergebnisse im Vergleich mit GPT-Live-1, Grok Voice, Gemini oder offenen Modellen. Nur qualitative Aussagen wie "Other models wait for you to finish, then laugh on cue."
- Sprachen. Die Demos sind auf Englisch. Ein Beispiel trägt den Titel "Singing nonsense Spanish", was nicht dasselbe ist wie Unterstützung für Spanisch.
- Zugang. Keine API, kein Preis, keine Lizenz, keine offenen Modellgewichte. In der Fußzeile der Seite steht "Launch links are coming soon."
Nichts davon ist eine Kritik an der Forschung. Dass ein kleines Labor frühe Arbeiten teilt, ist normal. Es bedeutet nur, dass jeder Artikel, der Ihnen erzählt, Dessa „schlägt“ ein anderes Modell, spekuliert, und dass jeder Plan, den Sie heute darauf aufbauen, auf Demo-Clips basiert.
Was sagen die Leute über Dessa?
Der Hacker-News-Thread hat 532 Punkte und 199 Kommentare, und auf X sorgten die Demo-Clips für viel Aufmerksamkeit. Die Reaktionen gingen in drei Richtungen.
Der Realismus beeindruckte viele Menschen. Der Kommentar mit den meisten Antworten im Thread handelte von der Hardware, nicht von der Stimme:
"The conversation examples are impressive but this made me say holy shit out loud: 'it runs locally on a MacBook Pro M4 Max or better. And we figured out how to train Dessa on only one NVIDIA GB200 NVL72.'"

Allerdings hörten nicht alle dasselbe. Ein Kommentator fand das Beispiel auf der Startseite "absolutely awful", und ein anderer sagte, seine Frau ohne technischen Hintergrund habe die KI-Stimme gleich beim ersten Versuch richtig erkannt.
Die Stimme ist dem Verstand voraus. Das war die häufigste Kritik von Menschen, die bereits Sprachagenten entwickelt haben:
"The speech realism is very good, but the intelligence is pretty clearly 2024-level."
Ein anderer Kommentator bemerkte eine erfundene Tatsache in der Film-Demo, die Bryan Singer mit Superman IV in Verbindung brachte. Das ist eine gute Erinnerung daran, dass eine selbstbewusste Stimme KI-Halluzinationen überzeugender macht, nicht weniger überzeugend.
Betrug und Identitätsnachahmung. Mehrere Personen sorgten sich darüber, welche Auswirkungen ein überzeugendes, lokales Sprachmodell auf Telefonbetrug hat:
"Block says it runs locally on a high-end MacBook. Once something like that is out, there's no server in the middle to watch it or switch it off. Research preview for now. Soon the only way to know you're talking to a human will be to hang up and call back."
Block scheint sich dessen bewusst zu sein. Die genannten Gründe für die Entwicklung von Dessa sind "curiosity (aka fun), better understanding between humans and AI, and safety," und den ersten externen Zugang erhalten Sicherheitsforscher, nicht Entwickler. Was Block noch nicht veröffentlicht hat, sind eine Model Card, Red-Team-Ergebnisse oder Angaben zu Audio-Wasserzeichen. OpenAI versieht GPT-Live-Audio dagegen mit SynthID-Wasserzeichen und beschränkt es auf voreingestellte Stimmen. Das ist also der Maßstab, den Dessa meiner Erwartung nach vor einer öffentlichen Veröffentlichung erfüllen sollte.
Könnte Dessa Kundensupport-Anrufe übernehmen?
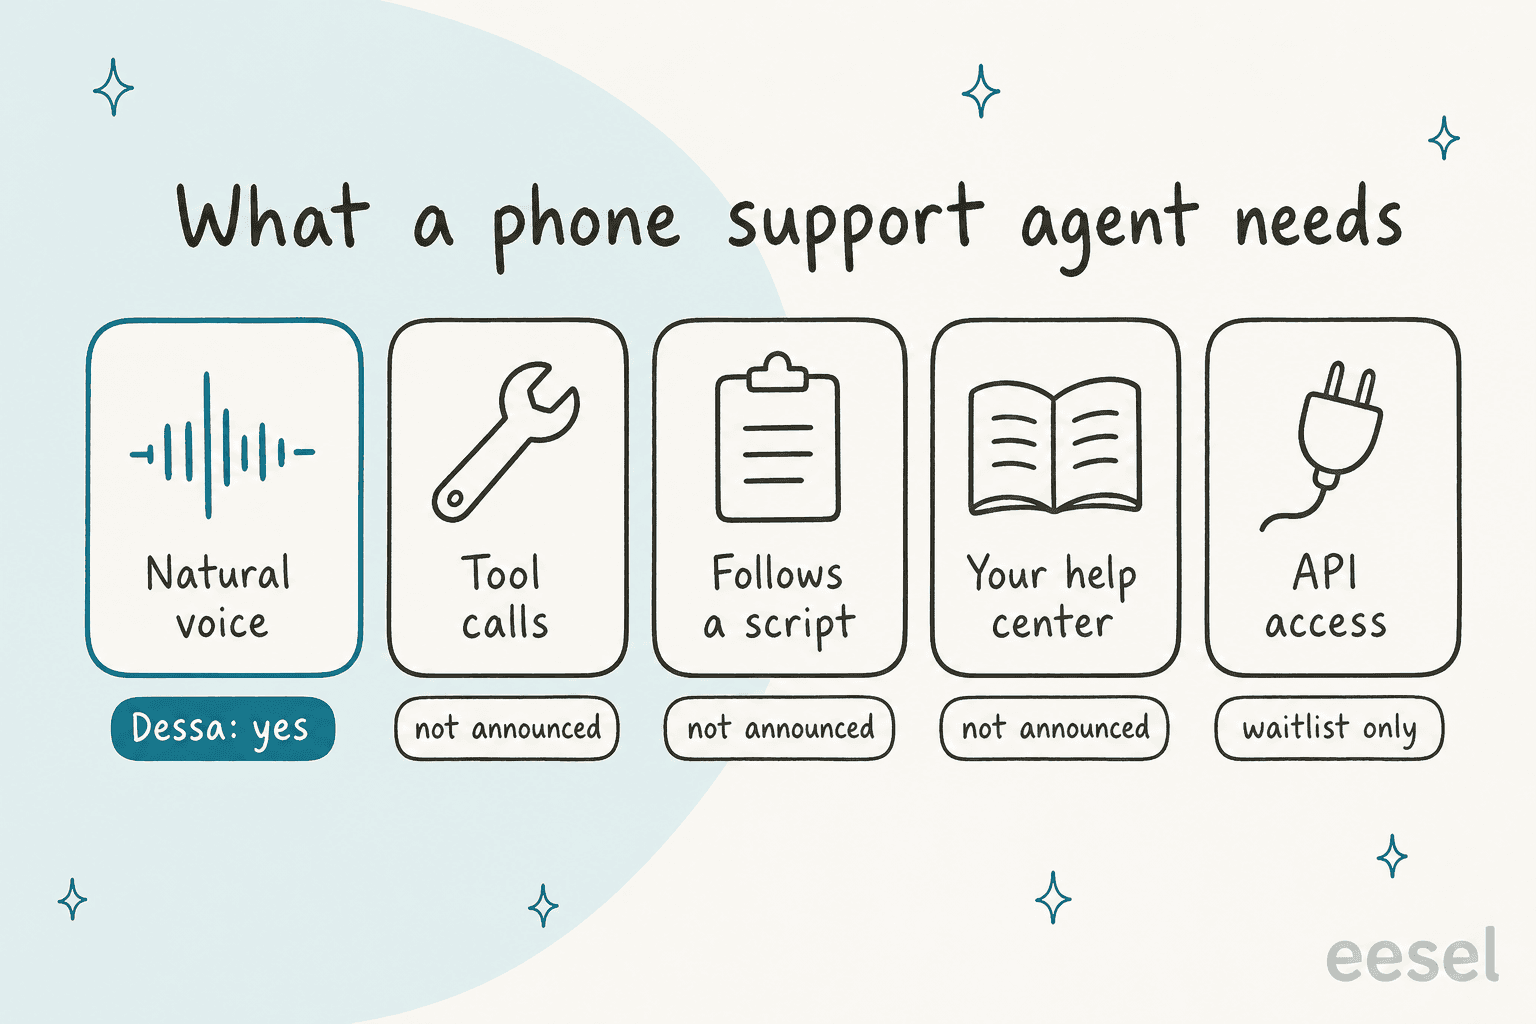
Nicht in seiner aktuellen Form, und die Gründe sind konkret. Ein Telefon-Supportagent muss neben einem guten Klang vier Dinge leisten: Tools aufrufen (die Bestellung nachschlagen, die Rückerstattung auslösen), einem Skript oder einer Richtlinie folgen, anhand Ihres eigenen Helpcenters antworten und sich über eine API mit Ihrem Telefonsystem verbinden. Block hat nichts davon angekündigt.
Die HN-Community formulierte es schärfer, als ich es tun würde:
"Given that it lacks both broad world knowledge and tool calling integration in any way, that seems kind of like a dead-end."
Ich glaube nicht, dass es eine Sackgasse ist. Ein anderer Kommentator schlug vor, die Zuhör- und Sprechteile von einem dazwischenliegenden Modell zu trennen, das die Abfragen der Wissensdatenbank und Tool-Aufrufe übernimmt. Das klingt nach einem sinnvollen Weg. Aber das ist Zukunftsmusik, und Block hat nicht gesagt, dass es daran arbeitet.
Es gibt außerdem eine Frage zum Kundenerlebnis, auf die noch niemand eine Antwort hat. Dessas Markenzeichen ist, wie ein Mensch zu unterbrechen und Zuhörsignale zu geben. Mehrere Kommentatoren sagten, genau das würden sie bei einer Supporthotline hassen:
"I get irrationally angry when actual people interrupt me while I'm talking, I'll start throwing chairs when AI tech support agents start doing it."
Nach dem, was ich in echten Supportwarteschlangen gesehen habe, verzeihen Kunden eine leicht roboterhafte Stimme, die das Problem löst. Eine charmante Stimme, die es nicht lösen kann, verzeihen sie nicht. Wenn ich bei eesel einen Agenten einführe, simuliere ich ihn zuerst anhand der bisherigen Tickets eines Teams, gerade weil der schmerzhafte Fehler eine selbstbewusste falsche Antwort ist, nicht eine unbeholfene Pause. Wenn Telefon-KI auf Ihrer Roadmap steht, beginnen Sie mit dem, was Ihr Helpdesk bereits bietet. Zendesk hat Sprach-KI-Agenten, und Freshdesk hat Freshcaller-Agenten.
Für eigenständige Tools, die Sie jetzt einsetzen können, sind meine Leitfäden zu KI-Sprachagenten für den Support und zur besten KI für den Telefonsupport der richtige Einstieg.
Wie schneidet Dessa im Vergleich mit Sprachmodellen ab, die Sie heute nutzen können?
Da Block keine Ergebnisse veröffentlicht hat, geht es bei einem ehrlichen Vergleich darum, was Sie mit jedem Modell tun können, nicht darum, welches am besten klingt.
| Block Dessa | GPT-Live-1 | Grok Voice Think Fast 2.0 | |
|---|---|---|---|
| Aufbau | Ein ausschließlich auf gesprochener Sprache basierendes Modell, kein Texttraining | Sprachschicht, die das logische Denken an ein Backend-Modell wie GPT-5.5 übergibt | Sprachmodell mit integriertem logischem Denken |
| Können Sie es heute nutzen? | Nur Warteliste und Sicherheitsforscher | Ja, per API | Ja, per API |
| Veröffentlichter Preis | Keiner | 0,05 $ pro Minute für die Sprachschicht | 0,08 $ pro Minute |
| Tool-Aufrufe | Nicht angekündigt | Ja | Ja |
| Läuft lokal | Ja, MacBook mit M4 Max oder besser (laut Block) | Nein | Nein |
| Veröffentlichte Benchmarks | Keine | Ja | Ja |
| Audio-Wasserzeichen | Nicht angekündigt | SynthID | Hier nicht behandelt |
Interessanterweise ähnelt der Aufbau von GPT-Live-1 dem, was jener Hacker-News-Kommentator für Dessa vorgeschlagen hat: eine Sprachschicht für das Gespräch und ein separates Modell für das Denken und die Tool-Aufrufe. Mein GPT-Live-1-Testbericht und meine Preisübersicht gehen darauf genauer ein.
Der lokale Betrieb ist das eine neue Merkmal auf Dessas Seite dieser Tabelle. Ein Sprachmodell, das auf einem Laptop läuft, eröffnet Möglichkeiten für Offline-Assistenten, Spiele und Sprachübungen, die Cloud-APIs nicht bieten. Wenn Sie sich für lokale KI interessieren, lohnt es sich, Dessa zusammen mit anderen Veröffentlichungen für den Betrieb direkt auf dem Gerät wie Nemotron 3.5 Bolt oder meiner Liste der Open-Source-KI-Agenten anzusehen.
Für alles mit direktem Kundenkontakt in diesem Jahr gewinnen jedoch automatisch die Modelle mit APIs und Tool-Aufrufen, und das Sprachmodell ist nur ein Teil eines funktionierenden KI-Agenten. Meine Übersicht über KI-Sprachagenten und der Testbericht zum Grok Voice Agent Builder sind bessere Ausgangspunkte als eine Warteliste.
Wer sollte Dessa im Blick behalten?
- KI-Sicherheitsforscher: ja, ganz direkt. Block spricht Sie ausdrücklich an, mit einem Formular für frühzeitigen Zugang, das eine institutionelle E-Mail-Adresse verlangt.
- Entwickler von Sprach-KI: beobachten Sie es genau. Wenn Block Modellgewichte oder eine API veröffentlicht, wäre ein ausschließlich auf gesprochener Sprache basierendes Modell, das lokal läuft, eine echte neue Option.
- Support- und CX-Verantwortliche: betrachten Sie es als Signal, nicht als Plan. Die schnelleren Erfolge bei Anrufen liegen heute in Dingen wie dem Zusammenfassen von Anrufen zu Tickets und einer umfassenderen Callcenter-Automatisierung. Sprach-KI wird eindeutig menschlicher klingen. Ob sie mit Ihren Daten arbeiten kann, ist eine andere Frage, die Dessa noch nicht beantwortet.
- Alle, die sich wegen Telefonbetrugs sorgen: eine berechtigte Sorge. Ein Familiencodewort für unerwartete Anrufe ist eine einfache, kostengünstige Gewohnheit, die Sie schon jetzt einführen können.
Testen Sie eesel
Dessa zeigt, wohin sich Sprach-KI entwickelt: menschlicher, emotionaler, irgendwann lokal. Den Teil, den es noch nicht erreicht hat, mit echten Kontodaten nach Ihren eigenen Regeln zu arbeiten, übernimmt eesels KI-Helpdesk-Teamkollege bereits bei E-Mail- und Chat-Tickets. Er lernt aus Ihrem Helpcenter und früheren Tickets, kann vor der Antwort Bestellungen nachschlagen und übergibt an einen Menschen, wenn es angebracht ist.
SamCart setzt einen Agenten für seine Freshdesk-Tickets und einen weiteren für den Website-Chat ein, die Antworten anhand von 280 Helpcenter-Artikeln geben. Swiftreg bearbeitete in einem Monat rund 2.100 Zendesk-Tickets anhand aktueller Bestelldaten und verschickte dabei etwa 1.500 öffentliche Antworten. Beide arbeiten mit den bereits vorhandenen Warteschlangen, ganz ohne Warteliste.
Wenn Ihre Ticketwarteschlange Hilfe braucht, bevor Sprach-KI ausgereift ist, testen Sie eesel kostenlos und probieren Sie es zuerst mit Ihren eigenen früheren Tickets aus.