

Warum ich diesen Launch genau gelesen habe
Ich baue bei eesel Funktionen und KI-Agenten, und eine Anfrage landet immer wieder auf unserer Roadmap: das Bild lesen. In den Verkaufsgesprächen von eesel in diesem Jahr wünschten sich Support-Teams für technische Produkte immer wieder eine KI, die Bilder und Diagramme in ihren PDFs sowie die an Tickets angehängten Kundenfotos lesen kann. Eine DTC-Nahrungsergänzungsmarke mit rund 7.000 Tickets im Monat erzählte uns, dass ein Teil ihres Produktwissens in Loom-Videos steckt, die niemand transkribiert hat.
Die meisten Vision-Modelle lösen das, indem sie eine Bildunterschrift schreiben und dann über diese Unterschrift nachdenken. Das funktioniert, bis das entscheidende Detail nicht in der Unterschrift stand. Glimpse ist das erste Modell, das ich gesehen habe, das genau darauf ausgelegt ist, das zu beheben. Deshalb habe ich den Launch-Beitrag, die Modellkarte von Together AI, die Plattformbedingungen und die Reaktionen am Launch-Tag durchgesehen. Hier steht, was Bestand hat und was eine Fußnote braucht.
Was ist Elorian Glimpse?
Glimpse ist laut Elorian "a new category of visual thinking model: a system that reasons about the physical world from what it sees." Einfach gesagt: ein multimodales Schlussfolgerungsmodell, abgestimmt auf Aufgaben, bei denen die Antwort im Bild liegt und sich schwer in Worte fassen lässt: wie schnell sich etwas bewegt, ob eine Einstellung ein durchgehender Schwenk oder zwei Schnitte ist, wie viele dieser Objekte tatsächlich geöffnet sind.
Das Unternehmen dahinter ist klein und gut finanziert. Elorian nennt 55 Millionen Dollar Finanzierung von Striker Ventures, Menlo Ventures und Altimeter, unter den weiteren Geldgebern sind NVIDIA und Jeff Dean. Mitgründer und CEO Andrew Dai verbrachte fast 12 Jahre bei Google Brain und DeepMind. Elorian sagt, es habe Glimpse "as a small team with only a few hundred GPUs, post-trained on an open weights base model" gebaut.
Hier das Datenblatt, mit markierten Lücken:
| Angabe | Elorian Glimpse |
|---|---|
| Veröffentlicht | 16. Oktober 2026 (Together nennt den 15. Oktober) |
| Status | Forschungsvorschau |
| Eingaben | Text, Bild, Video |
| Ausgabe | Text |
| Basismodell | Ein nicht genanntes Open-Weights-Modell, von Elorian nachtrainiert |
| Gewichte | Nicht veröffentlicht |
| Preis (Elorian API) | $0.60 / 1M Eingabe, $3.00 / 1M Ausgabe, ohne Cache |
| Kontextfenster, Ratenlimits | Nicht veröffentlicht |
| Zugang | Kostenloser Chat, Elorian API, dedizierte Bereitstellung bei Together AI |
| Unabhängige Benchmarks | Noch keine (nicht auf Artificial Analysis) |
Die Seite von Together AI führt es außerdem unter Chat, Reasoning, Vision und Video und zeigt Dedicated als einzigen Bereitstellungstyp. Das ist für die Budgetplanung wichtig, dazu komme ich noch.
Wie funktioniert "visuelles Denken"?
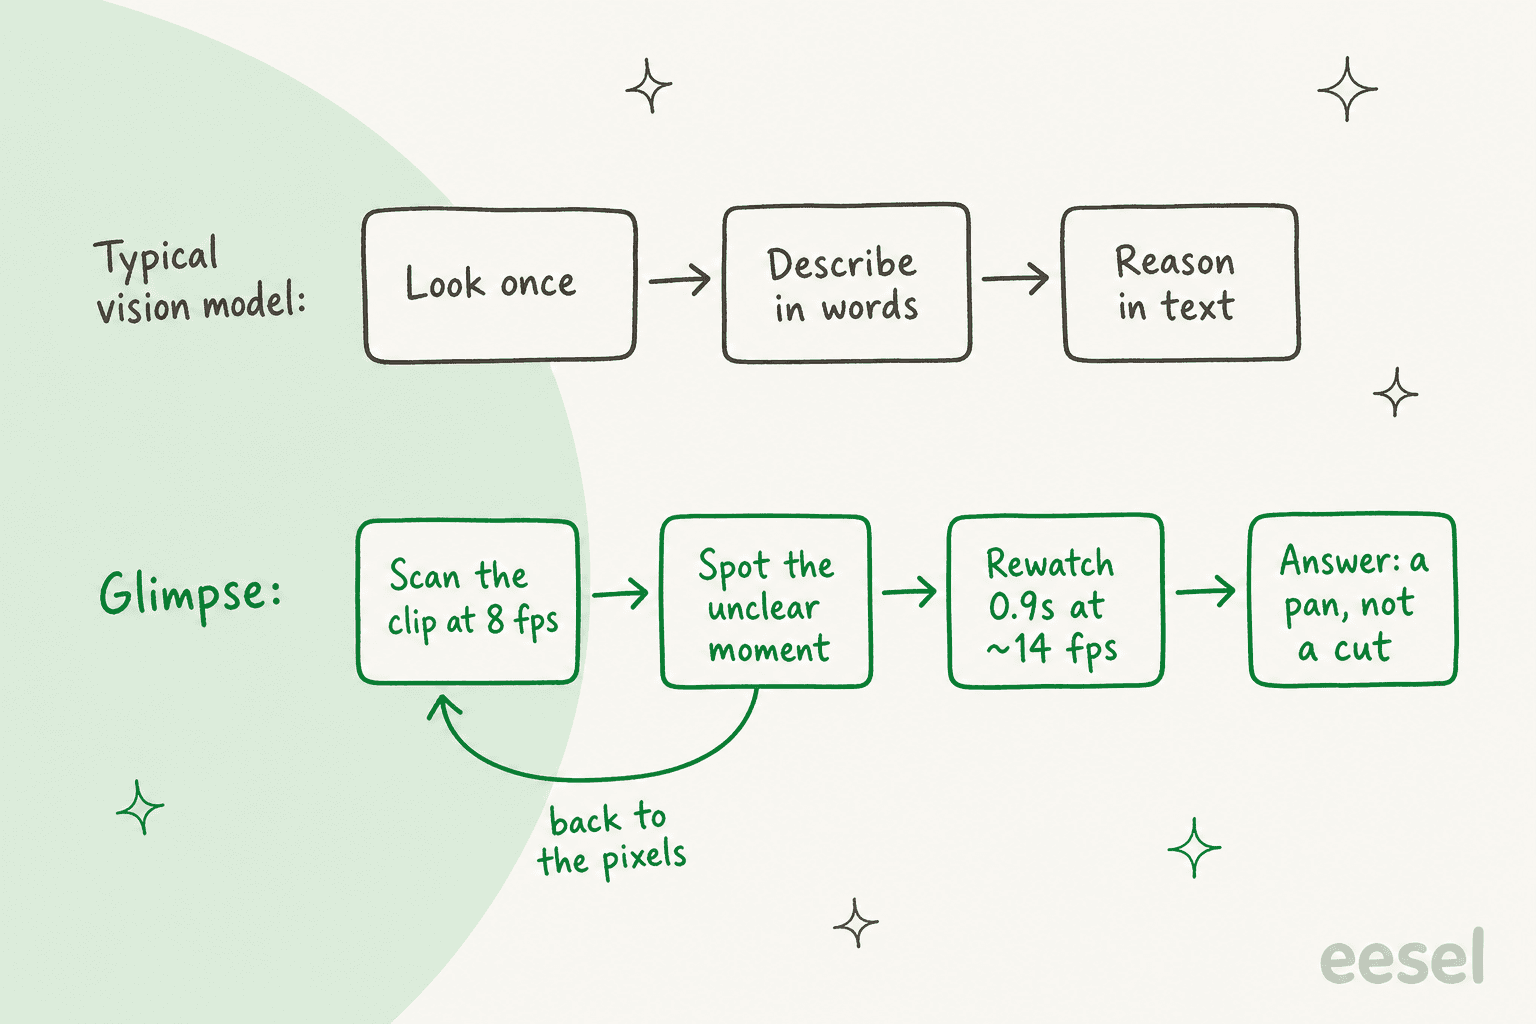
Elorians Argument: Heutige Vision-Modelle schlussfolgern in zwei Schritten, zuerst das Bild in Sprache übersetzen, dann in Text schlussfolgern. "No matter how advanced the subsequent reasoning, this chain is fragile", heißt es auf der Startseite, weil sich viele visuelle Details nicht präzise oder kurz beschreiben lassen.
Glimpse holt das Bild in das Schlussfolgern selbst. Es "can reason in visual space, revisiting and refining internal visual representations as thinking unfolds." In der Praxis zeigt der Launch-Beitrag drei Schritte, die das Modell mitten in der Antwort macht: in einen Bereich zoomen, ein kurzes Intervall mit dichterer Bildrate erneut ansehen und ein Merkmal über die Zeit verfolgen.
Das beste Beispiel ist ein Clip von zwei Vögeln, die einen Türgriff verlassen, während die Kamera schwenkt. Um zu klären, ob die Einstellung schneidet oder schwenkt, erfasst Glimpse zuerst die gesamten 6,13 Sekunden mit 8 Bildern pro Sekunde und sieht sich dann das 0,9-Sekunden-Fenster, das die Antwort entscheidet, mit etwa 14 Bildern pro Sekunde erneut an. Das zusätzliche Hinsehen geschieht nur dort, wo die Antwort unklar ist, und genau das ist die Idee.
Zwei weitere Designentscheidungen sind erwähnenswert:
- Werkzeugnutzung ist antrainiert. Laut Togethers Modellkarte ist Glimpse "trained end to end to use multimodal tools that write code, transform images, and watch videos." Das ähnelt im Geist Geminis Agentic Vision, bei dem das Modell Bilder zuschneidet und Code darauf ausführt.
- Es kann Arbeit auf Subagenten verteilen. Glimpse "can spawn and coordinate subagents that exchange text, visual artifacts, and internal representations." Dass visuelle Artefakte statt nur Textzusammenfassungen zwischen Agenten wandern, ist das Ungewöhnliche. Wer Subagenten in Claude Code kennt, kann sich dasselbe Muster mit Bildern in der Übergabe vorstellen.
Die Chat-Oberfläche macht all das sichtbar. Während Sie mit dem Modell sprechen, zeigt die Plattform, was Elorian den "visual scratch space" nennt: die Zooms, das erneute Ansehen und die verfolgten Merkmale, live.
Wo es präzise wird: Zählen
Zählen klingt trivial, bis ähnlich aussehende Objekte dazukommen. Elorians Beispiel fragt "How many open pliers are there?" zu einem Foto, auf dem auch geschlossene Zangen und Scheren liegen. Die richtige Antwort ist laut Elorians geprüfter Referenz vier. Geschlossene Zangen sind das richtige Werkzeug im falschen Zustand, und Scheren haben zwei Griffe und ein Scharnier, sind aber ein anderes Werkzeug.
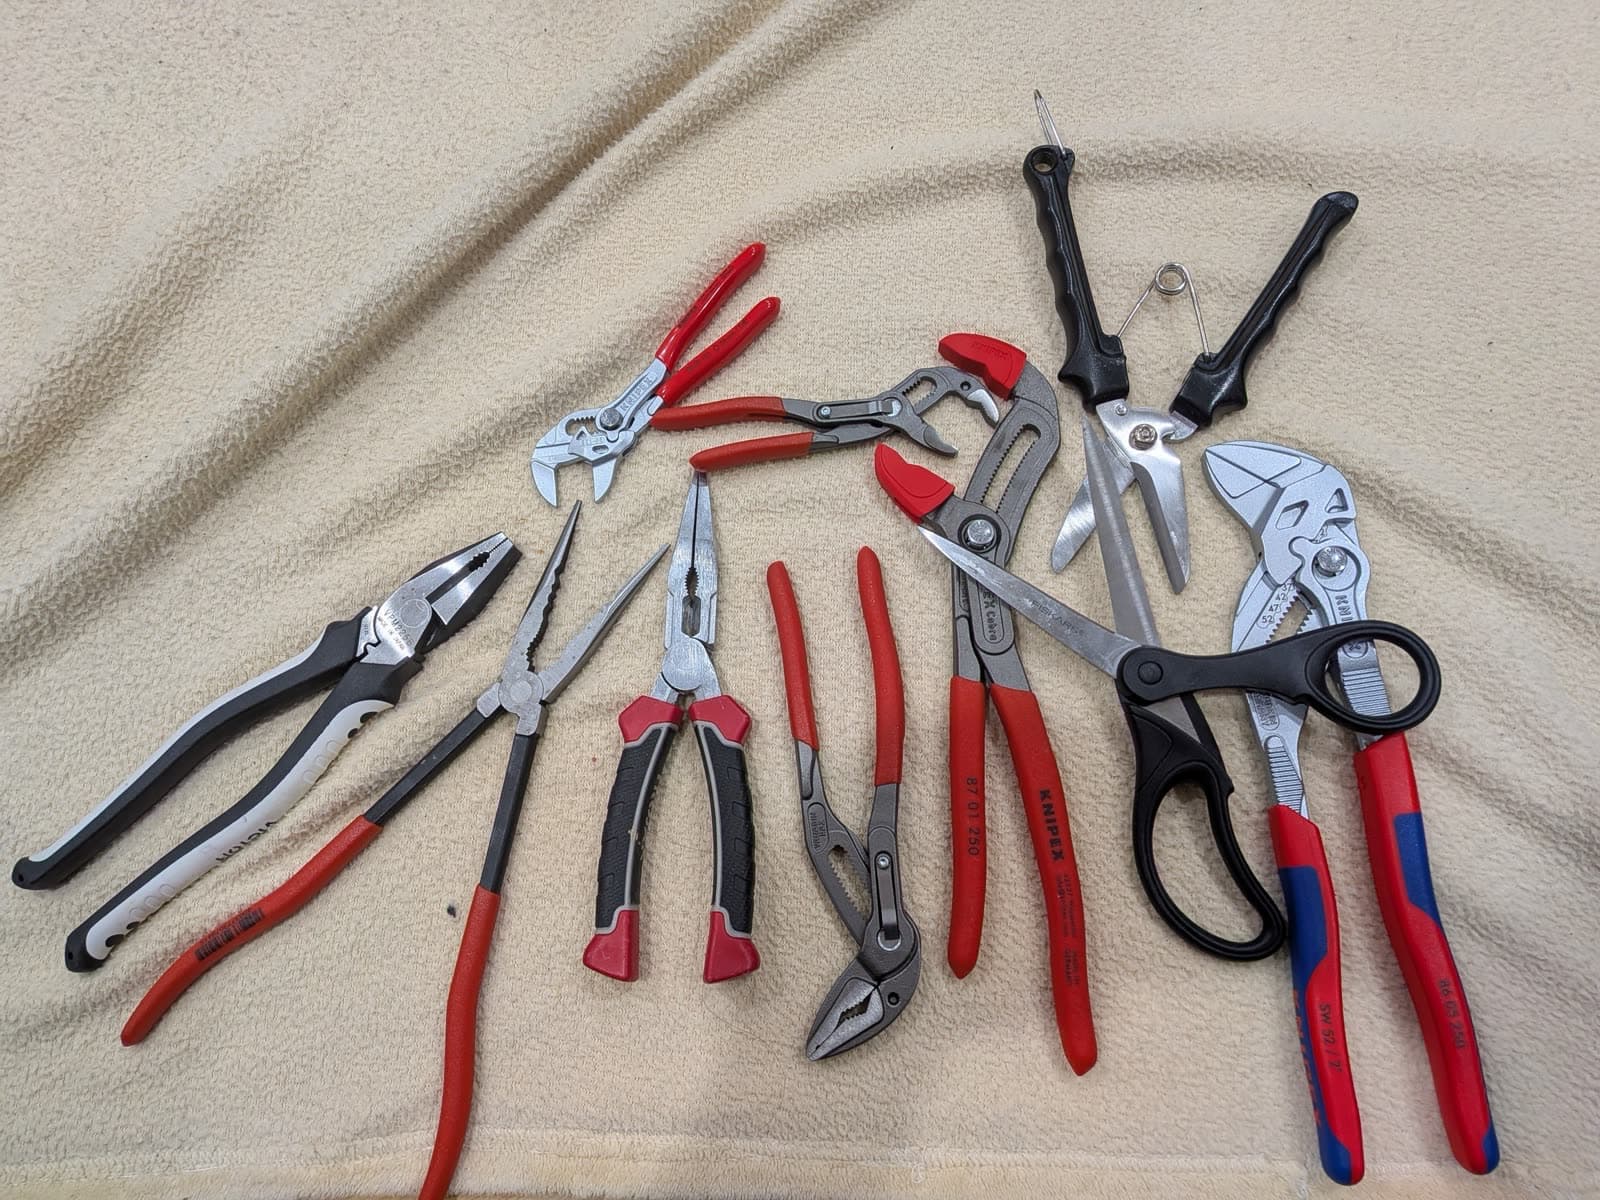
Ein fairer Hinweis: Elorian bezeichnet dieses Beispiel als geprüfte Referenzantwort, "not a recorded model trace." Die aufgezeichneten Abläufe im Beitrag sind die Zug- und Vogel-Clips, das Roboter-Material und die Zählung auf der Baustelle. Diese Unterscheidung geht leicht unter und ist es wert, beim Teilen der Demos im Hinterkopf zu bleiben.
Wie gut ist Glimpse wirklich?
Jede Zahl unten stammt von Elorian, gemessen bei maximalem Denkaufwand mit dem jeweiligen nativen Werkzeug-Setup jedes Modells. Unabhängig hat es noch niemand getestet: Zum 19. Oktober gibt es keine Artificial-Analysis-Seite für Glimpse. Mit diesem Vorbehalt hier die Launch-Tabelle.
| Test | Was er prüft | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| WGO Bench | Ereignisse bei Roboter-Manipulation | 42.70 | 39.42 | 38.91 | 12.34 | 33.99 |
| ERQA | Räumliches Schlussfolgern (Embodied) | 83.75 | 83.75 | 82.45 | 82.20 | 81.20 |
| BabyVision | Feinkörniges visuelles Schlussfolgern | 95.36 | 97.68 | 97.16 | n/a | 83.25 |
| HSS | Szenenverständnis, Bild + Video | 46.36 | 53.6 | 46.6 | 49.81 | 41.6 |
| CharXiv-R | Schlussfolgern über wissenschaftliche Diagramme | 92.90 | 92.10 | 92.60 | 93.40 | 91.80 |
| UGC-VideoCap | Untertitel für Kurzvideos | 82.66 | 80.32 | 80.41 | 76.35 | 78.33 |
| DREAM-1K | Dichte Videountertitel | 76.04 | 79.05 | 77.93 | 72.05 | 70.00 |
| TOMATO | Feinkörniges zeitliches Schlussfolgern | 93.60 | 96.02 | 89.02 | 72.44 | 83.02 |
| Video-MME v2 | Videofragen mit Untertiteln | 56.68 | 64.06 | 65.27 | n/a | 59.58 |
| E.T. Bench | Ereignisverständnis | 63.55 | n/a | 59.79 | n/a | 63.45 |
| FSC-147 | Zählen mit offenem Vokabular | 83.36 | 82.02 | 82.69 | 73.78 | 67.06 |
| CountQA | Zählen auf Produktbildern | 82.66 | 86.42 | 86.42 | 82.20 | 81.09 |
Fett markiert den besten Wert je Zeile. Liest man das gegen GPT-6 Astra, zeigt sich ein Muster:
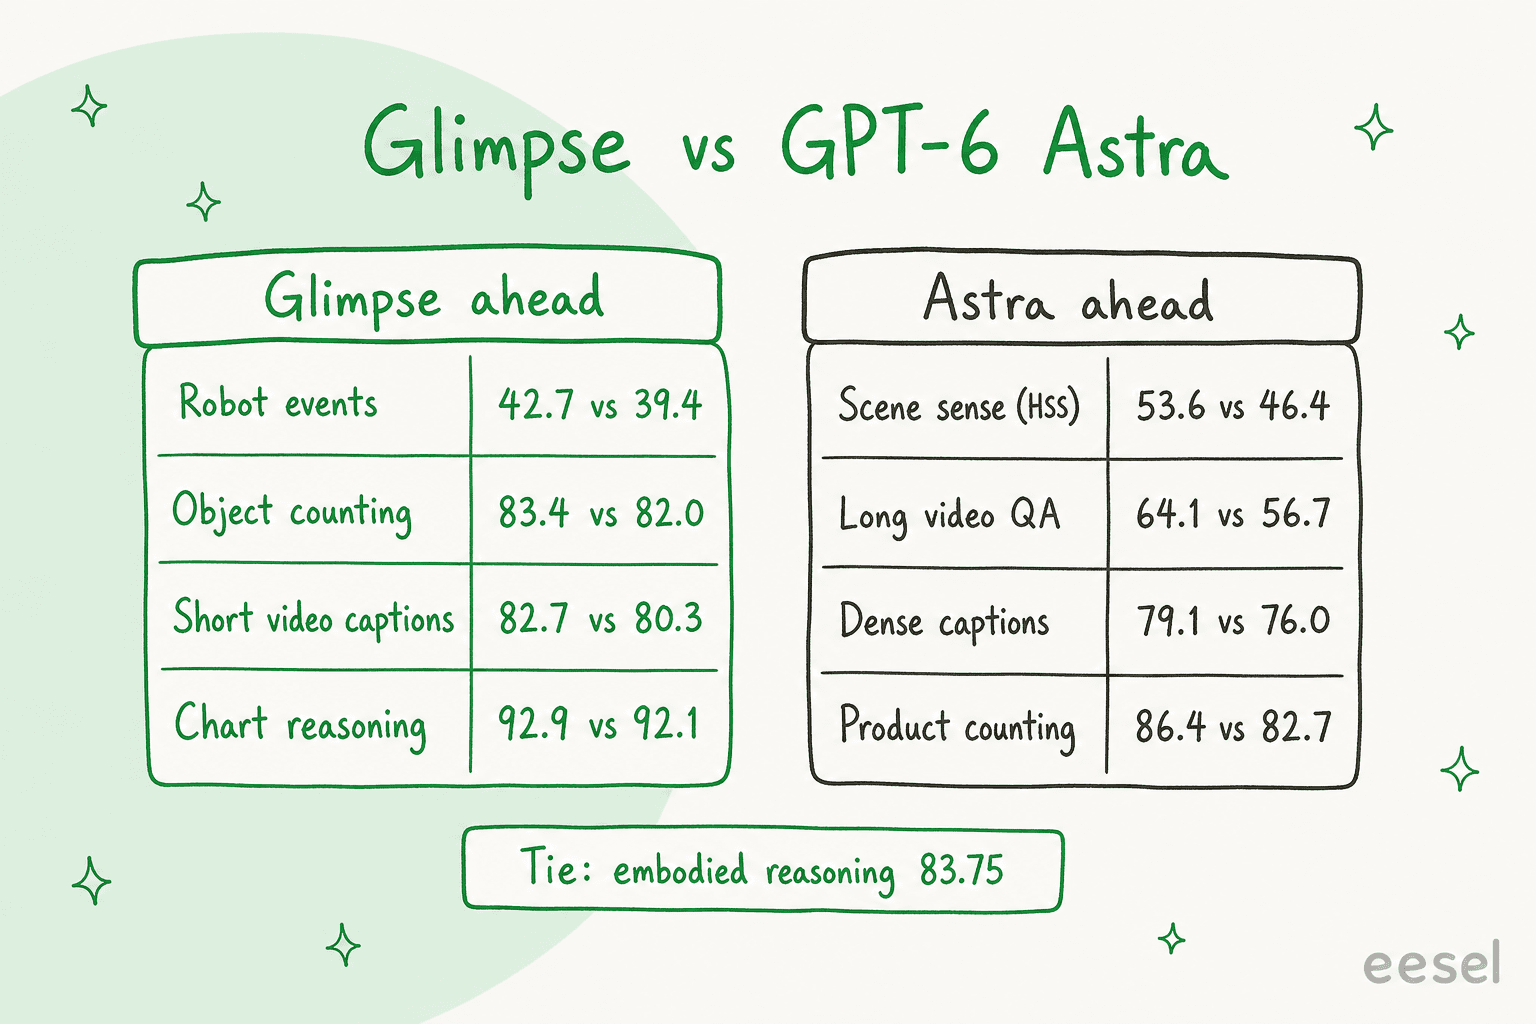
Glimpses Siege sind klein (0,8 Punkte beim Diagramm-Schlussfolgern, 1,3 beim Zählen), seine Niederlagen größer (7,2 Punkte bei HSS, 7,4 bei Video-MME v2). Die ehrliche Schlagzeile lautet also nicht "schlägt Astra". Sie lautet: bei den meisten visuellen Tests nah an Astra, bei etwa einem Sechzehntel des Preises. Das ist immer noch eine große Sache, und so rahmt es auch Elorian selbst: "frontier-level performance at the level of (and sometimes exceeding)" Astra und Claude Opus 5.5.
Außerdem schlägt es die günstige Klasse klar. Gegen Gemini 3.8 Flash, den preislich nächsten Konkurrenten, gewinnt Glimpse 11 der 12 Zeilen, und bei WGO Bench erreicht es 42.70 gegen 33.99.
Ein Wort zum HSS-Benchmark
HSS, kurz für Humanity's Sixth Sense, ist ein neuer Test, den Elorian mit Scale AI gebaut hat. Er enthält 522 offene Fragen (288 Bilder und 234 Videoclips) dazu, was eine Szene andeutet, aber nicht zeigt: aus welcher Richtung der Wind weht, ob ein Buch in ein Regal passt, ob Menschen Besucher oder Crew sind. Eine Antwort zählt nur, wenn sie jeden Punkt eines von Menschen geschriebenen Bewertungsrasters erfüllt.
Menschen erreichen 93,1. Das beste Modell auf Elorians Rangliste, GPT 6 Astra, erreicht 53,6, und Glimpse 46,36. Zwei Dinge sollte man gleichzeitig im Kopf behalten: Es ist ein nützlicher Benchmark, weil er eine echte Lücke anspricht, und es ist Elorians eigener Benchmark, also behandeln Sie ihn wie jeden vom Hersteller gebauten Test. Lob an Elorian dafür, einen Test zu veröffentlichen, den das eigene Modell nicht gewinnt. Dass Scale AI Partner ist, gibt dem Fragensatz etwas mehr Gewicht.
Was kostet Elorian Glimpse?
Die Preiskarte ist kurz, denn Elorian hat nur eine Zeile davon veröffentlicht:
| Weg | Eingabe | Ausgabe | Hinweise |
|---|---|---|---|
| Elorian API | $0.60 / 1M Tokens | $3.00 / 1M Tokens | Ohne Cache; keine Preise für Cache, Batch oder Kontextstufen veröffentlicht |
| Elorian Chat | Kostenlos | Kostenlos | Anmeldung mit Google oder E-Mail; Wall St Engine meldete zum Launch eine Warteliste |
| Together AI | Vertrieb kontaktieren | Vertrieb kontaktieren | Nur dedizierte Bereitstellung, kein serverloser Preis pro Token |
| Enterprise | Vertrieb kontaktieren | Vertrieb kontaktieren | Über Elorians Vertriebsteam |
Zum Vergleich, so stehen die Ausgabepreise der verglichenen Modelle in Elorians Launch-Tabelle zueinander:
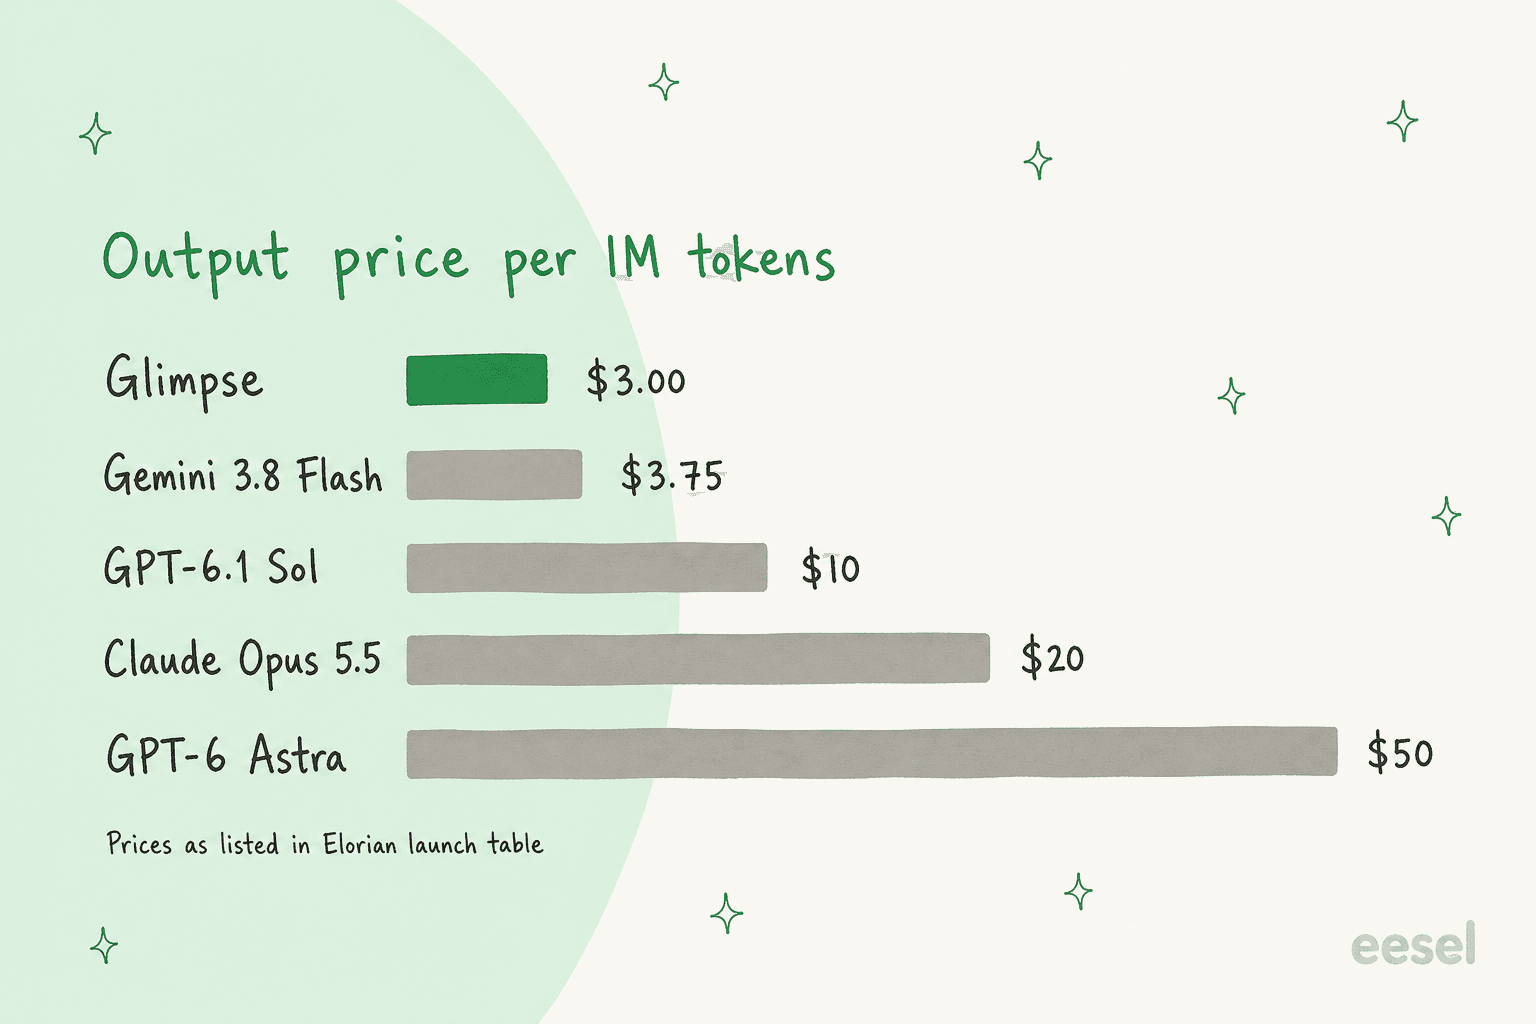
Diese Preise der Konkurrenz sind so, wie Elorian sie aufgeführt hat. Meine Aufschlüsselungen zu GPT-6 Astra pricing und Opus 5.5 pricing behandeln die vollen Preiskarten samt Caching. Elorians Behauptung: Glimpse ist 94 % günstiger als Astra und 20 % günstiger als der Einführungspreis von Gemini 3.8 Flash, bei Eingabe und Ausgabe.
Zwei Dinge verändern die tatsächliche Rechnung:
- Glimpse denkt mit vielen Tokens. Elorian sagt das selbst: "Looking that closely takes time, and tokens. Token efficiency is our next highest focus." Ein niedriger Preis pro Token bei einem Modell, das lange schlussfolgert, kann pro Aufgabe trotzdem mehr kosten als erwartet. Testen Sie also an eigenen Clips, bevor Sie budgetieren.
- Zahlen pro Aufgabe sehen besser aus als Zahlen pro Token. In Elorians Demo zur Roboterplanung kostete die ganze Episode mit Glimpse $0.035 gegenüber $0.249 mit Astra, etwa 7-mal weniger. Investor Brian Zhan hat durchgerechnet, was das für einen Roboter bedeutet, der alle 2 Sekunden seine Kameras prüft: 1.800 Aufrufe pro Roboterstunde, wobei "the same budget on Astra buys one check every 14s."
Bei Together bedeutet die rein dedizierte Auflistung, dass Sie für reservierte GPUs zahlen, nicht pro Aufruf. Das passt zu einem Team mit stetigem Volumen und einem Grund, den Traffic auf bereits genutzter Infrastruktur zu halten; mein Leitfaden zu Together AI pricing erklärt, wie dedizierte Endpunkte abgerechnet werden. Für einen ersten Test ist die Elorian API einfacher. Eine vollständige Kostenaufschlüsselung pro Szenario folgt in einem eigenen Beitrag zu den Glimpse-Preisen.
Wofür ist es tatsächlich gut?
Elorian und Together nennen dieselben drei Gruppen von Anwendungsfällen, und sie decken sich mit den Stärken in den Benchmarks.
Robotikdaten und Planung. Glimpse kann Teleoperations-Aufnahmen beschriften, Objekte benennen und einrahmen und eine Episode in zeitgestempelte Pick-and-Place-Ereignisse zerlegen. Es kann auch als Planer für eine Vision-Language-Action-Roboterrichtlinie dienen und anhand der Kameras entscheiden, wann ein Schritt abgeschlossen ist. In der Launch-Demo plante es für Physical Intelligences π0.5-Richtlinie bei einer LIBERO-Aufgabe. Wenn Robotik Ihr Feld ist, vergleichen Sie es mit Googles Gemini Robotics 2 und Gemini 4 Argon for robotics.
"Most teleop footage sits unlabelled because segmenting every step by hand is slow and expensive."
Video in großem Maßstab. Dichte Untertitel, die feine Bewegungen und emotionale Dynamik erfassen, Tagging von Kurz- und Social-Video für die Suche sowie Verfolgen oder Zählen von Objekten in Handkamera-Aufnahmen. Elorians Welpen-Demo behält die Nummer jedes Welpen, wenn die Kamera wegschwenkt und zurückkommt, und das ist der schwierige Teil beim Zählen in Videos.
Wissenschaftliche und betriebliche Inspektion. Diagramme und Labordaten lesen, Ausrüstung und Bestand zählen und dabei ähnlich aussehende Dinge trennen, und aus einem Foto auf physische Folgen schließen. Elorians Baustellen-Demo zählt Fahrzeuge auf einem Hof und gibt die Zeitstempel zurück, auf die es sich gestützt hat, also genau die Art Beleg, die ein Prüfer sehen will.
Was sagen frühe Nutzer?
Die Reaktionen zum Launch auf X drehten sich vor allem um den sichtbaren Prozess. Andrew Dais Ankündigung bekam über 5.700 Likes:
"Spent years watching models ace a single image and completely whiff on anything that moves or changes angle. Today we're fixing that."
Ein Tester mit frühem Zugang machte einen Zähltest an einem Gemälde und mochte, wie das Modell arbeitete, nicht nur die Antwort:
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
Die schärfste Kritik kam in den Antworten, und es ist die richtige Frage an jede Demo:
"Counting is the easy thing to check, but the footage use is where it gets hard. Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing. I'd want to see it on a long clip where the key change happens off to one side of the frame."
Bemerkenswert: Mehrere der euphorischsten Launch-Beiträge, darunter Brian Zhans Robotik-Thread und Strikers Beitrag "1/16 the price of Astra", stammen von Elorians Investoren. Sie sind für die Rechnung nützlich, aber keine neutralen Tests. Ich aktualisiere diesen Beitrag, sobald unabhängige Tester Ergebnisse zu langen Clips veröffentlichen.
Wo Glimpse Schwächen hat
Nichts davon ist für ein erstes Modell ein Ausschlusskriterium, aber Sie sollten es kennen, bevor Sie darauf aufbauen:
- Es ist eine Forschungsvorschau. Elorians eigene Formulierung. Rechnen Sie damit, dass sich Modell, Limits und Preis ändern.
- Noch keine unabhängigen Benchmarks. Jeder Wert ist Elorians eigener Lauf, bei maximalem Aufwand, in einer Tabelle mit einem Benchmark, den Elorian selbst gebaut hat.
- Fehlende Grundlagen. Kein veröffentlichtes Kontextfenster, keine maximale Ausgabelänge, keine Ratenlimits, kein Preis für gecachte Eingaben und keine Batch-Stufe. Für API-Käufer entscheidet das darüber, ob es in der Produktion funktioniert.
- Keine Gewichte. Es basiert auf einem Open-Weights-Modell, aber Glimpse selbst ist geschlossen. Wenn Sie Vision selbst hosten müssen, sind Nemotron 3.5 Super VL und das DeepSeek V4 Flash vision experiment die offenen Optionen.
- Trainiert standardmäßig mit Ihren Uploads. Elorians Bedingungen lizenzieren eingereichte Inhalte zum "train, test, evaluate, and improve" seiner Modelle. Zahlende Nutzer können per E-Mail widersprechen; kostenlosen Nutzern gewähren die Bedingungen diese Möglichkeit nicht. Dieselben Bedingungen verbieten außerdem, Ausgaben zum Training oder Benchmarking eines anderen Modells zu verwenden.
- Nur Text als Ausgabe. Es liest Bilder und Video, gibt aber Text zurück, und Elorian sagt, Roboter-Aktionsausgaben seien noch "work ahead."
Ist Glimpse für den Kundensupport nützlich?
Das ist die Frage, die mir am wichtigsten ist, also direkt: Der Vision-Teil passt wirklich. Kunden schicken Fotos beschädigter Produkte, Screenshots von Fehlermeldungen und Bildschirmaufnahmen von Bugs. Ein Textmodell sieht "siehe Anhang" und sonst nichts. Ein Modell, das zählen, vergleichen und verfolgen kann, was sich in einem Clip verändert hat, könnte aus diesen Anhängen Antworten machen.
Aber für ein Support-Team ist Glimpse heute eine Komponente, keine Lösung. Es gibt keine Helpdesk-Integration, kein veröffentlichtes Kontextfenster für lange Ticket-Verläufe, und wegen des Standard-Trainings mit Uploads bräuchten Sie einen bezahlten Tarif, bevor ein Kundenfoto damit in Berührung kommt. Helpdesks bauen außerdem eigene Bildlesefunktionen ein, etwa Gorgias AI Agent Vision, und die Handhabung von Anhängen hat eigene Grenzen, etwa Zendesks Größenlimits für Anhänge.
Die Lektion, die eesel auf die harte Tour gelernt hat, gilt für jedes neue Modell: Man kann einem Modell nicht zutrauen, sich in einer Live-Warteschlange selbst zu kontrollieren. Eine selbstsichere falsche Antwort zu einem Foto eines beschädigten Artikels ist schlimmer als eine langsame menschliche. Deshalb wird jeder eesel-Rollout an historischen Tickets simuliert, bevor die KI einem echten Kunden antwortet. Mein Leitfaden zum best support ticket model geht darauf ein, wie man die Modellschicht auswählt, und AI ticket classification ist eine risikoärmere erste Aufgabe für jedes neue Modell.
Wer sollte Elorian Glimpse ausprobieren?
So würde ich entscheiden:
- Robotik-Teams, die Aufnahmen beschriften oder die Arbeit einer Richtlinie prüfen. Hier ist Glimpse in Elorians Tabelle am stärksten und pro Prüfung am günstigsten. Probieren Sie es zuerst.
- Teams, die Kurzvideos in großem Maßstab taggen oder untertiteln. Starker UGC-VideoCap-Wert und niedriger Ausgabepreis. Lassen Sie es an Ihren eigenen Clips laufen.
- Inspektion und Bestandszählung. Gut beim offenen Zählen, schwächer beim Zählen auf Produktbildern (CountQA), testen Sie also mit Ihren tatsächlichen Produktfotos.
- Fragen zu langen Videos. Astra und GPT-6.1 Sol erzielen bei Video-MME v2 deutlich höhere Werte. Beginnen Sie dort, wenn Genauigkeit wichtiger ist als Kosten.
- Alles, was Gewichte, Verträge oder veröffentlichte Limits braucht. Warten Sie. Schauen Sie sich offene Modelle oder Togethers andere Optionen an, bis Glimpse die Vorschau verlässt.
Wenn Sie das weitere Feld neuer Vision-fähiger Modelle in diesem Monat verfolgen, sind Meta Muse Wonder, Reflection AI Beam und GLM-5.3-Flash die anderen Launches, über die ich geschrieben habe.
eesel ausprobieren
Glimpse ist Infrastruktur: ein Modell, eine API und eine Abrechnung pro Token. Um es für Support-Tickets zu nutzen, müssten Sie noch die Helpdesk-Anbindung, die Suche über Ihr Help Center, die Eskalationsregeln und die Tests selbst bauen. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied steigt in Ihre bestehende Warteschlange in Zendesk, Freshdesk, Gorgias und anderen Helpdesks ein, lernt aus Ihren früheren Tickets und Dokumenten, und Sie können es an Hunderten Ihrer historischen Tickets durchspielen, bevor es einem einzigen Kunden antwortet. In diesem Durchlauf fangen Sie die selbstsichere falsche Antwort zum Foto eines Kunden ab, bevor es der Kunde tut.
Wenn Sie lieber im Terminal arbeiten, so wie Sie ein neues Modell testen würden, steuert die eesel CLI dasselbe Teammitglied. eesel instructions liest und bearbeitet seine festen Regeln, eesel approvals listet Aktionen auf, die auf einen Menschen warten, und eesel activity zeigt jeden Lauf und warum es so gehandelt hat, sodass ein Coding-Agent wie Claude Code Ihr Support-Teammitglied genauso verwalten kann wie Ihr Repository. Wenn Sie Inhalte schreiben statt Tickets zu beantworten, hat dieselbe Riege einen KI-Blog-Autor.

Der Start ist kostenlos, ohne Karte. Testen Sie eesel an den Tickets des letzten Monats und sehen Sie, was es gesagt hätte, bevor Sie einen einzigen dedizierten Endpunkt durchrechnen. Die Tarife stehen auf der Preisseite.