

Wie schnell ist „ultraschnell"?
Tempo ist hier der ganze Pitch, also beginne ich mit den Zahlen, die TypeSafe tatsächlich veröffentlicht, und gehe ihnen dann auf den Grund.
TypeSafe sagt, die Ende-zu-Ende-Antwortzeit von Jev liege bei 70 ms bis 500 ms, gegenüber 3 bis 329 Sekunden bei Frontier-LLMs für System-One-artige Anfragen. Auf der Startseite geht es mit einem Workflow-Benchmark größer weiter: 193,6x schneller und 444,6x günstiger, auch wenn der Launch-Beitrag ehrlich sagt, dass dies „am oberen Ende realer Zugewinne" liegt. Eine Demo auf derselben Seite misst eine einzelne Entscheidung mit 0,114 Sekunden und 0,000081 $, gegenüber 8,566 Sekunden und 0,013880 $ für eine LLM-Baseline.
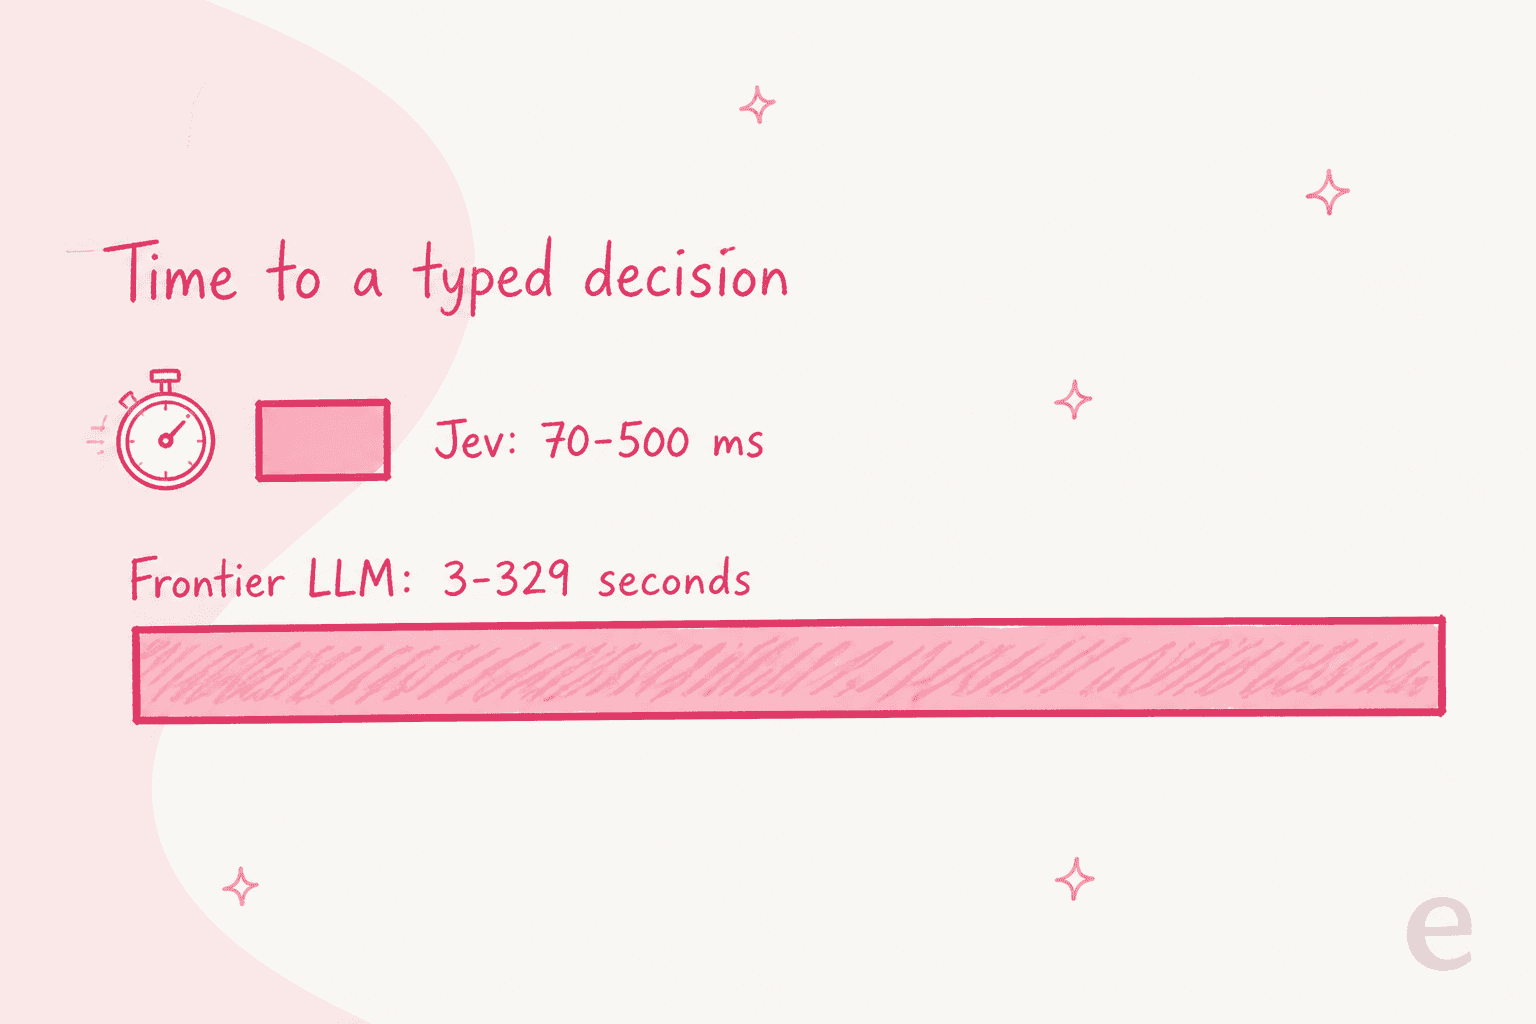
Hier dieselben Angaben samt Einschränkungen, denn die Baselines zählen genauso viel wie die Zahlen.
| Behauptung | Jev | Von TypeSafe genannte Baseline |
|---|---|---|
| Ende-zu-Ende-Latenz | 70 ms bis 500 ms | 3 bis 329 Sekunden für Frontier-LLMs |
| Tempo-Faktor | 40x bis 200x schneller | bei System-One-artigen Anfragen |
| Workflow-Schlagzeile | 193,6x schneller | „am oberen Ende realer Zugewinne" |
| Einzelentscheidungs-Demo | 0,114 s | 8,566 s für die LLM-Baseline |
| Kontextfenster | 32.000 Token | Modellversion jev-1.13.0 |
Die 70-500 ms sind die Zahl, nach der ich tatsächlich planen würde, weil sie eine einzelne Anfrage beschreibt und keinen ganzen Workflow. Bei dieser Latenz kann eine Entscheidung innerhalb einer Anfrage stecken, auf die ein Nutzer wartet, was nicht geht, wenn ein Klassifizierungsschritt acht Sekunden dauert.
Warum Jev schnell ist: ein paralleler Durchlauf statt eines Token-Stroms
Das Tempo ist kein Optimierungstrick, es kommt aus einem anderen Design. Ein LLM sampelt ein Token nach dem anderen, der Reihe nach, bis es eine Zeichenkette für einen Menschen erzeugt hat. Jev erzeugt alle seine Ausgaben in einem einzigen parallelen Durchlauf und produziert überhaupt keinen freien Text.
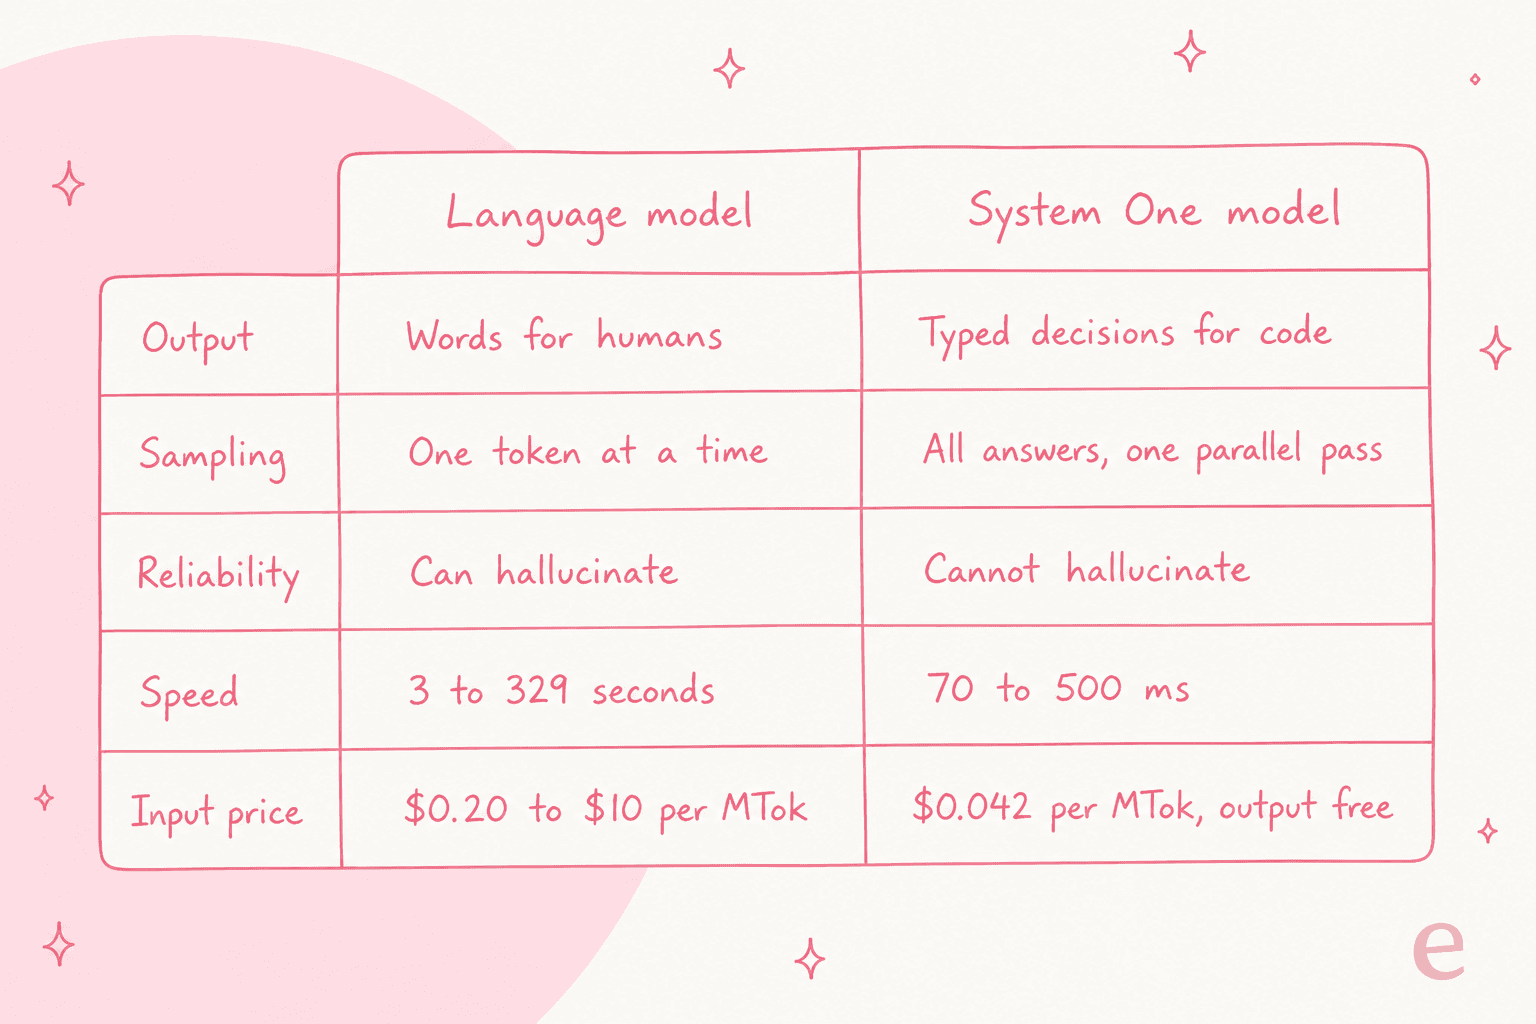
Du schickst Jev einen State (einen String oder ein strukturiertes Objekt) plus eine Reihe typisierter Fragen. Es wertet jede Frage parallel aus, und zwar gegen denselben State, und liefert typisierte Antworten mit Wahrscheinlichkeiten und einem Konfidenzwert. Weil jede Frage für sich bewertet wird, ändern weitere Fragen laut TypeSafe die Antwortzeit kaum, sodass du „ist das dringend", „welche Abteilung" und „wie frustriert" in einem Aufruf stellen und trotzdem im Latenzbudget bleiben kannst.
Deshalb ist die Beschreibung von Jev als schneller Baustein fairer als „ein schnelleres LLM". Es passt überall dort, wo du bisher ein Sprachmodell dazu zwingst, einen JSON-Blob auszugeben, den du dann parst und hoffst, dass er gültig ist, dieselbe Frage „welche Ebene wähle ich", die auch bei AgentKit vs. Anthropic API auftaucht. Es passt nicht dort, wo du Schreiben, Erklären oder mehrstufiges Schlussfolgern brauchst.
Der Tempo-Vergleich ist nicht ganz Äpfel mit Äpfeln
Das hat die Launch-Day-Menge innerhalb einer Stunde bemerkt, und es lohnt sich, ehrlich damit umzugehen. Jev ist zum Teil schnell, weil es weniger tut. Der Top-Kommentar im Hacker-News-Thread mit 1.929 Punkten stellte den ganzen Launch in ein neues Licht, und die schärfere Latenzkritik folgte direkt darauf:
"'70-500ms vs 3-329 seconds' are apples-to-oranges unless the LLM baseline is doing comparable work... If Jev is skipping generation entirely for a narrow structured task, of course it's faster."

Das ist ein berechtigter Treffer. Ein Modell, das drei typisierte Werte ausgibt, mit einem Modell zu vergleichen, das einen Absatz schreibt, und das erste dann 200x schneller zu nennen, misst zwei verschiedene Dinge. Ehrlich gelesen ist Jev extrem schnell für den entscheidungsförmigen Ausschnitt der Arbeit, auf den es zielt, und dieser Ausschnitt ist real und häufig. Bei den Aufgaben, die es schlicht nicht erledigt, ist es nicht schneller.
Die Zahl, der ich am meisten traue, steht also gar nicht auf der Seite von TypeSafe. Sie kam vom CEO von Vercel, der Jev in ein ausgeliefertes Produkt eingebaut hat:
"We're seeing extraordinary results from @typesafeai... Jev is up to 18x faster (p95) and more accurate."
Ein 18-faches Tempo beim p95 in einem Live-Sicherheitsprüfschritt ist sowohl kleiner als auch deutlich besser belegt als die 200x aus dem Marketing, und es zeigt genau, wo sich ultraschnell auszahlt.
Wo sich das Tempo wirklich auszahlt
Eine Latenz unter einer Sekunde lohnt sich nur, wenn eine Entscheidung auf dem kritischen Pfad liegt und etwas auf die Antwort wartet. Dieses Muster solltest du suchen: ein schneller Prüfer vor einem langsameren System.
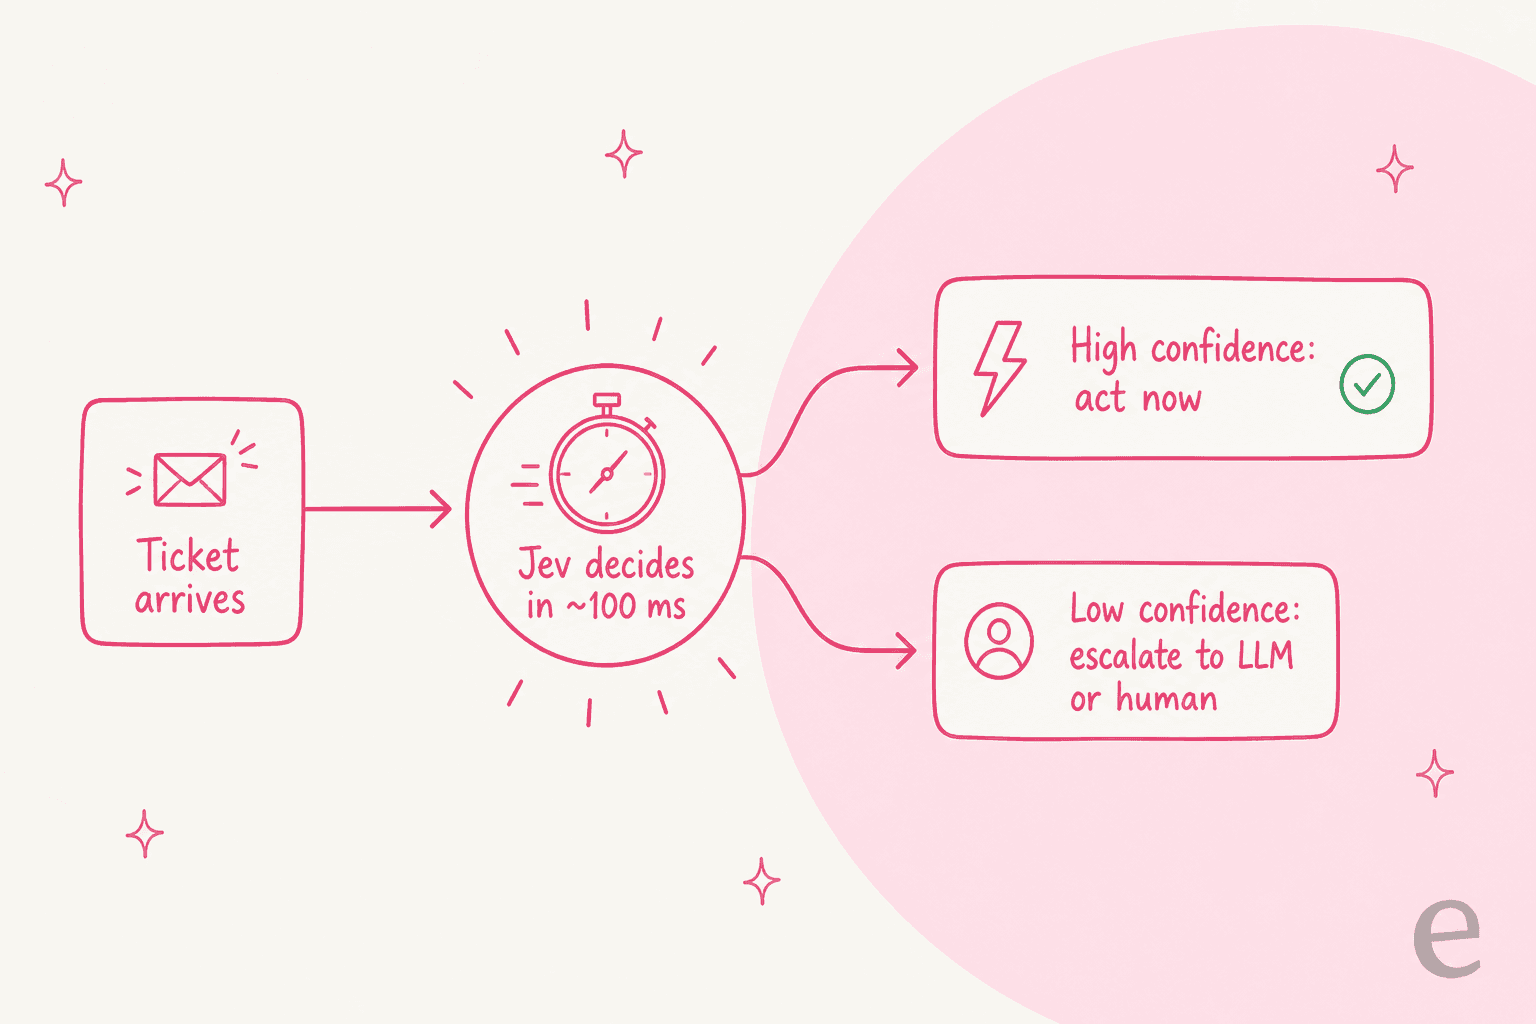
Das Praxisbeispiel, das Cloudflare veröffentlicht, ist bezeichnenderweise ein Support-Ticket: Gib Jev „Help! My payouts have been failing for 3 days" und es liefert is_urgent mit 0,95, department als Abrechnung mit 0,8 Konfidenz und einen Frustrationswert, alles in einem Aufruf. Das sind Triage, Routing und Stimmungsanalyse in einer einzigen Anfrage, genau der Schritt, den ein KI-Ticket-Triage-Ablauf tausendfach am Tag ausführt. Wenn jeder Aufruf 100 ms statt 8 Sekunden dauert, kannst du ihn synchron ausführen, sobald das Ticket eintrifft, statt in einer langsamen Hintergrundwarteschlange.
Der Entwickler, der den Bedarf am besten zusammenfasste, machte genau das schon von Hand:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing."
Der Konfidenzwert macht das Tempo in so einer Schleife nutzbar: sichere Antworten sofort umsetzen, unsichere an ein größeres Modell oder einen Menschen weiterreichen. Dieselbe Disziplin steckt hinter gutem KI-Agenten-Design und jedem ernsthaften Agent-Assist-Schritt, bei dem es um Tempo geht, ohne dass ein selbstsicher falscher Entscheid einen Kunden erreicht.
Was es kostet, so schnell zu laufen
Die andere Hälfte von „ultraschnell" ist, dass es billig genug ist, um ständig aufgerufen zu werden. TypeSafe verlangt für Jev 0,042 $ pro Million Eingabe-Token, die Ausgabe ist kostenlos, was es als 238-fach niedriger bei der Eingabe als Claude Fable 5.1 darstellt, und die Ausgabe beschreibt es als „too cheap to meter". Eine eigene Preisseite gibt es noch nicht, und zur Nachhaltigkeit ist der Launch-Beitrag erfrischend offen: „We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Günstig pro Aufruf plus schnell pro Aufruf ist, was den Jevons-Paradoxon-Pitch trägt, nach dem das Modell benannt ist: Wenn eine Entscheidung einen Bruchteil eines Cents kostet und in 100 ms zurückkommt, hörst du auf zu rationieren und rufst sie überall auf, so wie du dich schon heute auf günstige Bausteine in der KI-Workflow-Automatisierung stützt. Das ist eine ganz andere Haltung, als für jede Klassifizierung LLM-Preise zu zahlen.
Solltest du auf Jevs Tempo bauen?
Mein Fazit nach Docs, Demos und Gegenwind: Greif zu Jev, wenn die Aufgabe eine enge, klar umrissene Entscheidung ist, die dein Code verarbeitet, und die Latenz auf dem kritischen Pfad liegt, etwa Routing, Moderation, Intent-Erkennung, Scoring oder ein schnelles Sicherheits-Gate vor einem größeren Modell. Dort verändern die 70-500 ms und die kostenlose Ausgabe wirklich, was du bauen kannst.
Greif nicht danach in der Erwartung eines schnelleren ChatGPT. Es schreibt nicht, erklärt nicht und führt kein Gespräch, und ein so schnelles Werkzeug verleitet zum Übergebrauch bei Aufgaben, die ein einfacher Klassifikator oder eine Regel übernehmen sollte. Die Linie ist: Jev ist ein Baustein, es liefert dir in Millisekunden eine gute Entscheidung, und dir gehören weiterhin die Pipeline, die Eskalationslogik, die Deflection-Strategie und jede Aktion nach der Entscheidung. Tempo bei der Entscheidung kauft dir nichts davon.
eesel testen
Wenn du Support betreibst, lautet die ehrliche Übersetzung: Jev ist ein brillanter Motor, nicht das Auto. Es sagt dir in etwa 114 Millisekunden, dass ein Ticket dringend ist, die Abrechnung betrifft und von einem frustrierten Kunden stammt. Es öffnet das Ticket nicht, entwirft keine Antwort auf Basis deines Help Centers, führt die Erstattung nicht aus und übergibt nicht an einen Menschen, wenn es unsicher ist. Jemand muss diese Schicht noch bauen.
eesel ist dieses fertige Teammate. Es ist ein KI-Support-Teammate, das du in deinen Helpdesk einbindest, und es trifft die Triage-, Routing- und Eskalationsentscheidungen, die Jev als Bausteine anbietet, bereits selbst und setzt sie dann komplett um. Es lernt aus deinen bisherigen Tickets und deinem Help Center, und du kannst es an historischen Tickets simulieren, bevor es je einen Live-Kunden berührt.

Und wenn dir Jevs Entwickler-Ergonomie gefallen hat, wird dir das gefallen: eesel ist nicht nur ein Dashboard. Die eesel CLI (npx @eesel/cli) steuert dasselbe Teammate aus dem Terminal, ein Mensch kann eesel chat oder eesel activity von Hand ausführen, Skripte können es in CI automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können es bedienen, denn jeder Befehl gibt JSON aus und --dry-run zeigt den genauen Aufruf, bevor er abgeschickt wird. Jeder Workspace ist außerdem ein MCP-Server. Jev liefert dir die schnelle Entscheidung; eesel liefert das Teammate, das danach handelt. Du kannst eesel kostenlos testen.
Häufig gestellte Fragen
Wie schnell ist TypeSafe Jev?
TypeSafe gibt die Ende-zu-Ende-Antwortzeit von Jev mit 70 ms bis 500 ms an, gegenüber 3 bis 329 Sekunden für ein Frontier-LLM bei gleich gearteter Arbeit. Der Haken: Jev liefert nur typisierte Entscheidungen, keinen Text, der Vergleich ist also nicht ganz fair. Für Klassifizieren-und-Weiterleiten, wie es hinter der Tier-1-Entlastung steckt, ist es tatsächlich schnell.
Warum ist Jev so viel schneller als ein normales KI-Modell?
Ein LLM sampelt Token für Token, bis es eine Zeichenkette geschrieben hat, die ein Mensch liest. Jev wertet alle seine Fragen in einem einzigen parallelen Durchlauf aus und erzeugt nie freien Text, sodass der langsamste Teil entfällt. Das heißt auch: Es ist ein Baustein für Entscheidungen, kein Ersatz für ein Modell, das schreibt oder schlussfolgert, ähnlich der Trennung zwischen einem regelbasierten und einem KI-Agenten.
Ist der Tempo-Vergleich mit Jev fair?
Teilweise. Eine echte, belastbare Zahl kam vom CEO von Vercel, der bei einem Live-Sicherheitsprüfschritt Jev mit 18-fach schneller beim p95 gemessen hat. Der Marketing-Wert von 193,6x bezieht sich auf einen ganzen Workflow und liegt laut TypeSafe selbst am oberen Ende realer Zugewinne, worauf Hacker News schnell hinwies.
Was kostet das ultraschnelle Jev-Modell?
TypeSafe verlangt für Jev 0,042 $ pro Million Eingabe-Token, die Ausgabe ist kostenlos, was es als 238-fach niedrigeren Eingabepreis als Claude Fable 5.1 darstellt. Eine Tarifübersicht gibt es noch nicht, der Zugang läuft über eine Early-Access-Warteliste. Außerdem ist es auf Cloudflare Workers AI verfügbar.
Kann ich Jev allein Support-Tickets beantworten lassen?
Nicht allein. Jev trifft die schnelle Entscheidung, öffnet aber weder das Ticket, noch entwirft es eine fundierte Antwort oder führt die Erstattung aus. Ein fertiges Teammate wie eesel trifft diese Kundenservice-Entscheidungen und setzt sie in deinem Helpdesk um, und du kannst es sogar über die eesel CLI steuern.