

Die Preise der Gemini Decisions API sind einfach: 0,10 $ pro Million Input-Token, und 0 $ für Output, weil das Modell nie einen schreibt. Ein Ticket mit 600 Token und drei Fragen kostet etwa 0,00008 $, eine 10-minütige Gesprächsaufnahme etwa 0,0015 $. Der Satz entspricht der OpenAI Decisions API und liegt etwa beim 2,4-Fachen von dem, was TypeSafe Jev pro Token verlangt, du zahlst also einen Aufschlag für Audio-, Video- und PDF-Input. Die echten Kosten liegen anderswo: kein Caching, kein Batch, eine Free-Stufe mit Trainingsdaten und ein Tier-1-Limit von 50.000 Anfragen pro Tag. Für Support-Teams ist Triage inzwischen fast kostenlos; das Schreiben der Antwort ist weiterhin der teure Teil, und genau das macht eesels KI-Support-Teammitglied. Mit der eesel CLI kann ein Coding-Agent deine Routing-Regeln und Makros hochladen und dann Testtickets durchlaufen lassen, bevor irgendetwas live geht.
Was kostet die Gemini Decisions API?
Gemini Decision 1 (gemini-decision-1) hat einen einzigen Preis auf der kostenpflichtigen Stufe: 0,10 $ pro Million Input-Token, egal ob Text, Bilder, Video, Audio oder PDFs. Output wird auf beiden Stufen als „Nicht zutreffend (0 Output-Token)" ausgewiesen. Das ist die gesamte Preistabelle.
Hier ist die vollständige Zeile von Googles Preisseite, geprüft am 12. November 2026:
| Position | Free-Stufe | Kostenpflichtige Stufe (pro 1 Mio. Token) |
|---|---|---|
| Input (Text, Bild, Video, Audio, PDF) | Kostenlos | 0,10 $ |
| Output | 0 Output-Token | 0 Output-Token |
| Context Caching | Nicht verfügbar | Nicht verfügbar |
| Batch API | Nicht unterstützt | Nicht unterstützt |
| Wird zur Verbesserung von Googles Produkten genutzt | Ja | Nein |
Die Abrechnungsregel, die das günstig macht: geteilter Input wird einmal pro Anfrage abgerechnet, egal wie viele Fragen du stellst. Jede zusätzliche Frage fügt nur ihre eigenen Instruktions- und Kriterien-Token hinzu. Wenn du meinen Erklärartikel zur Gemini Decisions API gelesen hast, weißt du, dass eine Anfrage 1 bis 1.000 Fragen über denselben Input tragen kann, zehn Prüfungen an einem Ticket kosten also etwas mehr als eine Prüfung, nicht zehnmal so viel.
Ich mache seit zwei Jahren SEO für eesel, und die Suche hinter dieser Seite kommt von jemandem mit einer offenen Tabelle, der entscheiden will, ob sich ein Decision-Modell lohnt. Der Rest dieses Beitrags ist also die Tabelle: Kosten pro Posten, die Limits, die dein Volumen begrenzen, und die Kosten, die die Preistabelle auslässt.
Wie viel kostet eine Entscheidung wirklich?
Preise pro Million sind schwer zu greifen, deshalb zeige ich hier, was der Preis pro Posten bedeutet. Die Text-Rechnung ist einfach. Für Medien habe ich Googles Tabelle zur Medienauflösung für seine aktuellen Modelle verwendet, da Decision 1 bei Bild- und Video-Blöcken dieselben Einstellungen low, medium, high und ultra_high akzeptiert.
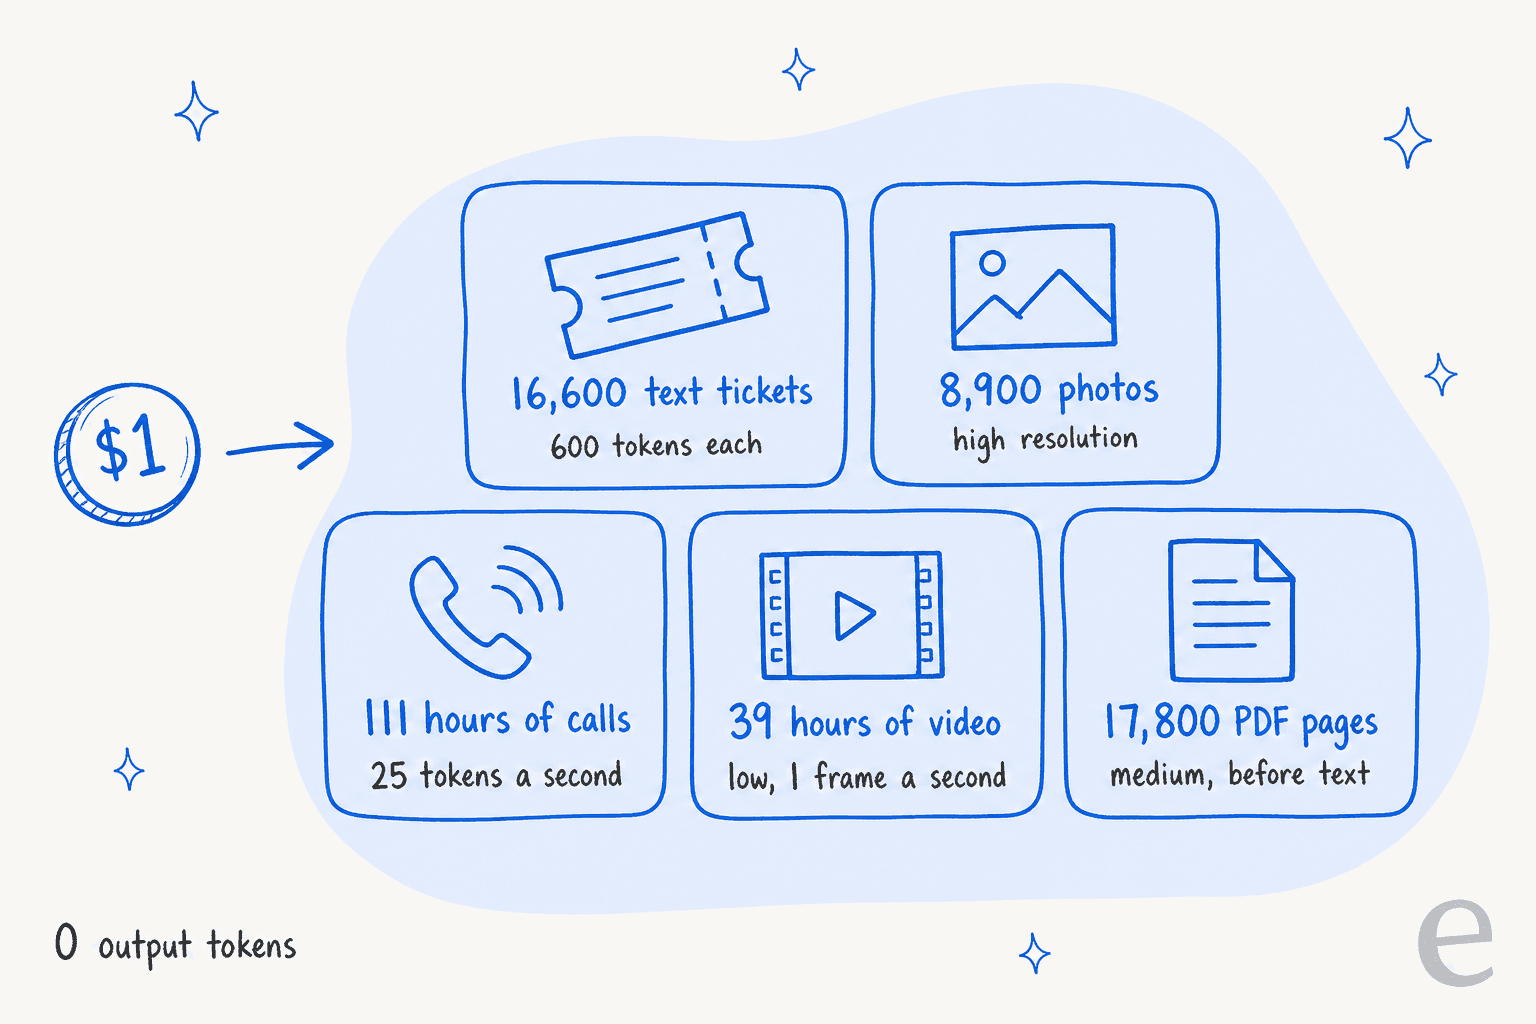
| Input | Token (ca.) | Kosten pro Posten | Kosten pro 10.000 |
|---|---|---|---|
| Support-Ticket, 600 Token + 3 Fragen | ~780 | 0,000078 $ | 0,78 $ |
| Foto, hohe Auflösung | ~1.120 | 0,000112 $ | 1,12 $ |
| Foto, niedrige Auflösung | ~280 | 0,000028 $ | 0,28 $ |
| 1-minütige Gesprächsaufnahme | ~1.500 (25 pro Sekunde) | 0,00015 $ | 1,50 $ |
| 10-minütige Gesprächsaufnahme | ~15.000 | 0,0015 $ | 15,00 $ |
| 60-sekündiges Video mit Ton, Standard | ~6.000 | 0,0006 $ | 6,00 $ |
| 5-seitiger PDF-Antrag, mittel | ~2.800 plus Textebene | ~0,0003 $ | ~3,00 $ |
| Volle Anfrage mit 262.144 Token | 262.144 | 0,026 $ | 262 $ |
Frage-Token sind meine Schätzung von etwa 60 pro Frage. Die Medienwerte sind ungefähr; das Feld usage.input_tokens_by_modality der Antwort nennt dir die genaue Zahl, wobei Videoframes und PDF-Seitenbilder als Bild-Token gezählt werden.
Drei Dinge fallen aus dieser Tabelle heraus:
- Text-Triage ist ein Rundungsfehler. Selbst eine große Warteschlange kostet im Monat nur einen einstelligen Dollarbetrag zum Klassifizieren.
- Auflösung ist dein größter Hebel bei Bildern. Ein Foto von
highauflowzu senken senkt die Kosten um 75 %. Für „Ist Schaden sichtbar?" ist das meist in Ordnung; um eine Seriennummer zu lesen, nicht. Googles eigene Angabe ist, dass die PDF-Qualität „sich typischerweise beimediumsättigt". - Audio ist das überraschende Schnäppchen. Eine 10-minütige Voicemail kostet 0,0015 $ zum Bewerten, ohne separate Transkriptionsrechnung. Das macht Sentiment- oder Eskalationsprüfungen an Anrufen möglich, die vorher niemand für ein LLM bezahlt hätte.
Was bietet die Free-Stufe wirklich?
Die Free-Stufe kostet nichts, aber die Limits und die Datenbedingungen entscheiden, wer sie nutzen kann. Laut Googles Rate-Limits-Seite bekommt Gemini Decision kostenlos 200 Anfragen pro Minute, 50.000 Token pro Minute und 10.000 Anfragen pro Tag.
Das reicht für Aufbau und Tests locker. Bei 780 Token pro Ticket erlaubt dir das Token-Limit etwa 64 Tickets pro Minute, und das Tageslimit deckt 10.000 ab. Eine stark frequentierte Warteschlange könnte fast damit laufen.
Tu es nicht. Auf der Free-Stufe sagt Googles Preistabelle, dass deine Inhalte „zur Verbesserung unserer Produkte genutzt" werden. Kunden-Tickets enthalten Namen, Bestellnummern und manchmal Zahlungs- oder Gesundheitsdaten. Das gehört auf die kostenpflichtige Stufe, wo es nicht fürs Training genutzt wird, zusammen mit den üblichen Prüfungen deiner KI-Guardrails. Die kostenpflichtige Stufe kostet bei Triage-Volumen außerdem so wenig, dass die Free-Stufe dir höchstens ein paar Dollar spart.
Wie funktionieren die Rate-Limit-Stufen?
Die kostenpflichtigen Limits steigen stufenweise, je nachdem, wie viel du insgesamt bei Google Cloud ausgegeben hast und wie lange deine erste Zahlung zurückliegt. Die Free-Stufe zu verlassen bedeutet laut Googles Billing-Doku, ein Billing-Konto zu verknüpfen und mindestens 5 $ an Guthaben vorauszuzahlen.
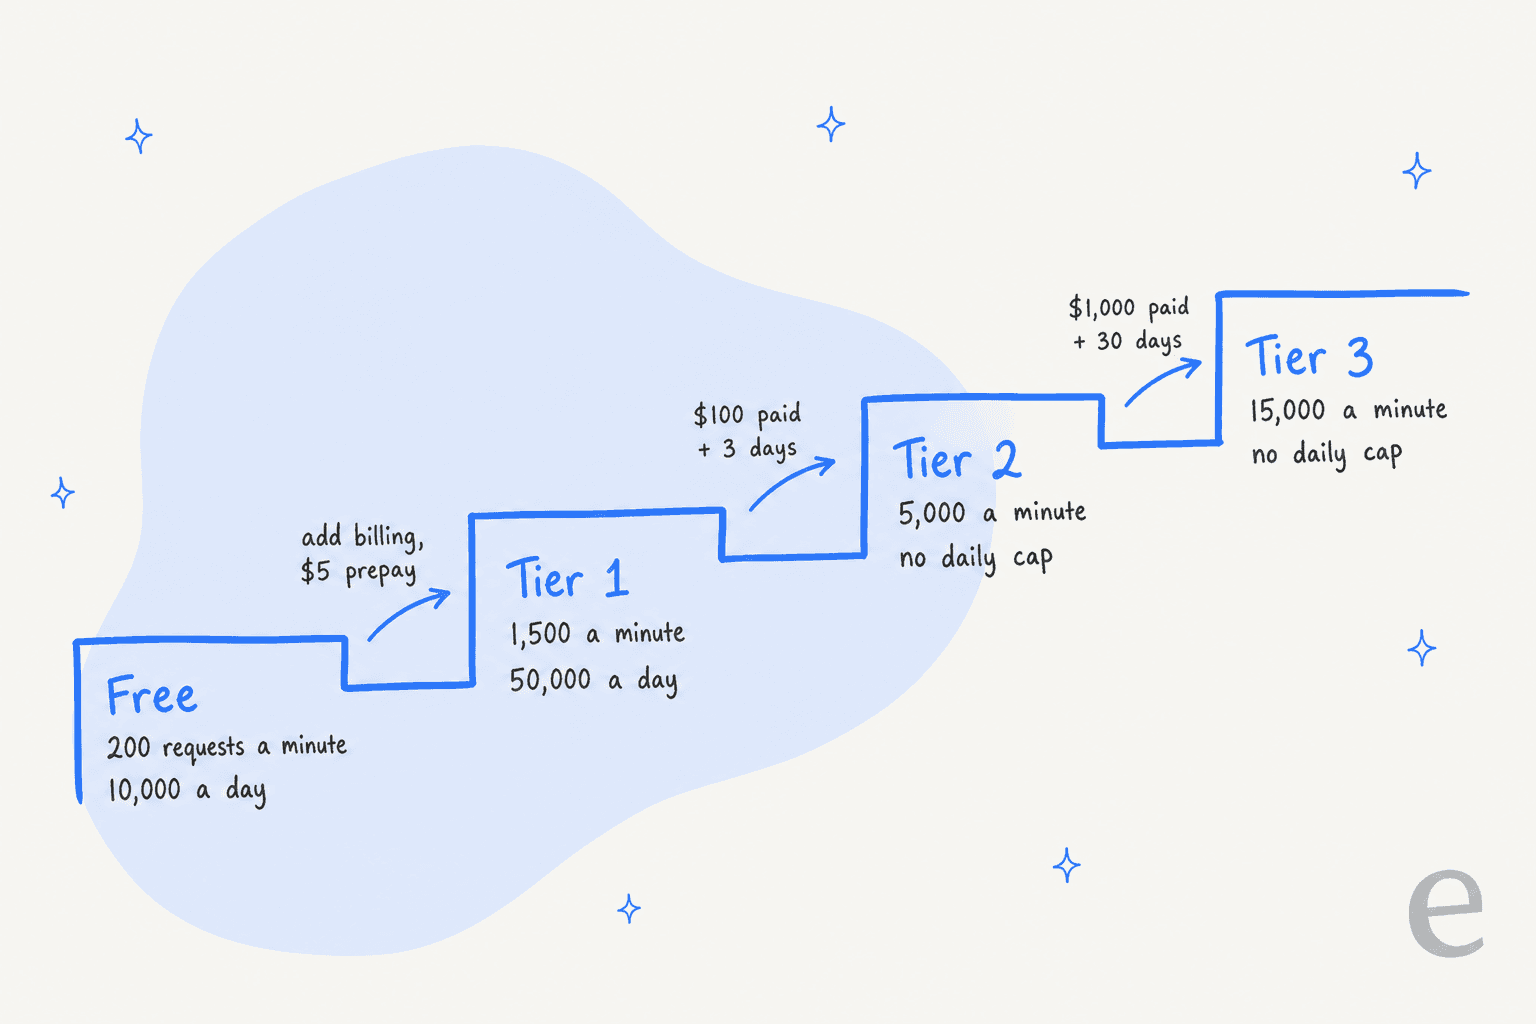
| Stufe | So erreichst du sie | Anfragen/Min. | Token/Min. | Anfragen/Tag | Monatliches Billing-Limit |
|---|---|---|---|---|---|
| Free | Standard | 200 | 50.000 | 10.000 | n/a |
| Tier 1 | Billing verknüpfen, ab 5 $ vorauszahlen | 1.500 | 1.000.000 | 50.000 | 250 $ |
| Tier 2 | 100 $ gezahlt + 3 Tage | 5.000 | 4.000.000 | Unbegrenzt | 2.000 $ |
| Tier 3 | 1.000 $ gezahlt + 30 Tage | 15.000 | 10.000.000 | Unbegrenzt | 20.000 $ bis 100.000 $+ |
Das Seltsame ist die Lücke zwischen Ausgaben und Limits. Tier 2 braucht 100 $ an kumulierten Google-Cloud-Ausgaben, aber bei 0,10 $ pro Million Token sind 100 $ eine Milliarde Token an Entscheidungen. Wenn Decision 1 das Einzige ist, wofür du bei Google bezahlst, kannst du lange auf Tier 1 festsitzen. Das Limit von 50.000 Anfragen pro Tag ist das, das wirklich wehtut: Eine Warteschlange mit 60.000 Tickets am Tag passt nicht hinein, egal wie wenige Token jedes davon braucht.
Wenn du bei Google Cloud bereits ausgibst, startest du wahrscheinlich höher. Andernfalls gibt es ein Formular für höhere Rate-Limits, und es lohnt sich, es vor dem Launch einzureichen statt nach deinem ersten 429.
Wie schneidet sie preislich gegen andere Decision-Modelle ab?
Beim Preis pro Token liegt Gemini in der Mitte der Kategorie Decision-Modelle. Hier ist der jeweils veröffentlichte Satz jedes Anbieters, angewendet auf dieselben 10.000 Tickets zu je 780 Token:
| Modell | Input pro 1 Mio. | Output | 10.000 Tickets | Liest |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | 0 $ | 0,78 $ | Text, Bilder, Audio, Video, PDFs |
| OpenAI Decisions API | 0,10 $ | 0 $ | 0,78 $ | Text, eingebettete Bilder |
| TypeSafe Jev | 0,042 $ | 0 $ | 0,33 $ | Text |
| Microsoft-Decision-1 | 0,042 $ | 0 $ | 0,33 $ | Nicht angegeben |
| Cloudflare Clef | 0,24 $ | Kein Output-Preis | 1,87 $ | Text, JSON, Bilder, Video |
| Cloudflare Clef-flash | 0,038 $ | Kein Output-Preis | 0,30 $ | Text, JSON, Bilder, Video |
| Gemini 3.5 Flash-Lite (strukturierter Output) | 0,30 $ | 2,50 $ | ~3,84 $ | Text, Bilder, Audio, Video, PDFs |
Gemini- und Flash-Lite-Werte geprüft am 12. November 2026. Konkurrenzpreise von der jeweiligen Anbieterseite, zuletzt geprüft am 11. Oktober 2026. Bei Flash-Lite werden etwa 20 Output-Token pro Antwort und keine Thinking-Token angenommen.
Bei reinen Text-Tickets kosten Jev, Microsofts Modell und Clef-flash alle weniger als die Hälfte. Der Unterschied liegt bei diesem Volumen allerdings im Centbereich, er zählt also erst bei sehr hohem Durchsatz. Geminis Preis ist dann sinnvoll, wenn deine Inputs nicht nur Text sind: Kein anderes hier gelistetes gehostetes Decision-Modell nimmt Audio und PDFs nativ an, und ein separater Speech-to-Text- oder OCR-Dienst davor würde mehr kosten als die Entscheidung selbst.
Der Vergleich mit Flash-Lite ist der, dem die meisten Gemini-Nutzer tatsächlich begegnen. Google sagt, Decision 1 sei in seiner Benchmark-Suite „fast 5-mal günstiger" als Flash-Lite, und mein Beispiel kommt auf etwa das 4,9-Fache. Ein Hacker-News-Kommentator hat den Preis-Trade-off beim Launch fair zusammengefasst:
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."

Wenn du den Rest von Googles Modell-Reihe abwägst, behandeln meine Aufschlüsselungen zu Gemini 4 Carbon Preisen und Gemini 3.8 Flash Preisen die generative Seite.
Rechne deine eigene Monatsrechnung aus
Trag deine eigenen Volumen ein. Der Rechner summiert Text, Fotos, Anrufe und PDFs zum kostenpflichtigen Satz von Google und prüft das Ergebnis gegen die Rate-Limit-Stufen.
Welche Kosten stehen nicht auf der Preistabelle?
Der Preis pro Token ist der einfache Teil. Das hier ist, was tatsächlich verändert, was du zahlst, oder ob eine Anfrage überhaupt durchgeht:
- Niemals Caching. Langer geteilter Kontext, etwa ein Richtliniendokument oder ein Produktkatalog, der mit jedem Ticket mitgeschickt wird, wird bei jeder Anfrage voll abgerechnet. Bei generativen Gemini-Modellen würdest du gecachten Input zu einem Bruchteil des Preises bekommen. Hier hältst du geteilten Kontext besser kurz oder verlagerst ihn in Code.
- Keine Batch API oder Flex-Stufe. Nächtliche Backfills kosten genauso viel wie Live-Traffic. Bei Modellen, die Batch unterstützen, zeigt Googles Preisseite einen Rabatt von 50 %.
- Vorausbezahltes Guthaben verfällt. Unter Googles Prepay-Plan verfällt ungenutztes Guthaben „nach 12 Monaten" und wird nicht erstattet. Wenn dein Guthaben 0 $ erreicht, stoppen alle API-Keys dieses Billing-Kontos sofort mit einem HTTP 402. Schalte Auto-Reload ein, sonst hört deine Triage stillschweigend auf zu routen.
- Überschreitungen durch Billing-Verzögerung. Google warnt, dass Billing-Daten etwa 10 Minuten verzögert sein können, du kannst also über ein Projekt-Ausgabenlimit hinausschießen, bevor es greift. Bei Decision 1s Preisen ist das meist unbedeutend, aber es zählt, wenn ein Bug Anfragen in einer Schleife wiederholt.
- Safety-Blocks liefern Fehler, keine Antworten. Inputs, die Googles Safety-Filter auslösen, kommen als HTTP 400 zurück. Du brauchst einen Fallback-Pfad, meist das Weiterleiten des Tickets an einen Menschen über deine normalen Eskalations-Regeln.
Dann gibt es noch die Engineering-Kosten, und die sind der große Posten. Die API liefert dir Wahrscheinlichkeiten. Die Schwellenwerte, die Routing-Logik, das Test-Setup und den Code, der Labels zurück in dein Helpdesk schreibt, schreibst du immer noch selbst. Der Hacker-News-Thread fasste die Use Cases als „Routing, Klassifizierung, Ersatz für LLM-as-Judge" zusammen, was zutrifft, und jedes davon ist ein Projekt, kein Schalter.
Was bedeutet das für das Budget eines Support-Teams?
Für Ticket-Routing sind die Modellkosten praktisch auf null gefallen. Das verändert, wohin das Geld im KI-Support fließt, nicht ob überhaupt welches fließt.
Hier ein Realitätscheck im großen Maßstab. smava, ein deutsches Kreditvergleichsportal, schickt über zwei Marken etwa 27.000 Zendesk-Tickets pro Monat durch eesel. In einem Monat kategorisierte eesel 14.600 davon, schrieb Sprache, Antwortberechtigung und Kategorie in Zendesk-Felder und bereitete 15.300 Antwortentwürfe aus 820 synchronisierten Makros und Artikeln vor. Würde man nur den Kategorisierungsschritt auf Decision 1 bei meiner Schätzung von 780 Token bepreisen, kämen alle 27.000 Tickets auf etwa 2,11 $ im Monat.
Die anderen Zahlen in dieser Geschichte sind da, wo die eigentliche Arbeit liegt. 15.300 Antworten auf Deutsch zu entwerfen, die genau das sagen, was ein freigegebenes Makro sagt, in einer regulierten Finanzbranche, ist kein Job für ein Decision-Modell. Genauso wenig wie die Inhalte zweier Marken getrennt zu halten. Deshalb würde ich die Gemini Decisions API als günstigen Weg einordnen, deine Triage-Schicht smarter zu machen, nicht als Ersatz für den Teil, der Kunden antwortet. Für das Gesamtbild, wie KI-Support-Ausgaben aussehen, deckt meine Analyse zu KI-Kundenservice-Kosten das ab, und Zendesk-KI-Preise zeigt, was ein Helpdesk-Anbieter für dieselben Aufgaben verlangt.
eesels KI-Support-Teammitglied übernimmt beide Hälften direkt in deiner bestehenden Warteschlange: Es labelt und routet Tickets in Zendesk, Freshdesk oder HubSpot und entwirft oder sendet dann die Antwort aus deinen eigenen Hilfe-Inhalten.
SamCart betreibt einen Agenten für Freshdesk-Tickets und einen weiteren für den Website-Chat, der aus 280 Hilfe-Center-Artikeln antwortet. Jeder Rollout wird zuerst gegen historische Tickets simuliert, denn ein billiges falsches Label ist immer noch falsch.
Lohnt sich die Gemini Decisions API?
Ja, wenn du Engineers hast und deine Inputs über reinen Text hinausgehen. Bei 0,10 $ pro Million Token mit kostenlosem Output ist die Modellrechnung für Triage, Richtlinienprüfungen oder Antwort-QA fast bei null, und die Audio- und PDF-Unterstützung erspart dir einen separaten Transkriptions- oder OCR-Schritt.
Zahl dafür, wenn du Anrufe, Fotos oder Dokumente bewertest, mehr als 32.000 Token Kontext brauchst oder viele Prüfungen am selben Input durchführst. Schau dich anderswo um, wenn deine Tickets reiner Text sind und das Volumen riesig ist (Jev-Alternativen und Clef-flash sind pro Token günstiger), du auf Caching- oder Batch-Rabatte setzt oder du es heute schon auf Vertex AI brauchst. Wenn nichts aus Googles Modell-Reihe passt, deckt mein Überblick zu Gemini-Alternativen andere Anbieter ab.
Und wenn du Triage plus Antwort willst, ohne die Verkabelung selbst zu bauen, vergleiche die Tools in meinem Überblick beste KI für Ticket-Triage, oder lies, wie du Tickets mit Intent Detection routest.
Probiere eesel, wenn das Label nicht der schwere Teil ist
Gemini kann dir für einen Bruchteil eines Cents sagen, dass ein Ticket ein Billing-Problem ist. eesel übernimmt ab da in Zendesk, Freshdesk oder HubSpot: Es setzt die Felder, routet das Ticket und entwirft die Antwort, die dein Team geschrieben hätte, getestet an deinen vergangenen Tickets, bevor es live geht. smava nutzt es, um 27.000 deutsche Tickets im Monat zu sortieren und zu entwerfen. Sieh dir die eesel-Preise an, oder probiere eesel kostenlos.
Häufig gestellte Fragen
Wie viel kostet die Gemini Decisions API?
Die Preise der Gemini Decisions API liegen auf der kostenpflichtigen Stufe bei 0,10 $ pro Million Input-Token, und Output kostet immer 0 $, weil das Modell keine Output-Token erzeugt. Die Free-Stufe ist für Prototyping kostenlos. Das ist derselbe Satz wie bei der OpenAI Decisions API, und etwa das 2,4-Fache von dem, was TypeSafe Jev pro Token verlangt.
Ist die Gemini Decisions API kostenlos?
Ja, auf der Free-Stufe. Google gibt den Input-Preis als kostenlos an, mit Limits von 200 Anfragen pro Minute, 50.000 Token pro Minute und 10.000 Anfragen pro Tag. Der Haken ist, dass Daten der Free-Stufe zur Verbesserung von Googles Produkten genutzt werden können, schick also keine Kunden-Tickets hindurch. Mein größerer Leitfaden zu Gemini-Preisen deckt die anderen Modelle ab.
Wie viel kostet ein einzelner Gemini-Decisions-API-Call?
Ein typisches Support-Ticket mit 600 Token und drei kurzen Fragen kommt auf etwa 780 Input-Token, also rund 0,00008 $. Sogar eine voll ausgereizte Anfrage, die das gesamte 262.144-Token-Fenster ausfüllt, kostet etwa 0,026 $. Für ein vollständiges Setup zur Ticket-Triage ist die Modellrechnung selten die Zahl, auf die es ankommt.
Wie werden Bilder, Audio und Video in der Gemini Decisions API abgerechnet?
Sie werden als Input-Token zum gleichen Satz von 0,10 $ pro Million abgerechnet. Googles Tabelle zur Medienauflösung setzt ein Bild auf etwa 1.120 Token bei hoher und 280 bei niedriger Auflösung, Audio auf 25 Token pro Sekunde und Video auf 70 Token pro Frame bei niedriger Auflösung. Ein 10-minütiger Anruf kommt auf etwa 15.000 Token, also 0,0015 $. Das ist ein großer Grund, warum sie sich für multimodale KI-Aufgaben eignet.
Unterstützt die Gemini Decisions API Batch oder Context Caching?
Nein. Gemini Decision 1 unterstützt weder die Batch API noch Context Caching, und es gibt keine Flex- oder Priority-Stufe, jedes Token wird also jedes Mal zum Standardsatz abgerechnet. Bei Gemini 3.5 Flash-Lite Preisen kannst du zumindest Input für 0,03 $ pro Million cachen.
Was sind die Rate-Limits der Gemini Decisions API?
Free-Stufe: 200 pro Minute, 50.000 Token pro Minute, 10.000 pro Tag. Tier 1: 1.500 pro Minute, 1 Mio. Token pro Minute, 50.000 pro Tag. Tier 2: 5.000 pro Minute und 4 Mio. Token, kein Tageslimit. Tier 3: 15.000 pro Minute und 10 Mio. Token. Höhere Stufen schalten sich nach 100 $ beziehungsweise 1.000 $ an kumulierten Ausgaben frei.
Ist die Gemini Decisions API günstiger als Gemini Flash-Lite für Klassifizierung?
Ja, und zwar deutlich. Flash-Lite verlangt 0,30 $ Input und 2,50 $ Output pro Million Token, und strukturierter Output bedeutet, dass du für jedes geschriebene Label zahlst. In meinem Beispiel mit 10.000 Tickets kostet Decision 1 etwa 0,78 $ im Monat gegenüber etwa 3,84 $ bei Flash-Lite. Googles eigene Angabe ist fast 5-mal günstiger. Mein Leitfaden zur KI-Ticket-Klassifizierung zeigt, wie die Labels genutzt werden.
Kann ich die Gemini Decisions API über OpenRouter oder Vertex AI kaufen?
OpenRouter listet google/gemini-decision-1 zum gleichen Satz von 0,10 $ Input und kostenlosem Output, mit Google AI Studio als einzigem Anbieter. Vertex AI ist noch nicht verfügbar; Google sagt, Unterstützung für Gemini in Google Cloud komme bald. Wenn du eine Cloud brauchst, die du schon bezahlst, vergleiche die Microsoft-Decision-1-Preise auf Azure.