

Muse Code kostet nichts. Meta berechnet Ihnen das Modell darunter: 1,25 $ pro Million Input-Tokens, 0,15 $ im Cache und 4,25 $ für Output bei muse-spark-1.2, oder 0,10 $ / 0,002 $ / 0,20 $ im Contributor-Tier, wenn Sie Meta mit Ihrem Code trainieren lassen. Es gibt keinen Preis pro Sitzplatz, kein Abonnement, keine Gratisstufe und kein Testguthaben auf irgendeiner der Preis-, Produkt- oder Abrechnungsseiten von Meta. Ich habe alle drei geprüft.
Das klingt günstig, und pro Token ist es das auch. Der Haken ist, dass Muse Code entscheidet, wie viele Tokens ausgegeben werden, und nichts hält es davon ab. Von Haus aus läuft es mit dem teuren Modell, auf der zweithöchsten von sieben Reasoning-Stufen, mit drei Hintergrund-Beobachter-Agenten, die jeweils eigene Modellaufrufe machen, und einem Subagent-Fan-out, der mit Ihrer CPU-Kernzahl skaliert. Meta bietet keinerlei Ausgabenlimit. Das Einzige, was in der Abrechnungsdokumentation als Limit bezeichnet wird, ist eine "Zahlungsschwelle", und die steigt, je mehr Sie zahlen.
Wenn Ihr Grund, sich die Token-Preise anzusehen, der ist, dass Sie eine planbare Support-Rechnung wollen, ist das ein anderes Problem mit einer anderen Antwort. eesel berechnet 1 Credit pro Ticket oder Chat, egal wie lange, zu einem festen Monatspreis ab 299 $/Monat für 500 Credits, statt pro Million Tokens abzurechnen, was bedeutet, dass die Rechnung der erledigten Arbeit folgt statt der Zeit, die ein Modell gerade zum Nachdenken brauchte. Diese Einheit ist der ganze Punkt.
Was Muse Code Ihnen eigentlich in Rechnung stellt
Muse Code ist Meta AIs KI-Coding-Tool fürs Terminal, das am 5. August 2026 in der Beta zusammen mit dem Modell Muse Spark 1.2 veröffentlicht wurde. Installiert wird es mit einer Zeile, curl -fsSL https://dev.meta.ai/install.sh | bash, und gestartet, indem Sie muse in einem Projektverzeichnis eingeben.
Hier ist, was die Leute auf der Muse Code Produktseite ins Stolpern bringt: Der Abschnitt mit der Überschrift "Models and pricing" enthält keinen Preis für Muse Code. Er enthält eine fünfspaltige Token-Tabelle für Muse Spark. Ich habe den gesamten gerenderten Text dieser Seite nach den Wörtern free, trial, credit, subscription, seat, plan, spend, limit und cap durchsucht. Null Treffer bei allen neun. Die gesamte kommerzielle Geschichte von Metas Coding-Agent ist eine Token-Tabelle.
Die echte Preistabelle ist also die der Model API. Jedes Modell, das Meta verkauft, wie auf pricing and rate limits veröffentlicht:
| Modell | Tier | Kontextfenster | Input / Mtok | Cached Input / Mtok | Output / Mtok | Anfragen pro Minute | Tokens pro Minute |
|---|---|---|---|---|---|---|---|
muse-spark-1.2 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
muse-spark-1.2-contributor | Contributor | 1.048.576 | 0,10 $ | 0,002 $ | 0,20 $ | 100 | 3M |
muse-spark-1.1 | Standard | 1.048.576 | 1,25 $ | 0,15 $ | 4,25 $ | 3.000 | 4M |
Drei Modelle, zwei Preise, und keine günstige Legacy-Hintertür: 1.1 kostet exakt so viel wie 1.2. Ratenlimits gelten pro Team statt pro Schlüssel, zusätzliche Schlüssel bringen also nichts. Hintergrund-Einsendungen tragen zusätzlich eine dritte Obergrenze von 600 pro Minute. Wenn Sie die modellseitige Lesart dieser Zahlen wollen, einschließlich dem, was sich zwischen 1.1 und 1.2 geändert hat, ist das, was der Leitfaden zu Muse Spark 1.2 Preise abdeckt.
Dann die Extras, oder eher der Mangel daran. Es gibt einen echten Zusatz-Zähler, Web-Suche-Grounding zu 2,50 $ pro 1.000 Anfragen, der zusätzlich zu den Tokens berechnet wird und flach bleibt, unabhängig davon, wie viel Kontext jede Suche zieht. Darüber hinaus hat Meta weniger Preis-Mechanik als die meisten Anbieter, und meist zu Ihren Gunsten:
- Kein Long-Context-Aufschlag. Meta sagt es unverblümt: "There is no long-context premium: you pay the same rate whether your context window is mostly empty or almost full." Mehrere Konkurrenten erhöhen den Preis ab einer Kontextschwelle. Meta tut das nicht.
- Keine Cache-Write-Gebühr. Caching ist automatisch, zwischengespeicherte Tokens sind eine Untermenge der Input-Tokens statt einer eigenen Zeile, und der optionale
"24h"-Retention-Hinweis kostet nichts extra. - Metas eigenes Scaffolding ist kostenlos. Aus der Dokumentation: "Meta injects a small amount of steering context into every prompt (a system prompt and related scaffolding); those injected tokens are not billed."
- Keine Batch-API und kein Batch-Rabatt.
background: true-Antworten existieren, werden aber nicht rabattiert. - Kein Fine-Tuning, zu keinem Preis. Es gibt überhaupt kein Fine-Tuning-Produkt in der Dokumentation.
- Kein Volumen- oder Commitment-Rabatt. Die Formulierung der Preisseite lautet "no minimums or upfront commitment", was in beide Richtungen wirkt.
Das ist eine ungewöhnlich saubere Preistabelle. Alles, was an Muse Code teuer ist, passiert woanders.
Die drei Standardwerte, die Ihre Rechnung bestimmen
Jeder nach Verbrauch abgerechnete Agent hat drei oder vier Einstellungen, die die Höhe der Rechnung bestimmen. Was Muse Code erwähnenswert macht, ist, dass alle drei seiner Kosten-Regler von Haus aus auf der teuren Position stehen, und keiner davon steht auf der Preisseite.
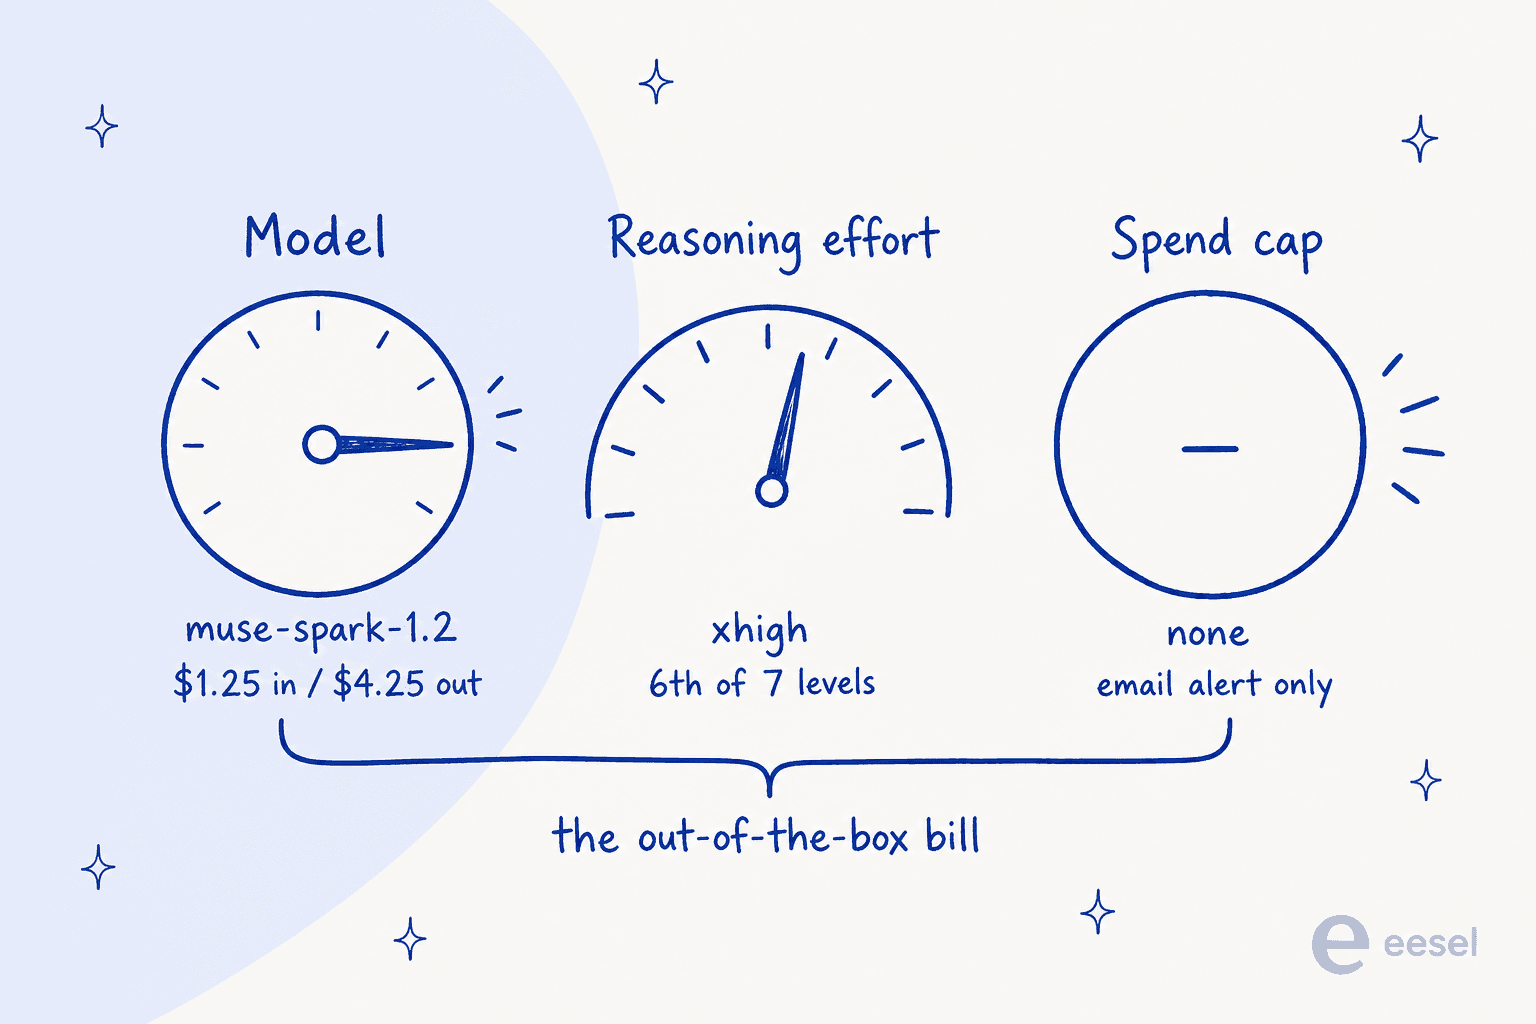
Regler eins ist das Modell. Metas Konfigurationsdokumentation sagt es unmissverständlich: "The default model is muse-spark-1.2." Das ist das 1,25-$-und-4,25-$-Tier, nicht das Zehn-Cent-Tier.
Hier wird es unklar, und ich will präzise sein, weil die Lücke zwischen den beiden Antworten 12,5x beim Input beträgt. Der Launch-Blog sagt das Gegenteil: Muse Code "starts on a contributor tier", und er nennt den Umschaltbefehl, /model to muse-spark-1.2-contributor. Die Konfigurationsseite erwähnt das Contributor-Tier überhaupt nicht. Das Wort kommt dort null Mal vor, und das einzige --model-Beispiel, das Meta abdruckt, ist das redundante muse --model muse-spark-1.2. Metas eigene zwei Seiten widersprechen sich darüber, welchen Preis Sie zahlen. Der Blog nennt den Befehl außerdem /model, wo die Dokumentation ihn /models nennt. Bis Meta das bereinigt, führen Sie /models in Ihrer ersten Session aus und lesen Sie, was dort steht, statt einer der beiden Seiten zu vertrauen.
Regler zwei ist der Reasoning-Aufwand. Muse Spark ist ein Reasoning-Modell, und Meta ist offen darüber, was das für die Rechnung bedeutet: "It thinks before it answers; those tokens are billed as output." Output ist der 4,25-$-Zähler. Die dokumentierten Aufwandsstufen sind none, minimal, low, medium, high, xhigh und ultra, und der Standard ist xhigh, die sechste von sieben. none wird in Muse Code überhaupt nicht unterstützt.
ultra verdient einen Warnhinweis, und zu Metas Ehre hat es einen. Es ist keine Einstellung für tieferes Nachdenken; der Client klemmt die Modellanfrage trotzdem auf xhigh. Was ultra tatsächlich tut, in Metas eigenen Worten, ist, zu ändern, "how aggressively Muse Code delegates to multi-agent workflows on the client, which can raise token usage". Wer darauf zugreift und bessere Antworten erwartet, bekommt statt dessen eine höhere Rechnung.
Regler drei ist das Ausgabenlimit, und das gibt es nicht. Mehr dazu weiter unten, denn das ist der Teil, der entscheidet, ob irgendetwas davon sicher auf eine Firmenkarte gehört.
Ihre Konversation ist das, was Sie kaufen
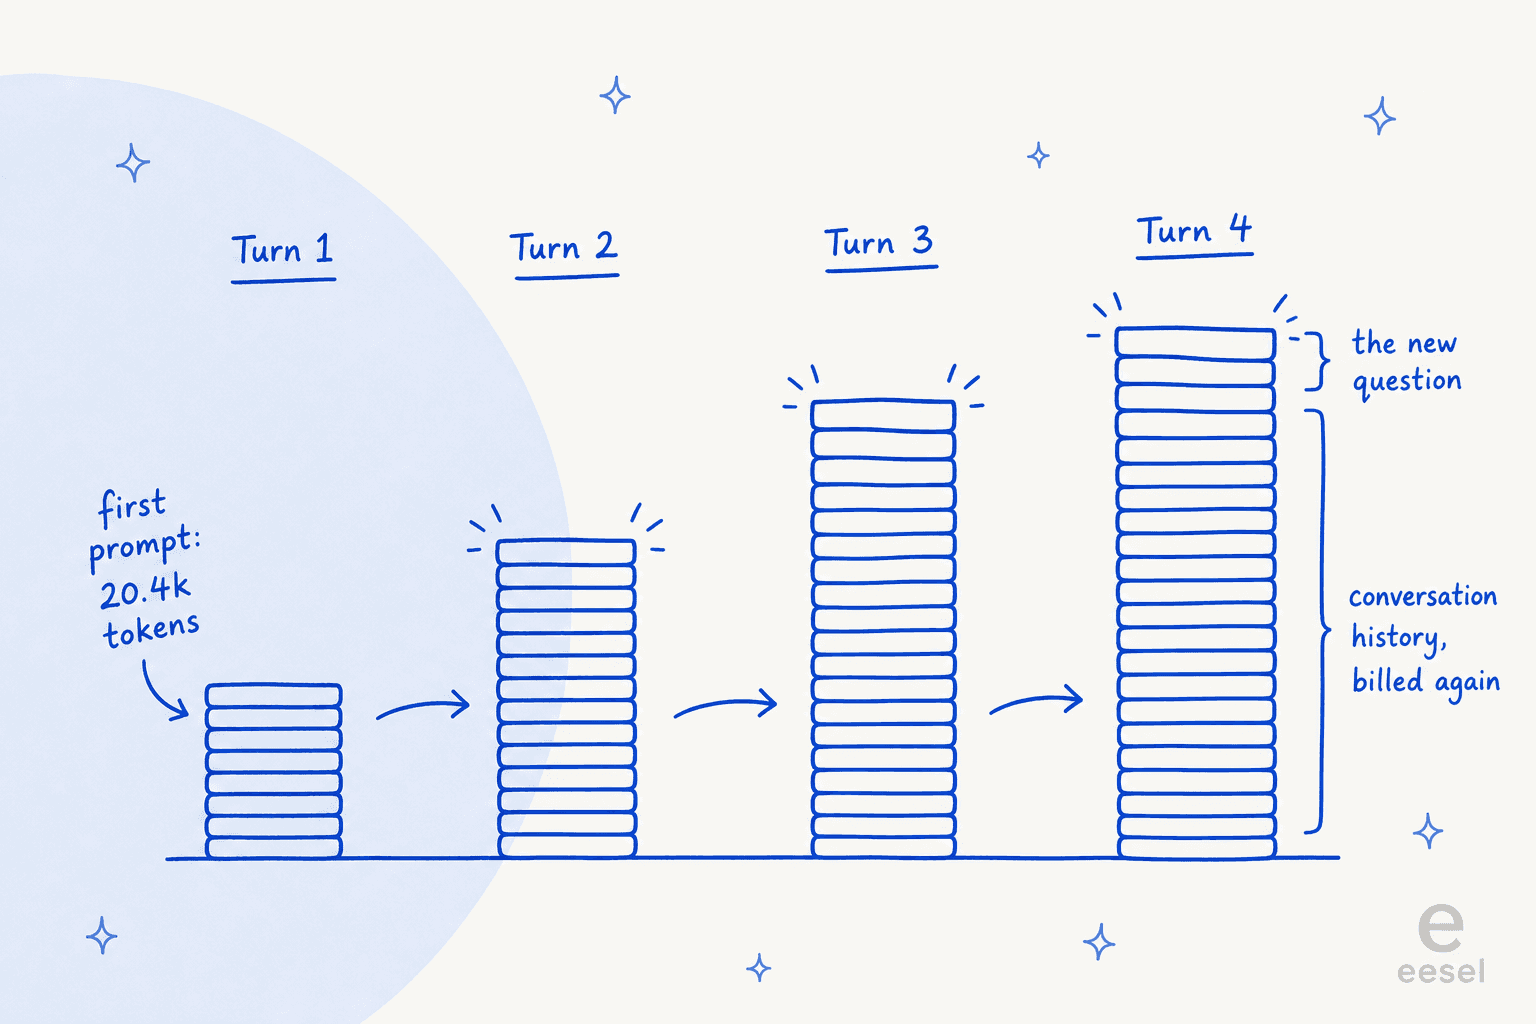
Der nützlichste einzelne Satz in Metas Abrechnungsdokumentation ist eine Definition, über die die meisten Leute hinweglesen. Die Gebühren basieren auf dem Token-Verbrauch, und jede Anfrage verbraucht "Input tokens: your prompt, system instructions, and conversation history."
Konversationsverlauf. In einem Chat-Fenster ist das eine Fußnote. In einem Agenten, der Dateien liest, Tests ausführt, die Ausgabe liest und es erneut versucht, ist es das gesamte Kostenmodell. Runde zwölf wird für die Runden eins bis elf berechnet.
Zwei Dinge mildern das, und eines verschärft es.
Mildernd: Prompt-Caching ist automatisch, und das wiederholte Präfix wird mit 0,15 $ statt 1,25 $ berechnet, ein Rabatt von 88 % auf den Teil Ihres Kontexts, der sich nicht geändert hat. Meta hält außerdem den Erinnerungsabruf von Haus aus günstig. Am Sessionstart fügt der Agent einen Index Ihrer Memory-Dateien ein, "their paths, not their contents, up to 48 files", und liest einzelne Dateien nur, wenn er sie will. Das ist eine echte Kostenkontrolle, und es ist schön, mal eine zu sehen.
Verschärfend: Code tokenisiert schlechter als Prosa, was Meta auch offen sagt. "A token is roughly 3 to 4 characters of English text. Non-English text and code often use more tokens per word, so equivalent requests can cost more." Ein Coding-Agent ist der schlimmste Fall für einen Pro-Token-Zähler, und es ist genau das Produkt, das Meta verkauft.
Den Boden von alldem sehen Sie an einer einzigen Messung. Ein Entwickler tippte am Launch-Tag ein einziges Wort in Muse Code und beobachtete den Zähler:
"Meta AI released muse code today. so i tested out. just said
hias the first prompt, and it consumed 20.4k tokens (and $0.02)."

Zwei Cent sind nichts. 20.400 Tokens für zwei Zeichen ist die Zahl, die man sich merken sollte, denn das ist die Größe der Basis, von der aus sich Ihre Session aufzuaddieren beginnt, bevor Sie überhaupt etwas verlangt haben.
Multi-Agent als Standard ist eine Abrechnungsentscheidung
Meta vermarktet das Kernfeature von Muse Code als "Multi-agent by default". Auf der Produktseite liest sich das wie eine Fähigkeit. Am Zähler ist es ein Multiplikator, und die Dokumentation ist präzise genug, um die Rechnung zu machen.
Beginnen wir mit dem Fan-out. Aus Metas Extending-Dokumentation: "The runtime runs several children at once. The default cap scales with the machine: roughly core count minus two, clamped between 2 and 16." Die Kernzahl Ihres Laptops ist ein Preisfaktor. Auf einer 16-Kern-Maschine sind das bis zu 14 schreibfähige Kind-Prozesse, die als separate abgerechnete Streams laufen, jeder mit eigenem Kontext, jeder mit einer eigenen Kopie der Aufgabe. Kinder laufen nur eine Ebene tief, es kann also zumindest nicht rekursieren.
Sie entscheiden sich nicht aktiv dafür. Der Launch-Blog ist eindeutig: Aufgaben werden "fanned out automatically... Your working copy is never touched and you don't set any of this up - Muse Code does it all automatically." Das ist eine echte technische Leistung, und mir gefällt das Design. Es ist aber auch das, was Ihre Token-Ausgaben vervielfacht, während Sie auf einen einzigen Fortschrittsbalken schauen.
Dann die Beobachter, die ich nirgendwo sonst behandelt gesehen habe und die mich am meisten überrascht haben. Muse Code betreibt ein Team von Hintergrund-Agenten, die Memory-Abruf, Skill-Abruf, Zielverfolgung und Verifikation beobachten. Metas eigener Satz: "Three of the four observers run by default, and each makes its own model calls, so they add token usage in addition to the main session." Drei zusätzliche abgerechnete Konversationen, in die Sie nie etwas eingetippt haben, standardmäßig an, abschaltbar in settings.json unter runtime_capabilities.
Und es gibt einen Fußangel bei der Unterbrechung. Das Drücken von Esc "stops the turn only. It does not stop background terminals or subagents." Der universelle Panikreflex, wenn ein Agent entgleist, stoppt den Zähler bei den parallelen Streams nicht. Das ist gut zu wissen, bevor Sie es brauchen, und es ist eine schärfere Version desselben Problems, das Subagent-Orchestrierung in jedem Harness schwer budgetierbar macht, dieses eingeschlossen. Wenn Sie den Vergleich wollen: Claude Code Subagents und Multi-Agent-Systeme gehen denselben Trade-off von der anderen Seite durch.
Rechnen Sie Ihre eigene Zahl aus
Meta veröffentlicht keinen Kostenrechner, und jedes durchgerechnete Beispiel, das ich schreiben könnte, wäre für Ihr Repository falsch. Hier ist also die Rechnung in einer Box, in die Sie Ihre eigenen Zahlen eintragen können. Sie nutzt die veröffentlichte Preistabelle und modelliert das eine, was die Rechnung tatsächlich treibt: dass Ihre Konversation bei jeder Runde zum Cache-Satz erneut abgerechnet wird, einmal pro parallelem Stream.
Der Prozentsatz in diesem Hinweis ist der Punkt der ganzen Übung. Bei jeder Session, die lang genug ist, um nützlich zu sein, zahlen Sie das meiste an Meta für das erneute Lesen einer Konversation, die Sie bereits bezahlt haben. Sessions zu verkürzen ist ein größerer Hebel als ein Modellwechsel, was nicht der Punkt ist, an dem die meisten Leute zuerst nachsehen. Das ist derselbe Grund, warum Kontextfenstergröße zu einer Budgetfrage statt einer Fähigkeitsfrage wird, sobald ein Agent echte Arbeit macht.
Wie das im Vergleich zum Kauf eines Plans aussieht
Der Grund, warum ein nach Verbrauch abgerechneter Agent sich seltsam anfühlt, ist, dass fast nichts anderes in dieser Kategorie so verkauft wird. Ich habe jedes ernstzunehmende agentische Coding-CLI gegen Metas verglichen, und das Muster ist konsistent genug, um die Erkenntnis zu sein: fünf der sechs bieten einen Pauschalplan und geben Ihnen auch auf dem Verbrauchsweg ein hartes Ausgabenlimit. Muse Code hat keins von beidem.
| Tool | Pauschalplan | Verbrauchssatz | Hartes Ausgabenlimit | Gratisstufe |
|---|---|---|---|---|
| Muse Code | Keiner, zu keinem Preis | 1,25 $ / 0,15 $ / 4,25 $, oder 0,10 $ / 0,002 $ / 0,20 $ Contributor | Nein. Nur E-Mail-Benachrichtigung | Nein |
| Claude Code | Pro 20 $, Max 5x 100 $, Max 20x 200 $ | Opus 5 5 $ / 25 $; Sonnet 5 2 $ / 10 $ | Ja, einstellbares Monatslimit, plus Workspace-Limits bei API-Organisationen | Nicht im Gratisplan |
| Codex CLI | Go 8 $, Plus 20 $, Pro ab 100 $, Business 25 $/Nutzer | Sol 5 $ / 30 $, Terra 2 $ / 12 $, Luna 0,20 $ / 1,20 $ | Ja, ein von der Organisation genehmigtes Nutzungslimit, das hart fehlschlägt | Gratisstufe vorhanden, CLI ab Plus |
| Gemini CLI | In AI Pro- und Ultra-Pläne eingebunden | Gemini API Tiers, Tier 1 bei 250 $ gedeckelt | Ja, Billing-Tier-Obergrenzen und Spend-Limits pro 10 Minuten | Ja, 60 Anfragen/Min und 1.000 Anfragen/Tag |
| Cursor | Pro 20 $, Pro Plus 60 $, Ultra 200 $, Teams 40 $/Nutzer | Enthaltenes Nutzungskontingent, dann Pass-Through | Ja, und die KI-Funktionen stoppen, wenn Sie es erreichen | Ja, Hobby |
| Grok Build | SuperGrok 30 $, SuperGrok Plus 100 $ | grok-build-0.1 1,00 $ / 2,00 $, 0,20 $ zwischengespeichert | Ja, und es ist der Standardzustand | Ja |
| OpenCode | Freie Software, optionaler Go-Plan 10 $/Monat | Was immer Ihr eigener Schlüssel kostet | Vom Anbieter übernommen | Ja |
Lesen Sie die Spalte mit dem Ausgabenlimit von oben nach unten. Cursors Dokumentation ist am klarsten darüber, was ein Limit in der Praxis bedeutet: "When a limit is reached, AI features stop for that user until the next billing cycle." Grok Build kommt standardmäßig mit einem auf 0 $ eingestellten Abrechnungslimit, sodass Anfragen abgelehnt werden, sobald das vorausbezahlte Guthaben aufgebraucht ist. Selbst die abgerechneten API-Wege haben Obergrenzen, weil Anbieter vor Jahren gelernt haben, dass Entwickler keine Karte hinterlegen, ohne eine zu haben.
Es gibt eine zweite Sache, die diese Anbieter tun und Meta nicht, und sie ist die nützlichere. Sie veröffentlichen, was Sie erwarten sollten auszugeben. Anthropics eigene Dokumentation gibt für Claude Code "$13 per developer per active day and $150-250 per developer per month" an. Cursor veröffentlicht ebenfalls Bandbreiten, etwa 60 bis 100 $ im Monat für tägliche Agenten-Nutzer und über 200 $ für Power-User. Meta veröffentlicht eine Preistabelle und wünscht Ihnen viel Glück. Nirgendwo in seiner Dokumentation steht ein Satz, der Ihnen sagt, wie ein normaler Monat aussieht.
Beim Preis pro Token ist Muse Spark also konkurrenzfähig, und das Contributor-Tier ist aggressiv gegenüber allem außer den günstigsten chinesischen Labs. Bei der Preisvorhersagbarkeit ist Muse Code die einzige Option hier, die nicht beantworten kann, "was kann mich das diesen Monat maximal kosten". Wenn Sie schon ein Beschaffungsgespräch über Claude-Preise, Codex-Preise, Windsurf-Preise oder GitHub-Copilot-Preise durchgesessen haben, wissen Sie, was diese Sicherheit einem Finance-Team wert ist, und das ist meist mehr als die Token-Differenz.
Tokens direkt zu kaufen ist immer noch eine echte Strategie, nur eine andere. Es ist dieselbe Entscheidung wie der Griff zu der OpenAI API oder der Anthropic API statt zu einem fertigen Produkt: bessere Unit Economics, und Sie erben das Prognoseproblem. Der Vergleich der drei großen Modell-APIs deckt ab, wo jede neben Claude Opus 4.6 Preisen und GPT 5.3 Codex Preisen landet. Wenn Sie rein nach günstigen Tokens einkaufen, gehören Qwen-Preise, Kimi K2.5-Preise, Mistral-AI-Preise und DeepSeek V3.2 alle auf dieselbe Tabelle. Gewichte anderswo zu hosten ist der dritte Weg, wofür Together-AI-Preise und Groq-Preise existieren.
Ein Pluspunkt für Meta, da ich den Großteil dieses Beitrags auf die Lücke verwendet habe: die Preistabelle selbst ist ehrlich. Zwei Preise, beide abgedruckt, mit den Datenbedingungen in klarem Englisch unter jedem einzelnen. Kein Credit-System, das zwischen Ihnen und der Zahl steht, was mehr ist, als man von den KI-Credits- und Flex-Credits-Schemata sagen kann, die sich über den Rest der Branche ausgebreitet haben. Das Problem ist nicht, dass Meta den Preis versteckt hat. Es ist, dass Meta die Tokens bepreist und das Volumen komplett dem Agenten überlassen hat.
Eine Beobachtung aus der Community ist es wert, hier wiederholt zu werden, weil sie den Maßstab setzt, an dem Meta tatsächlich gemessen wird, und das ist nicht Anthropic:
"This is a nice release and a solid improvement over Spark 1.1. It compares favorably with Grok 4.5. Not SOTA, but solid releases. I think they need to really get this more competitive with Deepseek V4 Flash / Luna pricing to move the needle."

Das, was Muse Code Ihnen nicht verkauft: eine Obergrenze
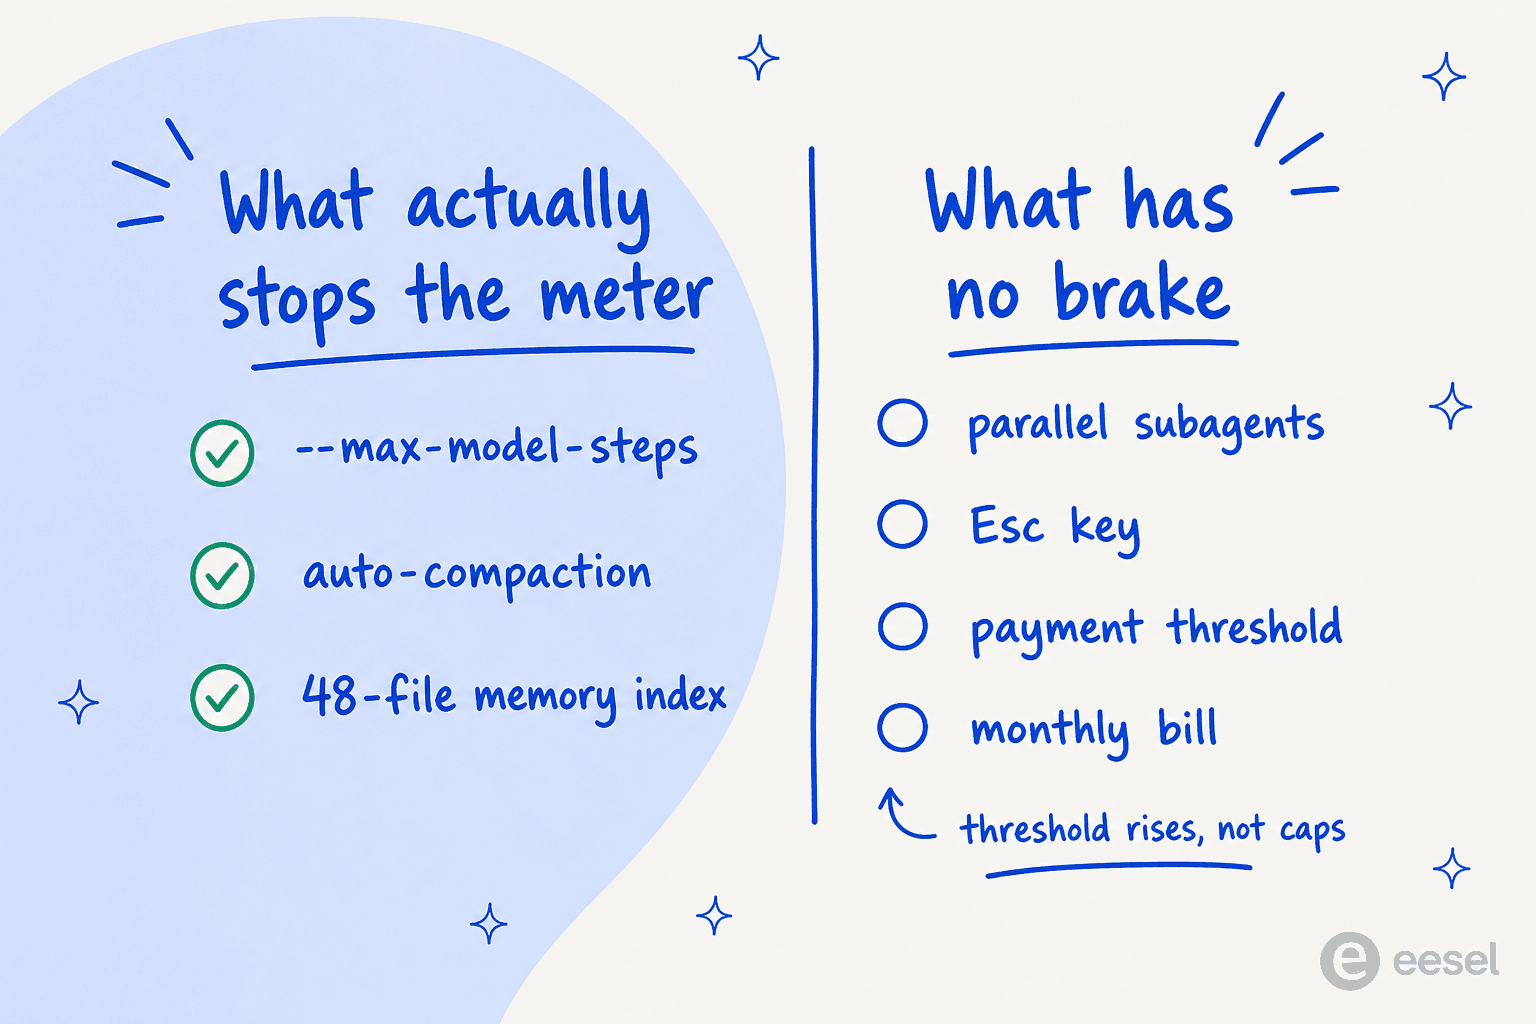
Ich habe jede Abrechnungsseite gelesen, die Meta für dieses Produkt veröffentlicht, und es gibt kein Ausgabenlimit, kein Budgetlimit, keinen harten Stopp und keine Nutzungswarnung in keiner von ihnen. Was es gibt, ist eine Zahlungsschwelle, und die ist leicht als Obergrenze misszuverstehen, weil es eine Zahl ist, die an Ihr Konto geknüpft ist und ein Dollarzeichen trägt.
Metas Worte: "Whenever your current balance reaches your payment threshold amount, your payment method is charged for that amount. As you make successful payments, your payment threshold may be raised until your account reaches a final threshold amount."
Lesen Sie das genau. Es ist ein Auslöser dafür, Ihre Karte zu belasten, und er steigt, je mehr Sie beweisen, dass Sie zahlen können. Es ist ein Kreditlimit, das zugunsten des Anbieters funktioniert. Alles, was übrig bleibt, wird am Ersten des Monats trotzdem abgebucht. Das Wort "plans" taucht in der Überschrift der Abrechnungsseite und in der Nav-Beschreibung auf, und wird nie von einem tatsächlichen Plan gefolgt.
Entwickler haben es am ersten Tag bemerkt, und der Einwand ist nicht theoretisch:
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Ich möchte bei diesem Kommentar verweilen, weil ich ihn aus einem völlig anderen Markt wiedererkenne. Ich baue Integrationen bei eesel und sitze in genug Sales-Calls, um zu wissen, dass die Bitte um eine Obergrenze das Gewöhnlichste ist, das ein Käufer verlangen kann. Ein Team, mit dem ich zusammensaß, hier anonymisiert als budgetbewusste B2B-Hardware-Support-Gruppe mit rund 250 Tickets im Monat, hatte beobachtet, wie sich der Preis eines früheren Anbieters mehr als verdoppelte, und kam ganz gezielt mit der Bitte um vertragliche Preisbindungen, wobei eine jährliche Vorauszahlung als Weg vorgeschlagen wurde, eine zu bekommen. Niemand nennt das Paranoia. Es ist einfach, was passiert, nachdem man einmal überrascht wurde.
Und die Überraschung kommt meist, nachdem sich das Produkt schon bewährt hat, was der Teil ist, der schmerzt. Ein anderes Team, eine US-Modemarke auf Gorgias, fuhr zwölf Testchats gegen eesels Agent. Der Agent machte das gut. Dann öffneten sie die Abrechnungsseite und reichten sofort zwei Kündigungsanfragen ein, von denen eine schlicht lautete:
"PLEASE CANCEL MY subscription"
Das bezog sich auf eesels eigene Preisseite, nicht auf die eines Konkurrenten, und es hat mir etwas gelehrt, worauf ich seitdem alles ausrichte: nicht ob das Produkt funktioniert, entscheidet über den Kauf, sondern die Rechnung. Ein nach Verbrauch abgerechneter Agent ohne Obergrenze hebt sich dieses Gespräch bis zum Ende des Monats auf.
Das Nächste, was Meta Ihnen zu einer Bremse gibt, ist ein Schritt-Limit statt eines Dollar-Limits: --max-model-steps <n> bei Headless-Läufen, was Meta so beschreibt, dass es da ist, "so a stuck task can't loop indefinitely". Nützlich in CI. Es tut nichts für eine interaktive Session, wo das meiste Geld ausgegeben wird.
Wo das günstige Tier teuer wird
Das Contributor-Tier ist die interessanteste Preisentscheidung im gesamten Launch, und die meistdiskutierte. 0,10 $ für Input und 0,20 $ für Output sind 12,5x bzw. 21x günstiger als Standard, und die Kennzeichnung, die Meta auf der Produktseite darunterschreibt, ist ein einziger Satz: "Used to improve our products." Die Kennzeichnung des Standard-Tiers ist "Not used to improve our products." Ich habe selten erlebt, dass ein Anbieter den Handel so unverblümt ausspricht, und viele Entwickler respektierten das dafür:
"I actually really like that pricing strategy. It's very transparent"
"The fact that Facebook has so much experience taking advantage of people's private data is one of the reasons I believe them when they say they won't be doing it when you pay them for that service."
Der Widerspruch ging in zwei Richtungen. Manche argumentierten, der Rabatt unterbewerte die Daten, da die wahren Kosten der Wahl die 4,05 $ pro Million entgangene Output-Tokens seien. Andere wiesen darauf hin, dass man denselben Preis ohne den Datengriff bekommen kann:
"FYI: there are providers of deepseek that offer the same or lower pricing and zero retention policies."
Jenseits der Ethik gibt es vier konkrete Gründe, warum das günstige Tier Sie mehr kosten könnte, als das Preisschild suggeriert, und das sind die, die ich auf einem Whiteboard haben wollte, bevor ich ein Team dafür verpflichte.
Es ist bei den Anfragen 30x stärker ratenlimitiert. 100 Anfragen pro Minute gegenüber den 3.000 des Standard-Tiers, während die Tokens pro Minute nur um 25 % fallen, von 4M auf 3M. Meta hat den Anfragepfad gezielt gedrosselt. Ein Agent, der viele kleine Tool-Calls parallel abfeuert, was genau das ist, was Muse Codes Fan-out tut, stößt lange vor einer Token-Obergrenze an eine Anfrage-Obergrenze. Ein in der Warteschlange hängender Agent ist ein langsamer Agent, und langsame Agenten werden erneut ausgeführt.
Der Zugang kann ohne Vorwarnung entzogen werden. Ein Entwickler berichtete, ihn mitten im Projekt verloren zu haben:
"Pointing out for others: without warning I was restricted from using the contributor model because of "policy violations". I was working on Kaggle research and some Apple Security work at the time. They really need to make cyber a first priority product feature."
Die Bedingungen für die Gratis-Credits haben sich nachträglich geändert. Meta verteilte beim Launch von Muse Spark 1.1 Credits im Wert von 20 $, und die zugehörige Datennutzungsformulierung änderte sich später:
"If you got the $20 in free credits from Meta for signing up when muse-spark-1.1 was release, please note that there's now small print stating "While using free credits your content may be used for product improvement" which was not present at muse-spark-1.1 launch when the credits were given out."
Null-Datenspeicherung ist sales-gated und unbepreist. Aus dem Launch-Blog: "We're also beginning to accept requests for zero data retention. Contact Meta sales to request this." Beginnend, und auf Anfrage. Wenn ein Security-Review Sie blockieren wird, wird es genau hier passieren, und es gibt weder eine Self-Service-Einstellung noch einen veröffentlichten Preis für die Lösung.
Der letzte Punkt ist, wo Kosten und Datenschutz aufhören, getrennte Fragen zu sein. Ein Terminal-Agent liest Ihr Repository und schickt es als abrechenbaren Input an die API eines Anbieters, also ist jedes Token, das Ihre Maschine verlässt, gleichzeitig ein Rechnungsposten und eine Offenlegung. Ich höre dieselbe Frage ständig auf der Support-Seite dieses Geschäfts. Ein technischer Prüfer bei einem Halbleiter-Hardware-Unternehmen wollte erst weitermachen, nachdem er sich davon überzeugt hatte, dass die KI nur aus dem genehmigten Wissen seiner Organisation antwortet statt ein allgemeines Modell zu befragen, und fragte direkt, ob sich dieses Verhalten abschalten lässt. Er fragte nicht nach Preisen. Er stellte dieselbe Frage. Diese Überlappung ist genau, warum sich Claude Code Sicherheit stellenweise wie ein Kostendokument liest.
Was das Modell selbst zu diesem Preis wert ist, die fairste praxisnahe Einschätzung im Launch-Thread war auch die nützlichste:
"Muse code is rough around the edges. But combined with almost free model (muse spark contributor) it's actually pretty good. I think it's on the same level as grok build."
Was ich tatsächlich tun würde
Konkret, in der Reihenfolge, in der ich es tun würde, wenn ich Muse Code diese Woche auf ein echtes Projekt setzen würde.
- Führen Sie
/modelsin Ihrer ersten Session aus und bestätigen Sie, auf welchem Tier Sie sind. Metas Dokumentation und der Launch-Blog widersprechen sich, und der Unterschied beträgt 12,5x. Schließen Sie es nicht, lesen Sie es. - Senken Sie
--reasoning-effortaufmediumund schauen Sie, ob Sie es merken. Reasoning wird als Output zu 4,25 $ abgerechnet.xhighist der Standard, keine Empfehlung, und die meisten Aufgaben sind nicht schwer. Das ist derselbe Hebel, den Modellauswahl und das Herunterschalten auf eine günstige Modellstufe in anderen Harnesses geben. - Schalten Sie die Beobachter-Agenten ab, die Sie nicht nutzen. Drei laufen standardmäßig in
settings.jsonunterruntime_capabilities, jeder mit eigenen Modellaufrufen. Verifikation ist bereits aus; die anderen drei sind eine Wahl. - Beenden Sie Sessions, statt sie fortzusetzen. Das Transkript ist bei jeder Runde abrechenbarer Input, also ist ein frisches
/newfür eine neue Aufgabe die mit Abstand günstigste verfügbare Gewohnheit. Nutzen Sie/compact, wenn Sie weitermachen müssen. - Setzen Sie
--max-model-stepsbei jedem Headless-Lauf. Es ist kein Dollar-Limit, aber es ist der einzige dokumentierte Stopp, und CI ist, wo eine Schleife unbeobachtet um 3 Uhr nachts läuft. - Behalten Sie das Nutzungsdashboard wöchentlich im Blick, denn sonst sagt es Ihnen niemand. Es gibt kein Limit und keine Warnung außer E-Mail. Behandeln Sie die Gewohnheit der Nutzungsanalysen als Pflicht statt als Option, und wenn das in ein Team geht, lesen Sie vorher über Admin-Kontrollen.
Und der strukturelle Punkt, den ich lieber offen sage, statt ihn zu verstecken. Ein nach Verbrauch abgerechneter Agent ohne Obergrenze ist das Selbstbau-Ende des Marktes, und etwas selbst zu bauen hat Kosten, die auf keiner Preistabelle auftauchen. Ein eesel-Kunde, ein Engineering Lead bei einem Krypto-Hardware-Unternehmen, hat es besser formuliert, als ich es könnte:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Manche Teams sollten trotzdem rohe Tokens kaufen. Wenn Ihre Last spitzig ist, Ihre Entwickler stark sind und jemand die Rechnung besitzt, ist die Unit Economics besser, und Muse Code ist ein gut gebautes Harness, um sie darüber auszugeben. Die Entscheidung Bauen vs. Kaufen hängt davon ab, wer Zeit hat, nicht davon, wer die günstigere Preistabelle hat. Und wenn die Antwort "keins von beiden, ich will einen Plan" ist, ist die Zusammenstellung der besten KI-Coding-Assistenten der kürzere Weg zu einem.
Probieren Sie eesel für die Support-Seite dieses Problems
Wenn Sie hier gelandet sind, weil Sie versuchen vorherzusagen, was KI tatsächlich kostet, und die Arbeit, die Sie vorhersagen, Kundensupport statt Code ist, ist die Einheit das ganze Argument. Muse Code bepreist Maschinenaufwand, also bewegt sich seine Rechnung danach, wie lange ein Modell gelaufen ist. eesel bepreist ein gelöstes Ticket, also bewegt sich die Rechnung mit der erledigten Arbeit, einer Zahl, die Ihr Finance-Team schon jetzt verfolgt.
Das zählt am meisten an der Stelle, für die Muse Code keine Antwort hat: Sie können sehen, was Sie schulden werden. eesel simuliert einen neuen Agenten gegen Ihre eigenen historischen Tickets, bevor er eine Live-Warteschlange berührt, sodass Sie die Lösungsquote und die Kostenprognose aus Ihrer echten Ticket-Historie bekommen, statt beides erst in der Produktion herauszufinden. Ich habe viele dieser Integrationen ausgeliefert, und der Simulationsschritt ist der, den Kunden immer wieder erwähnen, weil er den Unterschied zwischen einer Prognose und einer Hoffnung ausmacht.

Einen Blick wert, wenn Sie eine verbrauchsbasierte Modellrechnung gegen eine pro Lösung abwägen: die Aufschlüsselung der Kosten pro Lösung, das Argument für ergebnisbasierte Preisgestaltung, und wie man die Sache in der Praxis baut mit einem KI-Helpdesk. Kostenlos zu testen, und Sie werden Ihre Zahl kennen, bevor Sie sich darauf festlegen.
Häufig gestellte Fragen
Wie viel kostet Meta Muse Code?
Ist die Nutzung von Muse Code kostenlos?
Kann ich bei Muse Code ein Ausgabenlimit festlegen?
--reasoning-effort, --max-model-steps bei Headless-Läufen, das Abschalten der Hintergrund-Beobachter-Agenten und ein Modellwechsel. Vergleichen Sie das mit den veröffentlichten Obergrenzen bei OpenAI-Ratenlimits oder den Credit-Obergrenzen in Systemen wie KI-Credits.Wie sehen die Muse Code Preise für ein kleines Team aus?
Was ist der Unterschied zwischen dem Contributor- und dem Standard-Tier von Muse Spark?
muse-spark-1.2 trägt die Kennzeichnung "Not used to improve our products", und die vollständige Aufschlüsselung finden Sie in unserem Leitfaden zu Muse Spark 1.2 Preise.Warum hat mein erster Muse Code Prompt Geld gekostet?
hi 20.400 Tokens und zwei Cent, und von da an sendet jede weitere Runde die Konversation erneut als abrechenbaren Input zum Cache-Satz. Das ist derselbe Zinseszinseffekt, der Kontextfenstergröße zu einer Kostenfrage statt einer Fähigkeitsfrage macht, und deshalb laufen Best Practices für diese Agenten fast alle darauf hinaus, Sessions kurz zu halten.