

Was Meta am 12. Oktober tatsächlich veröffentlicht hat
Meta hat zwei Modelle angekündigt, Muse Wonder und Muse Wonder Full, in einem Launch-Beitrag, der sie „our most capable models“ und „a major leap toward personal superintelligence“ nennt. Sie wurden im Gigawatt-Rechenzentrum Prometheus von Meta trainiert und stehen oberhalb der Muse Spark-Reihe, die das günstigere Arbeitstier bleibt.
Wo welches Modell zum Start verfügbar ist:
- Muse Wonder (
muse-wonder-1.0) gibt es in der Meta Model API, auf OpenRouter und in jedem Muse-Code-Plan. - Muse Wonder Full gibt es nur in den Muse-Code-Plänen Power (50 $/Monat) und Max (200 $/Monat). Metas Modell-Dokumentation stellt klar, dass das Setzen von Wonder auf den Reasoning-Aufwand
maxnicht Full auswählt. - Die Muse-App, Metas Consumer-Agent, bekommt Wonder „bald“, zuerst für Abonnenten. Heute läuft diese App noch auf Spark 1.3.
Das Modell ist in der API weiterhin als Preview gekennzeichnet. Es nimmt Text, Bilder, Video, Audio und PDFs als Input entgegen, gibt Text aus und hat ein Kontextfenster von 1.048.576 Tokens. Der Reasoning-Aufwand reicht von minimal bis max. Metas Seite zu Preisen und Ratenlimits nennt für muse-wonder-1.0 3.000 Anfragen pro Minute und 4 Mio. Tokens pro Minute, was für eine Preview großzügig ist.
Metas eigene Doku liefert die klarste Routing-Regel, die ich seit Langem gesehen habe: Wähle Wonder für langlaufende, komplexe Arbeit und Spark für Volumen, Latenz und Kosten. So würde ich auch den Rest dieses Beitrags lesen.
Die zwei Ideen, die Meta verkauft: Active Memory und Active Focus
Reduziert man den Launch-Text, stellt Meta zwei Produktversprechen auf, beide gedacht für Agenten, die Stunden statt Sekunden arbeiten.
Active Memory ist Metas Bezeichnung dafür, Kontext über dich über Unterhaltungen hinweg mitzunehmen und im richtigen Moment das passende Detail wieder hervorzuholen. Meta misst das mit MemoryBench, und das ist die eine Stelle, an der das API-Modell alles schlägt, Full eingeschlossen: 85,6 für Wonder gegenüber 85,5 für Full und 81,5 für Opus 5.5. Wenn du etwas baust, das sich Wochen lang an einen Nutzer erinnern muss, ist diese Zahl die interessanteste Zeile der Tabelle.
Active Focus ist das „Dranbleiben“-Versprechen: nach einem Hindernis einen anderen Ansatz probieren, um Klärung bitten und vor wichtigen Aktionen nachfragen. Meta misst das mit FocusBench und SWE-Marathon, einem Test für anhaltende Arbeit an langlaufenden Softwareprojekten. Die Launch-Demos stützen sich stark darauf: ein spielbares 3D-Küchenspiel aus Bildern, ein Laufplan für Samstag, erstellt durch Arbeit über Browser und Apps hinweg, individuelle Merchandise-Artikel, entworfen und bestellt anhand von Instagram-Fotos, ein Sitzplan für eine Hochzeit, gelöst gegen eine Liste von Nebenbedingungen.
Darunter steckt außerdem eine wirklich interessante Forschungsaussage. Meta hat Muse Spark 1.3 und Wonder Full auf trainierten gegenüber nicht trainierten Aufgaben aufgetragen, und Full schneidet bei den unbekannten besser ab, als Sparks Trendlinie vorhersagt. Metas Erklärung ist ein größeres Basismodell. Das ist das Argument vom „big model smell“, und für Allzweck-Agenten, die auf Aufgaben treffen, die niemand geplant hat, zählt es mehr als jeder einzelne Benchmark.
Muse-Wonder-Preise: dieselbe Preisliste wie Claude Opus 5.5
Hier die vollständige API-Preisliste für die Version, die du tatsächlich kaufen kannst, direkt von Metas Modellseite und aus den Preis-Dokumenten.
| Posten | Muse Wonder (muse-wonder-1.0) |
|---|---|
| Input | 4,00 $ pro 1 Mio. Tokens |
| Gecachter Input | 0,20 $ pro 1 Mio. Tokens |
| Output | 20,00 $ pro 1 Mio. Tokens |
| Kontextfenster | 1.048.576 Tokens, kein Aufschlag für langen Kontext |
| Contributor-Tarif (Training mit deinem Traffic) | Nicht verfügbar |
| Websuche-Tool | 2,50 $ pro 1.000 Anfragen |
| Ratenlimit | 3.000 RPM / 4 Mio. TPM |
| Status | Preview |
Stellen wir das nun neben die Modelle, mit denen die meisten es tatsächlich vergleichen werden.
| Modell | Input / 1 Mio. | Output / 1 Mio. | Quelle |
|---|---|---|---|
| Muse Spark 1.3 | 1,25 $ | 4,25 $ | Metas Preis-Doku |
| GPT-6.1 Sol | 2,00 $ | 10,00 $ | GPT-6.1 Sol Preise |
| Muse Wonder | 4,00 $ | 20,00 $ | Metas Modellseite |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | Anthropic-Preise |
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | Anthropic-Preise |
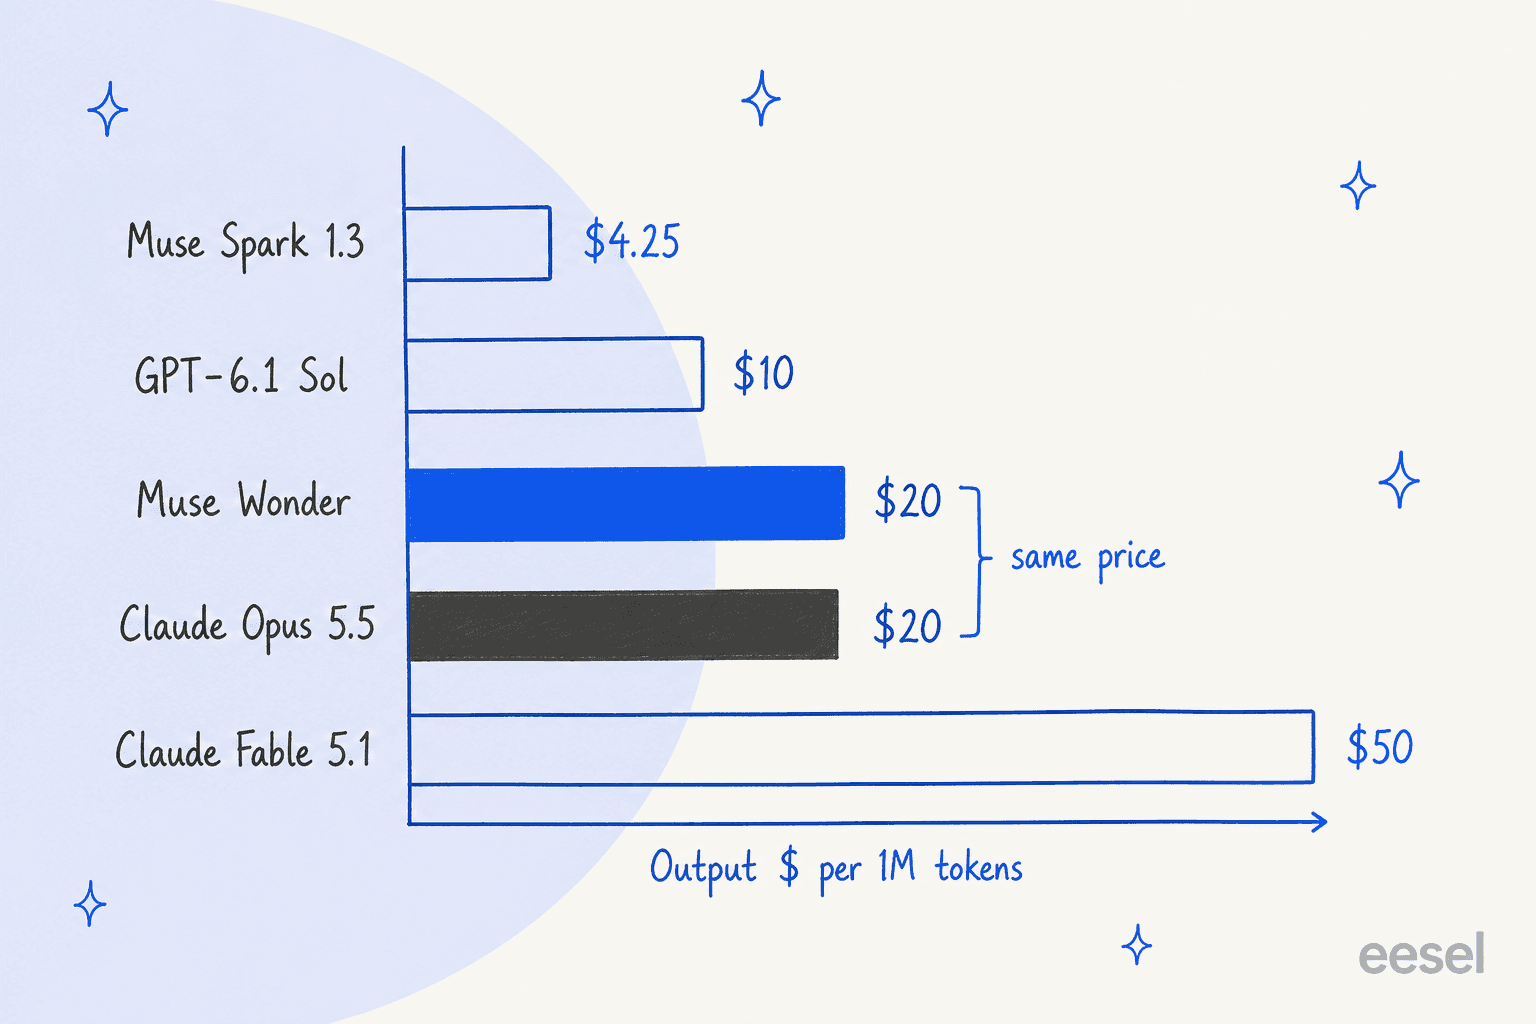
Auch der Preis für gecachten Input entspricht dem von Opus 5.5: bei beiden 0,20 $ pro Million. Das ist kein Zufall, gegen den ich wetten würde. Metas frühere Modelle starteten mit einem deutlichen Rabatt gegenüber allen anderen, was genau der erste Kommentar im Launch-Thread bemerkt hat.
"Interestingly unlike other Meta models this one seems to take a pretty big jump in pricing... $4/$20 in vs out making it higher than Sol and on par with Opus."

Ein durchgerechnetes Beispiel macht es greifbar. Nimm eine einstündige Agent-Session, die 50.000 Tokens liest und 15.000 schreibt. Mit Muse Wonder sind das 0,20 $ Input plus 0,30 $ Output, also 0,50 $. Mit Opus 5.5 sind es dieselben 0,50 $. Mit GPT-6.1 Sol sind es 0,25 $, und mit Muse Spark 1.3 etwa 0,13 $. Gleiche Session, ein Faktor 4 Spreizung, und Wonder liegt mit Opus an der Spitze.
Die andere Änderung gegenüber der Spark-Reihe ist der fehlende günstige Tarif. Spark 1.3 hat eine Contributor-ID für 0,10 $ Input und 0,20 $ Output, wenn du Meta mit deinem Traffic trainieren lässt. Wonder hat bei Pay-as-you-go keine solche ID. Die vollständige Kostenaufschlüsselung inklusive der Abo-Rechnung zeigt der Beitrag zu den Muse-Spark-1.3-Preisen, der erklärt, wie das ältere Zwei-ID-Modell funktionierte.
Muse-Code-Pläne: wo Wonder Full lebt
Wenn du das Modell willst, das Metas Diagramme anführt, kaufst du ein Coding-Abo. Hier die vier Muse-Code-Pläne zum Start.
| Plan | Preis | Nutzung | Modelle |
|---|---|---|---|
| Everyday Usage | 5 $/Monat | 10-50 Prompts alle 5 Stunden | Muse Spark, Muse Wonder, Muse Image |
| High Usage | 15 $/Monat | 5x Everyday | Wie Everyday, mehr multimodale Inputs |
| Power Usage | 50 $/Monat | 20x Everyday | Ergänzt Muse Wonder Full, früher Zugang zu Features |
| Maximum Usage | 200 $/Monat | 80x Everyday | Alles aus Power |
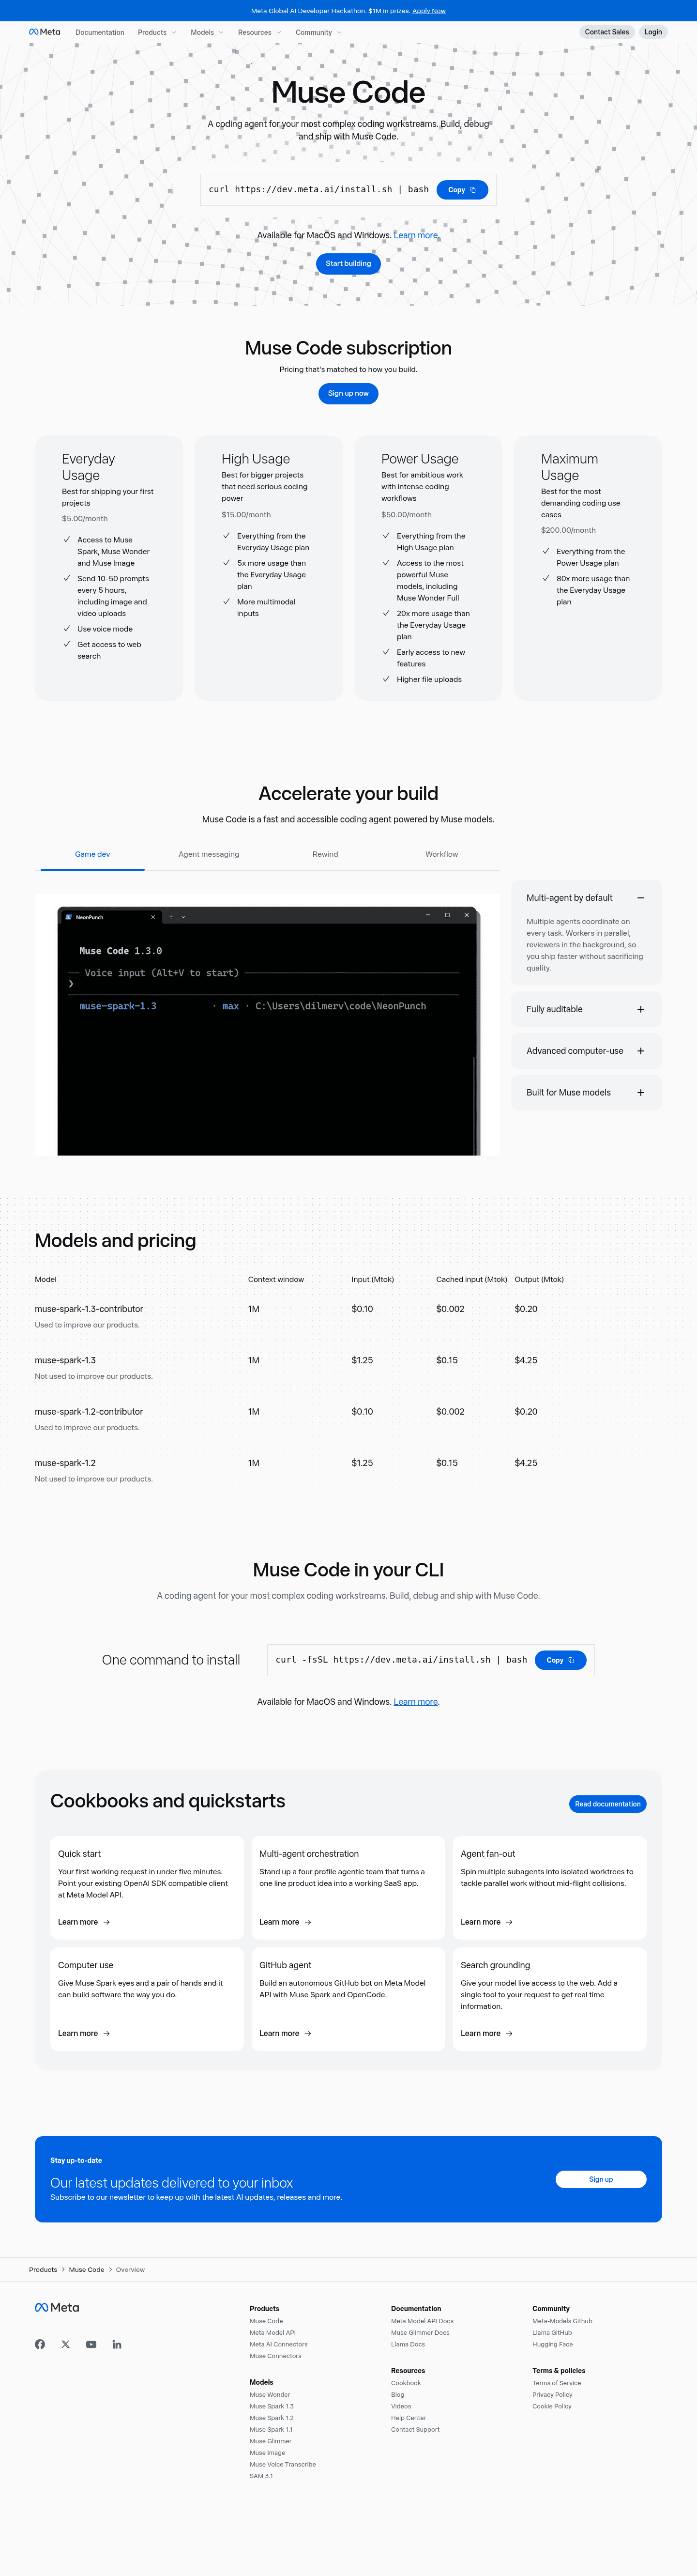
Drei Details aus Metas Abonnementbedingungen, die ich vor dem Bezahlen lesen würde: Die Pläne sind für Nutzer ab 18 Jahren, die Verfügbarkeit variiert je nach Region, und es gibt keine Rückerstattungen. Metas Modell-Dokumentation ergänzt ein viertes: Abos stehen standardmäßig im Contributor-Modus, dein Traffic hilft also beim Training von Metas Produkten, sofern du ihn nicht abschaltest.
Der 5-$-Plan ist bei Wonder außerdem schnell aufgebraucht. Ein Entwickler postete seine Nutzungsanzeige nach drei kleinen Anfragen.
"The usage limits on their basic $5 code plan to try things out are ludicrously low? I blew through 14% weekly usage and I'll I asked..."
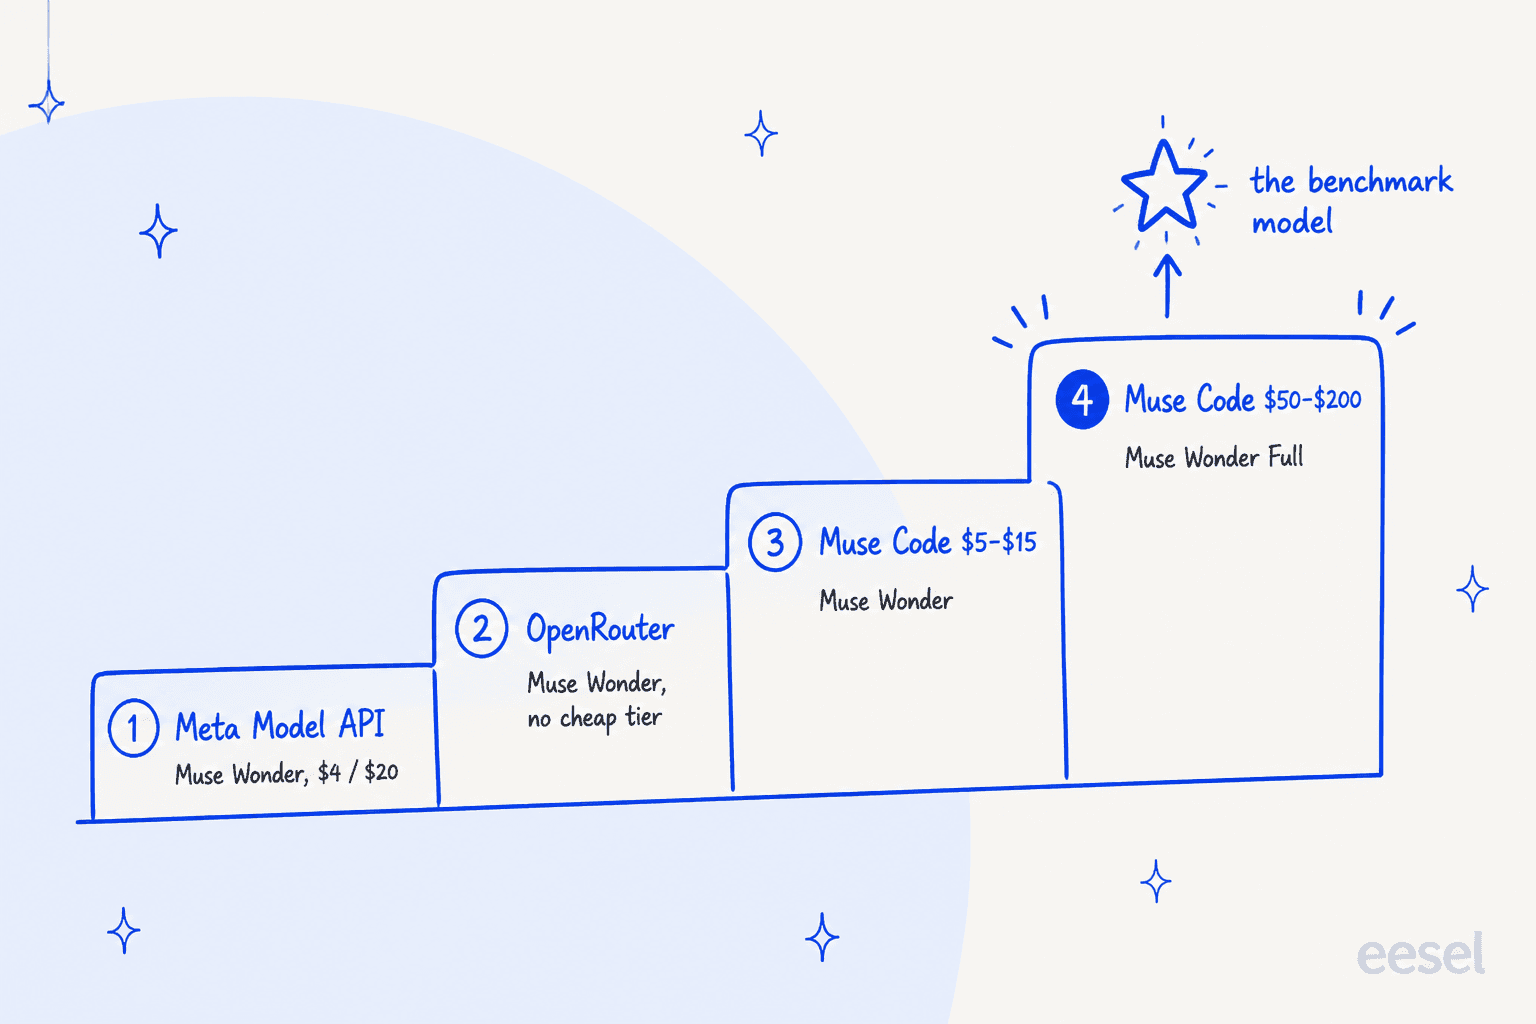
Wenn du bereits ein KI-Coding-Tool fürs Terminal wie Claude Code nutzt, lautet die praktische Frage, ob sich Muse Code als zweites Abo lohnt, nur um Full zu erreichen. Mein früheres Muse-Code-Review behandelt das Harness selbst, und die Aufschlüsselung der Muse-Code-Preise zeigt, was jeder Plan bei Spark bringt.
Wie Muse Wonder in Benchmarks abschneidet und welche Version gewonnen hat
Meta hat eine Benchmark-Tabelle mit 14 Zeilen veröffentlicht, die Wonder Full, Wonder, Claude Fable 5.1, GPT-6 Astra und Claude Opus 5.5 vergleicht. Zählt man die Siege, ist die Geschichte klar: Wonder Full gewinnt 6 Zeilen, Opus 5.5 gewinnt 6, GPT-6 Astra gewinnt 1, und die API-Version von Wonder gewinnt 1 (MemoryBench).
| Benchmark | Wonder Full | Wonder (API) | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Harvey LAB-AA (Recht) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| AutomationBench-AA | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| MemoryBench | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| DeepSWE 1.1 | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon | 57,5 | 53,1 | 45,6 | 42,5 | 46,3 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| ProgramBench | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| OSWorld V2.1 (partial) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| HealthBench Pro | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| GDP.pdf | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
Quelle: Metas Muse-Wonder-Modellseite. Fett markiert den Gewinner der Zeile. SWE-Marathon für Full ist mit Aufwand xhigh; die anderen Zeilen nutzen max.
Die Siege von Wonder Full häufen sich genau dort, wo Meta es versprochen hat: juristische und finanzielle Arbeitsergebnisse, durchgängige Geschäftsabläufe und Coding, das stundenlang läuft. Opus 5.5 behält das Terminal, die Computernutzung, Programmieren von Grund auf und den Gesamtindex.
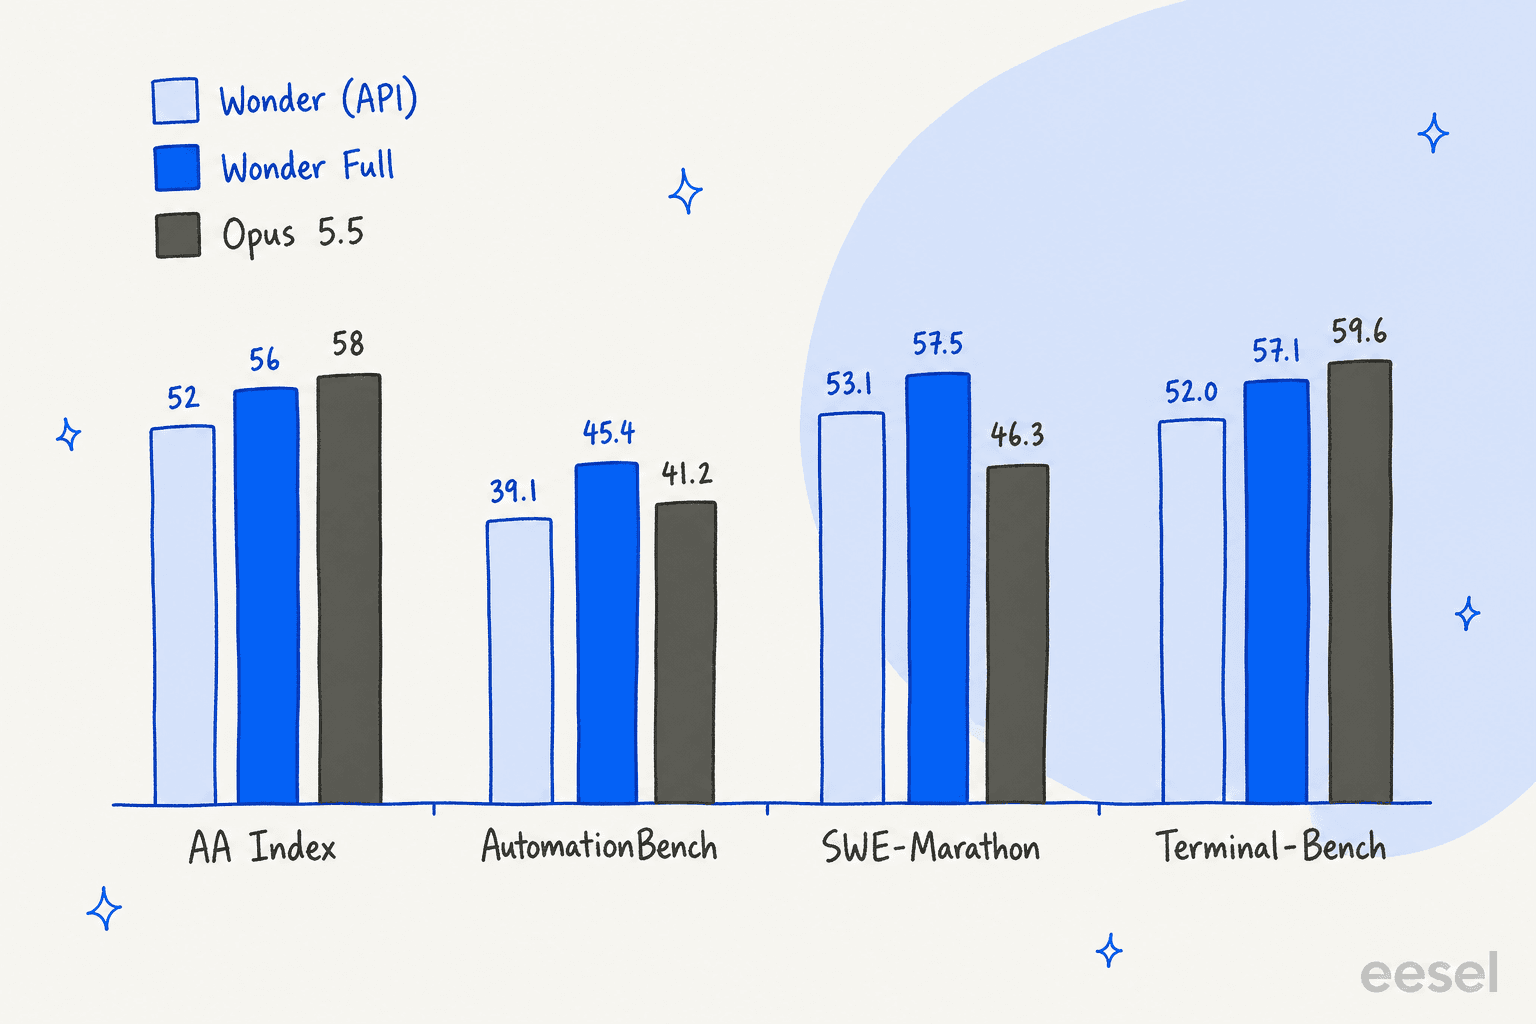
Der Haken ist, dass die erste Spalte diejenige ist, die die meisten nicht pro Token kaufen können. Ein Kommentator im Launch-Thread hat das innerhalb von Stunden bemerkt.
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Die API-Version hat dennoch zwei echte Stärken: Sie führt beim Gedächtnis und schlägt Opus 5.5 bei SWE-Marathon (53,1 vs. 46,3) und DeepSWE (78,8 vs. 74,2). Für langlaufende Coding-Agenten ist das nicht nichts. Aber beim allgemeinen Index liegt sie bei gleichem Preis 6 Punkte hinter Opus 5.5, und die Artificial-Analysis-Rankings verschoben sich noch am Launch-Tag. Ein Kommentator bemerkte, das Modell sei innerhalb von Stunden von Platz 2 auf Platz 5 gefallen, hinter Gemini 4 Argon.
Was Entwickler nach den ersten 48 Stunden sagen
Der Hacker-News-Launch-Thread erreichte 657 Punkte und 362 Kommentare, und der Ton teilt sich sauber: Respekt vor dem Benchmark-Sprung, Frust darüber, wie man daran kommt.
Der nützlichste Praxistest kam von einem Entwickler, der dieselbe Bild-zu-HTML-Aufgabe durch beide Modelle laufen ließ.
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test... I suspect its vision model isn't mature yet, and that it's been heavily optimized for text at this point in time."
Das ist ein Test mit Aufwand high, kein Urteil, passt aber zur Tabelle: Wonders Siege liegen bei textlastiger Agentenarbeit, nicht bei visuellen Aufgaben. Das Harness bekam eine härtere Kritik als das Modell.
"The benchmarks are great for sure. Now if only they could fix their coding harness so that it's usable for day-to-day use. I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux."
Zwei weitere wiederkehrende Anmerkungen: Simon Willison bestätigte, dass in der API nur muse-wonder-1.0 auftaucht, ohne Full-Modell-ID, und ein anderer Kommentator berichtete, die Abos seien zum Start nur in Nordamerika verfügbar gewesen. Metas Bedingungen sagen, die Verfügbarkeit variiere je nach Region, was dazu passt.
Sicherheit: Der Bericht ist noch nicht da
Meta sagt, Muse Wonder sei sein „most aligned model to date“ und liefere die bislang stärksten Schutzmaßnahmen gegen chemischen, biologischen, radiologischen, nuklearen und Cyber-Missbrauch, bei gleichzeitig verfügbaren defensiven Cyber-Fähigkeiten. Der Launch-Beitrag zeigt Diagramme zu nicht autorisierter Codeausführung, Umgang mit personenbezogenen Daten und Ablehnungsraten.
Der vollständige Sicherheitsbericht ist als „available soon“ aufgeführt. Bis er erscheint, beruhen die Sicherheitsaussagen auf Metas eigenen Diagrammen. Das wiegt hier schwerer als üblich, denn Meta bewirbt Wonder für persönliche Agenten, die Nachrichten, Kalender und private Dokumente lesen. Wenn du es für irgendetwas bewertest, das Kundendaten berührt, würde ich auf den Bericht warten, so wie ich auch das Sicherheitsdesign des Muse-Agenten als den Teil betrachtet habe, den man genau lesen sollte.
Wer sollte Muse Wonder also tatsächlich nutzen?
Meine Einschätzung, nach Situation:
- Du baust langlaufende Coding- oder Workflow-Agenten mit API-Budget. Teste Muse Wonder gegen Opus 5.5 an deinen eigenen Aufgaben. Gleicher Preis, ein echter Vorsprung bei SWE-Marathon und Gedächtnis, ein echtes Defizit beim Terminal und im allgemeinen Index. Deine Arbeitslast entscheidet, nicht das Plakat.
- Du willst Metas stärkstes Modell und lebst in einer unterstützten Region. Das ist Wonder Full, und der günstigste Einstieg sind 50 $/Monat für Muse Code Power. Plane ein, dass das Harness jünger ist als das Modell.
- Du verarbeitest große Mengen günstig. Bleib bei Muse Spark 1.3. Meta selbst sagt, Spark sei die Wahl für Volumen, Latenz und Kosten.
- Du brauchst visuelle Stärke oder Computernutzung. Opus 5.5 führt bei OSWorld und beim einen öffentlichen Bild-zu-HTML-Test. Wonder ist noch nicht die Wahl.
- Du brauchst offene Gewichte oder Self-Hosting. Wonder ist geschlossen. Schau dir stattdessen Open-Source-KI-Agenten an.
Speziell für den Kundensupport ist die Modellwahl die kleinere Entscheidung. Mein Leitfaden zu Support-Modellen erklärt, warum Retrieval, Eskalation und Tests die Lösungsqualität stärker bewegen als ein paar Indexpunkte. Eine Lücke von 6 Punkten in einem allgemeinen Benchmark zeigt sich selten in einer Warteschlange; ein veralteter Help-Center-Artikel zeigt sich jeden Tag.
eesel ausprobieren
Muse Wonder ist Infrastruktur: ein Modell, das du selbst aufrufst, mit Ratenlimits versiehst, promptest und überwachst. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied kommt bereits mit Zendesk, Freshdesk, Gorgias und den übrigen verbunden, ist auf deine vergangenen Tickets und dein Help Center trainiert, und du kannst es gegen Hunderte deiner historischen Tickets laufen lassen, bevor es einen einzigen Live-Kunden beantwortet. Genau dieser Simulationsschritt fängt die Antwort „Wir unterstützen alle Modelle“ ab, bevor es ein Kunde tut.
Wenn du es lieber so steuern willst, wie du Muse Code steuern würdest, funktioniert die eesel CLI im Terminal. eesel instructions liest und bearbeitet die dauerhaften Regeln des Teammitglieds, eesel approvals listet die Aktionen auf, die auf einen Menschen warten, und eesel activity zeigt, was es getan hat und warum. Jeder Befehl gibt JSON aus und Schreibzugriffe unterstützen --dry-run, sodass ein Coding-Agent wie Claude Code dein Support-Teammitglied genauso verwalten kann wie dein Repository. Wenn du stattdessen Inhalte erstellst, gehört zum selben Team auch ein KI-Blog-Writer.

Der Start ist kostenlos mit 100 Credits und ohne Karte. Teste eesel an deiner eigenen Warteschlange und sieh, was es mit den Tickets des letzten Monats macht.
Häufig gestellte Fragen
Was ist Meta Muse Wonder?
Was kostet Meta Muse Wonder?
muse-wonder-1.0 4,00 $ pro Million Input-Tokens, 0,20 $ für gecachte Tokens und 20,00 $ für Output, bei einem Kontextfenster von 1 Mio. Tokens und ohne Aufschlag für langen Kontext. Das entspricht exakt den Preisen von Claude Opus 5.5. Wonder Full hat gar keinen Token-Preis; du erreichst es über Muse Code Power für 50 $/Monat oder Max für 200 $/Monat.Was ist der Unterschied zwischen Muse Wonder und Muse Wonder Full?
max stellst, wechselst du nicht zu Full, und Full gibt es weder in der API noch auf OpenRouter. Wenn du darauf aufbauen willst, ist die Version, die du pro Token kaufen kannst, Muse Wonder.